


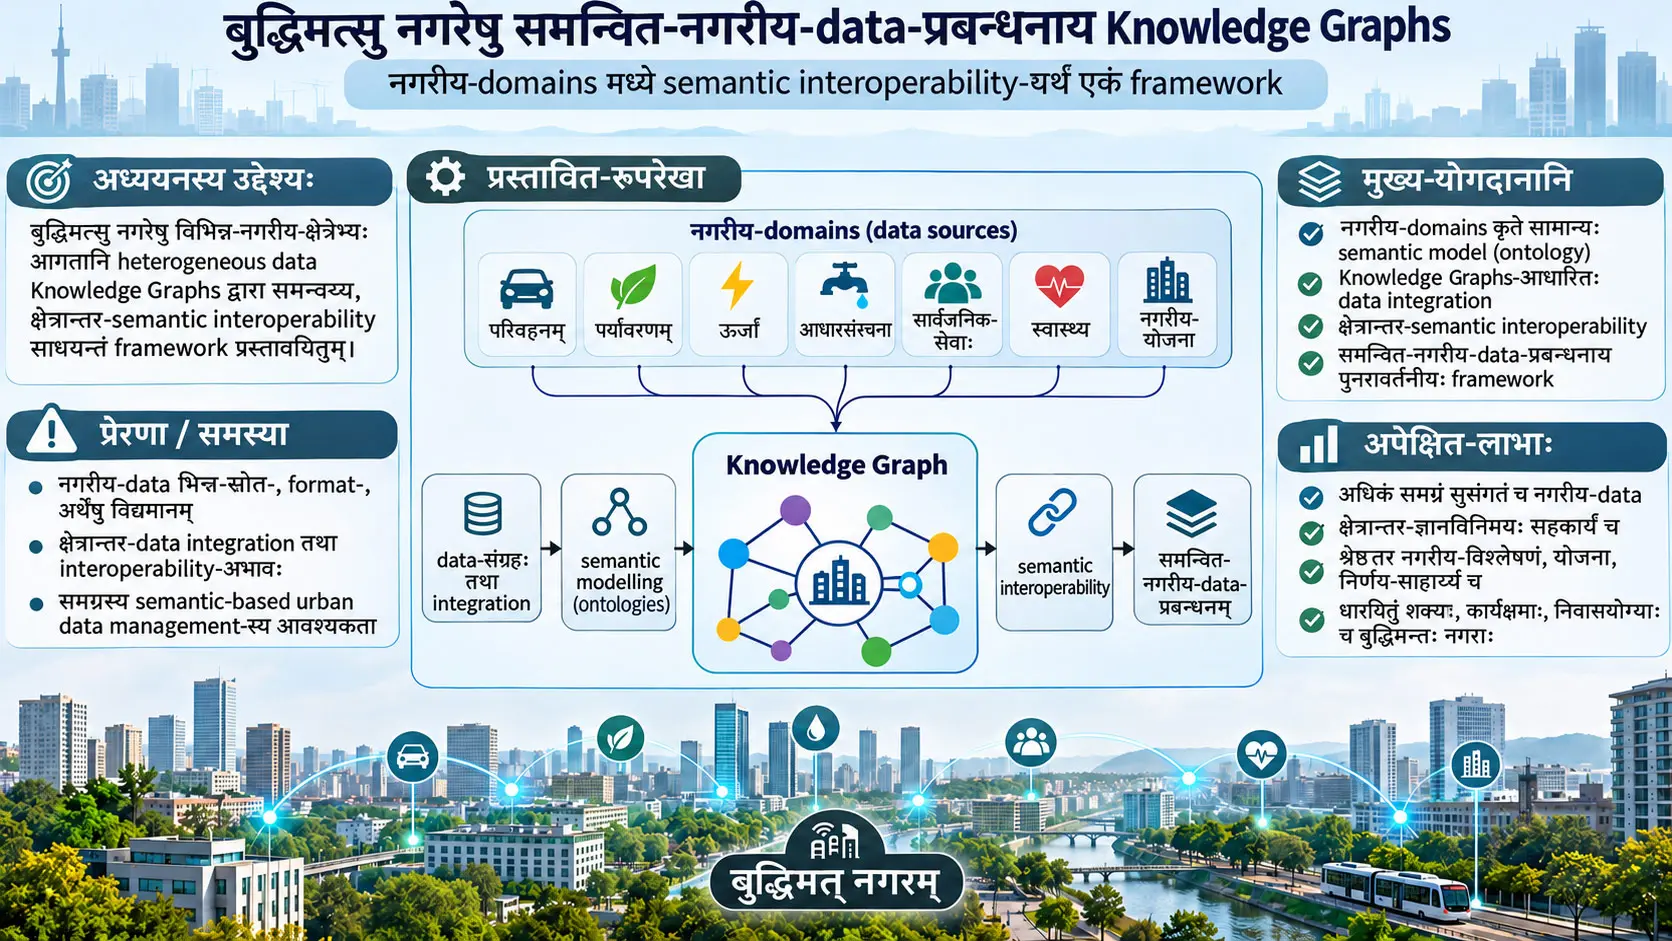
UrbanKG नामकं तन्त्रं बुद्धिमत्सु नगरेषु परिवहनस्य, ऊर्जायाः, पर्यावरणस्य, सार्वजनिकसुरक्षायाः, नागरिकसेवानां च data एकस्मिन् समानार्थसम्बद्धे model मध्ये परस्परं सम्बद्धुं विकसितं चतुस्तरीयं Knowledge Graph (KG) architecture अस्ति। Sommai Khantong, Charuay Savithi, Mohammad Nazir Ahmad इत्येतैः कृतस्य अध्ययनस्य अन्तर्गतं Design Science Research Methodology (DSRM) उपयुक्ता; मुक्त-data-स्रोतैः निर्मितेन proof-of-concept-प्रयोगेन च framework परीक्षितम्। निर्मिते Knowledge Graph मध्ये 287.456 RDF triples, 23.847 पृथक् entities, 127 relation-types, 42.384 time-stamped observations च सन्ति। शोधकर्तारः पञ्च design objectives सिद्धानीति, 23 cross-domain query patterns सफलतया सञ्चालितानीति, प्रस्तावितस्य architecture इत्यस्य semantic integration, temporal representation, federated management, hybrid inference च विषये तकनीकी कार्यसाध्यता दृश्यते इति प्रतिवेदयन्ति। एते निष्कर्षाः कस्यचित् वास्तविकस्य महानगरस्य पूर्णस्य live-production-प्रयोगस्य प्रमाणीकरणं न सूचयन्ति।
अध्ययनस्य मूलसमस्या केवलं नगरीय-data पृथक् files अथवा servers मध्ये स्थितमिति नास्ति; विभिन्नानि systems तान्येव objects, locations, times, relations च भिन्नरूपेण निर्दिशन्ति इति अपि समस्या अस्ति। UrbanKG एतां semantic fragmentation-समस्याम् ontologies, standard identifiers, RDF relations, SPARQL queries, cross-domain links च द्वारा सम्बोधयति।
अध्ययनं पुनः दर्शयति यत् नगरे सेवाप्राप्यता परिवहन-infrastructure सहितं hospital, public-service, environmental indicators च एकत्र परीक्ष्य अध्ययनं कर्तुं शक्यते। किन्तु प्रयुक्तस्रोतानां, sampling-निर्णयानां, synthetic emergency-response-components इत्येषां, केषाञ्चन measurement-definitions इत्येषां च मर्यादाभिः निष्कर्षाः परीक्षितस्य proof-of-concept-परिस्थितेः सह एव व्याख्येयाः।
1. बुद्धिमत्सु नगरेषु मूलसमस्या: केवलं data किमर्थं पर्याप्तं नास्ति?
बुद्धिमन्नगर-systems परस्परस्वतन्त्रेभ्यः technical infrastructures इत्येभ्यः data सङ्गृह्णन्ति। परिवहन-systems stations, vehicles, routes, trips च; ऊर्जा-systems meters, distribution facilities, consumption च; पर्यावरण-systems वायुगुणं meteorological measurements च; सार्वजनिकसुरक्षा-systems incidents, response resources च; नागरिकसेवाः service requests तेषां status च अभिलेखयन्ति।
एतेषां records इत्येषां संयुक्तमूल्याङ्कनं अपेक्षितं, तथापि विभिन्नाः संस्थाः पृथक् data models, identifiers, access protocols, terminology च प्रयुञ्जीरन्। अतः एकमेव नगरभागं सम्बध्नन्ति परिवहन-, ऊर्जा-, पर्यावरण-data कम्प्यूटर-systems इत्येषां दृष्ट्या परस्परम् असम्बद्धानि स्थातुं शक्नुवन्ति।
एषा अवस्था data silos इति कथ्यते। अस्याः semantic पक्षः विशेषतः महत्त्वपूर्णः: द्वयोः data-sets इत्योः समानरूपेण सञ्चयनं तौ समानान् concepts प्रतिनिधीयाताम् अथवा तयोः relation स्पष्टतया निर्दिष्टः अस्ति इति न सुनिश्चितयति।
उदाहरणार्थं परिवहन-record मध्ये station identifier तथा spatial data-set मध्ये physical-location object भिन्नाभ्यां identities युक्तौ भवेताम्। सामान्या relation अस्थापयित्वा files केवलं समाहृत्य, एतौ records कथं सम्बद्धौ स्तः इति स्वयमेव न ज्ञायते।
UrbanKG-शोधसमस्या इयं यत् विभिन्नसंस्थाभिः उत्पादितं data पूर्णतया केन्द्रीय-schema मध्ये अनानयित्वा, समानस्य semantic-structure इत्यस्य माध्यमेन query-योग्यं संयुक्तव्याख्यायोग्यं च करणीयम्।
Knowledge Graph किम्? बुद्धिमत्सु नगरेषु तस्य प्रयोजनं किम्?
Knowledge Graph (KG) वास्तविकजगतः entities इत्येतान् nodes इत्यैः, तेषां मध्ये निर्दिष्टाः relations इत्येतान् links इत्यैः च प्रतिनिधयन् structured knowledge model अस्ति। बुद्धिमत्सु नगरेषु Knowledge Graph परिवहन-station, विद्युत्-वितरण-point, environmental sensor, administrative area, public service इत्यादीनां विभिन्न-domain-entities इत्येषां एकस्मिन् semantic framework मध्ये परस्परसम्बन्धं सम्भावयति। UrbanKG-अध्ययनं Knowledge Graph इत्येतान् नगरस्य सर्वं data एकत्र सञ्चयति इति अनिवार्यं केन्द्रीयं repository न मन्यते; भिन्न-data-sources मध्ये semantic connection ददाति इति infrastructure रूपेण स्थापयति।
2. RDF triple: relation कम्प्यूटरद्वारा कथं प्रतिनिधीयते?
मूल-अध्ययनस्य प्रमुख-technology मध्ये Resource Description Framework (RDF) एकम्। RDF ज्ञानं त्रिभिः अङ्गैः युक्तासु relations इत्येषु प्रतिनिधयति:
Subject — Predicate — Object
Subject तद् entity यत् विषये सूचना दीयते। Predicate entity इत्यस्य कः property अथवा relation कथ्यते इति सूचयति। Object तु relation यत्र सम्बध्यते तदन्यं entity अथवा value दर्शयति।
स्रोतस्य RDF-approach स्पष्टयितुं निम्नलिखितः स्वतन्त्रः शिक्षणार्थः उदाहरणः प्रयुज्यते:
urb:Durak_A urb:bulunduguBolge urb:Bolge_5 .
एषः expression Durak_A नाम entity Bolge_5 नाम administrative area मध्ये स्थितम् इति प्रतिनिधयति। अत्र नामानि शिक्षणार्थानि placeholders सन्ति; UrbanKG data-set मध्ये प्रमाणीकृतानि वास्तविक-records इति न प्रस्तूयन्ते।
RDF मध्ये पूर्ण-identifiers URI अथवा IRI रूपेण प्रयुज्यन्ते। संक्षिप्ताः prefixes दीर्घ-identifiers अधिकं पठनीयतया दर्शयन्ति। relation इत्यस्य अर्थः अपि ontology मध्ये निर्दिश्यते, येन विभिन्न-applications समानं predicate सुसङ्गतया मूल्याङ्कयितुं शक्नुवन्ति।
3. Ontology, T-Box, A-Box च मध्ये भेदः
Ontology कस्यचित् निश्चितस्य knowledge-domain इत्यस्य concepts, तेषां परस्परrelations, logical properties च निर्दिशति इति formal structure अस्ति। UrbanKG मध्ये ontology विभिन्नसंस्थाभिः समान-entity-types समानार्थैः प्रतिनिधयितुं प्रयुज्यते।
T-Box (Terminological Box) knowledge model इत्यस्य conceptual तथा schematic भागः। entity कस्मिन् class मध्ये भवेत्, classes परस्परं कथं सम्बद्धाः, properties केषु entity-types इत्येषु प्रयोज्याः इति निर्दिशति।
A-Box (Assertional Box) निश्चित-entities इत्येषां उदाहरण-records तथा तेषां मध्ये वास्तविक-relations धारयति।
उदाहरणार्थम् ontology मध्ये "TopluTaşımaDurağı" नाम class-निर्देशः T-Box-स्तरस्य conceptual operation अस्ति। निश्चितस्य station-entity इत्यस्य अस्य class मध्ये सदस्यत्वस्य निर्देशः A-Box-स्तरस्य उदाहरण-information अस्ति।
स्रोत-UrbanKG proof-of-concept मध्ये 287.456 RDF triples A-Box-records इति प्रतिवेदितानि। एषा संख्या ontology इत्यस्य class-संख्यया सह न मिश्रणीया।
4. RDF, RDFS, OWL, SHACL, SPARQL, GeoSPARQL च कथं भिद्यन्ते?
| Technology | मुख्यकार्य | UrbanKG-सन्दर्भः |
|---|---|---|
| RDF | Subject-predicate-object triples द्वारा ज्ञानप्रतिनिधित्वम् | Entity-relation-records इत्येषां मूल-data-model |
| RDFS | Class तथा property hierarchies निर्देष्टुम् | Conceptual classification तथा मूल inference |
| OWL | अधिकविस्तृतानि ontological definitions तथा logical relations स्थापयितुम् | Formal urban ontology तथा deductive inference |
| SHACL | RDF data निर्दिष्ट-shapes तथा constraints अनुरूपम् अस्ति वा इति परीक्षितुम् | Schema-conformance-परीक्षणम् |
| SPARQL 1.1 | RDF graphs मध्ये patterns अन्वेष्टुं query कर्तुं च | Cross-domain data access तथा analysis |
| GeoSPARQL | Geographic geometry तथा spatial relations query कर्तुम् | Location, proximity, coverage-analysis |
| OWL-Time | Time points तथा intervals प्रतिनिधयितुम् | Time-stamped observations तथा events |
| PROV-O | Data provenance तथा production-relations प्रतिनिधयितुम् | Data provenance तथा event-chain relations |
| RML / R2RML | Source data RDF मध्ये परिवर्तयितुं mappings निर्देष्टुम् | भिन्न-data-sources semantic model मध्ये आनयनम् |
एते सर्वे standards समानं कार्यं न कुर्वन्ति। RDF data प्रतिनिधयति, ontology तस्य data इत्यस्य अर्थं संरचयति, SHACL conformance-check ददाति, SPARQL queries करोति, GeoSPARQL spatial operations सम्भावयति।
विशेषतः OWL मध्ये logical inference तथा SHACL मध्ये data-conformance-check पृथक् मन्तव्यौ। graph मध्ये logical रूपेण नूतन-relation निष्पादयितुं शक्यते इति कारणेन data सर्वान् application-constraints पूरयति इति न सिद्ध्यति।
5. Knowledge Graph तथा digital twin इत्योः सम्बन्धः
Digital twin भौतिकम् entity अथवा system डिजिटल्-पर्यावरणे प्रतिनिधयन्, उचित-data-links द्वारा अद्यतनं कर्तुं शक्यः system-approach अस्ति। Knowledge Graph तस्याः संरचनायाः सर्वथा समानः नास्ति।
UrbanKG-approach मध्ये Knowledge Graph भौतिक-प्रशासनिक-entities, तेषां relations, geographic context, data provenance च प्रतिनिधयन् semantic infrastructure भवितुं शक्नोति। Digital twin इत्यस्य visualization अथवा simulation-components तु अस्य structured knowledge उपरि कार्यं कर्तुं शक्नुवन्ति।
स्रोत-अध्ययने digital twin synchronization architecture इत्यस्य application possibilities मध्ये निर्दिष्टम्। अस्य अर्थः न यत् अध्ययनमध्ये पूर्णकार्यशीलः city digital twin live environment मध्ये सञ्चालितः।
6. साहित्ये UrbanKG येन रिक्तस्थानं समाधानयितुम् इच्छति
स्रोत-अध्ययनं कथयति यत् smart-city Knowledge Graph विषयेषु पूर्ववर्ती approaches परिवहनं mobility च इत्यादिषु विशिष्ट-data-domains मध्ये महत्त्वपूर्णां प्रगतिं कृतवन्तः; तथापि स्वतन्त्रसंस्थानां data संयुक्ततया प्रबन्धयितुं, domains मध्ये inference कर्तुं, technical results व्यवस्थिततया मूल्याङ्कयितुं च खुल्लाः research problems अवशिष्टाः।
Km4City, Liu तथा सहकर्मिणां UrbanKG-approach, temporal urban Knowledge Graphs, Snap4City इत्यादयः पूर्ववर्ती-अध्ययनानि अस्य शोधस्य comparative framework मध्ये चर्च्यन्ते।
अतः नूतन-अध्ययनस्य योगदानं Knowledge Graph technology प्रथमवारं smart cities मध्ये प्रयोगः नास्ति। योगदानं ontology-first structuring, federated data management, temporal knowledge representation, deductive तथा inductive inference इत्योः संयोजनम्, proof-of-concept evaluation च एकस्मिन् design framework मध्ये स्थापयितुम् अस्ति।
स्रोते पूर्ववर्ती-अध्ययनैः सह comparisons अपि सन्ति। एते comparisons परीक्षितेषु articles इत्येषु प्रतिवेदित-विशेषताभिः आधारिताः; सर्वेषां सम्भाव्य-Knowledge Graph technologies इत्येषां सर्वाङ्गीणः स्वतन्त्रः अन्तर्राष्ट्रीय-performance-competition इति न व्याख्येयाः।
UrbanKG इत्यस्य चतुस्तरीय architecture कथं कार्यं करोति?
UrbanKG इत्यस्य चतुस्तरीय architecture data ingestion, semantic integration, Knowledge Graph storage, application-analytics services च समाविशति। प्रथमस्तरः भिन्नस्रोतागतं data RDF-format मध्ये परिवर्तयति। द्वितीयस्तरः entity matching, ontology alignment, cross-domain linking च करोति। तृतीयस्तरः RDF triples तथा inference-functions धारयति। चतुर्थस्तरः query interfaces, dashboards, decision-support-services च प्रददाति। Architecture केन्द्रीय-data-ownership अनिवार्यं न कृत्वा समान-semantic-use साधयितुं प्रयतते।
7. प्रथमस्तरः: Data ingestion
Data-ingestion-स्तरः smart-city-infrastructure द्वारा विभिन्नरूपेण उत्पादितां सूचनां Knowledge Graph मध्ये आनयितुं योग्यां करोति। स्रोताः sensor streams, geographic information system records, open public data-sets, application programming interfaces च सन्ति।
अध्ययने Apache Kafka data streams buffer कर्तुं, Apache Flink stream-data process कर्तुं च प्रयुक्तौ। Proof-of-concept मध्ये Flink द्वारा पञ्चमिनिट्-windows मध्ये aggregation कृतम्।
RML तथा R2RML mappings source-data-fields कथं ontology मध्ये निर्दिष्टेषु classes तथा properties परिवर्तनीयाः इति निर्दिशन्ति। उदाहरणार्थं परिवहन-data मध्ये station-name तथा station-ID RDF-format मध्ये public-transport-station entity निर्मातुं प्रयुज्येताम्।
एतत् mapping केवलं file-format-परिवर्तनं नास्ति। Source-fields केषां concepts सह मिलन्ति इति निर्धारणं पश्चात् semantic queries इत्येषां consistency कृते आवश्यकम्।
8. द्वितीयस्तरः: Semantic integration
Semantic-integration-स्तरः भिन्न-systems मध्ये records केषां वास्तविक-जगतः entities इत्येषां सन्ति, तथा ते entities समान-ontology सह कथं सम्बध्यन्ते इति निर्धारयति।
Entity resolution भिन्न-records एकमेव entity प्रतिनिधयन्ति वा न वा इति मूल्याङ्कन-प्रक्रिया। Ontology alignment भिन्न-conceptual-schemas मध्ये समकक्ष-अथवा-सम्बद्ध-definitions मिलयितुं लक्ष्यते। Link discovery भिन्न-data-domains मध्ये नूतन-relations स्थापयितुं सम्भावयति।
UrbanKG इत्यस्य proof-of-concept मध्ये स्थानिक-सामीप्यं type-सामञ्जस्यं च एकत्र प्रयुक्तम्। स्रोतस्य अनुसारं 50 metre-सीमायाः अन्तर्गताः तथा type-दृष्ट्या अनुकूलाः entities owl:sameAs link कृते मूल्याङ्किताः।
owl:sameAs इति, एकमेव वास्तविक-जगतः entity प्रतिनिधयतः इति स्वीकृतयोः identifiers मध्ये दृढां identity घोषयति। केवलं समीपस्थानेषु स्थितिः वास्तविक-identity न प्रमाणयति। अतः type-सामञ्जस्यं accuracy-मूल्याङ्कनं च महत्त्वपूर्णम्।
9. तृतीयस्तरः: Knowledge Graph इत्यस्य सञ्चयनम्
तृतीयस्तरः निर्मितानि RDF triples तैः सम्बद्धानि metadata च सञ्चिनोति। SPARQL queries द्वारा access लभ्यते। Ontological rules inference-engine द्वारा process कर्तुं शक्यन्ते, graph-embedding models च relational patterns अधिगन्तुं शक्नुवन्ति।
स्रोत-प्रयोगे Apache Jena Fuseki 4.7.0 तथा TDB2 backend उपयुक्तौ। System Docker environment मध्ये चारि CPU cores तथा 16 GB RAM सहितं चालितम्।
एतानि hardware तथा software-विवरणानि performance-results कस्मिन् technical environment मध्ये प्राप्तानि इति ज्ञातुं आवश्यकानि। अन्यस्मिन् hardware मध्ये समानाः query-times पूर्वमेव अपेक्षितुं न शक्यन्ते।
10. चतुर्थस्तरः: Application तथा analytics
अन्तिमस्तरः निर्मितं Knowledge Graph query कृत्वा नगरीय-decision-support प्रक्रियाभिः सम्बध्नन् services धारयति। SPARQL endpoint applications इत्येभ्यः विभिन्नेषु urban data domains मध्ये relational queries कर्तुं समर्थयति।
स्रोत-architecture dashboards, cross-domain event-relations, digital twin connections, prediction-services च सम्भाव्य-application-components इति निर्दिशति। Proof-of-concept मध्ये एतेषां सर्वेषां कृते वास्तविक-city-scale continuous-production performance प्रतिवेदितं नास्ति।
11. पञ्च urban data domains एकस्मिन् समान-model मध्ये
| नगरीय-domain | मुख्य-data | स्रोतस्य निर्दिष्टाः standards |
|---|---|---|
| परिवहनम् | Roads, routes, stops, vehicles | NeTEx, GTFS Linked Data, GeoSPARQL |
| ऊर्जा | Generation, distribution, smart-meter तथा demand-data | SAREF4ENER, IEC CIM, GeoSPARQL, EM-KPI, Brick, BOT |
| पर्यावरणम् | वायुगुणः, pollutants, meteorological तथा hydrological observations | SSN/SOSA, QUDT, GeoSPARQL |
| सार्वजनिकसुरक्षा | Emergency incidents, response units, risk areas | EDXL, GeoSPARQL, POLARISCO, Dynamic Flood Ontology |
| नागरिकसेवाः | Administrative services, applications, service points | schema.org, W3C Organization Ontology, GeoSPARQL |
GeoSPARQL सामान्याः spatial concepts दत्त्वा विभिन्न-domains आगतानि entities कुत्र स्थितानि, परस्परं कथं स्थितानि च इति query कर्तुं साहाय्यं करोति।
Ontology इत्यस्य औपचारिक-model-scope 47 classes, 89 object properties, 34 datatype properties इति प्रतिवेदितम्। एते त्रयः categories परस्परं भिन्नाः: class entity-type प्रतिनिधयति, object property द्वयोः entities मध्ये relation, datatype property तु entity-संबद्धं numeric अथवा textual value प्रतिनिधयति।
Federated Data Management किम्?
Federated data management इति, विभिन्न-data-domains स्वकीयाः संस्थागत-management तथा storage-responsibilities रक्षन्तः common standards द्वारा संयुक्ततया query कर्तुं शक्नुवन्ति इति approach। UrbanKG urban domains पृथक् named graph sections इति पश्यति, तान् common ontological terms द्वारा सम्बद्धुं च प्रस्तावयति। अतः transport अथवा energy इत्यादयः domains एकस्य संस्थागत-data-owner अधीनम् एकत्र करणीयाः न भवन्ति। किन्तु federated partitioning स्वयमेव personal-data स्तरस्य authorization, privacy, अथवा पूर्ण-regulatory compliance सिद्धं न करोति।
12. Named graphs तथा cross-domain querying
RDF मध्ये named graph इति निश्चितस्य RDF triples-समूहस्य परिभाषितेन graph identifier अधः सञ्चयनं सम्भावयति। एषा रचना data source, domain, version अथवा time इत्यादीन् contexts पृथक् कर्तुं प्रयुज्यते।
UrbanKG मध्ये transport, energy, environment, public safety, citizen services domains पृथक् manage कर्तुं शक्याः इति परिकल्पितम्। Domains मध्ये common identities, ontological links, SPARQL 1.1 federation-functions च प्रयोज्याः।
SPARQL मध्ये GRAPH expression निश्चिते named graph मध्ये matching करोति, SERVICE expression तु अन्यस्मै SPARQL service endpoint प्रति query प्रेषयितुं शक्नोति। एतौ समानकार्यौ न स्तः; named-graph-logic तथा distributed-endpoint access पृथक् अवगन्तव्यौ।
स्रोतः semantic version management मध्ये ontology-version information तथा change-notifications मध्ये Kafka topics उपयोग्यन्ते इति वदति। Update-conflicts मध्ये timestamp-आधारितं समाधानं तथा कालेन consistency प्राप्तेः approach निर्दिष्टः।
13. Temporal data पृथक् किमर्थं प्रतिनिधीयते?
नगरस्य किञ्चित् information तुलनया स्थिरं भवति: roads परस्परं कथं सम्बद्धाः, administrative boundary relations च उदाहरणानि। Sensor value, vehicle location, अथवा incident-status तु कालक्रमे परिवर्तते।
UrbanKG structural relations तथा time-dependent observational records पृथक्करोति। Observation-information time-stamped named graphs मध्ये धारयितुं शक्यते। Events इत्येषां आरम्भ-अन्तसमययोः कृते OWL-Time, data provenance तथा production-relations कृते PROV-O प्रयुज्यते।
Timestamps ISO 8601-form मध्ये UTC प्रति normalize करणेन विभिन्नस्रोतानां time-representations मध्ये common basis निर्मीयते। तथापि daily summary data तथा minute-level measurement समान temporal precision न धारयतः। स्रोतः एतं भेदं precision-metadata द्वारा प्रतिनिधयितुं परिकल्पयति।
| Item | वैज्ञानिककार्य |
|---|---|
time:Interval | आरम्भ-अन्तयुक्तं time interval प्रतिनिधयति। |
time:hasTime | Entity अथवा event इत्येतत् time-definition सह सम्बध्नाति। |
time:hasBeginning | Interval इत्यस्य आरम्भक्षणं निर्दिशति। |
time:hasEnd | Interval इत्यस्य अन्तक्षणं निर्दिशति। |
time:inXSDDateTime | Time-value date-time datatype द्वारा व्यक्तुं समर्थयति। |
time:hasPrecision | स्रोते time-precision सूचयितुं प्रयुक्तम्। |
time:before | Temporal precedence relation दर्शयति। |
स्रोत-अध्ययनस्य road-closure उदाहरणे कश्चित् event 15 March 2026 आरब्धः 30 June 2026 समाप्तः च time interval द्वारा प्रतिनिधीयते। एतत् ontology-mechanism व्याख्यातुं code-display-example अस्ति; proof-of-concept इत्यस्य 1–14 May 2024 मुख्य-observation period सह न मिश्रणीयम्।
अपि च कालतः पूर्वं घटना स्वयमेव causality न प्रमाणयति। Event-chains इत्येषां वैज्ञानिकव्याख्यायां temporal order तथा causal relation पृथक् विचारणीयौ।
14. Deductive तथा inductive inference
UrbanKG इत्यस्य hybrid inference approach द्वौ भिन्नौ information-processing modes एकत्र करोति।
निगमनात्मक inference (deductive inference) परिभाषिताभ्यः ontology-relations तथा logical rules इत्येभ्यः आरभ्य, स्पष्टतया अलिखिताः किन्तु rules द्वारा समर्थिताः relations निष्पादयति।
आगमनात्मक inference (inductive inference) data मध्ये relational patterns अधिगच्छन्तः numerical models उपयुङ्क्ते। Knowledge Graph embedding methods अस्यार्थं entities तथा relations vectors द्वारा प्रतिनिधयितुं शक्नुवन्ति।
| विशेषता | निगमनात्मक-component | आगमनात्मक-component |
|---|---|---|
| स्रोते प्रयुक्तः approach | OWL-RL | RotatE |
| कार्यप्रणाली | Rules-आधारित inference | Graph-relations इत्येभ्यः learning |
| मुख्यकार्य | Logical तथा schematic relation निष्पादनम् | Link-pattern learning तथा link prediction |
| मर्यादा | सर्वं data-pattern स्वयमेव न अधिगच्छति। | Logical schema constraints स्वयमेव न सुनिश्चितयति। |
15. OWL-RL rules इत्येषां अर्थः
स्रोते 23 OWL-RL rules Apache Jena forward-chaining inference mechanism द्वारा प्रयुक्ताः इति कथितम्। Forward-chaining approach मध्ये विद्यमान-information इत्यस्मात् rules द्वारा नूतनाः inferences उत्पाद्यन्ते।
उदाहरण-rule-type मध्ये subclass-transitivity अस्ति। यदि class A, B इत्यस्य subclass, B च C इत्यस्य subclass, तर्हि A अपि C इत्यस्य subclass इति infer कर्तुं शक्यते।
Domain inference मध्ये property कस्य class कृते प्रयोज्यमिति ontology मध्ये परिभाषिते, तत् property प्रयुञ्जानस्य entity इत्यस्य class विषये conclusion लभ्यते।
स्रोते spatial containment तथा class-relations विषये inference-examples अपि सन्ति। एतादृशाः rules प्रयोगे के spatial relations तथा logical assumptions उपयुज्यन्ते इति महत्त्वपूर्णम्; सर्वे spatial relations निरपेक्षतया transitive इति स्वीकर्तुं न शक्यन्ते।
स्रोतस्य evaluation भागे 23 SWRL rules इत्यपि उक्तम्। OWL-RL तथा SWRL technical दृष्ट्या भिन्नौ concepts। अतः समानसंख्या दृश्यते इति कारणेन द्वौ rule-families समानौ इति न स्वीकरणीयम्; अध्ययनस्य terminological भेदः रक्षितः।
16. RotatE Knowledge Graph embedding model
RotatE इति Knowledge Graph मध्ये entities तथा relations numerical vector representations द्वारा model कृत्वा link prediction करोति इति approach। स्रोत-अध्ययने RotatE इत्यस्य प्रयोजनं स्पष्टतया recorded relations बाह्याः सम्भाव्य-link-patterns अधिगन्तुं समर्थम् inductive component दातुम्।
Embedding model entities numerical representations मध्ये परिवर्तयति। एतानि representations relational patterns अधिगन्तुं शक्यन्ति; किन्तु कस्यचित् link इत्यस्य उच्च-prediction-score वास्तविक-जगतः relation निश्चिततया प्रमाणितः इति न सूचयति।
| Parameter | Source value | Explanation |
|---|---|---|
| Embedding dimension | 200 | अधिगमितस्य representation इत्यस्य dimensional size |
| Negative sampling | प्रति positive triple 128 negative samples | Link prediction मध्ये comparative-learning samples |
| Loss approach | Self-adversarial negative sampling loss | Model द्वारा negative samples इत्येषां evaluation-आधारितः loss |
| Optimization | Adam | Model parameters अद्यतनं कुर्वन् optimization-method |
| Learning rate | 0,0001 | Parameter-updates इत्येषां मूल-step size |
| Training | 500 epoch | स्रोते प्रतिवेदिता training-period संख्या |
एते parameters स्रोत-प्रयोगे प्रतिवेदितस्य model-configuration इत्यस्य अङ्गानि। अन्येषु data-sets इत्येषु श्रेष्ठ-results अनिवार्यतया एतैरेव parameters प्राप्यन्ते इति दावा नास्ति।
अध्ययनस्य विधिः परिणामाश्च
17. Design Science Research Methodology इत्यस्य षट् अवस्थाः
Design Science Research (DSR) समस्या-समाधानार्थं model, method अथवा system इत्यादीनां research-artifacts इत्येषां विकासं मूल्याङ्कनं च केन्द्रे स्थापयति। DSRM तु स्रोते प्रयुक्ता methodology, या एतदध्ययनं षडवस्थात्मक-प्रक्रियायां व्यवस्थितं करोति।
| अवस्था | अध्ययने कार्यम् |
|---|---|
| 1. समस्यायाः परिभाषा | Urban data systems मध्ये semantic fragmentation इत्यस्य निर्धारणम् |
| 2. उद्देश्यानां निर्धारणम् | पञ्च measurable design objectives इत्येषां निर्माणम् |
| 3. Design तथा development | UrbanKG architecture तथा ontological components इत्येषां निर्माणम् |
| 4. Demonstration | Open-data sources द्वारा proof-of-concept प्रयोगः |
| 5. Evaluation | Technical measurements तथा comparisons द्वारा objectives इत्येषां परीक्षणम् |
| 6. Scientific communication | Design principles, findings, open problems च प्रकाशनम् |
स्रोतस्य प्रथम-figure DSR इत्यस्य requirements-संबद्धं relevance-cycle, scientific knowledge-base-संबद्धं rigor-cycle, research-artifact इत्यस्य iterative development तथा evaluation-युक्तं design-cycle च परस्परं सम्बध्नाति।
18. पञ्च design objectives
| Objective | Definition | स्रोते प्रतिवेदितं evaluation |
|---|---|---|
| DO1 | न्यूनातिन्यूनं पञ्च विभिन्न-domains मध्ये semantic interoperability | 23/23 cross-domain query patterns सफलाः |
| DO2 | Ontology-first setup | पञ्च domains, न्यूनातिन्यूनं त्रिभिः standards सह aligned; %99,4 SHACL conformance |
| DO3 | Temporal awareness | 42.384 time-stamped observations अनुसृताः |
| DO4 | Federated management | पञ्च पृथक् graph sections तथा version-update tests |
| DO5 | Hybrid inference | OWL-RL द्वारा rule inference, RotatE द्वारा link prediction |
स्रोतः पञ्चापि objectives proof-of-concept evaluation मध्ये सिद्धानि इति वदति। अत्र “सिद्धम्” इति निष्कर्षः objectives परिभाषितस्य research-scope मध्ये परीक्षितानि इति सूचयति। वास्तविकं inter-institutional production deployment अथवा नगरव्यापी uninterrupted operation इत्यस्य सर्वाः conditions पूरिताः इति न सूचयति।
19. Data sources तथा sampling conditions
Proof-of-concept पञ्च urban data domains इत्येभ्यः sources उपयुङ्क्ते। अध्ययनं Thailand इत्यस्य urban-data-context आधारितम्, तथापि प्रत्येकं data-set एकस्मिन् नगरे, एकस्मिन् काले, समानया पद्धत्या च प्रत्यक्षं observed इति न माननीयम्।
| Domain | Source तथा scope | महत्त्वपूर्णा interpretation-limit |
|---|---|---|
| परिवहनम् | Bangkok GTFS; 34 bus routes, द्वे metro lines, 427 stops; March–May 2024 historical records | स्रोतः निर्दिष्टं transport network तथा sample-period |
| ऊर्जा | UCI Individual Household Electric Power Consumption data-set; स्रोते 2.075 meters, 1–14 May 2024 तथा 696.600 hourly aggregated measurements इति प्रतिवेदितम् | Data source, date, meter-scope च स्वयमेव validate करणीयम्; प्रत्यक्ष-Bangkok measurement इति न स्वीकरणीयम्। |
| पर्यावरणम् | Thailand air-quality data; 12 stations, PM2.5, PM10, NO2, CO, O3; 20.160 observations | स्रोते प्रतिवेदितः 1–14 May 2024 period |
| सार्वजनिकसुरक्षा | 2019–2022 road-accident records आधारेण demonstration-period कृते चयनिताः तथा patterns अनुसारं adapted 1.247 records | प्रत्यक्षं प्रमाणितः 2024 incident-log इति न व्याख्येयम्। |
| Emergency-response component | अष्टसु districts मध्ये वितरिताः अष्ट synthetic ambulance locations; 15-minute status updates | वास्तविक ambulance locations अथवा live dispatch system नास्ति। |
| नागरिकसेवाः | Traffy Fondue Bangkok platform तः 1–14 May 2024 मध्ये 1.089 service requests | स्रोते प्रयुक्तः sample-scope |
Spatial analysis कृते OpenStreetMap boundary data तथा सम्बद्धाः Thailand public-data sources उपयुक्ताः। स्रोते study-area 103,3 km² तथा अष्ट administrative subdistricts इति निर्दिष्टम्। प्रतिवेदिताः population densities केन्द्रीयभागेषु 22.400 persons/km², बाह्यभागेषु 1.850 persons/km² पर्यन्तं परिवर्तन्ते।
UCI energy data-set इत्यस्य स्वरूपं तथा स्रोते प्रतिवेदितौ date तथा meter-count इत्येतयोः मध्ये पृथक् validation अपेक्षिताः विषयाः सन्ति। अतः सम्पूर्णं energy-data तत्काले Bangkok मध्ये प्रत्यक्षं measured इति प्रस्तोतुं वैज्ञानिकतया सुरक्षितं नास्ति। स्रोतस्य values अपरिवर्तिताः रक्ष्यन्ते, एषा सीमा च स्पष्टा स्थाप्यते।
20. निर्मितस्य Knowledge Graph इत्यस्य परिमाणम्
| Measure | Value | Explanation |
|---|---|---|
| RDF triple | 287.456 | A-Box relational records |
| Distinct entity | 23.847 | Graph मध्ये पृथक् entity identities |
| Relation type | 127 | प्रतिवेदिताः object-property types |
| Time-stamped observation | 42.384 | 14-day demonstration period इत्यस्य graph-records |
| Time coverage | 1–14 May 2024 | मुख्य demonstration-period |
Raw-data sources मध्ये अधिकाः observations सन्ति तथा निर्मिते Knowledge Graph मध्ये time-stamped triples अथवा observation-count भिन्नः अस्ति इति स्वयमेव data-loss प्रमाणं नास्ति। किन्तु प्रत्येकः source-record काः mapping, aggregation, selection अवस्थाः अतीतः इति reproducibility कृते महत्त्वपूर्णम्। स्रोतः सर्वासां संख्यानां परस्परसम्बन्धं दर्शयन् विस्तृतं row-level audit न ददाति; अतः अनुपस्थिताः transformation-steps कल्पयित्वा पूरिताः न सन्ति।
21. चत्वारि cross-domain demonstration scenarios
21.1. Traffic incident इत्यस्य अन्य-infrastructures उपरि प्रभावः
8 May 2024, 08.15 समये (13,7563° K, 100,5018° D) स्थाने simulated traffic incident मूल्याङ्कितम्। Incident इत्यस्य 500 metre परिधौ सम्बद्धानि entities बहुभ्यः urban domains query कृतानि।
स्रोते energy-distribution node 347 metre, air-quality station 423 metre, चत्वारः transport stops 156–489 metre मध्ये प्रतिवेदिताः। Query runtime 298 ms आसीत्।
एषः परिणामः विभिन्न-infrastructure types एकस्मिन् common spatial query मध्ये अन्वेष्टुं शक्यन्ते इति दर्शयति। समीपस्थितिः energy अथवा air-quality system मध्ये वास्तविकः physical damage जातः इति स्वयमेव न प्रमाणयति।
21.2. परिवहन-पर्यावरण सम्बन्धस्य परीक्षणम्
D5 district मध्ये peak-transport-hours इत्यस्य mean PM2.5 value 41,7 µg/m³, citywide comparison-value तु 32,4 µg/m³ इति प्रतिवेदितम्। स्रोतः एतं भेदं approximately %29 इति व्यक्तयति।
तस्मिन् एव scenario मध्ये D5 कृते transport-stop density 0,9 stop/km², commercial centre कृते 2,1 stop/km² इति दत्तम्। अस्मिन् comparison मध्ये D5 density approximately %57 न्यूनम्। Query time 487 ms।
एतौ indicators पर्यावरणीय-conditions तथा transport-infrastructure समान-domain-context मध्ये संयुक्ततया परीक्षितुं शक्ये इति दर्शयतः। किन्तु data तः transport-stop deficit एव PM2.5-वृद्धेः प्रत्यक्षकारणम् इति निष्कर्षः न कर्तव्यः।
21.3. Emergency-response resources चयनम्
(13,7245° K, 100,4932° D) स्थाने medical-emergency scenario मध्ये, अष्ट-minute response-threshold पूरयन्तः त्रयः available ambulance units निर्दिष्टाः इति प्रतिवेदितम्। Query 412 ms आसीत्।
Ambulance locations synthetic इति विशेषतया रक्षणीयम्। परिणामः वास्तविकः Thailand emergency fleet घटनास्थले वास्तवतः अष्ट minutes मध्ये response कृतवान् इति न दर्शयति।
21.4. Digital twin data मध्ये freshness समस्या
द्वि-hour freshness-threshold अतिक्रान्ताः 34 entities प्राप्ताः: 18 smart meters, 12 transport vehicles, चत्वारः environmental sensors। स्रोते 34 records मध्ये 31 वास्तविक communication failures प्रतिनिधयन्ति इति manual validation कृतम्, यत् approximately %91 इति उक्तम्।
Query time 523 ms। एषः ratio चयनिते demonstration scenario मध्ये flagged records इत्येषां validation सम्बध्नाति; समग्र-systems इत्येषां सामान्य-failure-detection accuracy इति न प्रयोज्यः।
22. Query performance: domains-संख्या वर्धते चेत् किं भवति?
स्रोतः प्रत्येक-query-group कृते 100 executions आधारितानि timing measurements प्रतिवेदयति। Queries यावत् अधिकान् data-domains आच्छादयन्ति, runtime अपि वर्धते इति दृश्यते।
| Domains-संख्या | Mean ± reported dispersion | Median | 95 percentile | Maximum |
|---|---|---|---|---|
| 1 | 127 ± 18 | 121 | 156 | 203 |
| 2 | 298 ± 34 | 287 | 358 | 421 |
| 3 | 487 ± 67 | 468 | 612 | 734 |
| 4 | 1.247 ± 189 | 1.189 | 1.587 | 1.923 |
| 5 | 2.834 ± 412 | 2.712 | 3.489 | 4.201 |
Mean measured query-times इत्येषां सामान्य-central value दर्शयति; median क्रमबद्ध-measurements इत्येषां मध्य-value; 95 percentile लगभग %95 observations यत् time-limit अधः तिष्ठन्ति; maximum प्रतिवेदितं सर्वाधिकं time।
Table मध्ये ±-चिह्नं कस्य dispersion-measure प्रतिनिधयति इति स्रोतस्य Table 8 मध्ये स्पष्टतया labelled नास्ति। अतः values स्वयमेव standard deviation अथवा confidence interval इति न नामिताः।
एक-domain query-group इत्यस्य mean 127 ms, पञ्च-domain group इत्यस्य mean 2.834 ms। एषा वृद्धि अधिक-domains आच्छादयन्तीभ्यः queries कृते अतिरिक्तं computational load सूचयति; किन्तु query-pattern complexity अपि परिवर्तितुं शक्नोति, अतः एतत् स्वयमेव universal scaling law न स्थापयति।
23. Entity matching-सफलतायाः मापनम्
स्रोतः विभिन्न-records एकमेव entity प्रतिनिधयन्ति वा इति मूल्याङ्कयन्तं matching-component 500 entity pairs द्वारा परीक्षितवान्। Reference matches द्वाभ्यां domain experts द्वारा labelled, disagreements च मूल्याङ्किताः।
Experts मध्ये agreement कृते Cohen's kappa coefficient 0,89 इति प्रतिवेदितम्। Kappa observed categorical agreement इत्येतत् chance द्वारा अपेक्षितेन agreement सह तुलना करोति। उच्चः value reference labelling मध्ये दृढतरं agreement सूचयति; model इत्यस्य स्वस्य accuracy metric इति न मिश्रणीयम्।
| Metric | Result | मापितं गुणम् |
|---|---|---|
| Precision | 0,94 | Matched इति predicted pairs मध्ये correct-match proportion |
| Recall | 0,87 | वास्तविक-matches मध्ये कियत् भागः प्राप्तः |
| F1 | 0,90 | Precision तथा Recall मध्ये harmonic balance |
| Baseline string-similarity approach इत्यस्य F1 | 0,74 | Comparison method |
| Reported F1 difference | +0,16 | द्वयोः approaches इत्येषां reported F1-values मध्ये absolute difference |
23.1. Precision, Recall, F1 सूत्राणि
अधोलिखिताः standard evaluation equations स्रोतस्य reported metrics इत्येषां mathematical अर्थं स्पष्टयन्तः शिक्षणार्थाः displays सन्ति; नूतनाः research-results न सन्ति।
\[\mathrm{Precision}=\frac{TP}{TP+FP}\]
TP सम्यक् match इति निर्दिष्टान् pairs, FP match इति labelled किन्तु वास्तवतः अमिलितान् pairs दर्शयति।
\[\mathrm{Recall}=\frac{TP}{TP+FN}\]
FN वास्तवतः matched किन्तु model द्वारा miss कृतान् pairs दर्शयति।
\[\mathrm{F1}=\frac{2\times\mathrm{Precision}\times\mathrm{Recall}}{\mathrm{Precision}+\mathrm{Recall}}\]
F1 value Precision तथा Recall इत्येतयोः harmonic mean अस्ति। अतः द्वयोः metrics मध्ये केवलं एकस्य उच्चता परिणामं स्वयमेव न निर्धारयति।
स्रोते प्रतिवेदितौ 0,94 तथा 0,87 सूत्रे स्थाप्येताम् चेत् approximately 0,90 लभ्यते। Metrics dimensionless ratios सन्ति। स्रोतः true positive, false positive, false negative इत्येषां exact counts पूर्ण-confusion-matrix रूपेण न ददाति; अतः अत्र exact counts कल्पिताः न सन्ति।
24. Hybrid inference इत्यस्य quantitative results
| Area | Reported value | वैज्ञानिकार्थः |
|---|---|---|
| OWL-RL inference | 8.947 अतिरिक्तानि triples | Rules तः निष्पादिताः relations |
| OWL-RL runtime | 12,3 seconds | Source-environment मध्ये inference-time |
| Schema violation detection | 34/34 | निर्दिष्टाः violations सर्वे detected इति प्रतिवेदितम्। |
| RotatE Hits@1 | 0,38 | Correct link प्रथमस्थाने प्राप्तेः proportion |
| RotatE Hits@10 | 0,74 | Correct link प्रथमेषु दशसु candidates मध्ये प्राप्तेः proportion |
| RotatE MRR | 0,53 | Correct answer rank विचारयन् mean reciprocal-rank measure |
| RotatE training time | 3,2 hours | NVIDIA RTX 3080 उपरि प्रतिवेदितः time |
Hits@10 value 0,74 इत्यस्य अर्थः प्रयुक्ते link-prediction evaluation मध्ये correct link प्रथमेषु दशसु candidates मध्ये लभ्यते इति proportion %74 प्रतिवेदितम्। एषा संख्या graph इत्यस्य सर्वाः relations %74 accuracy सहितं validated इति न सूचयति।
MRR (Mean Reciprocal Rank) correct answer prediction-ranking मध्ये कुत्र स्थितम् इति मूल्याङ्कयति। एकः correct answer अस्ति इति standard display मध्ये:
\[\mathrm{MRR}=\frac{1}{N}\sum_{i=1}^{N}\frac{1}{r_i}\]
अत्र \(N\) evaluation queries इत्येषां संख्या, \(r_i\) तु सम्बन्धित-query मध्ये correct answer इत्यस्य rank। Rank 1 चेत् contribution 1, rank 2 चेत् contribution 1/2। MRR dimensionless अस्ति। स्रोतः ranking-distribution इत्यस्य सर्वविवरणानि न ददाति; अतः अधिक-विभक्तानि performance-values निर्मितानि न सन्ति।
स्रोत-evaluation मध्ये deductive component schema constraints आच्छादयति, embedding model तु data patterns आच्छादयति इति निर्दिष्टम्। एते द्वे क्षमते परस्परं प्रतिस्थापके न स्तः; hybrid approach इत्यस्य प्रयोजनं complementary tasks एकस्मिन् architecture मध्ये संयोजयितुम्।
नगरीय-सेवा-accessibility कथं गणयति?
UrbanKG-अध्ययनं नगरीय-सेवा-accessibility इत्येतत् transport infrastructure द्वारा निश्चितसेवानां access इत्यस्य spatial तथा temporal conditions संयोज्य मूल्याङ्कयति। अध्ययनमध्ये Transit-Based Accessibility (TBA), Service Coverage Index (SCI), Multimodal Accessibility Score (MMAS) च प्रयुक्ताः। प्रथमयोः द्वयोः measures कृते mathematical definitions दत्ताः; MMAS कृते weights तथा score-range प्रतिवेदिते, किन्तु सर्व-normalization-steps निर्धारयन् पूर्ण calculation-equation न दत्तम्। अतः त्रयः measures समान mathematical precision-स्तरे न मूल्याङ्कनीयाः।
25. Transit-Based Accessibility (TBA)
TBA कस्यचित् district-area मध्ये निश्चित-transport-time सीमा अन्तर्गतं accessible इति स्वीकृतस्य भागस्य कुल-district-area प्रति अनुपातः। स्रोते सूत्रम्:
\[\mathrm{TBA}(d,t)=\frac{\mathrm{Area}(R_{d,t})}{\mathrm{Area}(d)}\]
Variables: \(d\) administrative district, \(t\) transport-time threshold, \(R_{d,t}\) तस्य threshold अन्तर्गतं accessible service areas इत्येषां union प्रतिनिधयति। \(\mathrm{Area}\) area-calculation function अस्ति।
Numerator तथा denominator समान-area-unit द्वारा व्यक्तौ चेत् TBA dimensionless ratio अस्ति। Areas kilometre-square अथवा metre-square भवेताम्, द्वौ terms सुसङ्गततया converted चेत् ratio न परिवर्तते।
Mathematical दृष्ट्या accessible area वर्धते तथा total district area स्थिरं तिष्ठति चेत् TBA वर्धते। Accessible area district-boundaries अन्तः मूल्याङ्कितः, overlapping areas union-logic द्वारा एकवारं गणिताः चेत् ratio 0 तथा 1 मध्ये भवति।
स्रोतः 15-minute city context मध्ये \(t=15\) minutes threshold प्रयुङ्क्ते। किन्तु area accessible इति गणना तथा district इत्यस्य प्रत्येकः resident निश्चितसेवां वास्तवतः प्राप्तुं शक्नोति इति मापनं समानं नास्ति। Population इत्यस्य spatial distribution तथा वास्तविक travel-time अपि महत्त्वपूर्णौ।
26. Service Coverage Index (SCI)
SCI निश्चित-service-category मध्ये accessible service points इत्येषां सम्बन्धित-district population प्रति ratio दर्शयति। Source equation:
\[\mathrm{SCI}(d,s)=\frac{|\{p\in S_s:\mathrm{distance}(d,p)\leq\theta\}|}{\mathrm{Population}(d)}\]
Variables: \(d\) district, \(s\) service-type, \(S_s\) तस्य type इत्यस्य service-points set, \(p\) एकः service-point, \(\theta\) accessibility-threshold, \(\mathrm{Population}(d)\) district-population दर्शयति।
Numerator मध्ये set इत्यस्य absolute value निर्दिष्टं threshold-condition पूरयन्तः service-points इत्येषां संख्या। Denominator persons-संख्या। Raw-result person प्रति accessible service-point ratio; 10.000 persons प्रति service-count इति दर्शनीयम् चेत् उचितं scaling अपेक्षितम्।
स्रोते threshold कृते 15-minute public-transport access अथवा 800 metre walking उदाहरणानि दत्तानि। Time तथा distance भिन्न-dimensions इत्येषां quantities; समान-symbol द्वारा व्यक्तौ अपि प्रयोगे compared quantities इत्येषां units consistent भवितव्याः।
अपि च district तः service-point प्रति distance कथं defined इति boundary geometry, centroid अथवा वास्तविक transport-network अनुसारं भिन्न-results दातुं शक्नोति। Source formula सर्वान् एतान् implementation-details स्वयमेव न निर्धारयति।
27. Multimodal Accessibility Score (MMAS)
MMAS विभिन्नेषु essential-service domains मध्ये accessibility एकस्मिन् composite score मध्ये संयोजयितुं परिभाषितः। स्रोते result-scale 0 तथा 10 मध्ये दत्तः।
| Component | Weight |
|---|---|
| Hospitals | 0,30 |
| Emergency services | 0,30 |
| Public-administration services | 0,20 |
| Public facilities | 0,15 |
| Environmental quality; PM2.5 exposure इत्यस्य विपरीतदिशायां evaluation | 0,05 |
Weights इत्येषां sum 1 अस्ति। एतत् components इत्येषां relative importance निर्दिशति। किन्तु raw-components कथं normalized, 0–10 score मध्ये कथं transformed च इति स्रोते पूर्ण-mathematical equation द्वारा न दत्तम्।
अतः केवलं weights दृष्ट्वा अध्ययनस्य MMAS values पुनरुत्पादयन् algorithm निर्मितः इति न वक्तव्यम्। विशेषतः PM2.5-value विपरीतदिशायां score कर्तुं प्रयुक्तस्य transformation इत्यस्य विवरणं महत्त्वपूर्णम्।
28. पञ्च districts मध्ये accessibility-results
| District | Settlement type | Stops/km² | Hospital access | Public-service access | MMAS |
|---|---|---|---|---|---|
| 1 | Central commercial | 3,2 | %94 | %89 | 8,2 |
| 3 | Mixed residential | 2,1 | %76 | %71 | 7,1 |
| 5 | Suburban | 1,2 | %52 | %48 | 5,3 |
| 7 | Industrial | 0,8 | %34 | %29 | 3,6 |
| 8 | Peripheral area | 0,4 | %18 | %12 | 2,4 |
स्रोते District 1 सर्वाधिकं, District 8 न्यूनतमं MMAS value धारयति। 8,2/2,4 ratio approximately 3,4; शोधकर्तारः एतं भेदं accessibility inequality दृष्ट्या विचारयन्ति।
अध्ययने stop-density 1,0 stop/km² समीपे threshold-pattern प्राप्तः इति कथितम्। एषः परिणामः परीक्षितेषु districts इत्येषु pattern; अन्येषु नगरेषु validated universal infrastructure threshold इति न प्रस्तोतव्यः।
स्रोतः environmental quality तथा accessibility मध्ये Spearman \(\rho=-0,63\) correlation अपि प्रतिवेदयति। Spearman rho rankings आधारितस्य relation इत्यस्य direction तथा strength संक्षेपयति। Negative sign द्वयोः variables इत्येषां rankings विपरीतदिशायां सम्बद्धे इति दर्शयति; causality न सूचयति।
स्रोते low-access areas इत्येषां mean PM2.5 level %38 अधिकम् इत्यपि कथितम्। किन्तु अस्य comparison इत्यस्य raw subgroup values तथा uncertainty information पूर्णतया न दत्ते; अतः अतिरिक्तः statistical inference न कृतः।
29. दिनस्य समयानुसारं hospital accessibility
| Time period | Trips/hour | Mean time (minutes) | Hospital access |
|---|---|---|---|
| 06.00–09.00 | 18,4 | 11,2 | %71 |
| 09.00–16.00 | 12,6 | 14,8 | %62 |
| 16.00–20.00 | 16,8 | 12,3 | %67 |
| 20.00–06.00 | 3,1 | 28,7 | %28 |
सर्वाधिकः access morning peak-hours मध्ये %71, night period मध्ये %28 इति प्रतिवेदितः। स्रोते night accessibility न्यूनाभवति इति निर्दिष्टम्।
एते values स्रोतः चयनितेषु districts तथा proof-of-concept calculation-method सम्बन्धिनः। Hospital-access ratio ambulance घटनास्थलागमनसमयेन अथवा medical-service वास्तवतः प्राप्त्या समानं मापनं नास्ति।
Source Table 10 मध्ये night accessibility %28 पर्यन्तं पतति इति अध्ययन-scope अन्तर्गतं temporal differences दर्शयति। एषः परिणामः अन्येषु नगरेषु प्रत्यक्षतया transfer कर्तुं न शक्यते।
30. Source SPARQL queries इत्येषां वैज्ञानिककार्य
Article appendices मध्ये incident-impact, transport-environment relation, emergency-unit selection, data freshness, विभिन्न-graph sections मध्ये querying च कृते example SPARQL structures सन्ति।
एतेषां queries इत्येषां मूल-logic एकस्मिन् data-table मध्ये सीमित-filtering न, अपि तु विभिन्न-ontological types इत्येषां entities तेषां relations तथा locations द्वारा अन्वेष्टुम्।
उदाहरणतः hospital-access query administrative boundary, transport stop, hospital entities च संयोजयति। GeoSPARQL distance function द्वारा निर्दिष्टं distance-condition पूरयन्तः records अन्विष्यन्ते।
Source Figure 3 इत्यस्य hospital query 2.000 metre proximity-filter धारयति। एषः distance-filter वास्तविकस्य 15-minute public-transport journey इत्यस्य पूर्ण-calculation समानः नास्ति। Stops मध्ये connections, schedules, waiting time, road-network इत्यादयः वास्तविक travel-time calculation मध्ये पृथक् महत्त्वपूर्णाः।
| Stage | अन्वेषितं information | Purpose |
|---|---|---|
| 1 | Administrative district तथा geometry | Analysis-area निर्धारयितुम् |
| 2 | District अन्तर्गताः transport stops | Transport infrastructure सम्बद्धुम् |
| 3 | Hospital locations | Health-service points अन्वेष्टुम् |
| 4 | Geographic proximity filter | निर्दिष्टं distance-condition मूल्याङ्कयितुम् |
| 5 | Counting तथा grouping | District-based result निर्मातुम् |
एषा table source-code इत्यस्य exact reproduction नास्ति; code इत्यस्य वैज्ञानिककार्य व्याख्यायन् स्वतन्त्रः process-summary अस्ति। Source appendices मध्ये queries पूर्णतया executable इति validate कर्तुं application इत्यस्य वास्तविक-prefix definitions, data types, functions, endpoints च पृथक् परीक्षितव्याः।
31. अध्ययनात् उत्पन्नाः चत्वारः design principles
प्रथमः सिद्धान्तः — Ontology modularity तथा governance: नगर-knowledge परस्परस्वतन्त्रेषु किन्तु standards-संरेखितेषु domain ontologies मध्ये विभागः institutional data-responsibilities तथा semantic-integration आवश्यकताः संयुक्ततया विचारयितुं साहाय्यं करोति।
द्वितीयः सिद्धान्तः — Structural तथा observational information इत्येषां पृथक्करणम्: तुलनया स्थिराः structural relations तथा निरन्तरं परिवर्तमानाः sensor records पृथक् contexts मध्ये धारयितुं time तथा data-provenance queries अधिकं व्यवस्थिताः भवितुं शक्नुवन्ति।
तृतीयः सिद्धान्तः — प्रथमं knowledge integration: Advanced prediction तथा analytical functions अर्थपूर्णतया कार्यं कुर्वन्ति चेत् related data प्रथमं consistent रूपेण integrate करणीयम्।
चतुर्थः सिद्धान्तः — Ontology-first top-down setup: यत्र data-quality तथा auditability महत्त्वपूर्णे operational domains, तत्र classes, properties, constraints च example-data ग्रहणात् पूर्वं परिभाषितुं उपयोगी भवेत्।
एते principles स्रोत-लेखकैः design research तः निष्पादिताः transferable recommendations सन्ति। सर्वेषु urban systems मध्ये निरपेक्षतया श्रेष्ठः approach इति universal experimental result नास्ति।
32. अध्ययनमध्ये अवशिष्टाः षट् open technical problems
| Code | Open problem | आवश्यकः research direction |
|---|---|---|
| ORC1 | Real-time scaling | बृहत्तर-graphs मध्ये low-latency stream updates |
| ORC2 | Ontology evolution | Version तथा backward-compatible schema changes इत्येषां management |
| ORC3 | Privacy तथा governance | Data-subject स्तरस्य authorization तथा personal-data protection |
| ORC4 | Knowledge-representation learning | Heterogeneous तथा temporal urban graphs अनुकूलाः models |
| ORC5 | Explainable decision support | Learned results traceable reasons द्वारा व्याख्यातुम् |
| ORC6 | Distributed graph processing | बहु-बृहत्तर-graphs कुशलतया query कर्तुं समर्थाः infrastructures |
स्रोतः proof-of-concept मध्ये प्रति second 12.000 triples insertion capacity प्रतिवेदयन्, एतत् city-scale sub-second real-time requirements न पूरयति इति वदति।
Demonstration मध्ये द्वे ontology updates परीक्षिते। एतत् बृहत् निरन्तरं चाल्यमानस्य integrated urban Knowledge Graph इत्यस्य long-term schema changes समाधानं कृतम् इति न सूचयति।
स्रोतः 10 million triples अतिक्रमितुं शक्नुवन्तः metropolitan scenarios कृते distributed storage तथा query-processing आवश्यकताः अपि रेखाङ्कयति।
Federated data partitions इत्येषां पृथक्करणं personal-data स्तरस्य access restrictions अथवा GDPR compliance पूर्णतया implemented इति न प्रमाणयति। वस्तुतः स्रोतः एतत् भविष्ये विकसितव्यं open research topic इति मूल्याङ्कयति।
33. Findings कथं व्याख्येयाः?
UrbanKG-अध्ययनं विभिन्न urban domains common ontologies द्वारा query कर्तुं शक्यन्ते इति technical proof-of-concept प्रस्तुतयति। प्राप्ताः numerical results निश्चितेषु software, hardware, data, query conditions इत्येषु प्रतिवेदिताः।
सफलतया सञ्चालिताः queries semantic-integration क्षमता समर्थयन्ति। Structural-conformance results ontological validation इत्यस्य एकं भागं, inference-results तु rule-based तथा learning-based mechanisms संयुक्ततया प्रयोज्याः इति दर्शयन्ति।
Service-accessibility analyses विभिन्नान् urban indicators सम्बध्य regional differences परीक्षितुं शक्यन्ते इति दर्शयन्ति। किन्तु एते परिणामाः urban inequality इत्यस्य सर्वकारणानि व्याख्यातुं causal research इति न प्रस्तोतव्याः।
34. Source-internal inconsistencies तथा reproducibility limits
Data-source context: विभिन्नस्रोतैः सङ्गृहीतानि transport, energy, environment, public-safety records समानं geographic अथवा temporal origin धारयन्ति इति न माननीयम्। Synthetic ambulance locations स्पष्टतया demonstration-data सन्ति।
15-minute expression: स्रोतस्य accessibility-विभागे कस्यचित् वाक्ये 15-minute city concept व्याख्यायमानः 1-minute access इति expression दृश्यते। Formula तथा अनन्तर-analyses 15 minutes आधारेण प्रवर्तन्ते। एषः भेदः study-text इत्यस्य inconsistency इति रक्षणीयः।
Rule terminology: OWL-RL तथा SWRL rule-count कृते पृथग्विभागयोः समानः 23 इति संख्या प्रयुक्ता। प्रयोगे के rules वास्तवतः चालिताः इति निश्चितुं सम्बद्ध-code तथा rule-lists परीक्षितव्याः।
Accessibility calculation: SCI formula, table मध्ये दत्ताः access-percentages, example SPARQL distance-filter च भिन्नानि measurement functions धारयन्ति। एते कथं प्रत्येकपदे परस्परं transformed इति समानविस्तरेण प्रतिवेदितं नास्ति। अनुपस्थिताः transformation-equations कल्पिताः न सन्ति।
MMAS normalization: स्रोतः component-weights ददाति; किन्तु प्रत्येकः component 0–10 score मध्ये कथं transformed इति पूर्णतया निर्दिशन् equation न ददाति। अतः table-scores source-values रूपेण एव प्रस्तुताः, independently calculated इति न दर्शिताः।
Statistical uncertainty: केषुचित् evaluation-tables मध्ये mean परितः ± values इत्येषां exact statistical nature न निर्दिष्टम्। नूतनाः confidence intervals, significance tests, effect sizes च न उत्पादिताः।
35. अध्ययनस्य वैज्ञानिकयोगदानं मर्यादाश्च
| समर्थितः निष्कर्षः | अप्रमाणिता generalization |
|---|---|
| पञ्च urban domains सहितं proof-of-concept निर्मितम्। | सर्वेषु metropolitan systems मध्ये live-use कृते तत्परम् इति। |
| 287.456 RDF triples युक्तः graph प्रतिवेदितः। | Unlimited-size data समान-performance सहितं process कर्तुं शक्नोति इति। |
| 23 query patterns सफलतया सञ्चालिताः। | सर्वे सम्भाव्याः SPARQL queries समस्यारहिततया कार्यं कुर्वन्ति इति। |
| OWL-RL तथा RotatE components उपयुक्ताः। | सर्वाः learned relations वास्तविकाः logical रूपेण validated च इति। |
| चयनितेषु districts accessibility differences प्रतिवेदिताः। | भेदानां कारणानि causally प्रमाणितानि इति। |
| पञ्च पृथक् domains इत्येषां management proof-of-concept scope मध्ये मूल्याङ्कितम्। | सर्वस्तरे personal-data protection पूर्णम् इति। |
36. सामान्यः वैज्ञानिकनिष्कर्षः
Khantong, Savithi, Ahmad इत्येषां UrbanKG-अध्ययनं smart cities मध्ये integrated data management केवलं data collection तथा storage समस्या इति न पश्यति। अध्ययनस्य केन्द्रे विभिन्नसंस्थासु स्थितं urban knowledge common concepts, relations, time, geographic context च द्वारा प्रतिनिधयितुम् अस्ति।
शोधकर्तारः एतं approach चतुस्तरीय-architecture, पञ्च design objectives, ontology-first development, federated graph management, hybrid inference mechanisms च द्वारा संरचितवन्तः। Proof-of-concept तः प्राप्ताः results परिभाषिते technical scope मध्ये feasibility समर्थयन्ति।
अध्ययनस्य महत्त्वपूर्णं योगदानं केवलं निश्चिताः queries कार्यं कुर्वन्ति इति प्रदर्शनं न; भविष्ये निर्मातुं शक्येभ्यः urban Knowledge Graphs कृते design principles तथा open research questions निर्माणम् अपि।
तथापि performance, data provenance, geographic transferability, large-scale real-time operation, data privacy, measurement definitions च विषये validation-आवश्यकताः अवशिष्टाः।
अतः UrbanKG सर्वाः smart-city समस्याः समाधानं कृतवान् पूर्णः universal system इति न, अपि तु urban domains मध्ये semantic interoperability तकनीकीरूपेण अन्वेषयन्, मूल्याङ्कितः, विकासाय खुल्लः design-research इति अवगन्तव्यः।
स्रोतः तथा विधि-विषयक टिप्पणी
मूल academic publication information
मूलशीर्षकम्: Knowledge Graphs for Integrated Urban Data Management in Smart Cities: A Framework for Semantic Interoperability Across Urban Domains.
लेखकाः: Sommai Khantong; Charuay Savithi; Mohammad Nazir Ahmad.
Corresponding author: Sommai Khantong.
प्रथमसंस्था: Digital Business and Information Systems Department, Mahasarakham Business School, Mahasarakham University, Thailand.
द्वितीयसंस्था: Smart City Management and Digital Innovation Department, Mahasarakham Business School, Mahasarakham University, Thailand.
तृतीयसंस्था: Institute of Visual Informatics, Universiti Kebangsaan, Malaysia.
Journal: Urban Science.
Publisher: MDPI, Basel, Switzerland.
Publication record: 2026, volume 10, issue 6, article 308.
Submitted: 14 March 2026.
Revised: 19 May 2026.
Accepted: 27 May 2026.
Published: 1 June 2026.
DOI: 10.3390/urbansci10060308.
Official publication: https://www.mdpi.com/2413-8851/10/6/308.
License: Creative Commons Attribution 4.0 International (CC BY 4.0). License conditions.
Source type: Peer-reviewed academic research; design-science method तथा technical proof-of-concept evaluation।
Funding: Mahasarakham Business School, Mahasarakham University, Thailand.
Conflict of interest: लेखकाः conflict of interest नास्ति इति घोषितवन्तः।
Software तथा data access: स्रोत-अध्ययनं application UrbanKG GitHub repository मध्ये MIT license अधीनं उपलब्धम् इति वदति। Repository इत्यस्य current code-content तथा operational status अस्मिन् Verianla लेखे स्वतन्त्रतया चालितं validated च नास्ति।
शोधकर्तृ-योगदानानि
स्रोते conceptualization Sommai Khantong तथा Charuay Savithi इत्येताभ्याम्; methodology Sommai Khantong तथा Mohammad Nazir Ahmad इत्येताभ्याम्; software, formal analysis, investigation, data curation च Sommai Khantong इत्यस्मै आरोपितानि। Validation Sommai Khantong तथा Charuay Savithi इत्येताभ्याम् कृतम्। Original draft Sommai Khantong द्वारा निर्मितः; review तथा editing मध्ये Charuay Savithi तथा Mohammad Nazir Ahmad योगदानं दत्तवन्तौ। Visualization, project administration, funding acquisition Sommai Khantong इत्यस्य; supervision Charuay Savithi तथा Mohammad Nazir Ahmad इत्येतयोः योगदानरूपेण निर्दिष्टम्।
Leave a comment
Your email address will not be published. Required fields are marked *