


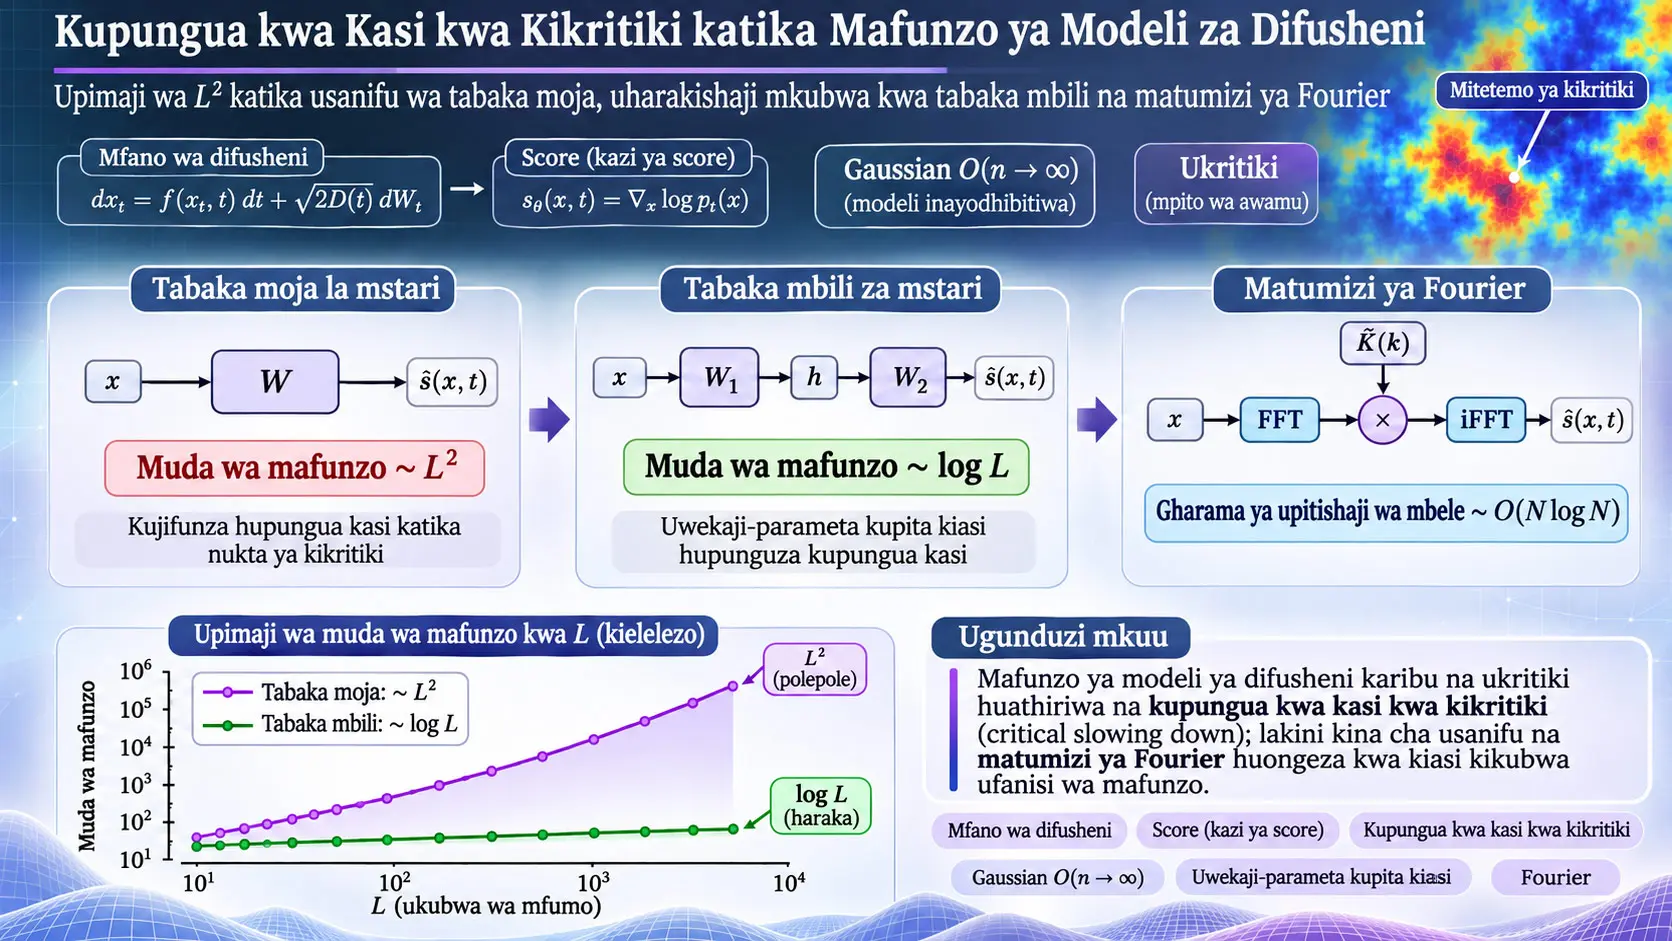
Mfano wa difusheni (diffusion model), ni kundi la modeli zalishi zinazobadilisha kwanza sampuli zilizochukuliwa kutoka usambazaji lengwa wa data kuwa kelele kwa namna inayodhibitiwa, kisha kwa msaada wa score iliyojifunzwa husogea kurudi nyuma kutoka usambazaji huo wenye kelele ili kuzalisha sampuli mpya. Utafiti huu unachunguza ikiwa modeli za difusheni kweli zinaweza kushinda kupungua kwa kasi kwa kikritiki unaotokea mfumo wa kimwili unapokaribia nukta kritiki, kwa kutumia modeli ya nadharia ya uga wa takwimu ya Gaussian \(O(n\rightarrow\infty)\) inayoweza kudhibitiwa kiuchanganuzi. Kwa kuwa watafiti wanajua score function halisi kiuchanganuzi katika mfumo huu, wanaweza kutatua moja kwa moja athari ya usanifu wa mtandao kwenye mienendo ya ujifunzaji bila kutokuwa na uhakika kuhusu target function.
Matokeo ya kwanza ya msingi ya utafiti yanashangaza: kutumia mtandao wenye safu moja ya linear convolution unaoweza kuwakilisha kikamilifu exact score katika kiwango cha kifunksia hakuondoi kupungua kwa kasi kwa kikritiki. Katika mafunzo kwa gradient descent, wakati bainifu wa mafunzo hupimwa dhidi ya ukubwa wa mstari wa mfumo \(L\) na kukua takriban kama \(L^2\) katika nukta kritiki. Huu ni ulinganishaji sawa wa ukubwa wa mfumo na kupungua kwa kasi kwa kikritiki wa \(z=2\) katika mienendo ya kawaida ya local Langevin ya modeli hiyo hiyo ya Gaussian. Hitilafu ya mafunzo kisha huhamishwa kwenye hatua ya denoising/generation na pia hufanya urejeshaji sahihi wa covariance ya uga zinazozalishwa kuwa mgumu kwa ulinganishaji huo huo bainifu.
Matokeo ya pili ya msingi ni kwamba kuongeza safu moja tu ya linear kunaweza kubadilisha mienendo kwa namna ya kimsingi. Safu zote mbili ni linear bila activation function na si lazima ziwakilishe darasa la function lenye nguvu zaidi kuliko mtandao wa safu moja; hata hivyo, chini ya hali zinazofaa za mwanzo, over-parameterization hufanya muda wa mafunzo ya gradient descent dhidi ya ukubwa wa mfumo kubadilika kutoka scaling ya \(L^2\) hadi takriban \(\log L\). Katika modeli inayodhibitiwa ya utafiti, muundo wa safu mbili hivyo huondoa upungufu wa kasi wa mafunzo wa kikritiki.
Hata hivyo, kuboresha muda wa mafunzo pekee hakutoshi. Utekelezaji wa moja kwa moja katika nafasi halisi wa convolution kernel inayofunika mfumo mzima unahitaji shughuli \(O(N^2)\) kwa forward pass moja. Watafiti hutumia sifa kwamba convolution hugeuka kuwa multiplication katika nafasi ya Fourier na kutekeleza hesabu ya score kama FFT → multiplication katika nafasi ya Fourier → inverse FFT. Kwa njia hii, jumla ya ugumu wa forward pass hupunguzwa hadi \(O(N\log N)\). Hapa \(N=(L/a)^d\), \(d\) ni idadi ya vipimo vya anga na \(a\) ni nafasi ya lattice.
Kikomo cha tafsiri ya matokeo haya ni muhimu. Utafiti haufundishi picha halisi, video, au mtandao mkubwa wa jumla wa difusheni. Mfumo unaochunguzwa ni modeli ya Gaussian \(O(n\rightarrow\infty)\); score ni linear, usanifu ni safu za linear convolution, na suluhisho la kiuchanganuzi linajulikana. Kwa hiyo, matokeo ya \(L^2\rightarrow\log L\) hayawezi kutafsiriwa kama sheria ya jumla ya mafunzo kwa modeli zote za kisasa za difusheni. Thamani ya utafiti ni kuweza kuonyesha kiuchanganuzi uhusiano kati ya kupungua kwa kasi kwa kikritiki na parametrization ya mtandao katika modeli ya kimwili inayoweza kudhibitiwa kikamilifu.
Kupungua kwa Kasi kwa Kikritiki ni Nini na Kwa Nini ni Muhimu katika Utafiti Huu?
Upungufu wa kasi wa kikritiki ni hali ambapo, mfumo wa kimwili unapokaribia nukta kritiki ya mpito wa awamu, mienendo ya local sampling huonyesha decorrelation inayozidi kuwa polepole kwa sababu ya kuibuka kwa correlation za masafa marefu. Katika modeli ya \(O(n\rightarrow\infty)\) inayochunguzwa, wakati bainifu wa relaxation wa local Langevin dynamics ya kawaida hupimwa kama \(\tau\sim L^2\) katika nukta kritiki; swali kuu la utafiti ni ikiwa diffusion sampler iliyojifunzwa hurithi bottleneck hiyo hiyo.
Modeli ya awali ya kimwili: nadharia ya uga ya \(O(n)\)
Mfumo mkuu wa kimwili wa utafiti umefafanuliwa kwa uga wenye vipengele \(n\), \(\vec{\phi}(\vec{x})\), ndani ya modeli ya \(O(n)\). Action inayotolewa na chanzo katika Equation (1):
\[ S(\vec{\phi}) = \frac{1}{2} \int_V d^d\vec{x} \left[ \sum_{\nu=1}^{d}\sum_{a=1}^{n} (\partial_\nu\phi_a)^2 + m^2\sum_{a=1}^{n}\phi_a^2 + \frac{g}{2n} \left( \sum_{a=1}^{n}\phi_a^2 \right)^2 \right]. \tag{1} \]
Hapa \(\vec{x}\) inaonyesha nafasi katika anga ya vipimo \(d\); \(a\), ni kipi kati ya vipengele \(n\) vya uga kinachozingatiwa; \(\partial_\nu\phi_a\), mabadiliko ya anga ya uga; \(m^2\), parameter ya mass inayodhibiti tabia ya modeli; na \(g>0\), nguvu ya quartic interaction. Katika muktadha wa utafiti, \(m\) hufanya kazi kama parameter ya udhibiti inayofanana na temperature.
Kwa nini tatizo huwa rahisi katika kikomo cha large-\(n\)?
Katika kikomo cha \(n\rightarrow\infty\), modeli huwa Gaussian kwa ufanisi:
\[ S_\Lambda(\vec{\phi}) = \frac{1}{2} \int_V d^d\vec{x} \left[ \sum_{\nu=1}^{d}\sum_{a=1}^{n} (\partial_\nu\phi_a)^2 + (m^2+\Lambda g) \sum_{a=1}^{n}\phi_a^2 \right]. \tag{2} \]
\(\Lambda\) huamuliwa kwa kujitosheleza kupitia:
\[ \Lambda = \frac{1}{(2\pi)^d} \int d^d\vec{k}\, \frac{1}{ \vec{k}\cdot\vec{k}+m^2+\Lambda g }. \tag{3} \]
equation hii.
Hivyo:
\[ m_{\rm eff}^2=m^2+\Lambda g \]
effective mass huwa parameter kuu inayodhibiti tabia ya modeli. Nukta kritiki hufafanuliwa kama:
\[ m_{\rm eff}=0 \]
.
Urahisishaji huu ndio faida kuu ya utafiti. Kwa sababu correlations, score na diffusion dynamics zinaweza kuhesabiwa kiuchanganuzi kwa usambazaji wa Gaussian, watafiti wanajua kwa usahihi jibu la swali “score halisi inayolengwa na mtandao ni ipi?” Hivyo, kupungua kwa kasi kunakoonekana katika mafunzo kunaweza kuchunguzwa moja kwa moja kutoka kwenye muundo wa optimization na correlation badala ya ugumu wa target function isiyojulikana.
Usambazaji lengwa wa Boltzmann–Gibbs
Lengo ni kuzalisha field configurations kutoka usambazaji ufuatao:
\[ P(\vec{\phi}) = \frac{1}{Z} e^{-S_\Lambda(\vec{\phi})}, \tag{4} \]
hapa:
\[ Z = \int D\vec{\phi}\, e^{-S_\Lambda(\vec{\phi})} \]
ni partition function.
Kipimo cha kupungua kwa kasi kwa kikritiki wa kimwili
Ili kuona local sampler inafanya decorrelation kwa kasi gani, utafiti hutumia autocorrelation function:
\[ C(\vec{x},\vec{x};T) = \frac{1}{V} \int_V d^d x\, \left\langle \phi(\vec{x},T)\phi(\vec{x},0) \right\rangle . \tag{5} \]
\(T\) ni muda wa kimwili wa sampling/simulation. Mfumo unapokaribia nukta kritiki, decay ya correlation hupungua kasi. Kwa mfumo wa hypercubic wenye ukubwa wa mstari \(L\), kwa local dynamics ya kawaida:
\[ \tau\sim L^z, \qquad z=2. \]
Kwa hiyo:
\[ \tau\sim L^2. \]
Tabia hii ya \(L^2\) baadaye inalinganishwa moja kwa moja na scaling ya mafunzo ya score ya safu moja.
Kikomo muhimu kuhusu nukta kritiki katika vipimo vya chini
Chanzo kinaeleza kuwa kwa \(d\leq2\), hakuna finite-temperature phase transition kwa maana ya kawaida katika thamani finiti ya \(m^2\). Kwa mfano, kwa \(d=1\):
\[ m_{\rm eff}^2 = m^2 + \frac{g}{2} \frac{1}{\sqrt{m_{\rm eff}^2}}. \tag{6} \]
Wakati \(m_{\rm eff}\rightarrow0\), \(m^2\) lazima idiverge kuelekea upande hasi. Katika \(d=2\) pia tabia ya logarithmic hujitokeza baada ya UV cutoff. Kwa hiyo, katika uchanganuzi unaofuata utafiti hutumia moja kwa moja nadharia ya Gaussian na \(m_{\rm eff}\) kama control parameter, na kuchunguza criticality kama \(m_{\rm eff}\rightarrow0\).
Score Function katika Diffusion Model ni Nini?
Score function ni logarithmic derivative ya probability distribution katika diffusion-time \(t\) fulani kwa kuzingatia field variables; kwa maneno mengine, ni vector field inayobainisha jinsi modeli inapaswa kurekebisha configuration ya sasa yenye kelele kuelekea mwelekeo wenye probability kubwa zaidi. Katika mfumo wa Gaussian wa utafiti huu, score ni linear na inaweza kuhesabiwa kwa usahihi, hivyo mtandao uliojifunzwa unaweza kulinganishwa moja kwa moja na score halisi.
Forward diffusion: kuongeza kelele kwenye data
Configuration ya mwanzo huchukuliwa kutoka usambazaji lengwa:
\[ \vec{\phi}(\vec{x},0) \sim P^\ast(\vec{\phi}). \tag{7} \]
Kisha huwekewa kelele kwa mchakato wa Ornstein–Uhlenbeck:
\[ \frac{\partial\vec{\phi}(\vec{x},t)}{\partial t} = -\vec{\phi}(\vec{x},t) + \vec{\zeta}(\vec{x},t). \tag{8} \]
\(\vec{\zeta}\) ni white Gaussian noise, na covariance yake ni:
\[ \left\langle \zeta(\vec{x},t) \zeta(\vec{x}',t') \right\rangle = 2\, \delta^{(d)}(\vec{x}-\vec{x}') \delta(t-t') \]
.
Reverse diffusion: kurudi kutoka kelele hadi usambazaji lengwa
Chanzo hutumia deterministic probability-flow ODE katika uchanganuzi mkuu:
\[ -\partial_t\vec{\phi}(\vec{x},t) = \vec{\phi}(\vec{x},t) + \vec{\mathcal F}_t(\vec{\phi}(\vec{x},t)). \tag{10} \]
Score:
\[ \vec{\mathcal F}_t(\vec{\phi}) = \frac{ \delta\log P_t(\vec{\phi}) }{ \delta\vec{\phi}(\vec{x}) }. \tag{11} \]
Hapa \(P_t\) ni usambazaji unaotokea wakati wa forward diffusion katika muda \(t\). Ikiwa score ni exact, reverse ODE kwa hali bora hurudisha usambazaji wenye kelele kwenye usambazaji lengwa.
Hasara ya score matching
Kama exact score ingejulikana, training loss ingeandikwa:
\[ \mathcal L_t(\vec{F}_t) = \frac{1}{2} \int D\vec{\phi}\, P_t(\vec{\phi}) \left\| \vec{F}_t(\vec{\phi}) - \vec{\mathcal F}_t(\vec{\phi}) \right\|^2. \tag{12} \]
kwa namna hii. Hapa \(\vec{F}_t\) ni score inayojifunzwa, na \(\vec{\mathcal F}_t\) ni exact score.
Kwa kuwa exact score haijulikani katika matatizo mengi ya vitendo, chanzo pia hutoa fomu sawia ya denoising score-matching:
\[ \widehat{\mathcal L}_t(\vec F_t) = \frac{1}{2} \mathbb E_{\vec\phi_0\sim P_0} \int D\vec\phi\, P_t(\vec\phi|\vec\phi_0) \left\| \vec F_t(\vec\phi) + \frac{ \vec\phi-e^{-t}\vec\phi_0 }{ \Delta_t } \right\|^2, \tag{13} \]
hapa:
\[ \Delta_t=1-e^{-2t}. \]
Kwa kuwa exact score inajulikana kiuchanganuzi katika utafiti huu, Equation (12) hutumika katika suluhisho la kinadharia la training dynamics.
Usambazaji baada ya forward diffusion
Kwa component moja ya uga, usambazaji katika Fourier space ni:
\[ P_t(\widetilde\phi) \propto \exp \left\{ -\frac{(2\pi)^d}{2} \int d^d\vec{k}\, \left[ \frac{ k^2+m_{\rm eff}^2 }{ \Delta_t(k^2+m_{\rm eff}^2)+e^{-2t} } \right] \widetilde\phi(\vec{k}) \widetilde\phi(-\vec{k}) \right\}. \tag{14} \]
Usemi huu unaonyesha kwamba muundo wa Gaussian huhifadhiwa katika muda wote wa diffusion.
Kwa nini exact score ni linear convolution?
Exact score:
\[ \mathcal F_t(\phi) = -\int d^d\vec y\, \mathcal S_t(\vec x,\vec y)\phi(\vec y). \tag{15} \]
iko katika fomu hii. Hivyo, linear operator hutumika kwenye uga wenyewe.
Score kernel:
\[ \begin{aligned} \mathcal S_t(\vec x,\vec y) =& \int\frac{d^d\vec k}{(2\pi)^d} \frac{ k^2+m_{\rm eff}^2 }{ \Delta_t(k^2+m_{\rm eff}^2)+e^{-2t} } e^{i\vec k\cdot(\vec y-\vec x)} \\ =& \frac{1}{\Delta_t} \delta^{(d)}(\vec y-\vec x) - \frac{e^{-2t}}{(2\pi)^{d/2}\Delta_t^2} \left( \frac{M_t}{|\vec y-\vec x|} \right)^{d/2-1} K_{d/2-1} \left( M_t|\vec y-\vec x| \right), \end{aligned} \tag{16} \]
hapa:
\[ M_t^2 = m_{\rm eff}^2 + \frac{e^{-2t}}{\Delta_t} \]
na \(K_\nu\) ni modified Bessel function ya aina ya pili.
Score kernel ina sehemu mbili: sehemu halisi ya local inayotokana na delta function na tail inayosambaa angani. Katika umbali mfupi tail hii huonyesha tabia ya power law inayofanana na Yukawa, huku katika umbali mrefu ikikandamizwa exponentially. Kuelekea criticality, \(m_{\rm eff}\rightarrow0\), muundo wa masafa marefu huwa muhimu.
Katika Fourier space, kernel huwa diagonal kwa sababu ya translation invariance:
\[ \widetilde{\mathcal S}_t(\vec k) = \frac{ k^2+m_{\rm eff}^2 }{ \Delta_t(k^2+m_{\rm eff}^2)+e^{-2t} }. \tag{17} \]
Safu moja inaweza kuwakilisha exact score; kwa nini bado kuna tatizo?
Approximate score ya safu moja huandikwa katika fomu hiyo hiyo:
\[ F_t(\phi) = -\int d^d\vec y\, S_t(\vec x,\vec y) \phi(\vec y). \tag{18} \]
Hapa model capacity si tatizo kuu: \(S_t\) inapofikia thamani inayofaa, mtandao unaweza kuwakilisha exact \(\mathcal S_t\). Bottleneck ya kikritiki iliyopatikana na utafiti ni zaidi kuhusu kasi ambayo parameters hujifunza katika Fourier modes tofauti.
Equation ya gradient-flow
Population loss kwa kernel:
\[ \mathcal L_t = \frac{1}{2} \int D\phi\,P_t(\phi) \left\| \int d^d\vec y\, [S_t(\vec x,\vec y)-\mathcal S_t(\vec x,\vec y)] \phi(\vec y) \right\|^2. \tag{19} \]
Gradient flow:
\[ \frac{ dS_t(\vec x',\vec y') }{ d\bar t } = -\eta \frac{ \delta\mathcal L_t }{ \delta S_t(\vec x',\vec y') }, \tag{20} \]
hapa \(\bar t\) ni training time, huku \(t\) ni diffusion/noising time. Vigezo hivi viwili vya muda ni tofauti.
Fomu ya operator:
\[ \frac{dS_t}{d\bar t} = -\eta (S_t-\mathcal S_t)C_t, \tag{21} \]
na covariance:
\[ C_t(\vec x,\vec y) = \langle \phi(\vec x)\phi(\vec y) \rangle_t. \tag{22} \]
Kwa \(S_t(0)=0\) ambayo haijafundishwa mwanzoni, suluhisho ni:
\[ S_t(\bar t) = \mathcal S_t \left( 1-e^{-\eta C_t\bar t} \right). \tag{23} \]
Equation hii ndio chanzo cha kihisabati cha matokeo ya kikritiki: eigenvalues tofauti za covariance hujifunzwa kwa kasi tofauti.
Kwa Nini Training Time katika Mtandao wa Safu Moja Hupimwa kama \(L^2\)?
Katika mtandao wa safu moja, muda wa kujifunza wa kila Fourier mode hutegemea covariance eigenvalue ya mode hiyo; katika nukta kritiki, momentum ndogo zaidi isiyo sifuri ni \(k_{\min}=2\pi/L\), hivyo learning rate thabiti ya gradient descent hubanwa hadi takriban scale ya \(k_{\min}^2\propto L^{-2}\), na effective training time inayohitajika kujifunza modes za \(k=O(1)\) hukua kama \(L^2\).
Covariance ya Fourier mode
Chanzo:
\[ \langle \widetilde\phi(\vec k) \widetilde\phi(\vec q) \rangle_t = \frac{ \delta^{(d)}(\vec k+\vec q) }{ (2\pi)^d } \widetilde C_t(\vec k), \tag{24} \]
na:
\[ \widetilde C_t(\vec k) = \frac{ \Delta_t(k^2+m_{\rm eff}^2)+e^{-2t} }{ k^2+m_{\rm eff}^2 }. \tag{25} \]
hupata.
Time scale inayolingana:
\[ \tau_t(\vec k) = \frac{ k^2+m_{\rm eff}^2 }{ \Delta_t(k^2+m_{\rm eff}^2)+e^{-2t} }. \tag{26} \]
Katika kikomo cha noising-time kirefu:
\[ \lim_{t\rightarrow\infty} \tau_t(\vec k) = 1. \tag{27} \]
Yaani training times za modes zote hukaribiana.
Katika kikomo cha noising-time kifupi:
\[ \lim_{t\rightarrow0} \tau_t(\vec k) = k^2+m_{\rm eff}^2. \tag{28} \]
Usemi huu una muundo sawa na time scale ya kila mode katika Langevin dynamics.
Time scale ndogo zaidi:
\[ \tau_{\min} = k_{\min}^2+m_{\rm eff}^2. \tag{29} \]
Ili gradient descent ibaki stable, learning rate hufungwa na mode ya haraka zaidi. Chanzo hutoa minimax-optimal learning rate kama:
\[ \eta_{\rm opt} = \frac{ 2 }{ \tau_{\min}^{-1} + \tau_{\max}^{-1} } \tag{30} \]
na kueleza kuwa maximum stable learning rate ina scaling hiyo hiyo.
Metric ya hitilafu ya score-kernel
\[ \varepsilon_S = \frac{ \sum_{x,y} |S(x,y)-\mathcal S(x,y)| }{ \sum_{x,y} |\mathcal S(x,y)| }. \tag{31} \]
Hii ni normalized absolute error kati ya kernel iliyojifunzwa na exact kernel.
Effective training time
Kwa noising time ndogo na katika scale ya maximum learning rate:
\[ \tau^{\rm eff}(\vec k) = \frac{ \tau(\vec k) }{ 2\tau_{\min} } = \frac{ m_{\rm eff}^2+k^2 }{ 2(m_{\rm eff}^2+k_{\min}^2) }. \tag{32} \]
Kwa kuwa zero mode inaweza kujifunzwa kando katika mfumo finiti, momentum ndogo zaidi isiyo sifuri ni:
\[ k_{\min} = \frac{2\pi}{L} \]
na:
\[ \tau_{\min} = \left( \frac{2\pi}{L} \right)^2 + m_{\rm eff}^2. \tag{33} \]
Katika criticality ambapo \(m_{\rm eff}=0\), kwa \(k=O(1)\):
\[ \tau^{\rm eff} \sim L^2. \]
Matokeo ni kwamba hata mtandao wa safu moja unaowakilisha exact score hurithi scaling ya \(L^2\) ya standard local sampling katika nukta kritiki.
Je, optimizer nyingine hutatua tatizo?
Chanzo kinaripoti kwamba optimally tuned momentum inaweza kuboresha critical scaling kutoka \(L^2\) hadi takriban \(L\), lakini haiwezi kuondoa kabisa utegemezi unaodiverge wa system size. Katika real-space optimization, Adagrad na Adam hazikufikia exact score kernel katika tatizo hili rahisi la convex. Kwa hiyo, hata kama coefficients maalumu za gradient descent zinaweza kubadilika, critical training slowdown haiondoki kiotomatiki kwa kubadilisha optimizer pekee.
Hitilafu ya mafunzo huhamishwaje kwenye generation?
Reverse-diffusion equation ya Fourier mode kwa exact score:
\[ \partial_t \widetilde\phi^\ast(\vec k,t) = - \widetilde\phi^\ast(\vec k,t) \left[ 1- \frac{ k^2+m_{\rm eff}^2 }{ \Delta_t(k^2+m_{\rm eff}^2)+e^{-2t} } \right]. \tag{34} \]
Exact solution yake:
\[ \widetilde\phi^\ast(\vec k,t;t_{\max}) = \frac{ \sqrt{ e^{-2t}+ \Delta_t(k^2+m_{\rm eff}^2) } }{ \sqrt{ e^{-2t_{\max}}+ \Delta_{t_{\max}} (k^2+m_{\rm eff}^2) } } \, \widetilde\phi^\ast(\vec k,t_{\max}). \tag{35} \]
Katika kikomo cha \(t_{\max}\rightarrow\infty\):
\[ \widetilde\phi^\ast(\vec k,t;\infty) = \frac{ \sqrt{ e^{-2t}+ \Delta_t(k^2+m_{\rm eff}^2) } }{ \sqrt{k^2+m_{\rm eff}^2} } \, \widetilde\phi^\ast(\vec k,\infty). \tag{36} \]
Suluhisho hili huzalisha tena exact \(P_t\) distribution.
Approximate score ya finite training time inapotumiwa, Equation (37) huingiza sehemu isiyojifunzwa ya score kupitia factor:
\[ 1- \exp \left[ -\frac{\eta\bar t}{\tau_t(\vec k)} \right] \]
kwenye reverse dynamics. Katika Equation (38), chanzo hutoa exact closed-form solution ya equation hii inayojumuisha exponential integral \(\operatorname{Ei}\). Exponential integral:
\[ \operatorname{Ei}(x) = - \int_{-x}^{\infty} \frac{e^{-u}}{u}\,du. \tag{39} \]
hufafanuliwa hivyo. Ujumbe wa kimwili wa closed-form solution hii ndefu ni kwamba kutofundishwa vya kutosha kwa score katika modes fulani hubadilisha kimfumo variance ya modes hizo wakati wa reverse diffusion.
Generation error hupimwaje?
Kwa kuwa mean ya distribution ni sifuri katika Gaussian model, distribution inayozalishwa inaelezewa kikamilifu na covariance matrix. Chanzo hutumia normalized Frobenius error:
\[ \varepsilon_C(\bar t,L) = \frac{ \left\| C_{\rm gen}(\bar t,L) - C^\ast(L) \right\|_F }{ \left\| C^\ast(L) \right\|_F }. \tag{42} \]
\(C^\ast\) ni target covariance, \(C_{\rm gen}\) ni covariance ya uga zinazozalishwa, na \(\|\cdot\|_F\) ni Frobenius norm.
Tabia kuu ya relative error katika criticality:
\[ \sim \exp \left( -\frac{ \bar t\,t_{\max} }{ L^2 } \right) \]
iko katika fomu hii. Kwa hiyo, critical slowdown ya \(L^2\) katika mafunzo pia hupunguza moja kwa moja kasi ya kuzalisha sampuli zenye covariance sahihi.
Safu ya Pili ya Linear Inapunguzaje Critical Slowdown?
Safu ya pili ya linear huunda zaidi representation iliyofactorize na over-parameterized ya score kernel kuliko kuongeza darasa jipya la nonlinear functions; parametrization hii hurekebisha kwa ufanisi gradient-descent directions na kubadilisha tofauti ya learning time kati ya Fourier modes kutoka linear covariance dependence ya hali ya safu moja hadi logarithmic dependence.
Modeli ya score ya safu mbili
Translation-invariant kernels mbili hutumiwa:
\[ F_t^{\rm ov}(\phi) = - \int d^d\vec z\,d^d\vec y\, S_t^{(2)}(\vec x,\vec z) S_t^{(1)}(\vec z,\vec y) \phi(\vec y). \tag{46} \]
Gradient-flow equations:
\[ \frac{dS_t^{(1)}}{d\bar t} = -\eta \left(S_t^{(2)}\right)^\dagger \left( S_t^{(2)}S_t^{(1)}C_t-I \right), \tag{47} \]
\[ \frac{dS_t^{(2)}}{d\bar t} = -\eta \left( S_t^{(2)}S_t^{(1)}C_t-I \right) \left(S_t^{(1)}\right)^\dagger. \tag{48} \]
Katika Fourier space kila mode huwa huru:
\[ \frac{ d\widetilde S_t^{(1)}(\vec k) }{ d\bar t } = -\eta \widetilde S_t^{(2)}(\vec k) \left[ \widetilde S_t^{(2)}(\vec k) \widetilde S_t^{(1)}(\vec k) \widetilde C_t(\vec k) -1 \right], \tag{49} \]
\[ \frac{ d\widetilde S_t^{(2)}(\vec k) }{ d\bar t } = -\eta \left[ \widetilde S_t^{(2)}(\vec k) \widetilde S_t^{(1)}(\vec k) \widetilde C_t(\vec k) -1 \right] \widetilde S_t^{(1)}(\vec k). \tag{50} \]
Fixed point:
\[ \widetilde S_t^{(2)}(\vec k) \widetilde S_t^{(1)}(\vec k) \widetilde C_t(\vec k) = 1. \]
Yaani, safu mbili hazina optimum moja ya lazima kila moja kivyake; kilicho muhimu ni kwamba product yao itoe exact score. Over-parameterization hapa ni hasa uhuru huu wa factorization.
Logistic equation katika balanced two-layer case
Ikiwa safu mbili ni sawa mwanzoni:
\[ s= \widetilde S_t^{(1)}(\vec k) = \widetilde S_t^{(2)}(\vec k), \qquad c= \widetilde C_t(\vec k)>0 \]
na:
\[ \dot{s} = \eta s(1-cs^2). \tag{51} \]
\[ u=s^2 \]
kwa ufafanuzi:
\[ \dot{u} = 2\eta u(1-cu). \tag{52} \]
Hii ni standard logistic equation na solution yake ni:
\[ u(\bar t) = \frac{ u_0 e^{2\eta\bar t} }{ 1-cu_0+cu_0e^{2\eta\bar t} }. \tag{53} \]
Kwa hiyo:
\[ s(\bar t) = \operatorname{sgn}[s(0)] \sqrt{ \frac{ u_0 e^{2\eta\bar t} }{ 1-cu_0+cu_0e^{2\eta\bar t} } }. \tag{54} \]
Tofauti ya msingi ni hii: katika Equation (23) ya safu moja, \(c\) iko moja kwa moja ndani ya exponential convergence rate, lakini katika Equation (53) ya safu mbili, sehemu ya \(e^{2\eta\bar t}\) haitegemei \(c\). Hivyo muda wa kufikia target accuracy una logarithmic, si linear, dependence kwa \(c\).
Kwa nini initial weights ni muhimu?
Chanzo kinahitaji initial layer weights zichaguliwe takriban katika scale ifuatayo ili kupata stable convergence ya kiwango \(\eta=O(1)\) katika modes zote:
\[ s(0)=O(1/L) \]
Katika scale hiyo. Chanzo kinaeleza kwamba initializations za ukubwa \(O(1)\), kama standard Kaiming, zinaweza kuwa tatizo zaidi kadiri system size inavyokua kwa tatizo hili la kinadharia.
Ikiwa layers si sawa mwanzoni
Katika hali ya jumla:
\[ u(\bar t) = s_1(\bar t)s_2(\bar t), \tag{55} \]
na layer mismatch:
\[ d_0=s_1^2(0)-s_2^2(0), \qquad \delta=|d_0|, \qquad \alpha=\frac{\delta}{2}. \]
Chanzo pia hufafanua:
\[ \kappa = c\alpha = \frac{c\delta}{2}, \qquad A = \sqrt{ 1+\kappa^2 } = \sqrt{ 1+\frac{c^2d_0^2}{4} }. \tag{56} \]
. Closed-form solution hutolewa katika Equation (57) kwa mfululizo wa \(q_0\), \(R_0\), \(R(\bar t)\), \(q(\bar t)\) na \(u(\bar t)\). Sehemu ya exponential ya convergence inadhibitiwa na \(A\eta\). Ili kuzuia polynomial degradation dhidi ya system size:
\[ d_0 \lesssim \frac{1}{L^2} \]
sharti hili linahitajika. Kuchagua \(s_1,s_2=O(1/L)\) ni sharti la kutosha kwa hili.
Uthibitishaji wa namba
Mode-based score error ya architectures mbili:
\[ \varepsilon_{F_e}(\vec k) = \left[ \frac{ \overline{ \left| F_t^{\rm ov}[\phi_t(\vec k)] - \mathcal F_t[\phi_t(\vec k)] \right|^2 } }{ \overline{ \left| \mathcal F_t[\phi_t(\vec k)] \right|^2 } } \right]^{1/2}. \tag{58} \]
Exact Fourier score:
\[ \mathcal F_t[\phi(\vec k)] = - \widetilde{\mathcal S}_t(\vec k) \widetilde\phi(\vec k). \tag{59} \]
Katika uthibitishaji wa Figure 5 wa chanzo, masharti \(d=2\), \(m_{\rm eff}=0\), \(a=1\), \(t=0.01\), \(L=16\) hutumiwa. Katika safu moja, characteristic error decay time hubadilika kama \(1/\widetilde C(\vec k)\), na katika safu mbili takriban kama \(-\log\widetilde C(\vec k)\). Numerical experiments hutumia 1024 training configurations na wastani wa 500 independent simulations.
Je, layers zaidi ni bora zaidi?
Chanzo kinachambua swali hili kwa simplified model yenye \(N_\ell\) equal layers. Kwa \(u=s^{N_\ell}\):
\[ \dot u = \eta N_\ell u^{\,2-2/N_\ell} (1-cu). \tag{60} \]
Required initialization scale:
\[ s_0 \sim L^{-2/N_\ell}. \tag{61} \]
Characteristic training time:
\[ \tau_{\rm eff} \sim L^{\,2-4/N_\ell}. \tag{62} \]
Katika special case ya \(N_\ell=2\), exponent ya power law hushuka hadi sifuri na uchanganuzi wa kina zaidi hutoa \(\log L\) scaling. Lakini kwa \(N_\ell\geq3\), positive power ya \(L\) hujitokeza tena. Katika kikomo cha \(N_\ell\rightarrow\infty\), exponent hukaribia 2. Kwa hiyo, katika simplified balanced model ya utafiti, hitimisho la “depth zaidi daima ni haraka zaidi” halitokei; layers mbili ni hali maalumu na yenye faida zaidi kinadharia.
Utekelezaji katika Fourier Space Hubadilishaje Gharama ya Hesabu?
Katika real space, forward pass ya convolution inayofunika mfumo mzima inahitaji \(O(N^2)\) operations, lakini translation-invariant convolution hiyo hiyo hugeuka kuwa pointwise multiplication katika Fourier space; kwa kuwa gharama ya \(O(N\log N)\) ya FFT na inverse FFT ndiyo hutawala, utafiti hupunguza total forward-pass complexity ya two-layer score network hadi \(O(N\log N)\).
Kwa nini real-space convolution ni ghali?
Kwa kuwa correlation length hudiverge katika critical point, exact score kernel inaweza kuenea kwenye system size nzima. Kutumia kernel moja kwa moja katika real space ili kufunika system size kunahitaji:
\[ O(N^2) \]
operations.
Hapa:
\[ N= \left( \frac{L}{a} \right)^d. \]
\(L\) ni linear system size, \(a\) ni lattice spacing, na \(d\) ni spatial dimension.
Mtiririko wa hesabu unaotegemea FFT
- Real-space configuration hubadilishwa kuwa Fourier space kwa FFT.
- Convolution kernel hutumiwa kwa kila mode kama pointwise multiplication katika Fourier space.
- Matokeo hurudishwa real space kwa inverse FFT.
Gharama ya kernel multiplication katika Fourier space ni \(O(N)\), huku gharama ya FFT ni:
\[ O(N\log N) = O\left( dL^d\log L \right) \]
kwa hiyo total score-call cost hutawaliwa na FFT.
Uthibitishaji wa hardware
Figure 6 ya chanzo inalinganisha forward-pass wall times za PyTorch real-space two-layer convolutional network na Fourier implementation. Majaribio yalifanywa kwa batches za sampuli 1024, kwa dimensions \(d=1,2,3\), na kwa kutumia NVIDIA Tesla V100-SXM2-32GB GPU. Fourier implementation ni ya haraka zaidi kuliko real-space convolution katika range iliyopimwa na inaonyesha system-size scaling yenye manufaa zaidi. Chanzo pia kinasema kwamba theoretical \(\log L\) correction haikutenganishwa wazi katika experimental range hii.
Mbinu na Matokeo ya Utafiti
Mpangilio wa jaribio la mwisho la uthibitishaji
Ili kujaribu kama Fourier-based two-layer architecture si tu inapunguza theoretical training time bali pia inazalisha kwa usahihi sifa za kimwili za configurations halisi zinazotengenezwa, utafiti hufanya generation experiment tofauti.
| Parameter | Thamani ya chanzo | Jukumu la kisayansi |
|---|---|---|
| Spatial dimension | \(d=2\) | Mfumo wa uga wa Gaussian wa vipimo viwili |
| System sizes | \(L=16,32,64,128\) | Hujaribu system-size scaling |
| Effective mass | \(m_{\rm eff}=3/L\) | Hukaribia criticality kadiri mfumo unavyokua |
| Diffusion-time range | \(t_{\max}=5\) → \(t_{\min}=10^{-4}\) | Forward/reverse diffusion time range |
| Diffusion-time models | 3000 separate time points | Independent linear network kwa kila \(t\) |
| Training dataset | \(M=4096\) | Training configurations za kila model |
| Learning rate | \(\eta=0.025\) | Gradient-descent step size |
| Weight initialization | Mean 0, standard deviation \(1/L\) Gaussian | Inalingana na theoretical two-layer convergence condition |
| Reverse ODE | Runge–Kutta ya daraja la 4 | Denoising integration |
| Integration steps | 1500 | Reverse ODE discretization |
| Idadi ya training epochs | 175, 200, 225, 250 | Kwa mpangilio \(L=16,32,64,128\); takriban ongezeko la kudumu kwa kila doubling kulingana na matarajio ya \(\log L\) |
Power spectrum
Observable ya kwanza ya kimwili:
\[ P(k) = \left\langle |\widetilde\phi(k)|^2 \right\rangle . \tag{63} \]
Kiasi hiki hupima average power ya field fluctuations katika wave numbers tofauti. Katika mfumo kritiki, low-\(k\) modes ni muhimu hasa kwa sababu zinawakilisha long-range correlations.
Chanzo hufit sehemu ya low-\(k\) kama:
\[ \frac{1}{P(k)} \simeq ak^2+b \tag{64} \]
.
Kutoka hapa fitted effective mass:
\[ m_{\rm fit} = \sqrt{\frac{b}{a}} \]
hupatikana.
| \(L\) | Target \(m_{\rm eff}=3/L\) | \(m_{\rm fit}\) kutoka data iliyozalishwa | Tafsiri ya chanzo |
|---|---|---|---|
| 16 | 0.188 | 0.189(3) | Ulinganifu mzuri sana na target |
| 32 | 0.094 | 0.097(2) | Ulinganifu mzuri sana na target |
| 64 | 0.0469 | 0.0463(8) | Ulinganifu mzuri sana na target |
| 128 | 0.0234 | 0.0234(4) | Ulinganifu mzuri sana na target |
Kila curve iliundwa kwa kutumia configurations 20.000. Jaribio hili huangalia hasa kama low-\(k\) spectrum inazalishwa kwa usahihi wakati criticality inakaribiwa.
Generation test katika full critical point
Katika Figure 8, chanzo kinalinganisha configurations kwa \(m_{\rm eff}=0\) na \(L=16,32,64,128\) kati ya target \(O(n)\) configurations na configurations zinazozalishwa na diffusion model. Kwa kila system size, kwa configurations 20.000:
- distribution ya field component moja \(P(\phi)\),
- action distribution,
- power spectrum \(P(k)\),
- covariance matrix
huchunguzwa. Chanzo kinasema kwamba kwa observables hizi, distributions zinazozalishwa haziwezi kutofautishwa numerically na theoretical targets.
Athari ya finite training dataset
Katika Appendix B, idadi ya training samples \(M\) pia huchunguzwa. Mfumo uliodiscretize unawakilishwa na variables \(N\), na ideal infinite-training-score estimate kupitia empirical covariance \(\widehat C_0\) ni:
\[ S_t = \left[ (1-e^{-2t})I + e^{-2t}\widehat C_0 \right]^{-1}. \tag{B1} \]
Finite-sample error ya kila element ya real-space \(N\times N\) kernel hupungua kadiri \(M\) inavyoongezeka. Uchanganuzi wa chanzo huchunguza total error scaling katika Frobenius na \(L_{1,1}\) norms.
Kwa kuwa translation invariance hufanya kernel kuwa diagonal katika Fourier space, inawezekana kujifunza parameters \(O(N)\) pekee moja kwa moja katika momentum space. Katika hali hii chanzo:
\[ E_{1,1} \sim \frac{N}{\sqrt M}, \tag{B6} \]
na:
\[ E_F \sim \sqrt{ \frac{N}{M} }. \tag{B7} \]
hutoa scaling hizi. Hitimisho muhimu kwa normalized relative error ni kwamba si lazima \(M\) ikue kwa lazima na system size ili kudumisha accuracy thabiti. Kwa hiyo, finite-sample error haibadilishi dominant \(L^2\) result ya one-layer critical slowdown.
Reverse ODE discretization error
Simple Euler discretization:
\[ \frac{ \widetilde\phi(\vec k,t-\delta t) - \widetilde\phi(\vec k,t) }{ \delta t } = \widetilde\phi(\vec k,t) + (2\pi)^d \widetilde\phi(\vec k,t) \widetilde S_t(\vec k). \tag{B8} \]
na equivalent update:
\[ \widetilde\phi(\vec k,t-\delta t) = \widetilde\phi(\vec k,t) \left[ 1+ \delta t \left( 1-(2\pi)^d\widetilde S_t(\vec k) \right) \right]. \tag{B9} \]
Katika Euler method, final error ni \(O(\delta t)\). Katika critical low-momentum mode na fixed \(\delta t\), absolute error inaweza kukua takriban linearly kwa \(L\) kubwa. Chanzo kinaonyesha kwamba hii inaweza kupunguzwa sana kwa higher-order integrators.
Kwa fourth-order Runge–Kutta method iliyotumiwa katika Figure 8, required discretization step inahitaji kukua takriban kama:
\[ L^{1/4} \]
na hii inatosha. Huu ni system-size dependence dhaifu zaidi kuliko \(L^2\) training bottleneck ya one-layer case.
Je, Local Score Kernel Inatosha katika Critical Point?
Hapana. Hitimisho kuu la Appendix C ni kwamba limited-range score kernel inaweza kuweka total score error ndogo chini ya hali fulani, lakini inaweza kushindwa kurejesha kwa usahihi low-momentum structure ya mfumo kritiki wa \(m_{\rm eff}\rightarrow0\); kwa hiyo, score error ndogo peke yake haitoi dhamana kwamba critical physical behavior imezalishwa kwa usahihi.
Kukata local kernel
Exact score kernel:
\[ |\vec x-\vec y|>\frac{K}{2} \]
huwekwa sifuri katika eneo hili ili kulocalize kwa bandia. Score error katika point moja ni:
\[ \delta F_t^{(R)} = - \int_{|\vec y|>R} d^d\vec y\, \mathcal S_t(0,\vec y) \phi_t(\vec y), \tag{C1} \]
hapa \(R=K/2\).
Scaling analysis ya chanzo kwa total local error variance hutoa:
\[ {\rm Var}[\delta F_t^{(R)}] \sim R^{-d}, \qquad d\geq3, \tag{C5} \]
\[ {\rm Var}[\delta F_t^{(R)}] \sim \frac{\log L}{R^2}, \qquad d=2, \tag{C6} \]
\[ {\rm Var}[\delta F_t^{(R)}] \sim \frac{L}{R^2}, \qquad d=1. \tag{C7} \]
matokeo haya.
Kwa hiyo, ili kudhibiti total score error, takriban:
- \(d=1\): \(R\sim\sqrt L\),
- \(d=2\): \(R\) kukua logarithmically,
- \(d\geq3\): sabit \(R\)
kunaweza kutosha.
Lakini hii haimaanishi “critical physics imezalishwa kwa usahihi”. Power-spectrum test ya Appendix C inaonyesha kuwa kadiri \(m_{\rm eff}\) inavyopungua, local/cropped score hurejesha vibaya low-\(k\) spectrum. Kernel truncation hutenda kimwili kana kwamba kuna finite correlation length. Kwa kuwa true correlation length hudiverge katika critical point, local kernel hupoteza critical behavior.
Kwa nini matokeo haya ni muhimu?
Kuwa na total mean error ndogo katika machine-learning model hakumaanishi modes zote muhimu kimwili ni sahihi. Katika critical systems, low-\(k\) modes huamua long-range correlations hata kama zina uzito mdogo katika total norm. Kwa hiyo, utafiti unaonyesha kwamba validation kwa physical observables ni salama zaidi kuliko kutegemea global score metric pekee.
Matokeo makuu ya utafiti
| Mbinu / usanifu | Scaling kuu katika criticality | Tafsiri ya chanzo |
|---|---|---|
| Local Langevin / simple MCMC relaxation | \(\tau\sim L^2\) | Physical critical slowdown |
| One linear score layer + gradient descent | \(\tau_{\rm train}\sim L^2\) | Hurithi physical bottleneck |
| Optimally tuned momentum | Takriban \(L\) | Hupunguza slowdown lakini haiondoi |
| Two linear layers + suitable initialization | \(\tau_{\rm train}\sim\log L\) | Huondoa critical training power-law slowdown |
| \(N_\ell\geq3\) balanced linear layers | \(L^{2-4/N_\ell}\) | System-size scaling mbaya zaidi kuliko layers mbili |
| Naive full real-space convolution | \(O(N^2)\) | Computational overhead inaweza kuondoa faida |
| Fourier score implementation | \(O(N\log N)\) | FFT cost ndiyo hutawala |
Matokeo yanayoungwa mkono na utafiti
- Exact diffusion score ya Gaussian \(O(n\rightarrow\infty)\) model ni linear na inaweza kuwakilishwa na full-system linear convolution kernel.
- Gradient-descent training ya one-layer linear network inayoweza kuwakilisha exact score huonyesha \(L^2\)-scale critical slowdown katika critical point.
- Slowdown katika score training huhamishwa kwenye generation error na hufanya uzalishaji wa covariance sahihi kuwa mgumu kwa system-size scaling hiyo hiyo.
- Kuongeza second linear layer, chini ya suitable \(1/L\)-scale initialization, hupunguza training time kutoka \(L^2\) hadi \(\log L\).
- Linear layers zaidi si bora kiotomatiki katika simplified model hii; kwa \(N_\ell>2\), power-law system-size dependence hurudi.
- Fourier implementation hupunguza forward-pass cost ya full-range score calculation kutoka \(O(N^2)\) hadi \(O(N\log N)\).
- Critical Gaussian fields zinazozalishwa na Fourier-based two-layer network zinaonyesha ulinganifu mzuri sana na theoretical targets katika power spectrum, action, single-field distribution na covariance measurements.
- Finite dataset na reverse-ODE discretization errors zimechunguzwa na kuonyeshwa kutobadilisha dominant scaling ya one-layer \(L^2\) training bottleneck.
- Global score error ndogo pekee haitoi dhamana kwamba critical physical correlations zimezalishwa kwa usahihi; low-\(k\) behavior lazima ichunguzwe pia.
Matokeo yasiyoungwa mkono na utafiti
- Uboreshaji wa \(L^2\rightarrow\log L\) si sheria ya jumla kwa modeli zote za kisasa za image/video diffusion.
- Utafiti hauonyeshi moja kwa moja scaling hiyo hiyo katika Transformer, U-Net au large nonlinear generative models.
- Matokeo hayajathibitishwa kiuchanganuzi katika finite-\(n\) \(O(n)\) models.
- Ferromagnetic phase ya \(m_{\rm eff}<0\), ambayo haipatikani katika Gaussian model, haichunguzwi moja kwa moja.
- Utafiti haudai kwamba intuition ya jumla ya kimwili kuhusu kwa nini layers mbili ni optimum maalumu kwa tatizo hili imekamilika; waandishi wanaiacha kama mada ya utafiti wa baadaye.
- Kudhibiti total score error kwa local kernel si dhamana ya kuzalisha kwa usahihi critical physical observables.
- Haijajaribiwa kama Fourier architecture itaonyesha faida hiyo hiyo ya performance katika multiscale real datasets zote.
- Utafiti hautatui tatizo la jinsi training dataset inavyopatikana; waandishi huchukulia dataset kuwa imetolewa.
Vikwazo vikuu na maeneo ya utafiti wa baadaye
1. Gaussian large-\(n\) limit: Sababu kuu ya analytical control pia ndiyo limitation kuu. \(n\rightarrow\infty\) limit hufanya model kuwa Gaussian; finite-\(n\) interactions na true nonlinear score structures hazipo katika main analysis.
2. High-temperature/critical side: Utafiti unalenga eneo la \(m_{\rm eff}\geq0\). Katika Gaussian limit, kwa kuwa model ya \(m_{\rm eff}<0\) haijafafanuliwa vizuri, ferromagnetic broken-symmetry phase haiwezi kuchunguzwa.
3. Linear architectures: One- na two-layer networks zinajumuisha linear convolutions bila activation. Hii hutenga kwa uwazi athari ya architectural parametrization, lakini haiwakilishi modern deep nonlinear diffusion architectures.
4. Network tofauti kwa kila diffusion-time: Katika final Fourier validation, independent network hufundishwa kwa kila fixed \(t\) badala ya single time-embedded network. Chaguo hili ni kwa kutekeleza theory moja kwa moja na ni tofauti na standard practical diffusion architectures.
5. Dataset inachukuliwa kuwa imetolewa: Katika physical sampling problems, mara nyingi lengo lenyewe ni kuzalisha training data kutoka target distribution. Makala inaweka gharama ya training samples nje ya tatizo kuu.
6. Tatizo la locality: Kwa kuwa correlation length hudiverge katika critical system, fully local score modeling inaweza kupoteza physical low-\(k\) behavior.
7. DOI ya data repository: PDF ya v3 iliyopakiwa inarejelea Duke Digital Repository katika data availability statement, lakini DOI katika Reference [96] bado iko katika placeholder form “10.7924/XXXXXXX”. Verianla haikamilishi pengo hili.
Maelezo ya Chanzo na Mbinu
Kichwa asili: The critical slowing down in training diffusion models
Waandishi: Luca Maria Del Bono, Giulio Biroli, Patrick Charbonneau, Marylou Gabrié.
Mpangilio wa waandishi: Mpangilio katika PDF ya chanzo umehifadhiwa kama ulivyo.
Mwandishi wa mawasiliano: Luca Maria Del Bono. Katika PDF ya chanzo ameonyeshwa wazi kwa alama ya nyota kama “Corresponding author”.
Mchango sawa: Hakuna taarifa ya equal contribution/co-first authorship iliyobainishwa katika chanzo kilichopakiwa.
Affiliations: Dipartimento di Fisica, Sapienza Università di Roma; CNR-Nanotec Rome unit; Laboratoire de Physique Statistique, École normale supérieure / PSL Research University; Department of Physics, Duke University; Department of Chemistry, Duke University.
Toleo la chanzo lililopakiwa: arXiv:2605.12597v3 [cond-mat.dis-nn], 18 Septemba 2026.
arXiv DOI: 10.48550/arXiv.2605.12597. DOI hii ni permanent identifier ya rekodi ya arXiv na si journal DOI.
Hali ya sasa ya uchapishaji: Utafiti ulikubaliwa na PRX Intelligence tarehe 28 Oktoba 2026. DOI katika rekodi ya “Accepted Paper” ya APS ni 10.1103/yskc-plm7. Maudhui ya kisayansi ya maandishi haya ya Verianla yanategemea PDF ya arXiv v3 iliyopakiwa; hali ya sasa ya kukubaliwa imeongezwa kwa madhumuni ya bibliographic verification pekee.
Jarida: PRX Intelligence — utafiti uliokubaliwa.
Mchapishaji: American Physical Society (APS).
Aina ya chanzo: Utafiti wa theoretical, analytical na numerical statistical physics / machine learning.
Maeneo makuu: Disordered Systems and Neural Networks, Statistical Mechanics, Artificial Intelligence, Machine Learning na Computational Physics.
Modeli kuu ya kimwili: Gaussian \(O(n\rightarrow\infty)\) statistical field theory.
Mbinu kuu ya machine learning: Score-based diffusion model; gradient-descent training dynamics ya one- na two-linear convolution layers.
Mbinu kuu ya hesabu: Fourier-space analysis, exact Gaussian score, gradient-flow solution, reverse diffusion ODE, FFT-based score implementation na numerical configuration generation.
Programu ya numerical: Chanzo kinaeleza kwamba PyTorch convolutions zilitumiwa na sehemu ya diffusion-model integration superstructure ilirekebishwa kutoka Reference [87].
Hardware ya numerical: NVIDIA Tesla V100-SXM2-32GB GPU ilitumika katika kulinganisha Fourier na real-space forward-pass times.
Upatikanaji wa data: PDF ya v3 iliyopakiwa ina kauli “The data that support the findings of this article are openly available [96]”; hata hivyo Reference [96] katika PDF hiyo hiyo ina DOI isiyokamilika katika fomu “Duke Digital Repository https://doi.org/10.7924/XXXXXXX”. Kwa hiyo DOI kamili ya data repository haiwezi kuthibitishwa kutoka toleo hili la chanzo.
Ufadhili / miundombinu ya hesabu: DARIAH HPC-AI cluster at CNR-NANOTEC, Lecce ilitumika katika utafiti. Chanzo kinaeleza kuwa miundombinu hii ilifadhiliwa na mradi “MUR PON Ricerca e Innovazione 2014–2020” PIR01_00022 na H2IOSC Project IR0000029 chini ya European Union – NextGenerationEU – NRRP M4C2.
Shukrani: Waandishi wanawashukuru Davide Carbone, Sebastian Goldt, Misaki Ozawa na Gilles Tarjus kwa mijadala yenye manufaa. Luca Maria Del Bono pia anataja ukarimu wa École normale supérieure.
Mgongano wa maslahi: Hakuna taarifa tofauti ya conflict of interest/competing interests iliyobainishwa katika PDF ya v3 iliyopakiwa; Verianla haijaunda taarifa ambayo haipo katika chanzo.
Michango ya waandishi / CRediT: Hakuna jedwali tofauti la michango ya CRediT lililobainishwa katika PDF ya v3 iliyopakiwa.
Leseni: Rekodi ya arXiv inaonyesha non-exclusive distribution license. Hii haijatafsiriwa kuwa source figures zinaweza kutumiwa tena kwa uhuru chini ya Creative Commons; Verianla haijanakili source figures moja kwa moja, bali imeunda SVG huru na HTML tables kwa kutegemea mahusiano ya kisayansi.
Kikomo kikuu cha tafsiri: Utafiti unachunguza linear score architectures kwenye controlled Gaussian \(O(n\rightarrow\infty)\) model. Kuhamisha matokeo haya moja kwa moja kwa kiwango cha quantitative kwenda large general-purpose nonlinear diffusion models hakujathibitishwa na chanzo.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *