


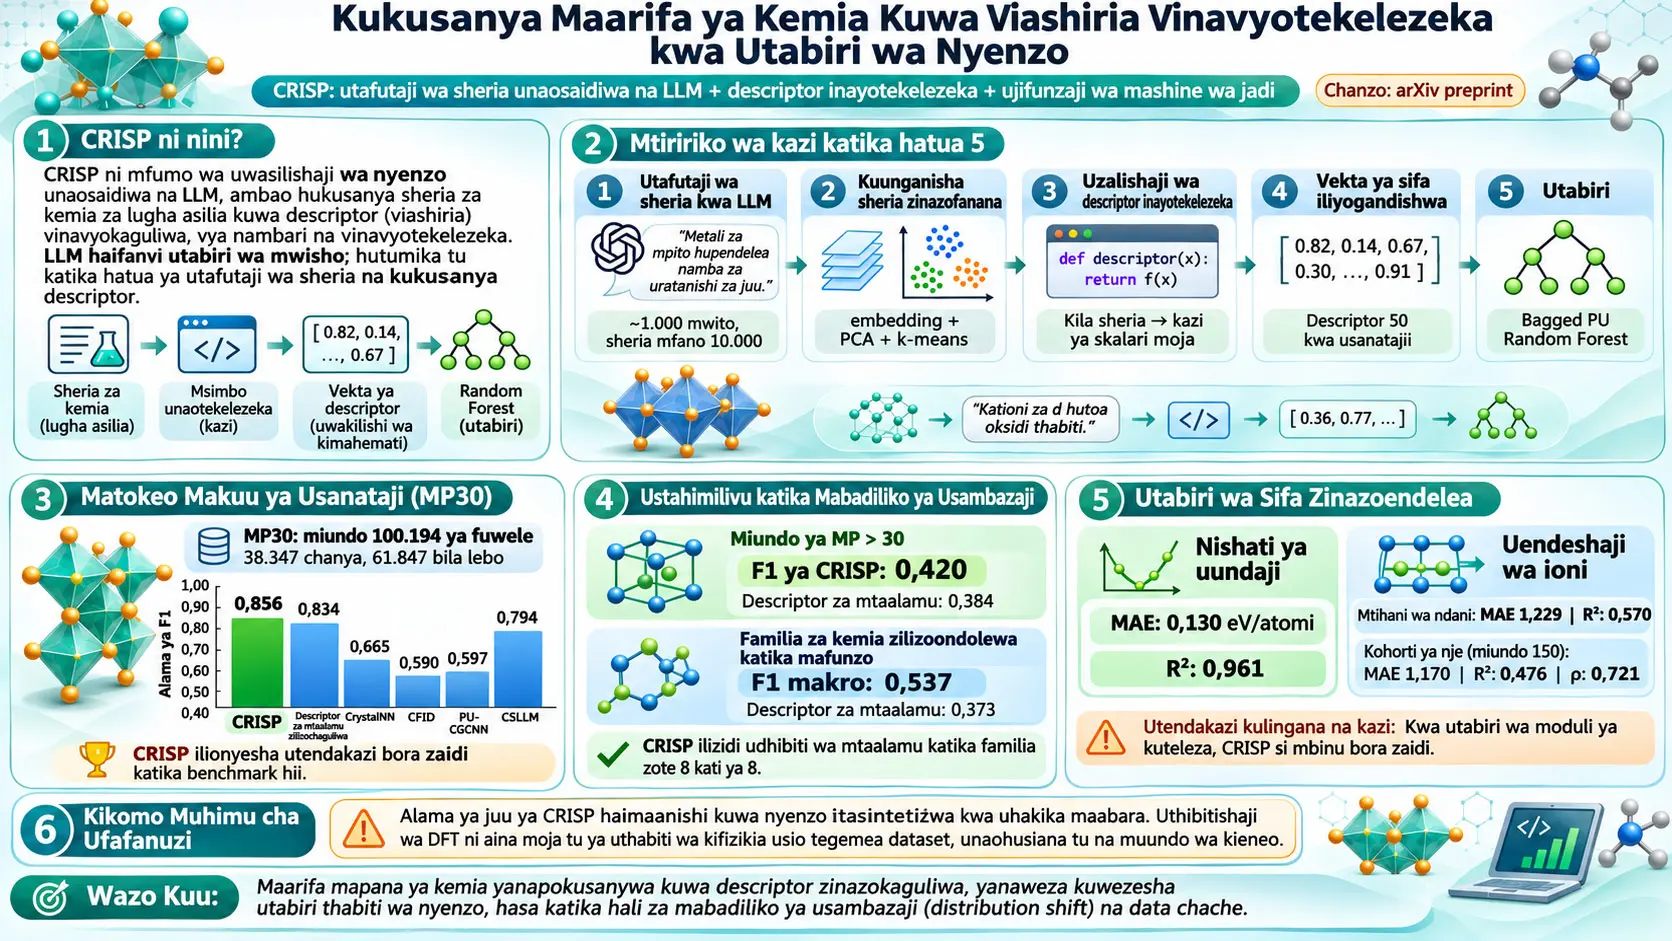
CRISP ni mfumo wa uwakilishi wa nyenzo unaosaidiwa na LLM ambao, badala ya kutumia maarifa ya kemia yaliyomo katika modeli kubwa za lugha kutoa utabiri moja kwa moja, hukusanya kanuni za kemia na muundo wa fuwele zilizoelezwa kwa lugha asilia na kuzigeuza kuwa descriptor zinazoweza kukaguliwa, za namba na zinazoweza kutekelezwa. Katika mbinu hii, LLM kwanza huchukua sampuli za kanuni za kemia zinazohusiana na lengo kutoka katika nafasi pana ya kanuni; kanuni zinazofanana huunganishwa; kila kanuni mwakilishi hubadilishwa kuwa kazi inayoweza kupangwa ambayo hubadilisha muundo wa fuwele kuwa thamani ya namba; katalogi ya descriptor inayotokana hugandishwa, na utabiri wa mwisho hufanywa na modeli ya kawaida ya ujifunzaji wa mashine kama Random Forest. LLM haishiriki katika hatua ya mwisho ya utabiri kwa kila nyenzo.
Eneo kuu la majaribio katika utafiti ni uwezo wa kusanisiwa kwa fuwele zisizo za kikaboni. “Uwezo wa kusanisiwa” hapa si jaribio ambalo nyenzo mpya zimesanisiwa maabara na kuthibitishwa kwa mafanikio. Katika benchmark inayotegemea Materials Project, miundo ya majaribio au iliyoripotiwa huchukuliwa kuwa chanya, huku miundo ya kinadharia au ambayo bado haijaripotiwa ikichukuliwa si hasi bali isiyo na lebo. Kwa hiyo, tatizo la ujifunzaji linalotumika ni positive–unlabeled, yaani ujifunzaji wa chanya–isiyo na lebo.
Benchmark ya MP30 ina miundo 100.194 ya fuwele: 38.347 chanya na 61.847 isiyo na lebo. Wakati uwakilishi pekee ulipobadilishwa chini ya mtumiaji yuleyule wa bagged PU Random Forest, descriptor 50 zinazoweza kutekelezwa za CRISP zilipata F1=0,856 iliyokalibishwa kwa α; descriptor 18 zilizochaguliwa na wataalamu F1=0,834; CrystalNN F1=0,665; CFID F1=0,590; embedding ya maandishi ya Robocrystallographer F1=0,438 na embedding ya maandishi ghafi ya CIF F1=0,388.
Faida iliyo wazi zaidi ya CRISP haikuonekana tu katika benchmark ya usambazaji uleule, bali pia katika hali ambapo data ya majaribio ilitoka nje ya usambazaji wa mafunzo. Katika miundo yenye seli kubwa zaidi, CRISP ilibaki juu ya uwakilishi wa kitaalamu kwa F1=0,420 dhidi ya 0,384. Katika majaribio ambapo kila moja ya familia nane za kemia iliachwa nje ya mafunzo kwa zamu, wastani wa macro F1 wa CRISP ulikuwa 0,537, huku seti ya descriptor za kitaalamu ikiwa 0,373. CRISP ilionyesha F1 ya juu kuliko udhibiti wa kitaalamu katika familia zote nane kati ya nane, na p=0,0078 iliripotiwa kwa two-sided exact sign test.
Mbinu pia ilitumika kwa sifa endelevu za nyenzo. Katika nishati ya uundaji, CRISP ilikaribia uwakilishi wa descriptor uliochaguliwa na wataalamu kwa MAE=0,130 eV/atom na R2=0,961. Katika uendeshaji wa ioniki wa joto la kawaida, kwa elektrolaiti dhabiti 503 ilipatikana MAE=1,229 log unit na R2=0,570; katika kohorti huru ya nje ya nyenzo 150, bila kufundishwa upya, MAE=1,170, R2=0,476 na Spearman ρ=0,721 zilibaki.
Hata hivyo, chanzo hakiwasilishi mbinu kama yenye ubora wa ulimwengu wote. Kwa uendeshaji wa ioniki, descriptor za kitaalamu maalumu kwa kazi zilifanya vizuri zaidi, na katika utabiri wa moduli ya shear, descriptor za kijiometri endelevu zenye ufafanuzi finer zilipita CRISP. Kwa hiyo, hitimisho la utafiti si kwamba “maarifa ya LLM ni bora katika kila tatizo la utabiri wa nyenzo”; bali ni kwamba kukusanya nafasi pana ya maarifa ya kisayansi katika umbo la namba, linalokaguliwa na lisilotegemea seti ya data kunaweza kuwa na manufaa hasa chini ya mabadiliko ya usambazaji na hali za data chache.
CRISP ni Nini na Inafanyaje Kazi?
CRISP ni mfumo wa kutengeneza uwakilishi ambao huchukua sampuli kwa kiwango kikubwa za kanuni za kemia zinazohusiana na lengo kwa kutumia LLM, huunganisha kanuni zinazofanana katika familia za dhana, hubadilisha kila familia kuwa programu inayoweza kutekelezwa inayokokotoa thamani moja ya skala kutoka kwenye muundo wa fuwele, na kutoa vekta hii ya descriptor iliyogandishwa kwa modeli ya kawaida ya ujifunzaji wa mashine; utabiri wa mwisho wa nyenzo haufanywi na LLM bali na modeli ya downstream inayotumia descriptor hizi za namba.
Tatizo kuu ambalo utafiti unajaribu kutatua
Katika utabiri wa nyenzo, si tu uchaguzi wa algoritimu ya ujifunzaji wa mashine ulio muhimu, bali pia ni kwa vigezo gani nyenzo inawakilishwa kwa modeli. Baadhi ya sifa, kama nishati ya uundaji, zinaweza kufafanuliwa moja kwa moja kama lengo la namba. Lakini uwezo wa kusanisiwa kwa fuwele hauwezi kupunguzwa kuwa kiasi kimoja cha namba cha kifizikia.
Uwezekano wa fuwele kupatikana kwa kweli unaweza kutegemea uthabiti wa thermodynamics, metastability, mazingira ya uratibu, upangaji wa atomi, ulinganifu, muundo wa kikemia, awamu zinazoshindana, njia za mmenyuko zinazofikika kinetiki, na upatikanaji wa viambata tangulizi vinavyofaa. Sehemu kubwa ya mawazo haya hupatikana katika fasihi ya kemia kama kanuni za lugha asilia katika umbo la “hali hii inaweza kurahisisha usanisi”.
Modeli ya kawaida ya ujifunzaji wa mashine haiwezi kusoma kanuni hizi za lugha asilia moja kwa moja. Kwanza zinahitaji kubadilishwa kuwa vigezo vya namba. Tatizo kuu la makala ni hili hasa: nafasi pana na iliyotawanyika ya maarifa ya kemia inaweza kugunduliwaje kwa utaratibu na kubadilishwaje kuwa descriptor zinazoweza kukokotolewa?
Kwa nini utabiri wa moja kwa moja wa LLM hautumiki?
Waandishi wanaonyesha matatizo mawili muhimu ya utabiri wa moja kwa moja wa LLM. Kwanza, hata modeli ikitoa jibu sahihi, inaweza kutokuwa wazi ni vigezo gani vya kifizikia au kikemia ilivyotumia kwa kweli wakati wa utabiri. Pili, maelezo ya lugha asilia yanayotolewa na modeli baada ya utabiri si lazima yawe kumbukumbu ya kuaminika ya hesabu ya ndani iliyotawala utabiri huo.
CRISP hushughulikia tatizo hili kwa kuweka kikomo kwenye jukumu la LLM. LLM:
- hupendekeza kanuni ya kemia,
- husaidia kuunganisha familia za kanuni,
- husaidia kutengeneza programu inayokokotoa kanuni.
Lakini baada ya katalogi ya descriptor kukamilika, katalogi hugandishwa. Utabiri kwenye seti ya mwisho ya data hufanywa na modeli ya kawaida. Hivyo, nyuma ya kila kigezo cha kuingiza kuna kanuni ya kemia iliyopewa jina na programu inayoweza kukaguliwa.
Kifupi CRISP kinasimamia nini?
PDF kuu iliyopakiwa hutumia CRISP kama jina la mbinu lakini haielezi wazi ni maneno gani ya Kiingereza ambayo herufi za kifupi hicho zimetokana nayo. Kwa hiyo Verianla haitengenezi ufafanuzi wa kifupi ambao haupo kwenye chanzo.
Mtiririko wa hatua tano wa CRISP
Hatua ya ugunduzi wa kanuni ilifanywaje?
Katika kazi ya uwezo wa kusanisiwa, modeli ya gpt-4.1-mini-2025-04-14 iliombwa kutenda kama mtaalamu wa kemia isiyo ya kikaboni na kupendekeza kanuni kumi za kemia au muundo ambazo zinaweza kuonyesha uwezo wa kusanisiwa kutoka taarifa ya fuwele. Maelezo ya kila kanuni yalipunguzwa hadi maneno yasiyozidi 100.
Ombi hilo hilo lilitumwa mara 1.000 kwa kujitegemea:
\[ 1000\;\text{çağrı}\times10\;\text{kural/çağrı}=10000\;\text{aday kural} \]
Watafiti wanaeleza kuwa katika hatua hii walichagua kimakusudi modeli ya non-reasoning yenye kasi na inayozalisha utofauti badala ya modeli yenye msisitizo mkubwa wa reasoning. Lengo halikuwa kuungana kwenye jibu moja, bali kuchukua sampuli ya nafasi pana iwezekanavyo ya kanuni za kemia.
Kwa hiyo, wazo lilelile linaweza kuzalishwa mara nyingi, huku baadhi ya kanuni zikionekana katika idadi ndogo tu ya miito. Uchambuzi wa baadaye wa utafiti ulionyesha kwamba kanuni kuzalishwa mara nyingi na LLM haimaanishi lazima iwe ya thamani zaidi kwa utabiri.
Kanuni 10.000 za lugha asilia zilipunguzwaje kuwa descriptor 50?
Maandishi ya kanuni yalibadilishwa kuwa embedding za maandishi za namba kwa kutumia text-embedding-3-large. Vekta za embedding kwanza zilifanyiwa L2 normalization, vipimo vikapunguzwa kwa PCA, kisha zikafanyiwa normalization tena.
Kwa k-means katika katalogi ya uwezo wa kusanisiwa:
- idadi ya cluster: 50,
- idadi ya kuanzisha centroid: 50,
- kiwango cha juu cha iteration: 1.000,
- random seed: 42
zilitumika.
Kanuni za lugha asilia katika kila cluster kisha zilipewa GPT-5 na kuunganishwa kuwa kanuni moja inayowakilisha maana yao ya pamoja ya kikemia. Chanzo kinasema kwamba hakukuwa na uhariri wa maudhui wa binadamu katika hatua ya kuunganisha kanuni.
Kwa nishati ya uundaji, moduli ya shear na uendeshaji wa ioniki, ugunduzi maalumu wa kanuni kwa lengo pia ulifanywa kwa miito 1.000; lakini katika kazi hizi kanuni ziliunganishwa kuwa familia 25.
“Kutokuona seti ya data” kunamaanisha nini?
CRISP kuitwa “dataset-blind”, yaani kutoona seti ya data, kunamaanisha kuwa wakati wa ugunduzi wa kanuni na uundaji wa katalogi ya descriptor, LLM haipewi mifano ya fuwele, thamani halisi za lengo, mgawanyo wa mafunzo/majaribio, utabiri wa modeli au metriki za utendaji. Muundo huu unalenga kuzuia descriptor kuboreshwa kwa kutazama lebo za benchmark fulani.
Kuna tofauti muhimu hapa: kazi za descriptor baadaye hutumika kwenye muundo halisi wa fuwele ili kukokotoa thamani. “Kutokuona seti ya data” hakumaanishi descriptor hazitumii muundo wa fuwele; kunamaanisha kwamba wazo na programu ya descriptor huundwa bila kupokea mrejesho kutoka kwa lebo za benchmark.
Kanuni ya lugha asilia inakuwaje descriptor inayoweza kutekelezwa?
Kila kanuni ya kemia iliyounganishwa ilibadilishwa kwa gpt-4.1-2025-04-14, chini ya temperature=0, kuwa kazi ya Python inayorudisha thamani moja ya skala ya floating-point.
Kwa dhana, kila descriptor inaweza kufikiriwa kama:
\[ f_k(x)\rightarrow z_k \]
Inaweza kufikiriwa kwa namna hii.
Hapa \(x\) inawakilisha muundo wa fuwele uliotokana na CIF na ingizo husika zisizobadilika za fizikia-kemia; \(f_k\) ni programu inayokokotoa kanuni ya kemia yenye nambari k; na \(z_k\) ni thamani moja ya skala inayozalishwa na kanuni hiyo kwa fuwele husika.
Uwakilishi wote katika kazi ya uwezo wa kusanisiwa unaweza kufikiriwa kama:
\[ \mathbf{z}(x)= [f_1(x),f_2(x),\ldots,f_{50}(x)] \]
veKta ya descriptor yenye vipimo 50. Uwasilishaji huu wa kihisabati ni uformalishaji wa kielimu wa mbinu ya chanzo; haukutolewa katika chanzo kama equation tofauti yenye nambari.
Ni nini hakikuruhusiwa katika msimbo wa descriptor?
Ndani ya descriptor za uwezo wa kusanisiwa, matumizi ya pretrained synthesizability models, graph neural networks au surrogate models zilizofundishwa kwa lengo yalipigwa marufuku.
Katika kazi za regression, ingizo zinazoweza kutoa ufikiaji wa moja kwa moja kwa lengo au kuunda target leakage pia zilipigwa marufuku. Chanzo kinataja kama mifano nishati ya uundaji/jumla kwa kila nyenzo, energy above hull, elastic tensors, elastic constants, moduli, majibu ya stress–strain, kuvuta thamani ya lengo kutoka hifadhidata na surrogate zilizofundishwa juu ya lengo.
Kazi zilizozalishwa zilifanyiwa ukaguzi tuli wa syntax, import, token zilizopigwa marufuku na target leakage. Katalogi zote za mwisho za regression zenye kazi 25 zilipita ukaguzi huu.
Uingiliaji wa binadamu ulikuwa kiasi gani?
Imeelezwa kwamba hakukuwa na uhariri wa maudhui ya kikemia uliofanywa na binadamu katika hatua ya kuunganisha kanuni. Katika hatua ya kuandaa msimbo, uingiliaji wa binadamu uliwekewa kikomo katika kurekebisha makosa yanayozuia msimbo kufanya kazi:
- syntax,
- type,
- import,
- runtime
Chanzo kinaeleza kwamba wakati wa marekebisho haya, mantiki ya kemia au muundo wa hesabu uliopendekezwa na LLM haukubadilishwa.
Kwa nini descriptor 50 zilichaguliwa?
Uchambuzi wa coverage na convergence uliunga mkono kwamba miito 1.000 ya LLM ni bajeti ya vitendo ya kufikia saturation. Idadi ya descriptor ilipoongezeka, utendaji ulipanda hadi K=50; karibu K=60, plateau ilionekana na semantic overlap ikaongezeka.
Kwa hiyo K=50 inatafsiriwa na chanzo kama uwiano kati ya coverage na urudiaji usio wa lazima.
Ujifunzaji wa Chanya–Isiyo na Lebo ni Nini?
Ujifunzaji wa chanya–isiyo na lebo ni tatizo la ujifunzaji ambapo seti ya data ina mifano chanya ya kuaminika, lakini mifano iliyobaki haiwezi kuchukuliwa kama hasi halisi; katika utafiti huu fuwele zilizoripotiwa ni chanya, huku fuwele za kinadharia au ambazo bado hazijaripotiwa zikiachwa bila lebo badala ya kutajwa kuwa “haziwezi kusanisiwa”.
Kwa nini fuwele isiyo na lebo si hasi?
Fuwele kutokuonekana bado kama chanya katika hifadhidata hakuthibitishi kwamba haiwezi kusanisiwa kimwili. Nyenzo inaweza kuwa haijajaribiwa bado, hali sahihi za usanisi hazijapatikana, au bado haijaongezwa kwenye hifadhidata.
Kwa hiyo kutumia moja kwa moja miundo isiyo na lebo kama darasa hasi kuna hatari ya kuchukulia baadhi ya nyenzo zinazoweza kusanisiwa kama hasi za uongo.
Benchmark ya MP30
| Sehemu | Chanya (P) | Isiyo na lebo (U) | Jumla |
|---|---|---|---|
| MP30 yote | 38.347 | 61.847 | 100.194 |
| Mafunzo | 34.512 | 55.662 | 90.174 |
| Jaribio lililogandishwa | 3.835 | 6.185 | 10.020 |
MP30 ilipunguzwa kwa miundo yenye atomi zisizozidi 30 katika uwakilishi wa unit cell. Baadhi ya ingizo zenye maelezo ya muundo ya herufi 10.000 au zaidi ziliondolewa ili kudumisha utangamano na pipeline ya StructLLM.
Bagged PU Random Forest inafanyaje kazi?
CRISP ilitumia modeli 50 tofauti za Random Forest katika utabiri wa uwezo wa kusanisiwa. Katika kila bag, mifano yote chanya ya mafunzo ilichukuliwa na idadi sawa ya mifano ilichaguliwa kwa nasibu kutoka kwenye pool isiyo na lebo.
Katika kila subset iliyosawazishwa:
- RandomForestClassifier,
- 100 estimator/mti,
- na mipangilio mingine ya default ya scikit-learn
ilitumika.
Skori ya mwisho ya CRISP inaweza kufikiriwa kwa usemi wa kihisabati wa mbinu ya chanzo kama ifuatavyo:
\[ s(x)=\frac{1}{50}\sum_{b=1}^{50}p_b(y=1\mid x) \]
Hapa \(p_b(y=1\mid x)\) ni skori inayofanana na uwezekano ambayo Random Forest yenye nambari b huipa darasa chanya kwa fuwele x. \(s(x)\) ni wastani wa skori za darasa chanya za modeli 50.
Skori hii haipaswi kutafsiriwa kama “uwezekano wa kusanisiwa” katika ulimwengu halisi. Ni skori ya modeli iliyoundwa kwa benchmark ya PU.
Kalibrasheni ya α=0,0567 Inamaanisha Nini?
α=0,0567 ni thamani ya prevalence isiyobadilika katika chanzo, inayowakilisha dhana kwamba ndani ya pool U isiyo na lebo kuna chanya halisi zilizofichika, na hutumika kukalibisha working point ya metriki za uainishaji wa PU; utafiti uliweka thamani hii bila kubadilika kwa kufuata tafiti za awali za PU synthesizability.
Kwa hiyo precision na F1 katika Table 1 hazipaswi kusomwa kama metriki za kawaida za supervised-classification zilizokokotolewa moja kwa moja kwenye seti ya data yenye lebo kamili. Chanzo kinaziripoti kulingana na tathmini ya PU yenye masharti ya α.
F1 inapima nini?
F1 ni wastani wa harmonic kati ya precision na recall/TPR. Ufafanuzi wake wa jumla wa kihisabati ni:
\[ F1= 2\frac{Precision\times Recall} {Precision+Recall} \]
kwa namna hii.
Katika utafiti huu, \(Recall\) inahusiana na TPR, ambayo inawakilisha kiasi cha miundo chanya kilichokamatwa kwa usahihi upande wa darasa chanya la juu. Lakini kwa sababu sehemu ya precision inakadiriwa na kukalibishwa kwa α katika mazingira ya PU, si tathmini ileile kabisa na precision ya uainishaji wa kawaida wenye lebo kamili.
TPR ni nini?
True Positive Rate (TPR) huonyesha ni kiasi gani cha mifano inayojulikana kuwa chanya kinatambuliwa kama chanya. Umbo lake la kawaida la dhana katika uainishaji wenye lebo kamili ni:
\[ TPR=\frac{TP}{TP+FN} \]
kwa namna hii.
TP ni idadi ya true positive na FN ni idadi ya false negative.
Matokeo makuu ya benchmark ya CRISP
| Modeli / uwakilishi | Mbinu | Kipimo cha ingizo / uwakilishi | TPR | Precision | F1 |
|---|---|---|---|---|---|
| CRISP | LLM-compiled descriptors + Random Forest | Descriptor 50 za kanuni za kemia zinazoweza kutekelezwa | 0,855 | 0,858 | 0,856 |
| Expert-curated | Random Forest | Sifa 18 za muundo na fuwele zilizochaguliwa na wataalamu | 0,818 | 0,850 | 0,834 |
| CrystalNN | Random Forest | Fingerprint 122 za uratibu wa ndani | 0,665 | 0,666 | 0,665 |
| CFID | Random Forest | Descriptor 1.557 za kemia/seli/radial/angular | 0,597 | 0,584 | 0,590 |
| Robocrystallographer | Random Forest | Embedding ya 256D ya maelezo ya muundo | 0,458 | 0,421 | 0,438 |
| Raw CIF | Random Forest | Embedding ya 256D ya maandishi ya CIF | 0,388 | 0,389 | 0,388 |
| CSLLM | Fine-tuned LLM | Maandishi ya nyenzo yenye taarifa ya space-group | 0,802 | 0,786 | 0,794 |
| StructLLM | Fine-tuned LLM | Maelezo ya muundo ya Robocrystallographer | 0,728 | 0,728 | 0,728 |
| SynCry | Fine-tuned LLM | Maandishi ya nyenzo bila taarifa ya space-group | 0,707 | 0,708 | 0,707 |
| PU-CGCNN | Graph-based PU learning | Grafu ya fuwele | 0,596 | 0,598 | 0,597 |
| GPT-4o | Prompted general-purpose LLM | Maandishi ya nyenzo bila taarifa ya space-group | 0,073 | 0,073 | 0,073 |
| Llama-3-8B | Prompted general-purpose LLM | Maandishi ya nyenzo bila taarifa ya space-group | 0,076 | 0,072 | 0,074 |
Kikomo cha kulinganisha: Jedwali lina aina mbili tofauti za ulinganisho. CRISP, Expert-curated, CrystalNN, CFID, Robocrystallographer na Raw CIF zimelinganishwa chini ya mtumiaji yuleyule wa PU Random Forest; hapa kigezo kikuu kinachobadilika ni umbo la uwakilishi. CSLLM, StructLLM, SynCry na PU-CGCNN zimelinganishwa kwa pipeline zao za awali za utabiri, kwa hiyo uwakilishi na predictor vyote vinabadilika. Hivyo, safu zote haziwezi kutafsiriwa kama “tofauti ya descriptor pekee”.
Kwa nini descriptor nyingi zaidi si bora moja kwa moja?
CRISP ina vipimo 50, uwakilishi wa Expert-curated una vipimo 18, na CFID ina vipimo 1.557. Hata hivyo, chini ya Random Forest ileile, mpangilio wa F1 ulikuwa CRISP > Expert-curated > CrystalNN > CFID.
Matokeo haya yanaonyesha kuwa idadi ya descriptor peke yake haiamui ubora wa taarifa. Idadi kubwa ya sifa za jumla si lazima iwe na manufaa zaidi kuliko katalogi ndogo lakini inayolenga zaidi maarifa ya kemia yenye maana kwa lengo.
Nini kilitokea wakati data ilikuwa chache?
Wakati %5 tu ya sehemu ya mafunzo ilitumika:
- CRISP F1 = 0,618,
- Expert-curated F1 = 0,577,
- F1 za uwakilishi nne za jumla = 0,261–0,403
zilibaki katika masafa hayo.
Hili ni dhibitisho ndani ya utafiti kwamba maarifa ya kemia yaliyokusanywa yanaweza kusaidia hasa wakati kiasi cha data ni kidogo. Haijaonyeshwa kwamba yatatoa moja kwa moja faida ya ukubwa uleule katika seti nyingine za data.
CIF ni nini?
Crystallographic Information File (CIF) ni muundo wa maandishi uliosanifishwa ambapo taarifa ya muundo wa fuwele huwakilishwa kwa data za kioo kama vigezo vya unit cell, aina za atomi, nafasi za atomi na taarifa ya ulinganifu.
Katika ulinganisho wa Raw-CIF, maandishi haya yote yalibadilishwa kwa text-embedding-3-large kuwa embedding ya vipimo 256.
CrystalNN, CFID na Robocrystallographer zinawakilisha nini?
- CrystalNN: hutumia fingerprint za vipimo 122 za mazingira ya uratibu wa ndani.
- CFID: huunganisha katika vipimo 1.557 usambazaji unaohusiana na kemia, seli, radial, angular, dihedral na chaji.
- Robocrystallographer: hutengeneza kiotomatiki maelezo ya muundo kwa lugha asilia kutoka muundo wa fuwele; utafiti huu ulitumia maelezo hayo kama embedding ya vipimo 256.
- Raw CIF: hubadilisha maandishi ghafi ya UTF-8 ya faili ya crystallographic kuwa embedding ya vipimo 256.
Kwa Nini Mabadiliko ya Usambazaji ni Kiini cha Utafiti Huu?
Mabadiliko ya usambazaji ni hali ambapo mifano ya majaribio hutofautiana kwa utaratibu na usambazaji wa muundo au kemia uliyoonekana wakati wa mafunzo; madai makuu ya CRISP si tu kuongeza F1 ya benchmark ya kawaida, bali kwamba kanuni za kemia zilizokusanywa zinaweza kuhifadhi ishara zaidi ya utabiri katika hali za nje ya usambazaji kama miundo mikubwa ya fuwele na familia za kemia ambazo hazikuonekana kabisa wakati wa mafunzo.
Mabadiliko ya ukubwa wa muundo
Modeli zilizofundishwa kwenye MP30 zilitumika bila kufundishwa upya kwa miundo 23.525 ya Materials Project yenye site 31–49.
| Uwakilishi | F1 |
|---|---|
| CRISP | 0,420 |
| Expert-curated | 0,384 |
| CFID | 0,355 |
| Uwakilishi mwingine mitatu ya jumla | Masafa 0,278–0,318 |
Thamani hizi zote hupima uhamishaji kutoka usambazaji uleule wa mafunzo wa MP30 kwenda kwenye uwakilishi wa fuwele kubwa zaidi.
Mabadiliko ya familia ya kemia
Katika jaribio la pili la uhamishaji, familia moja kati ya nane za nyenzo iliondolewa kabisa kwenye mafunzo, modeli ikafundishwa kwenye familia nyingine, kisha ikajaribiwa kwenye familia ambayo haikuwa imeiona.
| Uwakilishi | Macro F1 |
|---|---|
| CRISP | 0,537 |
| Expert-curated | 0,373 |
| CrystalNN | 0,344 |
| Uwakilishi mwingine | 0,140–0,235 |
“Wastani wa macro” ni wastani wa skori za kila familia ya kemia kwa uzito sawa bila kujali ukubwa wa familia:
\[ F1_{\mathrm{macro}} = \frac{1}{K} \sum_{k=1}^{K}F1_k \]
Katika jaribio hili kuna familia \(K=8\) za kemia.
Kwa nini exact sign test p=0,0078 ilitokea?
CRISP ilipata F1 ya juu kuliko udhibiti wa Expert-curated katika familia zote nane za kemia zilizobainishwa mapema.
Ikiwa uwezekano wa kila mbinu kushinda katika kila familia unachukuliwa kuwa sawa na %50, uwezekano wa ulinganisho wote nane kwenda upande wa mbinu ileile katika two-sided exact sign test ni:
\[ p= 2\left(\frac{1}{2}\right)^8 = \frac{2}{256} = 0.0078125 \]
Thamani ya p=0,0078 katika chanzo inaendana na matokeo haya.
Jaribio hili halitathmini ukubwa wa tofauti za F1, bali uwezekano wa kutokea kwa bahati kwamba tofauti zote nane zina mwelekeo uleule.
Tofauti katika intermetallics
Chanzo kinatoa familia ya intermetallic kama mfano mahsusi:
- CRISP F1 = 0,764,
- CrystalNN F1 = 0,508,
- Expert-curated F1 = 0,418.
Waandishi wanatafsiri hili kama ushahidi kwamba katalogi pana ya CRISP inaweza kuhifadhi baadhi ya taarifa za kemia maalumu kwa familia ambazo hazijawakilishwa vya kutosha katika sifa chache zilizochaguliwa na wataalamu.
Ulinganisho wa nje ya usambazaji na modeli za end-to-end
Katika jaribio la miundo mikubwa, TPR iliyokalibishwa ilikuwa:
- CRISP = 0,839,
- CSLLM = 0,754,
- PU-CGCNN = 0,574.
Wastani wa macro juu ya familia nane za kemia ambazo hazikuonekana:
| Pipeline | TPR | PU precision iliyokadiriwa |
|---|---|---|
| CRISP | 0,587 | 0,589 |
| CSLLM | 0,483 | 0,477 |
| PU-CGCNN | 0,244 | 0,243 |
Udhibiti wa muda 2022 → 2026
Watafiti walifanya udhibiti wa retrospektivu kwenye miundo 334 ambayo ilikuwa isiyo na lebo katika snapshot ya Materials Project ya Oktoba 2022 lakini ikawa rekodi chanya kufikia Aprili 2026.
%94,6 ya skori za CRISP za miundo hii ilikuwa juu ya kizingiti nominal 0,5.
Kikomo cha tafsiri: Matokeo haya hayamaanishi kwamba CRISP iligundua kwa kujitegemea na kwa majaribio usanisi wa nyenzo mpya 334 mapema. Uchambuzi ni wa retrospektivu na unachunguza uhusiano kati ya mabadiliko ya hali ya hifadhidata kwa muda na skori ya modeli.
Mbinu na Matokeo ya Utafiti
Je, marudio ya kanuni yanaamua umuhimu wa utabiri?
Hapana. Katika chanzo, cluster za kanuni zilipewa faharasa kulingana na mara ngapi zilizozalishwa na LLM, lakini hakuna uhusiano wenye maana uliopatikana kati ya marudio ya uzalishaji na thamani ya Random Forest importance au mchango wa wastani wa absolute SHAP.
Kwa mfano, kanuni zilizozalishwa mara chache zaidi kama:
- mkengeuko wa stoikiometria — R42,
- antisite formation-energy proxy — R45
zilionyesha michango ya utabiri inayotambulika.
Matokeo haya yanaonyesha tofauti ifuatayo: dhana kukumbukwa kwa urahisi na mara nyingi na LLM si kitu kilekile na descriptor inayokokotoa dhana hiyo kuwa ya manufaa kweli kwa modeli.
Kwa nini Energy above hull ni muhimu?
Energy above hull ni kipimo cha uthabiti wa thermodynamics kinachoonyesha nyenzo iko juu kiasi gani kwa nishati ikilinganishwa na mchanganyiko unaowezekana wa awamu thabiti zenye muundo wa jumla uleule. Miundo iliyo kwenye Convex hull ina energy-above-hull karibu na sifuri, huku thamani za juu zaidi zinaweza kuonyesha ongezeko la metastability ya thermodynamics.
Katika uchambuzi wa global descriptor importance wa CRISP, energy above hull ilikuwa descriptor muhimu zaidi. Hata hivyo, descriptor hii pekee haikuamua madarasa; chanzo kinaripoti kwamba hakuna descriptor moja iliyotoa mgawanyiko wa darasa karibu deterministic.
Descriptor 10 muhimu zaidi zilibeba taarifa kiasi gani?
Kulingana na mpangilio wa importance uliotolewa kutoka data ya mafunzo, kutumia descriptor 10 za juu pekee kulitoa F1=0,816. Subset zilizoanzia descriptor zenye importance ya chini zilirejesha utendaji polepole zaidi.
Hii inaonyesha kwamba sehemu kubwa ya utendaji ndani ya usambazaji hubebwa na kiini kidogo. Lakini chanzo pia kinaonyesha kwamba katalogi kamili ni imara zaidi chini ya mabadiliko ya ukubwa wa muundo na familia za kemia.
Kwa maneno mengine, baadhi ya kanuni za kemia zinazoonekana zisizo za lazima katika usambazaji wa mafunzo zinaweza kuwa na manufaa wakati wa kuhamia familia mpya ya nyenzo.
Familia za descriptor
Uainishaji wa post hoc wa wataalamu uligawanya taarifa katika descriptor hasa katika familia hizi za fizikia-kemia:
- thermodynamics,
- grafu-mahusiano,
- jiometri,
- muundo wa kikemia.
GPT-5 kwanza ilipendekeza lebo za importance za A/B/C, kisha wataalamu wawili wa eneo hilo walikagua descriptor kwa pamoja na kubainisha lebo za mwisho kwa makubaliano. Kwa kuwa hakuna upimaji huru uliofanywa, metriki ya inter-rater agreement, yaani makubaliano kati ya wakadiriaji, haikufafanuliwa.
Ukaguzi wa Kifizikia wa DFT Unaonyesha Nini na Hauonyeshi Nini?
Ukaguzi wa DFT perturbation–relaxation unaonyesha kwamba miundo yenye skori kubwa ya CRISP inahusishwa na kupata jiometri mbadala katika eneo la karibu ambazo hupunguza nishati kwa kiwango kidogo chini ya usumbufu mdogo wa koordinati uliowekwa; huu ni ukaguzi huru wa ulinganifu wa kifizikia kwa uimara wa muundo wa ndani, lakini hauthibitishi moja kwa moja kinetiki ya usanisi, uwezo wa kutengenezwa maabara au uimara wa majaribio.
Makundi ya DFT
Makundi matatu yalichaguliwa:
- miundo 50 chanya inayojulikana yenye skori ya juu,
- miundo 50 isiyo na lebo yenye skori ya juu,
- miundo 50 isiyo na lebo yenye skori ya chini.
Kwa kila muundo mkuu, koordinati za sehemu za atomi zilisogezwa kwa nasibu kwa %1 na miundo 10 iliyofanyiwa perturbation ikatengenezwa. Random seed zilezile kumi zilitumika kwa makundi yote matatu.
Uimara wa ndani ulitathminiwaje?
Kila muundo ulioperturbishwa ulifanyiwa relaxation kwa DFT, na baada ya relaxation nishati ililinganishwa kwa kila atomu dhidi ya nishati ya muundo mkuu.
Kizingiti kikuu kilikuwa:
\[ \Delta E<-0.02\;\mathrm{eV/atom} \]
ilitumika kama kizingiti.
Urelax wa perturbation hadi nishati iliyo angalau 0,02 eV/atom chini ya muundo mkuu unaonyesha kwamba jiometri yenye nishati ya chini inaweza kupatikana katika nafasi ya karibu ya usanidi. Tukio hili kuonekana katika perturbation nyingi zaidi za muundo mkuu uleule lilihusishwa na chanzo na uimara mdogo wa muundo wa ndani.
| Kundi | Idadi ya miundo mikuu | 10/10 perturbation zilizopita kizingiti |
|---|---|---|
| Chanya inayojulikana yenye skori kubwa | 50 | 1 |
| Isiyo na lebo yenye skori kubwa | 50 | 4 |
| Isiyo na lebo yenye skori ndogo | 50 | 12 |
Mpangilio uleule wa ubora uliendelea wakati vizingiti vya 0,01 na 0,03 eV/atom vilipotumika.
Masharti ya hesabu za DFT
| Parameta | Thamani / mbinu |
|---|---|
| Programu | VASP 5.4.4 |
| Mbinu ya kiini-elektroni | Projector-augmented-wave (PAW) |
| Exchange-correlation | PBE |
| Spin | Spin-polarized |
| Plane-wave cutoff | 520 eV |
| Convergence ya elektroni — relaxation | 1 × 10⁻⁴ eV |
| Convergence ya elektroni — static | 1 × 10⁻⁵ eV |
| Kigezo cha ionic relaxation | Mabadiliko ya nishati 1 × 10⁻³ eV |
| Gaussian smearing | 0,05 eV |
| k-point | Γ-centered mesh |
| Perturbation | Uhamishaji wa nasibu wa %1 katika koordinati zote za sehemu |
| Ufanano wa muundo | Umbali wa Euclidean wa CrystalNN fingerprint ndani ya matminer |
Kikomo cha udhibiti huu wa kifizikia
Muundo kuwa imara katika mazingira ya nishati ya ndani dhidi ya perturbation ndogo hakuonyeshi kwamba kuna njia ya mmenyuko inayofikika wakati wa usanisi halisi. Usanisi halisi unaweza kutegemea mambo mengi ya ziada kama joto, shinikizo, prekursor, vizuizi vya kinetiki, mabadiliko ya awamu na utaratibu wa majaribio.
Kwa hiyo utafiti hautafsiri matokeo ya DFT audit kama “CRISP ilijifunza kinetiki ya usanisi”.
Kazi ya nishati ya uundaji
Katika regression ya nishati ya uundaji, rekodi 99.186 zenye nishati ya uundaji yenye thamani finiti zilitumika. Ukubwa wa katalogi ya CRISP katika kazi hii ni descriptor 25.
Katika modeli za regression, RandomForestRegressor ilitumika na miti 100. Katika migawanyo mitatu ya GroupShuffleSplit, %20 ya miundo ilitengwa kwa majaribio. Uwiano wa mafunzo ulikuwa:
5%, 10%, 20%, 40%, 60%, 80% na 100%
ukitumika kama subset zilizopachikwa.
MAE inamaanisha nini?
Mean Absolute Error (MAE), yaani kosa la wastani la thamani kamili, ni wastani wa tofauti za thamani kamili kati ya utabiri na thamani halisi:
\[ MAE= \frac{1}{n} \sum_{i=1}^{n} |y_i-\hat{y}_i| \]
\(y_i\) ni thamani halisi, \(\hat{y}_i\) ni utabiri wa modeli, na \(n\) ni idadi ya mifano. Kadiri MAE inavyopungua, kosa la wastani la utabiri hupungua.
R² inamaanisha nini?
Ufafanuzi wa kawaida wa coefficient of determination ni:
\[ R^2= 1- \frac{\sum_i(y_i-\hat{y}_i)^2} {\sum_i(y_i-\bar{y})^2} \]
Kukaribia kwa \(R^2\) kwenye 1 kunaonyesha kwamba utabiri unaeleza sehemu kubwa ya tofauti za kigezo lengwa. R² hasi inaweza kuonyesha kwamba katika baadhi ya hali za majaribio modeli hufanya vibaya kuliko hata utabiri rahisi wa wastani.
Matokeo ya nishati ya uundaji
| Uwakilishi | MAE (eV/atom) |
|---|---|
| CRISP 25D | 0,130 |
| Expert-curated 17D | 0,131 |
| CFID | 0,160 |
| CrystalNN | 0,344 |
| Robocrystallographer | 0,384 |
| Raw CIF | 0,387 |
Chanzo pia kinaripoti R2=0,961 kwa CRISP.
Katika uhamishaji kwenda familia nane za kemia ambazo hazikuonekana, macro R2 ilikuwa:
- CRISP = 0,564,
- Expert-curated = 0,474,
- CFID = 0,323.
Uwakilishi mwingine haukuweza kudumisha macro R2 chanya katika familia nane.
Seti ya data ya uendeshaji wa ioniki
Kazi ya uendeshaji wa ioniki katika joto la kawaida ina elektrolaiti dhabiti 503 zisizo za kikaboni.
Lengo limeelezwa kama:
\[ \log_{10}\left[\frac{\sigma}{\mathrm{S/cm}}\right] \]
imeelezwa kwa namna hii.
Hapa \(\sigma\) ni uendeshaji wa ioniki. Kugawa uendeshaji kwa kitengo S/cm huweka uwiano usio na dimension ndani ya logariti; modeli hutabiri moja kwa moja logariti ya msingi 10 ya uendeshaji.
Mgawanyo wa data ulikuwa reduced-formula-group-disjoint kwa:
- 404 mafunzo,
- 99 majaribio
.
Matokeo ya uendeshaji wa ioniki
| Uwakilishi | Test MAE (log unit) |
|---|---|
| CRISP 25D | 1,229 |
| CFID | 1,329 |
| Robocrystallographer | 1,461 |
| CrystalNN | 1,518 |
| Raw CIF | 1,550 |
Thamani ya test R2 ya CRISP ni 0,570.
Kisha CRISP ilifundishwa kwenye miundo yote 503 ya seti ya maendeleo na kujaribiwa bila kufundishwa upya kwenye kohorti ya nje iliyokusanywa kwa mkono ya elektrolaiti dhabiti 150 ambazo hazikuwa katika mkusanyiko huo:
| Metriki ya uthibitishaji wa nje | CRISP |
|---|---|
| MAE | 1,170 log unit |
| R2 | 0,476 |
| Spearman ρ | 0,721 |
Spearman ρ ni metriki ya rank-correlation inayopima jinsi viwango vya vigezo viwili vinavyobadilika pamoja zaidi kuliko thamani zao kamili. ρ=0,721 inaonyesha uhusiano chanya katika kohorti hii ya nje kati ya mpangilio wa uendeshaji uliotabiriwa na mpangilio ulioonekana.
Hata hivyo, chanzo kinasema wazi kwamba udhibiti wa descriptor 18 uliochaguliwa kwa mkono kwa kutumia maarifa maalumu ya kitaalamu kuhusu usafirishaji wa ion ulifanya vizuri zaidi kuliko CRISP. Katika PDF kuu, matokeo kamili ya namba ya udhibiti huo wa kitaalamu yanaelekezwa kwenye Figure S20; kwa kuwa thamani sahihi za figua hiyo ya ziada hazijatolewa katika PDF kuu, Verianla haizitengenezi.
Kwa nini matokeo ya moduli ya shear ni kikomo muhimu?
Kazi ya moduli ya shear inahusisha miundo 10.794 inayofaa. Chanzo kinasema kwamba katika kazi hii descriptor za kijiometri endelevu zenye ufafanuzi finer zilifanya vizuri zaidi kuliko CRISP.
Matokeo haya yanaonyesha kwamba CRISP si uwakilishi wa ulimwengu wote usiotegemea kazi. Ikiwa lengo linategemea sana taarifa ya kijiometri yenye ufafanuzi wa juu na endelevu, katalogi ndogo ya descriptor iliyokusanywa kutoka kanuni za kemia za lugha asilia inaweza kutokuwa na ufafanuzi unaohitajika.
Muhtasari mkuu wa namba wa utafiti
| Kazi / jaribio | Matokeo ya CRISP | Ulinganisho / kikomo muhimu |
|---|---|---|
| Uwezo wa kusanisiwa wa MP30 | F1=0,856 | Expert-curated 0,834 |
| %5 data ya mafunzo | F1=0,618 | Expert-curated 0,577 |
| Mabadiliko ya ukubwa wa muundo MP > 30 | F1=0,420 | Expert-curated 0,384 |
| Familia 8 za kemia ambazo hazikuonekana | Macro F1=0,537 | Expert-curated 0,373; p=0,0078 |
| Udhibiti wa muda 2022 → 2026 | Skori >0,5 katika %94,6 ya miundo 334 | Udhibiti wa retrospektivu; si ugunduzi wa majaribio |
| Nishati ya uundaji | MAE=0,130 eV/atom; R2=0,961 | Expert MAE=0,131 |
| Nishati ya uundaji, familia ambazo hazikuonekana | Macro R2=0,564 | Expert 0,474; CFID 0,323 |
| Uendeshaji wa ioniki, jaribio la ndani | MAE=1,229; R2=0,570 | MAE ya chini zaidi kati ya uwakilishi wa jumla |
| Uendeshaji wa ioniki, kohorti ya nje ya miundo 150 | MAE=1,170; R2=0,476; ρ=0,721 | Udhibiti wa descriptor maalumu wa kitaalamu ulikuwa bora |
| Moduli ya shear | CRISP si bora zaidi | Descriptor endelevu za kijiometri zenye ufafanuzi finer ni bora |
Matokeo yanayoungwa mkono na utafiti
- Kanuni za kemia za lugha asilia zinazozalishwa na LLM zinaweza kubadilishwa kuwa descriptor zinazoweza kutekelezwa na kukaguliwa.
- Descriptor za CRISP zilipata F1 ya juu kwenye benchmark ya MP30 kuliko uwakilishi wa jumla na descriptor 18 zilizochaguliwa na wataalamu zilizolinganishwa chini ya PU Random Forest ileile.
- Faida ya CRISP iliongezeka chini ya mabadiliko ya ukubwa wa muundo na familia za kemia.
- Baadhi ya kanuni zinazozalishwa mara chache zinaweza kubeba taarifa muhimu ya utabiri; marudio ya uzalishaji wa LLM si proxy ya kuaminika ya feature importance.
- Katalogi kamili ya descriptor inaweza kutoa taarifa za ziada wakati wa mabadiliko ya usambazaji ambazo zinaweza kuonekana zisizo za lazima ndani ya usambazaji.
- Skori za juu za CRISP zilihusishwa na uimara mkubwa wa muundo wa ndani chini ya protokali ya DFT perturbation iliyotumika.
- CRISP ilipata kosa la ndani ya usambazaji linalofanana na uwakilishi mdogo wa kitaalamu katika nishati ya uundaji.
- CRISP ilipata MAE ya chini kuliko uwakilishi wa jumla wa fuwele katika uendeshaji wa ioniki na kuhamisha taarifa hadi kohorti huru ya miundo 150.
- Baada ya katalogi ya descriptor kujengwa, LLM inference kwa kila nyenzo haihitajiki.
- Kwa kuwa kila descriptor inaweza kuhusishwa na kanuni ya kemia iliyopewa jina na programu inayoweza kukaguliwa, uwakilishi unaweza kukaguliwa na kufanyiwa ablation.
Matokeo ambayo utafiti hauungi mkono
- Skori ya CRISP si dhamana kwamba fuwele inaweza kusanisiwa kwa hakika maabara.
- Mifano isiyo na lebo si hasi halisi.
- Haijaonyeshwa kwamba miundo iliyokuwa chanya kufikia 2026 “iligunduliwa” kwa majaribio na CRISP.
- Ukaguzi wa DFT perturbation haupimi moja kwa moja kinetiki ya usanisi au uimara wa majaribio.
- CRISP si uwakilishi bora zaidi kwa sifa zote za nyenzo.
- Katika uendeshaji wa ioniki, haikupita udhibiti wa descriptor maalumu kwa kazi wa wataalamu.
- Haijaonyeshwa kuwa ni bora kuliko descriptor za kijiometri zenye ufafanuzi finer katika moduli ya shear.
- Ubora wa LLM kama modeli ya moja kwa moja ya mwisho ya utabiri haujaonyeshwa; mchango mkuu wa CRISP upo katika hatua ya knowledge compilation.
- F1=0,856 si kiwango cha mafanikio ya usanisi wa maabara katika ulimwengu halisi.
- Thamani za PU precision hazipaswi kutafsiriwa moja kwa moja kama precision ya uainishaji wa kawaida wenye lebo kamili.
Vikwazo vikuu vya kimethodolojia vya utafiti
Muundo wa lebo za PU: Kazi ya uwezo wa kusanisiwa haina darasa hasi halisi. Matokeo yanategemea dhana za benchmark ya chanya/isiyo na lebo na dhana ya latent-positive prevalence ya α=0,0567.
Utegemezi wa lengo: Mafanikio ya CRISP yanategemea kiwango cha ufafanuzi wa taarifa kinachohitajika na sifa lengwa. Matokeo ya moduli ya shear yanaonyesha kikomo hiki wazi.
Maarifa ya awali ya wataalamu bado yana thamani: Katika seti ndogo ya data ya uendeshaji wa ioniki, descriptor zenye nguvu za wataalamu maalumu kwa kazi zilipita CRISP.
Matumizi ya proprietary LLM: Utekelezaji wa sasa hutumia modeli proprietary za lugha katika hatua za kutengeneza kanuni, kuziunganisha na kutengeneza msimbo. Kwa upande mwingine, waandishi wanasema walichapisha maandishi ya mwisho ya kanuni, programu za descriptor na rekodi za audit ili kudumisha ufuatiliaji wa uwakilishi uliotumika katika matokeo.
Kronolojia ya maendeleo ya katalogi: Katalogi K=50, bajeti ya miito 1.000 na mgawanyo wa kwanza wa MP30 zilibainishwa katika hatua ya awali ya maendeleo. Chanzo kinaeleza uchambuzi wa Figure S4 wa ukubwa wa katalogi na Figure S3 wa classifier kama uchambuzi wa retrospektivu wa sensitivity, si prospective model-selection.
Jaribio la familia ya kemia si element-disjoint: Uhamishaji kwa familia hupima taxonomy-level transfer; haimaanishi kwamba elementi zote katika familia inayojaribiwa ziliondolewa kwenye mafunzo.
Nguvu katika uzalishaji upya
- Prompt zimeshirikiwa katika Supporting Information.
- Utaratibu wa kuunganisha kanuni umeelezwa.
- Misimbo ya descriptor zinazoweza kutekelezwa imechapishwa.
- Rekodi za Code audit zimeshirikiwa.
- Imearifiwa kwamba msimbo wa mafunzo na tathmini ya modeli unapatikana kupitia GitHub.
- Data ya miundo ya MP30 inapatikana kupitia Materials Project.
- Zenodo DOI ya seti ya maendeleo ya uendeshaji wa ioniki ya miundo 503 imetolewa.
- Benchmark ID zilizogandishwa zimedumishwa kwa pamoja kati ya modeli tofauti.
Maelezo ya Chanzo na Mbinu
Utafiti asilia: Compiling Chemical Knowledge into Executable Descriptors for Materials Prediction
Waandishi: Jaehwan Choi; Kunik Jang; Seongmin Kim; Shuan Chen; Kyungju Nam; Seung Hyo Noh; Donghwi Kim; Yousung Jung.
Mwandishi anayewasiliana: Yousung Jung.
Barua pepe: yousung.jung@snu.ac.kr
Taasisi 1: Department of Chemical and Biological Engineering (BK21 four), and Institute of Chemical Processes, Seoul National University, 1 Gwanak-ro, Gwanak-gu, Seoul 08826, Korea.
Taasisi 2: Institute of Engineering Research, Seoul National University, 1 Gwanak-ro, Gwanak-gu, Seoul 08826, Korea.
Taasisi 3: Materials Research & Engineering Center, Hyundai Motor Company, Uiwang-si, Gyeonggi-do, Republic of Korea.
Aina ya chanzo: arXiv preprint; utafiti wa sayansi ya nyenzo za kikokotozi na ujifunzaji wa mashine.
Kitambulisho cha arXiv: arXiv:2608.27587.
Muundo wa arXiv DOI: 10.48550/arXiv.2608.27587.
Tarehe ya rekodi ya arXiv: 27 Agosti 2026.
Eneo: Materials Science / cond-mat.mtrl-sci.
Hali ya peer review: Toleo lililochunguzwa ni preprint. Kufikia 4 Novemba 2026, hakuna toleo tofauti la jarida lililopitia peer review lililothibitishwa.
Rekodi rasmi: arXiv:2608.27587.
Leseni: Hakuna tamko la wazi la Creative Commons linaloonekana katika maandishi ya PDF kuu iliyopakiwa; uainishaji wa leseni usiopo kwenye chanzo haujaongezwa.
Mchango sawa: Hakuna tamko la mchango sawa/waandishi wenza wa kwanza katika PDF kuu.
Mbinu kuu: CRISP — mfumo wa ugunduzi wa kanuni za kemia unaosaidiwa na LLM, uunganishaji wa kanuni na ukusanyaji wa descriptor za skala zinazoweza kutekelezwa.
Kifupi CRISP: Hakuna ufafanuzi wazi uliotolewa katika PDF kuu.
Ugunduzi wa kanuni za uwezo wa kusanisiwa: gpt-4.1-mini-2025-04-14; miito 1.000; kanuni wagombea 10 kwa kila mwito; jumla ya kanuni 10.000 za lugha asilia.
Embedding ya kanuni: text-embedding-3-large; L2 normalization → PCA → normalization tena.
Clustering: k-means; 50 cluster; 50 centroid initialization; kiwango cha juu cha iteration 1.000; random seed 42.
Uunganishaji wa kanuni: GPT-5; kanuni mwakilishi 50 kwa uwezo wa kusanisiwa.
Katalogi za kanuni za regression: Familia 25 za kanuni kwa nishati ya uundaji, moduli ya shear na uendeshaji wa ioniki.
Uzalishaji wa msimbo wa descriptor: gpt-4.1-2025-04-14; temperature=0; kila kazi huzalisha pato moja la skala la floating-point.
Uingiliaji wa binadamu: Katika maandalizi ya msimbo, execution repair pekee kwa makosa ya syntax, type, import na runtime; chanzo kinasema mantiki ya kemia haikubadilishwa.
Udhibiti wa uvujaji wa lengo: Matumizi ya thamani za lengo, target-trained surrogate na ingizo za proxy za moja kwa moja zilizokatazwa kwa kazi yalizuiwa katika uzalishaji wa descriptor.
MP30: Miundo 100.194; 38.347 P na 61.847 U.
Mafunzo ya MP30: Miundo 90.174; 34.512 P na 55.662 U.
Jaribio la MP30: Miundo 10.020; 3.835 P na 6.185 U.
Modeli ya uwezo wa kusanisiwa: Bagged Positive–Unlabeled Random Forest.
Idadi ya bag: 50.
Kila Random Forest: 100 estimator; zaidi ya hapo mipangilio ya default ya scikit-learn.
α: 0,0567; prevalence inayodhaniwa ya chanya zilizofichika ndani ya pool isiyo na lebo.
Matokeo ya CRISP MP30: TPR=0,855; estimated precision=0,858; F1=0,856.
Uhamishaji wa ukubwa wa muundo: Modeli zilizofundishwa kwenye MP30 zilitathminiwa bila kufundishwa upya kwenye miundo 23.525 yenye site 31–49; CRISP F1=0,420.
Uhamishaji wa familia ya kemia: Familia nane zilijaribiwa kwa mpangilio wa leave-one-family-out; CRISP macro F1=0,537; Expert-curated=0,373; exact sign test p=0,0078.
Udhibiti wa muda: Katika %94,6 ya miundo 334 iliyokuwa U mwaka 2022 na kuwa chanya mwaka 2026, skori ya CRISP ilikuwa juu ya 0,5; uchambuzi ni wa retrospektivu.
Feature attribution: Random Forest impurity importance, TreeSHAP, held-out permutation importance na uchambuzi wa fit uliorudiwa.
Makundi ya DFT audit: 50 chanya zinazojulikana zenye skori ya juu + 50 U zenye skori ya juu + 50 U zenye skori ya chini; coordinate perturbation 10 za %1 kwa kila muundo.
DFT: VASP 5.4.4; PAW; PBE; spin-polarized; 520 eV plane-wave cutoff; Gaussian smearing 0,05 eV; Γ-centered k-point mesh.
Kikomo cha tafsiri ya DFT: Uchambuzi wa perturbation–relaxation huchunguza uhusiano na uimara wa muundo wa ndani; si ushahidi wa kinetiki ya usanisi au utekelezekaji wa majaribio.
Idadi ya data ya nishati ya uundaji: Miundo 99.186.
Nishati ya uundaji CRISP: MAE=0,130 eV/atom; R2=0,961.
Uhamishaji wa familia ya kemia wa nishati ya uundaji: Macro R2=0,564.
Idadi ya data ya moduli ya shear: Miundo 10.794.
Kikomo cha moduli ya shear: Descriptor endelevu za kijiometri zenye ufafanuzi finer zilifanya vizuri zaidi kuliko CRISP; PDF kuu inaelekeza skori sahihi kwenye Supporting Information.
Seti ya maendeleo ya uendeshaji wa ioniki: Elektrolaiti dhabiti 503 zisizo za kikaboni; 404 mafunzo / 99 majaribio.
Lengo la uendeshaji wa ioniki: log10[σ/(S/cm)].
Jaribio la ndani la CRISP kwa uendeshaji wa ioniki: MAE=1,229 log unit; R2=0,570.
Kohorti ya nje ya uendeshaji wa ioniki: Miundo 150; ilikusanywa kwa mkono nje ya miundo 503 ya seti ya maendeleo.
Kohorti ya nje ya CRISP: MAE=1,170 log unit; R2=0,476; Spearman ρ=0,721; hakuna refitting iliyofanywa katika kohorti ya nje.
Kikomo cha uendeshaji wa ioniki: Udhibiti wa descriptor 18 maalumu kwa kazi wa wataalamu ulifanya vizuri zaidi kuliko CRISP.
Regression learner: RandomForestRegressor; miti 100; zaidi ya hapo mipangilio ya default ya scikit-learn.
Migawanyo ya nishati ya uundaji / moduli ya shear: GroupShuffleSplit tatu; %20 test; material identifier grouping; viwango vya mafunzo %5, %10, %20, %40, %60, %80 na %100.
Preprocessing ya regression: Median imputation na zero-variance removal kwenye Training data.
Metriki za regression: MAE, RMSE, R2 na Spearman ρ.
Upatikanaji wa data: Miundo ya fuwele ya MP30 na metadata husika kutoka Materials Project; imeripotiwa kwamba seti ya maendeleo ya uendeshaji wa ioniki ya miundo 503 inapatikana kupitia Zenodo DOI 10.5281/zenodo.17157647.
Upatikanaji wa msimbo: Imeripotiwa kwamba msimbo chanzo, prompt, frozen rule catalogs, executable descriptor functions, pamoja na msimbo wa mafunzo, tathmini na figure-preparation umechapishwa katika snu-micc/CRISP GitHub repository.
Ufadhili: Hyundai Motor Group.
Mgongano wa maslahi: Kyungju Nam, Seung Hyo Noh na Donghwi Kim ni wafanyakazi wa Hyundai Motor Company. Utafiti uliungwa mkono na Hyundai Motor Group. Waandishi wengine hawakuripoti competing interest.
Michango ya waandishi: Jaehwan Choi alibuni utafiti; akaendeleza mbinu na programu; akafanya uchambuzi, validasheni, kuratibu data na figua; na kuandika rasimu ya kwanza. Kunik Jang alifanya uchambuzi wa DFT perturbation–relaxation, akaratibu na kuthibitisha seti za data za uendeshaji wa ioniki, na kuchangia tafsiri/uandishi. Seongmin Kim na Shuan Chen walichangia kuendeleza dhana ya awali ya utafiti na mijadala. Kyungju Nam, Seung Hyo Noh na Donghwi Kim walichangia mijadala ya mradi na kukagua makala. Yousung Jung aliongoza mradi, akachangia uundaji wa dhana na tafsiri, akapata ufadhili na kurekebisha makala. Waandishi wote waliidhinisha maandishi ya mwisho.
Kikomo kikuu cha tafsiri: Skori ya uwezo wa kusanisiwa ya CRISP si dhamana ya mafanikio halisi ya usanisi wa maabara, ufikikaji wa kinetiki au uzalishaji wa majaribio.
Kikomo kikuu cha upeo: Faida ya mbinu inategemea lengo; kazi ambazo maarifa ya awali ya wataalamu au uwakilishi wa kijiometri wenye ufafanuzi wa juu zaidi ni bora zimeripotiwa wazi katika chanzo.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *