


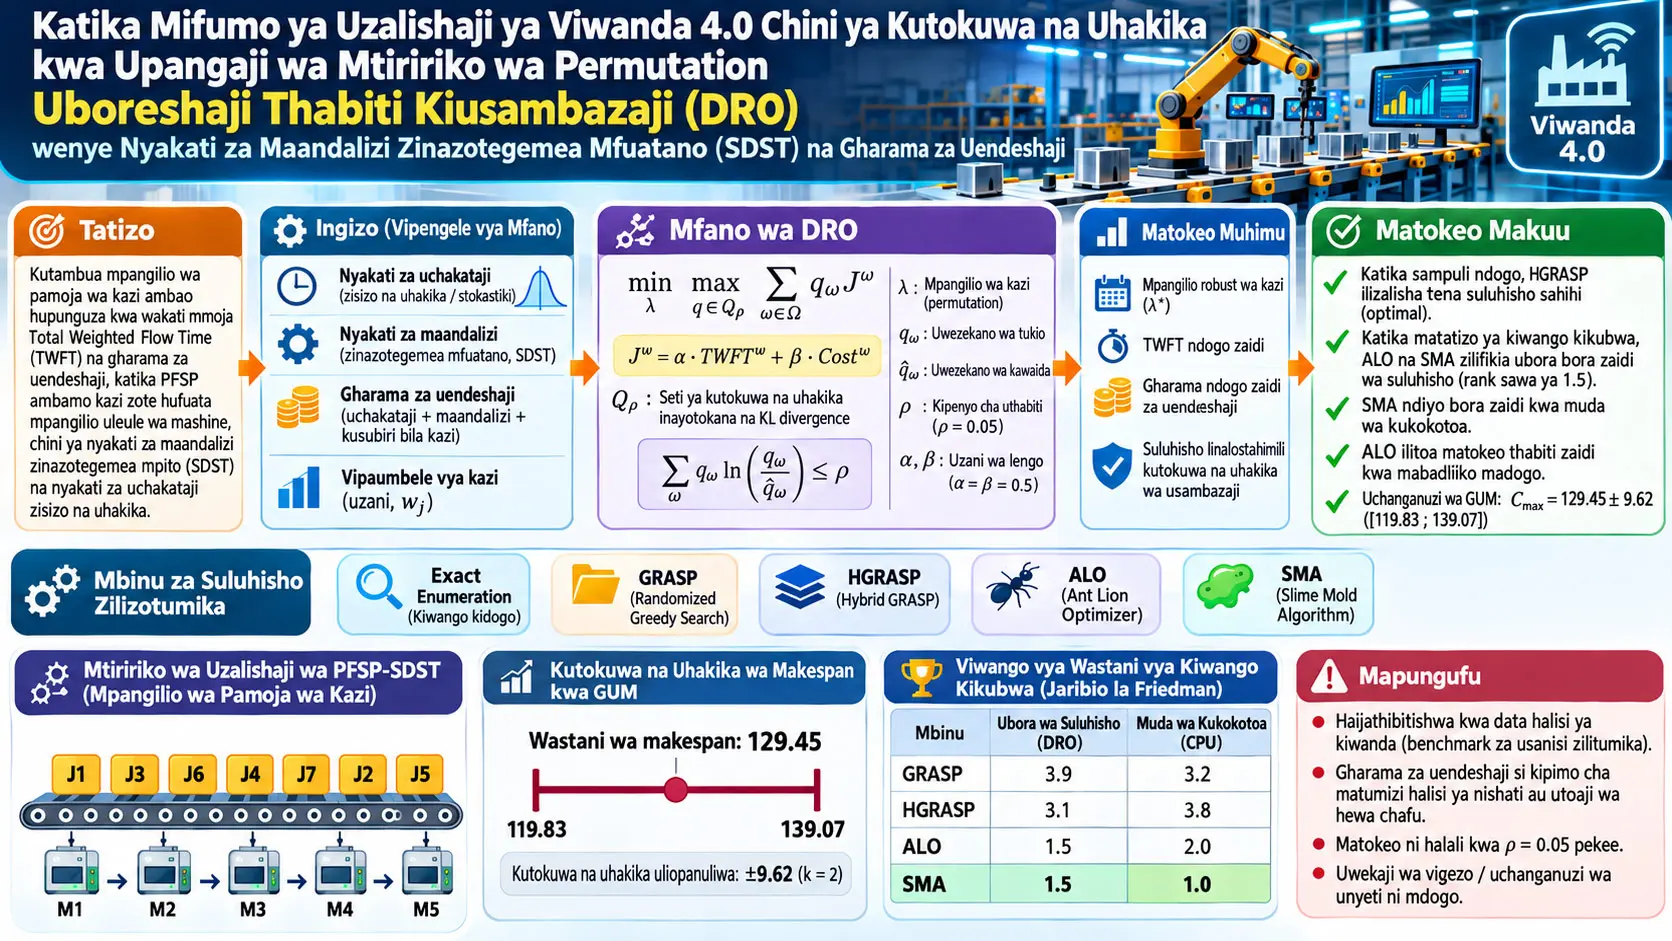
Uboreshaji Thabiti Kiusambazaji (Distributionally Robust Optimization, DRO) ni mkabala wa uboreshaji unaofanya maamuzi kwa kuzingatia matokeo mabaya zaidi yanayotarajiwa ndani ya ambiguity set yenye usambazaji mbalimbali unaowezekana, badala ya kudhani kuwa kigezo kisicho na uhakika kinatokana na usambazaji mmoja pekee wa uwezekano ulio kamili na unaojulikana. Utafiti huu unaunganisha DRO na muundo wa Permutation Flow Shop Scheduling Problem, ambamo kazi zote hupitia mashine kwa mpangilio uleule, nyakati za maandalizi zinazotegemea mfuatano (Sequence-Dependent Setup Times; SDST), processing times zisizo na uhakika na operational cost inayotokana na muda wa processing/setup/idle. Lengo ni kubainisha mpangilio mmoja wa kazi unaopunguza kwa pamoja Total Weighted Flow Time (TWFT) na operational cost katika fomula moja ya lengo yenye uzani.
Inakubaliwa kuwa processing-time distribution halisi haijulikani kikamilifu; processing scenarios za usanisi huundwa kuzunguka usambazaji wa kawaida, na scenario probability distributions zinazowezekana hutathminiwa ndani ya ambiguity set inayofafanuliwa kwa Kullback–Leibler divergence. Robustness radius \(\rho\) hudhibiti kiasi ambacho inaweza kuruhusiwa kujitenga na usambazaji wa kawaida. Kwa computational experiments zote kuu katika utafiti, \(\rho=0.05\) imewekwa bila kubadilishwa; kwa hiyo, viwango vya algorithms na matokeo ya robustness yaliyopatikana hayajathibitishwa kwa thamani tofauti za \(\rho\).
Kwa matatizo ya kiwango kidogo, suluhisho za global-optimum benchmark zilipatikana kwa mbinu ya exhaustive enumeration inayosaidiwa na IBM ILOG CPLEX. Kwa medium na large instances, Greedy Randomized Adaptive Search Procedure (GRASP), Hybrid GRASP (HGRASP) iliyopendekezwa na utafiti, Ant Lion Optimizer (ALO) na Slime Mold Algorithm (SMA) zililinganishwa. Katika mifano midogo, HGRASP ilizalisha upya exact benchmark zote zilizojaribiwa; mbinu nyingine za makadirio pia zilifikia matokeo exact au yaliyo karibu sana katika hali nyingi. Katika matatizo ya kiwango kikubwa, jaribio la Friedman lilionyesha kuwa kuna tofauti muhimu kati ya algorithms kwa solution quality na computational time. ALO na SMA zilifikia thamani sawa ya mean rank iliyo bora zaidi kwa solution quality na hazikupatikana kuwa tofauti kwa kiasi muhimu katika uchambuzi wa post-hoc; SMA ilifikia nafasi bora zaidi kwa computational time.
Utafiti haujathibitishwa kwa kutumia rekodi za uzalishaji kutoka kiwanda halisi. Processing times, setup times, job weights na machine cost coefficients zilitengenezwa kwa njia ya usanisi. Aidha, operational-cost coefficients si vipimo halisi vya matumizi ya umeme, nguvu, bei ya nishati au utoaji wa hewa chafu. Kwa hiyo, matokeo yanaonyesha tabia ya computational ya proposed DRO framework chini ya benchmark za usanisi; hayathibitishi kuwa akiba ileile ya gharama au nishati itapatikana katika kiwanda halisi cha Industry 4.0.
PFSP-SDST ni Nini na Ni Tatizo Gani Linalotatuliwa Katika Utafiti Huu?
PFSP-SDST ni tatizo la upangaji ratiba la kimchanganyiko ambamo kazi zilezile \(n\) hupitia mashine zilezile \(m\) kwa mfuatano uleule wa kiteknolojia na muda unaohitajika kuandaa mashine kwa kazi mpya hautegemei kazi hiyo pekee, bali pia kazi iliyochakatwa mara moja kabla yake; katika utafiti huu processing times pia zinachukuliwa kuwa stochastic na mpangilio mmoja wa kazi huchaguliwa ili kupunguza kwa pamoja TWFT na operational cost chini ya kutokuwa na uhakika.
Mantiki ya Permutation Flow Shop
Seti ya kazi:
\[ J=\{1,\ldots,n\} \]
na seti ya mashine:
\[ M=\{1,\ldots,m\} \]
imefafanuliwa.
Kila kazi hupitia mashine zote kwa mfuatano uleule. Zaidi ya hayo, si njia ya kiteknolojia pekee bali permutation ya kazi pia ni ya pamoja katika mashine zote. Kwa mfano:
\[ \lambda=[J_3,J_1,J_4,J_2] \]
ikichaguliwa, kazi kwenye mashine zote huendelea kwa mpangilio huo wa pamoja.
Kwa nini Sequence-Dependent Setup Time ni muhimu?
Muda wa maandalizi unaohitajika na mashine wakati wa kutoka kazi \(J_i\) kwenda kazi \(J_j\):
\[ s_{i,j,k} \]
unawakilishwa kwa hiyo.
Kwa hiyo muda wa maandalizi hautegemei kazi lengwa pekee; jozi ya predecessor–successor na mashine \(k\) ni muhimu kwa pamoja.
Hali hii inaweza kuwakilisha mabadiliko ya viwandani kama kubadilisha rangi, kurekebisha mold, kubadilisha zana, kusafisha au kubadilisha familia ya bidhaa. Chanzo hakitumii matrix halisi ya setup ya mchakato mmoja wa kiwanda; kinatengeneza benchmark za usanisi zinazodhibitiwa.
Stochastic processing time inawakilishwaje?
Processing time ya job \(j\) kwenye machine \(k\) katika scenario \(\omega\):
\[ p^\omega_{j,k} \]
imefafanuliwa.
Kazi inapopewa sequence position \(r\), position-level processing time:
\[ PT^\omega_{r,k} \]
huwa hivyo.
Kutokuwa na uhakika kunawakilishwa kupitia scenario set:
\[ \Omega=\{1,\ldots,S\} \]
.
Vigezo vikuu
| Alama | Maana |
|---|---|
| \(n\) | Idadi ya kazi |
| \(m\) | Idadi ya mashine |
| \(\omega\) | Indeksi ya uncertainty scenario |
| \(\lambda\) | Job permutation ya pamoja |
| \(x_{j,r}\) | Binary variable inayokuwa 1 ikiwa job \(j\) imepewa position \(r\) |
| \(y_{i,j,r}\) | Adjacency variable inayokuwa 1 ikiwa kwenye position \(r-1\) kuna \(i\), na kwenye position \(r\) kuna \(j\) |
| \(p^\omega_{j,k}\) | Katika scenario \(\omega\), processing time ya job \(j\) kwenye machine \(k\) |
| \(s^0_{j,k}\) | Initial setup time kwa job \(j\) |
| \(s_{i,j,k}\) | Sequence-dependent setup time ya mpito \(i\rightarrow j\) |
| \(ST_{r,k}\) | Katika position \(r\), setup duration ya machine \(k\) |
| \(A^\omega_{r,k}\) | Setup completion time |
| \(B^\omega_{r,k}\) | Processing start time |
| \(C^\omega_{r,k}\) | Processing completion time |
| \(I^\omega_{r,k}\) | Machine idle time |
| \(w_j\) | TWFT priority weight ya job \(j\) |
| \(c_k^{run}\) | Processing unit cost coefficient ya machine \(k\) |
| \(c_k^{setup}\) | Setup unit cost coefficient ya machine \(k\) |
| \(c_k^{idle}\) | Idle unit cost coefficient ya machine \(k\) |
| \(\alpha,\beta\) | Uzani wa TWFT na operational-cost |
| \(q_\omega\) | Scenario probability ndani ya ambiguity set |
| \(\hat q_\omega\) | Nominal scenario probability; katika chanzo uniform \(\hat q_\omega=1/S\) |
| \(\rho\) | KL ambiguity-set robustness radius |
| \(\eta\) | Auxiliary variable katika DRO dual reformulation |
Mlinganyo (1): Total Weighted Flow Time
\[ TWFT^\omega= \sum_{r\in R}\sum_{j\in J} w_j x_{j,r} C^\omega_{r,m} \tag{1} \]
Unahesabu nini? Huzidisha completion time ya kila job kwenye mashine ya mwisho kwa job priority weight na kisha kuzijumlisha.
\(C^\omega_{r,m}\), katika scenario \(\omega\), ni completion time ya kazi iliyo kwenye position \(r\) kwenye mashine ya mwisho.
Kadiri \(w_j\) inavyoongezeka, kuchelewa kukamilika kwa job husika kunaleta adhabu kubwa zaidi katika objective. Kwa namna hiyo, kazi za dharura au zenye kipaumbele cha juu zinaweza kupata uzani mkubwa zaidi ndani ya optimization.
Mlinganyo (2): Operational Cost
\[ Cost^\omega= \sum_{k\in M} \left[ c_k^{run}\sum_{r\in R}PT^\omega_{r,k} + c_k^{setup}\sum_{r\in R}ST_{r,k} + c_k^{idle}\sum_{r\in R}I^\omega_{r,k} \right] \tag{2} \]
Cost function ina sehemu tatu:
- processing cost,
- sequence-dependent setup cost,
- machine idle cost.
Chanzo kinaweka tofauti muhimu: kwa scenario isiyobadilika, jumla ya processing time haitegemei mpangilio wa kazi. Kwa hiyo term ya processing-cost hutenda kama gharama ya msingi isiyoepukika ndani ya scenario hiyo. Athari kuu ya uamuzi wa job sequencing juu ya gharama hutokana na vipengele vya setup na idle.
Mpaka wa kisayansi: \(c_k^{run}\), \(c_k^{setup}\) na \(c_k^{idle}\) si thamani zilizochukuliwa kutoka kifaa halisi cha kupima nishati. Objective hii haihesabu kWh halisi, bili ya umeme au utoaji wa CO₂.
Mlinganyo (3): Objective iliyounganishwa
\[ J^\omega= \alpha TWFT^\omega+ \beta Cost^\omega \tag{3} \]
Malengo mawili hubadilishwa kuwa objective moja kwa weighted aggregation.
Kwa computational experiments:
\[ \alpha=\beta=0.5 \]
imetumika.
Hata hivyo, chanzo kinasisitiza kuwa chaguo hili halimaanishi numerical contribution za TWFT na cost ni sawa wala kwamba linawakilisha muundo wa jumla wa decision-maker preference. Vipengele viwili vinaweza kuwa na mizani tofauti.
DRO Inatofautianaje na Stochastic Programming na Robust Optimization ya Kawaida?
Stochastic programming kwa kawaida hudhani kuwa probability distribution fulani inajulikana kwa usahihi, huku Robust Optimization ya kawaida ikilinda dhidi ya hali mbaya zaidi ya parameter realizations moja moja ndani ya uncertainty set; DRO katika utafiti huu, badala ya usambazaji mmoja, hupunguza thamani mbaya zaidi ya expected objective katika familia ya probability distributions zilizo karibu vya kutosha na usambazaji wa kawaida kwa kipimo cha KL divergence.
Mlinganyo (4): Worst-case expected objective
\[ \min J_{DRO} = \min_\lambda \max_{q\in Q_\rho} \sum_{\omega\in\Omega}q_\omega J^\omega \tag{4} \]
Inner maximization hapa hutafuta probability distribution isiyofaa zaidi ndani ya ambiguity set kwa schedule iliyochaguliwa.
Outer minimization huchagua job permutation inayopunguza worst-case expected objective hii kadiri iwezekanavyo.
Mlinganyo (5): Kullback–Leibler ambiguity set
\[ Q_\rho= \left\{ q\in\mathbb{R}_+^S: \sum_{\omega\in\Omega}q_\omega=1,\; \sum_{\omega\in\Omega} q_\omega \ln\left( \frac{q_\omega}{\hat q_\omega} \right) \le\rho \right\} \tag{5} \]
Sharti la kwanza linahakikisha jumla ya probability values ni 1.
Sharti la pili linaruhusu candidate distribution \(q\) kujitenga na nominal distribution \(\hat q\) kwa kiwango kisichozidi \(\rho\) kwa KL divergence.
Robustness Radius \(\rho\) Inafanya Kazi Gani?
\(\rho\) hudhibiti ukubwa wa ambiguity set; \(\rho\) ndogo huiweka optimization karibu na nominal probability distribution, huku \(\rho\) kubwa ikiruhusu usambazaji zaidi unaowezekana na kufanya schedule iwe ya tahadhari zaidi dhidi ya kutokuwa na uhakika wa usambazaji, lakini matokeo yote makuu yaliyoripotiwa katika utafiti huu yanahusu tu sharti la \(\rho=0.05\).
Kwa hiyo haiwezi kuhitimishwa kuwa “ALO ni sawa katika kila thamani ya \(\rho\)” au “SMA ndiyo ya haraka zaidi katika viwango vyote vya robustness”.
Mlinganyo (6): Dual DRO reformulation
\[ J_{DRO} = \min_{\eta>0} \left[ \eta\rho+ \eta\ln \left( \sum_{\omega\in\Omega} \hat q_\omega \exp\left(\frac{J^\omega}{\eta}\right) \right) \right] \tag{6} \]
Reformulation hii hubadilisha sehemu ya inner distribution maximization ya muundo wa nested min-max katika Equation (4) kuwa convex expression ya tabaka moja inayotekelezeka zaidi computationally kwa kutumia Lagrangian duality.
\(\eta\) ni auxiliary dual variable na huoptimizwa kwa kila candidate permutation.
Katika exact enumeration implementation, \(\eta\) ilioptimizwa kwa bounded one-dimensional optimizer ya MATLAB, fminbnd.
Equations (7)–(25): Vikwazo vya Feasibility na muda
Mathematical model ya chanzo haijumuishi objective function pekee. Job assignment, uhusiano wa predecessor–successor, setup calculation, machine precedence, completion times na variable domains hufafanuliwa kwa constraints zifuatazo.
\[ \sum_{j\in J}x_{j,r}=1,\qquad \forall r\in R \tag{7} \]
Kila sequence position inapewa job moja kamili.
\[ \sum_{r\in R}x_{j,r}=1,\qquad \forall j\in J \tag{8} \]
Kila job inapewa position moja kamili. Equations (7) na (8) kwa pamoja huunda permutation halali.
\[ y_{i,j,r}\le x_{i,r-1} \tag{9} \]
\[ y_{i,j,r}\le x_{j,r} \tag{10} \]
\[ y_{i,j,r}\ge x_{i,r-1}+x_{j,r}-1 \tag{11} \]
Equations (9)–(11) ni linear adjacency formulation inayohakikisha \(y_{i,j,r}\) huwa 1 tu ikiwa job \(i\) iko katika position iliyotangulia na job \(j\) iko katika position ya sasa.
\[ ST_{1,k} = \sum_{j\in J}s^0_{j,k}x_{j,1} \tag{12} \]
Kwa position ya kwanza hakuna predecessor, hivyo initial setup huhesabiwa kulingana na job ya kwanza iliyochaguliwa.
\[ ST_{r,k} = \sum_{i\in J}\sum_{j\in J} s_{i,j,k}y_{i,j,r}, \qquad r=2,\ldots,n \tag{13} \]
Katika position zinazofuata setup time hutegemea jozi ya predecessor–successor.
\[ PT^\omega_{r,k} = \sum_{j\in J} p^\omega_{j,k}x_{j,r} \tag{14} \]
Constraint hii huhamisha scenario-dependent processing time ya job iliyowekwa kwenye position \(r\) kwenda kwenye position hiyo.
\[ C^\omega_{0,k}=0 \tag{15} \]
\[ C^\omega_{r,0}=0 \tag{16} \]
Mwanzoni mwa scheduling horizon, completion times za job iliyotangulia na upande wa “machine 0” huwekwa sifuri.
\[ A^\omega_{r,k} = C^\omega_{r-1,k} + ST_{r,k} \tag{17} \]
Setup completion time ni jumla ya previous job completion kwenye mashine hiyo hiyo na setup duration inayohitajika.
\[ B^\omega_{r,k}\ge A^\omega_{r,k} \tag{18} \]
Processing haiwezi kuanza kabla setup haijakamilika.
\[ B^\omega_{r,k}\ge C^\omega_{r,k-1} \tag{19} \]
Job haiwezi kuanza kwenye mashine inayofuata kabla haijakamilisha uchakataji kwenye mashine iliyotangulia.
\[ C^\omega_{r,k} = B^\omega_{r,k} + PT^\omega_{r,k} \tag{20} \]
Completion time = processing start + processing duration.
\[ I^\omega_{r,k} = B^\omega_{r,k} - A^\omega_{r,k} \tag{21} \]
Tofauti ya muda kuanzia setup inapokuwa tayari hadi processing ianze ni machine idle time.
\[ ST_{r,k}\ge0 \tag{22} \]
\[ PT^\omega_{r,k}, A^\omega_{r,k}, B^\omega_{r,k}, C^\omega_{r,k}, I^\omega_{r,k}\ge0 \tag{23} \]
Temporal variables haziwezi kuchukua thamani hasi.
\[ x_{j,r}\in\{0,1\} \tag{24} \]
\[ y_{i,j,r}\in\{0,1\} \tag{25} \]
Assignment na adjacency variables ni binary.
Illustrative example: kazi 7, mashine 5
Chanzo kinatoa illustrative instance ili kuweka wazi mantiki ya DRO, kikitumia:
- \(n=7\) job,
- \(m=5\) machine,
- 300 generated processing-time scenarios,
- \(\rho=0.05\),
- \(\alpha=0.5\),
- \(\beta=0.5\)
.
Job weights:
\[ w=[4,2,5,3,1,4,2] \]
Feasible sequence ya kwanza ya maelezo:
\[ \lambda=[J_4,J_1,J_2,J_6,J_3,J_5,J_7] \]
imechaguliwa.
Optimal robust permutation iliyobainishwa na DRO:
\[ \lambda^*=[J_1,J_3,J_6,J_4,J_7,J_2,J_5] \]
ni hiyo.
Representative processing-time scenario tatu
Chanzo kinachagua matrix tatu kutoka 300 generated scenario ili kurahisisha ufasiri, zikawakilisha hali favourable, degraded na variable.
\[ PT^1= \begin{bmatrix} 2&17&9&11&14&9&11\\ 4&8&10&10&13&8&6\\ 7&14&8&9&15&7&11\\ 14&7&8&15&5&9&13\\ 11&9&6&9&8&8&10 \end{bmatrix} \]
\[ PT^2= \begin{bmatrix} 6&11&7&14&15&11&11\\ 7&8&12&11&13&8&5\\ 9&15&6&8&14&5&11\\ 15&9&10&14&4&10&12\\ 11&7&7&12&10&9&9 \end{bmatrix} \]
\[ PT^3= \begin{bmatrix} 10&12&10&14&15&9&9\\ 8&7&12&12&12&7&6\\ 9&15&5&12&16&6&11\\ 15&6&14&15&8&11&12\\ 10&8&8&8&7&10&8 \end{bmatrix} \]
Safu mlalo zinawakilisha mashine, na safu wima zinawakilisha kazi.
Uchanganuzi wa Kutokuwa na Uhakika wa GUM Unaongeza Nini kwa DRO?
Wakati DRO huchagua job sequence kwa namna robust chini ya probability-distribution ambiguity, uchanganuzi wa GUM hupima kando jinsi matokeo ya makespan ya optimal schedule yanavyotawanyika katika scenario realizations; chanzo huhesabu mean makespan, combined standard uncertainty na \(k=2\) expanded uncertainty kwa 300 scenario na kuripoti optimal makespan kuwa \(129.45\pm9.62\) pamoja na expanded interval \([119.83,139.07]\).
Mlinganyo (26): Mean makespan
\[ \overline{C}_{max} = \frac{1}{N} \sum_{\omega=1}^{N} C_{max}(\omega) \tag{26} \]
Hapa \(N=300\) ni generated scenario.
Mlinganyo (27): Combined standard uncertainty
\[ u_c^2(C_{max}) = \frac{1}{N-1} \sum_{\omega=1}^{N} \left[ C_{max}(\omega)-\overline{C}_{max} \right]^2 \tag{27} \]
Usemi huu huhesabu variance ya scenario makespan values. Combined standard uncertainty \(u_c\) ni mzizi wa mraba wa variance.
Mlinganyo (28): Expanded uncertainty
\[ U=k\,u_c \tag{28} \]
Chanzo hutumia:
\[ k=2 \]
na kuihusisha na takriban %95 coverage level.
Mlinganyo (29): Matokeo ya Makespan
\[ C_{max} = \overline{C}_{max} \pm U \tag{29} \]
Kwa illustrative example:
\[ C_{max}=129.45\pm9.62 \]
na expanded uncertainty interval:
\[ [119.83,\;139.07] \]
imetolewa.
Ulinganisho wa optimal DRO permutation na manual permutation
| Scenario | Hali | \(TWFT^\omega\) | \(Cost^\omega\) | \(J^\omega\) |
|---|---|---|---|---|
| 1 | Favourable | 1406.2 | 546.07 | 976.14 |
| 2 | Degraded | 1612.7 | 558.08 | 1085.4 |
| 3 | Variable | 1787.2 | 586.98 | 1187.1 |
| Scenario | Hali | \(TWFT^\omega\) | \(Cost^\omega\) | \(J^\omega\) |
|---|---|---|---|---|
| 1 | Favourable | 2262.4 | 557.51 | 1410 |
| 2 | Degraded | 2335.7 | 570.81 | 1453.3 |
| 3 | Variable | 2359.1 | 591.22 | 1475.2 |
Kwa kuwa processing-time realizations, setup times, machine cost coefficients na job weights zilezile zinatumika, tofauti katika illustrative comparison hii inatokana na sequence selection.
Source Figures 2–4 zinaonyesha Gantt charts za optimal DRO schedule kwa favourable, degraded na variable scenarios. Picha za chanzo zinaonyesha jinsi machine occupation, setup, idle na job progression zinavyorefuka scenario inapobadilika. Kwa kuwa Exact Gantt bar coordinates hazijachapishwa katika jedwali la namba, Verianla haichori upya michoro hii kwa usahihi bandia.
Mbinu na Matokeo ya Utafiti
Computational experimental framework
| Kigezo | Thamani ya chanzo |
|---|---|
| Idadi ya Job | 4–300 |
| Idadi ya Machine | 2–20 |
| \(\mu_P\) | \(U(5,15)\) |
| \(\sigma_P\) | \(U(0.5,2)\) |
| Scenario processing time | \(PT\sim N(\mu_P,\sigma_P^2)\) |
| Search scenario set | \(S_{small}=30\) |
| Final evaluation scenario set | \(S_{large}=300\) |
| Base random seed | 7 |
| Initial setup | \(setup_0\sim U(0.5,2.5)\) |
| Sequence-dependent setup | \(setup_{seq}\sim U(0.5,3.5)\) |
| Job weight | \(w_j\sim U(1,5)\) |
| Processing cost coefficient | \(c_k^{run}\sim U(1,1.5)\) |
| Setup cost coefficient | \(c_k^{setup}\sim U(0.6,1)\) |
| Idle cost coefficient | \(c_k^{idle}\sim U(0.2,0.5)\) |
| TWFT weight | \(\alpha=0.5\) |
| Operational-cost weight | \(\beta=0.5\) |
| Ambiguity radius | \(\rho=0.05\) |
| GRASP RCL parameter | \(\alpha_{RCL}=0.7\) |
| Maximum iterations | 100 |
| Random-Keys population | \(nPop=30\) |
| Independent runs | 50 |
| MATLAB | MATLAB R2021a |
| Exact solver | IBM ILOG CPLEX Optimization Studio 12.10.0 |
| Hardware | ASUS VivoBook X1502VA, 13th Gen Intel Core i9, 16 GB RAM |
Kwa nini \(\alpha_{RCL}\) ni 0,7?
Chanzo kilichunguza thamani:
\[ \alpha_{RCL}\in\{0.3,0.5,0.7\} \]
wakati wa preliminary exploratory tests na kuchagua 0,7 kama practical compromise inayofaa zaidi kati ya solution quality na diversification.
Mchakato huu hauwasilishwi kama systematic hyperparameter optimization.
Je, 100 iteration zinatoa computational budget sawa kwa algorithms zote?
Hapana. Ingawa chanzo kinatumia 100 iteration kwa iterative algorithms zote, kinaeleza wazi kuwa algorithms tofauti zinaweza kufanya idadi tofauti ya DRO objective evaluation ndani ya iteration moja.
Kwa hiyo, 100 iteration haimaanishi kila mbinu imepewa computational work sawa. Kwa sababu hii CPU time ililinganishwa kando.
Exact enumeration inafanyaje kazi?
Kwa small instances, CPLEX assignment model huzalisha feasible permutation ambayo haijajaribiwa kabla katika kila iteration.
Baada ya permutation kuwa decoded, setup, processing, start/completion na idle variables huhesabiwa nje na full DRO objective hutathminiwa.
Kisha no-good cut huongezwa ili kuzuia permutation ileile kuzalishwa tena:
\[ \sum_{j\in J}\sum_{r\in R} x^*_{j,r}x_{j,r} \le n-1 \]
Kwa kuwa kila feasible permutation huzalishwa mara moja kamili, katika small instances permutations zote \(n!\) hutathminiwa exhaustively.
Chanzo kimeweka exact procedure kwa instances zenye hadi job 10.
GRASP-DRO
GRASP hutumia randomised greedy construction.
Initial job priority score:
\[ \phi_j= w_j \sum_{k=1}^{m} \mu P_{j,k} \]
huundwa.
Kati ya candidate solutions, Restricted Candidate List:
\[ RCL= \left\{ cand_t: DRO(cand_t) \le J_{min} +\alpha_{RCL}(J_{max}-J_{min}) \right\} \]
hufafanuliwa na random candidate huchaguliwa kutoka RCL.
HGRASP-DRO
HGRASP inaunganisha vipengele vinne vikuu:
- DRO-adapted NEH initialization,
- GRASP constructive search,
- swap-based local search,
- restart/diversification mechanism.
Mwanzoni mwa iteration inayofuata, original robust NEH sequence hutumiwa tena kwa uwezekano wa %50; vinginevyo mpangilio wa mwanzo hutofautishwa kwa random swaps.
ALO-DRO
Kwa kuwa Ant Lion Optimizer hufanya kazi kiasili kwenye continuous search space, Random Keys representation ilitumika ili kuzalisha job permutation.
Thamani za continuous vector hupangwa na kubadilishwa kuwa feasible permutation. Wakati wa population search, elite solution huhifadhiwa na candidate schedules hutathminiwa kwa DRO objective kupitia reduced scenario set.
SMA-DRO
Slime Mold Algorithm pia hutumia Random Keys representation. Population hu-update kwa adaptive weighting; solutions bora hupata influence kubwa zaidi, huku solutions dhaifu zikiendelea kuwa na nafasi ndani ya population ili exploration isipotee.
Chanzo kimetumia \(nPop=30\) kwa Random-Keys population settings zote.
Matokeo ya small-scale exact benchmark
| Instance | Exact | Exact CPU | GRASP | CPU | HGRASP | CPU | ALO | CPU | SMA | CPU |
|---|---|---|---|---|---|---|---|---|---|---|
| 4×2 | 101.02 | 2.35 | 101.02 | 1.61 | 101.02 | 2.74 | 101.02 | 2.38 | 101.02 | 3.12 |
| 4×4 | 200.66 | 1.10 | 200.66 | 0.42 | 200.66 | 0.96 | 200.66 | 1.00 | 200.66 | 0.94 |
| 4×6 | 267.16 | 0.49 | 267.16 | 1.00 | 267.16 | 1.11 | 267.16 | 1.15 | 267.16 | 1.08 |
| 6×2 | 239.2 | 38.61 | 239.2 | 0.85 | 239.2 | 2.49 | 239.2 | 1.25 | 239.2 | 1.13 |
| 6×4 | 338.49 | 38.89 | 338.49 | 0.86 | 338.49 | 2.59 | 338.49 | 1.26 | 338.49 | 1.16 |
| 6×6 | 410.61 | 38.55 | 410.61 | 0.87 | 410.61 | 2.80 | 410.61 | 1.27 | 410.61 | 1.16 |
| 8×2 | 368.39 | 89,964 | 369.62 | 1.31 | 368.39 | 5.22 | 368.39 | 1.27 | 368.39 | 1.13 |
| 8×4 | 562.4 | 130,600 | 588.91 | 1.88 | 562.4 | 7.44 | 562.4 | 1.91 | 562.4 | 1.71 |
| 8×6 | 642.64 | 70,895 | 646.41 | 1.35 | 642.64 | 5.51 | 642.64 | 1.29 | 642.64 | 1.17 |
| 9×4 | 532.67 | 85,640 | 536.15 | 1.33 | 532.67 | 5.99 | 533.62 | 1.09 | 533.62 | 0.97 |
| 10×2 | 509.65 | 108,450 | 517.29 | 4.08 | 509.65 | 19.16 | 509.65 | 2.84 | 509.65 | 2.45 |
HGRASP ilizalisha upya exact objective value katika small-scale instances hizi zote.
Exact enumeration huwa computationally expensive haraka sana kadiri instance inavyokua.
Matokeo ya Medium-scale
| Instance | GRASP | CPU | HGRASP | CPU | ALO | CPU | SMA | CPU |
|---|---|---|---|---|---|---|---|---|
| 10×5 | 798.97 | 1.96 | 785.17 | 10.71 | 788.96 | 1.38 | 785.63 | 1.23 |
| 10×10 | 1413.7 | 2.04 | 1397.1 | 12.71 | 1397.1 | 1.44 | 1397.1 | 1.28 |
| 10×15 | 1932.2 | 2.15 | 1904.9 | 13.13 | 1904.9 | 1.51 | 1904.9 | 1.35 |
| 20×5 | 2674.7 | 7.38 | 2529.7 | 71.17 | 2535.7 | 1.96 | 2535.1 | 1.54 |
| 20×10 | 3679.1 | 26.49 | 3509.4 | 268.03 | 3524.6 | 7.72 | 3526.9 | 5.98 |
| 20×15 | 4339.95 | 7.77 | 4171.08 | 85.54 | 4183.04 | 2.15 | 4184.21 | 1.76 |
| 30×5 | 5078.17 | 13.02 | 4749.6 | 70.83 | 4528.46 | 2.07 | 4564.33 | 1.72 |
| 30×10 | 6352.42 | 14.07 | 6006.96 | 77.82 | 5888.47 | 2.22 | 5895.96 | 1.89 |
| 30×15 | 8242.85 | 15.28 | 8022.30 | 86 | 7876.46 | 2.45 | 7876.79 | 2.10 |
| 40×5 | 8846.77 | 27.5 | 8386.14 | 149.8 | 8016.26 | 4.81 | 7990.32 | 3.49 |
| 40×10 | 10,849.9 | 72.9 | 10,296.85 | 286.6 | 9860.56 | 6.78 | 9864.14 | 5.28 |
| 40×15 | 13,639.6 | 28.28 | 13,111.05 | 105.42 | 12,695.5 | 2.89 | 12,627.73 | 2.26 |
| 50×5 | 12,626.2 | 37.7 | 12,006.1 | 100.72 | 10,170.4 | 2.60 | 10,961.06 | 1.83 |
| 50×10 | 14,524.4 | 145.38 | 13,739.86 | 410.71 | 13,028.1 | 9.61 | 13,079.04 | 7.27 |
| 50×15 | 17,482 | 46 | 16,967 | 128.85 | 16,097 | 3.17 | 15,921 | 2.43 |
| 60×5 | 16,117 | 58.38 | 15,679 | 127.82 | 14,597 | 2.95 | 14,453 | 2.03 |
| 60×10 | 21,687 | 2028.5 | 21,143 | 616.84 | 19,656 | 13.27 | 19,724 | 9.57 |
| 60×15 | 26,425.6 | 70.51 | 26,124.06 | 160.05 | 24,834.7 | 3.48 | 24,842.04 | 2.65 |
| 70×5 | 22,505 | 1162.5 | 21,971 | 643.46 | 20,143 | 12.78 | 20,234 | 8.66 |
| 70×10 | 27,914 | 108.63 | 27,491 | 209.6 | 25,254 | 4.53 | 25,034 | 2.98 |
| 70×15 | 31,230.1 | 181.35 | 30,464.62 | 506.59 | 28,931.51 | 7.07 | 29,210.98 | 5.08 |
| 80×5 | 29,386.5 | 108.58 | 28,444.54 | 185.95 | 26,555.80 | 3.69 | 26,178.90 | 2.24 |
| 80×10 | 36,061.27 | 119.92 | 35,943.01 | 206.51 | 33,641.2 | 3.62 | 33,134.3 | 2.56 |
| 80×15 | 36,972.02 | 252 | 36,608.48 | 399.47 | 34,376.15 | 6.87 | 34,079.12 | 4.81 |
| 90×5 | 36,832.33 | 136.6 | 36,661.97 | 211.89 | 33,847.33 | 3.66 | 34,033.45 | 2.23 |
| 90×10 | 46,181.93 | 298.56 | 45,608.33 | 438.10 | 42,326.87 | 6.26 | 42,919.34 | 4.36 |
| 90×15 | 49,909.87 | 298.67 | 49,594.48 | 486.85 | 46,529.06 | 8.45 | 46,315.51 | 5.97 |
Kadiri medium scale inavyoongezeka, solution quality ya GRASP hudhoofika kwa kulinganisha; HGRASP huiboresha GRASP, lakini katika medium instances kubwa zaidi ALO na SMA mara nyingi hutoa DRO values za chini.
Matokeo ya Large-scale
| Instance | GRASP | CPU | HGRASP | CPU | ALO | CPU | SMA | CPU |
|---|---|---|---|---|---|---|---|---|
| 100×10 | 53,070.93 | 217.7 | 52,270.26 | 322.65 | 48,791.98 | 4.49 | 49,201.7 | 3 |
| 100×20 | 64,020.76 | 407.75 | 62,724.74 | 487.28 | 59,460.94 | 7.05 | 59,525.17 | 5.49 |
| 150×10 | 112,800 | 1290.4 | 111,170 | 38,421 | 107,070 | 6.8078 | 106,940 | 4.2935 |
| 150×20 | 133,252 | 1305 | 129,020 | 4540.02 | 124,230 | 7.067 | 120,014 | 4.305 |
| 200×10 | 194,880 | 1477.5 | 194,030 | 5541.4 | 180,940 | 7.2912 | 181,040 | 4.5586 |
| 200×20 | 220,890 | 6762.9 | 218,310 | 12,749 | 203,980 | 10.55 | 210,250 | 7.7775 |
| 250×10 | 294,680 | 6529.8 | 295,280 | 12,448 | 278,100 | 36.944 | 284,340 | 21.774 |
| 250×20 | 326,430 | 17,367 | 321,590 | 53,927 | 306,210 | 56.61 | 305,190 | 41.28 |
| 300×10 | 416,760 | 13,019 | 413,900 | 3824.1 | 393,590 | 10.779 | 393,430 | 6.9293 |
| 300×20 | 466,740 | 8101 | 464,820 | 20,180 | 446,440 | 15.3965 | 442,830 | 11.7650 |
Katika large scale, GRASP kwa ujumla hutoa objective values zilizo juu zaidi. HGRASP huiboresha GRASP, lakini computational time huongezeka sana kwa sababu ya local search yenye uzito mkubwa.
ALO na SMA huwa wazi kuwa competitive zaidi katika matatizo makubwa. Hakuna mojawapo inayomshinda mwingine katika kila instance.
Representative 300×20 instance: mikimbio huru 50
| Mbinu | Median DRO | Average DRO | Std. Dev. | Best DRO | Maximum DRO | Average CPU |
|---|---|---|---|---|---|---|
| GRASP | 1,010,536.65 | 1,006,974.81 | 7713.28 | Haijatolewa katika sentensi hii ya maandishi ya chanzo | 1,012,263.52 | — |
| HGRASP | 1,002,959.09 | 1,002,307.41 | 5487.10 | 996,523.57 | — | 12,697.84 s |
| ALO | 962,154.30 | 961,918.26 | 3583.37 | — | 965,377.78 | — |
| SMA | 966,327.54 | 964,057.76 | 6827.03 | 956,384.95 | 969,460.79 | 9.16 s |
Katika representative experiment hii, chanzo kinaitathmini ALO kuwa mbinu iliyo robust zaidi kwa sababu ya median/average ya chini na variability ya chini; SMA hutathminiwa kuwa optimization performer yenye nguvu kwa sababu ya individual DRO solution bora zaidi na average computational time fupi zaidi.
Figure 6 ni convergence history ya representative execution moja tu; si statistical summary ya 50 run. GRASP na HGRASP hufikia plateau mapema, huku ALO na SMA zikiendelea kuboreka kwa muda mrefu zaidi. Kwa kuwa raw iteration-level series hazijachapishwa, Verianla haichori Figure 6 upya kama exact curve bandia.
Jaribio la Medium-scale Friedman
| Mbinu | DRO Mean Rank | CPU Mean Rank |
|---|---|---|
| GRASP | 4.000 | 3.074 |
| HGRASP | 2.630 | 3.926 |
| ALO | 1.630 | 2.000 |
| SMA | 1.741 | 1.000 |
Solution quality:
\[ \chi^2=60.115,\qquad df=3,\qquad p=5.56\times10^{-13} \]
Computational time:
\[ \chi^2=78.778,\qquad df=3,\qquad p=5.94\times10^{-17} \]
Matokeo haya yanakataa null hypothesis kwamba medium-scale algorithms zina performance sawa.
Jaribio la Large-scale Friedman
| Mbinu | DRO Mean Rank | CPU Mean Rank |
|---|---|---|
| GRASP | 3.9 | 3.2 |
| HGRASP | 3.1 | 3.8 |
| ALO | 1.5 | 2.0 |
| SMA | 1.5 | 1.0 |
DRO objective:
\[ \chi^2=25.920,\qquad df=3,\qquad p=9.91\times10^{-6} \]
Computational time:
\[ \chi^2=28.080,\qquad df=3,\qquad p=3.49\times10^{-6} \]
Kati ya ALO na SMA, Ipi ni Bora Zaidi?
Katika matokeo ya large-scale ya utafiti huu, Friedman mean rank ya ALO na SMA kwa solution quality ni sawa 1,5 na jaribio la Wilcoxon–Holm post-hoc halionyeshi tofauti muhimu ya DRO kati yao; ALO inaonekana robust zaidi katika representative 300×20 runs kwa median/average na variability ya chini, huku SMA ikitoa individual solution bora zaidi na computational-time rank bora zaidi, hivyo chanzo hakitangazi algorithm moja kuwa bora kabisa kwa vigezo vyote.
Matokeo ya Large-scale Wilcoxon–Holm post-hoc
| Ulinganisho | DRO Raw p | DRO Holm p | DRO | CPU Raw p | CPU Holm p | CPU |
|---|---|---|---|---|---|---|
| GRASP vs HGRASP | 0.003906 | 0.011719 | Muhimu | 0.105469 | 0.105469 | Si muhimu |
| GRASP vs ALO | 0.001953 | 0.011719 | Muhimu | 0.001953 | 0.011719 | Muhimu |
| GRASP vs SMA | 0.001953 | 0.011719 | Muhimu | 0.001953 | 0.011719 | Muhimu |
| HGRASP vs ALO | 0.001953 | 0.011719 | Muhimu | 0.001953 | 0.011719 | Muhimu |
| HGRASP vs SMA | 0.001953 | 0.011719 | Muhimu | 0.001953 | 0.011719 | Muhimu |
| ALO vs SMA | 1.000000 | 1.000000 | Si muhimu | 0.001953 | 0.011719 | Muhimu |
Kusema kwamba ALO au SMA ni bora kuliko nyingine kwa solution quality hakuungwi mkono na jaribio hili.
Kwa computational time, tofauti ya ALO–SMA ni muhimu na Friedman ranking inaonyesha SMA kuwa favorable zaidi.
Matokeo yanayoungwa mkono na utafiti
- PFSP-SDST, stochastic processing times na operational cost zinaweza kumodeliwa ndani ya optimization framework moja kwa DRO.
- KL-divergence ambiguity set imetumika kufafanua distributional uncertainty kuzunguka nominal probability distribution.
- Kwa small instances, CPLEX-assisted exhaustive enumeration imetoa global optimum benchmark.
- HGRASP imezalisha upya exact objective value katika small-scale instances zote zilizojaribiwa.
- Kadiri medium na large scale zinavyoongezeka, ALO na SMA za population-based zimekuwa competitive zaidi.
- Kwa large-scale solution quality, jaribio la Friedman limeonyesha tofauti muhimu kati ya algorithms.
- Kwa large-scale CPU time, jaribio la Friedman limeonyesha tofauti muhimu kati ya algorithms.
- ALO na SMA zimepata mean rank sawa kwa large-scale DRO quality.
- Tofauti ya pairwise DRO ya ALO–SMA si muhimu.
- SMA ndiyo mbinu favorable zaidi kwa computational-time ranking.
- Katika representative 300×20 instance, ALO imeonyesha median/average na standard deviation ya chini.
- Katika representative instance hiyo hiyo, SMA imetoa individual DRO solution bora zaidi.
Matokeo yasiyoungwa mkono na utafiti
- Framework haijathibitishwa katika kiwanda halisi.
- Operational cost si kipimo cha matumizi halisi ya umeme.
- Modeli haihesabu CO₂/emission reduction.
- Haijaonyeshwa kuwa matokeo ya \(\rho=0.05\) yatabaki sawa kwa ambiguity radii nyingine.
- \(\alpha=\beta=0.5\) haionyeshi kuwa umuhimu wa maamuzi halisi au numerical scales za TWFT na cost ni sawa.
- Haijaonyeshwa kuwa ALO ni bora kuliko SMA katika instances zote.
- Haijaonyeshwa kuwa SMA ni bora kwa kitakwimu kuliko ALO kwa solution quality.
- Global optimum haijulikani kwa medium na large instances.
- Matokeo ya synthetic benchmark si performance ya moja kwa moja ya commercial Industry 4.0 deployment.
- Parameter tuning si exhaustive/systematic.
Vikwazo vikuu
Data za usanisi: Kwa kuwa hakuna public benchmark, processing, setup na cost parameters zimetengenezwa kutokana na controlled synthetic distributions.
Hakuna validation halisi ya viwandani: Hakuna jaribio la uwanjani lililofanywa kwenye production line maalumu.
Ambiguity radius isiyobadilika: Matokeo yote makuu yanategemea sharti la \(\rho=0.05\).
Hakuna sensitivity analysis: Systematic calibration/sensitivity analysis kwa thamani tofauti za \(\rho\) imeachwa kama future work.
Fixed algorithm settings: \(\alpha_{RCL}\), iteration limit, population sizes na algorithmic settings nyingine ni chaguo za practical/preliminary; systematic tuning haijafanywa.
Iteration sawa ≠ budget sawa: Algorithms zinaweza kufanya idadi tofauti ya objective evaluation kwa kila iteration.
Operational cost si nishati ya kimwili: Cost coefficients si direct power, electricity-price au emissions measurements.
Exact method scalability: Exhaustive enumeration imetumika kwa small instances pekee kutokana na combinatorial explosion.
Upeo wa Figure 5/6: Robustness boxplot na convergence curves ni za representative 300×20 instance; haziwezi kujumlishwa peke yake kwa instances zote.
Code availability: MATLAB source code si public wakati wa uchapishaji.
Utafiti wa baadaye
Chanzo kinapendekeza upanuzi ufuatao:
- stochastic setup times,
- machine disruptions,
- fluctuating energy prices,
- industrial case studies halisi,
- \(\rho\) calibration na sensitivity analysis,
- systematic metaheuristic parameter tuning,
- comparison pana na deterministic scheduling, stochastic programming, conventional DRO na RO,
- out-of-sample evaluation chini ya uncertainty distributions tofauti,
- multi-objective DRO inayoshughulikia kwa pamoja production efficiency, real energy consumption na sustainability indicators.
Maelezo ya Chanzo na Mbinu
Utafiti asili: Distributionally Robust Optimization for Permutation Flow Shop Scheduling with Sequence-Dependent Setup Times and Operational Cost Under Uncertainty in Industry 4.0 Manufacturing Systems.
Waandishi: Hafsa Mimouni, Abdelilah Jalid, Said Aqil.
Mpangilio wa waandishi: Mpangilio katika PDF ya chanzo na rekodi rasmi ya MDPI umehifadhiwa.
Mchango sawa: Hakuna taarifa ya equal-contribution katika chanzo.
Mwandishi wa mawasiliano: Hafsa Mimouni.
Taasisi 1: Mechanical and Thermal Processes and Controls (PCMT) Laboratory, National Graduate School of Arts and Crafts, Mohamed V University, Rabat, Morocco.
Taasisi 2: Intelligent Systems, Industrial and Mechanical Engineering (LISIME) Laboratory, National Graduate School of Arts and Crafts, Hassan II University, Casablanca, Morocco.
Jarida: Sustainability.
Mchapishaji: MDPI, Basel, Switzerland.
Juzuu / namba: 18(18).
Namba ya makala: 9278.
Mwaka wa uchapishaji: 2026.
Received: 26 June 2026.
Revised: 1 September 2026.
Accepted: 3 September 2026.
Published: 9 September 2026.
DOI: 10.3390/su18189278.
Aina ya chanzo: Peer-reviewed computational optimization research article.
Preprint: Hakuna toleo tofauti la preprint lililotajwa katika chanzo.
Leseni: Creative Commons Attribution (CC BY).
Aina ya utafiti: Utafiti wa mathematical optimization na computational-comparison unaotegemea benchmark za usanisi.
Tatizo kuu: PFSP-SDST with uncertain processing times.
Mbinu kuu: Distributionally Robust Optimization inayotumia Kullback–Leibler divergence ambiguity set.
Malengo makuu: Kupunguza Total Weighted Flow Time na machine-dependent operational cost kwa weighted aggregation.
Suluhisho exact: Exhaustive enumeration + no-good cuts inayosaidiwa na IBM ILOG CPLEX Optimization Studio 12.10.0; small instances, hadi job 10.
Approximate methods: GRASP, proposed HGRASP, ALO na SMA.
Mazingira ya programu: MATLAB R2021a; CPLEX 12.10.0.
Hardware: ASUS VivoBook X1502VA, 13th Generation Intel Core i9, 16 GB RAM.
Ukubwa wa benchmark: 4–300 job, 2–20 machine.
Processing mean: \(\mu_P\sim U(5,15)\).
Processing standard deviation: \(\sigma_P\sim U(0.5,2)\).
Scenario generation: \(PT\sim N(\mu_P,\sigma_P^2)\), strictly-positive lower bound hutumiwa inapohitajika.
Scenario sets: \(S_{small}=30\), \(S_{large}=300\).
Base seed: 7.
Initial setup: \(U(0.5,2.5)\).
Sequence-dependent setup: \(U(0.5,3.5)\).
Job weights: \(U(1,5)\).
Run-cost coefficient: \(U(1,1.5)\).
Setup-cost coefficient: \(U(0.6,1)\).
Idle-cost coefficient: \(U(0.2,0.5)\).
Objective weights: \(\alpha=\beta=0.5\).
Ambiguity radius: \(\rho=0.05\).
GRASP RCL: \(\alpha_{RCL}=0.7\); 0.3, 0.5 na 0.7 zilichunguzwa kwa preliminary exploratory.
Iteration limit: 100.
Random-Keys population: 30.
Independent stochastic runs: 50.
Illustrative GUM result: \(129.45\pm9.62\), expanded interval \([119.83,139.07]\), \(k=2\).
Medium Friedman — DRO: χ² = 60.115, df = 3, p = 5.56 × 10⁻13.
Medium Friedman — CPU: χ² = 78.778, df = 3, p = 5.94 × 10⁻17.
Large Friedman — DRO: χ² = 25.920, df = 3, p = 9.91 × 10⁻6.
Large Friedman — CPU: χ² = 28.080, df = 3, p = 3.49 × 10⁻6.
Large solution-quality ranking: ALO = 1.5, SMA = 1.5, HGRASP = 3.1, GRASP = 3.9.
Large computational-time ranking: SMA = 1, ALO = 2, GRASP = 3.2, HGRASP = 3.8.
ALO–SMA post-hoc DRO: Holm-adjusted p = 1.000000; hakuna tofauti muhimu.
ALO–SMA post-hoc computational time: Holm-adjusted p = 0.011719; kuna tofauti muhimu.
Uthibitishaji halisi wa uwanjani: Hakuna; umependekezwa kama future work.
Matumizi halisi ya nishati: Hayajapimwa. Operational-cost coefficients si direct physical energy, electricity price, power au emissions.
Funding: Hakuna External funding.
Institutional Review Board: Not applicable.
Informed Consent: Not applicable.
Data Availability: Synthetic datasets na run-level outputs hazikuhifadhiwa kama standalone historical files; generation procedures, scenario settings, parameter values na seed zimetolewa katika makala. Synthetic instances/output zinaweza kuzalishwa tena/kutolewa kutoka kwa corresponding author kwa reasonable request.
Source code: MATLAB implementation si public; inaendelea kutengenezwa kama ongoing research implementation.
Conflicts of Interest: Authors declare no conflicts of interest.
Michango ya waandishi: Conceptualization: H.M., A.J.; methodology: H.M., A.J.; software: H.M.; validation: H.M., A.J., S.A.; formal analysis: H.M.; investigation: H.M.; data curation: H.M.; original draft: H.M.; review/editing: H.M., A.J., S.A.; visualization: H.M.; supervision: A.J., S.A.
Dokezo la istilahi: Utafiti hutumia hasa istilahi PFSP-SDST; katika baadhi ya aya za computational-method kuna maandishi PFSSP/PFSSP-SDST. Kwa kuwa chanzo hakifafanui hizi kuwa darasa tofauti la tatizo, Verianla huhifadhi PFSP-SDST kama canonical term kuu.
Mpaka mkuu wa ufasiri: Comparative computational findings zote ni halali kwa synthetic benchmark conditions, fixed \(\rho=0.05\) na fixed algorithm settings zilizotumika.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *