


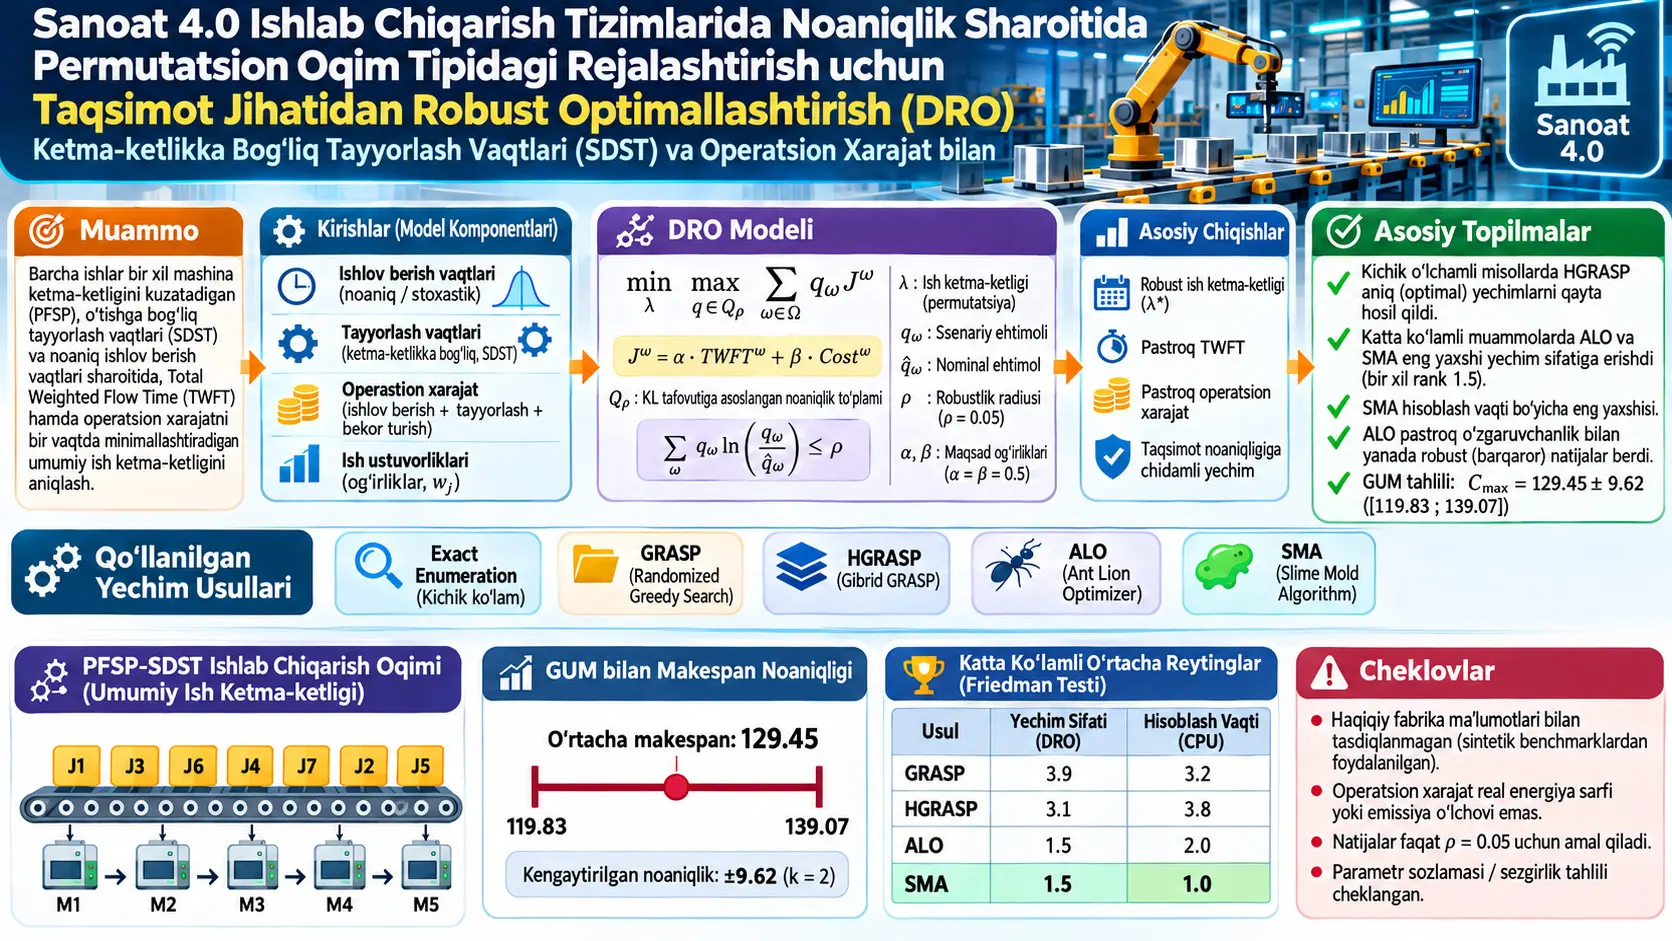
Taqsimot Jihatidan Robust Optimallashtirish (Distributionally Robust Optimization, DRO) — noaniq parametr faqat bitta va aniq ehtimollik taqsimotidan kelib chiqadi deb faraz qilish o‘rniga, ehtimoliy taqsimotlardan tashkil topgan ambiguity set ichidagi eng noqulay kutilayotgan natijani hisobga olib qaror ishlab chiqaradigan optimallashtirish yondashuvidir. Ushbu tadqiqot DRO ni barcha ishlar mashinalarga bir xil ketma-ketlikda kiradigan Permutation Flow Shop Scheduling Problem tuzilmasiga, ketma-ketlikka bog‘liq tayyorlash vaqtlariga (Sequence-Dependent Setup Times; SDST), noaniq processing times ga va processing/setup/idle vaqtlaridan hosil bo‘ladigan operational cost ga integratsiya qiladi. Maqsad Total Weighted Flow Time (TWFT) va operational cost ni og‘irlikli yagona maqsad funksiyasida birgalikda minimallashtiradigan umumiy ish ketma-ketligini aniqlashdir.
Haqiqiy processing-time distribution to‘liq ma’lum emas deb qabul qilinadi; sintetik processing scenarios nominal taqsimot atrofida yaratiladi va ehtimoliy scenario probability distributions Kullback–Leibler divergence orqali aniqlangan ambiguity set ichida baholanadi. Robustness radius \(\rho\) nominal taqsimotdan qanchalik uzoqlashish mumkinligini nazorat qiladi. Tadqiqotdagi barcha asosiy computational experiments uchun \(\rho=0.05\) o‘zgarmas qilib belgilangan; shu sababli olingan algoritm reytinglari va robustness natijalari boshqa \(\rho\) qiymatlari uchun isbotlangan emas.
Kichik o‘lchamli muammolar uchun IBM ILOG CPLEX yordamidagi exhaustive enumeration usuli bilan global-optimum benchmark yechimlar olingan. Medium va large instances uchun Greedy Randomized Adaptive Search Procedure (GRASP), tadqiqot taklif qilgan Hybrid GRASP (HGRASP), Ant Lion Optimizer (ALO) va Slime Mold Algorithm (SMA) taqqoslangan. Kichik misollarda HGRASP sinovdan o‘tkazilgan barcha exact benchmarklarni qayta hosil qilgan; boshqa yaqinlashtirilgan usullar ham ko‘p holatlarda exact yoki juda yaqin natijalarga erishgan. Katta o‘lchamli muammolarda Friedman testi solution quality va computational time bo‘yicha algoritmlar o‘rtasida ahamiyatli farq borligini ko‘rsatgan. ALO va SMA solution quality bo‘yicha bir xil eng yaxshi mean rank qiymatiga erishgan va post-hoc tahlilda bir-biridan ahamiyatli farq qilmagan; SMA computational time bo‘yicha eng yaxshi reytingga erishgan.
Tadqiqot haqiqiy zavoddan olingan ishlab chiqarish yozuvlarida tasdiqlanmagan. Processing times, setup times, job weights va machine cost coefficients sintetik tarzda yaratilgan. Shuningdek, operational-cost coefficients haqiqiy elektr energiyasi iste’moli, quvvat, energiya tarifi yoki emissiya o‘lchovlari emas. Shu sababli natijalar proposed DRO framework ning sintetik benchmarklar sharoitidagi computational xulqini ko‘rsatadi; haqiqiy Industry 4.0 zavodida xuddi shunday xarajat yoki energiya yutug‘i yuz berishini isbotlamaydi.
PFSP-SDST Nima va Ushbu Tadqiqotda Qaysi Muammo Yechilmoqda?
PFSP-SDST bir xil \(n\) ta ish bir xil \(m\) ta mashinadan bir xil texnologik ketma-ketlikda o‘tadigan hamda mashinani yangi ishga tayyorlash vaqti faqat shu ishga emas, undan bevosita oldin qaysi ish bajarilganiga ham bog‘liq bo‘lgan kombinator jadval tuzish muammosidir; ushbu tadqiqotda processing times qo‘shimcha ravishda stochastic deb olinib, umumiy ish ketma-ketligi TWFT bilan operational cost ni noaniqlik sharoitida birgalikda minimallashtiradigan tarzda tanlanadi.
Permutation Flow Shop mantiqi
Ishlar to‘plami:
\[ J=\{1,\ldots,n\} \]
va mashinalar to‘plami:
\[ M=\{1,\ldots,m\} \]
deb ta’riflangan.
Har bir ish barcha mashinalardan bir xil ketma-ketlikda o‘tadi. Bundan tashqari, faqat texnologik yo‘nalish emas, ishlarning permutatsiyasi ham barcha mashinalarda umumiydir. Masalan:
\[ \lambda=[J_3,J_1,J_4,J_2] \]
tanlangan bo‘lsa, barcha mashinalarda ishlar shu umumiy ketma-ketlik bo‘yicha bajariladi.
Sequence-Dependent Setup Time nega muhim?
Mashinaning \(J_i\) ishidan keyin \(J_j\) ishiga o‘tishda talab qilinadigan tayyorlash vaqti:
\[ s_{i,j,k} \]
bilan ifodalanadi.
Demak, tayyorlash vaqti faqat maqsad ishga bog‘liq emas; predecessor–successor juftligi va mashina \(k\) birgalikda muhimdir.
Bu holat bo‘yoq almashtirish, qolipni sozlash, asbob almashtirish, tozalash yoki mahsulot oilasini almashtirish kabi sanoat o‘tishlarini modellashtirishi mumkin. Manba ma’lum bir zavod jarayoniga tegishli haqiqiy setup matritsasidan foydalanmaydi; nazorat qilinadigan sintetik benchmarklarni yaratadi.
Stochastic processing time qanday ifodalanadi?
Job \(j\) ning machine \(k\) dagi scenario \(\omega\) processing time i:
\[ p^\omega_{j,k} \]
deb ta’riflanadi.
Ish sequence position \(r\) ga tayinlanganda position-level processing time:
\[ PT^\omega_{r,k} \]
bo‘ladi.
Noaniqlik scenario set:
\[ \Omega=\{1,\ldots,S\} \]
orqali ifodalanadi.
Asosiy o‘zgaruvchilar
| Belgi | Ma’nosi |
|---|---|
| \(n\) | Ishlar soni |
| \(m\) | Mashinalar soni |
| \(\omega\) | Uncertainty scenario indeksi |
| \(\lambda\) | Umumiy job permutation |
| \(x_{j,r}\) | Job \(j\), position \(r\) ga tayinlansa 1 bo‘ladigan binary variable |
| \(y_{i,j,r}\) | Position \(r-1\) da \(i\), position \(r\) da \(j\) bo‘lsa 1 bo‘ladigan adjacency variable |
| \(p^\omega_{j,k}\) | Scenario \(\omega\) da job \(j\) ning machine \(k\) dagi processing time i |
| \(s^0_{j,k}\) | Job \(j\) uchun initial setup time |
| \(s_{i,j,k}\) | \(i\rightarrow j\) o‘tishining sequence-dependent setup time i |
| \(ST_{r,k}\) | Position \(r\) da machine \(k\) setup duration |
| \(A^\omega_{r,k}\) | Setup completion time |
| \(B^\omega_{r,k}\) | Processing start time |
| \(C^\omega_{r,k}\) | Processing completion time |
| \(I^\omega_{r,k}\) | Machine idle time |
| \(w_j\) | Job \(j\) ning TWFT priority weight i |
| \(c_k^{run}\) | Machine \(k\) processing unit cost coefficient |
| \(c_k^{setup}\) | Machine \(k\) setup unit cost coefficient |
| \(c_k^{idle}\) | Machine \(k\) idle unit cost coefficient |
| \(\alpha,\beta\) | TWFT va operational-cost og‘irliklari |
| \(q_\omega\) | Ambiguity set ichidagi scenario probability |
| \(\hat q_\omega\) | Nominal scenario probability; manbada uniform \(\hat q_\omega=1/S\) |
| \(\rho\) | KL ambiguity-set robustness radius |
| \(\eta\) | DRO dual reformulation dagi auxiliary variable |
Tenglama (1): Total Weighted Flow Time
\[ TWFT^\omega= \sum_{r\in R}\sum_{j\in J} w_j x_{j,r} C^\omega_{r,m} \tag{1} \]
Nimani hisoblaydi? Har bir job ning oxirgi mashinadagi completion time ini job priority weight ga ko‘paytirib, ularning yig‘indisini oladi.
\(C^\omega_{r,m}\), scenario \(\omega\) da position \(r\) dagi ishning oxirgi mashinadagi completion time idir.
\(w_j\) oshgani sari tegishli job ning kech tugashi objective ga kattaroq jarima keltiradi. Shu tarzda shoshilinch yoki yuqori ustuvorlikdagi ishlar optimization ichida ko‘proq og‘irlik olishi mumkin.
Tenglama (2): Operational Cost
\[ Cost^\omega= \sum_{k\in M} \left[ c_k^{run}\sum_{r\in R}PT^\omega_{r,k} + c_k^{setup}\sum_{r\in R}ST_{r,k} + c_k^{idle}\sum_{r\in R}I^\omega_{r,k} \right] \tag{2} \]
Cost function uch qismdan iborat:
- processing cost,
- sequence-dependent setup cost,
- machine idle cost.
Manba muhim farqni ko‘rsatadi: doimiy scenario uchun jami processing time ishlar ketma-ketligiga bog‘liq emas. Shu sababli processing-cost hadi o‘sha scenario ichida muqarrar asosiy xarajat kabi ishlaydi. Job sequencing qarorining xarajatga asosiy ta’siri setup va idle komponentlaridan keladi.
Ilmiy chegara: \(c_k^{run}\), \(c_k^{setup}\) va \(c_k^{idle}\) jismoniy energiya o‘lchash qurilmasidan olingan qiymatlar emas. Bu objective haqiqiy kWh, elektr hisob-kitobi yoki CO₂ emissiyasini hisoblamaydi.
Tenglama (3): Yagona objective
\[ J^\omega= \alpha TWFT^\omega+ \beta Cost^\omega \tag{3} \]
Ikki maqsad weighted aggregation orqali bitta objective ga aylantiriladi.
Computational experiments uchun:
\[ \alpha=\beta=0.5 \]
ishlatilgan.
Biroq manba ayniqsa bu tanlov TWFT va cost ning numerical contribution lari teng yoki umumiy decision-maker preference tuzilmasini ifodalaydi degani emasligini ta’kidlaydi. Ikki komponentning masshtablari farq qilishi mumkin.
DRO, Stochastic Programming va Klassik Robust Optimization dan Qanday Farq Qiladi?
Stochastic programming odatda ma’lum probability distribution to‘g‘ri ma’lum deb faraz qilsa, klassik Robust Optimization alohida parameter realizations ning uncertainty set ichidagi eng yomon holatiga qarshi himoya beradi; ushbu tadqiqotdagi DRO esa bitta taqsimot o‘rniga nominal taqsimotga KL divergence jihatidan yetarlicha yaqin bo‘lgan probability distributions oilasidagi eng yomon kutilayotgan objective qiymatini minimallashtiradi.
Tenglama (4): Worst-case expected objective
\[ \min J_{DRO} = \min_\lambda \max_{q\in Q_\rho} \sum_{\omega\in\Omega}q_\omega J^\omega \tag{4} \]
Bu yerdagi ichki maximization tanlangan schedule uchun ambiguity set ichidagi eng noqulay probability distribution ni izlaydi.
Tashqi minimization esa shu worst-case expected objective ni imkon qadar kichraytiradigan job permutation ni tanlaydi.
Tenglama (5): Kullback–Leibler ambiguity set
\[ Q_\rho= \left\{ q\in\mathbb{R}_+^S: \sum_{\omega\in\Omega}q_\omega=1,\; \sum_{\omega\in\Omega} q_\omega \ln\left( \frac{q_\omega}{\hat q_\omega} \right) \le\rho \right\} \tag{5} \]
Birinchi shart probability values yig‘indisi 1 bo‘lishini ta’minlaydi.
Ikkinchi shart candidate distribution \(q\) ning nominal distribution \(\hat q\) dan KL divergence bo‘yicha eng ko‘pi bilan \(\rho\) miqdorida uzoqlashishiga ruxsat beradi.
Robustness Radius \(\rho\) Nima Uchun Kerak?
\(\rho\) ambiguity set hajmini nazorat qiladi; kichikroq \(\rho\) optimization ni nominal probability distribution ga yaqin ushlab turadi, kattaroq \(\rho\) esa ko‘proq ehtimoliy taqsimotga ruxsat berib schedule ni taqsimot noaniqligiga nisbatan ehtiyotkorroq qiladi, biroq ushbu tadqiqotning barcha hisobot qilingan asosiy natijalari faqat \(\rho=0.05\) shartiga tegishli.
Shu sababli “ALO har bir \(\rho\) qiymatida bir xil” yoki “SMA barcha robustness darajalarida eng tez” degan xulosa chiqarib bo‘lmaydi.
Tenglama (6): Dual DRO reformulation
\[ J_{DRO} = \min_{\eta>0} \left[ \eta\rho+ \eta\ln \left( \sum_{\omega\in\Omega} \hat q_\omega \exp\left(\frac{J^\omega}{\eta}\right) \right) \right] \tag{6} \]
Bu reformulation Equation (4) dagi nested min-max tuzilmaning inner distribution maximization qismini Lagrangian duality yordamida bir qatlamli va computational jihatdan amaliyroq convex expression ga aylantiradi.
\(\eta\) auxiliary dual variable bo‘lib, har bir candidate permutation uchun optimallashtiriladi.
Exact enumeration implementation da \(\eta\), MATLAB ning bounded one-dimensional optimizer i fminbnd yordamida optimallashtirilgan.
Equations (7)–(25): Feasibility va vaqt rejalashtirish cheklovlari
Manbaning mathematical model i faqat objective function dan iborat emas. Job assignment, predecessor–successor munosabati, setup calculation, machine precedence, completion times va variable domains quyidagi constraints bilan belgilanadi.
\[ \sum_{j\in J}x_{j,r}=1,\qquad \forall r\in R \tag{7} \]
Har bir sequence position ga aynan bitta job tayinlanadi.
\[ \sum_{r\in R}x_{j,r}=1,\qquad \forall j\in J \tag{8} \]
Har bir job aynan bitta position ga tayinlanadi. Equations (7) va (8) birgalikda yaroqli permutation hosil qiladi.
\[ y_{i,j,r}\le x_{i,r-1} \tag{9} \]
\[ y_{i,j,r}\le x_{j,r} \tag{10} \]
\[ y_{i,j,r}\ge x_{i,r-1}+x_{j,r}-1 \tag{11} \]
Equations (9)–(11), \(y_{i,j,r}\) faqat job \(i\) oldingi position da va job \(j\) joriy position da bo‘lgandagina 1 bo‘lishini ta’minlaydigan linear adjacency formulation dir.
\[ ST_{1,k} = \sum_{j\in J}s^0_{j,k}x_{j,1} \tag{12} \]
Birinchi position uchun predecessor mavjud bo‘lmagani sababli initial setup birinchi tanlangan job ga qarab hisoblanadi.
\[ ST_{r,k} = \sum_{i\in J}\sum_{j\in J} s_{i,j,k}y_{i,j,r}, \qquad r=2,\ldots,n \tag{13} \]
Keyingi position larda setup time predecessor–successor juftligiga bog‘liq.
\[ PT^\omega_{r,k} = \sum_{j\in J} p^\omega_{j,k}x_{j,r} \tag{14} \]
Bu constraint position \(r\) ga qaysi job tayinlangan bo‘lsa, uning scenario-dependent processing time ini position ga ko‘chiradi.
\[ C^\omega_{0,k}=0 \tag{15} \]
\[ C^\omega_{r,0}=0 \tag{16} \]
Scheduling horizon boshida oldingi job va “machine 0” tomonidagi completion times nolga tenglashtiriladi.
\[ A^\omega_{r,k} = C^\omega_{r-1,k} + ST_{r,k} \tag{17} \]
Setup completion time shu mashinadagi oldingi job completion bilan zarur setup duration yig‘indisidir.
\[ B^\omega_{r,k}\ge A^\omega_{r,k} \tag{18} \]
Processing setup tugamasdan boshlana olmaydi.
\[ B^\omega_{r,k}\ge C^\omega_{r,k-1} \tag{19} \]
Job oldingi mashinadagi ishlov tugamasdan keyingi mashinada boshlana olmaydi.
\[ C^\omega_{r,k} = B^\omega_{r,k} + PT^\omega_{r,k} \tag{20} \]
Completion time = processing start + processing duration.
\[ I^\omega_{r,k} = B^\omega_{r,k} - A^\omega_{r,k} \tag{21} \]
Setup tayyor bo‘lganidan processing boshlanguncha o‘tgan farq machine idle time hisoblanadi.
\[ ST_{r,k}\ge0 \tag{22} \]
\[ PT^\omega_{r,k}, A^\omega_{r,k}, B^\omega_{r,k}, C^\omega_{r,k}, I^\omega_{r,k}\ge0 \tag{23} \]
Temporal variables manfiy qiymat ola olmaydi.
\[ x_{j,r}\in\{0,1\} \tag{24} \]
\[ y_{i,j,r}\in\{0,1\} \tag{25} \]
Assignment va adjacency variables binary dir.
Illustrative example: 7 ta ish, 5 ta mashina
Manba DRO mantiqini aniqroq ko‘rsatish uchun:
- \(n=7\) job,
- \(m=5\) machine,
- 300 generated processing-time scenarios,
- \(\rho=0.05\),
- \(\alpha=0.5\),
- \(\beta=0.5\)
ishlatilgan illustrative instance ni taqdim etadi.
Job weights:
\[ w=[4,2,5,3,1,4,2] \]
Birinchi tushuntiruvchi feasible sequence:
\[ \lambda=[J_4,J_1,J_2,J_6,J_3,J_5,J_7] \]
sifatida tanlangan.
DRO aniqlagan optimal robust permutation:
\[ \lambda^*=[J_1,J_3,J_6,J_4,J_7,J_2,J_5] \]
ko‘rinishidadir.
Uchta representative processing-time scenario
Manba 300 generated scenario ichidan sharhlash qulayligi uchun favourable, degraded va variable sharoitlarini ifodalovchi uchta matrix ni tanlaydi.
\[ PT^1= \begin{bmatrix} 2&17&9&11&14&9&11\\ 4&8&10&10&13&8&6\\ 7&14&8&9&15&7&11\\ 14&7&8&15&5&9&13\\ 11&9&6&9&8&8&10 \end{bmatrix} \]
\[ PT^2= \begin{bmatrix} 6&11&7&14&15&11&11\\ 7&8&12&11&13&8&5\\ 9&15&6&8&14&5&11\\ 15&9&10&14&4&10&12\\ 11&7&7&12&10&9&9 \end{bmatrix} \]
\[ PT^3= \begin{bmatrix} 10&12&10&14&15&9&9\\ 8&7&12&12&12&7&6\\ 9&15&5&12&16&6&11\\ 15&6&14&15&8&11&12\\ 10&8&8&8&7&10&8 \end{bmatrix} \]
Qatorlar mashinalarni, ustunlar ishlarni ifodalaydi.
GUM Noaniqlik Tahlili DRO ga Nima Qo‘shadi?
DRO job sequence ni probability-distribution ambiguity sharoitida robust tarzda tanlasa, GUM tahlili tanlangan optimal schedule ning makespan chiqishi scenario realizations bo‘ylab qanchalik tarqalishini alohida miqdoriy baholaydi; manba 300 scenario uchun mean makespan, combined standard uncertainty va \(k=2\) expanded uncertainty ni hisoblab, optimal makespan ni \(129.45\pm9.62\) va expanded interval ni \([119.83,139.07]\) deb hisobot qiladi.
Tenglama (26): Mean makespan
\[ \overline{C}_{max} = \frac{1}{N} \sum_{\omega=1}^{N} C_{max}(\omega) \tag{26} \]
Bu yerda \(N=300\) generated scenario.
Tenglama (27): Combined standard uncertainty
\[ u_c^2(C_{max}) = \frac{1}{N-1} \sum_{\omega=1}^{N} \left[ C_{max}(\omega)-\overline{C}_{max} \right]^2 \tag{27} \]
Bu ifoda scenario makespan values ning variance ini hisoblaydi. Combined standard uncertainty \(u_c\), variance ning kvadrat ildizidir.
Tenglama (28): Expanded uncertainty
\[ U=k\,u_c \tag{28} \]
Manba:
\[ k=2 \]
ni ishlatadi va buni taxminan %95 coverage level bilan bog‘laydi.
Tenglama (29): Makespan natijasi
\[ C_{max} = \overline{C}_{max} \pm U \tag{29} \]
Illustrative example uchun:
\[ C_{max}=129.45\pm9.62 \]
va expanded uncertainty interval:
\[ [119.83,\;139.07] \]
deb berilgan.
Optimal DRO permutation bilan manual permutation taqqoslanishi
| Scenario | Sharoit | \(TWFT^\omega\) | \(Cost^\omega\) | \(J^\omega\) |
|---|---|---|---|---|
| 1 | Favourable | 1406.2 | 546.07 | 976.14 |
| 2 | Degraded | 1612.7 | 558.08 | 1085.4 |
| 3 | Variable | 1787.2 | 586.98 | 1187.1 |
| Scenario | Sharoit | \(TWFT^\omega\) | \(Cost^\omega\) | \(J^\omega\) |
|---|---|---|---|---|
| 1 | Favourable | 2262.4 | 557.51 | 1410 |
| 2 | Degraded | 2335.7 | 570.81 | 1453.3 |
| 3 | Variable | 2359.1 | 591.22 | 1475.2 |
Bir xil processing-time realizations, setup times, machine cost coefficients va job weights ishlatilgani sababli bu illustrative comparison dagi farq sequence selection dan kelib chiqadi.
Source Figures 2–4 favourable, degraded va variable scenarios uchun optimal DRO schedule ning Gantt charts ini ko‘rsatadi. Manba rasmlari machine occupation, setup, idle va job progression scenario o‘zgargani sari qanday cho‘zilishini ko‘rsatadi. Exact Gantt bar coordinates raqamli jadval ko‘rinishida e’lon qilinmagani sababli Verianla bu chizmalarni soxta aniqlik bilan qayta yaratmaydi.
Tadqiqot Usuli va Natijalari
Computational experimental framework
| Parametr | Manba qiymati |
|---|---|
| Job soni | 4–300 |
| Machine soni | 2–20 |
| \(\mu_P\) | \(U(5,15)\) |
| \(\sigma_P\) | \(U(0.5,2)\) |
| Scenario processing time | \(PT\sim N(\mu_P,\sigma_P^2)\) |
| Search scenario set | \(S_{small}=30\) |
| Final evaluation scenario set | \(S_{large}=300\) |
| Base random seed | 7 |
| Initial setup | \(setup_0\sim U(0.5,2.5)\) |
| Sequence-dependent setup | \(setup_{seq}\sim U(0.5,3.5)\) |
| Job weight | \(w_j\sim U(1,5)\) |
| Processing cost coefficient | \(c_k^{run}\sim U(1,1.5)\) |
| Setup cost coefficient | \(c_k^{setup}\sim U(0.6,1)\) |
| Idle cost coefficient | \(c_k^{idle}\sim U(0.2,0.5)\) |
| TWFT weight | \(\alpha=0.5\) |
| Operational-cost weight | \(\beta=0.5\) |
| Ambiguity radius | \(\rho=0.05\) |
| GRASP RCL parameter | \(\alpha_{RCL}=0.7\) |
| Maximum iterations | 100 |
| Random-Keys population | \(nPop=30\) |
| Independent runs | 50 |
| MATLAB | MATLAB R2021a |
| Exact solver | IBM ILOG CPLEX Optimization Studio 12.10.0 |
| Hardware | ASUS VivoBook X1502VA, 13th Gen Intel Core i9, 16 GB RAM |
\(\alpha_{RCL}\) nega 0,7?
Manba preliminary exploratory tests vaqtida:
\[ \alpha_{RCL}\in\{0.3,0.5,0.7\} \]
qiymatlarini ko‘rib chiqqan va solution quality bilan diversification o‘rtasidagi eng maqbul practical compromise sifatida 0,7 qiymatini tanlagan.
Bu jarayon systematic hyperparameter optimization sifatida taqdim etilmaydi.
100 iteration barcha algoritmlarga teng computational budget beradimi?
Yo‘q. Manba barcha iterative algorithms uchun 100 iteration ishlatgan bo‘lsa-da, turli algoritmlar bitta iteration ichida turli miqdorda DRO objective evaluation bajarishi mumkinligini ochiq aytadi.
Demak, 100 iteration har bir usulga bir xil computational work berilganini anglatmaydi. Shu sababli CPU time alohida taqqoslangan.
Exact enumeration qanday ishlaydi?
Small instances uchun CPLEX assignment model har bir iteration da avval sinab ko‘rilmagan feasible permutation hosil qiladi.
Permutation decode qilingandan so‘ng setup, processing, start/completion va idle variables tashqarida hisoblanib full DRO objective baholanadi.
Keyin shu permutation ning yana hosil qilinishiga yo‘l qo‘ymaydigan no-good cut qo‘shiladi:
\[ \sum_{j\in J}\sum_{r\in R} x^*_{j,r}x_{j,r} \le n-1 \]
Har bir feasible permutation aynan bir marta yaratilgani uchun small instances da barcha \(n!\) permutations exhaustively baholanadi.
Manba exact procedure ni eng ko‘pi bilan 10 ta job bo‘lgan instances bilan cheklagan.
GRASP-DRO
GRASP randomised greedy construction dan foydalanadi.
Initial job priority score:
\[ \phi_j= w_j \sum_{k=1}^{m} \mu P_{j,k} \]
orqali yaratiladi.
Candidate solutions orasida Restricted Candidate List:
\[ RCL= \left\{ cand_t: DRO(cand_t) \le J_{min} +\alpha_{RCL}(J_{max}-J_{min}) \right\} \]
ko‘rinishida ta’riflanadi va RCL ichidan random candidate tanlanadi.
HGRASP-DRO
HGRASP to‘rtta asosiy komponentni birlashtiradi:
- DRO-adapted NEH initialization,
- GRASP constructive search,
- swap-based local search,
- restart/diversification mechanism.
Keyingi iteration boshida %50 ehtimol bilan original robust NEH sequence qayta ishlatiladi; aks holda random swaps yordamida boshlang‘ich ketma-ketlik xilma-xillashtiriladi.
ALO-DRO
Ant Lion Optimizer tabiiy ravishda continuous search space da ishlagani sababli job permutation yaratish uchun Random Keys representation ishlatilgan.
Continuous vector qiymatlari saralanib feasible permutation ga aylantiriladi. Population search davomida elite solution saqlanadi va candidate schedules reduced scenario set orqali DRO objective bilan baholanadi.
SMA-DRO
Slime Mold Algorithm ham Random Keys representation dan foydalanadi. Population adaptive weighting bilan update qilinadi; yaxshiroq solutions kuchliroq influence oladi, exploration yo‘qolmasligi uchun zaif solutions ham population ichida o‘z rolini saqlaydi.
Manba barcha Random-Keys population settings uchun \(nPop=30\) ishlatgan.
Small-scale exact benchmark natijalari
| Instance | Exact | Exact CPU | GRASP | CPU | HGRASP | CPU | ALO | CPU | SMA | CPU |
|---|---|---|---|---|---|---|---|---|---|---|
| 4×2 | 101.02 | 2.35 | 101.02 | 1.61 | 101.02 | 2.74 | 101.02 | 2.38 | 101.02 | 3.12 |
| 4×4 | 200.66 | 1.10 | 200.66 | 0.42 | 200.66 | 0.96 | 200.66 | 1.00 | 200.66 | 0.94 |
| 4×6 | 267.16 | 0.49 | 267.16 | 1.00 | 267.16 | 1.11 | 267.16 | 1.15 | 267.16 | 1.08 |
| 6×2 | 239.2 | 38.61 | 239.2 | 0.85 | 239.2 | 2.49 | 239.2 | 1.25 | 239.2 | 1.13 |
| 6×4 | 338.49 | 38.89 | 338.49 | 0.86 | 338.49 | 2.59 | 338.49 | 1.26 | 338.49 | 1.16 |
| 6×6 | 410.61 | 38.55 | 410.61 | 0.87 | 410.61 | 2.80 | 410.61 | 1.27 | 410.61 | 1.16 |
| 8×2 | 368.39 | 89,964 | 369.62 | 1.31 | 368.39 | 5.22 | 368.39 | 1.27 | 368.39 | 1.13 |
| 8×4 | 562.4 | 130,600 | 588.91 | 1.88 | 562.4 | 7.44 | 562.4 | 1.91 | 562.4 | 1.71 |
| 8×6 | 642.64 | 70,895 | 646.41 | 1.35 | 642.64 | 5.51 | 642.64 | 1.29 | 642.64 | 1.17 |
| 9×4 | 532.67 | 85,640 | 536.15 | 1.33 | 532.67 | 5.99 | 533.62 | 1.09 | 533.62 | 0.97 |
| 10×2 | 509.65 | 108,450 | 517.29 | 4.08 | 509.65 | 19.16 | 509.65 | 2.84 | 509.65 | 2.45 |
HGRASP ushbu small-scale instances ning barchasida exact objective qiymatini qayta hosil qilgan.
Exact enumeration esa instance kattalashgan sari juda tez computationally expensive bo‘lib boradi.
Medium-scale natijalari
| Instance | GRASP | CPU | HGRASP | CPU | ALO | CPU | SMA | CPU |
|---|---|---|---|---|---|---|---|---|
| 10×5 | 798.97 | 1.96 | 785.17 | 10.71 | 788.96 | 1.38 | 785.63 | 1.23 |
| 10×10 | 1413.7 | 2.04 | 1397.1 | 12.71 | 1397.1 | 1.44 | 1397.1 | 1.28 |
| 10×15 | 1932.2 | 2.15 | 1904.9 | 13.13 | 1904.9 | 1.51 | 1904.9 | 1.35 |
| 20×5 | 2674.7 | 7.38 | 2529.7 | 71.17 | 2535.7 | 1.96 | 2535.1 | 1.54 |
| 20×10 | 3679.1 | 26.49 | 3509.4 | 268.03 | 3524.6 | 7.72 | 3526.9 | 5.98 |
| 20×15 | 4339.95 | 7.77 | 4171.08 | 85.54 | 4183.04 | 2.15 | 4184.21 | 1.76 |
| 30×5 | 5078.17 | 13.02 | 4749.6 | 70.83 | 4528.46 | 2.07 | 4564.33 | 1.72 |
| 30×10 | 6352.42 | 14.07 | 6006.96 | 77.82 | 5888.47 | 2.22 | 5895.96 | 1.89 |
| 30×15 | 8242.85 | 15.28 | 8022.30 | 86 | 7876.46 | 2.45 | 7876.79 | 2.10 |
| 40×5 | 8846.77 | 27.5 | 8386.14 | 149.8 | 8016.26 | 4.81 | 7990.32 | 3.49 |
| 40×10 | 10,849.9 | 72.9 | 10,296.85 | 286.6 | 9860.56 | 6.78 | 9864.14 | 5.28 |
| 40×15 | 13,639.6 | 28.28 | 13,111.05 | 105.42 | 12,695.5 | 2.89 | 12,627.73 | 2.26 |
| 50×5 | 12,626.2 | 37.7 | 12,006.1 | 100.72 | 10,170.4 | 2.60 | 10,961.06 | 1.83 |
| 50×10 | 14,524.4 | 145.38 | 13,739.86 | 410.71 | 13,028.1 | 9.61 | 13,079.04 | 7.27 |
| 50×15 | 17,482 | 46 | 16,967 | 128.85 | 16,097 | 3.17 | 15,921 | 2.43 |
| 60×5 | 16,117 | 58.38 | 15,679 | 127.82 | 14,597 | 2.95 | 14,453 | 2.03 |
| 60×10 | 21,687 | 2028.5 | 21,143 | 616.84 | 19,656 | 13.27 | 19,724 | 9.57 |
| 60×15 | 26,425.6 | 70.51 | 26,124.06 | 160.05 | 24,834.7 | 3.48 | 24,842.04 | 2.65 |
| 70×5 | 22,505 | 1162.5 | 21,971 | 643.46 | 20,143 | 12.78 | 20,234 | 8.66 |
| 70×10 | 27,914 | 108.63 | 27,491 | 209.6 | 25,254 | 4.53 | 25,034 | 2.98 |
| 70×15 | 31,230.1 | 181.35 | 30,464.62 | 506.59 | 28,931.51 | 7.07 | 29,210.98 | 5.08 |
| 80×5 | 29,386.5 | 108.58 | 28,444.54 | 185.95 | 26,555.80 | 3.69 | 26,178.90 | 2.24 |
| 80×10 | 36,061.27 | 119.92 | 35,943.01 | 206.51 | 33,641.2 | 3.62 | 33,134.3 | 2.56 |
| 80×15 | 36,972.02 | 252 | 36,608.48 | 399.47 | 34,376.15 | 6.87 | 34,079.12 | 4.81 |
| 90×5 | 36,832.33 | 136.6 | 36,661.97 | 211.89 | 33,847.33 | 3.66 | 34,033.45 | 2.23 |
| 90×10 | 46,181.93 | 298.56 | 45,608.33 | 438.10 | 42,326.87 | 6.26 | 42,919.34 | 4.36 |
| 90×15 | 49,909.87 | 298.67 | 49,594.48 | 486.85 | 46,529.06 | 8.45 | 46,315.51 | 5.97 |
Medium scale kattalashgani sari GRASP ning solution quality si nisbatan zaiflashadi; HGRASP GRASP ni yaxshilaydi, biroq kattaroq medium instances da ALO va SMA ko‘pincha pastroq DRO values beradi.
Large-scale natijalari
| Instance | GRASP | CPU | HGRASP | CPU | ALO | CPU | SMA | CPU |
|---|---|---|---|---|---|---|---|---|
| 100×10 | 53,070.93 | 217.7 | 52,270.26 | 322.65 | 48,791.98 | 4.49 | 49,201.7 | 3 |
| 100×20 | 64,020.76 | 407.75 | 62,724.74 | 487.28 | 59,460.94 | 7.05 | 59,525.17 | 5.49 |
| 150×10 | 112,800 | 1290.4 | 111,170 | 38,421 | 107,070 | 6.8078 | 106,940 | 4.2935 |
| 150×20 | 133,252 | 1305 | 129,020 | 4540.02 | 124,230 | 7.067 | 120,014 | 4.305 |
| 200×10 | 194,880 | 1477.5 | 194,030 | 5541.4 | 180,940 | 7.2912 | 181,040 | 4.5586 |
| 200×20 | 220,890 | 6762.9 | 218,310 | 12,749 | 203,980 | 10.55 | 210,250 | 7.7775 |
| 250×10 | 294,680 | 6529.8 | 295,280 | 12,448 | 278,100 | 36.944 | 284,340 | 21.774 |
| 250×20 | 326,430 | 17,367 | 321,590 | 53,927 | 306,210 | 56.61 | 305,190 | 41.28 |
| 300×10 | 416,760 | 13,019 | 413,900 | 3824.1 | 393,590 | 10.779 | 393,430 | 6.9293 |
| 300×20 | 466,740 | 8101 | 464,820 | 20,180 | 446,440 | 15.3965 | 442,830 | 11.7650 |
Large scale da GRASP umumiy holda eng yuqori objective values beradi. HGRASP GRASP ni yaxshilaydi, biroq intensiv local search sababli computational time keskin oshadi.
ALO va SMA katta muammolarda aniq ravishda ko‘proq competitive bo‘ladi. Ularning hech biri har bir instance da boshqasidan ustun kelmaydi.
Representative 300×20 instance: 50 ta mustaqil ishga tushirish
| Usul | Median DRO | Average DRO | Std. Dev. | Best DRO | Maximum DRO | Average CPU |
|---|---|---|---|---|---|---|
| GRASP | 1,010,536.65 | 1,006,974.81 | 7713.28 | Manba matnida bu jumlada berilmagan | 1,012,263.52 | — |
| HGRASP | 1,002,959.09 | 1,002,307.41 | 5487.10 | 996,523.57 | — | 12,697.84 s |
| ALO | 962,154.30 | 961,918.26 | 3583.37 | — | 965,377.78 | — |
| SMA | 966,327.54 | 964,057.76 | 6827.03 | 956,384.95 | 969,460.79 | 9.16 s |
Manba ushbu representative experiment da ALO ni pastroq median/average va pastroq variability sababli eng robust usul; SMA ni esa eng yaxshi individual DRO solution va eng qisqa average computational time tufayli kuchli optimization performer sifatida baholaydi.
Figure 6 faqat representative execution ning convergence history si; 50 run ning statistical summary si emas. GRASP va HGRASP erta plato qiladi, ALO va SMA esa uzoqroq vaqt davomida yaxshilanishda davom etadi. Xom iteration-level series e’lon qilinmagani sababli Verianla Figure 6 ni soxta exact curve sifatida qayta yaratmaydi.
Medium-scale Friedman testi
| Usul | DRO Mean Rank | CPU Mean Rank |
|---|---|---|
| GRASP | 4.000 | 3.074 |
| HGRASP | 2.630 | 3.926 |
| ALO | 1.630 | 2.000 |
| SMA | 1.741 | 1.000 |
Solution quality:
\[ \chi^2=60.115,\qquad df=3,\qquad p=5.56\times10^{-13} \]
Computational time:
\[ \chi^2=78.778,\qquad df=3,\qquad p=5.94\times10^{-17} \]
Bu natijalar medium-scale algorithms teng ishlash ko‘rsatadi degan null hypothesis ni rad etadi.
Large-scale Friedman testi
| Usul | DRO Mean Rank | CPU Mean Rank |
|---|---|---|
| GRASP | 3.9 | 3.2 |
| HGRASP | 3.1 | 3.8 |
| ALO | 1.5 | 2.0 |
| SMA | 1.5 | 1.0 |
DRO objective:
\[ \chi^2=25.920,\qquad df=3,\qquad p=9.91\times10^{-6} \]
Computational time:
\[ \chi^2=28.080,\qquad df=3,\qquad p=3.49\times10^{-6} \]
ALO va SMA dan Qaysi Biri Yaxshiroq?
Ushbu tadqiqotning large-scale natijalarida solution quality bo‘yicha ALO va SMA ning Friedman mean rank i bir xil 1,5 bo‘lib, Wilcoxon–Holm post-hoc testi ular orasida ahamiyatli DRO farqini ko‘rsatmaydi; ALO representative 300×20 ishga tushirishlarda pastroq median/average va variability bilan robustroq ko‘rinsa, SMA eng yaxshi individual solution va eng yaxshi computational-time rank ni hosil qilgan, shu sababli manba biror algoritmni barcha mezonlarda mutlaq ustun deb e’lon qilmaydi.
Large-scale Wilcoxon–Holm post-hoc natijalari
| Taqqoslash | DRO Raw p | DRO Holm p | DRO | CPU Raw p | CPU Holm p | CPU |
|---|---|---|---|---|---|---|
| GRASP vs HGRASP | 0.003906 | 0.011719 | Ahamiyatli | 0.105469 | 0.105469 | Ahamiyatli emas |
| GRASP vs ALO | 0.001953 | 0.011719 | Ahamiyatli | 0.001953 | 0.011719 | Ahamiyatli |
| GRASP vs SMA | 0.001953 | 0.011719 | Ahamiyatli | 0.001953 | 0.011719 | Ahamiyatli |
| HGRASP vs ALO | 0.001953 | 0.011719 | Ahamiyatli | 0.001953 | 0.011719 | Ahamiyatli |
| HGRASP vs SMA | 0.001953 | 0.011719 | Ahamiyatli | 0.001953 | 0.011719 | Ahamiyatli |
| ALO vs SMA | 1.000000 | 1.000000 | Ahamiyatli emas | 0.001953 | 0.011719 | Ahamiyatli |
Solution quality bo‘yicha ALO yoki SMA dan biri ikkinchisidan ustun deb aytish ushbu test tomonidan qo‘llab-quvvatlanmaydi.
Computational time bo‘yicha esa ALO–SMA farqi ahamiyatli va Friedman ranking SMA ni favorable holatda ko‘rsatadi.
Tadqiqot qo‘llab-quvvatlaydigan xulosalar
- DRO bilan PFSP-SDST, stochastic processing times va operational cost bitta optimization framework ichida modellashtirilishi mumkin.
- KL-divergence ambiguity set nominal probability distribution atrofida distributional uncertainty ni aniqlash uchun ishlatilgan.
- Small instances uchun CPLEX-assisted exhaustive enumeration global optimum benchmark ta’minlagan.
- HGRASP sinovdan o‘tkazilgan barcha small-scale instances da exact objective qiymatini qayta hosil qilgan.
- Medium va large scale kattalashgani sari population-based ALO va SMA ko‘proq competitive bo‘lgan.
- Large-scale solution quality uchun algorithms o‘rtasida Friedman testi ahamiyatli farq ko‘rsatgan.
- Large-scale CPU time uchun algorithms o‘rtasida Friedman testi ahamiyatli farq ko‘rsatgan.
- ALO va SMA large-scale DRO quality bo‘yicha bir xil mean rank olgan.
- ALO–SMA pairwise DRO farqi ahamiyatli emas.
- SMA computational-time ranking bo‘yicha eng favorable usuldir.
- Representative 300×20 instance da ALO pastroq median/average va standard deviation ko‘rsatgan.
- Shu representative instance da SMA eng yaxshi individual DRO solution ni hosil qilgan.
Tadqiqot qo‘llab-quvvatlamaydigan xulosalar
- Framework haqiqiy zavodda tasdiqlanmagan.
- Operational cost haqiqiy elektr energiyasi iste’moli o‘lchovi emas.
- Model CO₂/emission reduction ni hisoblamaydi.
- \(\rho=0.05\) natijalari boshqa ambiguity radii uchun ham bir xil qolishi ko‘rsatilmagan.
- \(\alpha=\beta=0.5\), TWFT va cost ning haqiqiy qaror ahamiyati yoki numerical scales tengligini ko‘rsatmaydi.
- ALO barcha instances da SMA dan ustun ekani ko‘rsatilmagan.
- SMA solution quality bo‘yicha ALO dan statistik jihatdan ustun ekani ko‘rsatilmagan.
- Medium va large instances uchun global optimum noma’lum.
- Sintetik benchmark natijalari bevosita commercial Industry 4.0 deployment performance emas.
- Parameter tuning exhaustive/systematic emas.
Asosiy cheklovlar
Sintetik ma’lumot: Public benchmark mavjud bo‘lmagani sababli processing, setup va cost parameters controlled synthetic distributions asosida yaratilgan.
Haqiqiy sanoat validation i yo‘q: Muayyan production line da dala sinovi o‘tkazilmagan.
Doimiy ambiguity radius: Barcha asosiy natijalar \(\rho=0.05\) shartiga bog‘liq.
Sensitivity analysis yo‘q: Turli \(\rho\) qiymatlarida systematic calibration/sensitivity analysis future work sifatida qoldirilgan.
Fixed algorithm settings: \(\alpha_{RCL}\), iteration limit, population sizes va boshqa algorithmic settings practical/preliminary tanlovlardir; systematic tuning bajarilmagan.
Teng iteration ≠ teng budget: Algorithms har bir iteration da turli miqdorda objective evaluation bajarishi mumkin.
Operational cost jismoniy energiya emas: Cost coefficients direct power, electricity-price yoki emissions measurements emas.
Exact method scalability: Exhaustive enumeration combinatorial explosion sababli faqat small instances uchun qo‘llangan.
Figure 5/6 qamrovi: Robustness boxplot va convergence curves representative 300×20 instance ga tegishli; barcha instances ga mustaqil ravishda umumlashtirib bo‘lmaydi.
Code availability: MATLAB source code nashr vaqtida public emas.
Kelajakdagi tadqiqotlar
Manba quyidagi kengaytmalarni taklif qiladi:
- stochastic setup times,
- machine disruptions,
- fluctuating energy prices,
- haqiqiy industrial case studies,
- \(\rho\) calibration va sensitivity analysis,
- systematic metaheuristic parameter tuning,
- deterministic scheduling, stochastic programming, conventional DRO va RO bilan keng qamrovli comparison,
- turli uncertainty distributions ostida out-of-sample evaluation,
- production efficiency, haqiqiy energy consumption va sustainability indicators ni bir vaqtning o‘zida hisobga oladigan multi-objective DRO.
Manba va Usul Haqida Izoh
Asl tadqiqot: Distributionally Robust Optimization for Permutation Flow Shop Scheduling with Sequence-Dependent Setup Times and Operational Cost Under Uncertainty in Industry 4.0 Manufacturing Systems.
Mualliflar: Hafsa Mimouni, Abdelilah Jalid, Said Aqil.
Mualliflar tartibi: Manba PDF va rasmiy MDPI qaydidagi tartib saqlangan.
Teng hissa: Manbada equal-contribution bayonoti yo‘q.
Mas’ul muallif: Hafsa Mimouni.
Muassasa 1: Mechanical and Thermal Processes and Controls (PCMT) Laboratory, National Graduate School of Arts and Crafts, Mohamed V University, Rabat, Morocco.
Muassasa 2: Intelligent Systems, Industrial and Mechanical Engineering (LISIME) Laboratory, National Graduate School of Arts and Crafts, Hassan II University, Casablanca, Morocco.
Jurnal: Sustainability.
Nashriyot: MDPI, Basel, Switzerland.
Jild / son: 18(18).
Maqola raqami: 9278.
Nashr yili: 2026.
Received: 26 June 2026.
Revised: 1 September 2026.
Accepted: 3 September 2026.
Published: 9 September 2026.
DOI: 10.3390/su18189278.
Manba turi: Peer-reviewed computational optimization research article.
Preprint: Manbada alohida preprint versiyasi ko‘rsatilmagan.
Litsenziya: Creative Commons Attribution (CC BY).
Tadqiqot turi: Sintetik benchmarklarga asoslangan mathematical optimization va computational-comparison tadqiqoti.
Asosiy muammo: PFSP-SDST with uncertain processing times.
Asosiy usul: Kullback–Leibler divergence ambiguity set ishlatadigan Distributionally Robust Optimization.
Asosiy maqsadlar: Total Weighted Flow Time va machine-dependent operational cost ni weighted aggregation orqali minimallashtirish.
Exact yechim: IBM ILOG CPLEX Optimization Studio 12.10.0 yordamidagi exhaustive enumeration + no-good cuts; small instances, ko‘pi bilan 10 job.
Approximate methods: GRASP, proposed HGRASP, ALO va SMA.
Dasturlash muhiti: MATLAB R2021a; CPLEX 12.10.0.
Hardware: ASUS VivoBook X1502VA, 13th Generation Intel Core i9, 16 GB RAM.
Benchmark hajmi: 4–300 job, 2–20 machine.
Processing mean: \(\mu_P\sim U(5,15)\).
Processing standard deviation: \(\sigma_P\sim U(0.5,2)\).
Scenario generation: \(PT\sim N(\mu_P,\sigma_P^2)\), zarur bo‘lganda strictly-positive lower bound qo‘llanadi.
Scenario sets: \(S_{small}=30\), \(S_{large}=300\).
Base seed: 7.
Initial setup: \(U(0.5,2.5)\).
Sequence-dependent setup: \(U(0.5,3.5)\).
Job weights: \(U(1,5)\).
Run-cost coefficient: \(U(1,1.5)\).
Setup-cost coefficient: \(U(0.6,1)\).
Idle-cost coefficient: \(U(0.2,0.5)\).
Objective weights: \(\alpha=\beta=0.5\).
Ambiguity radius: \(\rho=0.05\).
GRASP RCL: \(\alpha_{RCL}=0.7\); 0.3, 0.5 va 0.7 preliminary exploratory tarzda ko‘rib chiqilgan.
Iteration limit: 100.
Random-Keys population: 30.
Independent stochastic runs: 50.
Illustrative GUM natijasi: \(129.45\pm9.62\), expanded interval \([119.83,139.07]\), \(k=2\).
Medium Friedman — DRO: χ² = 60.115, df = 3, p = 5.56 × 10⁻13.
Medium Friedman — CPU: χ² = 78.778, df = 3, p = 5.94 × 10⁻17.
Large Friedman — DRO: χ² = 25.920, df = 3, p = 9.91 × 10⁻6.
Large Friedman — CPU: χ² = 28.080, df = 3, p = 3.49 × 10⁻6.
Large solution-quality ranking: ALO = 1.5, SMA = 1.5, HGRASP = 3.1, GRASP = 3.9.
Large computational-time ranking: SMA = 1, ALO = 2, GRASP = 3.2, HGRASP = 3.8.
ALO–SMA post-hoc DRO: Holm-adjusted p = 1.000000; ahamiyatli farq yo‘q.
ALO–SMA post-hoc computational time: Holm-adjusted p = 0.011719; ahamiyatli farq bor.
Haqiqiy dala tasdig‘i: Yo‘q; future work sifatida taklif qilingan.
Haqiqiy energiya iste’moli: O‘lchanmagan. Operational-cost coefficients direct physical energy, electricity price, power yoki emissions emas.
Funding: External funding yo‘q.
Institutional Review Board: Not applicable.
Informed Consent: Not applicable.
Data Availability: Synthetic datasets va run-level outputs standalone historical files sifatida arxivlanmagan; generation procedures, scenario settings, parameter values va seed maqolada berilgan. Synthetic instances/output corresponding author dan reasonable request orqali qayta yaratilishi/taqdim qilinishi mumkin.
Source code: MATLAB implementation public emas; ongoing research implementation sifatida rivojlantirish davom etmoqda.
Conflicts of Interest: Authors declare no conflicts of interest.
Muallif hissalari: Conceptualization: H.M., A.J.; methodology: H.M., A.J.; software: H.M.; validation: H.M., A.J., S.A.; formal analysis: H.M.; investigation: H.M.; data curation: H.M.; original draft: H.M.; review/editing: H.M., A.J., S.A.; visualization: H.M.; supervision: A.J., S.A.
Terminologiya izohi: Tadqiqot asosan PFSP-SDST iborasini ishlatadi; ayrim computational-method paragraflarida PFSSP/PFSSP-SDST yozilishi uchraydi. Manba ularni alohida muammo sinfi sifatida ta’riflamagani uchun Verianla asosiy canonical termin sifatida PFSP-SDST ni saqlaydi.
Asosiy talqin chegarasi: Barcha comparative computational findings sintetik benchmark conditions, fixed \(\rho=0.05\) va ishlatilgan fixed algorithm settings uchun amal qiladi.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan