


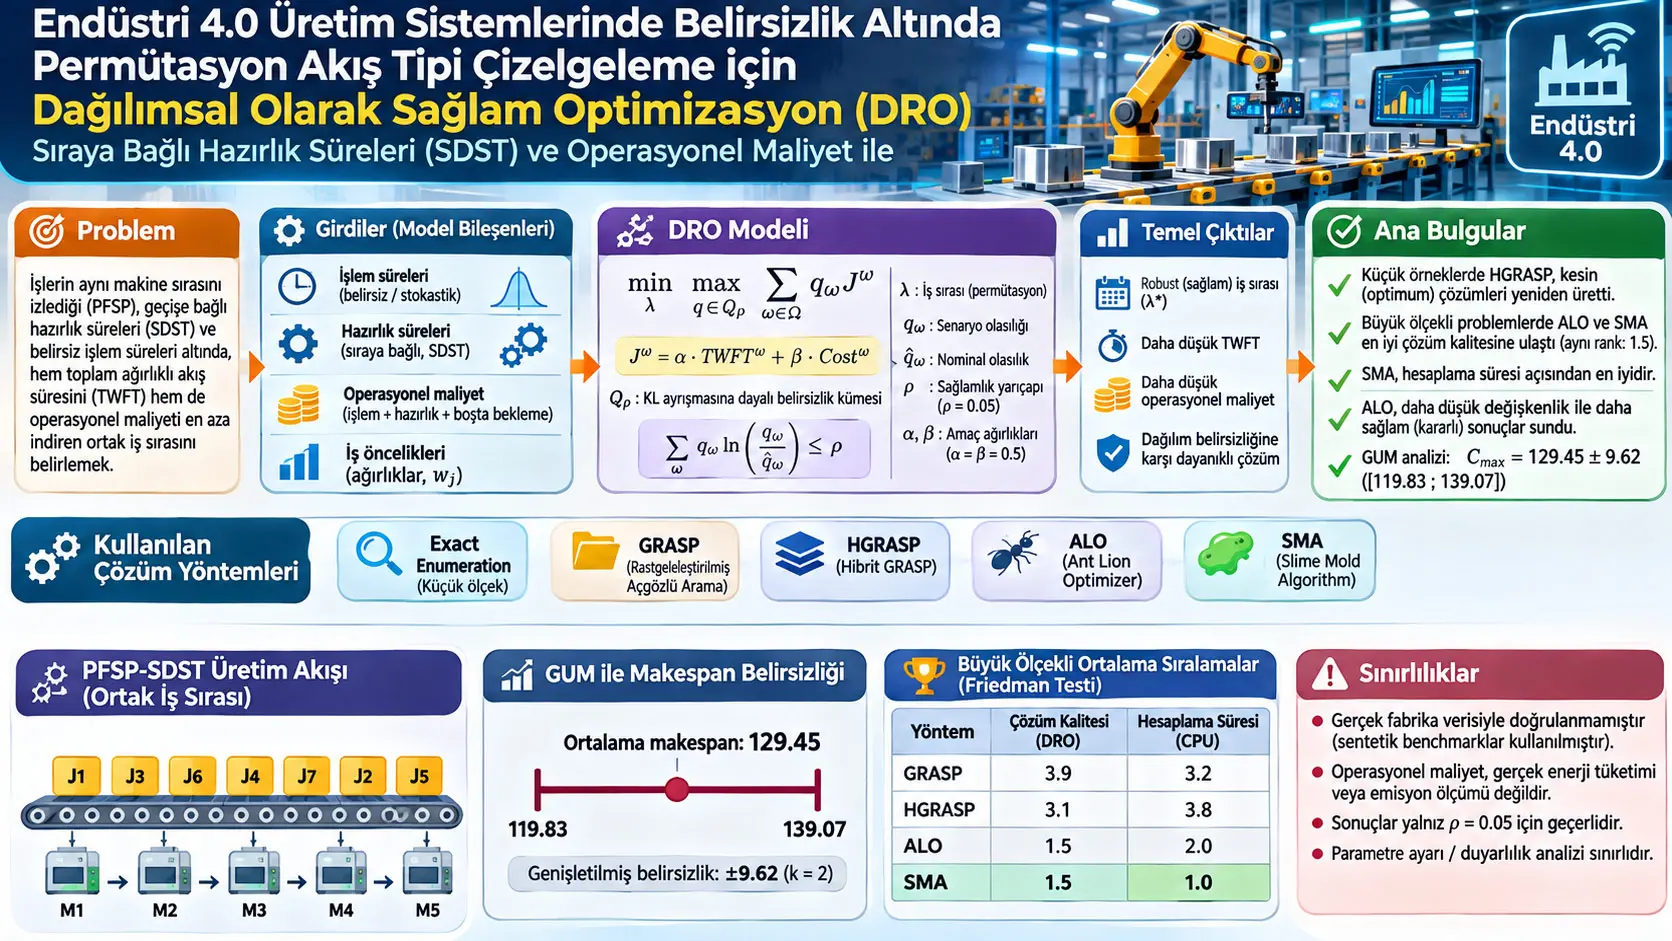
Dağılımsal Olarak Sağlam Optimizasyon (Distributionally Robust Optimization, DRO), belirsiz bir parametrenin yalnız tek ve kesin bir olasılık dağılımından geldiğini varsaymak yerine, olası dağılımlardan oluşan bir ambiguity set içindeki en elverişsiz beklenen sonucu dikkate alarak karar üreten bir optimizasyon yaklaşımıdır. Bu çalışma DRO'yu, bütün işlerin makineleri aynı sırada ziyaret ettiği Permutation Flow Shop Scheduling Problem yapısına, sıraya bağlı hazırlık sürelerine (Sequence-Dependent Setup Times; SDST), belirsiz processing times'a ve processing/setup/idle sürelerinden türetilen operational cost'a entegre etmektedir. Amaç, Total Weighted Flow Time (TWFT) ile operational cost'u ağırlıklı tek bir amaç fonksiyonunda birlikte küçülten ortak iş sırasını belirlemektir.
Gerçek processing-time distribution'ın tam olarak bilinmediği kabul edilmekte; sentetik processing scenarios nominal bir dağılım etrafında oluşturulmakta ve olası scenario probability distributions, Kullback–Leibler divergence ile tanımlanan bir ambiguity set içinde değerlendirilmektedir. Robustness radius \(\rho\), nominal dağılımdan ne kadar uzaklaşılabileceğini kontrol etmektedir. Çalışmadaki bütün ana computational experiments için \(\rho=0.05\) sabitlenmiştir; dolayısıyla elde edilen algoritma sıralamaları ve robustness sonuçları farklı \(\rho\) değerleri için kanıtlanmış değildir.
Küçük ölçekli problemler için IBM ILOG CPLEX destekli exhaustive enumeration yöntemiyle global-optimum benchmark çözümleri elde edilmiştir. Medium ve large instances için Greedy Randomized Adaptive Search Procedure (GRASP), çalışmanın önerdiği Hybrid GRASP (HGRASP), Ant Lion Optimizer (ALO) ve Slime Mold Algorithm (SMA) karşılaştırılmıştır. Küçük örneklerde HGRASP bütün test edilen exact benchmarkları yeniden üretmiş; diğer yaklaşık yöntemler de çoğu durumda exact veya çok yakın sonuçlara ulaşmıştır. Büyük ölçekli problemlerde Friedman testi solution quality ve computational time açısından algoritmalar arasında anlamlı fark bulunduğunu göstermiştir. ALO ile SMA solution quality bakımından aynı en iyi mean rank değerine ulaşmış ve post-hoc analizde birbirinden anlamlı biçimde farklı bulunmamıştır; SMA computational time açısından en iyi sıralamaya ulaşmıştır.
Çalışma gerçek bir fabrikadan alınmış üretim kayıtları üzerinde doğrulanmamıştır. Processing times, setup times, job weights ve machine cost coefficients sentetik olarak üretilmiştir. Ayrıca operational-cost coefficients gerçek elektrik tüketimi, güç, enerji tarifesi veya emisyon ölçümleri değildir. Bu nedenle sonuçlar proposed DRO framework'ün sentetik benchmarklar altındaki computational davranışını göstermekte; gerçek bir Industry 4.0 fabrikasında aynı maliyet veya enerji kazanımının gerçekleşeceğini kanıtlamamaktadır.
PFSP-SDST Nedir ve Bu Çalışmada Hangi Problem Çözülüyor?
PFSP-SDST, aynı \(n\) işin aynı \(m\) makineyi aynı teknolojik sırayla ziyaret ettiği ve bir makinenin yeni işe hazırlanma süresinin yalnız o işe değil, hemen önce hangi işin işlendiğine de bağlı olduğu kombinatoryal çizelgeleme problemidir; bu çalışmada processing times ayrıca stochastic kabul edilerek ortak iş sırası TWFT ile operational cost'u belirsizlik altında birlikte küçültecek biçimde seçilmektedir.
Permutation Flow Shop mantığı
İş kümesi:
\[ J=\{1,\ldots,n\} \]
ve makine kümesi:
\[ M=\{1,\ldots,m\} \]
olarak tanımlanmıştır.
Her iş bütün makineleri aynı sırada ziyaret eder. Ayrıca yalnız teknolojik rota değil, işlerin permütasyonu da bütün makinelerde ortaktır. Örneğin:
\[ \lambda=[J_3,J_1,J_4,J_2] \]
seçildiyse bütün makinelerde işler bu ortak sıraya göre ilerler.
Sequence-Dependent Setup Time neden önemlidir?
Bir makinenin \(J_i\) işinden sonra \(J_j\) işine geçerken gerektirdiği hazırlık süresi:
\[ s_{i,j,k} \]
ile temsil edilmektedir.
Dolayısıyla hazırlık süresi yalnız hedef işe bağlı değildir; predecessor–successor çifti ve makine \(k\) birlikte önemlidir.
Bu durum boya değişimi, kalıp ayarı, takım değişimi, temizlik veya ürün ailesi değişimi gibi endüstriyel geçişleri modelleyebilir. Kaynak belirli tek bir fabrika prosesine ait gerçek setup matrisi kullanmamakta; kontrollü sentetik benchmarklar oluşturmaktadır.
Stochastic processing time nasıl temsil ediliyor?
Job \(j\)'nin machine \(k\)'daki scenario \(\omega\) processing time'ı:
\[ p^\omega_{j,k} \]
olarak tanımlanmıştır.
Bir iş sequence position \(r\)'ye atandığında position-level processing time:
\[ PT^\omega_{r,k} \]
olmaktadır.
Belirsizlik scenario set:
\[ \Omega=\{1,\ldots,S\} \]
üzerinden temsil edilmektedir.
Temel değişkenler
| Sembol | Anlam |
|---|---|
| \(n\) | İş sayısı |
| \(m\) | Makine sayısı |
| \(\omega\) | Uncertainty scenario indeksi |
| \(\lambda\) | Ortak job permutation |
| \(x_{j,r}\) | Job \(j\), position \(r\)'ye atanırsa 1 olan binary variable |
| \(y_{i,j,r}\) | Position \(r-1\)'de \(i\), position \(r\)'de \(j\) bulunuyorsa 1 olan adjacency variable |
| \(p^\omega_{j,k}\) | Scenario \(\omega\)'da job \(j\)'nin machine \(k\)'daki processing time'ı |
| \(s^0_{j,k}\) | Job \(j\) için initial setup time |
| \(s_{i,j,k}\) | \(i\rightarrow j\) geçişinin sequence-dependent setup time'ı |
| \(ST_{r,k}\) | Position \(r\)'de machine \(k\) setup duration |
| \(A^\omega_{r,k}\) | Setup completion time |
| \(B^\omega_{r,k}\) | Processing start time |
| \(C^\omega_{r,k}\) | Processing completion time |
| \(I^\omega_{r,k}\) | Machine idle time |
| \(w_j\) | Job \(j\)'nin TWFT priority weight'i |
| \(c_k^{run}\) | Machine \(k\) processing unit cost coefficient |
| \(c_k^{setup}\) | Machine \(k\) setup unit cost coefficient |
| \(c_k^{idle}\) | Machine \(k\) idle unit cost coefficient |
| \(\alpha,\beta\) | TWFT ve operational-cost ağırlıkları |
| \(q_\omega\) | Ambiguity set içindeki scenario probability |
| \(\hat q_\omega\) | Nominal scenario probability; kaynakta uniform \(\hat q_\omega=1/S\) |
| \(\rho\) | KL ambiguity-set robustness radius |
| \(\eta\) | DRO dual reformulation'daki auxiliary variable |
Denklem (1): Total Weighted Flow Time
\[ TWFT^\omega= \sum_{r\in R}\sum_{j\in J} w_j x_{j,r} C^\omega_{r,m} \tag{1} \]
Ne hesaplar? Her job'ın son makinedeki completion time'ını job priority weight ile çarpar ve toplamını alır.
\(C^\omega_{r,m}\), scenario \(\omega\)'da position \(r\)'deki işin son makinedeki completion time'ıdır.
\(w_j\) yükseldikçe ilgili job'ın geç tamamlanması objective üzerinde daha büyük ceza yaratır. Böylece acil veya yüksek öncelikli işler optimization içinde daha fazla ağırlık kazanabilir.
Denklem (2): Operational Cost
\[ Cost^\omega= \sum_{k\in M} \left[ c_k^{run}\sum_{r\in R}PT^\omega_{r,k} + c_k^{setup}\sum_{r\in R}ST_{r,k} + c_k^{idle}\sum_{r\in R}I^\omega_{r,k} \right] \tag{2} \]
Cost function üç parçadan oluşur:
- processing cost,
- sequence-dependent setup cost,
- machine idle cost.
Kaynak önemli bir ayrım yapmaktadır: sabit bir scenario için toplam processing time işlerin sırasından bağımsızdır. Bu nedenle processing-cost terimi o scenario içinde kaçınılmaz temel maliyet gibi davranır. Job sequencing kararının maliyet üzerindeki asıl etkisi setup ve idle bileşenlerinden gelir.
Bilimsel sınır: \(c_k^{run}\), \(c_k^{setup}\) ve \(c_k^{idle}\) fiziksel enerji ölçüm cihazından alınmış değerler değildir. Bu objective gerçek kWh, elektrik faturası veya CO₂ emisyonu hesaplamamaktadır.
Denklem (3): Tekleştirilmiş objective
\[ J^\omega= \alpha TWFT^\omega+ \beta Cost^\omega \tag{3} \]
İki amaç weighted aggregation ile tek objective'a dönüştürülmektedir.
Computational experiments için:
\[ \alpha=\beta=0.5 \]
kullanılmıştır.
Ancak kaynak özellikle bu seçimin TWFT ile cost'un numerical contribution'larının eşit olduğu veya genel bir decision-maker preference yapısını temsil ettiği anlamına gelmediğini belirtmektedir. İki bileşenin ölçekleri farklı olabilir.
DRO, Stochastic Programming ve Klasik Robust Optimization'dan Nasıl Ayrılıyor?
Stochastic programming genellikle belirli bir probability distribution'ın doğru bilindiğini varsayarken klasik Robust Optimization tek tek parameter realizations'ın uncertainty set içindeki en kötü durumuna karşı koruma sağlar; bu çalışmadaki DRO ise tek bir dağılım yerine nominal dağılıma KL divergence bakımından yeterince yakın olan probability distributions ailesindeki en kötü beklenen objective değerini küçültmektedir.
Denklem (4): Worst-case expected objective
\[ \min J_{DRO} = \min_\lambda \max_{q\in Q_\rho} \sum_{\omega\in\Omega}q_\omega J^\omega \tag{4} \]
Buradaki iç maximization, seçilen schedule için ambiguity set içindeki en olumsuz probability distribution'ı arar.
Dış minimization ise bu worst-case expected objective'ı mümkün olduğunca küçülten job permutation'ı seçer.
Denklem (5): Kullback–Leibler ambiguity set
\[ Q_\rho= \left\{ q\in\mathbb{R}_+^S: \sum_{\omega\in\Omega}q_\omega=1,\; \sum_{\omega\in\Omega} q_\omega \ln\left( \frac{q_\omega}{\hat q_\omega} \right) \le\rho \right\} \tag{5} \]
İlk koşul probability values toplamının 1 olmasını sağlar.
İkinci koşul, candidate distribution \(q\)'nun nominal distribution \(\hat q\)'dan KL divergence bakımından en fazla \(\rho\) kadar uzaklaşmasına izin verir.
Robustness Radius \(\rho\) Ne İşe Yarıyor?
\(\rho\), ambiguity set'in büyüklüğünü kontrol eder; daha küçük \(\rho\) optimization'ı nominal probability distribution'a yakın tutarken daha büyük \(\rho\) daha fazla olası dağılıma izin vererek schedule'ı dağılım belirsizliğine karşı daha korumacı hale getirir, ancak bu çalışmanın bütün raporlanan ana sonuçları yalnız \(\rho=0.05\) koşuluna aittir.
Bu nedenle “ALO her \(\rho\) değerinde aynıdır” veya “SMA bütün robustness seviyelerinde en hızlıdır” sonucu çıkarılamaz.
Denklem (6): Dual DRO reformulation
\[ J_{DRO} = \min_{\eta>0} \left[ \eta\rho+ \eta\ln \left( \sum_{\omega\in\Omega} \hat q_\omega \exp\left(\frac{J^\omega}{\eta}\right) \right) \right] \tag{6} \]
Bu reformulation, Equation (4)'teki nested min-max yapının inner distribution maximization kısmını Lagrangian duality kullanarak tek-katmanlı ve computational olarak daha uygulanabilir bir convex expression'a dönüştürmektedir.
\(\eta\) auxiliary dual variable'dır ve her candidate permutation için optimize edilmektedir.
Exact enumeration implementation'ında \(\eta\), MATLAB'ın bounded one-dimensional optimizer'ı fminbnd ile optimize edilmiştir.
Equations (7)–(25): Feasibility ve zamanlama kısıtları
Kaynağın mathematical model'i yalnız objective function'dan oluşmamaktadır. Job assignment, predecessor–successor ilişkisi, setup calculation, machine precedence, completion times ve variable domains aşağıdaki constraints ile tanımlanmaktadır.
\[ \sum_{j\in J}x_{j,r}=1,\qquad \forall r\in R \tag{7} \]
Her sequence position'a tam bir job atanır.
\[ \sum_{r\in R}x_{j,r}=1,\qquad \forall j\in J \tag{8} \]
Her job tam bir position'a atanır. Equations (7) ve (8) birlikte geçerli permutation oluşturur.
\[ y_{i,j,r}\le x_{i,r-1} \tag{9} \]
\[ y_{i,j,r}\le x_{j,r} \tag{10} \]
\[ y_{i,j,r}\ge x_{i,r-1}+x_{j,r}-1 \tag{11} \]
Equations (9)–(11), \(y_{i,j,r}\)'nin ancak job \(i\) önceki position'da ve job \(j\) mevcut position'da olduğunda 1 olmasını sağlayan linear adjacency formulation'dır.
\[ ST_{1,k} = \sum_{j\in J}s^0_{j,k}x_{j,1} \tag{12} \]
İlk position için predecessor bulunmadığından initial setup, ilk seçilen job'a göre hesaplanır.
\[ ST_{r,k} = \sum_{i\in J}\sum_{j\in J} s_{i,j,k}y_{i,j,r}, \qquad r=2,\ldots,n \tag{13} \]
Daha sonraki position'larda setup time predecessor–successor çiftine bağlıdır.
\[ PT^\omega_{r,k} = \sum_{j\in J} p^\omega_{j,k}x_{j,r} \tag{14} \]
Bu constraint, position \(r\)'ye hangi job atanmışsa onun scenario-dependent processing time'ını position'a taşır.
\[ C^\omega_{0,k}=0 \tag{15} \]
\[ C^\omega_{r,0}=0 \tag{16} \]
Scheduling horizon başlangıcında önceki job ve “machine 0” tarafındaki completion times sıfırlanır.
\[ A^\omega_{r,k} = C^\omega_{r-1,k} + ST_{r,k} \tag{17} \]
Setup completion time, aynı makinedeki önceki job completion ile gerekli setup duration'ın toplamıdır.
\[ B^\omega_{r,k}\ge A^\omega_{r,k} \tag{18} \]
Processing setup tamamlanmadan başlayamaz.
\[ B^\omega_{r,k}\ge C^\omega_{r,k-1} \tag{19} \]
Job, önceki makinedeki işlemi tamamlanmadan sonraki makinede başlayamaz.
\[ C^\omega_{r,k} = B^\omega_{r,k} + PT^\omega_{r,k} \tag{20} \]
Completion time = processing start + processing duration.
\[ I^\omega_{r,k} = B^\omega_{r,k} - A^\omega_{r,k} \tag{21} \]
Setup hazır olduğu halde processing başlayana kadar geçen fark machine idle time'dır.
\[ ST_{r,k}\ge0 \tag{22} \]
\[ PT^\omega_{r,k}, A^\omega_{r,k}, B^\omega_{r,k}, C^\omega_{r,k}, I^\omega_{r,k}\ge0 \tag{23} \]
Temporal variables negatif değer alamaz.
\[ x_{j,r}\in\{0,1\} \tag{24} \]
\[ y_{i,j,r}\in\{0,1\} \tag{25} \]
Assignment ve adjacency variables binary'dir.
Illustrative example: 7 iş, 5 makine
Kaynak DRO mantığını somutlaştırmak için:
- \(n=7\) job,
- \(m=5\) machine,
- 300 generated processing-time scenarios,
- \(\rho=0.05\),
- \(\alpha=0.5\),
- \(\beta=0.5\)
kullanan illustrative instance sunmaktadır.
Job weights:
\[ w=[4,2,5,3,1,4,2] \]
İlk açıklayıcı feasible sequence:
\[ \lambda=[J_4,J_1,J_2,J_6,J_3,J_5,J_7] \]
olarak seçilmiştir.
DRO tarafından belirlenen optimal robust permutation:
\[ \lambda^*=[J_1,J_3,J_6,J_4,J_7,J_2,J_5] \]
şeklindedir.
Üç representative processing-time scenario
Kaynak 300 generated scenario içinden yorum kolaylığı için favourable, degraded ve variable koşullarını temsil eden üç matrix seçmektedir.
\[ PT^1= \begin{bmatrix} 2&17&9&11&14&9&11\\ 4&8&10&10&13&8&6\\ 7&14&8&9&15&7&11\\ 14&7&8&15&5&9&13\\ 11&9&6&9&8&8&10 \end{bmatrix} \]
\[ PT^2= \begin{bmatrix} 6&11&7&14&15&11&11\\ 7&8&12&11&13&8&5\\ 9&15&6&8&14&5&11\\ 15&9&10&14&4&10&12\\ 11&7&7&12&10&9&9 \end{bmatrix} \]
\[ PT^3= \begin{bmatrix} 10&12&10&14&15&9&9\\ 8&7&12&12&12&7&6\\ 9&15&5&12&16&6&11\\ 15&6&14&15&8&11&12\\ 10&8&8&8&7&10&8 \end{bmatrix} \]
Satırlar makineleri, sütunlar işleri temsil etmektedir.
GUM Belirsizlik Analizi DRO'ya Ne Ekliyor?
DRO job sequence'i probability-distribution ambiguity altında robust seçerken GUM analizi seçilen optimal schedule'ın makespan çıktısının scenario realizations boyunca ne kadar dağıldığını ayrıca nicelleştirir; kaynak 300 scenario için mean makespan, combined standard uncertainty ve \(k=2\) expanded uncertainty hesaplayarak optimal makespan'i \(129.45\pm9.62\) ve expanded interval'ı \([119.83,139.07]\) olarak raporlamaktadır.
Denklem (26): Mean makespan
\[ \overline{C}_{max} = \frac{1}{N} \sum_{\omega=1}^{N} C_{max}(\omega) \tag{26} \]
Burada \(N=300\) generated scenario'dur.
Denklem (27): Combined standard uncertainty
\[ u_c^2(C_{max}) = \frac{1}{N-1} \sum_{\omega=1}^{N} \left[ C_{max}(\omega)-\overline{C}_{max} \right]^2 \tag{27} \]
Bu ifade scenario makespan values'ın variance'ını hesaplar. Combined standard uncertainty \(u_c\), variance'ın kareköküdür.
Denklem (28): Expanded uncertainty
\[ U=k\,u_c \tag{28} \]
Kaynak:
\[ k=2 \]
kullanmakta ve bunu yaklaşık %95 coverage level ile ilişkilendirmektedir.
Denklem (29): Makespan sonucu
\[ C_{max} = \overline{C}_{max} \pm U \tag{29} \]
Illustrative example için:
\[ C_{max}=129.45\pm9.62 \]
ve expanded uncertainty interval:
\[ [119.83,\;139.07] \]
olarak verilmiştir.
Optimal DRO permutation ile manuel permutation karşılaştırması
| Scenario | Koşul | \(TWFT^\omega\) | \(Cost^\omega\) | \(J^\omega\) |
|---|---|---|---|---|
| 1 | Favourable | 1406.2 | 546.07 | 976.14 |
| 2 | Degraded | 1612.7 | 558.08 | 1085.4 |
| 3 | Variable | 1787.2 | 586.98 | 1187.1 |
| Scenario | Koşul | \(TWFT^\omega\) | \(Cost^\omega\) | \(J^\omega\) |
|---|---|---|---|---|
| 1 | Favourable | 2262.4 | 557.51 | 1410 |
| 2 | Degraded | 2335.7 | 570.81 | 1453.3 |
| 3 | Variable | 2359.1 | 591.22 | 1475.2 |
Aynı processing-time realizations, setup times, machine cost coefficients ve job weights kullanıldığından bu illustrative comparison'daki fark sequence selection'dan kaynaklanmaktadır.
Source Figures 2–4, favourable, degraded ve variable scenarios için optimal DRO schedule'ın Gantt charts'ını göstermektedir. Kaynak görseller machine occupation, setup, idle ve job progression'ın scenario değiştikçe nasıl uzadığını gösterir. Exact Gantt bar coordinates sayısal tablo halinde yayımlanmadığından Verianla bu çizimleri sahte hassasiyetle yeniden üretmemektedir.
Çalışmanın Yöntemi ve Bulguları
Computational experimental framework
| Parametre | Kaynak değeri |
|---|---|
| Job sayısı | 4–300 |
| Machine sayısı | 2–20 |
| \(\mu_P\) | \(U(5,15)\) |
| \(\sigma_P\) | \(U(0.5,2)\) |
| Scenario processing time | \(PT\sim N(\mu_P,\sigma_P^2)\) |
| Search scenario set | \(S_{small}=30\) |
| Final evaluation scenario set | \(S_{large}=300\) |
| Base random seed | 7 |
| Initial setup | \(setup_0\sim U(0.5,2.5)\) |
| Sequence-dependent setup | \(setup_{seq}\sim U(0.5,3.5)\) |
| Job weight | \(w_j\sim U(1,5)\) |
| Processing cost coefficient | \(c_k^{run}\sim U(1,1.5)\) |
| Setup cost coefficient | \(c_k^{setup}\sim U(0.6,1)\) |
| Idle cost coefficient | \(c_k^{idle}\sim U(0.2,0.5)\) |
| TWFT weight | \(\alpha=0.5\) |
| Operational-cost weight | \(\beta=0.5\) |
| Ambiguity radius | \(\rho=0.05\) |
| GRASP RCL parameter | \(\alpha_{RCL}=0.7\) |
| Maximum iterations | 100 |
| Random-Keys population | \(nPop=30\) |
| Independent runs | 50 |
| MATLAB | MATLAB R2021a |
| Exact solver | IBM ILOG CPLEX Optimization Studio 12.10.0 |
| Hardware | ASUS VivoBook X1502VA, 13th Gen Intel Core i9, 16 GB RAM |
\(\alpha_{RCL}\) neden 0,7?
Kaynak preliminary exploratory tests sırasında:
\[ \alpha_{RCL}\in\{0.3,0.5,0.7\} \]
değerlerini incelemiş ve solution quality ile diversification arasında en uygun practical compromise olarak 0,7 değerini seçmiştir.
Bu süreç systematic hyperparameter optimization olarak sunulmamaktadır.
100 iteration bütün algoritmalara eşit computational budget sağlar mı?
Hayır. Kaynak bütün iterative algorithms için 100 iteration kullanmasına rağmen farklı algoritmaların bir iteration içinde farklı sayıda DRO objective evaluation yapabileceğini açıkça belirtmektedir.
Dolayısıyla 100 iteration her yönteme aynı computational work verilmiş olduğu anlamına gelmez. Bu yüzden CPU time ayrıca karşılaştırılmıştır.
Exact enumeration nasıl çalışıyor?
Small instances için CPLEX assignment model her iteration'da daha önce denenmemiş bir feasible permutation üretmektedir.
Permutation decode edildikten sonra setup, processing, start/completion ve idle variables dışarıda hesaplanarak full DRO objective değerlendirilir.
Sonra aynı permutation'ın tekrar üretilmesini engelleyen no-good cut eklenir:
\[ \sum_{j\in J}\sum_{r\in R} x^*_{j,r}x_{j,r} \le n-1 \]
Her feasible permutation tam bir kez üretildiği için small instances'ta bütün \(n!\) permutations exhaustively değerlendirilir.
Kaynak exact procedure'ü en fazla 10 job içeren instances ile sınırlandırmıştır.
GRASP-DRO
GRASP randomised greedy construction kullanmaktadır.
Initial job priority score:
\[ \phi_j= w_j \sum_{k=1}^{m} \mu P_{j,k} \]
ile oluşturulur.
Candidate solutions arasında Restricted Candidate List:
\[ RCL= \left\{ cand_t: DRO(cand_t) \le J_{min} +\alpha_{RCL}(J_{max}-J_{min}) \right\} \]
şeklinde tanımlanır ve RCL içinden random candidate seçilir.
HGRASP-DRO
HGRASP dört ana bileşeni birleştirmektedir:
- DRO-adapted NEH initialization,
- GRASP constructive search,
- swap-based local search,
- restart/diversification mechanism.
Bir sonraki iteration başlangıcında %50 olasılıkla original robust NEH sequence yeniden kullanılır; diğer durumda random swaps ile başlangıç sırası çeşitlendirilir.
ALO-DRO
Ant Lion Optimizer doğal olarak continuous search space üzerinde çalıştığı için job permutation üretmek amacıyla Random Keys representation kullanılmıştır.
Continuous vector değerleri sıralanarak feasible permutation'a çevrilir. Population search sırasında elite solution korunur ve candidate schedules, reduced scenario set üzerinden DRO objective ile değerlendirilir.
SMA-DRO
Slime Mold Algorithm da Random Keys representation kullanmaktadır. Population adaptive weighting ile update edilir; daha iyi solutions daha güçlü influence kazanırken exploration kaybolmaması için zayıf solutions da population içinde rolünü sürdürür.
Kaynak bütün Random-Keys population settings için \(nPop=30\) kullanmıştır.
Small-scale exact benchmark sonuçları
| Instance | Exact | Exact CPU | GRASP | CPU | HGRASP | CPU | ALO | CPU | SMA | CPU |
|---|---|---|---|---|---|---|---|---|---|---|
| 4×2 | 101.02 | 2.35 | 101.02 | 1.61 | 101.02 | 2.74 | 101.02 | 2.38 | 101.02 | 3.12 |
| 4×4 | 200.66 | 1.10 | 200.66 | 0.42 | 200.66 | 0.96 | 200.66 | 1.00 | 200.66 | 0.94 |
| 4×6 | 267.16 | 0.49 | 267.16 | 1.00 | 267.16 | 1.11 | 267.16 | 1.15 | 267.16 | 1.08 |
| 6×2 | 239.2 | 38.61 | 239.2 | 0.85 | 239.2 | 2.49 | 239.2 | 1.25 | 239.2 | 1.13 |
| 6×4 | 338.49 | 38.89 | 338.49 | 0.86 | 338.49 | 2.59 | 338.49 | 1.26 | 338.49 | 1.16 |
| 6×6 | 410.61 | 38.55 | 410.61 | 0.87 | 410.61 | 2.80 | 410.61 | 1.27 | 410.61 | 1.16 |
| 8×2 | 368.39 | 89,964 | 369.62 | 1.31 | 368.39 | 5.22 | 368.39 | 1.27 | 368.39 | 1.13 |
| 8×4 | 562.4 | 130,600 | 588.91 | 1.88 | 562.4 | 7.44 | 562.4 | 1.91 | 562.4 | 1.71 |
| 8×6 | 642.64 | 70,895 | 646.41 | 1.35 | 642.64 | 5.51 | 642.64 | 1.29 | 642.64 | 1.17 |
| 9×4 | 532.67 | 85,640 | 536.15 | 1.33 | 532.67 | 5.99 | 533.62 | 1.09 | 533.62 | 0.97 |
| 10×2 | 509.65 | 108,450 | 517.29 | 4.08 | 509.65 | 19.16 | 509.65 | 2.84 | 509.65 | 2.45 |
HGRASP bütün bu small-scale instances'ta exact objective değerini yeniden üretmiştir.
Exact enumeration ise instance büyüdükçe çok hızlı biçimde computationally expensive hale gelmiştir.
Medium-scale sonuçları
| Instance | GRASP | CPU | HGRASP | CPU | ALO | CPU | SMA | CPU |
|---|---|---|---|---|---|---|---|---|
| 10×5 | 798.97 | 1.96 | 785.17 | 10.71 | 788.96 | 1.38 | 785.63 | 1.23 |
| 10×10 | 1413.7 | 2.04 | 1397.1 | 12.71 | 1397.1 | 1.44 | 1397.1 | 1.28 |
| 10×15 | 1932.2 | 2.15 | 1904.9 | 13.13 | 1904.9 | 1.51 | 1904.9 | 1.35 |
| 20×5 | 2674.7 | 7.38 | 2529.7 | 71.17 | 2535.7 | 1.96 | 2535.1 | 1.54 |
| 20×10 | 3679.1 | 26.49 | 3509.4 | 268.03 | 3524.6 | 7.72 | 3526.9 | 5.98 |
| 20×15 | 4339.95 | 7.77 | 4171.08 | 85.54 | 4183.04 | 2.15 | 4184.21 | 1.76 |
| 30×5 | 5078.17 | 13.02 | 4749.6 | 70.83 | 4528.46 | 2.07 | 4564.33 | 1.72 |
| 30×10 | 6352.42 | 14.07 | 6006.96 | 77.82 | 5888.47 | 2.22 | 5895.96 | 1.89 |
| 30×15 | 8242.85 | 15.28 | 8022.30 | 86 | 7876.46 | 2.45 | 7876.79 | 2.10 |
| 40×5 | 8846.77 | 27.5 | 8386.14 | 149.8 | 8016.26 | 4.81 | 7990.32 | 3.49 |
| 40×10 | 10,849.9 | 72.9 | 10,296.85 | 286.6 | 9860.56 | 6.78 | 9864.14 | 5.28 |
| 40×15 | 13,639.6 | 28.28 | 13,111.05 | 105.42 | 12,695.5 | 2.89 | 12,627.73 | 2.26 |
| 50×5 | 12,626.2 | 37.7 | 12,006.1 | 100.72 | 10,170.4 | 2.60 | 10,961.06 | 1.83 |
| 50×10 | 14,524.4 | 145.38 | 13,739.86 | 410.71 | 13,028.1 | 9.61 | 13,079.04 | 7.27 |
| 50×15 | 17,482 | 46 | 16,967 | 128.85 | 16,097 | 3.17 | 15,921 | 2.43 |
| 60×5 | 16,117 | 58.38 | 15,679 | 127.82 | 14,597 | 2.95 | 14,453 | 2.03 |
| 60×10 | 21,687 | 2028.5 | 21,143 | 616.84 | 19,656 | 13.27 | 19,724 | 9.57 |
| 60×15 | 26,425.6 | 70.51 | 26,124.06 | 160.05 | 24,834.7 | 3.48 | 24,842.04 | 2.65 |
| 70×5 | 22,505 | 1162.5 | 21,971 | 643.46 | 20,143 | 12.78 | 20,234 | 8.66 |
| 70×10 | 27,914 | 108.63 | 27,491 | 209.6 | 25,254 | 4.53 | 25,034 | 2.98 |
| 70×15 | 31,230.1 | 181.35 | 30,464.62 | 506.59 | 28,931.51 | 7.07 | 29,210.98 | 5.08 |
| 80×5 | 29,386.5 | 108.58 | 28,444.54 | 185.95 | 26,555.80 | 3.69 | 26,178.90 | 2.24 |
| 80×10 | 36,061.27 | 119.92 | 35,943.01 | 206.51 | 33,641.2 | 3.62 | 33,134.3 | 2.56 |
| 80×15 | 36,972.02 | 252 | 36,608.48 | 399.47 | 34,376.15 | 6.87 | 34,079.12 | 4.81 |
| 90×5 | 36,832.33 | 136.6 | 36,661.97 | 211.89 | 33,847.33 | 3.66 | 34,033.45 | 2.23 |
| 90×10 | 46,181.93 | 298.56 | 45,608.33 | 438.10 | 42,326.87 | 6.26 | 42,919.34 | 4.36 |
| 90×15 | 49,909.87 | 298.67 | 49,594.48 | 486.85 | 46,529.06 | 8.45 | 46,315.51 | 5.97 |
Medium scale büyüdükçe GRASP'ın solution quality'si görece zayıflamakta; HGRASP GRASP'ı iyileştirmekte, fakat daha büyük medium instances'ta ALO ve SMA çoğunlukla daha düşük DRO values üretmektedir.
Large-scale sonuçları
| Instance | GRASP | CPU | HGRASP | CPU | ALO | CPU | SMA | CPU |
|---|---|---|---|---|---|---|---|---|
| 100×10 | 53,070.93 | 217.7 | 52,270.26 | 322.65 | 48,791.98 | 4.49 | 49,201.7 | 3 |
| 100×20 | 64,020.76 | 407.75 | 62,724.74 | 487.28 | 59,460.94 | 7.05 | 59,525.17 | 5.49 |
| 150×10 | 112,800 | 1290.4 | 111,170 | 38,421 | 107,070 | 6.8078 | 106,940 | 4.2935 |
| 150×20 | 133,252 | 1305 | 129,020 | 4540.02 | 124,230 | 7.067 | 120,014 | 4.305 |
| 200×10 | 194,880 | 1477.5 | 194,030 | 5541.4 | 180,940 | 7.2912 | 181,040 | 4.5586 |
| 200×20 | 220,890 | 6762.9 | 218,310 | 12,749 | 203,980 | 10.55 | 210,250 | 7.7775 |
| 250×10 | 294,680 | 6529.8 | 295,280 | 12,448 | 278,100 | 36.944 | 284,340 | 21.774 |
| 250×20 | 326,430 | 17,367 | 321,590 | 53,927 | 306,210 | 56.61 | 305,190 | 41.28 |
| 300×10 | 416,760 | 13,019 | 413,900 | 3824.1 | 393,590 | 10.779 | 393,430 | 6.9293 |
| 300×20 | 466,740 | 8101 | 464,820 | 20,180 | 446,440 | 15.3965 | 442,830 | 11.7650 |
Large scale'da GRASP genel olarak en yüksek objective values üretmektedir. HGRASP GRASP'ı iyileştirmekte fakat yoğun local search nedeniyle computational time ciddi biçimde büyümektedir.
ALO ve SMA büyük problemlerde açık biçimde daha competitive hale gelmektedir. Hiçbiri her instance'ta diğerini geçmemektedir.
Representative 300×20 instance: 50 bağımsız koşu
| Yöntem | Median DRO | Average DRO | Std. Dev. | Best DRO | Maximum DRO | Average CPU |
|---|---|---|---|---|---|---|
| GRASP | 1,010,536.65 | 1,006,974.81 | 7713.28 | Kaynak metninde bu cümlede verilmemiştir | 1,012,263.52 | — |
| HGRASP | 1,002,959.09 | 1,002,307.41 | 5487.10 | 996,523.57 | — | 12,697.84 s |
| ALO | 962,154.30 | 961,918.26 | 3583.37 | — | 965,377.78 | — |
| SMA | 966,327.54 | 964,057.76 | 6827.03 | 956,384.95 | 969,460.79 | 9.16 s |
Kaynak bu representative experiment'ta ALO'yu daha düşük median/average ve daha düşük variability nedeniyle en robust yöntem; SMA'yı ise en iyi individual DRO solution ve en kısa average computational time nedeniyle güçlü optimization performer olarak değerlendirmektedir.
Figure 6 yalnız representative execution'ın convergence history'sidir; 50 run'ın statistical summary'si değildir. GRASP ve HGRASP erken plato yaparken ALO ve SMA daha uzun süre iyileşmeye devam etmektedir. Ham iteration-level series yayımlanmadığından Verianla Figure 6'yı sahte exact curve olarak yeniden üretmemektedir.
Medium-scale Friedman testi
| Yöntem | DRO Mean Rank | CPU Mean Rank |
|---|---|---|
| GRASP | 4.000 | 3.074 |
| HGRASP | 2.630 | 3.926 |
| ALO | 1.630 | 2.000 |
| SMA | 1.741 | 1.000 |
Solution quality:
\[ \chi^2=60.115,\qquad df=3,\qquad p=5.56\times10^{-13} \]
Computational time:
\[ \chi^2=78.778,\qquad df=3,\qquad p=5.94\times10^{-17} \]
Bu sonuçlar medium-scale algorithms'ın eşdeğer performans gösterdiği null hypothesis'i reddetmektedir.
Large-scale Friedman testi
| Yöntem | DRO Mean Rank | CPU Mean Rank |
|---|---|---|
| GRASP | 3.9 | 3.2 |
| HGRASP | 3.1 | 3.8 |
| ALO | 1.5 | 2.0 |
| SMA | 1.5 | 1.0 |
DRO objective:
\[ \chi^2=25.920,\qquad df=3,\qquad p=9.91\times10^{-6} \]
Computational time:
\[ \chi^2=28.080,\qquad df=3,\qquad p=3.49\times10^{-6} \]
ALO ile SMA'dan Hangisi Daha İyi?
Bu çalışmanın large-scale sonuçlarında solution quality açısından ALO ve SMA'nın Friedman mean rank'i aynı 1,5'tir ve Wilcoxon–Holm post-hoc testi aralarında anlamlı DRO farkı göstermemektedir; ALO representative 300×20 koşularında daha düşük median/average ve variability ile daha robust görünürken SMA en iyi individual solution'ı ve en iyi computational-time rank'ini üretmiştir, dolayısıyla kaynak tek bir algoritmayı bütün ölçütlerde mutlak üstün ilan etmemektedir.
Large-scale Wilcoxon–Holm post-hoc sonuçları
| Karşılaştırma | DRO Raw p | DRO Holm p | DRO | CPU Raw p | CPU Holm p | CPU |
|---|---|---|---|---|---|---|
| GRASP vs HGRASP | 0.003906 | 0.011719 | Anlamlı | 0.105469 | 0.105469 | Anlamlı değil |
| GRASP vs ALO | 0.001953 | 0.011719 | Anlamlı | 0.001953 | 0.011719 | Anlamlı |
| GRASP vs SMA | 0.001953 | 0.011719 | Anlamlı | 0.001953 | 0.011719 | Anlamlı |
| HGRASP vs ALO | 0.001953 | 0.011719 | Anlamlı | 0.001953 | 0.011719 | Anlamlı |
| HGRASP vs SMA | 0.001953 | 0.011719 | Anlamlı | 0.001953 | 0.011719 | Anlamlı |
| ALO vs SMA | 1.000000 | 1.000000 | Anlamlı değil | 0.001953 | 0.011719 | Anlamlı |
Solution quality bakımından ALO veya SMA'dan birinin diğerinden üstün olduğunu söylemek bu test tarafından desteklenmemektedir.
Computational time bakımından ise ALO–SMA farkı anlamlıdır ve Friedman ranking SMA'yı daha favorable göstermektedir.
Çalışmanın desteklediği sonuçlar
- DRO ile PFSP-SDST, stochastic processing times ve operational cost tek optimization framework içinde modellenebilir.
- KL-divergence ambiguity set nominal probability distribution etrafında distributional uncertainty tanımlamak için kullanılmıştır.
- Small instances için CPLEX-assisted exhaustive enumeration global optimum benchmark sağlamıştır.
- HGRASP test edilen bütün small-scale instances'ta exact objective değerini yeniden üretmiştir.
- Medium ve large scale büyüdükçe population-based ALO ve SMA daha competitive hale gelmiştir.
- Large-scale solution quality için algorithms arasında Friedman testi anlamlı fark göstermiştir.
- Large-scale CPU time için algorithms arasında Friedman testi anlamlı fark göstermiştir.
- ALO ve SMA large-scale DRO quality açısından aynı mean rank'i almıştır.
- ALO–SMA pairwise DRO farkı anlamlı değildir.
- SMA computational-time ranking açısından en favorable yöntemdir.
- Representative 300×20 instance'ta ALO daha düşük median/average ve standard deviation göstermiştir.
- Aynı representative instance'ta SMA en iyi individual DRO solution'ı üretmiştir.
Çalışmanın desteklemediği sonuçlar
- Framework gerçek bir fabrikada doğrulanmış değildir.
- Operational cost gerçek elektrik tüketimi ölçümü değildir.
- Model CO₂/emission reduction hesaplamamaktadır.
- \(\rho=0.05\) sonuçlarının başka ambiguity radii için aynı kalacağı gösterilmemiştir.
- \(\alpha=\beta=0.5\), TWFT ile cost'un gerçek karar önemlerinin veya numerical scales'ının eşit olduğunu göstermez.
- ALO'nun bütün instances'ta SMA'dan üstün olduğu gösterilmemiştir.
- SMA'nın solution quality açısından ALO'dan istatistiksel olarak üstün olduğu gösterilmemiştir.
- Medium ve large instances için global optimum bilinmemektedir.
- Sentetik benchmark sonuçları doğrudan commercial Industry 4.0 deployment performansı değildir.
- Parameter tuning exhaustive/systematic değildir.
Temel sınırlılıklar
Sentetik veri: Public benchmark bulunmadığı için processing, setup ve cost parameters controlled synthetic distributions üzerinden üretilmiştir.
Gerçek endüstriyel validation yok: Belirli bir production line üzerinde saha testi yapılmamıştır.
Sabit ambiguity radius: Bütün ana sonuçlar \(\rho=0.05\) koşuluna bağlıdır.
Sensitivity analysis yok: Farklı \(\rho\) değerlerinde systematic calibration/sensitivity analysis future work olarak bırakılmıştır.
Fixed algorithm settings: \(\alpha_{RCL}\), iteration limit, population sizes ve diğer algorithmic settings practical/preliminary seçimlerdir; systematic tuning yapılmamıştır.
Eşit iteration ≠ eşit budget: Algorithms iteration başına farklı sayıda objective evaluation yapabilmektedir.
Operational cost fiziksel enerji değildir: Cost coefficients direct power, electricity-price veya emissions measurements değildir.
Exact method scalability: Exhaustive enumeration combinatorial explosion nedeniyle yalnız small instances için uygulanmıştır.
Figure 5/6 kapsamı: Robustness boxplot ve convergence curves representative 300×20 instance'a aittir; bütün instances için tek başına genellenemez.
Code availability: MATLAB source code yayımlandığı aşamada public değildir.
Gelecek çalışmalar
Kaynak şu genişletmeleri önermektedir:
- stochastic setup times,
- machine disruptions,
- fluctuating energy prices,
- gerçek industrial case studies,
- \(\rho\) calibration ve sensitivity analysis,
- systematic metaheuristic parameter tuning,
- deterministic scheduling, stochastic programming, conventional DRO ve RO ile kapsamlı comparison,
- farklı uncertainty distributions altında out-of-sample evaluation,
- production efficiency, gerçek energy consumption ve sustainability indicators'ı aynı anda ele alan multi-objective DRO.
Kaynak ve Yöntem Notu
Özgün çalışma: Distributionally Robust Optimization for Permutation Flow Shop Scheduling with Sequence-Dependent Setup Times and Operational Cost Under Uncertainty in Industry 4.0 Manufacturing Systems.
Yazarlar: Hafsa Mimouni, Abdelilah Jalid, Said Aqil.
Yazar sırası: Kaynak PDF ve resmî MDPI kaydındaki sıra korunmuştur.
Eş katkı: Kaynakta equal-contribution beyanı bulunmamaktadır.
Sorumlu yazar: Hafsa Mimouni.
Kurum 1: Mechanical and Thermal Processes and Controls (PCMT) Laboratory, National Graduate School of Arts and Crafts, Mohamed V University, Rabat, Morocco.
Kurum 2: Intelligent Systems, Industrial and Mechanical Engineering (LISIME) Laboratory, National Graduate School of Arts and Crafts, Hassan II University, Casablanca, Morocco.
Dergi: Sustainability.
Yayınevi: MDPI, Basel, Switzerland.
Cilt / sayı: 18(18).
Makale numarası: 9278.
Yayın yılı: 2026.
Received: 26 June 2026.
Revised: 1 September 2026.
Accepted: 3 September 2026.
Published: 9 September 2026.
DOI: 10.3390/su18189278.
Kaynak türü: Peer-reviewed computational optimization research article.
Preprint: Kaynakta ayrı preprint sürümü belirtilmemektedir.
Lisans: Creative Commons Attribution (CC BY).
Araştırma türü: Sentetik benchmarklara dayalı mathematical optimization ve computational-comparison çalışması.
Ana problem: PFSP-SDST with uncertain processing times.
Ana yöntem: Kullback–Leibler divergence ambiguity set kullanan Distributionally Robust Optimization.
Ana amaçlar: Total Weighted Flow Time ve machine-dependent operational cost'un weighted aggregation ile minimizasyonu.
Exact çözüm: IBM ILOG CPLEX Optimization Studio 12.10.0 destekli exhaustive enumeration + no-good cuts; small instances, en fazla 10 job.
Approximate methods: GRASP, proposed HGRASP, ALO ve SMA.
Programlama ortamı: MATLAB R2021a; CPLEX 12.10.0.
Hardware: ASUS VivoBook X1502VA, 13th Generation Intel Core i9, 16 GB RAM.
Benchmark boyutu: 4–300 job, 2–20 machine.
Processing mean: \(\mu_P\sim U(5,15)\).
Processing standard deviation: \(\sigma_P\sim U(0.5,2)\).
Scenario generation: \(PT\sim N(\mu_P,\sigma_P^2)\), gerektiğinde strictly-positive lower bound uygulanmaktadır.
Scenario sets: \(S_{small}=30\), \(S_{large}=300\).
Base seed: 7.
Initial setup: \(U(0.5,2.5)\).
Sequence-dependent setup: \(U(0.5,3.5)\).
Job weights: \(U(1,5)\).
Run-cost coefficient: \(U(1,1.5)\).
Setup-cost coefficient: \(U(0.6,1)\).
Idle-cost coefficient: \(U(0.2,0.5)\).
Objective weights: \(\alpha=\beta=0.5\).
Ambiguity radius: \(\rho=0.05\).
GRASP RCL: \(\alpha_{RCL}=0.7\); 0.3, 0.5 ve 0.7 preliminary exploratory olarak incelenmiştir.
Iteration limit: 100.
Random-Keys population: 30.
Independent stochastic runs: 50.
Illustrative GUM sonucu: \(129.45\pm9.62\), expanded interval \([119.83,139.07]\), \(k=2\).
Medium Friedman — DRO: χ² = 60.115, df = 3, p = 5.56 × 10⁻13.
Medium Friedman — CPU: χ² = 78.778, df = 3, p = 5.94 × 10⁻17.
Large Friedman — DRO: χ² = 25.920, df = 3, p = 9.91 × 10⁻6.
Large Friedman — CPU: χ² = 28.080, df = 3, p = 3.49 × 10⁻6.
Large solution-quality ranking: ALO = 1.5, SMA = 1.5, HGRASP = 3.1, GRASP = 3.9.
Large computational-time ranking: SMA = 1, ALO = 2, GRASP = 3.2, HGRASP = 3.8.
ALO–SMA post-hoc DRO: Holm-adjusted p = 1.000000; anlamlı fark yok.
ALO–SMA post-hoc computational time: Holm-adjusted p = 0.011719; anlamlı fark var.
Gerçek saha doğrulaması: Yok; future work olarak önerilmiştir.
Gerçek enerji tüketimi: Ölçülmemiştir. Operational-cost coefficients direct physical energy, electricity price, power veya emissions değildir.
Funding: External funding yok.
Institutional Review Board: Not applicable.
Informed Consent: Not applicable.
Data Availability: Synthetic datasets ve run-level outputs standalone historical files olarak arşivlenmemiştir; generation procedures, scenario settings, parameter values ve seed makalede verilmiştir. Synthetic instances/output corresponding author'dan reasonable request ile yeniden üretilebilir/sağlanabilir.
Source code: MATLAB implementation public değildir; ongoing research implementation olarak geliştirilmeye devam etmektedir.
Conflicts of Interest: Authors declare no conflicts of interest.
Yazar katkıları: Conceptualization: H.M., A.J.; methodology: H.M., A.J.; software: H.M.; validation: H.M., A.J., S.A.; formal analysis: H.M.; investigation: H.M.; data curation: H.M.; original draft: H.M.; review/editing: H.M., A.J., S.A.; visualization: H.M.; supervision: A.J., S.A.
Terminoloji notu: Çalışma çoğunlukla PFSP-SDST ifadesini kullanmakta; bazı computational-method paragraflarında PFSSP/PFSSP-SDST yazımı görülmektedir. Kaynak bunları ayrı bir problem sınıfı olarak tanımlamadığından Verianla ana canonical terim olarak PFSP-SDST'yi korumaktadır.
Temel yorum sınırı: Bütün comparative computational findings sentetik benchmark conditions, fixed \(\rho=0.05\) ve kullanılan fixed algorithm settings için geçerlidir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir