


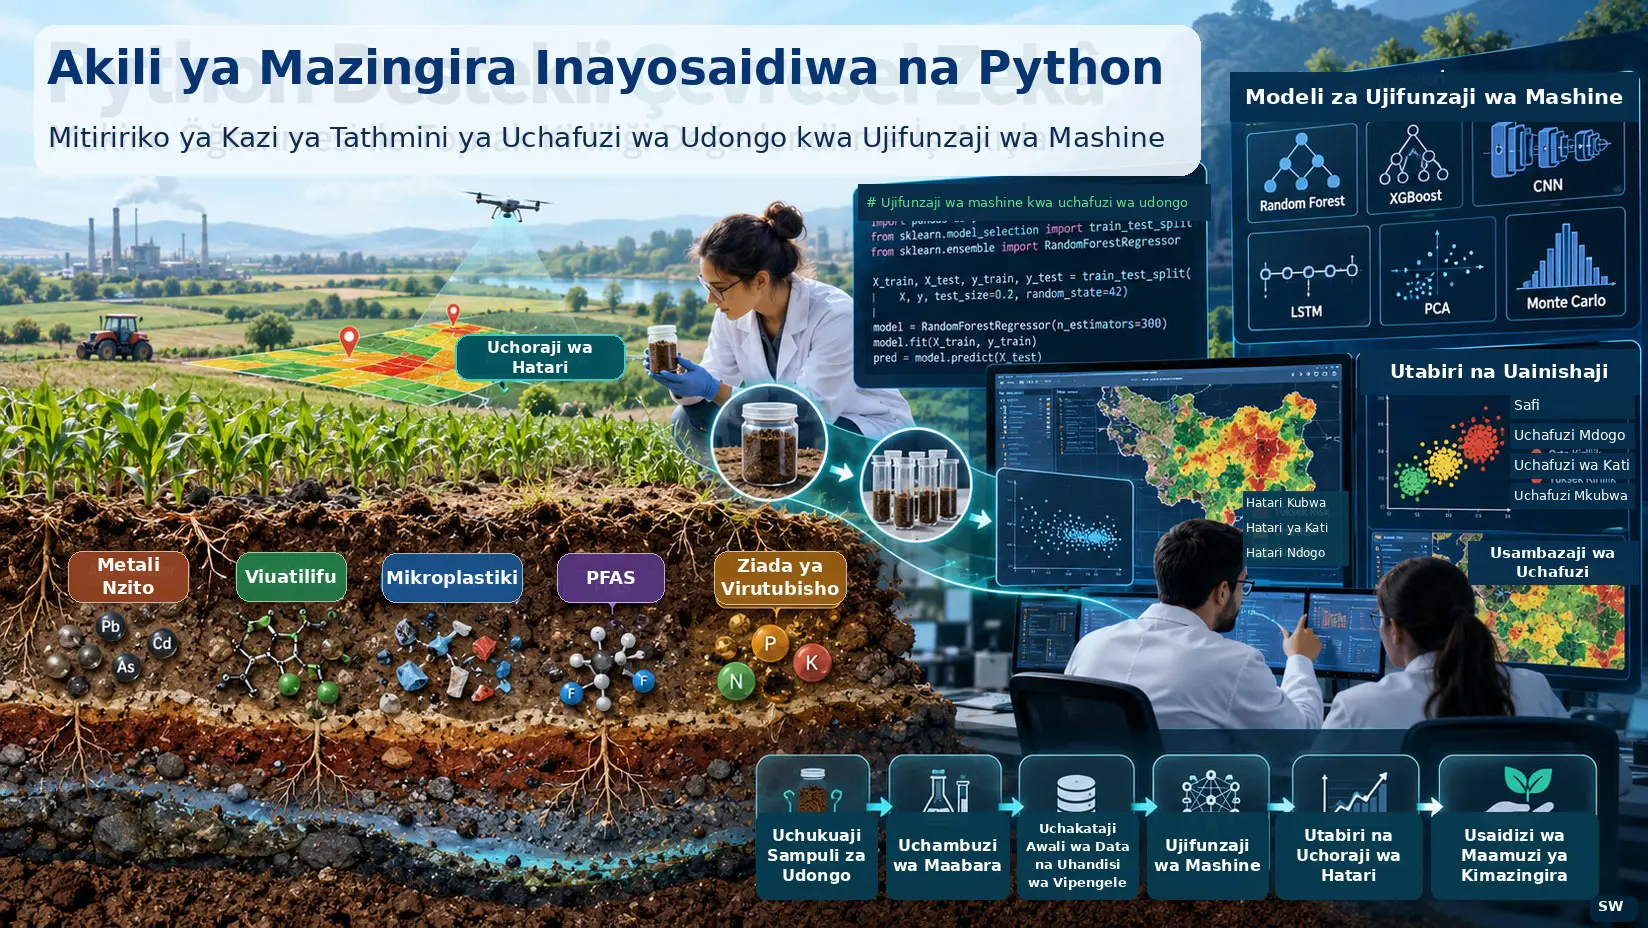
Mitiririko ya kazi ya tathmini ya uchafuzi wa udongo inayotegemea Python ni violezo vya uchanganuzi wa kimahesabu vya moduli vinavyounganisha ujifunzaji wa mashine, ujifunzaji wa kina, takwimu na zana za GIS ili kutabiri aina mbalimbali za vichafuzi, kuziainisha, kutabiri mabadiliko yake kwa muda, kuhesabu kutokuwa na uhakika na kuunda ramani za hatari za kieneo. Utafiti unashughulikia metali nzito, viuatilifu, mikroplastiki, dutu za per- na polifluoroalkyl (PFAS) na mzigo uliopitiliza wa virutubisho vikuu; unawasilisha mitiririko saba ya kazi ya Python inayotegemea Random Forest, XGBoost + SHAP, 1-B CNN, LSTM, PCA, Monte Carlo na GeoPandas.
Kikomo muhimu zaidi cha tafsiri ya utafiti ni kwamba mafanikio ya modeli yaliyoripotiwa si viwango vya utendaji vilivyothibitishwa katika data halisi za maeneo yaliyochafuliwa. Muundo wa data wa matumizi saba umejengwa kwa data sintetiki/benchmark zinazoiga vigezo vya kimazingira katika fasihi. Kwa Random Forest takriban \(R^2=0{,}88\), kwa XGBoost ROC-AUC takriban 0,91, kwa 1-B CNN ya mikroplastiki usahihi wa zaidi ya %95, kwa PFAS LSTM RMSE ya hatua-moja-mbele chini ya 0,05 ng/g, kwa PCA takriban %45 ya tofauti iliyofafanuliwa katika kijenzi cha kwanza, kwa Monte Carlo PLI kipindi cha kuaminika cha %90 cha takriban ±0,4 kitengo, na kwa uchoraji wa EF wa kieneo RMSE ya uthibitishaji mtambuka ya takriban 0,38 kitengo cha EF zimeripotiwa. Yote haya ni maonyesho ya workflow ya kimetodolojia.
Utafiti pia unaweka mfumo wa hatua sita unaounganisha uchanganuzi wa kimahesabu na huduma za mfumo ikolojia wa udongo: kutambua vyanzo vya uchafuzi, kuunda modeli ya tabia ya kichafuzi, utabiri wa senario, tathmini ya hatari ya kiikolojia, uchanganuzi wa mambo mengi na utabiri/usimamizi. Hivyo lengo si kuongeza tu skor ya modeli moja ya ML; ni kuunda mnyororo unaofuatilika wa uchanganuzi wa data za mazingira kutoka uchukuaji sampuli shambani hadi uchoraji wa hatari na uamuzi wa urejeshaji.
Tatizo la utafiti
Uchafuzi wa udongo ni tatizo tata zaidi kuliko kupima mkusanyiko wa kichafuzi kimoja. Uhamaji na upatikanaji wa kibayolojia wa kichafuzi hubadilika pamoja na madini ya udongo, dutu hai, pH, uwiano wa udongo wa mfinyanzi, muundo wa vinyweleo, hali za hidrologia, aina za kikemia na michakato ya mazingira. Muundo huu wenye vipimo vingi na usio wa mstari hufanya iwe vigumu kwa uchanganuzi wa kawaida wa kigezo kimoja kuwakilisha kikamilifu tabia ya mazingira.
Utafiti unalishughulikia tatizo hili katika tabaka tatu: usanisi wa fasihi iliyochapishwa ya sayansi ya mazingira, mfumo wa dhana wa hatua sita unaounganisha huduma za mfumo ikolojia wa udongo na mchakato wa uchanganuzi, na workflow saba za Python zinazoweza kuendeshwa.
Mapitio ya fasihi yalifanywaje?
Chanzo kilifanya usanisi wa fasihi unaotegemea zaidi ya machapisho 100 yaliyopitiwa na wenzao katika Web of Science na Scopus. Maneno ya utafutaji yalijumuisha “soil pollution”, “soil contamination”, “machine learning”, “random forest”, “deep learning”, “heavy metals”, “PFAS”, “microplastics”, “pesticide leaching” na “soil ecosystem services”. Kipindi kikuu cha muda ni 2015–2026; tafiti za zamani zaidi zilizochukuliwa kuwa za msingi kimetodolojia zilibaki katika wigo kwa madhumuni ya muktadha wa kihistoria.
Vigezo vya kujumuisha vilitegemea masharti matatu makuu: utafiti kuhusiana moja kwa moja na utambuzi wa uchafuzi wa udongo au tathmini ya hatari inayotegemea ML, kuripoti kipimo cha utendaji cha kiasi au mbinu iliyothibitishwa ya utambuzi, na kujumuisha angalau moja ya makundi matano makuu ya vichafuzi yanayoshughulikiwa katika makala.
Makundi makuu ya vichafuzi yaliyoshughulikiwa katika utafiti
| Kundi la kichafuzi | Kazi ya kimahesabu katika utafiti | Tatizo kuu la kimazingira |
|---|---|---|
| Metali nzito | Utabiri wa mkusanyiko, fahirisi za hatari, uchoraji wa EF wa kieneo | Mkusanyiko wa kudumu, upatikanaji wa kibayolojia, mkusanyiko katika mnyororo wa trofiki |
| Viuatilifu | Uainishaji wa hatari ya leaching | Usafirishaji kwenda maji ya chini ya ardhi, athari kwa vijidudu na mzunguko wa virutubisho |
| Mikroplastiki | Uainishaji kutoka spektra inayofanana na FTIR | Muundo wa udongo, unyweleo na vichafuzi vinavyosafirishwa pamoja |
| PFAS | Utabiri wa mfululizo wa muda | Ustahimilivu wa juu sana wa kimazingira na mkusanyiko wa muda mrefu |
| Virutubisho vikuu vilivyopitiliza | Upunguzaji wa vipimo kwa PCA na utambuzi wa hotspot | Mzigo wa N/P, eutrofikesheni, maji ya chini ya ardhi na ubora wa udongo |
Vichafuzi vya mionzi vinatambuliwa katika utafiti kama darasa muhimu la uchafuzi wa udongo, lakini vinaachwa nje ya wigo mkuu wa workflow za Python. Chanzo kinaeleza kuwa spektrometria ya gamma na uenezaji wa kutokuwa na uhakika vinaweza kutumika katika tathmini za baadaye za radionuklidi.
Mitiririko Saba ya Kazi ya Python Inachambuaje Uchafuzi wa Udongo?
Workflow saba zinahusiana na aina tofauti za data badala ya kurudia tatizo lilelile: Random Forest huchakata mkusanyiko wa metali nzito kwa regressioni, XGBoost huainisha hatari ya pesticide leaching, 1-B CNN hutambua mikroplastiki kwa mifumo ya spektra, LSTM hushughulikia PFAS kama mfululizo wa muda, PCA hutambua hotspot za virutubisho kwa kupunguza vipimo, Monte Carlo hueneza kutokuwa na uhakika wa vipimo katika fahirisi za hatari kwa njia ya uwezekano, na mchakato unaotegemea GeoPandas huchakata uongezaji wa metali nzito kwenye ramani ya kieneo.
Workflow 1: Mkusanyiko wa kadmiyamu kwa Random Forest
Skripti ya kwanza huunda regressioni ya Random Forest inayotabiri mkusanyiko wa kadmiyamu kwa kutumia bendi tano za uakisi wa spektra pamoja na pH, dutu hai ya udongo (SOM) na asilimia ya udongo wa mfinyanzi. Idadi ya data ni \(n=1000\).
Kigezo lengwa cha sintetiki kinaundwa katika msimbo chanzo kwa uhusiano ufuatao:
\[ C_{\mathrm{Cd}} = 2.8\,pH - 1.5\,SOM^2 + 6.0\,B_3 + \varepsilon, \qquad \varepsilon\sim\mathcal{N}(0,0.4^2) \]
Fomula inahesabu nini? Inaunda mkusanyiko wa kadmiyamu wa sintetiki katika mg/kg. \(B_3\) ni uakisi wa bendi ya tatu ya spektra; \(SOM\) ni kigezo cha asilimia ya dutu hai; \(\varepsilon\) ni kelele ya Gaussian yenye mkengeuko sanifu wa 0,4 mg/kg.
Kwa nini maelezo haya ni muhimu? Thamani kubwa ya \(R^2\) ya Random Forest haiathiriwi na ugunduzi wa uhusiano wa asili wa kimazingira pekee, bali na ukweli kwamba kigezo lengwa kilitengenezwa tangu mwanzo kama kazi ya kimahesabu ya predictor hizi. Chanzo kinaeleza hasa kwamba Band 3 na pH kuonekana kama predictor kuu kunatokana na fomula ya kutengeneza data.
Modeli imeundwa kwa miti 200, kina cha juu 12 na sampuli ya chini ya jani 4; data ziligawanywa kuwa %80 mafunzo na %20 majaribio, na uthibitishaji mtambuka wa mikunjo mitano ulitumika pia.
Matokeo: Takriban \(R^2=0.88\), RMSE < 0,35 mg/kg. Thamani hii ni ya onyesho la sintetiki.
Dokezo la mbinu ndani ya chanzo: ingawa maelezo ya mbinu yanataja feature importance inayotegemea SHAP, msimbo uliochapishwa wa Listing 1 hutumia `rf.feature_importances_`. Hiki ni kipimo cha umuhimu cha impurity kilichojengwa ndani ya Random Forest; hakuna wito wa SHAP unaoonekana katika Listing 1 iliyochapishwa.
Workflow 2: Hatari ya pesticide leaching kwa XGBoost + SHAP
Skripti ya pili huainisha hatari ya juu/chini ya pesticide leaching kwa kutumia mchanga, udongo wa mfinyanzi, SOM, mvua, mteremko na pH. Logit inayotumiwa kuunda hatari ya sintetiki ni:
\[ z= -0.04\,Sand +0.07\,Clay -0.30\,SOM +0.06\,Precip +0.05\,Slope -0.5 \]
na ubadilishaji wa lojistiki:
\[ P= \frac{1}{1+e^{-z}} \]
ambapo darasa la hatari kubwa huundwa wakati \(P>0.5\).
Ishara za coefficients zinaeleza mantiki ya kutengeneza data sintetiki: kwa mfano, katika muundo huu \(z\) huongezeka kadiri mvua na udongo wa mfinyanzi vinavyoongezeka, huku ikipungua kadiri SOM inavyoongezeka. Coefficients hizi si coefficients za ulimwengu mzima za usafirishaji wa viuatilifu zilizopimwa katika eneo halisi.
Katika modeli ya XGBoost, estimator 300, kina cha juu 5, learning rate 0,05, subsample 0,8 na column subsampling 0,8 zilitumika. Data ziligawanywa kwa namna ya stratified kuwa %75 mafunzo na %25 majaribio.
Matokeo: ROC-AUC takriban 0,91. Thamani hii ni ya hold-out partition moja; hakuna mzunguko wa uthibitishaji mtambuka katika msimbo. Uchanganuzi wa SHAP katika muundo huu wa sintetiki uliweka kiwango cha mvua na uwiano wa udongo wa mfinyanzi kama viashiria vikuu vya hatari.
Workflow 3: Uainishaji wa mikroplastiki kwa 1-B CNN
Skripti ya tatu hutumia Convolutional Neural Network ya kipimo kimoja kutenganisha mikroplastiki na chembe za madini/organiki kutoka fingerprint za spektra zenye njia 128 zinazofanana na FTIR. Jumla ya spektra sintetiki 1200 zilitengenezwa.
Darasa la madini/organiki takriban:
\[ X_{\mathrm{min}}\sim\mathcal{N}(0.3,0.08^2) \]
na darasa la mikroplastiki:
\[ X_{\mathrm{MP}}\sim\mathcal{N}(0.6,0.10^2) \]
yalitengenezwa kutoka kwenye usambazaji huu; vipengele bandia vya ufyonzwaji vya +0,5 na +0,4 viliongezwa mtawalia katika masafa ya njia 40–44 na 80–84 ya spektra za mikroplastiki.
Muundo wa mtandao unajumuisha kwa mpangilio Conv1D yenye vichujio 32 (kernel=5), MaxPooling1D, Conv1D yenye vichujio 64 (kernel=3), GlobalAveragePooling1D, Dense yenye neuroni 64, %30 dropout na safu ya pato ya sigmoid. Hasara ni binary cross-entropy, optimizer ni Adam. Mafunzo yalifanywa kwa epoch 30, batch size 32 na %15 validation split ndani ya data za mafunzo.
Matokeo: Katika spektra za sintetiki za hold-out, usahihi wa zaidi ya %95 na F1 > 0,94 uliripotiwa. Matokeo haya si skor ya uainishaji wa uwanja iliyothibitishwa katika maktaba halisi ya FTIR ya udongo.
Workflow 4: Mfululizo wa muda wa PFAS kwa LSTM
Skripti ya nne huunda mfululizo wa sintetiki wa PFAS wa miaka 10 wenye sampuli 120 za kila mwezi:
\[ C(t) = 0.8 + 0.4\sin(t) + 0.015\,m + \varepsilon, \qquad \varepsilon\sim\mathcal{N}(0,0.05^2) \]
Hapa \(m\) ni fahirisi ya mwezi. Neno la kwanza lisilobadilika linawakilisha kiwango cha msingi, neno la sine linawakilisha msimu, \(0.015m\) linawakilisha ongezeko la muda mrefu na neno la Gaussian linawakilisha kelele nasibu. Kitengo cha mkusanyiko ni ng/g.
Mfululizo ulirekebishwa kwa MinMaxScaler na dirisha linalosogea la miezi 12 lilitumika. Lengo la kila mfuatano wa ingizo wa miezi 12 ni thamani moja ya mwezi unaofuata mara moja.
Usanifu wa LSTM unajumuisha LSTM ya kwanza yenye vitengo 64 inayorudisha sequence, %20 dropout, LSTM ya pili yenye vitengo 32, ReLU Dense yenye neuroni 16 na safu ya pato inayotoa thamani moja. Modeli hufunzwa kwa Adam + MSE kwa epoch 50 na batch size 16.
Matokeo: RMSE ya utabiri wa PFAS wa hatua-moja-mbele ni <0,05 ng/g.
Kikomo muhimu: Modeli hii haitabiri miezi 12 mbele kwa mara moja. Hutumia dirisha la historia ya miezi kumi na miwili na kutabiri mwezi unaofuata. Kwa utabiri halisi wa muda mrefu wa hatua nyingi, autoregressive rollout na uthibitishaji huru wa shambani unahitajika.
Workflow 5: Kutambua hotspot za virutubisho kwa PCA
Skripti ya tano huunda matriki ya sintetiki ya kemia ya udongo yenye elementi nyingi na sampuli 500, inayojumuisha vigezo N, P, K, pH, SOM, nitrati na amoniamu. Katika sampuli 50 za hotspot zilizochaguliwa bila mpangilio, thamani za N, NO3 na P ziliongezwa mara 3,5.
Kwanza vigezo vyote vilisawazishwa kwa StandardScaler, kisha data zikapunguzwa hadi principal component mbili. Wazo la jumla la kimahesabu la PCA ni kuakisi nafasi ya data yenye vipimo vingi kwenye mihimili mipya iliyo wima kwa kila mmoja, ili kukusanya sehemu kubwa iwezekanavyo ya tofauti katika vipengele vya kwanza.
Matokeo: PC1 ilieleza takriban %45 ya tofauti yote na kutenganisha kundi la hotspot la juu la N/NO3/P lililoundwa kwa njia bandia. Kwa hiyo N na P kuonekana kuwa na ushawishi mkubwa si ugunduzi huru wa shambani; hatua yenyewe ya kuunda hotspot iliinua hasa vigezo hivi vitatu.
Workflow 6: Kutokuwa na uhakika wa PLI na Igeo kwa Monte Carlo
Skripti ya sita hueneza kutokuwa na uhakika wa vipimo vya maabara kwa metali nne kwenye fahirisi za hatari katika marudio 50.000 ya Monte Carlo.
| Metali | Mandharinyuma ya kijiolojia (mg/kg) | Wastani wa kipimo sintetiki ± SD (mg/kg) |
|---|---|---|
| Cd | 0,3 | 1,8 ± 0,25 |
| Pb | 20 | 85 ± 9 |
| As | 5 | 22 ± 2,5 |
| Cr | 50 | 120 ± 15 |
Kiasi cha kwanza kinachohesabiwa ni contamination factor:
\[ CF_i= \frac{C_{i,\mathrm{measured}}} {C_{i,\mathrm{background}}} \]
Inamaanisha nini? Ni uwiano usio na kipimo unaoonyesha mara ngapi mkusanyiko wa sasa umeongezeka ikilinganishwa na mandharinyuma ya asili/kijiolojia. \(CF_i=1\) inaonyesha kuwa kipimo na mandharinyuma ni sawa, na thamani kubwa zaidi zinaonyesha urutubishaji juu ya mandharinyuma.
Pollution Load Index huhesabiwa kwa wastani wa kijiometri wa contamination factor za metali nne:
\[ PLI= \left( \prod_{i=1}^{n}CF_i \right)^{1/n} \]
\(n\) ni idadi ya metali. Katika skripti hii \(n=4\). Wastani wa kijiometri hupunguza utawala wa moja kwa moja wa metali moja yenye thamani kubwa sana kama ilivyo katika jumla ya kihesabu, huku ukiunganisha mzigo wote wa vichafuzi katika fahirisi moja isiyo na kipimo. Katika onyesho la chanzo, \(PLI=1\) ni kikomo muhimu cha marejeo kwa uainishaji wa uchafuzi.
Kwa kadmiyamu, Geo-accumulation Index:
\[ I_{\mathrm{geo,Cd}} = \log_2 \left( \frac{C_{\mathrm{Cd}}} {1.5\,B_{\mathrm{Cd}}} \right) \]
inahesabiwa kwa namna hii. \(B_{\mathrm{Cd}}\) ni mkusanyiko wa mandharinyuma wa kadmiyamu. Kipengele 1,5 ni coefficient ya marekebisho inayozingatia utofauti wa asili wa jiokemia.
Matokeo: Katika marudio 50.000, kipindi cha kuaminika cha %90 cha takriban ±0,4 kitengo kiliripotiwa kwa PLI. Chanzo kinaonyesha kuwa katika baadhi ya marudio kipindi hiki kinaweza kuhamisha darasa la PLI kwenye pande zote mbili za thamani ya kikomo 1. Katika usambazaji wa kadmiyamu \(I_{\mathrm{geo}}\), takriban %15 ya marudio zilivuka kikomo cha \(I_{\mathrm{geo}}>3\) Class 4, huku wastani wa ensemble ukibaki katika Class 3. Mfano huu unaonyesha kwamba thamani moja ya hatari ya deterministiki inaweza kuficha mkia wa hatari kubwa.
Workflow 7: Ramani ya EF ya kieneo kwa GeoPandas
Skripti ya saba huunda pointi 150 za sampuli za sintetiki na kuhesabu Enrichment Factor inayorekebisha mkusanyiko wa Pb kulingana na elementi rejea Fe:
\[ EF_{\mathrm{Pb}} = \frac{ C_{\mathrm{Pb}}/C_{\mathrm{Fe}} }{ B_{\mathrm{Pb}}/B_{\mathrm{Fe}} } \]
\(C_{\mathrm{Pb}}\) na \(C_{\mathrm{Fe}}\) ni mikusanyiko ya Pb na Fe iliyopimwa katika sampuli; \(B_{\mathrm{Pb}}\) na \(B_{\mathrm{Fe}}\) ni thamani za mandharinyuma za kikanda. Katika skripti \(B_{\mathrm{Pb}}=20\) mg/kg na \(B_{\mathrm{Fe}}=25\,000\) mg/kg zilitumika.
Kwa kuwa EF ni uwiano, haina kipimo. Madarasa katika msimbo chanzo ni:
| EF | Darasa katika msimbo chanzo |
|---|---|
| \(EF<2\) | Minimal |
| \(2\leq EF<5\) | Moderate |
| \(5\leq EF<20\) | Significant |
| \(EF>20\) | Very high |
Katika sehemu ya matokeo ya chanzo, imeripotiwa kuwa hotspot ya kaskazini-mashariki yenye \(EF_{\mathrm{Pb}}>5\) ilifunika takriban %12 ya eneo na RMSE ya uthibitishaji mtambuka kulingana na pointi %20 withheld ilikuwa takriban 0,38 kitengo cha EF.
Tofauti ya mbinu ndani ya chanzo: Maandishi na matokeo yanaita uso huu “IDW”. Hata hivyo, wito wa interpolesheni katika Listing 7 iliyochapishwa ni `scipy.interpolate.griddata(..., method="linear")`. Interpolesheni ya mstari ndani ya `griddata` na classical inverse-distance weighting si algoriti sawa. Verianla haibadilishi msimbo chanzo na inaweka tofauti hii ya majina ionekane. Zaidi ya hayo, msimbo wa uthibitishaji wa %20 withheld-point katika sehemu ya matokeo haupo katika mistari inayoonekana ya Listing 7 iliyochapishwa.
Je, Matokeo Haya ya Utendaji Yanaonyesha Mafanikio Katika Maeneo Halisi Yaliyochafuliwa?
Hapana. Thamani za utendaji za utafiti ni maonyesho ya workflow katika miundo ya data sintetiki/benchmark iliyodhibitiwa; hakuna uthibitishaji huru wa nje uliofanywa katika maeneo halisi yaliyochafuliwa, na chanzo kinasema wazi kwamba matumizi halisi yanahitaji data za shambani, uthibitishaji mtambuka wa kieneo, uboreshaji wa hyperparameter unaolenga eneo husika na uthibitishaji huru.
Mbinu na Matokeo ya Utafiti
Utendaji wa jumla wa workflow saba
| Skripti | Kazi | Mbinu | Metriki | Matokeo sintetiki yaliyoripotiwa katika chanzo |
|---|---|---|---|---|
| 1 | Mkusanyiko wa kadmiyamu | Regressioni ya Random Forest | \(R^2\) / RMSE | \(R^2\approx0.88\); RMSE <0,35 mg/kg |
| 2 | Pesticide leaching | XGBoost + SHAP | ROC-AUC | ≈0,91; hold-out split moja |
| 3 | Mikroplastiki | 1-B CNN | Accuracy / F1 | Accuracy >%95; F1 >0,94 |
| 4 | Mfululizo wa muda wa PFAS | LSTM | RMSE | <0,05 ng/g; hatua-moja-mbele |
| 5 | Hotspot za virutubisho | PCA | Tofauti iliyofafanuliwa | PC1 ≈%45; hotspot imetenganishwa |
| 6 | Hatari ya metali nyingi | Monte Carlo PLI/Igeo | Kipindi cha kuaminika cha %90 | PLI ≈±0,4 kitengo; marudio 50.000 |
| 7 | EF ya kieneo | GeoPandas / katika chanzo “IDW” | CV RMSE | ≈0,38 kitengo cha EF |
Uwezekano wa kuhamisha mbinu kwenye data halisi
| Mbinu | Mahitaji ya data | Ufafanuzi | Gharama ya ukokotoaji | Kutokuwa na uhakika | Tathmini ya chanzo kwa data halisi |
|---|---|---|---|---|---|
| Random Forest | Wastani; tabular | Juu | Chini–wastani | Bootstrap CI inaweza kutumika | Nzuri; CV ya kieneo inahitajika |
| XGBoost + SHAP | Wastani; tabular | Juu | Chini–wastani | Haijajengwa ndani | Nzuri; stratified CV inapendekezwa |
| 1-B CNN | Maktaba kubwa ya spektra | Wastani | Wastani | Dropout | Wastani; transfer learning inapendekezwa |
| LSTM | Mfululizo mrefu wa muda | Chini | Wastani–juu | Haijajengwa ndani | Wastani; urekebishaji mahsusi wa eneo unahitajika |
| PCA | Data zisizo na lebo zinatosha | Juu | Chini sana | Haijajengwa ndani | Juu; unsupervised |
| Monte Carlo | Usambazaji wa uwezekano | Juu | Chini | CI wazi | Juu; imeundwa kwa kutokuwa na uhakika |
| Uchoraji wa GeoPandas | Pointi za sampuli za kieneo | Juu | Chini | Haijajengwa ndani | Wastani; autocorrelation ya kieneo inahitaji kudhibitiwa |
Uhusiano na huduma za mfumo ikolojia wa udongo
Moja ya sifa bainifu za utafiti ni kwamba hauachi mifano saba ya msimbo kama kazi za kiufundi za ML pekee. Listing 1 na 2 zimehusishwa na uhifadhi/upunguzaji wa vichafuzi; Listing 2 na 5 na udhibiti wa maji na mzunguko wa virutubisho; Listing 3 na 4 na makazi na uzalishaji wa biomasi; Listing 6 na uhifadhi wa kaboni na hatari ya kiikolojia; na Listing 7 na usimamizi wa hatari za kieneo na upangaji wa urejeshaji.
Matokeo yanayoungwa mkono na utafiti
- Imeonyeshwa kuwa Python inaweza kutumiwa kuunda mnyororo wa moduli wa uchanganuzi wa uchafuzi wa udongo unaofunika aina tofauti za data.
- Katika onyesho la sintetiki, RF ilijifunza upya muundo usio wa mstari uliopachikwa katika lengo la Cd kwa takriban \(R^2=0.88\).
- XGBoost + SHAP ilitoa takriban 0,91 ROC-AUC katika muundo wa sintetiki wa hatari ya viuatilifu.
- 1-B CNN ilifikia usahihi wa uainishaji wa zaidi ya %95 katika spektra sintetiki za FTIR zinazotenganishwa wazi.
- LSTM iliweka RMSE ya hatua-moja-mbele chini ya 0,05 ng/g katika mfululizo wa PFAS ambapo msimu na ongezeko la mstari vilifafanuliwa wazi katika utengenezaji wa data.
- PCA ilitenganisha kundi la hotspot la N/NO3/P lililoongezwa mara tatu na nusu kwa njia bandia kwenye PC1 na kueleza takriban %45 ya tofauti.
- Uchanganuzi wa Monte Carlo ulionyesha kwa namna ya onyesho kwamba kuripoti PLI/Igeo kwa thamani moja kunaweza kuficha mikia ya kutokuwa na uhakika.
- Kulingana na matokeo ya chanzo, pipeline ya EF ya kieneo ilitoa hotspot iliyo wazi na RMSE ya uthibitishaji ya takriban 0,38 kitengo cha EF iliripotiwa.
Ujumlishaji usioungwa mkono na utafiti na vikwazo
- Hakuna modeli iliyofanyiwa uthibitishaji huru wa nje katika seti halisi ya data ya eneo lililochafuliwa.
- Thamani kubwa za utendaji si ushahidi wa kugundua mahusiano halisi ya kimazingira; ishara zenye nguvu ziliwekwa mapema katika utengenezaji wa data sintetiki.
- Band 3 na pH kuonekana kuwa muhimu katika RF kunahusiana moja kwa moja na kigezo lengwa kutengenezwa kama kazi ya vigezo hivi.
- Kutenganishwa kwa hotspot ya N, nitrati na P katika PCA kunahusiana na vigezo hivi kuongezwa mara 3,5 katika sampuli 50 zilizochaguliwa.
- LSTM haijathibitisha utabiri halisi wa PFAS wa muda mrefu wa hatua nyingi.
- Radionuklidi ziko nje ya wigo mkuu.
- Katika matumizi halisi ya kimazingira, autocorrelation ya kieneo, muundo wa uchukuaji sampuli shambani, hitilafu ya kifaa, mabadiliko ya data na jiokemia ya eneo lazima zitathminiwe kando.
- Kuna tofauti ya majina ya kimetodolojia kati ya maelezo ya SHAP katika Listing 1 na msimbo wa importance uliochapishwa.
- Jina la “IDW” katika Listing 7 na utekelezaji wa `griddata(method="linear")` si mbinu sawa ya kimahesabu ya interpolesheni.
- Mchakato wa uthibitishaji mtambuka wa withheld-point ulioripotiwa kwa Listing 7 haupo katika sehemu inayoonekana ya Listing ya msimbo uliochapishwa.
Zana zilizotumiwa kwa mtazamo wa urudiaji
Toleo la Python limeelezwa kuwa 3.12. Maktaba kuu za chanzo huria zilizotumika ni scikit-learn, XGBoost, TensorFlow/Keras, SHAP, GeoPandas, SciPy, NumPy, pandas na Matplotlib. Lengo la utafiti si kuwasilisha misimbo hii kama modeli za mwisho za shambani, bali kuunda violezo vya uchanganuzi vinavyoeleweka vyenyewe ambavyo vinaweza kubadilishwa kwa seti halisi za data za maeneo yaliyochafuliwa.
Maelezo ya Chanzo na Mbinu
Kichwa asili: Python-Powered Environmental Intelligence: Computational Workflows for Soil Pollution Assessment Using ML Methods
Mwandishi: Polina Lemenkova.
Taasisi: Bureau de Recherches Géologiques et Minières (BRGM), Orléans, Ufaransa; Le Studium, Institut d’Etudes Avancées du Val de Loire, Orléans, Ufaransa; Le Laboratoire PRISME, INSA Centre-Val de Loire / Université d’Orléans, Ufaransa; La Technopole d’Orléans, Ufaransa.
Jarida: Environmental Remediation.
Mchapishaji: MDPI.
Rekodi ya bibliografia: Environ. Remediat. 2026, 1(2), 6.
DOI: 10.3390/environremediat1020006
Kiungo rasmi: https://doi.org/10.3390/environremediat1020006
Academic Editor: Wenjie Ren.
Imewasilishwa: 23 Mei 2026. Marekebisho: 16 Juni 2026. Imekubaliwa: 23 Juni 2026. Imechapishwa: 8 Julai 2026.
Aina ya chanzo: Makala ya utafiti wa workflow ya kimetodolojia iliyopitiwa na wenzao; inaunganisha usanisi wa fasihi na maonyesho saba ya Python yanayoweza kurudiwa kwenye data sintetiki/benchmark. Chanzo hakijielezi kama mapitio ya kimfumo kwa maana kali ya bibliometriki, bali kama methodological workflow paper.
Leseni: Creative Commons Attribution (CC BY).
Ufadhili: Chanzo kinatoa taarifa “This research received no external funding”.
Kamati ya maadili / ridhaa: Imeripotiwa kuwa haitumiki.
Upatikanaji wa data: Chanzo kinaeleza kuwa michango asili ya utafiti inapatikana ndani ya makala.
Mgongano wa maslahi: Mwandishi ameripoti kutokuwepo kwa mgongano wa maslahi.
Michango ya mwandishi: Katika sehemu ya mwisho ya taarifa ya PDF ya chanzo hakuna aya tofauti ya CRediT/Author Contributions; majukumu ya mchango yasiyokuwepo katika chanzo hayajaongezwa kwa utafiti wa mwandishi mmoja.
Kikomo kikuu cha kimetodolojia: Utendaji wote wa modeli katika makala unategemea data sintetiki au benchmark za maonyesho. Kwa maeneo halisi yaliyochafuliwa, uthibitishaji huru wa shambani, uthibitishaji mtambuka wa kieneo unaofaa, uboreshaji wa hyperparameter maalumu kwa eneo lengwa na tathmini ya ubora wa data vinahitajika.
Maelezo ya mbinu ndani ya chanzo: Maelezo ya Listing 1 yanataja upangaji wa umuhimu unaotegemea SHAP, huku msimbo unaoonekana ukitumia pato la `feature_importances_` la Random Forest. Ingawa Listing 7 inaitwa IDW katika maandishi, msimbo unaoonekana wa interpolesheni hutumia `griddata(method="linear")`. Katika sehemu ya Results, uthibitishaji wa %20 withheld-point na RMSE ya takriban 0,38 EF zinaripotiwa kwa Listing 7, lakini mzunguko huu wa uthibitishaji haupo katika mistari inayoonekana ya Listing 7 iliyochapishwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *