


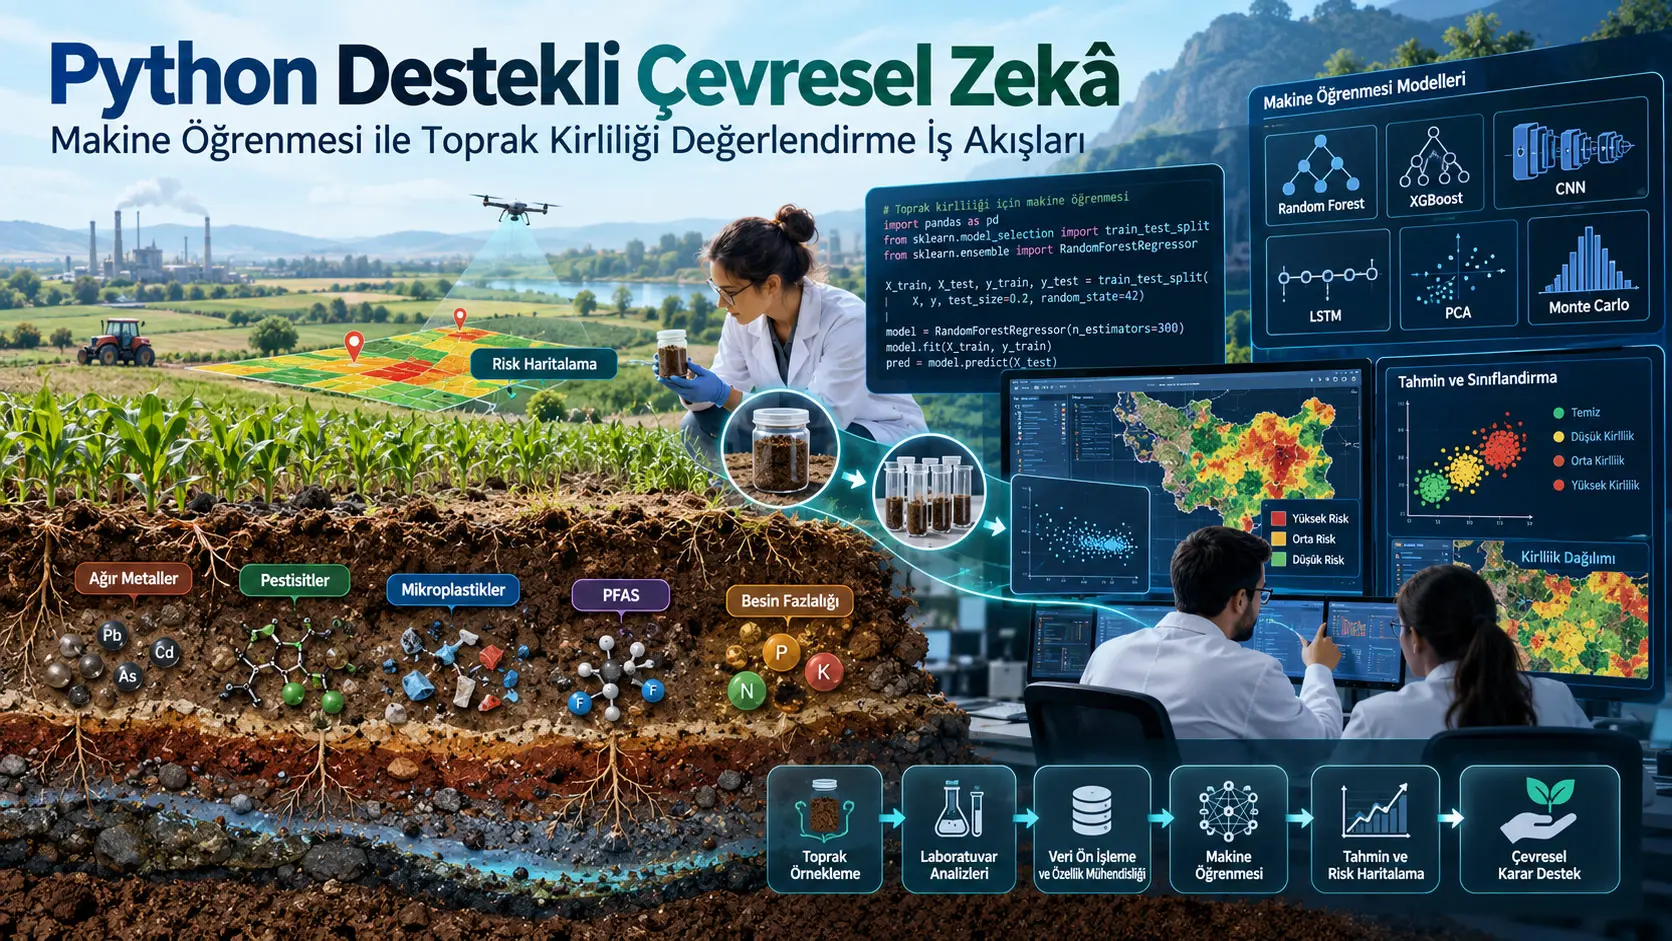
Python tabanlı toprak kirliliği değerlendirme iş akışları, farklı kirletici türlerinin tahmini, sınıflandırılması, zaman içindeki değişiminin öngörülmesi, belirsizliğinin hesaplanması ve mekânsal risk haritalarının oluşturulması için makine öğrenmesi, derin öğrenme, istatistik ve CBS araçlarını bir araya getiren modüler hesaplamalı analiz şablonlarıdır. Çalışma ağır metaller, pestisitler, mikroplastikler, per- ve polifloroalkil maddeler (PFAS) ve aşırı makrobesin yükünü ele almakta; Random Forest, XGBoost + SHAP, 1-B CNN, LSTM, PCA, Monte Carlo ve GeoPandas tabanlı yedi Python iş akışı sunmaktadır.
Çalışmanın en önemli yorum sınırı, bildirilen model başarılarının gerçek kirlenmiş saha verilerinde doğrulanmış performans değerleri olmamasıdır. Yedi uygulamanın veri yapısı, literatürdeki çevresel değişkenleri taklit eden sentetik/benchmark verilerle kurulmuştur. Random Forest için yaklaşık \(R^2=0{,}88\), XGBoost için ROC-AUC yaklaşık 0,91, mikroplastik 1-B CNN için %95'in üzerinde doğruluk, PFAS LSTM için 0,05 ng/g'nin altında bir-adım-ileri RMSE, PCA için ilk bileşende yaklaşık %45 açıklanan varyans, Monte Carlo PLI için yaklaşık ±0,4 birimlik %90 güven aralığı ve mekânsal EF haritalama için yaklaşık 0,38 EF birimi çapraz doğrulama RMSE'si raporlanmıştır. Bunların tamamı metodolojik workflow gösterimidir.
Çalışma ayrıca hesaplamalı analizi toprak ekosistem hizmetlerine bağlayan altı aşamalı bir çerçeve kurmaktadır: kirlilik kaynaklarının belirlenmesi, kirletici davranışının modellenmesi, senaryo tahmini, ekolojik risk değerlendirmesi, çok faktörlü analiz ve tahmin/yönetim. Böylece amaç yalnız bir ML modelinin skorunu yükseltmek değil; saha örneklemesinden risk haritalamasına ve iyileştirme kararına kadar izlenebilir bir çevresel veri analizi zinciri oluşturmaktır.
Çalışmanın araştırma problemi
Toprak kirliliği tek bir kirleticinin konsantrasyonunu ölçmekten daha karmaşık bir problemdir. Kirleticinin hareketliliği ve biyoyararlanımı; toprak mineralojisi, organik madde, pH, kil oranı, gözenek yapısı, hidrolojik koşullar, kimyasal türleşme ve çevresel süreçlerle birlikte değişmektedir. Bu yüksek boyutlu ve doğrusal olmayan yapı, klasik tek değişkenli analizlerin çevresel davranışı tam olarak temsil etmesini güçleştirir.
Çalışma bu problemi üç katmanda ele almaktadır: yayımlanmış çevre bilimleri literatürünün sentezi, toprak ekosistem hizmetlerini analitik süreçle bağlayan altı aşamalı kavramsal çerçeve ve yedi çalıştırılabilir Python workflow'u.
Literatür taraması nasıl yapıldı?
Kaynak, Web of Science ve Scopus üzerinde 100'den fazla hakemli yayına dayanan bir literatür sentezi gerçekleştirmiştir. Arama terimleri arasında “soil pollution”, “soil contamination”, “machine learning”, “random forest”, “deep learning”, “heavy metals”, “PFAS”, “microplastics”, “pesticide leaching” ve “soil ecosystem services” bulunmaktadır. Ana zaman aralığı 2015–2026'dır; metodolojik açıdan temel kabul edilen daha eski çalışmalar tarihsel bağlam amacıyla kapsamda tutulmuştur.
Dahil edilme ölçütleri üç ana koşula dayanmıştır: çalışmanın ML tabanlı toprak kirliliği tespiti veya risk değerlendirmesiyle doğrudan ilişkili olması, nicel performans metriği veya doğrulanmış tespit yöntemi raporlaması ve makalede ele alınan beş temel kirletici grubundan en az birini kapsaması.
Çalışmanın kapsadığı temel kirletici grupları
| Kirletici grubu | Çalışmadaki hesaplamalı görev | Ana çevresel sorun |
|---|---|---|
| Ağır metaller | Konsantrasyon tahmini, risk indisleri, mekânsal EF haritalama | Kalıcı birikim, biyoyararlanım, trofik zincirde birikim |
| Pestisitler | Sızıntı/leaching risk sınıflandırması | Yeraltı suyuna taşınım, mikrobiyal ve besin döngüsü etkileri |
| Mikroplastikler | FTIR benzeri spektrumdan sınıflandırma | Toprak yapısı, porozite ve birlikte taşınan kirleticiler |
| PFAS | Zaman serisi tahmini | Çok yüksek çevresel kalıcılık ve uzun dönemli birikim |
| Aşırı makrobesinler | PCA ile boyut indirgeme ve hotspot belirleme | N/P yükü, ötrofikasyon, yeraltı suyu ve toprak kalitesi |
Radyoaktif kirleticiler çalışmada önemli bir toprak kontaminasyonu sınıfı olarak kabul edilmekte, ancak ana Python workflow kapsamının dışında bırakılmaktadır. Kaynak gama spektrometrisi ve belirsizlik yayılımının gelecekteki radionüklid değerlendirmelerinde kullanılabileceğini belirtmektedir.
Yedi Python İş Akışı Toprak Kirliliğini Nasıl Analiz Ediyor?
Yedi workflow aynı problemi tekrarlamak yerine farklı veri tiplerine karşılık gelir: Random Forest ağır metal konsantrasyonunu regresyonla, XGBoost pestisit sızıntı riskini sınıflandırmayla, 1-B CNN mikroplastikleri spektral örüntüyle, LSTM PFAS'ı zaman serisiyle, PCA besin hotspotlarını boyut indirgemeyle, Monte Carlo risk indislerindeki ölçüm belirsizliğini olasılıksal olarak ve GeoPandas tabanlı süreç ise ağır metal zenginleşmesini mekânsal harita üzerinde işler.
Workflow 1: Random Forest ile kadmiyum konsantrasyonu
İlk script, beş spektral yansıtım bandı ile pH, toprak organik maddesi (SOM) ve kil yüzdesini kullanarak kadmiyum konsantrasyonunu tahmin eden Random Forest regresyonu kurmaktadır. Veri sayısı \(n=1000\)'dir.
Sentetik hedef değişken kaynak kodunda şu ilişkiyle oluşturulmaktadır:
\[ C_{\mathrm{Cd}} = 2.8\,pH - 1.5\,SOM^2 + 6.0\,B_3 + \varepsilon, \qquad \varepsilon\sim\mathcal{N}(0,0.4^2) \]
Formül neyi hesaplar? Sentetik kadmiyum konsantrasyonunu mg/kg cinsinden oluşturur. \(B_3\), üçüncü spektral bant yansıtımıdır; \(SOM\), yüzde organik madde değişkenidir; \(\varepsilon\), standart sapması 0,4 mg/kg olan Gaussian gürültüdür.
Neden bu ayrıntı kritik? Random Forest'ın yüksek \(R^2\) değeri doğal bir çevresel ilişkiyi keşfetmesinden değil, hedef değişkenin başlangıçta bu predictor'ların matematiksel fonksiyonu olarak üretilmesinden etkilenmektedir. Kaynak özellikle Band 3 ve pH'nin baskın predictor çıkmasının veri oluşturma formülünden kaynaklandığını belirtmektedir.
Model 200 ağaç, maksimum derinlik 12 ve minimum yaprak örneği 4 ile kurulmuş; veri %80 eğitim ve %20 test olarak bölünmüş, ayrıca beş katlı çapraz doğrulama uygulanmıştır.
Sonuç: Yaklaşık \(R^2=0.88\), RMSE < 0,35 mg/kg. Bu değer sentetik demonstrasyona aittir.
Kaynak-içi yöntem notu: yöntem açıklamasında SHAP tabanlı feature importance ifadesi bulunmasına karşın yayımlanan Listing 1 kodu `rf.feature_importances_` kullanmaktadır. Bu, Random Forest'ın yerleşik impurity-tabanlı önem ölçümüdür; yayımlanmış Listing 1 içinde SHAP çağrısı görünmemektedir.
Workflow 2: XGBoost + SHAP ile pestisit sızıntı riski
İkinci script; kum, kil, SOM, yağış, eğim ve pH kullanarak yüksek/düşük pestisit leaching riskini sınıflandırmaktadır. Sentetik riskin oluşturulmasında kullanılan logit:
\[ z= -0.04\,Sand +0.07\,Clay -0.30\,SOM +0.06\,Precip +0.05\,Slope -0.5 \]
ve lojistik dönüşüm:
\[ P= \frac{1}{1+e^{-z}} \]
üzerinden \(P>0.5\) olduğunda yüksek risk sınıfı oluşturulmaktadır.
Katsayıların işareti sentetik veri üretim mantığını açıklar: örneğin bu kurgu içinde yağış ve kil arttıkça \(z\) yükselirken SOM arttıkça azalır. Bu katsayılar gerçek saha için ölçülmüş evrensel pestisit taşıma katsayıları değildir.
XGBoost modelinde 300 estimator, maksimum derinlik 5, learning rate 0,05, subsample 0,8 ve column subsampling 0,8 kullanılmıştır. Veri stratified biçimde %75 eğitim ve %25 test olarak bölünmüştür.
Sonuç: ROC-AUC yaklaşık 0,91. Bu değer tek bir hold-out partition'a aittir; kodda çapraz doğrulama döngüsü bulunmamaktadır. SHAP analizi bu sentetik kurgu içinde yağış yoğunluğu ve kil oranını başlıca risk belirleyicileri olarak öne çıkarmıştır.
Workflow 3: 1-B CNN ile mikroplastik sınıflandırması
Üçüncü script 128 kanallı FTIR-benzeri spektral fingerprint'lerden mikroplastik ve mineral/organik parçacıkları ayırmak için bir boyutlu Convolutional Neural Network kullanmaktadır. Toplam 1200 sentetik spektrum üretilmiştir.
Mineral/organik sınıfı yaklaşık:
\[ X_{\mathrm{min}}\sim\mathcal{N}(0.3,0.08^2) \]
ve mikroplastik sınıfı:
\[ X_{\mathrm{MP}}\sim\mathcal{N}(0.6,0.10^2) \]
dağılımlarından oluşturulmuş; mikroplastik spektrumlarının 40–44. ve 80–84. kanal aralıklarına sırasıyla +0,5 ve +0,4 yapay absorbsiyon özellikleri eklenmiştir.
Ağ yapısı sırasıyla 32 filtreli Conv1D (kernel=5), MaxPooling1D, 64 filtreli Conv1D (kernel=3), GlobalAveragePooling1D, 64 nöronlu Dense, %30 dropout ve sigmoid çıkış katmanından oluşmaktadır. Kayıp binary cross-entropy, optimizer Adam'dır. Eğitim 30 epoch, batch size 32 ve eğitim verisi içinde %15 validation split ile yapılmıştır.
Sonuç: Sentetik hold-out spektrumlarında doğruluk %95'in üzerinde, F1 > 0,94 olarak raporlanmıştır. Bu sonuç gerçek toprak FTIR kütüphanesinde doğrulanmış bir saha sınıflandırma skoru değildir.
Workflow 4: LSTM ile PFAS zaman serisi
Dördüncü script 10 yıllık, aylık 120 örnekten oluşan sentetik PFAS serisi üretmektedir:
\[ C(t) = 0.8 + 0.4\sin(t) + 0.015\,m + \varepsilon, \qquad \varepsilon\sim\mathcal{N}(0,0.05^2) \]
Burada \(m\) ay indeksidir. İlk sabit temel düzeyi, sinüs terimi mevsimselliği, \(0.015m\) uzun dönem artışını ve Gaussian terim rastgele gürültüyü temsil eder. Konsantrasyon birimi ng/g'dir.
Seri MinMaxScaler ile normalize edilmiş ve 12 aylık kayan pencere kullanılmıştır. Her 12 aylık giriş dizisinin hedefi hemen sonraki tek aylık değerdir.
LSTM mimarisi 64 birimli ve sequence döndüren ilk LSTM, %20 dropout, 32 birimli ikinci LSTM, 16 nöronlu ReLU Dense ve tek değer üreten çıkış katmanından oluşur. Model Adam + MSE ile 50 epoch ve batch size 16 kullanılarak eğitilir.
Sonuç: Bir-adım-ileri PFAS tahmin RMSE'si <0,05 ng/g'dir.
Kritik sınır: Bu model 12 ay ileriyi tek seferde tahmin etmemektedir. On iki aylık geçmiş pencereyi kullanıp bir sonraki ayı tahmin eder. Gerçek uzun dönem çok-adımlı tahmin için autoregressive rollout ve bağımsız saha doğrulaması gerekir.
Workflow 5: PCA ile besin hotspotlarının bulunması
Beşinci script N, P, K, pH, SOM, nitrat ve amonyum değişkenlerinden oluşan 500 örneklik sentetik çok-elementli toprak kimyası matrisi üretir. Rastgele seçilen 50 hotspot örneğinde N, NO3 ve P değerleri 3,5 kat artırılmıştır.
Önce bütün değişkenler StandardScaler ile standardize edilmiş, ardından veri iki principal component'e indirgenmiştir. PCA'nın genel matematiksel fikri, yüksek boyutlu veri uzayını birbirine dik yeni eksenlere yansıtarak varyansın olabildiğince büyük bölümünü ilk bileşenlerde toplamaktır.
Sonuç: PC1 toplam varyansın yaklaşık %45'ini açıklamış ve yapay olarak oluşturulan yüksek N/NO3/P hotspot kümesini ayırmıştır. Bu nedenle N ve P'nin baskın çıkması bağımsız bir saha keşfi değildir; hotspot üretim adımının kendisi bu üç değişkeni özellikle yükseltmektedir.
Workflow 6: Monte Carlo ile PLI ve Igeo belirsizliği
Altıncı script dört metal için laboratuvar ölçüm belirsizliğini 50.000 Monte Carlo realizasyonu boyunca risk indislerine yaymaktadır.
| Metal | Jeojenik arka plan (mg/kg) | Sentetik ölçüm ortalaması ± SD (mg/kg) |
|---|---|---|
| Cd | 0,3 | 1,8 ± 0,25 |
| Pb | 20 | 85 ± 9 |
| As | 5 | 22 ± 2,5 |
| Cr | 50 | 120 ± 15 |
İlk hesaplanan büyüklük contamination factor'dür:
\[ CF_i= \frac{C_{i,\mathrm{measured}}} {C_{i,\mathrm{background}}} \]
Ne anlama gelir? Mevcut konsantrasyonun doğal/jeojenik arka plana göre kaç kat yükseldiğini gösteren boyutsuz bir orandır. \(CF_i=1\) ölçüm ile arka planın aynı olduğunu, daha büyük değerler arka planın üzerinde zenginleşmeyi ifade eder.
Pollution Load Index dört metalin contamination factor'larının geometrik ortalamasıyla hesaplanır:
\[ PLI= \left( \prod_{i=1}^{n}CF_i \right)^{1/n} \]
\(n\), metal sayısıdır. Bu scriptte \(n=4\)'tür. Geometrik ortalama tek bir çok yüksek metalin aritmetik toplam gibi doğrudan baskın olmasını azaltırken bütün kirletici yükünü tek bir boyutsuz indekste birleştirir. Kaynak demonstrasyonunda \(PLI=1\) kirlilik sınıflandırması açısından önemli referans sınırıdır.
Kadmiyum için Geo-accumulation Index:
\[ I_{\mathrm{geo,Cd}} = \log_2 \left( \frac{C_{\mathrm{Cd}}} {1.5\,B_{\mathrm{Cd}}} \right) \]
şeklinde hesaplanmaktadır. \(B_{\mathrm{Cd}}\), kadmiyumun arka plan konsantrasyonudur. 1,5 faktörü doğal jeokimyasal değişkenliği hesaba katan düzeltme katsayısıdır.
Sonuç: 50.000 realizasyonda PLI için yaklaşık ±0,4 birimlik %90 güven aralığı raporlanmıştır. Kaynak bu aralığın bazı realizasyonlarda PLI sınıfını 1 eşik değerinin iki tarafına taşıyabileceğini göstermektedir. Kadmiyum \(I_{\mathrm{geo}}\) dağılımında realizasyonların yaklaşık %15'i \(I_{\mathrm{geo}}>3\) Class 4 sınırını aşarken ensemble ortalaması Class 3'te kalmıştır. Bu örnek, tek bir deterministik risk değerinin yüksek risk kuyruğunu gizleyebileceğini göstermektedir.
Workflow 7: GeoPandas ile mekânsal EF haritası
Yedinci script 150 sentetik örnekleme noktası oluşturur ve Pb konsantrasyonunu Fe referans elementine göre normalize eden Enrichment Factor hesaplar:
\[ EF_{\mathrm{Pb}} = \frac{ C_{\mathrm{Pb}}/C_{\mathrm{Fe}} }{ B_{\mathrm{Pb}}/B_{\mathrm{Fe}} } \]
\(C_{\mathrm{Pb}}\) ve \(C_{\mathrm{Fe}}\) örnekte ölçülen Pb ve Fe konsantrasyonları; \(B_{\mathrm{Pb}}\) ve \(B_{\mathrm{Fe}}\) bölgesel arka plan değerleridir. Scriptte \(B_{\mathrm{Pb}}=20\) mg/kg ve \(B_{\mathrm{Fe}}=25\,000\) mg/kg kullanılmıştır.
EF oran olduğu için boyutsuzdur. Kaynak kodunda sınıflar:
| EF | Kaynak kodundaki sınıf |
|---|---|
| \(EF<2\) | Minimal |
| \(2\leq EF<5\) | Moderate |
| \(5\leq EF<20\) | Significant |
| \(EF>20\) | Very high |
Kaynak sonuç bölümünde \(EF_{\mathrm{Pb}}>5\) olan kuzeydoğu hotspotunun alanın yaklaşık %12'sini kapladığı ve %20 withheld noktaya göre çapraz doğrulama RMSE'sinin yaklaşık 0,38 EF birimi olduğu raporlanmıştır.
Kaynak-içi yöntem farkı: Metin ve sonuçlar bu yüzeyi “IDW” olarak adlandırmaktadır. Ancak yayımlanmış Listing 7'de interpolasyon çağrısı `scipy.interpolate.griddata(..., method="linear")` biçimindedir. `griddata` içindeki lineer interpolasyon ile klasik inverse-distance weighting aynı algoritma değildir. Verianla kaynak kodunu değiştirmemekte ve bu adlandırma farkını görünür tutmaktadır. Ayrıca sonuç bölümündeki %20 withheld-point doğrulama kodu, yayımlanmış Listing 7'nin görünen satırlarında yer almamaktadır.
Bu Performans Sonuçları Gerçek Kirlenmiş Sahalardaki Başarıyı Gösteriyor mu?
Hayır. Çalışmanın performans değerleri kontrollü sentetik/benchmark veri yapılarındaki workflow demonstrasyonlarıdır; gerçek kirlenmiş sahalarda bağımsız dış doğrulama yapılmamıştır ve kaynak, gerçek uygulamada saha verisi, mekânsal çapraz doğrulama, bölgeye özgü hiperparametre optimizasyonu ve bağımsız validasyon gerektiğini açıkça belirtmektedir.
Çalışmanın Yöntemi ve Bulguları
Yedi workflow'un toplu performansı
| Script | Görev | Yöntem | Metrik | Kaynakta raporlanan sentetik sonuç |
|---|---|---|---|---|
| 1 | Kadmiyum konsantrasyonu | Random Forest regresyon | \(R^2\) / RMSE | \(R^2\approx0.88\); RMSE <0,35 mg/kg |
| 2 | Pestisit leaching | XGBoost + SHAP | ROC-AUC | ≈0,91; tek hold-out split |
| 3 | Mikroplastik | 1-B CNN | Accuracy / F1 | Accuracy >%95; F1 >0,94 |
| 4 | PFAS zaman serisi | LSTM | RMSE | <0,05 ng/g; bir-adım-ileri |
| 5 | Besin hotspotları | PCA | Açıklanan varyans | PC1 ≈%45; hotspot ayrılmıştır |
| 6 | Çok-metalli risk | Monte Carlo PLI/Igeo | %90 güven aralığı | PLI ≈±0,4 birim; 50.000 realizasyon |
| 7 | Mekânsal EF | GeoPandas / kaynakta “IDW” | CV RMSE | ≈0,38 EF birimi |
Yöntemlerin gerçek veriye taşınabilirliği
| Yöntem | Veri gereksinimi | Yorumlanabilirlik | Hesaplama maliyeti | Belirsizlik | Kaynağın gerçek veri değerlendirmesi |
|---|---|---|---|---|---|
| Random Forest | Orta; tabular | Yüksek | Düşük–orta | Bootstrap CI uygulanabilir | İyi; mekânsal CV gerekir |
| XGBoost + SHAP | Orta; tabular | Yüksek | Düşük–orta | Yerleşik değil | İyi; stratified CV önerilir |
| 1-B CNN | Büyük spektral kütüphane | Orta | Orta | Dropout | Orta; transfer learning önerilir |
| LSTM | Uzun zaman serisi | Düşük | Orta–yüksek | Yerleşik değil | Orta; sahaya özgü ayar gerekir |
| PCA | Etiketsiz veri yeterli | Yüksek | Çok düşük | Yerleşik değil | Yüksek; unsupervised |
| Monte Carlo | Olasılık dağılımları | Yüksek | Düşük | Açık biçimde CI | Yüksek; belirsizlik için tasarlanmış |
| GeoPandas haritalama | Mekânsal örnek noktaları | Yüksek | Düşük | Yerleşik değil | Orta; mekânsal otokorelasyon kontrolü gerekir |
Toprak ekosistem hizmetleri ile bağlantı
Çalışmanın ayırt edici yönlerinden biri yedi kod örneğini yalnız teknik ML görevleri olarak bırakmamasıdır. Listing 1 ve 2 kirletici tutulumu/azaltımıyla; Listing 2 ve 5 su düzenleme ve besin döngüsüyle; Listing 3 ve 4 habitat ve biyokütle üretimiyle; Listing 6 karbon depolama ve ekolojik riskle; Listing 7 ise mekânsal risk yönetimi ve iyileştirme planlamasıyla ilişkilendirilmiştir.
Çalışmanın desteklediği sonuçlar
- Python ile farklı veri tiplerini kapsayan modüler bir toprak kirliliği analiz zinciri kurulabileceği gösterilmiştir.
- Sentetik demonstrasyonda RF, Cd hedefindeki gömülü doğrusal olmayan yapıyı yaklaşık \(R^2=0.88\) ile geri öğrenmiştir.
- XGBoost + SHAP sentetik pestisit risk kurgusunda yaklaşık 0,91 ROC-AUC üretmiştir.
- 1-B CNN açıkça ayrıştırılmış sentetik FTIR-benzeri spektrumlarda %95'in üzerinde sınıflandırma doğruluğu sağlamıştır.
- LSTM mevsimsellik ve doğrusal artışın veri üretiminde açıkça tanımlandığı PFAS serisinde bir-adım-ileri RMSE'yi 0,05 ng/g'nin altında tutmuştur.
- PCA, yapay olarak üç buçuk kat yükseltilen N/NO3/P hotspot kümesini PC1 üzerinde ayırmış ve yaklaşık %45 varyansı açıklamıştır.
- Monte Carlo analizi tek değerli PLI/Igeo raporlamasının belirsizlik kuyruklarını gizleyebileceğini demonstratif olarak göstermiştir.
- Kaynak sonuçlarına göre mekânsal EF pipeline'ı belirgin bir hotspot üretmiş ve yaklaşık 0,38 EF birimi doğrulama RMSE'si raporlamıştır.
Çalışmanın desteklemediği genellemeler ve sınırlılıklar
- Hiçbir modelin gerçek bir kirlenmiş saha veri setinde bağımsız dış doğrulaması yapılmamıştır.
- Yüksek performans değerleri gerçek çevresel ilişkileri keşfetmenin kanıtı değildir; sentetik veri üretiminde güçlü sinyaller önceden kodlanmıştır.
- RF'de Band 3 ve pH'nin önemli çıkması hedef değişkenin bu değişkenlerin fonksiyonu olarak üretilmesiyle doğrudan ilişkilidir.
- PCA'da N, nitrat ve P hotspotunun ayrılması, bu değişkenlerin seçilmiş 50 örnekte 3,5 kat yükseltilmesiyle bağlantılıdır.
- LSTM uzun dönem çok-adımlı gerçek PFAS tahminini doğrulamamıştır.
- Radionüklidler ana kapsam dışındadır.
- Gerçek çevresel uygulamalarda mekânsal otokorelasyon, saha örnekleme tasarımı, cihaz hatası, veri kayması ve yerel jeokimya ayrıca değerlendirilmelidir.
- Listing 1'in SHAP tanımı ile yayımlanmış importance kodu arasında yöntemsel adlandırma farkı vardır.
- Listing 7'nin “IDW” adlandırması ile `griddata(method="linear")` uygulaması aynı matematiksel interpolasyon yöntemi değildir.
- Listing 7 için raporlanan withheld-point çapraz doğrulama işlemi yayımlanmış kodun görünen Listing bölümünde bulunmamaktadır.
Yeniden üretilebilirlik açısından kullanılan araçlar
Python sürümü 3.12 olarak belirtilmiştir. Kullanılan başlıca açık kaynak kütüphaneleri scikit-learn, XGBoost, TensorFlow/Keras, SHAP, GeoPandas, SciPy, NumPy, pandas ve Matplotlib'dir. Çalışmanın amacı bu kodları nihai saha modelleri olarak sunmak değil, gerçek kirlenmiş saha veri kümelerine uyarlanabilecek kendi içinde anlaşılır analiz şablonları oluşturmaktır.
Kaynak ve Yöntem Notu
Özgün başlık: Python-Powered Environmental Intelligence: Computational Workflows for Soil Pollution Assessment Using ML Methods
Yazar: Polina Lemenkova.
Kurumlar: Bureau de Recherches Géologiques et Minières (BRGM), Orléans, Fransa; Le Studium, Institut d’Etudes Avancées du Val de Loire, Orléans, Fransa; Le Laboratoire PRISME, INSA Centre-Val de Loire / Université d’Orléans, Fransa; La Technopole d’Orléans, Fransa.
Dergi: Environmental Remediation.
Yayınevi: MDPI.
Bibliyografik kayıt: Environ. Remediat. 2026, 1(2), 6.
DOI: 10.3390/environremediat1020006
Resmî bağlantı: https://doi.org/10.3390/environremediat1020006
Academic Editor: Wenjie Ren.
Gönderim: 23 Mayıs 2026. Revizyon: 16 Haziran 2026. Kabul: 23 Haziran 2026. Yayın: 8 Temmuz 2026.
Kaynak türü: Hakemli metodolojik workflow araştırma makalesi; literatür sentezi ile sentetik/benchmark veriler üzerinde yedi tekrar üretilebilir Python demonstrasyonunu birleştirir. Kaynak kendisini katı bibliyometrik anlamda sistematik derleme olarak değil, methodological workflow paper olarak tanımlar.
Lisans: Creative Commons Attribution (CC BY).
Finansman: Kaynak “This research received no external funding” bildirimini vermektedir.
Etik kurul / onam: Uygulanabilir değil olarak bildirilmiştir.
Veri erişilebilirliği: Kaynak, çalışmanın özgün katkılarının makale içinde bulunduğunu belirtmektedir.
Çıkar çatışması: Yazar çıkar çatışması olmadığını bildirmiştir.
Yazar katkıları: Kaynak PDF'nin son bildirim bölümünde ayrı bir CRediT/Author Contributions paragrafı bulunmamaktadır; tek yazarlı çalışma için kaynakta olmayan katkı rolleri eklenmemiştir.
Temel yöntemsel sınır: Makaledeki bütün model performansları sentetik veya demonstrasyon benchmark verilerine dayanmaktadır. Gerçek kirlenmiş sahalar için bağımsız saha validasyonu, uygun mekânsal çapraz doğrulama, hedef bölgeye özgü hiperparametre optimizasyonu ve veri kalitesi değerlendirmesi gereklidir.
Kaynak-içi yöntem notları: Listing 1 açıklaması SHAP tabanlı önem sıralamasını belirtirken görünen kod Random Forest'ın `feature_importances_` çıktısını kullanır. Listing 7 metinde IDW olarak adlandırılmasına rağmen görünen interpolasyon kodunda `griddata(method="linear")` kullanılmaktadır. Results bölümünde Listing 7 için %20 withheld-point doğrulama ve yaklaşık 0,38 EF RMSE raporlanmakta, ancak bu doğrulama döngüsü yayımlanmış Listing 7'nin görünen kod satırlarında bulunmamaktadır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir