


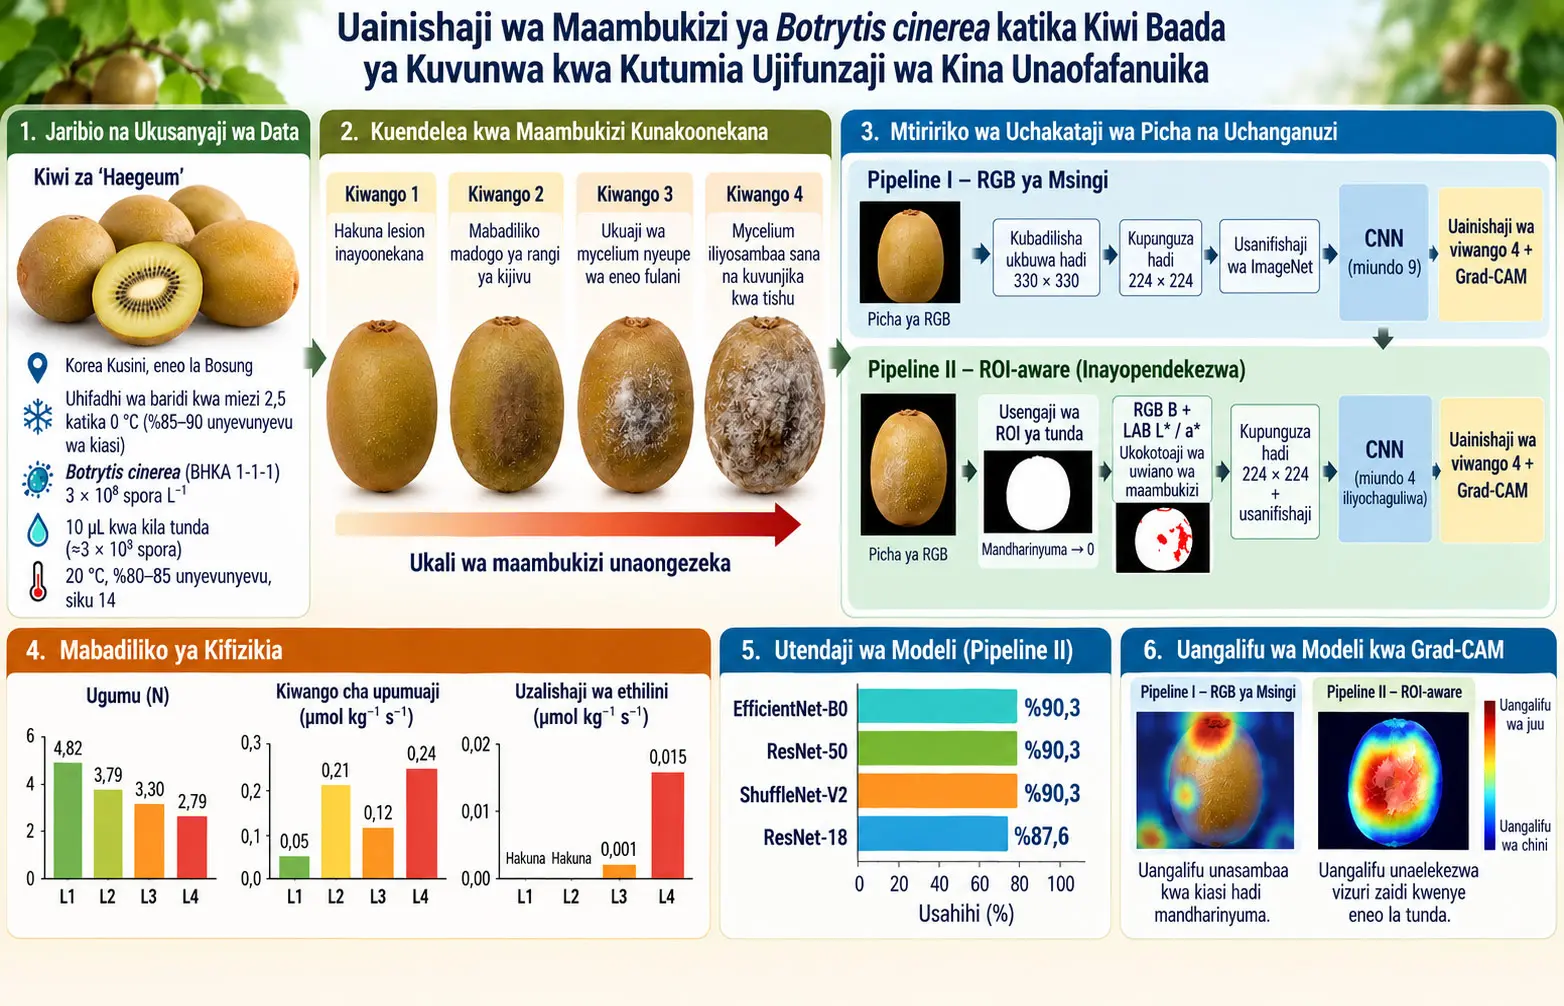
Mfumo wa deep learning unaoelezeka wa ROI-aware, ni mbinu inayotegemea picha ambayo katika picha za RGB kwanza hutenga eneo la kuvutiwa ambamo kiwi ipo (Region of Interest, ROI), hukandamiza usuli na kisha kwa kutumia convolutional neural networks huainisha ukali unaoonekana wa maambukizi ya Botrytis cinerea katika viwango vinne. Utafiti huu umeunganisha picha za kawaida za RGB, preprocessing inayotegemea ROI, uwiano wa lesion uliokokotolewa kutoka sifa za rangi za RGB/LAB, architectures tisa za deep learning na uchambuzi wa explainability wa Grad-CAM ili kuainisha maendeleo yanayoonekana ya maambukizi ya gray mold katika kiwi za ‘Haegeum’ zenye nyama ya dhahabu. Pamoja na uainishaji wa picha, firmness ya tunda, respiratory rate na uzalishaji wa ethylene vilipimwa ili kutathmini pia mabadiliko ya kifiziolojia yanayoambatana na viwango vinavyoonekana vya maambukizi.
Jumla ya kiwi 240 za ‘Haegeum’ B. cinerea ziliingizwa maambukizi, zikachunguzwa katika pointi nane za muda katika kipindi cha incubation cha siku 14 na kila tunda likapigwa picha kutoka pembe sita. Mchakato huu ulizalisha picha ghafi 1.440 za RGB; baada ya ukaguzi wa ubora wa picha, picha 959 zilibaki katika uchambuzi wa deep learning. Viwango vya maambukizi viliamuliwa kwa mwonekano wa nje pekee: Level 1 kutokuwepo kwa lesion inayoonekana, Level 2 mabadiliko mepesi ya rangi ya kijivu, Level 3 ukuaji wa mycelium nyeupe wa eneo maalumu na Level 4 ukuaji mkubwa wa mycelium pamoja na kuvunjika kwa tishu.
Uainishaji wa kifiziolojia ulionyesha kuwa kadiri ugonjwa unaoonekana ulivyoendelea, firmness ya tunda ilipungua kutoka 4,82 N hadi 2,79 N. Respiratory rate katika Level 1 ilikuwa 0,05 µmol kg−1 s−1 wakati katika Level 4 ilifikia 0,24 µmol kg−1 s−1. Ethylene haikugunduliwa katika Level 1 na 2, ilitokea katika Level 3 kwa kiwango cha 0,001 µmol kg−1 s−1 na ikaongezeka katika Level 4 hadi 0,015 µmol kg−1 s−1. Uwiano wa maambukizi uliokokotolewa kutoka kwenye picha uliongezeka kwa nambari kutoka %0,13 hadi %4,50.
Chini ya ROI-aware Pipeline II, EfficientNet-B0, ResNet-50 na ShuffleNet-V2 zilipata accuracy ya %90,3, huku ResNet-18 ikipata %87,6. Athari iliyo thabiti zaidi ya Pipeline II ilikuwa kuhamisha activation ya Grad-CAM kutoka maeneo ya usuli yaliyo nje ya tunda katika architectures zote zilizochaguliwa za CNN. Hata hivyo, metric ya Drop@20% Δ inayotegemea deletion haikuboreka katika mwelekeo mmoja kwa models zote. Kwa hiyo utafiti unaunga mkono kwamba preprocessing inayotegemea ROI huzuia umakini wa model kwenye eneo la tunda kwa ufanisi zaidi, lakini hautafsiri picha za Grad-CAM kama maelezo yanayothibitisha eneo la kisababishi la maambukizi.
Kikomo muhimu zaidi cha tafsiri ni kwamba haijaonyeshwa kuwa model inaweza kutambua kwa kweli maambukizi yaliyofichika au yasiyo na dalili ya B. cinerea. Matunda ya Level 1 pia yaliingizwa B. cinerea; hayakuonyesha tu lesion inayoonekana wakati wa kupigwa picha. Aidha, hakuna kundi huru la udhibiti la matunda yenye afya yaliyofanyiwa mock-inoculation. Kwa hiyo utafiti unatoa ushahidi hasa kwa uainishaji wa maendeleo yanayoonekana ya maambukizi chini ya hali za upigaji picha zilizodhibitiwa.
Maelezo ya Kina
Tatizo la utafiti
‘Haegeum’ ni aina ya kiwi ya Actinidia chinensis var. chinensis yenye nyama ya njano na umuhimu wa kibiashara nchini Korea Kusini. Kiwi ni tunda la climacteric; uzalishaji wa ethylene na respiratory activity unaweza kuongezeka wakati wa kukomaa. Katika kipindi baada ya mavuno, kulainika na kukomaa kwa tunda kunaweza kuendelea sambamba na uharibifu unaosababishwa na fangasi.
Botrytis cinerea ni fangasi wa phytopathogenic unaosababisha ugonjwa wa gray mold. Unaweza kuwa katika hali ya latent wakati wa mavuno na kuendelea kukua wakati wa kuhifadhi au kusambaza, ukisababisha mabadiliko ya rangi, uundaji wa mycelium, kulainika na kuvunjika kwa tishu za tunda.
Ukaguzi wa kawaida wa kuona ni wa vitendo, lakini hutegemea tafsiri ya mtu anayefanya tathmini. Mbinu za maabara zinaweza kutoa vipimo vya kina zaidi, lakini zinaweza kuwa na mipaka kwa uainishaji wa haraka wa kibiashara. Kwa hiyo watafiti walilenga kutengeneza mfumo unaoweza kuweka daraja kiotomatiki maendeleo ya maambukizi yanayoonekana kutoka picha za kawaida za RGB na wakati huohuo kuruhusu kuchunguzwa kwa maeneo ya picha ambayo model inazingatia.
Viwango vya Maambukizi Viliamuliwaje?
Viwango vinne vya maambukizi katika utafiti havikupewa kwa kutumia AI, firmness ya tunda, respiratory rate, uzalishaji wa ethylene au uwiano wa maambukizi uliokokotolewa kutoka picha, bali kwa dalili zinazoonekana kutoka nje pekee; vipimo vya kifiziolojia na uwiano wa maambukizi vilitumiwa baada ya kuunda madaraja haya ya kuona ili kuelezea sifa za kibaolojia na zinazohusiana na lesion katika kila kiwango.
| Kiwango | Kigezo cha mwonekano wa nje | Kikomo muhimu cha tafsiri |
|---|---|---|
| Level 1 | Hakuna lesion inayoonekana | Tunda limeingizwa maambukizi; si udhibiti wenye afya wa mock-inoculation. |
| Level 2 | Mabadiliko mepesi ya rangi ya kijivu | Dalili za mapema zinazoonekana zinaweza kuchanganyika na tofauti za asili za rangi ya uso. |
| Level 3 | Ukuaji wa mycelium nyeupe katika eneo maalumu | Ni hatua ya maambukizi iliyoendelea na inayoonekana. |
| Level 4 | Ukuaji mkubwa wa mycelium na kuvunjika kwa tishu | Ni hatua kali ya maambukizi na inayoonekana wazi. |
Kwa nini Level 1 haipaswi kuitwa “tunda lenye afya”?
Kwa sababu katika jaribio hakuna kundi tofauti la mock control ambalo halikupewa spore. Matunda ya Level 1 pia B. cinerea yaliingizwa kwa spore suspension, lakini hayakuendeleza lesion inayoonekana kwa nje wakati wa kupigwa picha. Hivyo Level 1 na tunda halisi lenye afya ambalo halijawahi kuingizwa maambukizi si kundi moja la kisayansi.
Je, Model Inagundua Maambukizi Yasiyo na Dalili ya Botrytis cinerea?
Utafiti huu hauonyeshi kuwa model inaweza kugundua kwa uhakika maambukizi halisi yasiyo na dalili au ya pre-symptomatic ya Botrytis cinerea; labels za madaraja zinategemea dalili zinazoonekana, hakuna udhibiti huru wenye afya, na waandishi wanasisitiza kwamba hasa maambukizi ya mapema/yasiyo na dalili yanapaswa kuthibitishwa baadaye kwa matunda ya asili na yaliyofanyiwa mock-inoculation.
Matunda ya ‘Haegeum’ yaliandaliwaje?
Kiwi za ‘Haegeum’ zilivunwa siku 160 baada ya full bloom kutoka bustani ya kibiashara katika eneo la Bosung, jimbo la Jeollanam-do nchini Korea Kusini. Matunda yalichaguliwa yawe na ukubwa unaofanana na bila kasoro zinazoonekana, yakavunwa kwa mkono asubuhi na kupelekwa moja kwa moja maabara.
Ili kupunguza tofauti za awali za kifiziolojia na kuiga uhifadhi wa muda mrefu wa kibiashara kwenye baridi, matunda kabla ya inoculation yalihifadhiwa kwa 0 °C na relative humidity ya %85–90 kwa miezi 2,5 katika cold storage.
Uingizaji wa Botrytis cinerea
Katika utafiti ilitumika strain ya B. cinerea BHKA 1-1-1 iliyotengwa kutoka kiwi ya ‘Haegeum’. Fangasi ilikuzwa kwenye potato dextrose agar kwa wiki nne katika 25 °C ili kupata culture yenye spore zilizokomaa.
Spore suspension iliandaliwa katika sterile distilled water na kurekebishwa kwa kutumia hemocytometer hadi 3 × 10⁸ spora L−1. Tone la 10 µL liliwekwa kwenye stylar end ya kila tunda bila kuunda jeraha. Kwa mujibu wa chanzo, tone hili lina takriban 3 × 10³ spora.
Matunda yaliyoingizwa maambukizi yaliwekwa incubation kwa siku 14 katika 20 °C, relative humidity ya %80–85 na gizani.
Pointi za muda na idadi ya picha
Jumla ya matunda 240 yaligawanywa katika nyakati nane za sampling: siku 0, 2, 4, 6, 8, 10, 12 na 14 baada ya inoculation. Matunda 30 yalitathminiwa katika kila pointi ya muda.
Kwa kila tunda zilichukuliwa sehemu ya juu, chini na views nne za pembeni zenye nafasi sawa, jumla ya picha sita za RGB zenye resolution ya juu. Hivyo mwanzoni zilipatikana picha ghafi 1.440 za RGB. Baada ya ukaguzi wa ubora wa picha, picha 959 zilibaki kwa training na evaluation ya model.
| Kiwango | Idadi ya picha | Hali ndani ya jumla |
|---|---|---|
| Level 1 | 259 | Daraja la ukubwa wa kati |
| Level 2 | 447 | Daraja kubwa zaidi |
| Level 3 | 158 | Daraja dogo zaidi |
| Level 4 | 95 | Daraja ndogo zaidi |
| Jumla | 959 | Madaraja hayana uwiano sawa |
Kwa sababu ya class imbalance hii, watafiti walitumia metrics kama macro-average precision, recall, F1 na AUC katika evaluation. Class-weighted loss au resampling haikutumiwa wakati wa training.
Jukumu la vipimo vya kifiziolojia
Vipimo vya kifiziolojia havikutumiwa kutengeneza class labels za model. Matunda kwanza yalipewa Level 1–4 kulingana na dalili za nje, kisha mabadiliko ya kibaolojia yanayoambatana na viwango hivi vinavyoonekana yalielezwa kupitia firmness, respiration na ethylene.
Firmness ya tunda ilipimwaje?
Firmness ilipimwa kwa Newton (N) kwenye kifaa cha CT-3 texture analyzer kwa kutumia probe bapa ya 4 mm. Kwenye pande mbili zinazokabiliana katika sehemu ya equator ya kila tunda, compression depth ya 4 mm na speed ya 1 mm s−1 zilitumika.
Kwa kila kiwango kinachoonekana cha maambukizi, biological replicates 15 zilitathminiwa na matokeo yakaripotiwa kama mean ± standard error (SE).
Respiratory rate na ethylene zilipimwaje?
Kiwi mbili ziliwekwa kwenye chombo cha plastiki kisichopitisha hewa cha 1 L na kuhifadhiwa kwa saa mbili katika 25 °C. Gesi 1 mL ilichukuliwa kutoka headspace na kudungwa kwenye mfumo wa gas chromatography wa YL 6400.
Kwa ethylene ilitumika flame ionization detector, na kwa CO2 ilitumika thermal conductivity detector. Mfumo ulitumia column ya Porapak N 80/100 na helium carrier gas katika flow rate ya 18 mL min−1. Injector na oven ziliwekwa katika 50 °C, thermal conductivity detector katika 200 °C na flame ionization detector katika 250 °C.
Kwa kila kiwango cha maambukizi kuna biological replicates tano. Kwa kuwa kila replicate ni chombo chenye matunda mawili, jumla ya matunda 10 yalitumika kwa kila kiwango katika vipimo vya gesi.
| Kiwango | Firmness (N) | Respiratory rate (µmol kg−1 s−1) | Ethylene (µmol kg−1 s−1) | Uwiano wa maambukizi (%) |
|---|---|---|---|---|
| Level 1 | 4,82 ± 0,24 | 0,05 ± 0,01 | Haikugunduliwa | 0,13 ± 0,00 |
| Level 2 | 3,79 ± 0,12 | 0,21 ± 0,01 | Haikugunduliwa | 0,33 ± 0,00 |
| Level 3 | 3,30 ± 0,07 | 0,12 ± 0,01 | 0,001 ± 0,001 | 0,94 ± 0,01 |
| Level 4 | 2,79 ± 0,13 | 0,24 ± 0,02 | 0,015 ± 0,002 | 4,50 ± 3,06 |
Katika chanzo herufi tofauti za superscript zinaonyesha tofauti yenye significance katika kiwango cha p<0,05 kwenye Tukey HSD test. Kwa firmness, viwango vyote vinne vilitofautiana. Kwa respiratory rate, Level 2 na Level 4 ziko katika kundi moja la kitakwimu; Level 3 iko chini yao, na Level 1 iko kiwango cha chini zaidi. Ethylene haikugunduliwa katika Level 1 na 2, huku Level 3 na Level 4 zikitofautiana kwa significance.
Katika uwiano wa maambukizi, Level 1, 2 na 3 zina herufi moja ya kitakwimu; yaani, licha ya ongezeko la namba, hakuna tofauti yenye significance iliyoonyeshwa kati ya viwango hivi vitatu kwa mujibu wa Tukey comparison katika jedwali la chanzo. Level 4, hata hivyo, ilitofautiana kwa significance na viwango vitatu vya kwanza.
ROI-Aware Pipeline II Inabadilisha Nini?
Pipeline II huongeza automatic fruit ROI segmentation na kuweka background pixels kuwa zero kwenye mkondo wa msingi wa RGB classification, hivyo kuzuia CNN input na Grad-CAM analysis kwenye eneo la tunda; pia hukokotoa rule-based infection ratio kutoka RGB blue na LAB L* na a* channels, lakini CNN classification input bado ni picha ya RGB na ratio hii haitumiki kufafanua class labels.
Pipeline I: mbinu ya msingi ya RGB
Pipeline I imefafanuliwa katika chanzo kama baseline RGB pipeline. Picha ghafi za RGB kwanza zilibadilishwa ukubwa hadi 330 × 330 pixels, kisha zikakatwa katikati hadi 224 × 224 pixels na normalized kwa kutumia ImageNet mean na standard deviation.
Katika mbinu hii background haikuondolewa kwa segmentation tofauti. Kwa hiyo kingo za tray, vivuli, reflections na vipengele vingine vya picha vinaweza kubaki kwenye field of view ya CNN.
Pipeline II: mbinu ya ROI-aware
Katika Pipeline II eneo la tunda lilibainishwa kwa automatic segmentation. Kwanza threshold-based foreground separation ilifanywa, ikafuatiwa na morphological refinement, na largest connected component ikafafanuliwa kama fruit ROI.
Pixels zilizo nje ya ROI zilimaskiwa kuwa zero. Kisha resize, center crop na ImageNet normalization zilezile zilitumika. Hivyo tofauti ya kimfumo kati ya pipeline mbili ni ROI-based background suppression na extraction ya infection ratio katika Pipeline II.
Kwa nini RGB na LAB color spaces zilitumika pamoja?
Katika picha za RGB, channel B ni blue, yaani inawakilisha intensity ya channel ya bluu. Katika LAB color space, L* inawakilisha perceptual lightness na a* inawakilisha component ya rangi katika mwelekeo wa red-green. Watafiti waliunganisha RGB B channel na LAB L* na a* values ili kutenganisha vizuri zaidi darkening ya rangi, upotevu wa rangi na mabadiliko ya uso katika lesions zinazoonekana.
Threshold hizi ziliamuliwa kwa majaribio kwenye representative images chini ya standardized lighting na baadaye zikawekwa constant kwa sampuli zote. Kwa hiyo utafiti huu haujathibitisha kuwa threshold hizi zitatoa performance ileile kwa kamera nyingine, lighting nyingine, season nyingine ya mavuno au population nyingine ya matunda.
Kanuni za pixel classification
| Sharti | Pixel class |
|---|---|
| B > 170 | Imeambukizwa |
| 130 < B < 170 na L* > 210 au a* < 120 | Imeambukizwa |
| 130 < B < 170 na 120 < a* < 130 | Inashukiwa |
| Pixels nyingine ndani ya 130 < B < 170 ambazo hazitimizi masharti yaliyo juu | Yenye afya |
| B < 130 | Yenye afya |
Maandishi ya chanzo hayaelezi tofauti kuhusu mipaka ya usawa B=130 au B=170; kwa hiyo hakuna rule ya mpaka isiyopo kwenye chanzo iliyoongezwa hapa.
Equation 1: uwiano wa maambukizi kutoka picha
\[ \text{Enfeksiyon oranı (\%)}= \frac{N_{\text{infected pixels}}} {N_{\text{fruit ROI pixels}}}\times100 \]
Ninfected pixels, ni idadi ya pixels ndani ya ROI zilizoainishwa kama “infected” kwa rule-based thresholds. Nfruit ROI pixels, ni jumla ya pixels katika fruit ROI iliyobainishwa kwa segmentation.
Matokeo ni image-derived descriptor inayowakilisha lesion burden kwa asilimia. Pixels za “suspected” si category ileile na infected pixels zinazojumuishwa kwenye numerator.
Kikomo muhimu zaidi ni kwamba ratio hii si independent ground-truth segmentation metric iliyothibitishwa dhidi ya lesion mask iliyochorwa kwa mkono na mtaalamu. Watafiti pia wanaeleza kuwa uthibitishaji kwa manual lesion annotations unahitajika siku zijazo.
Deep learning architectures
Katika screening ya kwanza architectures tisa zilitathminiwa:
- ResNet-18
- ResNet-50
- EfficientNet-B0
- ShuffleNet-V2
- MobileNet-V2
- MNASNet1_0
- GoogLeNet
- ViT-Base
- ViT-Large
Baada ya screening ya kwanza, ResNet-18, ResNet-50, EfficientNet-B0 na ShuffleNet-V2, ambazo zilikuwa na performance ya juu na yenye balance zaidi kati ya classes, zilichaguliwa kwa paired Pipeline I–Pipeline II comparison iliyofuata.
Transfer learning na training settings
Models zote zilianzishwa na weights zilizopretrainiwa kwenye ImageNet na zikafanyiwa fine-tuning kwenye kiwi dataset. Classification head ya awali iliondolewa na kubadilishwa na fully connected output layer inayotoa viwango vinne vya maambukizi.
| Kigezo | Thamani |
|---|---|
| Optimizer | Stochastic Gradient Descent (SGD) |
| Initial learning rate | 0,05 |
| Momentum | 0,9 |
| Weight decay | 1 × 10⁻⁴ |
| Learning-rate warm-up | Epoch 5 za kwanza, linear |
| Jumla ya training | 30 epoch |
| Train / validation / test | %70 / %15 / %15 |
| Independent repeat | 3 random fruit-level splits |
| Augmentation | Random horizontal flip |
| Class weighting / resampling | Haikutumika |
Katika kila split, checkpoint yenye validation accuracy ya juu zaidi ilitumika kwa final test evaluation.
Udhibiti wa data leakage: Picha sita tofauti za tunda moja hazikugawanywa katika train/validation/test sets tofauti kama samples huru. Picha zote za tunda moja ziliwekwa ndani ya subset moja. Design hii ni muhimu ili kuzuia ongezeko la bandia la performance linaloweza kutokea kwa kuona pembe tofauti za tunda moja la kimwili wakati wa training na test.
Training details ambazo hazijaripotiwa katika chanzo: Makala haielezi wazi batch size, jina kamili la loss function, random seed values au processor/GPU model ya training/inference hardware. Verianla haijajaza taarifa hizi.
Kwa nini augmentation ilidhibitiwa?
Watafiti wanaeleza kuwa classification inategemea mabadiliko mepesi ya rangi ya kijivu, local mycelium, surface texture na mabadiliko madogo ya RGB/LAB color information. Kwa sababu strong geometric au color-based augmentation inaweza kubadilisha bandia dalili hizi za kibaolojia, training augmentation ilidhibitiwa kuwa random horizontal flip pekee.
Kwa upande mwingine, utafiti pia unajadili kama limitation kwamba data diversity iliyobaki kuwa ndogo inaweza kupunguza robustness ya model hasa katika imaging conditions mpya.
Grad-CAM Inaonyesha Nini na Haithibitishi Nini Katika Utafiti Huu?
Grad-CAM ilitumika kuonyesha kwa colored saliency distributions ni maeneo gani ya picha yanachangia zaidi uamuzi wa CNN; ROI-aware Pipeline II ilikusanya activation zaidi ndani ya eneo la tunda, lakini chanzo kinasema wazi kuwa spatial overlap hii haithibitishi kwa uhakika eneo halisi la kisababishi la maambukizi wala usahihi wa maelezo ya model.
Grad-CAM ni nini?
Gradient-weighted Class Activation Mapping (Grad-CAM), ni post hoc explainability technique inayojaribu kuonyesha ni spatial regions zipi za high-level feature maps za CNN zina athari zaidi katika prediction ya class maalumu. Utafiti haurudii basic derivation equation ya Grad-CAM; badala yake unatathmini spatial relationship kati ya activation maps zinazozalishwa na ROI kwa kutumia metrics zilizofafanuliwa tofauti.
Equation 2: Accuracy
\[ \mathrm{Accuracy}= \frac{\sum_{c=1}^{C}TP_c}{N} \]
TPc, idadi ya true positive predictions katika class c; C ni idadi ya classes, na katika utafiti huu C=4. N, ni jumla ya picha zilizotathminiwa.
Accuracy ni uwiano wa classifications zote sahihi dhidi ya samples zote. Hata hivyo, wakati classes hazina balance, accuracy peke yake inaweza kutoweza kuonyesha performance katika classes ndogo vya kutosha.
Equation 3: Precision
\[ \mathrm{Precision}_c= \frac{TP_c}{TP_c+FP_c} \]
FPc, ni false positive samples ambazo kwa kweli ni za class nyingine lakini zimetabiriwa kuwa class c. Precision inaonyesha, model inaposema “picha hii ni class c”, ni sehemu gani ya maamuzi hayo iliyo sahihi.
Equation 4: Recall
\[ \mathrm{Recall}_c= \frac{TP_c}{TP_c+FN_c} \]
FNc, ni false negative samples ambazo kwa kweli ni za class c lakini model imezituma class nyingine. Recall au sensitivity inaonyesha ni sehemu gani ya samples halisi za class c zilizogunduliwa.
Equation 5: F1-score
\[ F1_c= \frac{2\times\mathrm{Precision}_c\times\mathrm{Recall}_c} {\mathrm{Precision}_c+\mathrm{Recall}_c} \]
F1-score ni harmonic mean ya precision na recall. Metric hii haioni kuwa inatosha metric moja tu kati ya hizo mbili kuwa juu; huadhibu behavior isiyo balanced ya precision–recall.
Equation 6: Wastani wa macro
\[ \mathrm{Precision}_{macro}= \frac{1}{C}\sum_{c=1}^{C}\mathrm{Precision}_c \]
\[ \mathrm{Recall}_{macro}= \frac{1}{C}\sum_{c=1}^{C}\mathrm{Recall}_c \]
\[ F1_{macro}= \frac{1}{C}\sum_{c=1}^{C}F1_c \]
Katika macro average, kila moja ya classes nne ina weight sawa. Ingawa Level 2 ina picha 447 na Level 4 ina picha 95, katika macro metric Level 2 haipati weight zaidi kwa sababu tu ina samples nyingi.
Equation 7: Macro AUC
\[ AUC_{macro}= \frac{1}{C}\sum_{c=1}^{C}AUC_c \]
Katika multiclass problem, one-vs-rest ROC curve huundwa kwa kila class na AUC values husika hupewa average kwa weight sawa. AUC hutathmini separability ya classes bila kutegemea decision threshold moja maalumu.
Equation 8: Outside-ROI ratio
\[ \mathrm{Outside\text{-}ROI\ ratio(\%)}= \frac{\sum_{p\notin ROI}A(p)} {\sum_p A(p)}\times100 \]
A(p), ni CAM activation katika pixel p. Numerator ni jumla ya CAM activations zilizo nje ya fruit ROI; denominator ni jumla ya CAM activation katika picha nzima.
Ratio hii inapopungua, sehemu ndogo zaidi ya saliency ya model huhamia background. Katika Pipeline II value hii ilipungua kwa CNN zote nne zilizochaguliwa.
Equation 9: entropy ndani ya ROI
Kwanza CAM activation hunormalishwa ndani ya ROI:
\[ \widetilde{A}(p)= \frac{A(p)} {\sum_{q\in ROI}A(q)} \]
Kisha:
\[ \mathrm{Entropy}_{ROI} = -\sum_{p\in ROI} \widetilde{A}(p)\log\widetilde{A}(p) \]
Entropy hupima jinsi activation ilivyoenea au kukusanyika ndani ya ROI. Entropy ya chini inaendana na muundo ambao saliency imetawanyika kidogo na imekusanyika zaidi kispace. Chanzo hakielezi base ya logarithm tofauti.
Equation 10: CAM area ≥ 0.5
\[ \mathrm{CAM\ area}_{\geq0.5} = \frac{\left|\left\{p\in ROI:A(p)\geq0.5\right\}\right|} {|ROI|} \]
Numerator ni idadi ya ROI pixels zenye normalized CAM intensity ya angalau 0,5; denominator ni jumla ya ROI pixels. Hivyo relative size ya eneo lenye activation ya juu ndani ya ROI hukokotolewa.
Maelezo kuhusu uwasilishaji katika chanzo: Ingawa equation inafafanua value hii kama ratio ya 0–1, heading ya column katika Table 3 hutumia alama “%” na values zimetolewa kama decimals kama 0,17–0,77. Kwa kuwa chanzo hakielezi tofauti scale presentation hii, Verianla haibadilishi kimya kimya values kuwa percentages kama 17 au 77.
Equation 11: Drop@20% Δ
\[ P_{drop}(\cdot)= P_{original}-P_{masked} \]
\[ \mathrm{Drop@20\%\ }\Delta= P_{drop}(CAM)-P_{drop}(Random) \]
Katika kila test image, eneo la %20 ndani ya ROI ambalo Grad-CAM inalisisitiza zaidi hufunikwa na hupimwa ni kiasi gani prediction probability ya class sahihi inapungua. Mchakato huohuo hurudiwa kwa eneo la ROI la ukubwa sawa lililochaguliwa random.
Positive Drop@20% Δ inaonyesha kuwa kufunika eneo lililosisitizwa na CAM hupunguza model confidence zaidi kuliko kufunika eneo random. Hata hivyo, chanzo kinatafsiri metric hii si kama ushahidi wa mwisho wa causal explanation, bali kama complementary indicator kuhusu sensitivity ya model prediction.
Equation 12: FPS
\[ FPS= \frac{N_{images}} {T_{inference}} \]
Nimages, idadi ya picha zilizoainishwa wakati wa test; Tinference ni forward-pass time ya picha hizi kwa seconds.
Kadiri FPS inavyoongezeka, model inaweza kuchakata picha nyingi zaidi kwa sekunde chini ya hardware conditions zilezile. Hata hivyo, ingawa makala inaeleza kuwa FPS measurement ilifanywa chini ya hardware conditions zilezile, haitoi processor au GPU model iliyotumika. Kwa hiyo haiwezi kudhaniwa kuwa FPS value ileile itapatikana kwenye mfumo mwingine.
Mbinu na Matokeo ya Utafiti
Uchambuzi wa kitakwimu
Vipimo vya kifiziolojia na infection ratio iliyopatikana kutoka picha vilichambuliwa chini ya completely randomized design. One-way analysis of variance (one-way ANOVA), ikifuatiwa na Tukey honestly significant difference (HSD) multiple comparison test, ilitumika kwa firmness, respiration, ethylene na infection ratio.
Kiwango cha significance ni p<0,05. Uchambuzi wa kitakwimu ulifanywa kwa IBM SPSS Statistics 21.
Matokeo ya kifiziolojia na infection ratio yalitolewa kama mean ± standard error (SE). Model performance na CAM metrics zilizokokotolewa kutoka independent fruit-level splits tatu zilitolewa kama mean ± standard deviation (SD).
Chanzo hakiripoti inferential p-value test tofauti kati ya model metrics za Pipeline I na Pipeline II. Kwa hiyo tofauti za model performance hazijawekwa upya kama “statistically significant improvement”.
Matokeo ya classification ya architectures tisa
| Model | Pipeline | Accuracy (%) | Precision (%) | Recall (%) | F1-score (%) |
|---|---|---|---|---|---|
| EfficientNet-B0 | I | 69,0 | 59,8 | 59,3 | 56,6 |
| EfficientNet-B0 | II | 90,3 | 93,7 | 91,8 | 92,1 |
| GoogLeNet | I | 71,7 | 66,9 | 65,0 | 63,8 |
| GoogLeNet | II | 75,2 | 71,9 | 70,6 | 71,3 |
| MNASNet1_0 | I | 55,9 | 51,0 | 52,7 | 42,1 |
| MNASNet1_0 | II | 50,3 | 50,0 | 50,0 | 50,0 |
| MobileNet-V2 | I | 66,9 | 57,2 | 59,7 | 56,6 |
| MobileNet-V2 | II | 75,2 | 75,0 | 65,6 | 69,5 |
| ResNet-18 | I | 73,8 | 65,0 | 72,0 | 70,8 |
| ResNet-18 | II | 87,6 | 87,5 | 80,8 | 83,8 |
| ResNet-50 | I | 75,2 | 82,2 | 77,8 | 78,2 |
| ResNet-50 | II | 90,3 | 90,6 | 90,6 | 90,6 |
| ShuffleNet-V2 | I | 69,0 | 62,3 | 52,3 | 57,4 |
| ShuffleNet-V2 | II | 90,3 | 92,1 | 92,3 | 92,1 |
| ViT-Base | I | 72,4 | 65,6 | 64,5 | 62,1 |
| ViT-Base | II | 77,9 | 78,1 | 77,3 | 77,7 |
| ViT-Large | I | 71,7 | 74,4 | 74,1 | 74,4 |
| ViT-Large | II | 71,7 | 71,9 | 73,1 | 73,1 |
Katika Pipeline II, EfficientNet-B0, ResNet-50 na ShuffleNet-V2 zilishiriki accuracy ya juu zaidi: models zote tatu zilifikia %90,3. Hata hivyo, metrics nyingine hazikuwa sawa. EfficientNet-B0 ilikuwa na precision ya %93,7, recall ya %91,8 na F1 ya %92,1, huku ShuffleNet-V2 ikiwa na %92,1, %92,3 na %92,1 kwa mpangilio huo.
Ingawa ResNet-50 ni network ya kina zaidi, haikuzidi EfficientNet-B0 na ShuffleNet-V2 kwa accuracy. Matokeo haya yanaonyesha kuwa katika dataset hii, kuongeza network depth hakutoi moja kwa moja accuracy ya juu zaidi; lakini hayawezi kujumlishwa kwa image classification tasks zote.
MNASNet1_0 haikuboreka katika Pipeline II, na accuracy ilishuka kutoka %55,9 hadi %50,3. Hii inaonyesha wazi kuwa ROI-aware processing si universal method inayoboresha kila model bila kujali architecture.
Matokeo ya CNN na Vision Transformer yalitafsiriwaje?
Chanzo kinaripoti kwamba CNN-based models zilionyesha performance yenye nguvu zaidi kuliko ViT-Base na ViT-Large kwenye dataset hii. Waandishi wanajadili kuwa hii inaweza kuhusiana na lesions zinazoonekana kuwa na local color na texture structures, CNN kuwa na strong local inductive bias na dataset kuwa ndogo kiasi.
Maelezo haya ni tafsiri ya waandishi wa utafiti. Utafiti hauungi mkono hitimisho kwamba “CNN ni bora kuliko Vision Transformer katika kila agricultural image task”.
Ulinganisho wa Macro AUC
Katika CNN nne zilizochaguliwa, macro AUC iliongezeka kwa Pipeline II. Values zilizotolewa katika Table 3 ya chanzo ni hizi:
| Model | Pipeline I | Pipeline II |
|---|---|---|
| ResNet-18 | 94,89 ± 0,02 | 98,13 ± 0,02 |
| ResNet-50 | 93,08 ± 0,09 | 96,02 ± 0,02 |
| EfficientNet-B0 | 93,82 ± 0,07 | 95,50 ± 0,01 |
| ShuffleNet-V2 | 94,57 ± 0,02 | 96,55 ± 0,01 |
Katika ROC graph ya chanzo, ukubwa huohuo umeonyeshwa takriban kama 0,95 na 0,98 kwenye 0–1 AUC scale, wakati Table 3 imetoa values kama 94,89 na 98,13. Mawasilisho haya mawili yanaendana na percentage/decimal scale conversion; lakini kwa kuwa AUC column heading katika Table 3 haina alama wazi ya “%”, Verianla imehifadhi table values katika format ya chanzo.
Matokeo ya kiasi ya Grad-CAM
| Model | Pipeline | FPS | Outside-ROI ratio | ROI entropy | CAM area ≥0,5 | Drop@20% Δ |
|---|---|---|---|---|---|---|
| ResNet-18 | I | 16,66 ± 1,23 | 0,77 ± 0,08 | 13,39 ± 0,50 | 0,38 ± 0,49 | −0,08 ± 0,03 |
| ResNet-18 | II | 17,65 ± 0,68 | 0,59 ± 0,16 | 12,15 ± 0,78 | 0,17 ± 0,10 | −0,17 ± 0,11 |
| ResNet-50 | I | 11,44 ± 0,27 | 0,78 ± 0,05 | 13,66 ± 0,20 | 0,45 ± 0,38 | +0,10 ± 0,07 |
| ResNet-50 | II | 12,31 ± 0,06 | 0,48 ± 0,13 | 12,46 ± 0,77 | 0,25 ± 0,12 | +0,04 ± 0,03 |
| EfficientNet-B0 | I | 17,26 ± 1,06 | 0,71 ± 0,19 | 13,42 ± 0,41 | 0,52 ± 0,15 | +0,06 ± 0,02 |
| EfficientNet-B0 | II | 17,06 ± 0,26 | 0,32 ± 0,07 | 12,98 ± 0,21 | 0,45 ± 0,19 | −0,05 ± 0,01 |
| ShuffleNet-V2 | I | 21,48 ± 0,92 | 0,51 ± 0,03 | 13,84 ± 0,04 | 0,77 ± 0,04 | −0,04 ± 0,01 |
| ShuffleNet-V2 | II | 21,43 ± 0,30 | 0,26 ± 0,06 | 12,61 ± 0,25 | 0,19 ± 0,10 | +0,06 ± 0,03 |
Matokeo yaliyo thabiti zaidi yako kwenye outside-ROI ratio. Katika Pipeline II value hii ilipungua kwa models zote nne. ResNet-18 kutoka 0,77 hadi 0,59; ResNet-50 kutoka 0,78 hadi 0,48; EfficientNet-B0 kutoka 0,71 hadi 0,32; ShuffleNet-V2 kutoka 0,51 hadi 0,26. Hii inaunga mkono kwamba model activation ilizuiliwa zaidi kutoka background kuelekea eneo la tunda.
ROI entropy pia ilipungua katika architectures zote nne na high-intensity CAM area ikawa compact zaidi. Lakini Drop@20% Δ haikubadilika katika mwelekeo mmoja. ShuffleNet-V2 ilitoka negative hadi positive, ResNet-50 ilibaki positive lakini ikapungua; ResNet-18 ikawa negative zaidi na EfficientNet-B0 ikatoka positive hadi negative.
Kwa hiyo utafiti unaunga mkono kwa nguvu kwamba Pipeline II inafanya nafasi yake ya kispace umakini wa model uwe consistent zaidi; lakini hauungi mkono kwamba kila kipengele cha explainability na kila kipimo cha causal importance katika kila architecture kimeboreshwa kwa kiwango sawa.
Kasi ya inference
ShuffleNet-V2 ilitoa FPS ya juu zaidi katika pipeline zote mbili: 21,48 ± 0,92 FPS kwa Pipeline I na 21,43 ± 0,30 FPS kwa Pipeline II. ResNet-50 ilikuwa model ya polepole zaidi, ikiwa na 11,44 ± 0,27 na 12,31 ± 0,06 FPS kwa mpangilio huo.
Ingawa Pipeline II inaongeza ROI segmentation, haikuleta penalty kubwa katika inference throughput kwa CNN zilizochaguliwa. Hata hivyo, kwa kuwa makala haitoi hardware model iliyotumika, haiwezi kudhaniwa kwamba FPS values hizi zitapatikana moja kwa moja kwenye hardware nyingine.
Kwa nini viwango vya mapema ni vigumu zaidi?
Kwa mujibu wa class-based analysis ya chanzo, viwango vya maambukizi vilivyoendelea kama Level 3 na Level 4 vilitenganishwa kwa urahisi zaidi na CNN zenye performance nzuri. Sababu ni kwamba katika viwango hivi visual cues zenye nguvu kama mycelium growth, mabadiliko wazi ya rangi na tissue collapse huonekana.
Tofauti kati ya Level 1 na Level 2 ni ngumu zaidi. Level 1 ina matunda yaliyoingizwa maambukizi lakini hayana lesion inayoonekana, wakati Level 2 ina mabadiliko mepesi tu ya rangi ya kijivu. Natural fruit surface color, tofauti za lighting na dalili za mapema sana zinaweza kufanya mwonekano wa makundi haya mawili kuingiliana.
Waandishi pia wanaeleza kuwa kwa sababu advanced decay levels kama Level 3–4 tayari zinaonekana kwa urahisi kwa binadamu, practical value ya kuzipambanua kiotomatiki inapaswa kutafsiriwa kwa tahadhari. Lengo muhimu zaidi la baadaye ni kutenganisha kwa uhakika maambukizi ya mapema na yasiyo na dalili.
Uhusiano kati ya physiology na AI
Maendeleo yanayoonekana ya maambukizi yaliambatana na kulainika kwa tunda, mabadiliko ya respiratory activity na uzalishaji wa ethylene katika hatua ya kuchelewa. Grad-CAM activations pia katika samples nyingi zilionyesha spatial alignment na maeneo yenye mabadiliko ya rangi yanayoonekana, kulainika au mycelium.
Hata hivyo, uhusiano huu si direct physiological validation. CNN kuzingatia eneo fulani la picha hakuonyeshi kuwa eneo hilo linaendana moja kwa moja na ethylene concentration maalumu au respiratory rate fulani. Vipimo vya kifiziolojia vinatoa post hoc characterization katika kiwango cha level.
Maana ya matumizi ya mbinu ya RGB/LAB
Utafiti unajadili kwamba standard digital RGB images zinaweza kutoa imaging approach rahisi na yenye gharama ndogo kuliko hyperspectral systems. Hata hivyo, utafiti huu si jaribio linalolinganisha moja kwa moja mfumo wa RGB/LAB na hyperspectral katika samples zilezile kwa cost au performance.
Kwa hiyo haiwezi kuhitimishwa kwamba “mbinu ya RGB ni bora kuliko hyperspectral imaging”. Hitimisho finyu zaidi linaloungwa mkono na chanzo ni kwamba katika standardized controlled imaging environment, ROI-aware RGB/LAB approach ilitoa matokeo yenye manufaa katika kuainisha viwango vinavyoonekana vya maambukizi.
Matokeo yanayoungwa mkono na utafiti
- Katika kiwi ya ‘Haegeum’, maendeleo yanayoonekana ya maambukizi ya B. cinerea yaliambatana na kulainika kwa tunda, mabadiliko ya respiration na uzalishaji wa ethylene katika viwango vya juu.
- ROI-aware preprocessing ilipunguza background-derived Grad-CAM activation katika CNN models zilizochaguliwa.
- EfficientNet-B0, ResNet-50 na ShuffleNet-V2 zilipata %90,3 accuracy katika Pipeline II.
- ROI-aware approach haikutoa ongezeko sawa la performance katika architectures zote.
- Kutenganisha viwango vya mapema na vyepesi vinavyoonekana ni vigumu zaidi kuliko viwango vya maambukizi vilivyoendelea.
- ShuffleNet-V2 ilitoa inference speed ya juu zaidi kati ya models nne zilizochaguliwa pamoja na accuracy ya juu.
Matokeo ambayo utafiti hauungi mkono
- Haijaonyeshwa kuwa model inagundua kwa uhakika maambukizi halisi latent au yasiyo na dalili.
- Level 1 si udhibiti halisi wenye afya ambao haujaingizwa maambukizi.
- Infection ratio iliyokokotolewa kutoka picha haijathibitishwa kwa kujitegemea kama manual lesion ground-truth.
- Maeneo yanayoonyeshwa na Grad-CAM hayajathibitishwa kama biological causal focus ya maambukizi.
- Haijaonyeshwa kwamba Pipeline II inaboresha kila model na kila explainability metric.
- Haijaonyeshwa kuwa controlled laboratory performance itahifadhiwa vilevile katika bustani tofauti, seasons tofauti za mavuno, kamera tofauti au commercial packing lines.
- Utafiti huu si direct superiority experiment dhidi ya hyperspectral imaging.
Mapungufu makuu
Ukosefu wa mock control: Hakuna separate healthy non-inoculated group. Kwa hiyo Level 1 inapaswa kutafsiriwa tu kama “inoculated fruit without visible lesion”.
Controlled imaging: RGB/LAB thresholds ziliendelezwa chini ya standardized lighting. Thresholds zinahitaji kuthibitishwa upya katika mazingira ya nje, kamera tofauti, season tofauti ya mavuno au commercial facility conditions.
Lesion ground-truth:Image-derived infection ratio haijathibitishwa kwa kujitegemea dhidi ya manual expert lesion annotations.
Ukubwa na kutokuwiana kwa dataset: Kati ya picha 959, 447 ni Level 2 na 95 tu ni Level 4. Ingawa macro metrics husaidia kupunguza athari ya imbalance hii kwenye evaluation, datasets kubwa zaidi zinahitajika.
Augmentation yenye mipaka: Kutumia horizontal flip pekee huenda kumehifadhi biological color na lesion features lakini kukapunguza diversity ya imaging conditions.
Split tatu: Grad-CAM na model comparison metrics zimefupishwa kupitia independent fruit-level splits tatu pekee. Kwa hiyo waandishi wanatafsiri hasa saliency na deletion metrics kama complementary indicators za kuongoza.
Maelezo yaliyokosekana ya reproducibility: Batch size, jina wazi la loss function na inference hardware model iliyotumika havijaripotiwa.
Uthibitishaji wa maambukizi ya asili: Utafiti ulifanywa katika mazingira yaliyodhibitiwa kwa artificial inoculation. External validation haikufanywa katika naturally infected commercial fruits.
Mwelekeo wa tafiti zijazo
Waandishi wanapendekeza mbinu ithibitishwe dhidi ya manual lesion annotations, seasons tofauti za mavuno, hali tofauti za bustani, mazingira tofauti ya imaging na naturally infected fruits.
Hasa kuwa na mock-inoculated healthy fruits, naturally healthy fruits na naturally infected fruits katika dataset moja ni muhimu kutathmini tofauti kati ya Level 1, Level 2 na true pre-symptomatic infection.
Katika siku zijazo, kutumia augmentation methods zisizoharibu symptoms, datasets kubwa zaidi na commercial storage/distribution conditions ni muhimu kutathmini generalizability ya model.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: Physiological and image-based characterization of Botrytis cinerea infection progression in postharvest ‘Haegeum’ kiwifruit using interpretable deep learning
Kichwa cha uchapishaji kwa Kituruki: Uainishaji wa Kifiziolojia na unaotegemea Picha wa Maendeleo ya Maambukizi ya Botrytis cinerea katika Kiwi ya ‘Haegeum’ Baada ya Mavuno kwa Kutumia Deep Learning Inayoelezeka
Waandishi: Joonggon Kim, Sang-Yeon Kim, Kyeonglim Min, Chanyong Jeong, Ghiseok Kim, Eun Jin Lee.
Mchango sawa: Joonggon Kim na Sang-Yeon Kim wametajwa kama waandishi waliotoa mchango sawa.
Mwandishi wa mawasiliano: Eun Jin Lee.
Affiliation 1: Department of Agriculture, Forestry and Bioresources, College of Agriculture and Life Sciences, Seoul National University, Seoul, Republic of Korea.
Affiliation 2: Department of Biosystems Engineering, Seoul National University, Seoul, Republic of Korea.
Affiliation 3: Integrated Major in Global Smart Farm, Seoul National University, Seoul, Republic of Korea.
Affiliation 4: Research Institute of Agriculture and Life Sciences, Seoul National University, Seoul, Republic of Korea.
Affiliation 5: Department of Electrical and Computer Engineering, Seoul National University, Seoul, Republic of Korea.
Jarida: Frontiers in Plant Science.
Sehemu: Technical Advances in Plant Science.
Juzuu / makala no: Volume 17, Article 1894572.
DOI: 10.3389/fpls.2026.1894572.
Aina ya makala: Original Research.
Tarehe ya kuwasilisha: 29 Mei 2026.
Tarehe ya marekebisho: 2 Julai 2026.
Tarehe ya kukubaliwa: 6 Julai 2026.
Tarehe ya kuchapishwa: 27 Julai 2026.
Peer review: Ni chapisho lililopitiwa na wenzao. Katika rekodi rasmi ya Frontiers, editor ni Orly Enrique Apolo-Apolo; reviewers ni Mónica Pineda, Mahmoud Okasha na Jairo Camilo Quijano Pérez.
Leseni: Creative Commons Attribution License (CC BY). Matumizi, usambazaji na uzalishaji upya yanaruhusiwa kwa kutoa attribution inayofaa.
Aina ya utafiti: Utafiti wa majaribio unaounganisha controlled postharvest fruit inoculation experiment, physiological characterization na deep learning-based RGB image classification.
Nyenzo ya mimea: Kiwi ya ‘Haegeum’ yenye nyama ya dhahabu, Actinidia chinensis var. chinensis.
Pathogen: Botrytis cinerea, strain BHKA 1-1-1.
Sampuli ya jaribio: Matunda 240; pointi nane za muda; matunda 30 kwa kila pointi ya muda.
Inoculum: 3 × 10⁸ spora L−1; 10 µL kwa kila tunda, takriban 3 × 10³ spora.
Incubation: 20 °C, relative humidity %80–85, gizani, siku 14.
Imaging: RGB views sita kwa kila tunda; jumla picha ghafi 1.440, picha 959 baada ya quality control.
Model classes: Viwango vinne vinavyoonekana vya maambukizi.
Kikomo cha control: Hakuna separate mock-inoculated healthy fruit group. Level 1 ina matunda yaliyopewa spore lakini hayakuonyesha visible lesion.
Architectures zilizochunguzwa kwanza: ResNet-18, ResNet-50, EfficientNet-B0, ShuffleNet-V2, MobileNet-V2, MNASNet1_0, GoogLeNet, ViT-Base na ViT-Large.
Models zilizowekwa katika paired detailed comparison: ResNet-18, ResNet-50, EfficientNet-B0 na ShuffleNet-V2.
Transfer learning: ImageNet pretrained weights.
Optimizer: SGD; initial learning rate 0,05; momentum 0,9; weight decay 1 × 10⁻⁴.
Training: 30 epoch; epoch 5 za kwanza linear learning-rate warm-up.
Mgawanyo wa data: Fruit-level %70 train, %15 validation na %15 test; independent random splits tatu.
Augmentation: Random horizontal flipping. Class-weighted loss au resampling haikutumika.
Model details ambazo hazijaripotiwa wazi katika chanzo: Batch size, jina wazi la loss function, training/inference hardware model na random seed values.
Statistics: One-way ANOVA + Tukey HSD; p<0,05. IBM SPSS Statistics 21.
Uwasilishaji wa physiological data: Mean ± SE.
Uwasilishaji wa Model/CAM performance: Mean ± SD katika independent splits tatu.
Physiological sampling: Biological replicates 15 kwa kila level kwa firmness; biological replicates za containers tano kwa respiration na ethylene, kila container ikiwa na matunda mawili.
Matokeo kuu ya model: Katika Pipeline II, EfficientNet-B0, ResNet-50 na ShuffleNet-V2 %90,3 accuracy; ResNet-18 %87,6 accuracy.
Matokeo kuu ya explainability: ROI-aware preprocessing ilipunguza outside-ROI saliency ratio katika CNN zote nne zilizochaguliwa na kuzuia model activation zaidi ndani ya eneo la tunda. Uboreshaji wa Drop@20% Δ unategemea model.
Formulas: Chanzo kinatoa equations 12: infection ratio, accuracy, precision, recall, F1, macro averages, macro AUC, outside-ROI ratio, ROI entropy, CAM area ≥0,5, Drop@20% Δ na FPS.
Maelezo ya scale presentation ndani ya chanzo: ROC graphs zinaonyesha AUC katika 0–1 range, huku Table 3 ikitoa AUCmacro values katika format kama 94,89–98,13. Equation 10 inaonyesha CAM area kama ratio, lakini Table 3 heading ina percent sign. Verianla haijarescale kimya kimya presentations hizi kwa namna ambayo haipo katika chanzo.
Upatikanaji wa data: Imeelezwa kuwa original contributions za utafiti zipo ndani ya makala na Supplementary Material, na maswali ya ziada yanaweza kuelekezwa kwa corresponding author.
Ufadhili: Umefadhiliwa na Korea Institute of Planning and Evaluation for Technology in Food, Agriculture, and Forestry (IPET), Agriculture and Food Convergence Technologies Program for Research Manpower Development; Ministry of Agriculture, Food and Rural Affairs. Grant no: RS-2024-00398300.
Mgongano wa maslahi: Waandishi wametangaza kuwa utafiti ulifanywa bila mahusiano ya kibiashara au kifedha yanayoweza kuonekana kama potential conflict of interest.
Tamko la Generative AI: Waandishi wametaarifu kuwa hawakutumia generative AI katika kuandaa makala. Frontiers pia inaeleza kwamba alternative text za figures huenda ziliundwa kwa msaada wa AI na zikakaguliwa na waandishi pale ilipowezekana.
Michango ya waandishi: Joonggon Kim: Validation, Formal analysis, Methodology, Writing – original draft. Sang-Yeon Kim: Writing – original draft, Formal analysis, Methodology, Validation. Kyeonglim Min: Writing – review & editing, Methodology. Chanyong Jeong: Writing – review & editing, Methodology. Ghiseok Kim: Writing – review & editing, Methodology. Eun Jin Lee: Formal analysis, Writing – review & editing, Supervision, Methodology, Resources, Conceptualization, Funding acquisition, Validation.
Mapungufu makuu ya kimethodolojia: Kukosekana kwa separate healthy mock control; classes kutegemea visible symptoms; early/asymptomatic infection kutothibitishwa kwa kujitegemea; RGB/LAB thresholds kutegemea standardized lighting; infection ratio kutothibitishwa dhidi ya manual lesion annotation; image dataset ndogo na yenye imbalance; independent splits tatu pekee; augmentation yenye mipaka; kutokuwepo kwa natural infection na external field validation.
Picha za chanzo: Figure 1 ya chanzo inaonyesha hatua nne halisi za visible infection; Figure 2 mkondo wa mbinu wa Pipeline I na Pipeline II; Figure 3 multiclass ROC curves; Figure 4 tofauti ya Grad-CAM ya Pipeline I na II kwenye matunda yaleyale; Figure 5 Grad-CAM distributions katika CNN backbones nne.
Kikomo cha visual reconstruction: Picha za matunda za chanzo na Grad-CAM raster maps hazijaigwa kwa artificial images. Viwango vinavyoonekana vya maambukizi na method pipeline vimewasilishwa kwa independent SVG schematics zisizo na scale. Kwa kuwa raw ROC coordinates hazijatolewa kama jedwali katika chanzo, fake ROC points hazijaundwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *