


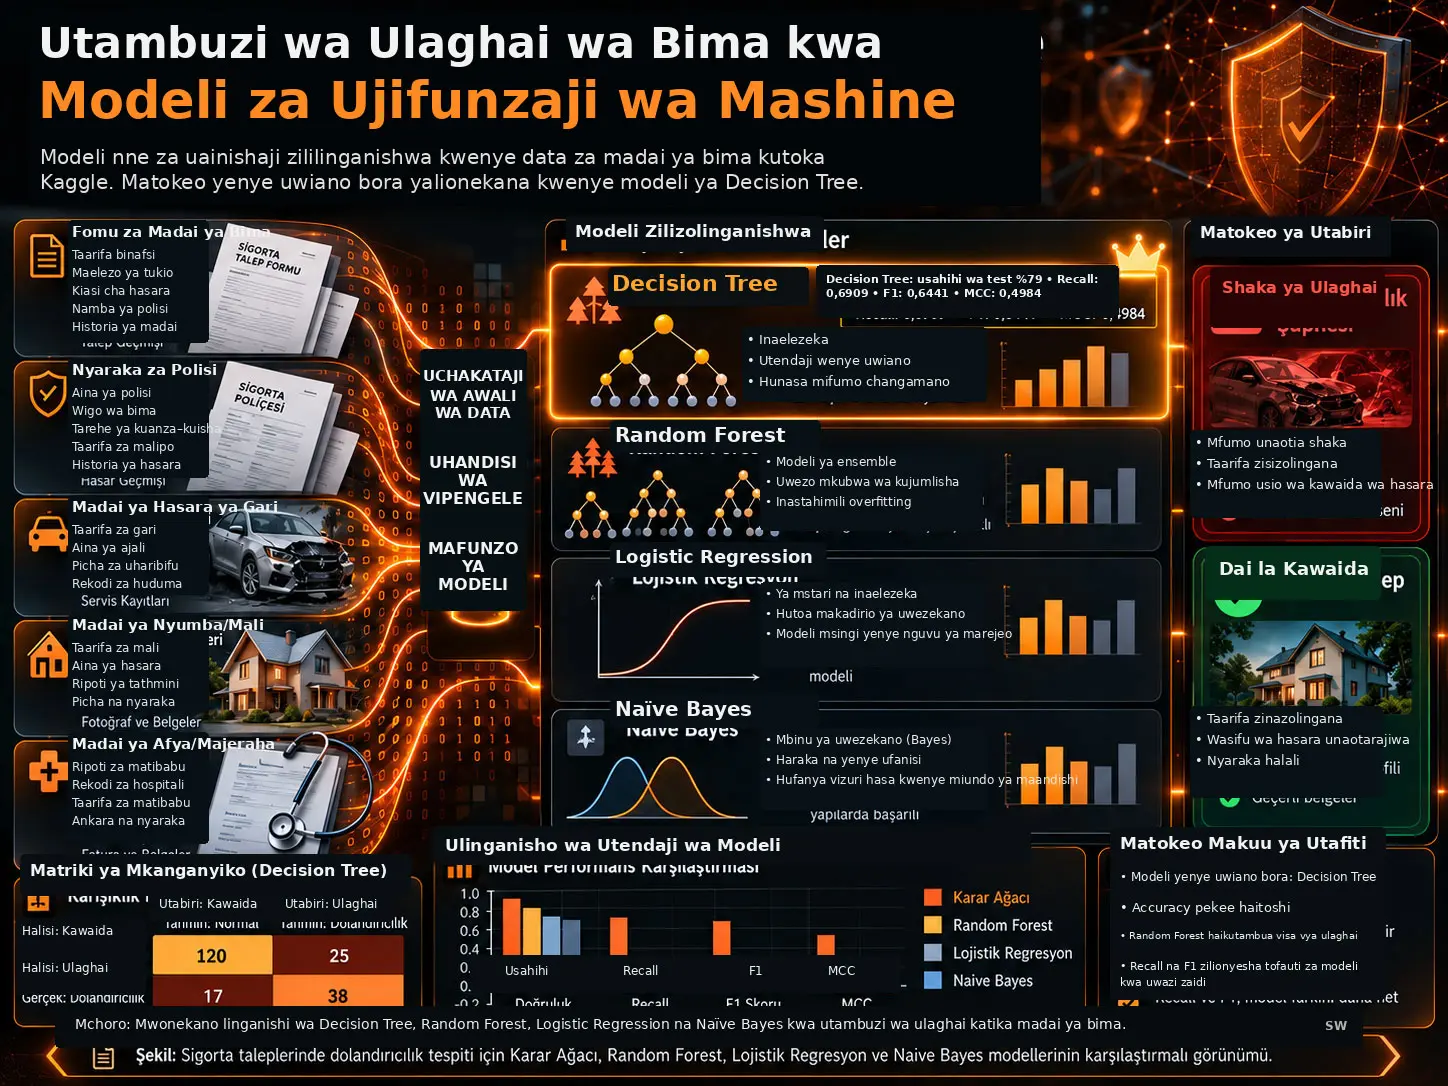
Utambuzi wa Ulaghai wa Bima Unaotegemea Ujifunzaji wa Mashine Unaosimamiwa, ni tatizo la uainishaji wa aina mbili linalolenga kujifunza mifumo kutoka kwa madai ya bima yaliyowahi kuwekewa lebo ya ulaghai au yasiyo ya ulaghai na kuainisha madai mapya katika mojawapo ya madarasa mawili. Praise Owusu Oteng na wenzake walilinganisha modeli za Decision Tree, Random Forest, Logistic Regression na Naïve Bayes kwenye seti ya data ya insurance.claims.csv iliyopatikana kupitia Kaggle. Usafishaji wa data unajumuisha kujaza thamani zinazokosekana, kuondoa baadhi ya vigezo vyenye cardinality kubwa au visivyohusika, ukaguzi wa multicollinearity, pamoja na hatua za ubadilishaji wa kategoria na scaling zilizotajwa katika muhtasari wa chanzo. Data iligawanywa kuwa %80 ya mafunzo na %20 ya majaribio; modeli zilitathminiwa kwa accuracy, precision, recall, F1-score na Matthews Correlation Coefficient (MCC). Decision Tree iliyorekebishwa ilitoa matokeo yenye uwiano bora zaidi kati ya modeli nne zilizochunguzwa, ikiwa na %79 test accuracy, 0,6032 precision, 0,6909 recall, 0,6441 F1-score na 0,4984 MCC.
Hitimisho muhimu zaidi la kielimu la utafiti ni kwamba, katika seti ya data yenye darasa la wachache kama ulaghai, thamani kubwa ya accuracy peke yake haimaanishi utambuzi mzuri wa ulaghai. Ingawa Random Forest ilitoa %72 accuracy kwenye data ya majaribio, haikuweza kutambua kwa usahihi hata rekodi moja kati ya 55 za darasa la ulaghai. Logistic Regression iliainisha kwa usahihi visa 3 tu vya ulaghai, na Naïve Bayes visa 2 tu. Decision Tree ilitambua kwa usahihi visa 38 kati ya visa hivyo hivyo 55. Kwa hiyo, tofauti kuu inayobainisha mpangilio wa modeli si usahihi wa jumla pekee, bali pia uwezo wa kutambua darasa la wachache la ulaghai na vipimo vya F1 na MCC vinavyozingatia makosa katika madarasa yote mawili kwa pamoja.
Matokeo yana mipaka ya seti moja ya data ya kihistoria iliyo wazi kwa umma na mgawanyo mmoja wa train/test. Chanzo hakiripoti maelezo ya hyperparameter tuning, mbinu za encoding/scaling zilizotumika, random seed, taarifa za stratification au matokeo ya cross-validation. Modeli hazijajaribiwa katika mfumo hai wa usimamizi wa madai wa kampuni halisi ya bima. Kwa hiyo, ubora wa Decision Tree kwenye seti hii ya data haumaanishi kwamba modeli hiyo lazima iwe bora zaidi katika seti zote za data za bima au katika shughuli halisi.
Tatizo la utafiti
Ulaghai wa bima ni tatizo pana linalojumuisha kuwasilisha madai yasiyo halali au yaliyobadilishwa kwa lengo la kupata manufaa ya kifedha kutoka kwa mtoa bima. Chanzo kinasisitiza kwamba tabia ya ulaghai inaweza kujitokeza katika maeneo mbalimbali kama bima ya afya, maisha, mali na magari, na kwamba ukaguzi wa kawaida wa mikono au mifumo ya sheria zisizobadilika inaweza kushindwa kunasa mifumo ya ulaghai inayobadilika.
Faida kuu ya ujifunzaji wa mashine katika utafiti huu ni uwezo wake wa kujifunza mifumo yenye vigezo vingi kutoka kwa rekodi za madai zilizo na lebo za awali na kutoa uainishaji wa kiotomatiki kuhusu uwezekano wa ulaghai kwa madai mapya. Hata hivyo, algoritimu ipi ni bora zaidi hutegemea mgawanyo wa data, vipengele, uwiano wa darasa la ulaghai na kipimo cha tathmini.
Maswali ya utafiti
Chanzo kinazingatia maswali matatu makuu: ujifunzaji wa mashine unaweza kutambua madai ya ulaghai kwa kiwango gani, ni ipi kati ya algoritimu nne zilizochunguzwa inayotoa uainishaji unaotegemewa zaidi, na matokeo ya ujifunzaji wa mashine yanaweza kusaidia mchakato wa uchunguzi wa ulaghai kwa njia zipi.
Seti ya data
Faili ya data iliyotumika katika utafiti insurance.claims.csv inaitwa hivyo na ilipatikana kupitia Kaggle. Chanzo kinaeleza muundo wa data kama seti ya data iliyopangwa ya madai ya bima yenye vigezo huru 40.
Makundi ya vigezo yanajumuisha:
- demografia ya mteja: taarifa kama umri, elimu na kazi,
- taarifa za sera: vipengele kama deductible na malipo ya kila mwaka,
- taarifa za tukio: aina ya tukio, ukali wa tukio na idadi ya magari,
- taarifa za madai: kiasi cha injury, property na vehicle claim,
- kigezo lengwa: fraud-reported = Y au N
vinapatikana.
Chanzo hakitoi ukubwa wa jumla wa sampuli kwa mstari mmoja wa “N = ...” katika sehemu ya Data Description. Hata hivyo, mgawanyo wa %80:%20 na kuonekana kwa rekodi 200 za majaribio katika confusion matrix zote kunaonyesha kwamba kiasi cha data kilichochambuliwa kinaendana na muundo wa rekodi 1.000. Table 3 ya chanzo pia inaripoti jumla ya rekodi 1.000 kwa Vehicle Claims.
Ushughulikiaji wa thamani zinazokosekana
| Kigezo | Idadi ya thamani zinazokosekana | Utaratibu uliotumika katika chanzo |
|---|---|---|
| collision-type | 178 | Kujaza kwa modi |
| property-damage | 360 | Kujaza kwa modi |
| authorities-contacted | 91 | Kujaza kwa modi |
| police-report-available | 343 | Kujaza kwa modi |
Mode imputation ni kuweka kategoria inayotokea mara nyingi zaidi katika kigezo husika badala ya rekodi zinazokosekana. Mbinu hii huhifadhi sampuli bila kufuta safu za data; hata hivyo, hakuna hakikisho kwamba inawakilisha mgawanyo halisi wa kategoria zilizokosekana.
Chanzo hakielezi wazi kama utaratibu wa imputation ulijifunzwa kwenye data ya mafunzo pekee kisha kutumika kwenye data ya majaribio, au kama ulihesabiwa kwenye data yote kabla ya mgawanyo wa train/test. Kwa hiyo, haiwezekani kuthibitisha kutoka kwenye chanzo jinsi pipeline ya preprocessing ilivyotekelezwa kuhusu uwezekano wa kuvuja kwa data.
Vigezo vilivyoondolewa
Chanzo kinaondoa policy-number, policy-bind-date, incident-date, policy-state, incident-state, incident-city, incident-location, insured.zip, insured-hobbies, auto-make, auto-model, auto-year na safu ya ziada iliyotokana na uumbizaji wa CSV kwa sababu ya manufaa yake madogo kwa uundaji wa modeli au cardinality kubwa.
Baadhi ya maamuzi haya yanalenga kupunguza ukubwa wa data na utata wa kategoria. Hata hivyo, haikujaribiwa kando kama vigezo vya tarehe na jiografia vina taarifa zinazoweza kuwa muhimu kwa ulaghai; katika utafiti vigezo hivi viliondolewa moja kwa moja kwenye modeli.
Ukaguzi wa multicollinearity
Katika uchambuzi wa correlation wa chanzo, kati ya months-as-customer na age kulipatikana 0,92 correlation chanya. Pia inaelezwa kwamba vipengele vya injury-claim, property-claim na vehicle-claim vina correlation kubwa na total-claim-amount. Kutokana na hilo, vipengele vya age na total-claim-amount viliondolewa kwenye seti ya uundaji wa modeli.
Chanzo kinaonyesha correlation heatmap ya pembetatu kwenye ukurasa wa 4. Jukumu la kisayansi la taswira hii ni kuonyesha kwamba baadhi ya vipengele vya nambari hurudia kwa kiwango kikubwa taarifa ileile; heatmap haipimi moja kwa moja utendaji wa modeli.
Pengo la kuripoti ubadilishaji wa kategoria na scaling
Sehemu ya abstract ya chanzo inaeleza kwamba data za kategoria zilibadilishwa kuwa muundo wa nambari na shughuli zinazofaa za scaling zilitumika. Hata hivyo, sehemu ya mbinu hairipoti jina la algoritimu ya encoding iliyotumika, jinsi viwango vya kategoria vilivyoshughulikiwa, au kama scaler maalumu kama StandardScaler au MinMaxScaler ilitumiwa.
Upungufu huu ni muhimu hasa kwa uwezo wa kurudia modeli kama Logistic Regression na Naïve Bayes ambazo zinaweza kuathiriwa na aina ya preprocessing.
Mgawanyo wa mafunzo na majaribio
Chanzo kiligawanya seti ya data kuwa %80 mafunzo na %20 majaribio. Cross-validation, validation set huru au seti ya data ya majaribio ya nje haijaripotiwa.
Pia haijaelezwa kama random seed ilitumika au kama uwiano wa fraud/non-fraud ulihifadhiwa kwa stratification wakati wa split. Kwa hiyo, haiwezi kubainishwa kutoka kwenye chanzo jinsi mpangilio wa modeli ulioonekana kwenye split moja ungekuwa thabiti katika mgawanyo mwingine.
Decision Tree inafanyaje kazi?
Decision Tree ni kiainishaji cha kihierarkia kinachogawanya seti ya data katika vikundi vidogo vilivyo sawa zaidi kwa kutegemea kipengele katika kila nodi, kisha kutoa uamuzi wa darasa katika nodi ya jani. Utafiti unatoa fomula za Gini impurity, entropy na information gain ili kueleza ubora wa mgawanyo.
\[ Gini(S)=1-\sum_{i=1}^{n}p_i^2 \]
\(p_i\), ndani ya nodi \(S\), ni uwiano wa darasa la \(i\). Katika nodi safi, uchunguzi wote wako katika darasa moja na Gini impurity hupungua.
\[ E(S)=-\sum_{i=1}^{n}p_i\log_2(p_i) \]
Entropy pia hupima mchanganyiko wa madarasa. Nodi iliyo sawa zaidi ina entropy ya chini.
Faida ya taarifa ya mgawanyo kulingana na kipengele \(A\):
\[ IG(S,A)=E(S)-\sum_{v\in Values(A)} \frac{|S_v|}{|S|}E(S_v) \]
inaonyeshwa hivyo. Information gain kubwa ina maana kwamba mgawanyo unapunguza zaidi kutokuwa na uhakika wa darasa.
Logistic Regression
Logistic Regression hubadilisha mchanganyiko wa mstari wa vipengele kuwa uwezekano wa kuwa katika darasa la ulaghai. Muundo wa logit unaotumiwa na chanzo ni:
\[ \ln\left(\frac{P(Y)}{1-P(Y)}\right) = \beta_0+\beta_1X_1+\beta_2X_2+\cdots+\beta_kX_k \]
na uwezekano unaolingana ni:
\[ P(Y)= \frac{e^{\beta_0+\beta_1X_1+\cdots+\beta_kX_k}} {1+e^{\beta_0+\beta_1X_1+\cdots+\beta_kX_k}} \]
inaonyeshwa hivyo. \(X_i\) inawakilisha vipengele vya ingizo, \(\beta_i\) ni coefficients za modeli, na \(P(Y)\) ni uwezekano uliotabiriwa wa darasa lengwa.
Random Forest
Random Forest ni mbinu ya ensemble inayounda idadi kubwa ya miti ya maamuzi kwenye sehemu ndogo tofauti za data na vipengele, kisha kuunganisha maamuzi ya uainishaji ya miti hiyo. Lengo ni kupunguza hatari ya mti mmoja kufaa kupita kiasi kwa sampuli maalumu za mafunzo.
Katika utafiti huu, Random Forest ilikosa kabisa darasa la ulaghai katika seti ya majaribio. Chanzo hakiripoti idadi ya miti iliyotumika, maximum depth, uwiano wa feature sampling, class-weight au hyperparameter nyingine za Random Forest.
Naïve Bayes
Modeli ya Naïve Bayes inategemea nadharia ya Bayes:
\[ P(C\mid X)=\frac{P(X\mid C)P(C)}{P(X)} \]
Chini ya dhana ya uhuru wa masharti:
\[ P(C\mid X)\propto P(C)\prod_{i=1}^{n}P(x_i\mid C) \]
hubadilika kuwa muundo huu. Hapa \(C\) inawakilisha darasa la ulaghai au lisilo la ulaghai, na \(X\) inawakilisha mkusanyiko wa vipengele vilivyoonekana. Dhana ya “Naïve” ni kwamba vipengele vinachukuliwa kuwa huru kwa masharti kutoka kwa kila kimoja pale darasa linapojulikana.
Kwa Nini Accuracy Pekee Haitoshi Katika Utambuzi wa Ulaghai wa Bima?
Kwa kuwa Accuracy hupima uwiano wa utabiri wote sahihi dhidi ya sampuli zote, modeli inayochagua kila mara darasa la wengi inaweza kuonekana kuwa na matokeo ya juu katika seti ya majaribio yenye darasa la wachache kama ulaghai; katika utafiti huu, rekodi 145 kati ya 200 za majaribio zilikuwa zisizo za ulaghai na 55 zilikuwa za ulaghai, na Random Forest ilitoa %72 test accuracy lakini haikutambua kwa usahihi hata kisa kimoja cha ulaghai. Kwa hiyo, recall, F1-score na MCC huonyesha kushindwa katika darasa la ulaghai kwa uwazi zaidi kuliko accuracy.
Matriki ya mkanganyiko
| Halisi / Utabiri | Ulaghai Uliotabiriwa | Isiyo Ulaghai Iliyotabiriwa |
|---|---|---|
| Ulaghai Halisi | Chanya ya Kweli (TP) | Hasi ya Uongo (FN) |
| Isiyo Ulaghai Halisi | Chanya ya Uongo (FP) | Hasi ya Kweli (TN) |
Chanya ya Kweli, ni kisa cha ulaghai kilichowekwa alama kwa usahihi kuwa ulaghai. Hasi ya Uongo, ni kisa cha ulaghai kilichokoswa na mfumo. Chanya ya Uongo, ni dai halisi lililowekwa alama kimakosa kuwa ulaghai; Hasi ya Kweli ni uainishaji sahihi wa rekodi isiyo ya ulaghai.
Accuracy
\[ Accuracy= \frac{TP+TN}{TP+TN+FP+FN} \]
Accuracy huonyesha usahihi wa jumla wa uainishaji lakini haizingatii mgawanyo wa madarasa.
Precision
\[ Precision=\frac{TP}{TP+FP} \]
Precision hupima ni madai mangapi kati ya yale ambayo modeli imesema ni ya ulaghai ambayo kwa kweli ni ya ulaghai.
Recall
\[ Recall=\frac{TP}{TP+FN} \]
Recall hupima ni visa vingapi vya ulaghai halisi vilivyotambuliwa na modeli. Katika muktadha wa fraud detection, recall ya chini humaanisha visa vingi vya ulaghai vimekosa kutambuliwa.
F1-score
\[ F1= 2\times \frac{Precision\times Recall} {Precision+Recall} \]
F1-score hufupisha uwiano kati ya precision na recall katika thamani moja.
Matthews Correlation Coefficient
\[ MCC= \frac{(TP\times TN)-(FP\times FN)} {\sqrt{(TP+FP)(TP+FN)(TN+FP)(TN+FN)}} \]
Kwa kuwa MCC hutumia seli zote nne za confusion-matrix kwa wakati mmoja, ni metriki muhimu ya muhtasari katika matatizo ya uainishaji wa aina mbili yenye madarasa yasiyowiana. Thamani kubwa chanya inaonyesha uainishaji wenye uthabiti zaidi, thamani karibu na sifuri inaonyesha uhusiano dhaifu, na thamani hasi inaonyesha utendaji wa mwelekeo kinyume kati ya utabiri na madarasa halisi.
Mbinu na Matokeo ya Utafiti
Ulinganisho wa utendaji wa modeli
| Modeli | Train Accuracy | Test Accuracy | Precision | Recall | F1-score | MCC |
|---|---|---|---|---|---|---|
| Decision Tree | 0,8225 | 0,7900 | 0,6032 | 0,6909 | 0,6441 | 0,4984 |
| Random Forest | 0,7887 | 0,7200 | 0,0000 | 0,0000 | 0,0000 | -0,0437 |
| Logistic Regression | 0,7512 | 0,6950 | 0,2500 | 0,0545 | 0,0896 | -0,0141 |
| Naïve Bayes | 0,7462 | 0,7000 | 0,2222 | 0,0364 | 0,0625 | -0,0257 |
Ni Modeli Gani ya Ujifunzaji wa Mashine Iliyoleta Matokeo Bora Zaidi Katika Utafiti Huu?
Chini ya seti moja ya data ya Kaggle iliyochunguzwa na mgawanyo wa %80:%20 train-test uliotumika, Decision Tree ndiyo modeli yenye uwiano bora zaidi; ikiwa na %79 test accuracy, 0,6909 recall, 0,6441 F1-score na 0,4984 MCC, ilitoa uainishaji wa ulaghai wenye nguvu zaidi kuliko modeli nyingine tatu. Matokeo haya yanatumika tu kwa data na mpangilio wa jaribio wa utafiti huu na hayaonyeshi kwamba Decision Tree ni modeli bora kwa ujumla katika seti zote za data za bima.
Matokeo ya Decision Tree
Chanzo kinaeleza kwamba modeli ya awali ya Decision Tree ilionyesha dalili ya overfitting kwa kuwa na %100 training accuracy na %71 test accuracy. Baada ya hyperparameter tuning, accuracy ya mafunzo ilishuka hadi %82,25 huku test accuracy ikipanda hadi %79.
Test confusion matrix:
| Matokeo ya Decision Tree | Idadi |
|---|---|
| Hasi ya Kweli | 120 |
| Chanya ya Uongo | 25 |
| Hasi ya Uongo | 17 |
| Chanya ya Kweli | 38 |
Decision Tree ilitambua visa 38 kati ya 55 vya ulaghai halisi na ikakosa 17. Chanzo kinatafsiri ukaribu mkubwa zaidi kati ya thamani za accuracy za mafunzo na majaribio baada ya tuning kama jambo chanya kwa generalization.
Hata hivyo, kwa kuwa vigezo vya tuning au utaratibu wa tuning haujaripotiwa, matokeo haya hayawezi kurudiwa kikamilifu na kwa kujitegemea.
Matokeo ya Random Forest
| Matokeo ya Random Forest | Idadi |
|---|---|
| Hasi ya Kweli | 144 |
| Chanya ya Uongo | 1 |
| Hasi ya Uongo | 55 |
| Chanya ya Kweli | 0 |
Ingawa Random Forest iliainisha kwa usahihi rekodi 144 kati ya 145 zisizo za ulaghai, ilikosa visa vyote 55 vya ulaghai. Matokeo yake ni kwamba thamani zote za precision, recall na F1-score ni sifuri.
Katika maandishi ya chanzo, Random Forest inaelezwa kwa kauli “perfect training accuracy”; hata hivyo, katika jedwali kuu la utendaji training accuracy imetolewa kuwa 0,7887. Kwa kuwa thamani hizi mbili hazilingani, maelezo ya Verianla yanategemea jedwali la wazi la nambari katika chanzo.
Matokeo ya Logistic Regression
| Matokeo ya Logistic Regression | Idadi |
|---|---|
| Hasi ya Kweli | 136 |
| Chanya ya Uongo | 9 |
| Hasi ya Uongo | 52 |
| Chanya ya Kweli | 3 |
Logistic Regression ilitoa %69,5 test accuracy; hata hivyo, ilitambua kwa usahihi visa 3 tu kati ya 55 vya ulaghai. Recall ni 0,0545, F1-score ni 0,0896 na MCC ni -0,0141. Kwa hiyo, accuracy ya jumla inaweza kuonyesha utendaji halisi katika darasa la ulaghai kuwa wenye nguvu zaidi kuliko ulivyo.
Matokeo ya Naïve Bayes
| Matokeo ya Naïve Bayes | Idadi |
|---|---|
| Hasi ya Kweli | 138 |
| Chanya ya Uongo | 7 |
| Hasi ya Uongo | 53 |
| Chanya ya Kweli | 2 |
Naïve Bayes ilitoa %70 test accuracy lakini ilitambua visa 2 tu vya ulaghai. Recall ni 0,0364 na MCC ni -0,0257. Matokeo haya pia yanaonyesha kwamba mafanikio katika majority class hayapaswi kuchanganywa na mafanikio ya utambuzi wa ulaghai.
Visa vya ulaghai vilivyotambuliwa na modeli
| Modeli | Ulaghai Halisi | Ulaghai Uliotambuliwa kwa Usahihi | Ulaghai Uliokoswa |
|---|---|---|---|
| Decision Tree | 55 | 38 | 17 |
| Random Forest | 55 | 0 | 55 |
| Logistic Regression | 55 | 3 | 52 |
| Naïve Bayes | 55 | 2 | 53 |
Jedwali hili linaonyesha tofauti ya kiutendaji kati ya modeli kwa uwazi zaidi kuliko jedwali la accuracy. Decision Tree inatambua sehemu kubwa ya visa vya ulaghai vya majaribio, huku modeli nyingine tatu zikionyesha upungufu mkubwa wa utendaji kwa darasa la wachache la ulaghai.
Jedwali la chanzo kuhusu aina za madai
| Kipengele cha dai | Jumla ya rekodi | Rekodi zilizoripotiwa kuwa ulaghai |
|---|---|---|
| Madai ya Majeraha | 975 | 238 |
| Madai ya Mali | 981 | 241 |
| Madai ya Magari | 1000 | 247 |
Chanzo kinaripoti nambari hizi chini ya Table 3. Hazipaswi kutafsiriwa kama sampuli tatu tofauti zinazojitegemea; rekodi moja ya bima inaweza kuwa na vipengele vya injury, property na vehicle claim.
Mipaka ya tafsiri za vipengele
Katika sehemu ya discussion, chanzo kinaeleza kwamba vigezo kama claim amount kubwa, missing police report na baadhi ya incident characteristics vinaweza kuwa viashiria vya ulaghai. Hata hivyo, utafiti hauripoti grafu ya feature-importance, thamani ya SHAP, permutation importance, umuhimu wa coefficients za Logistic Regression au uchambuzi mwingine wa kiasi wa uelezekaji.
Kwa hiyo, vipengele hivyo ni tafsiri za uchunguzi/modeli za waandishi wa chanzo; haiwezekani kupanga kwa kiasi kutoka kwenye PDF hii ni kigezo kipi kilicho “kiashiria chenye nguvu zaidi cha ulaghai”.
Je, Matokeo Haya Yanathibitisha Utendaji Hai Katika Mifumo Halisi ya Bima?
Hapana. Modeli zilitathminiwa kwenye seti ya data ya kihistoria iliyo wazi kwa umma kwa mgawanyo mmoja wa train-test na hazikuunganishwa kwenye mfumo hai wa claim-processing wa kampuni halisi ya bima; kwa hiyo %79 Decision Tree accuracy iliyoripotiwa au metriki nyingine si dhamana ya utendaji katika mazingira halisi, na uthibitishaji upya unahitajika katika nchi, bidhaa, aina ya ulaghai au mgawanyo tofauti wa data.
Mipaka ya utafiti wenyewe
- Data iliyo wazi kwa umma huenda isiakisi ugumu wote wa shughuli halisi za bima.
- Dhana za kila modeli huenda zisilingane kikamilifu na muundo wa data.
- Modeli zimejaribiwa kwenye data ya kihistoria pekee.
- Hakuna muunganisho uliofanywa na mfumo hai wa bima.
- Maelezo ya kwanza ya mipaka ya utafiti yanakubali kwamba uchambuzi wa uelezekaji ni mdogo.
- Hakuna hakikisho kwamba matokeo yanaweza kuhamishwa moja kwa moja kwenda nchi, sekta au seti tofauti za data.
Mipaka ya ziada ya uwezo wa kurudia utafiti
- Vigezo vya tuning vya Decision Tree havijaripotiwa.
- Hyperparameter za Random Forest hazijaripotiwa.
- Mbinu za Encoding na scaling hazijatajwa wazi.
- Taarifa za random seed na stratified splitting hazijatolewa.
- Hakuna matokeo ya cross-validation yaliyotekelezwa yaliyoripotiwa.
- Hakuna seti huru ya majaribio ya nje.
- Confidence interval au jaribio rasmi la umuhimu wa ulinganisho wa modeli halijaripotiwa.
- Metriki ya AUC-ROC, PR-AUC au calibration haijatolewa.
- Gharama ya kiuchumi ya chanya za uongo na hasi za uongo haijaundwa katika modeli.
Kutolingana kwa uhariri na nambari ndani ya chanzo
- Ingawa nambari za Decision Tree confusion matrix zinaendana na matokeo ya %79 ya modeli iliyofanyiwa tuning, caption husika ina kauli “Initial Model”.
- Kichwa cha picha kimoja kimeachwa bila kukamilika katika umbo la “Figure 5: Enter Caption”.
- Maelezo ya Random Forest yanasema perfect training accuracy, ilhali Table 2 inatoa training accuracy ya 0,7887.
- Abstract inaeleza kwamba ubadilishaji wa kategoria na scaling vilitumika, lakini sehemu ya mbinu haitoi maelezo yake ya kiufundi.
Mapendekezo ya utafiti
Chanzo kinapendekeza mielekeo minne kwa matumizi ya baadaye. Kwanza, kutumia zana kama SHAP ili kuongeza uelezekaji pamoja na usahihi. Pili, kuunganisha alama za ML na sheria za wataalamu. Tatu, kutathmini SMOTE, algoritimu za cost-sensitive au mbinu za ensemble kwa tatizo la kutokuwiana kwa madarasa. Nne, kupima tena vipengele katika seti tofauti za data na kufanya uthibitishaji wa nje kwa data halisi au proprietary za bima.
Ni muhimu kwamba mbinu hizi zimetolewa kama mapendekezo: katika utafiti wa sasa SHAP, SMOTE au cost-sensitive training hazikutumika na hakuna matokeo mapya ya utendaji yanayohusiana nazo yaliyoripotiwa.
Matokeo yanayoungwa mkono na utafiti
- Katika seti ya data iliyochunguzwa, tuned Decision Tree ilitoa utendaji wa majaribio wenye uwiano bora zaidi kati ya modeli nne.
- Kwa Decision Tree, test accuracy ni %79, recall ni 0,6909, F1-score ni 0,6441 na MCC ni 0,4984.
- Ingawa Random Forest ilitoa %72 accuracy, haikuweza kuainisha kwa usahihi hata kisa kimoja cha ulaghai katika majaribio.
- Thamani za recall za ulaghai kwa Logistic Regression na Naïve Bayes ni za chini sana.
- Katika tatizo la ulaghai lenye kutokuwiana kwa madarasa, F1, recall na MCC zimeonyesha tabia ya modeli ambayo accuracy pekee haionyeshi.
- Usafishaji wa data na uteuzi wa vipengele ni sehemu muhimu za mchakato wa kutengeneza modeli.
Matokeo yasiyoungwa mkono na utafiti
- Haijaonyeshwa kwamba Decision Tree ndiyo modeli bora kwa ujumla katika seti zote za data za ulaghai wa bima.
- Haijathibitishwa kwamba modeli itatoa %79 accuracy katika shughuli halisi za bima.
- Haiwezi kuhitimishwa kwamba Random Forest kwa ujumla ni algoritimu isiyofaa kwa fraud detection; ni muundo wa jaribio hili pekee uliofanya vibaya.
- Haijaonyeshwa kwamba vipengele fulani ni sababu ya kisababishi ya ulaghai.
- Chanzo hakitoi mpangilio wa feature importance wala uchambuzi wa SHAP.
- Haijajaribiwa kama SMOTE, cost-sensitive learning au SHAP huongeza utendaji kwenye seti hii ya data.
- Haijaonyeshwa rasmi kwamba tofauti kati ya modeli zina umuhimu wa kitakwimu.
- Utafiti haukupima kupungua kwa hasara ya kifedha katika shughuli halisi za bima.
Maelezo ya Chanzo na Mbinu
Kichwa kamili cha asili: Comparative Analysis of Machine Learning Models for Insurance Fraud Detection.
Mpangilio wa waandishi katika PDF: Praise Owusu Oteng; Francis Mawuse Addae; Edward Tait Kwaw; Catherine Ewoenam Kwablavi; Bismark Sarkodie; Sandra Addai-Henne.
Ushirika katika PDF: Kwame Nkrumah University of Science and Technology, Department of Statistics and Actuarial Science, Kumasi, Ghana.
Contact Author katika metadata ya SSRN: Praise Oteng.
Jukwaa: SSRN.
SSRN Abstract ID: 6899161.
DOI: 10.2139/ssrn.6899161.
Date Written: 2 Septemba 2025.
Kuchapishwa/kuwasilishwa kwenye SSRN: 30 Juni 2026.
Aina ya chanzo: Working paper / preprint.
Hali ya mapitio ya rika: Katika uthibitishaji wa sasa wa bibliografia, toleo la jarida lililopitia mapitio ya rika halijathibitishwa.
Leseni: Hakuna leseni ya wazi ya Creative Commons iliyothibitishwa. Katika maelezo ya Verianla, maandishi ya chanzo, muundo asili wa picha na mpangilio asili wa jedwali hayajachapishwa tena.
Data: Seti ya data iliyopangwa ya madai ya bima ya insurance.claims.csv iliyopatikana kupitia Kaggle.
Muundo wa vigezo ulioripotiwa katika chanzo: Vigezo huru 40 na lengo la fraud-reported Y/N.
Seti ya majaribio: Kulingana na confusion matrix za chanzo, rekodi 200; 55 za ulaghai na 145 zisizo za ulaghai.
Mgawanyo wa train-test: %80 / %20.
Ushughulikiaji wa data inayokosekana: Mode imputation kwa collision-type, property-damage, authorities-contacted na police-report-available.
Matokeo ya multicollinearity: Correlation ya 0,92 kati ya months-as-customer na age; age na total-claim-amount ziliondolewa kwenye seti ya uundaji wa modeli.
Modeli: Decision Tree, Random Forest, Logistic Regression na Naïve Bayes.
Metriki za tathmini: Accuracy, Precision, Recall, F1-score na Matthews Correlation Coefficient.
Matokeo makuu ya utendaji: Decision Tree — train accuracy 0,8225; test accuracy 0,7900; precision 0,6032; recall 0,6909; F1 0,6441; MCC 0,4984.
Matokeo muhimu ya kutokuwiana kwa madarasa: Ingawa test accuracy ya Random Forest ni 0,7200, thamani za recall, precision na F1 ni 0 na hakuna kisa cha ulaghai kilichotambuliwa kwa usahihi.
Maelezo ya uwezo wa kurudia utafiti ambayo hayajafafanuliwa katika chanzo: Mbinu ya kategorika ya encoding iliyotumika, scaler, vigezo vya tuning vya Decision Tree, hyperparameter za Random Forest, random seed, stratification, mpangilio wa preprocessing fit na matoleo ya software/package.
Cross-validation: Haijaripotiwa katika jaribio la chanzo lenyewe. Sehemu ya fasihi inaeleza matumizi ya ten-fold cross-validation katika utafiti mwingine; hiyo si mbinu ya utafiti huu.
Ulinganisho wa kitakwimu: Confidence interval, p-value au jaribio rasmi la umuhimu kwa tofauti za modeli halijaripotiwa.
Uthibitishaji wa mazingira halisi: Hakuna.
Muunganisho wa mfumo hai wa bima: Hakuna.
Uchambuzi wa uelezekaji: Feature importance au uchambuzi wa SHAP haujaripotiwa katika jaribio la sasa; SHAP inapendekezwa kwa matumizi ya baadaye.
Usawazishaji wa madarasa: SMOTE au cost-sensitive learning haikutumika katika jaribio la sasa, bali ilitolewa kama pendekezo la utafiti wa baadaye.
Kutolingana ndani ya chanzo: Kauli “perfect training accuracy” katika maandishi ya Random Forest hailingani na 0,7887 katika Table 2.
Tatizo la uhariri wa picha: Caption ya picha moja imebaki “Enter Caption”; kauli “Initial Model” katika caption ya Decision Tree confusion matrix inaendana na matokeo ya tuned %79 yaliyoonyeshwa kwenye matriki.
Ufadhili: Hakuna taarifa tofauti ya ufadhili iliyoripotiwa.
Mgongano wa maslahi: Hakuna taarifa tofauti ya mgongano wa maslahi iliyoripotiwa.
Upatikanaji wa data: Chanzo cha Kaggle kimetajwa lakini dataset URL tofauti, kitambulisho cha toleo au taarifa ya leseni ya data haijaripotiwa.
CRediT / michango ya waandishi: Hakuna taarifa tofauti ya CRediT iliyoripotiwa.
Shukrani: Waandishi wanamshukuru Mungu katika kazi yao na wanataja kando mchango wa ushauri wa Dr. Sandra Addai-Henne.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *