


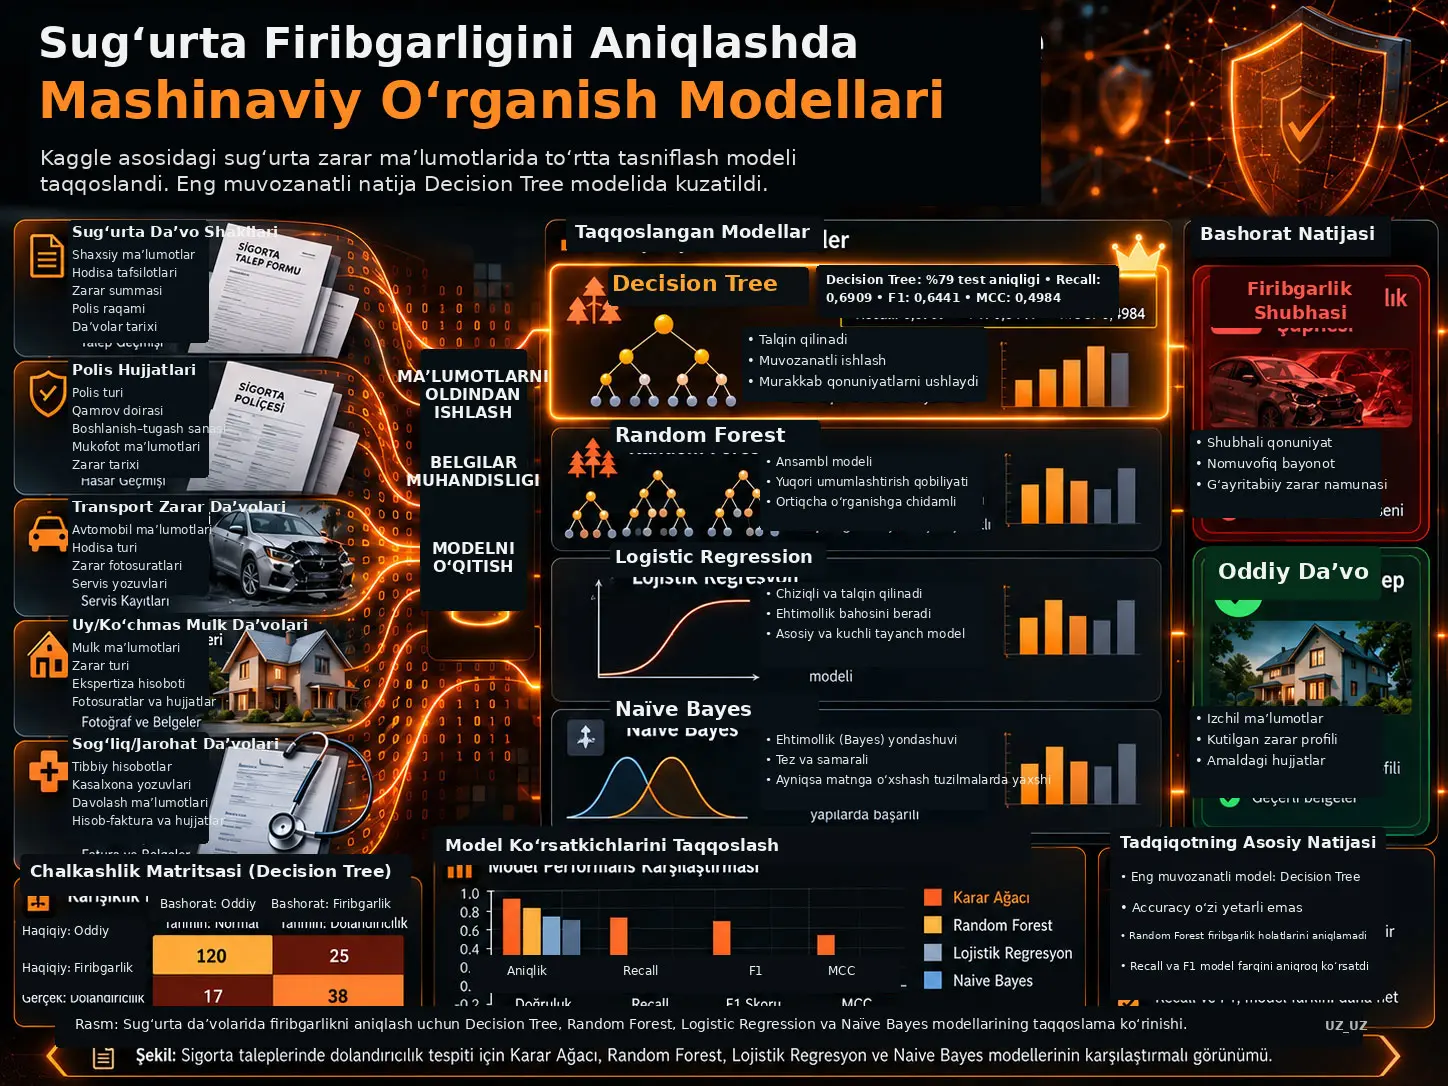
Nazoratli mashinaviy oʻrganishga asoslangan sugʻurta firibgarligini aniqlash, avval firibgarlik yoki firibgarlik boʻlmagan deb belgilangan sugʻurta daʼvolaridan qonuniyatlarni oʻrganib, yangi daʼvolarni ikki sinfdan biriga ajratishni maqsad qiladigan ikkilik tasniflash muammosidir. Praise Owusu Oteng va hamkasblari Kaggle orqali olingan insurance.claims.csv maʼlumotlar toʻplamida Decision Tree, Random Forest, Logistic Regression va Naïve Bayes modellarini taqqoslagan. Maʼlumotlarni tozalash; yetishmayotgan qiymatlarni toʻldirish, ayrim yuqori kardinallikka ega yoki aloqasiz oʻzgaruvchilarni chiqarib tashlash, multikollinearlikni tekshirish hamda manba annotatsiyasida koʻrsatilgan kategorik oʻzgartirish va masshtablash bosqichlarini oʻz ichiga oladi. Maʼlumotlar %80 oʻqitish va %20 testga ajratilgan; modellar accuracy, precision, recall, F1-score va Matthews Correlation Coefficient (MCC) bilan baholangan. Sozlangan Decision Tree %79 test accuracy, 0,6032 precision, 0,6909 recall, 0,6441 F1-score va 0,4984 MCC bilan koʻrib chiqilgan toʻrtta model ichida eng muvozanatli natijani bergan.
Tadqiqotning eng muhim oʻrgatuvchi xulosasi shuki, firibgarlik kabi ozchilik sinfi mavjud boʻlgan maʼlumotlar toʻplamida yuqori accuracy qiymati oʻz-oʻzidan firibgarlikni muvaffaqiyatli aniqlashni anglatmaydi. Random Forest test maʼlumotlarida %72 accuracy bergan boʻlsa-da, firibgarlik sinfidagi 55 yozuvning birortasini ham toʻgʻri aniqlay olmagan. Logistic Regression faqat 3 ta, Naïve Bayes esa faqat 2 ta firibgarlik holatini toʻgʻri tasniflagan. Decision Tree ayni 55 holatning 38 tasini toʻgʻri aniqlagan. Shu sababli modellar reytingini belgilovchi asosiy farq faqat umumiy aniqlik emas, balki ozchilik firibgarlik sinfini aniqlash qobiliyati va har ikki sinfdagi xatolarni birgalikda hisobga oladigan F1 hamda MCC oʻlchovlaridir.
Natijalar bitta ommaga ochiq tarixiy maʼlumotlar toʻplami va bitta train/test boʻlinishi bilan cheklangan. Manba hyperparameter tuning tafsilotlari, qoʻllangan encoding/scaling usullari, random seed, stratification maʼlumoti yoki cross-validation natijalarini bayon qilmaydi. Modellar haqiqiy sugʻurta kompaniyasining amaldagi zararlarni boshqarish tizimida sinovdan oʻtkazilmagan. Shuning uchun Decision Treeʼning ushbu maʼlumotlar toʻplamidagi ustunligi barcha sugʻurta maʼlumotlar toʻplamlarida yoki real operatsiyalarda aynan shu model albatta eng yaxshi boʻlishini anglatmaydi.
Tadqiqot muammosi
Sugʻurta firibgarligi — haqiqiy boʻlmagan yoki manipulyatsiya qilingan daʼvolarni sugʻurtalovchidan moliyaviy manfaat olish maqsadida taqdim etishni qamrab oladigan keng muammo. Manba firibgarlik xatti-harakati sogʻliq, hayot, mol-mulk va avtotransport sugʻurtasi kabi turli sohalarda yuzaga kelishi mumkinligini hamda anʼanaviy qoʻlda tekshirish yoki qatʼiy qoidali tizimlar oʻzgarib boruvchi firibgarlik qonuniyatlarini aniqlashda qiynalishi mumkinligini taʼkidlaydi.
Ushbu tadqiqot nuqtai nazaridan mashinaviy oʻrganishning asosiy afzalligi — ilgari belgilangan zarar yozuvlaridagi koʻp oʻzgaruvchili qonuniyatlarni oʻrganib, yangi daʼvolar uchun firibgarlik ehtimoli boʻyicha avtomatik tasnif ishlab chiqara olishidir. Biroq qaysi algoritm eng yaxshi ekani maʼlumotlar taqsimotiga, belgilarga, firibgarlik sinfining ulushiga va baholash metrikasiga bogʻliq.
Tadqiqot savollari
Manba uchta asosiy savolga eʼtibor qaratadi: mashinaviy oʻrganish firibgarlik daʼvolarini qay darajada aniqlay oladi, koʻrib chiqilgan toʻrtta algoritmdan qaysi biri eng ishonchli tasnifni beradi va mashinaviy oʻrganish natijalari firibgarlikni tekshirish jarayonini qaysi yoʻllar bilan qoʻllab-quvvatlashi mumkin.
Maʼlumotlar toʻplami
Tadqiqotda ishlatilgan maʼlumotlar fayli insurance.claims.csv deb ataladi va Kaggle orqali olingan. Manba maʼlumotlar tuzilmasini 40 ta mustaqil oʻzgaruvchiga ega tuzilmaviy sugʻurta zararlar maʼlumotlar toʻplami sifatida taʼriflaydi.
Oʻzgaruvchilar guruhlari quyidagilarni oʻz ichiga oladi:
- mijoz demografiyasi: yosh, taʼlim, kasb kabi maʼlumotlar,
- polis maʼlumotlari: deductible va yillik mukofot kabi belgilar,
- hodisa maʼlumotlari: hodisa turi, hodisa ogʻirligi va transport vositalari soni,
- zarar maʼlumotlari: injury, property va vehicle claim summalari,
- maqsadli oʻzgaruvchi: fraud-reported = Y yoki N
mavjud.
Manba Data Description boʻlimida umumiy tanlanma hajmini alohida “N = ...” qatori bilan bermaydi. Biroq %80:%20 boʻlinishi va barcha confusion matrixlarda 200 ta test yozuvi koʻrinishi tahlil qilingan maʼlumotlar hajmi 1.000 yozuvli tuzilishga mos kelishini koʻrsatadi. Manbaning Table 3 jadvalida Vehicle Claims uchun ham jami 1.000 yozuv qayd etilgan.
Yetishmayotgan qiymatlarni qayta ishlash
| Oʻzgaruvchi | Yetishmayotgan qiymatlar soni | Manbada qoʻllangan amal |
|---|---|---|
| collision-type | 178 | Moda bilan toʻldirish |
| property-damage | 360 | Moda bilan toʻldirish |
| authorities-contacted | 91 | Moda bilan toʻldirish |
| police-report-available | 343 | Moda bilan toʻldirish |
Moda imputatsiyasi tegishli oʻzgaruvchida eng koʻp uchraydigan kategoriyani yetishmayotgan yozuvlar oʻrniga qoʻyishdir. Bu usul maʼlumot qatorlarini oʻchirmasdan tanlanmani saqlaydi; biroq yetishmayotgan kategoriyalarning haqiqiy taqsimotini aks ettirishi kafolatlanmaydi.
Manba imputatsiya amali faqat oʻqitish maʼlumotlarida oʻrganilib test maʼlumotlariga qoʻllanganini yoki train/test boʻlinishidan oldin barcha maʼlumotlar boʻyicha hisoblanganini aniq koʻrsatmaydi. Shu sababli preprocessing zanjiri ehtimoliy maʼlumotlar sizib chiqishi nuqtai nazaridan qanday qoʻllanganini manba asosida tasdiqlab boʻlmaydi.
Chiqarib tashlangan oʻzgaruvchilar
Manba modellashtirish uchun foydasi cheklangan yoki yuqori kardinallikka ega degan asos bilan policy-number, policy-bind-date, incident-date, policy-state, incident-state, incident-city, incident-location, insured.zip, insured-hobbies, auto-make, auto-model, auto-year va CSV formatlashidan hosil boʻlgan qoʻshimcha ustunni olib tashlaydi.
Bu qarorlarning bir qismi maʼlumotlar hajmi va kategorik murakkablikni kamaytirishga qaratilgan. Biroq sana va geografik oʻzgaruvchilar firibgarlik boʻyicha potensial axborot tashiydimi-yoʻqmi alohida sinovdan oʻtkazilmagan; tadqiqotda ular bevosita modeldan chiqarib tashlangan.
Multikollinearlikni tekshirish
Manbaning korrelyatsiya tahlilida months-as-customer bilan age oʻrtasida 0,92 musbat korrelyatsiya aniqlangan. Injury-claim, property-claim va vehicle-claim komponentlari total-claim-amount bilan yuqori korrelyatsiyaga ega ekani ham qayd etiladi. Natijada age va total-claim-amount belgilari modellashtirish toʻplamidan chiqarilgan.
Manba 4-betda uchburchak korrelyatsion heatmapni taqdim etadi. Ushbu tasvirning ilmiy vazifasi ayrim sonli belgilar bir xil maʼlumotni kuchli takrorlashini koʻrsatishdir; heatmap model ishlashini bevosita oʻlchamaydi.
Kategorik oʻzgartirish va masshtablash boʻyicha hisobot boʻshligʻi
Manbaning abstract boʻlimida kategorik maʼlumotlar sonli koʻrinishga oʻtkazilgani va mos scaling amallari qoʻllangani aytiladi. Biroq metod boʻlimida ishlatilgan encoding algoritmining nomi, kategorik darajalar qanday qayta ishlangani yoki StandardScaler, MinMaxScaler kabi aniq masshtablagich qoʻllangan-qoʻllanmagani bayon qilinmagan.
Bu yetishmovchilik ayniqsa Logistic Regression va Naïve Bayes kabi preprocessing shakliga taʼsirchan modellarning qayta ishlab chiqarilishi nuqtai nazaridan muhim.
Oʻqitish va test boʻlinishi
Manba maʼlumotlar toʻplamini %80 oʻqitish va %20 test tarzida ajratgan. Cross-validation, mustaqil validation set yoki tashqi test maʼlumotlar toʻplami haqida maʼlumot berilmagan.
Random seed yoki split paytida fraud/non-fraud nisbati stratification orqali saqlangan-saqlanmagani ham koʻrsatilmagan. Shu sababli bitta splitda kuzatilgan model reytingi boshqa boʻlinishda qanchalik barqaror boʻlishini manbadan aniqlab boʻlmaydi.
Decision Tree qanday ishlaydi?
Decision Tree har bir tugunda bir belgi boʻyicha maʼlumotlar toʻplamini bir jinsliroq kichik guruhlarga ajratadigan va barg tugunida sinf qarorini chiqaradigan ierarxik tasniflagichdir. Tadqiqot boʻlinish sifatini tushuntirish uchun Gini impurity, entropy va information gain formulalarini beradi.
\[ Gini(S)=1-\sum_{i=1}^{n}p_i^2 \]
\(p_i\) — \(S\) tugunidagi \(i\)-sinfning ulushi. Sof tugunda barcha kuzatuvlar bitta sinfga tegishli boʻladi va Gini impurity kamayadi.
\[ E(S)=-\sum_{i=1}^{n}p_i\log_2(p_i) \]
Entropy ham sinflar aralashuvini oʻlchaydi. Bir jinsliroq tugun pastroq entropyga ega boʻladi.
\(A\) belgisi boʻyicha boʻlinishning axborot yutugʻi:
\[ IG(S,A)=E(S)-\sum_{v\in Values(A)} \frac{|S_v|}{|S|}E(S_v) \]
koʻrinishidadir. Yuqori information gain boʻlinish sinf noaniqligini koʻproq kamaytirishini anglatadi.
Logistic Regression
Logistic Regression belgilar chiziqli kombinatsiyasini firibgarlik sinfiga mansub boʻlish ehtimoliga aylantiradi. Manba ishlatgan logit koʻrinishi:
\[ \ln\left(\frac{P(Y)}{1-P(Y)}\right) = \beta_0+\beta_1X_1+\beta_2X_2+\cdots+\beta_kX_k \]
va unga mos ehtimollik:
\[ P(Y)= \frac{e^{\beta_0+\beta_1X_1+\cdots+\beta_kX_k}} {1+e^{\beta_0+\beta_1X_1+\cdots+\beta_kX_k}} \]
koʻrinishidadir. \(X_i\) kirish belgilarini, \(\beta_i\) model koeffitsiyentlarini va \(P(Y)\) maqsadli sinfning bashorat qilingan ehtimolini ifodalaydi.
Random Forest
Random Forest turli maʼlumot va belgilar kichik toʻplamlarida koʻplab qaror daraxtlarini yaratib, bu daraxtlarning tasnif qarorlarini birlashtiradigan ensemble usulidir. Maqsad bitta daraxtning muayyan oʻqitish namunalariga ortiqcha moslashish xavfini kamaytirishdir.
Ushbu tadqiqotda esa Random Forest test toʻplamidagi firibgarlik sinfini butunlay oʻtkazib yuborgan. Manba ishlatilgan daraxtlar soni, maximum depth, feature sampling nisbati, class-weight yoki boshqa Random Forest giperparametrlarini bayon qilmaydi.
Naïve Bayes
Naïve Bayes modeli Bayes teoremasiga asoslanadi:
\[ P(C\mid X)=\frac{P(X\mid C)P(C)}{P(X)} \]
Shartli mustaqillik farazi ostida:
\[ P(C\mid X)\propto P(C)\prod_{i=1}^{n}P(x_i\mid C) \]
koʻrinishiga oʻtadi. Bu yerda \(C\) firibgarlik yoki firibgarlik boʻlmagan sinfni, \(X\) kuzatilgan belgilar toʻplamini ifodalaydi. “Naïve” farazi sinf maʼlum boʻlganda belgilar bir-biridan shartli ravishda mustaqil deb qabul qilinishini anglatadi.
Sugʻurta Firibgarligini Aniqlashda Accuracy Nega Oʻzi Yetarli Emas?
Accuracy barcha toʻgʻri bashoratlarning umumiy namunalarga nisbatini oʻlchagani uchun firibgarlik kabi ozchilik sinfi mavjud test toʻplamida doim koʻpchilik sinfini tanlaydigan model yuqori koʻrsatkich berishi mumkin; ushbu tadqiqotda 200 ta test yozuvining 145 tasi firibgarlik boʻlmagan va 55 tasi firibgarlik boʻlganida Random Forest %72 test accuracy bergan, ammo firibgarlik holatlarining birortasini ham toʻgʻri aniqlamagan. Shu sababli recall, F1-score va MCC firibgarlik sinfidagi muvaffaqiyatsizlikni accuracyga qaraganda yaqqolroq koʻrsatadi.
Chalkashlik matritsasi
| Haqiqiy / Bashorat | Bashorat qilingan Firibgarlik | Bashorat qilingan Firibgarlik Emas |
|---|---|---|
| Haqiqiy Firibgarlik | Haqiqiy Musbat (TP) | Yolgʻon Manfiy (FN) |
| Haqiqiy Firibgarlik Emas | Yolgʻon Musbat (FP) | Haqiqiy Manfiy (TN) |
Haqiqiy Musbat, firibgarlik holatining toʻgʻri ravishda firibgarlik deb belgilanishidir. Yolgʻon Manfiy, firibgarlik holatining tizim tomonidan oʻtkazib yuborilishidir. Yolgʻon Musbat, haqiqiy daʼvoning xato ravishda firibgarlik deb belgilanishidir; Haqiqiy Manfiy esa firibgarlik boʻlmagan yozuvning toʻgʻri tasniflanishidir.
Accuracy
\[ Accuracy= \frac{TP+TN}{TP+TN+FP+FN} \]
Accuracy umumiy tasnif aniqligini koʻrsatadi, ammo sinflar taqsimotini hisobga olmaydi.
Precision
\[ Precision=\frac{TP}{TP+FP} \]
Precision model firibgarlik deb belgilagan daʼvolarning qanchasi haqiqatda firibgarlik ekanini oʻlchaydi.
Recall
\[ Recall=\frac{TP}{TP+FN} \]
Recall haqiqiy firibgarlik holatlarining qanchasi model tomonidan aniqlanganini oʻlchaydi. Fraud detection kontekstida past recall koʻplab firibgarlik holatlari oʻtkazib yuborilganini anglatadi.
F1-score
\[ F1= 2\times \frac{Precision\times Recall} {Precision+Recall} \]
F1-score precision va recall oʻrtasidagi muvozanatni bitta qiymatda umumlashtiradi.
Matthews Correlation Coefficient
\[ MCC= \frac{(TP\times TN)-(FP\times FN)} {\sqrt{(TP+FP)(TP+FN)(TN+FP)(TN+FN)}} \]
MCC confusion-matrixning toʻrtta katagidan bir vaqtda foydalangani sababli sinflari nomutanosib boʻlgan ikkilik tasniflash muammolarida foydali umumlashtiruvchi metrikadir. Yuqori musbat qiymat izchilroq tasniflashni, nol atrofidagi qiymat zaif bogʻliqlikni, manfiy qiymat esa bashoratlar bilan haqiqiy sinflar oʻrtasidagi teskari yoʻnalishdagi natijani bildiradi.
Tadqiqot Usuli va Natijalari
Model koʻrsatkichlarini taqqoslash
| Model | Train Accuracy | Test Accuracy | Precision | Recall | F1-score | MCC |
|---|---|---|---|---|---|---|
| Decision Tree | 0,8225 | 0,7900 | 0,6032 | 0,6909 | 0,6441 | 0,4984 |
| Random Forest | 0,7887 | 0,7200 | 0,0000 | 0,0000 | 0,0000 | -0,0437 |
| Logistic Regression | 0,7512 | 0,6950 | 0,2500 | 0,0545 | 0,0896 | -0,0141 |
| Naïve Bayes | 0,7462 | 0,7000 | 0,2222 | 0,0364 | 0,0625 | -0,0257 |
Ushbu Tadqiqotda Qaysi Mashinaviy Oʻrganish Modeli Eng Yaxshi Natija Berdi?
Koʻrib chiqilgan yagona Kaggle maʼlumotlar toʻplami va qoʻllangan %80:%20 train-test boʻlinishi sharoitida Decision Tree eng muvozanatli model boʻlgan; %79 test accuracy, 0,6909 recall, 0,6441 F1-score va 0,4984 MCC bilan boshqa uch modelga qaraganda kuchliroq firibgarlik tasnifini bergan. Bu natija faqat tadqiqot maʼlumotlari va tajriba tuzilishi uchun amal qiladi hamda Decision Tree barcha sugʻurta maʼlumotlar toʻplamlarida universal ravishda eng yaxshi model ekanini koʻrsatmaydi.
Decision Tree natijalari
Manba dastlabki Decision Tree modeli %100 training accuracy va %71 test accuracy koʻrsatib, overfitting belgisini berganini qayd etadi. Hyperparameter tuningdan soʻng oʻqitish accuracysi %82,25 ga tushgan, test accuracy esa %79 ga koʻtarilgan.
Test confusion matrix:
| Decision Tree natijasi | Soni |
|---|---|
| Haqiqiy Manfiy | 120 |
| Yolgʻon Musbat | 25 |
| Yolgʻon Manfiy | 17 |
| Haqiqiy Musbat | 38 |
Decision Tree 55 ta haqiqiy firibgarlik holatining 38 tasini aniqlagan va 17 tasini oʻtkazib yuborgan. Manba tuningdan keyin oʻqitish va test accuracy qiymatlarining bir-biriga yaqinlashishini generalization nuqtai nazaridan ijobiy baholaydi.
Biroq qoʻllangan tuning parametrlari yoki tuning jarayoni bayon qilinmagani sababli bu natijani mustaqil ravishda toʻliq qayta ishlab chiqarib boʻlmaydi.
Random Forest natijalari
| Random Forest natijasi | Soni |
|---|---|
| Haqiqiy Manfiy | 144 |
| Yolgʻon Musbat | 1 |
| Yolgʻon Manfiy | 55 |
| Haqiqiy Musbat | 0 |
Random Forest 145 ta firibgarlik boʻlmagan yozuvning 144 tasini toʻgʻri tasniflagan boʻlsa-da, 55 ta firibgarlik holatining barchasini oʻtkazib yuborgan. Natijada precision, recall va F1-score qiymatlarining barchasi nol boʻlgan.
Manba matnida Random Forest uchun “perfect training accuracy” iborasi ishlatiladi; aksincha, asosiy koʻrsatkichlar jadvalida training accuracy 0,7887 deb berilgan. Bu ikki qiymat bir-biriga mos kelmagani sababli Verianla bayonida ochiq sonli manba jadvali asos qilib olinadi.
Logistic Regression natijalari
| Logistic Regression natijasi | Soni |
|---|---|
| Haqiqiy Manfiy | 136 |
| Yolgʻon Musbat | 9 |
| Yolgʻon Manfiy | 52 |
| Haqiqiy Musbat | 3 |
Logistic Regression %69,5 test accuracy bergan; biroq 55 ta firibgarlik holatining faqat 3 tasini toʻgʻri aniqlagan. Recall 0,0545, F1-score 0,0896 va MCC -0,0141. Shu sababli umumiy accuracy firibgarlik sinfidagi haqiqiy natijani mavjudidan kuchliroq koʻrsatishi mumkin.
Naïve Bayes natijalari
| Naïve Bayes natijasi | Soni |
|---|---|
| Haqiqiy Manfiy | 138 |
| Yolgʻon Musbat | 7 |
| Yolgʻon Manfiy | 53 |
| Haqiqiy Musbat | 2 |
Naïve Bayes %70 test accuracy bergan boʻlsa-da, firibgarlik holatlarining faqat 2 tasini aniqlagan. Recall 0,0364 va MCC -0,0257. Bu natija majority class muvaffaqiyatini firibgarlikni aniqlash muvaffaqiyati bilan aralashtirmaslik kerakligini ham koʻrsatadi.
Firibgarlik holatlarining modellar tomonidan aniqlanishi
| Model | Haqiqiy Firibgarlik | Toʻgʻri Aniqlangan Firibgarlik | Oʻtkazib Yuborilgan Firibgarlik |
|---|---|---|---|
| Decision Tree | 55 | 38 | 17 |
| Random Forest | 55 | 0 | 55 |
| Logistic Regression | 55 | 3 | 52 |
| Naïve Bayes | 55 | 2 | 53 |
Ushbu jadval tadqiqotdagi amaliy model farqini accuracy jadvaliga qaraganda aniqroq koʻrsatadi. Decision Tree testdagi firibgarlik holatlarining muhim qismini aniqlagan boʻlsa, qolgan uch model ozchilik firibgarlik sinfiga nisbatan jiddiy natija yoʻqotishini koʻrsatadi.
Zarar turlari boʻyicha manba jadvali
| Zarar komponenti | Jami yozuv | Firibgarlik deb qayd etilgan yozuv |
|---|---|---|
| Jarohat Boʻyicha Daʼvolar | 975 | 238 |
| Mol-mulk Boʻyicha Daʼvolar | 981 | 241 |
| Transport Vositasi Boʻyicha Daʼvolar | 1000 | 247 |
Manba bu sonlarni Table 3 ostida keltiradi. Ularni bir-biridan mustaqil uchta alohida tanlanma deb talqin qilmaslik kerak; bir sugʻurta yozuvida injury, property va vehicle claim komponentlari boʻlishi mumkin.
Belgilar talqinining chegarasi
Manba discussion boʻlimida yuqori claim amount, missing police report va ayrim incident characteristics kabi oʻzgaruvchilar firibgarlik koʻrsatkichi boʻlishi mumkinligini aytadi. Biroq tadqiqotda feature-importance grafigi, SHAP qiymati, permutation importance, Logistic Regression koeffitsiyentlarining ahamiyatliligi yoki boshqa miqdoriy izohlanuvchanlik tahlili keltirilmagan.
Shu sababli mazkur belgilar manba mualliflarining kuzatuv/modelga asoslangan talqinlaridir; ushbu PDFdan qaysi oʻzgaruvchi “eng kuchli firibgarlik aniqlovchisi” ekani miqdoriy tarzda tartiblanishi mumkin emas.
Bu Natijalar Haqiqiy Sugʻurta Tizimlaridagi Jonli Ishlashni Isbotlaydimi?
Yoʻq. Modellar ommaga ochiq tarixiy maʼlumotlar toʻplamida bitta train-test boʻlinishi bilan baholangan va haqiqiy sugʻurta kompaniyasining jonli claim-processing tizimiga integratsiya qilinmagan; shu sababli qayd etilgan %79 Decision Tree accuracy yoki boshqa metrikalar real sharoitdagi ishlash kafolati emas hamda boshqa mamlakat, mahsulot, firibgarlik turi yoki maʼlumotlar taqsimotida qayta tekshirishni talab qiladi.
Tadqiqotning oʻz cheklovlari
- Ommaga ochiq maʼlumotlar haqiqiy sugʻurta operatsiyalarining barcha murakkabligini aks ettirmasligi mumkin.
- Har bir model farazlari maʼlumotlar tuzilmasiga toʻliq mos kelmasligi mumkin.
- Modellar faqat tarixiy maʼlumotlarda sinovdan oʻtkazilgan.
- Jonli sugʻurta tizimiga integratsiya amalga oshirilmagan.
- Tadqiqotning dastlabki cheklov izohi izohlanuvchanlik tahlili cheklanganini tan oladi.
- Natijalarni boshqa mamlakat, soha yoki maʼlumotlar toʻplamlariga bevosita koʻchirish kafolatlanmaydi.
Qoʻshimcha qayta ishlab chiqarish cheklovlari
- Decision Tree tuning parametrlari bayon qilinmagan.
- Random Forest giperparametrlari bayon qilinmagan.
- Encoding va scaling usullari aniq nomlanmagan.
- Random seed va stratified splitting maʼlumoti berilmagan.
- Cross-validation qoʻllangan natija bayon qilinmagan.
- Mustaqil tashqi test toʻplami mavjud emas.
- Confidence interval yoki formal model-taqqoslash ahamiyatlilik testi bayon qilinmagan.
- AUC-ROC, PR-AUC yoki calibration metrikasi berilmagan.
- Yolgʻon musbat va yolgʻon manfiy natijalarning iqtisodiy qiymati modellashtirilmagan.
Manba ichidagi tahririy va sonli nomuvofiqliklar
- Decision Tree confusion matrixidagi sonlar tuned modelning %79 natijasiga mos kelsa-da, tegishli caption “Initial Model” iborasini oʻz ichiga oladi.
- Bir rasm sarlavhasi “Figure 5: Enter Caption” koʻrinishida tugallanmay qolgan.
- Random Forest izohida perfect training accuracy deyiladi, biroq Table 2 training accuracyni 0,7887 deb beradi.
- Abstract kategorik oʻzgartirish va scaling qoʻllanganini bildiradi, ammo metod boʻlimi ularning texnik tafsilotlarini bermaydi.
Tadqiqot tavsiyalari
Manba kelajakdagi qoʻllanmalar uchun toʻrtta yoʻnalishni tavsiya qiladi. Birinchisi, aniqlik bilan birga izohlanuvchanlikni oshirish uchun SHAP kabi vositalardan foydalanish. Ikkinchisi, ML ballarini ekspert qoidalari bilan birlashtirish. Uchinchisi, sinf nomutanosibligi uchun SMOTE, cost-sensitive algoritmlar yoki ensemble usullarini baholash. Toʻrtinchisi, belgilarni turli maʼlumotlar toʻplamlarida qayta sinash va haqiqiy yoki proprietary sugʻurta maʼlumotlari bilan tashqi validatsiya oʻtkazish.
Bu texnikalar tavsiya sifatida berilganini ajratib koʻrsatish muhim: amaldagi tadqiqotda SHAP, SMOTE yoki cost-sensitive training qoʻllanmagan va ular boʻyicha yangi natija bayon qilinmagan.
Tadqiqot qoʻllab-quvvatlaydigan xulosalar
- Koʻrib chiqilgan maʼlumotlar toʻplamida tuned Decision Tree toʻrtta model ichida eng muvozanatli test natijasini bergan.
- Decision Tree uchun test accuracy %79, recall 0,6909, F1-score 0,6441 va MCC 0,4984.
- Random Forest %72 accuracy bergan boʻlsa-da, testdagi firibgarlik holatlarining birortasini ham toʻgʻri tasniflay olmagan.
- Logistic Regression va Naïve Bayesning firibgarlik boʻyicha recall qiymatlari juda past.
- Sinflari nomutanosib firibgarlik muammosida F1, recall va MCC accuracy oʻzi koʻrsatmaydigan model xatti-harakatini koʻrinadigan qilgan.
- Maʼlumotlarni tozalash va belgilarni tanlash model ishlab chiqish jarayonining muhim qismlaridir.
Tadqiqot qoʻllab-quvvatlamaydigan xulosalar
- Decision Tree barcha sugʻurta firibgarligi maʼlumotlar toʻplamlarida universal ravishda eng yaxshi model ekani koʻrsatilmagan.
- Model haqiqiy sugʻurta operatsiyasida %79 accuracy berishi isbotlanmagan.
- Random Forest umuman fraud detection uchun muvaffaqiyatsiz algoritm degan xulosa chiqarib boʻlmaydi; faqat ushbu tajribadagi tuzilma muvaffaqiyatsiz boʻlgan.
- Ayrim belgilar firibgarlikning sababiy omili ekani koʻrsatilmagan.
- Manba feature importance reytingi yoki SHAP tahlilini taqdim etmaydi.
- SMOTE, cost-sensitive learning yoki SHAP ushbu maʼlumotlar toʻplamida natijani yaxshilashi sinovdan oʻtkazilmagan.
- Modellar oʻrtasidagi farqlar statistik jihatdan ahamiyatli ekani formal tarzda koʻrsatilmagan.
- Tadqiqot haqiqiy sugʻurta operatsiyasida moliyaviy yoʻqotish kamayishini oʻlchamagan.
Manba va Usul Haqida Izoh
Toʻliq asl sarlavha: Comparative Analysis of Machine Learning Models for Insurance Fraud Detection.
PDFdagi mualliflar tartibi: Praise Owusu Oteng; Francis Mawuse Addae; Edward Tait Kwaw; Catherine Ewoenam Kwablavi; Bismark Sarkodie; Sandra Addai-Henne.
PDFdagi affiliasiya: Kwame Nkrumah University of Science and Technology, Department of Statistics and Actuarial Science, Kumasi, Ghana.
SSRN metadata-sidagi Contact Author: Praise Oteng.
Platforma: SSRN.
SSRN Abstract ID: 6899161.
DOI: 10.2139/ssrn.6899161.
Date Written: 2-sentabr 2025.
SSRNda nashr etilish/yuborilish: 30-iyun 2026.
Manba turi: Working paper / preprint.
Taqriz holati: Joriy bibliografik tekshiruvda taqrizdan oʻtgan jurnal versiyasi tasdiqlanmagan.
Litsenziya: Ochiq Creative Commons litsenziyasi tasdiqlanmagan. Verianla bayonida manba matni, asl rasm dizayni va asl jadval kompozitsiyasi qayta nashr etilmagan.
Maʼlumotlar: Kaggle orqali olingan insurance.claims.csv tuzilmaviy sugʻurta zararlar maʼlumotlar toʻplami.
Manbada bildirilgan oʻzgaruvchilar tuzilmasi: 40 ta mustaqil oʻzgaruvchi va fraud-reported Y/N maqsadi.
Test toʻplami: Manba confusion matrixlariga koʻra 200 ta yozuv; 55 ta firibgarlik va 145 ta firibgarlik boʻlmagan.
Train-test boʻlinishi: %80 / %20.
Yetishmayotgan maʼlumotlarni qayta ishlash: collision-type, property-damage, authorities-contacted va police-report-available uchun moda imputatsiyasi.
Multikollinearlik natijasi: months-as-customer bilan age oʻrtasida 0,92 korrelyatsiya; age va total-claim-amount modellashtirish toʻplamidan chiqarilgan.
Modellar: Decision Tree, Random Forest, Logistic Regression va Naïve Bayes.
Baholash metrikalari: Accuracy, Precision, Recall, F1-score va Matthews Correlation Coefficient.
Asosiy ishlash natijasi: Decision Tree — train accuracy 0,8225; test accuracy 0,7900; precision 0,6032; recall 0,6909; F1 0,6441; MCC 0,4984.
Muhim sinf nomutanosibligi natijasi: Random Forestning test accuracysi 0,7200 boʻlsa-da, recall, precision va F1 qiymatlari 0 va birorta firibgarlik holati toʻgʻri aniqlanmagan.
Manbada bayon qilinmagan qayta ishlab chiqarish tafsilotlari: Ishlatilgan kategorik encoding usuli, scaler, Decision Tree tuning parametrlari, Random Forest giperparametrlari, random seed, stratification, preprocessing fit tartibi va software/package versiyalari.
Cross-validation: Manbaning oʻz tajribasida bayon qilinmagan. Adabiyotlar boʻlimida boshqa tadqiqotda ten-fold cross-validation qoʻllangani tasvirlanadi; bu amaldagi tadqiqotning usuli emas.
Statistik taqqoslash: Model farqlari uchun confidence interval, p-qiymat yoki formal ahamiyatlilik testi bayon qilinmagan.
Amaliy muhitda tekshirish: Mavjud emas.
Jonli sugʻurta tizimiga integratsiya: Mavjud emas.
Izohlanuvchanlik tahlili: Feature importance yoki SHAP tahlili amaldagi tajribada bayon qilinmagan; SHAP kelajakdagi qoʻllanmalar uchun tavsiya etiladi.
Sinflarni muvozanatlash: SMOTE yoki cost-sensitive learning amaldagi tajribada qoʻllanmagan, kelajakdagi tadqiqot uchun tavsiya sifatida berilgan.
Manba ichidagi nomuvofiqlik: Random Forest matnidagi “perfect training accuracy” iborasi Table 2 jadvalidagi 0,7887 bilan mos kelmaydi.
Rasmga oid tahririy muammo: Bir rasm captioni “Enter Caption” holida qolgan; Decision Tree confusion matrix captionidagi “Initial Model” iborasi matritsada koʻrsatilgan tuned %79 natijasiga mos keladi.
Moliyalashtirish: Alohida moliyalashtirish bayonoti berilmagan.
Manfaatlar toʻqnashuvi: Alohida manfaatlar toʻqnashuvi bayonoti berilmagan.
Maʼlumotlarning mavjudligi: Kaggle manbasi koʻrsatilgan, biroq alohida dataset URL, versiya identifikatori yoki maʼlumotlar litsenziyasi bayonoti berilmagan.
CRediT / mualliflar hissasi: Alohida CRediT bayonoti berilmagan.
Minnatdorchilik: Mualliflar oʻz ishlarida Xudoga minnatdorchilik bildiradi va Dr. Sandra Addai-Henneʼning maslahat berish hissasini alohida qayd etadi.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan