


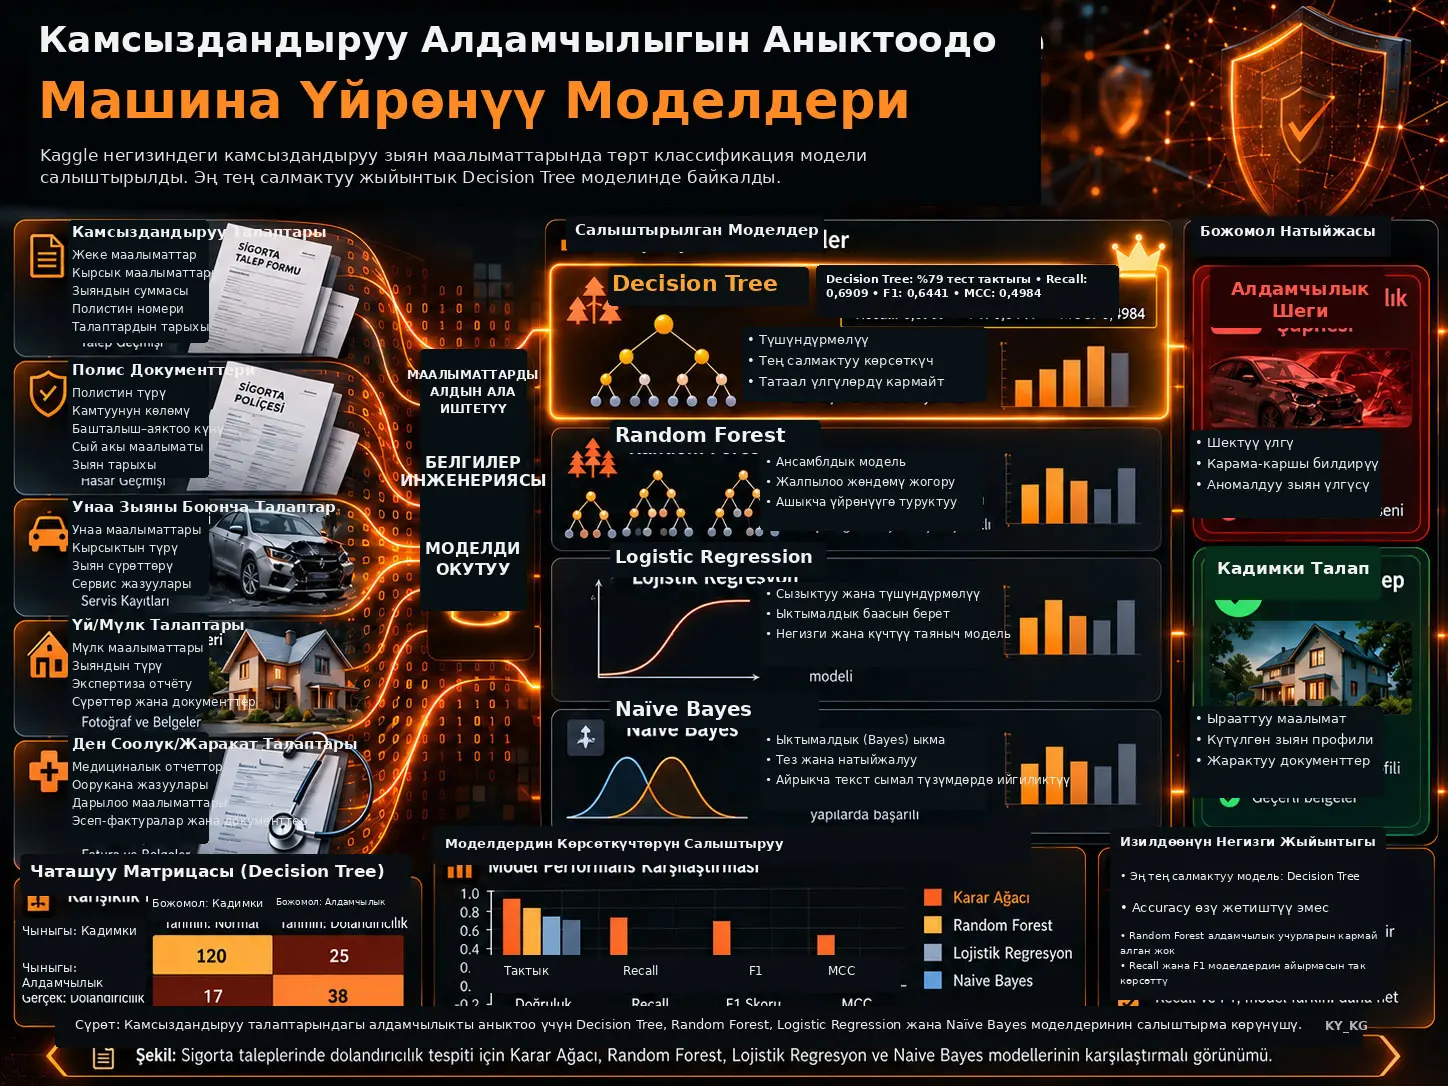
Көзөмөлдөнгөн машина үйрөнүүгө негизделген камсыздандыруу алдамчылыгын аныктоо, мурда алдамчылык же алдамчылык эмес деп белгиленген камсыздандыруу талаптарынан үлгүлөрдү үйрөнүп, жаңы талаптарды эки класстын бирине бөлүүгө багытталган бинардык классификация маселеси. Praise Owusu Oteng жана анын кесиптештери Kaggle аркылуу алынган insurance.claims.csv маалыматтар топтомунда Decision Tree, Random Forest, Logistic Regression жана Naïve Bayes моделдерин салыштырышкан. Маалыматтарды тазалоо жетишпеген маанилерди толтурууну, айрым жогорку кардиналдуулуктагы же тиешеси аз өзгөрмөлөрдү алып салууну, мультиколлинеардуулукту текшерүүнү жана булактын кыскача бөлүгүндө көрсөтүлгөн категориялык өзгөртүү менен масштабдоо кадамдарын камтыйт. Маалыматтар %80 окутуу жана %20 тест болуп бөлүнгөн; моделдер accuracy, precision, recall, F1-score жана Matthews Correlation Coefficient (MCC) менен бааланган. Жөндөлгөн Decision Tree %79 test accuracy, 0,6032 precision, 0,6909 recall, 0,6441 F1-score жана 0,4984 MCC менен каралган төрт моделдин ичинен эң тең салмактуу натыйжа берген.
Изилдөөнүн эң маанилүү үйрөтүүчү жыйынтыгы — алдамчылык сыяктуу азчылык класс бар маалыматтар топтомунда жогорку accuracy мааниси өзүнчө эле алдамчылыкты ийгиликтүү аныктоону билдирбейт. Random Forest тест маалыматтарында %72 accuracy көрсөткөнү менен, алдамчылык классындагы 55 жазуунун бирин да туура аныктай алган эмес. Logistic Regression болгону 3, ал эми Naïve Bayes болгону 2 алдамчылык учурду туура классификациялаган. Decision Tree ошол эле 55 учурдун ичинен 38 учурду туура аныктаган. Ошондуктан моделдердин иретин аныктаган негизги айырма жалпы тактык гана эмес, азчылыктагы алдамчылык классын кармоо жөндөмү жана эки класстагы каталарды бирге эске алган F1 жана MCC өлчөмдөрү болуп саналат.
Натыйжалар бир гана жалпыга ачык тарыхый маалыматтар топтому жана бир train/test бөлүнүшү менен чектелет. Булак hyperparameter tuning деталдарын, колдонулган encoding/scaling ыкмаларын, random seed'ди, stratification маалыматын же cross-validation натыйжаларын билдирбейт. Моделдер чыныгы камсыздандыруу компаниясынын иштеп турган зыяндарды башкаруу системасында сыналган эмес. Ошондуктан Decision Treeнин ушул маалыматтар топтомундагы артыкчылыгы бардык камсыздандыруу маалыматтарында же реалдуу операцияларда дал ушул модель сөзсүз эң жакшы болот дегенди билдирбейт.
Изилдөө маселеси
Камсыздандыруу алдамчылыгы — жараксыз же бурмаланган талаптарды камсыздандыруучудан финансылык пайда алуу максатында берүү менен байланышкан кеңири маселе. Булак алдамчылык жүрүм-турум саламаттык, өмүр, мүлк жана автотранспорт камсыздандыруусу сыяктуу ар кандай тармактарда кездешиши мүмкүн экенин жана салттуу кол менен текшерүү же туруктуу эрежелерге негизделген системалар өзгөрүп турган алдамчылык үлгүлөрүн кармоодо кыйналышы мүмкүн экенин баса белгилейт.
Бул изилдөөнүн алкагында машина үйрөнүүнүн негизги артыкчылыгы — мурда белгиленген зыян жазууларындагы көп өзгөрмөлүү үлгүлөрдү үйрөнүп, жаңы талаптар үчүн алдамчылык ыктымалдыгы боюнча автоматтык классификация бере алышы. Бирок кайсы алгоритм эң жакшы экени маалыматтардын бөлүштүрүлүшүнө, белгилерге, алдамчылык классынын үлүшүнө жана баалоо метрикасына көз каранды.
Изилдөөнүн суроолору
Булак үч негизги суроого көңүл бурат: машина үйрөнүү алдамчылык талаптарын канчалык деңгээлде аныктай алат, каралган төрт алгоритмдин кайсынысы эң ишенимдүү классификацияны берет жана машина үйрөнүүнүн натыйжалары алдамчылыкты текшерүү процессин кандай жолдор менен колдой алат.
Маалыматтар топтому
Изилдөөдө колдонулган маалымат файлы insurance.claims.csv деп аталат жана Kaggle аркылуу алынган. Булак маалымат түзүмүн 40 көз карандысыз өзгөрмөсү бар түзүмдөштүрүлгөн камсыздандыруу зыяндарынын маалыматтар топтому катары сүрөттөйт.
Өзгөрмөлөрдүн топторуна төмөнкүлөр кирет:
- кардардын демографиясы: жаш курак, билим, кесип сыяктуу маалыматтар,
- полис маалыматы: deductible жана жылдык премия сыяктуу белгилер,
- окуя маалыматы: окуянын түрү, окуянын оордугу жана унаалардын саны,
- зыян маалыматы: injury, property жана vehicle claim суммалары,
- максаттуу өзгөрмө: fraud-reported = Y же N
камтылат.
Булак Data Description бөлүмүндө жалпы тандалманын көлөмүн өзүнчө “N = ...” сабы менен бербейт. Бирок %80:%20 бөлүнүшү жана бардык confusion matrix'терде 200 тест жазуусунун көрүнүшү талданган маалымат көлөмү 1.000 жазуудан турган түзүмгө шайкеш экенин көрсөтөт. Булактын Table 3 бөлүгүндө Vehicle Claims үчүн да жалпы 1.000 жазуу берилген.
Жетишпеген маанилерди иштетүү
| Өзгөрмө | Жетишпеген маанилердин саны | Булакта колдонулган иштетүү |
|---|---|---|
| collision-type | 178 | Мода менен толтуруу |
| property-damage | 360 | Мода менен толтуруу |
| authorities-contacted | 91 | Мода менен толтуруу |
| police-report-available | 343 | Мода менен толтуруу |
Мода импутациясы — тиешелүү өзгөрмөдө эң көп кездешкен категорияны жетишпеген жазуулардын ордуна коюу. Бул ыкма маалымат саптарын өчүрбөстөн тандалманы сактайт; бирок жетишпеген категориялардын чыныгы бөлүштүрүлүшүн туура чагылдырат деп кепилдик берилбейт.
Булак импутация процесси окутуу маалыматтарында гана үйрөнүлүп, тест маалыматтарына колдонулганбы же train/test бөлүнүшүнө чейин бардык маалымат боюнча эсептелгенби, муну так көрсөтпөйт. Ошондуктан preprocessing тизмеги мүмкүн болгон маалымат агып кетүүсү жагынан кандай колдонулганын булактан ырастоо мүмкүн эмес.
Алып салынган өзгөрмөлөр
Булак моделдөө үчүн пайдасы чектелүү же кардиналдуулугу жогору деген негизде policy-number, policy-bind-date, incident-date, policy-state, incident-state, incident-city, incident-location, insured.zip, insured-hobbies, auto-make, auto-model, auto-year жана CSV форматтоосунан пайда болгон кошумча тилкени алып салат.
Бул чечимдердин бир бөлүгү маалыматтын өлчөмүн жана категориялык татаалдыкты азайтууга багытталган. Бирок дата жана география өзгөрмөлөрү алдамчылык боюнча пайдалуу маалымат алып жүрөбү же жокпу өзүнчө текшерилген эмес; изилдөөдө бул өзгөрмөлөр түздөн-түз моделден чыгарылган.
Мультиколлинеардуулукту текшерүү
Булактын корреляциялык талдоосунда months-as-customer менен age ортосунда 0,92 оң корреляция табылган. Injury-claim, property-claim жана vehicle-claim компоненттеринин total-claim-amount менен жогорку корреляцияга ээ экени да белгиленет. Натыйжада age жана total-claim-amount белгилери моделдөө топтомунан чыгарылган.
Булак 4-бетте үч бурчтуу корреляциялык heatmap берет. Бул визуалдын илимий ролу айрым сандык белгилер бир эле маалыматты күчтүү кайталарын көрсөтүү; heatmap моделдин иштешин түздөн-түз өлчөбөйт.
Категориялык өзгөртүү жана масштабдоо боюнча отчеттук боштук
Булактын abstract бөлүгүндө категориялык маалыматтар сандык формага айландырылганы жана ылайыктуу scaling операциялары колдонулганы айтылат. Бирок метод бөлүмүндө колдонулган encoding алгоритминин аты, категориялык деңгээлдер кандай иштетилгени же StandardScaler, MinMaxScaler сыяктуу белгилүү бир масштабдоочу колдонулган-колдонулбаганы берилбейт.
Бул жетишсиздик өзгөчө Logistic Regression жана Naïve Bayes сыяктуу preprocessing формасына сезимтал моделдердин кайра өндүрүлүшү үчүн маанилүү.
Окутуу жана тестке бөлүү
Булак маалыматтар топтомун %80 окутуу жана %20 тест болуп бөлгөн. Cross-validation, көз карандысыз validation set же тышкы тест маалыматтар топтому билдирилген эмес.
Random seed же split маалында fraud/non-fraud катышы stratification аркылуу сакталган-сакталбаганы да көрсөтүлгөн эмес. Ошондуктан бир splitте байкалган моделдердин ирети башка бөлүнүштө канчалык туруктуу болорун булактан аныктоо мүмкүн эмес.
Decision Tree кандай иштейт?
Decision Tree ар бир түйүндө бир белги боюнча маалыматтар топтомун бир тектүүрөөк чакан топторго бөлүп, жалбырак түйүндө класс боюнча чечим чыгарган иерархиялык классификатор. Изилдөө бөлүнүүнүн сапатын түшүндүрүү үчүн Gini impurity, entropy жана information gain формулаларын берет.
\[ Gini(S)=1-\sum_{i=1}^{n}p_i^2 \]
\(p_i\) — \(S\) түйүнүндөгү \(i\)-класстын үлүшү. Таза түйүндө байкоолордун баары бир класска таандык болуп, Gini impurity азаят.
\[ E(S)=-\sum_{i=1}^{n}p_i\log_2(p_i) \]
Entropy да класстардын аралашуусун өлчөйт. Бир тектүүрөөк түйүндө entropy төмөн болот.
\(A\) белгиси боюнча бөлүнүүнүн маалыматтык утушу:
\[ IG(S,A)=E(S)-\sum_{v\in Values(A)} \frac{|S_v|}{|S|}E(S_v) \]
түрүндө берилет. Жогорку information gain бөлүнүү класстын белгисиздигин көбүрөөк азайтарын билдирет.
Logistic Regression
Logistic Regression белгилердин сызыктуу айкалышын алдамчылык классына таандык болуу ыктымалдыгына айлантат. Булак колдонгон logit формасы:
\[ \ln\left(\frac{P(Y)}{1-P(Y)}\right) = \beta_0+\beta_1X_1+\beta_2X_2+\cdots+\beta_kX_k \]
жана ага туура келген ыктымалдык:
\[ P(Y)= \frac{e^{\beta_0+\beta_1X_1+\cdots+\beta_kX_k}} {1+e^{\beta_0+\beta_1X_1+\cdots+\beta_kX_k}} \]
түрүндө берилет. \(X_i\) киргизүү белгилерин, \(\beta_i\) модель коэффициенттерин, ал эми \(P(Y)\) максаттуу класстын болжолдонгон ыктымалдыгын билдирет.
Random Forest
Random Forest ар кандай маалымат жана белги чакан топторунда көптөгөн чечим дарактарын түзүп, алардын классификациялык чечимдерин бириктирген ensemble ыкмасы. Максат — бир дарактын белгилүү окутуу мисалдарына ашыкча ылайыкташуу коркунучун азайтуу.
Бул изилдөөдө Random Forest тест топтомундагы алдамчылык классын толугу менен өткөрүп жиберген. Булак колдонулган дарактардын санын, maximum depthти, feature sampling катышын, class-weightти же башка Random Forest гиперпараметрлерин билдирбейт.
Naïve Bayes
Naïve Bayes модели Байес теоремасына негизделет:
\[ P(C\mid X)=\frac{P(X\mid C)P(C)}{P(X)} \]
Шарттуу көз карандысыздык божомолунда:
\[ P(C\mid X)\propto P(C)\prod_{i=1}^{n}P(x_i\mid C) \]
түрүнө өтөт. Бул жерде \(C\) алдамчылык же алдамчылык эмес классты, \(X\) байкалган белгилердин жыйындысын билдирет. “Naïve” божомолу класс белгилүү болгондо белгилер бири-биринен шарттуу түрдө көз карандысыз деп кабыл алынарын билдирет.
Камсыздандыруу Алдамчылыгын Аныктоодо Accuracy Эмне Үчүн Өзүнчө Жетиштүү Эмес?
Accuracy бардык туура божомолдордун жалпы мисалдарга катышын өлчөгөндүктөн, алдамчылык сыяктуу азчылык классы бар тест топтомунда дайыма көпчүлүк классты тандаган модель жогорку көрсөткүч бере алат; бул изилдөөдө 200 тест жазуусунун ичинен 145 жазуу алдамчылык эмес жана 55 жазуу алдамчылык болгон учурда Random Forest %72 test accuracy көрсөткөн, бирок алдамчылык учурларынын бирин да туура аныктаган эмес. Ошондуктан recall, F1-score жана MCC алдамчылык классындагы ийгиликсиздикти accuracyге караганда даана көрсөтөт.
Чаташуу матрицасы
| Чыныгы / Божомол | Болжолдонгон Алдамчылык | Болжолдонгон Алдамчылык Эмес |
|---|---|---|
| Чыныгы Алдамчылык | Туура Оң (TP) | Жалган Терс (FN) |
| Чыныгы Алдамчылык Эмес | Жалган Оң (FP) | Туура Терс (TN) |
Туура Оң, алдамчылык учурдун туура түрдө алдамчылык деп белгилениши. Жалган Терс, алдамчылык учурдун система тарабынан өткөрүлүп жиберилиши. Жалган Оң, чыныгы талаптын жаңылыш түрдө алдамчылык деп белгилениши; Туура Терс болсо алдамчылык эмес жазуунун туура классификацияланышы.
Accuracy
\[ Accuracy= \frac{TP+TN}{TP+TN+FP+FN} \]
Accuracy жалпы классификация тактыгын көрсөтөт, бирок класстардын бөлүштүрүлүшүн эске албайт.
Precision
\[ Precision=\frac{TP}{TP+FP} \]
Precision модель алдамчылык деп белгилеген талаптардын канчасы чындап алдамчылык экенин өлчөйт.
Recall
\[ Recall=\frac{TP}{TP+FN} \]
Recall чыныгы алдамчылык учурлардын канчасын модель кармаганын өлчөйт. Fraud detection контекстинде төмөн recall көптөгөн алдамчылык учурлар өткөрүлүп жиберилгенин билдирет.
F1-score
\[ F1= 2\times \frac{Precision\times Recall} {Precision+Recall} \]
F1-score precision менен recall ортосундагы тең салмакты бир мааниге жыйынтыктайт.
Matthews Correlation Coefficient
\[ MCC= \frac{(TP\times TN)-(FP\times FN)} {\sqrt{(TP+FP)(TP+FN)(TN+FP)(TN+FN)}} \]
MCC чаташуу матрицасынын төрт уячасын бир учурда колдонгондуктан, класстары тең салмаксыз болгон бинардык классификация маселелеринде пайдалуу жыйынтыктоочу метрика. Жогорку оң маани туруктуураак классификацияны, нөлгө жакын маани алсыз байланышты, ал эми терс маани божомолдор менен чыныгы класстардын ортосунда тескери багыттагы көрсөткүчтү билдирет.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Моделдердин көрсөткүчтөрүн салыштыруу
| Модель | Train Accuracy | Test Accuracy | Precision | Recall | F1-score | MCC |
|---|---|---|---|---|---|---|
| Decision Tree | 0,8225 | 0,7900 | 0,6032 | 0,6909 | 0,6441 | 0,4984 |
| Random Forest | 0,7887 | 0,7200 | 0,0000 | 0,0000 | 0,0000 | -0,0437 |
| Logistic Regression | 0,7512 | 0,6950 | 0,2500 | 0,0545 | 0,0896 | -0,0141 |
| Naïve Bayes | 0,7462 | 0,7000 | 0,2222 | 0,0364 | 0,0625 | -0,0257 |
Бул Изилдөөдө Кайсы Машина Үйрөнүү Модели Эң Жакшы Натыйжа Берди?
Каралган жалгыз Kaggle маалыматтар топтому жана колдонулган %80:%20 train-test бөлүнүшүндө Decision Tree эң тең салмактуу модель болгон; %79 test accuracy, 0,6909 recall, 0,6441 F1-score жана 0,4984 MCC менен башка үч моделге караганда алдамчылыкты жакшыраак классификациялаган. Бул жыйынтык изилдөөнүн маалыматтары жана эксперименттик түзүлүшү үчүн гана жарактуу жана Decision Tree бардык камсыздандыруу маалыматтар топтомдорунда универсалдуу эң жакшы модель экенин көрсөтпөйт.
Decision Tree натыйжалары
Булак алгачкы Decision Tree модели %100 training accuracy жана %71 test accuracy көрсөтүп, overfitting белгисин бергенин айтат. Hyperparameter tuningден кийин окутуу accuracyси %82,25 деңгээлине төмөндөп, test accuracy %79 деңгээлине жогорулаган.
Тест confusion matrix:
| Decision Tree натыйжасы | Саны |
|---|---|
| Туура Терс | 120 |
| Жалган Оң | 25 |
| Жалган Терс | 17 |
| Туура Оң | 38 |
Decision Tree 55 чыныгы алдамчылык учурдун ичинен 38 учурду кармап, 17 учурду өткөрүп жиберген. Булак tuningден кийин окутуу жана тест accuracy маанилеринин бири-бирине жакындашын generalization жагынан оң баалайт.
Бирок колдонулган tuning параметрлери же tuning процедурасы билдирилбегендиктен, бул натыйжаны өз алдынча толук кайталап чыгаруу мүмкүн эмес.
Random Forest натыйжалары
| Random Forest натыйжасы | Саны |
|---|---|
| Туура Терс | 144 |
| Жалган Оң | 1 |
| Жалган Терс | 55 |
| Туура Оң | 0 |
Random Forest 145 алдамчылык эмес жазуунун ичинен 144 жазууну туура классификациялаганы менен, 55 алдамчылык учурдун баарын өткөрүп жиберген. Мунун натыйжасында precision, recall жана F1-score маанилеринин баары нөл болгон.
Булак текстинде Random Forest үчүн “perfect training accuracy” деген сөз айкашы колдонулат; бирок негизги көрсөткүчтөр таблицасында training accuracy 0,7887 деп берилген. Бул эки маани бири-бирине дал келбегендиктен, Verianla баянында ачык сандык булак таблицасы негиз катары алынат.
Logistic Regression натыйжалары
| Logistic Regression натыйжасы | Саны |
|---|---|
| Туура Терс | 136 |
| Жалган Оң | 9 |
| Жалган Терс | 52 |
| Туура Оң | 3 |
Logistic Regression %69,5 test accuracy көрсөткөн; бирок 55 алдамчылык учурдун ичинен 3 учурду туура аныктаган. Recall 0,0545, F1-score 0,0896 жана MCC -0,0141. Ошондуктан жалпы accuracy алдамчылык классындагы чыныгы көрсөткүчтү реалдуудан күчтүүрөөк көрсөтүшү мүмкүн.
Naïve Bayes натыйжалары
| Naïve Bayes натыйжасы | Саны |
|---|---|
| Туура Терс | 138 |
| Жалган Оң | 7 |
| Жалган Терс | 53 |
| Туура Оң | 2 |
Naïve Bayes %70 test accuracy көрсөткөнү менен, алдамчылык учурлардын болгону 2 учурду кармаган. Recall 0,0364 жана MCC -0,0257. Бул жыйынтык majority class ийгилигин алдамчылыкты аныктоо ийгилиги менен чаташтырбоо керектигин да көрсөтөт.
Алдамчылык учурлардын моделдер тарабынан кармалышы
| Модель | Чыныгы Алдамчылык | Туура Кармалган Алдамчылык | Өткөрүлүп Жиберилген Алдамчылык |
|---|---|---|---|
| Decision Tree | 55 | 38 | 17 |
| Random Forest | 55 | 0 | 55 |
| Logistic Regression | 55 | 3 | 52 |
| Naïve Bayes | 55 | 2 | 53 |
Бул таблица изилдөөдөгү практикалык модель айырмасын accuracy таблицасына караганда даана көрсөтөт. Decision Tree тесттеги алдамчылык учурлардын олуттуу бөлүгүн кармаса, калган үч модель азчылыктагы алдамчылык классына карата олуттуу көрсөткүч жоготуусун көрсөтөт.
Зыян түрлөрү боюнча булак таблицасы
| Зыян компоненти | Жалпы жазуу | Алдамчылык катары билдирилген жазуу |
|---|---|---|
| Дене Жаракаты Боюнча Талаптар | 975 | 238 |
| Мүлк Зыяны Боюнча Талаптар | 981 | 241 |
| Унаа Боюнча Талаптар | 1000 | 247 |
Булак бул сандарды Table 3 астында билдирет. Булар бири-биринен көз карандысыз үч өзүнчө тандалма катары чечмеленбеши керек; бир эле камсыздандыруу жазуусунда injury, property жана vehicle claim компоненттери болушу мүмкүн.
Белгилерди чечмелөөнүн чеги
Булак discussion бөлүгүндө жогорку claim amount, missing police report жана айрым incident characteristics сыяктуу өзгөрмөлөр алдамчылыктын көрсөткүчү болушу мүмкүн экенин айтат. Бирок изилдөөдө feature-importance графиги, SHAP мааниси, permutation importance, Logistic Regression коэффициенттеринин маанилүүлүгү же башка сандык түшүндүрмөлүүлүк талдоосу берилген эмес.
Ошондуктан бул белгилер булак авторлорунун байкоого/моделге негизделген чечмелөөлөрү; бул PDFтен кайсы өзгөрмө “эң күчтүү алдамчылык аныктагыч” экенин сандык түрдө иреттөө мүмкүн эмес.
Бул Натыйжалар Чыныгы Камсыздандыруу Системаларындагы Иштеп Турган Көрсөткүчтү Далилдейби?
Жок. Моделдер жалпыга ачык тарыхый маалыматтар топтомунда бир train-test бөлүнүшү менен бааланып, чыныгы камсыздандыруу компаниясынын иштеп турган claim-processing системасына интеграцияланган эмес; демек билдирилген %79 Decision Tree accuracy же башка метрикалар реалдуу талаадагы көрсөткүчкө кепилдик бербейт жана башка өлкөдө, продуктта, алдамчылык түрүндө же маалымат бөлүштүрүлүшүндө кайра текшерүүнү талап кылат.
Изилдөөнүн өз чектөөлөрү
- Жалпыга ачык маалыматтар чыныгы камсыздандыруу операцияларынын бардык татаалдыгын чагылдырбашы мүмкүн.
- Ар бир моделдин божомолдору маалымат түзүмүнө толук туура келбеши мүмкүн.
- Моделдер тарыхый маалыматтарда гана сыналган.
- Иштеп турган камсыздандыруу системасына интеграция жасалган эмес.
- Изилдөөнүн биринчи чектөө түшүндүрмөсү түшүндүрмөлүүлүк талдоосу чектелүү экенин кабыл алат.
- Натыйжаларды башка өлкөлөргө, тармактарга же маалыматтар топтомдоруна түздөн-түз көчүрүүгө кепилдик берилбейт.
Кайра өндүрүлүүгө байланышкан кошумча чектөөлөр
- Decision Tree tuning параметрлери билдирилбейт.
- Random Forest гиперпараметрлери билдирилбейт.
- Encoding жана scaling ыкмалары так аталбайт.
- Random seed жана stratified splitting маалыматы берилбейт.
- Cross-validation колдонулган натыйжа билдирилбейт.
- Көз карандысыз тышкы тест топтому жок.
- Confidence interval же формалдуу моделдерди салыштыруу маанилүүлүк тести билдирилбейт.
- AUC-ROC, PR-AUC же calibration метрикасы берилбейт.
- Жалган оң жана жалган терс жыйынтыктардын экономикалык наркы моделденген эмес.
Булак ичиндеги редакциялык жана сандык дал келбестиктер
- Decision Tree confusion matrix сандары tuned моделдин %79 натыйжасына туура келгени менен, тиешелүү caption “Initial Model” деген сөз айкашын камтыйт.
- Бир сүрөттүн аталышы “Figure 5: Enter Caption” түрүндө толтурулбай калган.
- Random Forest түшүндүрмөсү perfect training accuracy деп айтса, Table 2 training accuracyни 0,7887 деп берет.
- Abstract категориялык өзгөртүү жана scaling колдонулганын айтат, бирок метод бөлүмүндө алардын техникалык деталдары берилбейт.
Изилдөөнүн сунуштары
Булак келечектеги колдонмолор үчүн төрт багытты сунуштайт. Биринчиси — тактык менен катар түшүндүрмөлүүлүктү жогорулатуу үчүн SHAP сыяктуу куралдарды колдонуу. Экинчиси — ML упайларын эксперттик эрежелер менен айкалыштыруу. Үчүнчүсү — класстардын тең салмаксыздыгы үчүн SMOTE, cost-sensitive алгоритмдер же ensemble ыкмаларын баалоо. Төртүнчүсү — белгилерди ар башка маалыматтар топтомдорунда кайра текшерип, чыныгы же proprietary камсыздандыруу маалыматтары менен тышкы валидация жүргүзүү.
Бул техникалар сунуш катары берилгенин эске алуу маанилүү: учурдагы изилдөөдө SHAP, SMOTE же cost-sensitive training колдонулган эмес жана алар боюнча жаңы көрсөткүч натыйжалары билдирилген эмес.
Изилдөө колдогон жыйынтыктар
- Каралган маалыматтар топтомунда tuned Decision Tree төрт моделдин ичинен эң тең салмактуу тест көрсөткүчүн берген.
- Decision Tree үчүн test accuracy %79, recall 0,6909, F1-score 0,6441 жана MCC 0,4984.
- Random Forest %72 accuracy көрсөткөнү менен, тесттеги алдамчылык учурлардын бирин да туура классификациялай алган эмес.
- Logistic Regression жана Naïve Bayes моделдеринин алдамчылык боюнча recall маанилери өтө төмөн.
- Класстар тең салмаксыз болгон алдамчылык маселесинде F1, recall жана MCC accuracy өзүнчө көрсөтпөгөн модель жүрүм-турумун даана кылган.
- Маалыматтарды тазалоо жана белгилерди тандоо модель иштеп чыгуу процессинин маанилүү бөлүктөрү.
Изилдөө колдобогон жыйынтыктар
- Decision Tree бардык камсыздандыруу алдамчылыгы маалыматтар топтомдорунда универсалдуу эң жакшы модель экени көрсөтүлгөн эмес.
- Модель чыныгы камсыздандыруу операциясында %79 accuracy берет деп далилденген эмес.
- Random Forest жалпы fraud detection үчүн ийгиликсиз алгоритм деген жыйынтык чыгарууга болбойт; ушул эксперименттеги түзүлүш гана ийгиликсиз болгон.
- Айрым белгилер алдамчылыктын себептик себеби экени көрсөтүлгөн эмес.
- Булак feature importance рейтингин же SHAP талдоосун бербейт.
- SMOTE, cost-sensitive learning же SHAP бул маалыматтар топтомунда көрсөткүчтү жакшыртары текшерилген эмес.
- Моделдердин айырмасы статистикалык жактан маанилүү экени формалдуу түрдө көрсөтүлгөн эмес.
- Изилдөө чыныгы камсыздандыруу операциясында финансылык жоготуунун азайышын өлчөгөн эмес.
Булак жана Ыкма Жөнүндө Эскертүү
Толук түпнуска аталышы: Comparative Analysis of Machine Learning Models for Insurance Fraud Detection.
PDFдеги авторлордун ирети: Praise Owusu Oteng; Francis Mawuse Addae; Edward Tait Kwaw; Catherine Ewoenam Kwablavi; Bismark Sarkodie; Sandra Addai-Henne.
PDFдеги аффилиация: Kwame Nkrumah University of Science and Technology, Department of Statistics and Actuarial Science, Kumasi, Ghana.
SSRN metadataсындагы Contact Author: Praise Oteng.
Платформа: SSRN.
SSRN Abstract ID: 6899161.
DOI: 10.2139/ssrn.6899161.
Date Written: 2-сентябрь 2025.
SSRNде жарыялануу/жөнөтүлүү: 30-июнь 2026.
Булактын түрү: Working paper / preprint.
Рецензиялоо абалы: Учурдагы библиографиялык текшерүүдө рецензияланган журналдык версия ырасталган эмес.
Лицензия: Ачык Creative Commons лицензиясы ырасталган эмес. Verianla баянында булак тексти, түпнуска сүрөт дизайны жана түпнуска таблица композициясы кайра жарыяланган эмес.
Маалыматтар: Kaggle аркылуу алынган insurance.claims.csv түзүмдөштүрүлгөн камсыздандыруу зыяндарынын маалыматтар топтому.
Булакта билдирилген өзгөрмөлөрдүн түзүмү: 40 көз карандысыз өзгөрмө жана fraud-reported Y/N максаты.
Тест топтому: Булактын confusion matrixтерине ылайык 200 жазуу; 55 алдамчылык жана 145 алдамчылык эмес.
Train-test бөлүнүшү: %80 / %20.
Жетишпеген маалыматтарды иштетүү: collision-type, property-damage, authorities-contacted жана police-report-available үчүн мода импутациясы.
Мультиколлинеардуулук натыйжасы: months-as-customer менен age ортосунда 0,92 корреляция; age жана total-claim-amount моделдөө топтомунан чыгарылган.
Моделдер: Decision Tree, Random Forest, Logistic Regression жана Naïve Bayes.
Баалоо метрикалары: Accuracy, Precision, Recall, F1-score жана Matthews Correlation Coefficient.
Негизги көрсөткүч натыйжасы: Decision Tree — train accuracy 0,8225; test accuracy 0,7900; precision 0,6032; recall 0,6909; F1 0,6441; MCC 0,4984.
Маанилүү класс тең салмаксыздыгынын жыйынтыгы: Random Forestтун test accuracyси 0,7200 болгону менен, recall, precision жана F1 маанилери 0 жана бир да алдамчылык учур туура кармалган эмес.
Булакта түшүндүрүлбөгөн кайра өндүрүлүү деталдары: Колдонулган категориялык encoding ыкмасы, scaler, Decision Tree tuning параметрлери, Random Forest гиперпараметрлери, random seed, stratification, preprocessing fit ирети жана software/package версиялары.
Cross-validation: Булактын өз экспериментинде билдирилбейт. Адабият бөлүмүндө башка бир изилдөөнүн ten-fold cross-validation колдонушу сүрөттөлөт; бул учурдагы изилдөөнүн ыкмасы эмес.
Статистикалык салыштыруу: Моделдердин айырмасы үчүн confidence interval, p-маани же формалдуу маанилүүлүк тести билдирилбейт.
Талаада текшерүү: Жок.
Иштеп турган камсыздандыруу системасына интеграция: Жок.
Түшүндүрмөлүүлүк талдоосу: Feature importance же SHAP талдоосу учурдагы экспериментте билдирилбейт; SHAP келечектеги колдонмолор үчүн сунушталат.
Класстарды тең салмактоо: SMOTE же cost-sensitive learning учурдагы экспериментте колдонулган эмес, келечектеги изилдөөгө сунуш катары берилген.
Булак ичиндеги дал келбестик: Random Forest текстиндеги “perfect training accuracy” сөз айкашы Table 2 таблицасындагы 0,7887 менен дал келбейт.
Редакциялык сүрөт маселеси: Бир сүрөт captionы “Enter Caption” бойдон калган; Decision Tree confusion matrix captionындагы “Initial Model” сөз айкашы матрицада көрсөтүлгөн tuned %79 натыйжасына дал келет.
Каржылоо: Өзүнчө каржылоо жөнүндө билдирүү берилген эмес.
Кызыкчылыктардын кагылышы: Өзүнчө кызыкчылыктардын кагылышы жөнүндө билдирүү берилген эмес.
Маалыматтардын жеткиликтүүлүгү: Kaggle булагы көрсөтүлгөн, бирок өзүнчө dataset URLи, версия идентификатору же маалымат лицензиясы жөнүндө билдирүү берилген эмес.
CRediT / авторлордун салымы: Өзүнчө CRediT билдирүүсү берилген эмес.
Ыраазычылык: Авторлор өз эмгегинде Кудайга ыраазычылык билдирип, Dr. Sandra Addai-Henneнин кеңешчилик салымын өзүнчө белгилешет.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген