


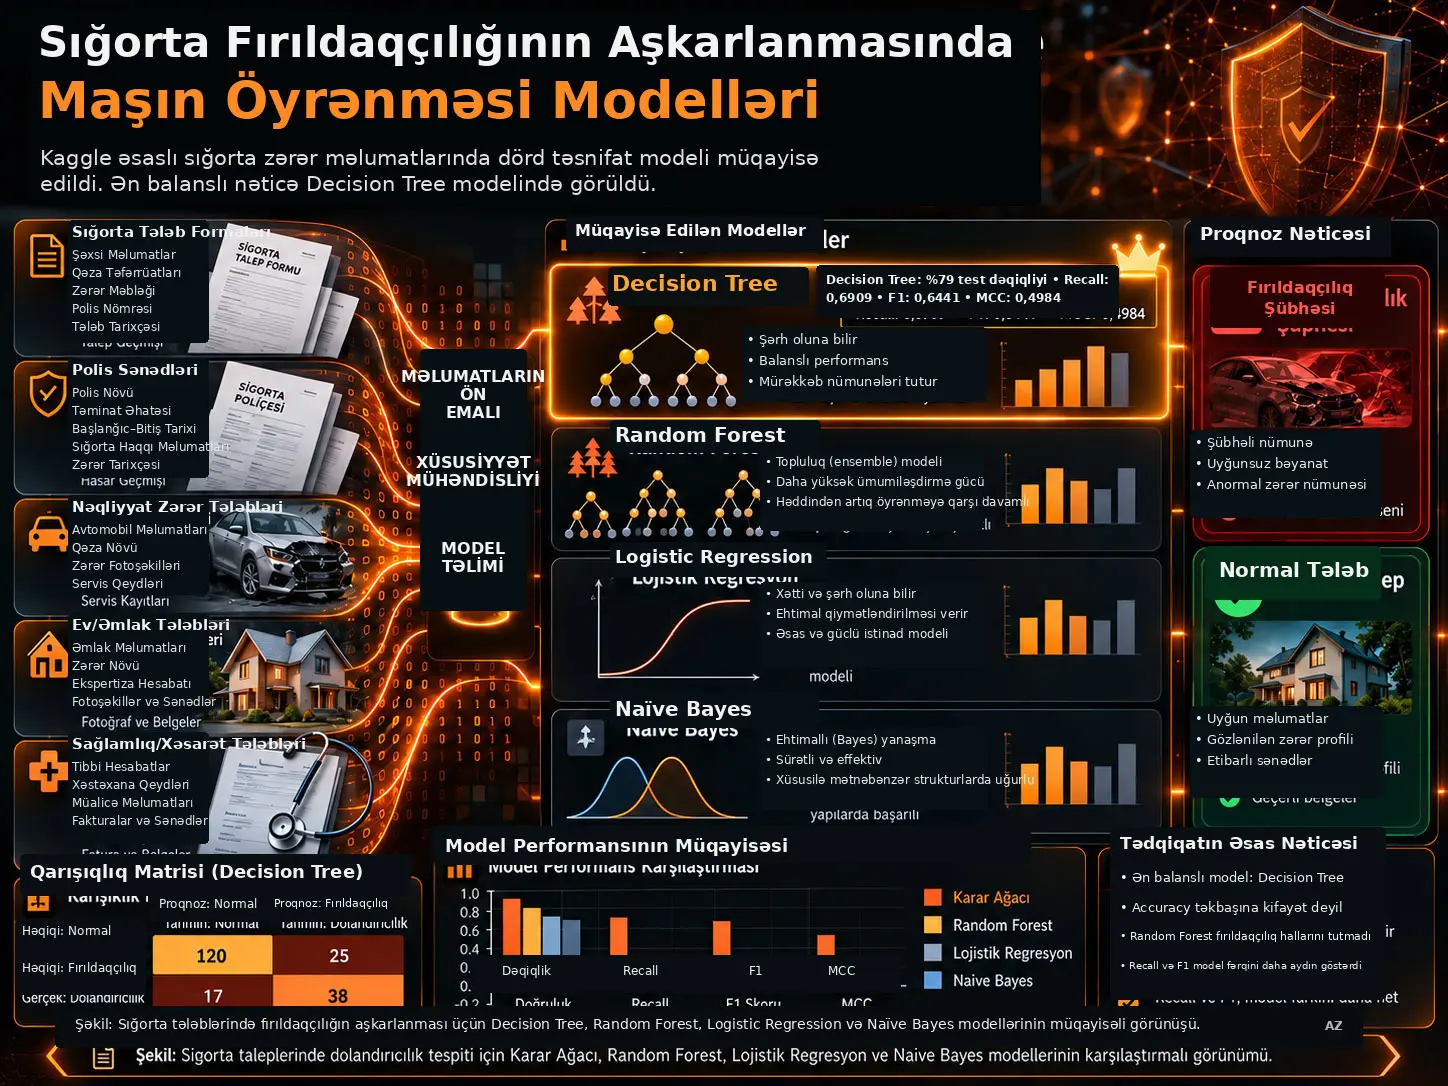
Nəzarətli maşın öyrənməsinə əsaslanan sığorta fırıldaqçılığının aşkarlanması, keçmişdə fırıldaqçılıq və ya fırıldaqçılıq olmayan kimi etiketlənmiş sığorta tələblərindən nümunələri öyrənərək yeni tələbləri iki sinifdən birinə ayırmağı hədəfləyən ikili təsnifat problemidir. Praise Owusu Oteng və həmkarları Kaggle vasitəsilə əldə edilmiş insurance.claims.csv verilənlər dəstində Decision Tree, Random Forest, Logistic Regression və Naïve Bayes modellərini müqayisə etmişlər. Verilənlərin təmizlənməsi; çatışmayan dəyərlərin doldurulmasını, bəzi yüksək kardinallıqlı və ya əlaqəsiz dəyişənlərin çıxarılmasını, multikolinearlıq yoxlamasını və mənbənin xülasəsində göstərilən kateqorik çevirmə ilə miqyaslama mərhələlərini əhatə edir. Verilənlər %80 təlim və %20 test olaraq bölünmüş; modellər accuracy, precision, recall, F1-score və Matthews Correlation Coefficient (MCC) ilə qiymətləndirilmişdir. Tənzimlənmiş Decision Tree %79 test accuracy, 0,6032 precision, 0,6909 recall, 0,6441 F1-score və 0,4984 MCC ilə araşdırılan dörd model arasında ən balanslı nəticəni vermişdir.
Tədqiqatın ən mühüm öyrədici nəticəsi odur ki, fırıldaqçılıq kimi azlıq sinfinin olduğu verilənlər dəstində yüksək accuracy dəyəri təkbaşına uğurlu fırıldaqçılıq aşkarlanması demək deyil. Random Forest test verilənlərində %72 accuracy əldə etsə də, fırıldaqçılıq sinfindəki 55 qeydin heç birini düzgün aşkarlaya bilməmişdir. Logistic Regression yalnız 3, Naïve Bayes isə yalnız 2 fırıldaqçılıq halını düzgün təsnif etmişdir. Decision Tree eyni 55 halın 38-ni düzgün aşkarlamışdır. Buna görə model sıralamasını müəyyən edən əsas fərq yalnız ümumi dəqiqlik deyil, azlıq fırıldaqçılıq sinfini tutmaq qabiliyyəti və hər iki sinifdəki səhvləri birlikdə nəzərə alan F1 və MCC ölçüləridir.
Nəticələr bir açıq tarixi verilənlər dəsti və bir train/test bölgüsü ilə məhdudlaşır. Mənbə hyperparameter tuning təfərrüatlarını, istifadə olunan encoding/scaling üsullarını, random seed-i, stratification məlumatını və ya cross-validation nəticələrini bildirmir. Modellər real sığorta şirkətinin canlı zərər idarəetmə sistemində sınaqdan keçirilməmişdir. Buna görə Decision Tree-nin bu verilənlər dəstində üstün olması bütün sığorta verilənlərində və ya real əməliyyatlarda eyni modelin mütləq ən yaxşı olacağı anlamına gəlmir.
Tədqiqat problemi
Sığorta fırıldaqçılığı etibarlı olmayan və ya manipulyasiya edilmiş tələblərin sığortaçıdan maliyyə faydası əldə etmək məqsədilə təqdim edilməsini əhatə edən geniş problemdir. Mənbə fırıldaqçılıq davranışının sağlamlıq, həyat, əmlak və avtomobil sığortası kimi müxtəlif sahələrdə ortaya çıxa bildiyini və ənənəvi əl ilə yoxlama və ya sabit qayda sistemlərinin dəyişən fırıldaqçılıq nümunələrini tutmaqda çətinlik çəkə biləcəyini vurğulayır.
Maşın öyrənməsinin bu tədqiqat baxımından əsas üstünlüyü keçmişdə etiketlənmiş sığorta zərəri qeydlərindəki çoxdəyişənli nümunələri öyrənə və yeni tələblər üçün fırıldaqçılıq ehtimalına dair avtomatik təsnifat yarada bilməsidir. Bununla belə, hansı alqoritmin ən yaxşı olması verilənlərin paylanmasından, əlamətlərdən, fırıldaqçılıq sinfinin payından və qiymətləndirmə metrikindən asılıdır.
Tədqiqatın araşdırma sualları
Mənbə üç əsas suala diqqət yetirir: maşın öyrənməsinin fırıldaqçılıq tələblərini nə dərəcədə aşkarlaya bilməsi, araşdırılan dörd alqoritmdən hansının ən etibarlı təsnifatı verməsi və maşın öyrənməsi nəticələrinin fırıldaqçılıq araşdırması prosesini hansı formalarda dəstəkləyə bilməsi.
Verilənlər dəsti
Tədqiqatda istifadə olunan verilənlər faylı insurance.claims.csv adlanır və Kaggle vasitəsilə əldə edilmişdir. Mənbə verilənlər strukturunu 40 müstəqil dəyişəni olan strukturlaşdırılmış sığorta zərəri verilənlər dəsti kimi təsvir edir.
Dəyişən qruplarına aşağıdakılar daxildir:
- müştəri demoqrafiyası: yaş, təhsil, peşə kimi məlumatlar,
- polis məlumatları: deductible və illik sığorta haqqı kimi xüsusiyyətlər,
- hadisə məlumatları: hadisə növü, hadisənin ağırlığı və nəqliyyat vasitələrinin sayı,
- zərər məlumatları: injury, property və vehicle claim məbləğləri,
- hədəf dəyişən: fraud-reported = Y və ya N
yer alır.
Mənbə Data Description bölməsində ümumi nümunə ölçüsünü ayrıca “N = ...” sətri ilə vermir. Bununla belə, %80:%20 bölgüsü və bütün confusion matrix-lərdə 200 test qeydinin görünməsi analiz edilən verilənlərin 1.000 qeyddən ibarət strukturla uyğun olduğunu göstərir. Mənbənin Table 3-də Vehicle Claims üçün də ümumilikdə 1.000 qeyd bildirilir.
Çatışmayan dəyərlərin işlənməsi
| Dəyişən | Çatışmayan dəyərlərin sayı | Mənbədə istifadə olunan əməliyyat |
|---|---|---|
| collision-type | 178 | Moda ilə doldurma |
| property-damage | 360 | Moda ilə doldurma |
| authorities-contacted | 91 | Moda ilə doldurma |
| police-report-available | 343 | Moda ilə doldurma |
Moda imputasiyası müvafiq dəyişəndə ən çox rast gəlinən kateqoriyanın çatışmayan qeydlərin yerinə yerləşdirilməsidir. Bu üsul verilənlər sətirlərini silmədən nümunəni qoruyur; lakin çatışmayan kateqoriyaların həqiqi paylanmasını təmsil etdiyinə zəmanət verilmir.
Mənbə imputasiya əməliyyatının yalnız təlim verilənləri üzərində öyrənilib test verilənlərinə tətbiq edildiyini, yoxsa train/test bölgüsündən əvvəl bütün verilənlər üzərində hesablandığını açıq şəkildə bildirmir. Buna görə preprocessing xəttinin mümkün verilən sızması baxımından necə tətbiq edildiyini mənbədən doğrulamaq mümkün deyil.
Çıxarılan dəyişənlər
Mənbə modelləşdirmə baxımından məhdud fayda verdiyi və ya yüksək kardinallığa malik olduğu əsaslandırması ilə policy-number, policy-bind-date, incident-date, policy-state, incident-state, incident-city, incident-location, insured.zip, insured-hobbies, auto-make, auto-model, auto-year və CSV formatlaşdırılmasından yaranmış əlavə sütunu çıxarır.
Bu qərarların bir hissəsi verilənlərin ölçüsünü və kateqorik mürəkkəbliyi azaltmağa yönəlib. Bununla belə, tarix və coğrafiya dəyişənlərinin fırıldaqçılıq baxımından potensial məlumat daşıyıb-daşımadığı ayrıca sınaqdan keçirilməmişdir; tədqiqatda bu dəyişənlər birbaşa modeldən kənarlaşdırılmışdır.
Multikolinearlıq yoxlaması
Mənbənin korrelyasiya təhlilində months-as-customer ilə age arasında 0,92 müsbət korrelyasiya müəyyən edilmişdir. Injury-claim, property-claim və vehicle-claim komponentlərinin total-claim-amount ilə yüksək korrelyasiyaya malik olduğu da bildirilir. Bunun nəticəsində age və total-claim-amount xüsusiyyətləri modelləşdirmə dəstindən çıxarılmışdır.
Mənbə 4-cü səhifədə üçbucaqlı korrelyasiya heatmap-i təqdim edir. Bu vizualın elmi rolu bəzi ədədi xüsusiyyətlərin eyni məlumatı güclü şəkildə təkrarladığını göstərməkdir; heatmap model performansını birbaşa ölçmür.
Kateqorik çevirmə və miqyaslama üzrə hesabat boşluğu
Mənbənin abstract bölməsində kateqorik verilənlərin ədədi formaya çevrildiyi və uyğun scaling əməliyyatlarının istifadə edildiyi bildirilir. Lakin metod bölməsində istifadə olunan encoding alqoritminin adı, kateqorik səviyyələrin necə işləndiyi və ya StandardScaler, MinMaxScaler kimi konkret miqyaslayıcının istifadə edilib-edilmədiyi göstərilmir.
Bu çatışmazlıq xüsusilə Logistic Regression və Naïve Bayes kimi preprocessing formasından təsirlənə bilən modellərin təkrar istehsal edilə bilməsi baxımından əhəmiyyətlidir.
Təlim və test bölgüsü
Mənbə verilənlər dəstini %80 təlim və %20 test olaraq bölmüşdür. Cross-validation, müstəqil validation set və ya xarici test verilənlər dəsti bildirilmir.
Random seed və ya split zamanı fraud/non-fraud nisbətinin stratification ilə qorunub-qorunmadığı da göstərilmir. Buna görə bir split üzərində müşahidə olunan model sıralamasının başqa bölgüdə nə qədər sabit olacağı mənbədən müəyyən edilə bilməz.
Decision Tree necə işləyir?
Decision Tree hər düyündə bir xüsusiyyətə əsasən verilənlər dəstini daha homogen alt qruplara bölən və yarpaq düyünündə sinif qərarı verən iyerarxik təsnifedicidir. Tədqiqat bölünmə keyfiyyətini izah etmək üçün Gini impurity, entropy və information gain düsturlarını verir.
\[ Gini(S)=1-\sum_{i=1}^{n}p_i^2 \]
\(p_i\), \(S\) düyünü daxilində \(i\)-ci sinfin payıdır. Təmiz düyündə bütün müşahidələr bir sinfə aiddir və Gini impurity azalır.
\[ E(S)=-\sum_{i=1}^{n}p_i\log_2(p_i) \]
Entropy də sinif qarışıqlığını ölçür. Daha homogen düyün daha aşağı entropy dəyərinə malikdir.
\(A\) xüsusiyyətinə görə bölünmənin informasiya qazancı:
\[ IG(S,A)=E(S)-\sum_{v\in Values(A)} \frac{|S_v|}{|S|}E(S_v) \]
şəklindədir. Yüksək information gain bölünmənin sinif qeyri-müəyyənliyini daha çox azaltdığı anlamına gəlir.
Logistic Regression
Logistic Regression xüsusiyyətlərin xətti kombinasiyasını fırıldaqçılıq sinfinə aid olma ehtimalına çevirir. Mənbənin istifadə etdiyi logit forması:
\[ \ln\left(\frac{P(Y)}{1-P(Y)}\right) = \beta_0+\beta_1X_1+\beta_2X_2+\cdots+\beta_kX_k \]
və ona uyğun ehtimal:
\[ P(Y)= \frac{e^{\beta_0+\beta_1X_1+\cdots+\beta_kX_k}} {1+e^{\beta_0+\beta_1X_1+\cdots+\beta_kX_k}} \]
şəklindədir. \(X_i\) giriş xüsusiyyətlərini, \(\beta_i\) model əmsallarını və \(P(Y)\) hədəf sinfin proqnozlaşdırılan ehtimalını ifadə edir.
Random Forest
Random Forest müxtəlif verilən və xüsusiyyət alt dəstləri üzərində çoxlu qərar ağacı yaradan və bu ağacların təsnifat qərarlarını birləşdirən ensemble üsuludur. Məqsəd bir ağacın konkret təlim nümunələrinə həddindən artıq uyğunlaşma riskini azaltmaqdır.
Bu tədqiqatda isə Random Forest test dəstindəki fırıldaqçılıq sinfini tamamilə qaçırmışdır. Mənbə istifadə olunan ağacların sayını, maximum depth-i, feature sampling nisbətini, class-weight-i və ya digər Random Forest hiperparametrlərini bildirmir.
Naïve Bayes
Naïve Bayes modeli Bayes teoreminə əsaslanır:
\[ P(C\mid X)=\frac{P(X\mid C)P(C)}{P(X)} \]
Şərti müstəqillik fərziyyəsi altında:
\[ P(C\mid X)\propto P(C)\prod_{i=1}^{n}P(x_i\mid C) \]
formasına çevrilir. Burada \(C\) fırıldaqçılıq və ya fırıldaqçılıq olmayan sinfi, \(X\) isə müşahidə olunan xüsusiyyətlərin məcmusunu ifadə edir. “Naïve” fərziyyəsi sinif məlum olduqda xüsusiyyətlərin bir-birindən şərti olaraq müstəqil qəbul edilməsidir.
Sığorta Fırıldaqçılığının Aşkarlanmasında Accuracy Niyə Təkbaşına Kifayət Deyil?
Accuracy bütün düzgün proqnozların ümumi nümunələrə nisbətini ölçdüyünə görə fırıldaqçılıq kimi azlıq sinfinin olduğu test dəstində daim çoxluq sinfini seçən model yüksək nəticə göstərə bilər; bu tədqiqatda 200 test qeydinin 145-i fırıldaqçılıq olmayan və 55-i fırıldaqçılıq olduğu halda Random Forest %72 test accuracy əldə etmiş, lakin fırıldaqçılıq hallarının heç birini düzgün aşkarlaya bilməmişdir. Buna görə recall, F1-score və MCC fırıldaqçılıq sinfindəki uğursuzluğu accuracy-dən daha aydın göstərir.
Qarışıqlıq matrisi
| Həqiqi / Proqnoz | Proqnozlaşdırılan Fırıldaqçılıq | Proqnozlaşdırılan Fırıldaqçılıq Olmayan |
|---|---|---|
| Həqiqi Fırıldaqçılıq | Doğru Müsbət (TP) | Yanlış Mənfi (FN) |
| Həqiqi Fırıldaqçılıq Olmayan | Yanlış Müsbət (FP) | Doğru Mənfi (TN) |
Doğru Müsbət, fırıldaqçılıq halının düzgün şəkildə fırıldaqçılıq kimi işarələnməsidir. Yanlış Mənfi, fırıldaqçılıq halının sistem tərəfindən qaçırılmasıdır. Yanlış Müsbət, həqiqi tələbin səhvən fırıldaqçılıq kimi işarələnməsidir; Doğru Mənfi isə fırıldaqçılıq olmayan qeydin düzgün təsnif edilməsidir.
Accuracy
\[ Accuracy= \frac{TP+TN}{TP+TN+FP+FN} \]
Accuracy ümumi təsnifat dəqiqliyini göstərir, lakin sinif paylanmasını nəzərə almır.
Precision
\[ Precision=\frac{TP}{TP+FP} \]
Precision modelin fırıldaqçılıq dediyi tələblərin nə qədərinin həqiqətən fırıldaqçılıq olduğunu ölçür.
Recall
\[ Recall=\frac{TP}{TP+FN} \]
Recall həqiqi fırıldaqçılıq hallarının nə qədərinin model tərəfindən tutulduğunu ölçür. Fraud detection kontekstində aşağı recall çox sayda fırıldaqçılıq halının qaçırılması deməkdir.
F1-score
\[ F1= 2\times \frac{Precision\times Recall} {Precision+Recall} \]
F1-score precision və recall arasındakı tarazlığı bir dəyərdə ümumiləşdirir.
Matthews Correlation Coefficient
\[ MCC= \frac{(TP\times TN)-(FP\times FN)} {\sqrt{(TP+FP)(TP+FN)(TN+FP)(TN+FN)}} \]
MCC dörd confusion-matrix xanasını eyni vaxtda istifadə etdiyinə görə siniflərin balanssız olduğu ikili təsnifat problemlərində faydalı ümumiləşdirici metrikdir. Yüksək müsbət dəyər daha ardıcıl təsnifata, sıfıra yaxın dəyər zəif əlaqəyə, mənfi dəyər isə proqnozlarla həqiqi siniflər arasında əks istiqamətli performansa işarə edir.
Tədqiqatın Metodu və Nəticələri
Model performanslarının müqayisəsi
| Model | Train Accuracy | Test Accuracy | Precision | Recall | F1-score | MCC |
|---|---|---|---|---|---|---|
| Decision Tree | 0,8225 | 0,7900 | 0,6032 | 0,6909 | 0,6441 | 0,4984 |
| Random Forest | 0,7887 | 0,7200 | 0,0000 | 0,0000 | 0,0000 | -0,0437 |
| Logistic Regression | 0,7512 | 0,6950 | 0,2500 | 0,0545 | 0,0896 | -0,0141 |
| Naïve Bayes | 0,7462 | 0,7000 | 0,2222 | 0,0364 | 0,0625 | -0,0257 |
Bu Tədqiqatda Hansı Maşın Öyrənməsi Modeli Ən Yaxşı Nəticəni Verdi?
Araşdırılan tək Kaggle verilənlər dəsti və istifadə olunan %80:%20 train-test bölgüsü şəraitində Decision Tree ən balanslı modeldir; %79 test accuracy, 0,6909 recall, 0,6441 F1-score və 0,4984 MCC ilə digər üç modeldən daha güclü fırıldaqçılıq təsnifatı vermişdir. Bu nəticə yalnız tədqiqatın verilənləri və eksperimental quruluşu üçün keçərlidir və Decision Tree-nin bütün sığorta verilənlər dəstlərində universal olaraq ən yaxşı model olduğunu göstərmir.
Decision Tree nəticələri
Mənbə ilkin Decision Tree modelinin %100 training accuracy və %71 test accuracy göstərərək overfitting əlaməti verdiyini bildirir. Hyperparameter tuning-dən sonra təlim accuracy-si %82,25-ə düşərkən test accuracy %79-a yüksəlmişdir.
Test confusion matrix:
| Decision Tree nəticəsi | Say |
|---|---|
| Doğru Mənfi | 120 |
| Yanlış Müsbət | 25 |
| Yanlış Mənfi | 17 |
| Doğru Müsbət | 38 |
Decision Tree 55 həqiqi fırıldaqçılıq halının 38-ni tutmuş, 17-ni isə qaçırmışdır. Mənbə tuning-dən sonra təlim və test accuracy dəyərlərinin bir-birinə daha yaxınlaşmasını generalization baxımından müsbət qiymətləndirir.
Bununla belə, istifadə olunan tuning parametrləri və ya tuning proseduru bildirilmədiyi üçün bu nəticəni müstəqil şəkildə tam təkrar istehsal etmək mümkün deyil.
Random Forest nəticələri
| Random Forest nəticəsi | Say |
|---|---|
| Doğru Mənfi | 144 |
| Yanlış Müsbət | 1 |
| Yanlış Mənfi | 55 |
| Doğru Müsbət | 0 |
Random Forest 145 fırıldaqçılıq olmayan qeydin 144-nü düzgün təsnif etsə də, 55 fırıldaqçılıq halının hamısını qaçırmışdır. Nəticədə precision, recall və F1-score dəyərlərinin hamısı sıfırdır.
Mənbə mətnində Random Forest üçün “perfect training accuracy” ifadəsi işlədilir; bunun əksinə, əsas performans cədvəlində training accuracy 0,7887 olaraq verilir. Bu iki dəyər bir-biri ilə uyğun gəlmədiyinə görə Verianla izahında açıq ədədi mənbə cədvəli əsas götürülür.
Logistic Regression nəticələri
| Logistic Regression nəticəsi | Say |
|---|---|
| Doğru Mənfi | 136 |
| Yanlış Müsbət | 9 |
| Yanlış Mənfi | 52 |
| Doğru Müsbət | 3 |
Logistic Regression %69,5 test accuracy vermişdir; lakin 55 fırıldaqçılıq halından yalnız 3-nü düzgün aşkarlamışdır. Recall 0,0545, F1-score 0,0896 və MCC -0,0141-dir. Buna görə ümumi accuracy fırıldaqçılıq sinfindəki həqiqi performansı olduğundan daha güclü göstərə bilər.
Naïve Bayes nəticələri
| Naïve Bayes nəticəsi | Say |
|---|---|
| Doğru Mənfi | 138 |
| Yanlış Müsbət | 7 |
| Yanlış Mənfi | 53 |
| Doğru Müsbət | 2 |
Naïve Bayes %70 test accuracy əldə etdiyi halda fırıldaqçılıq hallarının yalnız 2-ni tutmuşdur. Recall 0,0364 və MCC -0,0257-dir. Bu nəticə də majority class uğurunun fırıldaqçılığın aşkarlanması uğuru ilə qarışdırılmamalı olduğunu göstərir.
Fırıldaqçılıq hallarının modellər tərəfindən tutulması
| Model | Həqiqi Fırıldaqçılıq | Düzgün Tutulan Fırıldaqçılıq | Qaçırılan Fırıldaqçılıq |
|---|---|---|---|
| Decision Tree | 55 | 38 | 17 |
| Random Forest | 55 | 0 | 55 |
| Logistic Regression | 55 | 3 | 52 |
| Naïve Bayes | 55 | 2 | 53 |
Bu cədvəl tədqiqatdakı praktik model fərqini accuracy cədvəlindən daha aydın göstərir. Decision Tree testdəki fırıldaqçılıq hallarının mühüm hissəsini tutarkən digər üç model azlıq fırıldaqçılıq sinfinə qarşı ciddi performans itkisi göstərir.
Zərər növlərinə dair mənbə cədvəli
| Zərər komponenti | Ümumi qeyd | Fırıldaqçılıq kimi bildirilən qeyd |
|---|---|---|
| Bədən Xəsarəti Tələbləri | 975 | 238 |
| Əmlak Zərəri Tələbləri | 981 | 241 |
| Nəqliyyat Vasitəsi Tələbləri | 1000 | 247 |
Mənbə bu rəqəmləri Table 3 altında bildirir. Bunlar bir-birindən müstəqil üç ayrı nümunə kimi şərh edilməməlidir; eyni sığorta qeydində injury, property və vehicle claim komponentləri ola bilər.
Xüsusiyyət şərhlərinin sərhədi
Mənbə discussion bölməsində yüksək claim amount, missing police report və müəyyən incident characteristics kimi dəyişənlərin fırıldaqçılıq göstəricisi ola biləcəyini bildirir. Lakin tədqiqatda feature-importance qrafiki, SHAP dəyəri, permutation importance, Logistic Regression əmsallarının əhəmiyyətliliyi və ya başqa kəmiyyət izaholunma təhlili təqdim edilmir.
Buna görə sözügedən xüsusiyyətlər mənbə müəlliflərinin müşahidəyə/modelə əsaslanan şərhləridir; bu PDF-dən hansı dəyişənin “ən güclü fırıldaqçılıq müəyyənedicisi” olduğu kəmiyyətcə sıralana bilməz.
Bu Nəticələr Real Sığorta Sistemlərində Canlı Performansı Sübut Edirmi?
Xeyr. Modellər açıq tarixi verilənlər dəstində bir train-test bölgüsü ilə qiymətləndirilmiş və real sığorta şirkətinin canlı claim-processing sisteminə inteqrasiya edilməmişdir; buna görə bildirilən %79 Decision Tree accuracy-si və ya digər metriklər real sahə performansına zəmanət vermir və fərqli ölkə, məhsul, fırıldaqçılıq növü və ya verilənlər paylanmasında yenidən doğrulama tələb olunur.
Tədqiqatın öz məhdudiyyətləri
- Açıq verilənlər real sığorta əməliyyatlarının bütün mürəkkəbliyini əks etdirməyə bilər.
- Hər modelin fərziyyələri verilənlər strukturu ilə tam uyğun olmaya bilər.
- Modellər yalnız tarixi verilənlər üzərində sınaqdan keçirilmişdir.
- Canlı sığorta sistemi inteqrasiyası həyata keçirilməmişdir.
- Tədqiqatın ilk məhdudiyyət izahı izaholunma təhlilinin məhdud olduğunu qəbul edir.
- Nəticələrin fərqli ölkə, sektor və ya verilənlər dəstlərinə birbaşa köçürülməsinə zəmanət verilmir.
Əlavə təkrar istehsal oluna bilmə məhdudiyyətləri
- Decision Tree tuning parametrləri bildirilmir.
- Random Forest hiperparametrləri bildirilmir.
- Encoding və scaling üsulları açıq şəkildə adlandırılmır.
- Random seed və stratified splitting məlumatı verilmir.
- Cross-validation tətbiq edilmiş nəticə bildirilmir.
- Müstəqil xarici test dəsti yoxdur.
- Confidence interval və ya formal model-müqayisə əhəmiyyətlilik testi bildirilmir.
- AUC-ROC, PR-AUC və ya calibration metriki verilmir.
- Yanlış müsbət və yanlış mənfilərin iqtisadi dəyəri modelləşdirilmir.
Mənbədaxili redaktə və ədədi uyğunsuzluqlar
- Decision Tree confusion matrix-in rəqəmləri tuned modelin %79 nəticəsi ilə uyğun gəlsə də, müvafiq caption “Initial Model” ifadəsini daşıyır.
- Bir şəkil başlığı “Figure 5: Enter Caption” formasında tamamlanmamış qalmışdır.
- Random Forest izahında perfect training accuracy deyildiyi halda Table 2 training accuracy-ni 0,7887 kimi verir.
- Abstract kateqorik çevirmə və scaling tətbiq edildiyini bildirir, lakin metod bölməsi bunların texniki təfərrüatlarını vermir.
Tədqiqatın tövsiyələri
Mənbə gələcək tətbiqlər üçün dörd istiqamət təklif edir. Birincisi, dəqiqliklə yanaşı izaholunmanı artırmaq üçün SHAP kimi alətlərdən istifadə etməkdir. İkincisi, ML ballarını ekspert qaydaları ilə birləşdirməkdir. Üçüncüsü, sinif balanssızlığı üçün SMOTE, cost-sensitive alqoritmlər və ya ensemble üsullarını qiymətləndirməkdir. Dördüncüsü, xüsusiyyətləri fərqli verilənlər dəstlərində yenidən sınaqdan keçirmək və real və ya proprietary sığorta verilənləri ilə xarici doğrulama aparmaqdır.
Bu texnikaların tövsiyə kimi verilməsi vacibdir: mövcud tədqiqatda SHAP, SMOTE və ya cost-sensitive training tətbiq edilməmiş və bunlara dair yeni performans nəticəsi bildirilməmişdir.
Tədqiqatın dəstəklədiyi nəticələr
- Araşdırılan verilənlər dəstində tuned Decision Tree dörd model arasında ən balanslı test performansını vermişdir.
- Decision Tree üçün test accuracy %79, recall 0,6909, F1-score 0,6441 və MCC 0,4984-dür.
- Random Forest %72 accuracy əldə etsə də, testdəki fırıldaqçılıq hallarının heç birini düzgün təsnif edə bilməmişdir.
- Logistic Regression və Naïve Bayes-in fırıldaqçılıq recall dəyərləri çox aşağıdır.
- Sinif balanssızlığı olan fırıldaqçılıq problemində F1, recall və MCC accuracy-nin təkbaşına göstərmədiyi model davranışını görünən etmişdir.
- Verilənlərin təmizlənməsi və xüsusiyyət seçimi model hazırlama prosesinin mühüm hissələridir.
Tədqiqatın dəstəkləmədiyi nəticələr
- Decision Tree-nin bütün sığorta fırıldaqçılığı verilənlər dəstlərində universal olaraq ən yaxşı model olduğu göstərilməmişdir.
- Modelin real sığorta əməliyyatında %79 accuracy təmin edəcəyi sübut edilməmişdir.
- Random Forest-ın ümumilikdə fraud detection üçün uğursuz alqoritm olduğu nəticəsinə gəlmək olmaz; yalnız bu təcrübədəki quruluş uğursuz olmuşdur.
- Müəyyən xüsusiyyətlərin fırıldaqçılığın səbəbi olduğu göstərilməmişdir.
- Mənbə feature importance sıralaması və ya SHAP təhlili təqdim etmir.
- SMOTE, cost-sensitive learning və ya SHAP-ın bu verilənlər dəstində performansı artırdığı sınaqdan keçirilməmişdir.
- Model fərqlərinin statistik cəhətdən əhəmiyyətli olduğu formal şəkildə göstərilməmişdir.
- Tədqiqat real sığorta əməliyyatında maliyyə itkisinin azalmasını ölçməmişdir.
Mənbə və Metod Qeydi
Tam orijinal başlıq: Comparative Analysis of Machine Learning Models for Insurance Fraud Detection.
PDF-də müəllif sırası: Praise Owusu Oteng; Francis Mawuse Addae; Edward Tait Kwaw; Catherine Ewoenam Kwablavi; Bismark Sarkodie; Sandra Addai-Henne.
PDF-də afiliyasiya: Kwame Nkrumah University of Science and Technology, Department of Statistics and Actuarial Science, Kumasi, Ghana.
SSRN metadata-sında Contact Author: Praise Oteng.
Platforma: SSRN.
SSRN Abstract ID: 6899161.
DOI: 10.2139/ssrn.6899161.
Date Written: 2 sentyabr 2025.
SSRN-də yayımlanma/göndərilmə: 30 iyun 2026.
Mənbə növü: Working paper / preprint.
Rəyçilik statusu: Cari biblioqrafik yoxlamada rəyli jurnal versiyası doğrulanmamışdır.
Lisenziya: Açıq Creative Commons lisenziyası doğrulanmamışdır. Verianla izahında mənbə mətni, orijinal şəkil dizaynı və orijinal cədvəl kompozisiyası yenidən yayımlanmamışdır.
Verilənlər: Kaggle vasitəsilə əldə edilmiş insurance.claims.csv strukturlaşdırılmış sığorta zərəri verilənlər dəsti.
Mənbədə bildirilən dəyişən strukturu: 40 müstəqil dəyişən və fraud-reported Y/N hədəfi.
Test dəsti: Mənbənin confusion matrix-lərinə görə 200 qeyd; 55 fırıldaqçılıq və 145 fırıldaqçılıq olmayan.
Train-test bölgüsü: %80 / %20.
Çatışmayan verilənlərin işlənməsi: collision-type, property-damage, authorities-contacted və police-report-available üçün moda imputasiyası.
Multikolinearlıq nəticəsi: months-as-customer ilə age arasında 0,92 korrelyasiya; age və total-claim-amount modelləşdirmə dəstindən çıxarılmışdır.
Modellər: Decision Tree, Random Forest, Logistic Regression və Naïve Bayes.
Qiymətləndirmə metrikləri: Accuracy, Precision, Recall, F1-score və Matthews Correlation Coefficient.
Əsas performans nəticəsi: Decision Tree — train accuracy 0,8225; test accuracy 0,7900; precision 0,6032; recall 0,6909; F1 0,6441; MCC 0,4984.
Mühüm sinif balanssızlığı nəticəsi: Random Forest-ın test accuracy-si 0,7200 olsa da, recall, precision və F1 dəyərləri 0-dır və heç bir fırıldaqçılıq halı düzgün tutulmamışdır.
Mənbədə açıqlanmayan təkrar istehsal oluna bilmə təfərrüatları: İstifadə olunan kateqorik encoding üsulu, scaler, Decision Tree tuning parametrləri, Random Forest hiperparametrləri, random seed, stratification, preprocessing fit ardıcıllığı və software/package versiyaları.
Cross-validation: Mənbənin öz təcrübəsində bildirilmir. Ədəbiyyat bölməsində başqa bir tədqiqatın ten-fold cross-validation istifadəsi təsvir olunur; bu, mövcud tədqiqatın metodu deyil.
Statistik müqayisə: Model fərqləri üçün confidence interval, p-dəyəri və ya formal əhəmiyyətlilik testi bildirilmir.
Sahə doğrulaması: Yoxdur.
Canlı sığorta sistemi inteqrasiyası: Yoxdur.
İzaholunma təhlili: Feature importance və ya SHAP təhlili mövcud təcrübədə bildirilmir; SHAP gələcək tətbiqlər üçün tövsiyə olunur.
Sinif balanslaşdırılması: SMOTE və ya cost-sensitive learning mövcud təcrübədə tətbiq edilməmiş, gələcək tədqiqat tövsiyəsi kimi verilmişdir.
Mənbədaxili uyğunsuzluq: Random Forest mətnindəki “perfect training accuracy” ifadəsi Table 2-dəki 0,7887 ilə uyğun gəlmir.
Redaktə xarakterli şəkil problemi: Bir şəkil caption-ı “Enter Caption” olaraq qalmış; Decision Tree confusion matrix caption-ındakı “Initial Model” ifadəsi matrisdə göstərilən tuned %79 nəticəsi ilə uyğun gəlir.
Maliyyələşdirmə: Ayrı maliyyələşdirmə bəyanatı bildirilməmişdir.
Maraqların toqquşması: Ayrı maraqların toqquşması bəyanatı bildirilməmişdir.
Verilənlərin əlçatanlığı: Kaggle mənbəyi göstərilmişdir, lakin ayrıca dataset URL-i, versiya identifikatoru və ya verilənlər lisenziyası bəyanatı bildirilmir.
CRediT / müəllif töhfələri: Ayrı CRediT bəyanatı bildirilməmişdir.
Təşəkkürlər: Müəlliflər tədqiqatlarında Allaha təşəkkür edir və Dr. Sandra Addai-Henne-nin məsləhətçilik töhfəsini ayrıca qeyd edirlər.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib