


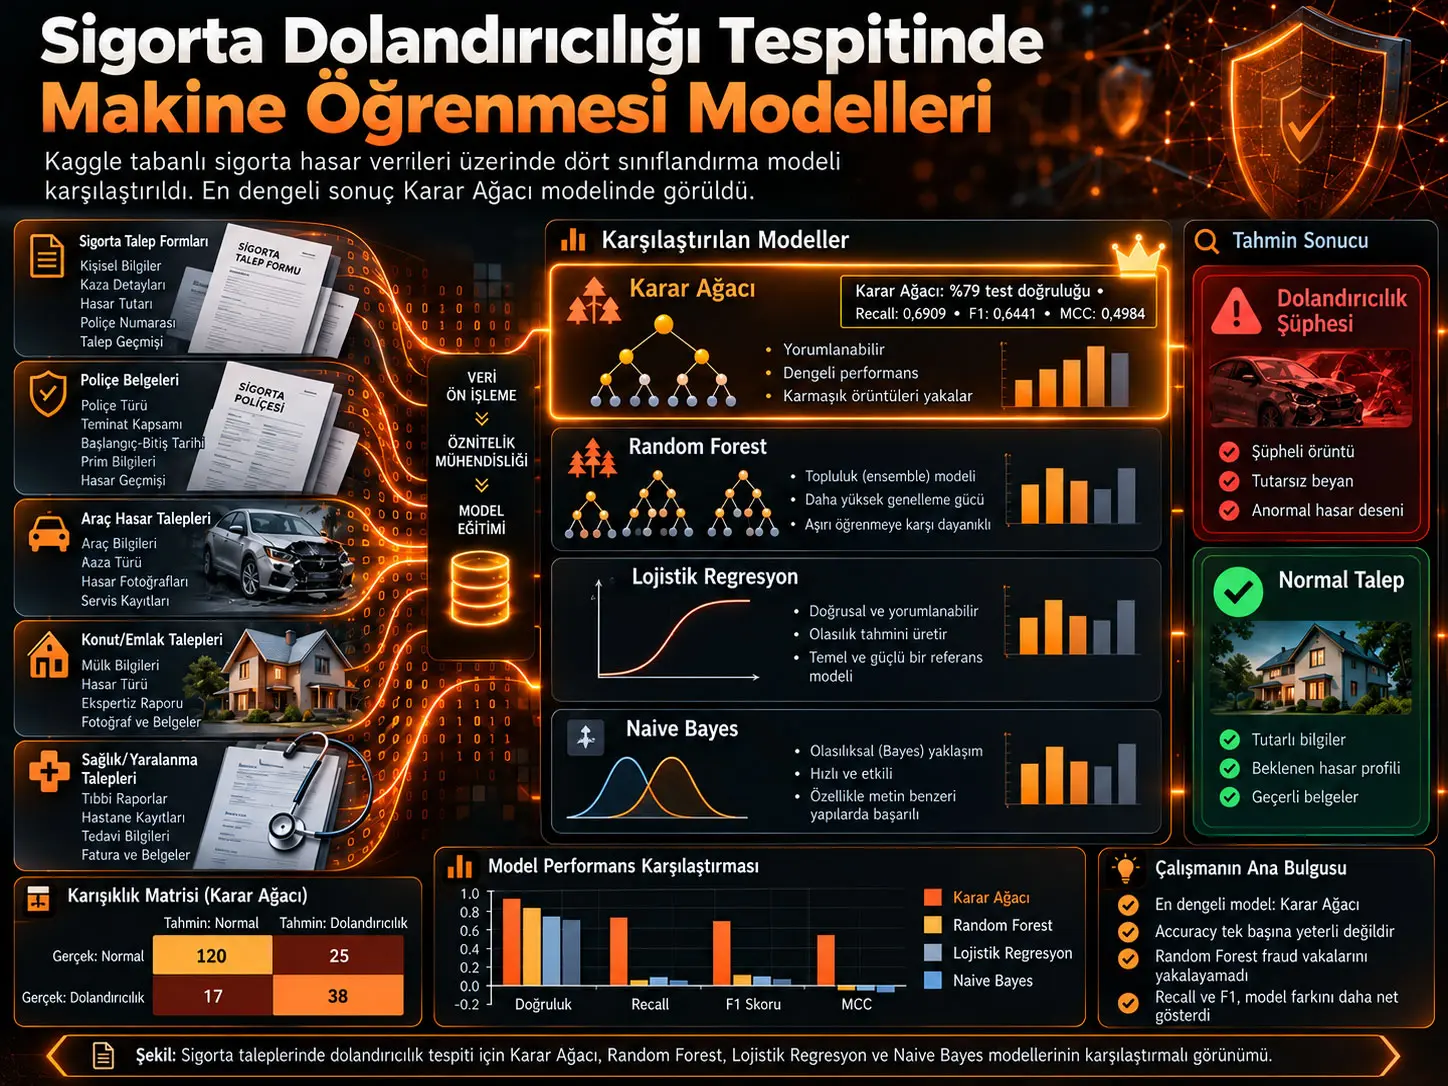
Denetimli makine öğrenmesi tabanlı sigorta dolandırıcılığı tespiti, geçmişte fraud veya non-fraud olarak etiketlenmiş sigorta taleplerinden örüntüler öğrenerek yeni talepleri iki sınıftan birine ayırmayı amaçlayan bir ikili sınıflandırma problemidir. Praise Owusu Oteng ve çalışma arkadaşları, Kaggle üzerinden elde edilen insurance.claims.csv veri kümesinde Decision Tree, Random Forest, Logistic Regression ve Naïve Bayes modellerini karşılaştırmıştır. Veri temizleme; eksik değerlerin doldurulması, bazı yüksek kardinaliteli veya ilgisiz değişkenlerin çıkarılması, çoklu doğrusal bağlantı kontrolü ve kaynağın özetinde belirtilen kategorik dönüşüm ile ölçekleme adımlarını içermektedir. Veri %80 eğitim ve %20 test olarak ayrılmış; modeller accuracy, precision, recall, F1-score ve Matthews Correlation Coefficient (MCC) ile değerlendirilmiştir. Ayarlanmış Decision Tree %79 test accuracy, 0,6032 precision, 0,6909 recall, 0,6441 F1-score ve 0,4984 MCC ile incelenen dört model içinde en dengeli sonucu üretmiştir.
Çalışmanın en önemli öğretici sonucu, fraud gibi azınlık sınıfının bulunduğu bir veri kümesinde yüksek accuracy değerinin tek başına başarılı fraud tespiti anlamına gelmemesidir. Random Forest test verisinde %72 accuracy üretmesine rağmen fraud sınıfındaki 55 kaydın hiçbirini doğru tespit edememiştir. Logistic Regression yalnız 3, Naïve Bayes ise yalnız 2 fraud vakasını doğru sınıflandırmıştır. Decision Tree aynı 55 vakanın 38'ini doğru tespit etmiştir. Bu nedenle model sıralamasını belirleyen asıl fark yalnız genel doğruluk değil, azınlık fraud sınıfını yakalama kapasitesi ve iki sınıftaki hataları birlikte dikkate alan F1 ve MCC ölçüleridir.
Sonuçlar tek bir kamuya açık tarihsel veri kümesi ve tek bir train/test ayrımıyla sınırlıdır. Kaynak hyperparameter tuning ayrıntılarını, kullanılan encoding/scaling yöntemlerini, random seed'i, stratification bilgisini veya cross-validation sonuçlarını raporlamamaktadır. Modeller gerçek bir sigorta şirketinin canlı hasar yönetim sisteminde sınanmamıştır. Dolayısıyla Decision Tree'nin bu veri kümesindeki üstünlüğü, bütün sigorta veri kümelerinde veya gerçek operasyonlarda aynı modelin mutlaka en iyi olacağı anlamına gelmez.
Araştırma problemi
Sigorta dolandırıcılığı, geçerli olmayan veya manipüle edilmiş taleplerin sigortacıdan finansal fayda elde etmek amacıyla sunulmasını kapsayan geniş bir problemdir. Kaynak, fraud davranışının sağlık, hayat, mülk ve motorlu taşıt sigortaları gibi farklı alanlarda ortaya çıkabildiğini ve geleneksel manuel inceleme veya sabit kural sistemlerinin değişen fraud örüntülerini yakalamakta zorlanabileceğini vurgulamaktadır.
Makine öğrenmesinin çalışma açısından temel avantajı, geçmişte etiketlenmiş hasar kayıtlarındaki çok değişkenli örüntüleri öğrenebilmesi ve yeni talepler için fraud olasılığına ilişkin otomatik bir sınıflandırma üretebilmesidir. Bununla birlikte hangi algoritmanın en iyi olduğu veri dağılımına, özelliklere, fraud sınıfının oranına ve değerlendirme metriğine bağlıdır.
Çalışmanın araştırma soruları
Kaynak üç temel soruya odaklanmaktadır: makine öğrenmesinin fraud taleplerini ne ölçüde tespit edebildiği, incelenen dört algoritmadan hangisinin en güvenilir sınıflandırmayı ürettiği ve makine öğrenmesi sonuçlarının fraud inceleme sürecini hangi biçimlerde destekleyebileceği.
Veri kümesi
Çalışmada kullanılan veri dosyası insurance.claims.csv olarak adlandırılmaktadır ve Kaggle üzerinden elde edilmiştir. Kaynak veri yapısını 40 bağımsız değişken içeren yapılandırılmış bir sigorta hasar veri seti olarak tanımlamaktadır.
Değişken grupları arasında:
- müşteri demografisi: yaş, eğitim, meslek gibi bilgiler,
- poliçe bilgileri: deductible ve yıllık prim gibi özellikler,
- olay bilgileri: olay türü, olay şiddeti ve araç sayısı,
- hasar bilgileri: injury, property ve vehicle claim tutarları,
- hedef değişken: fraud-reported = Y veya N
yer almaktadır.
Kaynak Data Description bölümünde toplam örneklem büyüklüğünü tek bir “N = ...” satırıyla vermemektedir. Bununla birlikte %80:%20 bölünme ve bütün confusion matrix'lerde 200 test kaydının görülmesi, analiz edilen veri miktarının 1.000 kayıtlık yapı ile uyumlu olduğunu göstermektedir. Kaynağın Table 3'ünde Vehicle Claims için de toplam 1.000 kayıt raporlanmaktadır.
Eksik değerlerin işlenmesi
| Değişken | Eksik değer sayısı | Kaynakta kullanılan işlem |
|---|---|---|
| collision-type | 178 | Mod ile doldurma |
| property-damage | 360 | Mod ile doldurma |
| authorities-contacted | 91 | Mod ile doldurma |
| police-report-available | 343 | Mod ile doldurma |
Mod imputasyonu, ilgili değişkende en sık görülen kategorinin eksik kayıtların yerine yerleştirilmesidir. Bu yöntem veri satırlarını silmeden örneklemi korur; ancak eksik kategorilerin gerçek dağılımını temsil ettiği garanti edilmez.
Kaynak imputasyon işleminin yalnız eğitim verisi üzerinde öğrenilip test verisine uygulandığını veya train/test ayrımından önce bütün veri üzerinde hesaplandığını açıkça belirtmemektedir. Bu nedenle preprocessing hattının olası veri sızıntısı açısından nasıl uygulandığı kaynak üzerinden doğrulanamamaktadır.
Çıkarılan değişkenler
Kaynak, modelleme açısından sınırlı yarar sağladığı veya yüksek kardinalite taşıdığı gerekçesiyle policy-number, policy-bind-date, incident-date, policy-state, incident-state, incident-city, incident-location, insured.zip, insured-hobbies, auto-make, auto-model, auto-year ve CSV biçimlendirmesinden oluşmuş ek bir sütunu kaldırmaktadır.
Bu kararların bir bölümü veri boyutunu ve kategorik karmaşıklığı azaltmaya yöneliktir. Bununla birlikte tarih ve coğrafya değişkenlerinin fraud açısından potansiyel bilgi taşıyıp taşımadığı ayrıca test edilmemiştir; çalışmada bu değişkenler doğrudan model dışı bırakılmıştır.
Çoklu bağlantı kontrolü
Kaynağın korelasyon analizinde months-as-customer ile age arasında 0,92 pozitif korelasyon bulunmuştur. Injury-claim, property-claim ve vehicle-claim bileşenlerinin total-claim-amount ile yüksek korelasyon taşıdığı da belirtilmektedir. Bunun sonucunda age ve total-claim-amount özellikleri modelleme kümesinden çıkarılmıştır.
Kaynak sayfa 4'te üçgensel bir korelasyon heatmap'i sunmaktadır. Bu görselin bilimsel rolü, bazı sayısal özelliklerin aynı bilgiyi güçlü biçimde tekrar ettiğini göstermektir; heatmap model performansını doğrudan ölçmez.
Kategorik dönüşüm ve ölçekleme raporlama boşluğu
Kaynağın abstract bölümü kategorik verilerin sayısal biçime dönüştürüldüğünü ve uygun scaling işlemlerinin kullanıldığını belirtmektedir. Ancak yöntem bölümünde kullanılan encoding algoritmasının adı, kategorik seviyelerin nasıl işlendiği veya StandardScaler, MinMaxScaler gibi belirli bir ölçekleyicinin kullanılıp kullanılmadığı raporlanmamıştır.
Bu eksiklik özellikle Logistic Regression ve Naïve Bayes gibi ön işleme biçiminden etkilenebilecek modellerin yeniden üretilebilirliği açısından önemlidir.
Eğitim ve test bölünmesi
Kaynak veri kümesini %80 eğitim ve %20 test olarak ayırmıştır. Cross-validation, bağımsız validation set veya dış test veri kümesi raporlanmamaktadır.
Random seed veya split sırasında fraud/non-fraud oranının stratification ile korunup korunmadığı da belirtilmemiştir. Bu nedenle tek bir split üzerinde gözlenen model sıralamasının farklı bir bölünmede ne kadar kararlı olacağı kaynaktan belirlenemez.
Decision Tree nasıl çalışır?
Decision Tree, her düğümde bir özelliğe göre veri kümesini daha homojen alt gruplara bölen ve yaprak düğümünde sınıf kararı üreten hiyerarşik bir sınıflandırıcıdır. Çalışma bölünme kalitesini açıklamak için Gini impurity, entropy ve information gain formüllerini vermektedir.
\[ Gini(S)=1-\sum_{i=1}^{n}p_i^2 \]
\(p_i\), düğüm \(S\) içindeki \(i\). sınıfın oranıdır. Saf bir düğümde gözlemlerin tamamı tek sınıftadır ve Gini impurity azalır.
\[ E(S)=-\sum_{i=1}^{n}p_i\log_2(p_i) \]
Entropy de sınıf karışıklığını ölçmektedir. Daha homojen bir düğüm daha düşük entropy taşır.
Bir \(A\) özelliğine göre bölmenin bilgi kazancı:
\[ IG(S,A)=E(S)-\sum_{v\in Values(A)} \frac{|S_v|}{|S|}E(S_v) \]
şeklindedir. Yüksek information gain, bölmenin sınıf belirsizliğini daha fazla azalttığı anlamına gelir.
Logistic Regression
Logistic Regression, özelliklerin doğrusal kombinasyonunu fraud sınıfına ait olma olasılığına dönüştürür. Kaynağın kullandığı logit biçimi:
\[ \ln\left(\frac{P(Y)}{1-P(Y)}\right) = \beta_0+\beta_1X_1+\beta_2X_2+\cdots+\beta_kX_k \]
ve buna karşılık gelen olasılık:
\[ P(Y)= \frac{e^{\beta_0+\beta_1X_1+\cdots+\beta_kX_k}} {1+e^{\beta_0+\beta_1X_1+\cdots+\beta_kX_k}} \]
şeklindedir. \(X_i\) giriş özelliklerini, \(\beta_i\) model katsayılarını ve \(P(Y)\) hedef sınıfın tahmin edilen olasılığını temsil eder.
Random Forest
Random Forest, farklı veri ve özellik alt kümeleri üzerinde çok sayıda karar ağacı oluşturan ve bu ağaçların sınıflandırma kararlarını birleştiren ensemble yöntemidir. Tek bir ağacın belirli eğitim örneklerine aşırı uyum sağlama riskini azaltmak amaçlanır.
Bu çalışmada ise Random Forest test kümesindeki fraud sınıfını tamamen kaçırmıştır. Kaynak kullanılan ağaç sayısı, maximum depth, feature sampling oranı, class-weight veya başka Random Forest hiperparametrelerini raporlamamaktadır.
Naïve Bayes
Naïve Bayes modeli Bayes teoremi üzerine kuruludur:
\[ P(C\mid X)=\frac{P(X\mid C)P(C)}{P(X)} \]
Koşullu bağımsızlık varsayımı altında:
\[ P(C\mid X)\propto P(C)\prod_{i=1}^{n}P(x_i\mid C) \]
biçimine dönüşür. Burada \(C\) fraud veya non-fraud sınıfını, \(X\) gözlenen özellikler bütününü temsil eder. “Naïve” varsayımı, sınıf bilindiğinde özelliklerin birbirlerinden koşullu olarak bağımsız kabul edilmesidir.
Sigorta Dolandırıcılığı Tespitinde Accuracy Neden Tek Başına Yeterli Değildir?
Accuracy bütün doğru tahminlerin toplam örneklere oranını ölçtüğü için fraud gibi azınlık sınıfının bulunduğu bir test kümesinde çoğunluk sınıfını sürekli seçen bir model yüksek görünebilir; bu çalışmada 200 test kaydının 145'i non-fraud ve 55'i fraud iken Random Forest %72 test accuracy üretmiş fakat fraud vakalarının hiçbirini doğru tespit edememiştir. Bu nedenle recall, F1-score ve MCC fraud sınıfındaki başarısızlığı accuracy'den daha görünür hale getirmektedir.
Karışıklık matrisi
| Gerçek / Tahmin | Predicted Fraud | Predicted Non-Fraud |
|---|---|---|
| Actual Fraud | True Positive (TP) | False Negative (FN) |
| Actual Non-Fraud | False Positive (FP) | True Negative (TN) |
True Positive, fraud vakasının doğru biçimde fraud olarak işaretlenmesidir. False Negative, fraud vakasının sistem tarafından kaçırılmasıdır. False Positive, gerçek bir talebin yanlışlıkla fraud olarak işaretlenmesi; True Negative ise non-fraud kaydın doğru sınıflandırılmasıdır.
Accuracy
\[ Accuracy= \frac{TP+TN}{TP+TN+FP+FN} \]
Accuracy genel sınıflandırma doğruluğunu gösterir ancak sınıf dağılımını dikkate almaz.
Precision
\[ Precision=\frac{TP}{TP+FP} \]
Precision, modelin fraud dediği taleplerin ne kadarının gerçekten fraud olduğunu ölçer.
Recall
\[ Recall=\frac{TP}{TP+FN} \]
Recall, gerçek fraud vakalarının ne kadarının model tarafından yakalandığını ölçer. Fraud detection bağlamında düşük recall çok sayıda fraud vakasının kaçırıldığı anlamına gelir.
F1-score
\[ F1= 2\times \frac{Precision\times Recall} {Precision+Recall} \]
F1-score precision ve recall arasındaki dengeyi tek değerde özetler.
Matthews Correlation Coefficient
\[ MCC= \frac{(TP\times TN)-(FP\times FN)} {\sqrt{(TP+FP)(TP+FN)(TN+FP)(TN+FN)}} \]
MCC dört confusion-matrix hücresini aynı anda kullandığı için sınıfların dengesiz olduğu ikili sınıflandırma problemlerinde yararlı bir özet metriktir. Pozitif yüksek değer daha tutarlı sınıflandırmaya, sıfır civarı değer zayıf ilişkiye, negatif değer ise tahminlerle gerçek sınıflar arasında ters yönlü performansa işaret eder.
Çalışmanın Yöntemi ve Bulguları
Model performanslarının karşılaştırılması
| Model | Train Accuracy | Test Accuracy | Precision | Recall | F1-score | MCC |
|---|---|---|---|---|---|---|
| Decision Tree | 0,8225 | 0,7900 | 0,6032 | 0,6909 | 0,6441 | 0,4984 |
| Random Forest | 0,7887 | 0,7200 | 0,0000 | 0,0000 | 0,0000 | -0,0437 |
| Logistic Regression | 0,7512 | 0,6950 | 0,2500 | 0,0545 | 0,0896 | -0,0141 |
| Naïve Bayes | 0,7462 | 0,7000 | 0,2222 | 0,0364 | 0,0625 | -0,0257 |
Bu Çalışmada Hangi Makine Öğrenmesi Modeli En İyi Sonucu Verdi?
İncelenen tek Kaggle veri kümesi ve kullanılan %80:%20 train-test ayrımı altında Decision Tree en dengeli modeldir; %79 test accuracy, 0,6909 recall, 0,6441 F1-score ve 0,4984 MCC ile diğer üç modelden daha güçlü fraud sınıflandırması üretmiştir. Bu sonuç yalnız çalışmanın veri ve deney düzeni için geçerlidir ve Decision Tree'nin bütün sigorta veri kümelerinde evrensel olarak en iyi model olduğunu göstermez.
Decision Tree sonuçları
Kaynak ilk Decision Tree modelinin %100 training accuracy ve %71 test accuracy göstererek overfitting işareti verdiğini belirtmektedir. Hyperparameter tuning sonrasında eğitim accuracy'si %82,25'e düşerken test accuracy %79'a yükselmiştir.
Test confusion matrix:
| Decision Tree sonucu | Sayı |
|---|---|
| True Negative | 120 |
| False Positive | 25 |
| False Negative | 17 |
| True Positive | 38 |
Decision Tree 55 gerçek fraud vakasının 38'ini yakalamış ve 17'sini kaçırmıştır. Kaynak, eğitim ve test accuracy değerlerinin tuning sonrasında birbirine daha yakın hale gelmesini generalization açısından olumlu yorumlamaktadır.
Bununla birlikte kullanılan tuning parametreleri veya tuning prosedürü raporlanmadığı için bu sonuç bağımsız olarak tam biçimde yeniden üretilemez.
Random Forest sonuçları
| Random Forest sonucu | Sayı |
|---|---|
| True Negative | 144 |
| False Positive | 1 |
| False Negative | 55 |
| True Positive | 0 |
Random Forest 145 non-fraud kaydın 144'ünü doğru sınıflandırmasına rağmen 55 fraud vakasının tamamını kaçırmıştır. Bunun sonucu precision, recall ve F1-score'un tamamının sıfır olmasıdır.
Kaynak metninde Random Forest için “perfect training accuracy” ifadesi kullanılmaktadır; buna karşılık ana performans tablosunda training accuracy 0,7887 olarak verilmektedir. Bu iki değer birbiriyle uyuşmadığı için Verianla anlatımında açık sayısal kaynak tablosu esas alınmaktadır.
Logistic Regression sonuçları
| Logistic Regression sonucu | Sayı |
|---|---|
| True Negative | 136 |
| False Positive | 9 |
| False Negative | 52 |
| True Positive | 3 |
Logistic Regression %69,5 test accuracy üretmiştir; fakat 55 fraud vakasının yalnız 3'ünü doğru tespit etmiştir. Recall 0,0545, F1-score 0,0896 ve MCC -0,0141'dir. Genel accuracy bu nedenle fraud sınıfındaki gerçek performansı olduğundan daha güçlü gösterebilir.
Naïve Bayes sonuçları
| Naïve Bayes sonucu | Sayı |
|---|---|
| True Negative | 138 |
| False Positive | 7 |
| False Negative | 53 |
| True Positive | 2 |
Naïve Bayes %70 test accuracy üretirken fraud vakalarının yalnız 2'sini yakalamıştır. Recall 0,0364 ve MCC -0,0257'dir. Bu sonuç da majority class başarısının fraud tespiti başarısıyla karıştırılmaması gerektiğini göstermektedir.
Fraud vakalarının modeller tarafından yakalanması
| Model | Gerçek Fraud | Doğru Yakalanan Fraud | Kaçırılan Fraud |
|---|---|---|---|
| Decision Tree | 55 | 38 | 17 |
| Random Forest | 55 | 0 | 55 |
| Logistic Regression | 55 | 3 | 52 |
| Naïve Bayes | 55 | 2 | 53 |
Bu tablo çalışmanın pratik model farkını accuracy tablosundan daha açık gösterir. Decision Tree test fraud vakalarının önemli bölümünü yakalarken diğer üç model azınlık fraud sınıfına karşı ciddi performans kaybı göstermektedir.
Hasar türlerine ilişkin kaynak tablosu
| Hasar bileşeni | Toplam kayıt | Fraud olarak raporlanan kayıt |
|---|---|---|
| Injury Claims | 975 | 238 |
| Property Claims | 981 | 241 |
| Vehicle Claims | 1000 | 247 |
Kaynak bu sayıları Table 3 altında raporlamaktadır. Bunlar birbirinden bağımsız üç farklı örneklem olarak yorumlanmamalıdır; aynı sigorta kaydının injury, property ve vehicle claim bileşenleri bulunabilir.
Özellik yorumlarının sınırı
Kaynak discussion bölümünde yüksek claim amount, missing police report ve belirli incident characteristics gibi değişkenlerin fraud göstergesi olabileceğini belirtmektedir. Ancak çalışmada feature-importance grafiği, SHAP değeri, permutation importance, Logistic Regression katsayı anlamlılığı veya başka nicel açıklanabilirlik analizi raporlanmamaktadır.
Bu nedenle söz konusu özellikler kaynak yazarlarının gözlemsel/model yorumlarıdır; bu PDF'den hangi değişkenin “en güçlü fraud belirleyicisi” olduğu nicel olarak sıralanamaz.
Bu Sonuçlar Gerçek Sigorta Sistemlerindeki Canlı Performansı Kanıtlıyor mu?
Hayır. Modeller kamuya açık tarihsel bir veri kümesinde tek train-test ayrımıyla değerlendirilmiş ve gerçek bir sigorta şirketinin canlı claim-processing sistemine entegre edilmemiştir; dolayısıyla raporlanan %79 Decision Tree accuracy'si veya diğer metrikler gerçek saha performansının garantisi değildir ve farklı ülke, ürün, fraud tipi veya veri dağılımında yeniden doğrulama gerekir.
Çalışmanın kendi sınırlılıkları
- Kamuya açık veri gerçek sigorta operasyonlarının bütün karmaşıklığını yansıtmayabilir.
- Her modelin varsayımları veri yapısıyla tam uyumlu olmayabilir.
- Modeller yalnız tarihsel veri üzerinde sınanmıştır.
- Canlı sigorta sistemi entegrasyonu yapılmamıştır.
- Çalışmanın ilk sınırlılık açıklaması yorumlanabilirlik analizinin sınırlı olduğunu kabul etmektedir.
- Sonuçların farklı ülke, sektör veya veri kümelerine doğrudan taşınması garanti edilmemektedir.
Ek yeniden üretilebilirlik sınırlılıkları
- Decision Tree tuning parametreleri raporlanmamaktadır.
- Random Forest hiperparametreleri raporlanmamaktadır.
- Encoding ve scaling teknikleri açıkça adlandırılmamaktadır.
- Random seed ve stratified splitting bilgisi verilmemektedir.
- Cross-validation uygulanmış sonuç raporlanmamaktadır.
- Bağımsız dış test seti bulunmamaktadır.
- Confidence interval veya formal model-karşılaştırma anlamlılık testi raporlanmamaktadır.
- AUC-ROC, PR-AUC veya calibration metriği verilmemektedir.
- Yanlış pozitif ve yanlış negatiflerin ekonomik maliyeti modellenmemektedir.
Kaynak-içi editoryal ve sayısal tutarsızlıklar
- Decision Tree confusion matrix'inin sayıları tuned modelin %79 sonucuyla uyumlu olduğu halde ilgili caption “Initial Model” ifadesi taşımaktadır.
- Bir şekil başlığı “Figure 5: Enter Caption” biçiminde tamamlanmamış kalmıştır.
- Random Forest açıklaması perfect training accuracy derken Table 2 training accuracy'yi 0,7887 vermektedir.
- Abstract kategorik dönüşüm ve scaling uygulandığını belirtirken yöntem bölümü bunların teknik ayrıntılarını vermemektedir.
Çalışmanın önerileri
Kaynak gelecek uygulamalar için dört yön önermektedir. Birincisi, doğruluk yanında yorumlanabilirliği artırmak için SHAP gibi araçların kullanılmasıdır. İkincisi, ML skorlarının uzman kurallarıyla birleştirilmesidir. Üçüncüsü, sınıf dengesizliği için SMOTE, cost-sensitive algoritmalar veya ensemble yöntemlerin değerlendirilmesidir. Dördüncüsü, özelliklerin farklı veri kümelerinde yeniden test edilmesi ve gerçek veya proprietary sigorta verileriyle dış doğrulama yapılmasıdır.
Bu tekniklerin öneri olarak verilmesi önemlidir: mevcut çalışmada SHAP, SMOTE veya cost-sensitive training uygulanmış değildir ve bunlara ait yeni performans sonucu raporlanmamaktadır.
Çalışmanın desteklediği sonuçlar
- İncelenen veri kümesinde tuned Decision Tree dört model içinde en dengeli test performansını üretmiştir.
- Decision Tree için test accuracy %79, recall 0,6909, F1-score 0,6441 ve MCC 0,4984'tür.
- Random Forest %72 accuracy üretmesine rağmen test fraud vakalarının hiçbirini doğru sınıflandıramamıştır.
- Logistic Regression ve Naïve Bayes'in fraud recall değerleri çok düşüktür.
- Sınıf dengesizliği bulunan fraud probleminde F1, recall ve MCC accuracy'nin tek başına göstermediği model davranışını görünür hale getirmiştir.
- Veri temizleme ve özellik seçimi model geliştirme sürecinin önemli parçalarıdır.
Çalışmanın desteklemediği sonuçlar
- Decision Tree'nin bütün sigorta fraud veri kümelerinde evrensel olarak en iyi model olduğu gösterilmemiştir.
- Modelin gerçek sigorta operasyonunda %79 accuracy sağlayacağı kanıtlanmamıştır.
- Random Forest'ın genel olarak fraud detection için başarısız bir algoritma olduğu sonucu çıkarılamaz; yalnız bu deneydeki yapı başarısız olmuştur.
- Belirli özelliklerin fraud'un nedensel nedeni olduğu gösterilmemiştir.
- Kaynak feature importance sıralaması veya SHAP analizi sunmamaktadır.
- SMOTE, cost-sensitive learning veya SHAP'ın bu veri kümesinde performansı artırdığı test edilmemiştir.
- Model farklarının istatistiksel olarak anlamlı olduğu formal olarak gösterilmemiştir.
- Çalışma finansal kayıp azalmasını gerçek sigorta operasyonunda ölçmemiştir.
Kaynak ve Yöntem Notu
Tam özgün başlık: Comparative Analysis of Machine Learning Models for Insurance Fraud Detection.
PDF'deki yazar sırası: Praise Owusu Oteng; Francis Mawuse Addae; Edward Tait Kwaw; Catherine Ewoenam Kwablavi; Bismark Sarkodie; Sandra Addai-Henne.
PDF afiliyasyonu: Kwame Nkrumah University of Science and Technology, Department of Statistics and Actuarial Science, Kumasi, Ghana.
SSRN metadata'sındaki Contact Author: Praise Oteng.
Platform: SSRN.
SSRN Abstract ID: 6899161.
DOI: 10.2139/ssrn.6899161.
Date Written: 2 Eylül 2025.
SSRN'de yayımlanma/gönderim: 30 Haziran 2026.
Kaynak türü: Working paper / preprint.
Hakemlik durumu: Güncel bibliyografik doğrulamada hakemli dergi sürümü doğrulanmamıştır.
Lisans: Açık bir Creative Commons lisansı doğrulanmamıştır. Verianla anlatımında kaynak metin, özgün şekil tasarımı ve özgün tablo kompozisyonu yeniden yayımlanmamıştır.
Veri: Kaggle üzerinden elde edilen insurance.claims.csv yapılandırılmış sigorta hasar veri kümesi.
Kaynakta bildirilen değişken yapısı: 40 bağımsız değişken ve fraud-reported Y/N hedefi.
Test kümesi: Kaynak confusion matrix'lerine göre 200 kayıt; 55 fraud ve 145 non-fraud.
Train-test ayrımı: %80 / %20.
Eksik veri işlemi: collision-type, property-damage, authorities-contacted ve police-report-available için mod imputasyonu.
Multicollinearity sonucu: months-as-customer ile age arasında 0,92 korelasyon; age ve total-claim-amount modelleme kümesinden çıkarılmıştır.
Modeller: Decision Tree, Random Forest, Logistic Regression ve Naïve Bayes.
Değerlendirme metrikleri: Accuracy, Precision, Recall, F1-score ve Matthews Correlation Coefficient.
Ana performans sonucu: Decision Tree — train accuracy 0,8225; test accuracy 0,7900; precision 0,6032; recall 0,6909; F1 0,6441; MCC 0,4984.
Önemli sınıf dengesizliği sonucu: Random Forest'ın test accuracy'si 0,7200 olmasına rağmen recall, precision ve F1 değerleri 0'dır ve hiçbir fraud vakası doğru yakalanmamıştır.
Kaynakta açıklanmayan yeniden üretilebilirlik ayrıntıları: Kullanılan kategorik encoding yöntemi, scaler, Decision Tree tuning parametreleri, Random Forest hiperparametreleri, random seed, stratification, preprocessing fit sırası ve software/package sürümleri.
Cross-validation: Kaynağın kendi deneyinde raporlanmamaktadır. Literatür bölümünde başka bir çalışmanın ten-fold cross-validation kullanımı anlatılmaktadır; bu, mevcut çalışmanın yöntemi değildir.
İstatistiksel karşılaştırma: Model farkları için confidence interval, p-değeri veya formal anlamlılık testi raporlanmamaktadır.
Saha doğrulaması: Yoktur.
Canlı sigorta sistemi entegrasyonu: Yoktur.
Açıklanabilirlik analizi: Feature importance veya SHAP analizi mevcut deneyde raporlanmamaktadır; SHAP gelecek uygulamalar için önerilmektedir.
Sınıf dengeleme: SMOTE veya cost-sensitive learning mevcut deneyde uygulanmamış, gelecek çalışma önerisi olarak verilmiştir.
Kaynak-içi tutarsızlık: Random Forest metnindeki “perfect training accuracy” ifadesi Table 2'deki 0,7887 ile uyuşmamaktadır.
Editoryal şekil sorunu: Bir şekil caption'ı “Enter Caption” olarak kalmış; Decision Tree confusion matrix caption'ındaki “Initial Model” ifadesi matriste gösterilen tuned %79 sonuçla uyuşmaktadır.
Finansman: Ayrı bir finansman bildirimi raporlanmamıştır.
Çıkar çatışması: Ayrı bir çıkar çatışması bildirimi raporlanmamıştır.
Veri erişilebilirliği: Kaggle kaynağı belirtilmiştir ancak ayrı bir dataset URL'si, sürüm kimliği veya veri lisans beyanı raporlanmamıştır.
CRediT / yazar katkıları: Ayrı CRediT beyanı raporlanmamıştır.
Acknowledgments: Yazarlar çalışmalarında Tanrı'ya teşekkür etmekte ve Dr. Sandra Addai-Henne'nin danışmanlık katkısını ayrıca belirtmektedir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir