


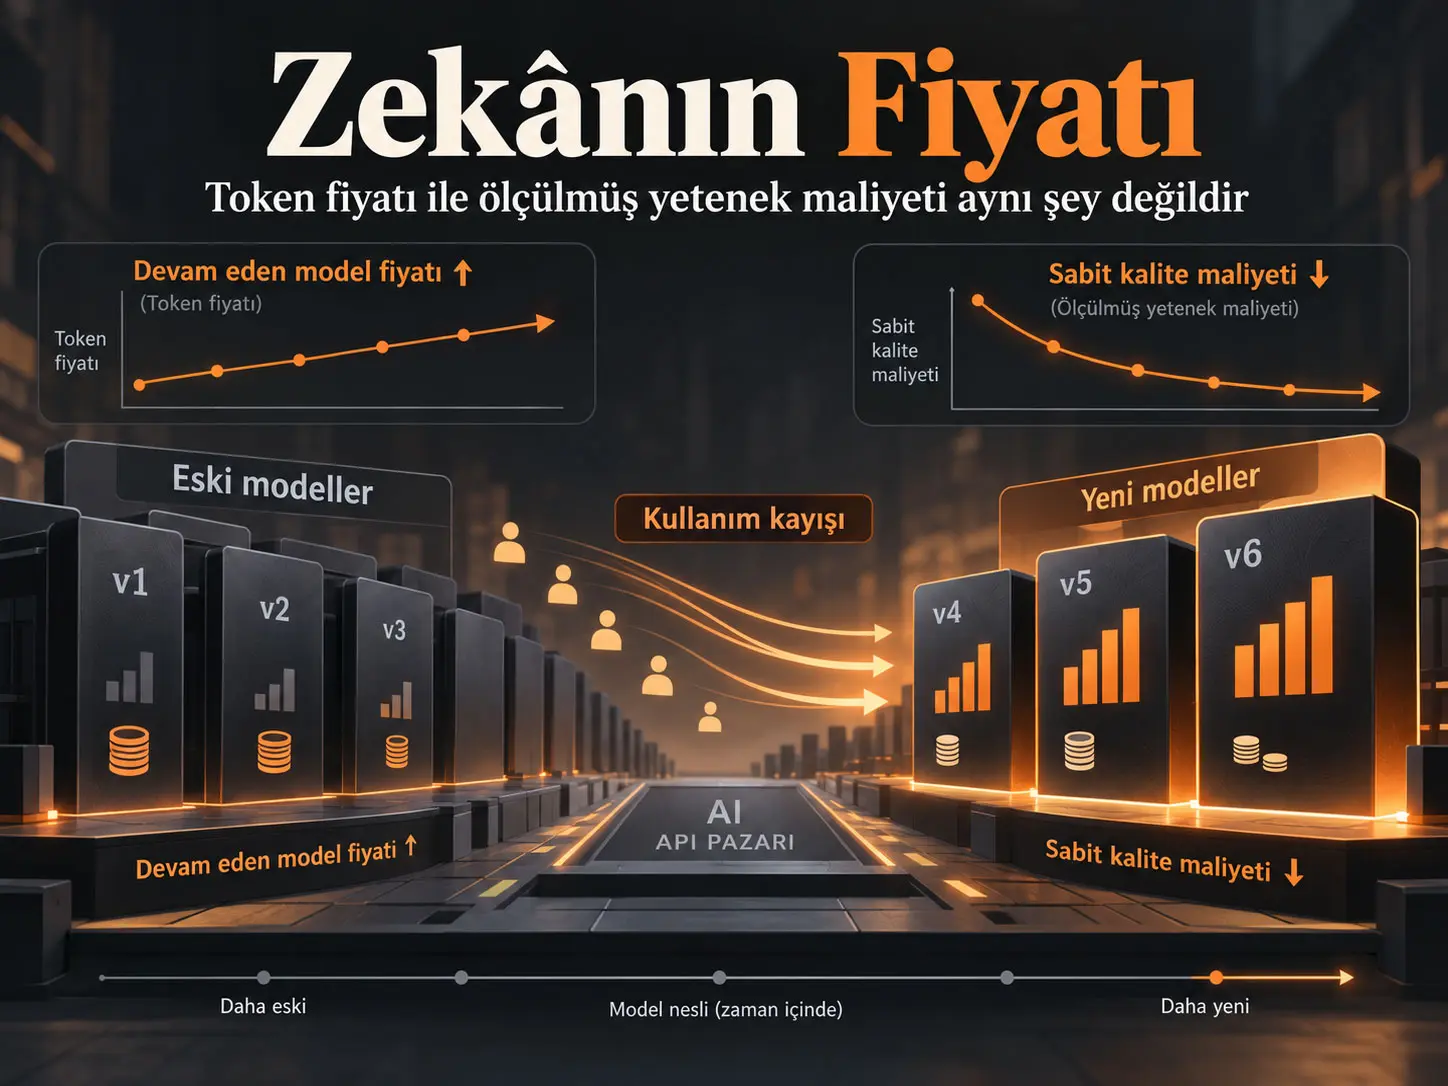
Yapay Zekâ Çıkarım Fiyat Endeksi (AI Inference Price Index, AIPI), yapay zekâ modellerinin yalnız bir milyon token başına ilan edilen fiyatlarını değil, bu tokenların satın aldığı ölçülmüş model yeteneğini de hesaba katan bir fiyat ölçüm çerçevesidir. Cayman Seagraves ve Stace Sirmans, OpenRouter üzerindeki ilan edilmiş çıkarım fiyatlarını ve günlük model kullanımını Artificial Analysis benchmark puanlarıyla eşleştirerek Ocak 2025–Haziran 2026 döneminde dört farklı fiyat ölçüsü oluşturmuştur. Kaynak sürümde piyasada kalmaya devam eden modellerin fiyatları %6,5 artarken sabit ölçülmüş kaliteye göre çıkarım fiyatı %51,9, kullanıcıların seçtiği model sepetinin yetenek başına maliyeti %86,8 ve sabit bir benchmark eşiğini aşan en ucuz modele erişim fiyatı %99,4 düşmektedir. Ancak bu sonuç kamuya açık API piyasasının ölçümüdür; özel kurumsal sözleşmeleri, kendi altyapısında çalıştırılan modelleri, paket yazılım fiyatlarını veya bir gerçek dünya görevinin toplam tamamlama maliyetini temsil etmez.
Çalışmanın merkezi bulgusu, token fiyatı ile makine yeteneğinin ekonomik fiyatının aynı şey olmadığıdır. Eski modeller ortalamada ciddi fiyat indirimi yapmamış olsa bile daha yeni modeller daha yüksek ölçülmüş yeteneği daha düşük maliyetle sunabilmekte ve kullanıcılar bu modellere geçebilmektedir. Böylece piyasadaki “zekânın fiyatı”, tek tek eski ürünlerin etiket fiyatlarından çok, hangi modellerin piyasaya girdiğine, fiyat-performans sınırının nasıl ilerlediğine ve kullanımın hangi model kuşaklarına kaydığına bağlı hale gelmektedir.
Yazarların yorumu ayrıca önemli bir sınır içerir: Artificial Analysis Intelligence Index gerçek ekonomik çıktı veya görev başına üretkenliğin doğal bir fiziksel birimi değildir. Çalışmada model kalitesini karşılaştırmaya yarayan ölçülmüş bir benchmark özelliğidir. Bu nedenle sabit-kalite ve eşik endeksleri güçlü bir fiyat ölçümü sunarken, kullanım ağırlıklı “yetenek başına maliyet” serisi kullanıcıların fiilen seçtiği model sepetini de yansıtan betimleyici bir piyasa-durumu ölçüsüdür.
Ekonomik problem: Bir tokenın fiyatı neden tek başına yeterli değildir?
Yapay zekâ çıkarımı, önceden eğitilmiş bir modelin bir isteme yanıt üretmesi için kullanılmasıdır. API sağlayıcıları bu hizmeti çoğunlukla giriş ve çıkış tokenları üzerinden fiyatlandırır. Bu nedenle ilk bakışta “yapay zekânın fiyatı” bir milyon token başına dolar olarak ölçülebilir. Sorun, farklı modellerin aynı token miktarıyla aynı düzeyde muhakeme, kodlama, bilgi veya nicel problem çözme yeteneği sunmamasıdır. Bir milyon tokenlık yeni bir model kullanımı, eski bir modeldeki bir milyon tokenla ekonomik olarak aynı hizmet akışını temsil etmeyebilir.
Çalışma bu nedenle üç ayrı değişimin birbirinden ayrılması gerektiğini savunur: piyasada zaten bulunan modellerin ilan edilmiş fiyatlarının değişmesi, modellerin ölçülmüş kalitesinin değişmesi ve kullanıcıların hangi modelleri seçtiğinin değişmesi. Ham token fiyatı bu üç marjı birbirine karıştırabilir.
Yapay zekâ çıkarımında token fiyatı ile “zekânın fiyatı” arasındaki fark nedir?
Token fiyatı sağlayıcının faturalandırdığı metin biriminin fiyatıdır; çalışmadaki “zekânın fiyatı” ise belirli miktarda ölçülmüş benchmark yeteneğini satın almak için gereken ekonomik maliyettir. Model kalitesi zaman içinde hızla değiştiği için aynı token miktarı farklı model kuşaklarında farklı miktarda ölçülmüş yetenek sağlayabilir.
Çalışmanın dört ayrı fiyat ölçüsü
Araştırmacılar tek bir endeksin bütün soruları yanıtlamadığını kabul ederek dört farklı ölçü oluşturur.
| Ölçü | Temel soru | Kaynak sürümde ana sonuç | Doğru yorum |
|---|---|---|---|
| Devam eden model endeksi | Piyasada zaten bulunan modeller kendi ilan fiyatlarını düşürdü mü? | +%6,5 | Eski ürünlerin ortalama fiyatı düşmemiş, yükselmiştir. |
| Sabit-kalite hedonik fiyat endeksi | Aynı ölçülmüş benchmark yeteneğinin satın alınma maliyeti nasıl değişti? | -%51,9 | Çalışmanın temel kalite-düzeltilmiş fiyat ölçüsüdür. |
| Sabit-yetenek eşiği erişim fiyatı | Belirli benchmark düzeyine ulaşan en ucuz modelin fiyatı nasıl değişti? | -%99,4; q ≥ 38,4 eşiği | Minimum fiyat ölçüsüdür; tek bir çok ucuz modele duyarlı olabileceği için sağlamlık testleri yapılmıştır. |
| Kullanıcı sepetinde yetenek başına maliyet | Kullanıcıların fiilen seçtiği modellerin fiyat-kalite bileşimi nasıl değişti? | -%86,8 | Saf fiyat şoku değil; fiyat, model bileşimi ve kullanım göçünü birlikte yansıtır. |
Veri kaynakları ve örneklem
İlan edilmiş model fiyatları OpenRouter’dan alınmıştır. OpenRouter, farklı sağlayıcıların modellerine ortak bir API arayüzü üzerinden erişim sağlayan bir çıkarım pazarıdır. Çalışma her modeli, tipik bir isteği yaklaşık temsil etmek üzere kullanılan 3:1 giriş–çıkış token bileşimi ile bir milyon token başına harmanlanmış fiyat üzerinden özetlemektedir. Güncel fiyatlar canlı katalogdan, geçmiş fiyatlar ise arşivlenmiş sağlayıcı ve pazar fiyat sayfalarından oluşturulan aylık fiyat anlık görüntülerinden alınmıştır.
Model kullanım miktarı OpenRouter’ın günlük model sıralamalarındaki token hacimlerinden gelir. Böylece araştırmacılar yalnız piyasada hangi modellerin bulunduğunu değil, kullanıcıların hangi modelleri gerçekten ne ölçüde kullandığını da gözlemleyebilir.
Kalite ölçümü için Artificial Analysis Intelligence Index kullanılmıştır. Bu bileşik puan muhakeme, kodlama ve nicel benchmarkları birleştirir. OpenRouter model adları ile Artificial Analysis kayıtları sağlayıcı ve model adına dayalı sürümlenmiş bir eşleştirme tablosu aracılığıyla bağlanmıştır; ana metinde bu eşleştirmenin pazar token hacminin yaklaşık %94’ünü kapsadığı belirtilmektedir.
| Yapı | Örneklem bilgisi |
|---|---|
| Aylık sabit-kalite ana paneli | 18 fiyat anlık görüntüsü; 2.625 eşleştirilmiş fiyat-kalite gözlemi; 313 model |
| A1 örneklem özeti | 250 benzersiz normalize token seti; 24 sağlayıcı |
| Günlük piyasa-durumu başlangıç örneklemi | 513 kullanım günü |
| En az %70 fiyatlandırılmış ve puanlanmış hacim kapsaması sağlayan güvenilir günler | 300 gün |
| Güvenilir günlerde ortalama fiyatlandırılmış ve puanlanmış token kapsaması | %80,1 |
| Yeni-mal analizinde release-date guard uygulanmış günlük panel | 259 güvenilir gün; 8.399 fiyatlandırılmış ve puanlanmış model-gün |
Örneklem sayılarının farklı bölümlerde değişmesi bir tutarsızlık değildir. Ana hedonik fiyat paneli daha geniş örneklemi kullanırken bazı yeni-mal ve benchmark sağlamlık analizleri modelin benchmark yayın tarihinden önceki fiyat gözlemlerini dışlayan daha dar bir “release-date guard” uygular.
Hedonik sabit-kalite fiyat endeksi
Sabit-kalite fiyat endeksi, model fiyatının benchmark yeteneğiyle sistematik olarak değişebileceğini kabul eden hedonik bir regresyondan elde edilir:
\[ \ln p_{m,t} = \theta \tilde{q}_m + \phi \tilde{q}_m^2 + \delta_{g(m)} + \tau_t + \varepsilon_{m,t} \]
Burada \(p_{m,t}\), \(m\) modelinin \(t\) fiyat anlık görüntüsündeki bir milyon harmanlanmış token başına ilan fiyatıdır. \(q_m\), Artificial Analysis intelligence score değeridir; \(\tilde{q}_m\) bu skorun örneklem medyanı çevresinde merkezlenmiş halidir. \(\delta_{g(m)}\) sağlayıcı sabit etkilerini, \(\tau_t\) zaman/anlık görüntü sabit etkilerini ve \(\varepsilon_{m,t}\) açıklanmayan bileşeni gösterir.
Model kalitesi sabit tutulduğunda zaman sabit etkilerinin izlediği hareket, aynı ölçülmüş benchmark yeteneğinin fiyatındaki değişimi verir. Kalite örneklem medyanında merkezlendiği için \(\theta\), medyan kalite düzeyindeki marjinal fiyat-kalite eğimini temsil eder.
Ana tahminde benchmark skorundaki bir puanlık artış medyan kalite civarında log fiyatla +0,059 ilişkilidir ve t-istatistiği 11,7’dir. Kareli kalite terimi -0,0006’dır ve t = -3,3’tür. Bu negatif ikinci dereceden terim, kalite yükseldikçe marjinal fiyat-kalite eğiminin frontier bölgesine doğru yataylaştığını gösterir. Regresyon 2.625 fiyat gözlemi ve 313 modeli kapsar; \(R^2 = 0,48\)’dir.
Kalite sabit tutulduğunda yapay zekâ çıkarım fiyatı ne kadar düştü?
Yüklenen 26 Haziran 2026 kaynak sürümünde Ocak 2025–Haziran 2026 arasında sabit ölçülmüş benchmark kalitesinin hedonik çıkarım fiyatı %51,9 düşmüştür; model-kümeli bootstrap ile bildirilen %95 güven aralığı yaklaşık -%64,5 ile -%31,9 arasındadır.
Sonucun benchmark seçimine dayanıp dayanmadığı nasıl kontrol edildi?
Artificial Analysis tek bir güncel kalite skoru yayımladığı için araştırmacılar her modelin tarihsel olarak o tarihte hangi benchmark puanına sahip olduğunu tam bir “as-of” zaman serisi şeklinde yeniden kuramamaktadır. Yazarlar bu sınırlılığı gizlemek yerine çeşitli sağlamlık kontrolleriyle sınırlar.
| Kalite ölçümü / kontrolü | Sabit-kalite fiyat değişimi |
|---|---|
| Ana kardinal Artificial Analysis skoru | -%51,9 |
| Model yayın tarihinden önceki fiyatların çıkarılması | -%53,8 |
| Rank-normalized kalite | -%48,6 |
| En üst benchmark desilinin çıkarılması | -%52,3 |
Bağımsız kalite ölçüsü olarak LMArena insan-tercihi Elo puanları kullanıldığında iki kalite sıralamasının eşleşen modellerde Spearman korelasyonu 0,85’tir. LMArena’ya göre sabit-kalite endeksi aynı alt örneklemde %68,7 düşmektedir; aynı modellerde Artificial Analysis tabanlı düşüş %65,6’dır. Bu kontrol, ana sonucun yalnız tek bir benchmark sağlayıcısının ölçeğine bağlı olmadığını destekler.
Her yeteneğin ekonomik fiyatı aynı mı?
Hayır. Çalışmanın dikkat çekici sonuçlarından biri “zekâ” olarak tek bir fiyatlanmış özellik varsaymanın yetersizliğidir. Farklı benchmark bileşenleri ayrı ayrı kullanıldığında Ocak 2025–Haziran 2026 arasında ölçülmüş kodlama yeteneğinin sabit-kalite fiyatı %68,6, MMLU-Pro geniş bilgi yeteneğinin fiyatı %59,8 ve GPQA yüksek düzey muhakeme yeteneğinin fiyatı %61,1 düşerken matematik bileşeni %41,9 artmaktadır.
| Ölçülmüş yetenek | Sabit-kalite uçtan uca değişim | Ortalama fiyat korelasyonu | Ortak hedonikte 1 standart sapma fiyat primi |
|---|---|---|---|
| Kodlama | -%68,6 | +0,73 | +0,595; t = +2,7 |
| Muhakeme / GPQA | -%61,1 | +0,59 | +0,051; t = +0,2 |
| Geniş bilgi / MMLU-Pro | -%59,8 | +0,80 | +0,848; t = +3,3 |
| Matematik | +%41,9 | +0,45 | -0,454; t = -2,2 |
Kodlama fiyat korelasyonu 18 fiyat anlık görüntüsünün 16’sında matematik korelasyonundan yüksektir. Dolayısıyla araştırmacılar, bu pazar ve benchmark yapısında ölçülen “zekâ fiyatının” büyük ölçüde kodlama ve geniş bilgi kapasitesinin fiyatını yansıttığı uyarısını yapar.
Model kuşakları neden klasik fiyat endekslerini zorlaştırıyor?
Geleneksel eşleştirilmiş-ürün fiyat endeksi aynı ürünün iki tarihteki fiyatını karşılaştırır. Yapay zekâ model piyasasında ise ticari ürünlerin ömrü çok kısadır. Çalışmada tepe aylık kullanımına ulaştıktan sonra örneklem içinde kullanım kaybeden modeller arasında medyan ticari yarı ömür yalnız 2,0 ay, çeyrekler arası aralık 1–2 aydır. Kullanım ağırlıklı medyan model yaşı 94 gündür ve medyan olarak kullanımın %82’si altı aydan daha genç modeller üzerinde gerçekleşmektedir.
Ayrıca son 30 günlük pencerede 90 günden genç modeller fiyatlandırılmış ve puanlanmış kullanımın %70,9’unu oluşturur. Bu kadar hızlı ürün devri altında Ocak 2025’te satılan ürünlerle Haziran 2026’da yoğun kullanılan ürünlerin ortak kümesi çok küçülür. Dolayısıyla yalnız “aynı modeli iki tarihte karşılaştıran” yöntem piyasanın ekonomik olarak önemli bölümünü kaçırabilir.
Fiyat-performans sınırının hareketi
Kaynağın Şekil 2’si Ocak 2025, Ekim 2025 ve Haziran 2026 fiyat anlık görüntülerinde modellerin ölçülmüş yetenek ile bir milyon token başına fiyat uzayındaki konumlarını gösterir. Zaman içinde daha genç modeller daha yüksek yetenek ve daha düşük maliyet kombinasyonlarıyla alt fiyat-performans zarfını dışarı taşımaktadır. Bu, eski bir ürünün kendi fiyatını azaltmasıyla aynı mekanizma değildir. Kullanıcı aynı yetenek düzeyini piyasadaki daha yeni bir ürün üzerinden daha ucuz satın alabilmektedir.
Ekonomik fiyat çerçevesi
Yazarlar bir modelin token başına ölçülmüş yeteneğini \(q\), token başına marjinal hesaplama maliyetini \(c\) ve maliyet üzerindeki fiyatlama çarpanını \(\mu \ge 1\) olarak tanımlar. İlan edilen token fiyatı:
\[ p = \mu c \]
Bir birim ölçülmüş yeteneğin çerçeve içindeki fiyatı ise:
\[ P = \frac{p}{q} = \mu\frac{c}{q} \]
Bu denklemin logaritmik değişimi:
\[ \Delta\ln P = \Delta\ln\mu + \Delta\ln c - \Delta\ln q \]
şeklindedir. Denklem, yetenek başına fiyatın yalnız modelin ilan fiyatından oluşmadığını açıklaştırır. Marjlar veya marjinal hesaplama maliyeti aynı kalsa bile token başına yetenek \(q\) yükselirse yetenek başına ekonomik fiyat \(P\) düşebilir. Çalışma \(\mu\) değerlerini yapısal olarak tahmin etmemektedir; denklem ampirik sonuçların hangi ekonomik marjlardan oluşabileceğini düzenleyen bir çerçevedir.
Açık ağırlıklı modellerin rolü
Açık ağırlıklı modeller, kullanıcıların modeli dışarıda çalıştırabilmesi veya açık sağlayıcılar üzerinden erişebilmesi durumunda kapalı modeller için bir dış seçenek oluşturabilir. Çalışmanın çerçevesine göre bu seçenek yetenek, gecikme, güvenilirlik ve entegrasyon açısından yeterince yakın bir ikame olduğunda kapalı model sağlayıcılarının fiyatlama gücünü sınırlayabilir. Ancak makale doğrudan marj tahmini yapmadığından “açık modeller fiyatları şu kadar düşürdü” biçiminde nedensel bir sonuç üretmez. Ek bölümdeki açık-ağırlık giriş olayları rekabet için betimleyici bir tanı testi olarak sunulmaktadır.
Çalışmanın Yöntemi ve Bulguları
İlan edilmiş fiyatın oluşturulması
Girdi ve çıktı tokenları farklı fiyatlandırıldığı için ana analizde harmanlanmış fiyat şu genel yapının 3:1 özel haliyle oluşturulur:
\[ p_{\text{blend}} = \frac{3p_{\text{in}} + p_{\text{out}}}{4} \]
Burada \(p_{\text{in}}\) giriş token fiyatını, \(p_{\text{out}}\) çıkış token fiyatını gösterir. Ek sağlamlık analizinde yalnız giriş, 1:1, 3:1, 10:1 ve yalnız çıkış ağırlıkları denenmiştir. Sabit-kalite fiyatındaki düşüş bütün bu seçeneklerde yaklaşık %49,3 ile %53,8 arasında kalmakta; kullanıcı sepetinin uçtan uca yetenek başına maliyet düşüşü ise yaklaşık %86,6 düzeyinde değişmeden kalmaktadır. Böylece ana sonuç belirli bir giriş–çıkış token ağırlığı seçiminin ürünü değildir.
Beş ana fiyat göstergesinin uzlaştırılması
| Fiyat ölçüsü | Uçtan uca değişim |
|---|---|
| Ham medyan ilan fiyatı | -%73,5 |
| Devam eden model eşleştirilmiş endeksi | +%6,5 |
| Hedonik sabit-kalite fiyatı | -%51,9 |
| Sabit-yetenek eşiğine erişim, q ≥ 38,4 | -%99,4 |
| Kullanıcı sepetinde yetenek başına maliyet | -%86,8 |
Bu tablo çalışmanın “ölçüm kaması” olarak adlandırılabilecek temel sonucunu gösterir. Aynı pazar için hangi ekonomik nesnenin sabit tutulduğuna bağlı olarak fiyat değişiminin yönü ve büyüklüğü ciddi biçimde değişmektedir.
Yapay zekâ yeteneğinin maliyetindeki düşüşü eski modellerin fiyat indirimi mi açıklıyor?
Hayır. Kaynak sürümde devam eden modellerin fiyatları %6,5 yükselirken zincirlenmiş kullanıcı-sepeti ayrıştırmasında devam eden modellerin fiyat değişimleri toplam -178,8 log yüzde puanlık maliyet düşüşünün yalnız yaklaşık -2,7 log yüzde puanını açıklamaktadır; esas hareket kullanımın modeller arasında yeniden dağılması ve yeni model girişleriyle değişen ürün menüsünden gelmektedir.
Zincirlenmiş kullanıcı-sepeti ayrıştırması
Yazarlar uzak iki uç noktayı doğrudan karşılaştırmak yerine ardışık fiyat anlık görüntülerinin çevresindeki geriye dönük kullanım pencerelerini zincirler. Bu ayrıştırma düzey yüzde değişimi değil, \(100 \times \Delta\ln\) biriminde log yüzde puanlarını kullanır.
| Bileşen | Kümülatif katkı | Ana yorum |
|---|---|---|
| Devam eden modellerin fiyat değişimi | -2,7 log yüzde puanı | Toplamın yaklaşık %1’i |
| Devam eden modeller arasında kullanımın yeniden dağılımı | -106,2 log yüzde puanı | Yaklaşık %59 |
| Net giriş, çıkış ve frontier bileşeni | -69,9 log yüzde puanı | Yaklaşık %39 |
| Toplam | -178,8 log yüzde puanı | Zincirlenmiş kullanıcı-sepeti maliyet değişimi |
Burada önemli bir metodolojik uyarı vardır. Kullanımın devam eden modeller arasındaki yeniden dağılımı ile “yeni giriş” bileşeninin tam paylaşımı zincirleme aralığına bağlıdır. Yaklaşık 30 günlük ardışık eşleştirmede net giriş payı %39 iken daha geniş aralıklarda daha önce “yeni giriş” olan bir model artık devam eden model sayılabilir. Bu yüzden çalışma giriş ile yeniden dağılım arasındaki tek bir oranı yapısal gerçek olarak sunmaz.
Sağlam kalan bulgu iki parçadan oluşur: toplam maliyet düşüşü büyüktür ve devam eden modellerin kendi fiyat değişiminin katkısı her zincirleme şemasında yok denecek kadar küçüktür. Aralık değiştirildiğinde toplam yaklaşık -178,8 ile -169,8 log yüzde puanı arasında kalır. Ardışık aralık bootstrap analizinde toplam için %95 aralık -183,8 ile -173,4; devam eden fiyat bileşeni için -3,0 ile -2,2 log yüzde puanıdır.
Uç nokta karşılaştırması neden yanıltıcı olabilir?
İlk ve son 30 günlük kullanım pencerelerinde fiyatı, kalite puanı ve kullanımı birlikte gözlenen yalnız bir ortak token seti bulunmaktadır. Son uç noktadaki fiyatlandırılmış ve puanlanmış tokenların %98,5’i başlangıç penceresinde bulunmayan modellerden gelir. Bu nedenle doğrudan ilk-son ayrıştırması matematiksel olarak neredeyse bütün değişimi “giriş/çıkış/frontier” bileşenine yükler. Yazarlar bunu ana nedensel ayrıştırma değil, uzun dönem ortak desteğin ne kadar ince olduğunu gösteren tanı olarak kullanır.
Model kümesini ve kullanım ağırlıklarını sabitleyen kontrol
| Ağırlıklandırma | Uçtan uca değişim |
|---|---|
| Tüm modeller, zamanla değişen gerçek kullanım ağırlıkları | -%73,5 |
| Yalnız iki uç noktada da bulunan ortak modeller | +%2,9 |
| Ortak modeller ve başlangıç kullanım ağırlıkları sabit | +%0,0 |
Bu kontrol farklı bir uç nokta penceresi kullandığı için -%86,8 ana günlük uçtan uca istatistiğiyle aynı sayı değildir. Bilimsel mesaj ise aynıdır: model girişleri ve kullanıcı göçü kaldırıldığında büyük maliyet düşüşü ortadan kalkmaktadır.
Yeni ürünlerin fiyat endeksindeki rolü: Feenstra/CES yaklaşımı
Çalışma yeni model çeşitlerinin klasik eşleştirilmiş-ürün endeksi tarafından kaçırılan katkısını ayrıca Feenstra tipi CES kesin fiyat endeksiyle ölçer. Endeks, ardışık dönemlerde ortak olan modeller için Sato–Vartia eşleştirilmiş ürün bileşenini ve şu çeşitlilik düzeltmesini içerir:
\[ \left( \frac{\lambda_t}{\lambda_{t-1}} \right)^{1/(\sigma-1)} \]
Burada \(\lambda_\tau\), ilgili dönemin harcamasının iki dönemde de ortak olan modellere giden payını; \(\sigma\), modeller arasındaki ikame esnekliğini temsil eder.
Fiyat ile ölçülmüş kalite bu pazarda yüksek derecede birlikte hareket ettiği için \(\sigma\) güvenilir biçimde tahmin edilememektedir. Araştırmacılar bu nedenle farklı kalibre edilmiş değerleri raporlar.
| İkame esnekliği | CES kesin fiyat endeksi değişimi | Çeşitlilik düzeltmesi | Eşleştirilmiş ürün bileşeni |
|---|---|---|---|
| σ = 2 | -%99,8 | -%99,8 | -%2,9 |
| σ = 3 | -%95,6 | -%95,4 | -%2,9 |
| σ = 5 | -%79,2 | -%78,6 | -%2,9 |
| σ = 10 | -%51,1 | -%49,6 | -%2,9 |
Mutlak büyüklük \(\sigma\) varsayımına bağlıdır; fakat eşleştirilmiş ürün bileşiminin yalnız %2,9 düşmesi ve esas hareketin çeşitlilik/yeni-mal bileşeninden gelmesi kalibrasyonlar boyunca değişmez. İlginç biçimde \(\sigma \approx 10\) düzeyindeki CES sonucu -%51,1 ile bağımsız hedonik sabit-kalite sonucu olan -%51,9’a çok yaklaşmaktadır.
Sabit benchmark eşiğine erişimin fiyatı
Eşik endeksi, belirli Artificial Analysis skorunu geçen en ucuz modelin ilan fiyatını izler. Fiyat bir minimum olduğu için tek bir çok ucuz modelden etkilenebilir. Kaynak bu nedenle farklı eşikleri ve her seferinde bir modelin çıkarıldığı leave-one-model-out kontrollerini raporlar.
| Benchmark eşiği | Fiyat değişimi | Leave-one-model-out aralığı |
|---|---|---|
| q ≥ 16,3 | -%99,1 | -%99,7 ile -%96,5 |
| q ≥ 25,2 | -%99,9 | -%99,9 ile -%99,7 |
| q ≥ 38,4 | -%99,4 | -%99,4 ile -%99,3 |
Bu sonucun çok büyük olması nedeniyle araştırmacılar ana başlık ölçüsü olarak eşik endeksinden ziyade daha muhafazakâr olan -%51,9’luk hedonik sabit-kalite endeksini öne çıkarır.
Günlük piyasa-durumu endeksi ne gösteriyor?
Günlük endeks, kullanıcıların seçtiği modellerin harmanlanmış fiyatını ve kullanım ağırlıklı benchmark yeteneğini birlikte izler. 2025 ilk çeyrekten 2026 ikinci çeyreğe tutarlı çeyreklik ortalamalarda ham kullanım ağırlıklı maliyet yaklaşık %32 düşerken, kullanım ağırlıklı ölçülmüş yetenek yaklaşık %110 artmış ve yetenek başına maliyet yaklaşık %68 düşmüştür.
| Dönem | Ham maliyet endeksi | Yetenek endeksi | Yetenek başına maliyet endeksi |
|---|---|---|---|
| 2025 Q1 | 62,5 | 133,4 | 48,0 |
| 2025 Q2 | 45,3 | 152,0 | 29,7 |
| 2025 Q3 | 48,4 | 165,4 | 29,4 |
| 2025 Q4 | 34,6 | 183,2 | 18,8 |
| 2026 Q1 | 43,3 | 213,3 | 20,4 |
| 2026 Q2 | 42,8 | 280,5 | 15,3 |
Günlük değişimlerin muhasebe ayrıştırmasında ilan-fiyatı-only bileşiminin açıklanan varyans payı yalnız yaklaşık %0,2 iken kullanım-fiyat-bileşimi bileşimi yaklaşık %105,1’lik imzalı katkı taşır; yetenek bileşimi -%6,3 ve artık +%1,0’dır. Bu değerlerin toplamı muhasebe yapısı gereği %100’e gelir ve kullanım bileşiminin baskınlığını gösterir. Bu analiz nedensel fiyat şoku ayrıştırması değil, günlük piyasa durumunun betimleyici muhasebesidir.
Kısa dönem kullanım talebi
Yazarlar, model düzeyindeki aylık kullanım değişimini modelin ilan edilmiş token fiyatındaki değişimle ilişkilendirir:
\[ \Delta\ln U_{m,t} = -\eta\,\Delta\ln p_{m,t} + \lambda_t + u_{m,t} \]
\(U_{m,t}\) model kullanımını, \(p_{m,t}\) ilan edilmiş token fiyatını, \(\lambda_t\) ay sabit etkilerini ve \(\eta\) fiyat-kullanım esnekliğini gösterir.
Tüm modeller için nokta tahmini \(\eta = 0,40\)’tır. Başka bir ifadeyle %1 fiyat düşüşü yaklaşık %0,40 daha yüksek kullanımla ilişkilidir. Sıfıra karşı t-istatistiği 1,6’dır; model-kümeli bootstrap %95 güven aralığı -0,15 ile +0,90’dır. Birim esneklik hipotezine karşı t = -2,5’tir. Dolayısıyla sonuç “fiyat düşerse kullanım kesin şu kadar artar” şeklinde yapısal bir talep eğrisi değildir. Fiyat sağlayıcıların beklediği talebe tepki verebilir ve model lansmanları rastgele değildir.
Kalite katmanlarında nokta tahminleri düşük kaliteli “commodity” modeller için 0,00, orta katmanda 0,60 ve frontier modellerde 0,77’dir; ancak katman bazındaki bootstrap güven aralıkları sıfırı içermektedir.
Tamamlayıcı sermaye neden önemlidir?
Çalışmanın kavramsal kısa dönem talep çerçevesi şöyledir:
\[ \ln Q_t = a - \eta_{SR}\ln P_t + b\ln K_t + e_t \]
Burada \(Q_t\) satın alınan ölçülmüş yeteneği, \(P_t\) yetenek başına fiyatı, \(K_t\) tamamlayıcı sermayeyi, \(\eta_{SR}\) kısa dönem fiyat esnekliğini gösterir. Tamamlayıcı sermaye yalnız fiziksel sermaye anlamına gelmez; uygulama kodu, istem tasarımı, değerlendirme süreçleri, güvenlik kontrolleri, veri erişimi ve kurumsal güven gibi unsurların ayarlanması zaman alabilir. Bu nedenle ölçülmüş yapay zekâ yeteneğinin fiyatının hızla düşmesi, kullanımın aynı anda bire bir oranda artacağını garanti etmez.
AIPI ekonomik ve finansal araştırmada nasıl kullanılabilir?
Çalışma AIPI serisini firma, sektör, meslek veya makroekonomik verilerle birleştirilebilecek yapay zekâ girdi fiyatı olarak tasarlar. Maruziyet temelli tipik bir ekonometrik tasarım şu şekilde yazılır:
\[ y_{i,t} = \beta \left( E_i \times \Delta\ln AIPI_t \right) + \alpha_i + \gamma_t + \varepsilon_{i,t} \]
\(E_i\), firma, sektör veya mesleğin önceden belirlenmiş yapay zekâ maruziyetini; \(y_{i,t}\) incelenen sonucu; \(\alpha_i\) birim sabit etkilerini; \(\gamma_t\) zaman sabit etkilerini gösterir. Zaman etkileri AIPI’nin genel seviyesini emdiği için tanımlanan katsayı, düşen yapay zekâ girdi fiyatına farklı derecede maruz kalan birimler arasındaki farkı kullanır.
Yazarlar burada önemli bir uyarı yapar: nedensel yorum için \(E_i\) önceden belirlenmiş olmalı ve kullanılan AIPI bileşeni gerçek bir fiyat değişimini temsil etmelidir. Günlük kullanım ağırlıklı piyasa-durumu endeksi büyük ölçüde kullanım bileşimiyle hareket ettiği için nedensel fiyat tasarımlarında sabit-kalite veya sabit-eşik fiyat bileşenleri daha uygundur.
12.000 tokenlık örnek ne anlatıyor?
Çalışma sabit benchmark eşiği endeksini daha sezgisel birimlere çevirmek için yaklaşık 12.000 harmanlanmış tokenlık büyük bir isteği örnek verir. En ucuz sabit benchmark eşiğini geçen modelle böyle bir isteğin ilan edilmiş maliyeti örneklemin başlangıcında yaklaşık 0,32 ABD doları iken sonunda yaklaşık 0,0002 ABD dolarına düşmektedir.
Bu sayı bir “gerçek görev maliyet endeksi” değildir. Kaynak, tamamlanan belirli görev başına gerçekte kaç token gerektiğini gözlemlememektedir. Dolayısıyla bu hesap yalnız fiyat biriminin dönüştürülmesidir; sabit bir görev sepetinin başarıyla tamamlanma maliyetini doğrulamamaktadır.
İşgücü uygulaması
Ekonomik fiyat serisinin olası kullanımını göstermek amacıyla çalışma Revelio’nun halka açık şirketlerdeki SOC-6 düzeyindeki mesleki işe alım akışlarını ve istihdam stoklarını 2021–2026 döneminde O*NET tabanlı görev ölçüleri ve yapay zekâ maruziyet ölçüleriyle birleştirir. 2026 kısmi yıl olduğundan özellikle dikkatle yorumlanır.
| 2025 etkileşimi | Log işe alım katsayısı | t-istatistiği |
|---|---|---|
| Routine Task Intensity | -0,149 | -4,9 |
| AI Occupational Exposure | +0,210 | +5,4 |
| Eloundou GPT exposure | +0,123 | +2,2 |
Görev özelliklerinin birlikte karşılaştırıldığı analizde rutin manuel görev katsayısı -0,102, t = -2,0; rutin olmayan analitik görev katsayısı +0,142, t = +4,0’dır. Görev özelliklerine göre artıklaştırılmış rutinlik katsayısı -0,010 ve t = -0,3’e düşer. Bu nedenle bulgu basit bir “rutin bilişsel işler yapay zekâ tarafından değiştirildi” mekanizmasına indirgenmez; kaynak bunu daha geniş bir mesleki yükseltme/desen değişimi olarak yorumlar.
Bu işgücü sonuçları yapay zekâ fiyat düşüşünün nedensel işgücü etkisini kanıtlamaz. Panel, meslek düzeyinde farklı yapay zekâ fiyat şokları sağlamadığı için yazarlar bunları endeksin nasıl kullanılabileceğini gösteren betimleyici uygulamalar olarak sunar.
Çalışmanın desteklediği sonuçlar
- Kamuya açık API piyasasında aynı ölçülmüş benchmark yeteneğinin fiyatı Ocak 2025–Haziran 2026 arasında belirgin biçimde düşmüştür.
- Bu düşüş, devam eden eski modellerin genel fiyat indirimleriyle açıklanamamaktadır.
- Yeni modellerin girişi, fiyat-performans sınırının hareketi ve kullanıcı kullanımının yeni model kuşaklarına kayması ölçümün temel parçalarıdır.
- Uzun dönem eşleştirilmiş-ürün endeksleri hızlı model devri nedeniyle büyük bir yeni-mal/çeşitlilik marjını kaçırabilir.
- Farklı yetenek alanları piyasada aynı biçimde fiyatlanmamaktadır.
- Sabit-kalite düşüşü alternatif benchmark ölçekleri, LMArena Elo ve farklı giriş–çıkış token fiyat bileşimleri altında devam etmektedir.
Çalışmanın desteklemediği sonuçlar
- AIPI bütün yapay zekâ pazarının fiyat endeksi değildir.
- Özel kurumsal anlaşmaların, self-hosted çıkarımın veya paket yazılımın fiyatı ölçülmemektedir.
- Benchmark puanı gerçek dünya üretkenliğinin kusursuz veya doğal bir ekonomik çıktı birimi değildir.
- Kullanım ağırlıklı günlük endeksteki değişim saf bir fiyat şoku olarak yorumlanamaz.
- İşgücü ilişkileri nedensel iş kaybı veya iş yaratımı kanıtı değildir.
- Open-weight modellerin belirli bir miktarda fiyat indirimi yarattığı yapısal olarak tahmin edilmemektedir.
- Yetenek başına çıkarım fiyatı, kurumun yapay zekâ benimsemesinin toplam maliyeti değildir; veri, entegrasyon, yazılım, değerlendirme, güvenlik ve tamamlayıcı sermaye maliyetleri ayrıca vardır.
Kaynak ve Yöntem Notu
Özgün kaynak başlığı: The Price of Intelligence
Yazarlar: Cayman Seagraves; Stace Sirmans.
PDF sürümündeki kurumlar: Cayman Seagraves — Florida Atlantic University; Stace Sirmans — Auburn University.
Kaynak tarihi: 26 Haziran 2026.
Kaynak türü: Ekonomi ve finans alanında ampirik fiyat ölçümü / çalışma kâğıdı-preprint. Çalışma hakemli bir dergi makalesi olarak sunulmamalıdır.
Bibliyografik sürüm notu: Kullanılan PDF’nin özgün başlığı “The Price of Intelligence” ve örneklem sonu Haziran 2026’dır. Daha sonraki SSRN kaydı “The Price of Intelligence: A Hedonic Index for AI Capability” başlığını taşımakta ve daha ileri bir revizyon içermektedir. Bu Verianla metnindeki nicel sonuçlar daha sonraki revizyondan değil, yüklenen 26 Haziran 2026 PDF sürümünden alınmıştır.
DOI / SSRN kimliği: Güncel bibliyografik kayıtta DOI 10.2139/ssrn.7003679 ve SSRN abstract 7003679 olarak doğrulanmıştır.
JEL sınıflandırması: O33, E31, C43, L86.
Kaynak anahtar kelimeleri: artificial intelligence; inference cost; price index; new goods; economics; finance.
Fiyat ve kullanım verisi: OpenRouter ilan fiyatları, arşivlenmiş aylık fiyat anlık görüntüleri ve günlük model kullanım sıralamaları.
Kalite verisi: Artificial Analysis bileşik Intelligence Index; bağımsız sağlamlık kontrolünde LMArena/Chatbot Arena text Elo.
İşgücü uygulaması: Revelio halka açık şirket meslek verileri; O*NET tabanlı Routine Task Intensity, AI Occupational Exposure ve Eloundou GPT exposure ölçüleri.
Veri erişilebilirliği: Yazarların türettiği AI Inference Price Index serileri, sürümlenmiş model eşleştirme tablosu ve tablo/şekilleri oluşturan yapım ve analiz kodu çoğaltma paketinde yayımlanmaktadır. OpenRouter, Artificial Analysis, LMArena ve Revelio gibi üçüncü taraf girdilerin yeniden dağıtımı kendi kullanım ve lisans koşullarına tabidir.
Lisans: PDF, makalenin kendisi için açık bir yeniden kullanım lisansı belirtmemektedir. Veri erişilebilirliği beyanı, yazarların türettiği AIPI serisi, eşleştirme tablosu ve analiz/yapım kodunun çoğaltma paketinde Creative Commons Attribution lisansı altında yayımlandığını belirtmektedir. Bu lisans üçüncü taraf ham girdilere otomatik olarak uygulanmamalıdır.
Finansman: Yüklenen PDF sürümünde finansman beyanı raporlanmamıştır.
Çıkar çatışması: Yüklenen PDF sürümünde ayrı bir çıkar çatışması beyanı raporlanmamıştır.
Yazar katkıları: Yüklenen PDF sürümünde CRediT veya ayrıntılı yazar katkı bildirimi raporlanmamıştır.
Corresponding author: PDF dipnotunda Stace Sirmans için e-posta adresi verilmiştir; ayrı bir “corresponding author” etiketi açıkça yazılmamıştır.
Temel yöntemsel sınırlılıklar: Örneklem kamuya açık OpenRouter API piyasasıyla sınırlıdır. Özel kurumsal sözleşmeler, self-hosted çıkarım ve paket yazılım fiyatları gözlenmez. Artificial Analysis her model için tek güncel kalite skoru verdiğinden tam tarihsel “as-of” benchmark serisi yeniden oluşturulamamaktadır. Kullanım ağırlıklı endeks fiyat ve model seçimini birlikte taşır. Feenstra/CES analizindeki ikame esnekliği veri içinde güvenilir biçimde belirlenemediğinden kalibre edilir. Kullanım esnekliği ve işgücü sonuçları betimleyicidir ve nedensel yapısal tahminler olarak yorumlanmamalıdır.
Kaynak şekillerinin bilimsel rolü: Ana Şekil 1 devam eden model fiyatı, sabit-kalite maliyeti ve genç model kullanımını yan yana getirir. Şekil 2 fiyat-performans sınırının yeni model kuşaklarıyla ilerlemesini gösterir. Şekil 3 farklı fiyat endekslerinin aynı pazar için nasıl ayrıştığını gösterir. Şekil 4 kullanıcı-sepeti maliyet düşüşünün zincirlenmiş ayrıştırmasını, Şekil 5 ise kullanımın genç model kuşaklarına kayışını ve bu kuşakların daha düşük ölçülmüş yetenek başına maliyetini gösterir. Ek şekiller bootstrap belirsizliği, benchmark eşiklerini, model ailesi bileşimini, ticari yarı ömrü, CES yeni-mal düzeltmesini ve işgücü uygulamalarını test eder.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir