


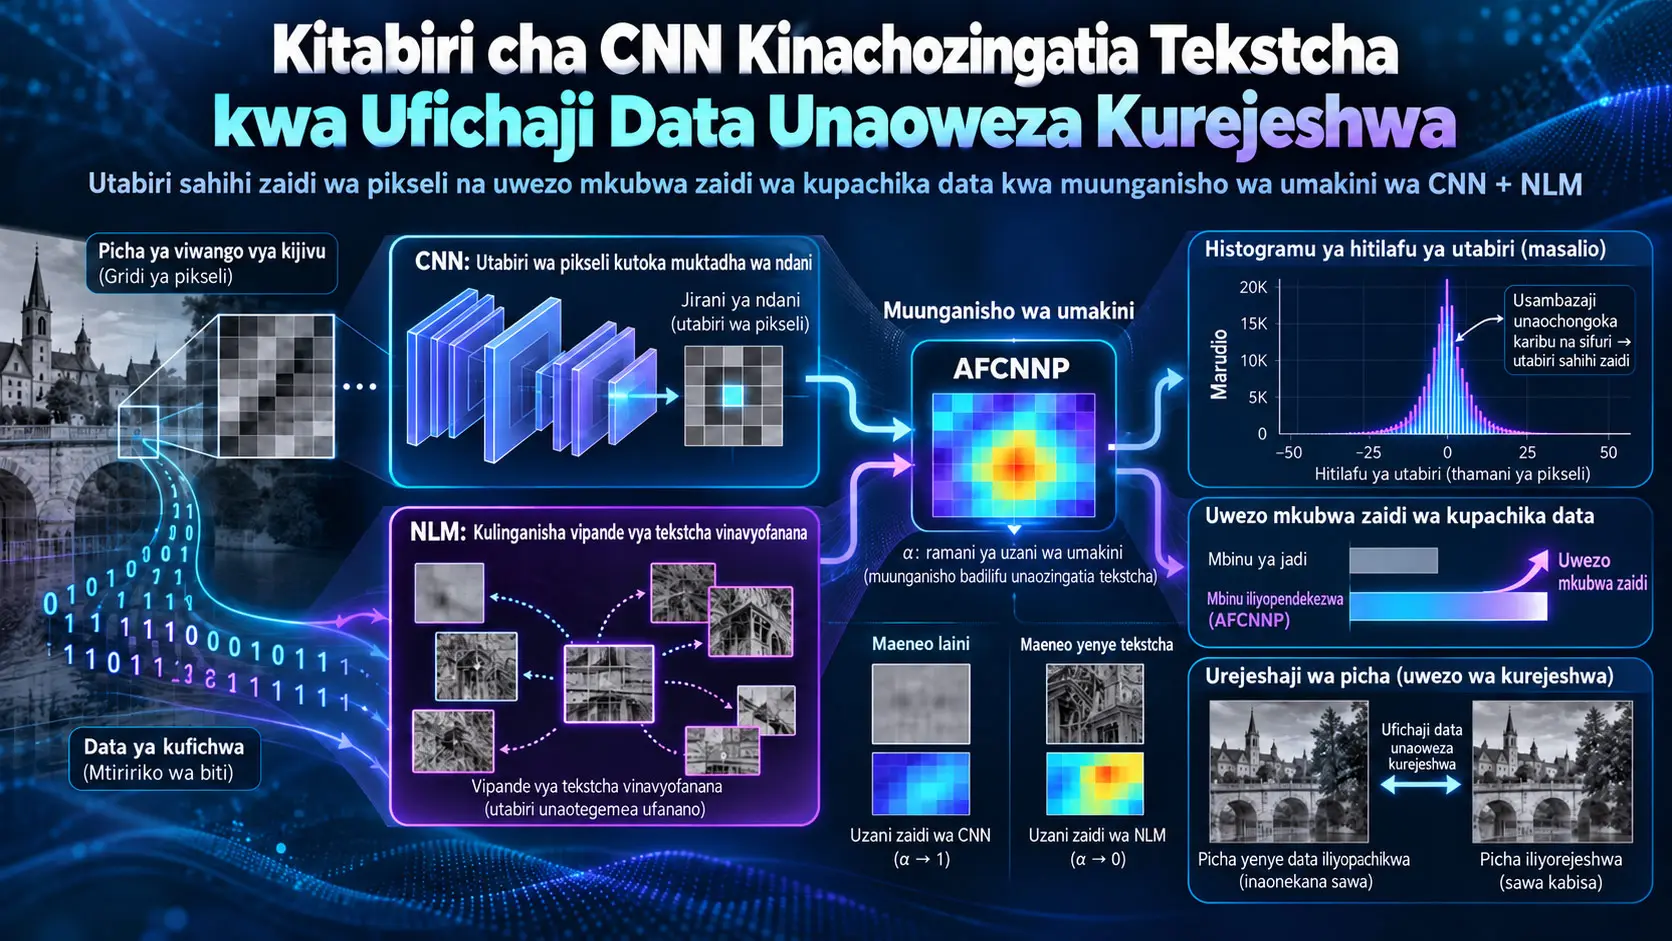
Kitabiri cha CNN chenye muunganisho wa umakini unaozingatia tekstcha (Attention Fusion-Based CNN Predictor, AFCNNP), ni mfumo wa utabiri wa picha unaounganisha, kwa kiwango cha pikseli, utabiri wa ndani wa CNN na utabiri wa wastani usio wa karibu (Non-Local Means, NLM) ili kutabiri thamani za pikseli kwa usahihi zaidi katika ufichaji data unaoweza kurejeshwa. Wazo kuu la mbinu hii ni kuunganisha uwezo mkubwa wa kitabiri cha CNN wa kutumia uhusiano wa ndani katika maeneo laini na uwezo wa NLM wa kutumia viraka vya picha vilivyo mbali lakini vinavyofanana katika maeneo yenye tekstcha. Uzito wa umakini uliojifunzwa \(\alpha(i,j)\) huamua kiasi ambacho CNNP na NLM huchangia katika utabiri wa mwisho kwa kila pikseli.
Lengo la utafiti si kupunguza tu kosa la utabiri wa pikseli. Katika ufichaji data unaoweza kurejeshwa, makosa ya utabiri yanapounda mgawanyo mwembamba na mrefu karibu na sifuri, utaratibu wa Prediction Error Expansion (PEE) unaweza kupachika data nyingi zaidi kwa upotoshaji mdogo wa picha. Kwa hiyo, badala ya kutegemea maeneo laini pekee, AFCNNP hujaribu pia kubadilisha ujifananifu usio wa karibu katika maeneo yenye tekstcha kuwa taarifa ya utabiri inayoweza kutumika.
Katika ulinganisho wa picha 100 za UCID.v2, kwa mbinu iliyopendekezwa MSE iliripotiwa kuwa 51.5, thamani iliyoandikwa “Mean” katika jedwali la chanzo kuwa 3.3, na variansi ya kosa la utabiri kuwa 34.0; thamani hizi zote ni ndogo kuliko za vitabiri vya CNN vilivyolinganishwa. Mbinu ya RDH inayotegemea AFCNNP iliyopendekezwa ilifikia uwezo wa wastani wa juu zaidi wa kupachika wa 125.816 bit huku thamani ya wastani ya PSNR katika hatua hiyo ikiwa 42.58 dB. Kwa picha 24 katika seti ya data ya Kodak, MSE iliripotiwa kuwa \(50.30\pm2.7\) na PSNR kuwa \(64.78\pm0.38\), na katika ulinganisho wa MSE na mbinu ya Lin na wenzake, matokeo ya paired t-test yalikuwa \(p<0.05\).
Matokeo yanaonyesha kwamba katika mpangilio wa majaribio uliotumika, AFCNNP iliweza kuboresha usahihi wa utabiri na utendaji wa upachikaji data kwa kutumia maeneo laini na yenye tekstcha. Hata hivyo, utafiti unatokana na picha za kijivu, usanifu maalum wa CNN/NLM, seti za data za UCID.v2 na Kodak, na mpangilio wa mafunzo ulioripotiwa; matokeo si ushahidi wa moja kwa moja wa ubora katika aina zote za picha au mifumo yote ya RDH.
Ufichaji Data Unaoweza Kurejeshwa Ni Nini?
Ufichaji data unaoweza kurejeshwa (Reversible Data Hiding, RDH) ni mkabala wa kuficha taarifa unaolenga, baada ya data ya ziada kupachikwa kwenye picha mbebaji, kutoa data hiyo ya ziada na pia kurejesha picha asilia ya mbebaji bila upotevu. Katika matumizi ambayo upotoshaji wa kudumu wa pikseli haukubaliki, uwezo huu wa kurejesha ni hitaji la msingi.
Tatizo ambalo utafiti unajaribu kutatua
Katika mbinu za RDH zinazotegemea Prediction Error Expansion, tofauti kati ya thamani halisi ya pikseli na thamani iliyotabiriwa hutumiwa kupachika data. Kadiri utabiri unavyokuwa sahihi, ndivyo thamani za makosa zinavyojikusanya zaidi karibu na sifuri. Hii huzalisha makosa madogo zaidi yanayoweza kutumika kwa upotoshaji mdogo.
Vitabiri vya kawaida vya CNN vinaweza kutumia vizuri uhusiano mkubwa wa ndani kati ya pikseli jirani katika maeneo laini. Hata hivyo, katika maeneo yenye tekstcha nzito, nywele, kitambaa, majani, kingo changamano au mifumo inayojirudia, kuangalia ujirani wa karibu pekee huenda kusitoshe. NLM hutumia aina tofauti ya taarifa katika maeneo yenye tekstcha kwa sababu hutafuta viraka vinavyofanana katika sehemu nyingine za picha. Msingi wa kisayansi wa AFCNNP ni kujifunza mchango wa aina hizi mbili za utabiri kwa kila pikseli na kuziunganisha, badala ya kulazimisha kuchagua moja kwa picha nzima.
Familia ya vitabiri vilivyolinganishwa katika chanzo
| Kitabiri | Aina | Maeneo laini | Maeneo yenye tekstcha | Uwezo wa kupachika |
|---|---|---|---|---|
| [16] | Kawaida | Usahihi wa wastani | Dhaifu, makosa makubwa | Chini |
| [20] | Kawaida | Nzuri katika maeneo laini/ya kingo | Wastani | Wastani |
| [21] | Kawaida | Nzuri sana katika maeneo laini | Dhaifu | Chini |
| [22] | Kawaida | Nzuri kwenye gradianti | Wastani; si thabiti kwenye kelele | Wastani |
| [23] | Kawaida | Nzuri sana kwa difyusheni | Wastani; hatari ya kulainisha kupita kiasi | Wastani |
| [24] | Kawaida | Hujifunza muundo laini | Wastani | Juu |
| [25] | Kawaida | Inayobadilika | Nzuri, imara kwa kiasi | Juu |
| [28] | CNN | Imefunzwa kwa ulaini | Huepuka maeneo yenye tekstcha | Wastani |
| [29] | CNN | Imara katika maeneo laini | Huepuka pikseli zenye kosa kubwa | Wastani |
| [30] | CNN | Eneo pana la upokezi | Upachikaji wa kuchagua | Wastani |
| [31] | CNN | Utabiri mkali wenye kosa dogo | Huondoa tekstcha | Chini |
| [32] | CNN | Huweka uzito kwenye ulaini | Tekstcha yenye uzito mdogo | Chini-Wastani |
| [33] | CNN | Uchaguzi wa uchangamano mdogo | Huondoa tekstcha | Wastani |
Mlinganyo (1): Pikseli inatabiriwaje?
\[ \hat{p}_{i,j}=\mathcal{P}\left(p_{i',j'}\right),\qquad (i',j')\in\mathcal{N}_{i,j} \tag{1} \]
\(p_{i,j}\) ni thamani halisi ya pikseli ya kiwango cha kijivu; \(\hat p_{i,j}\) ni thamani iliyotabiriwa. \(\mathcal{N}_{i,j}\) huwakilisha ujirani au muktadha wa utabiri unaotumika kutabiri pikseli ya katikati, na \(\mathcal P\) huwakilisha fomula ya utabiri. Katika picha za kijivu za 8-bit, thamani za pikseli ziko katika masafa ya 0-255. Lengo la kihisabati ni kufanya \(\hat p_{i,j}\) iwe karibu iwezekanavyo na \(p_{i,j}\) halisi.
Kosa la utabiri pia hufafanuliwa:
\[ e_{i,j}=p_{i,j}-\hat p_{i,j} \]
hivyo. Wakati \(e_{i,j}=0\), utabiri ni sahihi kabisa. Kadiri thamani kamili ya kosa inavyoongezeka, ndivyo utabiri unavyozidi kuwa mbali na pikseli halisi.
Makosa ya ndani na nje ya utabiri katika PEE
Chanzo hugawanya makosa ya utabiri kwa kutumia vizingiti viwili, \(T_l\) na \(T_r\). Makosa katika masafa ya \(e_{i,j}\in[T_l,T_r)\) hutumika kama makosa ya ndani yanayobeba data. Makosa yaliyo nje ya masafa haya husogezwa ili kuunda nafasi tupu katika histogramu badala ya kubeba biti ya data.
Kwa kosa la ndani, ikiwa biti ya kupachikwa ni \(b\in\{0,1\}\), kosa lililopanuliwa ni:
\[ e^w_{i,j}=2e_{i,j}+b \]
kama ilivyoonyeshwa. Hapa kuzidisha kwa mbili huunda nafasi mpya kati ya thamani zinazoweza kutumika katika histogramu ya kosa; \(b\) huamua ni ipi kati ya nafasi hizo mbili inayochaguliwa.
Mlinganyo (2): Uundaji wa pikseli iliyotiwa alama
\[ p^w_{i,j}= \begin{cases} p_{i,j}+e_{i,j}+b, & e_{i,j}\in[T_l,T_r)\\ p_{i,j}+T_r, & e_{i,j}\in[T_r,+\infty)\\ p_{i,j}+T_l, & e_{i,j}\in(-\infty,T_l) \end{cases} \tag{2} \]
\(p^w_{i,j}\) ni thamani ya pikseli iliyotiwa alama baada ya data kupachikwa. Katika hali ya kwanza pikseli hubeba biti ya data. Katika hali ya pili na ya tatu, upande wa kulia au kushoto wa mgawanyo wa kosa husogezwa ili kuunda nafasi tupu za histogramu kwa thamani za kosa zinazobeba data. Ikiwa pikseli inaweza kutoka nje ya mipaka ya 0-255 kutokana na mchakato huo, chanzo kinapendekeza pikseli hiyo iondolewe au irekodiwe kwa ramani ya maeneo.
Mlinganyo (3): Kosa lililopanuliwa upande wa mpokeaji
\[ e^w_{i,j}=p^w_{i,j}-\hat p_{i,j} \tag{3} \]
Mpokeaji hutumia fomula ileile ya utabiri kuzalisha tena thamani ya \(\hat p_{i,j}\). Tofauti kati ya pikseli iliyotiwa alama na utabiri huu hutoa kosa la utabiri lililopanuliwa lililoundwa katika hatua ya upachikaji data. Sharti la msingi la urejeshaji ni kwamba muktadha wa utabiri uweze kubaki uleule wakati wa kupachika na kutoa data.
Mlinganyo (4): Kurejesha kosa asilia la utabiri
\[ e_{i,j}= \begin{cases} \left\lfloor\dfrac{e^w_{i,j}}{2}\right\rfloor, & e^w_{i,j}\in[2T_l,2T_r)\\ e^w_{i,j}-T_r, & e^w_{i,j}\in[2T_r,+\infty)\\ e^w_{i,j}-T_l, & e^w_{i,j}\in(-\infty,2T_l) \end{cases} \tag{4} \]
Katika eneo la kosa la ndani, upanuzi hubatilishwa kwa kugawanya kwa mbili. Katika maeneo ya nje, usogezaji wa kizingiti uliofanywa wakati wa upachikaji hubatilishwa. Biti iliyopachikwa:
\[ b=e^w_{i,j}\bmod 2 \]
hutolewa, na pikseli asilia:
\[ p_{i,j}=\hat p_{i,j}+e_{i,j} \]
hujengwa upya. Mlolongo huu unaonyesha kihisabati kwa nini mbinu hii “inaweza kurejeshwa”: lengo si kutoa data iliyofichwa pekee, bali pia kurejesha thamani za pikseli za kabla ya data kupachikwa.
Kwa Nini AFCNNP Hutumia Utabiri wa CNN na NLM Pamoja?
AFCNNP huunganisha taarifa ya uhusiano wa ndani ya CNNP katika maeneo laini na taarifa ya ujifananifu usio wa karibu ya NLM katika maeneo yenye tekstcha ndani ya utabiri mmoja wa pikseli; uzito uliojifunzwa \(\alpha(i,j)\) hukaribia 1 mahali ambapo CNNP ni muhimu zaidi na 0 mahali ambapo NLM ni muhimu zaidi, hivyo kuruhusu mpito unaobadilika kwa kiwango cha pikseli kati ya vitabiri viwili.
Non-Local Means: Kutafuta muundo unaofanana badala ya pikseli iliyo karibu
Wazo kuu la NLM ni hili: ikiwa pikseli zilizo karibu kabisa na pikseli inayotabiriwa hazitoi taarifa ya kutosha, viraka vyenye muundo wa tekstcha uleule au unaofanana vinaweza kutafutwa katika sehemu zilizo mbali zaidi za picha. Chanzo hufafanua kiraka chenye umbo la almasi kinachoundwa na pikseli lengwa \(p_{i,j}\) na majirani zake wanne wa karibu zaidi.
Mlinganyo (5): Utabiri wa NLM
\[ NL(p_{i,j})= \frac{1}{\sum_k w_k} \sum_{\tilde p_k\in\tilde P_k} w_k\tilde p_k \tag{5} \]
\(\tilde p_k\) ni pikseli mgombea isiyo ya karibu; \(w_k\) ni uzito unaotolewa kulingana na jinsi mgombea huyo anavyofanana na eneo lengwa. Kiasi cha juu ni jumla yenye uzito ya pikseli zilizokubaliwa, na kiasi cha chini ni jumla ya uzito. Hivyo, matokeo ni wastani wenye uzito. Katika utekelezaji wa chanzo, uzito si mgawo endelevu wa ufanano bali ni kigezo cha uchaguzi kinachochukua thamani 0 au 1 kama inavyoonyeshwa katika Mlinganyo (7).
Mlinganyo (6): Umbali wa ufanano wa viraka
\[ d_k= \left\| V(\tilde p_k)-V(p_{i,j}) \right\|_2 \tag{6} \]
\(V(\cdot)\) huwakilisha uwakilishi wa namba wa mazingira ya picha inayolinganishwa; \(d_k\) ni umbali wa Euclidean kati ya uwakilishi huo miwili. Kadiri \(d_k\) inavyopungua, ndivyo eneo mgombea linavyofanana zaidi na eneo lengwa. Kiasi hiki hutokana na thamani za kiwango cha kijivu na kulinganishwa na kizingiti \(T_{sim}\).
Mlinganyo (7): Uchaguzi wa ufanano wa NLM
\[ w_k= \begin{cases} 1, & d_k\leq T_{sim}\\ 0, & \text{aksi halde} \end{cases} \tag{7} \]
\(T_{sim}\) ni kizingiti cha ufanano kinachowekwa na mtumiaji. Ikiwa umbali ni mdogo kuliko au sawa na kizingiti, mgombea hujumuishwa katika utabiri wa NLM; ikiwa ni mkubwa, huondolewa kabisa. Kizingiti kidogo sana kinaweza kupunguza kosa kwa kuchagua tu viraka vinavyofanana sana, lakini hupunguza idadi ya mifano isiyo ya karibu inayoweza kutumika. Kuongeza kizingiti huruhusu viraka zaidi kutumika, lakini pia hujumuisha katika utabiri mifano ambayo inafanana kwa kiwango kidogo.
Mlinganyo (8): Entropia ya kosa la utabiri
\[ E=-\sum_e p(e)\ln p(e) \tag{8} \]
\(p(e)\) ni uwezekano wa kosa la utabiri \(e\). Entropia hufupisha jinsi mgawanyo ulivyoenea au usivyo na uhakika. Kwa mtazamo wa RDH, lengo ni kufanya makosa ya utabiri yajikusanye karibu na sifuri kadiri iwezekanavyo. Katika chanzo, kwenye picha ya Baboon imeonekana kwamba kadiri \(T_{sim}\) inavyoongezeka, entropia ya kosa la utabiri huongezeka kwa mwelekeo mmoja. Sababu ni kwamba vizingiti vikubwa hujumuisha viraka visivyofanana sana katika utabiri wa NLM.
Kwa nini mgawanyo wa picha wa Dot na Cross ni muhimu?
Picha hugawanywa katika seti mbili huru za pikseli. Chanzo huzita Dot na Cross. Wakati pikseli za seti moja zinatabiriwa, muktadha wa utabiri huundwa kutoka kwa pikseli za seti nyingine ambazo bado hazijabadilishwa. Kisha majukumu hubadilishwa. Mkakati huu huwezesha muktadha wa utabiri uliotumika wakati wa kupachika data kujengwa tena wakati wa kutoa data na husaidia kuhifadhi urejeshaji.
Mlinganyo (9): Utabiri wa CNNP
\[ P_{\mathrm{CNNP}}(i,j) = f_{\theta} \left( \mathcal{V}_k(I(i,j)) \right) \tag{9} \]
\(I\in\mathbb{R}^{H\times W}\) ni picha ya ingizo. \(\mathcal V_k(I(i,j))\) huwakilisha kiraka cha ndani cha \(k\times k\) kuzunguka pikseli \((i,j)\); \(f_\theta\) ni kitabiri cha CNN kilichofunzwa awali chenye uzito \(\theta\). Tokeo \(P_{\mathrm{CNNP}}(i,j)\) ni utabiri wa kiwango cha kijivu unaozalishwa na CNN kwa pikseli ya katikati.
Muundo wa mtandao wa muunganisho wa umakini
Kila ramani ya utabiri ya CNNP na NLM ina umbo la \((B,1,H,W)\). Zikiunganishwa katika kipimo cha chaneli, hutengeneza tensor ya \((B,2,H,W)\). Mtandao wa umakini una tabaka mbili za konvolusheni. Tabaka la kwanza hutumia kichujio 16 chenye kiini cha 3×3 na padding 1, kisha ReLU hutumika. Konvolusheni ya pili ya 3×3 huzalisha ramani ya uzito ya chaneli moja, na kazi ya Sigmoid huweka matokeo kati ya 0 na 1.
Mlinganyo (10): Uzito wa umakini kwa kiwango cha pikseli
\[ \alpha(i,j) = \sigma \left( W_2\cdot \operatorname{ReLU} \left( W_1\cdot [P_{\mathrm{CNNP}}(i,j);P_{\mathrm{NLM}}(i,j)] +b_1 \right) +b_2 \right) \tag{10} \]
Katika uwakilishi wa chanzo, \(W_1\in\mathbb{R}^{16\times2}\), \(b_1\in\mathbb{R}^{16}\), \(W_2\in\mathbb{R}^{1\times16}\) na \(b_2\in\mathbb{R}^{1}\) hufafanuliwa. \(\sigma\) ni kazi ya Sigmoid. Hivyo \(0\leq\alpha(i,j)\leq1\).
Wakati \(\alpha\rightarrow1\), utabiri wa CNNP hutawala. Wakati \(\alpha\rightarrow0\), utabiri wa NLM hutawala. Thamani za katikati humaanisha mchanganyiko laini wa vitabiri viwili.
Mlinganyo (11): Utabiri wa mwisho uliounganishwa
\[ P_{\mathrm{fused}}(i,j) = \alpha(i,j)P_{\mathrm{CNNP}}(i,j) + \left(1-\alpha(i,j)\right)P_{\mathrm{NLM}}(i,j) \tag{11} \]
Huu ni muunganiko wenye uzito wa konveksi: jumla ya vigawo viwili ni 1. Badala ya kuunda moja kwa moja utabiri mpya wa tatu, mtandao huamua mchango wa uwiano wa utabiri wa CNNP na NLM. Kulingana na tafsiri ya chanzo, CNNP hupata uzito zaidi katika maeneo laini na NLM katika maeneo yenye tekstcha.
Mlinganyo (12): Hasara ya mafunzo ya AFCNNP
\[ \mathcal{L} = \frac{1}{HW} \sum_{i,j} \left| I(i,j)-P_{\mathrm{fused}}(i,j) \right| + \psi\cdot \operatorname{Var} \left( I-P_{\mathrm{fused}} \right) \tag{12} \]
Kipengele cha kwanza huadhibu wastani wa kosa kamili kati ya pikseli halisi na utabiri uliounganishwa, na kipengele cha pili huadhibu variansi ya makosa ya utabiri. Katika utafiti, parameta ya regularization \(\psi=0.3\) iliwekwa.
Kazi ya kipengele cha kwanza ni kuhakikisha pikseli zinatabiriwa kwa usahihi mmoja mmoja. Kipengele cha pili hujaribu kuzuia makosa kusambaa katika eneo pana. Kwa mtazamo wa RDH, wastani mdogo wa kosa pekee hautoshi; kujikusanya kwa histogramu ya kosa karibu na sifuri pia ni muhimu kwa PEE.
Katika grafu ya unyeti wa \(\psi\) ya chanzo, \(\psi=0.1\) huzalisha mgawanyo wa kosa wenye mikia mipana na kilele cha chini, huku \(\psi=0.3\) hufanya mgawanyo ujikusanye zaidi karibu na sifuri. \(\psi=0.5\) huzalisha mgawanyo mkali zaidi, lakini kilele husogea mbali na sifuri na MAE huongezeka. Kwa hiyo thamani iliyotumika katika utafiti ni 0.3.
Mbinu na Matokeo ya Utafiti
Mchakato wa upachikaji wa RDH
Picha asilia hugawanywa kwanza katika picha ndogo za Dot \(I_D\) na Cross \(I_C\). Katika hatua ya kwanza, \(I_C\) hutumika kutabiri pikseli za Dot. Kupitia makosa ya utabiri kati ya \(I_D\) halisi na \(\tilde I_D\) iliyotabiriwa, sehemu ya kwanza ya data ya ziada \(W_1\) hupachikwa na picha ya Dot iliyotiwa alama \(I_D^{W_1}\) huundwa.
Katika hatua ya pili, \(I_D^{W_1}\) hupewa kitabiri mseto ili kutabiri picha ya Cross \(\tilde I_C\). Kwa kutumia utabiri huu, \(W_2\) hupachikwa na \(I_C^{W_2}\) hupatikana. Picha ndogo mbili zilizotiwa alama huunganishwa ili kuunda picha ya mwisho iliyotiwa alama \(I^W\).
Utoaji wa data na urejeshaji wa picha
Utoaji hufuata mpangilio wa kinyume wa upachikaji. Kwanza picha iliyotiwa alama hugawanywa tena katika seti za Dot na Cross. Kwa kutumia picha ya Dot iliyotiwa alama, pikseli za Cross hutabiriwa; \(W_2\) hutolewa na \(I_C\) asilia hurejeshwa. Kisha picha ya Cross iliyorejeshwa hutumika kutabiri picha ya Dot; \(W_1\) hutolewa na \(I_D\) asilia hurejeshwa. Mwishowe \(I_D\) na \(I_C\) huunganishwa kurejesha picha asilia, na \(W_1\) na \(W_2\) huunganishwa kurejesha data iliyopachikwa.
Mpangilio wa mafunzo na majaribio
| Picha za mafunzo | Picha 3000 zilizochaguliwa kwa nasibu kutoka ImageNet |
|---|---|
| Muundo wa mafunzo | Kijivu, 512×512 |
| Kiboreshaji | Adam |
| Kiwango cha awali cha kujifunza | \(1\times10^{-4}\) |
| Weight decay | \(1\times10^{-3}\) |
| Batch size | 8 |
| Adam \(\beta_1\) | 0.9 |
| Adam \(\beta_2\) | 0.999 |
| Adam \(\epsilon\) | \(1\times10^{-8}\) |
| Epoch | 20 |
| Picha kuu za majaribio | Lena, Baboon, Boat, Barbara, Pepper, Lake |
| Seti ya data ya kulinganisha | UCID.v2 |
| Uthibitishaji wa ziada | Kodak |
| Programu | Python 3.11.2, PyTorch 2.6.0 |
| CPU | Intel Core i9-10980XE @ 3.00 GHz |
| RAM | 64 GB |
| GPU | NVIDIA RTX A5000 |
Dokezo la parameta ndani ya chanzo: Katika maelezo ya mbinu ya AFCNNP, NLM imeelezwa kutumia kiraka cha 3×3 na dirisha la utafutaji la 21×21. Kwa upande mwingine, katika sehemu ya uchangamano wa ukokotoaji, ukokotoaji wa uchangamano umefanywa kwa kutumia \(S=15\) na \(P=5\). Chanzo hakielezi kando kwa nini seti hizi mbili za parameta zinatofautiana; kwa hiyo hapa moja haijabadilishwa na nyingine.
Ramani za uzito wa umakini zilionyesha nini?
Katika ramani za uzito za picha sita za majaribio za chanzo, maeneo yanayotawaliwa na CNNP yenye \(\alpha>0.8\) yameonyeshwa kwa njano, maeneo yanayotawaliwa na NLM yenye \(\alpha<0.2\) kwa bluu, na maeneo ya kati yenye \(0.2\leq\alpha\leq0.8\) kama mchanganyiko laini wa vitabiri viwili. CNNP ilitawala katika sehemu kubwa za picha za Lena, Boat na Pepper, huku mchango wa NLM ukiongezeka katika picha za Barbara na Lake. Katika picha ya Baboon yenye tekstcha ya manyoya iliyo nzito sana na inayobadilika haraka, vitabiri viwili vilitumika pamoja kwa namna iliyo dhahiri zaidi.
Usahihi wa utabiri: picha 100 za UCID.v2
| Kipimo | Hu [28] | Hu [29] | Yang [30] | Wu [31] | Lin [32] | Iliyopendekezwa |
|---|---|---|---|---|---|---|
| MSE | 92.41 | 79.57 | 59.72 | 57.31 | 53.23 | 51.5 |
| Mean | 4.42 | 4.31 | 3.70 | 3.59 | 3.41 | 3.3 |
| Variansi | 63.17 | 52.34 | 39.67 | 37.78 | 35.30 | 34.0 |
Katika histogramu ya wastani ya kosa la utabiri, mgawanyo wa AFCNNP ulijikusanya karibu na sifuri zaidi kuliko mbinu nyingine na kutoa kilele cha kati kilicho juu zaidi. Hili ni muhimu kwa PEE, kwa sababu idadi kubwa ya makosa madogo au sifuri ya utabiri huunda histogramu inayofaa zaidi kwa upachikaji data.
Idadi ya makosa ya utabiri yenye thamani sifuri
| Picha | Hu [28] | Hu [29] | Yang [30] | Wu [31] | Lin [32] | Iliyopendekezwa |
|---|---|---|---|---|---|---|
| Lena | 36.203 | 36.982 | 39.375 | 40.354 | 41.135 | 42.735 |
| Baboon | 12.032 | 12.940 | 13.765 | 14.011 | 15.322 | 16.371 |
| Boat | 22.111 | 25.078 | 27.550 | 28.428 | 30.352 | 31.142 |
| Barbara | 31.896 | 38.587 | 43.135 | 44.969 | 45.621 | 46.931 |
| Pepper | 21.959 | 23.807 | 28.038 | 29.600 | 32.199 | 33.753 |
| Lake | 20.409 | 23.101 | 25.934 | 26.246 | 26.832 | 27.926 |
Hasa ongezeko katika picha ya Baboon yenye tekstcha nyingi linaendana na sababu ya utafiti ya kuongeza kipengele cha NLM. Hata hivyo, matokeo ya picha moja hayakuchukuliwa kama ushahidi wa ubora wa jumla; utafiti pia ulifanya tathmini pana zaidi kwenye UCID.v2 na Kodak.
Uwezo wa juu zaidi wa kupachika na PSNR
| Mbinu | Matumizi ya tekstcha | Wast. uwezo wa juu zaidi (bit) | Wast. PSNR katika uwezo wa juu zaidi (dB) |
|---|---|---|---|
| Hu [28] | Chini | 120.000 | 43.0 |
| Hu [29] | Chini | 45.000 | 52.1 |
| Yang [30] | Chini sana | 80.000 | 49.97 |
| Wu [31] | Chini | 20.000 | 59.64 |
| Lin [32] | Chini sana | 20.000 | 59.78 |
| Iliyopendekezwa | Wastani-Juu | 125.816 | 42.58 |
Mbinu iliyopendekezwa ilipata uwezo wa wastani wa juu zaidi uliokuwa mkubwa zaidi katika jedwali. Hata hivyo, PSNR ya 42.58 dB katika uwezo wa juu zaidi ni ndogo kuliko thamani za PSNR za baadhi ya mbinu zinazopachika data kidogo. Kwa hiyo matokeo haya hayawezi kutafsiriwa kuwa “AFCNNP ina PSNR ya juu zaidi katika hali zote”. Faida ya utafiti ni kufikia hatua tofauti ya uwiano kati ya uwezo mkubwa na uaminifu wa picha.
Ulinganisho wa PSNR kwa uwezo sawa wa kupachika
| Bit | Hu [28] | Hu [29] | Yang [30] | Wu [31] | Lin [32] | Iliyopendekezwa |
|---|---|---|---|---|---|---|
| 10.000 | 63.42 | 64.12 | 64.32 | 65.03 | 65.15 | 65.50 |
| 11.000 | 63.18 | 63.62 | 63.79 | 64.71 | 64.89 | 65.17 |
| 12.000 | 62.89 | 63.41 | 63.50 | 64.35 | 64.51 | 64.80 |
| 13.000 | 62.51 | 63.02 | 63.10 | 64.01 | 64.13 | 64.45 |
| 14.000 | 62.21 | 62.76 | 62.73 | 63.63 | 63.78 | 64.06 |
| 15.000 | 61.89 | 62.50 | 62.41 | 63.22 | 63.43 | 63.65 |
| 16.000 | 61.56 | 62.21 | 62.09 | 62.91 | 63.06 | 63.30 |
| 17.000 | 61.31 | 61.93 | 61.80 | 62.56 | 62.74 | 62.95 |
| 18.000 | 61.12 | 61.70 | 61.61 | 62.40 | 62.58 | 62.78 |
| 19.000 | 60.89 | 61.49 | 61.40 | 62.21 | 62.32 | 62.59 |
| 20.000 | 60.67 | 61.27 | 61.15 | 61.94 | 61.98 | 62.30 |
Katika ulinganisho huu, kwa sababu uwezo umewekwa sawa kwa kila mbinu, tafsiri ni ya moja kwa moja zaidi: katika kila hatua ya uwezo iliyoripotiwa kati ya 10.000-20.000 bit, mbinu iliyopendekezwa ilitoa wastani wa juu zaidi wa PSNR. Kadiri uwezo unavyoongezeka, PSNR hupungua katika mbinu zote, kwa sababu upachikaji zaidi unahitaji mabadiliko zaidi kwenye picha.
Seti ya data ya Kodak na jaribio la ablation
Picha za rangi za Kodak zilibadilishwa kuwa za kijivu na kubadilishwa ukubwa hadi 512×512. Ablation 1, huwakilisha wastani rahisi wa utabiri wa CNN na NLM bila mtandao wa umakini; Ablation 2 nayo huwakilisha matokeo yaliyopatikana bila kipengele cha regularization ya variansi katika Mlinganyo (12).
| Picha | Hu [28] | Hu [29] | Yang [30] | Wu [31] | Lin [32] | Abl. 1 | Abl. 2 | Iliyopendekezwa |
|---|---|---|---|---|---|---|---|---|
| Kodak01 | 62.24 | 63.30 | 63.78 | 64.31 | 64.83 | 61.14 | 64.21 | 65.02 |
| Kodak02 | 61.33 | 62.25 | 63.40 | 63.72 | 64.54 | 60.78 | 63.78 | 64.86 |
| Kodak03 | 61.93 | 62.56 | 63.70 | 64.19 | 64.56 | 61.04 | 64.05 | 64.30 |
| Kodak04 | 62.50 | 63.21 | 63.81 | 64.45 | 65.63 | 61.12 | 64.63 | 65.78 |
| Kodak05 | 61.68 | 63.81 | 63.90 | 64.58 | 64.83 | 59.31 | 64.45 | 65.32 |
| Kodak06 | 59.78 | 61.54 | 63.60 | 64.41 | 64.87 | 58.43 | 63.01 | 64.93 |
| Kodak07 | 60.62 | 62.45 | 63.24 | 63.20 | 63.93 | 58.14 | 62.37 | 64.58 |
| Kodak08 | 61.43 | 62.65 | 62.80 | 63.78 | 64.41 | 59.72 | 63.72 | 65.02 |
| Kodak09 | 62.21 | 62.36 | 63.14 | 63.74 | 63.85 | 60.25 | 62.83 | 64.81 |
| Kodak10 | 62.54 | 62.78 | 63.42 | 63.55 | 64.20 | 61.62 | 62.93 | 64.73 |
| Wastani | 61.63 | 62.69 | 63.48 | 63.99 | 64.57 | 60.15 | 63.59 | 64.94 |
Kusalia kwa Ablation 1 katika wastani wa 60.15 dB kunaonyesha kuwa kuchukua tu wastani wa kihesabu wa CNN na NLM hakutoshi. Thamani ya 63.59 dB ya Ablation 2 inaunga mkono pia kwamba regularization ya variansi huchangia katika utendaji wa mwisho. AFCNNP kamili ilipata wastani wa 64.94 dB.
Tathmini ya kitakwimu kwenye picha 24 za Kodak
| Mbinu | MSE | PSNR (dB) |
|---|---|---|
| Hu [28] | 90.23 ± 4.2 | 60.42 ± 0.83 |
| Hu [29] | 78.52 ± 3.7 | 61.51 ± 0.60 |
| Yang [30] | 56.14 ± 3.4 | 63.23 ± 0.46 |
| Wu [31] | 55.35 ± 3.1 | 63.67 ± 0.43 |
| Lin [32] | 52.42 ± 2.8 | 64.12 ± 0.49 |
| Iliyopendekezwa | 50.30 ± 2.7 | 64.78 ± 0.38 |
Chanzo kilichagua mbinu ya Lin na wenzake kama ulinganisho wenye nguvu zaidi kati ya mbinu iliyopendekezwa na mbinu zilizopo, na kikatumia paired t-test kwenye thamani za MSE za picha 24. Matokeo yaliripotiwa kuwa \(p<0.05\), na uboreshaji wa MSE ulioonekana ulielezwa kuwa muhimu kitakwimu kwa kiwango ambacho katika jaribio hili hauwezi kuelezwa kwa mabadiliko ya nasibu. Jaribio hili linatumika tu kwa picha, kipimo na jozi ya mbinu zilizolinganishwa.
Nini kilitokea kadiri uchangamano wa tekstcha ulivyoongezeka?
Utafiti ulipanga picha 10 za UCID.v2 kutoka picha laini zaidi hadi zenye tekstcha zaidi kulingana na thamani ya Laplacian Variance (LV). Uwezo wa kupachika wa mbinu za awali kwa ujumla ulipungua kadiri tekstcha ya picha ilivyoongezeka, huku uwezo wa AFCNNP ukibaki thabiti zaidi au kuongezeka katika picha zenye tekstcha nyingi. Waandishi wanahusisha tabia hii na uwezo wa NLM kutumia ufanano wa kimuundo usio wa karibu unaopatikana katika maeneo yasiyo laini.
Uchangamano wa ukokotoaji
Picha ya ingizo imefafanuliwa kuwa \(H\times W\) na jumla ya pikseli kuwa \(N=H\times W\). Kwa tabaka moja la konvolusheni, chanzo hutumia:
\[ O\left(NK^2C_{in}C_{out}\right) \]
kama uchangamano. Hapa \(K\times K\) ni ukubwa wa kiini, \(C_{in}\) ni idadi ya chaneli za ingizo na \(C_{out}\) ni idadi ya chaneli za tokeo.
Kitabiri cha CNN huzalisha ramani 32 za vipengele katika matawi matatu sambamba ya utoaji wa vipengele kwa kutumia viini vya 3×3, 5×5 na 7×7; katika tawi la utabiri kuna vitalu viwili mfululizo vya konvolusheni ya 3×3. Ukokotoaji wa jumla wa CNN katika chanzo umetolewa kama:
\[ C_{\mathrm{CNN}}=O(6.7\times10^4N) \]
.
Kwa NLM:
\[ C_{\mathrm{NLM}}=O(NS^2P^2) \]
imetumika. Katika sehemu hii chanzo kinatoa \(S=15\) na \(P=5\), na kuripoti:
\[ C_{\mathrm{NLM}}=O(5.6\times10^3N) \]
kama matokeo. Hapa \(S\times S\) ni dirisha la utafutaji wa ufanano na \(P\times P\) ni ukubwa wa kiraka. Kama ilivyoelezwa awali, thamani hizi si sawa na taarifa ya 21×21 na 3×3 katika sehemu ya mbinu.
Kwa mtandao wa muunganisho wa umakini wa tabaka mbili:
\[ C_{\mathrm{Attn}}=O(4.3\times10^2N) \]
na kwa jumla:
\[ C_{\mathrm{total}} = C_{\mathrm{CNN}}+ C_{\mathrm{NLM}}+ C_{\mathrm{Attn}} = O(7.3\times10^4N) \]
imeripotiwa. Chanzo kinaeleza kuwa chini ya muundo huu uchangamano huongezeka kwa mstari kulingana na idadi ya pikseli katika picha.
| Kipengele | Uchangamano ulioripotiwa katika chanzo |
|---|---|
| CNN Predictor | \(O(6.7\times10^4N)\) |
| NLM Predictor | \(O(5.6\times10^3N)\) |
| Attention Fusion Network | \(O(4.3\times10^2N)\) |
| Jumla | \(O(7.3\times10^4N)\) |
Matokeo yanayoungwa mkono na utafiti
- Katika majaribio yaliyoripotiwa, AFCNNP ilizalisha MSE na variansi ya kosa la utabiri zilizo chini kuliko vitabiri vya CNN vilivyolinganishwa.
- Mtandao wa umakini uliweza kubadilisha mchango wa CNNP na NLM kwa kiwango cha pikseli.
- Katika picha zenye tekstcha, mchango wa NLM ulifanya sehemu ya pikseli zinazoweza kutabiriwa, ambazo mbinu zinazosisitiza maeneo laini pekee hazikuweza kutumia, ziweze kutumika.
- Katika jaribio la UCID.v2, mbinu iliyopendekezwa ilifikia uwezo wa wastani wa juu zaidi wa kupachika ulioripotiwa.
- Katika ulinganisho wa uwezo sawa kati ya 10.000-20.000 bit, mbinu iliyopendekezwa ilitoa wastani wa juu zaidi wa PSNR katika jedwali la chanzo.
- Matokeo ya ablation yanaunga mkono kwamba muunganisho wa umakini uliojifunzwa na regularization ya variansi vyote vinachangia katika utendaji.
- Katika ulinganisho wa MSE kwenye picha 24 za Kodak, tofauti dhidi ya mbinu ya Lin na wenzake iliripotiwa kuwa \(p<0.05\).
Ujumlishaji na mipaka ambayo utafiti hauungi mkono
- Matokeo hayathibitishi kwamba AFCNNP ndiyo mbinu bora bila masharti katika aina zote za picha.
- Majaribio makuu yalifanywa kwenye picha za kijivu zilizowekwa katika ukubwa wa 512×512.
- Chanzo hakikufanya ulinganisho wa moja kwa moja wa kiasi na mbinu inayotegemea transformer; ulinganisho huo uliachwa nje kwa sababu ya tofauti katika usanifu na upeo wa mafunzo.
- Kwa kuwa thamani za PSNR katika uwezo wa juu zaidi wa kupachika zilipimwa katika viwango tofauti vya uwezo kwa mbinu mbalimbali, haiwezekani kupanga ubora wa moja kwa moja kwa kuangalia safu ya PSNR pekee.
- Kuna tofauti isiyoelezwa kati ya vigezo vya kiraka/utafutaji vya NLM katika sehemu ya uchangamano wa ukokotoaji na vigezo katika sehemu kuu ya mbinu.
- Utafiti unapendekeza baadaye kuchunguza familia pana zaidi za vitabiri vya CNN, encrypted-domain RDH na ujumuishaji na vitabiri vinavyotegemea transformer; haya si matokeo yaliyothibitishwa katika makala hii.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: A Texture-Aware CNN Predictor for Reversible Data Hiding
Waandishi: Mohsin Shah; Chang Choi.
Mwandishi anayewajibika: Chang Choi.
Taasisi: Department of Computer Engineering, Gachon University, Seongnam-si 13120, Gyeonggi-do, Republic of Korea.
Jarida: Mathematics.
Mchapishaji: MDPI.
Rekodi ya bibliografia: Mathematics 2026, 14(9), 1542.
DOI: 10.3390/math14091542
Kiungo rasmi: https://doi.org/10.3390/math14091542
Iliwasilishwa: 1 Aprili 2026. Marekebisho: 21 Aprili 2026. Ilikubaliwa: 29 Aprili 2026. Ilichapishwa: 1 Mei 2026.
Aina ya chanzo: Makala ya utafiti iliyopitiwa na wataalamu.
Leseni: Leseni ya ufikiaji wazi ya Creative Commons Attribution (CC BY).
Taarifa ya ufadhili iliyopo katika PDF: Basic Science Research Program through the National Research Foundation of Korea (NRF), Ministry of Education, RS-2025-25434261; pamoja na Gachon University Research Fund of 2024, GCU-202404090001.
Onyo kuhusu rekodi rasmi ya sasa: Ukurasa wa sasa wa uchapishaji wa MDPI unaeleza kuwa makala imechapishwa tena kwa marekebisho madogo katika taarifa ya ufadhili. Katika rekodi ya sasa mtandaoni, msaada wa NRF unaonekana kama Korea government (MSIT), RS-2025-00559546. Kwa hiyo, tofauti ya ufadhili kati ya PDF na rekodi rasmi ya sasa haipaswi kuunganishwa kimya kimya.
Upatikanaji wa data: Chanzo kinaeleza kuwa data iliyotumika katika utafiti inapatikana wazi kupitia UCID.v2.
Mgongano wa maslahi: Waandishi wameripoti kutokuwa na mgongano wa maslahi.
Michango ya waandishi: Mohsin Shah; uundaji wa dhana, metodolojia, programu, uthibitishaji, uchanganuzi rasmi, utafiti na rasimu ya kwanza. Chang Choi; rasilimali, uratibu wa data, mapitio/uhariri, uonyeshaji, usimamizi wa kitaalamu, usimamizi wa mradi na upatikanaji wa ufadhili. Waandishi wote wawili walisoma na kuidhinisha toleo lililochapishwa.
Kikomo cha tafsiri ya kisayansi: Makala inaonyesha utendaji wa AFCNNP katika majaribio yaliyoripotiwa ya UCID.v2 na Kodak. Matokeo hayapaswi kujumuishwa moja kwa moja kwa migawanyo tofauti ya picha, vipimo asilia vya picha za rangi, usanifu mwingine wa RDH au matumizi ya encrypted-domain.
Madokezo ya kuripoti ndani ya chanzo: Ingawa chanzo kimetaja kipimo cha pili cha Jedwali 2 kuwa “Mean”, maandishi yanayokizunguka yanazungumzia ulinganisho wa MAE, MSE na variansi. Pia, kiraka cha 3×3 / dirisha la utafutaji la 21×21 katika maelezo ya mbinu ya NLM ni tofauti na thamani za \(P=5\) / \(S=15\) katika uchanganuzi wa uchangamano. Tofauti hizi hazijasahihishwa kimya kimya kwa sababu ya sharti la uaminifu kwa chanzo.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *