


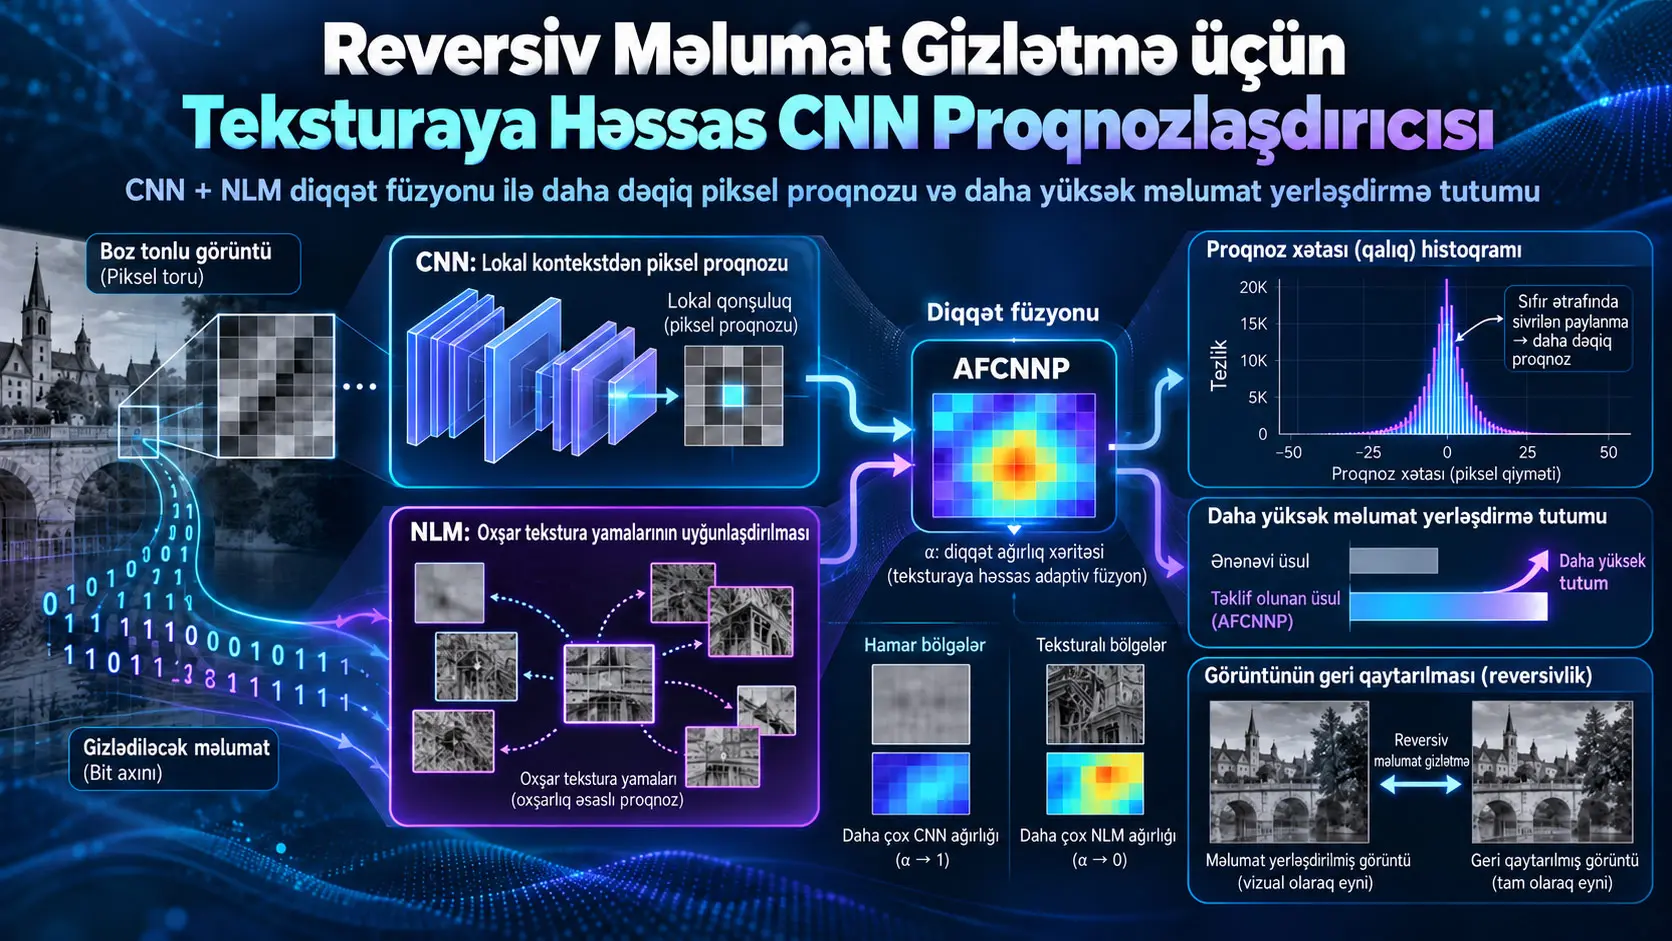
Teksturaya həssas diqqət füzyonlu CNN proqnozlaşdırıcısı (Attention Fusion-Based CNN Predictor, AFCNNP), reversiv məlumat gizlətmədə piksel qiymətlərini daha dəqiq proqnozlaşdırmaq üçün lokal CNN proqnozu ilə qeyri-lokal orta qiymətlər (Non-Local Means, NLM) proqnozunu piksel səviyyəsində birləşdirən təsvir proqnozlaşdırma çərçivəsidir. Metodun əsas ideyası CNN proqnozlaşdırıcısının hamar bölgələrdəki güclü lokal korrelyasiya qabiliyyətini NLM-nin teksturalı bölgələrdə uzaqda yerləşən, lakin oxşar təsvir yamalarından istifadə etmək qabiliyyəti ilə birləşdirməkdir. Öyrənilmiş diqqət çəkisi \(\alpha(i,j)\) hər piksel üçün CNNP ilə NLM-nin yekun proqnoza nə qədər töhfə verəcəyini müəyyənləşdirir.
Tədqiqatın məqsədi yalnız piksel proqnozlaşdırma xətasını azaltmaq deyil. Reversiv məlumat gizlətmədə proqnozlaşdırma xətalarının sıfır ətrafında dar və yüksək paylanma yaratması Prediction Error Expansion (PEE) mexanizminə daha çox məlumatı daha az təsvir təhrifilə yerləşdirməyə imkan verir. Buna görə AFCNNP yalnız hamar bölgələrdən istifadə etməklə kifayətlənməyib teksturalı bölgələrdəki qeyri-lokal öz-oxşarlığı da istifadə edilə bilən proqnoz məlumatına çevirməyə çalışır.
100 UCID.v2 təsviri üzərində aparılan müqayisədə təklif olunan metod üçün MSE 51.5, mənbə cədvəlində “Mean” kimi verilən qiymət 3.3 və proqnozlaşdırma xətasının dispersiyası 34.0 olaraq bildirilmişdir; bu qiymətlərin hamısı müqayisə edilən CNN proqnozlaşdırıcılarından aşağıdır. Təklif olunan AFCNNP əsaslı RDH metodu orta maksimum 125.816 bit yerləşdirmə tutumuna çatarkən bu nöqtədə orta PSNR qiyməti 42.58 dB olmuşdur. Kodak verilənlər dəstindəki 24 təsvir üzərində isə MSE \(50.30\pm2.7\), PSNR \(64.78\pm0.38\) olaraq hesabat verilmiş və Lin və həmkarlarının metodu ilə MSE müqayisəsində cütləşdirilmiş t-testinin nəticəsi \(p<0.05\) olmuşdur.
Nəticələr AFCNNP-nin istifadə olunan eksperimental quruluşda həm hamar, həm də teksturalı bölgələrdən yararlanaraq proqnozlaşdırma dəqiqliyini və məlumat yerləşdirmə performansını yaxşılaşdıra bildiyini göstərir. Bununla belə, tədqiqat boz tonlu təsvirlərə, müəyyən CNN/NLM arxitekturasına, UCID.v2 və Kodak verilənlər dəstlərinə və hesabat verilmiş təlim quruluşuna əsaslanır; nəticələr bütün təsvir növləri və ya bütün RDH sistemləri üçün avtomatik üstünlük sübutu deyil.
Reversiv Məlumat Gizlətmə Nədir?
Reversiv məlumat gizlətmə (Reversible Data Hiding, RDH), daşıyıcı təsvirə əlavə məlumat yerləşdirildikdən sonra həm əlavə məlumatın çıxarılmasını, həm də orijinal daşıyıcı təsvirin itkisiz şəkildə yenidən əldə edilməsini hədəfləyən məlumat gizlətmə yanaşmasıdır. Daimi piksel təhrifinin qəbul edilmədiyi tətbiqlərdə bu reversivlik əsas tələbatdır.
Tədqiqatın həll etməyə çalışdığı problem
Prediction Error Expansion əsaslı RDH metodlarında pikselin həqiqi qiyməti ilə proqnozlaşdırılan qiyməti arasındakı fərq məlumat yerləşdirmək üçün istifadə olunur. Proqnoz nə qədər dəqiqdirsə, xəta qiymətləri sıfır ətrafında bir o qədər sıxlaşır. Bu da az təhriflə istifadə edilə bilən daha çox kiçik xəta yaradır.
Klassik CNN proqnozlaşdırıcıları hamar bölgələrdə qonşu piksellər arasındakı güclü lokal korrelyasiyadan yaxşı istifadə edə bilir. Lakin sıx tekstura, saç, parça, yarpaq, mürəkkəb kənarlar və ya təkrarlanan naxışlar olan sahələrdə yalnız yaxın qonşuluğa baxmaq kifayət etməyə bilər. NLM isə təsvirin başqa mövqeyində yerləşən oxşar yamaları axtardığı üçün teksturalı bölgələrdə fərqli növ məlumatdan istifadə edir. AFCNNP-nin elmi nüvəsi bu iki proqnozlaşdırma üsulundan birini bütün təsvir üçün məcburi seçmək əvəzinə, hər pikseldə onların töhfələrini öyrənərək birləşdirməkdir.
Mənbədə müqayisə edilən proqnozlaşdırıcı ailəsi
| Proqnozlaşdırıcı | Növ | Hamar bölgələr | Teksturalı bölgələr | Yerləşdirmə tutumu |
|---|---|---|---|---|
| [16] | Klassik | Orta dəqiqlik | Zəif, böyük xətalar | Aşağı |
| [20] | Klassik | Hamar/kənar bölgələrdə yaxşı | Orta | Orta |
| [21] | Klassik | Hamar bölgələrdə çox yaxşı | Zəif | Aşağı |
| [22] | Klassik | Qradiyentlərdə yaxşı | Orta; səs-küydə qeyri-sabit | Orta |
| [23] | Klassik | Diffuziya ilə çox yaxşı | Orta; həddindən artıq hamarlatma riski | Orta |
| [24] | Klassik | Hamar strukturu öyrənir | Orta | Yüksək |
| [25] | Klassik | Uyğunlaşan | Yaxşı, qismən davamlı | Yüksək |
| [28] | CNN | Hamarlıq üçün öyrədilmiş | Teksturalı sahələrdən yayınır | Orta |
| [29] | CNN | Hamar bölgələrdə davamlı | Yüksək xətalı piksellərdən yayınır | Orta |
| [30] | CNN | Geniş reseptiv sahə | Seçici yerləşdirmə | Orta |
| [31] | CNN | Kəskin aşağı-xətalı proqnozlar | Teksturaları kənarlaşdırır | Aşağı |
| [32] | CNN | Hamarlığa çəki verir | Teksturanın çəkisi aşağı | Aşağı-Orta |
| [33] | CNN | Aşağı mürəkkəblik seçimi | Teksturaları kənarlaşdırır | Orta |
Tənlik (1): Piksel necə proqnozlaşdırılır?
\[ \hat{p}_{i,j}=\mathcal{P}\left(p_{i',j'}\right),\qquad (i',j')\in\mathcal{N}_{i,j} \tag{1} \]
\(p_{i,j}\) həqiqi boz səviyyəli piksel qiymətidir; \(\hat p_{i,j}\) proqnozlaşdırılan qiymətdir. \(\mathcal{N}_{i,j}\) mərkəzi pikseli proqnozlaşdırmaq üçün istifadə olunan qonşuluğu və ya proqnoz kontekstini, \(\mathcal P\) isə proqnoz funksiyasını göstərir. Boz tonlu 8-bit təsvirlərdə piksel qiymətləri 0-255 diapazonundadır. Riyazi məqsəd \(\hat p_{i,j}\) qiymətini həqiqi \(p_{i,j}\) qiymətinə mümkün qədər yaxınlaşdırmaqdır.
Proqnozlaşdırma xətası həmçinin:
\[ e_{i,j}=p_{i,j}-\hat p_{i,j} \]
kimi müəyyən edilir. \(e_{i,j}=0\) olduqda proqnoz tam doğrudur. Xətanın mütləq qiyməti böyüdükcə proqnoz həqiqi pikseldən daha çox uzaqlaşır.
PEE-də daxili və xarici proqnozlaşdırma xətaları
Mənbə proqnozlaşdırma xətalarını iki hədd \(T_l\) və \(T_r\) vasitəsilə ayırır. \(e_{i,j}\in[T_l,T_r)\) intervalındakı xətalar məlumat daşıyan daxili xətalar kimi istifadə olunur. Bu intervaldan kənardakı xətalar məlumat biti daşımaq əvəzinə histoqramda boş sahə yaratmaq üçün sürüşdürülür.
Daxili xəta üçün yerləşdiriləcək bit \(b\in\{0,1\}\) olmaqla genişləndirilmiş xəta:
\[ e^w_{i,j}=2e_{i,j}+b \]
şəklindədir. Burada ikiyə vurma xəta histoqramındakı istifadə edilə bilən qiymətlər arasında yeni mövqelər yaradır; \(b\) isə bu iki mümkün mövqedən hansının seçiləcəyini müəyyənləşdirir.
Tənlik (2): İşarələnmiş pikselin yaradılması
\[ p^w_{i,j}= \begin{cases} p_{i,j}+e_{i,j}+b, & e_{i,j}\in[T_l,T_r)\\ p_{i,j}+T_r, & e_{i,j}\in[T_r,+\infty)\\ p_{i,j}+T_l, & e_{i,j}\in(-\infty,T_l) \end{cases} \tag{2} \]
\(p^w_{i,j}\) məlumat yerləşdirildikdən sonrakı işarələnmiş piksel qiymətidir. Birinci halda piksel məlumat biti daşıyır. İkinci və üçüncü hallarda xəta paylanmasının sağ və ya sol tərəfi sürüşdürülərək məlumat daşıyan xəta qiymətləri üçün boş histoqram bölmələri yaradılır. Əməliyyat nəticəsində piksel 0-255 sərhədindən kənara çıxa bilərsə, mənbə bu pikselin istisna edilməsini və ya mövqe xəritəsi ilə qeydə alınmasını nəzərdə tutur.
Tənlik (3): Qəbuledici tərəfdə genişləndirilmiş xəta
\[ e^w_{i,j}=p^w_{i,j}-\hat p_{i,j} \tag{3} \]
Qəbuledici eyni proqnoz funksiyasından istifadə edərək \(\hat p_{i,j}\) qiymətini yenidən yaradır. İşarələnmiş piksellə bu proqnoz arasındakı fərq məlumat yerləşdirmə mərhələsində yaradılmış genişləndirilmiş proqnozlaşdırma xətasını verir. Reversivliyin əsas şərti yerləşdirmə və çıxarma zamanı proqnoz kontekstinin eyni qala bilməsidir.
Tənlik (4): Orijinal proqnozlaşdırma xətasının bərpası
\[ e_{i,j}= \begin{cases} \left\lfloor\dfrac{e^w_{i,j}}{2}\right\rfloor, & e^w_{i,j}\in[2T_l,2T_r)\\ e^w_{i,j}-T_r, & e^w_{i,j}\in[2T_r,+\infty)\\ e^w_{i,j}-T_l, & e^w_{i,j}\in(-\infty,2T_l) \end{cases} \tag{4} \]
Daxili xəta bölgəsində genişləndirmə əməliyyatı ikiyə bölünərək tərsinə çevrilir. Xarici bölgələrdə isə yerləşdirmə zamanı edilən hədd sürüşdürməsi geri alınır. Yerləşdirilmiş bit:
\[ b=e^w_{i,j}\bmod 2 \]
ilə çıxarılır və orijinal piksel:
\[ p_{i,j}=\hat p_{i,j}+e_{i,j} \]
ilə yenidən yaradılır. Bu zəncir metodun niyə “reversiv” olduğunu riyazi olaraq göstərir: məqsəd yalnız gizli məlumatı çıxarmaq deyil, məlumat yerləşdirilməzdən əvvəlki piksel qiymətlərini də bərpa etməkdir.
AFCNNP Niyə CNN və NLM Proqnozlarını Birlikdə İstifadə Edir?
AFCNNP, CNNP-nin hamar bölgələrdəki lokal korrelyasiya məlumatını və NLM-nin teksturalı bölgələrdəki qeyri-lokal öz-oxşarlıq məlumatını eyni piksel proqnozunda birləşdirir; öyrənilmiş \(\alpha(i,j)\) çəkisi CNNP-nin daha faydalı olduğu yerdə 1-ə, NLM-nin daha faydalı olduğu yerdə 0-a yaxınlaşaraq iki proqnozlaşdırıcı arasında piksel səviyyəsində uyğunlaşan keçid təmin edir.
Non-Local Means: Yaxındakı piksel əvəzinə oxşar naxışı axtarmaq
NLM-nin əsas fikri belədir: proqnozlaşdırılan pikselin dərhal yanındakı piksellər kifayət qədər məlumat vermirsə, təsvirin daha uzaq hissələrində eyni və ya oxşar tekstura quruluşuna malik yamalar axtarıla bilər. Mənbədə hədəf piksel \(p_{i,j}\) və onun dörd ən yaxın qonşusundan ibarət romb formalı yama müəyyən edilir.
Tənlik (5): NLM proqnozu
\[ NL(p_{i,j})= \frac{1}{\sum_k w_k} \sum_{\tilde p_k\in\tilde P_k} w_k\tilde p_k \tag{5} \]
\(\tilde p_k\) qeyri-lokal namizəd pikseli; \(w_k\) isə bu namizədin hədəf bölgəyə nə qədər oxşar olduğuna görə verilən çəkini göstərir. Surət qəbul edilən piksellərin çəkili cəmidir; məxrəc isə çəkilərin cəmidir. Beləliklə nəticə çəkili ortadır. Mənbədəki tətbiqdə çəki davamlı oxşarlıq əmsalı deyil, Tənlik (7)-də göstərildiyi kimi 0 və ya 1 qiyməti alan seçim dəyişənidir.
Tənlik (6): Yama oxşarlıq məsafəsi
\[ d_k= \left\| V(\tilde p_k)-V(p_{i,j}) \right\|_2 \tag{6} \]
\(V(\cdot)\) müqayisə edilən təsvir ətrafının ədədi təsvirini; \(d_k\) isə iki təsvir arasındakı Evklid məsafəsini ifadə edir. \(d_k\) kiçildikcə namizəd bölgə hədəf bölgəyə daha çox bənzəyir. Bu kəmiyyət boz səviyyə qiymətlərindən törədilir və \(T_{sim}\) həddi ilə müqayisə edilir.
Tənlik (7): NLM oxşarlıq seçimi
\[ w_k= \begin{cases} 1, & d_k\leq T_{sim}\\ 0, & \text{aksi halde} \end{cases} \tag{7} \]
\(T_{sim}\) istifadəçi tərəfindən müəyyən edilən oxşarlıq həddidir. Məsafə həddən kiçik və ya ona bərabərdirsə, namizəd NLM proqnozuna daxil edilir; böyükdürsə, tamamilə kənarlaşdırılır. Həddin çox kiçik olması yalnız çox oxşar yamaları seçərək xətanı azalda bilər, lakin istifadə edilə bilən qeyri-lokal nümunələrin sayını məhdudlaşdırır. Həddin böyüdülməsi daha çox yamanın istifadəsinə imkan verir, lakin daha az oxşar nümunələri də proqnoza daxil edir.
Tənlik (8): Proqnozlaşdırma xətası entropiyası
\[ E=-\sum_e p(e)\ln p(e) \tag{8} \]
\(p(e)\), proqnozlaşdırma xətası \(e\)-nin ehtimalıdır. Entropiya paylanmanın nə qədər geniş və ya qeyri-müəyyən olduğunu ümumiləşdirir. RDH baxımından məqsəd proqnozlaşdırma xətalarının mümkün qədər sıfır ətrafında sıxlaşmasıdır. Mənbədə Baboon təsviri üzərində \(T_{sim}\) böyüdükcə proqnozlaşdırma xətası entropiyasının monoton şəkildə artdığı müşahidə edilmişdir. Bunun səbəbi daha böyük hədlərin daha az oxşar yamaları NLM proqnozuna daxil etməsidir.
Dot və Cross təsvir ayrımı niyə lazımdır?
Təsvir iki müstəqil piksel çoxluğuna ayrılır. Mənbə bunları Dot və Cross dəstləri adlandırır. Bir çoxluqdakı piksellər proqnozlaşdırılarkən proqnoz konteksti qarşı çoxluğun hələ dəyişdirilməmiş piksellərindən qurulur. Sonra rollar dəyişdirilir. Bu strategiya məlumat yerləşdirmə zamanı istifadə olunan proqnoz kontekstinin məlumat çıxarma zamanı yenidən yaradıla bilməsini təmin edir və reversivliyin qorunmasına kömək edir.
Tənlik (9): CNNP proqnozu
\[ P_{\mathrm{CNNP}}(i,j) = f_{\theta} \left( \mathcal{V}_k(I(i,j)) \right) \tag{9} \]
\(I\in\mathbb{R}^{H\times W}\) giriş təsviridir. \(\mathcal V_k(I(i,j))\), \((i,j)\) pikselinin ətrafındakı \(k\times k\) lokal yamanı; \(f_\theta\) çəkiləri \(\theta\) olan əvvəlcədən öyrədilmiş CNN proqnozlaşdırıcısını göstərir. Çıxış \(P_{\mathrm{CNNP}}(i,j)\), CNN-nin mərkəzi piksel üçün yaratdığı boz səviyyə proqnozudur.
Diqqət füzyon şəbəkəsinin quruluşu
CNNP və NLM proqnoz xəritələrinin hər biri \((B,1,H,W)\) formasındadır. Kanal ölçüsündə birləşdirildikdə \((B,2,H,W)\) tenzoru yaranır. Diqqət şəbəkəsi iki konvolyusiya qatından ibarətdir. Birinci qat 3×3 nüvə ilə 16 filtr və padding 1 istifadə edir, sonra ReLU tətbiq olunur. İkinci 3×3 konvolyusiya birkanallı çəki xəritəsi yaradır və Sigmoid funksiyası nəticəni 0 ilə 1 arasına məhdudlaşdırır.
Tənlik (10): Piksel əsaslı diqqət çəkisi
\[ \alpha(i,j) = \sigma \left( W_2\cdot \operatorname{ReLU} \left( W_1\cdot [P_{\mathrm{CNNP}}(i,j);P_{\mathrm{NLM}}(i,j)] +b_1 \right) +b_2 \right) \tag{10} \]
Mənbə göstərimində \(W_1\in\mathbb{R}^{16\times2}\), \(b_1\in\mathbb{R}^{16}\), \(W_2\in\mathbb{R}^{1\times16}\) və \(b_2\in\mathbb{R}^{1}\) kimi müəyyən edilir. \(\sigma\) Sigmoid funksiyasıdır. Buna görə \(0\leq\alpha(i,j)\leq1\).
\(\alpha\rightarrow1\) olduqda CNNP proqnozu üstün olur. \(\alpha\rightarrow0\) olduqda NLM proqnozu üstün olur. Aralıq qiymətlər iki proqnozlaşdırıcının yumşaq şəkildə qarışdırılması deməkdir.
Tənlik (11): Yekun birləşdirilmiş proqnoz
\[ P_{\mathrm{fused}}(i,j) = \alpha(i,j)P_{\mathrm{CNNP}}(i,j) + \left(1-\alpha(i,j)\right)P_{\mathrm{NLM}}(i,j) \tag{11} \]
Bu, konveks çəkili birləşmədir: iki əmsalın cəmi 1-dir. Şəbəkə yeni üçüncü proqnozu birbaşa uydurmaq əvəzinə CNNP və NLM proqnozlarının nisbi töhfəsini müəyyənləşdirir. Mənbənin şərhinə görə hamar bölgələrdə CNNP, teksturalı bölgələrdə isə NLM daha çox çəki qazanır.
Tənlik (12): AFCNNP təlim itkisi
\[ \mathcal{L} = \frac{1}{HW} \sum_{i,j} \left| I(i,j)-P_{\mathrm{fused}}(i,j) \right| + \psi\cdot \operatorname{Var} \left( I-P_{\mathrm{fused}} \right) \tag{12} \]
Birinci termin həqiqi piksel ilə birləşdirilmiş proqnoz arasındakı orta mütləq xətanı, ikinci termin isə proqnozlaşdırma xətalarının dispersiyasını cəzalandırır. Tədqiqatda requlyarlaşdırma parametri \(\psi=0.3\) olaraq təyin edilmişdir.
Birinci terminin vəzifəsi piksellərin ayrı-ayrılıqda düzgün proqnozlaşdırılmasını təmin etməkdir. İkinci termin isə xətaların geniş sahəyə yayılmasının qarşısını almağa çalışır. RDH baxımından aşağı orta xəta təkbaşına kifayət deyil; xəta histoqramının sıfır ətrafında sıxlaşması da PEE üçün faydalıdır.
Mənbənin \(\psi\) həssaslıq qrafikində \(\psi=0.1\) daha geniş quyruqlu və aşağı zirvəli xəta paylanması yaradarkən, \(\psi=0.3\) paylanmanı sıfır ətrafında daha sıx edir. \(\psi=0.5\) daha kəskin paylanma yaratsa da, zirvə sıfırdan uzaqlaşır və MAE artır. Buna görə tədqiqatda istifadə olunan qiymət 0.3-dür.
Tədqiqatın Metodu və Nəticələri
RDH yerləşdirmə prosesi
Orijinal təsvir əvvəlcə Dot \(I_D\) və Cross \(I_C\) alt təsvirlərinə ayrılır. Birinci mərhələdə \(I_C\), Dot piksellərini proqnozlaşdırmaq üçün istifadə olunur. Həqiqi \(I_D\) ilə proqnozlaşdırılan \(\tilde I_D\) arasındakı proqnozlaşdırma xətaları vasitəsilə əlavə məlumatın ilk hissəsi \(W_1\) yerləşdirilir və işarələnmiş Dot təsviri \(I_D^{W_1}\) yaranır.
İkinci mərhələdə \(I_D^{W_1}\) hibrid proqnozlaşdırıcıya verilərək Cross təsviri \(\tilde I_C\) proqnozlaşdırılır. Bu proqnozdan istifadə edilərək \(W_2\) yerləşdirilir və \(I_C^{W_2}\) əldə edilir. İki işarələnmiş alt təsvir birləşdirilərək yekun işarələnmiş təsvir \(I^W\) yaradılır.
Məlumatın çıxarılması və təsvirin bərpası
Çıxarma prosesi yerləşdirmə prosesinin tərs ardıcıllığıdır. Əvvəlcə işarələnmiş təsvir yenidən Dot və Cross çoxluqlarına ayrılır. İşarələnmiş Dot təsvirindən istifadə edilərək Cross pikselləri proqnozlaşdırılır; \(W_2\) çıxarılır və orijinal \(I_C\) bərpa olunur. Daha sonra bərpa edilmiş Cross təsvirindən istifadə edilərək Dot təsviri proqnozlaşdırılır; \(W_1\) çıxarılır və orijinal \(I_D\) bərpa olunur. Sonda \(I_D\) və \(I_C\) birləşdirilərək orijinal təsvir, \(W_1\) və \(W_2\) birləşdirilərək isə yerləşdirilmiş məlumat yenidən əldə edilir.
Təlim və eksperimental quruluş
| Təlim təsvirləri | ImageNet-dən təsadüfi seçilmiş 3000 təsvir |
|---|---|
| Təlim formatı | Boz ton, 512×512 |
| Optimallaşdırıcı | Adam |
| İlkin öyrənmə sürəti | \(1\times10^{-4}\) |
| Weight decay | \(1\times10^{-3}\) |
| Batch size | 8 |
| Adam \(\beta_1\) | 0.9 |
| Adam \(\beta_2\) | 0.999 |
| Adam \(\epsilon\) | \(1\times10^{-8}\) |
| Epoch | 20 |
| Əsas eksperimental təsvirlər | Lena, Baboon, Boat, Barbara, Pepper, Lake |
| Müqayisə verilənlər dəsti | UCID.v2 |
| Əlavə doğrulama | Kodak |
| Proqram təminatı | Python 3.11.2, PyTorch 2.6.0 |
| CPU | Intel Core i9-10980XE @ 3.00 GHz |
| RAM | 64 GB |
| GPU | NVIDIA RTX A5000 |
Mənbədaxili parametr qeydi: AFCNNP metodunun təsvirində NLM-nin 3×3 yama və 21×21 axtarış pəncərəsi istifadə etdiyi bildirilmişdir. Bunun əksinə, hesablama mürəkkəbliyi bölməsində \(S=15\) və \(P=5\) istifadə edilərək mürəkkəblik hesablanmışdır. Mənbə bu iki parametr dəstinin niyə fərqli olduğunu ayrıca izah etmir; buna görə burada biri digərinin yerinə keçirilməmişdir.
Diqqət çəki xəritələri nə göstərdi?
Mənbənin altı test təsvirindəki çəki xəritələrində \(\alpha>0.8\) olan CNNP-dominant bölgələr sarı, \(\alpha<0.2\) olan NLM-dominant bölgələr mavi, \(0.2\leq\alpha\leq0.8\) aralıq bölgələr isə iki proqnozlaşdırıcının yumşaq qarışığı kimi göstərilmişdir. Lena, Boat və Pepper təsvirlərinin böyük hissələrində CNNP üstün olduğu halda, Barbara və Lake təsvirlərində NLM-nin töhfəsi artmışdır. Çox sıx və sürətlə dəyişən xəz teksturasına malik Baboon təsvirində isə iki proqnozlaşdırıcı daha aydın şəkildə birlikdə istifadə edilmişdir.
Proqnozlaşdırma dəqiqliyi: 100 UCID.v2 təsviri
| Metrik | Hu [28] | Hu [29] | Yang [30] | Wu [31] | Lin [32] | Təklif olunan |
|---|---|---|---|---|---|---|
| MSE | 92.41 | 79.57 | 59.72 | 57.31 | 53.23 | 51.5 |
| Mean | 4.42 | 4.31 | 3.70 | 3.59 | 3.41 | 3.3 |
| Dispersiya | 63.17 | 52.34 | 39.67 | 37.78 | 35.30 | 34.0 |
Orta proqnozlaşdırma xətası histoqramında AFCNNP-nin paylanması digər metodlardan daha çox sıfır ətrafında sıxlaşmış və daha yüksək mərkəzi zirvə yaratmışdır. PEE baxımından bu vacibdir; çünki çox sayda kiçik və ya sıfır proqnozlaşdırma xətası məlumat yerləşdirmə üçün daha əlverişli histoqram yaradır.
Sıfır proqnozlaşdırma xətalarının sayı
| Təsvir | Hu [28] | Hu [29] | Yang [30] | Wu [31] | Lin [32] | Təklif olunan |
|---|---|---|---|---|---|---|
| Lena | 36.203 | 36.982 | 39.375 | 40.354 | 41.135 | 42.735 |
| Baboon | 12.032 | 12.940 | 13.765 | 14.011 | 15.322 | 16.371 |
| Boat | 22.111 | 25.078 | 27.550 | 28.428 | 30.352 | 31.142 |
| Barbara | 31.896 | 38.587 | 43.135 | 44.969 | 45.621 | 46.931 |
| Pepper | 21.959 | 23.807 | 28.038 | 29.600 | 32.199 | 33.753 |
| Lake | 20.409 | 23.101 | 25.934 | 26.246 | 26.832 | 27.926 |
Xüsusilə yüksək teksturalı Baboon təsvirindəki artım tədqiqatın NLM komponentini əlavə etmə əsaslandırması ilə uyğundur. Bununla belə, tək bir təsvirin nəticəsi ümumi üstünlük sübutu kimi qəbul edilməmiş; tədqiqat daha geniş UCID.v2 və Kodak qiymətləndirmələri də aparmışdır.
Maksimum yerləşdirmə tutumu və PSNR
| Metod | Teksturadan istifadə | Ort. maksimum tutum (bit) | Maksimum tutumda ort. PSNR (dB) |
|---|---|---|---|
| Hu [28] | Aşağı | 120.000 | 43.0 |
| Hu [29] | Aşağı | 45.000 | 52.1 |
| Yang [30] | Çox aşağı | 80.000 | 49.97 |
| Wu [31] | Aşağı | 20.000 | 59.64 |
| Lin [32] | Çox aşağı | 20.000 | 59.78 |
| Təklif olunan | Orta-Yüksək | 125.816 | 42.58 |
Təklif olunan metod cədvəldə ən yüksək orta maksimum tutumu əldə etmişdir. Lakin maksimum tutumdakı 42.58 dB PSNR daha az məlumat yerləşdirən bəzi metodların PSNR qiymətlərindən aşağıdır. Buna görə nəticə “AFCNNP bütün şərtlərdə ən yüksək PSNR-yə malikdir” kimi şərh edilə bilməz. Tədqiqatın üstünlüyü yüksək tutumla təsvir sədaqəti arasında fərqli tarazlıq nöqtəsinə çatmasıdır.
Eyni yerləşdirmə tutumunda PSNR müqayisəsi
| Bit | Hu [28] | Hu [29] | Yang [30] | Wu [31] | Lin [32] | Təklif olunan |
|---|---|---|---|---|---|---|
| 10.000 | 63.42 | 64.12 | 64.32 | 65.03 | 65.15 | 65.50 |
| 11.000 | 63.18 | 63.62 | 63.79 | 64.71 | 64.89 | 65.17 |
| 12.000 | 62.89 | 63.41 | 63.50 | 64.35 | 64.51 | 64.80 |
| 13.000 | 62.51 | 63.02 | 63.10 | 64.01 | 64.13 | 64.45 |
| 14.000 | 62.21 | 62.76 | 62.73 | 63.63 | 63.78 | 64.06 |
| 15.000 | 61.89 | 62.50 | 62.41 | 63.22 | 63.43 | 63.65 |
| 16.000 | 61.56 | 62.21 | 62.09 | 62.91 | 63.06 | 63.30 |
| 17.000 | 61.31 | 61.93 | 61.80 | 62.56 | 62.74 | 62.95 |
| 18.000 | 61.12 | 61.70 | 61.61 | 62.40 | 62.58 | 62.78 |
| 19.000 | 60.89 | 61.49 | 61.40 | 62.21 | 62.32 | 62.59 |
| 20.000 | 60.67 | 61.27 | 61.15 | 61.94 | 61.98 | 62.30 |
Bu müqayisədə tutum hər metod üçün eyni saxlandığından şərh daha birbaşadır: 10.000-20.000 bit intervalında hesabat verilən bütün tutum nöqtələrində təklif olunan metod ən yüksək orta PSNR qiymətini vermişdir. Tutum artdıqca bütün metodlarda PSNR azalır; çünki daha çox yerləşdirmə əməliyyatı təsvirə daha çox dəyişiklik tələb edir.
Kodak verilənlər dəsti və ablasiya təcrübəsi
Kodak-ın rəngli təsvirləri boz tona çevrilmiş və 512×512 ölçüsünə yenidən miqyaslandırılmışdır. Ablation 1, diqqət şəbəkəsi olmadan CNN və NLM proqnozlarının sadə ortasını; Ablation 2 isə Tənlik (12)-dəki dispersiya requlyarlaşdırma termini olmadan əldə edilən nəticəni təmsil edir.
| Təsvir | Hu [28] | Hu [29] | Yang [30] | Wu [31] | Lin [32] | Abl. 1 | Abl. 2 | Təklif olunan |
|---|---|---|---|---|---|---|---|---|
| Kodak01 | 62.24 | 63.30 | 63.78 | 64.31 | 64.83 | 61.14 | 64.21 | 65.02 |
| Kodak02 | 61.33 | 62.25 | 63.40 | 63.72 | 64.54 | 60.78 | 63.78 | 64.86 |
| Kodak03 | 61.93 | 62.56 | 63.70 | 64.19 | 64.56 | 61.04 | 64.05 | 64.30 |
| Kodak04 | 62.50 | 63.21 | 63.81 | 64.45 | 65.63 | 61.12 | 64.63 | 65.78 |
| Kodak05 | 61.68 | 63.81 | 63.90 | 64.58 | 64.83 | 59.31 | 64.45 | 65.32 |
| Kodak06 | 59.78 | 61.54 | 63.60 | 64.41 | 64.87 | 58.43 | 63.01 | 64.93 |
| Kodak07 | 60.62 | 62.45 | 63.24 | 63.20 | 63.93 | 58.14 | 62.37 | 64.58 |
| Kodak08 | 61.43 | 62.65 | 62.80 | 63.78 | 64.41 | 59.72 | 63.72 | 65.02 |
| Kodak09 | 62.21 | 62.36 | 63.14 | 63.74 | 63.85 | 60.25 | 62.83 | 64.81 |
| Kodak10 | 62.54 | 62.78 | 63.42 | 63.55 | 64.20 | 61.62 | 62.93 | 64.73 |
| Orta | 61.63 | 62.69 | 63.48 | 63.99 | 64.57 | 60.15 | 63.59 | 64.94 |
Ablation 1-in orta hesabla 60.15 dB-də qalması CNN və NLM-ni yalnız ədədi orta götürməyin kifayət etmədiyini göstərir. Ablation 2-nin 63.59 dB qiyməti isə dispersiya requlyarlaşdırmasının da yekun performansa töhfə verdiyini dəstəkləyir. Tam AFCNNP orta hesabla 64.94 dB əldə etmişdir.
24 Kodak təsvirində statistik qiymətləndirmə
| Metod | MSE | PSNR (dB) |
|---|---|---|
| Hu [28] | 90.23 ± 4.2 | 60.42 ± 0.83 |
| Hu [29] | 78.52 ± 3.7 | 61.51 ± 0.60 |
| Yang [30] | 56.14 ± 3.4 | 63.23 ± 0.46 |
| Wu [31] | 55.35 ± 3.1 | 63.67 ± 0.43 |
| Lin [32] | 52.42 ± 2.8 | 64.12 ± 0.49 |
| Təklif olunan | 50.30 ± 2.7 | 64.78 ± 0.38 |
Mənbə təklif olunan metodla mövcud metodlar arasında ən güclü müqayisə kimi Lin və həmkarlarının metodunu seçmiş və 24 təsvirin MSE qiymətləri üzərində cütləşdirilmiş t-testi tətbiq etmişdir. Nəticə \(p<0.05\) olaraq hesabat verilmiş və müşahidə olunan MSE yaxşılaşmasının bu təcrübədə təsadüfi dəyişkənliklə izah edilə bilməyəcək səviyyədə statistik əhəmiyyətli olduğu bildirilmişdir. Bu test yalnız müqayisə edilən təsvirlər, metrik və metod cütü üçün keçərlidir.
Tekstura mürəkkəbliyi artdıqda nə baş verdi?
Tədqiqat 10 UCID.v2 təsvirini Laplacian Variance (LV) qiymətinə görə daha hamar təsvirlərdən daha teksturalı təsvirlərə doğru sıralamışdır. Əvvəlki metodların yerləşdirmə tutumu təsvir teksturası artdıqca ümumiyyətlə azalarkən, AFCNNP-nin tutumu yüksək teksturalı təsvirlərdə daha sabit qalmış və ya artmışdır. Müəlliflər bu davranışı NLM-nin hamar olmayan bölgələrdəki qeyri-lokal struktur oxşarlığından istifadə edə bilməsi ilə əlaqələndirirlər.
Hesablama mürəkkəbliyi
Giriş təsviri \(H\times W\) və ümumi piksel sayı \(N=H\times W\) kimi müəyyən edilmişdir. Bir konvolyusiya qatı üçün mənbə:
\[ O\left(NK^2C_{in}C_{out}\right) \]
mürəkkəbliyindən istifadə edir. Burada \(K\times K\) nüvə ölçüsü, \(C_{in}\) giriş kanallarının sayı və \(C_{out}\) çıxış kanallarının sayıdır.
CNN proqnozlaşdırıcısı üç paralel xüsusiyyət çıxarma qolunda 3×3, 5×5 və 7×7 nüvələrlə 32 xüsusiyyət xəritəsi yaradır; proqnoz qolunda ardıcıl iki 3×3 konvolyusiya bloku mövcuddur. Mənbənin ümumi CNN hesabı:
\[ C_{\mathrm{CNN}}=O(6.7\times10^4N) \]
kimi verilir.
NLM üçün:
\[ C_{\mathrm{NLM}}=O(NS^2P^2) \]
istifadə edilmişdir. Bu bölmədə mənbə \(S=15\) və \(P=5\) qiymətlərini verərək:
\[ C_{\mathrm{NLM}}=O(5.6\times10^3N) \]
nəticəsini hesabat verir. Buradakı \(S\times S\) oxşarlıq axtarış pəncərəsi, \(P\times P\) isə yama ölçüsüdür. Daha əvvəl qeyd edildiyi kimi, metod bölməsindəki 21×21 və 3×3 hesabatı ilə bu qiymətlər eyni deyil.
İkiqatlı diqqət füzyon şəbəkəsi üçün:
\[ C_{\mathrm{Attn}}=O(4.3\times10^2N) \]
və ümumi üçün:
\[ C_{\mathrm{total}} = C_{\mathrm{CNN}}+ C_{\mathrm{NLM}}+ C_{\mathrm{Attn}} = O(7.3\times10^4N) \]
hesabat verilmişdir. Mənbə bu struktur daxilində mürəkkəbliyin təsvirin piksel sayı ilə xətti miqyaslandığını bildirir.
| Komponent | Mənbədə hesabat verilən mürəkkəblik |
|---|---|
| CNN Predictor | \(O(6.7\times10^4N)\) |
| NLM Predictor | \(O(5.6\times10^3N)\) |
| Attention Fusion Network | \(O(4.3\times10^2N)\) |
| Ümumi | \(O(7.3\times10^4N)\) |
Tədqiqatın dəstəklədiyi nəticələr
- AFCNNP, hesabat verilən təcrübələrdə müqayisə edilən CNN proqnozlaşdırıcılarından daha aşağı MSE və proqnozlaşdırma xətası dispersiyası yaratmışdır.
- Diqqət şəbəkəsi CNNP və NLM töhfələrini piksel səviyyəsində dəyişdirə bilmişdir.
- Teksturalı təsvirlərdə NLM-nin töhfəsi yalnız hamar bölgələri önə çıxaran metodların istifadə edə bilmədiyi proqnozlaşdırıla bilən piksellərin bir hissəsini istifadə edilə bilən hala gətirmişdir.
- UCID.v2 təcrübəsində təklif olunan metod hesabat verilmiş ən yüksək orta maksimum yerləşdirmə tutumuna çatmışdır.
- 10.000-20.000 bit intervalındakı bərabər tutum müqayisələrində təklif olunan metod mənbə cədvəlindəki ən yüksək orta PSNR-ni vermişdir.
- Ablasiya nəticələri həm öyrənilmiş diqqət füzyonunun, həm də dispersiya requlyarlaşdırmasının performansa töhfə verdiyini dəstəkləyir.
- 24 Kodak təsvirindəki MSE müqayisəsində Lin və həmkarlarının metoduna qarşı fərq \(p<0.05\) kimi hesabat verilmişdir.
Tədqiqatın dəstəkləmədiyi ümumiləşdirmələr və məhdudiyyətlər
- Nəticələr AFCNNP-nin bütün təsvir növlərində şərtsiz olaraq ən yaxşı metod olduğunu sübut etmir.
- Əsas təcrübələr boz tonlu və 512×512 ölçüsünə gətirilmiş təsvirlər üzərində aparılmışdır.
- Mənbə transformer əsaslı metodla birbaşa kəmiyyət müqayisəsi aparmamışdır; dizayn və təlim əhatəsindəki fərqlər səbəbindən bu müqayisəni kənarda saxlamışdır.
- Maksimum yerləşdirmə tutumundakı PSNR qiymətləri metodların fərqli tutum nöqtələrində ölçüldüyünə görə yalnız PSNR sütununa baxaraq birbaşa üstünlük sıralaması aparmaq olmaz.
- Hesablama mürəkkəbliyi bölməsindəki NLM yama/axtarış parametrləri ilə əsas metod bölməsindəki parametrlər arasında izah olunmamış fərq var.
- Tədqiqat gələcəkdə daha geniş CNN proqnozlaşdırıcı ailələrinin, encrypted-domain RDH və transformer əsaslı proqnozlaşdırıcılarla inteqrasiyanın araşdırılmasını təklif edir; bunlar bu məqalədə təsdiqlənmiş nəticələr deyil.
Mənbə və Metod Qeydi
Orijinal başlıq: A Texture-Aware CNN Predictor for Reversible Data Hiding
Müəlliflər: Mohsin Shah; Chang Choi.
Məsul müəllif: Chang Choi.
Qurum: Department of Computer Engineering, Gachon University, Seongnam-si 13120, Gyeonggi-do, Republic of Korea.
Jurnal: Mathematics.
Nəşriyyat: MDPI.
Biblioqrafik qeyd: Mathematics 2026, 14(9), 1542.
DOI: 10.3390/math14091542
Rəsmi keçid: https://doi.org/10.3390/math14091542
Göndərilmə: 1 aprel 2026. Reviziya: 21 aprel 2026. Qəbul: 29 aprel 2026. Nəşr: 1 may 2026.
Mənbə növü: Resenziyalı tədqiqat məqaləsi.
Lisenziya: Creative Commons Attribution (CC BY) açıq giriş lisenziyası.
PDF-də yer alan maliyyələşdirmə məlumatı: Basic Science Research Program through the National Research Foundation of Korea (NRF), Ministry of Education, RS-2025-25434261; həmçinin Gachon University Research Fund of 2024, GCU-202404090001.
Cari rəsmi qeyd xəbərdarlığı: MDPI-nin cari nəşr səhifəsi məqalənin maliyyələşdirmə bəyanatında kiçik düzəlişlə yenidən yayımlandığını bildirir. Cari onlayn qeyddə NRF dəstəyi Korea government (MSIT), RS-2025-00559546 kimi görünür. Buna görə PDF ilə cari rəsmi qeyd arasındakı maliyyələşdirmə fərqi səssizcə birləşdirilməməlidir.
Məlumatların əlçatanlığı: Mənbə tədqiqatda istifadə olunan məlumatların UCID.v2 vasitəsilə açıq şəkildə əlçatan olduğunu bildirir.
Maraqların toqquşması: Müəlliflər maraqların toqquşmasının olmadığını bildirmişlər.
Müəllif töhfələri: Mohsin Shah; konseptuallaşdırma, metodologiya, proqram təminatı, doğrulama, formal analiz, tədqiqat və ilkin qaralama. Chang Choi; resurslar, məlumat kurasiyası, nəzərdən keçirmə/redaktə, vizuallaşdırma, məsləhətçilik, layihə idarəetməsi və maliyyənin əldə edilməsi. Hər iki müəllif də nəşr olunmuş versiyanı oxuyub təsdiqləmişdir.
Elmi şərh sərhədi: Məqalə AFCNNP-nin hesabat verilən UCID.v2 və Kodak təcrübələrindəki performansını göstərir. Nəticələr fərqli təsvir paylanmalarına, rəngli təsvirlərin orijinal təsvir ölçülərinə, başqa RDH arxitekturalarına və ya encrypted-domain tətbiqlərinə birbaşa ümumiləşdirilməməlidir.
Mənbədaxili hesabat qeydləri: Mənbə Cədvəl 2-nin ikinci metriki “Mean” kimi etiketlənsə də, ətraf mətn MAE, MSE və dispersiya müqayisəsindən bəhs edir. Bundan əlavə, NLM metod təsvirindəki 3×3 yama / 21×21 axtarış pəncərəsi ilə mürəkkəblik analizindəki \(P=5\) / \(S=15\) qiymətləri bir-birindən fərqlidir. Bu fərqlər mənbəyə sədaqət tələbi səbəbindən səssizcə düzəldilməmişdir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib