


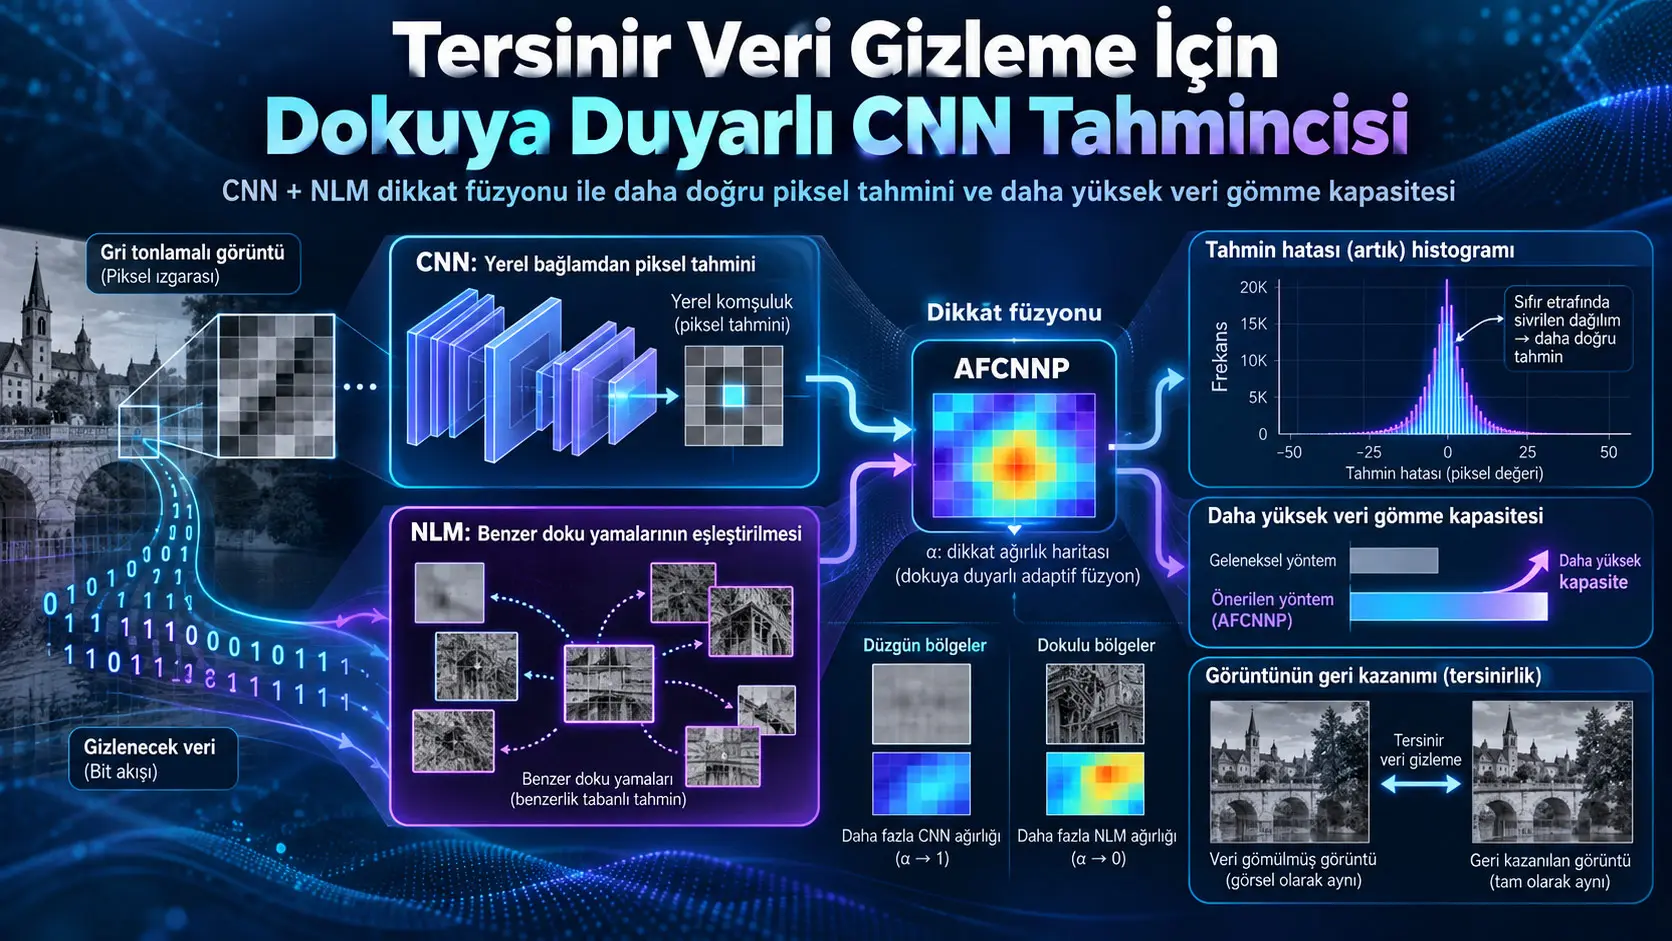
Dokuya duyarlı dikkat füzyonlu CNN tahmincisi (Attention Fusion-Based CNN Predictor, AFCNNP), tersinir veri gizlemede piksel değerlerini daha doğru tahmin etmek için yerel CNN tahmini ile yerel olmayan ortalamalar (Non-Local Means, NLM) tahminini piksel bazında birleştiren bir görüntü tahmin çerçevesidir. Yöntemin temel fikri, CNN tahmincisinin düzgün bölgelerdeki güçlü yerel korelasyon yeteneğini, NLM'nin dokulu bölgelerdeki uzak fakat benzer görüntü yamalarını kullanabilme yeteneğiyle birleştirmektir. Öğrenilen dikkat ağırlığı \(\alpha(i,j)\), her piksel için CNNP ile NLM'nin nihai tahmine ne kadar katkıda bulunacağını belirler.
Çalışmanın hedefi yalnız piksel tahmin hatasını azaltmak değildir. Tersinir veri gizlemede tahmin hatalarının sıfır çevresinde dar ve yüksek bir dağılım oluşturması, Prediction Error Expansion (PEE) mekanizmasının daha fazla veriyi daha düşük görüntü bozulmasıyla gömebilmesini sağlar. AFCNNP bu nedenle düzgün bölgeleri kullanmakla yetinmek yerine dokulu bölgelerdeki yerel olmayan öz-benzerliği de kullanılabilir tahmin bilgisine dönüştürmeye çalışmaktadır.
100 UCID.v2 görüntüsü üzerindeki karşılaştırmada önerilen yöntem için MSE 51.5, kaynak tablosunda “Mean” olarak verilen değer 3.3 ve tahmin hatası varyansı 34.0 olarak bildirilmiştir; bu değerlerin tamamı karşılaştırılan CNN tahmincilerinden düşüktür. Önerilen AFCNNP tabanlı RDH yöntemi ortalama maksimum 125.816 bit gömme kapasitesine ulaşırken bu noktadaki ortalama PSNR değeri 42.58 dB olmuştur. Kodak veri kümesindeki 24 görüntü üzerinde ise MSE \(50.30\pm2.7\), PSNR \(64.78\pm0.38\) olarak raporlanmış ve Lin ve arkadaşlarının yöntemiyle MSE karşılaştırmasında eşleştirilmiş t-testi sonucu \(p<0.05\) bulunmuştur.
Sonuçlar AFCNNP'nin kullanılan deney düzeninde hem düzgün hem de dokulu bölgelerden yararlanarak tahmin doğruluğunu ve veri gömme performansını geliştirebildiğini göstermektedir. Bununla birlikte çalışma gri ölçekli görüntüler, belirli CNN/NLM mimarisi, UCID.v2 ve Kodak veri kümeleri ile raporlanan eğitim düzenine dayanmaktadır; sonuçlar bütün görüntü türleri veya bütün RDH sistemleri için otomatik bir üstünlük kanıtı değildir.
Tersinir Veri Gizleme Nedir?
Tersinir veri gizleme (Reversible Data Hiding, RDH), bir taşıyıcı görüntüye ek bilgi gömüldükten sonra hem ek bilginin çıkarılmasını hem de özgün taşıyıcı görüntünün kayıpsız biçimde yeniden elde edilmesini amaçlayan bilgi gizleme yaklaşımıdır. Kalıcı piksel bozulmasının kabul edilmediği uygulamalarda bu tersinirlik temel gereksinimdir.
Çalışmanın çözmeye çalıştığı problem
Prediction Error Expansion tabanlı RDH yöntemlerinde bir pikselin gerçek değeri ile tahmin edilen değeri arasındaki fark veri gömmek için kullanılır. Tahmin ne kadar doğruysa hata değerleri sıfır çevresinde o kadar yoğunlaşır. Bu da düşük bozulmayla kullanılabilecek daha fazla küçük hata üretir.
Klasik CNN tahmincileri düzgün bölgelerde komşu pikseller arasındaki güçlü yerel korelasyondan iyi yararlanabilir. Ancak yoğun doku, saç, kumaş, yaprak, karmaşık kenarlar veya tekrarlı desenler içeren alanlarda yalnız yakın komşuluğa bakmak yeterli olmayabilir. NLM ise görüntünün başka bir konumunda bulunan benzer yamaları aradığı için dokulu bölgelerde farklı türde bir bilgi kullanır. AFCNNP'nin bilimsel çekirdeği, bu iki tahmin biçiminden birini bütün görüntü için zorla seçmek yerine her pikselde katkılarını öğrenerek birleştirmektir.
Kaynakta karşılaştırılan tahminci ailesi
| Tahminci | Tür | Düzgün bölgeler | Dokulu bölgeler | Gömme kapasitesi |
|---|---|---|---|---|
| [16] | Klasik | Orta doğruluk | Zayıf, büyük hatalar | Düşük |
| [20] | Klasik | Düz/kenar bölgelerinde iyi | Orta | Orta |
| [21] | Klasik | Düzgün bölgelerde çok iyi | Zayıf | Düşük |
| [22] | Klasik | Gradyanlarda iyi | Orta; gürültüde kararsız | Orta |
| [23] | Klasik | Difüzyonla çok iyi | Orta; aşırı yumuşatma riski | Orta |
| [24] | Klasik | Düzgün yapıyı öğrenir | Orta | Yüksek |
| [25] | Klasik | Uyarlanabilir | İyi, kısmen dayanıklı | Yüksek |
| [28] | CNN | Düzgünlük için eğitilmiş | Dokulu alanlardan kaçınır | Orta |
| [29] | CNN | Düzgün bölgelerde dayanıklı | Yüksek hatalı piksellerden kaçınır | Orta |
| [30] | CNN | Geniş alıcı alan | Seçici gömme | Orta |
| [31] | CNN | Keskin düşük-hatalı tahminler | Dokuları dışlar | Düşük |
| [32] | CNN | Düzgünlüğe ağırlık verir | Doku düşük ağırlıklı | Düşük-Orta |
| [33] | CNN | Düşük karmaşıklık seçimi | Dokuları dışlar | Orta |
Denklem (1): Bir piksel nasıl tahmin ediliyor?
\[ \hat{p}_{i,j}=\mathcal{P}\left(p_{i',j'}\right),\qquad (i',j')\in\mathcal{N}_{i,j} \tag{1} \]
\(p_{i,j}\) gerçek gri seviye piksel değeridir; \(\hat p_{i,j}\) tahmin edilen değerdir. \(\mathcal{N}_{i,j}\), merkez pikseli tahmin etmek için kullanılan komşuluk veya tahmin bağlamını, \(\mathcal P\) ise tahmin fonksiyonunu gösterir. Gri ölçekli 8-bit görüntülerde piksel değerleri 0-255 aralığındadır. Matematiksel amaç, \(\hat p_{i,j}\) değerini gerçek \(p_{i,j}\)'ye mümkün olduğunca yaklaştırmaktır.
Tahmin hatası ayrıca:
\[ e_{i,j}=p_{i,j}-\hat p_{i,j} \]
olarak tanımlanır. \(e_{i,j}=0\) olduğunda tahmin tam doğrudur. Hatanın mutlak değeri büyüdükçe tahmin gerçek pikselden daha fazla uzaklaşır.
PEE'de iç ve dış tahmin hataları
Kaynak, tahmin hatalarını iki eşik \(T_l\) ve \(T_r\) yardımıyla ayırır. \(e_{i,j}\in[T_l,T_r)\) aralığındaki hatalar veri taşıyan iç hatalar olarak kullanılır. Bu aralığın dışındaki hatalar veri biti taşımak yerine histogramda boş alan oluşturmak amacıyla kaydırılır.
İç hata için gömülecek bit \(b\in\{0,1\}\) olmak üzere genişletilmiş hata:
\[ e^w_{i,j}=2e_{i,j}+b \]
şeklindedir. Burada ikiyle çarpma hata histogramındaki kullanılabilir değerler arasında yeni konumlar oluşturur; \(b\) ise bu iki olası konumdan hangisinin seçileceğini belirler.
Denklem (2): İşaretlenmiş pikselin üretilmesi
\[ p^w_{i,j}= \begin{cases} p_{i,j}+e_{i,j}+b, & e_{i,j}\in[T_l,T_r)\\ p_{i,j}+T_r, & e_{i,j}\in[T_r,+\infty)\\ p_{i,j}+T_l, & e_{i,j}\in(-\infty,T_l) \end{cases} \tag{2} \]
\(p^w_{i,j}\) veri gömüldükten sonraki işaretlenmiş piksel değeridir. İlk durumda piksel veri biti taşır. İkinci ve üçüncü durumlarda hata dağılımının sağ veya sol tarafı kaydırılarak veri taşıyan hata değerleri için boş histogram bölmeleri oluşturulur. İşlem sonucunda piksel 0-255 sınırının dışına çıkabilecekse kaynak bu pikselin dışlanmasını veya bir konum haritasıyla kaydedilmesini öngörür.
Denklem (3): Alıcı tarafta genişletilmiş hata
\[ e^w_{i,j}=p^w_{i,j}-\hat p_{i,j} \tag{3} \]
Alıcı aynı tahmin fonksiyonunu kullanarak \(\hat p_{i,j}\) değerini yeniden üretir. İşaretlenmiş pikselle bu tahmin arasındaki fark, veri gömme aşamasında oluşturulan genişletilmiş tahmin hatasını verir. Tersinirliğin temel koşulu, gömme ve çıkarma sırasında tahmin bağlamının aynı kalabilmesidir.
Denklem (4): Özgün tahmin hatasının geri alınması
\[ e_{i,j}= \begin{cases} \left\lfloor\dfrac{e^w_{i,j}}{2}\right\rfloor, & e^w_{i,j}\in[2T_l,2T_r)\\ e^w_{i,j}-T_r, & e^w_{i,j}\in[2T_r,+\infty)\\ e^w_{i,j}-T_l, & e^w_{i,j}\in(-\infty,2T_l) \end{cases} \tag{4} \]
İç hata bölgesinde genişletme işlemi ikiye bölünerek tersine çevrilir. Dış bölgelerde ise gömme sırasında yapılan eşik kaydırması geri alınır. Gömülü bit:
\[ b=e^w_{i,j}\bmod 2 \]
ile çıkarılır ve özgün piksel:
\[ p_{i,j}=\hat p_{i,j}+e_{i,j} \]
ile yeniden oluşturulur. Bu zincir, yöntemin neden “tersinir” olduğunu matematiksel olarak gösterir: amaç yalnız gizli veriyi çıkarmak değil, veri gömülmeden önceki piksel değerlerini de geri getirmektir.
AFCNNP Neden CNN ve NLM Tahminlerini Birlikte Kullanıyor?
AFCNNP, CNNP'nin düzgün bölgelerdeki yerel korelasyon bilgisini ve NLM'nin dokulu bölgelerdeki yerel olmayan öz-benzerlik bilgisini aynı piksel tahmini içinde birleştirir; öğrenilen \(\alpha(i,j)\) ağırlığı CNNP'nin daha yararlı olduğu yerde 1'e, NLM'nin daha yararlı olduğu yerde 0'a yaklaşarak iki tahminci arasında piksel bazında uyarlanabilir geçiş sağlar.
Non-Local Means: Yakındaki piksel yerine benzer deseni aramak
NLM'nin temel düşüncesi şudur: Tahmin edilen pikselin hemen yanındaki pikseller yeterince bilgi vermiyorsa, görüntünün daha uzaktaki bölümlerinde aynı veya benzer dokusal yapıya sahip yamalar aranabilir. Kaynakta hedef piksel \(p_{i,j}\) ve dört en yakın komşusundan oluşan eşkenar dörtgen biçimli bir yama tanımlanır.
Denklem (5): NLM tahmini
\[ NL(p_{i,j})= \frac{1}{\sum_k w_k} \sum_{\tilde p_k\in\tilde P_k} w_k\tilde p_k \tag{5} \]
\(\tilde p_k\), yerel olmayan aday pikseli; \(w_k\), bu adayın hedef bölgeye ne kadar benzer olduğuna göre verilen ağırlığı gösterir. Pay, kabul edilen piksellerin ağırlıklı toplamıdır; payda ise ağırlıkların toplamıdır. Böylece sonuç bir ağırlıklı ortalamadır. Kaynaktaki uygulamada ağırlık sürekli bir benzerlik katsayısı değil, Denklem (7)'de gösterildiği gibi 0 veya 1 değerini alan bir seçim değişkenidir.
Denklem (6): Yama benzerlik uzaklığı
\[ d_k= \left\| V(\tilde p_k)-V(p_{i,j}) \right\|_2 \tag{6} \]
\(V(\cdot)\), karşılaştırılan görüntü çevresinin sayısal temsilini; \(d_k\) ise iki temsil arasındaki Öklid uzaklığını ifade eder. \(d_k\) küçüldükçe aday bölge hedef bölgeye daha çok benzer. Bu büyüklük gri seviye değerlerinden türetilir ve eşik \(T_{sim}\) ile karşılaştırılır.
Denklem (7): NLM benzerlik seçimi
\[ w_k= \begin{cases} 1, & d_k\leq T_{sim}\\ 0, & \text{aksi halde} \end{cases} \tag{7} \]
\(T_{sim}\) kullanıcı tarafından belirlenen benzerlik eşiğidir. Uzaklık eşikten küçük veya eşitse aday NLM tahminine katılır; büyükse tamamen dışlanır. Eşiğin çok küçük olması yalnız çok benzer yamaları seçerek hatayı azaltabilir ancak kullanılabilir yerel olmayan örnek sayısını sınırlar. Eşiğin büyütülmesi daha fazla yamanın kullanılmasına izin verir fakat daha az benzer örnekleri de tahmine dahil eder.
Denklem (8): Tahmin hatası entropisi
\[ E=-\sum_e p(e)\ln p(e) \tag{8} \]
\(p(e)\), tahmin hatası \(e\)'nin olasılığıdır. Entropi dağılımın ne kadar yaygın veya belirsiz olduğunu özetler. RDH açısından amaç, tahmin hatalarının olabildiğince sıfır çevresinde yoğunlaşmasıdır. Kaynakta Baboon görüntüsü üzerinde \(T_{sim}\) büyüdükçe tahmin hatası entropisinin monoton biçimde yükseldiği gözlenmiştir. Bunun nedeni daha büyük eşiklerin daha az benzer yamaları NLM tahminine dahil etmesidir.
Dot ve Cross görüntü ayrımı neden gerekli?
Görüntü iki bağımsız piksel kümesine ayrılır. Kaynak bunları Dot ve Cross setleri olarak adlandırır. Bir kümedeki pikseller tahmin edilirken tahmin bağlamı karşı kümenin henüz değiştirilmemiş piksellerinden oluşturulur. Ardından roller ters çevrilir. Bu strateji, veri gömme sırasında kullanılan tahmin bağlamının veri çıkarma sırasında yeniden oluşturulabilmesini sağlar ve tersinirliğin korunmasına yardım eder.
Denklem (9): CNNP tahmini
\[ P_{\mathrm{CNNP}}(i,j) = f_{\theta} \left( \mathcal{V}_k(I(i,j)) \right) \tag{9} \]
\(I\in\mathbb{R}^{H\times W}\) giriş görüntüsüdür. \(\mathcal V_k(I(i,j))\), \((i,j)\) pikselinin çevresindeki \(k\times k\) yerel yamayı; \(f_\theta\), ağırlıkları \(\theta\) olan önceden eğitilmiş CNN tahmincisini gösterir. Çıktı \(P_{\mathrm{CNNP}}(i,j)\), CNN'nin merkez piksel için ürettiği gri seviye tahminidir.
Dikkat füzyon ağının yapısı
CNNP ve NLM tahmin haritalarının her biri \((B,1,H,W)\) biçimindedir. Kanal boyutunda birleştirildiklerinde \((B,2,H,W)\) tensörü oluşur. Dikkat ağı iki evrişim katmanından oluşur. İlk katman 3×3 çekirdekle 16 filtre ve padding 1 kullanır, ardından ReLU uygulanır. İkinci 3×3 evrişim tek kanallı ağırlık haritası üretir ve Sigmoid fonksiyonu sonucu 0 ile 1 arasına sınırlar.
Denklem (10): Piksel bazlı dikkat ağırlığı
\[ \alpha(i,j) = \sigma \left( W_2\cdot \operatorname{ReLU} \left( W_1\cdot [P_{\mathrm{CNNP}}(i,j);P_{\mathrm{NLM}}(i,j)] +b_1 \right) +b_2 \right) \tag{10} \]
Kaynak gösteriminde \(W_1\in\mathbb{R}^{16\times2}\), \(b_1\in\mathbb{R}^{16}\), \(W_2\in\mathbb{R}^{1\times16}\) ve \(b_2\in\mathbb{R}^{1}\) olarak tanımlanır. \(\sigma\) Sigmoid fonksiyonudur. Dolayısıyla \(0\leq\alpha(i,j)\leq1\).
\(\alpha\rightarrow1\) olduğunda CNNP tahmini baskın hale gelir. \(\alpha\rightarrow0\) olduğunda NLM tahmini baskın hale gelir. Ara değerler iki tahmincinin yumuşak biçimde karıştırılması anlamına gelir.
Denklem (11): Nihai birleşik tahmin
\[ P_{\mathrm{fused}}(i,j) = \alpha(i,j)P_{\mathrm{CNNP}}(i,j) + \left(1-\alpha(i,j)\right)P_{\mathrm{NLM}}(i,j) \tag{11} \]
Bu bir konveks ağırlıklı birleşimdir: iki katsayının toplamı 1'dir. Ağ yeni bir üçüncü tahmini doğrudan uydurmak yerine CNNP ve NLM tahminlerinin göreli katkısını belirler. Kaynağın yorumuna göre düzgün bölgelerde CNNP, dokulu bölgelerde NLM daha fazla ağırlık kazanır.
Denklem (12): AFCNNP eğitim kaybı
\[ \mathcal{L} = \frac{1}{HW} \sum_{i,j} \left| I(i,j)-P_{\mathrm{fused}}(i,j) \right| + \psi\cdot \operatorname{Var} \left( I-P_{\mathrm{fused}} \right) \tag{12} \]
İlk terim gerçek piksel ile birleşik tahmin arasındaki ortalama mutlak hatayı, ikinci terim tahmin hatalarının varyansını cezalandırır. Çalışmada düzenlileştirme parametresi \(\psi=0.3\) olarak ayarlanmıştır.
Birinci terimin görevi piksellerin tek tek doğru tahmin edilmesini sağlamaktır. İkinci terim ise hataların geniş bir alana dağılmasını engellemeye çalışır. RDH açısından düşük ortalama hata tek başına yeterli değildir; hata histogramının sıfır çevresinde yoğunlaşması da PEE için yararlıdır.
Kaynağın \(\psi\) duyarlılık grafiğinde \(\psi=0.1\) daha yaygın kuyruklu ve düşük tepeli bir hata dağılımı oluştururken, \(\psi=0.3\) dağılımı sıfır çevresinde daha yoğun hale getirir. \(\psi=0.5\) daha keskin bir dağılım oluştursa da tepe sıfırdan uzaklaşır ve MAE yükselir. Bu nedenle çalışmanın kullandığı değer 0.3'tür.
Çalışmanın Yöntemi ve Bulguları
RDH gömme süreci
Özgün görüntü önce Dot \(I_D\) ve Cross \(I_C\) alt görüntülerine ayrılır. İlk aşamada \(I_C\), Dot piksellerini tahmin etmek için kullanılır. Gerçek \(I_D\) ile tahmin edilen \(\tilde I_D\) arasındaki tahmin hataları üzerinden ek verinin ilk bölümü \(W_1\) gömülür ve işaretlenmiş Dot görüntüsü \(I_D^{W_1}\) oluşur.
İkinci aşamada \(I_D^{W_1}\) hibrit tahminciye verilerek Cross görüntüsü \(\tilde I_C\) tahmin edilir. Bu tahmin kullanılarak \(W_2\) gömülür ve \(I_C^{W_2}\) elde edilir. İki işaretlenmiş alt görüntü birleştirilerek nihai işaretlenmiş görüntü \(I^W\) oluşturulur.
Veri çıkarma ve görüntü kurtarma
Çıkarma işlemi gömme işleminin ters sırasıdır. Önce işaretlenmiş görüntü tekrar Dot ve Cross kümelerine ayrılır. İşaretlenmiş Dot görüntüsü kullanılarak Cross pikselleri tahmin edilir; \(W_2\) çıkarılır ve özgün \(I_C\) geri kazanılır. Daha sonra geri kazanılmış Cross görüntüsü kullanılarak Dot görüntüsü tahmin edilir; \(W_1\) çıkarılır ve özgün \(I_D\) geri kazanılır. Son olarak \(I_D\) ve \(I_C\) birleştirilerek özgün görüntü, \(W_1\) ve \(W_2\) birleştirilerek gömülü veri yeniden elde edilir.
Eğitim ve deney düzeni
| Eğitim görüntüleri | ImageNet'ten rastgele seçilen 3000 görüntü |
|---|---|
| Eğitim biçimi | Gri ölçek, 512×512 |
| Optimizer | Adam |
| Başlangıç öğrenme oranı | \(1\times10^{-4}\) |
| Weight decay | \(1\times10^{-3}\) |
| Batch size | 8 |
| Adam \(\beta_1\) | 0.9 |
| Adam \(\beta_2\) | 0.999 |
| Adam \(\epsilon\) | \(1\times10^{-8}\) |
| Epoch | 20 |
| Temel deney görüntüleri | Lena, Baboon, Boat, Barbara, Pepper, Lake |
| Karşılaştırma veri kümesi | UCID.v2 |
| Ek doğrulama | Kodak |
| Yazılım | Python 3.11.2, PyTorch 2.6.0 |
| CPU | Intel Core i9-10980XE @ 3.00 GHz |
| RAM | 64 GB |
| GPU | NVIDIA RTX A5000 |
Kaynak içi parametre notu: AFCNNP yöntem açıklamasında NLM'nin 3×3 yama ve 21×21 arama penceresi kullandığı belirtilmiştir. Buna karşılık hesaplama karmaşıklığı bölümünde \(S=15\) ve \(P=5\) kullanılarak karmaşıklık hesabı yapılmıştır. Kaynak bu iki parametre setinin neden farklı olduğunu ayrıca açıklamamaktadır; bu nedenle burada biri diğerinin yerine geçirilmemiştir.
Dikkat ağırlığı haritaları ne gösterdi?
Kaynağın altı test görüntüsündeki ağırlık haritalarında \(\alpha>0.8\) olan CNNP-baskın bölgeler sarı, \(\alpha<0.2\) olan NLM-baskın bölgeler mavi, \(0.2\leq\alpha\leq0.8\) ara bölgeler iki tahmincinin yumuşak karışımı olarak gösterilmiştir. Lena, Boat ve Pepper görüntülerinin büyük bölümlerinde CNNP baskınken Barbara ve Lake görüntülerinde NLM'nin katkısı artmıştır. Çok yoğun ve hızlı değişen kürk dokusuna sahip Baboon görüntüsünde ise iki tahminci daha belirgin biçimde birlikte kullanılmıştır.
Tahmin doğruluğu: 100 UCID.v2 görüntüsü
| Metrik | Hu [28] | Hu [29] | Yang [30] | Wu [31] | Lin [32] | Önerilen |
|---|---|---|---|---|---|---|
| MSE | 92.41 | 79.57 | 59.72 | 57.31 | 53.23 | 51.5 |
| Mean | 4.42 | 4.31 | 3.70 | 3.59 | 3.41 | 3.3 |
| Varyans | 63.17 | 52.34 | 39.67 | 37.78 | 35.30 | 34.0 |
Ortalama tahmin hatası histogramında AFCNNP'nin dağılımı diğer yöntemlerden daha fazla sıfır çevresinde yoğunlaşmış ve daha yüksek bir merkez tepesi üretmiştir. PEE bakımından bu önemlidir; çünkü çok sayıda küçük veya sıfır tahmin hatası veri gömme için daha elverişli bir histogram oluşturur.
Sıfır tahmin hatası sayıları
| Görüntü | Hu [28] | Hu [29] | Yang [30] | Wu [31] | Lin [32] | Önerilen |
|---|---|---|---|---|---|---|
| Lena | 36.203 | 36.982 | 39.375 | 40.354 | 41.135 | 42.735 |
| Baboon | 12.032 | 12.940 | 13.765 | 14.011 | 15.322 | 16.371 |
| Boat | 22.111 | 25.078 | 27.550 | 28.428 | 30.352 | 31.142 |
| Barbara | 31.896 | 38.587 | 43.135 | 44.969 | 45.621 | 46.931 |
| Pepper | 21.959 | 23.807 | 28.038 | 29.600 | 32.199 | 33.753 |
| Lake | 20.409 | 23.101 | 25.934 | 26.246 | 26.832 | 27.926 |
Özellikle yüksek dokulu Baboon görüntüsündeki artış, çalışmanın NLM bileşenini ekleme gerekçesiyle uyumludur. Bununla birlikte tek bir görüntünün sonucu genel üstünlük kanıtı olarak ele alınmamış; çalışma daha geniş UCID.v2 ve Kodak değerlendirmeleri de gerçekleştirmiştir.
Maksimum gömme kapasitesi ve PSNR
| Yöntem | Doku kullanımı | Ort. maksimum kapasite (bit) | Maksimum kapasitedeki ort. PSNR (dB) |
|---|---|---|---|
| Hu [28] | Düşük | 120.000 | 43.0 |
| Hu [29] | Düşük | 45.000 | 52.1 |
| Yang [30] | Çok düşük | 80.000 | 49.97 |
| Wu [31] | Düşük | 20.000 | 59.64 |
| Lin [32] | Çok düşük | 20.000 | 59.78 |
| Önerilen | Orta-Yüksek | 125.816 | 42.58 |
Önerilen yöntem tablodaki en yüksek ortalama maksimum kapasiteyi elde etmiştir. Ancak maksimum kapasitedeki 42.58 dB PSNR, daha az veri gömen bazı yöntemlerin PSNR değerlerinden düşüktür. Bu nedenle sonuç “AFCNNP bütün koşullarda en yüksek PSNR'ye sahiptir” şeklinde yorumlanamaz. Çalışmanın avantajı yüksek kapasite ile görüntü sadakati arasındaki farklı bir denge noktasına ulaşmasıdır.
Aynı gömme kapasitesinde PSNR karşılaştırması
| Bit | Hu [28] | Hu [29] | Yang [30] | Wu [31] | Lin [32] | Önerilen |
|---|---|---|---|---|---|---|
| 10.000 | 63.42 | 64.12 | 64.32 | 65.03 | 65.15 | 65.50 |
| 11.000 | 63.18 | 63.62 | 63.79 | 64.71 | 64.89 | 65.17 |
| 12.000 | 62.89 | 63.41 | 63.50 | 64.35 | 64.51 | 64.80 |
| 13.000 | 62.51 | 63.02 | 63.10 | 64.01 | 64.13 | 64.45 |
| 14.000 | 62.21 | 62.76 | 62.73 | 63.63 | 63.78 | 64.06 |
| 15.000 | 61.89 | 62.50 | 62.41 | 63.22 | 63.43 | 63.65 |
| 16.000 | 61.56 | 62.21 | 62.09 | 62.91 | 63.06 | 63.30 |
| 17.000 | 61.31 | 61.93 | 61.80 | 62.56 | 62.74 | 62.95 |
| 18.000 | 61.12 | 61.70 | 61.61 | 62.40 | 62.58 | 62.78 |
| 19.000 | 60.89 | 61.49 | 61.40 | 62.21 | 62.32 | 62.59 |
| 20.000 | 60.67 | 61.27 | 61.15 | 61.94 | 61.98 | 62.30 |
Bu karşılaştırmada kapasite her yöntem için aynı tutulduğundan yorum daha doğrudandır: 10.000-20.000 bit aralığındaki raporlanan bütün kapasite noktalarında önerilen yöntem en yüksek ortalama PSNR değerini vermiştir. Kapasite yükseldikçe bütün yöntemlerde PSNR düşmektedir; çünkü daha fazla gömme işlemi görüntüde daha fazla değişiklik gerektirir.
Kodak veri kümesi ve ablasyon deneyi
Kodak'ın renkli görüntüleri gri ölçeğe dönüştürülmüş ve 512×512 boyutuna yeniden ölçeklenmiştir. Ablation 1, dikkat ağı olmadan CNN ve NLM tahminlerinin basit ortalamasını; Ablation 2 ise Denklem (12)'deki varyans düzenlileştirme terimi olmadan elde edilen sonucu temsil eder.
| Görüntü | Hu [28] | Hu [29] | Yang [30] | Wu [31] | Lin [32] | Abl. 1 | Abl. 2 | Önerilen |
|---|---|---|---|---|---|---|---|---|
| Kodak01 | 62.24 | 63.30 | 63.78 | 64.31 | 64.83 | 61.14 | 64.21 | 65.02 |
| Kodak02 | 61.33 | 62.25 | 63.40 | 63.72 | 64.54 | 60.78 | 63.78 | 64.86 |
| Kodak03 | 61.93 | 62.56 | 63.70 | 64.19 | 64.56 | 61.04 | 64.05 | 64.30 |
| Kodak04 | 62.50 | 63.21 | 63.81 | 64.45 | 65.63 | 61.12 | 64.63 | 65.78 |
| Kodak05 | 61.68 | 63.81 | 63.90 | 64.58 | 64.83 | 59.31 | 64.45 | 65.32 |
| Kodak06 | 59.78 | 61.54 | 63.60 | 64.41 | 64.87 | 58.43 | 63.01 | 64.93 |
| Kodak07 | 60.62 | 62.45 | 63.24 | 63.20 | 63.93 | 58.14 | 62.37 | 64.58 |
| Kodak08 | 61.43 | 62.65 | 62.80 | 63.78 | 64.41 | 59.72 | 63.72 | 65.02 |
| Kodak09 | 62.21 | 62.36 | 63.14 | 63.74 | 63.85 | 60.25 | 62.83 | 64.81 |
| Kodak10 | 62.54 | 62.78 | 63.42 | 63.55 | 64.20 | 61.62 | 62.93 | 64.73 |
| Ortalama | 61.63 | 62.69 | 63.48 | 63.99 | 64.57 | 60.15 | 63.59 | 64.94 |
Ablation 1'in ortalama 60.15 dB'de kalması, CNN ve NLM'yi yalnız aritmetik olarak ortalamanın yeterli olmadığını gösterir. Ablation 2'nin 63.59 dB değeri ise varyans düzenlileştirmenin de nihai performansa katkıda bulunduğunu desteklemektedir. Tam AFCNNP ortalama 64.94 dB elde etmiştir.
24 Kodak görüntüsünde istatistiksel değerlendirme
| Yöntem | MSE | PSNR (dB) |
|---|---|---|
| Hu [28] | 90.23 ± 4.2 | 60.42 ± 0.83 |
| Hu [29] | 78.52 ± 3.7 | 61.51 ± 0.60 |
| Yang [30] | 56.14 ± 3.4 | 63.23 ± 0.46 |
| Wu [31] | 55.35 ± 3.1 | 63.67 ± 0.43 |
| Lin [32] | 52.42 ± 2.8 | 64.12 ± 0.49 |
| Önerilen | 50.30 ± 2.7 | 64.78 ± 0.38 |
Kaynak, önerilen yöntem ile mevcut yöntemler arasında en güçlü karşılaştırma olarak Lin ve arkadaşlarının yöntemini seçmiş ve 24 görüntünün MSE değerleri üzerinde eşleştirilmiş t-testi uygulamıştır. Sonuç \(p<0.05\) olarak raporlanmış ve gözlenen MSE iyileşmesinin bu deneyde rastlantısal değişkenlikle açıklanamayacak düzeyde istatistiksel olarak anlamlı olduğu belirtilmiştir. Bu test yalnız karşılaştırılan görüntüler, metrik ve yöntem çifti için geçerlidir.
Doku karmaşıklığı arttığında ne oldu?
Çalışma 10 UCID.v2 görüntüsünü Laplacian Variance (LV) değerine göre daha düzgün görüntülerden daha dokulu görüntülere doğru sıralamıştır. Önceki yöntemlerin gömme kapasitesi görüntü dokusu arttıkça genel olarak düşerken, AFCNNP'nin kapasitesi yüksek dokulu görüntülerde daha kararlı kalmış veya yükselmiştir. Yazarlar bu davranışı NLM'nin düzgün olmayan bölgelerde bulunan yerel olmayan yapısal benzerliği kullanabilmesine bağlamaktadır.
Hesaplama karmaşıklığı
Giriş görüntüsü \(H\times W\) ve toplam piksel sayısı \(N=H\times W\) olarak tanımlanmıştır. Bir evrişim katmanı için kaynak:
\[ O\left(NK^2C_{in}C_{out}\right) \]
karmaşıklığını kullanır. Burada \(K\times K\) çekirdek boyutu, \(C_{in}\) giriş kanal sayısı ve \(C_{out}\) çıkış kanal sayısıdır.
CNN tahmincisi üç paralel özellik çıkarma kolunda 3×3, 5×5 ve 7×7 çekirdeklerle 32 özellik haritası üretir; tahmin kolunda seri iki 3×3 evrişim bloğu bulunur. Kaynağın toplam CNN hesabı:
\[ C_{\mathrm{CNN}}=O(6.7\times10^4N) \]
olarak verilmektedir.
NLM için:
\[ C_{\mathrm{NLM}}=O(NS^2P^2) \]
kullanılmıştır. Bu bölümde kaynak \(S=15\) ve \(P=5\) değerlerini vererek:
\[ C_{\mathrm{NLM}}=O(5.6\times10^3N) \]
sonucunu raporlamaktadır. Buradaki \(S\times S\) benzerlik arama penceresi, \(P\times P\) ise yama boyutudur. Daha önce belirtildiği üzere yöntem bölümündeki 21×21 ve 3×3 raporlamasıyla bu değerler aynı değildir.
İki katmanlı dikkat füzyon ağı için:
\[ C_{\mathrm{Attn}}=O(4.3\times10^2N) \]
ve toplam için:
\[ C_{\mathrm{total}} = C_{\mathrm{CNN}}+ C_{\mathrm{NLM}}+ C_{\mathrm{Attn}} = O(7.3\times10^4N) \]
raporlanmıştır. Kaynak, bu yapı altında karmaşıklığın görüntüdeki piksel sayısıyla doğrusal ölçeklendiğini ifade etmektedir.
| Bileşen | Kaynakta raporlanan karmaşıklık |
|---|---|
| CNN Predictor | \(O(6.7\times10^4N)\) |
| NLM Predictor | \(O(5.6\times10^3N)\) |
| Attention Fusion Network | \(O(4.3\times10^2N)\) |
| Toplam | \(O(7.3\times10^4N)\) |
Çalışmanın desteklediği sonuçlar
- AFCNNP, raporlanan deneylerde karşılaştırılan CNN tahmincilerinden daha düşük MSE ve tahmin hatası varyansı üretmiştir.
- Dikkat ağı, CNNP ile NLM katkılarını piksel bazında değiştirebilmiştir.
- Dokulu görüntülerde NLM'nin katkısı, yalnız düzgün bölgeleri öne çıkaran yöntemlerin kullanamadığı tahmin edilebilir piksellerin bir bölümünü kullanılabilir hale getirmiştir.
- UCID.v2 deneyinde önerilen yöntem en yüksek raporlanan ortalama maksimum gömme kapasitesine ulaşmıştır.
- 10.000-20.000 bit aralığındaki eşit kapasite karşılaştırmalarında önerilen yöntem kaynak tablosundaki en yüksek ortalama PSNR'yi vermiştir.
- Ablasyon sonuçları hem öğrenilmiş dikkat füzyonunun hem de varyans düzenlileştirmesinin performansa katkı verdiğini desteklemektedir.
- 24 Kodak görüntüsündeki MSE karşılaştırmasında Lin ve arkadaşlarının yöntemine karşı fark \(p<0.05\) olarak raporlanmıştır.
Çalışmanın desteklemediği genellemeler ve sınırlılıklar
- Sonuçlar bütün görüntü türlerinde AFCNNP'nin koşulsuz biçimde en iyi yöntem olduğunu kanıtlamaz.
- Ana deneyler gri ölçekli ve 512×512 boyutuna getirilen görüntüler üzerinde yapılmıştır.
- Kaynak transformer tabanlı yöntemle doğrudan nicel karşılaştırma yapmamıştır; tasarım ve eğitim kapsamındaki farklar nedeniyle bu karşılaştırmayı dışarıda bırakmıştır.
- Maksimum gömme kapasitesindeki PSNR değerleri yöntemlerin farklı kapasite noktalarında ölçüldüğünden yalnız PSNR sütununa bakılarak doğrudan üstünlük sıralaması yapılamaz.
- Hesaplama karmaşıklığı bölümündeki NLM yama/arama parametreleriyle ana yöntem bölümündeki parametreler arasında açıklanmamış bir fark vardır.
- Çalışma gelecekte daha geniş CNN tahminci aileleri, encrypted-domain RDH ve transformer tabanlı tahmincilerle entegrasyonu araştırmayı önermektedir; bunlar bu makalede doğrulanmış sonuçlar değildir.
Kaynak ve Yöntem Notu
Özgün başlık: A Texture-Aware CNN Predictor for Reversible Data Hiding
Yazarlar: Mohsin Shah; Chang Choi.
Sorumlu yazar: Chang Choi.
Kurum: Department of Computer Engineering, Gachon University, Seongnam-si 13120, Gyeonggi-do, Republic of Korea.
Dergi: Mathematics.
Yayınevi: MDPI.
Bibliyografik kayıt: Mathematics 2026, 14(9), 1542.
DOI: 10.3390/math14091542
Resmî bağlantı: https://doi.org/10.3390/math14091542
Gönderim: 1 Nisan 2026. Revizyon: 21 Nisan 2026. Kabul: 29 Nisan 2026. Yayın: 1 Mayıs 2026.
Kaynak türü: Hakemli araştırma makalesi.
Lisans: Creative Commons Attribution (CC BY) açık erişim lisansı.
PDF'de yer alan finansman bilgisi: Basic Science Research Program through the National Research Foundation of Korea (NRF), Ministry of Education, RS-2025-25434261; ayrıca Gachon University Research Fund of 2024, GCU-202404090001.
Güncel resmî kayıt uyarısı: MDPI'nin güncel yayın sayfası makalenin finansman beyanında küçük bir düzeltmeyle yeniden yayımlandığını belirtmektedir. Güncel çevrimiçi kayıtta NRF desteği Korea government (MSIT), RS-2025-00559546 olarak görünmektedir. Bu nedenle PDF ile güncel resmî kayıt arasındaki finansman farkı sessizce birleştirilmemelidir.
Veri erişilebilirliği: Kaynak, çalışmada kullanılan verilerin UCID.v2 üzerinden açıkça erişilebilir olduğunu belirtmektedir.
Çıkar çatışması: Yazarlar çıkar çatışması olmadığını bildirmiştir.
Yazar katkıları: Mohsin Shah; kavramsallaştırma, metodoloji, yazılım, doğrulama, biçimsel analiz, araştırma ve ilk taslak. Chang Choi; kaynaklar, veri kürasyonu, gözden geçirme/düzenleme, görselleştirme, danışmanlık, proje yönetimi ve finansman edinimi. Her iki yazar da yayımlanan sürümü okuyup onaylamıştır.
Bilimsel yorum sınırı: Makale, AFCNNP'nin raporlanan UCID.v2 ve Kodak deneylerindeki performansını göstermektedir. Bulgular farklı görüntü dağılımlarına, renkli görüntülerin özgün çözünürlüklerine, başka RDH mimarilerine veya encrypted-domain uygulamalara doğrudan genellenmemelidir.
Kaynak içi raporlama notları: Kaynak Tablo 2'nin ikinci metriği “Mean” olarak etiketlenirken çevre metin MAE, MSE ve varyans karşılaştırmasından söz etmektedir. Ayrıca NLM yöntem açıklamasındaki 3×3 yama / 21×21 arama penceresi ile karmaşıklık analizindeki \(P=5\) / \(S=15\) değerleri birbirinden farklıdır. Bu farklılıklar kaynak sadakati gereği sessizce düzeltilmemiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir