


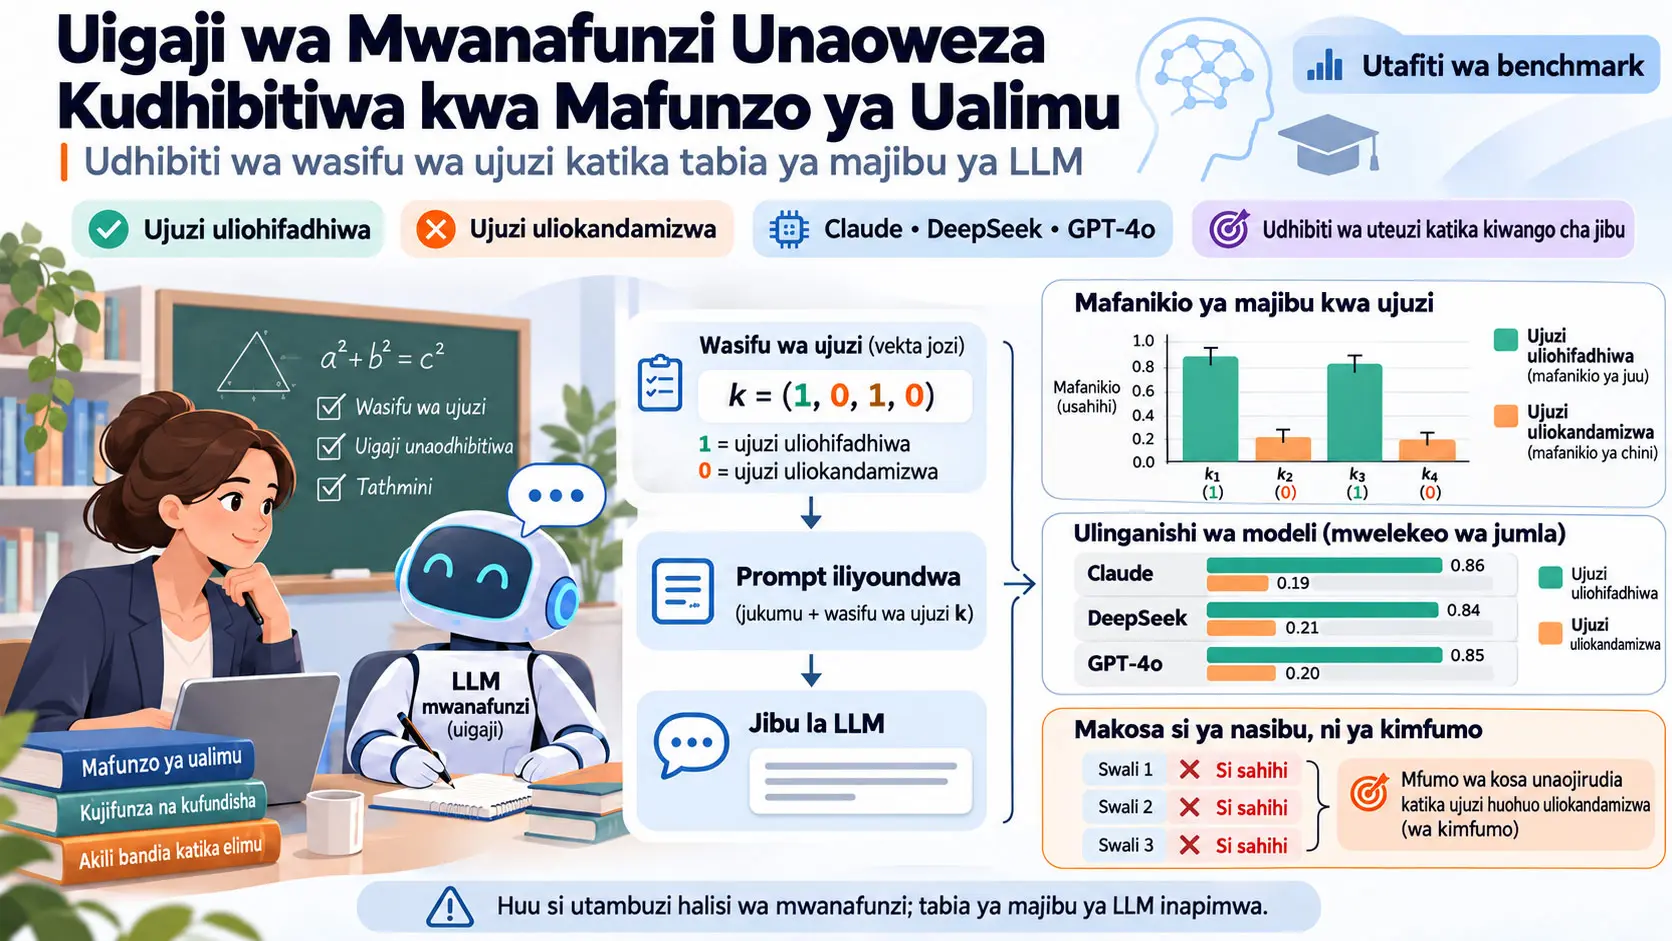
Uigaji wa mwanafunzi unaoweza kudhibitiwa (controllable learner simulation) ni tatizo la uigaji wa kielimu linalolenga kufanya modeli kubwa ya lugha isiigize tu kwa ujumla kama “mwanafunzi dhaifu zaidi”, bali ionyeshe kwa uteuzi utendaji wa chini wa majibu katika ujuzi fulani huku ikihifadhi baadhi ya ujuzi wa mtaala ndani ya wasifu wa ujuzi uliobainishwa mapema. Utafiti huu ni utafiti wa benchmark wa kikokotozi kabisa unaochunguza kama tabia hiyo inaweza kupimwa katika muktadha wa hisabati ya shule. Watafiti walitathmini endpoint za Claude, DeepSeek na GPT-4o katika ujuzi wa hisabati wa Grade 4 na Grade 5, kwa kutumia vekta za ujuzi za jozi zinazoonyesha ujuzi retained na suppressed.
Matokeo makuu ya utafiti ni kwamba modeli zote tatu ziliweza kutoa wasifu wa majibu wa uteuzi unaokandamiza ujuzi fulani huku ukihifadhi kwa kiasi ujuzi mwingine; hata hivyo, kiwango cha udhibiti huu kilitofautiana sana kati ya modeli. Utendaji wa juu zaidi wa msingi katika hisabati haukumaanisha controllability yenye nguvu zaidi. Claude ilitoa utengano ulio wazi zaidi kati ya ujuzi retained na suppressed katika vipimo vya jumla vilivyoripotiwa; DeepSeek ilionyesha utendaji wa mabaki zaidi katika ujuzi uliokusudiwa kukandamizwa, huku GPT-4o, licha ya kukandamiza kwa nguvu baadhi ya ujuzi, ilizalisha makosa zaidi katika ujuzi retained.
Muundo wa prompt pia ni wa kuamua. Mbinu ya few-shot inayoonyesha mifano pekee ilizalisha kutolingana kwa juu zaidi na wasifu lengwa wa ujuzi: masafa ya RMSE yalikuwa 0.40–0.61. Prompt za rule-based na combined, ambazo hutaja wazi ujuzi retained na suppressed, zilizalisha RMSE ya chini katika masafa ya 0.19–0.39. Chanzo kinafafanua kipengele cha explicit instruction kuwa kichocheo kikuu cha controllability; ilionekana kuwa kuongeza mifano kwenye kanuni kulitoa mchango mdogo wa ziada ukilinganishwa na kutumia kanuni pekee.
Majibu yasiyo sahihi yaliyochochewa pia si ya nasibu kabisa. Modeli tatu huru, katika vipengee vya pamoja ambavyo zilivijibu kwa usahihi katika baseline lakini zikavijibu vibaya chini ya suppression, zilielekea kwenye chaguo lilelile lisilo sahihi katika Grade 4 kwa kiwango cha %39 na katika Grade 5, kulingana na maandishi ya chanzo, %35; kwa kuwa lebo ya upau ya Grade 5 Figure 10 inaonyesha 0.34, matokeo haya yanapaswa kusomwa kama takriban %34–35. Viwango vya shuffle-null kwa muunganiko wa modeli zote tatu ni takriban %21 na %11, mtawalia. Hata hivyo, muunganiko huu hauonyeshi kwamba kuna utaratibu uleule wa kiutambuzi kama wa wanafunzi halisi wala hauuthibitishi misconception halisi; ukweli kwamba maswali ya chaguo nne yameundwa kwa makusudi kuwa na distractor zinazoweza kuonekana kuwa na mantiki unaweza pia kuathiri mwelekeo wa kuchagua jibu lilelile lisilo sahihi.
Hiki ndicho kikomo muhimu zaidi cha tafsiri: utafiti haupimi maarifa ya wanafunzi halisi, mchakato wao wa kufikiri, wala ufanisi wa mafunzo ya ualimu. Majaribio yanahusu majibu ya LLM ya mzunguko mmoja yenye chaguo nne. Binary target profile si mastery state halisi ya kiakili ya mwanafunzi wa binadamu; ni hali ya utendaji wa majibu iliyopangiwa modeli pekee. Kwa hiyo, utafiti hauungi mkono hitimisho kwamba “LLM hizi zinaiga wanafunzi halisi kwa usahihi”, bali unaunga mkono hitimisho kwamba “inawezekana kupima kiwango ambacho wasifu fulani wa ujuzi katika kiwango cha majibu unaweza kuundwa kwa uteuzi”.
Uigaji wa Mwanafunzi Unaoweza Kudhibitiwa ni Nini?
Uigaji wa mwanafunzi unaoweza kudhibitiwa ni tatizo la benchmark linalolenga kufanya LLM ionyeshe tabia ya majibu kulingana na ujuzi wa mtaala wa retained na suppressed uliobainishwa mapema na kupima kwa kiasi kiwango ambacho tabia hiyo inalingana na wasifu lengwa; utafiti huu haujaribu utambuzi mzima wa mwanafunzi, bali sifa ya answer-level skill-profile control pekee.
Kwa nini haitoshi kutengeneza “mwanafunzi anayekosea”?
Kwa mwalimu mtarajiwa, thamani ya kielimu ya simulator inayokosea kwa nasibu ni ndogo. Katika mazingira halisi ya ufundishaji, jambo muhimu si tu mwanafunzi kutoa jibu lisilo sahihi, bali kuonyesha muundo wa utendaji ulio na nguvu katika maeneo fulani, udhaifu katika maeneo fulani, na uthabiti wa kiasi.
Mnyororo wa dhana ambao chanzo kinaweka katika muktadha wa mafunzo ya ualimu ni huu:
maandalizi ya walimu → wanafunzi walioigwa → wasifu wa ujuzi unaodhibitiwa → mazoezi yenye kusudi yanayoweza kurudiwa → utambuzi bora → ufundishaji unaoitikia zaidi
Hata hivyo, utafiti unapima kiungo cha “mwanafunzi aliyeigwa → wasifu wa ujuzi unaodhibitiwa” pekee katika mnyororo huu. Jaribio hili halikupima kama mazoezi ya kurudiwa kweli huboresha uwezo wa mwalimu wa kutambua hali ya mwanafunzi au kama jambo hilo hubadilika kuwa ufundishaji bora zaidi.
Kwa nini controllability na utendaji wa juu si kitu kilekile?
Katika benchmark za kawaida za LLM, modeli kujibu maswali mengi zaidi kwa usahihi kwa kawaida humaanisha utendaji bora. Katika utafiti huu lengo ni tofauti. Ikiwa wasifu lengwa unataka ujuzi mmoja uwe retained na mwingine uwe suppressed, modeli kujibu kila swali kwa usahihi inaweza kuhesabiwa kama kushindwa; kwa sababu modeli haitakuwa imetekeleza wasifu wa utendaji wa sehemu uliokusudiwa.
Kwa hiyo:
- Capability: Modeli inaweza kutatua hisabati vizuri kwa kiwango gani?
- Controllability: Modeli inaweza kufuata kwa uteuzi kwa kiwango gani wasifu wa retained/suppressed iliopewa?
ni mihimili miwili tofauti ya tathmini.
Matokeo ya utafiti katika modeli tatu pia yanaunga mkono utengano huu: utendaji wa juu wa baseline katika hisabati haukuenda moja kwa moja sambamba na selective suppression yenye nguvu zaidi.
Vekta ya Wasifu wa Ujuzi Ina Maana Gani?
Vekta ya wasifu wa ujuzi ni vekta lengwa ya jozi inayoweka thamani 1 kama “retained” na thamani 0 kama “suppressed” kwa kila ujuzi wa mtaala; vekta hii si kipimo cha utambuzi wa binadamu, bali ni hali ya majaribio ya utendaji ambayo LLM inatakiwa kuitekeleza katika tabia yake ya majibu.
Ufafanuzi rasmi
Familia za ujuzi wa mtaala kwa kiwango fulani cha darasa zinafafanuliwa kama:
\[ \mathcal{S}=\{s_1,\ldots,s_K\} \]
.
Wasifu lengwa ni:
\[ \mathbf{k}=(k_1,\ldots,k_K)\in\{0,1\}^{K} \]
.
- \(k_i=1\): ujuzi \(s_i\) umewekwa kuwa retained.
- \(k_i=0\): ujuzi \(s_i\) umewekwa kuwa suppressed.
\(K\) ni idadi ya familia za ujuzi zilizojumuishwa katika tathmini na haina kitengo cha kimwili.
Kwa mfano:
\[ \mathbf{k}=(1,0,0,1) \]
katika hali yenye ujuzi minne, wasifu huu unasema kwamba ujuzi wa kwanza na wa nne unapaswa kuhifadhiwa, huku ujuzi wa pili na wa tatu ukikandamizwa.
Chanzo kinasisitiza hasa utengano huu: vekta hii si “mambo ambayo mwanafunzi anajua na hajui kwa kweli”. Hii ni assigned curricular performance condition iliyopewa modeli.
Seti za retained na suppressed
Seti ya faharasa za ujuzi retained ni:
\[ R=\{i:k_i=1\} \]
na seti ya faharasa za ujuzi suppressed ni:
\[ F=\{i:k_i=0\} \]
.
Baseline accuracy kwa ujuzi mmoja ni:
\[ a_i^{0}=A_{\mathrm{base}}(s_i) \]
na accuracy inayozingatiwa chini ya wasifu lengwa ni:
\[ a_i^{*}=A_{\mathrm{ctrl}}(s_i\mid\mathbf{k}) \]
.
\(a_i^{0}\) ni kiwango cha mafanikio cha modeli katika hali ya perfect-student, yaani wakati ujuzi wote ni retained. \(a_i^{*}\) ni mafanikio yanayozingatiwa katika ujuzi huohuo chini ya target profile fulani.
Wastani wa utendaji wa retained na suppressed
Chanzo kinatumia wastani mbili za msingi:
\[ a_R(\mathbf{k}) = \frac{1}{|R|} \sum_{i\in R}a_i^{*} \]
\[ a_F(\mathbf{k}) = \frac{1}{|F|} \sum_{i\in F}a_i^{*} \]
\(a_R\) inaonyesha wastani wa usahihi katika ujuzi uliowekwa kuwa retained; \(a_F\) inaonyesha wastani wa usahihi unaobaki katika ujuzi uliowekwa kuwa suppressed.
Katika mantiki bora ya udhibiti wa uteuzi, \(a_R\) inatarajiwa kuwa juu na \(a_F\) kuwa chini. Hata hivyo, chanzo hakifanyi dhana ya “suppressed = utendaji sifuri”; matokeo halisi yanaonyesha kwamba suppression ni ya viwango.
Jukumu la seti ya data ya MathCAMPS
Utafiti unatumia seti ya data ya MathCAMPS, ambayo ina maswali ya hisabati yaliyowekewa lebo kulingana na viwango vya U.S. Common Core. Benchmark iliundwa kwa Grade 1–8, na kila grade-specific dataset ina maswali 99 ya chaguo nyingi.
Maswali yana chaguo nne. Distractor zimepangwa kuwa majibu yasiyo sahihi yaliyo karibu kwa thamani ya nambari na jibu sahihi au yanayoonekana kuwa na mantiki kimawazo kwa kuzingatia ujuzi lengwa.
Majaribio makuu ya kina ya controllability hayakufanywa katika madarasa yote manane, bali katika Grade 4 na Grade 5 pekee.
Ujuzi uliotumika katika Grade 4
- S4.1: Measurement and Data
- S4.2: Number and Operations — Base
- S4.3: Number and Operations — Fractions
- S4.4: Operations and Algebraic
Kwa kuwa kuna ujuzi minne, idadi ya wasifu wote wa jozi ni:
\[ 2^4=16 \]
.
Ujuzi uliotumika katika Grade 5
- S5.1: Number and Operations — Base
- S5.2: Number and Operations — Fractions
- S5.3: Operations and Algebraic
Kwa ujuzi mitatu:
\[ 2^3=8 \]
kuna wasifu lengwa tofauti.
Kwa hivyo, uchanganuzi wa kina kwa jumla unajumuisha:
\[ 16+8=24 \]
wasifu tofauti wa retained/suppressed.
Maswali yaliyobadilishwa katika uchakataji wa awali wa data
Vipengee ambavyo modeli zote au nyingi zilijibu vibaya katika hali ya perfect-student viliwekwa alama ndani ya udhibiti wa ubora uliobainishwa mapema kwa sababu vinaweza kuwa maswali yenye tatizo bila kujali tabia lengwa ya “kusahau”.
Mwishoni mwa mchakato huu:
- katika Grade 4 vipengee 7,
- katika Grade 5 vipengee 12
vilibadilishwa na vipengee mbadala kutoka kiwango kilekile cha Common Core.
Jambo hili ni muhimu kimetodolojia kwa sababu matumizi ya matokeo ya modeli katika item curation yanaweza kukabiliwa na ukosoaji wa outcome-aware curation. Waandishi walijaribu kando kama jambo hili liliathiri matokeo na wakaripoti kwamba, baada ya kuondoa vipengee vyote vilivyobadilishwa, mpangilio wa modeli uliendelea kuwa uleule na mabadiliko makubwa zaidi katika thamani yoyote ya selectivity yalikuwa 0.04.
Usahihi katika kiwango cha ujuzi
Kiasi cha msingi kinachozingatiwa ni:
\[ Acc(s_i)=\frac{c_i}{n_i} \]
.
- \(c_i\): ni idadi ya majibu sahihi katika maswali yaliyowekewa lebo ya ujuzi \(s_i\).
- \(n_i\): ni jumla ya vipengee vilivyotathminiwa kwa ujuzi huohuo.
- \(Acc(s_i)\): ni uwiano wa usahihi usio na kipimo kati ya 0 na 1.
Thamani hii ndiyo ingizo la msingi kwa vipimo vingine katika kiwango cha wasifu.
Relative Loss inapima nini?
Chanzo kinafafanua relative loss kama:
\[ L_i= \max\left( 0, \frac{a_i^{0}-a_i^{*}} {\max(a_i^{0},\varepsilon)} \right) \]
.
\(\varepsilon>0\) ni thabiti ndogo inayozuia denominator kuwa sifuri.
Kipimo hiki hupima upotevu wa utendaji kwa uwiano ikilinganishwa na baseline.
- Kwa ujuzi suppressed, \(L_i\) ya juu ina maana ya suppression yenye nguvu zaidi.
- Kwa ujuzi retained, \(L_i\) inatarajiwa kuwa karibu na sifuri; kwa sababu hii inaonyesha kwamba utendaji uliopaswa kuhifadhiwa haujapotea.
RMSE inapimaje ulinganifu na wasifu lengwa?
Katika chanzo:
\[ RMSE(\mathbf{k}) = \sqrt{ \frac{1}{K} \sum_{i=1}^{K} (k_i-a_i^{*})^2 } \]
imefafanuliwa hivyo.
RMSE ni mzizi wa wastani wa mkengeuko wa mraba kati ya binary target vector na continuous skill-accuracy profile inayozingatiwa.
Kwa mfano, katika ujuzi retained, ikiwa \(k_i=1\) na usahihi unaozingatiwa uko karibu na 1, kosa ni dogo. Katika ujuzi suppressed, ikiwa \(k_i=0\), kosa pia hupungua kadiri usahihi unavyokaribia 0.
Kwa hiyo, RMSE ya chini zaidi ina maana ya ulinganifu bora zaidi wa wasifu lengwa.
Hata hivyo, kwa sababu RMSE inabana uhifadhi wa utendaji wa retained na upunguzaji wa utendaji wa suppressed kuwa nambari moja, utafiti huitumia hasa katika prompt-strategy ablation; haujengi tafsiri kuu ya controllability kwa RMSE pekee.
Controllability Score C(k) Inapima Nini?
Controllability score \(C(\mathbf{k})\) hupima katika masafa ya 0–1 kiwango ambacho wasifu wa majibu unaozingatiwa unalingana na wasifu lengwa wa jozi, kwa kutuza katika fomula moja usahihi wa juu katika ujuzi uliowekewa alama retained na usahihi wa chini katika ujuzi uliowekewa alama suppressed; \(C=1\) inaonyesha ulinganifu kamili na lengo.
Fomula ya chanzo ni:
\[ C(\mathbf{k}) = \frac{1}{K} \sum_{i=1}^{K} \left[ k_i a_i^{*} + (1-k_i)(1-a_i^{*}) \right] \]
.
Kusoma fomula hatua kwa hatua
Ikiwa \(k_i=1\), yaani ujuzi ni retained:
\[ k_i a_i^{*}=a_i^{*} \]
na sehemu ya pili huwa sifuri. Kwa hiyo usahihi wa juu huongeza alama.
Ikiwa \(k_i=0\), yaani ujuzi ni suppressed:
\[ (1-k_i)(1-a_i^{*})=1-a_i^{*} \]
. Wakati huu usahihi wa chini huongeza alama.
Kwa hiyo, fomula haijibu swali “modeli iko sahihi kwa kiwango gani?”, bali swali “modeli imefuata kwa kiwango gani tabia ya retained/suppressed iliyotakiwa?”.
Kwa nini cross-skill influence inahitajika?
Kukandamiza ujuzi mmoja kunaweza kuonekana rahisi; lakini ikiwa ujuzi mwingine ambao unapaswa kuhifadhiwa pia unaathirika katika mchakato huo, udhibiti huo si wa uteuzi kwa kweli.
Chanzo kinachunguza hali hii kwa matriksi ya cross-skill influence \(\Delta_{ij}\).
Athari ya moja kwa moja ya suppression:
\[ \Delta_{ii} = \frac{1}{|\mathcal{K}_i|} \sum_{\mathbf{k}\in\mathcal{K}_i} A_{\mathrm{ctrl}}(s_i\mid\mathbf{k}) - A_{\mathrm{base}}(s_i) \]
hutathminiwa kwa njia hii.
Hapa:
\[ \mathcal{K}_i=\{\mathbf{k}:k_i=0\} \]
ni seti ya wasifu ambapo \(s_i\) ni suppressed.
Collateral influence katika ujuzi mwingine retained \(s_j\) ni:
\[ \Delta_{ij} = \frac{1}{|\mathcal{K}_{ij}|} \sum_{\mathbf{k}\in\mathcal{K}_{ij}} A_{\mathrm{ctrl}}(s_j\mid\mathbf{k}) - A_{\mathrm{base}}(s_j), \qquad i\neq j \]
na:
\[ \mathcal{K}_{ij} = \{\mathbf{k}:k_i=0,\;k_j=1\} \]
.
Jambo muhimu ni kwamba athari ya off-diagonal huhesabiwa tu katika wasifu ambapo \(s_i\) ni suppressed huku \(s_j\) ikiwa retained. Kwa njia hii, wasifu ambapo \(s_j\) pia imekandamizwa kwa makusudi hauchanganywi katika hesabu ya collateral-damage.
Katika chanzo, wakati athari ya suppression ya moja kwa moja katika kiwango cha modeli/hali ni kubwa na hasi, mabadiliko ya off-diagonal katika ujuzi retained ni madogo. Katika uchanganuzi wa robustness, thamani ya mean diagonal iliripotiwa kuwa takriban −0.47 na mean off-diagonal magnitude kuwa 0.03, na tofauti ilipatikana kwa jaribio la Mann–Whitney \(U\) katika kiwango cha \(p<10^{-10}\).
Prediction Score ni nini?
Kipimo cha pili cha calibration ni:
\[ PS(\mathbf{k}) = a_R^{actual}(\mathbf{k}) - a_R^{expected}(\mathbf{k}) \]
.
Thamani ikiwa:
- karibu na 0, observed retention inalingana na calibration expectation;
- chanya, utendaji retained ni bora kuliko ulivyotarajiwa;
- hasi, utendaji retained uko chini ya uliotarajiwa.
Utafiti hautumii Prediction Score kama kipimo kikuu cha matokeo, bali kama diagnostic ya ziada iliyo nyeti kwa correlation structure.
Fomula ya Gaussian calibration
Katika Appendix A, kwa vekta ya utendaji wa ujuzi:
\[ \mathbf{a}\sim\mathcal{N}(\boldsymbol{\mu},\boldsymbol{\Sigma}) \]
hutumiwa Gaussian approximation.
Ikiwa seti suppressed ni \(F\) na seti retained ni \(R\), conditional expectation ya utendaji retained chini ya forgetting inayolengwa huandikwa kama:
\[ E[\mathbf{a}_R\mid\mathbf{a}_F=0] = \boldsymbol{\mu}_R - \boldsymbol{\Sigma}_{RF} \boldsymbol{\Sigma}_{FF}^{-1} \boldsymbol{\mu}_F \]
.
Hapa:
- \(\boldsymbol{\mu}_R\): wastani wa retained skill performance,
- \(\boldsymbol{\mu}_F\): wastani wa suppressed skill performance,
- \(\boldsymbol{\Sigma}_{RF}\): cross-covariance block kati ya ujuzi retained na suppressed,
- \(\boldsymbol{\Sigma}_{FF}\): covariance block kati ya ujuzi suppressed.
Ikiwa cross-skill coupling ni dhaifu sana:
\[ \boldsymbol{\Sigma}_{RF}\approx0 \]
na kwa hiyo:
\[ E[\mathbf{a}_R\mid\mathbf{a}_F=0] \approx \boldsymbol{\mu}_R \]
.
Chanzo kinasisitiza hasa kwamba hii si modeli zalishi ya utambuzi wa mwanafunzi halisi. Mbinu hii ya Gaussian ni mbinu ya uchanganuzi inayotumika tu kwa calibration ya expected-versus-observed retention.
Mbinu na Matokeo ya Utafiti
Jaribio ni la kikokotozi kabisa
Hakuna mwanafunzi, mwalimu, wala mshiriki mwingine wa kibinadamu aliyejumuishwa katika utafiti. Uchunguzi wote ni tathmini za majibu ya chaguo moja yaliyotolewa na modeli za lugha.
Endpoint za modeli zilizotathminiwa
| Modeli | Identifier iliyotolewa katika chanzo | Jukumu katika utafiti |
|---|---|---|
| Claude | claude-sonnet-4-5-20250929 | Sehemu ya kulinganisha yenye high-compliance kutokana na uwezo mkubwa wa instruction-following |
| DeepSeek | DeepSeek-chat | Ulinganisho unaochunguza kama utendaji mkubwa wa hisabati ni kitu kilekile na controllability |
| GPT-4o | gpt-4o | Ulinganisho wa LLM ya matumizi ya jumla inayotumika sana |
Katika inference zote:
\[ temperature=0 \]
ilitumika.
Kwa hiyo, stochastic sampling variability ilipunguzwa kimakusudi ndani ya jaribio lilelile. Tofauti ya wasifu katika Appendix A pia inawakilisha tofauti kati ya hali tofauti za student-profile, si sampling noise kati ya marudio.
Chanzo pia kinaeleza kwamba alias za DeepSeek-chat na gpt-4o si date-pinned na zinaweza kubadilishwa na provider kadiri muda unavyopita. Kwa hiyo haifai kujumlisha matokeo kwa matoleo yote ya familia za modeli.
Mikakati mitatu ya prompt
| Mkakati | Maudhui | Matokeo ya chanzo |
|---|---|---|
| Rule-based | Kanuni zinazosema wazi tabia ya kujibu kwa usahihi katika ujuzi retained na tabia ya makosa yenye uthabiti katika ujuzi suppressed | Alignment error ya chini; sawa na combined |
| Example-only / few-shot | Mifano inayoonyesha tabia sahihi na isiyo sahihi; ilitenganishwa na data ya tathmini | RMSE ya juu zaidi, 0.40–0.61 |
| Combined | Kanuni za wazi + mifano | Mojawapo ya mikakati yenye rule-bearing katika masafa ya RMSE 0.19–0.39 |
Kwa Claude, rule-based RMSE iliripotiwa kuwa chini kidogo kuliko combined:
- Grade 4: rule-based 0.19, combined 0.24;
- Grade 5: rule-based 0.20, combined 0.22.
Kwa hiyo hitimisho kwamba “combined daima ndiyo prompt bora zaidi” haliungwi mkono. Tafsiri sahihi zaidi ya chanzo ni kwamba maelekezo ya wazi ya hali ya ujuzi ni muhimu zaidi kuliko mifano ya few-shot.
Mtiririko mkuu wa jaribio
- Kila modeli ilijaribiwa katika hali ya perfect-student, yaani ujuzi wote ukiwa retained.
- Binary skill vector iliwekwa ndani ya prompt ili kufafanua wasifu lengwa wa retained na suppressed.
- Wasifu huohuo ulitathminiwa chini ya prompting ya rule-based, example-only na combined.
- Majibu yalibadilishwa kuwa vipimo vya profile-level na skill-level.
Kwa Grade 4, wasifu 16 na kwa Grade 5, wasifu 8 ulitathminiwa kwa exhaustive.
Katika ulinganisho mkuu wa combined prompt, modeli tatu pamoja na maswali 99 katika kila grade zilizalisha:
\[ (16\times99+8\times99)\times3=7128 \]
model–question response event.
Thamani hii ya 7128 ni kwa core combined-prompt comparison pekee; utafiti mzima ni mkubwa zaidi wakati perfect-student baseline na majaribio ya prompt ablation yanajumuishwa.
Kitengo cha inference ya takwimu ni nini?
Chanzo hutumia vipengee 99 vilivyowekwa kwa kila grade chini ya deterministic decoding kama kitengo cha inference.
Kwa kuwa hali za perfect na all-forgotten zilioanishwa katika kipengee kilekile, exact McNemar test ilitumika kwa mabadiliko ya retained-versus-forgotten.
Jaribio la McNemar hulinganisha matokeo ya binary ya kitengo kilekile katika hali mbili. Mantiki kuu hapa, badala ya kuuliza “ni maswali mangapi yalibaki sawa katika hali zote mbili?”, hupima hasa uwiano wa idadi ya discordant pair ambapo:
- jibu lilikuwa sahihi katika baseline lakini lisilo sahihi chini ya suppression,
- jibu lilikuwa lisilo sahihi katika baseline lakini sahihi chini ya suppression
.
Chanzo kinaripoti kwa tofauti za perfect vs all-forgotten katika mchanganyiko wote wa modeli na grade:
\[ p<10^{-5} \]
na kwa Cohen's \(h\):
\[ 0.76\leq h\leq1.62 \]
.
Modeli ya logistic GEE
Uchanganuzi wa Population-averaged:
\[ correct \sim target\_state \times model + grade \]
ulifanywa kwa modeli ya logistic generalized estimating equations (GEE) ya umbo hilo.
Katika modeli:
- vipengee 198 vilitumika kama cluster katika grade mbili,
- binomial family ilitumika,
- working correlation ilichaguliwa kuwa exchangeable,
- robust sandwich standard errors zilitumika.
Kwa reference model Claude, odds ya kutoa jibu sahihi katika ujuzi retained ilikadiriwa kuwa takriban mara 40 ya odds katika ujuzi forgotten; confidence interval yote ilikuwa juu sana ya 1 na \(p<10^{-30}\) iliripotiwa.
Hii haimaanishi kwamba “Claude ina kiwango cha usahihi mara 40 zaidi katika retained skill”. Odds ratio si probability ratio ya moja kwa moja. Hapa chanzo kinaripoti mabadiliko katika odds ya jibu sahihi.
Umuhimu wa target-state × model interaction unaunga mkono kwamba utengano wa retained–forgotten hutofautiana kati ya modeli.
Tofauti kati ya modeli
Kwa forgotten-skill accuracy, jaribio la Friedman katika grade-by-skill block saba lilitoa:
\[ \chi^2=11.1,\qquad p=0.004 \]
.
Majibio ya pairwise Wilcoxon yaliyosahihishwa kwa Holm yalitenganisha:
- Claude–DeepSeek,
- DeepSeek–GPT-4o
kwa adjusted \(p<0.05\).
Chanzo hakihitimishi kwamba ulinganisho wa tatu wa jozi ambao haukuripotiwa pia ni muhimu kiotomatiki.
Tofauti ya takwimu kati ya mikakati ya prompt
Jaribio la Friedman RMSE katika model-by-grade block sita lilitoa:
\[ \chi^2=9.3,\qquad p=0.009 \]
.
Hata hivyo, kwa sababu kuna block sita tu, resolution ya exact pairwise signed-rank tests ni ndogo. Kwa sababu hiyo waandishi wanaegemeza tafsiri ya prompt-strategy zaidi kwenye omnibus test na masafa ya wazi ya RMSE kuliko kwenye pairwise p values.
Selectivity index
Chanzo hutumia selectivity index kama tofauti kati ya retained accuracy na forgotten accuracy.
Kwa 4000 item-level bootstrap resampling, %95 percentile interval zilizohesabiwa zilibaki juu ya sifuri katika mchanganyiko wote wa modeli–grade, na index iliripotiwa kuwa takriban:
\[ 0.35\text{–}0.70 \]
.
Compliance rate, yaani kiwango cha kutoa jibu lisilo sahihi katika ujuzi suppressed kama ilivyoagizwa, kilikuwa:
\[ 0.56\text{–}0.82 \]
.
Utendaji wa retained na suppressed ulitengana kwa kiwango gani dhidi ya baseline?
| Modeli | Grade | Retained / baseline | Suppressed / baseline |
|---|---|---|---|
| Claude | 4 | %101.2 | %34.1 |
| Claude | 5 | %97.4 | %33.4 |
| DeepSeek | 4 | %98.8 | %59.9 |
| DeepSeek | 5 | %98.3 | %51.9 |
| GPT-4o | 4 | %94.1 | %29.7 |
| GPT-4o | 5 | %100.0 | %50.5 |
Jedwali hili linaonyesha utengano muhimu. Haitoshi kuangalia tu suppressed accuracy ikiwa chini zaidi. Kwa mfano, GPT-4o inaweza kutoa suppression yenye nguvu katika baadhi ya hali huku pia ikionyesha upotevu zaidi katika ujuzi retained. Controllability nzuri inaeleweka kwa kutathmini suppression + retention pamoja.
Suppression hutofautiana kwa familia ya ujuzi
| Grade | Modeli | S1 | S2 | S3 | S4 |
|---|---|---|---|---|---|
| 4 | Claude | 0.43 | 0.39 | 0.10 | 0.34 |
| 4 | DeepSeek | 0.50 | 0.48 | 0.54 | 0.63 |
| 4 | GPT-4o | 0.19 | 0.21 | 0.28 | 0.14 |
| 5 | Claude | 0.23 | 0.24 | 0.52 | — |
| 5 | DeepSeek | 0.56 | 0.30 | 0.56 | — |
| 5 | GPT-4o | 0.30 | 0.18 | 0.33 | — |
Matokeo haya yanaonyesha kwamba controllability si sifa moja ya jumla ya “utii”; inategemea mwingiliano kati ya modeli na curricular skill family.
Mfano mmoja wa wasifu unaonyeshaje udhibiti wa uteuzi?
Kwa Claude Grade 4, chanzo kinatoa:
\[ [1,0,0,1] \]
Katika wasifu huo, lengo ni kuweka S4.1 na S4.4 kuwa retained, na S4.2 na S4.3 kuwa suppressed.
| Ujuzi | Hali lengwa | Accuracy inayozingatiwa |
|---|---|---|
| S4.1 | Retained | 0.92 |
| S4.2 | Suppressed | 0.32 |
| S4.3 | Suppressed | 0.12 |
| S4.4 | Retained | 0.96 |
Maana ya kisayansi ya mfano huu si kwamba modeli inakuwa mbaya kwa ujumla. Ndani ya wasifu huohuo, ujuzi mbili retained hubaki juu huku utendaji ukishuka kwa kasi katika ujuzi mbili targeted.
Suppression ni ya viwango, si kamili
Wakati modeli, grade na wasifu wote vinazingatiwa pamoja, wastani wa forgotten-skill accuracy uliripotiwa kuwa:
\[ 0.35 \]
.
%95 ya mifano ya forgotten-skill iko katika masafa ya:
\[ 0.1\text{–}0.9 \]
.
Kwa hiyo kauli kwamba “ujuzi uliosahaulishwa umetoweka kabisa” si sahihi. Katika utafiti, suppression huzalisha partial and graded performance.
Mtazamo wa signal-detection
Chanzo pia kinachunguza instruction-following kwa mlinganisho wa signal-detection:
- Hit rate: uwiano wa vipengee vilivyojibiwa vibaya katika ujuzi suppressed kama maelekezo yalivyotaka.
- False-alarm rate: uwiano wa vipengee vilivyojibiwa vibaya katika ujuzi retained.
Simulator bora ya mwanafunzi anayedhibitiwa inapaswa kutoa hit rate ya juu lakini false-alarm rate ya chini.
Kwa Claude, sensitivity index \(d'\) iliripotiwa kuwa takriban 2.1, na ilielezwa kwamba Claude ilionyesha utengano ulio wazi zaidi kati ya modeli tatu zilizotathminiwa.
Je, Ukandamizaji wa Ujuzi kwa Uteuzi Unathibitisha Dhana Potofu ya Mwanafunzi Halisi?
Hapana. Ukweli kwamba modeli zinaelekea kwenye chaguo lilelile lisilo sahihi mara nyingi zaidi kuliko ilivyotarajiwa unaunga mkono kwamba makosa si ya nasibu, lakini hauthibitishi kwamba utaratibu uleule wa kiutambuzi kama wa wanafunzi halisi au misconception halisi umezalishwa; utafiti unasema wazi kwamba kwa hili kunahitajika uthibitishaji kupitia tathmini ya walimu na usambazaji wa majibu ya wanafunzi halisi.
Muunganiko wa majibu yasiyo sahihi
Uchanganuzi uliwekewa kikomo kwenye vipengee ambavyo modeli zote ziliweza kujibu kwa usahihi katika hali ya perfect-student. Kwa njia hii, ilijaribiwa kuzuia kosa linalojitokeza baada ya suppression lisitokane na swali ambalo tayari halikuweza kutatuliwa katika baseline.
| Ulinganisho | Grade 4 observed | Grade 5 observed | Shuffle-null |
|---|---|---|---|
| Modeli tatu zatoa jibu lilelile lisilo sahihi | %39 | Maandishi: %35; lebo ya Figure 10: %34 | Takriban %21 / %11 |
| Pairwise agreement | %56–%59 | Takriban %31–%40 | |
Kwa ulinganisho huu wote:
\[ p<0.001 \]
iliripotiwa.
Permutation null huhifadhi marudio ya herufi ya jibu lisilo sahihi ya kila modeli yenyewe. Kwa njia hii, kwa mfano, modeli fulani kuchagua kwa ujumla chaguo “A” kwa wingi hakujaribiwi kutafsiriwa kama muunganiko wa uongo kati ya modeli.
Thamani ya permutation p katika chanzo ilihesabiwa kama:
\[ p= \frac{ 1+\#\{\mathrm{null}\geq\mathrm{observed}\} }{ 1+5000 } \]
.
Permutation 5000 zilitumika.
Majibu 28 ya pamoja yasiyo sahihi yaligawanywa katika makundi gani?
| Kategoria ya kosa | Idadi | Maana ya mfano wa chanzo |
|---|---|---|
| Magnitude / fraction-comparison misconception | 7 | Muundo wa jibu unaotafsiri kinyume uhusiano wa ukubwa wa sehemu |
| Fraction whole-unit / conversion error | 3 | Kwa 78/65 + 78/65, jibu sahihi ni 2.4 lakini 1.4 lilichaguliwa |
| Computation slip / carrying error | 11 | Kwa 47 × 9, jibu sahihi ni 423 lakini 422 lilichaguliwa |
| Wrong operation | 1 | Jibu linaloelekea kwenye kujumlisha badala ya kutoa katika 48 − 12 |
| Degenerate option selection | 4 | Waandishi hawakuainisha hii kama misconception |
| Notation artifact | 2 | Hali inayotokana na miandiko sawa ya thamani ileile |
Vipengee 22/28, yaani:
\[ \frac{22}{28}\approx79\% \]
vilipatikana katika uainishaji wa exploratory wa mwandishi kuwa vinaendana na aina za makosa zilizoandikwa katika fasihi ya elimu ya hisabati.
Hata hivyo, %79 hii:
- si %79 ya induced error zote;
- inahusu tu subset ya vipengee 28 ambapo modeli tatu ziliungana kwenye kosa lilelile;
- iliainishwa na mwandishi/coder mmoja;
- inter-rater reliability haikuhesabiwa.
Kwa hiyo haifai kuwasilisha matokeo haya kama ushahidi wa misconception fidelity ya mwanafunzi halisi.
Robustness: vipengee vinavyoweza kutatuliwa katika baseline pekee
Katika uchanganuzi mkali zaidi, vipengee ambavyo modeli iliweza kutatua kwa usahihi katika hali ya perfect-student vilichukuliwa.
| Modeli | Kubaki sahihi ikiwa Retained | Kubadilishwa kuwa kosa ikiwa Suppressed | Controllability score |
|---|---|---|---|
| Claude | 0.98 | 0.68 | 0.82 |
| DeepSeek | 0.97 | 0.47 | 0.69 |
| GPT-4o | 0.93 | 0.80 | 0.69 |
Matokeo haya yanafundisha sana: ingawa GPT-4o ina kiwango cha juu cha “kubadilishwa kuwa kosa” kwa upande wa suppression, haifikii kiwango kilekile cha Claude katika controllability score ya jumla kwa sababu huzalisha makosa mengi zaidi ya collateral katika vipengee retained kuliko Claude na DeepSeek.
Nini kilitokea wakati maswali yaliyobadilishwa yaliondolewa?
| Modeli | Retained — Full | Retained — Excl. | Forgotten — Full | Forgotten — Excl. | Selectivity — Full | Selectivity — Excl. |
|---|---|---|---|---|---|---|
| Claude | 0.948 | 0.946 | 0.318 | 0.317 | 0.630 | 0.628 |
| DeepSeek | 0.888 | 0.877 | 0.521 | 0.528 | 0.367 | 0.349 |
| GPT-4o | 0.618 | 0.589 | 0.223 | 0.232 | 0.396 | 0.357 |
Mabadiliko makubwa zaidi ya selectivity ni 0.04. Kwa hiyo chanzo kinahitimisha kwamba vipengee 19 vilivyobadilishwa havielezi mpangilio mkuu wa modeli.
Answer-position imbalance
Nafasi za majibu sahihi kati ya chaguo nne hazikusambazwa kwa uniform na chaguo A liliwakilishwa kupita kiasi:
\[ p<10^{-6} \]
iliripotiwa kwa grade zote mbili.
Hata hivyo, kwa kuwa error-convergence permutation null huhifadhi usambazaji wa answer-letter frequency wa kila modeli yenyewe, chanzo kinaeleza kwamba positional imbalance hii peke yake haielezi muunganiko wa majibu yasiyo sahihi kati ya modeli.
Hitimisho zinazoungwa mkono na utafiti
- Kwa kutumia binary retained/suppressed skill profile, tabia ya LLM katika kiwango cha answer-level iliweza kuelekezwa kwa namna inayopimika.
- Prompt zenye skill-state rule iliyo wazi zilizalisha kosa la chini la profile-alignment kuliko example-only prompting.
- Rule-based na combined prompting zilitoa alignment zinazokaribiana katika hali zilizotathminiwa.
- Selective suppression iliweza kupimwa katika modeli zote tatu, lakini nguvu yake inategemea modeli na familia ya ujuzi.
- Kwa ujumla, ujuzi retained ulihifadhiwa kwa wazi zaidi kuliko ujuzi suppressed.
- Cross-skill collateral change ni ndogo ikilinganishwa na athari ya moja kwa moja ya suppression.
- Uwezo wa juu zaidi wa baseline katika hisabati haukumaanisha kiotomatiki controllability yenye nguvu zaidi kati ya modeli tatu zilizotathminiwa.
- Induced wrong answers zinaonekana kuwa na muundo zaidi kuliko modeli rahisi ya uchaguzi huru wa nasibu.
- Muunganiko wa modeli tatu kwenye chaguo lilelile lisilo sahihi ulitokea juu ya marginal answer-letter bias.
- Kuondolewa kwa vipengee vya benchmark vilivyobadilishwa hakukubadilisha mpangilio mkuu wa modeli.
Hitimisho ambazo utafiti hauungi mkono
- Haijathibitishwa kwamba LLM zinaiga kwa usahihi hali ya kiutambuzi ya wanafunzi halisi.
- Binary skill vector si mastery state halisi ya binadamu.
- Induced wrong answer haijathibitishwa kuwa misconception ya mwanafunzi halisi.
- Modeli tatu kuelekea kwenye kosa lilelile si ushahidi wa utaratibu wa pamoja wa kiutambuzi.
- Haijajaribiwa kama uzalishaji wa wasifu unaoweza kudhibitiwa huboresha uwezo wa walimu wa kutambua hali ya mwanafunzi.
- Haijaonyeshwa kwamba simulator za aina hii huboresha mafunzo ya ualimu au mafanikio ya wanafunzi.
- Matokeo hayajathibitishwa kwa maelezo ya wazi au tutor–student dialog ya mizunguko mingi.
- Ingawa benchmark ya Grade 1–8 iliandaliwa, matokeo ya kina ya controllability hayajaonyeshwa kwa Grade 1–8 zote.
- Ujumlishaji kwa maeneo yasiyo hisabati kama sayansi, lugha na programu haujajaribiwa.
- Matokeo hayawezi kujumlishwa kwa familia zote za modeli za Claude, DeepSeek au GPT; yanahusu endpoint zilizotumika pekee.
- Haiwezi kuhitimishwa kutokana na utafiti huu kama mbinu za fine-tuning au training-time ni bora au mbaya kuliko prompt-based control.
Vikomo vinne vikuu vya uhalali wa utafiti
1. Construct validity
Target profile alignment si sawa na mastery halisi ya binadamu au authentic misconception. Wakati target profile ni binary, suppression inayozingatiwa ni ya viwango.
2. Ecological validity
Data ni jibu la chaguo nyingi la mzunguko mmoja. Hakuna maelezo ya mwanafunzi, tutor dialog, motivation, confusion, engagement wala peer interaction.
3. External validity
Uchanganuzi wa kina unahusu tu ujuzi wa hisabati wa Grade 4 na Grade 5 na endpoint tatu za modeli. Matokeo yanahitaji kuthibitishwa upya kwa madarasa, masomo na familia nyingine za modeli.
4. Benchmark / internal validity
Kila swali limewekewa lebo ya skill family moja; matatizo halisi ya hisabati yanaweza kuhitaji ujuzi zaidi ya mmoja kwa pamoja. Aidha, full \(2^K\) profile enumeration hukua kwa kiwango cha kipeo kadiri idadi ya ujuzi inavyoongezeka.
Uwezo wa kurudia matokeo
Chanzo kinaeleza kwamba vipengee vya benchmark, skill annotation, rule-based/example-only/combined prompt template, item-to-skill mapping, matokeo ya per-item evaluation ya modeli tatu, rekodi za raw prompt/response/parsed-answer na msimbo wa uchanganuzi vimehifadhiwa kwenye kumbukumbu.
Zenodo DOI iliyotolewa katika chanzo kwa kumbukumbu ya data na msimbo ni:
10.5281/zenodo.21853933
.
Uchanganuzi uliendeshwa kwa kutumia Python 3.14, statsmodels 0.14.6, SciPy 1.17.1 na NumPy 1.26.4.
Tafiti za baadaye
Jambo ambalo waandishi wanaona kuwa hatua inayofuata muhimu zaidi ni tathmini ya wataalamu wa kibinadamu. Walimu wenye uzoefu kutathmini uhalisia na manufaa ya kipedagojia ya wanafunzi walioigwa kunaweza kutoa ushahidi wa external validity ambao hauwezi kupatikana kwa objective answer metrics pekee.
Chanzo pia kinapendekeza upanuzi kama:
- ulinganisho na response distributions za wanafunzi halisi,
- blinded multi-rater misconception coding,
- wasifu wa makosa wa kina zaidi kama conceptual misconception, procedural slip, arithmetic error na reasoning shortcut,
- continuous target-performance scale badala ya binary,
- hierarchical skill representations,
- fine-tuning au reinforcement-based control,
- masomo mengine na grade bands,
- interactive tutoring ya mizunguko mingi,
- uthibitishaji halisi wa kielimu wenye mwalimu katika mzunguko
.
Maelezo ya Chanzo na Mbinu
Kichwa asili: Toward Controllable Learner Simulation for Teacher Education: Benchmarking Skill-Profile Control in LLM Answer Behavior
Waandishi, kwa mpangilio wa chanzo: Omri Sasson; Alexander Apartsin; Yehudit Aperstein.
Mahusiano ya taasisi ya waandishi: Omri Sasson na Yehudit Aperstein — Intelligent Systems, Afeka College of Engineering, Tel Aviv, Israel. Alexander Apartsin — School of Computer Science, Faculty of Sciences, Holon Institute of Technology, Holon, Israel.
Mwandishi wa mawasiliano: Yehudit Aperstein.
Mchango sawa: Chanzo hakina tamko la equal-contribution.
Jarida: Education Sciences.
Mchapishaji: MDPI, Basel, Switzerland.
Aina ya uchapishaji: Article; benchmark/experimental evaluation ya kikokotozi kabisa.
Juzuu / toleo / nambari ya makala: 16(10), 1752.
DOI: 10.3390/educsci16101752.
Received: 11 August 2026.
Revised: 4 October 2026.
Accepted: 14 October 2026.
Published: 19 October 2026.
Academic Editor: Samson Nashon.
Hali ya mapitio ya rika: Ni makala ya jarida iliyochapishwa na iliyopitiwa na rika.
Hali ya preprint: Chanzo kilichochunguzwa na rekodi rasmi ya bibliografia hazitoi taarifa kuhusu toleo tofauti la preprint la makala hii.
Leseni: Creative Commons Attribution (CC BY).
Swali kuu la utafiti: Je, LLM inayodhibitiwa kwa prompt inaweza kutekeleza kwa uteuzi student skill profile iliyobainishwa ambayo huhifadhi baadhi ya ujuzi wa mtaala kuwa retained huku ikionyesha mingine kuwa suppressed?
Maswali madogo ya utafiti: Athari ya mkakati wa prompt; tofauti ya controllability kati ya endpoint za modeli zilizotathminiwa; kama suppression inaweza kutekelezwa kwa collateral interference ndogo katika retained skills.
Seti ya data: MathCAMPS; kwa Grade 1–8 ziliandaliwa seti za maswali 99 ya chaguo nyingi. Uchanganuzi wa kina wa controllability umewekewa kikomo kwa Grade 4 na Grade 5.
Footprint kuu ya uchanganuzi: Katika Grade 4, ujuzi 4 na wasifu 16; katika Grade 5, ujuzi 3 na wasifu 8; jumla ya 24 target profile.
Core combined-prompt response count: 7128 model–question event.
Endpoint za modeli: claude-sonnet-4-5-20250929; DeepSeek-chat; gpt-4o.
Decoding: Deterministic, temperature = 0.
Mikakati ya prompt: Rule-based; example-only/few-shot; combined.
Vipimo vikuu: Per-skill accuracy; retained/suppressed mean accuracy; relative loss; RMSE; controllability score \(C(\mathbf{k})\); cross-skill influence \(\Delta_{ij}\); selectivity index; muundo wa signal-detection hit/false-alarm. Prediction score ni calibration metric ya ziada.
Uchanganuzi wa takwimu: Exact McNemar; Cohen's \(h\); logistic GEE; Friedman omnibus; Holm-corrected Wilcoxon signed-rank; 4000-resample percentile bootstrap; 5000-permutation marginal-preserving error-convergence test; uchanganuzi wa robustness wa Mann–Whitney \(U\).
Programu za takwimu: Python 3.14; statsmodels 0.14.6; SciPy 1.17.1; NumPy 1.26.4.
Dokezo la nambari ndani ya chanzo: Maandishi ya Section 7.7 yanatoa thamani ya three-model wrong-answer convergence ya Grade 5 kuwa %35, huku thamani iliyo kwenye Figure 10 ikiwa 0.34. Verianla haikusahihisha tofauti hii kimya kimya na imeweka matokeo husika katika takriban %34–35.
Item quality control: Katika Grade 4 vipengee 7 na katika Grade 5 vipengee 12 vilibadilishwa kutokana na kushindwa kwa modeli mbalimbali katika perfect-student baseline. Katika uchanganuzi wa robustness ambapo vipengee hivi vyote viliondolewa, mpangilio wa modeli ulihifadhiwa na mabadiliko ya selectivity yalikuwa, kwa kiwango cha juu, 0.04.
Ufadhili: Utafiti haukupokea ufadhili wa nje.
Institutional Review Board: Haitumiki; hakuna washiriki binadamu au wanyama katika utafiti, na majibu yote yaliyochanganuliwa yalitolewa na modeli za lugha.
Informed Consent: Haitumiki.
Data Availability: Vipengee vya benchmark, prompt template, matokeo ya per-item ya modeli na msimbo wa uchanganuzi vimehifadhiwa wazi katika Zenodo kwa DOI 10.5281/zenodo.21853933.
Mgongano wa maslahi: Waandishi waliripoti kwamba hakuna mgongano wa maslahi.
Michango ya waandishi
- Conceptualization: Yehudit Aperstein, Alexander Apartsin.
- Methodology: Yehudit Aperstein, Alexander Apartsin.
- Formal analysis: Omri Sasson, Yehudit Aperstein, Alexander Apartsin.
- Data curation: Omri Sasson, Alexander Apartsin.
- Software: Omri Sasson.
- Supervision: Yehudit Aperstein, Alexander Apartsin.
- Project administration: Yehudit Aperstein.
- Writing — original draft preparation: Omri Sasson, Yehudit Aperstein, Alexander Apartsin.
- Writing — review and editing: Yehudit Aperstein, Alexander Apartsin.
Vikomo vikuu vya kimetodolojia: Kutokuwepo kwa uthibitishaji wa wataalamu wa kibinadamu; binary target profile kutokuwa mastery state halisi; tathmini ya answer-level ya mzunguko mmoja yenye chaguo nyingi; kutokuchunguzwa kwa reasoning ya wazi na tutor dialog; uchanganuzi wa kina wa Grade 4–5 pekee; endpoint tatu tu za modeli; prompt-based control pekee; single-skill item annotation; baadhi ya vipengee kupitishwa katika udhibiti wa ubora kwa matokeo ya baseline ya modeli; full \(2^K\) profile enumeration kukua kwa kiwango cha kipeo kadiri idadi ya ujuzi inavyoongezeka.
Kikomo kikuu cha tafsiri ya kisayansi: Utafiti huu hauonyeshi kwamba akili bandia zalishi inaiga wanafunzi halisi kwa njia inayotegemeka kipedagojia au kwamba inaboresha mafunzo ya walimu watarajiwa. Utafiti unatoa benchmark na familia ya vipimo ili kupima kiwango ambacho retained/suppressed skill profile iliyobainishwa inaweza kutekelezwa kwa uteuzi na kwa kiwango cha eneo katika LLM answer behavior.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *