


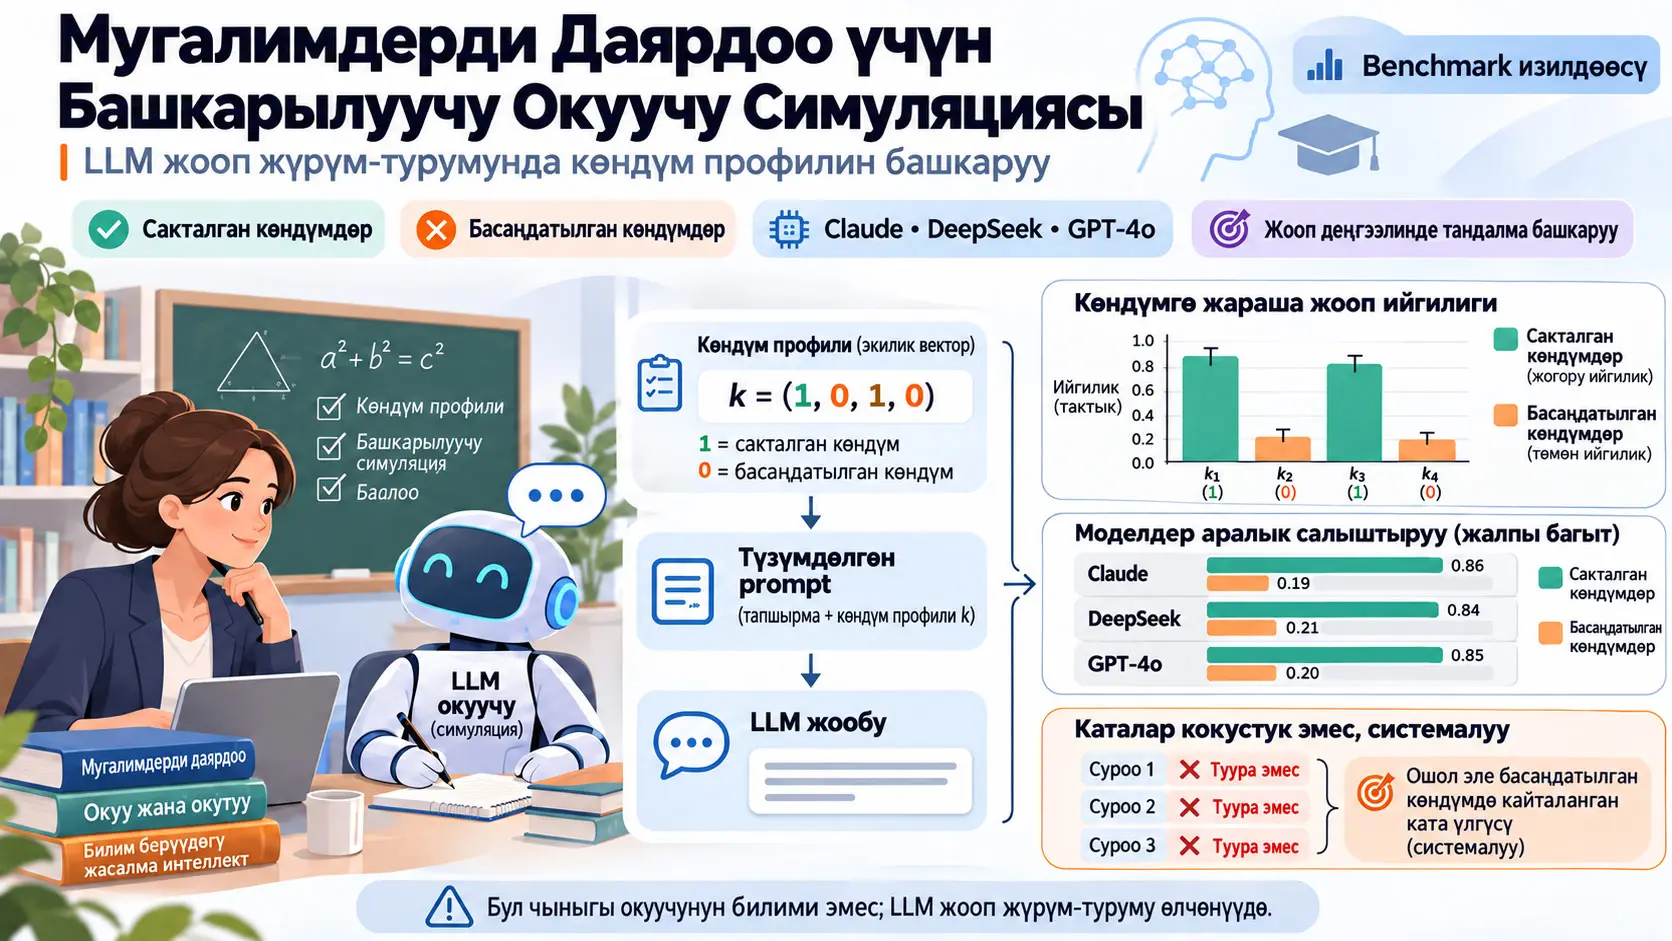
Башкарылуучу окуучу симуляциясы (controllable learner simulation) — чоң тил моделинин жалпы эле “алсызыраак окуучу” сыяктуу жүрүш-турушун эмес, алдын ала аныкталган көндүм профилинде айрым окуу программасынын көндүмдөрүн сактап туруп, белгилүү бир көндүмдөрдө тандалма түрдө төмөнүрөөк жооп көрсөткүчүн берүү жөндөмүн максат кылган билим берүүчү симуляция маселеси. Бул изилдөө мектеп математикасынын контекстинде мындай жүрүм-турумду өлчөөгө болобу же жокпу деген суроону толугу менен эсептөөчү benchmark изилдөөсү аркылуу карайт. Изилдөөчүлөр Claude, DeepSeek жана GPT-4o endpoint-терин Grade 4 жана Grade 5 математика көндүмдөрүндө retained жана suppressed көндүмдөрүн көрсөткөн экилик көндүм векторлорун колдонуп баалашкан.
Изилдөөнүн негизги жыйынтыгы — үч моделдин тең белгилүү көндүмдөрдү басаңдатуу менен башка көндүмдөрдү салыштырмалуу сактаган тандалма жооп профилдерин түзө алышы, бирок бул башкаруу моделден моделге олуттуу өзгөрүшү. Баштапкы математикадагы жогорку көрсөткүч күчтүүрөөк башкарылуучулук дегенди билдирген эмес. Claude отчет берилген жалпы өлчөмдөрдө retained жана suppressed көндүмдөрүнүн ортосундагы эң так ажырымды түзсө; DeepSeek басаңдатылышы керек болгон көндүмдөрдө көбүрөөк калдык көрсөткүчүн көрсөткөн, ал эми GPT-4o айрым көндүмдөрдү күчтүү басаңдатканына карабастан retained көндүмдөрүндө көбүрөөк ката чыгарган.
Prompt түзүлүшү да чечүүчү мааниге ээ. Мисалдарды гана көрсөткөн few-shot ыкмасы максаттуу көндүм профилине эң чоң дал келбестикти жараткан: RMSE аралыгы 0.40–0.61. Retained жана suppressed көндүмдөрүн ачык көрсөткөн rule-based жана combined prompt-тор 0.19–0.39 аралыгында төмөнүрөөк RMSE берген. Булак explicit instruction компонентин башкарылуучулуктун негизги кыймылдаткычы катары чечмелейт; эрежелерге мисал кошуу эрежелерди өзүнчө колдонуудан салыштырмалуу чектелүү гана кошумча пайда бергени байкалган.
Индукцияланган туура эмес жооптор да толугу менен кокустук эмес. Үч көз карандысыз модель baseline шартында туура чечкен, бирок suppression учурунда туура эмес жооп берген жалпы тапшырмаларда бир эле туура эмес вариантка Grade 4тө %39, Grade 5те булак текстине ылайык %35 өлчөмүндө багытталган; Grade 5 Figure 10 тилкесинин энбелгиси 0.34 көрсөткөндүктөн, бул натыйжаны болжол менен %34–35 деп окуу керек. Үч моделдин жакындашуусу үчүн shuffle-null көрсөткүчтөрү тиешелүүлүгүнө жараша болжол менен %21 жана %11. Бирок мындай жакындашуу чыныгы окуучулардагыдай эле когнитивдик механизм же чыныгы misconception пайда болгонун далилдебейт; төрт варианттуу суроолордо атайылап ынанымдуу distractor-лордун болушу да бир эле туура эмес жоопко багытталууга таасир этиши мүмкүн.
Эң маанилүү чечмелөө чеги ушул: изилдөө чыныгы окуучулардын билимин, ой жүгүртүү процессин же мугалимдерди даярдоонун натыйжалуулугун өлчөбөйт. Эксперименттер бир жолку, төрт варианттуу LLM жоопторуна негизделген. Binary target profile адам окуучунун чыныгы психикалык mastery state-и эмес; бул модель үчүн берилген гана дайындалган жооп-көрсөткүч шарты. Ошондуктан изилдөө “бул LLM-дер чыныгы окуучуларды туура симуляциялайт” деген тыянакты эмес, “белгилүү жооп деңгээлиндеги көндүм профилдерин канчалык тандалма түзүүгө болорун өлчөөгө болот” деген тыянакты колдойт.
Башкарылуучу Окуучу Симуляциясы Деген Эмне?
Башкарылуучу окуучу симуляциясы — LLM алдын ала аныкталган retained жана suppressed окуу программасынын көндүмдөрүнө ылайык жооп жүрүм-турумун көрсөтүп, бул жүрүм-турумдун максаттуу профилге канчалык дал келерин сандык түрдө өлчөөнү көздөгөн benchmark маселеси; бул изилдөө окуучунун бүтүндөй когнитивдик абалын эмес, answer-level skill-profile control өзгөчөлүгүн гана текшерет.
Эмне үчүн “ката кетирген окуучуну” түзүү жетишсиз?
Мугалимдикке талапкер үчүн кокусунан ката кетирген симулятордун билим берүүчү баалуулугу чектелүү. Чыныгы окутуу чөйрөсүндө маанилүүсү окуучунун жөн гана туура эмес жооп бериши эмес, белгилүү тармактарда күчтүү, белгилүү тармактарда алсыз жана салыштырмалуу туруктуу көрсөткүч үлгүсүн көрсөтүшү.
Булак мугалимдерди даярдоо жагынан төмөнкү түшүнүктүк чынжырды түзөт:
мугалимди даярдоо → симуляцияланган окуучулар → башкарылуучу көндүм профилдери → кайталоого боло турган максаттуу практика → жакшыраак аныктоо → муктаждыкка сезимтал окутуу
Бирок изилдөө бул чынжырдагы “симуляцияланган окуучу → башкарылуучу көндүм профили” байланышын гана өлчөйт. Кайталанма практика мугалимдин аныктоо көндүмүн чындап жакшыртабы же бул жакшыраак окутууга айланабы — бул экспериментте текшерилген эмес.
Эмне үчүн башкарылуучулук менен жогорку көрсөткүч бир эле нерсе эмес?
Стандарттуу LLM benchmark-тарында моделдин көбүрөөк суроого туура жооп бериши адатта жакшыраак көрсөткүчтү билдирет. Бул изилдөөдө максат башка. Эгер максаттуу профиль бир көндүмдүн retained, экинчисинин suppressed болушун талап кылса, моделдин бардык суроону туура чечиши ийгиликсиздик болуп эсептелиши мүмкүн; анткени модель талап кылынган жарым-жартылай көрсөткүч профилин ишке ашырган болбойт.
Ошондуктан:
- Capability: Модель математиканы канчалык жакшы чече алат?
- Controllability: Модель ага берилген retained/suppressed профилге канчалык тандалма түрдө ылайыкташа алат?
эки өзүнчө баалоо огун түзөт.
Изилдөөнүн үч модель боюнча жыйынтыгы да бул айырманы колдойт: жогорку baseline математика көрсөткүчү эң күчтүү selective suppression менен автоматтык түрдө коштолгон эмес.
Көндүм Профилинин Вектору Эмнени Билдирет?
Көндүм профилинин вектору ар бир окуу программасынын көндүмү үчүн 1 маанисин “retained”, 0 маанисин “suppressed” деп дайындаган экилик максат вектору; бул вектор өлчөнгөн адам когнициясы эмес, LLM жооп жүрүм-турумунда ишке ашырышы талап кылынган эксперименттик көрсөткүч шарты.
Формалдуу аныктама
Бир класс деңгээли үчүн окуу программасынын көндүмдөрүнүн үй-бүлөлөрү:
\[ \mathcal{S}=\{s_1,\ldots,s_K\} \]
деп аныкталат.
Максаттуу профиль:
\[ \mathbf{k}=(k_1,\ldots,k_K)\in\{0,1\}^{K} \]
түрүндө берилет.
- \(k_i=1\): \(s_i\) көндүмү retained деп дайындалган.
- \(k_i=0\): \(s_i\) көндүмү suppressed деп дайындалган.
\(K\) — баалоого киргизилген көндүм үй-бүлөлөрүнүн саны жана физикалык бирдикке ээ эмес.
Мисалы:
\[ \mathbf{k}=(1,0,0,1) \]
профили төрт көндүмдүү шартта биринчи жана төртүнчү көндүмдөр сакталууга, ал эми экинчи жана үчүнчү көндүмдөр басаңдатылууга тийиш экенин билдирет.
Булак бул айырманы өзгөчө белгилейт: бул вектор “окуучу чындап билген жана билбеген нерселер” эмес. Бул модель үчүн берилген assigned curricular performance condition.
Retained жана suppressed топтомдору
Retained көндүмдөрүнүн индекстер топтому:
\[ R=\{i:k_i=1\} \]
suppressed көндүмдөрүнүн индекстер топтому:
\[ F=\{i:k_i=0\} \]
деп аныкталат.
Бир көндүм үчүн baseline accuracy:
\[ a_i^{0}=A_{\mathrm{base}}(s_i) \]
жана максаттуу профиль астында байкалган accuracy:
\[ a_i^{*}=A_{\mathrm{ctrl}}(s_i\mid\mathbf{k}) \]
түрүндө көрсөтүлөт.
\(a_i^{0}\) — моделдин perfect-student, башкача айтканда бардык көндүмдөр retained болгон шарттагы ийгилик көрсөткүчү. \(a_i^{*}\) — белгилүү target profile астында ошол эле көндүмдө байкалган ийгилик.
Retained жана suppressed орточо көрсөткүчтөрү
Булак эки негизги орточо маанини колдонот:
\[ a_R(\mathbf{k}) = \frac{1}{|R|} \sum_{i\in R}a_i^{*} \]
\[ a_F(\mathbf{k}) = \frac{1}{|F|} \sum_{i\in F}a_i^{*} \]
\(a_R\) retained деп дайындалган көндүмдөрдөгү орточо тактыкты; \(a_F\) suppressed деп дайындалган көндүмдөрдө калган орточо тактыкты көрсөтөт.
Идеалдуу тандалма башкарууда \(a_R\) жогору, \(a_F\) төмөн болушу күтүлөт. Бирок булак “suppressed = нөлдүк көрсөткүч” деген божомолду кабыл албайт; чыныгы жыйынтыктар басаңдатуу даражалуу экенин көрсөткөн.
MathCAMPS маалымат топтомунун ролу
Изилдөө U.S. Common Core стандарттарына ылайык белгиленген математика суроолорунан турган MathCAMPS маалымат топтомун колдонот. Benchmark Grade 1–8 үчүн түзүлгөн жана ар бир grade-specific dataset 99 көп варианттуу суроону камтыйт.
Суроолор төрт варианттуу. Distractor-лор туура мааниге сандык жактан жакын же максаттуу көндүм жагынан түшүнүктүк жактан ынанымдуу туура эмес жооптор боло тургандай түзүлгөн.
Негизги кеңири controllability эксперименттери сегиз класстын баарында эмес, Grade 4 жана Grade 5 деңгээлдеринде гана жүргүзүлгөн.
Grade 4тө колдонулган көндүмдөр
- S4.1: Measurement and Data
- S4.2: Number and Operations — Base
- S4.3: Number and Operations — Fractions
- S4.4: Operations and Algebraic
Төрт көндүм болгондуктан бардык экилик профилдердин саны:
\[ 2^4=16 \]
болот.
Grade 5те колдонулган көндүмдөр
- S5.1: Number and Operations — Base
- S5.2: Number and Operations — Fractions
- S5.3: Operations and Algebraic
Үч көндүм үчүн:
\[ 2^3=8 \]
ар башка максаттуу профиль бар.
Ошентип, кеңири талдоо жалпысынан:
\[ 16+8=24 \]
ар башка retained/suppressed профилди камтыйт.
Маалыматты алдын ала иштетүүдө алмаштырылган суроолор
Perfect-student шартында моделдердин баары же көпчүлүгү туура эмес жооп берген тапшырмалар максатталган “унутуу” жүрүм-турумунан көз карандысыз эле көйгөйлүү суроо болушу мүмкүн деген негизде алдын ала белгиленген сапат контролунун алкагында белгиленген.
Бул процесстин аягында:
- Grade 4тө 7 тапшырма,
- Grade 5те 12 тапшырма
ошол эле Common Core стандартынын альтернативдүү тапшырмалары менен алмаштырылган.
Бул методологиялык жактан маанилүү, анткени моделдин чыгыштарын item curation үчүн колдонуу outcome-aware curation сынына ачык болушу мүмкүн. Авторлор мунун жыйынтыктарды багыттап-багыттабаганын өзүнчө текшерип, алмаштырылган бардык тапшырмалар алынып салынганда моделдердин ирети сакталганын жана кандай гана selectivity мааниси болбосун эң чоң өзгөрүү 0.04 болгонун билдиришкен.
Көндүм деңгээлиндеги тактык
Негизги байкалган чоңдук:
\[ Acc(s_i)=\frac{c_i}{n_i} \]
түрүндө.
- \(c_i\): \(s_i\) көндүмү менен белгиленген суроолордогу туура жооптордун саны.
- \(n_i\): ошол эле көндүм үчүн бааланган жалпы тапшырмалардын саны.
- \(Acc(s_i)\): 0 менен 1дин ортосундагы өлчөмсүз тактык катышы.
Бул маани профиль деңгээлиндеги башка метрикалардын негизги кириш маалыматы.
Relative Loss эмнени өлчөйт?
Булак relative loss-ту:
\[ L_i= \max\left( 0, \frac{a_i^{0}-a_i^{*}} {\max(a_i^{0},\varepsilon)} \right) \]
түрүндө аныктайт.
\(\varepsilon>0\) — бөлүүчүнүн нөл болуп калышына жол бербеген кичине туруктуу.
Бул метрика baseline-га салыштырмалуу көрсөткүчтүн пропорциялык жоготуусун өлчөйт.
- Suppressed көндүмдөр үчүн жогорку \(L_i\) күчтүүрөөк басаңдатууну билдирет.
- Retained көндүмдөр үчүн \(L_i\) нөлгө жакын болушу керек; анткени бул сакталууга тийиш болгон көрсөткүч жоголбогонун көрсөтөт.
RMSE максаттуу профилге дал келүүнү кантип өлчөйт?
Булакта:
\[ RMSE(\mathbf{k}) = \sqrt{ \frac{1}{K} \sum_{i=1}^{K} (k_i-a_i^{*})^2 } \]
деп аныкталат.
RMSE — binary target vector менен байкалган continuous skill-accuracy profile ортосундагы орточо квадраттык четтөөнүн квадраттык тамыры.
Мисалы, retained көндүмдө \(k_i=1\) болгондо байкалган тактык 1ге жакын болсо, ката аз болот. Suppressed көндүмдө \(k_i=0\) болгондо тактык 0гө жакындаган сайын ката кайра азаят.
Демек, төмөн RMSE максат-профилге жакшыраак дал келүүнү билдирет.
Бирок RMSE retained көрсөткүчүн сактоо менен suppressed көрсөткүчүн азайтууну бир санга бириктиргендиктен, изилдөө аны өзгөчө prompt-strategy ablation бөлүгүндө колдонот; негизги controllability чечмелөөсүн RMSEге гана таяндырбайт.
Controllability Score C(k) Эмнени Өлчөйт?
Controllability score \(C(\mathbf{k})\) retained деп белгиленген көндүмдөрдө жогорку тактыкты жана suppressed деп белгиленген көндүмдөрдө төмөн тактыкты бир эле формулада сыйлык катары эсептеп, байкалган жооп профилинин максаттуу экилик профилге канчалык дал келерин 0–1 аралыгында өлчөйт; \(C=1\) максатка толук дал келүүнү билдирет.
Булактагы формула:
\[ C(\mathbf{k}) = \frac{1}{K} \sum_{i=1}^{K} \left[ k_i a_i^{*} + (1-k_i)(1-a_i^{*}) \right] \]
түрүндө.
Формуланы кадам сайын окуу
Эгер \(k_i=1\), башкача айтканда көндүм retained болсо:
\[ k_i a_i^{*}=a_i^{*} \]
жана экинчи мүчө нөл болот. Демек, жогорку тактык упайды көбөйтөт.
Эгер \(k_i=0\), башкача айтканда көндүм suppressed болсо:
\[ (1-k_i)(1-a_i^{*})=1-a_i^{*} \]
болот. Бул жолу төмөн тактык упайды көбөйтөт.
Ошондуктан формула “модель канчалык туура?” деген суроого эмес, “модель талап кылынган retained/suppressed жүрүм-турумуна канчалык ылайык келди?” деген суроого жооп берет.
Cross-skill influence эмне үчүн керек?
Бир көндүмдү басаңдатуу оңой көрүнүшү мүмкүн; бирок ошол учурда сакталууга тийиш болгон башка көндүмдөр да зыян тартса, башкаруу чындап тандалма эмес.
Булак бул абалды cross-skill influence матрицасы \(\Delta_{ij}\) аркылуу талдайт.
Түз suppression таасири:
\[ \Delta_{ii} = \frac{1}{|\mathcal{K}_i|} \sum_{\mathbf{k}\in\mathcal{K}_i} A_{\mathrm{ctrl}}(s_i\mid\mathbf{k}) - A_{\mathrm{base}}(s_i) \]
менен бааланат.
Бул жерде:
\[ \mathcal{K}_i=\{\mathbf{k}:k_i=0\} \]
башкача айтканда \(s_i\) suppressed болгон профилдердин топтому.
Башка retained көндүм \(s_j\) үстүндөгү collateral influence:
\[ \Delta_{ij} = \frac{1}{|\mathcal{K}_{ij}|} \sum_{\mathbf{k}\in\mathcal{K}_{ij}} A_{\mathrm{ctrl}}(s_j\mid\mathbf{k}) - A_{\mathrm{base}}(s_j), \qquad i\neq j \]
жана:
\[ \mathcal{K}_{ij} = \{\mathbf{k}:k_i=0,\;k_j=1\} \]
түрүндө.
Маанилүү жагдай — off-diagonal таасир \(s_i\) suppressed болуп, \(s_j\) retained болгон профилдерде гана эсептелет. Ошентип, \(s_j\) да атайылап басаңдатылган профилдер collateral-damage эсебине аралашпайт.
Булакта түз suppression-дын модель/шарт деңгээлиндеги таасири чоң жана терс болсо, retained көндүмдөрүндөгү off-diagonal өзгөрүүлөр аз. Robustness талдоосунда mean diagonal мааниси болжол менен −0.47, mean off-diagonal magnitude болсо 0.03 деп билдирилип, айырма Mann–Whitney \(U\) тести менен \(p<10^{-10}\) деңгээлинде табылган.
Prediction Score деген эмне?
Экинчи даражадагы калибрлөө метрикасы:
\[ PS(\mathbf{k}) = a_R^{actual}(\mathbf{k}) - a_R^{expected}(\mathbf{k}) \]
түрүндө.
Маани:
- 0гө жакын болсо observed retention менен calibration expectation шайкеш;
- оң болсо retained көрсөткүчү күтүлгөндөн жакшы;
- терс болсо retained көрсөткүчү күтүлгөндөн төмөн.
Изилдөө Prediction Score-ду негизги жыйынтык метрикасы катары эмес, correlation structure-га сезимтал жардамчы diagnostic катары колдонот.
Gaussian calibration формуласы
Appendix Aда көндүм көрсөткүчтөрүнүн вектору үчүн:
\[ \mathbf{a}\sim\mathcal{N}(\boldsymbol{\mu},\boldsymbol{\Sigma}) \]
Gaussian approximation колдонулат.
Suppressed топтому \(F\), retained топтому \(R\) болсо, максатталган forgetting шартындагы retained көрсөткүчүнүн conditional expectation-ы:
\[ E[\mathbf{a}_R\mid\mathbf{a}_F=0] = \boldsymbol{\mu}_R - \boldsymbol{\Sigma}_{RF} \boldsymbol{\Sigma}_{FF}^{-1} \boldsymbol{\mu}_F \]
түрүндө жазылат.
Бул жерде:
- \(\boldsymbol{\mu}_R\): retained skill performance орточо маанилери,
- \(\boldsymbol{\mu}_F\): suppressed skill performance орточо маанилери,
- \(\boldsymbol{\Sigma}_{RF}\): retained менен suppressed көндүмдөрүнүн ортосундагы cross-covariance block,
- \(\boldsymbol{\Sigma}_{FF}\): suppressed көндүмдөрүнүн ортосундагы covariance block.
Эгер cross-skill coupling өтө алсыз болсо:
\[ \boldsymbol{\Sigma}_{RF}\approx0 \]
жана ошондуктан:
\[ E[\mathbf{a}_R\mid\mathbf{a}_F=0] \approx \boldsymbol{\mu}_R \]
болот.
Булак мунун чыныгы окуучу когнициясынын генеративдик модели эмес экенин өзгөчө баса белгилейт. Бул Gaussian ыкмасы expected-versus-observed retention калибрлөөсү үчүн гана колдонулган аналитикалык ыкма.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Эксперимент толугу менен эсептөөчү мүнөздө
Изилдөөгө окуучу, мугалим же башка адам катышуучу киргизилген эмес. Бардык байкоолор тил моделдери түзгөн бир варианттуу жоопторду баалоодон турат.
Бааланган модель endpoint-тери
| Модель | Булакта берилген identifier | Изилдөөдөгү ролу |
|---|---|---|
| Claude | claude-sonnet-4-5-20250929 | Күчтүү instruction-following өзгөчөлүгү менен жогорку-compliance салыштыруу чекити |
| DeepSeek | DeepSeek-chat | Күчтүү математика көрсөткүчү controllability менен бир эле нерсе экенин же эместигин текшерген салыштыруу |
| GPT-4o | gpt-4o | Кеңири колдонулган жалпы максаттагы LLM салыштыруусу |
Бардык inference операцияларында:
\[ temperature=0 \]
колдонулган.
Ошондуктан ошол эле экспериментте stochastic sampling variability атайын азайтылган. Appendix Aдагы профиль вариациясы да кайталануулар арасындагы sampling noise-ту эмес, ар башка student-profile шарттарынын ортосундагы өзгөрүүнү билдирет.
Булак ошондой эле DeepSeek-chat жана gpt-4o alias-тары date-pinned эмес экенин жана убакыт өтүшү менен provider тарабынан өзгөрүшү мүмкүн экенин белгилейт. Демек, жыйынтыктарды модель үй-бүлөсүнүн бардык версияларына жалпылоо туура эмес.
Үч prompt стратегиясы
| Стратегия | Мазмун | Булактын жыйынтыгы |
|---|---|---|
| Rule-based | Retained көндүмдөрдө туура, suppressed көндүмдөрдө туруктуу ката жүрүм-турумун ачык көрсөткөн эрежелер | Төмөн alignment error; combined менен окшош |
| Example-only / few-shot | Туура жана туура эмес жүрүм-турумду көрсөткөн мисалдар; баалоо маалыматынан бөлөк сакталган | Эң жогорку RMSE, 0.40–0.61 |
| Combined | Ачык эрежелер + мисалдар | RMSE 0.19–0.39 аралыгындагы rule-bearing стратегиялардын бири |
Claude үчүн rule-based RMSE combined-дан бир аз төмөн деп билдирилген:
- Grade 4: rule-based 0.19, combined 0.24;
- Grade 5: rule-based 0.20, combined 0.22.
Ошондуктан “combined дайыма эң жакшы prompt” деген тыянак колдоого алынбайт. Булактын такыраак чечмелөөсү — көндүм абалын ачык көрсөткөн нускама few-shot мисалдарынан маанилүүрөөк.
Негизги эксперимент агымы
- Ар бир модель perfect-student, башкача айтканда бардык көндүмдөр retained болгон шартта текшерилди.
- Binary skill vector prompt ичине жайгаштырылып, retained жана suppressed максаттуу профилдер аныкталды.
- Ошол эле профилдер rule-based, example-only жана combined prompting шарттарында бааланды.
- Жооптор profile-level жана skill-level метрикаларга айландырылды.
Grade 4 үчүн 16 профиль жана Grade 5 үчүн 8 профиль exhaustive түрдө бааланган.
Combined prompt негизги салыштыруусунда үч модель жана ар бир grade-деги 99 суроо бирге:
\[ (16\times99+8\times99)\times3=7128 \]
model–question response event жараткан.
Бул 7128 мааниси core combined-prompt comparison үчүн гана; perfect-student baseline жана prompt ablation эксперименттери кошулганда бүткүл изилдөө мындан чоңураак.
Статистикалык жыйынтык чыгаруу бирдиги эмне?
Булак deterministic decoding шартында ар бир grade үчүн туруктуу 99 тапшырманы inference бирдиги катары колдонот.
Ошол эле тапшырмада perfect жана all-forgotten абалдары жупташтырылгандыктан retained-versus-forgotten өзгөрүшү үчүн exact McNemar test колдонулган.
McNemar тести бир эле бирдиктин эки шарттагы binary жыйынтыгын салыштырат. Бул жердеги негизги логика “эки шартта тең канча суроо бирдей?” дегенден көрө, өзгөчө:
- baseline-да туура болуп, suppression шартында туура эмес болгон,
- baseline-да туура эмес болуп, suppression шартында туура болгон
discordant pair сандарынын тең салмактуулугун текшерүү.
Булак бардык модель жана grade комбинацияларында perfect vs all-forgotten айырмалары үчүн:
\[ p<10^{-5} \]
жана Cohen's \(h\) үчүн:
\[ 0.76\leq h\leq1.62 \]
аралыгын билдирет.
GEE логистикалык модели
Population-averaged талдоо:
\[ correct \sim target\_state \times model + grade \]
түрүндөгү logistic generalized estimating equations (GEE) модели менен жүргүзүлгөн.
Моделде:
- 198 тапшырма эки grade боюнча cluster катары колдонулган,
- binomial family колдонулган,
- working correlation exchangeable тандалган,
- robust sandwich standard errors колдонулган.
Reference model Claude үчүн retained көндүмдө туура жооп берүү odds-у forgotten көндүмгө салыштырмалуу болжол менен 40 эсе жогору деп бааланган; confidence interval толугу менен 1ден кыйла жогору жана \(p<10^{-30}\) деп билдирилген.
Бул “Claude retained skill-де 40 эсе жогорку тактык катышына ээ” дегенди билдирбейт. Odds ratio түздөн-түз probability ratio эмес. Булак бул жерде туура жооп берүү odds-ундагы өзгөрүүнү билдирет.
Target-state × model interaction-дарынын маанилүү болушу retained–forgotten ажырымы моделден моделге өзгөрөрүн колдойт.
Моделдердин айырмалары
Forgotten-skill accuracy үчүн жети grade-by-skill block боюнча Friedman тести:
\[ \chi^2=11.1,\qquad p=0.004 \]
жыйынтыгын берген.
Holm-түзөтүлгөн pairwise Wilcoxon тесттери:
- Claude–DeepSeek,
- DeepSeek–GPT-4o
салыштырууларын adjusted \(p<0.05\) менен айырмалаган.
Булак бул жерде билдирилбеген үчүнчү жуптук салыштыруу да автоматтык түрдө маанилүү деген тыянак чыгарбайт.
Prompt стратегияларынын ортосундагы статистикалык айырма
Алты model-by-grade block боюнча Friedman RMSE тести:
\[ \chi^2=9.3,\qquad p=0.009 \]
жыйынтыгын берген.
Бирок болгону алты block болгондуктан exact pairwise signed-rank тесттердин ажырата билүү мүмкүнчүлүгү төмөн. Авторлор ошондуктан prompt-strategy чечмелөөсүн pairwise p маанилерине караганда omnibus тестке жана ачык RMSE аралыктарына көбүрөөк таяндырышат.
Selectivity index
Булак selectivity index-ти retained accuracy менен forgotten accuracy ортосундагы айырма катары колдонот.
4000 item-level bootstrap resampling менен эсептелген %95 percentile interval-дар бардык модель–grade комбинацияларында нөлдөн жогору болуп, index болжол менен:
\[ 0.35\text{–}0.70 \]
аралыгында билдирилген.
Suppressed көндүмдөрдө нускамага ылайык туура эмес жооп берүү катышы, башкача айтканда compliance rate:
\[ 0.56\text{–}0.82 \]
аралыгында.
Retained жана suppressed көрсөткүчтөрү baseline-га салыштырмалуу канчалык ажырады?
| Модель | Grade | Retained / baseline | Suppressed / baseline |
|---|---|---|---|
| Claude | 4 | %101.2 | %34.1 |
| Claude | 5 | %97.4 | %33.4 |
| DeepSeek | 4 | %98.8 | %59.9 |
| DeepSeek | 5 | %98.3 | %51.9 |
| GPT-4o | 4 | %94.1 | %29.7 |
| GPT-4o | 5 | %100.0 | %50.5 |
Бул таблица маанилүү айырманы көрсөтөт. Suppressed accuracy эң төмөн экенин гана кароо жетишсиз. Мисалы, GPT-4o айрым шарттарда күчтүү suppression түзсө да retained көндүмдөрүндө көбүрөөк жоготуу болушу мүмкүн. Жакшы controllability suppression + retention бирге бааланганда түшүнүлөт.
Suppression көндүм үй-бүлөсүнө жараша өзгөрөт
| Grade | Модель | S1 | S2 | S3 | S4 |
|---|---|---|---|---|---|
| 4 | Claude | 0.43 | 0.39 | 0.10 | 0.34 |
| 4 | DeepSeek | 0.50 | 0.48 | 0.54 | 0.63 |
| 4 | GPT-4o | 0.19 | 0.21 | 0.28 | 0.14 |
| 5 | Claude | 0.23 | 0.24 | 0.52 | — |
| 5 | DeepSeek | 0.56 | 0.30 | 0.56 | — |
| 5 | GPT-4o | 0.30 | 0.18 | 0.33 | — |
Бул жыйынтыктар controllability бир эле глобалдык “баш ийүү” касиети эмес экенин; ал модель менен curricular skill family өз ара аракетине көз каранды экенин көрсөтөт.
Бир профиль мисалы тандалма башкарууну кантип көрсөтөт?
Claude Grade 4 үчүн булакта берилген:
\[ [1,0,0,1] \]
профилинде максат S4.1 жана S4.4тү retained; S4.2 жана S4.3тү suppressed сактоо.
| Көндүм | Максаттуу абал | Байкалган accuracy |
|---|---|---|
| S4.1 | Retained | 0.92 |
| S4.2 | Suppressed | 0.32 |
| S4.3 | Suppressed | 0.12 |
| S4.4 | Retained | 0.96 |
Бул мисалдын илимий мааниси модель жалпы жаман иштеп калганы эмес. Бир эле профиль ичинде retained болгон эки көндүм жогору бойдон калса, targeted болгон эки көндүмдө көрсөткүч кескин төмөндөйт.
Suppression даражалуу, абсолюттук эмес
Бардык модель, grade жана профилдер бирге каралганда forgotten-skill accuracy орточосу:
\[ 0.35 \]
деп билдирилген.
Forgotten-skill мисалдарынын %95и:
\[ 0.1\text{–}0.9 \]
аралыгында.
Ошондуктан “унутулган көндүм толугу менен жок болду” деген сөз туура эмес. Изилдөөдө suppression partial and graded performance жаратат.
Signal-detection көз карашы
Булак instruction-following көрүнүшүн signal-detection окшоштугу аркылуу да карайт:
- Hit rate: suppressed көндүмдө нускамага ылайык туура эмес жооп берилген тапшырмалардын үлүшү.
- False-alarm rate: retained көндүмдө туура эмес жооп берилген тапшырмалардын үлүшү.
Идеалдуу башкарылуучу окуучу симулятору жогорку hit rate, бирок төмөн false-alarm rate бериши керек.
Claude үчүн sensitivity index \(d'\) болжол менен 2.1 деп билдирилип, бааланган үч моделдин ичинен эң так ажырым Claude-да байкалганы белгиленген.
Тандалма Көндүмдү Басаңдатуу Чыныгы Окуучунун Жаңылыш Түшүнүгүн Далилдейби?
Жок. Моделдердин бир эле туура эмес вариантка күтүлгөндөн көп багытталышы каталар кокустук эмес экенин колдойт, бирок чыныгы окуучулардагыдай эле когнитивдик механизм же чыныгы misconception түзүлгөнүн далилдебейт; изилдөө муну текшерүү үчүн мугалимдердин баалоосу жана чыныгы окуучулардын жооп бөлүштүрүүлөрү менен ырастоо керек экенин ачык белгилейт.
Туура эмес жооптордун жакындашуусу
Талдоо бардык моделдер perfect-student абалында туура жооп бере алган тапшырмалар менен гана чектелген. Ошентип, suppression-дан кийин чыккан ката baseline-да эле чечилбеген суроодон келип чыгышына жол бербөөгө аракет кылынган.
| Салыштыруу | Grade 4 observed | Grade 5 observed | Shuffle-null |
|---|---|---|---|
| Үч модель бир эле туура эмес жооп | %39 | Текст: %35; Figure 10 энбелгиси: %34 | Болжол менен %21 / %11 |
| Pairwise agreement | %56–%59 | Болжол менен %31–%40 | |
Бул салыштыруулардын баары үчүн:
\[ p<0.001 \]
деп билдирилген.
Permutation null ар бир моделдин өзүнүн туура эмес жооп тамгаларынын жыштыгын сактайт. Ошентип, мисалы, белгилүү бир моделдин “A” вариантын жалпы түрдө көп тандашы жасалма моделдер аралык жакындашуу катары чечмеленбешине аракет кылынат.
Permutation p мааниси булакта:
\[ p= \frac{ 1+\#\{\mathrm{null}\geq\mathrm{observed}\} }{ 1+5000 } \]
түрүндө эсептелген.
5000 пермутация колдонулган.
28 жалпы туура эмес жооп кайсы категорияларга бөлүндү?
| Ката категориясы | Саны | Булак мисалынын мааниси |
|---|---|---|
| Magnitude / fraction-comparison misconception | 7 | Бөлчөктөрдүн чоңдук байланышын тескери чечмелеген жооп үлгүсү |
| Fraction whole-unit / conversion error | 3 | 78/65 + 78/65 үчүн туура 2.4 ордуна 1.4 тандоо |
| Computation slip / carrying error | 11 | 47 × 9 үчүн 423 ордуна 422 тандоо |
| Wrong operation | 1 | 48 − 12 амалында кемитүүнүн ордуна кошууга багытталган жооп |
| Degenerate option selection | 4 | Авторлор муну misconception катары классификациялаган эмес |
| Notation artifact | 2 | Бир эле маанинин эквиваленттүү жазылыштарынан келип чыккан абал |
22/28 тапшырма, башкача айтканда:
\[ \frac{22}{28}\approx79\% \]
автордун exploratory классификациясында математика билими адабиятында документтештирилген ката түрлөрүнө шайкеш деп табылган.
Бирок бул %79:
- бардык induced error-лордун %79у эмес;
- үч модель бир эле катада бириккен 28 тапшырмалык чакан топтомго гана тиешелүү;
- бир эле автор/coder тарабынан классификацияланган;
- inter-rater reliability эсептелген эмес.
Ошондуктан бул табылганы чыныгы окуучунун misconception fidelity далили катары көрсөтүү туура эмес.
Robustness: baseline-да гана чечиле турган тапшырмалар
Катуураак талдоодо модель perfect-student шартында туура чече алган тапшырмалар алынган.
| Модель | Retained болгондо туура бойдон калуу | Suppressed болгондо туура эместикке өтүү | Controllability score |
|---|---|---|---|
| Claude | 0.98 | 0.68 | 0.82 |
| DeepSeek | 0.97 | 0.47 | 0.69 |
| GPT-4o | 0.93 | 0.80 | 0.69 |
Бул жыйынтык абдан маанилүү: GPT-4o suppression жагынан жогорку “туура эместикке өткөрүү” көрсөткүчүнө ээ болсо да retained тапшырмаларында Claude жана DeepSeekке караганда көбүрөөк collateral ката чыгаргандыктан жалпы controllability score боюнча Claude менен бир деңгээлге жетпейт.
Алмаштырылган суроолор алынып салынганда эмне болду?
| Модель | Retained — Full | Retained — Excl. | Forgotten — Full | Forgotten — Excl. | Selectivity — Full | Selectivity — Excl. |
|---|---|---|---|---|---|---|
| Claude | 0.948 | 0.946 | 0.318 | 0.317 | 0.630 | 0.628 |
| DeepSeek | 0.888 | 0.877 | 0.521 | 0.528 | 0.367 | 0.349 |
| GPT-4o | 0.618 | 0.589 | 0.223 | 0.232 | 0.396 | 0.357 |
Эң чоң selectivity өзгөрүүсү 0.04. Ошондуктан булак алмаштырылган 19 тапшырма негизги модель иретин түшүндүрбөйт деген тыянак чыгарат.
Answer-position imbalance
Төрт варианттын ичиндеги туура жооп позициялары uniform бөлүштүрүлгөн эмес жана A варианты ашыкча көрсөтүлгөн:
\[ p<10^{-6} \]
эки grade үчүн тең билдирилген.
Бирок error-convergence permutation null ар бир моделдин өз answer-letter frequency бөлүштүрүүсүн сактагандыктан, булак бул positional imbalance моделдер аралык туура эмес жооп жакындашуусун өз алдынча түшүндүрбөй турганын белгилейт.
Изилдөө колдогон жыйынтыктар
- Экилик retained/suppressed skill profile колдонуу менен answer-level LLM жүрүм-турумун өлчөөгө боло тургандай багыттоого мүмкүн болгон.
- Ачык skill-state rule камтыган prompt-тор example-only prompting-ге караганда төмөн profile-alignment катасын берген.
- Rule-based жана combined prompting бааланган шарттарда бири-бирине жакын alignment камсыз кылган.
- Selective suppression үч моделде тең өлчөнгөн, бирок анын күчү модель жана көндүм үй-бүлөсүнө көз каранды.
- Retained көндүмдөр жалпы алганда suppressed көндүмдөргө караганда кыйла жакшы сакталган.
- Cross-skill collateral change түз suppression таасирине караганда аз.
- Жогорку baseline математика көндүмү бааланган үч моделдин ичинде автоматтык түрдө күчтүүрөөк controllability дегенди билдирген эмес.
- Induced wrong answers жөнөкөй көз карандысыз кокустук тандоо моделине караганда көбүрөөк түзүмдөлгөн көрүнөт.
- Үч моделдин бир эле туура эмес вариантка жакындашуусу marginal answer-letter bias деңгээлинен жогору болгон.
- Алмаштырылган benchmark тапшырмаларын алып салуу негизги модель иретин өзгөрткөн эмес.
Изилдөө колдобогон жыйынтыктар
- LLM-дер чыныгы окуучулардын когнитивдик абалын туура симуляциялай турганы далилденген эмес.
- Binary skill vector чыныгы адам mastery state-и эмес.
- Induced wrong answer чыныгы окуучу misconception-ы катары ырасталган эмес.
- Үч моделдин бир эле катага багытталышы жалпы когнитивдик механизмдин далили эмес.
- Башкарылуучу профиль түзүү мугалимдердин аныктоо көндүмүн жакшыртары текшерилген эмес.
- Мындай симуляторлор мугалимдерди даярдоону же окуучулардын жетишкендигин жогорулатары көрсөтүлгөн эмес.
- Жыйынтыктар ачык жооптуу түшүндүрмө же көп жолку tutor–student dialog үчүн ырасталган эмес.
- Grade 1–8 benchmark даярдалган болсо да, кеңири controllability жыйынтыгы бардык Grade 1–8 үчүн көрсөтүлгөн эмес.
- Математикадан тышкаркы илим, тил, программалоо сыяктуу тармактарга жалпылоо мүмкүнчүлүгү текшерилген эмес.
- Жыйынтыктарды бардык Claude, DeepSeek же GPT модель үй-бүлөлөрүнө жалпылоого болбойт; алар колдонулган endpoint-терге гана тиешелүү.
- Prompt-based control-дан башка fine-tuning же training-time ыкмалары жакшыраак же начарыраак экенин бул изилдөөдөн чыгарууга болбойт.
Изилдөөнүн төрт негизги жарактуулук чеги
1. Construct validity
Максаттуу profile alignment чыныгы адам mastery-си же authentic misconception менен бирдей эмес. Target profile binary болсо, байкалган suppression даражалуу.
2. Ecological validity
Маалымат бир жолку көп варианттуу жооптон турат. Окуучунун түшүндүрмөсү, tutor dialog, motivation, confusion, engagement жана peer interaction жок.
3. External validity
Терең талдоо Grade 4 жана Grade 5 математика көндүмдөрүн жана үч модель endpoint-ин гана камтыйт. Башка класстар, сабактар жана модель үй-бүлөлөрү үчүн жыйынтыктарды кайра ырастоо керек.
4. Benchmark / internal validity
Ар бир суроо бир гана skill family менен белгиленген; чыныгы математика маселелери бир нече көндүмдү бирге талап кылышы мүмкүн. Мындан тышкары толук \(2^K\) profile enumeration көндүмдөрдүн санына жараша экспоненциалдуу өсөт.
Кайра өндүрүлүүчүлүк
Булак benchmark тапшырмалары, skill annotation-дары, rule-based/example-only/combined prompt template-тери, item-to-skill mapping, үч моделдин per-item evaluation чыгыштары, raw prompt/response/parsed-answer жазуулары жана талдоо коду архивделгенин билдирет.
Маалымат жана код архиви үчүн булакта берилген Zenodo DOI:
10.5281/zenodo.21853933
деп көрсөтүлгөн.
Талдоолор Python 3.14, statsmodels 0.14.6, SciPy 1.17.1 жана NumPy 1.26.4 колдонуу менен жүргүзүлгөн.
Келечектеги изилдөөлөр
Авторлор эң маанилүү кийинки кадам катары адам эксперттеринин баалоосун көрүшөт. Тажрыйбалуу мугалимдердин симуляцияланган окуучулардын реалдуулугун жана педагогикалык пайдалуулугун баалоосу objective answer metrics аркылуу гана алынбай турган external validity далилин бере алат.
Булак ошондой эле:
- чыныгы окуучулардын response distributions менен салыштыруу,
- blinded multi-rater misconception coding,
- conceptual misconception, procedural slip, arithmetic error жана reasoning shortcut сыяктуу кененирээк ката профилдери,
- binary ордуна continuous target-performance scale,
- hierarchical skill representations,
- fine-tuning же reinforcement-based control,
- башка сабактар жана grade bands,
- көп жолку interactive tutoring,
- мугалим катышкан чыныгы билим берүүчү валидация
сыяктуу кеңейтүүлөрдү сунуштайт.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска аталышы: Toward Controllable Learner Simulation for Teacher Education: Benchmarking Skill-Profile Control in LLM Answer Behavior
Авторлор, булактагы ирети менен: Omri Sasson; Alexander Apartsin; Yehudit Aperstein.
Авторлордун аффилиациялары: Omri Sasson жана Yehudit Aperstein — Intelligent Systems, Afeka College of Engineering, Tel Aviv, Israel. Alexander Apartsin — School of Computer Science, Faculty of Sciences, Holon Institute of Technology, Holon, Israel.
Жооптуу автор: Yehudit Aperstein.
Тең салым: Булакта equal-contribution билдирүүсү жок.
Журнал: Education Sciences.
Басмакана: MDPI, Basel, Switzerland.
Жарыя түрү: Article; толугу менен эсептөөчү benchmark/experimental evaluation.
Том / номер / макала номери: 16(10), 1752.
DOI: 10.3390/educsci16101752.
Received: 11 August 2026.
Revised: 4 October 2026.
Accepted: 14 October 2026.
Published: 19 October 2026.
Academic Editor: Samson Nashon.
Рецензия абалы: Жарыяланган, рецензиядан өткөн журналдык макала.
Preprint абалы: Каралган булакта жана расмий библиографиялык жазууда бул макаланын өзүнчө preprint версиясы тууралуу маалымат берилген эмес.
Лицензия: Creative Commons Attribution (CC BY).
Изилдөөнүн негизги суроосу: Prompt менен башкарылган LLM айрым окуу программасынын көндүмдөрүн retained бойдон кармап, башкаларын suppressed көрсөткөн белгиленген student skill profile-ды тандалма түрдө ишке ашыра алабы?
Кошумча изилдөө суроолору: Prompt стратегиясынын таасири; бааланган модель endpoint-теринин ортосундагы controllability айырмасы; suppression retained skills үстүндө чектелүү collateral interference менен ишке ашырылышы мүмкүнбү.
Маалымат топтому: MathCAMPS; Grade 1–8 үчүн ар биринде 99дан көп варианттуу суроо даярдалган. Кеңири controllability талдоолору Grade 4 жана Grade 5 менен чектелген.
Негизги талдоо footprint-и: Grade 4тө 4 көндүм жана 16 профиль; Grade 5те 3 көндүм жана 8 профиль; жалпысынан 24 target profile.
Core combined-prompt response count: 7128 model–question event.
Модель endpoint-тери: claude-sonnet-4-5-20250929; DeepSeek-chat; gpt-4o.
Decoding: Deterministic, temperature = 0.
Prompt стратегиялары: Rule-based; example-only/few-shot; combined.
Негизги метрикалар: Per-skill accuracy; retained/suppressed mean accuracy; relative loss; RMSE; controllability score \(C(\mathbf{k})\); cross-skill influence \(\Delta_{ij}\); selectivity index; signal-detection hit/false-alarm түзүмү. Prediction score жардамчы calibration metric болуп саналат.
Статистикалык талдоо: Exact McNemar; Cohen's \(h\); logistic GEE; Friedman omnibus; Holm-corrected Wilcoxon signed-rank; 4000-resample percentile bootstrap; 5000-permutation marginal-preserving error-convergence test; Mann–Whitney \(U\) robustness талдоосу.
Статистикалык программалык камсыздоо: Python 3.14; statsmodels 0.14.6; SciPy 1.17.1; NumPy 1.26.4.
Булак ичиндеги сандык эскертүү: Section 7.7 тексти Grade 5 үч-model wrong-answer convergence маанисин %35 деп берсе, Figure 10догу маани 0.34. Verianla бул айырманы унчукпай оңдогон эмес жана тиешелүү жыйынтыкты болжол менен %34–35 деп чектеген.
Item quality control: Grade 4тө 7, Grade 5те 12 тапшырма perfect-student baseline-дагы моделдер аралык ийгиликсиздиктерден улам алмаштырылган. Бул тапшырмалардын баары чыгарылган robustness талдоосунда модель ирети сакталган, selectivity өзгөрүүлөрү эң көп 0.04 болгон.
Каржылоо: Изилдөө тышкы каржылоо алган эмес.
Institutional Review Board: Колдонулбайт; изилдөөдө адам же жаныбар катышуучу жок жана талданган жооптордун баары тил моделдери тарабынан түзүлгөн.
Informed Consent: Колдонулбайт.
Data Availability: Benchmark тапшырмалары, prompt template-тери, per-item модель чыгыштары жана талдоо коду Zenodo-до DOI 10.5281/zenodo.21853933 менен ачык архивделген.
Кызыкчылыктардын кагылышы: Авторлор кызыкчылыктардын кагылышы жок экенин билдиришкен.
Авторлордун салымдары
- Conceptualization: Yehudit Aperstein, Alexander Apartsin.
- Methodology: Yehudit Aperstein, Alexander Apartsin.
- Formal analysis: Omri Sasson, Yehudit Aperstein, Alexander Apartsin.
- Data curation: Omri Sasson, Alexander Apartsin.
- Software: Omri Sasson.
- Supervision: Yehudit Aperstein, Alexander Apartsin.
- Project administration: Yehudit Aperstein.
- Writing — original draft preparation: Omri Sasson, Yehudit Aperstein, Alexander Apartsin.
- Writing — review and editing: Yehudit Aperstein, Alexander Apartsin.
Негизги методологиялык чектөөлөр: Адам эксперттик текшерүүсүнүн жоктугу; binary target profile чыныгы mastery state эместиги; бир жолку көп варианттуу answer-level баалоо; ачык жооптуу ой жүгүртүү жана tutor dialog изилденбегени; Grade 4–5 боюнча гана кеңири талдоо; үч гана модель endpoint-и; prompt-based control гана; single-skill item annotation; айрым тапшырмалар baseline модель чыгышы менен сапат контролунан өткөрүлгөнү; full \(2^K\) profile enumeration көндүмдөрдүн санына жараша экспоненциалдуу өсүшү.
Негизги илимий чечмелөө чеги: Бул изилдөө генеративдик жасалма интеллект чыныгы окуучуларды педагогикалык жактан ишенимдүү симуляциялай турганын же мугалимдикке талапкерлердин даярдыгын жакшыртарын көрсөтпөйт. Изилдөө белгиленген retained/suppressed skill profile LLM answer behavior деңгээлинде канчалык тандалма жана локалдуу ишке ашырылышын өлчөө үчүн benchmark жана метрикалардын үй-бүлөсүн сунуштайт.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген