


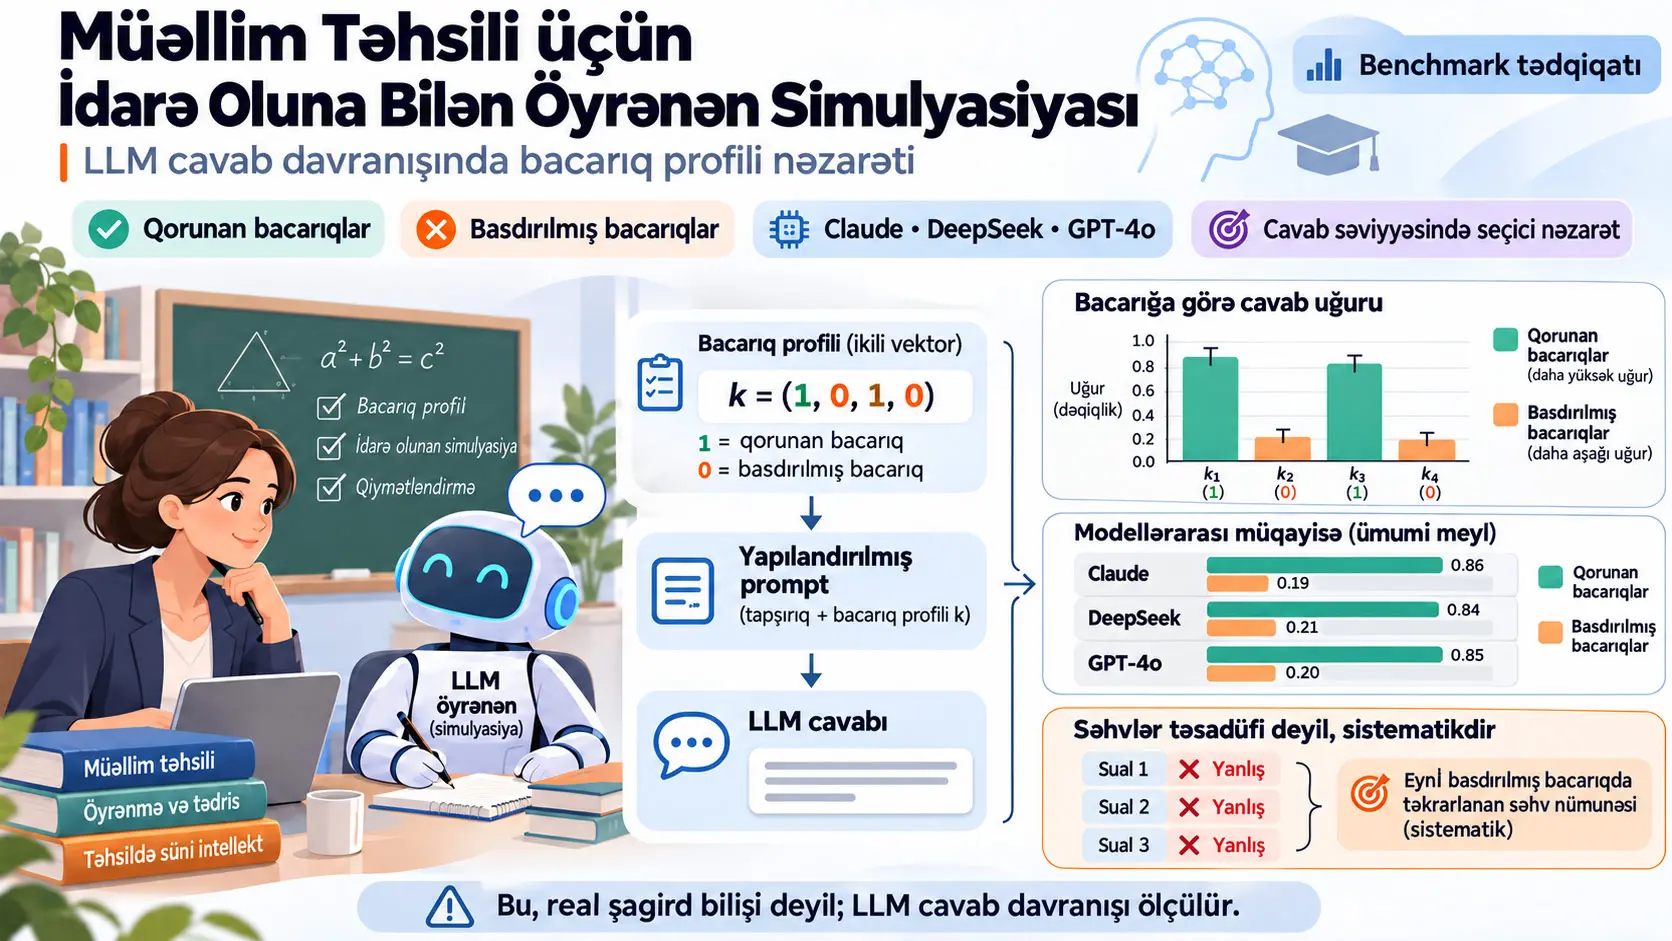
İdarə oluna bilən öyrənən simulyasiyası (controllable learner simulation), böyük dil modelinin yalnız ümumi şəkildə “daha zəif şagird” kimi davranmasını deyil, əvvəlcədən müəyyən edilmiş bacarıq profilində bəzi kurikulum bacarıqlarını qoruyarkən müəyyən bacarıqlarda seçici şəkildə daha aşağı cavab performansı göstərməsini hədəfləyən təhsilə aid simulyasiya problemidir. Bu tədqiqat, məktəb riyaziyyatı kontekstində belə bir davranışın ölçülüb-ölçülə bilməyəcəyini araşdıran tamamilə hesablama əsaslı benchmark tədqiqatıdır. Tədqiqatçılar Claude, DeepSeek və GPT-4o endpoint-lərini; Grade 4 və Grade 5 riyaziyyat bacarıqları üzərində, retained və suppressed bacarıqları göstərən ikili bacarıq vektorlarından istifadə etməklə qiymətləndirmişlər.
Tədqiqatın əsas nəticəsi budur ki, hər üç model müəyyən bacarıqları basdırarkən digər bacarıqları nisbətən qoruyan seçici cavab profilləri yarada bilmişdir; lakin bu nəzarət modeldən modelə ciddi şəkildə dəyişir. Daha yüksək ilkin riyaziyyat göstəricisi daha güclü idarəolunma qabiliyyəti demək olmamışdır. Claude, hesabat verilən ümumi ölçülərdə retained və suppressed bacarıqlar arasında ən aydın ayrımı yaradarkən; DeepSeek basdırılması istənən bacarıqlarda daha çox qalıq performans göstərmiş, GPT-4o isə bəzi bacarıqları güclü şəkildə basdırmasına baxmayaraq retained bacarıqlarda daha çox səhv yaratmışdır.
Prompt dizaynı da həlledicidir. Yalnız nümunə göstərən few-shot yanaşması hədəf bacarıq profilinə ən yüksək uyğunsuzluğu yaratmışdır: RMSE intervalı 0.40–0.61-dir. Retained və suppressed bacarıqları açıq şəkildə bildirən rule-based və combined prompt-lar isə 0.19–0.39 intervalında daha aşağı RMSE yaratmışdır. Mənbə explicit instruction komponentini idarəolunmanın əsas hərəkətverici amili kimi şərh edir; qaydalara nümunə əlavə etməyin qaydaların təkbaşına istifadəsi ilə müqayisədə məhdud əlavə töhfə verdiyi görülmüşdür.
İnduksiya olunmuş yanlış cavablar da tamamilə təsadüfi deyil. Üç müstəqil model, baseline-da düzgün həll etdikləri, lakin suppression altında səhv cavablandırdıqları ortaq maddələrdə eyni yanlış variantı Grade 4-də %39, Grade 5-də isə mənbə mətninə görə %35 nisbətində seçmişdir; Grade 5 Figure 10 sütun etiketi 0.34 göstərdiyi üçün bu nəticə təxminən %34–35 kimi oxunmalıdır. Üçlü yaxınlaşma üçün shuffle-null nisbətləri müvafiq olaraq təxminən %21 və %11-dir. Bununla belə, bu yaxınlaşma real şagirdlərlə eyni koqnitiv mexanizmi və ya real misconception-ı sübut etmir; dördvariantlı suallarda qəsdən inandırıcı distractor-ların olması da eyni yanlış cavaba yönəlməyə təsir göstərə bilər.
Ən mühüm şərh sərhədi budur: tədqiqat real şagirdlərin biliyini, düşünmə prosesini və ya müəllim təhsilinin effektivliyini ölçmür. Təcrübələr bir turlu, dördvariantlı LLM cavabları üzərində aparılmışdır. Binary target profile insan şagirdin real zehni mastery state-i deyil; yalnız modelə verilən təyin edilmiş cavab-performans şərtidir. Buna görə tədqiqat “bu LLM-lər real şagirdləri düzgün simulyasiya edir” nəticəsini deyil, “müəyyən cavab səviyyəli bacarıq profillərinin nə dərəcədə seçici şəkildə yaradıla bildiyi ölçülə bilər” nəticəsini dəstəkləyir.
İdarə Oluna Bilən Öyrənən Simulyasiyası Nədir?
İdarə oluna bilən öyrənən simulyasiyası, LLM-in əvvəlcədən müəyyən edilmiş retained və suppressed kurikulum bacarıqlarına uyğun cavab davranışı göstərməsini və bu davranışın hədəf profilə nə dərəcədə uyğun olduğunun kəmiyyətcə ölçülməsini məqsəd qoyan benchmark problemidir; bu tədqiqat şagird idrakının hamısını deyil, yalnız answer-level skill-profile control xüsusiyyətini sınaqdan keçirir.
Niyə “səhv edən şagird” yaratmaq kifayət deyil?
Müəllim namizədi üçün təsadüfi şəkildə səhv edən simulyatorun təhsil dəyəri məhduddur. Real tədris mühitində vacib olan yalnız şagirdin səhv cavab verməsi deyil, müəyyən sahələrdə güclü, müəyyən sahələrdə zəif və nisbətən ardıcıl performans nümunəsi göstərməsidir.
Mənbənin müəllim təhsili baxımından qurduğu konseptual zəncir belədir:
müəllim hazırlığı → simulyasiya edilmiş şagirdlər → idarə olunan bacarıq profilləri → təkrarlana bilən məqsədli praktika → daha yaxşı diaqnostika → daha həssas tədris
Lakin tədqiqat bu zəncirin yalnız “simulyasiya edilmiş şagird → idarə olunan bacarıq profili” əlaqəsini ölçür. Təkrarlanan praktikanın həqiqətən müəllimin diaqnostika bacarığını inkişaf etdirib-etdirmədiyi və ya bunun daha yaxşı tədrisə çevrilib-çevrilmədiyi bu təcrübədə sınaqdan keçirilməmişdir.
Niyə idarəolunma qabiliyyəti ilə yüksək performans eyni şey deyil?
Standart LLM benchmark-larında modelin daha çox suala düzgün cavab verməsi adətən daha yaxşı performans deməkdir. Bu tədqiqatda məqsəd fərqlidir. Əgər hədəf profil bir bacarığın retained, digərinin suppressed olmasını tələb edirsə, modelin hər suala düzgün cavab verməsi uğursuzluq sayıla bilər; çünki model tələb olunan qismən performans profilini həyata keçirməmiş olur.
Buna görə:
- Capability: Model riyaziyyatı nə dərəcədə yaxşı həll edə bilir?
- Controllability: Model ona verilən retained/suppressed profilə nə dərəcədə seçici şəkildə uyğunlaşa bilir?
iki ayrı qiymətləndirmə oxudur.
Tədqiqatın üç model üzrə nəticəsi də bu fərqi dəstəkləyir: yüksək baseline riyaziyyat performansı ən güclü selective suppression ilə avtomatik şəkildə birlikdə getməmişdir.
Bacarıq Profili Vektoru Nə Deməkdir?
Bacarıq profili vektoru hər bir kurikulum bacarığı üçün 1 dəyərini “retained”, 0 dəyərini isə “suppressed” kimi təyin edən ikili hədəf vektorudur; bu vektor ölçülmüş insan idrakı deyil, LLM-in cavab davranışında həyata keçirməsi tələb olunan eksperimental performans şərtidir.
Formal tərif
Bir sinif səviyyəsi üçün kurikulum bacarıq ailələri:
\[ \mathcal{S}=\{s_1,\ldots,s_K\} \]
kimi müəyyən edilir.
Hədəf profil:
\[ \mathbf{k}=(k_1,\ldots,k_K)\in\{0,1\}^{K} \]
şəklindədir.
- \(k_i=1\): \(s_i\) bacarığı retained kimi təyin edilmişdir.
- \(k_i=0\): \(s_i\) bacarığı suppressed kimi təyin edilmişdir.
\(K\), qiymətləndirməyə daxil edilən bacarıq ailələrinin sayıdır və fiziki vahid daşımır.
Məsələn:
\[ \mathbf{k}=(1,0,0,1) \]
profili dörd bacarıqlı bir vəziyyətdə birinci və dördüncü bacarıqların qorunmalı, ikinci və üçüncü bacarıqların isə basdırılmalı olduğunu bildirir.
Mənbə xüsusilə bu fərqi vurğulayır: bu vektor “şagirdin həqiqətən bildiyi və bilmədiyi şeylər” deyil. Bu, modelə verilən assigned curricular performance condition-dır.
Retained və suppressed çoxluqları
Retained bacarıqların indeks çoxluğu:
\[ R=\{i:k_i=1\} \]
suppressed bacarıqların indeks çoxluğu:
\[ F=\{i:k_i=0\} \]
kimi müəyyən edilir.
Bir bacarıq üçün baseline accuracy:
\[ a_i^{0}=A_{\mathrm{base}}(s_i) \]
və hədəf profil altında müşahidə olunan accuracy:
\[ a_i^{*}=A_{\mathrm{ctrl}}(s_i\mid\mathbf{k}) \]
kimi göstərilir.
\(a_i^{0}\), modelin perfect-student, yəni bütün bacarıqların retained olduğu şərtdəki müvəffəqiyyət nisbətidir. \(a_i^{*}\), müəyyən target profile altında eyni bacarıqda müşahidə olunan müvəffəqiyyətdir.
Retained və suppressed orta performans
Mənbə iki əsas ortalamadan istifadə edir:
\[ a_R(\mathbf{k}) = \frac{1}{|R|} \sum_{i\in R}a_i^{*} \]
\[ a_F(\mathbf{k}) = \frac{1}{|F|} \sum_{i\in F}a_i^{*} \]
\(a_R\), retained kimi təyin edilmiş bacarıqlardakı orta düzgünlüyü; \(a_F\), suppressed kimi təyin edilmiş bacarıqlarda qalan orta düzgünlüyü göstərir.
İdeal seçici nəzarət məntiqində \(a_R\)-nin yüksək, \(a_F\)-nin isə aşağı olması gözlənilir. Lakin mənbə “suppressed = sıfır performans” fərziyyəsini irəli sürmür; real nəticələr basdırmanın dərəcəli olduğunu göstərmişdir.
MathCAMPS məlumat dəstinin rolu
Tədqiqat U.S. Common Core standartlarına uyğun etiketlənmiş riyaziyyat suallarından ibarət MathCAMPS məlumat dəstindən istifadə edir. Benchmark Grade 1–8 üçün yaradılmış və hər grade-specific dataset 99 çoxvariantlı sualdan ibarətdir.
Suallar dördvariantlıdır. Distractor-lar düzgün qiymətə ədədi baxımdan yaxın və ya hədəf bacarıq baxımından konseptual olaraq inandırıcı yanlış cavablar olacaq şəkildə tərtib edilmişdir.
Əsas ətraflı controllability təcrübələri bütün səkkiz sinif üzrə deyil, yalnız Grade 4 və Grade 5 üzrə aparılmışdır.
Grade 4-də istifadə olunan bacarıqlar
- S4.1: Measurement and Data
- S4.2: Number and Operations — Base
- S4.3: Number and Operations — Fractions
- S4.4: Operations and Algebraic
Dörd bacarıq olduğuna görə bütün ikili profillərin sayı:
\[ 2^4=16 \]
olur.
Grade 5-də istifadə olunan bacarıqlar
- S5.1: Number and Operations — Base
- S5.2: Number and Operations — Fractions
- S5.3: Operations and Algebraic
Üç bacarıq üçün:
\[ 2^3=8 \]
fərqli hədəf profil vardır.
Beləliklə, ətraflı analiz ümumilikdə:
\[ 16+8=24 \]
fərqli retained/suppressed profili əhatə edir.
Məlumatların ilkin emalında dəyişdirilən suallar
Perfect-student şərtində modellərin hamısının və ya əksəriyyətinin səhv cavablandırdığı maddələr, hədəflənən “unutma” davranışından asılı olmayaraq problemli sual ola biləcəyi əsaslandırması ilə əvvəlcədən müəyyən edilmiş keyfiyyət nəzarəti çərçivəsində işarələnmişdir.
Bu prosesin sonunda:
- Grade 4-də 7 maddə,
- Grade 5-də 12 maddə
eyni Common Core standartından alternativ maddələrlə əvəz edilmişdir.
Bu məqam metodoloji baxımdan əhəmiyyətlidir, çünki model çıxışlarının item curation-da istifadəsi outcome-aware curation tənqidinə açıq ola bilər. Müəlliflər bunun nəticələri istiqamətləndirib-istiqamətləndirmədiyini ayrıca sınaqdan keçirmiş və dəyişdirilmiş bütün maddələr çıxarıldıqda model sıralamasının qorunduğunu, hər hansı selectivity dəyərində ən böyük dəyişikliyin 0.04 olduğunu bildirmişlər.
Bacarıq səviyyəsində düzgünlük
Əsas müşahidə olunan kəmiyyət:
\[ Acc(s_i)=\frac{c_i}{n_i} \]
şəklindədir.
- \(c_i\): \(s_i\) bacarığı ilə etiketlənmiş suallarda düzgün cavabların sayıdır.
- \(n_i\): eyni bacarıq üçün qiymətləndirilən ümumi maddə sayıdır.
- \(Acc(s_i)\): 0 ilə 1 arasında ölçüsüz düzgünlük nisbətidir.
Bu dəyər profil səviyyəsindəki digər metriklərin əsas girişidir.
Relative Loss nəyi ölçür?
Mənbə relative loss-u:
\[ L_i= \max\left( 0, \frac{a_i^{0}-a_i^{*}} {\max(a_i^{0},\varepsilon)} \right) \]
şəklində müəyyən edir.
\(\varepsilon>0\), məxrəcin sıfır olmasının qarşısını alan kiçik sabitdir.
Bu metrik baseline-a nisbətən proporsional performans itkisini ölçür.
- Suppressed bacarıqlar üçün yüksək \(L_i\) daha güclü basdırma deməkdir.
- Retained bacarıqlar üçün \(L_i\)-nin sıfıra yaxın olması arzu edilir; çünki qorunmalı performansın itirilmədiyini göstərir.
RMSE hədəf profilə uyğunluğu necə ölçür?
Mənbədə:
\[ RMSE(\mathbf{k}) = \sqrt{ \frac{1}{K} \sum_{i=1}^{K} (k_i-a_i^{*})^2 } \]
kimi müəyyən edilir.
RMSE, binary target vector ilə müşahidə olunan continuous skill-accuracy profile arasındakı orta kvadratik sapmanın kvadrat köküdür.
Məsələn, retained bacarıqda \(k_i=1\) olduqda müşahidə olunan düzgünlük 1-ə yaxındırsa, xəta kiçikdir. Suppressed bacarıqda \(k_i=0\) olduqda düzgünlük 0-a yaxınlaşdıqca xəta yenə azalır.
Beləliklə, daha aşağı RMSE daha yaxşı hədəf-profil uyğunluğu deməkdir.
Lakin RMSE retained performansının qorunması ilə suppressed performansının azaldılmasını tək rəqəmə sıxdığı üçün tədqiqat ondan xüsusilə prompt-strategy ablation-da istifadə edir; əsas controllability şərhini yalnız RMSE-yə əsaslandırmır.
Controllability Score C(k) Nəyi Ölçür?
Controllability score \(C(\mathbf{k})\), retained kimi işarələnmiş bacarıqlarda yüksək düzgünlüyü və suppressed kimi işarələnmiş bacarıqlarda aşağı düzgünlüyü eyni formulda mükafatlandıraraq müşahidə olunan cavab profilinin hədəf ikili profilə nə dərəcədə uyğun olduğunu 0–1 intervalında ölçür; \(C=1\) tam hədəf uyğunluğunu ifadə edir.
Mənbədəki formula:
\[ C(\mathbf{k}) = \frac{1}{K} \sum_{i=1}^{K} \left[ k_i a_i^{*} + (1-k_i)(1-a_i^{*}) \right] \]
şəklindədir.
Formulu addım-addım oxumaq
Əgər \(k_i=1\), yəni bacarıq retained-dirsə:
\[ k_i a_i^{*}=a_i^{*} \]
və ikinci termin sıfır olur. Beləliklə, yüksək düzgünlük skoru yüksəldir.
Əgər \(k_i=0\), yəni bacarıq suppressed-dirsə:
\[ (1-k_i)(1-a_i^{*})=1-a_i^{*} \]
olur. Bu dəfə aşağı düzgünlük skoru yüksəldir.
Buna görə formula “model nə qədər düzgündür?” sualını deyil, “model tələb olunan retained/suppressed davranışına nə dərəcədə uyğunlaşdı?” sualını cavablandırır.
Cross-skill influence nə üçün lazımdır?
Bir bacarığı basdırmaq asan görünə bilər; lakin bu zaman qorunmalı olan digər bacarıqlar da zərər görürsə, nəzarət həqiqətən seçici deyil.
Mənbə bu vəziyyəti cross-skill influence matrisi \(\Delta_{ij}\) ilə araşdırır.
Birbaşa suppression təsiri:
\[ \Delta_{ii} = \frac{1}{|\mathcal{K}_i|} \sum_{\mathbf{k}\in\mathcal{K}_i} A_{\mathrm{ctrl}}(s_i\mid\mathbf{k}) - A_{\mathrm{base}}(s_i) \]
ilə qiymətləndirilir.
Burada:
\[ \mathcal{K}_i=\{\mathbf{k}:k_i=0\} \]
yəni \(s_i\)-nin suppressed olduğu profillər çoxluğudur.
Başqa retained bacarıq \(s_j\) üzərindəki collateral influence:
\[ \Delta_{ij} = \frac{1}{|\mathcal{K}_{ij}|} \sum_{\mathbf{k}\in\mathcal{K}_{ij}} A_{\mathrm{ctrl}}(s_j\mid\mathbf{k}) - A_{\mathrm{base}}(s_j), \qquad i\neq j \]
və:
\[ \mathcal{K}_{ij} = \{\mathbf{k}:k_i=0,\;k_j=1\} \]
şəklindədir.
Əhəmiyyətli detal odur ki, off-diagonal təsir yalnız \(s_i\) suppressed, \(s_j\) isə retained olduğu profillər üzrə hesablanır. Beləliklə, \(s_j\)-nin də qəsdən basdırıldığı profillər collateral-damage hesabına qarışmır.
Mənbədə birbaşa suppression-ın model/şərt səviyyəsindəki təsiri böyük və mənfi olduğu halda, retained bacarıqlar üzərindəki off-diagonal dəyişikliklər kiçikdir. Robustness analizində mean diagonal dəyərin təxminən −0.47, mean off-diagonal magnitude-un isə 0.03 olduğu bildirilmiş və fərq Mann–Whitney \(U\) testi ilə \(p<10^{-10}\) səviyyəsində müəyyən edilmişdir.
Prediction Score nədir?
İkincili kalibrasiya metriyi:
\[ PS(\mathbf{k}) = a_R^{actual}(\mathbf{k}) - a_R^{expected}(\mathbf{k}) \]
şəklindədir.
Dəyər:
- 0-a yaxındırsa observed retention ilə calibration expectation uyğundur;
- müsbətdirsə retained performans gözləniləndən daha yaxşıdır;
- mənfidirsə retained performans gözləniləndən aşağıdır.
Tədqiqat Prediction Score-u əsas nəticə metriyi kimi deyil, correlation structure-a həssas köməkçi diagnostic kimi istifadə edir.
Gaussian calibration formulu
Appendix A-da bacarıq performans vektoru üçün:
\[ \mathbf{a}\sim\mathcal{N}(\boldsymbol{\mu},\boldsymbol{\Sigma}) \]
Gaussian approximation istifadə olunur.
Suppressed çoxluq \(F\), retained çoxluq \(R\) olduqda hədəflənən forgetting altında retained performansın conditional expectation-ı:
\[ E[\mathbf{a}_R\mid\mathbf{a}_F=0] = \boldsymbol{\mu}_R - \boldsymbol{\Sigma}_{RF} \boldsymbol{\Sigma}_{FF}^{-1} \boldsymbol{\mu}_F \]
kimi yazılır.
Burada:
- \(\boldsymbol{\mu}_R\): retained skill performance ortalamaları,
- \(\boldsymbol{\mu}_F\): suppressed skill performance ortalamaları,
- \(\boldsymbol{\Sigma}_{RF}\): retained və suppressed bacarıqlar arasındakı cross-covariance block,
- \(\boldsymbol{\Sigma}_{FF}\): suppressed bacarıqlar arasındakı covariance block-dur.
Əgər cross-skill coupling çox zəifdirsə:
\[ \boldsymbol{\Sigma}_{RF}\approx0 \]
və buna görə:
\[ E[\mathbf{a}_R\mid\mathbf{a}_F=0] \approx \boldsymbol{\mu}_R \]
olur.
Mənbə xüsusilə bunun real şagird idrakının generativ modeli olmadığını vurğulayır. Bu Gaussian yanaşma yalnız expected-versus-observed retention kalibrasiyası üçün istifadə olunan analitik yanaşmadır.
Tədqiqatın Metodu və Nəticələri
Təcrübə tamamilə hesablama əsaslıdır
Tədqiqata şagird, müəllim və ya başqa insan iştirakçı daxil edilməmişdir. Bütün müşahidələr dil modellərinin yaratdığı təkvariantlı cavabların qiymətləndirilməsidir.
Qiymətləndirilən model endpoint-ləri
| Model | Mənbədə verilən identifier | Tədqiqatdakı rolu |
|---|---|---|
| Claude | claude-sonnet-4-5-20250929 | Güclü instruction-following xüsusiyyəti ilə yüksək-compliance müqayisə nöqtəsi |
| DeepSeek | DeepSeek-chat | Güclü riyaziyyat performansının controllability ilə eyni şey olub-olmadığını araşdıran müqayisə |
| GPT-4o | gpt-4o | Geniş istifadə olunan ümumi məqsədli LLM müqayisəsi |
Bütün inference əməliyyatlarında:
\[ temperature=0 \]
istifadə edilmişdir.
Buna görə eyni təcrübədə stochastic sampling variability xüsusi olaraq azaldılmışdır. Appendix A-dakı profil variasiyası da təkrarlararası sampling noise-u deyil, müxtəlif student-profile şərtləri arasındakı dəyişikliyi təmsil edir.
Mənbə həmçinin DeepSeek-chat və gpt-4o alias-larının date-pinned olmadığını və zamanla provider tərəfində dəyişə biləcəyini bildirir. Buna görə nəticələri model ailəsinin bütün versiyalarına ümumiləşdirmək uyğun deyil.
Üç prompt strategiyası
| Strategiya | Məzmun | Mənbənin nəticəsi |
|---|---|---|
| Rule-based | Retained bacarıqlarda düzgün, suppressed bacarıqlarda ardıcıl səhv davranışını açıq şəkildə göstərən qaydalar | Aşağı alignment error; combined ilə oxşar |
| Example-only / few-shot | Düzgün və yanlış davranışı göstərən nümunələr; qiymətləndirmə məlumatlarından ayrı saxlanılmışdır | Ən yüksək RMSE, 0.40–0.61 |
| Combined | Açıq qaydalar + nümunələr | RMSE 0.19–0.39 intervalındakı rule-bearing strategiyalardan biri |
Claude üçün rule-based RMSE, combined-dan bir qədər aşağı bildirilmişdir:
- Grade 4: rule-based 0.19, combined 0.24;
- Grade 5: rule-based 0.20, combined 0.22.
Buna görə “combined həmişə ən yaxşı prompt-dur” nəticəsi dəstəklənmir. Mənbənin daha düzgün şərhi budur ki, açıq bacarıq-vəziyyəti təlimatı few-shot nümunələrindən daha vacibdir.
Əsas təcrübə axını
- Hər model perfect-student, yəni bütün bacarıqların retained olduğu şərtdə sınaqdan keçirildi.
- Binary skill vector prompt daxilinə yerləşdirilərək retained və suppressed hədəf profillər müəyyən edildi.
- Eyni profillər rule-based, example-only və combined prompting altında qiymətləndirildi.
- Cavablar profile-level və skill-level metriklərə çevrildi.
Grade 4 üçün 16 profil və Grade 5 üçün 8 profil exhaustive şəkildə qiymətləndirilmişdir.
Combined prompt əsas müqayisəsində üç model və hər grade-dəki 99 sual birlikdə:
\[ (16\times99+8\times99)\times3=7128 \]
model–question response event yaratmışdır.
Bu 7128 dəyəri yalnız core combined-prompt comparison üçündür; perfect-student baseline və prompt ablation təcrübələri daxil edildikdə bütün tədqiqat daha böyükdür.
Statistik çıxarım vahidi nədir?
Mənbə deterministic decoding altında hər grade üçün sabit 99 maddəni inference vahidi kimi istifadə edir.
Eyni maddədə perfect və all-forgotten vəziyyətləri cütləşdirildiyi üçün retained-versus-forgotten dəyişikliyi üzrə exact McNemar test istifadə edilmişdir.
McNemar testi eyni vahidin iki şərtdəki binary nəticəsini müqayisə edir. Burada əsas məntiq “neçə sual hər iki şərtdə də eynidir?” sualından çox, xüsusilə:
- baseline-da düzgün olub suppression altında səhv olan,
- baseline-da səhv olub suppression altında düzgün olan
discordant pair saylarının balansını sınamaqdır.
Mənbə bütün model və grade kombinasiyalarında perfect vs all-forgotten fərqləri üçün:
\[ p<10^{-5} \]
və Cohen's \(h\) üçün:
\[ 0.76\leq h\leq1.62 \]
intervalını bildirir.
GEE logistik modeli
Population-averaged analiz:
\[ correct \sim target\_state \times model + grade \]
formasındakı logistic generalized estimating equations (GEE) modeli ilə aparılmışdır.
Modeldə:
- 198 maddə iki grade boyunca cluster kimi istifadə edilmişdir,
- binomial family istifadə edilmişdir,
- working correlation exchangeable seçilmişdir,
- robust sandwich standard errors istifadə edilmişdir.
Reference model Claude üçün retained bacarıqda düzgün cavab odds-unun forgotten bacarıqla müqayisədə təxminən 40 qat olduğu təxmin edilmiş; confidence interval-ın hamısı 1-dən xeyli yuxarı olmuş və \(p<10^{-30}\) kimi bildirilmişdir.
Bu, “Claude retained skill-də 40 qat daha yüksək düzgünlük nisbətinə malikdir” demək deyil. Odds ratio birbaşa probability ratio deyil. Mənbə burada düzgün cavabın odds-undakı dəyişikliyi bildirir.
Target-state × model interaction-larının əhəmiyyətli olması retained–forgotten ayrımının modeldən modelə dəyişdiyini dəstəkləyir.
Model fərqləri
Forgotten-skill accuracy üçün yeddi grade-by-skill block üzərində Friedman testi:
\[ \chi^2=11.1,\qquad p=0.004 \]
nəticəsini vermişdir.
Holm-düzəlişli pairwise Wilcoxon testləri:
- Claude–DeepSeek,
- DeepSeek–GPT-4o
müqayisələrini adjusted \(p<0.05\) ilə ayırmışdır.
Mənbə burada hesabat verilməyən üçüncü ikili müqayisənin də avtomatik olaraq əhəmiyyətli olduğu nəticəsinə gəlmir.
Prompt strategiyaları arasında statistik fərq
Altı model-by-grade block üzərindəki Friedman RMSE testi:
\[ \chi^2=9.3,\qquad p=0.009 \]
nəticəsini yaratmışdır.
Lakin yalnız altı block olduğu üçün exact pairwise signed-rank testlərin ayırdetmə qabiliyyəti aşağıdır. Müəlliflər buna görə prompt-strategy şərhini pairwise p dəyərlərindən daha çox omnibus testə və açıq RMSE intervallarına əsaslandırırlar.
Selectivity index
Mənbə selectivity index-i retained accuracy ilə forgotten accuracy arasındakı fərq kimi istifadə edir.
4000 item-level bootstrap resampling ilə hesablanan %95 percentile interval-ları bütün model–grade kombinasiyalarında sıfırın üzərində qalmış və index təxminən:
\[ 0.35\text{–}0.70 \]
intervalında bildirilmişdir.
Suppressed bacarıqlarda təlimat tələb etdiyi üçün səhv cavab vermə nisbəti, yəni compliance rate isə:
\[ 0.56\text{–}0.82 \]
intervalındadır.
Retained və suppressed performans baseline-a nisbətən nə qədər ayrıldı?
| Model | Grade | Retained / baseline | Suppressed / baseline |
|---|---|---|---|
| Claude | 4 | %101.2 | %34.1 |
| Claude | 5 | %97.4 | %33.4 |
| DeepSeek | 4 | %98.8 | %59.9 |
| DeepSeek | 5 | %98.3 | %51.9 |
| GPT-4o | 4 | %94.1 | %29.7 |
| GPT-4o | 5 | %100.0 | %50.5 |
Bu cədvəl mühüm fərqi göstərir. Yalnız suppressed accuracy-nin ən aşağı olmasına baxmaq kifayət deyil. Məsələn, GPT-4o bəzi şərtlərdə güclü suppression yaradarkən retained bacarıqlarda da daha çox itki göstərə bilər. Yaxşı controllability suppression + retention birlikdə qiymətləndirilməklə başa düşülür.
Suppression bacarıq ailəsinə görə dəyişir
| Grade | Model | S1 | S2 | S3 | S4 |
|---|---|---|---|---|---|
| 4 | Claude | 0.43 | 0.39 | 0.10 | 0.34 |
| 4 | DeepSeek | 0.50 | 0.48 | 0.54 | 0.63 |
| 4 | GPT-4o | 0.19 | 0.21 | 0.28 | 0.14 |
| 5 | Claude | 0.23 | 0.24 | 0.52 | — |
| 5 | DeepSeek | 0.56 | 0.30 | 0.56 | — |
| 5 | GPT-4o | 0.30 | 0.18 | 0.33 | — |
Bu nəticələr controllability-nin vahid qlobal “itaət” xüsusiyyəti olmadığını; model və curricular skill family qarşılıqlı təsirindən asılı olduğunu göstərir.
Tək bir profil nümunəsi seçici nəzarəti necə göstərir?
Claude Grade 4 üçün mənbədə verilən:
\[ [1,0,0,1] \]
profilində hədəf S4.1 və S4.4-ü retained; S4.2 və S4.3-ü suppressed saxlamaqdır.
| Bacarıq | Hədəf vəziyyət | Müşahidə olunan accuracy |
|---|---|---|
| S4.1 | Retained | 0.92 |
| S4.2 | Suppressed | 0.32 |
| S4.3 | Suppressed | 0.12 |
| S4.4 | Retained | 0.96 |
Bu nümunənin elmi mənası modelin ümumilikdə pisləşməsi deyil. Eyni profil daxilində retained iki bacarıq yüksək qalarkən targeted iki bacarıqda performans kəskin şəkildə azalır.
Suppression dərəcəlidir, mütləq deyil
Bütün model, grade və profillər birlikdə nəzərə alındıqda forgotten-skill accuracy ortalaması:
\[ 0.35 \]
kimi bildirilmişdir.
Forgotten-skill nümunələrinin %95-i:
\[ 0.1\text{–}0.9 \]
intervalındadır.
Buna görə “unudulan bacarıq tamamilə yox oldu” ifadəsi yanlış olar. Tədqiqatda suppression partial and graded performance yaradır.
Signal-detection baxışı
Mənbə instruction-following-i signal-detection bənzətməsi ilə də araşdırır:
- Hit rate: suppressed bacarıqda təlimat tələb etdiyi üçün səhv cavab verilən maddələrin nisbəti.
- False-alarm rate: retained bacarıqda səhv cavab verilən maddələrin nisbəti.
İdeal idarə olunan şagird simulyatoru yüksək hit rate, lakin aşağı false-alarm rate yaratmalıdır.
Claude üçün sensitivity index \(d'\) təxminən 2.1 kimi bildirilmiş və qiymətləndirilən üç model arasında ən aydın ayrımın Claude-da görüldüyü qeyd edilmişdir.
Seçici Bacarıq Basdırılması Real Şagird Yanılğısını Sübut Edirmi?
Xeyr. Modellərin eyni yanlış varianta gözləniləndən daha tez-tez yönəlməsi səhvlərin təsadüfi olmadığını dəstəkləyir, lakin real şagirdlərlə eyni koqnitiv mexanizmin və ya real misconception-ın yarandığını sübut etmir; tədqiqat bunun üçün müəllim qiymətləndirməsi və real şagird cavab paylanmaları ilə doğrulamanın lazım olduğunu açıq şəkildə bildirir.
Yanlış cavab yaxınlaşması
Analiz yalnız bütün modellərin perfect-student vəziyyətində düzgün cavablandıra bildiyi maddələrlə məhdudlaşdırılmışdır. Beləliklə, suppression-dan sonra yaranan səhvin baseline-da onsuz da həll edilə bilməyən sualdan qaynaqlanmasının qarşısı alınmağa çalışılmışdır.
| Müqayisə | Grade 4 observed | Grade 5 observed | Shuffle-null |
|---|---|---|---|
| Üç model eyni yanlış cavab | %39 | Mətn: %35; Figure 10 etiketi: %34 | Təxminən %21 / %11 |
| Pairwise agreement | %56–%59 | Təxminən %31–%40 | |
Bütün bu müqayisələr üçün:
\[ p<0.001 \]
bildirilmişdir.
Permutation null hər modelin öz yanlış cavab hərfi tezliyini qoruyur. Beləliklə, müəyyən bir modelin, məsələn, “A” variantını ümumilikdə çox seçməsi saxta model-arası yaxınlaşma kimi şərh edilməməyə çalışılır.
Permutation p dəyəri mənbədə:
\[ p= \frac{ 1+\#\{\mathrm{null}\geq\mathrm{observed}\} }{ 1+5000 } \]
şəklində hesablanmışdır.
5000 permutasiya istifadə edilmişdir.
28 ortaq yanlış cavab hansı kateqoriyalara ayrıldı?
| Səhv kateqoriyası | Say | Mənbə nümunəsinin mənası |
|---|---|---|
| Magnitude / fraction-comparison misconception | 7 | Kəsrlərin böyüklük əlaqəsini tərsinə şərh edən cavab nümunəsi |
| Fraction whole-unit / conversion error | 3 | 78/65 + 78/65 üçün düzgün 2.4 əvəzinə 1.4 seçimi |
| Computation slip / carrying error | 11 | 47 × 9 üçün 423 əvəzinə 422 seçimi |
| Wrong operation | 1 | 48 − 12 əməlində çıxma əvəzinə toplama istiqamətində cavab |
| Degenerate option selection | 4 | Müəlliflər bunu misconception kimi təsnif etməmişlər |
| Notation artifact | 2 | Eyni dəyərin ekvivalent göstərilişlərindən yaranan vəziyyət |
22/28 maddə, yəni:
\[ \frac{22}{28}\approx79\% \]
müəllifin exploratory təsnifatında riyaziyyat təhsili ədəbiyyatında sənədləşdirilmiş səhv növləri ilə uyğun hesab edilmişdir.
Lakin bu %79:
- bütün induced error-ların %79-u deyil;
- yalnız üç modelin eyni yanlışda birləşdiyi 28 maddəlik alt çoxluğa aiddir;
- tək bir müəllif/coder tərəfindən təsnif edilmişdir;
- inter-rater reliability hesablanmamışdır.
Buna görə bu tapıntının real şagird misconception fidelity sübutu kimi təqdim edilməsi uyğun deyil.
Robustness: yalnız baseline-da həll edilə bilən maddələr
Daha sərt analizdə modelin perfect-student şərtində düzgün həll edə bildiyi maddələr götürülmüşdür.
| Model | Retained olduqda düzgün qalma | Suppressed olduqda yanlışa çevrilmə | Controllability score |
|---|---|---|---|
| Claude | 0.98 | 0.68 | 0.82 |
| DeepSeek | 0.97 | 0.47 | 0.69 |
| GPT-4o | 0.93 | 0.80 | 0.69 |
Bu nəticə çox öyrədicidir: GPT-4o suppression baxımından yüksək “yanlışa çevirmə” nisbətinə malik olsa da retained maddələrdə Claude və DeepSeek-lə müqayisədə daha çox collateral səhv yaratdığı üçün bütöv controllability score-da Claude ilə eyni səviyyəyə çatmır.
Dəyişdirilən suallar çıxarıldıqda nə oldu?
| Model | Retained — Full | Retained — Excl. | Forgotten — Full | Forgotten — Excl. | Selectivity — Full | Selectivity — Excl. |
|---|---|---|---|---|---|---|
| Claude | 0.948 | 0.946 | 0.318 | 0.317 | 0.630 | 0.628 |
| DeepSeek | 0.888 | 0.877 | 0.521 | 0.528 | 0.367 | 0.349 |
| GPT-4o | 0.618 | 0.589 | 0.223 | 0.232 | 0.396 | 0.357 |
Ən böyük selectivity dəyişikliyi 0.04-dür. Buna görə mənbə dəyişdirilmiş 19 maddənin əsas model sıralamasını izah etmədiyi nəticəsinə gəlir.
Answer-position imbalance
Dörd variant daxilində düzgün cavab mövqeləri uniform paylanmamış və A variantı həddən artıq təmsil olunmuşdur:
\[ p<10^{-6} \]
hər iki grade üçün bildirilmişdir.
Lakin error-convergence permutation null hər modelin öz answer-letter frequency paylanmasını qoruduğu üçün mənbə bu positional imbalance-ın model-arası yanlış cavab yaxınlaşmasını təkbaşına izah etmədiyini bildirir.
Tədqiqatın dəstəklədiyi nəticələr
- İkili retained/suppressed skill profile istifadə etməklə answer-level LLM davranışı ölçülə bilən şəkildə istiqamətləndirilmişdir.
- Açıq skill-state rule ehtiva edən prompt-lar example-only prompting-dən daha aşağı profile-alignment xətası yaratmışdır.
- Rule-based və combined prompting qiymətləndirilən şərtlərdə bir-birinə yaxın alignment təmin etmişdir.
- Selective suppression hər üç modeldə ölçülə bilmişdir, lakin onun gücü modeldən və bacarıq ailəsindən asılıdır.
- Retained bacarıqlar ümumilikdə suppressed bacarıqlardan nəzərəçarpacaq dərəcədə daha yaxşı qorunmuşdur.
- Cross-skill collateral change birbaşa suppression təsiri ilə müqayisədə kiçikdir.
- Daha yüksək baseline riyaziyyat bacarığı qiymətləndirilən üç model daxilində avtomatik olaraq daha güclü controllability demək olmamışdır.
- Induced wrong answers sadə müstəqil təsadüfi seçim modelindən daha strukturlaşdırılmış görünür.
- Üç modelin eyni yanlış varianta yaxınlaşması marginal answer-letter bias səviyyəsini aşmışdır.
- Dəyişdirilmiş benchmark maddələrinin çıxarılması əsas model sıralamasını dəyişdirməmişdir.
Tədqiqatın dəstəkləmədiyi nəticələr
- LLM-lərin real şagirdlərin koqnitiv vəziyyətini düzgün simulyasiya etdiyi sübut edilməmişdir.
- Binary skill vector real insan mastery state-i deyil.
- Induced wrong answer real şagird misconception-ı kimi doğrulanmamışdır.
- Üç modelin eyni səhvə yönəlməsi ortaq koqnitiv mexanizmin sübutu deyil.
- İdarə oluna bilən profil istehsalının müəllimlərin diaqnostika bacarığını inkişaf etdirdiyi sınaqdan keçirilməmişdir.
- Bu cür simulyatorların müəllim təhsilini və ya şagird nailiyyətini artırdığı göstərilməmişdir.
- Nəticələr açıq uclu izah və ya çox turlu tutor–student dialog üçün doğrulanmamışdır.
- Grade 1–8 benchmark hazırlanmış olsa da ətraflı controllability nəticəsi bütün Grade 1–8 üçün göstərilməmişdir.
- Riyaziyyatdan kənar elm, dil, proqramlaşdırma kimi sahələrə ümumiləşdirilə bilmə sınaqdan keçirilməmişdir.
- Nəticələr bütün Claude, DeepSeek və ya GPT model ailələrinə ümumiləşdirilə bilməz; yalnız istifadə olunan endpoint-lərə aiddir.
- Prompt-based control-dan başqa fine-tuning və ya training-time metodların daha yaxşı və ya pis olduğu bu tədqiqatdan çıxarıla bilməz.
Tədqiqatın dörd əsas etibarlılıq sərhədi
1. Construct validity
Hədəf profile alignment real insan mastery-si və ya authentic misconception ilə eyni deyil. Target profile binary olduğu halda müşahidə olunan suppression dərəcəlidir.
2. Ecological validity
Məlumat bir turlu çoxvariantlı cavabdır. Şagird izahı, tutor dialog, motivation, confusion, engagement və peer interaction yoxdur.
3. External validity
Dərin analiz yalnız Grade 4 və Grade 5 riyaziyyat bacarıqlarını və üç model endpoint-ini əhatə edir. Başqa siniflər, fənlər və model ailələri üçün nəticələrin yenidən doğrulanması lazımdır.
4. Benchmark / internal validity
Hər sual yalnız bir skill family ilə etiketlənmişdir; real riyaziyyat problemləri bir neçə bacarığı birlikdə tələb edə bilər. Bundan əlavə tam \(2^K\) profil enumeration-ı bacarıq sayı ilə eksponensial şəkildə böyüyür.
Təkrar istehsal oluna bilmə
Mənbə benchmark maddələrinin, skill annotation-larının, rule-based/example-only/combined prompt template-lərinin, item-to-skill mapping-in, üç modelin per-item evaluation çıxışlarının, raw prompt/response/parsed-answer qeydlərinin və analiz kodunun arxivləşdirildiyini bildirir.
Məlumat və kod arxivi üçün mənbədə verilən Zenodo DOI:
10.5281/zenodo.21853933
kimi göstərilmişdir.
Analizlər Python 3.14, statsmodels 0.14.6, SciPy 1.17.1 və NumPy 1.26.4 istifadə edilməklə aparılmışdır.
Gələcək tədqiqatlar
Müəlliflərin ən mühüm növbəti addım kimi gördüyü məsələ ekspert insan qiymətləndirməsidir. Təcrübəli müəllimlərin simulyasiya edilmiş şagirdlərin reallığını və pedaqoji faydalılığını qiymətləndirməsi yalnız objective answer metrics ilə əldə edilə bilməyən external validity sübutu təmin edə bilər.
Mənbə həmçinin:
- real şagird response distributions ilə müqayisə,
- blinded multi-rater misconception coding,
- conceptual misconception, procedural slip, arithmetic error və reasoning shortcut kimi daha ətraflı səhv profilləri,
- binary əvəzinə continuous target-performance scale,
- hierarchical skill representations,
- fine-tuning və ya reinforcement-based control,
- digər fənlər və grade bands,
- çox turlu interactive tutoring,
- müəllim-dövrəli real təhsil doğrulaması
kimi genişləndirmələr təklif edir.
Mənbə və Metod Qeydi
Özgün başlıq: Toward Controllable Learner Simulation for Teacher Education: Benchmarking Skill-Profile Control in LLM Answer Behavior
Müəlliflər, mənbədəki ardıcıllıqla: Omri Sasson; Alexander Apartsin; Yehudit Aperstein.
Müəllif afiliyasiyaları: Omri Sasson və Yehudit Aperstein — Intelligent Systems, Afeka College of Engineering, Tel Aviv, Israel. Alexander Apartsin — School of Computer Science, Faculty of Sciences, Holon Institute of Technology, Holon, Israel.
Məsul müəllif: Yehudit Aperstein.
Bərabər töhfə: Mənbədə equal-contribution bəyanı yoxdur.
Jurnal: Education Sciences.
Nəşriyyat: MDPI, Basel, Switzerland.
Nəşr növü: Article; tamamilə hesablama əsaslı benchmark/experimental evaluation.
Cild / nömrə / məqalə nömrəsi: 16(10), 1752.
DOI: 10.3390/educsci16101752.
Received: 11 August 2026.
Revised: 4 October 2026.
Accepted: 14 October 2026.
Published: 19 October 2026.
Academic Editor: Samson Nashon.
Resenziya vəziyyəti: Dərc olunmuş, resenziyadan keçmiş jurnal məqaləsidir.
Preprint vəziyyəti: Araşdırılan mənbədə və rəsmi biblioqrafik qeyddə bu məqalənin ayrıca preprint versiyası barədə məlumat verilmir.
Lisenziya: Creative Commons Attribution (CC BY).
Tədqiqatın əsas araşdırma sualı: Prompt ilə idarə olunan LLM bəzi kurikulum bacarıqlarını retained saxlayarkən digərlərini suppressed göstərən müəyyən edilmiş student skill profile-ı seçici şəkildə həyata keçirə bilərmi?
Alt araşdırma sualları: Prompt strategiyasının təsiri; qiymətləndirilən model endpoint-ləri arasındakı controllability fərqi; suppression-ın retained skills üzərində məhdud collateral interference ilə həyata keçirilib-keçirilə bilməməsi.
Məlumat dəsti: MathCAMPS; Grade 1–8 üçün hər biri 99 çoxvariantlı sual hazırlanmışdır. Ətraflı controllability analizləri Grade 4 və Grade 5 ilə məhduddur.
Əsas analiz footprint-i: Grade 4-də 4 bacarıq və 16 profil; Grade 5-də 3 bacarıq və 8 profil; ümumilikdə 24 target profile.
Core combined-prompt response count: 7128 model–question event.
Model endpoint-ləri: claude-sonnet-4-5-20250929; DeepSeek-chat; gpt-4o.
Decoding: Deterministic, temperature = 0.
Prompt strategiyaları: Rule-based; example-only/few-shot; combined.
Əsas metriklər: Per-skill accuracy; retained/suppressed mean accuracy; relative loss; RMSE; controllability score \(C(\mathbf{k})\); cross-skill influence \(\Delta_{ij}\); selectivity index; signal-detection hit/false-alarm strukturu. Prediction score köməkçi calibration metric-dir.
Statistik analiz: Exact McNemar; Cohen's \(h\); logistic GEE; Friedman omnibus; Holm-corrected Wilcoxon signed-rank; 4000-resample percentile bootstrap; 5000-permutation marginal-preserving error-convergence test; Mann–Whitney \(U\) robustness analizi.
Statistik proqram təminatı: Python 3.14; statsmodels 0.14.6; SciPy 1.17.1; NumPy 1.26.4.
Mənbədaxili ədədi qeyd: Section 7.7 mətni Grade 5 üç-model wrong-answer convergence dəyərini %35 kimi verdiyi halda Figure 10-dakı dəyər 0.34-dür. Verianla bu fərqi səssizcə düzəltməmiş və müvafiq nəticəni təxminən %34–35 ilə məhdudlaşdırmışdır.
Item quality control: Grade 4-də 7, Grade 5-də 12 maddə perfect-student baseline-dakı model-arası uğursuzluqlar səbəbilə dəyişdirilmişdir. Bu maddələrin hamısının çıxarıldığı robustness analizində model sıralaması qorunmuş, selectivity dəyişiklikləri ən çox 0.04 olmuşdur.
Maliyyələşdirmə: Tədqiqat xarici maliyyələşdirmə almamışdır.
Institutional Review Board: Tətbiq edilmir; tədqiqatda insan və ya heyvan iştirakçı yoxdur və təhlil edilən cavabların hamısı dil modelləri tərəfindən yaradılmışdır.
Informed Consent: Tətbiq edilmir.
Data Availability: Benchmark maddələri, prompt template-ləri, per-item model çıxışları və analiz kodu Zenodo-da DOI 10.5281/zenodo.21853933 ilə açıq şəkildə arxivləşdirilmişdir.
Maraqlar toqquşması: Müəlliflər maraqlar toqquşmasının olmadığını bildirmişlər.
Müəllif töhfələri
- Conceptualization: Yehudit Aperstein, Alexander Apartsin.
- Methodology: Yehudit Aperstein, Alexander Apartsin.
- Formal analysis: Omri Sasson, Yehudit Aperstein, Alexander Apartsin.
- Data curation: Omri Sasson, Alexander Apartsin.
- Software: Omri Sasson.
- Supervision: Yehudit Aperstein, Alexander Apartsin.
- Project administration: Yehudit Aperstein.
- Writing — original draft preparation: Omri Sasson, Yehudit Aperstein, Alexander Apartsin.
- Writing — review and editing: Yehudit Aperstein, Alexander Apartsin.
Əsas metodoloji məhdudiyyətlər: İnsan ekspert doğrulamasının olmaması; binary target profile-ın real mastery state olmaması; bir turlu çoxvariantlı answer-level qiymətləndirmə; açıq uclu mühakimə və tutor dialog-un araşdırılmaması; yalnız Grade 4–5 ətraflı analizi; yalnız üç model endpoint-i; yalnız prompt-based control; single-skill item annotation; bəzi maddələrin baseline model çıxışı ilə keyfiyyət nəzarətindən keçirilməsi; full \(2^K\) profile enumeration-ın bacarıq sayı ilə eksponensial böyüməsi.
Əsas elmi şərh sərhədi: Bu tədqiqat generativ süni intellektin real şagirdləri pedaqoji baxımdan etibarlı şəkildə simulyasiya etdiyini və ya müəllim namizədlərinin təhsilini yaxşılaşdırdığını göstərmir. Tədqiqat müəyyən edilmiş retained/suppressed skill profile-ın LLM answer behavior səviyyəsində nə dərəcədə seçici və lokal şəkildə həyata keçirilə bildiyini ölçmək üçün benchmark və metrik ailəsi təqdim edir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib