


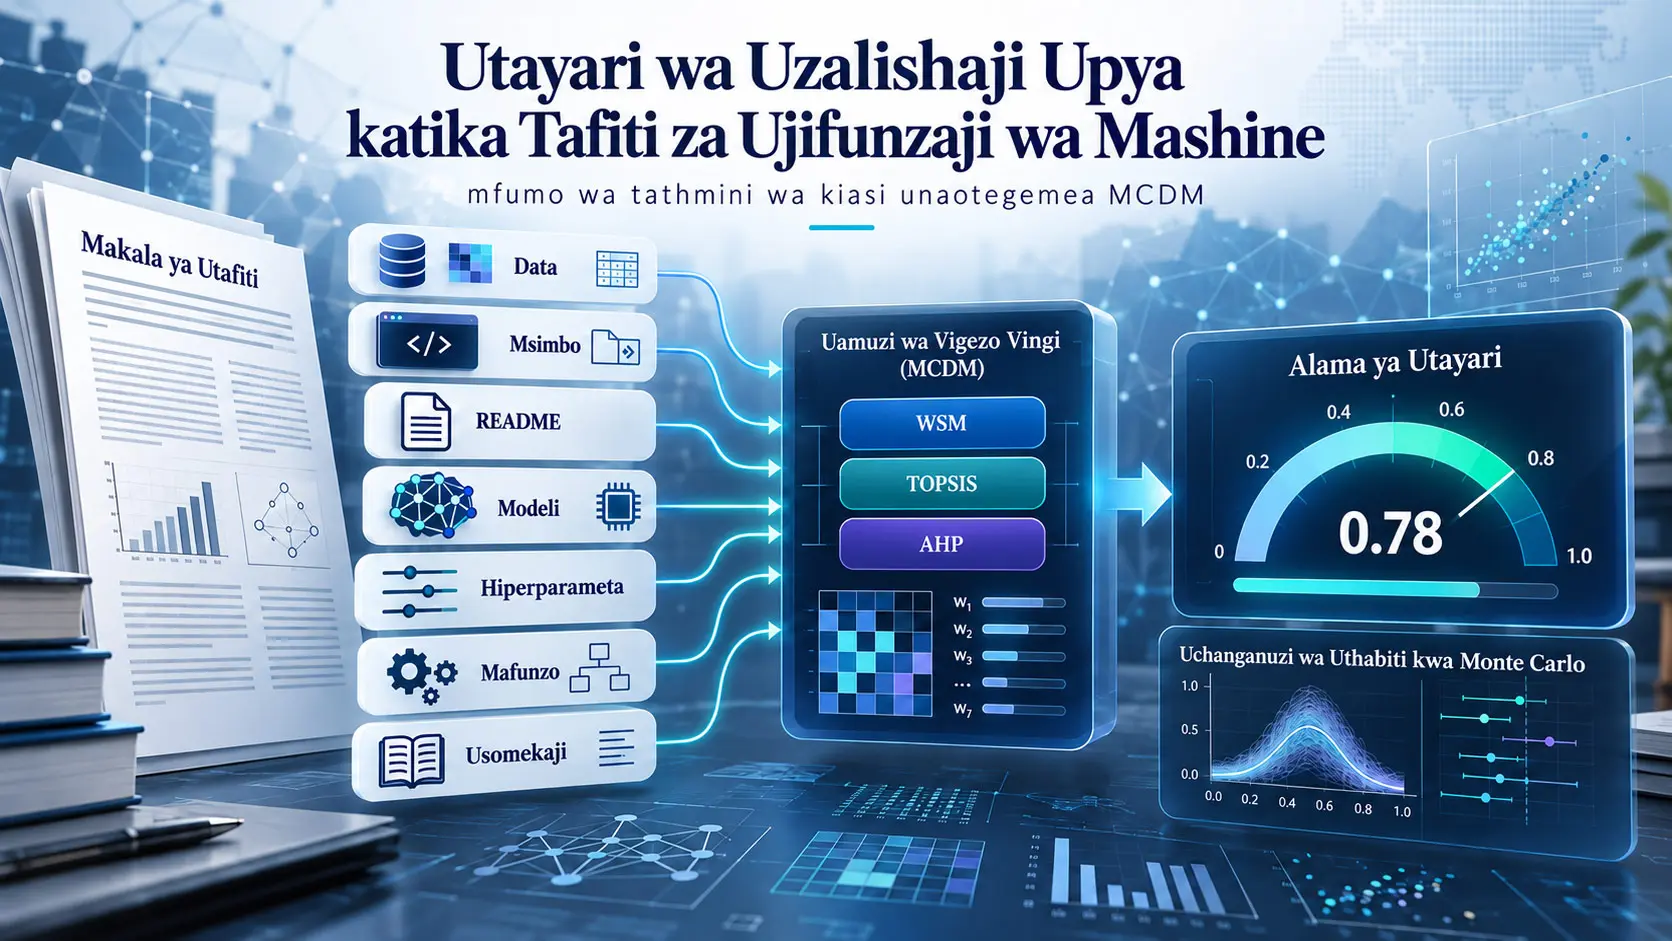
Utafiti huu unapendekeza mfumo wa tathmini wa kupima, bila kuendesha upya majaribio, kiwango ambacho makala iliyochapishwa na artefakti za utafiti zinazohusiana nayo ziko tayari kwa uzalishaji upya wa kiwango cha R1 kwa njia inayoweza kupimwa kwa kiasi, kwa kutumia mfumo unaotegemea Uamuzi wa Vigezo Vingi (Multi-Criteria Decision Making, MCDM). Utayari wa uzalishaji upya wa R1 ni dhana ya tathmini inayoonyesha kiwango ambacho utafiti hutoa data, msimbo, modeli iliyofunzwa na maelezo ya kimethodolojia yanayoweza kusaidia kupatikana tena kwa matokeo yale yale kwa kutumia data ile ile, msimbo ule ule, modeli ile ile na mazingira yale yale ya ukokotoaji. Mfumo hutumia vigezo saba: upatikanaji wa data, upatikanaji wa msimbo, kuwepo kwa README, kutolewa kwa modeli iliyofunzwa, maelezo ya hiperparameta, maelezo ya mchakato wa mafunzo na usomekaji wa makala. Vigezo hupewa alama kwa rubriki ya mpangilio, hurekebishwa hadi katika masafa ya [0,1], na kuunganishwa kuwa alama moja ya utayari kwa kutumia Mfano wa Jumla Yenye Uzani (Weighted Sum Model, WSM) na Mbinu ya Kupanga Mapendeleo kwa Kufanana na Suluhisho Bora (TOPSIS).
Katika kuendeleza mfumo huo, seti mbili zilizopo za data za uzalishaji upya zilitumika. Kwa tathmini kuu, makala 139 zilichaguliwa kwa nasibu kutoka seti iliyosafishwa ya makala 215 ya Olszewski na wenzake kwa kutumia mbinu ya sampuli ya Cochran yenye marekebisho ya idadi yenye ukomo. Kila makala ilipewa alama kwa kujitegemea na watafiti pamoja na ChatGPT kwa vigezo saba; wastani wa tathmini hizo mbili ulitumika kama alama ya mwisho ya kigezo. Wastani wa weighted Cohen kappa kati ya tathmini za binadamu na zile zilizosaidiwa na modeli uliripotiwa kuwa \(\kappa=0.96\).
Katika tathmini ya msingi iliyotumia uzani sawa kwa vigezo, WSM na TOPSIS zilitoa matokeo yale yale ya uainishaji wa pande mbili. Kwa kizingiti cha uamuzi cha 0,5, wakati mfumo ulilinganishwa na lebo rejea ya uzalishaji upya, usahihi ulikuwa 0,64, precision 0,40, recall 0,70 na alama ya F1 0,51. Matokeo haya yanaonyesha kuwa mfumo unaweza kutambua sehemu muhimu ya makala zinazoweza kuzalishwa upya, lakini pia kwamba baadhi ya makala zinazoonekana “tayari” zinaweza kushindwa wakati wa uzalishaji upya wa vitendo.
Kikomo muhimu zaidi cha tafsiri: Alama inayopatikana si ushahidi kwamba utafiti umefanikiwa kuzalishwa upya. Mfumo hauendeshi majaribio; hupima kiwango cha maandalizi kinachoonekana katika makala na artefakti zilizounganishwa nayo. Utegemezi uliojificha, skripti zisizofanya kazi, kutolingana kwa maunzi au programu, operesheni za GPU zisizo deterministiki, au data isiyoweza kufikiwa kwa vitendo vinaweza kuzuia uzalishaji upya halisi licha ya alama ya juu ya utayari. Aidha, alama ya chini ya utayari haimaanishi kuwa ubora wa kisayansi, ubunifu au athari ya utafiti ni ndogo.
Kwa nini uzalishaji upya katika ujifunzaji wa mashine unakuwa tatizo la pekee?
Katika tafiti za ujifunzaji wa mashine, kupata tena matokeo yaliyochapishwa hakutegemei tu kujua usahihi wa mwisho, alama ya F1 au thamani ya hasara iliyoripotiwa katika makala. Data gani ilitumika, jinsi ilivyofanyiwa uchakataji wa awali, jinsi mgawanyo wa mafunzo na majaribio ulivyofanywa, maelezo ya usanifu wa modeli, hiperparameta, vyanzo vya nasibu, utegemezi wa programu na kama msimbo wa mafunzo unaweza kweli kuendeshwa, vyote vinaweza kuathiri matokeo.
Utafiti chanzo unasisitiza kuwa matokeo yasiyoweza kuzalishwa upya huleta matatizo mawili makuu ya kisayansi. La kwanza ni kufanya uthibitishaji huru wa madai yaliyochapishwa kuwa mgumu. La pili ni kwamba iwapo tafiti zinazofuata zitajengwa juu ya msingi ambao haujathibitishwa, muda na rasilimali za utafiti zinaweza kupotea.
Miongoni mwa juhudi zilizopo za kutatua tatizo hili ni orodha za ukaguzi wa uzalishaji upya, miongozo ya uchapishaji, sera za data wazi na msimbo wazi, hazina za msimbo, matumizi ya kontena na uwekaji nyaraka wenye muundo. Hata hivyo, sehemu kubwa ya mbinu hizi hutoa tathmini za pande mbili au za ubora za aina ya “ipo/haipo”. Pengo ambalo utafiti chanzo unalenga kutatua ni hitaji la kutoa alama ya utayari wa uzalishaji upya iliyo ya kiasi na inayoweza kufasiriwa kwa makala moja ya utafiti, huku ikizingatia pia ulinganifu wa sehemu.
Utayari wa uzalishaji upya wa kiwango cha R1 ni nini?
Utayari wa uzalishaji upya wa kiwango cha R1 unaeleza kiwango ambacho kazi hutoa artefakti za utafiti na maelezo ya kimethodolojia yanayoweza kusaidia kupatikana tena kwa matokeo yale yale kwa kutumia data ile ile, msimbo ule ule, modeli ile ile na mazingira yale yale ya ukokotoaji; badala ya kuendesha upya majaribio ya R1, utafiti huu hupima utayari unaoonekana wa uzalishaji huo upya kupitia makala na artefakti zilizounganishwa nayo.
Tofauti kati ya R1, R2 na R3
| Kiwango | Mantiki ya msingi | Nini huhifadhiwa? | Je, ni ndani ya upeo wa utafiti huu? |
|---|---|---|---|
| R1 | Kupata tena matokeo yale yale kwa kutumia artefakti asilia | Data ile ile, msimbo ule ule, modeli ile ile na mazingira yale yale ya ukokotoaji | Ndiyo |
| R2 | Uzalishaji upya kwa utekelezaji huru | Data asilia huhifadhiwa; utekelezaji unaweza kuwa huru | Hapana |
| R3 | Kufikia hitimisho la kisayansi linalofanana kwa data na mbinu tofauti za uundaji modeli | Kiwango cha tafsiri au hitimisho la kisayansi | Hapana |
Sababu kuu ya kuchagua R1 ni kwamba inaweza kutathminiwa kwa urahisi zaidi kwa njia ya kitu. R2 na R3 huhitaji utekelezaji huru pamoja na data au modeli mbadala, hivyo mara nyingi huhitaji majaribio halisi ya uzalishaji upya. Mfumo chanzo umeundwa kutumika katika kiwango cha makala bila kuendesha upya majaribio.
Vyanzo vikuu vya kutoweza kuzalisha upya
Msimbo na mazingira ya ukokotoaji: Kutokushirikishwa kabisa kwa msimbo, kushirikishwa kwa sehemu tu, au kutotajwa kwa matoleo ya utegemezi kunaweza kuzuia kujengwa tena kwa operesheni zile zile.
Upatikanaji wa data: Seti za data binafsi, zilizofungwa au zinazotolewa kwa sehemu tu zinaweza kuzuia moja kwa moja kurudiwa kwa jaribio. Kutokueleza hatua za uchakataji wa awali au matatizo ya kimethodolojia kama data leakage kunaweza pia kuongeza tofauti kati ya matokeo asilia na uzalishaji upya.
Nasibu: Iwapo uanzishaji wa uzani, uchukuaji sampuli, mpangilio wa mini-batch na vipengele vingine vya stochastiki havitadhibitiwa, hata msimbo ule ule unaweza kutoa matokeo tofauti. Zaidi ya hayo, operesheni za GPU, uendeshaji sambamba na tofauti za floating-point zinaweza kuzuia utekelezaji kamili wa deterministiki katika baadhi ya mazingira.
Kuripoti: Kuripoti majaribio yaliyofanikiwa pekee, kutotaja wazi takwimu zilizotumika, kuficha kutokuwa na uhakika au kutoa maelezo yasiyokamilika ya mafunzo kunaweza kufanya ujenzi upya wa utafiti kuwa mgumu.
Kwa nini orodha ya ukaguzi pekee haikuchukuliwa kuwa ya kutosha?
Orodha nyingi za ukaguzi zina maswali muhimu kama “je, msimbo upo?”, “je, data inapatikana?” au “je, hiperparameta zimeelezwa?”. Hata hivyo, uwekaji alama wa pande mbili hauwakilishi vya kutosha ulinganifu wa sehemu. Kwa mfano, utafiti usioshiriki msimbo kabisa na utafiti unaoshiriki msimbo lakini sehemu yake haijakamilika unaweza kuangukia katika kundi lile lile la “hapana”.
Kwa hiyo utafiti huu hutumia mantiki ya upimaji wa ordinal, yaani wa mpangilio. Hivyo viwango vya “hakuna kabisa”, “kipo kwa sehemu” na “kimekamilika vya kutosha” vinaweza kutofautishwa kihisabati.
Kwa nini MCDM inatumika katika tathmini hii?
Uamuzi wa Vigezo Vingi (MCDM) unatumika kwa sababu huruhusu viashiria tofauti vya uzalishaji upya—kama upatikanaji wa data, msimbo, uwekaji nyaraka, artefakti ya modeli na uwazi wa kimethodolojia—kuletwa kwenye kipimo kimoja, kupewa uzani na kuunganishwa kuwa alama moja inayoweza kufasiriwa; muundo huo huo pia huruhusu uzani wa vigezo kubadilishwa kulingana na lengo la tathmini.
Vigezo saba vya msingi vya mfumo
| Kigezo | Nini kinatathminiwa? |
|---|---|
| Upatikanaji wa data | Iwapo seti ya data iliyotumika katika makala iko wazi kwa wote, inapatikana kwa sehemu, ni nyeti au inapatikana kwa ombi. |
| Upatikanaji wa msimbo | Iwapo msimbo unaohitajika kuendesha tena majaribio upo na umekamilika vya kutosha. |
| Kuwepo kwa README | Iwapo nyaraka za matumizi zinazoeleza mazingira, utegemezi na hatua za kuendesha zipo na zinatosha. |
| Kutolewa kwa modeli iliyofunzwa | Iwapo uzani au artefakti za modeli iliyofunzwa zinazowezesha kuitumia bila kuifundisha upya zinapatikana. |
| Maelezo ya hiperparameta | Kiwango ambacho hiperparameta kuu zilizotumika katika mafunzo zimeainishwa. |
| Maelezo ya mafunzo | Kiwango cha uwazi wa uchakataji wa awali, uchukuaji sampuli, mgawanyo wa mafunzo/majaribio na utaratibu wa mafunzo. |
| Usomekaji wa makala | Muundo, uthabiti na kueleweka kwa maelezo ya mbinu. |
Vigezo hivi saba vilichaguliwaje?
Uundaji wa vigezo ulifanywa katika hatua tatu. Katika hatua ya kwanza, fasihi ya uzalishaji upya, orodha zilizopo za ukaguzi na vyanzo vinavyojulikana vya kutoweza kuzalisha upya vilipitiwa. Hatua hii ilihakikisha kujumuishwa kwa artefakti zinazoweza kuendeshwa kama data, msimbo, modeli iliyofunzwa na README, pamoja na vipengele vya uwazi wa kimethodolojia kama mchakato wa mafunzo na uwazi wa hiperparameta.
Katika hatua ya pili, logistic regression, Random Forest na XGBoost zilitumika kwenye seti mbili zilizopo za data kuchunguza mambo yanayohusiana na lebo ya uzalishaji upya. Modeli hizi hazikutumika kama “mwamuzi” wa kiotomatiki na wa mwisho wa kuchagua vigezo; zilitumika kutoa ushahidi wa kiempiria unaounga mkono uteuzi wa kinadharia.
Katika hatua ya tatu, ushahidi wa kinadharia na wa kiempiria uliunganishwa na kuunda seti fupi ya vigezo saba vinavyoweza kutathminiwa kutoka kwenye makala na artefakti zinazohusiana bila kuendesha jaribio.
Mfumo unaacha nini nje ya upeo?
Ingawa vigezo saba vina wigo mpana, si orodha inayokamilisha kila kitu. Uwepo wa majaribio ya kiotomatiki, ulinganifu wa leseni za programu, nyaraka zenye muundo za data kama data cards, udhibiti wa nasibu, determinism ya maunzi/programu na evaluation leakage havijaingizwa kama vigezo huru katika modeli.
Baadhi ya mambo haya yanaweza kunaswa kwa njia isiyo ya moja kwa moja kupitia maelezo ya mafunzo au ubora wa uwekaji nyaraka; lakini utafiti chanzo haudai kwamba yamewakilishwa kikamilifu.
Mbinu na Matokeo ya Utafiti
Vyanzo viwili vya data vilivyotumika
| Seti ya data | Ukubwa wa awali | Upeo | Jukumu la kisayansi |
|---|---|---|---|
| Olszewski na wenzake | Makala 745 | 2013–2022, NDSS, IEEE S&P, CCS na USENIX; sifa 19 za uzalishaji upya na lebo ya makala ya pande mbili | Msingi wa sampuli kuu na tathmini ya MCDM |
| Raff | Makala 255 | Hasa NeurIPS na ICML; 1984–2017; sifa 28 za anoteshini | Kuimarisha uchunguzi wa kiempiria hasa kwa mambo kama muundo na usomekaji |
Usafishaji wa data
Katika seti ya data ya Olszewski, rekodi zilizokosekana na zisizo na manufaa ya uchanganuzi ziliondolewa. Thamani za kategoria zilizokosekana hazikujazwa kwa njia ya bandia; safu husika ziliondolewa na data ya makala 745 ikapungua hadi makala 292. Sehemu kama kichwa, mwandishi, vitambulisho vya eneo la uchapishaji na viungo ambazo hazikuchangia tathmini ya jumla ya vigezo, pamoja na vigeu visivyo lazima au vya maandishi pekee, ziliondolewa. Sifa nane za uzalishaji upya zilibaki.
Baadaye lebo ya uzalishaji upya ilipunguzwa hadi makala zilizoainishwa tu kama “zinazoweza kuzalishwa upya kikamilifu” na “zisizoweza kuzalishwa upya”, na seti ya mwisho iliyosafishwa ikawa na makala 215.
Katika seti ya Raff, thamani moja iliyokosekana ilisahihishwa na sifa moja adimu sana ikaondolewa. Baada ya kuondoa vigeu vinavyohusiana na eneo la uchapishaji na mada, sifa 20 zilibaki. Vigeu vya kategoria vilibadilishwa kuwa viashiria vya pande mbili. Katika logistic regression, sifa za namba ziliwekewa kipimo cha min–max hadi [0,1] ili coefficients ziweze kulinganishwa, huku katika modeli zinazotegemea miti vigeu vya namba vilitumika bila kupimwa upya.
Uchunguzi wa kiempiria wa vigezo
Seti hizo mbili za data ziliundwa modeli tofauti. Logistic regression ilitumika kama modeli ya mwanzo inayoweza kufasiriwa, huku Random Forest na XGBoost zikitumika kunasa mahusiano yasiyo ya mstari na mwingiliano wa sifa. Katika seti zote mbili, mgawanyo wa mafunzo/majaribio ulikuwa %80/%20.
Kutokuwiana kwa madarasa kulishughulikiwa kwa uzani wa darasa uliosawazishwa katika Random Forest na kwa parameta scale_pos_weight katika XGBoost.
Mlinganyo (1): umuhimu wa sifa wa XGBoost unaotegemea gain
\[ \mathrm{Imp}(j) = \sum_{\text{j özelliğini kullanan bölünmeler}} \Delta L_{\mathrm{split}} \]
1. Fomula huhesabu nini? Huhesabu jumla ya uboreshaji katika lengo/funksioni ya hasara ya modeli unaotokana na migawanyiko ya miti ya maamuzi ya XGBoost inayotumia sifa fulani \(j\).
2. Vigeu ni vipi? \(\mathrm{Imp}(j)\) ni umuhimu wa sifa \(j\). \(\Delta L_{\mathrm{split}}\) ni upungufu wa hasara unaopatikana katika funksi ya lengo kwa mgawanyiko mahususi wa mti unaotumia sifa hiyo.
3. Vipimo ni vipi? Hiki si kipimo cha kimwili. Thamani ghafi ni ukubwa wa umuhimu wa kialgorithimu unaotegemea uboreshaji katika funksi ya lengo ya XGBoost. Katika utafiti, thamani za umuhimu baadaye zilinormalishwa kwa min–max ili ziweze kulinganishwa.
4. Jukumu la kihisabati ni nini? Sifa ile ile inaweza kutumika katika miti na migawanyiko mingi. Fomula hujumlisha upungufu wote wa hasara unaotolewa na sifa hiyo.
5. Maana ya kialgorithimu ni nini? \(\mathrm{Imp}(j)\) kubwa inaonyesha kuwa modeli iliona sifa husika kuwa na manufaa katika kutenganisha darasa la uzalishaji upya.
6. Ni halali chini ya hali gani? Umuhimu huu unategemea miti iliyojengwa na XGBoost, seti ya data na mpangilio wa mafunzo; si athari ya kisababishi.
7. Matokeo yanapaswa kufasiriwaje? Umuhimu mkubwa wa sifa haujithibitishii peke yake kwamba jambo husika ni sharti la lazima la kinadharia la uzalishaji upya. Utafiti chanzo ulitumia thamani hizi kama ushahidi wa kusaidia pamoja na uchanganuzi wa kinadharia, si kama kizingiti kamili cha kuchagua kigezo.
Mlinganyo (2): athari ya wastani ya utabiri ya sifa ya pande mbili
\[ \Delta_j = \frac{1}{N} \sum_{i=1}^{N} \left[ P\left( y=1 \mid x_j^{(i)}=1,\, x_{-j}^{(i)} \right) - P\left( y=1 \mid x_j^{(i)}=0,\, x_{-j}^{(i)} \right) \right] \]
1. Fomula huhesabu nini? Huhesabu, kwa wastani, mabadiliko ya uwezekano wa utabiri wa modeli kwa darasa “linaloweza kuzalishwa upya” wakati sifa ya pande mbili inabadilishwa kutoka 0 hadi 1 huku sifa nyingine zote zikibaki vilevile.
2. Vigeu ni vipi? \(N\) ni idadi ya makala. \(y=1\) inaonyesha darasa linaloweza kuzalishwa upya. \(x_j^{(i)}\) ni sifa \(i\) inayochunguzwa katika makala ya \(j\). \(x_{-j}^{(i)}\) ni sifa nyingine zote katika makala hiyo.
3. Vipimo ni vipi? \(\Delta_j\) iko katika kipimo cha tofauti ya uwezekano na haina kipimo cha kimwili.
4. Jukumu la kihisabati ni nini? Kila makala hutathminiwa mara mbili: sifa husika huwekwa kimadhahania kuwa 1 na 0. Tofauti kati ya utabiri huo miwili hupewa wastani katika makala zote.
5. Maana ya kialgorithimu ni nini? \(\Delta_j\) chanya inaonyesha kuwa kuwepo kwa sifa kunahusishwa na kusogea kwa utabiri wa modeli kuelekea darasa linaloweza kuzalishwa upya; thamani hasi inaonyesha mabadiliko ya utabiri katika mwelekeo kinyume.
6. Ni halali katika hali gani? Thamani hii inaeleza tabia ya modeli ya utabiri iliyofunzwa. Haithibitishi athari ya kisababishi ya sifa katika ulimwengu halisi.
7. Matokeo yanapaswa kufasiriwaje? Athari ya sifa ilitumika kufasiri uhusiano ambao XGBoost ilijifunza katika seti fulani ya data, na uteuzi wa vigezo ulifanywa pamoja na maarifa ya kinadharia kuhusu uzalishaji upya.
Rubriki ya mpangilio iliyochaguliwa
| Kigezo | Kiwango | Maana |
|---|---|---|
| Upatikanaji wa data | 0 | Seti ya data haipatikani kwa umma. |
| 1 | Data imeainishwa kuwa nyeti. | |
| 2 | Data inapatikana kwa sehemu au kwa ombi. | |
| 3 | Data inapatikana kwa umma. | |
| Upatikanaji wa msimbo | 0 | Msimbo haupatikani kwa umma. |
| 1 | Msimbo unapatikana kwa sehemu au una mapungufu yanayozuia kuendesha upya kikamilifu. | |
| 2 | Msimbo unapatikana kwa umma na umekamilika vya kutosha. | |
| README | 0 | Hakuna README au maelekezo ya matumizi. |
| 1 | README ipo lakini hatua muhimu au utegemezi vinakosekana. | |
| 2 | README imekamilika vya kutosha kuendesha mtiririko wa kazi. | |
| Modeli iliyofunzwa | 0 | Artefakti ya modeli iliyofunzwa haijatolewa. |
| 1 | Artefakti ya modeli iliyofunzwa imetolewa. | |
| Hiperparameta | 0 | Hiperparameta hazijaelezwa. |
| 1 | Zimeelezwa kwa sehemu. | |
| 2 | Zimeelezwa kikamilifu. | |
| Maelezo ya mafunzo | 0 | Mafunzo/uchakataji wa awali/migawanyo haijaelezwa. |
| 1 | Imeelezwa kwa sehemu. | |
| 2 | Imeelezwa kikamilifu. | |
| Usomekaji wa makala | 0 | Muundo haueleweki na ni vigumu kufuatilia hatua muhimu za mbinu. |
| 1 | Muundo wa jumla una mantiki lakini kuna sehemu zisizo wazi au zisizo thabiti. | |
| 2 | Imeandaliwa vizuri, iko wazi na maelezo ya mbinu ni thabiti. |
Mlinganyo (3): kunormalisha alama ya ordinal hadi [0,1]
\[ x_k = \frac{s_k}{L_k}, \qquad x_k\in[0,1] \]
1. Fomula huhesabu nini? Hubadilisha alama za vigezo vyenye viwango tofauti vya juu kuwa kipimo cha pamoja cha [0,1].
2. Vigeu ni vipi? \(s_k\) ni alama ya ordinal iliyotolewa kwa kigezo \(k\). \(L_k\) ni kiwango cha juu zaidi cha ordinal kinachowezekana kwa kigezo hicho. \(x_k\) ni thamani ya kigezo iliyofanyiwa normalizesheni.
3. Vipimo ni vipi? \(x_k\) haina kipimo.
4. Jukumu la kihisabati ni nini? Kwa mfano, hufanya upatikanaji wa data wenye kiwango cha juu cha 3 uweze kulinganishwa katika masafa yale yale ya namba na kigezo cha modeli iliyofunzwa chenye kiwango cha juu cha 1.
5. Maana ya kialgorithimu ni nini? \(x_k=0\) inaonyesha kigezo kiko katika kiwango cha chini kabisa; \(x_k=1\) inaonyesha kiko katika kiwango cha juu zaidi cha utayari kilichofafanuliwa.
6. Dhana ni nini? Normalizesheni ya mstari hudhani kuwa tofauti kati ya viwango jirani vya ordinal ni hatua sawa. Utafiti chanzo unakubali wazi kuwa hii ni rahisi na wazi, lakini ongezeko la manufaa halisi si lazima liwe la mstari.
7. Matokeo yanapaswa kufasiriwaje? Kwa mfano, ikiwa \(s_k=2\) na \(L_k=3\):
\[ x_k=\frac{2}{3}\approx0.667 \]
Thamani hii haimaanishi “inaweza kuzalishwa upya kwa 66,7% kwa kweli”; ni kiwango tu cha ulinganifu kilichonormalishwa dhidi ya kiwango cha juu cha ordinal katika kigezo husika.
Ukubwa wa sampuli na anoteshini
Wakati wa kuchukua sampuli kutoka seti iliyosafishwa ya makala 215 ya Olszewski, utafiti chanzo ulitumia mbinu ya Cochran yenye marekebisho ya idadi yenye ukomo. Kwa %95 kiwango cha kujiamini, p=0,5 kama uwiano wa tahadhari wa idadi, na %5 kiwango cha kosa, ukubwa wa sampuli ulihesabiwa kuwa makala 139.
Makala chanzo haitoi mlinganyo wa kialjebra wa hesabu ya Cochran kama fomula yenye namba. Kwa hiyo, hakuna mlinganyo tofauti wa Cochran ambao haupo katika chanzo ulioongezwa hapa.
Makala 139 zilipewa alama kwa kujitegemea katika vigezo vyote saba na waandishi wa utafiti pamoja na ChatGPT.
Mlinganyo (4): kuunganisha anoteshini mbili
\[ S_{\mathrm{final}} = \frac{ A_{\mathrm{study}} + A_{\mathrm{ChatGPT}} }{2} \]
1. Fomula huhesabu nini? Huchukua wastani wa kihesabu wa anoteshini ya mtafiti na anoteshini ya ChatGPT ili kupata alama ya mwisho ya kigezo.
2. Vigeu ni vipi? \(A_{\mathrm{study}}\) ni alama ya kigezo iliyotolewa na timu ya utafiti; \(A_{\mathrm{ChatGPT}}\) ni alama ya kigezo iliyotolewa na modeli.
3. Vipimo ni vipi? Thamani iko katika kipimo cha alama ya ordinal ya kigezo husika.
4. Jukumu la kihisabati ni nini? Watathmini wawili wanaunganishwa kwa uzani sawa.
5. Maana ya kialgorithimu ni nini? Ni operesheni rahisi ya uunganishaji inayozuia alama ya mwisho kutegemea tathmini ya binadamu pekee au LLM pekee.
6. Sharti ni nini? Anoteshini zote mbili lazima zifanywe kwa kigezo kile kile na rubriki ile ile ya ordinal.
7. Matokeo yanapaswa kufasiriwaje? Ulinganifu wa jumla wa juu sana uliripotiwa kati ya anoteshini hizo mbili: wastani wa weighted Cohen kappa \(\kappa=0.96\). Hata hivyo, katika vigezo vya kibinafsi zaidi kama usomekaji, ulinganifu ulikuwa chini kiasi na utafiti ulitumia idadi ndogo tu ya waannoteshaji.
Hesabu ya alama ya MCDM
Baada ya normalizesheni, kila kigezo kiko katika masafa \(x_i\in[0,1]\). Utafiti hutumia mbinu mbili tofauti, zinazoelezeka za uunganishaji wa MCDM: WSM na TOPSIS.
Tofauti ya msingi kati ya WSM na TOPSIS ni nini?
WSM huunganisha alama za vigezo kama jumla ya mstari yenye uzani, huku TOPSIS ikipima umbali wa wasifu wa vigezo vya kila makala kutoka kwa wasifu bora ambako vigezo vyote ni bora zaidi na wasifu wa kinyume-bora ambako vigezo vyote ni vibaya zaidi; kwa hiyo hata kama uzani ule ule unatumiwa, mbinu hizi mbili zinaweza kuitikia kwa njia tofauti mchanganyiko wa vigezo vyenye nguvu na dhaifu.
Mlinganyo (5): Mfano wa Jumla Yenye Uzani — WSM
\[ S = \sum_{i=1}^{n}w_i x_i, \qquad \sum_{i=1}^{n}w_i=1 \]
1. Fomula huhesabu nini? Huchukua wastani wenye uzani wa vigezo vyote vilivyonormalishwa na kutoa alama moja ya utayari wa uzalishaji upya.
2. Vigeu ni vipi? \(x_i\) ni alama iliyofanyiwa normalizesheni ya kigezo \(i\); \(w_i\) ni uzani wa kigezo; \(n\) ni idadi ya vigezo. Katika utafiti huu \(n=7\). \(S\) ni alama ya mwisho ya WSM.
3. Vipimo ni vipi? Thamani zote hazina vipimo na \(S\in[0,1]\).
4. Jukumu la kihisabati ni nini? Kila kigezo huzidishwa kwa uzani wake wa umuhimu na michango saba hujumlishwa.
5. Maana ya kialgorithimu ni nini? Utendaji mzuri katika vigezo vyenye uzani mkubwa huchangia zaidi katika alama ya mwisho.
6. Dhana kuu ni nini? WSM hudhani uhuru wa kujumlisha kati ya vigezo. Hii ina maana kuwa utendaji mzuri katika kigezo kimoja unaweza kufidia kihisabati udhaifu katika kigezo kingine.
7. Matokeo yanapaswa kufasiriwaje? Utafiti chanzo unaeleza kuwa dhana hii huenda isiakisi kikamilifu mantiki halisi ya uzalishaji upya. Kwa mfano, ikiwa msimbo au data haipo kabisa, uimara wa vigezo vingine huenda usiweze kufanya uzalishaji upya halisi uwezekane. Kwa hiyo WSM hutoa alama ya kukadiria iliyo wazi; haimodeli kikamilifu utegemezi wa lazima kati ya vigezo.
Mlinganyo (6): wasifu bora na kinyume-bora wa TOPSIS
\[ v_j^{+}=1, \qquad v_j^{-}=0 \]
1. Fomula inafafanua nini? Inafafanua thamani rejea bora na kinyume-bora kwa kila kigezo katika TOPSIS.
2. Vigeu ni vipi? \(v_j^{+}\) ni thamani bora ya kigezo \(j\); \(v_j^{-}\) ni thamani ya kinyume-bora.
3. Vipimo ni vipi? Ni thamani zisizo na vipimo katika kipimo kilichonormalishwa cha [0,1].
4. Jukumu la kihisabati ni nini? Wasifu wa kinadharia wenye 1 katika vigezo vyote ni rejea ya utayari kamili, huku wasifu wenye 0 katika vigezo vyote ukiwa rejea mbaya zaidi.
5. Maana ya kialgorithimu ni nini? Wasifu wa alama wa makala halisi huwekwa kulingana na rejea hizi mbili.
6. Sharti ni nini? Vigezo vyote vinapaswa kuwa vimenormalishwa kwa mwelekeo wa “thamani kubwa ni bora”.
7. Matokeo yanapaswa kufasiriwaje? Nukta bora si lazima iwe makala halisi; ni rejea ya kihisabati iliyofafanuliwa kwa madhumuni ya kulinganisha.
Mlinganyo (7): umbali hadi wasifu bora na kinyume-bora
\[ D_i^{+} = \sqrt{ \sum_{j=1}^{n} w_j \left( v_{ij}-v_j^{+} \right)^2 } \]
\[ D_i^{-} = \sqrt{ \sum_{j=1}^{n} w_j \left( v_{ij}-v_j^{-} \right)^2 } \]
1. Fomula huhesabu nini? Huhesabu umbali wa Euclidean wenye uzani wa wasifu wa vigezo vya makala \(i\) hadi wasifu bora na kinyume-bora.
2. Vigeu ni vipi? \(v_{ij}\) ni thamani iliyofanyiwa normalizesheni ya makala \(i\) katika kigezo \(j\). \(w_j\) ni uzani wa kigezo. \(v_j^{+}\) na \(v_j^{-}\) ni thamani bora na kinyume-bora.
3. Vipimo ni vipi? Ni umbali usio na vipimo katika nafasi ya vigezo iliyofanyiwa normalizesheni.
4. Jukumu la kihisabati ni nini? Tofauti kutoka rejea katika kila kigezo huinuliwa mraba, huzidishwa kwa uzani, kisha mzizi wa mraba wa jumla huchukuliwa.
5. Maana ya kialgorithimu ni nini? \(D_i^{+}\) ndogo inaonyesha makala iko karibu na wasifu bora; \(D_i^{-}\) kubwa inaonyesha iko mbali na wasifu mbaya zaidi.
6. Sharti ni nini? Vigezo lazima viwe katika nafasi ile ile iliyofanyiwa normalizesheni na uzani lazima uwakilishe vipaumbele vya modeli ya uamuzi.
7. Matokeo yanapaswa kufasiriwaje? Umbali mmoja peke yake hautoshi; TOPSIS huunganisha umbali wote miwili katika ukaribu wa kiasi kwa kutumia Mlinganyo (8).
Mlinganyo (8): alama ya ukaribu wa kiasi ya TOPSIS
\[ C_i = \frac{D_i^{-}} {D_i^{+}+D_i^{-}} \]
1. Fomula huhesabu nini? Huhesabu ukaribu wa kiasi wa makala \(i\) na wasifu bora.
2. Vigeu ni vipi? \(D_i^{+}\) ni umbali hadi suluhisho bora, \(D_i^{-}\) ni umbali hadi suluhisho la kinyume-bora.
3. Vipimo ni vipi? \(C_i\) haina kipimo na iko katika masafa \(0\leq C_i\leq1\).
4. Jukumu la kihisabati ni nini? Hugawanya umbali kutoka kinyume-bora kwa jumla ya umbali zote mbili ili kutoa namba moja.
5. Maana ya kialgorithimu ni nini? Kadiri \(C_i\) inavyoongezeka, ndivyo makala inavyokuwa karibu na wasifu bora wa utayari wa uzalishaji upya.
6. Sharti ni nini? Umbali lazima uhesabiwe katika nafasi ile ile ya vigezo na kwa uzani ule ule.
7. Matokeo yanapaswa kufasiriwaje? \(C_i=0.8\) haimaanishi “kazi inaweza kuzalishwa upya kwa uwezekano wa 80%”. Alama inaonyesha ukaribu wa kiasi na wasifu bora chini ya vigezo saba na mfumo wa uzani uliobainishwa.
Tathmini ya msingi: uzani sawa
Katika tathmini ya msingi, kila moja ya vigezo saba ilipewa uzani sawa. Hivyo, tabia ya msingi ya rubriki na mfumo wa vigezo ilichunguzwa bila matokeo kuendeshwa na vipaumbele vya kibinafsi vya mtoa uamuzi fulani.
Alama za WSM na TOPSIS ziko katika masafa ya [0,1]. Utafiti chanzo ulichunguza kwa mkono vizingiti vya uamuzi kati ya 0 na 1 kwa hatua za 0,1 na kuripoti kwamba kizingiti cha 0,5 kilitoa usawa bora zaidi kati ya usahihi, precision na recall.
Matokeo dhidi ya lebo rejea
Katika sampuli ya makala 139, usambazaji wa lebo rejea haukuwa sawa: kulikuwa na makala 102 hasi na makala 37 chanya.
| Rejea | Utabiri 0 | Utabiri 1 |
|---|---|---|
| 0 — lebo ya kutoweza kuzalishwa upya | 63 | 39 |
| 1 — lebo ya kuweza kuzalishwa upya | 11 | 26 |
| Metriki | Thamani |
|---|---|
| Usahihi | 0,64 |
| Precision | 0,40 |
| Recall | 0,70 |
| Alama ya F1 | 0,51 |
Recall ya 0,70 inaonyesha kuwa sehemu muhimu ya makala zilizoainishwa kama zinazoweza kuzalishwa upya katika seti ya rejea pia zilitambuliwa na mfumo wa utayari. Precision ya 0,40 inaonyesha kuwa sehemu muhimu ya makala zilizoainishwa kama “tayari” zilikuwa na lebo rejea ya kutoweza kuzalishwa upya.
Chanzo hakitafsiri tofauti hii kama kushindwa kwa mfumo pekee. Mfumo hutathmini utayari unaoonekana wa msimbo, data na maelezo, huku lebo rejea ikiwakilisha matokeo ya uzalishaji upya wa vitendo. Kizuizi kisichoonekana kama tatizo la mazingira au utekelezaji usiokamilika kinaweza kusababisha kushindwa wakati wa kuendesha, hata kama makala inaonekana tayari kwenye karatasi.
Ulinganisho na sheria rahisi za artefakti
| Modeli | Precision | Recall | F1 |
|---|---|---|---|
| Msimbo pekee | 0,27 | 0,62 | 0,38 |
| Data pekee | 0,33 | 0,73 | 0,45 |
| Msimbo AU data | 0,30 | 0,86 | 0,45 |
| Msimbo NA data | 0,30 | 0,49 | 0,37 |
| WSM/TOPSIS — uzani sawa | 0,40 | 0,70 | 0,51 |
Sheria ya “Msimbo AU data” ilitoa recall ya juu zaidi ya 0,86, lakini kwa sababu ya precision ya chini ilizalisha false positive nyingi. Mbinu ya MCDM yenye vigezo saba ilifikia alama ya juu zaidi ya F1 na kutoa matokeo yaliyosawazika zaidi.
Matukio matatu ya uwekaji uzani kwa AHP
Utafiti chanzo ulionyesha Mchakato wa Uongozi wa Kichanganuzi (Analytic Hierarchy Process, AHP) kama njia ya vitendo ya kupata uzani wa vigezo kulingana na muktadha. Ulinganisho wa vigezo ulijengwa kwa kutumia kipimo cha Saaty cha 1–9, matriksi za ulinganisho zikanormalishwa na uthabiti ukakaguliwa kwa Consistency Ratio (CR).
Chanzo hakitoi mlinganyo tofauti wenye namba wa AHP katika sehemu hii. Kwa hiyo, fomula ya AHP ambayo haipo katika chanzo haijaundwa hapa.
| Kigezo | S1: Sawa | S2: Data na Msimbo | S3: Mafunzo na Usomekaji |
|---|---|---|---|
| Upatikanaji wa data | 0,143 | 0,241 | 0,107 |
| Upatikanaji wa msimbo | 0,143 | 0,241 | 0,107 |
| README | 0,143 | 0,103 | 0,107 |
| Modeli iliyofunzwa | 0,143 | 0,103 | 0,036 |
| Maelezo ya hiperparameta | 0,143 | 0,103 | 0,143 |
| Maelezo ya mafunzo | 0,143 | 0,103 | 0,250 |
| Usomekaji wa makala | 0,143 | 0,103 | 0,250 |
| Jumla | 1,000 | 1,000 | 1,000 |
Katika matukio yote matatu, \(\lambda_{\max}=7.0\) na \(CR=0.0\) ziliripotiwa. Uzani uliotumika haukuwa mapendeleo yaliyokusanywa kutoka kundi halisi la wadau; ulikuwa matukio ya mfano yaliyoundwa kuonyesha jinsi malengo tofauti ya uamuzi yanavyoweza kubadilisha alama.
Athari ya mabadiliko ya uzani katika makala kumi za mfano
| No | Makala | WSM S1 | WSM S2 | WSM S3 | TOPSIS S1 | TOPSIS S2 | TOPSIS S3 |
|---|---|---|---|---|---|---|---|
| 1 | WTAGRAPH: Web Tracking and Advertising Detection using Graph Neural Networks | 0,286 | 0,207 | 0,446 | 0,277 | 0,210 | 0,490 |
| 2 | DeepSteal: Advanced Model Extractions Leveraging Efficient Weight Stealing in Memories | 0,429 | 0,448 | 0,500 | 0,370 | 0,442 | 0,484 |
| 3 | Model Stealing Attacks Against Inductive Graph Neural Networks | 0,452 | 0,420 | 0,589 | 0,375 | 0,385 | 0,570 |
| 4 | Phishpedia: A Hybrid Deep Learning Based Approach to Visually Identify Phishing Webpages | 0,643 | 0,603 | 0,643 | 0,649 | 0,575 | 0,627 |
| 5 | Cheetah: Lean and Fast Secure Two-Party Deep Neural Network Inference | 0,524 | 0,609 | 0,554 | 0,424 | 0,555 | 0,501 |
| 6 | DEEPCASE: Semi-Supervised Contextual Analysis of Security Events | 0,643 | 0,741 | 0,714 | 0,478 | 0,625 | 0,658 |
| 7 | Khaleesi: Breaker of Advertising and Tracking Request Chains | 0,595 | 0,592 | 0,750 | 0,447 | 0,498 | 0,712 |
| 8 | AI/ML for Network Security: The Emperor Has No Clothes | 0,786 | 0,845 | 0,679 | 0,782 | 0,837 | 0,622 |
| 9 | Improving Password Guessing via Representation Learning | 0,524 | 0,471 | 0,714 | 0,402 | 0,401 | 0,638 |
| 10 | Privacy Risks of Securing Machine Learning Models against Adversarial Examples | 0,595 | 0,661 | 0,696 | 0,431 | 0,549 | 0,611 |
Katika tukio la S2 ambako uzani wa data na msimbo uliongezwa, alama za WSM za makala namba 6, 8 na 10 zenye ushiriki mzuri wa artefakti ziliongezeka. Kinyume chake, alama ya WSM ya makala namba 1 ilishuka kutoka 0,286 hadi 0,207.
Katika tukio la S3 ambako maelezo ya mafunzo na usomekaji yalitiliwa mkazo, alama za WSM za makala namba 1, 3, 6, 7 na 9 ziliongezeka ikilinganishwa na S1. Hivyo, uzani unaonekana kuwa si maelezo ya kiufundi pekee bali chaguo la uundaji modeli linalowakilisha moja kwa moja lengo la tathmini.
Uchanganuzi wa Monte Carlo wa unyeti na uthabiti
Ili kuchunguza jinsi uzani wa AHP ulivyo nyeti kwa kutokuwa na uhakika kidogo, uzani wa kila kigezo ulibadilishwa kwa kujitegemea katika eneo la ±%20 la thamani yake ya awali, kisha uzani wote ulinormalishwa tena ili jumla yake iwe 1.
Kwa kila tukio, vekta 500 tofauti za uzani zilizofanyiwa perturbation ziliundwa na kwa kila vekta alama za WSM na TOPSIS zilihesabiwa upya. Matokeo yalitathminiwa kwa wastani na masafa ya persentili ya 5–95.
| Mbinu | S1 | S2 | S3 |
|---|---|---|---|
| Wastani wa variation wa WSM | 0,091 | 0,089 | 0,083 |
| Wastani wa variation wa TOPSIS | 0,114 | 0,116 | 0,127 |
WSM ilionyesha variation ndogo kidogo dhidi ya mabadiliko ya uzani kuliko TOPSIS. Muundo wa TOPSIS unaotegemea umbali unaweza kuwa nyeti zaidi kwa mabadiliko katika uzani wa vigezo. Hata hivyo, katika mbinu zote mbili mabadiliko yaliyoonekana yalibaki madogo ikilinganishwa na masafa kamili ya alama ya [0,1].
Sehemu kubwa ya nafasi za makala ilihifadhiwa chini ya perturbation. Tofauti kubwa zaidi katika nafasi zilionekana kusababishwa zaidi na mabadiliko ya makusudi ya vipaumbele vya uamuzi kati ya S1–S2–S3 kuliko na mabadiliko madogo ya nasibu ya uzani.
Kiambatisho A: matokeo ya logistic regression
| Kigeu | Coefficient | Kosa la kawaida | z | p | %95 muda wa kujiamini |
|---|---|---|---|---|---|
| Konstanti | −2,196 | 0,492 | −4,458 | 0,000 | [−3,161; −1,230] |
| Kutolewa kwa modeli iliyofunzwa | 0,882 | 0,330 | 2,670 | 0,008 | [0,235; 1,529] |
| Upatikanaji wa data | 1,106 | 0,510 | 2,167 | 0,030 | [0,106; 2,105] |
Thamani ya pseudo \(R^2\) ya modeli ni 0,054 na uwezo wake wa kueleza ni mdogo. Uchanganuzi huu ulitumika zaidi kwa uwezekano wa kufasiri kuliko kwa mafanikio ya utabiri.
| Kigeu | Coefficient | Kosa la kawaida | z | p | %95 muda wa kujiamini |
|---|---|---|---|---|---|
| Konstanti | −1,611 | 0,489 | −3,294 | 0,001 | [−2,570; −0,653] |
| Usomekaji wa makala | 2,764 | 0,367 | 7,531 | 0,000 | [2,045; 3,484] |
| Ugumu wa algorithimu iliyotumika | −0,963 | 0,360 | −2,676 | 0,007 | [−1,669; −0,258] |
| Uainishaji wa hiperparameta | 1,183 | 0,402 | 2,942 | 0,003 | [0,395; 1,972] |
Kwa modeli ya logistic katika seti ya Raff, pseudo \(R^2=0.33\) iliripotiwa. Usomekaji na uainishaji wa hiperparameta vilionyesha uhusiano chanya na darasa linaloweza kuzalishwa upya; ugumu wa algorithimu iliyotumika ulionyesha uhusiano hasi.
Kiambatisho A: utendaji wa uchunguzi wa Random Forest na XGBoost
| Seti ya data | Modeli | Usahihi | Precision ya darasa 1 | Recall ya darasa 1 | F1 ya darasa 1 |
|---|---|---|---|---|---|
| Olszewski | Random Forest | 0,65 | 0,40 | 0,50 | 0,44 |
| Olszewski | XGBoost | 0,70 | 0,46 | 0,50 | 0,48 |
| Raff | Random Forest | 0,86 | 0,88 | 0,91 | 0,89 |
| Raff | XGBoost | 0,88 | 0,88 | 0,94 | 0,91 |
Katika seti ya Olszewski, XGBoost ilitoa uboreshaji mdogo ikilinganishwa na Random Forest, huku katika seti ya Raff modeli zote mbili zinazotegemea miti zikitoa matokeo yenye nguvu zaidi. Hata hivyo, jukumu kuu la modeli hizi halikuwa kuunda klasifaya ya mwisho ya uzalishaji upya bali kutambua mambo yanayosaidia uundaji wa vigezo.
Umuhimu wa sifa za XGBoost
| Sifa | Umuhimu uliowekwa kawaida |
|---|---|
| Kuwepo kwa README | 0,279 |
| Upatikanaji wa data | 0,269 |
| Kuwepo kwa modeli iliyofunzwa | 0,140 |
| Maelezo ya mafunzo | 0,116 |
| Uainishaji wa hiperparameta | 0,103 |
| Uainishaji wa mgawanyo wa mafunzo/majaribio | 0,090 |
| Upatikanaji wa jaribio | 0,000 |
Katika seti ya Olszewski, README na upatikanaji wa data vina umuhimu wa juu zaidi uliowekwa kawaida. Katika uchanganuzi wa athari ya sifa, athari ya utabiri ya README kwa darasa linaloweza kuzalishwa upya ilikuwa +0,300, ya modeli iliyofunzwa +0,190, na ya upatikanaji wa data +0,108.
Katika seti ya Raff, sifa iliyotawala zaidi ilikuwa usomekaji wa makala ikiwa na umuhimu uliowekwa kawaida wa 0,288. Upatikanaji wa data ulikuwa 0,062; idadi ya vielelezo vya uundaji dhana 0,056; uainishaji wa hiperparameta 0,051; idadi ya jedwali na vielelezo 0,048; upatikanaji wa msimbo 0,043. Thamani ya athari ya usomekaji kwa darasa linaloweza kuzalishwa upya iliripotiwa kuwa +0,6198.
Ujumbe mkuu wa kisayansi wa utafiti
Haitoshi kupunguza uzalishaji upya kuwa swali moja la “je, msimbo upo?”. Mchakato halisi wa uzalishaji upya unaweza kuhitaji data, msimbo, modeli iliyofunzwa, maelekezo ya uendeshaji, hiperparameta, maelezo ya mafunzo na maelezo ya mbinu kuwa vya kutosha kwa pamoja. Mbinu ya MCDM inajaribu kufupisha muundo huu wa vipimo vingi kuwa namba moja.
Hata hivyo, namba moja si ya kudumu kwa kila muktadha. Kamati ya tathmini ya artefakti inayotanguliza ushiriki wa data na msimbo na mhakiki katika eneo lenye data nyeti anayetanguliza uwazi wa kimethodolojia si lazima watumie uzani ule ule wa vigezo. Lengo la matukio ya AHP ni kufanya tofauti hii ya kimuktadha ionekane.
Matokeo yanayoungwa mkono na utafiti
Utafiti chanzo unaonyesha kuwa kutoa alama za ordinal kwa vigezo saba, kuzinormalisha na kuziunganisha kwa WSM/TOPSIS kunaweza kutoa alama ya utayari wa R1 inayoweza kutumika na kufasiriwa katika kiwango cha makala ya utafiti.
Alama ya msingi ilionyesha ulinganifu wa wastani na lebo rejea; ilitoa utendaji wa F1 ulio na uwiano zaidi kuliko sheria rahisi zinazotegemea artefakti moja. Matukio tofauti ya uzani yalibadilisha alama katika mwelekeo uliotarajiwa na matokeo hayakuwa yasiyotulia kabisa chini ya perturbation za uzani za ±%20.
Matokeo yasiyoungwa mkono na utafiti
Alama ya juu ya utayari haimaanishi kuwa jaribio halisi hakika litazalishwa upya kwa mafanikio. Kwa sababu mfumo hauendeshi msimbo, hauwezi kuthibitisha moja kwa moja utegemezi uliojificha, utekelezaji uliovunjika, kutolingana kwa maunzi au tofauti kati ya madai ya upatikanaji na upatikanaji wa vitendo.
Alama ya chini ya utayari pia haimaanishi kuwa utafiti ni mbaya kisayansi, hauna umuhimu au si sahihi. Tafiti zenye athari kubwa ambazo haziwezi kushiriki artefakti kwa sababu za kibiashara, kimkakati au faragha zinaweza kupata alama ya chini ya utayari.
Alama ya 0–1 ya mfumo si uwezekano wa uzalishaji upya na haipaswi kufasiriwa kama “utafiti wenye alama 0,8 una uwezekano wa 80% wa kuzalishwa upya”.
Mapungufu
Upeo wa data: Seti ya Olszewski inahusisha hasa mikutano ya kiwango cha juu ya usalama; seti ya Raff inahusisha kwa kiasi kikubwa kazi za NeurIPS na ICML. Utamaduni wa ushiriki katika maeneo haya huenda usiwakilishe maeneo yote madogo ya ujifunzaji wa mashine.
Tofauti ya dhana kati ya lebo rejea na alama: Alama ya utayari hupima maelezo na artefakti zinazoonekana, huku lebo rejea inaweza kutegemea matokeo halisi ya uzalishaji upya. Kwa hiyo, ulinganifu kamili wa miundo hii miwili haupaswi kutarajiwa kinadharia.
Kikomo cha anoteshini: Ingawa ulinganifu wa juu ulipatikana kati ya anoteshini za binadamu na ChatGPT, tathmini ilitegemea idadi ndogo ya waannoteshaji. Hasa katika maeneo kama usomekaji au nyaraka “zilizokamilika kwa sehemu”, upendeleo wa tathmini ya kibinafsi unaweza kubaki.
Rubriki ya ordinal na normalizesheni ya mstari: Mlinganyo (3) huchukulia viwango vya ordinal jirani kuwa na umbali sawa. Hata hivyo, katika baadhi ya vigezo manufaa ya vitendo ya kutoka “sehemu” hadi “kamili” yanaweza kuwa makubwa au madogo kuliko kutoka “hakuna” hadi “sehemu”.
Utegemezi wa vigezo: Muundo wa WSM wa kujumlisha unaoruhusu fidia hauwakilishi kikamilifu utegemezi wa kimantiki wa uzalishaji upya. Ikiwa kipengele muhimu kama msimbo au data ni sifuri, katika baadhi ya hali hakiwezi kufidiwa na vigezo vingine vya juu.
Upeo wa mfumo: Mbinu si cheti cha mwisho cha uzalishaji upya bali ni zana ya uchunguzi wa awali na tathmini linganishi.
Mielekeo ya utafiti wa baadaye
Utafiti chanzo unapendekeza kuunda seti mpya za data zenye matokeo halisi ya uendeshaji siku zijazo. Taarifa kama kuendesha upya ndani ya kontena, kuthibitisha utatuzi wa utegemezi na kupima uadilifu wa artefakti zinaweza kuruhusu tofauti kati ya alama ya utayari na vikwazo halisi vya uzalishaji upya kupimwa moja kwa moja zaidi.
Seti ya vigezo inaweza kupanuliwa kwa vipimo vya ziada kama udhibiti wa nasibu, uainishaji wa mazingira ya kuendesha na ukaguzi wa evaluation leakage. Mfumo huo huo unaweza kubadilishwa kwa viwango vya juu zaidi vya uzalishaji upya kama R2 na R3 kwa kubadilisha vigezo na rubriki.
Uchimbaji wa kiotomatiki kwa sehemu wa viungo vya artefakti, ukamilifu wa README na taarifa za mbinu zenye muundo unaweza kufanya mfumo ufae kwa tathmini ya kiwango kikubwa. Hata hivyo, kwa vigezo vya kibinafsi, tathmini yenye binadamu katika mzunguko na makubaliano ya waannoteshaji wengi bado ni muhimu.
Mbali na WSM na TOPSIS, kulinganisha familia nyingine za MCDM kama LINMAP, PROMETHEE na VIKOR; kuunda mbinu zinazopeleka moja kwa moja kutokuwa na uhakika wa anoteshini na uzani katika masafa ya alama; na kutumia mifumo ya tathmini isiyoruhusu fidia yenye masharti ya chini katika vigezo muhimu ni miongoni mwa maeneo ya utafiti wa baadaye.
Hitimisho la jumla
Utafiti unaondoa tatizo la uzalishaji upya katika tafiti za ujifunzaji wa mashine kutoka katika ukaguzi wa kipimo kimoja wa “je, msimbo umeshirikishwa?” na kulichukulia kama tatizo la uamuzi wa vigezo vingi. Kutoa alama kwa vigezo saba vilivyo wazi kwa rubriki ya mpangilio, kuvibadilisha hadi kipimo cha pamoja na kuviunganisha kwa WSM au TOPSIS kunatoa alama ya utayari wa R1 inayoweza kulinganishwa kati ya makala na kupewa uzani kulingana na lengo la uamuzi.
Mchango muhimu zaidi wa kimawazo wa utafiti ni kuweka wazi mpaka wa alama: utayari na uzalishaji upya halisi vinahusiana lakini si dhana ile ile. Makala inaweza kutoa maelezo na artefakti zote zinazohitajika, lakini ishindwe katika hatua ya uendeshaji kutokana na matatizo ya kiufundi yasiyoonekana. Kinyume chake, kazi inayoonekana kukosa taarifa fulani katika rubriki ya kawaida inaweza kwa vitendo kuzalishwa upya.
Kwa hiyo matumizi yanayofaa zaidi ya mfumo uliopendekezwa si kuwa mfumo wa mwisho wa kuweka daraja ubora wa kisayansi, bali kuwa zana ya ziada inayochunguza kwa utaratibu uwazi wa utafiti na utayari wa uzalishaji upya wa R1, kurahisisha ulinganisho na kuonyesha ni kazi zipi zinaonekana tayari kwa uthibitishaji wa kina zaidi wa uzalishaji upya.
Maelezo ya Chanzo na Mbinu
Utafiti asilia: A MCDM-Based Framework for Quantifying Reproducibility Readiness in Machine Learning Research.
Waandishi: Paulina Leščinskaitė, Remigijus Paulavičius na Ernestas Filatovas.
Mwandishi anayewajibika: Ernestas Filatovas.
Taasisi: Institute of Data Science and Digital Technologies, Faculty of Mathematics and Informatics, Vilnius University, Akademijos Str. 4, LT-08412 Vilnius, Lithuania.
Jarida: Mathematics.
Mchapishaji: MDPI, Basel, Switzerland.
Rekodi ya kibibliografia: Mathematics, 2026, Juzuu 14, Toleo 9, Makala 1536.
DOI: 10.3390/math14091536
Imepokelewa: 20 Machi 2026.
Marekebisho: 23 Aprili 2026.
Imekubaliwa: 28 Aprili 2026.
Imechapishwa: 1 Mei 2026.
Aina ya chanzo: Makala asilia ya utafiti iliyopitiwa na wenzao na yenye ufikiaji wazi.
Leseni: Creative Commons Attribution (CC BY).
Mbinu kuu: Uchanganuzi wa kinadharia wa uzalishaji upya, uchunguzi wa kiempiria wa vigezo kwa logistic regression/Random Forest/XGBoost katika seti mbili zilizopo za data, rubriki ya ordinal yenye vigezo saba, normalizesheni ya [0,1], uunganishaji wa MCDM kwa WSM na TOPSIS, matukio ya mfano ya uzani yanayotegemea AHP na uchanganuzi wa unyeti wa uzani kwa Monte Carlo.
Ufadhili
Utafiti uliungwa mkono na Baraza la Utafiti la Lithuania chini ya mpango wa “University Excellence Initiatives” wa Wizara ya Elimu, Sayansi na Michezo ya Jamhuri ya Lithuania. Namba ya mradi iliyotajwa katika chanzo ni S-A-UEI-23-11.
Upatikanaji wa data na msimbo
Waandishi wanaripoti kuwa msingi kamili wa msimbo, seti za data na hati ya README inayoeleza faili za data/msimbo zimetolewa wazi. Mbinu na metriki za utafiti zilitekelezwa kwa Python 3.13.3.
Hazina ya msimbo chanzo na data: GitHub — Quantifying reproducibility of ML papers using MCDM.
Mgongano wa maslahi
Waandishi wanatangaza kuwa hakuna mgongano wa maslahi. Imeelezwa kuwa wafadhili hawakuwa na jukumu katika usanifu wa utafiti, ukusanyaji wa data, uchanganuzi, tafsiri, uandishi wa makala au uamuzi wa kuchapisha.
Michango ya waandishi
- Uundaji dhana: P.L., R.P. na E.F.
- Methodolojia: P.L. na E.F.
- Programu: P.L.
- Uthibitishaji: P.L., R.P. na E.F.
- Uchanganuzi rasmi: P.L., R.P. na E.F.
- Utafiti: P.L., R.P. na E.F.
- Usimamizi wa data: P.L.
- Rasimu ya kwanza: P.L. na E.F.
- Mapitio na uhariri: R.P. na E.F.
- Uwasilishaji wa kuona: P.L.
- Usimamizi: E.F.
- Usimamizi wa mradi: R.P.
- Upatikanaji wa ufadhili: R.P.
Kikomo cha tafsiri ya kimethodolojia
Utafiti huu si jaribio la uzalishaji upya wa pamoja lililoendesha tena majaribio asilia ya makala 139 za ujifunzaji wa mashine. Alama inayopendekezwa hutathmini utayari wa uzalishaji upya kupitia artefakti zinazoonekana na taarifa za kuripoti. Kwa hiyo, alama na mafanikio ya uzalishaji upya wa vitendo haziwezi kutumika badala ya nyingine.
Aidha, upeo wa nyanja wa seti mbili za data chanzo zilizotumika ni mdogo; uzani wa vigezo katika matukio ya mfano uliundwa na watafiti kwa madhumuni ya kuonyesha na si mapendeleo yaliyopatikana kutoka kwa wadau halisi. Seti ya vigezo haijumuishi matatizo yote yanayowezekana ya uzalishaji upya, kama nasibu, evaluation leakage na determinism ya mazingira ya ukokotoaji, kama vigezo huru.
Kiungo rasmi cha uchapishaji: https://doi.org/10.3390/math14091536
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *