


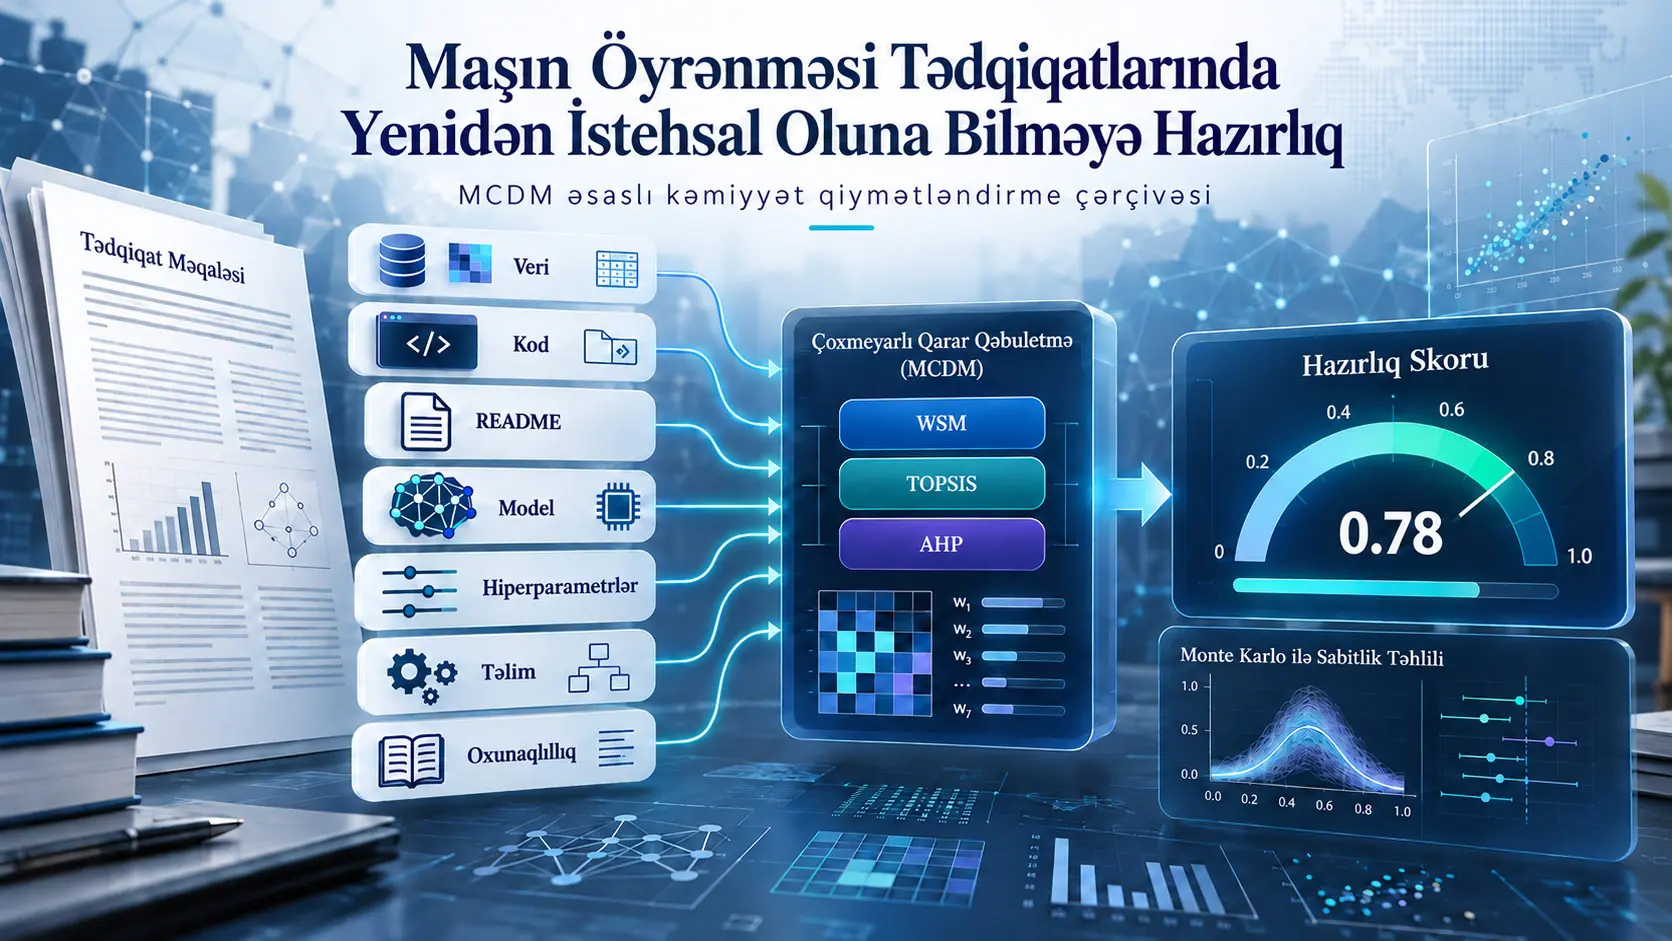
Bu tədqiqat maşın öyrənməsi üzrə bir araşdırmanın təcrübələrini yenidən işə salmadan, dərc olunmuş məqalənin və ona bağlı tədqiqat artefaktlarının R1 səviyyəli yenidən istehsal oluna bilməyə nə dərəcədə hazır olduğunu kəmiyyətcə ölçmək üçün Çoxmeyarlı Qərar Qəbuletmə (Multi-Criteria Decision Making, MCDM) əsaslı qiymətləndirmə çərçivəsi təklif edir. R1 yenidən istehsal oluna bilməyə hazırlıq, tədqiqatın eyni verilənlər, kod, model və hesablama mühiti ilə eyni nəticələrin yenidən əldə edilməsini dəstəkləyəcək verilənləri, kodu, öyrədilmiş modeli və metodoloji izahları nə dərəcədə təqdim etdiyini ifadə edən qiymətləndirmə anlayışıdır. Çərçivə yeddi meyardan istifadə edir: verilənlərin əlçatanlığı, kodun əlçatanlığı, README-nin mövcudluğu, öyrədilmiş modelin təqdim edilməsi, hiperparametrlərin açıqlanması, təlim prosesinin açıqlanması və məqalənin oxunaqlılığı. Meyarlar ordinal rubriklə qiymətləndirilir, [0,1] intervalına normallaşdırılır və Çəkili Cəm Modeli (Weighted Sum Model, WSM) ilə İdeal Həllə Bənzərliyə görə Üstünlük Sıralama Texnikasından (TOPSIS) istifadə olunaraq vahid hazırlıq skoruna çevrilir.
Çərçivənin hazırlanmasında mövcud iki yenidən istehsal oluna bilmə verilənlər toplusundan istifadə edilmişdir. Əsas qiymətləndirmə üçün Olszewski və həmkarlarının təmizlənmiş 215 məqaləlik verilənlər toplusundan sonlu populyasiya düzəlişli Cochran seçmə yanaşması ilə 139 məqalə təsadüfi seçilmişdir. Hər məqalə yeddi meyar üzrə tədqiqatçılar və ChatGPT tərəfindən müstəqil şəkildə qiymətləndirilmiş; iki qiymətləndirmənin ortalaması yekun meyar balı kimi istifadə olunmuşdur. İnsan və model dəstəkli qiymətləndirmələr arasında çəkili Cohen kappa orta göstəricisi \(\kappa=0.96\) kimi bildirilmişdir.
Bərabər meyar çəkilərinin istifadə edildiyi əsas qiymətləndirmədə WSM və TOPSIS eyni ikili təsnifat nəticəsini vermişdir. 0,5 qərar həddində çərçivənin istinad yenidən istehsal oluna bilmə etiketi ilə müqayisəsində dəqiqlik 0,64, precision 0,40, həssaslıq 0,70 və F1 skoru 0,51 olmuşdur. Bu nəticələr çərçivənin yenidən istehsal oluna bilən məqalələrin mühüm bir hissəsini aşkar edə bildiyini, lakin “hazır” görünən bəzi məqalələrin praktik yenidən istehsal zamanı uğursuz ola biləcəyini də göstərir.
Ən mühüm şərh məhdudiyyəti: Əldə edilən skor tədqiqatın həqiqətən yenidən istehsal edildiyini sübut edən nəticə deyil. Çərçivə təcrübələri işə salmır; məqalədə və bağlı artefaktlarda görünən hazırlıq səviyyəsini ölçür. Gizli asılılıqlar, işləməyən skriptlər, aparat və ya proqram təminatı uyğunsuzluğu, deterministik olmayan GPU əməliyyatları və ya praktik olaraq əlçatmaz verilənlər yüksək hazırlıq skoruna baxmayaraq real yenidən istehsalı əngəlləyə bilər. Bundan əlavə, aşağı hazırlıq skoru tədqiqatın elmi keyfiyyətinin, yeniliyinin və ya təsirinin aşağı olduğu mənasına gəlmir.
Maşın öyrənməsində yenidən istehsal oluna bilmə niyə ayrıca problemə çevrilir?
Maşın öyrənməsi tədqiqatlarında dərc edilmiş nəticənin yenidən əldə edilə bilməsi yalnız məqalədəki yekun dəqiqlik, F1 skoru və ya itki dəyərinin bilinməsindən asılı deyil. Tədqiqatçının hansı verilənlərdən istifadə etdiyi, verilənləri necə ilkin emal etdiyi, təlim və test bölünmələrinin necə aparıldığı, model arxitekturasının təfərrüatları, hiperparametrlər, təsadüfilik mənbələri, proqram asılılıqları və təlim kodunun həqiqətən icra oluna bilib-bilməməsi də nəticəni müəyyən edə bilər.
Mənbə tədqiqat yenidən istehsal edilə bilməyən nəticələrin elmi baxımdan iki əsas problem yaratdığını vurğulayır. Birincisi, dərc olunmuş iddiaların müstəqil şəkildə yoxlanmasını çətinləşdirməsidir. İkincisi isə sonrakı tədqiqatların yoxlanmamış əsas üzərində qurulması halında vaxtın və tədqiqat resurslarının boşa sərf oluna bilməsidir.
Mövcud həll təşəbbüsləri arasında yenidən istehsal oluna bilmə yoxlama siyahıları, nəşr qaydaları, açıq verilənlər və açıq kod siyasətləri, kod repozitoriyaları, konteynerləşdirmə və strukturlaşdırılmış sənədləşdirmə var. Lakin bunların mühüm hissəsi “var/yox” tipli ikili və ya keyfiyyət qiymətləndirmələri yaradır. Mənbə tədqiqatın həll etməyə çalışdığı boşluq, bir tədqiqat məqaləsi üçün qismən uyğunluğu da nəzərə alan, şərh edilə bilən və kəmiyyətcə yenidən istehsal oluna bilməyə hazırlıq skoru yaratmaq ehtiyacıdır.
R1 səviyyəli yenidən istehsal oluna bilməyə hazırlıq nədir?
R1 səviyyəli yenidən istehsal oluna bilməyə hazırlıq, bir işin eyni verilənlər, eyni kod, eyni model və eyni hesablama mühiti ilə eyni nəticələrin yenidən əldə edilməsini dəstəkləyəcək tədqiqat artefaktlarını və metodoloji izahları nə dərəcədə təmin etdiyini ifadə edir; bu tədqiqat R1 təcrübələrini faktiki olaraq yenidən işə salmaq əvəzinə, həmin yenidən istehsala yönəlmiş görünən hazırlığı məqalə və əlaqəli artefaktlar üzərindən ölçür.
R1, R2 və R3 arasındakı fərq
| Səviyyə | Əsas məntiq | Nə qorunur? | Bu tədqiqatın əhatəsidirmi? |
|---|---|---|---|
| R1 | Eyni nəticələrin ilkin artefaktlarla yenidən əldə edilməsi | Eyni verilənlər, kod, model və hesablama mühiti | Bəli |
| R2 | Müstəqil tətbiqlə yenidən istehsal | İlkin verilənlər qorunur; tətbiq müstəqil ola bilər | Xeyr |
| R3 | Fərqli verilənlər və modelləşdirmə yanaşmaları ilə oxşar elmi nəticəyə çatmaq | Şərh və ya elmi nəticə səviyyəsi | Xeyr |
R1-in seçilməsinin əsas səbəbi obyektiv olaraq daha asan qiymətləndirilə bilməsidir. R2 və R3 müstəqil tətbiqlər və alternativ verilənlər və ya modellər tələb etdiyi üçün əksər hallarda real yenidən istehsal təcrübələrinin aparılmasını tələb edir. Mənbə çərçivə isə məqalə səviyyəsində, təcrübələri yenidən işə salmadan istifadə olunmaq üçün hazırlanmışdır.
Yenidən istehsal edilə bilməmənin əsas mənbələri
Kod və hesablama mühiti: Kodun ümumiyyətlə paylaşılmaması, yalnız qismən paylaşılması və ya asılılıq versiyalarının göstərilməməsi eyni əməliyyatların yenidən qurulmasına mane ola bilər.
Verilənlərin əlçatanlığı: Özəl, qapalı və ya yalnız qismən təqdim olunan verilənlər topluları təcrübənin yenidən aparılmasını birbaşa məhdudlaşdıra bilər. İlkin emal addımlarının açıqlanmaması və ya verilən sızması kimi metodoloji problemlər də ilkin nəticə ilə yenidən istehsal arasındakı fərqi böyüdə bilər.
Təsadüfilik: Çəkilərin başlanğıclaşdırılması, seçmə, mini-batch sıralaması və oxşar stoxastik komponentlər nəzarət edilmədikdə eyni kod belə fərqli nəticələr yarada bilər. Bundan əlavə GPU əməliyyatları, paralellik və sürüşən nöqtə fərqləri bəzi mühitlərdə tam deterministik işləməyə mane ola bilər.
Hesabatvermə: Yalnız uğurlu təcrübələrin bildirilməsi, istifadə olunan statistikanın aydın göstərilməməsi, qeyri-müəyyənliklərin gizlədilməsi və ya təlim təfərrüatlarının natamam verilməsi tədqiqatın yenidən qurulmasını çətinləşdirə bilər.
Nə üçün yoxlama siyahısı təkbaşına kifayət hesab edilməmişdir?
Bir çox yoxlama siyahısı “kod varmı?”, “verilənlər mövcuddurmu?” və ya “hiperparametrlər açıqlanıbmı?” kimi faydalı suallar ehtiva edir. Lakin ikili işarələmə qismən uyğunluğu kifayət qədər təmsil etmir. Məsələn, ümumiyyətlə kod paylaşmayan iş ilə kod paylaşsa da onun bir hissəsini çatışmayan qoyan iş eyni “xeyr” kateqoriyasına düşə bilər.
Bu tədqiqat buna görə ordinal, yəni sıralı qiymətləndirmə məntiqindən istifadə edir. Beləliklə “heç yoxdur”, “qismən var” və “kifayət qədər tamamlanıb” səviyyələri riyazi olaraq bir-birindən fərqləndirilə bilər.
MCDM bu qiymətləndirmədə niyə istifadə olunur?
Çoxmeyarlı Qərar Qəbuletmə (MCDM), verilənlərin əlçatanlığı, kod, sənədləşdirmə, model artefaktı və metodoloji aydınlıq kimi müxtəlif növ yenidən istehsal oluna bilmə göstəricilərini ortaq miqyasa gətirib çəkiləndirərək vahid və şərh edilə bilən skor yaratmağa imkan verdiyi üçün istifadə olunur; eyni struktur meyar çəkilərinin qiymətləndirmə məqsədinə uyğun dəyişdirilməsini də mümkün edir.
Çərçivənin yeddi əsas meyarı
| Meyar | Nə qiymətləndirilir? |
|---|---|
| Verilənlərin əlçatanlığı | Məqalədə istifadə olunan verilənlər toplusunun ictimai, qismən, həssas və ya sorğu əsasında əlçatan olub-olmaması. |
| Kodun əlçatanlığı | Təcrübələrin yenidən aparılmasına imkan verəcək kodun mövcud və kifayət qədər tamamlanmış olub-olmaması. |
| README-nin mövcudluğu | Mühiti, asılılıqları və iş addımlarını açıqlayan istifadə sənədlərinin olub-olmaması və yetərliliyi. |
| Öyrədilmiş modelin təqdim edilməsi | Modeli yenidən öyrətmədən istifadə etməyə imkan verən çəkilərin və ya öyrədilmiş model artefaktlarının mövcudluğu. |
| Hiperparametr açıqlaması | Təlimdə istifadə olunan əsas hiperparametrlərin nə dərəcədə göstərilməsi. |
| Təlim açıqlaması | İlkin emalın, seçmənin, təlim/test bölünməsinin və təlim prosedurunun açıqlıq səviyyəsi. |
| Məqalənin oxunaqlılığı | Metod izahının strukturu, ardıcıllığı və anlaşıqlılığı. |
Bu yeddi meyar necə seçilmişdir?
Meyarların hazırlanması üç mərhələdə aparılmışdır. Birinci mərhələdə yenidən istehsal oluna bilmə ədəbiyyatı, mövcud yoxlama siyahıları və məlum yenidən istehsal edilə bilməmə mənbələri nəzərdən keçirilmişdir. Bu mərhələ verilənlər, kod, öyrədilmiş model və README kimi icra edilə bilən artefaktlar ilə təlim prosesi və hiperparametr açıqlığı kimi metodoloji şəffaflıq komponentlərinin əhatə edilməsini təmin etmişdir.
İkinci mərhələdə iki mövcud verilənlər toplusu üzərində logistika reqressiyası, Random Forest və XGBoost istifadə olunaraq yenidən istehsal oluna bilmə etiketi ilə əlaqəli amillər araşdırılmışdır. Bu modellər meyarları avtomatik və qəti şəkildə seçən “hakim” kimi istifadə edilməmiş; nəzəri seçimi dəstəkləyən empirik sübut yaratmışdır.
Üçüncü mərhələdə nəzəri və empirik sübutlar birləşdirilərək məqalə və bağlı artefaktlardan, təcrübə işə salınmadan qiymətləndirilə bilən kompakt yeddi meyarlı dəst yaradılmışdır.
Çərçivə nələri əhatədən kənarda saxlayır?
Yeddi meyar geniş olsa da, tükənməz siyahı deyil. Avtomatik testlərin mövcudluğu, proqram lisenziyalarının uyğunluğu, data kartları kimi strukturlaşdırılmış verilən sənədləşdirilməsi, təsadüfiliyə nəzarət, aparat/proqram determinizmi və qiymətləndirmə sızması kimi amillər müstəqil meyarlar kimi modelə daxil edilməmişdir.
Bu amillərdən bəziləri təlim izahı və ya sənədləşdirmə keyfiyyəti vasitəsilə dolayı şəkildə əhatə oluna bilər; lakin mənbə tədqiqat onların tam təmsil edildiyini iddia etmir.
Tədqiqatın Metodu və Nəticələri
İstifadə olunan iki verilənlər mənbəyi
| Verilənlər toplusu | Başlanğıc ölçü | Əhatə | Elmi rolu |
|---|---|---|---|
| Olszewski və b. | 745 məqalə | 2013–2022, NDSS, IEEE S&P, CCS və USENIX; 19 yenidən istehsal oluna bilmə xüsusiyyəti və ikili məqalə etiketi | Əsas seçmə və MCDM qiymətləndirməsinin bazası |
| Raff | 255 məqalə | Əsasən NeurIPS və ICML; 1984–2017; 28 annotasiya xüsusiyyəti | Xüsusilə struktur və oxunaqlılıq kimi amillərlə empirik araşdırmanı zənginləşdirmək |
Verilənlərin təmizlənməsi
Olszewski verilənlər toplusunda çatışmayan və analitik baxımdan faydalı olmayan qeydlər çıxarılmışdır. Çatışmayan kateqorik dəyərlər süni şəkildə doldurulmamış; müvafiq sətirlər silinmiş və 745 məqaləlik verilənlər 292 məqaləyə enmişdir. Başlıq, müəllif, nəşr yeri identifikatorları və bağlantılar kimi ümumi meyar qiymətləndirməsinə töhfə verməyən sahələr ilə lazımsız və ya yalnız mətn xarakterli dəyişənlər çıxarılmışdır. Səkkiz yenidən istehsal oluna bilmə xüsusiyyəti saxlanılmışdır.
Daha sonra yenidən istehsal oluna bilmə etiketi yalnız “tam yenidən istehsal oluna bilən” və “yenidən istehsal oluna bilməyən” kimi etiketlənmiş məqalələrlə məhdudlaşdırılmış və yekun təmiz verilənlər toplusu 215 məqalədən ibarət olmuşdur.
Raff verilənlər toplusunda bir çatışmayan dəyər düzəldilmiş və çox seyrək bir xüsusiyyət çıxarılmışdır. Nəşr yeri və mövzuya xas dəyişənlərin çıxarılmasından sonra 20 xüsusiyyət saxlanılmışdır. Kateqorik dəyişənlər ikili göstəricilərə çevrilmişdir. Logistika reqressiyasında ədədi xüsusiyyətlər əmsalların müqayisəsi üçün min–max üsulu ilə [0,1] intervalına miqyaslanmış, ağac əsaslı modellərdə isə ədədi dəyişənlər miqyaslanmadan istifadə edilmişdir.
Empirik meyar araşdırması
İki verilənlər toplusu ayrı-ayrılıqda modelləşdirilmişdir. Logistika reqressiyası şərh edilə bilən başlanğıc model, Random Forest və XGBoost isə qeyri-xətti əlaqələri və xüsusiyyət qarşılıqlı təsirlərini tutmaq üçün istifadə edilmişdir. Hər iki verilənlər toplusunda təlim/test bölünməsi %80/%20 olmuşdur.
Sinif balanssızlığı Random Forest üçün balanslaşdırılmış sinif çəkiləri, XGBoost üçün isə scale_pos_weight parametri ilə idarə edilmişdir.
Tənlik (1): XGBoost qazanc əsaslı xüsusiyyət əhəmiyyəti
\[ \mathrm{Imp}(j) = \sum_{\text{j özelliğini kullanan bölünmeler}} \Delta L_{\mathrm{split}} \]
1. Formula nəyi hesablayır? XGBoost qərar ağaclarında müəyyən \(j\) xüsusiyyətinin istifadə edildiyi bölünmələrin model məqsəd/itki funksiyasında yaratdığı ümumi yaxşılaşmanı hesablayır.
2. Dəyişənlər hansılardır? \(\mathrm{Imp}(j)\), \(j\) xüsusiyyətinin əhəmiyyətidir. \(\Delta L_{\mathrm{split}}\), həmin xüsusiyyətdən istifadə edən konkret ağac bölünməsinin məqsəd funksiyasında təmin etdiyi itki azalmasıdır.
3. Vahidlər hansılardır? Bu fiziki ölçü deyil. Xam dəyər XGBoost məqsəd funksiyasındakı yaxşılaşmadan asılı alqoritmik əhəmiyyət kəmiyyətidir. Tədqiqatda əhəmiyyət dəyərləri müqayisə oluna bilməsi üçün sonradan min–max normallaşdırılmışdır.
4. Riyazi rolu nədir? Eyni xüsusiyyət bir neçə ağac və bölünmədə istifadə oluna bilər. Formula bu xüsusiyyətin təmin etdiyi bütün itki azalmalarını toplayır.
5. Alqoritmik mənası nədir? Böyük \(\mathrm{Imp}(j)\), modelin yenidən istehsal oluna bilmə sinfini ayırarkən müvafiq xüsusiyyəti faydalı hesab etdiyini göstərir.
6. Hansı şərt altında keçərlidir? Bu əhəmiyyət XGBoost modelinin qurduğu ağaclardan, verilənlər toplusundan və təlim quruluşundan asılıdır; səbəb-nəticə təsiri deyil.
7. Nəticə necə şərh edilməlidir? Yüksək xüsusiyyət əhəmiyyəti müvafiq amilin nəzəri baxımdan zəruri yenidən istehsal oluna bilmə şərti olduğunu təkbaşına sübut etmir. Mənbə tədqiqat bu dəyərləri meyar seçiminin qəti həddi deyil, nəzəri analizlə birlikdə istifadə olunan dəstəkləyici sübut kimi qiymətləndirmişdir.
Tənlik (2): ikili xüsusiyyətin orta proqnoz təsiri
\[ \Delta_j = \frac{1}{N} \sum_{i=1}^{N} \left[ P\left( y=1 \mid x_j^{(i)}=1,\, x_{-j}^{(i)} \right) - P\left( y=1 \mid x_j^{(i)}=0,\, x_{-j}^{(i)} \right) \right] \]
1. Formula nəyi hesablayır? İkili xüsusiyyətin 0-dan 1-ə dəyişdirilməsinin, digər bütün xüsusiyyətlər eyni saxlanılarkən modelin “yenidən istehsal oluna bilən” sinfinə verdiyi proqnoz ehtimalında orta hesabla nə qədər dəyişiklik yaratdığını hesablayır.
2. Dəyişənlər hansılardır? \(N\) məqalə sayıdır. \(y=1\) yenidən istehsal oluna bilən sinfi göstərir. \(x_j^{(i)}\), \(i\)-ci məqalədə araşdırılan \(j\) xüsusiyyətidir. \(x_{-j}^{(i)}\), eyni məqalədəki digər bütün xüsusiyyətlərdir.
3. Vahidlər hansılardır? \(\Delta_j\) ehtimal fərqi miqyasındadır və fiziki vahidi yoxdur.
4. Riyazi rolu nədir? Hər məqalə iki dəfə qiymətləndirilir: müvafiq xüsusiyyət hipotetik olaraq 1 və 0 edilir. İki proqnoz arasındakı fərqlər bütün məqalələr üzrə ortalanır.
5. Alqoritmik mənası nədir? Müsbət \(\Delta_j\), xüsusiyyətin mövcudluğunun model proqnozunda yenidən istehsal oluna bilən sinfə doğru hərəkətlə əlaqəli olduğunu; mənfi dəyər əks istiqamətli proqnoz dəyişimini göstərir.
6. Hansı şərtlərdə keçərlidir? Bu dəyər öyrədilmiş proqnoz modelinin davranışını izah edir. Xüsusiyyətlərin real dünyadakı səbəb-nəticə təsirini sübut etmir.
7. Nəticə necə şərh edilməlidir? Xüsusiyyət təsiri XGBoost-un konkret verilənlər toplusunda öyrəndiyi əlaqəni şərh etmək üçün istifadə olunmuş və meyar seçimi nəzəri yenidən istehsal oluna bilmə bilgisi ilə birlikdə aparılmışdır.
Seçilmiş ordinal rubrik
| Meyar | Səviyyə | Məna |
|---|---|---|
| Verilənlərin əlçatanlığı | 0 | Verilənlər toplusu ictimai deyil. |
| 1 | Verilənlər həssas kimi müəyyənləşdirilib. | |
| 2 | Verilənlər qismən əlçatandır və ya sorğu əsasında təqdim olunur. | |
| 3 | Verilənlər ictimai şəkildə əlçatandır. | |
| Kodun əlçatanlığı | 0 | Kod ictimai deyil. |
| 1 | Kod qismən mövcuddur və ya tam yenidən icranı əngəlləyən çatışmazlıqlar var. | |
| 2 | Kod ictimai və kifayət qədər tamamlanmışdır. | |
| README | 0 | README və ya istifadə təlimatı yoxdur. |
| 1 | README var, lakin mühüm addımlar və ya asılılıqlar çatışmır. | |
| 2 | README iş axınını icra etmək üçün kifayət qədər tamamlanıb. | |
| Öyrədilmiş model | 0 | Öyrədilmiş model artefaktı təqdim edilməyib. |
| 1 | Öyrədilmiş model artefaktı təqdim edilib. | |
| Hiperparametrlər | 0 | Hiperparametrlər açıqlanmayıb. |
| 1 | Qismən açıqlanıb. | |
| 2 | Tam şəkildə açıqlanıb. | |
| Təlim açıqlaması | 0 | Təlim/ilkin emal/bölünmələr açıqlanmayıb. |
| 1 | Qismən açıqlanıb. | |
| 2 | Tam şəkildə açıqlanıb. | |
| Məqalənin oxunaqlılığı | 0 | Struktur qeyri-müəyyəndir və mühüm metod addımlarını izləmək çətindir. |
| 1 | Ümumi struktur məntiqlidir, lakin qeyri-müəyyən və ya ziddiyyətli hissələr var. | |
| 2 | Yaxşı təşkil olunub, aydındır və metod izahı ardıcıldır. |
Tənlik (3): ordinal balın [0,1] intervalına normallaşdırılması
\[ x_k = \frac{s_k}{L_k}, \qquad x_k\in[0,1] \]
1. Formula nəyi hesablayır? Fərqli maksimum səviyyələrə malik meyarların ballarını ortaq [0,1] miqyasına çevirir.
2. Dəyişənlər hansılardır? \(s_k\), \(k\)-cı meyar üçün verilmiş ordinal baldır. \(L_k\), eyni meyarın mümkün ən yüksək ordinal səviyyəsidir. \(x_k\), normallaşdırılmış meyar dəyəridir.
3. Vahidlər hansılardır? \(x_k\) ölçüsüzdür.
4. Riyazi rolu nədir? Məsələn maksimum səviyyəsi 3 olan verilənlərin əlçatanlığı ilə maksimum səviyyəsi 1 olan öyrədilmiş model meyarını eyni ədədi intervalda müqayisə edilə bilən edir.
5. Alqoritmik mənası nədir? \(x_k=0\), meyarın ən aşağı; \(x_k=1\), ən yüksək müəyyən edilmiş hazırlıq səviyyəsində olduğunu göstərir.
6. Fərziyyə nədir? Xətti normallaşdırma qonşu ordinal səviyyələr arasındakı fərqlərin bərabər addımlar olduğunu fərz edir. Mənbə tədqiqat bunun sadə və şəffaf olduğunu, lakin real fayda artımının mütləq xətti olmaya biləcəyini açıq şəkildə qəbul edir.
7. Nəticə necə şərh edilməlidir? Məsələn \(s_k=2\) və \(L_k=3\) olduqda:
\[ x_k=\frac{2}{3}\approx0.667 \]
Bu dəyər “%66,7 həqiqətən yenidən istehsal oluna biləndir” demək deyil; yalnız müvafiq meyarda maksimum ordinal səviyyəyə nisbətən normallaşdırılmış uyğunluq dərəcəsidir.
Seçmə ölçüsü və annotasiya
Təmizlənmiş 215 məqaləlik Olszewski verilənlər toplusundan seçmə aparılarkən mənbə tədqiqat sonlu populyasiya düzəlişli Cochran yanaşmasından istifadə etmişdir. %95 etibar səviyyəsi, qoruyucu populyasiya nisbəti kimi p=0,5 və %5 xəta həddi istifadə edildikdə seçmə ölçüsü 139 məqalə kimi hesablanmışdır.
Mənbə məqalə Cochran hesabının cəbri tənliyini nömrələnmiş formula kimi vermir. Buna görə burada mənbənin təqdim etmədiyi ayrıca Cochran tənliyi əlavə edilməmişdir.
139 məqalə yeddi meyarın hamısında həm tədqiqat müəllifləri, həm də ChatGPT tərəfindən müstəqil şəkildə qiymətləndirilmişdir.
Tənlik (4): iki annotasiyanın birləşdirilməsi
\[ S_{\mathrm{final}} = \frac{ A_{\mathrm{study}} + A_{\mathrm{ChatGPT}} }{2} \]
1. Formula nəyi hesablayır? Tədqiqatçı annotasiyası ilə ChatGPT annotasiyasının arifmetik ortasını götürərək meyarın yekun balını yaradır.
2. Dəyişənlər hansılardır? \(A_{\mathrm{study}}\), tədqiqat komandasının meyar balı; \(A_{\mathrm{ChatGPT}}\), model tərəfindən verilən meyar balıdır.
3. Vahidlər hansılardır? Dəyər müvafiq meyarın ordinal bal miqyasındadır.
4. Riyazi rolu nədir? İki qiymətləndirici bərabər çəki ilə birləşdirilir.
5. Alqoritmik mənası nədir? Yekun balın yalnız insan və ya yalnız LLM qiymətləndirməsinə əsaslanmasının qarşısını alan sadə birləşdirmə əməliyyatıdır.
6. Şərt nədir? İki annotasiya eyni meyar və eyni ordinal rubrik üzrə aparılmalıdır.
7. Nəticə necə şərh edilməlidir? İki annotasiya arasında çox yüksək ümumi uyğunluq bildirilmişdir: çəkili Cohen kappa orta göstəricisi \(\kappa=0.96\). Bununla yanaşı, oxunaqlılıq kimi daha subyektiv meyarlarda uyğunluq nisbətən aşağıdır və tədqiqat yalnız məhdud sayda annotatordan istifadə etmişdir.
MCDM skorunun hesablanması
Normallaşdırmadan sonra hər meyar \(x_i\in[0,1]\) intervalındadır. Tədqiqat iki ayrı, şərh edilə bilən MCDM toplulaşdırma üsulundan istifadə edir: WSM və TOPSIS.
WSM ilə TOPSIS arasındakı əsas fərq nədir?
WSM meyar ballarını çəkili xətti cəm kimi birləşdirərkən TOPSIS hər məqalənin meyar profilinin bütün meyarların ən yaxşı olduğu ideal profilə və bütün meyarların ən pis olduğu anti-ideal profilə məsafəsini ölçür; buna görə eyni çəkilər istifadə olunsa belə iki üsul güclü və zəif meyar kombinasiyalarına fərqli reaksiya verə bilər.
Tənlik (5): Çəkili Cəm Modeli — WSM
\[ S = \sum_{i=1}^{n}w_i x_i, \qquad \sum_{i=1}^{n}w_i=1 \]
1. Formula nəyi hesablayır? Normallaşdırılmış bütün meyarların çəkili ortasını götürərək vahid yenidən istehsal oluna bilməyə hazırlıq skoru yaradır.
2. Dəyişənlər hansılardır? \(x_i\), \(i\)-ci meyarın normallaşdırılmış skoru; \(w_i\), meyar çəkisi; \(n\), meyar sayıdır. Bu tədqiqatda \(n=7\)-dir. \(S\), yekun WSM skorudur.
3. Vahidlər hansılardır? Bütün dəyərlər ölçüsüzdür və \(S\in[0,1]\) intervalındadır.
4. Riyazi rolu nədir? Hər meyar öz əhəmiyyət çəkisi ilə vurulur və yeddi töhfə toplanır.
5. Alqoritmik mənası nədir? Daha yüksək çəkili meyarlarda yaxşı performans yekun skora daha çox töhfə verir.
6. Əsas fərziyyə nədir? WSM meyarlar arasında toplanan müstəqillik fərz edir. Yəni bir meyardakı yaxşı performans başqa meyardakı zəifliyi riyazi olaraq kompensasiya edə bilər.
7. Nəticə necə şərh edilməlidir? Mənbə tədqiqat bu fərziyyənin yenidən istehsal oluna bilmənin real məntiqini tam əks etdirməyə biləcəyini bildirir. Məsələn kod və ya verilənlər tamamilə yoxdursa, digər meyarların güclü olması real yenidən istehsalı mümkün etməyə bilər. Buna görə WSM şəffaf təxmini skor yaradır; meyarlar arasındakı zəruri asılılıqları tam modelləşdirmir.
Tənlik (6): TOPSIS ideal və anti-ideal profilləri
\[ v_j^{+}=1, \qquad v_j^{-}=0 \]
1. Formula nəyi müəyyənləşdirir? TOPSIS üçün hər meyarın ideal və anti-ideal istinad dəyərlərini müəyyənləşdirir.
2. Dəyişənlər hansılardır? \(v_j^{+}\), \(j\)-ci meyarın ideal dəyəri; \(v_j^{-}\), anti-ideal dəyəridir.
3. Vahidlər hansılardır? Normallaşdırılmış [0,1] miqyasında ölçüsüz dəyərlərdir.
4. Riyazi rolu nədir? Bütün meyarlarda 1 alan nəzəri profil mükəmməl hazırlıq istinadı, bütün meyarlarda 0 alan profil isə ən pis istinaddır.
5. Alqoritmik mənası nədir? Real məqalənin skor profili bu iki istinada görə yerləşdirilir.
6. Şərt nədir? Bütün meyarların “daha yüksək dəyər daha yaxşıdır” istiqamətində normallaşdırılmış olması lazımdır.
7. Nəticə necə şərh edilməlidir? İdeal nöqtə real məqalə olmaq məcburiyyətində deyil; müqayisə məqsədilə müəyyən edilmiş riyazi istinaddır.
Tənlik (7): ideal və anti-ideal profilə məsafə
\[ D_i^{+} = \sqrt{ \sum_{j=1}^{n} w_j \left( v_{ij}-v_j^{+} \right)^2 } \]
\[ D_i^{-} = \sqrt{ \sum_{j=1}^{n} w_j \left( v_{ij}-v_j^{-} \right)^2 } \]
1. Formula nəyi hesablayır? Məqalə \(i\)-nin meyar profilinin ideal və anti-ideal profillərə çəkili Evklid məsafəsini hesablayır.
2. Dəyişənlər hansılardır? \(v_{ij}\), məqalə \(i\)-nin meyar \(j\)-dəki normallaşdırılmış dəyəridir. \(w_j\), meyar çəkisidir. \(v_j^{+}\) və \(v_j^{-}\) ideal və anti-ideal dəyərlərdir.
3. Vahidlər hansılardır? Normallaşdırılmış meyar fəzasında ölçüsüz məsafələrdir.
4. Riyazi rolu nədir? Hər meyardakı istinad fərqinin kvadratı alınır, çəki ilə vurulur, cəmin kvadrat kökü alınır.
5. Alqoritmik mənası nədir? Kiçik \(D_i^{+}\), məqalənin ideal profilə yaxın olduğunu; böyük \(D_i^{-}\), ən pis profildən uzaq olduğunu göstərir.
6. Şərt nədir? Meyarların eyni normallaşdırılmış fəzada olması və çəkilərin qərar modelinin prioritetlərini təmsil etməsi lazımdır.
7. Nəticə necə şərh edilməlidir? Təkcə məsafələrdən biri kifayət deyil; TOPSIS hər ikisini birlikdə Tənlik (8) ilə nisbi yaxınlığa çevirir.
Tənlik (8): TOPSIS nisbi yaxınlıq skoru
\[ C_i = \frac{D_i^{-}} {D_i^{+}+D_i^{-}} \]
1. Formula nəyi hesablayır? Məqalə \(i\)-nin ideal profilə nisbi yaxınlığını hesablayır.
2. Dəyişənlər hansılardır? \(D_i^{+}\) ideal həllə məsafə, \(D_i^{-}\) anti-ideal həllə məsafədir.
3. Vahidlər hansılardır? \(C_i\) ölçüsüzdür və \(0\leq C_i\leq1\) intervalındadır.
4. Riyazi rolu nədir? Anti-idealdan məsafəni iki məsafənin cəminə nisbətləndirərək vahid ədəd yaradır.
5. Alqoritmik mənası nədir? \(C_i\) böyüdükcə məqalə ideal yenidən istehsal oluna bilməyə hazırlıq profilinə daha yaxındır.
6. Şərt nədir? Məsafələrin eyni meyar fəzasında və eyni çəkilərlə hesablanması lazımdır.
7. Nəticə necə şərh edilməlidir? \(C_i=0.8\) “iş 80% ehtimalla yenidən istehsal oluna bilər” demək deyil. Skor müəyyən edilmiş yeddi meyar və çəki sistemi altında ideal profilə nisbi yaxınlığı göstərir.
Əsas qiymətləndirmə: bərabər çəkilər
Əsas qiymətləndirmədə yeddi meyarın hər biri bərabər çəki almışdır. Beləliklə nəticələrin konkret qərarverənin subyektiv prioritetləri tərəfindən yönləndirilməsinin qarşısı alınaraq rubrik və meyar sisteminin əsas davranışı araşdırılmışdır.
WSM və TOPSIS skorları [0,1] intervalındadır. Mənbə tədqiqat 0 ilə 1 arasındakı qərar hədlərini 0,1 addımlarla əl ilə yoxlamış və 0,5 həddinin dəqiqlik, precision və həssaslıq arasında ən balanslı nəticəni verdiyini bildirmişdir.
İstinad etiketinə qarşı nəticələr
139 məqaləlik seçmədə istinad etiketinin paylanması balanssızdır: 102 mənfi və 37 müsbət məqalə var.
| İstinad | 0 proqnozu | 1 proqnozu |
|---|---|---|
| 0 — yenidən istehsal oluna bilməyən etiketi | 63 | 39 |
| 1 — yenidən istehsal oluna bilən etiketi | 11 | 26 |
| Metrik | Dəyər |
|---|---|
| Dəqiqlik | 0,64 |
| Precision | 0,40 |
| Həssaslıq | 0,70 |
| F1 skoru | 0,51 |
Həssaslığın 0,70 olması, istinad verilənlər toplusunda yenidən istehsal oluna bilən kimi etiketlənmiş məqalələrin mühüm hissəsinin hazırlıq çərçivəsi tərəfindən də tutulduğunu göstərir. Precision-un 0,40 olması isə “hazır” kimi təsnif edilən məqalələrin mühüm hissəsinin istinad etiketində yenidən istehsal oluna bilməyən olduğunu göstərir.
Mənbə bu fərqi yalnız çərçivənin uğursuzluğu kimi şərh etmir. Çərçivə kod, verilənlər və izahların görünən hazırlığını qiymətləndirərkən istinad etiketi praktik yenidən istehsal nəticəsini təmsil edir. Görünməyən mühit problemi və ya natamam tətbiq kimi bir maneə məqalə kağız üzərində hazır görünsə belə icra zamanı uğursuzluğa səbəb ola bilər.
Sadə artefakt qaydaları ilə müqayisə
| Model | Precision | Həssaslıq | F1 |
|---|---|---|---|
| Yalnız kod | 0,27 | 0,62 | 0,38 |
| Yalnız verilənlər | 0,33 | 0,73 | 0,45 |
| Kod VƏ YA verilənlər | 0,30 | 0,86 | 0,45 |
| Kod VƏ verilənlər | 0,30 | 0,49 | 0,37 |
| WSM/TOPSIS — bərabər çəki | 0,40 | 0,70 | 0,51 |
“Kod VƏ YA verilənlər” qaydası 0,86 ilə ən yüksək həssaslığı təmin etsə də, aşağı precision səbəbindən çoxlu yanlış müsbət yaradır. Yeddi meyarlı MCDM yanaşması ən yüksək F1 skoruna çataraq daha balanslı nəticə verir.
AHP ilə üç çəkiləndirmə ssenarisi
Mənbə tədqiqat Analitik İyerarxiya Prosesini (Analytic Hierarchy Process, AHP) kontekstə uyğun meyar çəkisi törətməyin praktik üsulu kimi göstərmişdir. Meyar müqayisələri Saaty-nin 1–9 şkalası ilə qurulmuş, müqayisə matrisləri normallaşdırılmış və ardıcıllıq Consistency Ratio (CR) ilə yoxlanılmışdır.
Mənbə bu bölmədə AHP-nin ayrıca nömrələnmiş tənliyini vermir. Buna görə burada mənbədə olmayan AHP formulu yaradılmamışdır.
| Meyar | S1: Bərabər | S2: Verilənlər və Kod | S3: Təlim və Oxunaqlılıq |
|---|---|---|---|
| Verilənlərin əlçatanlığı | 0,143 | 0,241 | 0,107 |
| Kodun əlçatanlığı | 0,143 | 0,241 | 0,107 |
| README | 0,143 | 0,103 | 0,107 |
| Öyrədilmiş model | 0,143 | 0,103 | 0,036 |
| Hiperparametr açıqlaması | 0,143 | 0,103 | 0,143 |
| Təlim açıqlaması | 0,143 | 0,103 | 0,250 |
| Məqalənin oxunaqlılığı | 0,143 | 0,103 | 0,250 |
| Cəmi | 1,000 | 1,000 | 1,000 |
Üç ssenaridə də \(\lambda_{\max}=7.0\) və \(CR=0.0\) bildirilmişdir. İstifadə olunan çəkilər real maraqlı tərəf qrupundan toplanmış üstünlüklər deyil; müxtəlif qərar məqsədlərinin skoru necə dəyişdirdiyini göstərmək üçün hazırlanmış nümunə ssenarilərdir.
On nümunə məqalədə çəki dəyişiminin təsiri
| No | Məqalə | WSM S1 | WSM S2 | WSM S3 | TOPSIS S1 | TOPSIS S2 | TOPSIS S3 |
|---|---|---|---|---|---|---|---|
| 1 | WTAGRAPH: Web Tracking and Advertising Detection using Graph Neural Networks | 0,286 | 0,207 | 0,446 | 0,277 | 0,210 | 0,490 |
| 2 | DeepSteal: Advanced Model Extractions Leveraging Efficient Weight Stealing in Memories | 0,429 | 0,448 | 0,500 | 0,370 | 0,442 | 0,484 |
| 3 | Model Stealing Attacks Against Inductive Graph Neural Networks | 0,452 | 0,420 | 0,589 | 0,375 | 0,385 | 0,570 |
| 4 | Phishpedia: A Hybrid Deep Learning Based Approach to Visually Identify Phishing Webpages | 0,643 | 0,603 | 0,643 | 0,649 | 0,575 | 0,627 |
| 5 | Cheetah: Lean and Fast Secure Two-Party Deep Neural Network Inference | 0,524 | 0,609 | 0,554 | 0,424 | 0,555 | 0,501 |
| 6 | DEEPCASE: Semi-Supervised Contextual Analysis of Security Events | 0,643 | 0,741 | 0,714 | 0,478 | 0,625 | 0,658 |
| 7 | Khaleesi: Breaker of Advertising and Tracking Request Chains | 0,595 | 0,592 | 0,750 | 0,447 | 0,498 | 0,712 |
| 8 | AI/ML for Network Security: The Emperor Has No Clothes | 0,786 | 0,845 | 0,679 | 0,782 | 0,837 | 0,622 |
| 9 | Improving Password Guessing via Representation Learning | 0,524 | 0,471 | 0,714 | 0,402 | 0,401 | 0,638 |
| 10 | Privacy Risks of Securing Machine Learning Models against Adversarial Examples | 0,595 | 0,661 | 0,696 | 0,431 | 0,549 | 0,611 |
Verilənlər və kodun çəkisinin artırıldığı S2 ssenarisində artefakt paylaşımı güclü olan 6, 8 və 10 nömrəli məqalələrin WSM skorları yüksəlmişdir. Əksinə, 1 nömrəli məqalənin WSM skoru 0,286-dan 0,207-yə düşmüşdür.
Təlim açıqlaması və oxunaqlılığın önə çəkildiyi S3 ssenarisində 1, 3, 6, 7 və 9 nömrəli məqalələrin WSM skorları S1-lə müqayisədə artmışdır. Beləliklə çəkilərin yalnız texniki detal deyil, qiymətləndirmə məqsədini birbaşa təmsil edən modelləşdirmə seçimi olduğu görünür.
Monte Carlo həssaslıq və dayanıqlılıq analizi
AHP çəkilərinin kiçik qeyri-müəyyənliklərə nə qədər həssas olduğunu araşdırmaq üçün hər meyar çəkisi müstəqil olaraq başlanğıc dəyərinin ±%20 ətrafında dəyişdirilmiş, sonra bütün çəkilərin cəmi yenidən 1 olacaq şəkildə normallaşdırılmışdır.
Hər ssenari üçün 500 fərqli perturbasiya olunmuş çəki vektoru yaradılmış və hər vektorla həm WSM, həm də TOPSIS skorları yenidən hesablanmışdır. Nəticələr orta və 5–95-ci persentil intervalı ilə qiymətləndirilmişdir.
| Üsul | S1 | S2 | S3 |
|---|---|---|---|
| WSM orta variasiya | 0,091 | 0,089 | 0,083 |
| TOPSIS orta variasiya | 0,114 | 0,116 | 0,127 |
WSM çəki dəyişikliklərinə qarşı TOPSIS-dən bir qədər aşağı variasiya göstərmişdir. TOPSIS-in məsafəyə əsaslanan quruluşu meyar çəkilərindəki dəyişikliklərə daha həssas ola bilər. Bununla belə hər iki üsulda müşahidə olunan dəyişiklik [0,1] ümumi skor intervalına nisbətən məhdud qalmışdır.
Məqalə sıralamalarının böyük hissəsi perturbasiyalar altında qorunmuşdur. Sıralamada daha nəzərəçarpan fərqlərin kiçik təsadüfi çəki dəyişikliklərindən çox, S1–S2–S3 arasında şüurlu şəkildə dəyişdirilən qərar prioritetlərindən qaynaqlandığı görülmüşdür.
Əlavə A: logistika reqressiyası nəticələri
| Dəyişən | Əmsal | Standart xəta | z | p | %95 etibar intervalı |
|---|---|---|---|---|---|
| Sabit | −2,196 | 0,492 | −4,458 | 0,000 | [−3,161; −1,230] |
| Öyrədilmiş modelin təqdim edilməsi | 0,882 | 0,330 | 2,670 | 0,008 | [0,235; 1,529] |
| Verilənlərin əlçatanlığı | 1,106 | 0,510 | 2,167 | 0,030 | [0,106; 2,105] |
Modelin pseudo \(R^2\) dəyəri 0,054-dür və izah gücü məhduddur. Bu analiz proqnoz uğurundan çox şərh edilə bilmə üçün istifadə edilmişdir.
| Dəyişən | Əmsal | Standart xəta | z | p | %95 etibar intervalı |
|---|---|---|---|---|---|
| Sabit | −1,611 | 0,489 | −3,294 | 0,001 | [−2,570; −0,653] |
| Məqalənin oxunaqlılığı | 2,764 | 0,367 | 7,531 | 0,000 | [2,045; 3,484] |
| İstifadə olunan alqoritmin çətinliyi | −0,963 | 0,360 | −2,676 | 0,007 | [−1,669; −0,258] |
| Hiperparametr göstərilməsi | 1,183 | 0,402 | 2,942 | 0,003 | [0,395; 1,972] |
Raff verilənlər toplusundakı logistika modeli üçün pseudo \(R^2=0.33\) bildirilmişdir. Oxunaqlılıq və hiperparametr göstərilməsi yenidən istehsal oluna bilən siniflə müsbət; istifadə olunan alqoritmin çətinliyi isə mənfi əlaqə göstərmişdir.
Əlavə A: Random Forest və XGBoost araşdırma performansı
| Verilənlər toplusu | Model | Dəqiqlik | Sinif 1 precision | Sinif 1 həssaslıq | Sinif 1 F1 |
|---|---|---|---|---|---|
| Olszewski | Random Forest | 0,65 | 0,40 | 0,50 | 0,44 |
| Olszewski | XGBoost | 0,70 | 0,46 | 0,50 | 0,48 |
| Raff | Random Forest | 0,86 | 0,88 | 0,91 | 0,89 |
| Raff | XGBoost | 0,88 | 0,88 | 0,94 | 0,91 |
Olszewski verilənlər toplusunda XGBoost Random Forest-la müqayisədə kiçik yaxşılaşma təmin etmiş, Raff verilənlər toplusunda isə hər iki ağac əsaslı model daha güclü nəticələr vermişdir. Bununla yanaşı, bu modellərin əsas vəzifəsi yekun yenidən istehsal oluna bilmə təsnifatçısını yaratmaq deyil, meyarların törədilməsini dəstəkləyən amilləri müəyyənləşdirməkdir.
XGBoost xüsusiyyət əhəmiyyətləri
| Xüsusiyyət | Normallaşdırılmış əhəmiyyət |
|---|---|
| README-nin mövcudluğu | 0,279 |
| Verilənlərin əlçatanlığı | 0,269 |
| Öyrədilmiş modelin mövcudluğu | 0,140 |
| Təlim açıqlaması | 0,116 |
| Hiperparametr göstərilməsi | 0,103 |
| Təlim/test bölünməsinin göstərilməsi | 0,090 |
| Təcrübənin əlçatanlığı | 0,000 |
Olszewski verilənlər toplusunda README və verilənlərin əlçatanlığı ən yüksək normallaşdırılmış əhəmiyyətə malikdir. Xüsusiyyət-təsir analizində README-nin yenidən istehsal oluna bilən sinfə proqnoz təsiri +0,300, öyrədilmiş modelin +0,190 və verilənlərin əlçatanlığının +0,108 kimi tapılmışdır.
Raff verilənlər toplusunda ən dominant xüsusiyyət məqalənin oxunaqlılığı olmuş və normallaşdırılmış əhəmiyyəti 0,288-dir. Verilənlərin əlçatanlığı 0,062; konseptuallaşdırma fiqurlarının sayı 0,056; hiperparametr göstərilməsi 0,051; cədvəl və fiqur sayı 0,048; kodun əlçatanlığı 0,043 dəyərinə malikdir. Oxunaqlılığın yenidən istehsal oluna bilən sinfə xüsusiyyət-təsir dəyəri +0,6198 kimi bildirilmişdir.
Tədqiqatın əsas elmi mesajı
Yenidən istehsal oluna bilməni bir “kod varmı?” sualına endirmək kifayət deyil. Real yenidən istehsal prosesi verilənlərin, kodun, öyrədilmiş modelin, iş təlimatının, hiperparametrlərin, təlim təfərrüatlarının və metod izahının birlikdə yetərli olmasını tələb edə bilər. MCDM yanaşması bu çoxölçülü quruluşu vahid ədəddə xülasə etməyə çalışır.
Bununla belə vahid ədəd hər kontekst üçün mütləq deyil. Verilənlər və kod paylaşımını prioritetləşdirən artefakt qiymətləndirmə komitəsi ilə həssas verilənlərin geniş yayıldığı sahədə metodoloji şəffaflığı prioritetləşdirən rəyçi eyni meyar çəkilərindən istifadə etməyə məcbur deyil. AHP ssenarilərinin məqsədi məhz bu kontekstual fərqi görünən etməkdir.
Tədqiqatın dəstəklədiyi nəticələr
Mənbə tədqiqat yeddi meyarın ordinal şəkildə qiymətləndirilib normallaşdırılmasının və WSM/TOPSIS ilə birləşdirilməsinin tədqiqat məqaləsi səviyyəsində tətbiq oluna bilən və şərh edilə bilən R1 hazırlıq skoru yarada bildiyini göstərir.
Əsas skor istinad etiketi ilə orta səviyyədə uyğunluq göstərmiş; tək artefakt əsaslı sadə qaydalardan daha balanslı F1 performansı təmin etmişdir. Fərqli çəki ssenariləri skorları gözlənilən istiqamətdə dəyişdirmiş və ±%20 çəki perturbasiyaları altında nəticələrin tam qeyri-sabit hala gəlmədiyi görülmüşdür.
Tədqiqatın dəstəkləmədiyi nəticələr
Yüksək hazırlıq skoru real təcrübənin mütləq uğurla yenidən istehsal ediləcəyi mənasına gəlmir. Çərçivə kodu işə salmadığı üçün gizli asılılıqları, pozulmuş tətbiqi, aparat uyğunsuzluğunu və ya əlçatanlıq iddiası ilə praktik əlçatanlıq arasındakı fərqi birbaşa yoxlamır.
Aşağı hazırlıq skoru da tədqiqatın elmi baxımdan pis, əhəmiyyətsiz və ya səhv olduğu mənasına gəlmir. Kommersiya, strateji və ya məxfilik səbəbləri ilə artefaktlarını paylaşa bilməyən yüksək təsirli tədqiqatlar aşağı hazırlıq skoru ala bilər.
Çərçivənin 0–1 skoru yenidən istehsal oluna bilmə ehtimalı deyil və “0,8 bal alan tədqiqatın 80% ehtimalla yenidən istehsal ediləcəyi” kimi şərh edilməməlidir.
Məhdudiyyətlər
Verilənlərin əhatəsi: Olszewski verilənlər toplusu əsasən yüksək səviyyəli təhlükəsizlik konfranslarını; Raff verilənlər toplusu isə böyük ölçüdə NeurIPS və ICML işlərini əhatə edir. Bu sahələrdəki paylaşım mədəniyyəti maşın öyrənməsinin bütün alt sahələrini təmsil etməyə bilər.
İstinad etiketi ilə skor arasındakı konseptual fərq: Hazırlıq skoru görünən izah və artefaktları ölçərkən istinad etiketi real yenidən istehsal nəticəsinə əsaslana bilər. Buna görə iki quruluşun tam uyğunlaşması nəzəri baxımdan gözlənilməməlidir.
Annotasiya məhdudiyyəti: İnsan və ChatGPT annotasiyaları arasında yüksək uyğunluq tapılsa da, qiymətləndirmə məhdud sayda annotatora əsaslanmışdır. Xüsusilə oxunaqlılıq və ya “qismən tamamlanmış” sənədləşdirmə kimi sahələrdə subyektiv qiymətləndirmə qərəzi qala bilər.
Ordinal rubrik və xətti normallaşdırma: Tənlik (3), qonşu ordinal səviyyələri bərabər məsafəli qəbul edir. Halbuki bəzi meyarlarda “qismən” səviyyədən “tam” səviyyəyə keçidin praktik faydası, “yox”dan “qismən”ə keçiddən daha böyük və ya daha kiçik ola bilər.
Meyar asılılıqları: WSM-nin kompensasiyaedici toplanan quruluşu yenidən istehsal oluna bilmənin məntiqi asılılıqlarını tam təmsil etmir. Kod və ya verilənlər kimi kritik elementin sıfır olması bəzi şərtlərdə digər yüksək meyarlarla kompensasiya edilə bilməyə bilər.
Çərçivənin əhatəsi: Metod yekun yenidən istehsal oluna bilmə sertifikatı deyil, ilkin skrininq və müqayisəli qiymətləndirmə alətidir.
Gələcək tədqiqat istiqamətləri
Mənbə tədqiqat gələcəkdə real icra nəticələrini ehtiva edən yeni verilənlər toplularının yaradılmasını təklif edir. Konteyner daxilində yenidən işə salma, asılılıqların həllinin yoxlanması və artefakt bütövlüyünün sınaqdan keçirilməsi kimi məlumatlar hazırlıq skoru ilə real yenidən istehsal maneələri arasındakı fərqin daha birbaşa ölçülməsinə imkan verə bilər.
Meyar dəsti təsadüfiliyə nəzarət, iş mühitinin göstərilməsi və qiymətləndirmə sızması yoxlamaları kimi əlavə ölçülərlə genişləndirilə bilər. Eyni çərçivə meyar və rubrik dəyişdirilərək R2 və R3 kimi daha irəli yenidən istehsal oluna bilmə səviyyələrinə də uyğunlaşdırıla bilər.
Artefakt bağlantılarının, README bütövlüyünün və strukturlaşdırılmış metod məlumatlarının qismən avtomatik çıxarılması çərçivəni böyükmiqyaslı qiymətləndirməyə uyğun edə bilər. Bununla yanaşı, subyektiv meyarlar üçün insan-dövrədə qiymətləndirmə və çoxlu annotator razılaşması əhəmiyyətini qoruyur.
WSM və TOPSIS-dən başqa LINMAP, PROMETHEE və VIKOR kimi fərqli MCDM ailələrinin müqayisəsi; annotasiya və çəki qeyri-müəyyənliyini birbaşa skor intervallarına daşıyan üsulların hazırlanması; həmçinin əsas meyarlarda minimum şərt tətbiq edən kompensasiyaedilməz qiymətləndirmə mexanizmlərinin istifadəsi gələcək tədqiqat sahələri arasındadır.
Ümumi nəticə
Tədqiqat maşın öyrənməsi tədqiqatlarında yenidən istehsal oluna bilmə problemini yalnız “kod paylaşılıbmı?” tipli birölçülü yoxlamadan çıxarıb çoxmeyarlı qərar problemi kimi nəzərdən keçirir. Yeddi açıq meyarın sıralı rubriklə qiymətləndirilməsi, ortaq miqyasa çevrilməsi və WSM və ya TOPSIS ilə birləşdirilməsi məqalələr arasında müqayisə oluna bilən və qərar məqsədinə uyğun çəkiləndirilə bilən R1 hazırlıq skoru təmin edir.
Tədqiqatın ən mühüm konseptual töhfəsi skorun sərhədini açıq saxlamasıdır: hazırlıq və real yenidən istehsal oluna bilmə əlaqəli, lakin eyni anlayış deyil. Məqalə tələb olunan bütün izahları və artefaktları təqdim edə bilər, lakin icra mərhələsində görünməyən texniki problemlər səbəbindən uğursuz ola bilər. Əksinə, standart rubrikdə bəzi məlumatları çatışmayan görünən iş praktikada yenidən istehsal oluna bilər.
Buna görə təklif olunan çərçivənin ən uyğun istifadəsi elmi keyfiyyəti qiymətləndirən yekun reytinq sistemi olmaq deyil; tədqiqat şəffaflığını və R1 yenidən istehsal oluna bilməyə hazırlığı sistematik şəkildə araşdıran, müqayisəni asanlaşdıran və daha təfərrüatlı yenidən istehsal yoxlamasına hansı işlərin hazır göründüyünü göstərə bilən tamamlayıcı alət olmaqdır.
Mənbə və Metod Qeydi
Orijinal tədqiqat: A MCDM-Based Framework for Quantifying Reproducibility Readiness in Machine Learning Research.
Müəlliflər: Paulina Leščinskaitė, Remigijus Paulavičius və Ernestas Filatovas.
Məsul müəllif: Ernestas Filatovas.
Qurum: Institute of Data Science and Digital Technologies, Faculty of Mathematics and Informatics, Vilnius University, Akademijos Str. 4, LT-08412 Vilnius, Lithuania.
Jurnal: Mathematics.
Nəşriyyat: MDPI, Basel, Switzerland.
Biblioqrafik qeyd: Mathematics, 2026, Cild 14, Say 9, Məqalə 1536.
DOI: 10.3390/math14091536
Qəbul edilib: 20 Mart 2026.
Reviziya: 23 Aprel 2026.
Qəbul: 28 Aprel 2026.
Nəşr: 1 May 2026.
Mənbə növü: Resenziyalı, açıq girişli orijinal tədqiqat məqaləsi.
Lisenziya: Creative Commons Attribution (CC BY).
Əsas metod: Nəzəri yenidən istehsal oluna bilmə analizi, iki mövcud verilənlər toplusu üzərində logistika reqressiyası/Random Forest/XGBoost əsaslı empirik meyar araşdırması, yeddi meyarlı ordinal rubrik, [0,1] normallaşdırması, WSM və TOPSIS əsaslı MCDM toplulaşdırması, AHP əsaslı nümunə çəki ssenariləri və Monte Carlo çəki həssaslıq analizi.
Maliyyələşdirmə
Tədqiqat Litva Tədqiqat Şurası tərəfindən Litva Respublikası Təhsil, Elm və İdman Nazirliyinin “University Excellence Initiatives” proqramı çərçivəsində dəstəklənmişdir. Mənbədə göstərilən layihə nömrəsi S-A-UEI-23-11-dir.
Verilənlər və kodun əlçatanlığı
Müəlliflər tam kod bazasının, verilənlər toplularının və verilənlər/kod fayllarını izah edən README sənədinin açıq şəkildə təqdim edildiyini bildirirlər. Tədqiqatdakı metod və metriklər Python 3.13.3 ilə həyata keçirilmişdir.
Mənbə kod və verilənlər repozitoriyası: GitHub — Quantifying reproducibility of ML papers using MCDM.
Maraqların toqquşması
Müəlliflər maraqların toqquşması olmadığını bəyan edirlər. Maliyyələşdirən qurumların tədqiqatın dizaynı, verilənlərin toplanması, analiz, şərh, məqalənin yazılması və ya nəşr qərarında rol oynamadığı bildirilmişdir.
Müəllif töhfələri
- Konseptuallaşdırma: P.L., R.P. və E.F.
- Metodologiya: P.L. və E.F.
- Proqram təminatı: P.L.
- Yoxlama: P.L., R.P. və E.F.
- Formal analiz: P.L., R.P. və E.F.
- Araşdırma: P.L., R.P. və E.F.
- Verilənlərin kurasiyası: P.L.
- İlk layihə: P.L. və E.F.
- Baxış və redaktə: R.P. və E.F.
- Vizuallaşdırma: P.L.
- Nəzarət: E.F.
- Layihənin idarə edilməsi: R.P.
- Maliyyələşdirmənin əldə edilməsi: R.P.
Metodoloji şərh məhdudiyyəti
Bu tədqiqat 139 maşın öyrənməsi məqaləsinin orijinal təcrübələrini yenidən icra etmiş toplu yenidən istehsal tədqiqatı deyil. Təklif olunan skor görünən artefaktlar və hesabat məlumatları üzərindən yenidən istehsal oluna bilməyə hazırlığı qiymətləndirir. Buna görə skor ilə praktik yenidən istehsal uğuru bir-birinin əvəzinə istifadə edilə bilməz.
Həmçinin istifadə olunan iki mənbə verilənlər toplusunun sahə əhatəsi məhduddur; meyar çəkiləri nümunə ssenarilərdə tədqiqatçılar tərəfindən nümayiş məqsədilə yaradılmış və real maraqlı tərəflərdən əldə olunmuş üstünlüklər deyil. Meyar dəsti təsadüfilik, qiymətləndirmə sızması və hesablama mühitinin determinizmi kimi bütün mümkün yenidən istehsal oluna bilmə problemlərini müstəqil meyarlar kimi əhatə etmir.
Rəsmi nəşr bağlantısı: https://doi.org/10.3390/math14091536
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib