


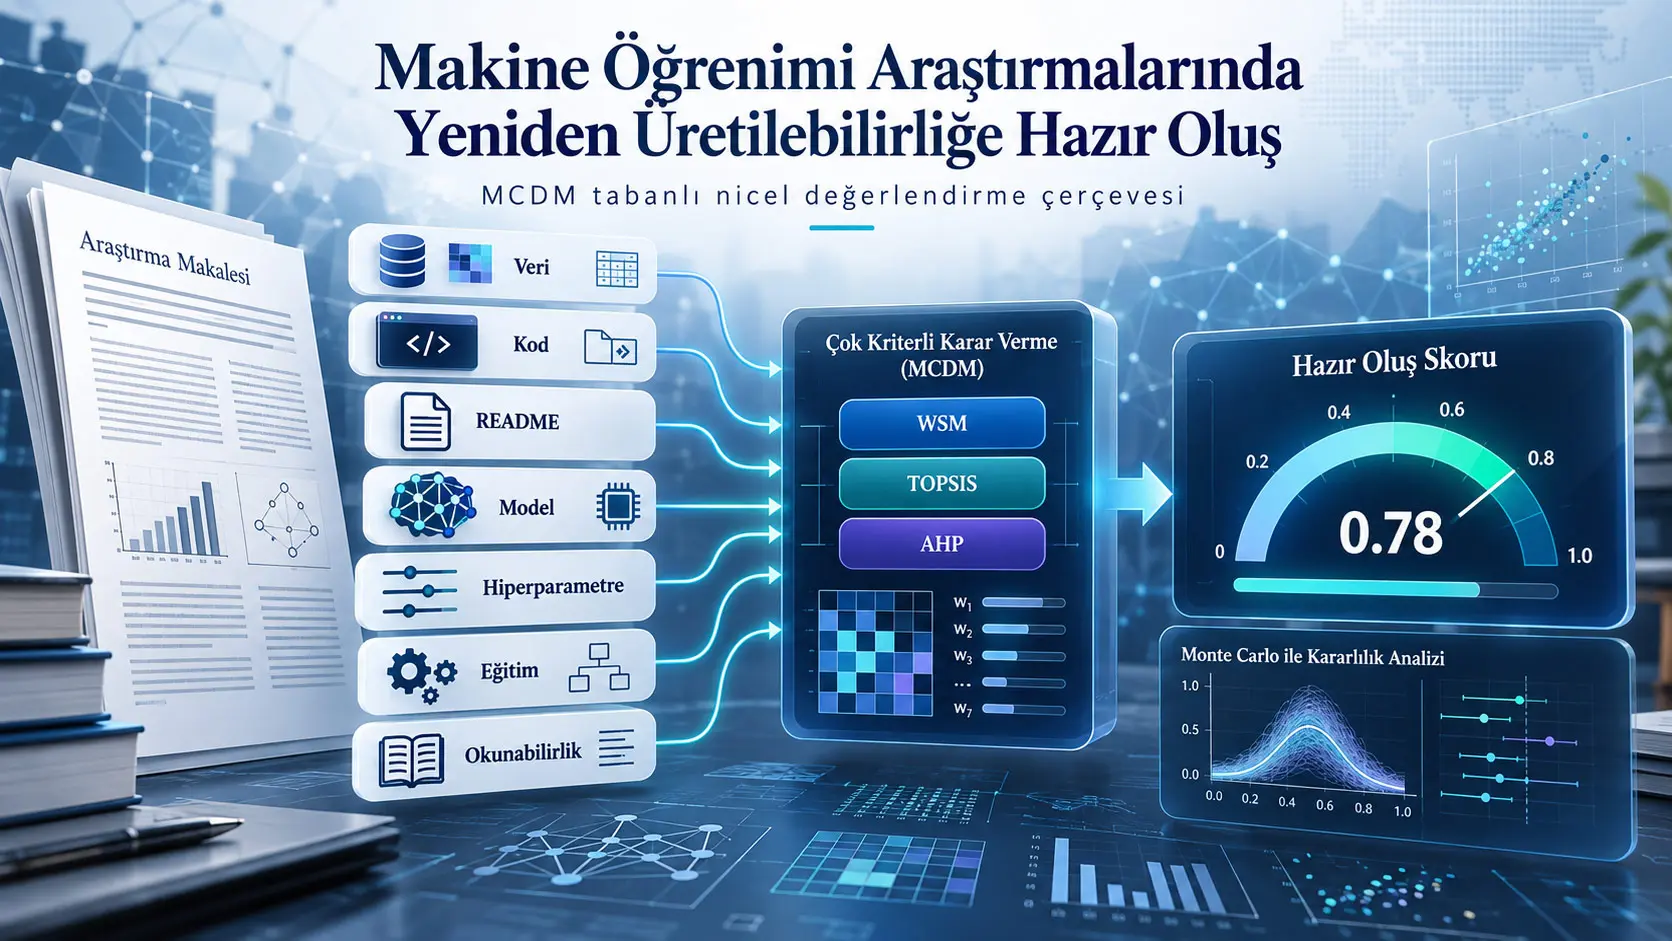
Bu çalışma, bir makine öğrenimi araştırmasının deneylerini yeniden çalıştırmadan, yayımlanan makale ve ona bağlı araştırma artefaktlarının R1 düzeyi yeniden üretilebilirliğe ne kadar hazır olduğunu nicel olarak ölçmek için Çok Kriterli Karar Verme (Multi-Criteria Decision Making, MCDM) tabanlı bir değerlendirme çerçevesi önermektedir. R1 yeniden üretilebilirlik hazır oluşu, araştırmanın aynı veri, kod, model ve hesaplama ortamıyla aynı sonuçların yeniden elde edilmesini destekleyecek veri, kod, eğitilmiş model ve yöntemsel açıklamaları ne ölçüde sunduğunu ifade eden bir değerlendirme kavramıdır. Çerçeve yedi kriter kullanmaktadır: veri erişilebilirliği, kod erişilebilirliği, README bulunması, eğitilmiş modelin sağlanması, hiperparametrelerin açıklanması, eğitim sürecinin açıklanması ve makalenin okunabilirliği. Kriterler ordinal bir rubrikle puanlanmakta, [0,1] aralığına normalize edilmekte ve Ağırlıklı Toplam Modeli (Weighted Sum Model, WSM) ile İdeal Çözüme Benzerliğe Göre Tercih Sıralama Tekniği (TOPSIS) kullanılarak tek bir hazır oluş skoruna dönüştürülmektedir.
Çerçevenin geliştirilmesinde iki mevcut yeniden üretilebilirlik veri setinden yararlanılmıştır. Ana değerlendirme için Olszewski ve çalışma arkadaşlarının temizlenmiş 215 makalelik veri kümesinden sonlu nüfus düzeltmeli Cochran örnekleme yaklaşımıyla 139 makale rastgele seçilmiştir. Her makale yedi kriter açısından araştırmacılar ve ChatGPT tarafından bağımsız biçimde puanlanmış; iki değerlendirmenin ortalaması nihai kriter puanı olarak kullanılmıştır. İnsan ve model destekli değerlendirmeler arasındaki ağırlıklı Cohen kappa ortalaması \(\kappa=0.96\) olarak raporlanmıştır.
Eşit kriter ağırlıklarının kullanıldığı temel değerlendirmede WSM ve TOPSIS aynı ikili sınıflandırma sonucunu üretmiştir. 0,5 karar eşiğinde çerçevenin referans yeniden üretilebilirlik etiketiyle karşılaştırılmasında doğruluk 0,64, kesinlik 0,40, duyarlılık 0,70 ve F1 skoru 0,51 bulunmuştur. Bu sonuçlar çerçevenin yeniden üretilebilir makalelerin önemli bir bölümünü yakalayabildiğini, ancak “hazır” görünen bazı makalelerin pratik yeniden üretim sırasında başarısız olabileceğini de göstermektedir.
En önemli yorum sınırı: Elde edilen skor bir araştırmanın gerçekten yeniden üretildiğini kanıtlayan bir sonuç değildir. Çerçeve deneyleri çalıştırmaz; makalede ve bağlı artefaktlarda görünür olan hazırlık düzeyini ölçer. Gizli bağımlılıklar, çalışmayan betikler, donanım veya yazılım uyumsuzluğu, deterministik olmayan GPU işlemleri ya da pratikte erişilemeyen veri gibi sorunlar yüksek hazır oluş skoruna rağmen gerçek yeniden üretimi engelleyebilir. Ayrıca düşük bir hazır oluş skoru çalışmanın bilimsel kalitesinin, yeniliğinin veya etkisinin düşük olduğu anlamına gelmez.
Makine öğreniminde yeniden üretilebilirlik neden ayrı bir problem haline geliyor?
Makine öğrenimi çalışmalarında yayımlanan bir sonucun yeniden elde edilebilmesi yalnız makaledeki nihai doğruluk, F1 skoru veya kayıp değerinin bilinmesine bağlı değildir. Araştırmacının hangi veriyi kullandığı, veriyi nasıl ön işlediği, eğitim ve test bölünmelerinin nasıl yapıldığı, model mimarisinin ayrıntıları, hiperparametreler, rastgelelik kaynakları, yazılım bağımlılıkları ve eğitim kodunun gerçekten çalıştırılabilir olup olmadığı da sonucu belirleyebilir.
Kaynak çalışma yeniden üretilemeyen sonuçların bilimsel açıdan iki temel sorun oluşturduğunu vurgulamaktadır. Birincisi, yayımlanan iddiaların bağımsız olarak doğrulanmasını zorlaştırmasıdır. İkincisi ise sonraki araştırmaların doğrulanamamış bir temel üzerine kurulması durumunda zaman ve araştırma kaynağının boşa harcanabilmesidir.
Mevcut çözüm girişimleri arasında yeniden üretilebilirlik kontrol listeleri, yayın yönergeleri, açık veri ve açık kod politikaları, kod depoları, konteynerleştirme ve yapılandırılmış dokümantasyon bulunur. Ancak bunların önemli bölümü “var/yok” biçimindeki ikili veya nitel değerlendirmeler üretmektedir. Kaynak çalışmanın çözmeye çalıştığı boşluk, tek bir araştırma makalesi için kısmi uygunluğu da hesaba katan, yorumlanabilir ve nicel bir yeniden üretilebilirlik hazır oluş skoru üretme ihtiyacıdır.
R1 düzeyi yeniden üretilebilirlik hazır oluşu nedir?
R1 düzeyi yeniden üretilebilirlik hazır oluşu, bir çalışmanın aynı veri, aynı kod, aynı model ve aynı hesaplama ortamı kullanılarak aynı sonuçların yeniden elde edilmesini destekleyecek araştırma artefaktlarını ve yöntemsel açıklamaları ne ölçüde sağladığını ifade eder; bu çalışma R1 deneylerini fiilen yeniden çalıştırmak yerine, bu yeniden üretime yönelik görünür hazırlığı makale ve bağlantılı artefaktlar üzerinden ölçmektedir.
R1, R2 ve R3 arasındaki fark
| Düzey | Temel mantık | Ne korunur? | Bu çalışmanın kapsamı mı? |
|---|---|---|---|
| R1 | Aynı sonuçların özgün artefaktlarla yeniden elde edilmesi | Aynı veri, kod, model ve hesaplama ortamı | Evet |
| R2 | Bağımsız uygulamayla yeniden üretim | Özgün veri korunur; uygulama bağımsız olabilir | Hayır |
| R3 | Farklı veri ve modelleme yaklaşımlarıyla benzer bilimsel sonuca ulaşılması | Yorum veya bilimsel sonuç düzeyi | Hayır |
R1’in seçilmesinin temel nedeni nesnel olarak daha kolay değerlendirilebilir olmasıdır. R2 ve R3, bağımsız uygulamalar ve alternatif veri veya modeller gerektirdiği için çoğu durumda gerçek yeniden üretim deneylerinin yürütülmesini gerektirir. Kaynak çerçeve ise makale düzeyinde, deneyleri yeniden çalıştırmadan kullanılmak üzere tasarlanmıştır.
Yeniden üretilemezliğin başlıca kaynakları
Kod ve hesaplama ortamı: Kodun hiç paylaşılmaması, yalnız kısmen paylaşılması veya bağımlılık sürümlerinin belirtilmemesi aynı işlemlerin yeniden kurulmasını engelleyebilir.
Veri erişilebilirliği: Özel, kapalı veya yalnız kısmen sağlanan veri kümeleri deneyin yeniden yürütülmesini doğrudan sınırlayabilir. Ön işleme adımlarının açıklanmaması veya veri sızıntısı gibi yöntemsel sorunlar da özgün sonuç ile yeniden üretim arasındaki farkı büyütebilir.
Rastgelelik: Ağırlık başlatma, örnekleme, mini-batch sıralaması ve benzeri stokastik bileşenler kontrol edilmezse aynı kod dahi farklı sonuçlar üretebilir. Buna ek olarak GPU işlemleri, paralellik ve kayan nokta farklılıkları bazı ortamlarda tam deterministik çalışmayı engelleyebilir.
Raporlama: Yalnız başarılı deneylerin raporlanması, kullanılan istatistiklerin açık belirtilmemesi, belirsizliklerin gizlenmesi veya eğitim ayrıntılarının eksik verilmesi araştırmanın yeniden kurulmasını zorlaştırabilir.
Kontrol listesi neden tek başına yeterli görülmemiştir?
Birçok kontrol listesi “kod var mı?”, “veri mevcut mu?” veya “hiperparametreler açıklanmış mı?” gibi yararlı sorular içerir. Ancak ikili işaretleme kısmi uygunluğu yeterince temsil etmez. Örneğin hiç kod paylaşmayan çalışma ile kod paylaşmış fakat bir bölümünü eksik bırakmış çalışma aynı “hayır” kategorisine düşebilir.
Bu araştırma bu nedenle ordinal, yani sıralı bir puanlama mantığı kullanmaktadır. Böylece “hiç yok”, “kısmen var” ve “yeterince tamamlanmış” düzeyleri matematiksel olarak birbirinden ayrılabilir.
MCDM bu değerlendirmede neden kullanılıyor?
Çok Kriterli Karar Verme (MCDM), veri erişilebilirliği, kod, dokümantasyon, model artefaktı ve yöntemsel açıklık gibi farklı türdeki yeniden üretilebilirlik göstergelerini ortak bir ölçeğe getirip ağırlıklandırarak tek ve yorumlanabilir bir skor üretmeye izin verdiği için kullanılmaktadır; aynı yapı kriter ağırlıklarının değerlendirme amacına göre değiştirilmesini de mümkün kılar.
Çerçevenin yedi temel kriteri
| Kriter | Ne değerlendiriliyor? |
|---|---|
| Veri erişilebilirliği | Makalede kullanılan veri kümesinin herkese açık, kısmi, hassas veya talep üzerine erişilebilir olup olmadığı. |
| Kod erişilebilirliği | Deneylerin yeniden yürütülmesini sağlayacak kodun mevcut ve yeterince tamamlanmış olup olmadığı. |
| README bulunması | Ortam, bağımlılıklar ve çalışma adımlarını açıklayan kullanım dokümantasyonunun bulunup bulunmadığı ve yeterliliği. |
| Eğitilmiş modelin sağlanması | Modeli yeniden eğitmeden kullanmaya imkân sağlayacak ağırlık veya eğitilmiş model artefaktlarının bulunması. |
| Hiperparametre açıklaması | Eğitimde kullanılan temel hiperparametrelerin ne ölçüde belirtildiği. |
| Eğitim açıklaması | Ön işleme, örnekleme, eğitim/test bölünmesi ve eğitim prosedürünün açıklık düzeyi. |
| Makale okunabilirliği | Yöntem anlatımının yapısı, tutarlılığı ve anlaşılabilirliği. |
Bu yedi kriter nasıl seçildi?
Kriter geliştirme üç aşamalı yürütülmüştür. İlk aşamada yeniden üretilebilirlik literatürü, mevcut kontrol listeleri ve bilinen yeniden üretilemezlik kaynakları incelenmiştir. Bu aşama, veri, kod, eğitilmiş model ve README gibi çalıştırılabilir artefaktlar ile eğitim süreci ve hiperparametre açıklığı gibi yöntemsel şeffaflık bileşenlerinin kapsanmasını sağlamıştır.
İkinci aşamada iki mevcut veri kümesi üzerinde lojistik regresyon, Random Forest ve XGBoost kullanılarak yeniden üretilebilirlik etiketiyle ilişkili faktörler taranmıştır. Bu modeller kriterleri otomatik ve kesin biçimde seçen bir “hakem” olarak kullanılmamış; teorik seçimi destekleyen ampirik kanıt üretmiştir.
Üçüncü aşamada teorik ve ampirik kanıtlar birleştirilerek makale ve bağlı artefaktlardan, deney çalıştırılmadan değerlendirilebilen kompakt yedi kriterlik set oluşturulmuştur.
Çerçeve neyi kapsam dışı bırakıyor?
Yedi kriter kapsamlı olmakla birlikte tükenmez bir liste değildir. Otomatik testlerin bulunması, yazılım lisanslarının tutarlılığı, veri kartları gibi yapılandırılmış veri dokümantasyonu, rastgelelik kontrolü, donanım/yazılım determinizmi ve değerlendirme sızıntısı gibi faktörler bağımsız kriterler olarak modele dahil edilmemiştir.
Bu faktörlerden bazıları eğitim açıklaması veya dokümantasyon kalitesi üzerinden dolaylı biçimde yakalanabilir; fakat kaynak çalışma bunların bütünüyle temsil edildiğini iddia etmemektedir.
Çalışmanın Yöntemi ve Bulguları
Kullanılan iki veri kaynağı
| Veri kümesi | Başlangıç büyüklüğü | Kapsam | Bilimsel rolü |
|---|---|---|---|
| Olszewski ve ark. | 745 makale | 2013–2022, NDSS, IEEE S&P, CCS ve USENIX; 19 yeniden üretilebilirlik özelliği ve ikili makale etiketi | Ana örnekleme ve MCDM değerlendirmesinin temeli |
| Raff | 255 makale | Başta NeurIPS ve ICML; 1984–2017; 28 anotasyon özelliği | Özellikle yapı ve okunabilirlik gibi faktörlerle ampirik taramayı zenginleştirmek |
Veri temizleme
Olszewski veri kümesinde eksik ve analitik açıdan yararlı olmayan girdiler çıkarılmıştır. Eksik kategorik değerler yapay biçimde doldurulmamış; ilgili satırlar kaldırılmış ve 745 makalelik veri 292 makaleye düşmüştür. Başlık, yazar, yayın yeri kimlikleri ve bağlantılar gibi genel kriter değerlendirmesine katkı sağlamayan alanlar ile gereksiz veya salt metinsel değişkenler çıkarılmıştır. Sekiz yeniden üretilebilirlik özelliği tutulmuştur.
Daha sonra yeniden üretilebilirlik etiketi yalnız “tam yeniden üretilebilir” ve “yeniden üretilemez” olarak etiketlenmiş makalelerle sınırlandırılmış ve nihai temiz veri kümesi 215 makaleden oluşmuştur.
Raff veri kümesinde bir eksik değer düzeltilmiş ve çok seyrek bir özellik çıkarılmıştır. Yayın yeri ve konuya özgü değişkenlerin kaldırılmasının ardından 20 özellik korunmuştur. Kategorik değişkenler ikili göstergelere çevrilmiştir. Lojistik regresyonda sayısal özellikler katsayıların karşılaştırılabilmesi için min–max yöntemiyle [0,1] aralığına ölçeklenmiş, ağaç tabanlı modellerde ise sayısal değişkenler ölçeklenmeden kullanılmıştır.
Ampirik kriter taraması
İki veri kümesi ayrı ayrı modellenmiştir. Lojistik regresyon yorumlanabilir başlangıç modeli, Random Forest ve XGBoost ise doğrusal olmayan ilişkileri ve özellik etkileşimlerini yakalamak için kullanılmıştır. Her iki veri kümesinde de eğitim/test ayrımı %80/%20 olarak yapılmıştır.
Sınıf dengesizliği Random Forest için dengelenmiş sınıf ağırlıkları, XGBoost için ise scale_pos_weight parametresiyle ele alınmıştır.
Denklem (1): XGBoost kazanç tabanlı özellik önemi
\[ \mathrm{Imp}(j) = \sum_{\text{j özelliğini kullanan bölünmeler}} \Delta L_{\mathrm{split}} \]
1. Formül neyi hesaplar? XGBoost karar ağaçlarında belirli bir \(j\) özelliğinin kullanıldığı bölünmelerin model amaç/kayıp fonksiyonunda oluşturduğu toplam iyileşmeyi hesaplar.
2. Değişkenler nelerdir? \(\mathrm{Imp}(j)\), \(j\) özelliğinin önemidir. \(\Delta L_{\mathrm{split}}\), o özelliği kullanan belirli bir ağaç bölünmesinin amaç fonksiyonunda sağladığı kayıp azalmasıdır.
3. Birimler nelerdir? Bu bir fiziksel ölçü değildir. Ham değer, XGBoost amaç fonksiyonundaki iyileşmeye bağlı algoritmik bir önem büyüklüğüdür. Çalışmada önem değerleri karşılaştırılabilmek için daha sonra min–max normalize edilmiştir.
4. Matematiksel rol nedir? Aynı özellik birden fazla ağaç ve bölünmede kullanılabilir. Formül, bu özelliğin sağladığı bütün kayıp azalmalarını toplar.
5. Algoritmik anlam nedir? Büyük \(\mathrm{Imp}(j)\), modelin yeniden üretilebilirlik sınıfını ayırırken ilgili özelliği yararlı bulduğunu gösterir.
6. Hangi koşul altında geçerlidir? Bu önem XGBoost modelinin kurduğu ağaçlara, veri kümesine ve eğitim düzenine bağlıdır; nedensel etki değildir.
7. Sonuç nasıl yorumlanmalıdır? Yüksek özellik önemi, ilgili faktörün teorik olarak zorunlu bir yeniden üretilebilirlik koşulu olduğunu tek başına kanıtlamaz. Kaynak çalışma bu değerleri kriter seçiminin kesin eşiği değil, teorik analizle birlikte kullanılan destekleyici kanıt olarak değerlendirmiştir.
Denklem (2): ikili bir özelliğin ortalama tahmin etkisi
\[ \Delta_j = \frac{1}{N} \sum_{i=1}^{N} \left[ P\left( y=1 \mid x_j^{(i)}=1,\, x_{-j}^{(i)} \right) - P\left( y=1 \mid x_j^{(i)}=0,\, x_{-j}^{(i)} \right) \right] \]
1. Formül neyi hesaplar? Bir ikili özelliğin 0’dan 1’e değiştirilmesinin, diğer bütün özellikler aynı tutulduğunda modelin “yeniden üretilebilir” sınıfına verdiği tahmin olasılığında ortalama olarak ne kadar değişim oluşturduğunu hesaplar.
2. Değişkenler nelerdir? \(N\) makale sayısıdır. \(y=1\) yeniden üretilebilir sınıfı gösterir. \(x_j^{(i)}\), \(i\). makaledeki incelenen \(j\) özelliğidir. \(x_{-j}^{(i)}\), aynı makaledeki diğer bütün özelliklerdir.
3. Birimler nelerdir? \(\Delta_j\) olasılık farkı ölçeğindedir ve fiziksel bir birimi yoktur.
4. Matematiksel rol nedir? Her makale iki kez değerlendirilir: ilgili özellik varsayımsal olarak 1 ve 0 yapılır. İki tahmin arasındaki farklar bütün makalelerde ortalanır.
5. Algoritmik anlam nedir? Pozitif \(\Delta_j\), özelliğin mevcut olmasının model tahmininde yeniden üretilebilir sınıfına doğru hareketle ilişkili olduğunu; negatif değer ters yönlü tahmin değişimini gösterir.
6. Hangi koşullarda geçerlidir? Bu değer eğitilmiş tahmin modelinin davranışını açıklar. Özelliklerin gerçek dünyadaki nedensel etkisini ispatlamaz.
7. Sonuç nasıl yorumlanmalıdır? Özellik etkisi, XGBoost’un belirli veri kümesinde öğrendiği ilişkiyi yorumlamak için kullanılmıştır ve kriter seçimi teorik yeniden üretilebilirlik bilgisiyle birlikte yapılmıştır.
Seçilen ordinal rubrik
| Kriter | Seviye | Anlam |
|---|---|---|
| Veri erişilebilirliği | 0 | Veri kümesi herkese açık değil. |
| 1 | Veri hassas olarak tanımlanmış. | |
| 2 | Veri kısmen erişilebilir veya talep üzerine sunuluyor. | |
| 3 | Veri herkese açık. | |
| Kod erişilebilirliği | 0 | Kod herkese açık değil. |
| 1 | Kod kısmen mevcut veya tam yeniden çalıştırmayı engelleyen eksikler içeriyor. | |
| 2 | Kod herkese açık ve yeterince tamamlanmış. | |
| README | 0 | README veya kullanım talimatı yok. |
| 1 | README var ancak önemli adımlar veya bağımlılıklar eksik. | |
| 2 | README iş akışını yürütmek için yeterince tamamlanmış. | |
| Eğitilmiş model | 0 | Eğitilmiş model artefaktı sağlanmamış. |
| 1 | Eğitilmiş model artefaktı sağlanmış. | |
| Hiperparametreler | 0 | Hiperparametreler açıklanmamış. |
| 1 | Kısmen açıklanmış. | |
| 2 | Tam olarak açıklanmış. | |
| Eğitim açıklaması | 0 | Eğitim/ön işleme/bölünmeler açıklanmamış. |
| 1 | Kısmen açıklanmış. | |
| 2 | Tam olarak açıklanmış. | |
| Makale okunabilirliği | 0 | Yapı belirsiz ve önemli yöntem adımlarını takip etmek zor. |
| 1 | Genel yapı mantıklı fakat belirsiz veya tutarsız kısımlar var. | |
| 2 | İyi düzenlenmiş, açık ve yöntem anlatımı tutarlı. |
Denklem (3): ordinal puanın [0,1] aralığına normalizasyonu
\[ x_k = \frac{s_k}{L_k}, \qquad x_k\in[0,1] \]
1. Formül neyi hesaplar? Farklı maksimum seviyelere sahip kriterlerin puanlarını ortak [0,1] ölçeğine dönüştürür.
2. Değişkenler nelerdir? \(s_k\), \(k\). kriter için atanan ordinal puandır. \(L_k\), aynı kriterin mümkün olan en yüksek ordinal seviyesidir. \(x_k\), normalize edilmiş kriter değeridir.
3. Birimler nelerdir? \(x_k\) boyutsuzdur.
4. Matematiksel rol nedir? Örneğin maksimum düzeyi 3 olan veri erişilebilirliği ile maksimum düzeyi 1 olan eğitilmiş model kriterini aynı sayısal aralıkta karşılaştırılabilir hale getirir.
5. Algoritmik anlam nedir? \(x_k=0\), kriterin en düşük; \(x_k=1\), en yüksek tanımlı hazır oluş seviyesinde olduğunu gösterir.
6. Varsayım nedir? Doğrusal normalizasyon komşu ordinal seviyeler arasındaki farkların eşit adımlar olduğunu varsayar. Kaynak çalışma bunun basit ve şeffaf olduğunu fakat gerçek fayda artışının mutlaka doğrusal olmayabileceğini açıkça kabul etmektedir.
7. Sonuç nasıl yorumlanmalıdır? Örneğin \(s_k=2\) ve \(L_k=3\) ise:
\[ x_k=\frac{2}{3}\approx0.667 \]
Bu değer “%66,7 oranında gerçekten yeniden üretilebilir” anlamına gelmez; yalnız ilgili kriterde maksimum ordinal seviyeye göre normalize edilmiş uygunluk derecesidir.
Örneklem büyüklüğü ve anotasyon
Temizlenmiş 215 makalelik Olszewski veri kümesinden örnek alınırken kaynak çalışma sonlu nüfus düzeltmeli Cochran yaklaşımını kullanmıştır. %95 güven düzeyi, koruyucu nüfus oranı olarak p=0,5 ve %5 hata payı kullanıldığında örneklem büyüklüğü 139 makale olarak hesaplanmıştır.
Kaynak makale Cochran hesabının cebirsel denklemini numaralı bir formül olarak vermemektedir. Bu nedenle burada kaynağın vermediği ayrı bir Cochran denklemi eklenmemiştir.
139 makale yedi kriterin tamamında hem çalışma yazarları hem de ChatGPT tarafından bağımsız olarak puanlanmıştır.
Denklem (4): iki anotasyonun birleştirilmesi
\[ S_{\mathrm{final}} = \frac{ A_{\mathrm{study}} + A_{\mathrm{ChatGPT}} }{2} \]
1. Formül neyi hesaplar? Araştırmacı anotasyonu ile ChatGPT anotasyonunun aritmetik ortalamasını alarak kriterin nihai puanını oluşturur.
2. Değişkenler nelerdir? \(A_{\mathrm{study}}\), çalışma ekibinin kriter puanı; \(A_{\mathrm{ChatGPT}}\), model tarafından verilen kriter puanıdır.
3. Birimler nelerdir? Değer ilgili kriterin ordinal puan ölçeğindedir.
4. Matematiksel rol nedir? İki değerlendirici eşit ağırlıkla birleştirilir.
5. Algoritmik anlam nedir? Nihai puanın yalnız insan veya yalnız LLM değerlendirmesine dayanmasını önleyen basit bir füzyon işlemidir.
6. Koşul nedir? İki anotasyonun aynı kriter ve aynı ordinal rubrik üzerinde yapılması gerekir.
7. Sonuç nasıl yorumlanmalıdır? İki anotasyon arasında çok yüksek genel uyum rapor edilmiştir: ağırlıklı Cohen kappa ortalaması \(\kappa=0.96\). Bununla birlikte okunabilirlik gibi daha öznel kriterlerde uyum görece daha düşüktür ve çalışma yalnız sınırlı sayıda anotatör kullanmıştır.
MCDM skorunun hesaplanması
Normalizasyon sonrasında her kriter \(x_i\in[0,1]\) aralığındadır. Çalışma iki ayrı, yorumlanabilir MCDM toplulaştırma yöntemi kullanmaktadır: WSM ve TOPSIS.
WSM ile TOPSIS arasındaki temel fark nedir?
WSM kriter puanlarını ağırlıklı doğrusal bir toplam olarak birleştirirken TOPSIS her makalenin kriter profilinin tüm kriterlerin en iyi olduğu ideal profile ve tüm kriterlerin en kötü olduğu anti-ideal profile uzaklığını ölçer; bu nedenle aynı ağırlıklar kullanılsa bile iki yöntem güçlü ve zayıf kriter kombinasyonlarına farklı tepki verebilir.
Denklem (5): Ağırlıklı Toplam Modeli — WSM
\[ S = \sum_{i=1}^{n}w_i x_i, \qquad \sum_{i=1}^{n}w_i=1 \]
1. Formül neyi hesaplar? Normalize edilmiş bütün kriterlerin ağırlıklı ortalamasını alarak tek bir yeniden üretilebilirlik hazır oluş skoru üretir.
2. Değişkenler nelerdir? \(x_i\), \(i\). kriterin normalize skoru; \(w_i\), kriter ağırlığı; \(n\), kriter sayısıdır. Bu çalışmada \(n=7\)’dir. \(S\), nihai WSM skorudur.
3. Birimler nelerdir? Bütün değerler boyutsuzdur ve \(S\in[0,1]\) aralığındadır.
4. Matematiksel rol nedir? Her kriter kendi önem ağırlığıyla çarpılır ve yedi katkı toplanır.
5. Algoritmik anlam nedir? Daha yüksek ağırlıklı kriterlerde iyi performans nihai skora daha fazla katkı verir.
6. Temel varsayım nedir? WSM kriterler arasında toplamsal bağımsızlık varsayar. Yani bir kriterdeki iyi performans başka bir kriterdeki zayıflığı matematiksel olarak telafi edebilir.
7. Sonuç nasıl yorumlanmalıdır? Kaynak çalışma bu varsayımın yeniden üretilebilirliğin gerçek mantığını tam yansıtmayabileceğini belirtmektedir. Örneğin kod veya veri tamamen yoksa, diğer kriterlerin güçlü olması gerçek yeniden üretimi mümkün kılmayabilir. Dolayısıyla WSM şeffaf bir yaklaşık skor üretir; kriterler arasındaki zorunlu bağımlılıkları tam modellemez.
Denklem (6): TOPSIS ideal ve anti-ideal profilleri
\[ v_j^{+}=1, \qquad v_j^{-}=0 \]
1. Formül neyi tanımlar? TOPSIS için her kriterin ideal ve anti-ideal referans değerlerini tanımlar.
2. Değişkenler nelerdir? \(v_j^{+}\), \(j\). kriterin ideal değeri; \(v_j^{-}\), anti-ideal değeridir.
3. Birimler nelerdir? Normalize [0,1] ölçeğinde boyutsuz değerlerdir.
4. Matematiksel rol nedir? Bütün kriterlerde 1 alan kuramsal profil mükemmel hazır oluş referansı, bütün kriterlerde 0 alan profil ise en kötü referanstır.
5. Algoritmik anlam nedir? Gerçek bir makalenin skor profili bu iki referansa göre konumlandırılır.
6. Koşul nedir? Bütün kriterlerin “daha yüksek değer daha iyi” yönünde normalize edilmiş olması gerekir.
7. Sonuç nasıl yorumlanmalıdır? İdeal nokta gerçek bir makale olmak zorunda değildir; karşılaştırma amacıyla tanımlanan matematiksel referanstır.
Denklem (7): ideal ve anti-ideal profile uzaklık
\[ D_i^{+} = \sqrt{ \sum_{j=1}^{n} w_j \left( v_{ij}-v_j^{+} \right)^2 } \]
\[ D_i^{-} = \sqrt{ \sum_{j=1}^{n} w_j \left( v_{ij}-v_j^{-} \right)^2 } \]
1. Formül neyi hesaplar? Makale \(i\)'nin kriter profilinin ideal ve anti-ideal profillere ağırlıklı Öklid uzaklığını hesaplar.
2. Değişkenler nelerdir? \(v_{ij}\), makale \(i\)'nin kriter \(j\)'deki normalize değeridir. \(w_j\), kriter ağırlığıdır. \(v_j^{+}\) ve \(v_j^{-}\) ideal ve anti-ideal değerlerdir.
3. Birimler nelerdir? Normalize kriter uzayında boyutsuz uzaklıklardır.
4. Matematiksel rol nedir? Her kriterdeki referans farkının karesi alınır, ağırlıkla çarpılır, toplamın karekökü alınır.
5. Algoritmik anlam nedir? Küçük \(D_i^{+}\), makalenin ideal profile yakın olduğunu; büyük \(D_i^{-}\), en kötü profile uzak olduğunu gösterir.
6. Koşul nedir? Kriterlerin aynı normalize uzayında bulunması ve ağırlıkların karar modelinin önceliklerini temsil etmesi gerekir.
7. Sonuç nasıl yorumlanmalıdır? Tek başına uzaklıklardan biri yeterli değildir; TOPSIS ikisini birlikte Denklem (8) ile göreli yakınlığa dönüştürür.
Denklem (8): TOPSIS göreli yakınlık skoru
\[ C_i = \frac{D_i^{-}} {D_i^{+}+D_i^{-}} \]
1. Formül neyi hesaplar? Makale \(i\)'nin ideal profile göreli yakınlığını hesaplar.
2. Değişkenler nelerdir? \(D_i^{+}\) ideal çözüme uzaklık, \(D_i^{-}\) anti-ideal çözüme uzaklıktır.
3. Birimler nelerdir? \(C_i\) boyutsuzdur ve \(0\leq C_i\leq1\) aralığındadır.
4. Matematiksel rol nedir? Anti-idealden uzaklığı toplam iki uzaklığa oranlayarak tek sayı üretir.
5. Algoritmik anlam nedir? \(C_i\) büyüdükçe makale ideal yeniden üretilebilirlik hazır oluş profiline daha yakındır.
6. Koşul nedir? Uzaklıkların aynı kriter uzayı ve aynı ağırlıklarla hesaplanması gerekir.
7. Sonuç nasıl yorumlanmalıdır? \(C_i=0.8\) “çalışma %80 olasılıkla yeniden üretilebilir” demek değildir. Skor, tanımlanan yedi kriter ve ağırlık sistemi altında ideal profile göreli yakınlığı gösterir.
Temel değerlendirme: eşit ağırlıklar
Temel değerlendirmede yedi kriterin her biri eşit ağırlık almıştır. Böylece sonuçların belirli bir karar vericinin öznel öncelikleri tarafından yönlendirilmesi önlenerek rubrik ve kriter sisteminin temel davranışı incelenmiştir.
WSM ve TOPSIS skorları [0,1] aralığındadır. Kaynak çalışma 0 ile 1 arasındaki karar eşiklerini 0,1 adımlarla manuel olarak taramış ve 0,5 eşiğinin doğruluk, kesinlik ve duyarlılık arasında en dengeli sonucu verdiğini raporlamıştır.
Referans etikete karşı sonuçlar
139 makalelik örneklemde referans etiket dağılımı dengesizdir: 102 negatif ve 37 pozitif makale bulunmaktadır.
| Referans | 0 tahmini | 1 tahmini |
|---|---|---|
| 0 — yeniden üretilemez etiketi | 63 | 39 |
| 1 — yeniden üretilebilir etiketi | 11 | 26 |
| Metrik | Değer |
|---|---|
| Doğruluk | 0,64 |
| Kesinlik | 0,40 |
| Duyarlılık | 0,70 |
| F1 skoru | 0,51 |
Duyarlılığın 0,70 olması, referans veri kümesinde yeniden üretilebilir olarak etiketlenen makalelerin önemli bir bölümünün hazır oluş çerçevesi tarafından da yakalandığını gösterir. Kesinliğin 0,40 olması ise “hazır” olarak sınıflandırılan makalelerin önemli bir bölümünün referans etikette yeniden üretilemez olduğunu göstermektedir.
Kaynak bu farkı çerçevenin başarısızlığı olarak tek başına yorumlamamaktadır. Çerçeve kod, veri ve açıklamaların görünür hazır oluşunu değerlendirirken referans etiket pratik yeniden üretim sonucunu temsil etmektedir. Görünmeyen ortam problemi veya eksik uygulama gibi bir engel, makale kâğıt üzerinde hazır görünse bile çalıştırma sırasında başarısızlığa yol açabilir.
Basit artefakt kurallarıyla karşılaştırma
| Model | Kesinlik | Duyarlılık | F1 |
|---|---|---|---|
| Yalnız kod | 0,27 | 0,62 | 0,38 |
| Yalnız veri | 0,33 | 0,73 | 0,45 |
| Kod VEYA veri | 0,30 | 0,86 | 0,45 |
| Kod VE veri | 0,30 | 0,49 | 0,37 |
| WSM/TOPSIS — eşit ağırlık | 0,40 | 0,70 | 0,51 |
“Kod VEYA veri” kuralı 0,86 ile en yüksek duyarlılığı sağlasa da düşük kesinlik nedeniyle çok sayıda yanlış pozitif üretmektedir. Yedi kriterli MCDM yaklaşımı en yüksek F1 skoruna ulaşarak daha dengeli sonuç vermektedir.
AHP ile üç ağırlıklandırma senaryosu
Kaynak çalışma Analitik Hiyerarşi Süreci'ni (Analytic Hierarchy Process, AHP) bağlama göre kriter ağırlığı türetmenin pratik bir yolu olarak göstermiştir. Kriter karşılaştırmaları Saaty’nin 1–9 ölçeği kullanılarak kurulmuş, karşılaştırma matrisleri normalize edilmiş ve tutarlılık Consistency Ratio (CR) ile kontrol edilmiştir.
Kaynak bu bölümde AHP’nin ayrı bir numaralı denklemini vermemektedir. Bu nedenle burada kaynakta bulunmayan bir AHP formülü üretilmemiştir.
| Kriter | S1: Eşit | S2: Veri ve Kod | S3: Eğitim ve Okunabilirlik |
|---|---|---|---|
| Veri erişilebilirliği | 0,143 | 0,241 | 0,107 |
| Kod erişilebilirliği | 0,143 | 0,241 | 0,107 |
| README | 0,143 | 0,103 | 0,107 |
| Eğitilmiş model | 0,143 | 0,103 | 0,036 |
| Hiperparametre açıklaması | 0,143 | 0,103 | 0,143 |
| Eğitim açıklaması | 0,143 | 0,103 | 0,250 |
| Makale okunabilirliği | 0,143 | 0,103 | 0,250 |
| Toplam | 1,000 | 1,000 | 1,000 |
Üç senaryoda da \(\lambda_{\max}=7.0\) ve \(CR=0.0\) raporlanmıştır. Kullanılan ağırlıklar gerçek bir paydaş grubundan toplanmış tercihler değildir; farklı karar hedeflerinin skoru nasıl değiştirdiğini göstermek için oluşturulmuş örnek senaryolardır.
On örnek makalede ağırlık değişiminin etkisi
| No | Makale | WSM S1 | WSM S2 | WSM S3 | TOPSIS S1 | TOPSIS S2 | TOPSIS S3 |
|---|---|---|---|---|---|---|---|
| 1 | WTAGRAPH: Web Tracking and Advertising Detection using Graph Neural Networks | 0,286 | 0,207 | 0,446 | 0,277 | 0,210 | 0,490 |
| 2 | DeepSteal: Advanced Model Extractions Leveraging Efficient Weight Stealing in Memories | 0,429 | 0,448 | 0,500 | 0,370 | 0,442 | 0,484 |
| 3 | Model Stealing Attacks Against Inductive Graph Neural Networks | 0,452 | 0,420 | 0,589 | 0,375 | 0,385 | 0,570 |
| 4 | Phishpedia: A Hybrid Deep Learning Based Approach to Visually Identify Phishing Webpages | 0,643 | 0,603 | 0,643 | 0,649 | 0,575 | 0,627 |
| 5 | Cheetah: Lean and Fast Secure Two-Party Deep Neural Network Inference | 0,524 | 0,609 | 0,554 | 0,424 | 0,555 | 0,501 |
| 6 | DEEPCASE: Semi-Supervised Contextual Analysis of Security Events | 0,643 | 0,741 | 0,714 | 0,478 | 0,625 | 0,658 |
| 7 | Khaleesi: Breaker of Advertising and Tracking Request Chains | 0,595 | 0,592 | 0,750 | 0,447 | 0,498 | 0,712 |
| 8 | AI/ML for Network Security: The Emperor Has No Clothes | 0,786 | 0,845 | 0,679 | 0,782 | 0,837 | 0,622 |
| 9 | Improving Password Guessing via Representation Learning | 0,524 | 0,471 | 0,714 | 0,402 | 0,401 | 0,638 |
| 10 | Privacy Risks of Securing Machine Learning Models against Adversarial Examples | 0,595 | 0,661 | 0,696 | 0,431 | 0,549 | 0,611 |
Veri ve kodun ağırlığının yükseltildiği S2 senaryosunda artefakt paylaşımı güçlü olan 6, 8 ve 10 numaralı makalelerin WSM skorları yükselmiştir. Buna karşılık 1 numaralı makalenin WSM skoru 0,286’dan 0,207’ye düşmüştür.
Eğitim açıklaması ve okunabilirliğin öne çıkarıldığı S3 senaryosunda 1, 3, 6, 7 ve 9 numaralı makalelerin WSM skorları S1’e kıyasla artmıştır. Böylece ağırlıkların yalnız teknik bir detay değil, değerlendirme amacını doğrudan temsil eden bir modelleme tercihi olduğu görülmektedir.
Monte Carlo duyarlılık ve sağlamlık analizi
AHP ağırlıklarının küçük belirsizliklere ne kadar duyarlı olduğunu incelemek için her kriter ağırlığı bağımsız olarak başlangıç değerinin ±%20 çevresinde değiştirilmiş, ardından bütün ağırlıkların toplamı tekrar 1 olacak biçimde normalize edilmiştir.
Her senaryo için 500 farklı pertürbe ağırlık vektörü oluşturulmuş ve her vektörle hem WSM hem TOPSIS skorları yeniden hesaplanmıştır. Sonuçlar ortalama ve 5.–95. yüzdelik aralıklarla değerlendirilmiştir.
| Yöntem | S1 | S2 | S3 |
|---|---|---|---|
| WSM ortalama varyasyon | 0,091 | 0,089 | 0,083 |
| TOPSIS ortalama varyasyon | 0,114 | 0,116 | 0,127 |
WSM, ağırlık değişimlerine karşı TOPSIS’ten bir miktar daha düşük varyasyon göstermiştir. TOPSIS’in uzaklığa dayalı yapısı kriter ağırlıklarındaki değişikliklere daha duyarlı olabilmektedir. Bununla birlikte her iki yöntemde de gözlenen değişim [0,1] toplam skor aralığına göre sınırlı kalmıştır.
Makale sıralamalarının büyük bölümü pertürbasyonlar altında korunmuştur. Sıralamada meydana gelen daha belirgin farkların küçük rastgele ağırlık değişikliklerinden çok, S1–S2–S3 arasında bilinçli olarak değiştirilen karar önceliklerinden kaynaklandığı görülmüştür.
Ek A: lojistik regresyon sonuçları
| Değişken | Katsayı | Standart hata | z | p | %95 güven aralığı |
|---|---|---|---|---|---|
| Sabit | −2,196 | 0,492 | −4,458 | 0,000 | [−3,161; −1,230] |
| Eğitilmiş modelin sağlanması | 0,882 | 0,330 | 2,670 | 0,008 | [0,235; 1,529] |
| Veri erişilebilirliği | 1,106 | 0,510 | 2,167 | 0,030 | [0,106; 2,105] |
Modelin pseudo \(R^2\) değeri 0,054’tür ve açıklayıcı gücü sınırlıdır. Bu analiz öngörü başarısından çok yorumlanabilirlik için kullanılmıştır.
| Değişken | Katsayı | Standart hata | z | p | %95 güven aralığı |
|---|---|---|---|---|---|
| Sabit | −1,611 | 0,489 | −3,294 | 0,001 | [−2,570; −0,653] |
| Makale okunabilirliği | 2,764 | 0,367 | 7,531 | 0,000 | [2,045; 3,484] |
| Kullanılan algoritmanın zorluğu | −0,963 | 0,360 | −2,676 | 0,007 | [−1,669; −0,258] |
| Hiperparametre belirtimi | 1,183 | 0,402 | 2,942 | 0,003 | [0,395; 1,972] |
Raff veri kümesindeki lojistik model için pseudo \(R^2=0.33\) raporlanmıştır. Okunabilirlik ve hiperparametre belirtimi yeniden üretilebilir sınıfıyla pozitif; kullanılan algoritmanın zorluğu ise negatif ilişki göstermiştir.
Ek A: Random Forest ve XGBoost tarama performansı
| Veri kümesi | Model | Doğruluk | Sınıf 1 kesinlik | Sınıf 1 duyarlılık | Sınıf 1 F1 |
|---|---|---|---|---|---|
| Olszewski | Random Forest | 0,65 | 0,40 | 0,50 | 0,44 |
| Olszewski | XGBoost | 0,70 | 0,46 | 0,50 | 0,48 |
| Raff | Random Forest | 0,86 | 0,88 | 0,91 | 0,89 |
| Raff | XGBoost | 0,88 | 0,88 | 0,94 | 0,91 |
Olszewski veri kümesinde XGBoost Random Forest’a göre küçük bir iyileşme sağlamış, Raff veri kümesinde ise her iki ağaç tabanlı model daha güçlü sonuçlar vermiştir. Bununla birlikte bu modellerin temel görevi nihai yeniden üretilebilirlik sınıflandırıcısını oluşturmak değil, kriter türetimini destekleyen faktörleri belirlemektir.
XGBoost özellik önemleri
| Özellik | Normalize önem |
|---|---|
| README bulunması | 0,279 |
| Veri erişilebilirliği | 0,269 |
| Eğitilmiş model bulunması | 0,140 |
| Eğitim açıklaması | 0,116 |
| Hiperparametre belirtimi | 0,103 |
| Eğitim/test bölünmesi belirtimi | 0,090 |
| Deney erişilebilirliği | 0,000 |
Olszewski veri kümesinde README ve veri erişilebilirliği en yüksek normalize öneme sahiptir. Özellik-etki analizinde README’nin yeniden üretilebilir sınıfına tahmin etkisi +0,300, eğitilmiş modelin +0,190 ve veri erişilebilirliğinin +0,108 olarak bulunmuştur.
Raff veri kümesinde en baskın özellik makale okunabilirliği olmuştur ve normalize önemi 0,288’dir. Veri erişilebilirliği 0,062; kavramsallaştırma şekillerinin sayısı 0,056; hiperparametre belirtimi 0,051; tablo ve şekil sayısı 0,048; kod erişilebilirliği 0,043 değerine sahiptir. Okunabilirliğin yeniden üretilebilir sınıfına özellik-etki değeri +0,6198 olarak raporlanmıştır.
Çalışmanın temel bilimsel mesajı
Yeniden üretilebilirliği tek bir “kod var mı?” sorusuna indirgemek yeterli değildir. Gerçek bir yeniden üretim süreci veri, kod, eğitilmiş model, çalışma talimatı, hiperparametreler, eğitim ayrıntıları ve yöntem anlatımının birlikte yeterli olmasını gerektirebilir. MCDM yaklaşımı bu çok boyutlu yapıyı tek sayıda özetlemeye çalışmaktadır.
Bununla birlikte tek sayı her bağlam için mutlak değildir. Veri ve kod paylaşımını önceleyen bir artefakt değerlendirme komitesi ile hassas verilerin yaygın olduğu bir alanda yöntemsel şeffaflığı önceleyen bir hakem aynı kriter ağırlıklarını kullanmak zorunda değildir. AHP senaryolarının amacı tam olarak bu bağlamsal farklılığı görünür hale getirmektir.
Çalışmanın desteklediği sonuçlar
Kaynak çalışma, yedi kriterin ordinal olarak puanlanıp normalize edilmesi ve WSM/TOPSIS ile birleştirilmesinin, araştırma makalesi düzeyinde uygulanabilir ve yorumlanabilir bir R1 hazır oluş skoru üretebildiğini göstermektedir.
Temel skor referans etiketle orta düzeyde uyum göstermiş; tek artefakt temelli basit kurallardan daha dengeli F1 performansı sağlamıştır. Farklı ağırlık senaryoları skorları beklenen yönde değiştirmiş ve ±%20 ağırlık pertürbasyonları altında sonuçların tamamen kararsız hale gelmediği görülmüştür.
Çalışmanın desteklemediği sonuçlar
Yüksek hazır oluş skoru gerçek deneyin kesin olarak başarıyla yeniden üretileceği anlamına gelmez. Çerçeve kodu çalıştırmadığı için gizli bağımlılıkları, bozuk uygulamayı, donanım uyumsuzluğunu veya erişim iddiasıyla pratik erişim arasındaki farkı doğrudan doğrulamaz.
Düşük hazır oluş skoru da bir çalışmanın bilimsel açıdan kötü, önemsiz veya yanlış olduğu anlamına gelmez. Ticari, stratejik veya gizlilik gerekçeleri nedeniyle artefaktlarını paylaşamayan yüksek etkili araştırmalar düşük hazır oluş skoru alabilir.
Çerçevenin 0–1 skoru bir yeniden üretilebilirlik olasılığı değildir ve “0,8 puan alan araştırmanın %80 ihtimalle yeniden üretileceği” biçiminde yorumlanmamalıdır.
Sınırlılıklar
Veri kapsamı: Olszewski veri kümesi ağırlıklı olarak üst düzey güvenlik konferanslarını; Raff veri kümesi ise büyük ölçüde NeurIPS ve ICML çalışmalarını kapsamaktadır. Bu alanlardaki paylaşım kültürü bütün makine öğrenimi alt alanlarını temsil etmeyebilir.
Referans etiket ile skor arasındaki kavramsal fark: Hazır oluş skoru görünür açıklama ve artefaktları ölçerken referans etiket gerçek yeniden üretim sonucuna dayanabilir. Dolayısıyla iki yapının tam eşleşmesi teorik olarak beklenmemelidir.
Anotasyon sınırlılığı: İnsan ve ChatGPT anotasyonları arasında yüksek uyum bulunmasına rağmen değerlendirme sınırlı sayıda anotatöre dayanmıştır. Özellikle okunabilirlik veya “kısmen tamamlanmış” dokümantasyon gibi alanlarda öznel değerlendirme yanlılığı kalabilir.
Ordinal rubrik ve doğrusal normalizasyon: Denklem (3), komşu ordinal seviyeleri eşit mesafeli kabul eder. Oysa bazı kriterlerde “kısmi” düzeyden “tam” düzeye geçişin pratik yararı, “yok”tan “kısmi”ye geçişten daha büyük veya daha küçük olabilir.
Kriter bağımlılıkları: WSM’nin telafi edici toplamsal yapısı yeniden üretilebilirliğin mantıksal bağımlılıklarını tamamen temsil etmez. Kod veya veri gibi kritik bir unsurun sıfır olması bazı koşullarda diğer yüksek kriterlerle telafi edilemeyebilir.
Çerçevenin kapsamı: Yöntem nihai bir yeniden üretilebilirlik sertifikası değil, ilk tarama ve karşılaştırmalı değerlendirme aracıdır.
Gelecek araştırma yönleri
Kaynak çalışma gelecekte gerçek çalıştırma sonuçlarını içeren yeni veri setlerinin kurulmasını önermektedir. Konteyner içinde yeniden çalıştırma, bağımlılık çözümünün doğrulanması ve artefakt bütünlüğünün test edilmesi gibi bilgiler hazır oluş skoru ile gerçek yeniden üretim engelleri arasındaki farkın daha doğrudan ölçülmesini sağlayabilir.
Kriter seti rastgelelik kontrolü, çalışma ortamı belirtimi ve değerlendirme sızıntısı kontrolleri gibi ek boyutlarla genişletilebilir. Aynı çerçeve kriter ve rubrik değiştirilerek R2 ve R3 gibi daha ileri yeniden üretilebilirlik düzeylerine de uyarlanabilir.
Artefakt bağlantılarının, README bütünlüğünün ve yapılandırılmış yöntem bilgilerinin kısmen otomatik çıkarılması çerçeveyi büyük ölçekli değerlendirmeye uygun hale getirebilir. Bununla birlikte öznel kriterler için insan-döngüde değerlendirme ve çoklu anotatör uzlaşması önemini korumaktadır.
WSM ve TOPSIS dışında LINMAP, PROMETHEE ve VIKOR gibi farklı MCDM ailelerinin karşılaştırılması; anotasyon ve ağırlık belirsizliğini doğrudan skor aralıklarına taşıyan yöntemlerin geliştirilmesi; ayrıca temel kriterlerde minimum şart uygulayan telafi edilemez değerlendirme mekanizmalarının kullanılması gelecekteki araştırma alanları arasındadır.
Genel sonuç
Çalışma, makine öğrenimi araştırmalarında yeniden üretilebilirlik sorununu yalnız “kod paylaşılmış mı?” biçimindeki tek boyutlu kontrolden çıkararak çok kriterli bir karar problemi olarak ele almaktadır. Yedi açık kriterin sıralı rubrikle puanlanması, ortak ölçeğe dönüştürülmesi ve WSM veya TOPSIS ile birleştirilmesi, makaleler arasında karşılaştırılabilir ve karar amacı doğrultusunda ağırlıklandırılabilir bir R1 hazır oluş skoru sağlamaktadır.
Araştırmanın en önemli kavramsal katkısı skorun sınırını açık tutmasıdır: hazır oluş ve gerçek yeniden üretilebilirlik ilişkili fakat aynı kavram değildir. Bir makale gereken bütün açıklamaları ve artefaktları sunabilir, fakat çalıştırma aşamasında görünmeyen teknik sorunlar nedeniyle başarısız olabilir. Tersine, standart rubrikte bazı bilgileri eksik görünen bir çalışma pratikte yeniden üretilebilir olabilir.
Bu nedenle önerilen çerçevenin en uygun kullanımı bilimsel kaliteyi puanlayan nihai bir derecelendirme sistemi olmak değil; araştırma şeffaflığını ve R1 yeniden üretilebilirlik hazırlığını sistematik biçimde inceleyen, karşılaştırmayı kolaylaştıran ve daha ayrıntılı yeniden üretim doğrulamasına hangi çalışmaların hazır göründüğünü gösterebilen tamamlayıcı bir araç olmaktır.
Kaynak ve Yöntem Notu
Özgün çalışma: A MCDM-Based Framework for Quantifying Reproducibility Readiness in Machine Learning Research.
Yazarlar: Paulina Leščinskaitė, Remigijus Paulavičius ve Ernestas Filatovas.
Sorumlu yazar: Ernestas Filatovas.
Kurum: Institute of Data Science and Digital Technologies, Faculty of Mathematics and Informatics, Vilnius University, Akademijos Str. 4, LT-08412 Vilnius, Lithuania.
Dergi: Mathematics.
Yayınevi: MDPI, Basel, Switzerland.
Bibliyografik kayıt: Mathematics, 2026, Cilt 14, Sayı 9, Makale 1536.
DOI: 10.3390/math14091536
Alınma: 20 Mart 2026.
Revizyon: 23 Nisan 2026.
Kabul: 28 Nisan 2026.
Yayın: 1 Mayıs 2026.
Kaynak türü: Hakemli, açık erişimli özgün araştırma makalesi.
Lisans: Creative Commons Attribution (CC BY).
Temel yöntem: Teorik yeniden üretilebilirlik analizi, iki mevcut veri kümesi üzerinde lojistik regresyon/Random Forest/XGBoost tabanlı ampirik kriter taraması, yedi kriterli ordinal rubrik, [0,1] normalizasyonu, WSM ve TOPSIS tabanlı MCDM toplulaştırması, AHP tabanlı örnek ağırlık senaryoları ve Monte Carlo ağırlık duyarlılık analizi.
Finansman
Araştırma, Litvanya Araştırma Konseyi tarafından Litvanya Cumhuriyeti Eğitim, Bilim ve Spor Bakanlığı'nın “University Excellence Initiatives” programı kapsamında desteklenmiştir. Kaynakta belirtilen proje numarası S-A-UEI-23-11'dir.
Veri ve kod erişilebilirliği
Yazarlar tam kod tabanının, veri kümelerinin ve veri/kod dosyalarını açıklayan README belgesinin açık olarak sağlandığını bildirmektedir. Araştırmadaki yöntem ve metrikler Python 3.13.3 ile uygulanmıştır.
Kaynak kod ve veri deposu: GitHub — Quantifying reproducibility of ML papers using MCDM.
Çıkar çatışması
Yazarlar çıkar çatışması olmadığını beyan etmektedir. Finansman sağlayıcıların çalışmanın tasarımı, veri toplama, analiz, yorumlama, makale yazımı veya yayın kararında rol almadığı belirtilmiştir.
Yazar katkıları
- Kavramsallaştırma: P.L., R.P. ve E.F.
- Metodoloji: P.L. ve E.F.
- Yazılım: P.L.
- Doğrulama: P.L., R.P. ve E.F.
- Biçimsel analiz: P.L., R.P. ve E.F.
- Araştırma: P.L., R.P. ve E.F.
- Veri kürasyonu: P.L.
- İlk taslak: P.L. ve E.F.
- İnceleme ve düzenleme: R.P. ve E.F.
- Görselleştirme: P.L.
- Gözetim: E.F.
- Proje yönetimi: R.P.
- Finansman edinimi: R.P.
Yöntemsel yorum sınırı
Bu çalışma 139 makine öğrenimi makalesinin özgün deneylerini yeniden yürütmüş bir toplu yeniden üretim çalışması değildir. Önerilen skor, görünür artefaktlar ve raporlama bilgileri üzerinden yeniden üretilebilirliğe hazır oluşu değerlendirir. Dolayısıyla skor ile pratik yeniden üretim başarısı birbirinin yerine kullanılamaz.
Ayrıca kullanılan iki kaynak veri kümesinin alan kapsamı sınırlıdır; kriter ağırlıkları örnek senaryolarda araştırmacılar tarafından gösterim amacıyla oluşturulmuştur ve gerçek paydaşlardan elde edilmiş tercihler değildir. Kriter seti rastgelelik, değerlendirme sızıntısı ve hesaplama ortamı determinizmi gibi bütün olası yeniden üretilebilirlik sorunlarını bağımsız kriterler olarak içermemektedir.
Resmî yayın bağlantısı: https://doi.org/10.3390/math14091536
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir