


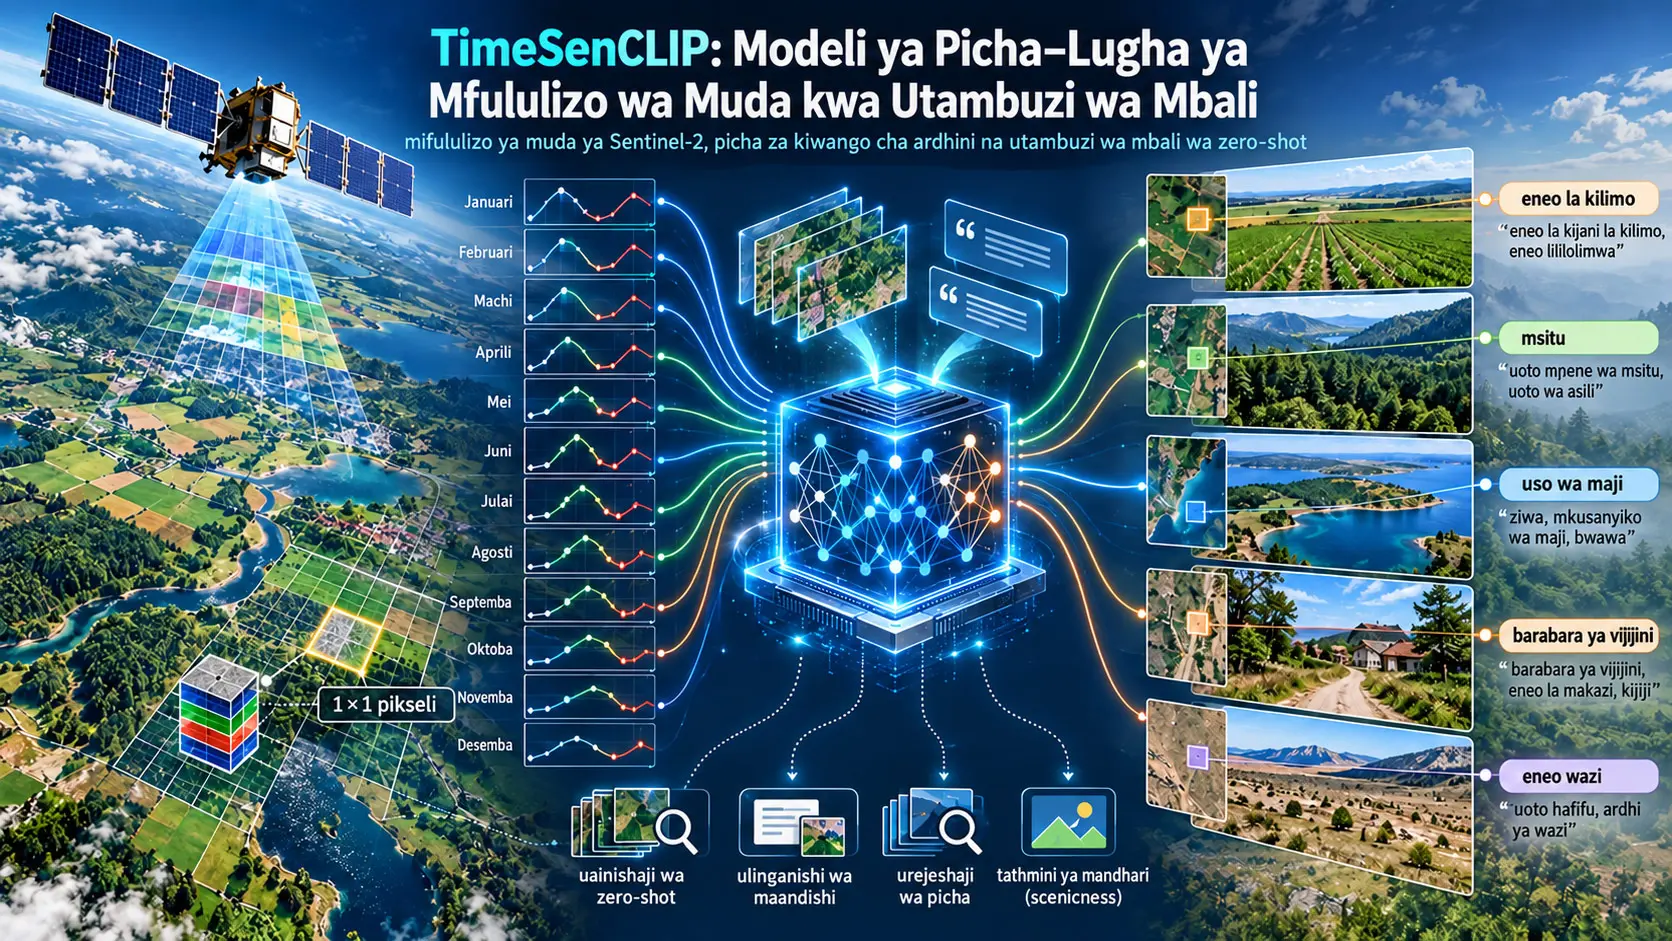
TimeSenCLIP ni modeli nyepesi ya picha–lugha inayolinganisha mfululizo wa muda wa satelaiti wa multispectral Sentinel-2 na uwakilishi wa semantiki wa CLIP kutoka picha za kiwango cha ardhini zenye lebo za kijiografia kwa kutumia ujifunzaji linganishi wa cross-view. Sifa bainifu ya modeli ni uwezo wake wa kujifunza uwakilishi wa semantiki kutokana na mabadiliko ya spektri–muda ya pikseli moja tu ya Sentinel-2, bila kuhitaji patch kubwa za picha upande wa satelaiti au caption za maandishi wakati wa mafunzo.
TimeSenCLIP imefunzwa kwa kutumia picha za kiwango cha ardhini za LUCAS 2018 na mfululizo wa muda wa Sentinel-2 wa Sen4Map; kisha ikatathminiwa katika uainishaji wa zero-shot wa land cover, land use, habitat, aina ya mazao na bioregion, cross-modal retrieval, pamoja na utabiri wa scenicness. Modeli kuu ya TimeSenCLIP-P1 yenye miezi 12, pikseli moja na multispectral ilifikia usahihi wa jumla wa zero-shot Top-1 wa %47,35 ± 0,18 kwa kutumia descriptive prompt. Kwa modeli hiyo hiyo yenye mfululizo wa muda wa kila mwezi, Recall@1 ya jumla ya cross-modal ilikuwa 0,446 katika mwelekeo wa Ground-to-Satellite na 0,535 katika mwelekeo wa Satellite-to-Ground.
Hitimisho kuu la utafiti ni kwamba katika data za remote sensing za azimio la kati kama Sentinel-2, mienendo ya muda na spektri inaweza kufidia sehemu muhimu ya muktadha mpana wa anga kwa kazi nyingi. Hata hivyo, matokeo haya hayamaanishi kwamba “pikseli moja inatosha kila wakati” kwa kazi zote: katika matatizo kama uainishaji wa habitat na scenicness, ambako muundo wa anga, texture na jiometria ya mandhari ni muhimu, patch kubwa zaidi zinaweza kutoa faida. Aidha, modeli imetathminiwa kwa Sentinel-2 na data za LUCAS zinazolenga Ulaya pekee; utendaji uleule bado haujaonyeshwa kwenye sensor, hali za hewa na maeneo mengine ya kijiografia.
Tatizo la utafiti
Vision–language model (VLM) nyingi zilizotengenezwa kwa remote sensing hubadilisha miundo inayofanana na CLIP iliyoundwa kwa picha za kawaida ili ifanye kazi na picha za satelaiti. Njia hii huleta matatizo matatu makuu. Kwanza, mafunzo mara nyingi huhitaji jozi za picha ya satelaiti–caption ya maandishi; maelezo hayo ni ghali na pia yanaweza kuzuiwa na msamiati uliotumiwa. Pili, modeli kwa kawaida hutegemea patch kubwa za anga zenye upana wa mamia ya pikseli. Kwa sensor za azimio la kati kama Sentinel-2, patch kubwa inaweza kuchanganya maeneo tofauti ndani ya mosaiki changamani ya kilimo au ekosistimu kuwa ingizo moja. Tatu, njia ya kawaida inayotegemea RGB haitumii kikamilifu msimu, fenolojia na sifa za uakisi katika urefu tofauti wa mawimbi.
TimeSenCLIP huuliza tatizo hili kwa mwelekeo mwingine: Je, mfululizo wa muda wa multispectral wa pikseli moja ya Sentinel-2 unaobadilika mwaka mzima una taarifa za kutosha kujifunza semantiki ya ardhi na ekosistimu bila patch kubwa ya picha ya anga?
Njia ya utafiti ina maana hasa kwa madarasa ya kilimo na ikolojia. Kwa mfano, ngano, mahindi au mifumo tofauti ya mimea inaweza kuonekana sawa katika picha za tarehe moja; lakini mabadiliko ya uakisi yanayotokea wakati wa kupanda, ukuaji, kukomaa na kuvuna hutengeneza saini tofauti za muda.
TimeSenCLIP Hujifunzaje Taarifa ya Semantiki Kutoka Pikseli Moja ya Sentinel-2?
TimeSenCLIP hujifunza kwa kuleta karibu mfululizo wa spektri–muda wa Sentinel-2 na picha za kiwango cha ardhini za eneo lilelile katika nafasi moja ya embedding; taarifa ya semantiki kutoka encoder ya picha ya CLIP iliyofungwa kwa picha za ardhini huhamishwa kwenda kwenye mfululizo wa muda wa satelaiti, na baada ya mafunzo kukamilika, encoder ya satelaiti pamoja na CLIP text encoder pekee zinaweza kutumiwa kufanya utabiri wa zero-shot kwa madarasa mapya ya maandishi.
Kuna mitazamo miwili katika mafunzo
Mtazamo wa kiwango cha ardhini: Picha zenye lebo za kijiografia zilizopigwa katika pande nne kuu kwenye pointi za LUCAS hupitishwa katika encoder ya picha ya CLIP ViT-B/32 iliyofungwa. Kwa kuwa CLIP tayari ina nafasi ya semantiki iliyojifunza kati ya picha za kawaida na lugha, picha hizi hufanya kazi kama shabaha za semantiki zilizolinganishwa na maandishi kwa TimeSenCLIP.
Mtazamo wa satelaiti: Mfululizo wa muda wa Sentinel-2 wa eneo hilohilo huchakatwa na Transformer encoder tofauti. Encoder ya satelaiti hufunzwa kutoka mwanzo na kujifunza kukaribia embedding ya picha ya ardhini.
Dokezo la majina ndani ya chanzo: katika muhtasari wa jumla wa mbinu, imeelezwa kwamba picha nyingi za ardhini zinaunganishwa kwa “attention pooling”. Katika maelezo ya kina ya usanifu na Appendix A.4.3, hata hivyo, “average pooling” hutumiwa. Kwa kuwa chanzo hakijapatanisha maneno haya mawili kando, hayajabadilishwa kimya kimya kuwa usemi mmoja hapa.
Mlinganyo (1): Uhalalishaji wa L2 wa embedding za CLIP
\[ \mathbf{v}_i= \frac{f_{\mathrm{img}}(I_i)} {\left\|f_{\mathrm{img}}(I_i)\right\|_2}, \qquad \mathbf{t}_i= \frac{f_{\mathrm{text}}(T_i)} {\left\|f_{\mathrm{text}}(T_i)\right\|_2}. \tag{1} \]
Formula huhesabu nini? Hufanya vekta za embedding zinazotolewa na encoder ya picha na text encoder kuwa na urefu wa kitengo.
Vigezo: \(I_i\), picha ya \(i\); \(T_i\), maandishi yanayolingana nayo; \(f_{\mathrm{img}}\) encoder ya picha; \(f_{\mathrm{text}}\) text encoder; \(\|\cdot\|_2\) ni norma ya Euclidean/L2.
Jukumu la kihisabati: Baada ya uhalalishaji, urefu wa embedding huwa 1. Hivyo dot product kati ya uwakilishi miwili inalingana moja kwa moja na cosine similarity:
\[ \operatorname{sim}(\mathbf{v}_i,\mathbf{t}_j) = \mathbf{v}_i\cdot\mathbf{t}_j. \]
Thamani za embedding hazina kitengo cha kipimo cha kimwili; ni namba zisizo na kipimo katika nafasi ya uwakilishi.
Mlinganyo (2): Hasara ya InfoNCE
\[ \mathcal{L}_{\mathrm{InfoNCE}} (\mathbf{x},\mathbf{x}^{+},\{\mathbf{x}_{j}^{-}\}) = -\log \frac{ \exp(\mathbf{x}\cdot\mathbf{x}^{+}/\tau) }{ \exp(\mathbf{x}\cdot\mathbf{x}^{+}/\tau) + \sum_{j=1}^{J} \exp(\mathbf{x}\cdot\mathbf{x}_{j}^{-}/\tau) }. \tag{2} \]
Huhesabu nini? Hupima kwa hasara moja ya contrastive jinsi anchor embedding inavyofanana kwa nguvu na jozi sahihi na kwa udhaifu na jozi zisizo sahihi.
\(\mathbf{x}\) ni sampuli ya anchor, \(\mathbf{x}^{+}\) ni jozi chanya sahihi, \(\mathbf{x}_{j}^{-}\) ni sampuli hasi na \(\tau\) ni parameter ya temperature inayoweza kujifunzwa. Kwa kuwa ukubwa wote uko katika nafasi ya embedding, hauna vitengo vya kimwili.
Cosine similarity ya jozi chanya inapoongezeka, sehemu ya juu huongezeka na hasara hupungua. Mfanano wa sampuli hasi unapoongezeka, sehemu ya chini huongezeka na hasara huongezeka. Kwa njia hii modeli hujifunza kuleta karibu mitazamo miwili tofauti ya eneo lilelile la kijiografia huku ikisogeza maeneo mengine mbali.
Mlinganyo (3): Kubadilisha hatua ya muda ya Sentinel-2 kuwa embedding
\[ \mathbf{r}_t= \operatorname{Linear} \left( \operatorname{Flatten}(\mathbf{R}_t) \right), \qquad t=1,\ldots,T. \tag{3} \]
Ingizo kamili la satelaiti lina umbo:
\[ \mathbf{R}\in \mathbb{R}^{T\times C\times H\times W} \]
ambapo \(T\) ni idadi ya hatua za muda, \(C\) ni idadi ya bendi za spektri na \(H\times W\) ni ukubwa wa anga. Katika usanidi mkuu wa TimeSenCLIP-P1, \(H=W=1\), \(C=10\) na kwa matumizi ya kila mwezi \(T=12\).
Kila kipande cha muda \(\mathbf{R}_t\) kwanza hufanywa flat, kisha hubadilishwa kwa linear projection inayoweza kujifunzwa kuwa ukubwa wa embedding unaoweza kutumiwa na Transformer. Bendi za Sentinel-2 ziliwekewa min–max normalization kwa kila bendi hadi masafa ya \([0,1]\) kabla ya mafunzo.
Mlinganyo (4): Kuunda mfuatano wa token za muda
\[ \mathbf{Z} = [ \mathbf{p}_{\mathrm{cls}}; \mathbf{r}_1+\mathbf{p}_1; \ldots; \mathbf{r}_T+\mathbf{p}_T ]. \tag{4} \]
\(\mathbf{p}_{\mathrm{cls}}\) ni CLS token inayojifunzwa ili kubeba muhtasari wa mfululizo wote wa muda. \(\mathbf{p}_t\) ni temporal position embedding inayojifunzwa inayosimba nafasi ya hatua ya muda ya \(t\) katika mfuatano.
Kwa nini muundo huu unahitajika? Thamani ileile ya uakisi ikionekana mwezi Machi na ikionekana mwezi Agosti huenda isiwe na maana ileile ya kiikolojia. Position embedding husaidia modeli kuhifadhi taarifa ya “uchunguzi gani uko katika mwezi/nafasi gani ya muda?”.
Mlinganyo (5): Transformer encoder ya mfululizo wa muda
\[ \hat{\mathbf{s}} = f_S(\mathbf{Z}). \tag{5} \]
\(f_S\) ni Transformer encoder ya satelaiti ya TimeSenCLIP inayofunzwa. Katika chanzo encoder hii hutumia tabaka 6 za Transformer, 8 attention head, 256 hidden dimension na 512 latent dimension. GELU activations na LayerNorm hutumiwa. Matokeo ya mwisho ya CLS hupitishwa kwenye MLP projection head nyepesi ya tabaka mbili.
Mlinganyo (6): Uhalalishaji wa embedding za satelaiti na ardhini
\[ \mathbf{s} = \frac{\hat{\mathbf{s}}}{\|\hat{\mathbf{s}}\|_2}, \qquad \mathbf{g} = \frac{\hat{\mathbf{g}}}{\|\hat{\mathbf{g}}\|_2}. \tag{6} \]
\(\hat{\mathbf{s}}\) ni matokeo ghafi ya encoder ya satelaiti, na \(\hat{\mathbf{g}}\) ni uwakilishi wa CLIP wa kiwango cha ardhini. Baada ya uhalalishaji, \(\mathbf{s}\) na \(\mathbf{g}\) zinaweza kulinganishwa katika nafasi moja ya latent yenye vipimo 512.
Mlinganyo (7): Hasara halisi ya mafunzo ya TimeSenCLIP
\[ \mathcal{L}_{\mathrm{TimeSenCLIP}} ( \{\mathbf{s}_i\}, \{\mathbf{g}_i\}, \mathcal{Q} ) = \sum_i \mathcal{L}_{\mathrm{InfoNCE}} \left( \mathbf{s}_i, \mathbf{g}_i^{+}, \{\mathbf{g}_{j}^{-}\}_i \cup \mathcal{Q} \right). \tag{7} \]
\(\mathbf{g}_i^{+}\) ni uwakilishi wa picha ya ardhini kutoka eneo lilelile la kijiografia na sampuli ya satelaiti. \(\mathbf{g}_{j}^{-}\) ni sampuli hasi kutoka maeneo tofauti ndani ya batch. \(\mathcal{Q}\) ni memory queue ya aina ya MoCo inayohifadhi embedding za ardhini kutoka batch zilizopita.
Ukubwa wa Queue katika chanzo ni \(K=2048\). Lengo lake ni kuruhusu sampuli ya satelaiti kujifunza dhidi ya idadi kubwa ya maeneo hasi bila kuhitaji batch kubwa sana.
Kwa nini temporal augmentation hutumiwa?
Katika mfululizo halisi wa muda wa Sentinel-2 kunaweza kuwa na mawingu, acquisition iliyokosekana au mapengo ya data ya msimu. Wakati wa mafunzo, TimeSenCLIP hutumia kwa uwezekano wa %50 mojawapo ya perturbation tatu za muda kwa kila batch:
- Median Pooling: hupunguza hatua zote za muda kuwa vekta moja ya spektri ya median.
- Random Quarter Mask: huficha sehemu mfululizo ya takriban miezi mitatu.
- Random Temporal Mask: huficha kwa nasibu hatua 1–11 za muda; angalau uchunguzi mmoja huhifadhiwa.
Augmentation hizi hutumiwa tu wakati wa mafunzo. Wakati wa inference, modeli inaweza kuendeshwa kwa ingizo la kila mwezi \(T=12\), la kila robo mwaka \(T=4\), au la muda mmoja \(T=1\) linalotumia median ya mwaka mzima.
Prompt za maandishi ziliundwaje?
Katika tathmini ya zero-shot, aina tatu za prompt zililinganishwa:
- Class-name: jina la darasa pekee.
- Generic: kiolezo cha jumla kama “a centered satellite image of {class name}”.
- Description: sentensi za lugha ya kawaida zinazoeleza mwonekano au sifa za kiikolojia za darasa.
Kwa kila darasa, tofauti tano za descriptive ziliundwa kwa kutumia GPT-4 kwa namna inayofanana na mbinu ya SenCLIP. Prompt hizi si caption za mafunzo; ni maelezo ya darasa yanayotolewa kwa CLIP text encoder wakati wa tathmini ya zero-shot. Kwa descriptive prompt, text embedding ziliunganishwa kwa late prompt ensembling.
Je, Taarifa ya Muda Inaweza Kuchukua Nafasi ya Patch Kubwa za Satelaiti?
Kulingana na matokeo ya utafiti, katika kazi nyingi za ardhi, mazao na bioregion, mfululizo mrefu wa muda wa Sentinel-2 unaweza kuruhusu ingizo la pikseli moja kushindana na patch kubwa zaidi za anga au kuzizidi; hata hivyo, katika kazi kama habitat na scenicness zinazohitaji texture, jiometria na mpangilio mpana wa anga, patch kubwa zaidi bado zina faida.
Mbinu na Matokeo ya Utafiti
Muundo wa data wa LUCAS na Sen4Map
| Kipengele | Muundo uliotumika katika chanzo |
|---|---|
| Mwaka wa LUCAS | 2018 |
| Upeo wa LUCAS | Takriban pointi 235.000 zenye marejeo ya kijiografia, nchi 28 |
| Picha za ardhini | Picha za azimio la juu katika pande za kaskazini, mashariki, kusini na magharibi |
| Chanzo cha Sentinel-2 | Sen4Map |
| Patch ya chanzo | 64 × 64 pikseli |
| Bendi za spektri | bendi 10; azimio la 10 m na 20 m |
| Hatua ya muda ya mwaka | kompositi ya median ya miezi 12 |
| Mafunzo | sampuli 140.000 |
| Uthibitishaji | sampuli 30.000 |
| Jaribio | sampuli 50.000 |
| Ingizo kuu la TimeSenCLIP | pikseli 1 × 1 kutoka katikati ya patch |
| Spatial ablation | muktadha wa 1×1, 5×5, 9×9, 16×16 na 64×64 |
Kazi za tathmini
| Kazi | Darasa / muundo wa data | Metriki kuu |
|---|---|---|
| Land Cover | madarasa 8 | Top-1 accuracy |
| Land Use | madarasa 16 | Top-1 accuracy |
| Crops | madarasa 40 katika Jedwali 2; 38 specific crop type katika maandishi | Top-1 accuracy |
| EUNIS Habitat | aina 44 za terrestrial habitat | Top-1 accuracy |
| Bioregion | madarasa 8 katika Jedwali 2 | Top-1 accuracy |
| Country retrieval | lebo za nchi 28 | Recall@1 |
| Scenicness | UK ScenicOrNot; sampuli 2411 zilizolinganishwa | Pearson \(R\), Kendall \(\tau\) |
Dokezo la chanzo kuhusu Crop-class: maandishi ya mbinu kuu yanasema LUCAS Level-1 ina 38 specific crop type, ilhali Jedwali 2 linatoa thamani “Crops — 40 classes”. Tofauti hii ya chanzo imehifadhiwa hapa kama ilivyo.
Hyperparameter za mafunzo
| Ground encoder | CLIP ViT-B/32, iliyofungwa |
|---|---|
| Ground embedding | vipimo 512 |
| Satellite Transformer | tabaka 6, 8 attention head |
| Hidden dimension | 256 |
| Latent dimension | 512 |
| Memory queue | 2048 embedding hasi |
| Optimizer | AdamW |
| Learning rate ya mwanzo | \(10^{-4}\) |
| Weight decay | \(1\times10^{-6}\) |
| AdamW \(\beta_1,\beta_2\) | 0,9; 0,999 |
| Schedule | Cosine annealing |
| Warm-up | 10 epoch |
| Mafunzo jumla | 200 epoch |
| Batch size | 1024 |
| Vifaa | NVIDIA TITAN X GPU moja |
Matokeo makuu katika uainishaji wa zero-shot
| Modeli | Ingizo | T | Overall C (%) | Overall G (%) | Overall D (%) |
|---|---|---|---|---|---|
| CLIP | 64×64 RGB | 1 | 20,37 ± 0,22 | 22,14 ± 0,21 | 22,66 ± 0,20 |
| GeoRSCLIP | 64×64 RGB | 1 | 21,35 ± 0,10 | 24,74 ± 0,22 | 27,32 ± 0,15 |
| RemoteCLIP | 64×64 RGB | 1 | 20,35 ± 0,14 | 23,78 ± 0,10 | 23,31 ± 0,11 |
| SkyCLIP | 64×64 RGB | 1 | 7,91 ± 0,06 | 10,36 ± 0,10 | 16,68 ± 0,10 |
| SenCLIP | 64×64 RGB | 1 | 25,75 ± 0,10 | 25,91 ± 0,10 | 25,89 ± 0,14 |
| Llama3-MS-CLIP | Multispectral | 1 | 24,29 ± 0,12 | 25,35 ± 0,11 | 26,28 ± 0,13 |
| TimeSenCLIP-P64 | 64×64 RGB | 1 | 34,68 ± 0,16 | 36,27 ± 0,15 | 39,15 ± 0,24 |
| TimeSenCLIP-P1-RGB | 1×1 RGB | 1 | 32,33 ± 0,16 | 32,97 ± 0,14 | 32,49 ± 0,12 |
| TimeSenCLIP-P1-MS | 1×1 multispectral | 1 | 35,26 ± 0,11 | 36,47 ± 0,13 | 37,46 ± 0,15 |
| TimeSenCLIP-P1-MS | 1×1 multispectral | 12 | 42,02 ± 0,15 | 44,22 ± 0,16 | 47,35 ± 0,18 |
Modeli ya kila mwezi, pikseli moja na multispectral ilifanya nini kwa kila kazi?
| Kazi | Class-name (%) | Generic (%) | Description (%) |
|---|---|---|---|
| Land Cover | 62,40 | 61,35 | 66,49 |
| Land Use | 54,45 | 60,67 | 64,59 |
| Habitat | 24,06 | 25,01 | 30,90 |
| Crops | 29,33 | 28,42 | 40,36 |
| Bioregion | 49,87 | 45,65 | 34,42 |
Ingawa descriptive prompt zilitoa matokeo ya juu zaidi kwa wastani wa jumla, aina ileile ya prompt si bora katika kila kazi. Kwa mfano, kwa Bioregion usahihi wa %49,87 ulipatikana kwa jina la darasa pekee, huku descriptive prompt ikitoa %34,42. Hii inaonyesha kwamba hitimisho la “prompt ndefu daima ni bora” halijaungwa mkono.
Matokeo ya cross-modal retrieval
Recall@1 hutumiwa katika tathmini ya retrieval. Ikiwa sampuli inayorudishwa katika nafasi ya kwanza ya query ni ya darasa lilelile na query, inachukuliwa kuwa imefanikiwa.
| Modeli | G2S Recall@1 ya jumla | S2G Recall@1 ya jumla |
|---|---|---|
| CLIP | 0,327 | 0,161 |
| GeoRSCLIP | 0,360 | 0,209 |
| RemoteCLIP | 0,291 | 0,232 |
| SkyCLIP | 0,126 | 0,167 |
| SenCLIP | 0,362 | 0,306 |
| Llama3-MS-CLIP | 0,218 | 0,167 |
| TimeSenCLIP-P64-RGB, T=1 | 0,416 | 0,460 |
| TimeSenCLIP-P1-RGB, T=1 | 0,331 | 0,331 |
| TimeSenCLIP-P1-MS, T=1 | 0,352 | 0,365 |
| TimeSenCLIP-P1-MS, T=12 | 0,446 | 0,535 |
Modeli ya kila mwezi ya pikseli moja ni imara hasa katika mwelekeo wa S2G. Kwa kazi mbalimbali, S2G Recall@1 ni: Land Cover 0,660, Land Use 0,682, Habitat 0,433, Crops 0,411, Bioregion 0,634 na Country 0,392.
Utabiri wa scenicness
Scenicness ni skor endelevu kuhusu uzuri wa kuona wa mandhari jinsi unavyotambuliwa na watu. Utafiti uliunganisha sampuli 2411 kutoka data ya ScenicOrNot ya Uingereza na eneo la karibu zaidi la Sen4Map ndani ya 100 m.
Pearson \(R\) hupima uhusiano wa mstari kati ya utabiri na ground-truth, huku Kendall \(\tau\) ikipima ulinganifu wa mpangilio. Vipimo vyote viwili havina kitengo.
| Modeli | T | Ingizo | Late \(R\) | Late \(\tau\) |
|---|---|---|---|---|
| CLIP — picha ya ardhini | 1 | Picha ya ardhini | 0,660 | 0,465 |
| CLIP — satellite | 1 | 64×64 | 0,519 | 0,363 |
| SenCLIP | 1 | 64×64 | 0,421 | 0,283 |
| TimeSenCLIP-RGB | 1 | 64×64 | 0,660 | 0,450 |
| TimeSenCLIP-MS | 1 | 1×1 | 0,318 | 0,205 |
| TimeSenCLIP-MS | 4 | 1×1 | 0,451 | 0,312 |
| TimeSenCLIP-MS | 12 | 1×1 | 0,527 | 0,363 |
Katika Appendix A.1, wastani wa mikakati yote ya prompt-ensemble unapochunguzwa, TimeSenCLIP-P64-RGB ilipata \(R=0.639\), \(\tau=0.440\) kwa ingizo la kila mwezi; P1-MS ya pikseli moja ilipata \(R=0.526\), \(\tau=0.363\). Matokeo haya yanaonyesha kwamba taarifa ya muda husaidia scenicness, lakini muktadha mpana wa anga bado una thamani kwa sababu ya sifa kama jiometria na texture ya mandhari.
Ulinganisho na miundo ya kawaida ya mfululizo wa muda
| Modeli | Overall C (%) | Overall G (%) | Overall D (%) |
|---|---|---|---|
| Supervised upper bound | 73,70 | – | – |
| CNN1D | 39,04 ± 0,19 | 41,96 ± 0,22 | 44,88 ± 0,15 |
| ConvTran | 40,06 ± 0,24 | 42,76 ± 0,24 | 45,89 ± 0,22 |
| MLP | 41,20 ± 0,24 | 43,89 ± 0,22 | 46,72 ± 0,14 |
| TempCNN | 41,94 ± 0,24 | 43,45 ± 0,22 | 45,41 ± 0,11 |
| Transformer — TimeSenCLIP | 42,02 ± 0,15 | 44,22 ± 0,16 | 47,35 ± 0,18 |
Transformer ilitoa matokeo ya juu zaidi kwa wastani wa jumla; hata hivyo, si bora bila mpinzani katika kila seli ya kazi. Kwa mfano, TempCNN katika Habitat descriptive prompt ilipata %33,37 na kuzidi %30,90 ya Transformer. Kwa hiyo chanzo hakidai kwamba “Transformer ndiyo usanifu bora kabisa katika kila kazi ndogo”.
Je, temporal dropout ilisaidia kweli?
| T | Temporal Drop | MS Drop | Land Cover | Land Use | Habitat | Bioregion | Crops | Wastani |
|---|---|---|---|---|---|---|---|---|
| 1 | Hapana | Hapana | 28,69 | 25,86 | 9,52 | 18,68 | 3,23 | 17,20 |
| 1 | Hapana | Ndiyo | 23,76 | 27,88 | 8,39 | 18,18 | 2,93 | 16,23 |
| 1 | Ndiyo | Hapana | 56,32 | 57,83 | 31,29 | 25,30 | 12,61 | 36,67 |
| 1 | Ndiyo | Ndiyo | 53,52 | 56,15 | 28,03 | 25,00 | 7,81 | 34,10 |
| 12 | Hapana | Hapana | 61,72 | 59,76 | 23,43 | 38,71 | 31,82 | 43,09 |
| 12 | Hapana | Ndiyo | 63,12 | 58,77 | 25,15 | 40,47 | 31,14 | 43,73 |
| 12 | Ndiyo | Hapana | 63,63 | 60,03 | 25,54 | 40,24 | 32,23 | 44,34 |
| 12 | Ndiyo | Ndiyo | 62,42 | 58,17 | 26,68 | 39,42 | 31,64 | 43,67 |
Katika ingizo la muda mmoja, temporal dropout iliongeza usahihi wa wastani kutoka %17,20 hadi %36,67. Katika ingizo kamili la miezi 12, mchango wake ulikuwa mdogo zaidi: kutoka %43,09 hadi %44,34. Tabia hii inaendana na tafsiri ya chanzo; temporal dropout huongeza uimara hasa dhidi ya uchunguzi wa muda uliokosekana au wenye kikomo.
Multispectral dropout kwa ujumla haikutoa faida ya kiwango kilekile. Chanzo kinahusisha hili na ukweli kwamba bendi zisizo za RGB hubeba taarifa muhimu ya spektri kwa kutofautisha mimea na ekosistimu.
Temporal dropout katika retrieval
Katika Appendix A.3, wastani wa retrieval wa muda mmoja \(T=1\) ulikuwa 0,219 bila temporal dropout na uliongezeka hadi 0,369 wakati temporal dropout ilipotumiwa. Katika ingizo la kila robo mwaka ongezeko lilipungua hadi 0,452 → 0,457, huku katika ingizo la kila mwezi wastani wa 0,516 bila temporal dropout ukiendelea kuwa juu zaidi. Kwa hiyo faida kubwa zaidi ya regularizer iko katika hali ambayo taarifa ya muda ni pungufu.
Je, picha nne za ardhini zinahitajika?
Appendix A.4 ililinganisha kuunganisha picha za ardhini za pande nne kwa average pooling na kutumia picha moja ya ardhini iliyochaguliwa kwa nasibu. Usahihi wa jumla wa zero-shot Top-1 ulikuwa %41,30 kwa average pooling na %41,24 kwa single image. Tofauti ni ndogo sana. Chanzo kinatafsiri hili kama dalili kwamba katika baadhi ya matumizi, picha moja wakilishi ya ardhini inaweza kupunguza mahitaji ya ukusanyaji wa data na hesabu.
Ufanisi wa hesabu
| Modeli | FLOPs / GMac | Parameter (M) | Throughput (sampuli/s) | Peak Memory (MB) |
|---|---|---|---|---|
| CLIP | 4,46 | 151,28 | 565,33 | 3045,13 |
| TimeSenCLIP 1×1 | 0,105 | 8,17 | 19.530,50 | 584,60 |
| TimeSenCLIP 5×5 | 0,106 | 8,29 | 19.424,24 | 596,32 |
| TimeSenCLIP 9×9 | 0,110 | 8,58 | 19.428,41 | 624,08 |
| TimeSenCLIP 16×16 | 0,121 | 9,48 | 17.798,35 | 709,12 |
Kulingana na hesabu za waandishi, 1×1 TimeSenCLIP hupunguza FLOPs kwa takriban %97–98 na idadi ya parameter kwa takriban %94 ikilinganishwa na CLIP ya kawaida, na kutoa kasi ya throughput zaidi ya mara 33. Vipimo hivi ni vya mpangilio wa vifaa na batch-size wa utafiti wenyewe; namba zilezile hazihakikishwi katika GPU au mazingira tofauti ya deployment.
Prediction map zinaonyesha nini?
Figure 4 na 5 za chanzo huunda LULC na crop prediction map kwa kutumia mfululizo wa muda wa Sentinel-2 wa kila mwezi kwa kila pikseli kwa kujitegemea. Kwa kuwa LUCAS hutoa lebo ya ground-truth kwa pointi ya katikati tu, ramani hizi hazijathibitishwa kwa segmentation ground truth kamili ya kiwango cha pikseli.
Ingawa maeneo makubwa yanaonekana kuwa na ulinganifu wa semantiki kwenye ramani, kuna mabadiliko ya ndani ya madarasa ya “salt-and-pepper” kati ya pikseli jirani. Chanzo kinaeleza sababu kuwa modeli huainisha kila pikseli kwa kujitegemea na spatial smoothing post-processing haitumiki.
Confusion matrix katika Figure A.4 ya chanzo pia zinaonyesha kwamba sehemu muhimu ya makosa hukusanyika kati ya madarasa yanayofanana kisemantiki au kimuundo. Kwa mfano, katika madarasa ya crop, nafaka zilizo karibu kifeno kama ngano na shayiri; katika Land Cover, shrubland na woodland; na katika habitat, grassland na madarasa ya kilimo yenye miundo inayofanana ya uoto yanaweza kuchanganywa.
Matokeo yanayoungwa mkono moja kwa moja na utafiti
- Mabadiliko ya multispectral na muda ya Sentinel-2 ni chanzo imara cha uwakilishi kwa kazi za zero-shot za remote sensing.
- TimeSenCLIP-P1-MS ya miezi 12 na pikseli moja ilitoa matokeo ya juu zaidi katika uainishaji wa jumla wa zero-shot kuliko modeli za CLIP zilizolinganishwa.
- Temporal depth ilitoa mchango mkubwa hasa katika madarasa yanayotegemea fenolojia kama mazao na bioregion.
- Bendi za multispectral zilitoa taarifa ya ziada kuliko RGB hasa katika kazi za Land Cover na Crops.
- Mchango wa muktadha wa anga unategemea kazi; patch pana zaidi inaweza kuwa na manufaa katika Habitat, Land Cover/Use na scenicness.
- Temporal dropout iliongeza kwa kiasi kikubwa uimara hasa katika uchunguzi uliokosekana au wa muda mmoja.
- Usanifu wa pikseli moja ulifanya kazi kwa gharama ndogo sana ya hesabu na kumbukumbu kuliko encoder kubwa zinazotegemea CLIP.
- Matokeo ya Ground-to-Satellite na Satellite-to-Ground retrieval yanaonyesha kwamba embedding za mfululizo wa muda zinaweza kulinganishwa kwa maana na semantiki ya picha za ardhini.
Ujumlishaji na vikwazo ambavyo utafiti hauungi mkono
- Modeli imetathminiwa tu katika muktadha wa Sentinel-2 na Umoja wa Ulaya/LUCAS; utendaji uleule haujathibitishwa katika mabara, hali za hewa na sensor nyingine.
- Pikseli moja haichukui nafasi ya patch kubwa katika kazi zote.
- Katika matatizo yanayohitaji muundo wa anga kama habitat na scenicness, muktadha mpana unaendelea kuwa muhimu.
- Prediction map hazijatathminiwa kwa segmentation ground truth kamili; LUCAS ground truth hutoa pointi ya sampuli ya katikati pekee.
- Kwa kuwa nafasi ya semantiki ya CLIP yenyewe ilijifunza kutoka picha na caption za mtandaoni, baadhi ya sifa zinazoonekana tu kwa muda huenda zisiwe katika ground-image embedding.
- Matumizi ya sensor tofauti, hasa mchanganyiko wa multisensor kama Sentinel-1 + Sentinel-2, hayajathibitishwa katika utafiti huu.
- Mafunzo kwa vyanzo vya picha za ground-level za kiwango cha dunia ni mwelekeo wa utafiti wa baadaye.
- Katika kazi za madarasa mengi zilizo karibu kisemantiki kama mazao na habitat, bado kuna pengo dhahiri la utendaji kati ya supervised upper bound na modeli ya zero-shot.
Utafiti wa baadaye
Waandishi wanatambua kupanua TimeSenCLIP kwa sensor nyingine na maeneo tofauti ya hali ya hewa/fenolojia, kutumia kwa pamoja sensor nyingi kama Sentinel-1 na Sentinel-2, na kuongeza makusanyo mapana ya picha za ardhini kutoka maeneo ya kijiografia nje ya Ulaya katika mchakato wa mafunzo kama mielekeo muhimu ya baadaye.
Chanzo pia kinaeleza kwamba uwakilishi wa picha za ardhini wa CLIP huenda usijumuishe baadhi ya sifa za mazingira zinazoweza kuonekana kwa muda, na kinapendekeza kwamba pengo hili linaweza kujazwa na vyanzo vya ziada vya semantiki kama maelezo ya maandishi yanayohusishwa na eneo la kijiografia.
Maelezo ya Chanzo na Mbinu
Kichwa asili: TimeSenCLIP: A time series vision–language model for remote sensing
Waandishi: Pallavi Jain; Diego Marcos; Dino Ienco; Roberto Interdonato; Tristan Berchoux.
Mwandishi anayewasiliana: Pallavi Jain.
Taasisi: Mediterranean Agronomic Institute of Montpellier – CIHEAM-IAMM; Inria; INRAE; Cirad; UMR TETIS; University of Montpellier, Ufaransa.
Jarida: ISPRS Journal of Photogrammetry and Remote Sensing.
Mchapishaji: Elsevier B.V., kwa niaba ya International Society for Photogrammetry and Remote Sensing (ISPRS).
Rekodi ya bibliografia: Volume 236 (2026), 99–119.
DOI: 10.1016/j.isprsjprs.2026.03.043
Kiungo rasmi: https://doi.org/10.1016/j.isprsjprs.2026.03.043
Uwasilishaji: 14 Agosti 2025. Marekebisho: 20 Februari 2026. Kukubaliwa: 26 Machi 2026. Tarehe ya jalada: Juni 2026.
Aina ya chanzo: Makala ya utafiti wa majaribio ya machine learning / remote sensing iliyopitiwa na wataalamu.
Leseni: Creative Commons Attribution 4.0 (CC BY 4.0).
Data na msimbo: Makala hutumia vyanzo vilivyopo vya data kama LUCAS, Sen4Map, EUNIS/EEA na ScenicOrNot. Muhtasari wa chanzo unaeleza kwamba msimbo wa TimeSenCLIP umechapishwa katika https://github.com/pallavijain-pj/TimeSenCLIP.
Ufadhili/msaada: Utafiti uliungwa mkono kupitia mradi “Giving Rural Actors Novel Data and Re-Usable Tools to Lead Public Action in Rural Areas” (GRANULAR) na European Union Horizon Europe Research and Innovation Programme, Grant Agreement No. 101061068; pia na mradi wa ANR OBTEA (ANR-22-CPJ1-0054-01) na University of Montpellier I-SITE Excellence Program / Investissements France 2030.
Mgongano wa maslahi: Waandishi waliripoti kwamba hakuna maslahi ya kifedha yanayoshindana au mahusiano binafsi yanayojulikana ambayo yangeweza kuathiri utafiti.
Tamko la uandishi unaosaidiwa na AI: Waandishi walieleza kwamba walitumia LLM wakati wa kuandaa makala ili kuboresha muundo wa sentensi na sarufi, kwamba waliipitia na kuihariri wenyewe maudhui ya mwisho, na kwamba wanawajibika kwa maudhui hayo.
Michango ya waandishi: Pallavi Jain: rasimu ya kwanza, mapitio/uhariri, uonyeshaji, uthibitishaji, metodolojia, utafiti, uchanganuzi rasmi, usimamizi wa data na uundaji wa dhana. Diego Marcos: mapitio/uhariri, usimamizi, rasilimali, metodolojia, upatikanaji wa ufadhili na uundaji wa dhana. Dino Ienco: mapitio/uhariri, usimamizi na rasilimali. Roberto Interdonato: mapitio/uhariri, usimamizi na rasilimali. Tristan Berchoux: mapitio/uhariri, usimamizi, rasilimali, usimamizi wa mradi na upatikanaji wa ufadhili.
Dokezo la kuripoti ndani ya chanzo 1: Muhtasari mkuu wa mbinu unasema embedding za ground-level image za pande nyingi zinaunganishwa kwa attention pooling, ilhali maelezo ya kina ya usanifu na Appendix A.4.3 hutumia average pooling. Chanzo hakipatanishi kauli hizi mbili kando.
Dokezo la kuripoti ndani ya chanzo 2: Maelezo ya Dataset yanasema Level-1 ina 38 specific crop type, ilhali Jedwali 2 linaripoti “Crops — 40 classes”. Verianla haijaunganisha namba hizo mbili kimya kimya.
Kizuizi kikuu cha kimetodolojia: Uwezo wa ujumlishaji wa TimeSenCLIP ulioripotiwa unahusu mazingira ya tathmini ya Sentinel-2 na LUCAS/Sen4Map yanayolenga Ulaya. Uhamisho wa cross-domain kwenda sensor, bara, hali ya hewa na mifumo mingine ya fenolojia haujathibitishwa moja kwa moja katika utafiti huu.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *