


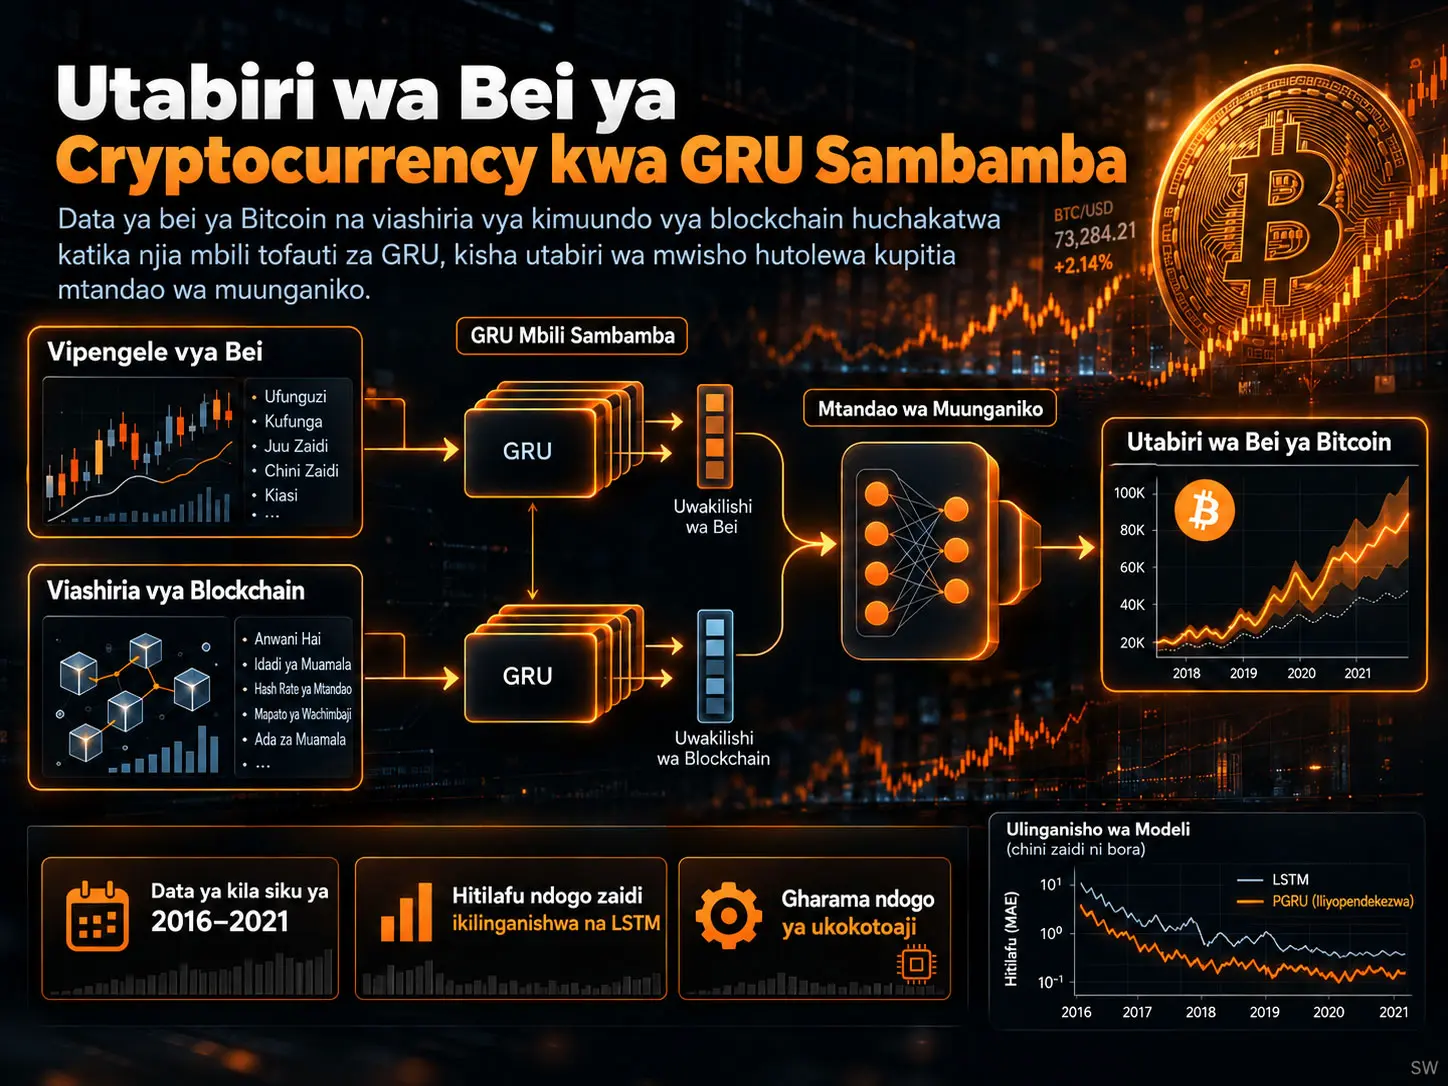
Parallel Gated Recurrent Units (PGRU) ni usanifu sambamba wa deep learning unaochakata vipengele vya bei ya Bitcoin na vipengele vya kimuundo vya blockchain katika mitandao miwili huru ya GRU, kisha kuunganisha utabiri wa mitandao hiyo miwili katika mtandao wa tatu wa feedforward. Katika utafiti, bei ya wastani ya kila siku, bei ya ufunguzi, bei ya chini na bei ya juu zilipelekwa kwenye tawi la kwanza la data; wastani wa ukubwa wa block, hash rate, difficulty, idadi ya miamala ya kila siku na mapato ya miner zilipelekwa kwenye tawi la pili la data. Kwa kutumia uchunguzi 1.859 wa kila siku katika kipindi cha 1 Januari 2016–31 Januari 2021, lengo lilikuwa kutabiri bei inayofuata ya Bitcoin kwa njia ya regression.
Modeli ilitathminiwa kwa sliding windows za siku \(w=5,10,15,20,25\) zinazobainisha urefu wa uchunguzi wa zamani. Kulingana na Jedwali 2 la chanzo, thamani ya chini zaidi ya MAPE iliyoripotiwa kwa PGRU ni %2,0 kwa \(w=5\). Thamani zilizosisitizwa hasa katika muhtasari wa chanzo ni %2,641 kwa \(w=15\) na %3,243 kwa \(w=20\). Mbadala sambamba wa LSTM ulioundwa katika mpangilio huo huo wa majaribio ulitoa MSE, RMSE, MAE na MAPE za juu zaidi katika urefu wote wa windows uliochunguzwa.
Matokeo ya utafiti yanaonyesha regression performance ya modeli ya utabiri wa bei ya Bitcoin kwenye data ya kihistoria. Matokeo hayamaanishi faida ya live trading, return on investment, transaction costs au generalizability iliyothibitishwa katika cryptocurrencies nyingine. Aidha, muundo wa muda wa 10-fold cross-validation uliotumika kwa time series, kama statistics za z-score zilihesabiwa kutoka training data pekee, na njia kamili ya kuzalisha utabiri wa siku 10 hazijaelezwa kwa undani wa kutosha katika chanzo.
PGRU ni Nini na Inatofautianaje na Modeli ya GRU yenye Mtiririko Mmoja?
Parallel Gated Recurrent Units (PGRU) ni usanifu wa regression wenye mitiririko mingi unaochakata data ya bei na data ya kimuundo ya mtandao wa Bitcoin kwa kujitegemea katika modeli mbili tofauti za recurrent, badala ya kupeleka vipengele vyote kwenye mtandao mmoja wa GRU, na kisha kubadilisha utabiri wa modeli hizo mbili kuwa utabiri mmoja wa bei kupitia mtandao wa mwisho wa feedforward fusion.
Tatizo kuu la utafiti
Bei ya Bitcoin si time series inayojumuisha viwango vya bei vya zamani pekee. Mtandao wa Bitcoin pia una variables zake za ndani za kimuundo kama uzalishaji wa block, nguvu ya hash, difficulty, shughuli za miamala na mapato ya miner. Wazo kuu la utafiti ni kuiga tabia ya zamani ya bei na hali ya mtandao wa blockchain katika matawi mawili tofauti ya wataalamu badala ya kuvichanganya katika input matrix moja.
Tawi la kwanza la GRU hujifunza tabia ya bei. Tawi la pili la GRU hujifunza tabia ya blockchain na mtandao. Matawi yote mawili hujaribu kutabiri lengo lile lile, yaani bei inayofuata ya Bitcoin. Kisha mtandao wa tatu huunganisha utabiri huo kupitia feedforward transformation iliyojifunzwa wakati wa training, badala ya kuamua kwa mkono kwa coefficient iliyowekwa mapema ni utabiri upi uaminiwe kwa kiwango gani.
Pengo katika fasihi
Chanzo kinaeleza kuwa tafiti za awali zilitumia vyanzo vya data kama price series, blockchain features, mitandao ya kijamii au search trends; hata hivyo, taarifa hizi kwa kawaida zilichakatwa katika miundo yenye mtiririko mmoja. Muundo unaotofautisha PGRU ni kutenganisha data ya bei na data ya kimuundo kwenda kwa recurrent experts huru na kuziunganisha katika kiwango cha utabiri.
Hypothesis ya kisayansi ya mbinu hii haijatolewa wazi katika muundo rasmi wa “H1”. Hata hivyo, muundo wa majaribio unajaribu wazo kwamba matawi mawili ya data yanayokamilishana yanaweza kutoa utabiri bora kuliko recurrent flows zinazotumiwa peke yake.
Vipengele vya Kimuundo vya Blockchain ya Bitcoin Vinaongezwaje kwenye Utabiri wa Bei?
Katika utafiti, taarifa za kimuundo za blockchain hazipelekwi moja kwa moja kwenye GRU moja kama kundi la ziada la columns lililounganishwa na price series; wastani wa ukubwa wa block, hash rate, difficulty, jumla ya miamala ya kila siku na mapato ya miner huunda time series tofauti yenye vipengele vitano, na series hii huchakatwa kwa kujitegemea na tawi la pili la GRU.
Tawi la data ya bei
| Kipengele cha bei | Jukumu la kisayansi |
|---|---|
| Bei ya wastani ya kila siku | Inawakilisha kiwango cha jumla cha bei cha siku. |
| Bei ya ufunguzi | Inatoa kiwango cha bei mwanzoni mwa siku. |
| Bei ya chini | Inawakilisha kiwango cha chini cha bei ndani ya siku. |
| Bei ya juu | Inawakilisha kiwango cha juu cha bei ndani ya siku. |
Tawi la data ya kimuundo ya blockchain
| Kipengele cha kimuundo | Ufafanuzi wa chanzo |
|---|---|
| Average Block Size | Wastani wa ukubwa wa block kwa saa 24; hutolewa kwa MB. |
| Hash Rate | Kiasi kinachokadiriwa cha terahash kwa sekunde. |
| Difficulty | Kiwango cha kulinganisha cha ugumu wa kupata block mpya. |
| Total Transactions | Jumla ya idadi ya miamala ya kila siku. |
| Miner Revenue | Jumla ya thamani ya Coinbase rewards na transaction fees. |
Data sets zote mbili zina uchunguzi 1.859 wa kila siku na zinahusu kipindi kati ya 1 Januari 2016 na 31 Januari 2021.
Kwa Nini Z-Score Normalization Ilitumiwa katika Utafiti Huu?
Z-score normalization ilitumika kwa sababu vipengele vya bei na blockchain viko kwenye numerical scales tofauti sana; kila value huwekwa katikati kulingana na mean ya variable yake na kuscale kulingana na standard deviation yake. Chanzo kinahoji kuwa mchakato huu huhifadhi vizuri zaidi tofauti ya kulinganisha kati ya values kubwa na ndogo kuliko min–max scaling.
Tatizo la scale
Kulingana na chanzo, maximum ya average price katika price dataset ni karibu mara 95 ya minimum, huku maximum ya variable ya difficulty ikiwa karibu mara 185 ya minimum. Kuingiza magnitudes tofauti kiasi hiki moja kwa moja kwenye neural network kunaweza kufanya optimization kuwa ngumu.
Transformation iliyotumiwa na chanzo ni:
\[ z=\frac{x-\mu}{\sigma} \]
.
Hapa \(x\) inawakilisha raw observation value, \(\mu\) mean ya variable husika, na \(\sigma\) standard deviation. Baada ya transformation, variable huwekwa katikati karibu na sifuri na standard deviation huwa scale unit.
Katika sehemu ya discussion, chanzo kinaeleza kuwa z-score normalization ilitoa ongezeko la accuracy la takriban 5–7 percentage points ikilinganishwa na simple min–max scaling. Hata hivyo, kwa kuwa hakuna experiment iliyotolewa katika results section inayoonyesha comparison hii kwa separate ablation table, value hii inapaswa kuchukuliwa kama taarifa ya waandishi katika discussion section.
Kuunda input na target kwa sliding window
Normalized price data sequence imefafanuliwa kama \(X\), na structural data sequence kama \(Y\). Urefu wa zote mbili ni:
\[ n=1859 \]
siku.
Kwa window ya siku \(w\), chanzo kinatoa inputs kwa dhana kama:
\[ Input_1^{(i)} = [X_i,X_{i+1},...,X_{i+w-1}] \]
\[ Input_2^{(i)} = [Y_i,Y_{i+1},...,Y_{i+w-1}] \]
na target kama:
\[ Output^{(i)}=X_{i+w} \]
.
Kwa mfano, ikiwa \(w=15\), modeli hutumia data ya bei na data ya kimuundo ya blockchain ya siku 15 zilizopita kutabiri bei ya siku inayofuata.
Mitandao mitatu ya usanifu wa PGRU
Kielelezo 2 kwenye ukurasa 13 kinaonyesha matawi mawili huru ya recurrent na mtandao wa tatu unaoyaunganisha. Ukubwa wa layers unaoonyeshwa katika figure ya chanzo unaweza kufupishwa kama ifuatavyo:
| Mtandao | Ingizo | Muundo unaoonyeshwa kwenye figure ya chanzo | Matokeo |
|---|---|---|---|
| Tawi la GRU 1 | Vipengele vya bei | GRU 120 → Fully Connected 70 → Fully Connected 4 | Utabiri mmoja wa bei |
| Tawi la GRU 2 | Vipengele vya kimuundo vya blockchain | GRU 112 → Fully Connected 70 → Fully Connected 50 → Fully Connected 4 | Utabiri mmoja wa bei |
| Fusion network | Utabiri mbili za GRU | Hidden 13 → Hidden 16 → Hidden 13 | Utabiri wa mwisho wa bei |
Matawi yote mawili ya GRU yalifundishwa kwa kutumia Adam optimizer ili kupunguza regression loss. Fusion network hutumia Levenberg–Marquardt optimization. Implementation ilifanywa ndani ya MATLAB R2020b.
Usanifu wa kulinganisha wa LSTM
Kama controlled baseline, matawi mawili ya GRU yalibadilishwa na LSTM layers. Data flow haibadiliki: data ya bei na data ya kimuundo huingia kwenye recurrent branches mbili tofauti na utabiri mbili huunganishwa na aina ileile ya feedforward fusion network.
Kielelezo 3 kwenye ukurasa 14 kinaonyesha kwamba katika mbadala wa LSTM, tawi la kwanza lina LSTM 120, Dropout 0,2, Fully Connected 70 na Fully Connected 4; tawi la pili lina LSTM 112, Dropout 0,2, Fully Connected 70, 50 na 4. Fusion network bado ina hidden-layer structure ya 13–16–13.
Mpangilio wa Cross-validation
Chanzo kinaeleza kuwa 10-fold cross-validation ilitumika kwa mitandao yote mitatu na kwamba katika window sensitivity experiments modeli ilifundishwa kwa 200 epoch.
Hata hivyo, haijaelezwa jinsi chronological structure ya time series ilivyohifadhiwa katika folds. Chanzo hakielezi kama ordinary random k-fold, blocked cross-validation au forward-chaining ilitumika. Katika financial time series, detail hii ni muhimu; kwa sababu statistics za future period zikivuja kwenda kwenye training fold ya zamani zinaweza kupunguza evaluation error kwa njia ya bandia.
Vilevile, haijulikani kama values za \(\mu\) na \(\sigma\) zilizotumika kwa z-score zilihesabiwa kwenye kila training fold pekee au kutoka observations zote 1.859. Kwa hiyo haiwezi kuthibitishwa kutoka kwenye report ya chanzo kwamba data leakage ilizuiwa kikamilifu.
Metrics za tathmini
Chanzo hutumia metrics nne za regression.
Mean Squared Error:
\[ MSE= \frac{1}{N} \sum_{i=1}^{N} (R_i-\hat R_i)^2 \]
Huadhibu errors kubwa kwa uzito mkubwa zaidi kwa kuziweka square.
Root Mean Squared Error:
\[ RMSE=\sqrt{MSE} \]
Hurejesha scale ya error kwenye unit ya bei.
Mean Absolute Error:
\[ MAE= \frac{1}{N} \sum_{i=1}^{N} |R_i-\hat R_i| \]
Hupima wastani wa absolute price difference.
Equation (4) iliyochapishwa kama MAPE katika chanzo:
\[ MAPE= \frac{100}{N} \sum_{i=1}^{N} \frac{R_i-\hat R_i}{R_i} \]
Kuna source-internal inconsistency muhimu hapa. Ingawa metric inaitwa “Mean Absolute Percentage Error”, absolute value signs hazionekani kwenye error ya numerator katika Equation (4) iliyochapishwa. Kwa upande mwingine, tables za 10-day forecast hutumia “Abs. Perc. Error”. Kwa hiyo Verianla inaonyesha formula kama ilivyo katika chanzo na kuhifadhi tofauti hii wazi.
Mbinu na Matokeo ya Utafiti
Thamani ya Chini Zaidi ya MAPE ya PGRU Iliyoripotiwa Iko kwenye Urefu Gani wa Window?
Thamani ya chini zaidi ya PGRU MAPE katika Jedwali 2 la chanzo ni %2,0 kwa \(w=5\); muhtasari na sehemu ya matokeo ya utafiti zinasisitiza hasa takriban %2,64 kwa \(w=15\) na takriban %3,24 kwa \(w=20\).
Window length sensitivity
| Window \(w\) | MSE | RMSE | MAE | MAPE |
|---|---|---|---|---|
| 5 | 49.334,9 | 222,1 | 120,2 | %2,0 |
| 10 | 50.941,0 | 225,7 | 127,2 | %2,6 |
| 15 | 54.575,6 | 233,6 | 136,0 | %2,6 |
| 20 | 61.648,1 | 248,3 | 143,3 | %3,2 |
| 25 | 63.330,9 | 251,7 | 165,4 | %3,9 |
Jedwali linaonyesha kwamba configuration ya \(w=5\) ilitoa value ya chini zaidi katika error metrics zote nne. Kutumia historical window ndefu zaidi hakukutoa prediction bora kiotomatiki katika experiment hii.
Matokeo haya ni muhimu dhidi ya dhana kwamba historical information zaidi huwa na manufaa kila wakati. Hata hivyo, utafiti haufanyi ablation au mechanism analysis kueleza kwa nini \(w=5\) ni bora.
Je, PGRU Ilitoa Matokeo Bora kuliko Usanifu Sambamba wa LSTM?
Ndiyo. Katika LSTM comparison iliyoundwa na chanzo kwa data structure ileile, PGRU ilitoa MSE, RMSE, MAE na MAPE za chini katika urefu wote wa window wa \(w=5,10,15,20,25\); pia ilionyesha execution time fupi katika measurements kwenye hardware ileile.
Ulinganisho wa matokeo ya error ya PGRU na LSTM
| \(w\) | PGRU MAPE | LSTM MAPE | PGRU RMSE | LSTM RMSE |
|---|---|---|---|---|
| 5 | %2,0 | %3,2 | 222,1 | 348,1 |
| 10 | %2,6 | %3,5 | 225,7 | 349,7 |
| 15 | %2,6 | %3,7 | 233,6 | 350,0 |
| 20 | %3,2 | %4,1 | 248,3 | 365,6 |
| 25 | %3,9 | %4,2 | 251,7 | 382,2 |
Katika full error table ya LSTM, MSE na MAE values pia ni za juu kuliko PGRU. Kwa hiyo, ndani ya controlled comparison ya utafiti wenyewe, superiority ya PGRU haitegemei MAPE metric pekee.
Muda wa utekelezaji
| Window | GRU-based | LSTM-based |
|---|---|---|
| \(w=5\) | 10:58 | 12:51 |
| \(w=10\) | 11:37 | 13:29 |
| \(w=15\) | 12:18 | 14:27 |
| \(w=20\) | 12:56 | 15:03 |
| \(w=25\) | 13:43 | 15:49 |
Muda uliripotiwa kama wastani wa runs tatu kwenye mfumo uliotumia Intel Core i7-6700HQ CPU na NVIDIA GTX 960 GPU. Usanifu wa GRU una execution time fupi kuliko mbadala wa LSTM katika urefu wote wa windows.
Utabiri wa siku 10 wa PGRU na LSTM
| Siku | Bei halisi | Utabiri wa PGRU | PGRU absolute % error | Utabiri wa LSTM | LSTM absolute % error |
|---|---|---|---|---|---|
| 1 | 33.515,7 | 33.174,3 | %1,02 | 32.756,6 | %2,26 |
| 2 | 35.485,2 | 35.913,2 | %1,21 | 36.062,5 | %1,62 |
| 3 | 37.646,8 | 37.837,7 | %0,51 | 38.116,5 | %1,24 |
| 4 | 36.982,1 | 39.913,6 | %7,93 | 38.502,0 | %4,11 |
| 5 | 38.297,6 | 37.145,8 | %3,01 | 37.314,4 | %2,56 |
| 6 | 39.256,6 | 36.810,9 | %6,23 | 36.746,4 | %6,39 |
| 7 | 38.852,9 | 37.646,1 | %3,11 | 36.651,5 | %5,66 |
| 8 | 46.395,7 | 43.232,2 | %6,82 | 39.437,6 | %14,99 |
| 9 | 46.508,6 | 42.189,7 | %9,29 | 39.265,4 | %15,57 |
| 10 | 44.836,0 | 40.245,3 | %10,24 | 37.784,1 | %15,72 |
PGRU ilitoa absolute percentage error ya %0,51–%1,21 katika siku tatu za kwanza, lakini error inaongezeka wazi katika siku za baadaye zenye movement kubwa. Siku ya kumi, absolute percentage error ya PGRU inafikia %10,24, huku ya LSTM ikifikia %15,72.
Jedwali hili halimaanishi kwamba PGRU ni bora kuliko LSTM kila siku. Kwa mfano, katika siku ya nne na ya tano, absolute percentage error ya LSTM ni ya chini kuliko ya PGRU. Kwa upande mwingine, hasa katika siku 8–10, PGRU inatoa error ya chini.
Tatizo la reproducibility katika jaribio la siku 10
Katika sehemu ya methods, modeli imefafanuliwa kama single-step structure inayotabiri siku inayofuata. Hata hivyo, wakati chanzo kinazalisha horizon ya siku 10 hakielezi:
- kama prediction ya kwanza ilitumika kama input ya siku inayofuata,
- kama bei mpya halisi zilirejeshwa kwenye modeli katika kila hatua,
- kama outputs 10 zilizalishwa kwa mara moja
. Kwa hiyo, full inference procedure ya 10-day performance haiwezi kujengwa upya kutoka kwenye source text.
Aidha, dataset katika methods section inaisha 31 Januari 2021, lakini Section 5.2 inatumia kauli “January 2016 to December 2021”. Kwa kuwa figure na actual price series zinalingana na Februari 2021, kauli hii ya tarehe haiendani na taarifa nyingine za wakati ndani ya chanzo.
Kielelezo 4 na Kielelezo 5 vinaonyesha nini?
Kielelezo 4 kwenye ukurasa 15 kinaonyesha actual Bitcoin price na PGRU prediction kwenye time axis ileile kwa kipindi cha 1 Novemba 2020–31 Januari 2021 kwa \(w=15\). Curves mbili kwa kiasi kikubwa zinasogea pamoja katika trend ya jumla; Kielelezo 5 kinaonyesha prediction–actual differences za kipindi hicho karibu na zero axis.
Visual alignment hii inaunga mkono kwamba modeli iliweza kufuatilia price pattern ya kipindi hicho cha kihistoria. Hata hivyo, graph peke yake haithibitishi kwamba error ileile itadumishwa katika market regimes tofauti za baadaye.
Tofauti kati ya Kielelezo 6 na Kielelezo 9
Kielelezo 6 kwenye ukurasa 16 kinaonyesha 10-day forecast ya PGRU, huku Kielelezo 9 kwenye ukurasa 17 kikionyesha mbadala wa LSTM. Hasa katika ongezeko kali la bei karibu na 8–10 Februari 2021, modeli zote mbili hubaki chini ya actual price; hata hivyo, deviation ya LSTM ni kubwa zaidi.
Kipindi hiki kinaonyesha kuwa pamoja na average error metric, inapaswa kuchunguzwa pia jinsi modeli inavyoweza kufanya kazi wakati wa rapid regime changes.
MAPE comparison na tafiti za awali iliyotolewa katika chanzo
| Mbinu | MAPE iliyotolewa katika chanzo |
|---|---|
| PGRU — utafiti huu | %3,24 (\(w=20\)); %2,64 (\(w=15\)) |
| Roy na wenzake | %9,69 |
| Hitam na wenzake — PSO-SVM | %9,6 |
| Garg na wenzake — ARIMA | <%6 |
| Rizwan na wenzake — GRU | %5,3 |
| Ji na wenzake — LSTM | %4,46 (\(w=20\)) |
| Patel na wenzake — Litecoin GRU | %4,94 |
Chanzo kinawasilisha jedwali hili kama ishara kwamba PGRU imetoa MAPE ya chini kuliko approaches za awali. Hata hivyo, methods hazikuendeshwa upya chini ya kipindi kilekile cha Bitcoin data, training/test split ileile na data preprocessing ileile. Target asset ya utafiti wa Patel pia ni Litecoin. Kwa hiyo jedwali si controlled head-to-head benchmark, bali ni comparison ya literature-level ya published results.
Hitimisho zinazoungwa mkono na utafiti
- Katika Bitcoin dataset iliyochunguzwa, usanifu wa PGRU unaounganisha matawi mawili sambamba ya GRU kwa fusion network uliweza kutekelezwa.
- Katika Jedwali 2 la chanzo, thamani ya chini zaidi ya PGRU MAPE ni %2,0 kwa \(w=5\).
- PGRU ilitoa error ya chini kuliko mbadala sambamba wa LSTM ulioundwa katika utafiti huohuo katika urefu wote wa windows uliochunguzwa.
- Muundo wa GRU-based ulionyesha execution time fupi kuliko mbadala wa LSTM kwenye hardware ileile.
- Kuchakata data ya bei na data ya kimuundo ya blockchain katika recurrent branches tofauti kuliunda fusion architecture inayofanya kazi katika experiment ya chanzo.
- Katika mfano wa siku 10, PGRU ilitoa error ya chini kuliko mbadala wa LSTM hasa katika siku za mwisho.
Hitimisho ambazo utafiti hauungi mkono
- Haijaonyeshwa kwamba PGRU itatoa profit katika live Bitcoin trading.
- Modeli haijatathmini transaction fee, slippage, spread, funding au portfolio risk.
- Haijaonyeshwa kwa majaribio kwamba modeli inafanya kazi kwa accuracy ileile kwenye cryptocurrencies nyingine.
- Haijaonyeshwa kwamba PGRU ni bora kuliko Transformer zote za kisasa au current 2025–2026 forecasting architectures.
- Comparison na tafiti za awali katika Table 7 haikufanywa chini ya common benchmark protocol.
- Haijathibitishwa katika chanzo kwamba 10-fold cross-validation imezuia time-series leakage kikamilifu.
- Faida ya 5–7 percentage points ya Z-score haijaonyeshwa kwa separate, visible normalization ablation table.
- Recursive, direct au rolling mechanism ya 10-day forecast haijaelezwa wazi.
Nguvu za utafiti
Muundo wa modeli unaeleweka na ni modular. Kutenganisha data ya bei na data ya kimuundo ya blockchain katika matawi tofauti huruhusu kila kundi la data kujifunza temporal dynamics zake. Kwa kuwa controlled LSTM alternative iliundwa ndani ya overall structure ileile, PGRU–LSTM comparison ina maana zaidi kuliko MAPE comparison inayotokana na articles tofauti.
Aidha, utafiti hautegemei error metric moja pekee; MSE, RMSE, MAE na MAPE zinaripotiwa pamoja. Urefu wa windows tano na execution-time results hutoa taarifa za ziada kuhusu uhusiano wa accuracy–computation wa modeli.
Mapungufu makuu ya kimethodolojia
Cross-validation detail: Haijaelezwa kama 10-fold structure ni chronological.
Normalization leakage detail: Haijaandikwa wazi kwamba Z-score statistics zilihesabiwa kutoka training data pekee.
10-day inference mechanism: Multi-step forecasting procedure haijaelezwa.
Date inconsistency: Data collection section inaisha 31 Januari 2021, huku Section 5.2 ikiandika kwamba data zilitumika hadi Desemba 2021.
MAPE equation: Equation (4) iliyochapishwa haionyeshi absolute value signs.
Statistical uncertainty: Standard deviation ya cross-validation means, confidence interval au multi random-seed distribution haijatolewa.
External generalization: Experimental target ni Bitcoin pekee.
Literature benchmark: Table 7 inaweka pamoja MAPE values zilizoripotiwa kutoka data na study protocols tofauti.
Mielekeo ya utafiti wa baadaye
Chanzo kinapendekeza kuongeza independent data branches mpya kwenye usanifu wa PGRU. Mifano ni global economic indicators, bei za cryptocurrencies nyingine kubwa na social-network sentiment/trend data.
Mapendekezo haya yametolewa na chanzo kama future work; data flows hizi hazikutumika katika experiments za sasa.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: Cryptocurrency Price Prediction Using Parallel Gated Recurrent Units
Waandishi: Milad Asadpour; Alireza Rezaee; Farshid Hajati.
Taasisi: College of Interdisciplinary Science and Technology, University of Tehran, Tehran, Iran; School of Science and Technology, University of New England, Armidale, NSW, Australia.
Aina ya chanzo: Preprint.
Jukwaa: arXiv / CoRR.
arXiv: 2512.22599v1 [cs.LG].
Tarehe ya kuwasilishwa arXiv: 27 Desemba 2025.
Tarehe iliyotolewa kwenye PDF: 30 Desemba 2025.
Hali ya peer review: Katika current bibliographic verification, separate peer-reviewed journal au conference version haikugunduliwa; utafiti umetathminiwa kama preprint.
Independent journal DOI: Haijathibitishwa.
Corresponding author: Source PDF haitoi alama tofauti ya corresponding-author.
Aina ya utafiti: Computational deep learning/regression experiment inayolenga bei ya Bitcoin.
Target variable: Bei ya baadaye ya Bitcoin.
Kipindi cha data: Katika main data definition 1 Januari 2016–31 Januari 2021.
Idadi ya observations: Records 1.859 za kila siku katika data streams zote mbili.
Price features: Bei ya wastani ya kila siku, bei ya ufunguzi, bei ya chini, bei ya juu.
Structural features: Wastani wa ukubwa wa block, hash rate, difficulty, jumla ya daily transactions, miner revenue.
Chanzo cha price data: Utafiti chanzo unarejelea historical Bitcoin data ya Investing.com.
Chanzo cha structural data: Utafiti chanzo unarejelea market/network charts source kwenye bitcoin.com.
Preprocessing: Z-score normalization.
Window lengths: Siku 5, 10, 15, 20 na 25.
Modeli: Parallel GRU predictor mbili + feedforward fusion network.
Controlled comparison: Parallel LSTM predictor mbili + overall fusion approach ileile.
Software: MATLAB R2020b.
GRU optimizer: Adam.
Fusion optimizer: Levenberg–Marquardt.
Training: 200 epoch katika window sensitivity experiment.
Cross-validation: 10-fold; time-series form ya folds haijaelezwa kwa undani katika chanzo.
Performance metrics: MSE, RMSE, MAE na percentage error metric iliyoitwa MAPE na chanzo.
Hardware: Intel Core i7-6700HQ CPU na NVIDIA GTX 960 GPU; execution-time results ni wastani wa runs tatu.
Funding: Hakuna separate funding statement iliyogunduliwa katika PDF iliyotolewa.
Conflict of interest: Hakuna separate conflict-of-interest declaration iliyogunduliwa katika PDF iliyotolewa.
Data availability: Hakuna separate Data Availability Statement; data sources zimeelezwa kama web sources katika methods section.
Code availability: Hakuna verifiable public code repository iliyotajwa katika PDF iliyotolewa.
Author contributions: Hakuna separate CRediT author-contribution statement.
License: Kwa kuwa aina ya open license inayoweza kuthibitishwa kwa kuaminika kwa reuse haikugunduliwa katika PDF iliyochunguzwa na official arXiv view iliyothibitishwa, fail-closed approach ilitumika. Source figures hazipaswi kunakiliwa moja kwa moja; scientific relationships na table values zinapaswa kuchorwa upya kwa kujitegemea kwa Verianla.
Source-internal numeric note: Muhtasari unasitiza MAPE ya %3,243 na %2,641 kwa \(w=20\) na \(w=15\) mtawalia, huku Jedwali 2 likiripoti MAPE ya chini zaidi ya %2,0 kwa \(w=5\).
Source-internal date note: Main data section inatoa kipindi cha 2016-01-01–2021-01-31, huku Section 5.2 ikitumia kauli January 2016–December 2021 kwa 10-day experiment. Graph na actual price series za experiment hiyo zinaendana na Februari 2021.
Source-internal formula note: Ingawa Equation (4) imewekewa label ya MAPE, absolute value sign haionekani kuzunguka error term katika printed expression; Table 3 na Table 5 zinaripoti absolute percentage error.
Mpaka mkuu wa tafsiri: Matokeo ni model-error performance kwenye historical Bitcoin data. Hayapaswi kutafsiriwa kama live-market profitability, investment advice, transaction costs au validated performance katika cryptocurrencies nyingine.
Hakimiliki/mbinu ya uwasilishaji: Maandishi ya Verianla hayarudii sentence au paragraph order ya source study. Data, model structure, formulas, tables, figures, results na limitations zilizotolewa katika chanzo zimegawanywa kuwa scientific inventory na kujengwa upya ndani ya independent educational Kiswahili structure.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *