


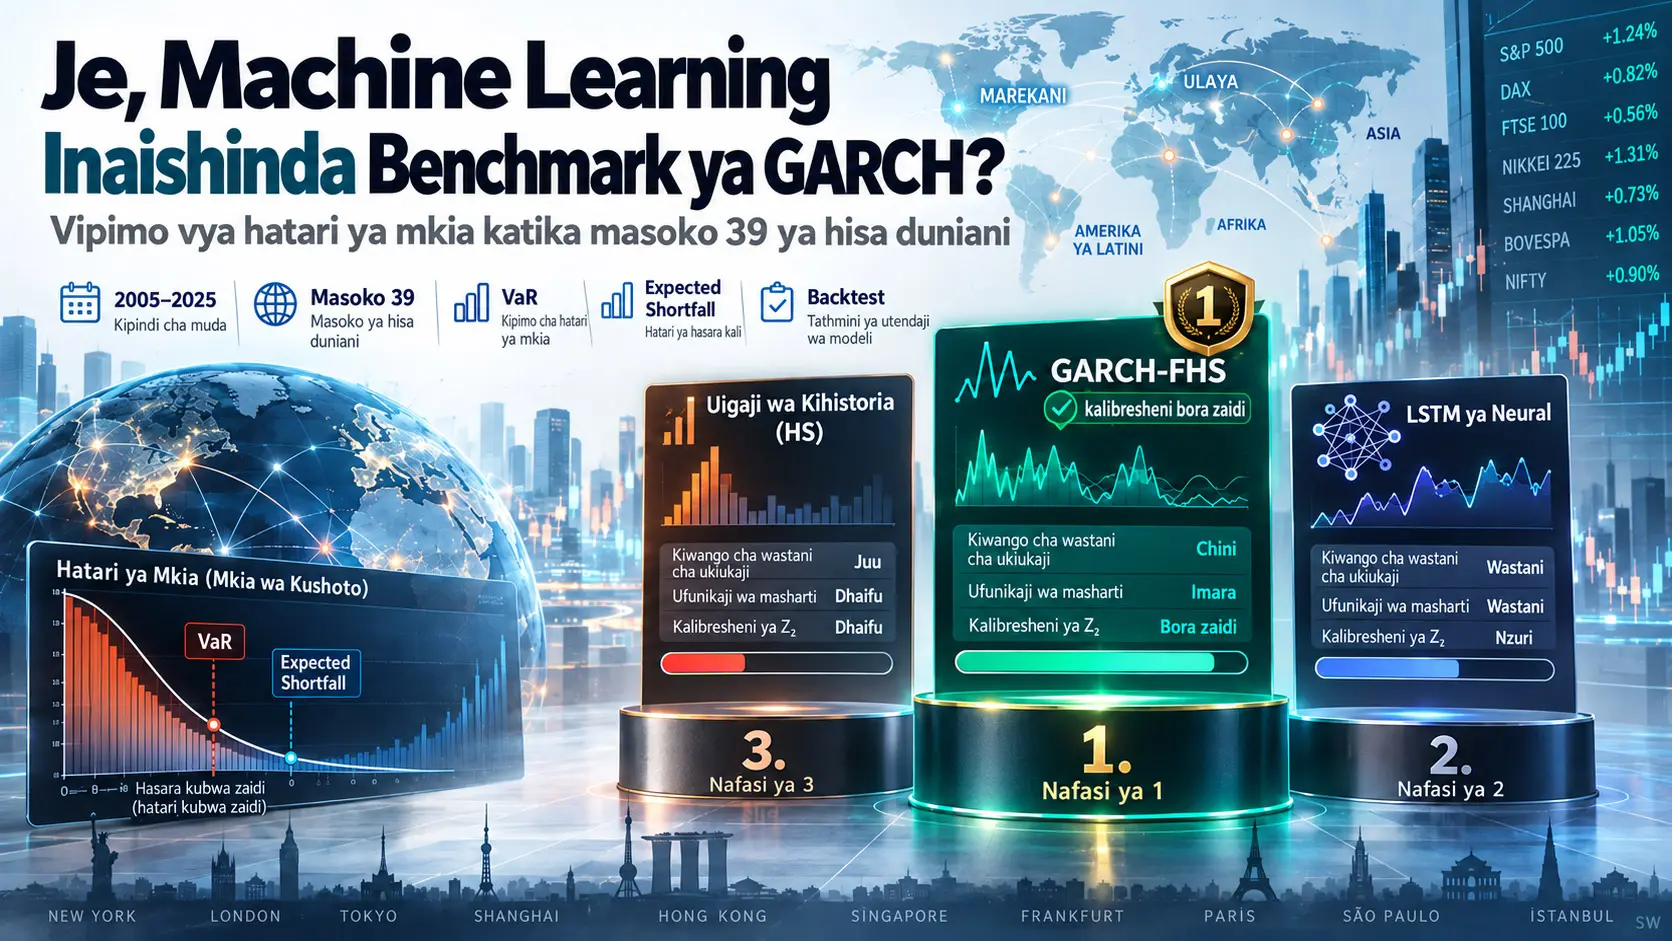
Uigaji wa Kihistoria Uliochujwa (Filtered Historical Simulation, FHS), ni mbinu ya masharti ya hatari ya soko inayochuja volatility ya masharti ya returns kwa GARCH(1,1), kisha huzalisha Value-at-Risk (VaR) na Expected Shortfall (ES) kutoka kwenye usambazaji wa mkia wa mabaki ya kiempiria yaliyosanifishwa. Amjad na Ahmed walilinganisha FHS na rolling Historical Simulation (HS) ya siku 250 pamoja na LSTM ya quantile nyingi inayojifunza quantile za masharti za %1, %2,5, %5 na %10 kutokana na returns za siku 40 zilizopita, kwenye msingi uleule wa strictly out-of-sample. Sampuli ya pamoja ya backtest inahusisha masoko 39 ya hisa yaliyoendelea, yanayoibukia na frontier katika kipindi cha 2005–2025, pamoja na jumla ya uchunguzi 192.789 wa market-day. Ingawa LSTM ndogo iliyojaribiwa ilifanya vizuri kuliko uigaji wa kihistoria, haikuweza kuishinda benchmark ya GARCH(1,1)-FHS.
Kwa lengo la 5% VaR, HS ilikuwa na kiwango cha wastani cha ukiukaji cha %5,61; ingawa ilipita jaribio la Kupiec katika masoko 21/39, haikupita majaribio ya Christoffersen independence na conditional-coverage katika soko lolote. FHS ndiyo familia iliyokuwa karibu zaidi na lengo kwa kiwango cha wastani cha ukiukaji cha %4,92; ilipita Kupiec katika 33/39, independence katika 15/39 na conditional coverage katika 19/39 ya masoko. Kiwango cha wastani cha ukiukaji cha LSTM yenye units 16 ni %5,12; Kupiec ilipita katika 21/39, independence 7/39 na conditional coverage katika masoko 4/39 pekee.
Tofauti ni kubwa zaidi katika matokeo ya Expected shortfall. Katika takwimu ya Acerbi–Székely \(Z_2\), thamani iliyo karibu na sifuri inaendana na calibration sahihi ya ES. FHS ilikuwa karibu sana na sifuri kwa wastani wa \(Z_2=-0.003\), huku HS ikiwa −0,205 na familia ya neural −0,195. Thamani hasi zinaendana na kukadiria chini ukali wa hasara za mkia zilizotokea. Hata hivyo, kwa sababu NCVaR ya neural ni wastani wa vipande wa quantile tatu, ulinganisho wake wa ES na FHS si wa moja kwa moja kabisa kwa upande wa darasa la estimator.
Mbinu ya neural ina faida nyingine: inaonekana kuwa less procyclical katika paneli ya kila mwaka ya makro. Katika subsample ya msingi ya EPU, ongezeko la asilimia-point moja katika ukuaji wa GDP hupunguza VaR ya kihistoria kwa takriban %4,3, VaR ya FHS kwa takriban %3,2 na VaR ya neural kwa takriban %1,5. Katika miaka ya migogoro, VaR ya kihistoria iliongezeka kwa takriban log point 0,72, FHS kwa 0,40 na VaR ya neural kwa 0,27. Kwa hiyo, chanzo kinajadili kuwa kipimo cha neural kinaweza kuwa ishara ya cross-check inayokamilisha FHS, badala ya kuibadilisha, huku kikiwa polepole zaidi na kisichohisi sana mzunguko.
Hitimisho si hukumu ya jumla kuhusu mbinu zote za machine learning. LSTM ya msingi inatumia hidden unit 16 pekee. Idadi ya hidden-unit ilipoongezwa hadi 64, passes za conditional-coverage ziliongezeka kutoka 4 hadi 9, wastani wa \(Z_2\) ukaboreshwa kutoka −0,195 hadi −0,113 na kiwango cha wastani cha ukiukaji kikakaribia %4,99; hata hivyo, mtandao huu mkubwa pia haukufikia passes 19/39 za conditional-coverage za FHS wala matokeo ya −0,003 \(Z_2\).
Kwa nini hatari ya mkia ni tofauti na volatility ya wastani pekee?
Katika masoko ya fedha, standard deviation hupima mabadiliko ya jumla, ilhali hatari ya mkia hulenga hasa mkia wa kushoto wa usambazaji ambako hasara kubwa hutokea. Modeli ya hatari inaweza kufanya kazi kwa kuridhisha katika siku tulivu lakini ikakadiria chini uwezekano au ukali wa hasara kubwa wakati wa migogoro. Kwa hiyo, mantiki ya tathmini ya utafiti haiangalii tu kiwango cha wastani cha hatari, bali pia kasi ambayo modeli hujibu wakati wa migogoro na kama ukiukaji hukusanyika kwa vipindi maalumu.
Tofauti kati ya Value-at-Risk na expected shortfall
Value-at-Risk (VaR), huonyesha kizingiti cha hasara katika kiwango fulani cha kujiamini. Utafiti huu unatumia mkia wa \(\alpha=5\%\). VaR hujibu swali “tunapoingia katika siku mbaya zaidi za %5, kizingiti kiko wapi?”, lakini peke yake haisemi hasara zilizo ng’ambo ya kizingiti hicho ni kubwa kiasi gani.
Expected Shortfall (ES) au, katika muktadha unaofaa, Conditional VaR (CVaR), huonyesha ukali wa wastani wa hasara zinazopita kizingiti cha VaR. Hivyo, VaR inapocalibrate marudio ya ukiukaji, ES husaidia kutathmini ukubwa wa hasara baada ya kuingia kwenye mkia.
Familia tatu za modeli zinafanyaje kazi?
Je, Machine Learning Iliishinda Benchmark ya GARCH Katika Utafiti Huu?
Hapana. LSTM ya quantile nyingi yenye units 16 iliyojaribiwa iliboresha clustering ya ukiukaji na calibration ya ES ikilinganishwa na Historical Simulation isiyo na masharti; hata hivyo, FHS inayotegemea GARCH(1,1) ilifanya vizuri kuliko LSTM katika kiwango cha wastani cha ukiukaji, independence, conditional coverage na calibration ya expected-shortfall, na hata LSTM kubwa yenye units 64 ilipunguza tu tofauti hiyo bila kuifunga.
Kwa nini Historical Simulation inaweza kuwa benchmark dhaifu?
Historical Simulation hutumia moja kwa moja returns za siku 250 zilizopita. Volatility inapoongezeka ghafla, sehemu kubwa ya dirisha la nyuma bado inatokana na vipindi tulivu, kwa hiyo kizingiti hubadilika polepole. Siku za mgogoro zinapoingia kwenye dirisha, kiwango cha hatari huongezeka kwa kuchelewa; baadaye, hata mgogoro ukiwa tayari umepita, utabiri unaweza kubaki juu kwa muda mrefu kadiri siku hizo zinavyobaki ndani ya dirisha la siku 250.
Chanzo kinajadili tabia hii kama plateau ya hatari iliyochelewa yenye sifa ya “ghost”. Katika grafu ya wastani wa kimataifa, HS haikupanda haraka kama FHS wakati wa mgogoro, lakini ilidumisha kiwango cha juu karibu %4 katika kipindi cha 2009–2010. Baada ya COVID-19 pia kulionekana plateau iliyochelewa iliyobaki karibu %2,7 kwa takriban mwaka mmoja. Thamani hizi ni makadirio ya kusoma kwa macho kutoka grafu ya chanzo na maelezo ya waandishi; si jedwali ghafi la data za kila mwezi.
Kwa nini FHS hujibu haraka zaidi?
Katika FHS, ingawa parameters za GARCH hukadiriwa mwanzoni mwa mwaka wa kalenda kutokana na data za zamani na kubaki bila kubadilika mwaka mzima, conditional variance \(\sigma_t^2\) husasishwa mbele kwa kila return mpya ya kila siku. Kwa hiyo, mgogoro unapoanza, mbinu huingiza mara moja volatility mpya kwenye kizingiti cha hatari.
Katika mfano wa Marekani kwenye chanzo, FVaR iliongezeka kutoka takriban %2,5 hadi zaidi ya %6 ndani ya wiki nne baada ya kufilisika kwa Lehman Brothers tarehe 15 Septemba 2008, na kufikia %8,2 tarehe 29 Oktoba 2008. Katika kipindi hicho hicho, VaR ya Historical Simulation ya siku 250 haikuzidi %5 na ilikaribia kiwango hicho miezi baadaye tu, kadiri siku za mgogoro zilivyoingia kwenye rolling window.
Katika robustness test iliyokadiria upya parameters za GARCH kila baada ya miezi mitatu badala ya kila mwaka, kiwango cha wastani cha ukiukaji kilibaki %4,92, Kupiec passes 33/39 na conditional-coverage passes 19/39. Wastani wa \(Z_2\) ulibadilika kutoka −0,003 hadi −0,001. Jaribio hili linaunga mkono tafsiri kwamba faida ya kasi ya FHS inatokana hasa na daily variance recursion.
LSTM inajifunza nini?
Modeli ya msingi ya neural ni LSTM ya layer moja yenye units 16. Katika kila utabiri, hupokea mfuatano wa returns za siku 40 zilizopita kama input na kutabiri kwa wakati mmoja quantile za masharti za %1, %2,5, %5 na %10. Lengo la training ni wastani wa pinball loss katika viwango vinne vya quantile.
Quantile ya %5 huzalisha NVaR. Wastani wa quantile za %1, %2,5 na %5 ni mkabala wa discrete tail integral unaotumika kama NCVaR. Muundo huu ni makadirio ya vitendo ya expected-shortfall, lakini si modeli iliyofunzwa moja kwa moja kwa jointly elicitable joint loss function ya VaR na ES.
Matokeo ya correlation ya utafiti yanaonyesha kuwa hatari ya neural iko karibu zaidi na hatari iliyochujwa. Uchunguzi 192.789 wa market-day unapochukuliwa pamoja, correlation ya NVaR–FVaR ni 0,64 na correlation ya NVaR–VaR ni 0,53. Wastani wa correlations ndani ya soko ni 0,53 na 0,40 mtawalia. Katika masoko 34 kati ya 39, NVaR ilikuwa na correlation kubwa zaidi na FVaR kuliko na Historical VaR; paired t-test ya tofauti za correlation katika kiwango cha soko ilitoa \(t=5.51,\;p<0.001\).
Kwa Nini Kiwango cha Ukiukaji Karibu Asilimia 5 Pekee Hakitoshi?
Kwa sababu modeli sahihi ya %5 VaR haipaswi tu kutoa ukiukaji takriban mara moja kila siku 20 kwa wastani wa muda mrefu; ukiukaji huo pia unapaswa kusambazwa kwa kujitegemea kwa muda na usikusanyike katika vipindi maalumu vya mgogoro. Kwa hiyo, jaribio la Kupiec unconditional-coverage linapaswa kutathminiwa pamoja na majaribio ya Christoffersen independence na joint conditional-coverage.
Jaribio la Kupiec huangalia nini?
Jaribio la Kupiec proportion-of-failures huchunguza kama kiwango halisi cha ukiukaji wa VaR kinaendana na kiwango lengwa cha \(\alpha=5\%\). Jaribio hili halizingatii tarehe ambazo ukiukaji umetokea.
Jaribio la Christoffersen independence huangalia nini?
Jaribio la Christoffersen independence hutathmini kama ukiukaji unakusanyika kwa muda. Ikiwa modeli haitoi ukiukaji katika vipindi tulivu lakini inatoa ukiukaji mwingi mfululizo katika siku za mgogoro, hata kama kiwango cha jumla kiko karibu %5, utabiri wa hatari unaweza kuwa ume-calibrate vibaya kwa upande wa timing.
Conditional coverage inaunganisha nini?
Jaribio la conditional-coverage huchunguza kwa pamoja marudio sahihi ya jumla ya ukiukaji na timing huru ya ukiukaji. Katika chanzo, “pass” imefafanuliwa kama \(p>0.05\); hii si ushahidi kwamba modeli ni kamilifu, bali inamaanisha kwamba null hypothesis haikuweza kukataliwa katika kiwango cha %5 kwenye jaribio husika.
| Familia ya hatari | Kiwango cha wastani cha ukiukaji | Kupiec passes | Independence passes | Conditional coverage passes | Wastani wa Z₂ | Median Z₂ |
|---|---|---|---|---|---|---|
| Historical Simulation (HS) | %5,61 | 21/39 | 0/39 | 0/39 | −0,205 | −0,204 |
| Filtered Historical Simulation (GARCH-FHS) | %4,92 | 33/39 | 15/39 | 19/39 | −0,003 | +0,009 |
| Neural LSTM | %5,12 | 21/39 | 7/39 | 4/39 | −0,195 | −0,182 |
Kiwango cha ukiukaji kilibadilikaje katika miaka ya migogoro?
Katika uchanganuzi ambapo market-days zote ziliunganishwa kwa mwaka, kiwango cha ukiukaji cha HS kilipanda hadi %11,0 mwaka 2008 na kushuka hadi %1,5 mwaka 2009. Muundo huu unaendana na mfumo uliochelewa unaozalisha ukiukaji mwingi wakati wa mgogoro, kisha ukiukaji mdogo kuliko inavyohitajika wakati siku za mgogoro zinapotawala rolling window.
Kiwango cha kila mwaka cha ukiukaji cha FHS kilibaki katika takriban %2,7–%8,6 kwenye chanzo. Ingawa modeli ya neural ilikuwa karibu na lengo katika miaka mingi, ilipanda hadi %13,7 mwaka 2008, na kuwa kipindi kikubwa zaidi cha neural under-response katika utafiti.
Conditional coverage katika madaraja ya soko
FHS ilipita conditional coverage katika %58 ya masoko yaliyoendelea, %39 ya masoko yanayoibukia na moja kati ya masoko mawili ya frontier (%50). LSTM ilikuwa na kiwango cha kupita cha %5 katika masoko yaliyoendelea na %17 katika masoko yanayoibukia; haikupita katika soko lolote la frontier. HS haikupita conditional coverage katika daraja lolote.
Masoko manne ambayo LSTM ilipita conditional coverage ni Israel, Mexico, Philippines na Indonesia. Matatu kati yake ni katika daraja la masoko yanayoibukia. Hali hii inaonyesha kuwa nafasi ya kulinganisha ya LSTM huboreka kwa kiasi fulani katika masoko yanayoibukia, lakini haionyeshi kuwa imeishinda FHS kwa ujumla katika daraja lolote la soko.
Je, Neural Expected Shortfall Inaweza Kulinganishwa Moja Kwa Moja na FHS?
Si kikamilifu. FES ni wastani wa mkia wa usambazaji uleule wa mabaki ya kiempiria yaliyosanifishwa unaozalisha FVaR; NCVaR ni wastani wa vipande wa utabiri wa quantile za %1, %2,5 na %5 wa LSTM. Kwa hiyo, matokeo ya \(Z_2\) hulinganisha calibration ya kipimo cha hatari kinachodaiwa na kila familia, lakini si jaribio sawa kabisa la darasa lilelile la estimator.
Acerbi–Székely Z₂ inatafsiriwaje?
Jaribio lililotumika katika chanzo:
\[ Z_2= \frac{1}{T\alpha} \sum_{t:r_t<-VaR_t} \left(\frac{r_t}{ES_t}\right)+1 \]
limetolewa katika umbo hili. \(T\) ni jumla ya idadi ya uchunguzi katika kipindi cha tathmini, \(\alpha=0.05\) ni mkia lengwa, \(r_t\) ni return iliyotokea, \(VaR_t\) ni kizingiti kilichotabiriwa cha VaR na \(ES_t\) ni utabiri husika wa expected-shortfall.
Kuwa kwa \(Z_2\) karibu na sifuri kunaendana na calibration ya ES. Thamani hasi inaonyesha kwamba ES iliyotabiriwa inaakisi kwa kiwango cha chini ukali wa hasara za mkia zilizotokea.
| Familia | Wastani wa Z₂ | Median Z₂ | Tafsiri ndani ya chanzo |
|---|---|---|---|
| Historical CVaR | −0,205 | −0,204 | Hukadiria chini kwa utaratibu ukali wa mkia. |
| Filtered ES | −0,003 | +0,009 | Calibration iliyo karibu sana na sifuri. |
| Neural NCVaR | −0,195 | −0,182 | Kwa wastani, ukali wa mkia umekadiriwa chini kwa kiwango kinachoonekana; kuna mtawanyiko mkubwa kati ya masoko. |
Thamani za neural \(Z_2\) zina wigo mpana katika kiwango cha soko: chanzo kinatoa mifano ya mwisho ya +0,26 kwa Korea na −0,77 kwa Greece. Usambazaji huu unaonyesha kwamba calibration ya neural ES ni heterogeneous kati ya masoko, pamoja na kuwa na upotovu wa wastani.
Viwango vya hatari vilibadilikaje kulingana na kiwango cha maendeleo ya soko?
| Daraja la soko | VaR | CVaR | FVaR | FES | NVaR | NCVaR |
|---|---|---|---|---|---|---|
| Yaliyoendelea | 1,88 | 2,68 | 1,89 | 2,55 | 1,88 | 2,47 |
| Yanayoibukia | 2,07 | 3,05 | 2,05 | 2,94 | 2,08 | 2,84 |
| Frontier | 2,53 | 3,88 | 2,60 | 3,70 | 2,46 | 3,30 |
| Masoko yote | 2,00 | 2,90 | 2,00 | 2,78 | 2,00 | 2,67 |
Familia zote tatu ziko karibu kwa kiwango cha wastani cha VaR; tofauti kuu si kiwango bali ni mwitikio wa wakati kwa vipindi vya stress. Ingawa wastani wa frontier unaonekana kuwa juu zaidi, Argentina na Sri Lanka pekee ziko katika daraja hili; chanzo kinachukulia mwisho wa frontier kama tathmini ya awali, si kama gradient ya maendeleo iliyothibitishwa.
Paneli ya makroekonomia ilijaribu nini?
Utabiri wa kila siku wa hatari uligeuzwa kuwa wastani wa kila mwaka kwa uchunguzi wa country-year wenye angalau siku 100 za biashara kwa mwaka, na modeli ifuatayo ya fixed-effects panel ilikadiriwa kwa logarithm ya kila kipimo cha hatari:
\[ \ln MR_{it} = \gamma \ln MR_{i,t-1} + \beta_1 GDP_{it} + \beta_2 INT_{it} + \beta_3 INF_{it} + \beta_4 RET_{it} + \beta_5 UNC_{it} + a_i + \varepsilon_{it} \]
Hapa \(MR\) ni mojawapo ya VaR, CVaR, FVaR, FES, NVaR au NCVaR. \(GDP\) inawakilisha ukuaji halisi wa GDP, \(INT\) kiwango cha riba, \(INF\) mfumuko wa bei wa CPI, \(RET\) cumulative log return ya mwaka na \(UNC\) uncertainty. Katika modeli inayojumuisha masoko 21, variable ya uncertainty ni country EPU index; katika modeli iliyo karibu na cross-section kamili ni VIX. \(a_i\) ni country/market fixed effect.
Driscoll–Kraay standard errors zilitumika kwa inference inayostahimili cross-sectional na serial dependence. Kwa sababu lagged dependent variable inaweza kuleta Nickell bias katika mazingira ya moderate-\(T\), chanzo kinachukulia coefficient ya \(\gamma\) kama kipimo cha maelezo cha persistence, si parameter ya kimuundo ya causal.
| Kigezo | lnVaR | lnCVaR | lnFVaR | lnFES | lnNVaR | lnNCVaR |
|---|---|---|---|---|---|---|
| Hatari iliyocheleweshwa | 0,567 *** | 0,565 *** | 0,462 *** | 0,463 *** | 0,083 | 0,122 |
| Ukuaji wa GDP | −0,043 *** | −0,052 *** | −0,032 *** | −0,031 *** | −0,015 ** | −0,013 ** |
| Riba | 0,007 | 0,007 | 0,013 * | 0,012 | 0,002 | 0,002 |
| Mfumuko wa bei | 0,015 ** | 0,007 | 0,007 | 0,007 | 0,015 * | 0,014 * |
| Return ya mwaka | −0,001 | −0,001 | −0,004 *** | −0,004 *** | −0,001 | −0,001 |
| EPU | −0,0005 | −0,0004 | −0,0004 | −0,0003 | −0,0002 | −0,0002 |
| Within R² | 0,417 | 0,415 | 0,380 | 0,378 | 0,058 | 0,051 |
Paneli hii inatumia masoko 21 ya EPU; idadi ya uchunguzi ni 278 kwa HS na 255 kwa vipimo vingine vya hatari. Misimbo ya significance katika chanzo ni: * \(p<0.10\), ** \(p<0.05\), *** \(p<0.01\).
| Kigezo | lnVaR | lnCVaR | lnFVaR | lnFES | lnNVaR | lnNCVaR |
|---|---|---|---|---|---|---|
| Hatari iliyocheleweshwa | 0,330 *** | 0,291 *** | 0,199 *** | 0,195 *** | 0,149 ** | 0,196 ** |
| Ukuaji wa GDP | −0,005 | −0,010 | −0,003 | −0,002 | −0,003 | −0,004 |
| Riba | 0,005 * | 0,001 | 0,013 *** | 0,013 *** | 0,002 | 0,002 |
| Mfumuko wa bei | 0,001 | 0,001 | 0,000 | 0,000 | 0,001 | 0,001 |
| Return ya mwaka | 0,001 | 0,002 *** | −0,001 *** | −0,001 *** | −0,001 | 0,000 |
| VIX | 0,030 *** | 0,033 *** | 0,026 *** | 0,026 *** | 0,017 *** | 0,013 *** |
| Within R² | 0,556 | 0,559 | 0,555 | 0,553 | 0,229 | 0,182 |
Katika cross-section ya makro yenye masoko 38, VIX ni chanya na significant katika kiwango cha %1 kwa vipimo vyote sita vya hatari. Katika specification ileile, coefficients za GDP hupoteza significance. Matokeo haya yanaashiria kuwa sehemu muhimu ya cyclical risk compression iliyohusishwa na ukuaji wa GDP katika paneli ya msingi inahusiana na common global financial cycle.
Familia zilipangwaje kwa upande wa procyclicality?
Katika modeli ya msingi ya EPU, ongezeko la asilimia-point moja katika ukuaji wa GDP hupunguza HS VaR kwa takriban %4,3, HS CVaR kwa %5,2, hatari ya FHS kwa takriban %3,1 na hatari ya neural kwa takriban %1,3–1,5. Kwa hiyo, chanzo kinapanga ukubwa wa procyclicality kwa ujumla kama HS > FHS > LSTM.
Katika crisis dummy ya 2008–2009 na 2020, coefficient ya kila mwaka ya Historical VaR ni log point 0,72, FHS VaR 0,40 na NVaR 0,27. Kwa uongofu wa takriban wa chanzo, hizi zinawakilisha ongezeko la mgogoro la takriban mara mbili, +%50 na +%31 mtawalia.
2022 ilipoongezwa pia kwenye kundi la migogoro, mpangilio haukubadilika: HS 0,66, FHS 0,37 na LSTM 0,23; zote tatu ni significant katika kiwango cha %1 kwenye chanzo.
Kwa nini matokeo ya mfumuko wa bei yanapaswa kutafsiriwa kwa tahadhari?
Katika mgawanyo wa masoko yanayoibukia, uhusiano wa mfumuko wa bei na hatari ya neural ni mkubwa zaidi. Matokeo yaliyoripotiwa ni takriban +%2,8/asilimia-point kwa NVaR na NCVaR; +%1,9 kwa historical VaR na takriban +%1,5 kwa filtered VaR.
Hata hivyo, kipindi cha kimataifa cha mfumuko mkubwa wa bei cha 2021–2023 kinapoondolewa, coefficients za mfumuko wa bei hupungua kwa takriban %20–40 na hupoteza kiwango cha significance cha %5 katika modeli nyingi. Kwa hiyo, chanzo kinaweka kikomo cha matokeo haya kama finding ya kiempiria inayotegemea sana uzoefu wa mfumuko mkubwa wa bei wa 2021–2023, si sheria ya soko isiyobadilika ya muda mrefu.
Je, FHS na LSTM zinapaswa kutumika badala ya nyingine?
Kwa mujibu wa mjadala wa chanzo, hapana. FHS inaonekana kuaminika zaidi katika matumizi yanayohitaji calibration ya aina ya daily limit na capital, ilhali kipimo cha hatari ya neural hutoa ishara laini zaidi na less procyclical katika mzunguko.
Hata hivyo, ukweli kwamba modeli ya neural huongezeka kidogo chini ya stress pia ndiyo udhaifu wake muhimu zaidi: clustered large losses zinapotokea, NCVaR huonyesha kwa chini ukali wa mkia kwa wastani wa takriban %20. Kwa hiyo, tafsiri ya waandishi ya “complementary” haimaanishi kufanya LSTM kuwa kikomo pekee cha lazima cha hatari wakati wa mgogoro; inamaanisha kuitathmini kama ishara ya pili ya hatari yenye maudhui tofauti ya makroekonomia kando ya FHS.
Mbinu na Matokeo ya Utafiti
Sampuli
| Daraja | Idadi | Masoko |
|---|---|---|
| Yaliyoendelea (DM) | 19 | Australia, Austria, Belgium, Canada, France, Germany, Hong Kong, Ireland, Israel, Italy, Japan, Netherlands, New Zealand, Singapore, Spain, Sweden, Switzerland, United Kingdom, Marekani |
| Yanayoibukia (EM) | 18 | Brazil, Chile, China, Greece, Hungary, India, Indonesia, Korea, Malaysia, Mexico, Pakistan, Philippines, Qatar, Saudi Arabia, Taiwan, Thailand, Türkiye, UAE |
| Frontier (FM) | 2 | Argentina, Sri Lanka |
Uainishaji ulifanywa kwa mujibu wa 2024 MSCI Market Classification Framework. Bei za kufunga za kila siku zilipatikana kutoka Yahoo Finance chart API kwa kipindi cha 2000–2025, na daily log returns zikakokotolewa kama:
\[ r_t=\ln P_t-\ln P_{t-1} \]
. Uchunguzi wenye absolute daily return inayozidi %50 uliondolewa kwa kuchukuliwa kuwa kosa la data.
Dirisha la pamoja la backtest linajumuisha siku kuanzia Januari 2005 ambazo vipimo vyote sita vya hatari vilipatikana kwa wakati mmoja. Dirisha la pamoja kwa kila soko ni siku 3595–5373, median siku 5172; jumla kuna 192.789 market-day.
Mipaka ya paneli isiyosawazika na mfululizo usiokamilika
Paneli imeachwa bila kusawazishwa kwa makusudi. Mifululizo ya bei ya Hungary, Qatar, Pakistan na Sri Lanka inaishia Septemba 2021; mfululizo wa Chile unaishia Juni 2019. Masoko haya yalibaki katika uchanganuzi kwa tarehe ambazo data zake zilipatikana.
Katika paneli ya makro, Taiwan iliondolewa kwenye regressions kwa sababu haikufunikwa na World Bank, lakini ilibaki kwenye backtests. Kwa Argentina, uchunguzi wa mfumuko wa bei ni mchache kutokana na pengo rasmi la data katika mfululizo wa CPI wa 2007–2015.
Fomula ya Historical Simulation
5% VaR ni hasi ya quantile ya kiempiria ya %5 ya usambazaji wa returns za siku 250 zilizopita:
\[ VaR_t=-Q_{\alpha} \left( r_{t-250},\ldots,r_{t-1} \right), \qquad \alpha=0.05 \]
Historical CVaR ni hasi ya wastani wa masharti wa returns zilizo chini ya quantile ya %5 ndani ya dirisha hilo hilo:
\[ CVaR_t= -E\left[ r\mid r\le Q_{\alpha} \right] \]
Kwa sababu dirisha linaishia \(t-1\), return ya siku hiyo hiyo haitumiki katika utabiri.
Fomula ya GARCH-FHS
Kwa kila mwaka wa kalenda \(y\), GARCH(1,1) hukadiriwa kwa kutumia returns zote zinazopatikana kabla ya mwaka huo, kwa angalau uchunguzi 500:
\[ r_t=\mu+\varepsilon_t \]
\[ \varepsilon_t=\sigma_t z_t \]
\[ \sigma_t^2= \omega+ \alpha_1\varepsilon_{t-1}^2+ \beta_1\sigma_{t-1}^2 \]
Dhana ya normal distribution hutumika tu kukadiria parameters za \(\omega,\alpha_1,\beta_1\) kwa mbinu ya quasi-maximum-likelihood. Mkia wa hatari hautolewi kutoka normal distribution.
Ikiwa quantile ya kiempiria ya %5 ya standardized residuals katika dirisha la training ni \(q_z\), na wastani wa mkia ni \(z_{tail}\):
\[ FVaR_t= -\left( \mu+\sigma_t q_z \right) \]
\[ FES_t= -\left( \mu+\sigma_t z_{tail} \right) \]
hukokotolewa hivyo. Tofauti hii ni muhimu: utafiti haujaribu “GARCH-normal VaR”, bali mbinu ya empirical-tail FHS ambayo GARCH hutumika kama kichujio cha volatility.
Muundo wa LSTM na itifaki ya training
| Kipengele | Thamani |
|---|---|
| Muundo | LSTM ya layer moja |
| Hidden unit | 16 |
| Dirisha la input | Return za siku 40 zilizopita |
| Quantile za output | %1, %2,5, %5, %10 |
| Loss function | Wastani wa pinball loss kwa quantile nne |
| Scaling | Expanding-window standard deviation |
| Retraining | Kutoka mwanzo mwanzoni mwa kila mwaka wa kalenda; expanding window |
| Kiwango cha chini cha uchunguzi wa training | 500 |
| Optimizer | Adam |
| Learning rate | 0,01 |
| Batch size | 256 |
| Maximum epoch | 20 |
| Validation split | %10 |
| Early-stopping patience | 3 |
| Random seed | Thabiti |
| Quantile monotonicity | Quantile zilizotabiriwa hupangwa |
Output ya %5 ni NVaR. Mkabala wa neural expected-shortfall ni:
\[ NCVaR_t \approx \frac{ Q_{0.01,t} + Q_{0.025,t} + Q_{0.05,t} }{3} \]
wastani wa discrete quantile katika umbo hili. Fomula hii imewekewa mpaka katika chanzo kama “practical approximation”.
Hypotheses sita za utafiti na hali ya matokeo
| Hypothesis | Utabiri | Matokeo |
|---|---|---|
| H1 — Persistence | Vipimo vya hatari vya kila mwaka vitaonyesha autocorrelation chanya. | Ni kubwa katika familia za classical; ni dhaifu/isiyo significant katika familia ya neural kwenye sampuli ya EPU. H1 haikuthibitishwa kwa vipimo vyote sita. |
| H2 — Filtering | Kichujio cha volatility kitaboresha calibration ya independence/CC ikilinganishwa na HS. | Iliungwa mkono kwa nguvu; LSTM haikuishinda FHS. |
| H3 — Procyclicality | Hatari itapungua kadiri GDP growth inavyoongezeka; HS itakuwa procyclical zaidi. | Katika modeli ya msingi, mpangilio ni HS > FHS > LSTM; VIX inapoongezwa, coefficients za GDP zinakuwa zisizo significant. |
| H4 — Inflation | Mfumuko wa bei utaongeza hatari, hasa katika shocks kubwa za mfumuko wa bei. | Inaungwa mkono hasa katika masoko yanayoibukia; imejikita kwa kiasi kikubwa katika kipindi cha 2021–2023. |
| H5 — Global / local uncertainty | VIX itakuwa chanya; EPU itatoa explanatory power ya ziada hasa katika EM na migogoro. | Sehemu ya VIX iliungwa mkono kwa nguvu; matarajio kuhusu country EPU hayakuungwa mkono. |
| H6 — Development gradient | Calibration itazidi kuwa mbaya katika mwelekeo wa DM → EM → FM. | Katika FHS kuna kushuka kutoka DM → EM; si monotonic katika vigezo vyote. Kwa kuwa kuna masoko mawili tu ya frontier, mwisho wa FM hauwezi kuhitimishwa. |
Ukaguzi saba wa robustness
| Ukaguzi | Muundo | Matokeo makuu |
|---|---|---|
| Unyeti wa muundo wa LSTM | 64 hidden unit vs 16; walk-forward retraining katika masoko yote 39 | CC 4→9/39; Z₂ −0,195→−0,113; ukiukaji %5,12→%4,99. Tofauti ya FHS inapungua lakini haifungwi. |
| EVT-augmented FHS | GPD peaks-over-threshold juu ya standardized GARCH residuals | Ukiukaji %4,98; Z₂ −0,007. Karibu sana na baseline FHS. |
| Dynamic-panel bias | One-step Arellano–Bond difference GMM | FVaR/FES/NVaR/NCVaR zinaendana kwa mwelekeo na baseline; katika familia ya HS identification ni dhaifu kwa sababu ya near-unit-root. |
| Jaribio la correlation ya NVaR–FVaR | paired t-test na Wilcoxon juu ya correlation za masoko 39 | 0,53 vs 0,40; masoko 34/39; t=5,51; p<0,001. |
| Effective sample size / nguvu | ESS na Kupiec power kulingana na breach autocorrelation | Uwiano wa ESS ni FHS 0,82; neural 0,51; HS 0,46. Nguvu ya kugundua ukiukaji wa %5→%7 ni >0,98 kwa ujumla. |
| Utambuzi wa mfumuko wa bei wa 2021–2023 | Coefficient ya mfumuko wa bei ya EM/FM ikiwa kipindi kimejumuishwa na kimeondolewa | Kipindi kinapoondolewa, coefficient hupungua kwa takriban %20–40 na hupoteza significance ya %5 katika vipimo vingi. |
| Mara ya GARCH refit | FHS ya kila mwaka vs kila miezi mitatu | Ukiukaji %4,92, Kupiec 33/39 na CC 19/39 havibadiliki; Z₂ −0,003→−0,001. |
Matokeo yanayoungwa mkono na utafiti
- Rolling Historical Simulation ilionyesha conditional calibration dhaifu dhidi ya clustering ya migogoro.
- Kichujio cha volatility kinachotegemea GARCH kilipunguza kwa kiasi kikubwa tatizo la timing ya ukiukaji la HS.
- LSTM yenye units 16 iliyojaribiwa ilifanya vizuri kuliko HS lakini ilikuwa dhaifu kuliko FHS katika backtest.
- LSTM yenye units 64 iliboresha calibration lakini haikufunga tofauti ya FHS.
- Neural VaR inafanana zaidi na FVaR kuliko Historical VaR.
- Calibration ya expected-shortfall ya FHS ilitoa Z₂ iliyo karibu sana na sifuri kwa wastani.
- Familia ya neural inaonekana kuwa less procyclical kuliko familia za classical katika paneli ya kila mwaka ya makro.
- VIX ni mojawapo ya explanatory variables za makro zilizo thabiti zaidi kwa vipimo vyote sita vya hatari.
- Katika masoko yanayoibukia, uhusiano mkubwa kati ya mfumuko wa bei na hatari ya neural umeripotiwa, lakini matokeo yanategemea kwa wazi kipindi cha 2021–2023.
Matokeo yasiyoungwa mkono na utafiti na mipaka
- Utafiti hauonyeshi kwamba mbinu zote za machine learning ni mbaya kuliko GARCH.
- Utafiti haukujaribu transformer, modeli kubwa sana za deep-learning, au architectures pana za hybrid GARCH-LSTM.
- LSTM ya msingi yenye units 16 si “theoretical upper bound ya machine learning”.
- Ulinganisho wa Z₂ kati ya neural NCVaR na FES si jaribio la moja kwa moja kabisa la darasa lilelile la estimator.
- Matokeo ya Historical-family dynamic-panel GMM yameainishwa kwa udhaifu kwa sababu ya near-unit-root.
- Matokeo ya frontier yanategemea Argentina na Sri Lanka pekee na hayapaswi kuchukuliwa kama matokeo ya jumla kwa frontier-market.
- Baadhi ya mifululizo ya bei inaishia mwaka 2021 au 2019.
- Data ya CPI ya Argentina haijakamilika katika kipindi cha 2007–2015.
- Paneli ya makro ina frequency ya mwaka na resolution ya muda iliyo coarse zaidi kuliko mienendo ya hatari ya kila siku.
- Matokeo ya mfumuko wa bei katika masoko yanayoibukia si regularity ya kudumu iliyojirudia katika vipindi vingi huru vya mfumuko mkubwa wa bei.
- Coefficients za makroekonomia katika paneli ni mahusiano ya uchunguzi; hazithibitishi athari sahihi ya causal ya sera au shocks za makro kwa vipimo vya hatari.
Mapendekezo ya utafiti wa baadaye
Chanzo kinapendekeza kufundisha moja kwa moja jozi ya neural VaR–ES kwa jointly elicitable loss functions; kutumia regression-based na estimation-error-robust ES backtests; na kujaribu mitandao mikubwa zaidi, deep quantile-regression models na miundo ya hybrid GARCH-LSTM.
Badala ya kuweka variables za makroekonomia tu baadaye kwenye panel regression, inapendekezwa pia kuingiza moja kwa moja kwenye neural model variables kama GDP growth, inflation na global uncertainty. Muundo kama huo unaweza kupima kama modeli inaweza kujifunza macro-conditional tail dynamics moja kwa moja.
Kwa upande wa data, inapendekezwa kuongeza masoko zaidi ya frontier, kukamilisha mifululizo iliyokatika baada ya 2021 na kutumia variables za macro-financial zenye frequency ya juu zaidi.
Maelezo ya Chanzo na Mbinu
Utafiti asilia: Does Machine Learning Beat the GARCH Benchmark? Historical, Filtered, and Neural Tail-Risk Measures Across Thirty-Nine Global Equity Markets.
Waandishi: Raima Amjad na Zeeshan Ahmed.
Mwandishi anayewajibika: Raima Amjad.
Barua pepe ya mwandishi anayewajibika: rahaymah@gmail.com.
Taasisi: Department of Management Sciences, Capital University of Science and Technology, Islamabad 44000, Pakistan.
Jarida: Economies.
Mchapishaji: MDPI.
Juzuu / toleo / makala: 14(9), 379.
DOI: 10.3390/economies14090379.
Iliwasilishwa: 14 Julai 2026.
Marekebisho: 20 Agosti 2026.
Ilikubaliwa: 21 Agosti 2026.
Ilichapishwa: 3 Septemba 2026.
Wahariri wa kitaaluma: Weixin Yang na Periklis Gogas.
Aina ya chanzo: Utafiti wa kulinganisha wa empirical financial econometrics na machine learning.
Hali ya peer review: Makala ya jarida iliyochapishwa / Version of Record.
Leseni: Creative Commons Attribution (CC BY).
Uainishaji wa JEL: C45; C52; C58; G17; G32; E44.
Maneno muhimu ya chanzo: tail risk; Value-at-Risk; expected shortfall; filtered historical simulation; GARCH; LSTM; quantile regression; backtesting; emerging markets; frontier markets.
Idadi ya masoko: 39 — 19 developed, 18 emerging, 2 frontier.
Kipindi cha data za bei: 2000–2025.
Kipindi cha pamoja cha strictly out-of-sample backtest: Kuanzia Januari 2005; market-days ambazo vipimo vyote sita vilipatikana kwa wakati mmoja.
Ukubwa wa joint backtest: 192.789 market-day; 3595–5373 kwa kila soko, median siku 5172.
Chanzo cha bei: Yahoo Finance chart API.
Vyanzo vya data za makro: World Bank World Development Indicators, country-level Economic Policy Uncertainty indices na CBOE VIX.
Tarehe ya kufikia data: 15 Juni 2026.
Historical Simulation: Rolling window ya siku 250; \(\alpha=5\%\).
FHS: GARCH(1,1); expanding prior-data window; angalau uchunguzi 500; parameters za GARCH hukadiriwa upya kila mwaka; conditional variance husasishwa kila siku; VaR na ES kutoka usambazaji wa kiempiria wa standardized residuals.
LSTM: Input ya siku 40; 16 hidden unit; quantile za %1, %2,5, %5 na %10; pinball loss; Adam; learning rate 0,01; batch size 256; hadi epoch 20; %10 validation; patience 3; annual walk-forward retraining.
Backtests: Kupiec proportion-of-failures; Christoffersen independence; Christoffersen conditional coverage; Acerbi–Székely \(Z_2\).
Paneli ya makro: Country fixed effects na Driscoll–Kraay standard errors; risk persistence, GDP growth, interest rate, inflation, annual return na EPU/VIX variables.
Matokeo makuu ya backtest: FHS %4,92 average violation, 33/39 Kupiec, 15/39 independence, 19/39 conditional coverage na wastani wa \(Z_2=-0.003\).
Matokeo ya msingi ya LSTM: %5,12 average violation, 21/39 Kupiec, 7/39 independence, 4/39 conditional coverage na wastani wa \(Z_2=-0.195\).
Matokeo ya robustness ya 64-unit LSTM: 9/39 conditional coverage, kiwango cha ukiukaji %4,99, wastani wa \(Z_2=-0.113\); tofauti ya FHS haikufungwa.
Ufadhili: Utafiti haukupokea ufadhili wa nje.
Institutional Review Board: haitumiki.
Idhini iliyoarifiwa: haitumiki.
Upatikanaji wa data: Data zilizochanganuliwa zilitoka kwenye vyanzo vya umma; hakuna data mpya iliyoundwa. Imeelezwa kuwa code iliyotumika kuzalisha vipimo vya hatari, backtests na panel regressions inaweza kupatikana kutoka kwa mwandishi anayewajibika kwa ombi la msingi.
Mgongano wa maslahi: Waandishi wametangaza kuwa hakuna mgongano wa maslahi.
Michango ya waandishi: Conceptualization, methodology, software, formal analysis, investigation, resources, data curation, original draft na visualization: Raima Amjad; validation: Raima Amjad na Zeeshan Ahmed; review na editing: waandishi wote wawili; supervision na project administration: Zeeshan Ahmed.
Mpaka mkuu wa wigo: Ingawa neno “machine learning” katika kichwa ni la jumla, upande wa neural wa ulinganisho wa empirical ni single-layer multi-quantile LSTM katika kiwango cha kawaida cha matumizi. Matokeo haya hayawezi kujumlishwa kwa architectures zote zinazowezekana za machine learning.
Mpaka wa ulinganisho wa expected-shortfall: NCVaR ni wastani wa discrete wa quantile tatu na si jointly elicitable VaR–ES estimate. FES ni wastani wa mkia wa usambazaji uleule wa kiempiria unaozalisha FVaR. Tofauti ya \(Z_2\) inapaswa kutafsiriwa kwa kuzingatia tofauti hii ya estimator-class.
Mpaka wa dynamic-panel: Lagged dependent variable inaweza kusababisha Nickell bias katika fixed-effects model. Difference-GMM kwa ujumla inaendana na baseline katika familia za filtered na neural, lakini imeonyesha weak identification katika historical family kwa sababu ya near-unit-root.
Mpaka wa frontier-market: Daraja la frontier lina Argentina na Sri Lanka pekee; chanzo hakioni cell hii kuwa ya kutosha kwa dai la jumla kuhusu frontier markets.
Mpaka wa mfumuko wa bei: Uhusiano wa inflation katika emerging-market umejikita katika kipindi cha 2021–2023; miaka hii ikiondolewa, coefficients hupungua kwa takriban %20–40 na matokeo mengi hupoteza significance.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *