


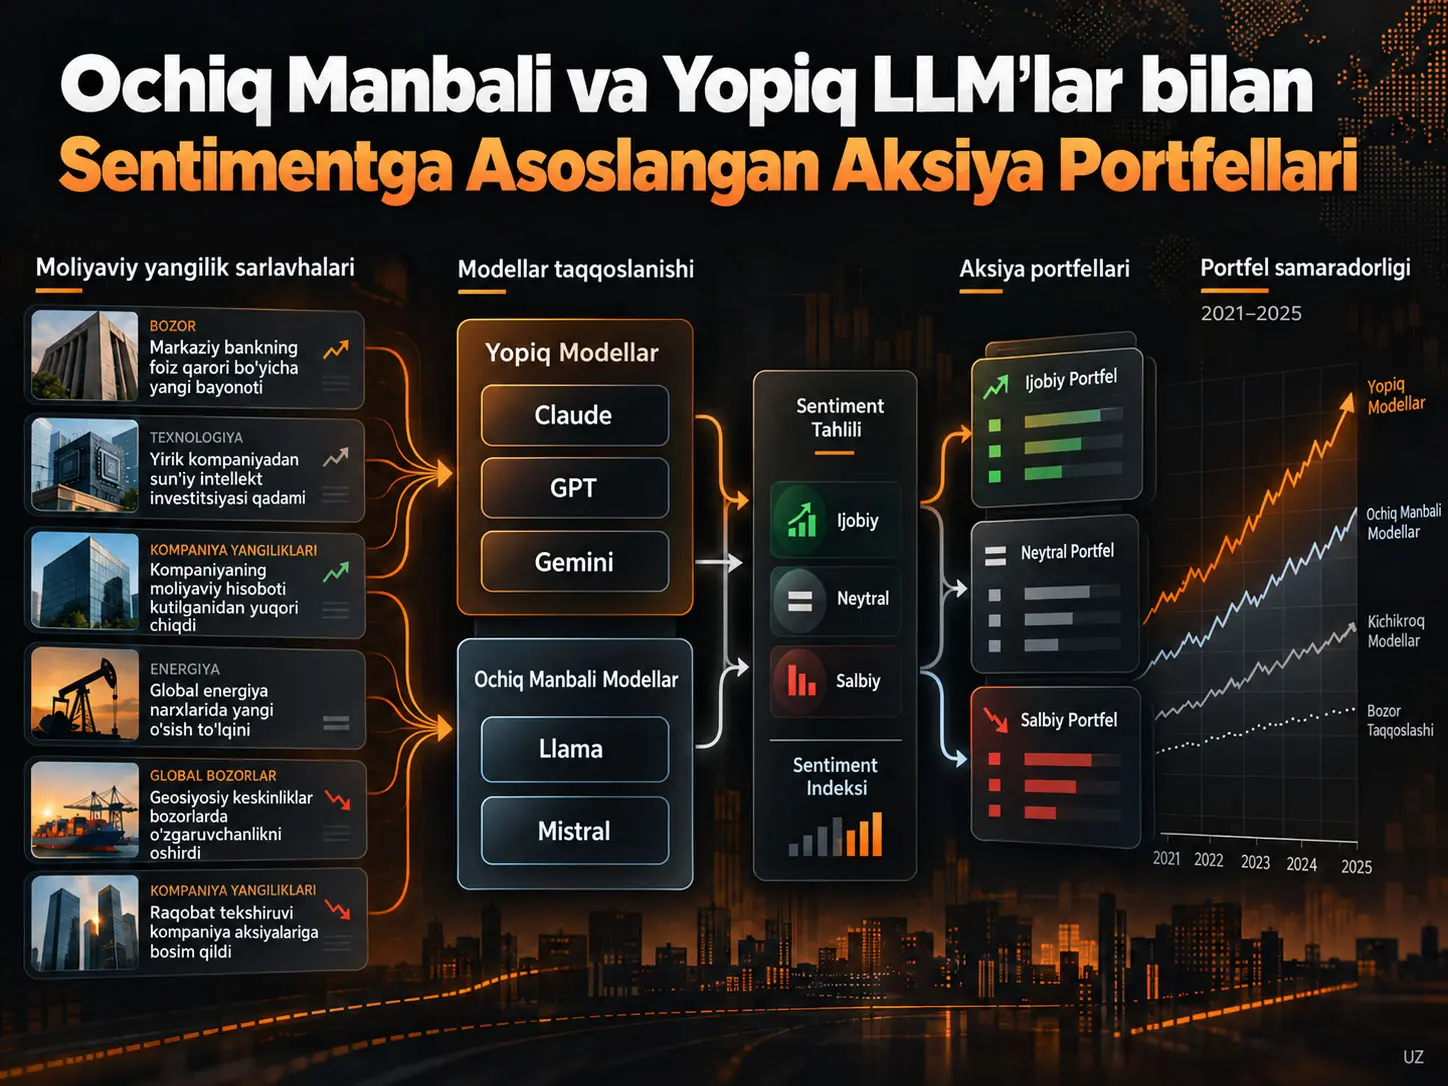
LLM asosidagi sentiment portfeli, moliyaviy yangilik sarlavhalarini katta til modellari tomonidan ijobiy, salbiy yoki neytral deb tasniflash va ushbu sinflardan hosil qilingan kompaniyalarning oylik sentiment ballaridan aksiya tanlashda foydalanish orqali tuziladigan portfel yondashuvidir. Felipe Affonso va Marcelo S. Perlin 2021–2025 davrida S&P 500 kompaniyalari uchun tozalashdan keyin qolgan 1.477.385 ta yangilik sarlavhasini yettita katta til modeli bilan tasniflagan; toʻrtta yopiq model va mahalliy ishga tushirilishi mumkin boʻlgan, vaznlari mavjud uchta modelni bir xil rank-based portfel usuli asosida taqqoslagan. Manba namunasida riskka moslashtirilgan eng yuqori natijani Claude 3 Haiku bergan, Llama 3.1 8B tijoriy API modellariga yaqin natija koʻrsatgan, Llama 3.2 1B esa benchmarkdan oshmagan. Biroq natijalar muayyan maʼlumot, davr, prompt, model versiyasi va portfel qoidasi uchun amal qiladi; model strategiyalari oʻrtasidagi alpha va Sharpe farqlari formal statistik ustunlik testlari bilan tasdiqlanmagan.
Tadqiqotning muhim tomoni faqat “qaysi LLM yuqoriroq daromad berdi?” degan savol emas. Tadqiqot bir xil moliyaviy tasniflash vazifasida model oilasi, model sigʻimi, mahalliy ishga tushirish imkoniyati va tijoriy APIga kirish oʻrtasida amaliy taqqoslash oʻtkazadi. Yopiq modellar umuman olganda riskka moslashtirilgan eng yuqori daromadlarni bergan boʻlsa-da, 8 milliard parametrli Llama 3.1 Gemini 2.5 Flashga yaqin va GPT-4.1 Nanodan yuqori natija bergani mahalliy ishga tushiriladigan model ayrim moliyaviy matn tasnifi vazifalarida foydalanish mumkin boʻlgan muqobil boʻlishi mumkinligini koʻrsatadi.
Bu natija investitsiya tavsiyasi yoki kelajakda ayni daromadlar olinishi isboti emas. Tadqiqot tranzaksiya xarajatlari, komissiyalar va bozor ishqalanishlarini hisobga olmaydi; alpha faqat S&P 500 teng vaznli benchmarkiga nisbatan bir omilli; kompaniya hajmi, value, momentum va sektor omillariga moslashtirilmagan. Bundan tashqari, model bilimining cutoff sanalari maʼlumotlar davrining bir qismini qamrab olishi pre-training orqali oʻtmish voqealari haqidagi bilimni toʻliq chiqarib tashlashga imkon bermaydi.
Tadqiqot muammosi
Moliyaviy bozorlarda matn uzoq vaqtdan beri investitsiya signali sifatida qoʻllanadi. Anʼanaviy lugʻatga asoslangan usullar soʻzni uning atrofidagi kontekstni yetarli darajada hisobga olmasdan ijobiy yoki salbiy deb tasniflashi mumkin. Katta til modellari esa yangilik sarlavhasi kontekstini kengroq qayta ishlay olgani uchun moliyaviy sentimentni aniqlashda boshqacha yondashuv taklif qiladi.
Biroq avvalgi tadqiqotlarning muhim qismi bitta yopiq model oilasiga qaratilgan. Bu ikki savolni ochiq qoldiradi: turli tijoriy LLMlar bir xil moliyaviy yangiliklarda bir xil investitsiya signalini ishlab chiqaradimi va mahalliy ishga tushiriladigan kichikroq modellar pullik tijoriy APIlarga qanchalik yaqinlasha oladi?
Affonso va Perlin ushbu boʻshliqni bir xil maʼlumotlar toʻplami va bir xil portfel qoidasi ostida yettita LLMni taqqoslab koʻrib chiqadi. Maqsad mavjud barcha modellar uchun universal reyting tuzish emas. Tadqiqot tanlangan yopiq va vaznlari mavjud modellar bir xil moliyaviy matn vazifasida hosil qilgan signallarning portfel natijalarini taqqoslaydi.
Maʼlumotlar olami nega dinamik S&P 500 aʼzoligiga asoslanadi?
Maʼlumotlar toʻplami EOD Historical Data portalidan olingan AQSh kompaniyalari yangilik sarlavhalariga asoslanadi. Tadqiqot 2021-yil yanvar–2025-yil dekabr davrini oʻrganadi. Har oy faqat aynan oʻsha oyda S&P 500 aʼzosi boʻlgan kompaniyalar ishlatilgan; 2025-yil oxiridagi kompaniyalar roʻyxatini oʻtmishga tatbiq etish tanlanmagan.
Bu jihat metodologik nuqtai nazardan muhim. Faqat davr oxiridagi kompaniyalarning oʻtmishdagi natijalarini oʻrganish keyinroq indeksga kirgan yoki ilgari indeksdan chiqqan kompaniyalarni notoʻgʻri hisobga olib, tanlov va survivorship biasni keltirib chiqarishi mumkin. Point-in-time aʼzolik yondashuvi portfel olami har bir sanada aynan oʻsha vaqtda maʼlum boʻlgan indeks tarkibiga asoslanishini taʼminlaydi.
1,69 million yangilik sarlavhasidan 1,48 millionlik analitik namunaga
| Bosqich | 2021 | 2022 | 2023 | 2024 | 2025 | Jami |
|---|---|---|---|---|---|---|
| Dastlab chiqarib olingan sarlavha | 246.365 | 281.361 | 291.426 | 230.335 | 640.082 | 1.689.569 |
| Chiqarib tashlangan metadata artefakti | 5 | 18 | 1.997 | 6.406 | 0 | 8.426 |
| Chiqarib tashlangan yaqin dublikat | 41.657 | 21.757 | 28.952 | 19.899 | 91.493 | 203.758 |
| Yakuniy analitik namuna | 204.703 | 259.586 | 260.477 | 204.030 | 548.589 | 1.477.385 |
Yaqin dublikatlarni aniqlashda normallashtirilgan Levenshtein oʻxshashlik nisbati qoʻllanilgan. Bir kompaniya va bir kunga tegishli ikki sarlavhaning oʻxshashlik nisbati 0,6dan yuqori boʻlsa, juftliklardan biri chiqarib tashlangan. Bir kun va bir kompaniya cheklovi turli iqtisodiy voqealarga oid, ammo til jihatidan oʻxshash yangiliklarning xato ravishda oʻchirilishi xavfini kamaytirish uchun qoʻllanilgan.
2025-yildagi yangiliklar hajmi sakrashi nega muhim?
2025-yilda dastlabki yangiliklar soni 640.082gacha koʻtarilib, oldingi yillar hajmidan sezilarli darajada oshgan. Manbaga koʻra, maʼlumot yetkazib beruvchi shu davrda tuzilmagan manbalardan yangilik ajratib olish uchun katta til modelidan foydalana boshlagan; biroq bu oʻzgarishning aniq boshlanish sanasi eʼlon qilinmagan.
Mualliflar shu sababli maʼlumotlar toʻplamini boʻlish oʻrniga uni toʻliq saqlab qolgan. Ularning asosiga koʻra, qoʻllanilgan Sentiment Index har bir kompaniya-oy ichida normallashtirilgani sababli faqat yangiliklar sonining koʻpayishi signal darajasini mexanik tarzda oʻzgartirmaydi. Shunga qaramay, maʼlumot ishlab chiqarish jarayonidagi bu oʻzgarish davrlararo taqqoslashda hisobga olinishi kerak boʻlgan maʼlumot manbai xususiyatidir.
Sentiment Index nimani oʻlchaydi?
Sentiment Index — muayyan oyda kompaniya haqidagi ijobiy va salbiy deb tasniflangan yangiliklarning nisbiy muvozanatini -1 bilan +1 oraligʻida oʻlchaydigan normallashtirilgan sentiment koʻrsatkichidir. +1 faqat ijobiy, -1 faqat salbiy tasniflar ustun boʻlgan chekka holatlarni ifodalaydi; koʻrsatkich yangiliklar hajmining mutlaq darajasidan koʻra ijobiy va salbiy yangiliklarning oʻzaro nisbatidan foydalanadi.
Kompaniya \(i\) va oy \(t\) uchun ishlatiladigan tenglama:
\[ SI_{i,t} = \frac{\sum POS-\sum NEG} {\sum POS+\sum NEG} \]
Bu yerda \(POS\) tegishli kompaniya-oy uchun ijobiy deb tasniflangan yangiliklar sonini, \(NEG\) esa salbiy deb tasniflangan yangiliklar sonini koʻrsatadi. Formulaning surat qismi sof sentiment yoʻnalishini, maxraj qismi esa ijobiy va salbiy yangiliklarning jami hajmini normallashtiradi. Neytral deb tasniflangan yangiliklar ushbu formulaning ijobiy-salbiy muvozanatiga bevosita kirmaydi.
Koʻrsatkich mutlaq “aksiya daromadi prognozi” emas. Keyingi bosqichda u faqat kompaniyalarni bir-biriga nisbatan saralashga xizmat qiladigan nisbiy signal sifatida qoʻllanadi.
Qaysi LLMlar taqqoslandi?
| Guruh | Model | Manbada berilgan parametr maʼlumoti | Kontekst oynasi | Bilim cutoff sanasi / proxy |
|---|---|---|---|---|
| Yopiq | GPT-4.1 Nano | Ochiqlanmagan | 1M | Iyun 2024 |
| Yopiq | Claude 3 Haiku | Ochiqlanmagan | 200k | Avgust 2023 |
| Yopiq | Claude 4.5 Haiku | Ochiqlanmagan | 200k | Fevral 2025 |
| Yopiq | Gemini 2.5 Flash | Ochiqlanmagan | 1M | Yanvar 2025 |
| Mualliflarning “open-source” guruhi | LLaMA 3.1 8B Instruct | 8 milliard | 128k | Dekabr 2023 |
| Mualliflarning “open-source” guruhi | LLaMA 3.2 1B Instruct | 1 milliard | 128k | Dekabr 2023 |
| Mualliflarning “open-source” guruhi | Mistral 7B Instruct v0.2 | 7 milliard | 32k | Dekabr 2023 versiya sanasi proxy sifatida ishlatilgan |
Manba sarlavha va asosiy matnda Llama hamda Mistral modellarini “open-source” deb ataydi; texnik xususiyatlar jadvalida esa bu guruh qoʻshimcha ravishda “Weights Available” deb taʼriflangan. Verianla matni ushbu terminologik farqni oʻzgartirmasdan saqlaydi.
Nega tejamkorroq modellar tanlandi?
Taxminan 1,5 million yangilik sarlavhasini koʻp sonli modellar bilan qayta ishlash yuqori hisoblash va API xarajatini keltirib chiqaradi. Shu sababli tadqiqotchilar juda ogʻir reasoning modellari oʻrniga nisbatan tejamkor Flash, Haiku va Nano sinfidagi tijoriy modellarni; mahalliy tomonda esa 1Bdan 7–8B parametrgacha boʻlgan modellarni tanlagan.
Tadqiqotning maqsadi har bir model oilasining eng katta versiyasini taqqoslash emas, balki moliyaviy yangiliklarni tasniflash miqyosida amalda qoʻllash mumkin boʻlgan modellar oʻrtasida amaliy taqqoslash oʻtkazishdir.
Tasniflash qanday amalga oshirildi?
Barcha yangilik sarlavhalarida bir xil standartlashtirilgan tasniflash mantiqi qoʻllanilgan. Modellardan har bir sarlavhani investorlar kutilmalari nuqtai nazaridan ijobiy, salbiy yoki noaniq/neytral deb tasniflash soʻralgan. Manba ish oqimida ushbu sinflar YES, NO va UNKNOWN chiqishlariga mos keladi.
Hisoblash samaradorligi uchun bitta soʻrovda koʻpi bilan 10 ta yangilik sarlavhasi qayta ishlangan. Tijoriy API modellarida temperature nolga oʻrnatilgan; mahalliy modellarda sampling oʻchirilib, greedy decoding qoʻllanilgan. Shu tariqa bir xil kirish uchun tasodifiy samplingdan kelib chiqadigan chiqish oʻzgaruvchanligi kamaytirilgan.
Ochiq vaznli modellar Hugging Face transformers kutubxonasi bilan mahalliy tarzda va FP16 yarim aniqlikda ishga tushirilgan. Tijoriy modellar esa provayder APIlari orqali ishlatilgan. Manba shuningdek tijoriy API xatti-harakati versiyalar oʻrtasida oʻzgarishi mumkinligini tan olgani uchun har bir modelning amaldagi kirish davrini texnik xususiyatlar jadvalida alohida qayd etgan.
Portfelga aylantirish qanday amalga oshirildi?
Oy \(t\) davomida toʻplangan va tasniflangan yangiliklar avval har bir kompaniya uchun oylik Sentiment Index qiymatiga aylantirilgan. Portfel oy \(t+1\)ning birinchi ish kunida tuzilgan. Shu tariqa ayni oyning kelajakdagi narx harakatlari signal yaratish uchun ishlatilmaydi.
Kompaniyalar Sentiment Index boʻyicha yuqoridan pastga saralangan. Portfel uchun minimal maqsad 15 ta aksiya etib belgilangan. Kesish nuqtasidagi kompaniyalar bir xil sentiment balliga ega boʻlsa, bir xil balli barcha aksiyalar portfelga kiritilgan; shu sababli haqiqiy portfel hajmi ayrim oylarda 15dan oshishi mumkin boʻlgan.
Har bir kompaniya bir oyda portfel tanloviga mos kelishi uchun kamida 15 ta yangilik sarlavhasiga ega boʻlishi talab qilingan. Bu qoida yangilik zichligi past kompaniyalarda haddan tashqari oʻzgaruvchan sentiment oʻlchovlarini kamaytirar ekan, namunani koʻproq yangilik oladigan yirik va koʻrinadigan kompaniyalar tomon ogʻdiradi.
Portfeldagi aksiyalar teng vaznlangan, bir oy ushlab turilgan va keyingi oyning birinchi ish kunida qayta muvozanatlashtirilgan. Daromadlar aksiya boʻlinishlari va dividendlarga moslashtirilgan yopilish narxlaridan hisoblangani uchun jami daromad xususiyatiga ega.
Benchmarklar
Ikki taqqoslash nuqtasi qoʻllanilgan. Birinchisi — har oy oʻsha oydagi faol S&P 500 aʼzolaridan tuzilgan teng vaznli S&P 500 portfeli. Ikkinchisi — ayni faol aʼzolardan tasodifiy tanlangan 15 aksiyali portfellarning 1.000 ta Monte Carlo tanlovining oʻrtacha qiymati.
Benchmark olami faqat yetarli yangilik olgan kompaniyalar bilan cheklanmagan. Shu sababli LLM portfellarining media koʻrinuvchanligi filtri natijalarda rol oʻynashi mumkinligi alohida hisobga olinishi kerak.
Tadqiqot Usuli va Natijalari
Samaradorlik metrikalari
Tadqiqot yilliklashtirilgan daromad, yilliklashtirilgan volatillik, Sharpe koeffitsiyenti, maksimal pasayish, bir omilli alpha va beta koʻrsatkichlarini beradi. Sharpe koeffitsiyentida risksiz foiz stavkasi nol deb qabul qilingan.
Alpha va beta har bir LLM strategiyasining oylik daromadlarini oylik S&P 500 EW daromadiga qarshi OLS regressiyasi orqali baholangan. Beta bozor benchmarkiga nisbatan sezgirlikni, alpha esa ushbu bir omilli munosabatda benchmark harakati bilan izohlanmaydigan daromad komponentini ifodalaydi.
2021–2025 asosiy samaradorlik natijalari
| Strategiya | Yillik daromad (%) | Volatillik (%) | Sharpe | Maksimal pasayish (%) | Alpha (%) | Beta |
|---|---|---|---|---|---|---|
| Claude 3 Haiku | 14,18 | 15,11 | 0,94 | -17,14 | 7,73 | 0,90 |
| Claude 4.5 Haiku | 12,61 | 14,34 | 0,88 | -18,49 | 6,66 | 0,82 |
| Gemini 2.5 Flash | 11,25 | 14,91 | 0,75 | -16,28 | 4,73 | 0,89 |
| GPT-4.1 Nano | 10,41 | 15,87 | 0,66 | -23,20 | 3,82 | 0,89 |
| Llama 3.1 8B | 11,53 | 15,50 | 0,74 | -20,34 | 4,77 | 0,92 |
| Mistral 7B | 7,68 | 15,00 | 0,51 | -20,39 | 0,79 | 0,92 |
| Llama 3.2 1B | 4,61 | 15,44 | 0,30 | -23,59 | -2,18 | 0,91 |
| S&P 500 EW | 7,46 | 15,67 | 0,48 | -21,45 | 0,00 | 1,00 |
| Random 15 oʻrtachasi | 7,42 | 15,69 | 0,47 | -21,58 | -0,05 | 1,00 |
Qaysi LLM eng yuqori portfel samaradorligini berdi?
Koʻrib chiqilgan 2021–2025 namunasida Claude 3 Haiku eng yuqori yilliklashtirilgan daromad, Sharpe koeffitsiyenti va bir omilli alpha kombinatsiyasini berdi: %14,18 daromad, 0,94 Sharpe va %7,73 alpha. Biroq tadqiqot model farqlarini formal alpha yoki Sharpe ahamiyatlilik testlari bilan taqqoslamagani sababli bu natija “Claude 3 Haiku statistik jihatdan barcha modellardan ustun” deb talqin qilinmasligi kerak.
Claude 3 Haiku va Claude 4.5 Haiku
Claude 3 Haiku eng yuqori daromad va alpha qiymatlarini bergan, uning vorisi Claude 4.5 Haiku esa %12,61 daromad, 0,88 Sharpe va %6,66 alpha bilan ikkinchi oʻrinni egallagan.
Claude 4.5 Haikuning volatilligi %14,34 va betasi 0,82 boʻlib, namunadagi eng past qiymatlar qatoriga kiradi. Shunga qaramay, eski Claude 3 Haikuning riskka moslashtirilgan daromadi yuqoriroq boʻlib qolgan. Tadqiqot bu holatni yangi model versiyasi ayni moliyaviy signal vazifasida avtomatik ravishda kuchliroq natija bermasligining misoli sifatida keltiradi.
Gemini 2.5 Flash va GPT-4.1 Nano
Gemini 2.5 Flash %11,25 yillik daromad va 0,75 Sharpe berdi. GPT-4.1 Nanoning yillik daromadi %10,41, Sharpe koeffitsiyenti esa 0,66. Har ikki strategiyaning bir omilli alpha qiymati ijobiy.
GPT-4.1 Nanoning maksimal pasayish qiymati -%23,20 boʻlib, S&P 500 EWning -%21,45 darajasidan yomonroq. Shu sababli benchmarkdan yuqori oʻrtacha daromad berishi har bir bozor sharoitida kamroq yoʻqotish degani emas.
Mahalliy ishga tushirilgan Llama 3.1 8B tijoriy APIlarga yaqinlasha oldimi?
Ha, koʻrib chiqilgan vazifa va davr ichida Llama 3.1 8B %11,53 yillik daromad, 0,74 Sharpe va %4,77 bir omilli alpha berib; ushbu qiymatlar bilan GPT-4.1 Nanodan yuqori va Gemini 2.5 Flashga yaqin natija koʻrsatgan. Natija mahalliy ishga tushirilishi mumkin boʻlgan model ushbu maxsus moliyaviy yangilik tasnifi vazifasida foydalanish mumkin boʻlgan muqobil boʻlishi mumkinligini qoʻllab-quvvatlaydi, ammo barcha ochiq vaznli modellar yoki barcha moliyaviy vazifalar tijoriy APIlarga teng ekanini isbotlamaydi.
Llama 3.1 8B bilan Mistral 7B oʻrtasidagi farq nimani koʻrsatadi?
Llama 3.1 8B bilan Mistral 7B oʻxshash parametr hajmi sinfida boʻlsa-da, ularning portfel natijalari sezilarli darajada farq qiladi. Llama 3.1 8B %11,53 daromad va 0,74 Sharpe bergan boʻlsa, Mistral 7B %7,68 va 0,51 darajasida qolgan.
Mualliflar bu farq model hajmining oʻzi yetarli tushuntiruvchi omil emasligini koʻrsatishini taʼkidlaydi. Oʻqitish maʼlumotlari va instruction-following qobiliyati ham moliyaviy matn tasnifida rol oʻynashi mumkin. Biroq 7–8B oraligʻida faqat ikkita model oʻrganilgani sababli bu natijani umumiy model-arxitektura qonuni sifatida talqin qilib boʻlmaydi.
1B model nega alohida baholanishi kerak?
Llama 3.2 1B %4,61 daromad va 0,30 Sharpe bilan ham S&P 500 EW, ham tasodifiy portfel benchmarkidan pastda qolgan, bir omilli alpha esa -%2,18 boʻlgan.
Manba ushbu natija 1B modelning axborotli sentimentni shovqindan ajratishda cheklanganroq boʻlishi mumkinligi bilan mos kelishini bildiradi. Ammo namunada faqat bitta 1B model boʻlgani sababli natijani “1 milliard parametrdan kichik modellar moliyaviy sentiment tahlilida muvaffaqiyatsiz” deb umumlashtirmaydi. Farq oʻsha modelning oʻqitish maʼlumotlari yoki instruction-following xususiyatlaridan ham kelib chiqishi mumkin.
Maksimal pasayish va 2022-yil ayiq bozori
Claude 3 Haiku, Claude 4.5 Haiku va Gemini 2.5 Flashning maksimal pasayishlari S&P 500 EW benchmarkidan kichikroq. GPT-4.1 Nano esa benchmarkdan chuqurroq maksimal pasayishni boshdan kechirgan.
Beta qiymatlarining aksariyati taxminan 0,82–0,92 oraligʻida boʻlishi LLM portfellari bozordan mustaqil emasligini, biroq ayrim strategiyalar S&P 500 EWga nisbatan pastroq bozor sezgirligiga ega ekanini anglatadi.
1-rasmning ilmiy xabari
Manbaning 1-rasmi barcha strategiyalarning 2021-yil boshidagi umumiy boshlangʻich darajadan boshlab kumulyativ boylik rivojlanishini koʻrsatadi. Eng kuchli model chiziqlari 2022-yilgi bozor pasayishi vaqtida benchmarklardan ajrala boshlagan va 2024–2025 davrida farq kengaygan.
Biroq mualliflar bu soʻnggi qismni faqat LLM signalining kuchi sifatida talqin qilmaydi. 2024–2025 davridagi yirik texnologiya kompaniyalarining kuchli natijalari media qamrovi yuqori kompaniyalarga moyil portfel olami bilan birga oʻlchangan farqning bir qismini izohlashi mumkin.
Rasmda Llama 3.2 1B strategiyasining chizigʻi namunaning katta qismida S&P 500 EWdan pastda qoladi. Ushbu vizual naqsh 3-jadvaldagi past yillik daromad, past Sharpe va manfiy alpha bilan mos keladi.
Alpha nega ehtiyotkor talqin qilinishi kerak?
Claude 3 Haikuning %7,73 va Llama 3.1 8Bning %4,77 yilliklashtirilgan alpha qiymatlari faqat S&P 500 EWning bitta bozor omilidan foydalangan holda hisoblangan.
Regressiya kompaniya hajmi, value, momentum, sektor vaznlari yoki boshqa maʼlum aktiv narxlash omillarini nazorat qilmaydi. Shu sababli ijobiy alphaning bir qismi yangilik sentimentidan tashqaridagi tizimli ekspozitsiyalardan kelib chiqishi mumkin.
Ayniqsa, eng koʻp yangilik oladigan kompaniyalarning yirik va koʻrinadigan kompaniyalar boʻlishi hamda 2024–2025 davridagi texnologiya aksiyalari samaradorligi ushbu talqin chegarasini muhim qiladi.
Tadqiqot kelajak haqidagi maʼlumotdan foydalanishni butunlay toʻxtatadimi?
Yoʻq. Tadqiqotchilar sarlavha sanalarini model kirishlaridan olib tashlagan, yangiliklarni vaqtga bogʻliq boʻlmagan batchlar shaklida qayta ishlagan va modellarga narx maʼlumotlarini bermagan; biroq ayrim modellarning bilim cutoff sanalari 2021–2025 namuna davri ichiga toʻgʻri kelgani sababli pre-training vaqtida ayrim kompaniya voqealarini ilgari koʻrgan boʻlish ehtimolini butunlay yoʻq qilish mumkin emas.
Look-ahead biasni kamaytirish qadamlari
Birinchi chora — LLM tasnifi paytida yangilik sanalarini model kirishidan olib tashlash. Ikkinchi chora — sarlavhalarni vaqt ketma-ketligi maʼlumotini tashimaydigan batchlar shaklida tasniflash. Uchinchidan, LLMlarga aksiya narxlari berilmagan.
Bu choralar model tasniflash paytida kelajakdagi narxni toʻgʻridan-toʻgʻri koʻrishiga yoʻl qoʻymaydi. Ammo model pre-training vaqtida muayyan kompaniya voqeasi yoki yangiligini ilgari koʻrgan boʻlishi mumkin. Bu xavf, ayniqsa modelning bilim cutoff sanasi oʻrganilayotgan yangilik sanasidan keyin boʻlsa, butunlay yoʻq qilinmaydi.
Post-cutoff nazorati
Mualliflar ushbu xavfni baholash uchun tahlilni modelning bilim cutoff sanasidan keyingi davrda takrorlagan. Eng yangi ikkita modelning post-cutoff davri ishonchli taqqoslash uchun juda qisqa boʻlgan. Boshqa modellarda alpha ishorasi toʻliq namunadagi ishorasini saqlagan.
Ushbu nazorat look-ahead muammosini kamaytiruvchi mustahkamlik tahlilini beradi; biroq kompaniya nomlarining model xotirasida yuzaga keltirishi mumkin boʻlgan entity-level taʼsirlarni bartaraf etmaydi. Mualliflarning kelajakdagi tadqiqot takliflaridan biri kompaniya nomlarini anonimlashtirib, semantik yangilik talqinini oʻrganilgan brend assotsiatsiyalaridan ajratishdir.
Tranzaksiya xarajatlari nega muhim kamchilik?
Portfellar har oy qayta muvozanatlashtiriladi; shunga qaramay, tadqiqot oldi-sotdi komissiyalari, bid-ask spread, bozor taʼsiri yoki boshqa tranzaksiya ishqalanishlarini natijalardan ayirmaydi.
Shu sababli 3-jadval strategiyaning yalpi samaradorligini koʻrsatadi. Tadqiqot sof investitsiya rentabelligini isbotlamaydi. Tranzaksiya xarajatlarini qoʻshish manba tomonidan bevosita kelajakdagi tadqiqot yoʻnalishi sifatida koʻrsatilgan.
Tijoriy va mahalliy modellar oʻrtasidagi xarajat taqqoslandimi?
Yoʻq. Maqola API xarajati, mahalliy GPU xarajati, energiya isteʼmoli, kechikish yoki apparat investitsiyasini miqdoriy jihatdan taqqoslamaydi. Tijoriy modellarning foydalanish qulayligi bilan mahalliy modellarning maʼlumot maxfiyligi va xarajat nazorati oʻrtasidagi farq muhokama qilinadi; biroq umumiy egalik qiymati oʻlchanmagan.
Shu sababli “Llama 3.1 8B arzonroq” yoki “tijoriy API tejamkorroq” degan manba tomonidan qoʻllab-quvvatlangan miqdoriy xulosa chiqarib boʻlmaydi.
Tadqiqot qoʻllab-quvvatlaydigan natijalar
- Moliyaviy yangilik sarlavhalaridan LLM asosidagi sentiment tasnifidan foydalanib rank-based oylik aksiya portfellarini tuzish mumkin.
- Koʻrib chiqilgan namunada yopiq modellar umuman olganda riskka moslashtirilgan eng yuqori natijalarni bergan.
- Claude 3 Haiku koʻrib chiqilgan modellar orasida eng yuqori Sharpe koeffitsiyenti va bir omilli alpha qiymatini bergan.
- Claude 4.5 Haiku eski Claude 3 Haikudan pastda qolishi yangi model versiyasi ayni vazifada avtomatik ravishda kuchliroq signal bermasligini koʻrsatadi.
- Llama 3.1 8B koʻrib chiqilgan vazifada Gemini 2.5 Flashga yaqin va GPT-4.1 Nanodan yuqori samaradorlik bergan.
- Llama 3.2 1B benchmarkdan oshmagan va manfiy bir omilli alpha bergan.
- Parametr hajmi oʻxshash Llama 3.1 8B bilan Mistral 7B oʻrtasidagi farq parametrlar sonining oʻzi samaradorlikni tushuntirmasligini koʻrsatadi.
Tadqiqot qoʻllab-quvvatlamaydigan natijalar
- Claude 3 Haiku barcha moliyaviy davrlarda yoki barcha bozorlarda eng yaxshi LLM ekani isbotlanmagan.
- Model strategiyalari oʻrtasidagi alpha yoki Sharpe farqlari statistik jihatdan ahamiyatli ekani koʻrsatilmagan.
- Hisobotda keltirilgan alphaning barchasi faqat yangilik sentimentidan kelib chiqqani isbotlanmagan.
- 1B modellar umuman olganda moliyaviy tasnif uchun yetarli emas degan xulosaga kelib boʻlmaydi; faqat bitta 1B model sinovdan oʻtkazilgan.
- Ochiq vaznli modellar barcha tijoriy API modellarining oʻrnini bosa olishi koʻrsatilmagan.
- Tranzaksiya xarajatlari hisobga olinmagani sababli strategiyalarning sof investitsiya rentabelligi isbotlanmagan.
- Pre-trainingdan kelib chiqadigan oʻtmish voqealari haqidagi bilim butunlay yoʻq qilingani koʻrsatilmagan.
- Natijalar individual investor uchun oldi-sotdi tavsiyasini tashkil etmaydi.
Kelajakdagi tadqiqot yoʻnalishlari
Manba uchta asosiy kengayish yoʻnalishini taklif qiladi. Birinchisi — tranzaksiya xarajatlari va boshqa bozor ishqalanishlarini portfel natijalariga qoʻshish. Ikkinchisi — generativ LLMlarni moliya sohasiga xos diskriminativ modellar, masalan FinBERTga oʻxshash encoder tuzilmalari bilan taqqoslash.
Uchinchi yoʻnalish — pre-trainingdan kelib chiqadigan kompaniya identifikatsiyasi haqidagi bilim. Kompaniya nomlarini anonimlashtirish model haqiqatan ham yangilik semantikasini talqin qilyaptimi yoki ilgari oʻrgangan kompaniya va brend assotsiatsiyalaridan foydalanayaptimi, shuni aniqroq ajratishi mumkin.
Manba va Usul Haqida Izoh
Toʻliq asl sarlavha: Open-Source versus Proprietary LLMs for Sentiment-Based Equity Portfolios.
Mualliflar: Felipe Affonso; Marcelo S. Perlin.
Muassasa: Escola de Administração, Departamento de Finanças, Universidade Federal do Rio Grande do Sul (UFRGS), Porto Alegre, Brazil.
Corresponding author: Felipe Affonso.
Manba turi: Preprint / taqrizdan oʻtmagan tadqiqot.
Maqsadli jurnal: PDFda “Preprint submitted to Economics Letters” iborasi mavjud.
Platforma: SSRN.
SSRN identifikatori: 7009844.
DOI: 10.2139/ssrn.7009844.
SSRN nashr sanasi: 27-iyun 2026.
Taqriz holati: Yuklangan PDF tadqiqot hali taqrizdan oʻtmaganini aniq bildiradi.
Ochiq litsenziya: Yuklangan PDF va tekshirilgan SSRN yozuvida Creative Commons yoki unga teng ochiq qayta foydalanish litsenziyasi tasdiqlanmagan. Shu sababli Verianla bayoni ilmiy faktlar asosida mustaqil tuzilgan; manba matni, asl jadval dizayni yoki 1-rasmning vizual kompozitsiyasi koʻchirilmagan.
Maʼlumot manbai: EOD Historical Data portalidan AQShda roʻyxatga olingan kompaniyalarga oid moliyaviy yangilik sarlavhalari.
Oʻrganilgan davr: Yanvar 2021–Dekabr 2025.
Dastlabki yangiliklar soni: 1.689.569.
Yakuniy analitik namuna: 1.477.385 sarlavha.
Kompaniyalar olami: Har bir oy uchun point-in-time tarixiy S&P 500 aʼzolari.
Yaqin dublikat filtri: Bir kompaniya va bir sanada normallashtirilgan Levenshtein oʻxshashligi 0,6dan yuqori boʻlgan sarlavha juftlari.
LLM vazifasi: Yangilik sarlavhalarini ijobiy, salbiy yoki neytral/noaniq deb tasniflash.
LLM soni: 7.
Yopiq modellar: GPT-4.1 Nano, Claude 3 Haiku, Claude 4.5 Haiku, Gemini 2.5 Flash.
Manbaning open-source/weights-available guruhidagi modellar: LLaMA 3.1 8B Instruct, LLaMA 3.2 1B Instruct, Mistral 7B Instruct v0.2.
Decoding: Yopiq API modellarida temperature = 0; mahalliy modellarda greedy decoding va do_sample=False.
Mahalliy inference: Hugging Face transformers va FP16.
Asosiy signal: Kompaniya darajasidagi oylik Sentiment Index.
Portfel qoidasi: Oldingi oyning sentiment balliga koʻra kamayuvchi tartiblash, minimal maqsad 15 ta aksiya, teng vaznlash, oylik qayta muvozanatlashtirish.
Media filtri: Har bir kompaniya-oy uchun kamida 15 ta yangilik.
Benchmarklar: S&P 500 Equal Weighted va faol S&P 500 aʼzolaridan 1.000 ta Monte Carlo tanlovining oʻrtachasi boʻlgan Random 15 portfeli.
Daromad turi: Boʻlinishlar va dividendlarga moslashtirilgan jami daromad.
Sharpe farazi: Risksiz foiz stavkasi nol.
Alpha/beta usuli: Oylik strategiya daromadlarining S&P 500 EW oylik daromadiga qarshi bir omilli OLS regressiyasi.
Formal model taqqoslash testi: Alpha va Sharpe farqlari uchun formal modellararo ahamiyatlilik testi hisobot qilinmagan; natijalar tavsifiy tarzda taqdim etilgan.
Look-ahead nazorati: Yangilik sanalari model kirishidan olib tashlangan, tasniflash vaqt ketma-ketligi maʼlumotini tashimaydigan batchlar bilan amalga oshirilgan va modellarga aksiya narxi berilmagan. Shunga qaramay, pre-training orqali voqealar haqidagi bilimni butunlay chiqarib tashlab boʻlmaydi.
Post-cutoff nazorati: Yetarli post-cutoff kuzatuvlarga ega modellarda alpha ishorasi toʻliq namunadagi ishorasini saqlagan; eng yangi ikkita model uchun oyna juda qisqa.
Moliyalashtirish: Coordenação de Aperfeiçoamento de Pessoal de Nível Superior – Brasil (CAPES), Finance Code 001.
Generativ sunʼiy intellekt bayonoti: Mualliflar yakuniy matnning oʻqilishini yaxshilash uchun Google Gemini ishlatganini, chiqishni koʻrib chiqib tahrir qilganini va maqola mazmuni uchun javobgarlikni oʻz zimmasiga olganini bildiradi.
Manfaatlar toʻqnashuvi: Yuklangan PDFda alohida manfaatlar toʻqnashuvi bayonoti hisobot qilinmagan.
CRediT / muallif hissalari: Yuklangan PDFda batafsil CRediT muallif hissasi bayonoti hisobot qilinmagan.
Maʼlumotlarning mavjudligi: Manba maʼlumot yetkazib beruvchisi koʻrsatilgan boʻlsa-da, PDFda alohida va ochiq maʼlumotlar mavjudligi boʻlimi hisobot qilinmagan.
Asosiy cheklovlar: Tranzaksiya xarajatlarining chiqarib tashlanishi; faqat bir omilli alpha ishlatilishi; model bilim cutoff sanalarining namuna bilan qisman ustma-ust tushishi; har bir kompaniya uchun minimal yangilik filtri media koʻrinuvchanligi yuqori firmalarga moyil boʻlishi; 2025-yilda maʼlumot yetkazib beruvchining yangilik ajratib olish jarayonidagi oʻzgarish; faqat yettita model oʻrganilishi; faqat bitta 1B model mavjudligi; API versiyalari vaqt oʻtishi bilan oʻzgarishi mumkinligi; xarajat, kechikish va apparat talablari miqdoriy oʻlchanmagani.
1-rasm: 2021–2025 kumulyativ boylik rivojlanishini model strategiyalari, S&P 500 EW va Random 15 benchmarki uchun taqqoslaydi. Eng kuchli strategiyalar 2022-yildan keyin benchmarkdan ajralgan, Llama 3.2 1B esa namunaning katta qismida benchmarkdan pastda qolgan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan