


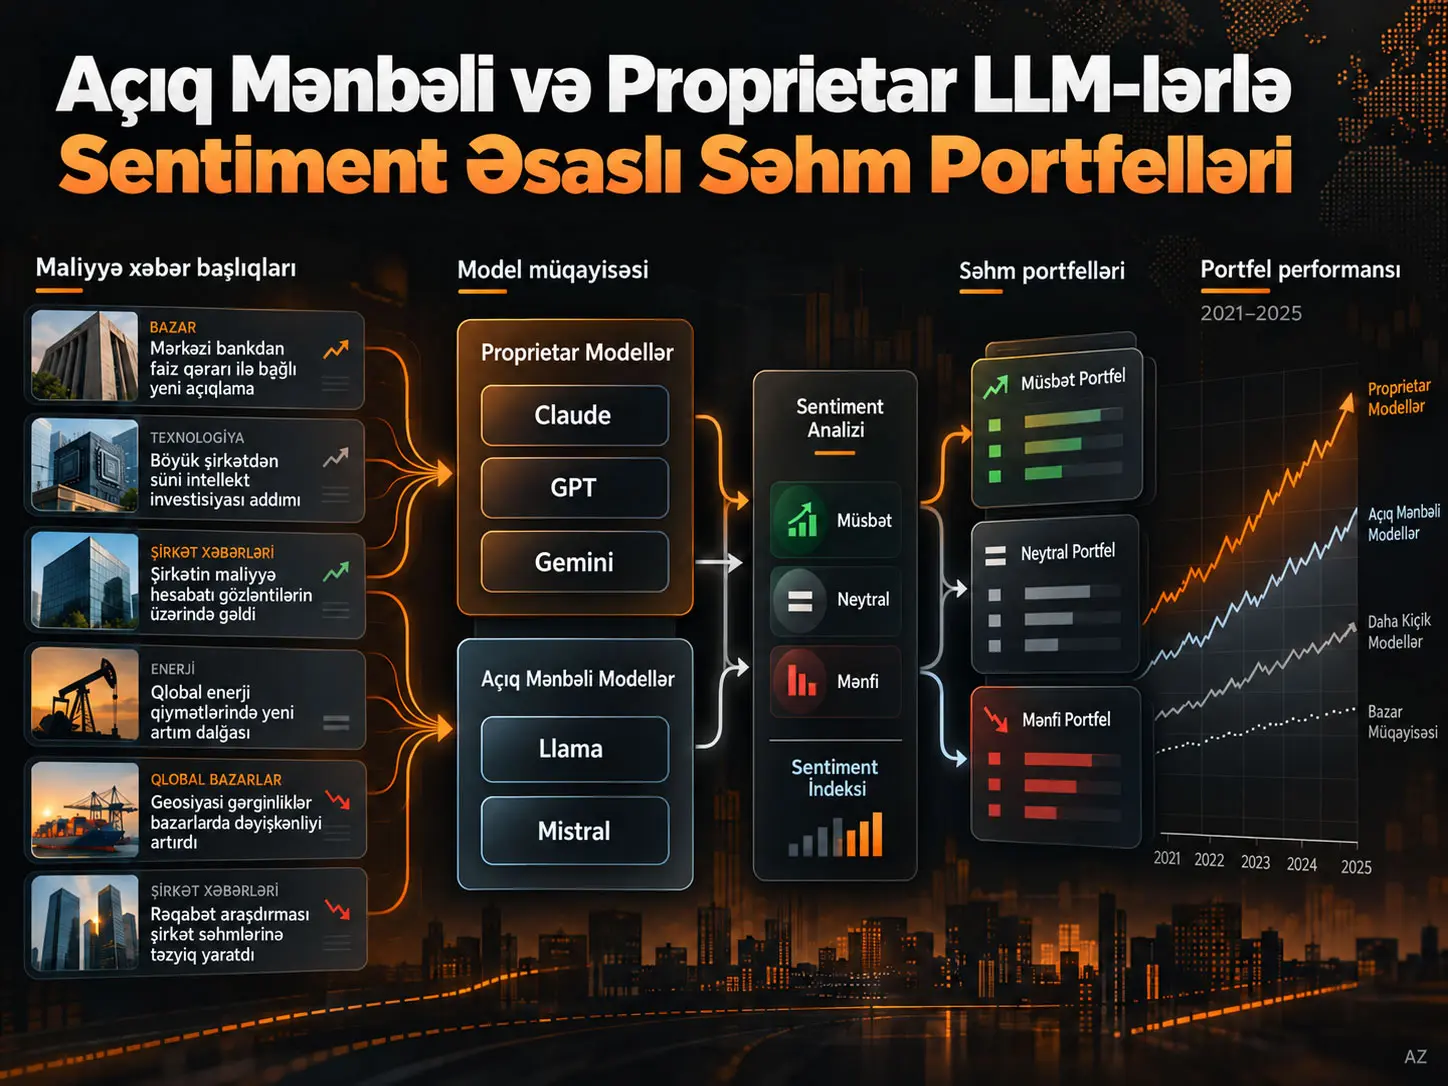
LLM əsaslı sentiment portfeli, maliyyə xəbərlərinin başlıqlarının böyük dil modelləri tərəfindən müsbət, mənfi və ya neytral kimi təsnif edilməsi və bu siniflərdən əldə edilən aylıq şirkət sentiment ballarının səhm seçimində istifadə olunması ilə yaradılan portfel yanaşmasıdır. Felipe Affonso və Marcelo S. Perlin 2021–2025 dövründə S&P 500 şirkətləri üçün təmizləmədən sonra qalan 1.477.385 xəbər başlığını yeddi böyük dil modeli ilə təsnif etmiş; dörd proprietar modeli və lokal olaraq işlədilə bilən, çəkiləri əlçatan üç modeli eyni rank-based portfel metodu altında müqayisə etmişdir. Mənbə nümunəsində riskə uyğunlaşdırılmış ən yüksək performans Claude 3 Haiku-dan gəldiyi halda, Llama 3.1 8B kommersiya API modellərinə yaxın nəticə vermiş; Llama 3.2 1B isə benchmarkı keçə bilməmişdir. Bununla belə, nəticələr konkret məlumatlar, dövr, prompt, model versiyası və portfel qaydası üçün keçərlidir; model strategiyaları arasındakı alpha və Sharpe fərqləri formal statistik üstünlük testləri ilə təsdiqlənməmişdir.
Tədqiqatın mühüm tərəfi yalnız “hansı LLM daha yüksək gəlir verdi?” sualı deyil. Araşdırma eyni maliyyə təsnifat tapşırığında model ailəsi, model tutumu, lokal işlədilə bilmə və kommersiya API çıxışı arasında praktik müqayisə aparır. Proprietar modellər ümumilikdə riskə uyğunlaşdırılmış ən yüksək gəlirləri yaratsa da, 8 milyard parametrli Llama 3.1-in Gemini 2.5 Flash-a yaxın və GPT-4.1 Nano-dan yüksək nəticə verməsi lokal işlədilən modelin müəyyən maliyyə mətn təsnifatı tapşırıqlarında istifadə oluna bilən alternativ ola biləcəyini göstərir.
Bu nəticə investisiya tövsiyəsi və ya gələcəkdə eyni gəlirlərin əldə ediləcəyinin sübutu deyil. Tədqiqat əməliyyat xərclərini, komissiyaları və bazar friksiyalarını nəzərə almır; alpha yalnız S&P 500 bərabər çəkili benchmarkına qarşı tək faktorludur; şirkət ölçüsü, value, momentum və sektor faktorlarına görə düzəliş edilməmişdir. Bundan əlavə, model bilik kəsim tarixlərinin məlumat dövrünün bir hissəsini əhatə etməsi keçmiş hadisələrə dair məlumatın pre-training vasitəsilə tam istisna olunmasına mane olur.
Tədqiqat problemi
Maliyyə bazarlarında mətn uzun müddətdir investisiya siqnalı kimi istifadə olunur. Ənənəvi lüğət əsaslı metodlar sözü ətrafındakı konteksti kifayət qədər nəzərə almadan müsbət və ya mənfi kimi təsnif edə bilər. Böyük dil modelləri isə xəbər başlığının kontekstini daha geniş şəkildə işləyə bildiyinə görə maliyyə sentimentinin çıxarılmasında fərqli yanaşma təqdim edir.
Bununla belə, əvvəlki tədqiqatların mühüm hissəsi yalnız bir proprietar model ailəsinə fokuslanmışdır. Bu, iki sualı açıq saxlayır: Müxtəlif kommersiya LLM-ləri eyni maliyyə xəbərlərində eyni investisiya siqnalını yaradırmı və lokal işlədilə bilən daha kiçik modellər ödənişli kommersiya API-lərinə nə qədər yaxınlaşa bilər?
Affonso və Perlin bu boşluğu eyni məlumat dəsti və eyni portfel qaydası altında yeddi LLM-i müqayisə etməklə araşdırır. Məqsəd bütün mövcud modellər üçün universal sıralama yaratmaq deyil. Tədqiqat seçilmiş proprietar və çəkiləri əlçatan modellərin eyni maliyyə mətn tapşırığında yaratdığı siqnalların portfel nəticələrini müqayisə edir.
Məlumat kainatı niyə dinamik S&P 500 üzvlüyünə əsaslanır?
Məlumat dəsti EOD Historical Data portalından alınmış ABŞ şirkətlərinə aid xəbər başlıqlarına əsaslanır. Tədqiqat 2021-ci ilin yanvarından 2025-ci ilin dekabrınadək olan dövrü araşdırır. Hər ay yalnız həmin ay həqiqətən S&P 500 üzvü olan şirkətlər istifadə edilmişdir; 2025-ci ilin sonundakı şirkət siyahısının keçmişə tətbiq olunması seçilməmişdir.
Bu məqam metodoloji baxımdan mühümdür. Yalnız dövrün sonundakı şirkətlərin keçmiş performansını araşdırmaq, sonradan indeksə daxil olan və ya daha əvvəl indeksdən çıxan şirkətləri yanlış şəkildə nəzərə alaraq seçim və sağqalma qərəzi yarada bilər. Point-in-time üzvlük yanaşması portfel kainatının hər tarixdə həmin tarixdə məlum olan indeks tərkibinə əsaslanmasını təmin edir.
1,69 milyon xəbər başlığından 1,48 milyonluq analitik nümunəyə
| Mərhələ | 2021 | 2022 | 2023 | 2024 | 2025 | Cəmi |
|---|---|---|---|---|---|---|
| İlkin çıxarılan başlıq | 246.365 | 281.361 | 291.426 | 230.335 | 640.082 | 1.689.569 |
| Çıxarılan metadata artefaktı | 5 | 18 | 1.997 | 6.406 | 0 | 8.426 |
| Çıxarılan yaxın dublikat | 41.657 | 21.757 | 28.952 | 19.899 | 91.493 | 203.758 |
| Yekun analitik nümunə | 204.703 | 259.586 | 260.477 | 204.030 | 548.589 | 1.477.385 |
Yaxın dublikatların müəyyənləşdirilməsində normallaşdırılmış Levenshtein oxşarlıq nisbəti istifadə edilmişdir. Eyni şirkətə və eyni günə aid iki başlığın oxşarlıq nisbəti 0,6-dan yüksəkdirsə, cütlərdən biri çıxarılmışdır. Eyni gün və eyni şirkət məhdudiyyəti, müxtəlif iqtisadi hadisələrə aid, lakin dil baxımından bir-birinə bənzəyən xəbərlərin səhvən silinməsi riskini azaltmaq üçün tətbiq edilmişdir.
2025-ci ildə xəbər həcminin sıçrayışı niyə mühümdür?
2025-ci ildə ilkin xəbər sayı 640.082-yə yüksəlmiş və əvvəlki illərin həcmindən nəzərəçarpacaq dərəcədə çox olmuşdur. Mənbəyə görə, məlumat təminatçısı bu dövrdə strukturlaşdırılmamış mənbələrdən xəbər çıxarmaq üçün böyük dil modelindən istifadə etməyə başlamışdır; lakin bu dəyişikliyin dəqiq başlanğıc tarixi dərc edilməmişdir.
Müəlliflər buna görə məlumat dəstini bölmək əvəzinə bütöv saxlamışdır. Onların əsaslandırmasına görə, istifadə edilən Sentiment Index hər şirkət-ay daxilində normallaşdırıldığı üçün təkcə xəbər sayının artması siqnal səviyyəsini mexaniki şəkildə dəyişmir. Bununla belə, məlumat istehsalı prosesindəki bu dəyişiklik dövrlərarası müqayisə aparılarkən nəzərə alınmalı olan məlumat mənbəyi xüsusiyyətidir.
Sentiment Index nəyi ölçür?
Sentiment Index müəyyən ayda bir şirkət haqqında təsnif edilmiş müsbət və mənfi xəbərlərin nisbi balansını -1 ilə +1 arasında ölçən normallaşdırılmış sentiment göstəricisidir. +1 yalnız müsbət, -1 isə yalnız mənfi təsnifatların üstünlük təşkil etdiyi ekstremal halları ifadə edir; göstərici xəbər həcminin mütləq səviyyəsindən çox, müsbət və mənfi xəbərlərin bir-birinə nisbətindən istifadə edir.
Şirkət \(i\) və ay \(t\) üçün istifadə olunan tənlik:
\[ SI_{i,t} = \frac{\sum POS-\sum NEG} {\sum POS+\sum NEG} \]
Burada \(POS\) müvafiq şirkət-ay üçün müsbət kimi təsnif edilmiş xəbərlərin sayını; \(NEG\) isə mənfi kimi təsnif edilmiş xəbərlərin sayını göstərir. Formulun surəti xalis sentiment istiqamətini, məxrəci isə müsbət və mənfi xəbərlərin ümumi həcmini normallaşdırır. Neytral kimi təsnif edilən xəbərlər bu formulun müsbət-mənfi balansına birbaşa daxil olmur.
Göstərici mütləq “səhm gəliri proqnozu” deyil. Növbəti mərhələdə yalnız şirkətlərin bir-birinə nəzərən sıralanmasını təmin edən nisbi siqnal kimi istifadə olunur.
Hansı LLM-lər müqayisə edildi?
| Qrup | Model | Mənbədə verilən parametr məlumatı | Kontekst pəncərəsi | Bilik kəsim tarixi / proxy |
|---|---|---|---|---|
| Proprietar | GPT-4.1 Nano | Açıqlanmayıb | 1M | İyun 2024 |
| Proprietar | Claude 3 Haiku | Açıqlanmayıb | 200k | Avqust 2023 |
| Proprietar | Claude 4.5 Haiku | Açıqlanmayıb | 200k | Fevral 2025 |
| Proprietar | Gemini 2.5 Flash | Açıqlanmayıb | 1M | Yanvar 2025 |
| Müəlliflərin “open-source” qrupu | LLaMA 3.1 8B Instruct | 8 milyard | 128k | Dekabr 2023 |
| Müəlliflərin “open-source” qrupu | LLaMA 3.2 1B Instruct | 1 milyard | 128k | Dekabr 2023 |
| Müəlliflərin “open-source” qrupu | Mistral 7B Instruct v0.2 | 7 milyard | 32k | Dekabr 2023 versiya tarixi proxy kimi istifadə edilmişdir |
Mənbə başlıqda və əsas mətndə Llama və Mistral modellərini “open-source” adlandırır; texniki xüsusiyyətlər cədvəlində isə bu qrup əlavə olaraq “Weights Available” kimi müəyyən edilir. Verianla mətni bu terminoloji fərqi dəyişdirmədən qoruyur.
Niyə daha qənaətli modellər seçildi?
Təxminən 1,5 milyon xəbər başlığının çoxsaylı modellərlə işlənməsi yüksək hesablama və API xərci yaradır. Tədqiqatçılar buna görə çox ağır reasoning modelləri əvəzinə nisbətən qənaətli Flash, Haiku və Nano sinifli kommersiya modellərini; lokal tərəfdə isə 1B ilə 7–8B parametr aralığındakı modelləri seçmişdir.
Tədqiqatın məqsədi hər model ailəsinin ən böyük versiyasını müqayisə etmək deyil, maliyyə xəbərlərinin təsnifatı miqyasında tətbiq oluna bilən modellər arasında praktik müqayisə aparmaqdır.
Təsnifat necə aparıldı?
Bütün xəbər başlıqlarında eyni standartlaşdırılmış təsnifat məntiqi istifadə edilmişdir. Modellərdən hər başlığı investor gözləntiləri baxımından müsbət, mənfi və ya qeyri-müəyyən/neytral kimi təsnif etmələri istənilmişdir. Mənbənin iş axınında bu siniflər YES, NO və UNKNOWN çıxışlarına uyğun gəlir.
Hesablama səmərəliliyi üçün eyni sorğuda ən çox 10 xəbər başlığı işlənmişdir. Kommersiya API modellərində temperature sıfıra təyin edilmiş; lokal modellərdə sampling söndürülərək greedy decoding tətbiq olunmuşdur. Beləliklə, eyni giriş üçün təsadüfi sampling-dən qaynaqlanan çıxış dəyişkənliyi azaldılmışdır.
Açıq çəkili modellər Hugging Face transformers kitabxanası ilə lokal olaraq və FP16 yarım dəqiqlikdə işlədilmişdir. Kommersiya modelləri isə təminatçı API-ləri üzərindən işlədilmişdir. Mənbə həmçinin kommersiya API davranışının versiyalar arasında dəyişə biləcəyini qəbul etdiyinə görə hər modelin real çıxış dövrünü texniki xüsusiyyətlər cədvəlində ayrıca hesabatlandırmışdır.
Portfelə çevrilmə necə aparıldı?
Ay \(t\) ərzində toplanan və təsnif edilən xəbərlər əvvəlcə hər şirkət üçün aylıq Sentiment Index dəyərinə çevrilmişdir. Portfel ay \(t+1\)-in ilk iş günündə yaradılmışdır. Beləliklə, eyni ayın gələcək qiymət hərəkətləri siqnal yaratmaq üçün istifadə edilmir.
Şirkətlər Sentiment Index-ə görə yüksəkdən aşağıya sıralanmışdır. Portfel üçün minimum hədəf 15 səhm müəyyən edilmişdir. Kəsim nöqtəsindəki şirkətlər eyni sentiment balına malik olduqda bütün eyni ballı səhmlər portfelə daxil edilmiş; buna görə faktiki portfel ölçüsü bəzi aylarda 15-i keçə bilmişdir.
Hər şirkətin bir ayda portfel seçiminə uyğun olması üçün ən azı 15 xəbər başlığına malik olması tələb edilmişdir. Bu qayda xəbər sıxlığı az olan şirkətlərdə həddən artıq dəyişkən sentiment ölçmələrini azaldarkən, nümunəni daha çox xəbər alan iri və görünən şirkətlərə doğru meylləndirir.
Portfeldəki səhmlər bərabər çəkiləndirilmiş, bir ay saxlanılmış və növbəti ayın ilk iş günündə yenidən balanslaşdırılmışdır. Gəlirlər həm səhm bölünmələrinə, həm də dividendlərə görə düzəldilmiş bağlanış qiymətlərindən hesablandığı üçün ümumi gəlir xarakteri daşıyır.
Benchmarklar
İki müqayisə nöqtəsi istifadə edilmişdir. Birincisi, hər ay həmin ayın aktiv S&P 500 üzvlərindən yaradılan bərabər çəkili S&P 500 portfelidir. İkincisi isə eyni aktiv üzvlərdən təsadüfi seçilmiş 15 səhmlik portfellərin 1.000 Monte Carlo çəkilişinin ortalamasıdır.
Benchmark kainatı yalnız kifayət qədər xəbəri olan şirkətlərlə məhdudlaşdırılmamışdır. Buna görə LLM portfellərinin media görünürlüğü filtrinin nəticələrdə rol oynaya biləcəyi ayrıca nəzərə alınmalıdır.
Tədqiqatın Metodu və Nəticələri
Performans metrikləri
Tədqiqat illikləşdirilmiş gəlir, illikləşdirilmiş volatillik, Sharpe nisbəti, maksimum düşüş, tək faktorlu alpha və beta hesabatlandırır. Sharpe nisbətində risksiz faiz dərəcəsi sıfır qəbul edilmişdir.
Alpha və beta hər LLM strategiyasının aylıq gəlirlərinin aylıq S&P 500 EW gəlirinə qarşı OLS reqressiyası ilə qiymətləndirilmişdir. Beta bazar benchmarkına qarşı həssaslığı, alpha isə bu tək faktorlu əlaqədə benchmark hərəkəti ilə izah olunmayan gəlir komponentini ifadə edir.
2021–2025 əsas performans nəticələri
| Strategiya | İllik gəlir (%) | Volatillik (%) | Sharpe | Maksimum düşüş (%) | Alpha (%) | Beta |
|---|---|---|---|---|---|---|
| Claude 3 Haiku | 14,18 | 15,11 | 0,94 | -17,14 | 7,73 | 0,90 |
| Claude 4.5 Haiku | 12,61 | 14,34 | 0,88 | -18,49 | 6,66 | 0,82 |
| Gemini 2.5 Flash | 11,25 | 14,91 | 0,75 | -16,28 | 4,73 | 0,89 |
| GPT-4.1 Nano | 10,41 | 15,87 | 0,66 | -23,20 | 3,82 | 0,89 |
| Llama 3.1 8B | 11,53 | 15,50 | 0,74 | -20,34 | 4,77 | 0,92 |
| Mistral 7B | 7,68 | 15,00 | 0,51 | -20,39 | 0,79 | 0,92 |
| Llama 3.2 1B | 4,61 | 15,44 | 0,30 | -23,59 | -2,18 | 0,91 |
| S&P 500 EW | 7,46 | 15,67 | 0,48 | -21,45 | 0,00 | 1,00 |
| Random 15 ortalaması | 7,42 | 15,69 | 0,47 | -21,58 | -0,05 | 1,00 |
Hansı LLM ən yüksək portfel performansını yaratdı?
Araşdırılan 2021–2025 nümunəsində Claude 3 Haiku ən yüksək illikləşdirilmiş gəlir, Sharpe nisbəti və tək faktorlu alpha kombinasiyasını yaratmışdır: %14,18 gəlir, 0,94 Sharpe və %7,73 alpha. Lakin tədqiqat model fərqlərini formal alpha və ya Sharpe əhəmiyyətlilik testləri ilə müqayisə etmədiyinə görə bu nəticə “Claude 3 Haiku statistik olaraq bütün modellərdən üstündür” şəklində şərh edilməməlidir.
Claude 3 Haiku və Claude 4.5 Haiku
Claude 3 Haiku ən yüksək gəlir və alpha dəyərlərini yaradarkən, onun xələfi Claude 4.5 Haiku %12,61 gəlir, 0,88 Sharpe və %6,66 alpha ilə ikinci yerdə qərarlaşmışdır.
Claude 4.5 Haiku-nun volatilliyi %14,34 və betası 0,82 ilə nümunədəki ən aşağı dəyərlər arasındadır. Buna baxmayaraq, daha köhnə Claude 3 Haiku-nun riskə uyğunlaşdırılmış gəliri daha yüksək qalmışdır. Tədqiqat bu vəziyyəti yeni model versiyasının eyni maliyyə siqnalı tapşırığında avtomatik olaraq daha güclü nəticə vermədiyinə nümunə kimi istifadə edir.
Gemini 2.5 Flash və GPT-4.1 Nano
Gemini 2.5 Flash %11,25 illik gəlir və 0,75 Sharpe yaratmışdır. GPT-4.1 Nano-nun illik gəliri %10,41, Sharpe nisbəti isə 0,66-dır. Hər iki strategiyanın tək faktorlu alpha dəyəri müsbətdir.
GPT-4.1 Nano-nun maksimum düşüş dəyəri -%23,20 olmaqla S&P 500 EW-nin -%21,45 səviyyəsindən daha pisdir. Buna görə benchmarkdan yüksək orta gəlir yaratması hər bazar şəraitində daha aşağı itki demək deyil.
Lokal işlədilən Llama 3.1 8B kommersiya API-lərinə yaxınlaşa bildimi?
Bəli, araşdırılan tapşırıq və dövr daxilində Llama 3.1 8B %11,53 illik gəlir, 0,74 Sharpe və %4,77 tək faktorlu alpha yaratmış; bu dəyərlərlə GPT-4.1 Nano-dan yüksək və Gemini 2.5 Flash-a yaxın performans göstərmişdir. Nəticə lokal işlədilə bilən modelin bu xüsusi maliyyə xəbərləri təsnifatı tapşırığında istifadə edilə bilən alternativ ola biləcəyini dəstəkləyir, lakin bütün açıq çəkili modellərin və ya bütün maliyyə tapşırıqlarının kommersiya API-ləri ilə ekvivalent olduğunu sübut etmir.
Llama 3.1 8B ilə Mistral 7B arasındakı fərq nə göstərir?
Llama 3.1 8B ilə Mistral 7B oxşar parametr ölçüsü sinfində olsa da, portfel performansları nəzərəçarpacaq dərəcədə fərqlidir. Llama 3.1 8B %11,53 gəlir və 0,74 Sharpe yaratdığı halda, Mistral 7B %7,68 və 0,51 səviyyəsində qalmışdır.
Müəlliflər bu fərqin model ölçüsünün təkbaşına kifayət qədər izahverici olmadığını düşündürdüyünü bildirirlər. Təlim məlumatları və instruction-following qabiliyyəti də maliyyə mətninin təsnifatında rol oynaya bilər. Bununla belə, 7–8B aralığında yalnız iki model araşdırıldığı üçün bu nəticə ümumi model-memarlıq qanunu kimi şərh edilə bilməz.
1B model niyə ayrıca qiymətləndirilməlidir?
Llama 3.2 1B %4,61 gəlir və 0,30 Sharpe ilə həm S&P 500 EW, həm də təsadüfi portfel benchmarkının altında qalmış, tək faktorlu alpha -%2,18 olmuşdur.
Mənbə bu nəticənin 1B modelin informativ sentimenti səs-küydən ayırmaqda daha məhdud ola biləcəyi ilə uyğun olduğunu bildirir. Lakin nümunədə yalnız bir 1B model olduğu üçün nəticəni “1 milyard parametrdən aşağı modellər maliyyə sentiment analizində uğursuzdur” şəklində ümumiləşdirmir. Fərq həmin modelin təlim məlumatlarından və ya instruction-following xüsusiyyətlərindən də qaynaqlana bilər.
Maksimum düşüş və 2022 ayı bazarı
Claude 3 Haiku, Claude 4.5 Haiku və Gemini 2.5 Flash-ın maksimum düşüşləri S&P 500 EW benchmarkından daha kiçikdir. GPT-4.1 Nano isə benchmarkdan daha dərin maksimum düşüş yaşamışdır.
Beta dəyərlərinin çoxunun təxminən 0,82–0,92 aralığında olması LLM portfellərinin bazardan müstəqil olmadığını, lakin bəzi strategiyaların S&P 500 EW-yə nisbətən daha aşağı bazar həssaslığı daşıdığını göstərir.
Şəkil 1-in elmi mesajı
Mənbənin Şəkil 1-i bütün strategiyaların 2021-ci ilin əvvəlindəki ortaq başlanğıc səviyyəsindən etibarən kumulyativ sərvət inkişafını göstərir. Ən güclü model xətləri 2022-ci il bazar geriləməsi zamanı benchmarklardan ayrılmağa başlamış və 2024–2025 dövründə fərq genişlənmişdir.
Lakin müəlliflər bu son hissəni yalnız LLM siqnalının gücü kimi şərh etmirlər. 2024–2025 dövründə iri texnologiya şirkətlərinin güclü performansı, media əhatəsi yüksək şirkətlərə yönələn portfel kainatı ilə birlikdə ölçülən fərqin bir hissəsini izah edə bilər.
Şəkildə Llama 3.2 1B strategiyasının xətti isə nümunənin böyük hissəsində S&P 500 EW-nin altında qalır. Bu vizual nümunə Cədvəl 3-dəki aşağı illik gəlir, aşağı Sharpe və mənfi alpha ilə uyğundur.
Alpha niyə ehtiyatla şərh edilməlidir?
Claude 3 Haiku-nun %7,73 və Llama 3.1 8B-nin %4,77 illikləşdirilmiş alpha dəyərləri yalnız S&P 500 EW-nin tək bazar faktorundan istifadə etməklə hesablanmışdır.
Reqressiya şirkət ölçüsü, value, momentum, sektor çəkiləri və ya digər məlum aktiv qiymətləndirmə faktorlarını nəzarətdə saxlamır. Buna görə müsbət alpha-nın bir hissəsi xəbər sentimentindən kənarda qalan sistematik ekspozisiyalardan qaynaqlana bilər.
Xüsusilə ən çox xəbər alan şirkətlərin iri və görünən şirkətlər olması və 2024–2025 dövründə texnologiya səhmlərinin performansı bu şərh məhdudiyyətini mühüm edir.
Tədqiqat gələcək məlumatdan istifadəni tamamilə əngəlləyirmi?
Xeyr. Tədqiqatçılar başlıq tarixlərini model girişlərindən çıxarmış, xəbərləri zamandan asılı olmayan batch-lər şəklində emal etmiş və modellərə qiymət məlumatı verməmişdir; lakin bəzi modellərin bilik kəsim tarixləri 2021–2025 nümunə dövrünün daxilinə düşdüyü üçün pre-training zamanı müəyyən şirkət hadisələrini görmüş olma ehtimalı tam aradan qaldırıla bilmir.
Look-ahead bias-ı azaltma addımları
Birinci tədbir LLM təsnifatı zamanı xəbər tarixlərinin model girişindən çıxarılmasıdır. İkinci tədbir başlıqların zaman sırası məlumatı daşımayan batch-lər şəklində təsnif edilməsidir. Üçüncü olaraq LLM-lərə səhm qiymətləri verilməmişdir.
Bu tədbirlər modelin təsnifat zamanı gələcək qiyməti birbaşa görməsinin qarşısını alır. Lakin model pre-training zamanı müəyyən şirkət hadisəsini və ya xəbəri əvvəllər görmüş ola bilər. Bu risk, xüsusilə modelin bilik kəsim tarixi araşdırılan xəbər tarixindən sonradırsa, tam aradan qaldırıla bilməz.
Post-cutoff yoxlaması
Müəlliflər bu riski qiymətləndirmək üçün analizi modelin bilik kəsim tarixindən sonrakı dövr üzrə təkrarlamışdır. Ən yeni iki modelin post-cutoff dövrü etibarlı müqayisə üçün çox qısa qalmışdır. Digər modellərdə alpha işarəsi tam nümunədəki işarəsini qorumuşdur.
Bu yoxlama look-ahead problemini azaldan möhkəmlik analizi təqdim edir; lakin şirkət adlarının model yaddaşında yarada biləcəyi entity-level təsirləri aradan qaldırmır. Müəlliflərin gələcək tədqiqat təkliflərindən biri şirkət adlarını anonimləşdirərək semantik xəbər şərhini öyrənilmiş marka assosiasiyalarından ayırmaqdır.
Əməliyyat xərcləri niyə mühüm çatışmazlıqdır?
Portfellər hər ay yenidən balanslaşdırılır; buna baxmayaraq, tədqiqat alqı-satqı komissiyalarını, bid-ask spread-i, bazar təsirini və ya digər əməliyyat friksiyalarını nəticələrdən çıxmır.
Buna görə Cədvəl 3 bruto strategiya performansını göstərir. Tədqiqat xalis investisiya gəlirliliyini sübut etmir. Əməliyyat xərclərinin əlavə edilməsi mənbə tərəfindən birbaşa gələcək tədqiqat sahəsi kimi göstərilir.
Kommersiya və lokal modellər arasındakı xərc müqayisə edildimi?
Xeyr. Məqalə API xərci, lokal GPU xərci, enerji istehlakı, gecikmə və ya aparat investisiyasını kəmiyyət baxımından müqayisə etmir. Kommersiya modellərinin istifadə rahatlığı ilə lokal modellərin məlumat məxfiliyi və xərc nəzarəti arasındakı fərq müzakirə olunur; lakin ümumi sahibolma xərci ölçülməmişdir.
Buna görə “Llama 3.1 8B daha ucuzdur” və ya “kommersiya API-si daha qənaətlidir” şəklində mənbə ilə dəstəklənən kəmiyyət nəticəsi çıxarıla bilməz.
Tədqiqatın dəstəklədiyi nəticələr
- Maliyyə xəbərlərinin başlıqlarından LLM əsaslı sentiment təsnifatı istifadə etməklə rank-based aylıq səhm portfelləri yaradıla bilər.
- Araşdırılan nümunədə proprietar modellər ümumilikdə riskə uyğunlaşdırılmış ən yüksək nəticələri yaratmışdır.
- Claude 3 Haiku araşdırılan modellər arasında ən yüksək Sharpe nisbəti və tək faktorlu alpha dəyərini yaratmışdır.
- Claude 4.5 Haiku-nun daha köhnə Claude 3 Haiku-dan aşağı qalması yeni model versiyasının eyni tapşırıqda avtomatik olaraq daha güclü siqnal yaratmadığını göstərir.
- Llama 3.1 8B araşdırılan tapşırıqda Gemini 2.5 Flash-a yaxın və GPT-4.1 Nano-dan yüksək performans yaratmışdır.
- Llama 3.2 1B benchmarkı keçməmiş və mənfi tək faktorlu alpha yaratmışdır.
- Oxşar parametr ölçüsündə olan Llama 3.1 8B ilə Mistral 7B arasındakı fərq parametr sayının təkbaşına performansı izah etmədiyini düşündürür.
Tədqiqatın dəstəkləmədiyi nəticələr
- Claude 3 Haiku-nun bütün maliyyə dövrlərində və ya bütün bazarlarda ən yaxşı LLM olduğu sübut edilməmişdir.
- Model strategiyaları arasındakı alpha və ya Sharpe fərqlərinin statistik baxımdan əhəmiyyətli olduğu göstərilməmişdir.
- Hesabatlandırılan alpha-nın hamısının yalnız xəbər sentimentindən qaynaqlandığı sübut edilməmişdir.
- 1B modellərin ümumilikdə maliyyə təsnifatı üçün yetərsiz olduğu nəticəsinə gəlmək olmaz; yalnız bir 1B model sınaqdan keçirilmişdir.
- Açıq çəkili modellərin bütün kommersiya API modellərini əvəz edə biləcəyi göstərilməmişdir.
- Əməliyyat xərcləri nəzərə alınmadığı üçün strategiyaların xalis investisiya gəlirliliyi sübut edilməmişdir.
- Pre-training-dən qaynaqlanan keçmiş hadisə məlumatının tam aradan qaldırıldığı göstərilməmişdir.
- Nəticələr fərdi investor üçün alqı-satqı tövsiyəsi təşkil etmir.
Gələcək tədqiqat istiqamətləri
Mənbə üç əsas genişlənmə sahəsi təklif edir. Birincisi, əməliyyat xərclərinin və digər bazar friksiyalarının portfel nəticələrinə əlavə edilməsidir. İkincisi, generativ LLM-lərin maliyyə sahəsinə xüsusi diskriminativ modellərlə, məsələn FinBERT tipli encoder strukturları ilə müqayisə edilməsidir.
Üçüncü sahə pre-training-dən qaynaqlanan şirkət kimliyi məlumatıdır. Şirkət adlarının anonimləşdirilməsi modelin həqiqətən xəbər semantikasını şərh etdiyini, yoxsa əvvəllər öyrəndiyi şirkət və marka assosiasiyalarından faydalandığını daha aydın ayıra bilər.
Mənbə və Metod Qeydi
Tam orijinal başlıq: Open-Source versus Proprietary LLMs for Sentiment-Based Equity Portfolios.
Müəlliflər: Felipe Affonso; Marcelo S. Perlin.
Qurum: Escola de Administração, Departamento de Finanças, Universidade Federal do Rio Grande do Sul (UFRGS), Porto Alegre, Brazil.
Corresponding author: Felipe Affonso.
Mənbə növü: Preprint / rəyçilikdən keçməmiş tədqiqat.
Hədəf jurnal: PDF-də “Preprint submitted to Economics Letters” ifadəsi yer alır.
Platforma: SSRN.
SSRN identifikatoru: 7009844.
DOI: 10.2139/ssrn.7009844.
SSRN nəşr tarixi: 27 iyun 2026.
Rəyçilik statusu: Yüklənmiş PDF tədqiqatın hələ rəyçilikdən keçmədiyini açıq şəkildə bildirir.
Açıq lisenziya: Yüklənmiş PDF-də və yoxlanılmış SSRN qeydində Creative Commons və ya ekvivalent açıq təkrar istifadə lisenziyası təsdiqlənməmişdir. Buna görə Verianla izahı elmi faktlar əsasında müstəqil şəkildə qurulmuş; mənbə mətni, orijinal cədvəl dizaynı və ya Şəkil 1-in vizual kompozisiyası kopyalanmamışdır.
Məlumat mənbəyi: EOD Historical Data portalından ABŞ-da listinqdə olan şirkətlərə aid maliyyə xəbərlərinin başlıqları.
Araşdırılan dövr: Yanvar 2021–Dekabr 2025.
İlkin xəbər sayı: 1.689.569.
Yekun analitik nümunə: 1.477.385 başlıq.
Şirkət kainatı: Hər ay üçün point-in-time tarixi S&P 500 üzvləri.
Yaxın dublikat filtri: Eyni şirkət və eyni tarixdə normallaşdırılmış Levenshtein oxşarlığı 0,6-dan yüksək olan başlıq cütləri.
LLM tapşırığı: Xəbər başlıqlarının müsbət, mənfi və ya neytral/qeyri-müəyyən kimi təsnif edilməsi.
LLM sayı: 7.
Proprietar modellər: GPT-4.1 Nano, Claude 3 Haiku, Claude 4.5 Haiku, Gemini 2.5 Flash.
Mənbənin open-source/weights-available qrupundakı modellər: LLaMA 3.1 8B Instruct, LLaMA 3.2 1B Instruct, Mistral 7B Instruct v0.2.
Decoding: Proprietar API modellərində temperature = 0; lokal modellərdə greedy decoding və do_sample=False.
Lokal inference: Hugging Face transformers və FP16.
Əsas siqnal: Aylıq şirkət səviyyəsində Sentiment Index.
Portfel qaydası: Əvvəlki ayın sentiment balına görə azalan sıralama, minimum hədəf 15 səhm, bərabər çəkiləndirmə, aylıq yenidən balanslaşdırma.
Media filtri: Şirkət-ay başına ən azı 15 xəbər.
Benchmarklar: S&P 500 Equal Weighted və aktiv S&P 500 üzvlərindən 1.000 Monte Carlo çəkilişinin ortalaması olan Random 15 portfeli.
Gəlir növü: Bölünmələrə və dividendlərə görə düzəldilmiş ümumi gəlir.
Sharpe fərziyyəsi: Risksiz faiz dərəcəsi sıfır.
Alpha/beta metodu: Aylıq strategiya gəlirlərinin S&P 500 EW aylıq gəlirinə qarşı tək faktorlu OLS reqressiyası.
Formal model müqayisə testi: Alpha və Sharpe fərqləri üçün formal modellərarası əhəmiyyətlilik testi hesabatlandırılmamışdır; nəticələr təsviri şəkildə təqdim olunur.
Look-ahead yoxlaması: Xəbər tarixləri model girişindən çıxarılmış, təsnifat zaman sırası məlumatı daşımayan batch-lərlə aparılmış və modellərə səhm qiyməti verilməmişdir. Bununla belə, pre-training vasitəsilə hadisə məlumatı tam istisna edilə bilmir.
Post-cutoff yoxlaması: Kifayət qədər post-cutoff müşahidəsi olan modellərdə alpha işarəsi tam nümunədəki işarəsini qorumuşdur; ən yeni iki model üçün pəncərə çox qısadır.
Maliyyələşdirmə: Coordenação de Aperfeiçoamento de Pessoal de Nível Superior – Brasil (CAPES), Finance Code 001.
Generativ süni intellekt bəyanatı: Müəlliflər yekun mətnin oxunaqlığını yaxşılaşdırmaq üçün Google Gemini istifadə etdiklərini, çıxışı nəzərdən keçirib redaktə etdiklərini və məqalənin məzmununa görə məsuliyyəti öz üzərlərinə götürdüklərini bəyan edirlər.
Maraqların toqquşması: Yüklənmiş PDF-də ayrıca maraqların toqquşması bəyanatı hesabatlandırılmamışdır.
CRediT / müəllif töhfələri: Yüklənmiş PDF-də ətraflı CRediT müəllif töhfəsi bəyanatı hesabatlandırılmamışdır.
Məlumat əlçatanlığı: Mənbə məlumat təminatçısı göstərilsə də, PDF-də ayrıca və açıq məlumat əlçatanlığı bölməsi hesabatlandırılmamışdır.
Əsas məhdudiyyətlər: Əməliyyat xərclərinin istisna edilməsi; yalnız tək faktorlu alpha-dan istifadə; model bilik kəsim tarixlərinin nümunə ilə qismən üst-üstə düşməsi; şirkət başına minimum xəbər filtrinin media görünürlüğü yüksək firmalara yönəlməsi; 2025-ci ildə məlumat təminatçısının xəbər çıxarma prosesində dəyişiklik; yalnız yeddi modelin araşdırılması; yalnız bir 1B modelin olması; API versiyalarının zamanla dəyişə bilməsi; xərc, gecikmə və aparat tələblərinin kəmiyyət baxımından ölçülməməsi.
Şəkil 1: 2021–2025 kumulyativ sərvət inkişafını model strategiyaları, S&P 500 EW və Random 15 benchmarkı üçün müqayisə edir. Ən güclü strategiyalar 2022-dən sonra benchmarkdan ayrılarkən, Llama 3.2 1B nümunənin böyük hissəsində benchmarkın altında qalır.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib