


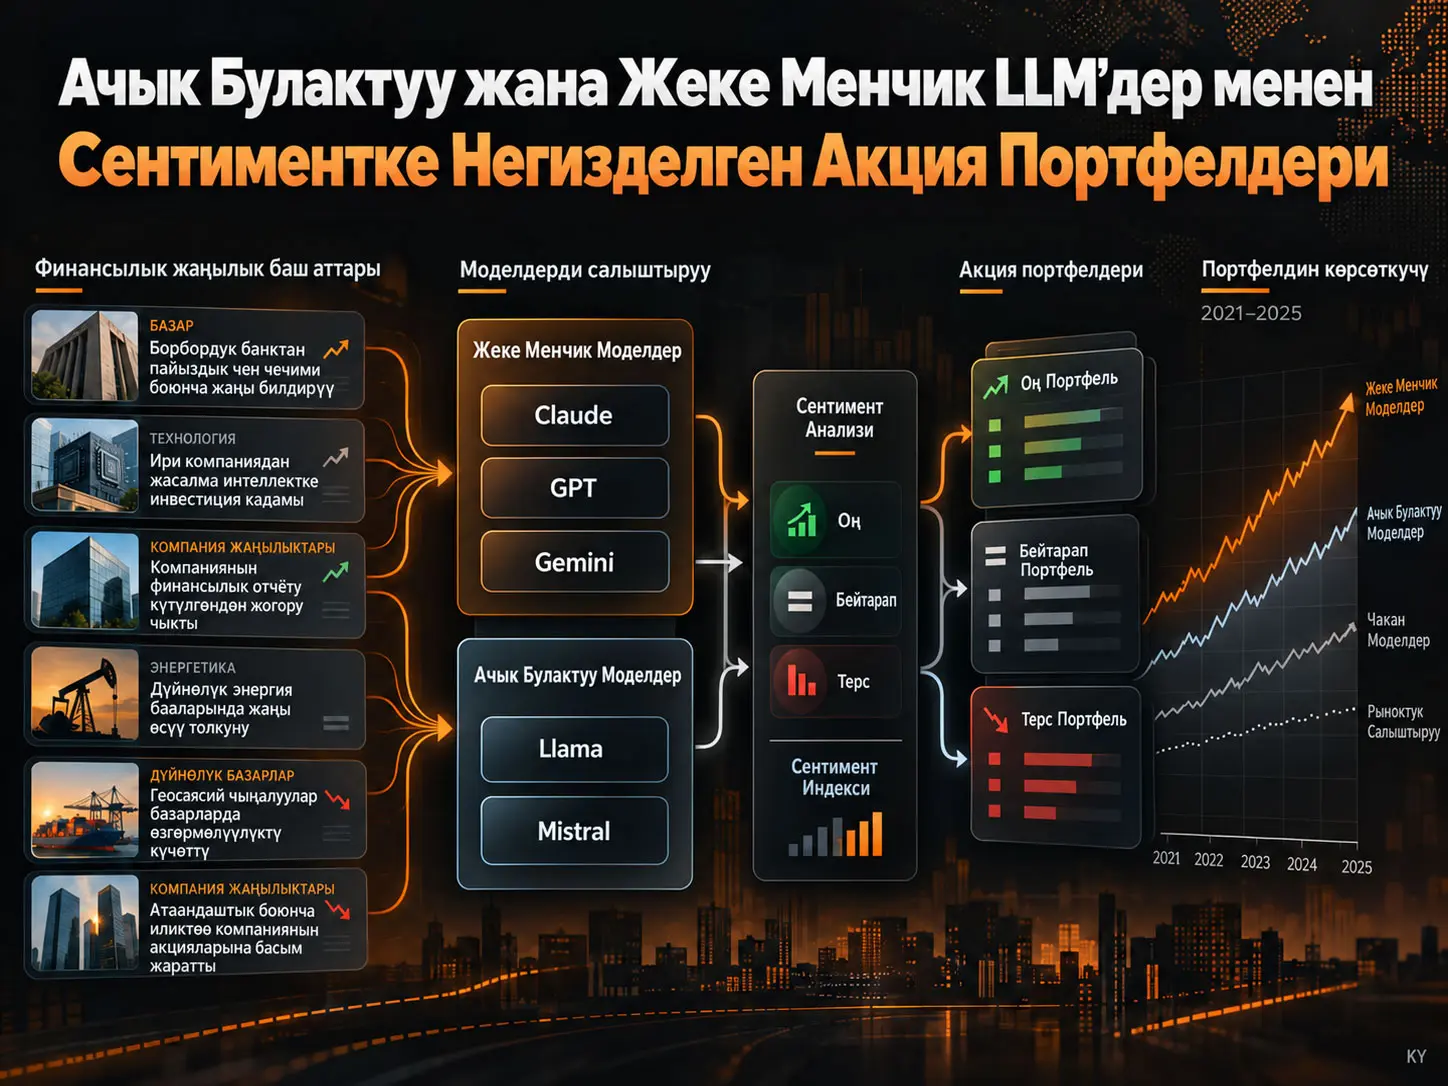
LLM негизиндеги сентимент портфели, финансылык жаңылык баш аттарын чоң тил моделдери оң, терс же нейтралдуу деп классификациялап, ушул класстардан алынган компаниялардын айлык сентимент упайларын акция тандоодо колдонуу аркылуу түзүлгөн портфель ыкмасы. Felipe Affonso жана Marcelo S. Perlin 2021–2025-жылдар аралыгында S&P 500 компаниялары үчүн тазалоодон кийин калган 1.477.385 жаңылык баш атын жети чоң тил модели менен классификациялап; төрт жеке менчик моделди жана жергиликтүү иштетүүгө боло турган, салмактары жеткиликтүү үч моделди бирдей rank-based портфель ыкмасынын алкагында салыштырышкан. Булактагы үлгүдө тобокелдикке ылайыкталган эң жогорку көрсөткүчтү Claude 3 Haiku берген, Llama 3.1 8B коммерциялык API моделдерине жакын жыйынтык чыгарган, ал эми Llama 3.2 1B benchmarkтан ашкан эмес. Ошол эле учурда жыйынтыктар белгилүү бир маалыматка, мезгилге, promptка, модель версиясына жана портфель эрежесине гана тиешелүү; модель стратегияларынын alpha жана Sharpe айырмачылыктары формалдуу статистикалык артыкчылык тесттери менен ырасталган эмес.
Изилдөөнүн маанилүү жагы бир гана “кайсы LLM жогорку киреше берди?” деген суроо эмес. Изилдөө бирдей финансылык классификация тапшырмасында модель үй-бүлөсү, моделдин кубаттуулугу, жергиликтүү иштетүү мүмкүнчүлүгү жана коммерциялык API жеткиликтүүлүгү ортосунда практикалык салыштыруу жүргүзөт. Жеке менчик моделдер жалпысынан тобокелдикке ылайыкталган эң жогорку кирешелерди бергени менен, 8 миллиард параметрлүү Llama 3.1 Gemini 2.5 Flashка жакын жана GPT-4.1 Nanoдон жогору жыйынтык бергени жергиликтүү иштетилген модель айрым финансылык текст классификациясы тапшырмаларында колдонууга жарамдуу альтернатива боло аларын көрсөтөт.
Бул жыйынтык инвестициялык кеңеш же келечекте ошол эле кирешелер алынарынын далили эмес. Изилдөө транзакциялык чыгымдарды, комиссияларды жана рыноктук сүрүлүүлөрдү эсепке албайт; alpha S&P 500 тең салмактуу benchmarkына карата бир факторлуу гана; компаниянын көлөмү, value, momentum жана сектор факторлору боюнча оңдолгон эмес. Мындан тышкары, моделдердин билим кесилген даталары маалымат мезгилинин бир бөлүгүн камтышы pre-training аркылуу өткөн окуялар тууралуу маалыматты толугу менен четтетүүгө мүмкүндүк бербейт.
Изилдөө маселеси
Финансылык рыноктордо текст көптөн бери инвестициялык сигнал катары колдонулуп келет. Салттуу сөздүккө негизделген ыкмалар сөздү анын айланасындагы контекстти жетиштүү эске албай туруп оң же терс деп классификациялашы мүмкүн. Чоң тил моделдери болсо жаңылык баш атынын контекстин кененирээк иштете алгандыктан, финансылык сентиментти чыгарууда башкача ыкма сунуштайт.
Ошол эле учурда мурдагы изилдөөлөрдүн олуттуу бөлүгү бир жеке менчик модель үй-бүлөсүнө гана көңүл бурган. Бул эки суроону ачык калтырат: ар башка коммерциялык LLMдер бир эле финансылык жаңылыктарда бирдей инвестициялык сигнал чыгарабы жана жергиликтүү иштетүүгө боло турган кичирээк моделдер акы төлөнүүчү коммерциялык APIлерге канчалык жакындай алат?
Affonso жана Perlin бул боштукту бир эле маалымат топтому жана бир эле портфель эрежеси алдында жети LLMди салыштыруу аркылуу карайт. Максат бардык жеткиликтүү моделдер үчүн универсалдуу рейтинг түзүү эмес. Изилдөө тандалган жеке менчик жана салмактары жеткиликтүү моделдер бир эле финансылык текст тапшырмасында түзгөн сигналдардын портфель жыйынтыктарын салыштырат.
Маалымат ааламы эмне үчүн динамикалык S&P 500 мүчөлүгүнө негизделет?
Маалымат топтому EOD Historical Data порталынан алынган АКШ компанияларынын жаңылык баш аттарына негизделет. Изилдөө 2021-жылдын январынан 2025-жылдын декабрына чейинки мезгилди карайт. Ар бир айда ошол айда чындап S&P 500 мүчөсү болгон компаниялар гана колдонулган; 2025-жылдын аягындагы компаниялар тизмесин өткөнгө колдонуу тандалган эмес.
Бул жагдай методологиялык жактан маанилүү. Мезгилдин аягындагы компаниялардын гана өткөн көрсөткүчтөрүн изилдөө кийин индекс курамына кирген же мурда индекс курамынан чыккан компанияларды туура эмес эсепке алып, тандоо жана survivorship bias жаратышы мүмкүн. Point-in-time мүчөлүк ыкмасы портфель ааламы ар бир датада ошол учурда белгилүү болгон индекс курамына таянышын камсыздайт.
1,69 миллион жаңылык баш атынан 1,48 миллиондук аналитикалык үлгүгө
| Этап | 2021 | 2022 | 2023 | 2024 | 2025 | Жалпы |
|---|---|---|---|---|---|---|
| Баштапкы алынган баш ат | 246.365 | 281.361 | 291.426 | 230.335 | 640.082 | 1.689.569 |
| Алынып салынган metadata артефакты | 5 | 18 | 1.997 | 6.406 | 0 | 8.426 |
| Алынып салынган жакын дубликат | 41.657 | 21.757 | 28.952 | 19.899 | 91.493 | 203.758 |
| Акыркы аналитикалык үлгү | 204.703 | 259.586 | 260.477 | 204.030 | 548.589 | 1.477.385 |
Жакын дубликаттарды аныктоодо нормалдаштырылган Levenshtein окшоштук коэффициенти колдонулган. Бир компанияга жана бир күнгө тиешелүү эки баш аттын окшоштук коэффициенти 0,6дан жогору болсо, жуптардын бири алынып салынган. Бир күн жана бир компания чектөөсү ар башка экономикалык окуяларга тиешелүү, бирок тил жагынан бири-бирине окшош жаңылыктардын жаңылыш өчүрүлүү тобокелдигин азайтуу үчүн колдонулган.
2025-жылдагы жаңылык көлөмүнүн секириги эмне үчүн маанилүү?
2025-жылы баштапкы жаңылык саны 640.082ге чейин өсүп, мурунку жылдардын көлөмүнөн кыйла жогору болгон. Булакка ылайык, маалымат берүүчү ушул мезгилде структураланбаган булактардан жаңылык чыгаруу үчүн чоң тил моделин колдоно баштаган; бирок бул өзгөрүүнүн так башталган датасы жарыяланган эмес.
Авторлор ушул себептен маалымат топтомун бөлбөй, толугу менен сакташкан. Алардын жүйөсү: колдонулган Sentiment Index ар бир компания-ай ичинде нормалдаштырылгандыктан, жаңылык санынын жөн гана көбөйүшү сигнал деңгээлин механикалык түрдө өзгөртпөйт. Бирок маалымат өндүрүү процессиндеги бул өзгөрүү мезгилдерди салыштырганда эске алынышы керек болгон маалымат булагынын өзгөчөлүгү.
Sentiment Index эмнени өлчөйт?
Sentiment Index — белгилүү бир айда компания тууралуу оң жана терс деп классификацияланган жаңылыктардын салыштырмалуу балансын -1ден +1ге чейин өлчөгөн нормалдаштырылган сентимент көрсөткүчү. +1 оң классификациялар гана, -1 терс классификациялар гана үстөмдүк кылган чектүү учурларды билдирет; көрсөткүч жаңылык көлөмүнүн абсолюттук деңгээлинен көрө оң жана терс жаңылыктардын бири-бирине катышын колдонот.
Компания \(i\) жана ай \(t\) үчүн колдонулган теңдеме:
\[ SI_{i,t} = \frac{\sum POS-\sum NEG} {\sum POS+\sum NEG} \]
Бул жерде \(POS\) тиешелүү компания-ай үчүн оң деп классификацияланган жаңылыктардын санын, \(NEG\) терс деп классификацияланган жаңылыктардын санын көрсөтөт. Формуланын алымы таза сентимент багытын, бөлүмү болсо оң жана терс жаңылыктардын жалпы көлөмүн нормалдаштырат. Нейтралдуу деп классификацияланган жаңылыктар формуланын оң-терс балансына түз кирбейт.
Көрсөткүч абсолюттук “акция кирешесинин божомолу” эмес. Кийинки этапта ал компанияларды бири-бирине салыштырмалуу иреттөөгө гана кызмат кылган салыштырмалуу сигнал катары колдонулат.
Кайсы LLMдер салыштырылды?
| Топ | Model | Булакта берилген параметр маалыматы | Контекст терезеси | Билимдин кесилген датасы / proxy |
|---|---|---|---|---|
| Жеке менчик | GPT-4.1 Nano | Ачыкталган эмес | 1M | Июнь 2024 |
| Жеке менчик | Claude 3 Haiku | Ачыкталган эмес | 200k | Август 2023 |
| Жеке менчик | Claude 4.5 Haiku | Ачыкталган эмес | 200k | Февраль 2025 |
| Жеке менчик | Gemini 2.5 Flash | Ачыкталган эмес | 1M | Январь 2025 |
| Авторлордун “open-source” тобу | LLaMA 3.1 8B Instruct | 8 миллиард | 128k | Декабрь 2023 |
| Авторлордун “open-source” тобу | LLaMA 3.2 1B Instruct | 1 миллиард | 128k | Декабрь 2023 |
| Авторлордун “open-source” тобу | Mistral 7B Instruct v0.2 | 7 миллиард | 32k | Декабрь 2023 версия датасы proxy катары колдонулган |
Булак баш атта жана негизги текстте Llama менен Mistral моделдерин “open-source” деп атайт; техникалык мүнөздөмөлөр таблицасында бул топ кошумча “Weights Available” деп аныкталган. Verianla тексти бул терминологиялык айырманы өзгөртпөстөн сактайт.
Эмне үчүн үнөмдүү моделдер тандалды?
Болжол менен 1,5 миллион жаңылык баш атын көп сандагы моделдер менен иштетүү чоң эсептөө жана API чыгымын жаратат. Ошондуктан изилдөөчүлөр өтө оор reasoning моделдеринин ордуна салыштырмалуу үнөмдүү Flash, Haiku жана Nano класстарындагы коммерциялык моделдерди; жергиликтүү тарапта болсо 1Bден 7–8B параметрге чейинки моделдерди тандашкан.
Изилдөөнүн максаты ар бир модель үй-бүлөсүнүн эң чоң версиясын салыштыруу эмес, финансылык жаңылыктарды классификациялоо масштабына ылайыктуу моделдердин ортосунда практикалык салыштыруу жүргүзүү.
Классификация кантип жүргүзүлдү?
Бардык жаңылык баш аттары үчүн бирдей стандартташтырылган классификация логикасы колдонулган. Моделдерден ар бир баш атты инвесторлордун күтүүлөрү жагынан оң, терс же белгисиз/нейтралдуу деп классификациялоо суралган. Булактагы иш агымында бул класстар YES, NO жана UNKNOWN чыгууларына туура келет.
Эсептөө натыйжалуулугу үчүн бир эле суроо-талапта эң көп 10 жаңылык баш аты иштетилген. Коммерциялык API моделдеринде temperature нөлгө коюлган; жергиликтүү моделдерде sampling өчүрүлүп, greedy decoding колдонулган. Ошентип, бир эле киргизүү үчүн кокустук samplingден келип чыккан чыгуу өзгөрмөлүүлүгү азайтылган.
Ачык салмактуу моделдер Hugging Face transformers китепканасы менен жергиликтүү түрдө жана FP16 жарым тактыкта иштетилген. Коммерциялык моделдер болсо камсыздоочулардын APIлери аркылуу иштетилген. Булак ошондой эле коммерциялык API жүрүм-туруму версиялар арасында өзгөрүшү мүмкүн экенин кабыл алгандыктан, ар бир моделдин чыныгы жеткиликтүүлүк мезгилин техникалык мүнөздөмөлөр таблицасында өзүнчө көрсөткөн.
Портфелге айландыруу кантип жүргүзүлдү?
Ай \(t\) ичинде чогултулган жана классификацияланган жаңылыктар адегенде ар бир компания үчүн айлык Sentiment Index маанисине айландырылган. Портфель ай \(t+1\)дин биринчи иш күнүндө түзүлгөн. Ошентип, ошол эле айдын келечектеги баа кыймылдары сигнал түзүү үчүн колдонулбайт.
Компаниялар Sentiment Index боюнча жогорудан төмөнгө иреттелген. Портфель үчүн минималдуу максат 15 акция деп белгиленген. Кесүү чекитиндеги компаниялар бирдей сентимент упайына ээ болсо, бардык бирдей упайлуу акциялар портфелге киргизилген; ошондуктан чыныгы портфель көлөмү айрым айларда 15тен ашышы мүмкүн болгон.
Ар бир компания бир айда портфель тандоосуна жарамдуу болушу үчүн кеминде 15 жаңылык баш атына ээ болушу талап кылынган. Бул эреже жаңылык тыгыздыгы төмөн компанияларда өтө өзгөрмөлүү сентимент өлчөөлөрүн азайтса, үлгүнү жаңылыгы көбүрөөк чыккан ири жана көрүнүктүү компанияларга карай оодарат.
Портфелдеги акциялар тең салмакталган, бир ай кармалган жана кийинки айдын биринчи иш күнүндө кайра тең салмакталган. Кирешелер акция бөлүнүүлөрүнө жана дивиденддерге ылайык оңдолгон жабылуу бааларынан эсептелгендиктен, жалпы киреше мүнөзүндө.
Benchmarkтар
Эки салыштыруу чекити колдонулган. Биринчиси — ар айда ошол айдагы активдүү S&P 500 мүчөлөрүнөн түзүлгөн тең салмактуу S&P 500 портфели. Экинчиси — ошол эле активдүү мүчөлөрдөн кокус тандалган 15 акциялык портфелдердин 1.000 Monte Carlo тартуусунун орточо мааниси.
Benchmark ааламы жетиштүү жаңылыгы бар компаниялар менен гана чектелген эмес. Ошондуктан LLM портфелдеринин медиа көрүнүктүүлүк фильтри жыйынтыктарда роль ойношу мүмкүн экени өзүнчө эске алынышы керек.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Иш натыйжалуулугунун метрикалары
Изилдөө жылдыкташтырылган киреше, жылдык волатилдүүлүк, Sharpe коэффициенти, максималдуу төмөндөө, бир факторлуу alpha жана beta көрсөткүчтөрүн берет. Sharpe коэффициентинде тобокелсиз пайыздык чен нөл деп кабыл алынган.
Alpha жана beta ар бир LLM стратегиясынын айлык кирешелерин айлык S&P 500 EW кирешесине каршы OLS регрессиясы аркылуу бааланган. Beta рынок benchmarkына болгон сезимталдыкты, alpha болсо бул бир факторлуу байланышта benchmark кыймылы менен түшүндүрүлбөгөн киреше компонентин билдирет.
2021–2025 негизги иш натыйжалары
| Стратегия | Жылдык киреше (%) | Волатилдүүлүк (%) | Sharpe | Максималдуу төмөндөө (%) | Alpha (%) | Beta |
|---|---|---|---|---|---|---|
| Claude 3 Haiku | 14,18 | 15,11 | 0,94 | -17,14 | 7,73 | 0,90 |
| Claude 4.5 Haiku | 12,61 | 14,34 | 0,88 | -18,49 | 6,66 | 0,82 |
| Gemini 2.5 Flash | 11,25 | 14,91 | 0,75 | -16,28 | 4,73 | 0,89 |
| GPT-4.1 Nano | 10,41 | 15,87 | 0,66 | -23,20 | 3,82 | 0,89 |
| Llama 3.1 8B | 11,53 | 15,50 | 0,74 | -20,34 | 4,77 | 0,92 |
| Mistral 7B | 7,68 | 15,00 | 0,51 | -20,39 | 0,79 | 0,92 |
| Llama 3.2 1B | 4,61 | 15,44 | 0,30 | -23,59 | -2,18 | 0,91 |
| S&P 500 EW | 7,46 | 15,67 | 0,48 | -21,45 | 0,00 | 1,00 |
| Random 15 орточо мааниси | 7,42 | 15,69 | 0,47 | -21,58 | -0,05 | 1,00 |
Кайсы LLM эң жогорку портфель көрсөткүчүн берди?
Каралган 2021–2025 үлгүсүндө Claude 3 Haiku жылдыкташтырылган киреше, Sharpe коэффициенти жана бир факторлуу alpha боюнча эң жогорку айкалышты берген: %14,18 киреше, 0,94 Sharpe жана %7,73 alpha. Бирок изилдөө моделдердин айырмаларын формалдуу alpha же Sharpe маанилүүлүк тесттери менен салыштырбагандыктан, бул жыйынтыкты “Claude 3 Haiku статистикалык жактан бардык моделдерден жогору” деп чечмелөөгө болбойт.
Claude 3 Haiku жана Claude 4.5 Haiku
Claude 3 Haiku эң жогорку киреше жана alpha маанилерин берген, ал эми анын мураскери Claude 4.5 Haiku %12,61 киреше, 0,88 Sharpe жана %6,66 alpha менен экинчи орунда калган.
Claude 4.5 Haikuнун волатилдүүлүгү %14,34 жана beta көрсөткүчү 0,82 болуп, үлгүдөгү эң төмөн маанилердин катарында. Ошого карабастан, мурдагы Claude 3 Haikuнун тобокелдикке ылайыкталган кирешеси жогору бойдон калган. Изилдөө муну жаңы модель версиясы ошол эле финансылык сигнал тапшырмасында автоматтык түрдө күчтүүрөөк жыйынтык бербешинин мисалы катары колдонот.
Gemini 2.5 Flash жана GPT-4.1 Nano
Gemini 2.5 Flash %11,25 жылдык киреше жана 0,75 Sharpe берген. GPT-4.1 Nanoнун жылдык кирешеси %10,41, Sharpe коэффициенти 0,66. Эки стратегиянын тең бир факторлуу alpha мааниси оң.
GPT-4.1 Nanoнун максималдуу төмөндөө мааниси -%23,20 болуп, S&P 500 EWнин -%21,45 деңгээлинен начар. Демек, benchmarkтан жогору орточо киреше бергени ар бир рынок шартында төмөн жоготуу болот дегенди билдирбейт.
Жергиликтүү иштетилген Llama 3.1 8B коммерциялык APIлерге жакындай алдыбы?
Ооба, каралган тапшырма жана мезгил ичинде Llama 3.1 8B %11,53 жылдык киреше, 0,74 Sharpe жана %4,77 бир факторлуу alpha берип; бул көрсөткүчтөр менен GPT-4.1 Nanoдон жогору жана Gemini 2.5 Flashка жакын көрсөткүч көрсөткөн. Жыйынтык жергиликтүү иштетүүгө боло турган модель ушул өзгөчө финансылык жаңылык классификациясы тапшырмасында колдонууга жарамдуу альтернатива боло аларын колдойт, бирок бардык ачык салмактуу моделдер же бардык финансылык тапшырмалар коммерциялык APIлерге барабар экенин далилдебейт.
Llama 3.1 8B менен Mistral 7B ортосундагы айырма эмнени көрсөтөт?
Llama 3.1 8B менен Mistral 7B параметр көлөмү жагынан окшош класста болгону менен, алардын портфель көрсөткүчтөрү кыйла айырмаланат. Llama 3.1 8B %11,53 киреше жана 0,74 Sharpe бергенде, Mistral 7B %7,68 жана 0,51 деңгээлинде калган.
Авторлор бул айырма моделдин көлөмү жалгыз өзү жетиштүү түшүндүрүүчү фактор эмес экенин көрсөтөт деп белгилешет. Окутуу маалыматтары жана instruction-following жөндөмү да финансылык текст классификациясында роль ойношу мүмкүн. Бирок 7–8B диапазонунда болгону эки модель изилденгендиктен, бул жыйынтыкты жалпы модель-архитектура мыйзамы катары чечмелөөгө болбойт.
1B модель эмне үчүн өзүнчө бааланышы керек?
Llama 3.2 1B %4,61 киреше жана 0,30 Sharpe менен S&P 500 EW жана кокустук портфель benchmarkынан да төмөн калып, бир факторлуу alpha -%2,18 болгон.
Булак бул жыйынтык 1B модель маалыматтуу сентиментти ызы-чуудан ажыратууда чектелүү болушу мүмкүн деген ойго шайкеш экенин белгилейт. Бирок үлгүдө бир гана 1B модель болгондуктан, муну “1 миллиард параметрден төмөн моделдер финансылык сентимент анализинде ийгиликсиз” деп жалпылабайт. Айырма ошол моделдин окутуу маалыматтарынан же instruction-following өзгөчөлүктөрүнөн да келип чыгышы мүмкүн.
Максималдуу төмөндөө жана 2022-жылдагы аюу рыногу
Claude 3 Haiku, Claude 4.5 Haiku жана Gemini 2.5 Flashтын максималдуу төмөндөөлөрү S&P 500 EW benchmarkынан кичине. GPT-4.1 Nano болсо benchmarkка караганда тереңирээк максималдуу төмөндөөгө дуушар болгон.
Beta маанилеринин көпчүлүгү болжол менен 0,82–0,92 диапазонунда болушу LLM портфелдери рыноктон көз карандысыз эмес экенин, бирок айрым стратегиялар S&P 500 EWге салыштырмалуу төмөнүрөөк рыноктук сезимталдыкка ээ экенин билдирет.
1-сүрөттүн илимий билдирүүсү
Булактын 1-сүрөтү бардык стратегиялардын 2021-жылдын башындагы жалпы старттык деңгээлден тартып кумулятивдүү байлыктын өсүшүн көрсөтөт. Эң күчтүү модель сызыктары 2022-жылдагы рынок төмөндөөсү учурунда benchmarkтардан ажырай баштап, 2024–2025 мезгилинде айырма кеңейген.
Бирок авторлор бул акыркы бөлүктү LLM сигналынын күчү катары гана чечмелешпейт. 2024–2025 мезгилиндеги ири технологиялык компаниялардын күчтүү көрсөткүчү, медиа камтылышы жогору компанияларга багытталган портфель ааламы менен бирге өлчөнгөн айырманын бир бөлүгүн түшүндүрүшү мүмкүн.
Сүрөттө Llama 3.2 1B стратегиясынын сызыгы үлгүнүн көпчүлүк бөлүгүндө S&P 500 EWден төмөн турат. Бул визуалдык үлгү 3-таблицадагы төмөн жылдык киреше, төмөн Sharpe жана терс alpha менен шайкеш.
Alpha эмне үчүн этият чечмелениши керек?
Claude 3 Haikuнун %7,73 жана Llama 3.1 8Bнин %4,77 жылдыкташтырылган alpha маанилери S&P 500 EWнин жалгыз рынок фактору колдонулуп гана эсептелген.
Регрессия компаниянын көлөмүн, value, momentum, сектор салмактарын же башка белгилүү актив баалоо факторлорун көзөмөлдөбөйт. Ошондуктан оң alphaнын бир бөлүгү жаңылык сентиментинен тышкаркы системалуу экспозициялардан келип чыгышы мүмкүн.
Айрыкча эң көп жаңылык чыккан компаниялардын ири жана көрүнүктүү компаниялар болушу жана 2024–2025 мезгилиндеги технологиялык акциялардын көрсөткүчү бул чечмелөө чегин маанилүү кылат.
Изилдөө келечектеги маалыматтын колдонулушун толугу менен токтотобу?
Жок. Изилдөөчүлөр баш аттардын даталарын модель киргизүүлөрүнөн алып салышкан, жаңылыктарды убакытка көз каранды эмес batchтер түрүндө иштетишкен жана моделдерге баа маалыматын беришкен эмес; бирок айрым моделдердин билим кесилген даталары 2021–2025 үлгү мезгилинин ичине туш келгендиктен, pre-training учурунда айрым компания окуяларын мурда көргөн болуу ыктымалдыгын толугу менен жокко чыгарууга болбойт.
Look-ahead biasты азайтуу кадамдары
Биринчи чара — LLM классификациясы учурунда жаңылык даталарын модель киргизүүсүнөн алып салуу. Экинчи чара — баш аттарды убакыттык ирет маалыматын камтыбаган batchтер түрүндө классификациялоо. Үчүнчүдөн, LLMдерге акция баалары берилген эмес.
Бул чаралар модель классификация учурунда келечектеги бааны түз көрүшүнө жол бербейт. Бирок модель pre-training учурунда белгилүү бир компания окуясын же жаңылыгын мурда көргөн болушу мүмкүн. Бул тобокелдик, айрыкча моделдин билим кесилген датасы изилденген жаңылык датасынан кийин болсо, толугу менен жоюлбайт.
Post-cutoff текшерүүсү
Авторлор бул тобокелдикти баалоо үчүн анализди моделдин билим кесилген датасынан кийинки мезгилде кайталап чыгышкан. Эң жаңы эки моделдин post-cutoff мезгили ишенимдүү салыштыруу үчүн өтө кыска болгон. Калган моделдерде alpha белгиси толук үлгүдөгү белгисин сактаган.
Бул текшерүү look-ahead көйгөйүн азайтуучу туруктуулук анализин берет; бирок компания аттары моделдин эсинде жаратышы мүмкүн болгон entity-level таасирлерди жок кылбайт. Авторлордун келечектеги изилдөө сунуштарынын бири — компания аттарын анонимдештирип, семантикалык жаңылык чечмелөөсүн үйрөнүлгөн бренд ассоциацияларынан бөлүү.
Транзакциялык чыгымдар эмне үчүн маанилүү жетишпестик?
Портфелдер ар ай сайын кайра тең салмакталат; ошого карабастан изилдөө сатып алуу-сатуу комиссияларын, bid-ask spreadди, рынок таасирин же башка транзакциялык сүрүлүүлөрдү жыйынтыктардан алып салбайт.
Ошондуктан 3-таблица стратегиянын брутто көрсөткүчүн көрсөтөт. Изилдөө таза инвестициялык кирешелүүлүктү далилдебейт. Транзакциялык чыгымдарды кошуу булакта түздөн-түз келечектеги изилдөө багыты катары көрсөтүлгөн.
Коммерциялык жана жергиликтүү моделдердин чыгымдары салыштырылдыбы?
Жок. Макала API чыгымын, жергиликтүү GPU чыгымын, энергия керектөөсүн, кечигүүнү же аппараттык инвестицияны сандык түрдө салыштырбайт. Коммерциялык моделдердин колдонуу жеңилдиги менен жергиликтүү моделдердин маалымат купуялыгы жана чыгым көзөмөлү ортосундагы айырма талкууланат; бирок жалпы ээлик кылуу чыгымы өлчөнгөн эмес.
Ошондуктан “Llama 3.1 8B арзаныраак” же “коммерциялык API үнөмдүүрөөк” деген булак менен колдоого алынган сандык жыйынтык чыгарууга болбойт.
Изилдөө колдогон жыйынтыктар
- Финансылык жаңылык баш аттарынан LLM негизиндеги сентимент классификациясын колдонуп, rank-based айлык акция портфелдерин түзүүгө болот.
- Каралган үлгүдө жеке менчик моделдер жалпысынан тобокелдикке ылайыкталган эң жогорку жыйынтыктарды берген.
- Claude 3 Haiku каралган моделдердин арасында эң жогорку Sharpe коэффициентин жана бир факторлуу alpha маанисин берген.
- Claude 4.5 Haiku мурдагы Claude 3 Haikuдан төмөн калганы жаңы модель версиясы ошол эле тапшырмада автоматтык түрдө күчтүүрөөк сигнал түзбөй турганын көрсөтөт.
- Llama 3.1 8B каралган тапшырмада Gemini 2.5 Flashка жакын жана GPT-4.1 Nanoдон жогору көрсөткүч берген.
- Llama 3.2 1B benchmarkтан ашкан эмес жана терс бир факторлуу alpha берген.
- Параметр көлөмү окшош Llama 3.1 8B менен Mistral 7B ортосундагы айырма параметр саны жалгыз өзү көрсөткүчтү түшүндүрбөй турганын көрсөтөт.
Изилдөө колдобогон жыйынтыктар
- Claude 3 Haiku бардык финансылык мезгилдерде же бардык рыноктордо эң мыкты LLM экени далилденген эмес.
- Модель стратегияларынын alpha же Sharpe айырмачылыктары статистикалык жактан маанилүү экени көрсөтүлгөн эмес.
- Көрсөтүлгөн alphaнын баары жаңылык сентиментинен гана келип чыкканы далилденген эмес.
- 1B моделдер жалпы алганда финансылык классификация үчүн жетишсиз деген жыйынтык чыгарууга болбойт; бир гана 1B модель тесттен өткөн.
- Ачык салмактуу моделдер бардык коммерциялык API моделдерин алмаштыра алары көрсөтүлгөн эмес.
- Транзакциялык чыгымдар эсепке алынбагандыктан стратегиялардын таза инвестициялык кирешелүүлүгү далилденген эмес.
- Pre-trainingден келип чыккан өткөн окуялар тууралуу маалымат толугу менен жоюлганы көрсөтүлгөн эмес.
- Жыйынтыктар жеке инвестор үчүн сатып алуу-сатуу кеңешин түзбөйт.
Келечектеги изилдөө багыттары
Булак кеңейтүүнүн үч негизги багытын сунуштайт. Биринчиси — транзакциялык чыгымдарды жана башка рыноктук сүрүлүүлөрдү портфель жыйынтыктарына кошуу. Экинчиси — генеративдүү LLMдерди финансы тармагына атайын дискриминативдүү моделдер, мисалы FinBERT сыяктуу encoder түзүмдөрү менен салыштыруу.
Үчүнчү багыт — pre-trainingден келип чыккан компания иденттүүлүгү тууралуу маалымат. Компания аттарын анонимдештирүү модель чындап жаңылыктын семантикасын чечмелеп жатабы же мурда үйрөнгөн компания жана бренд ассоциацияларынан пайдаланып жатабы дегенди такыраак бөлүүгө жардам бере алат.
Булак жана Ыкма Жөнүндө Эскертүү
Толук оригиналдуу аталыш: Open-Source versus Proprietary LLMs for Sentiment-Based Equity Portfolios.
Авторлор: Felipe Affonso; Marcelo S. Perlin.
Мекеме: Escola de Administração, Departamento de Finanças, Universidade Federal do Rio Grande do Sul (UFRGS), Porto Alegre, Brazil.
Corresponding author: Felipe Affonso.
Булактын түрү: Preprint / рецензиядан өтө элек изилдөө.
Максаттуу журнал: PDFте “Preprint submitted to Economics Letters” деген билдирүү бар.
Платформа: SSRN.
SSRN идентификатору: 7009844.
DOI: 10.2139/ssrn.7009844.
SSRN жарыяланган датасы: 27-июнь 2026.
Рецензиялоо абалы: Жүктөлгөн PDF изилдөө али рецензиядан өтө электигин ачык көрсөтөт.
Ачык лицензия: Жүктөлгөн PDFте жана текшерилген SSRN жазуусунда Creative Commons же ага барабар ачык кайра пайдалануу лицензиясы ырасталган эмес. Ошондуктан Verianla баяны илимий фактыларга таянып өз алдынча түзүлгөн; булак тексти, оригиналдуу таблица дизайны же 1-сүрөттүн визуалдык композициясы көчүрүлгөн эмес.
Маалымат булагы: EOD Historical Data порталынан АКШда листингден өткөн компанияларга тиешелүү финансылык жаңылык баш аттары.
Каралган мезгил: Январь 2021–Декабрь 2025.
Баштапкы жаңылык саны: 1.689.569.
Акыркы аналитикалык үлгү: 1.477.385 баш ат.
Компания ааламы: Ар бир ай үчүн point-in-time тарыхый S&P 500 мүчөлөрү.
Жакын дубликат фильтри: Бир компания жана бир дата үчүн нормалдаштырылган Levenshtein окшоштугу 0,6дан жогору болгон баш ат жуптары.
LLM тапшырмасы: Жаңылык баш аттарын оң, терс же нейтралдуу/белгисиз деп классификациялоо.
LLM саны: 7.
Жеке менчик моделдер: GPT-4.1 Nano, Claude 3 Haiku, Claude 4.5 Haiku, Gemini 2.5 Flash.
Булактын open-source/weights-available тобундагы моделдер: LLaMA 3.1 8B Instruct, LLaMA 3.2 1B Instruct, Mistral 7B Instruct v0.2.
Decoding: Жеке менчик API моделдеринде temperature = 0; жергиликтүү моделдерде greedy decoding жана do_sample=False.
Жергиликтүү inference: Hugging Face transformers жана FP16.
Негизги сигнал: Компания деңгээлиндеги айлык Sentiment Index.
Портфель эрежеси: Мурунку айдын сентимент упайына жараша азаюучу иреттөө, минималдуу максат 15 акция, тең салмактоо, ай сайын кайра тең салмактоо.
Медиа фильтри: Компания-ай үчүн кеминде 15 жаңылык.
Benchmarkтар: S&P 500 Equal Weighted жана активдүү S&P 500 мүчөлөрүнөн алынган 1.000 Monte Carlo тартуусунун орточосу болгон Random 15 портфели.
Киреше түрү: Бөлүнүүлөргө жана дивиденддерге ылайык оңдолгон жалпы киреше.
Sharpe божомолу: Тобокелсиз пайыздык чен нөл.
Alpha/beta ыкмасы: Айлык стратегия кирешелеринин S&P 500 EW айлык кирешесине каршы бир факторлуу OLS регрессиясы.
Формалдуу модель салыштыруу тести: Alpha жана Sharpe айырмачылыктары үчүн формалдуу моделдер аралык маанилүүлүк тести берилген эмес; жыйынтыктар сүрөттөөчү түрдө сунушталган.
Look-ahead текшерүүсү: Жаңылык даталары модель киргизүүсүнөн алынып салынган, классификация убакыттык ирет маалыматын камтыбаган batchтер менен жүргүзүлгөн жана моделдерге акция баасы берилген эмес. Бирок pre-training аркылуу окуя маалыматын толугу менен четтетүүгө болбойт.
Post-cutoff текшерүүсү: Жетиштүү post-cutoff байкоосу бар моделдерде alpha белгиси толук үлгүдөгү белгисин сактаган; эң жаңы эки модель үчүн терезе өтө кыска.
Каржылоо: Coordenação de Aperfeiçoamento de Pessoal de Nível Superior – Brasil (CAPES), Finance Code 001.
Генеративдүү жасалма интеллект боюнча билдирүү: Авторлор акыркы тексттин окулушун жакшыртуу үчүн Google Gemini колдонушканын, чыгышын карап чыгып оңдошконун жана макаланын мазмуну үчүн жоопкерчиликти өздөрүнө алышканын билдиришет.
Кызыкчылыктардын кагылышы: Жүктөлгөн PDFте өзүнчө кызыкчылыктардын кагылышы боюнча билдирүү берилген эмес.
CRediT / автордук салымдар: Жүктөлгөн PDFте кеңири CRediT автордук салым билдирүүсү берилген эмес.
Маалыматтын жеткиликтүүлүгү: Булак маалымат берүүчүсү көрсөтүлгөнү менен PDFте өзүнчө жана ачык маалымат жеткиликтүүлүгү бөлүмү берилген эмес.
Негизги чектөөлөр: Транзакциялык чыгымдардын эске алынбашы; бир факторлуу alpha гана колдонулушу; моделдердин билим кесилген даталарынын үлгү менен жарым-жартылай дал келиши; компания башына минималдуу жаңылык фильтринин медиа көрүнүктүүлүгү жогору фирмаларга ыкташы; 2025-жылы маалымат берүүчүнүн жаңылык чыгаруу процессиндеги өзгөрүү; болгону жети модель каралышы; болгону бир 1B модель болушу; API версиялары убакыттын өтүшү менен өзгөрүшү мүмкүн экендиги; чыгым, кечигүү жана аппараттык талаптардын сандык өлчөнбөшү.
1-сүрөт: 2021–2025 кумулятивдүү байлык өсүшүн модель стратегиялары, S&P 500 EW жана Random 15 benchmarkы үчүн салыштырат. Эң күчтүү стратегиялар 2022-жылдан кийин benchmarkтан ажыраганда, Llama 3.2 1B үлгүнүн чоң бөлүгүндө benchmarkтан төмөн калган.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген