


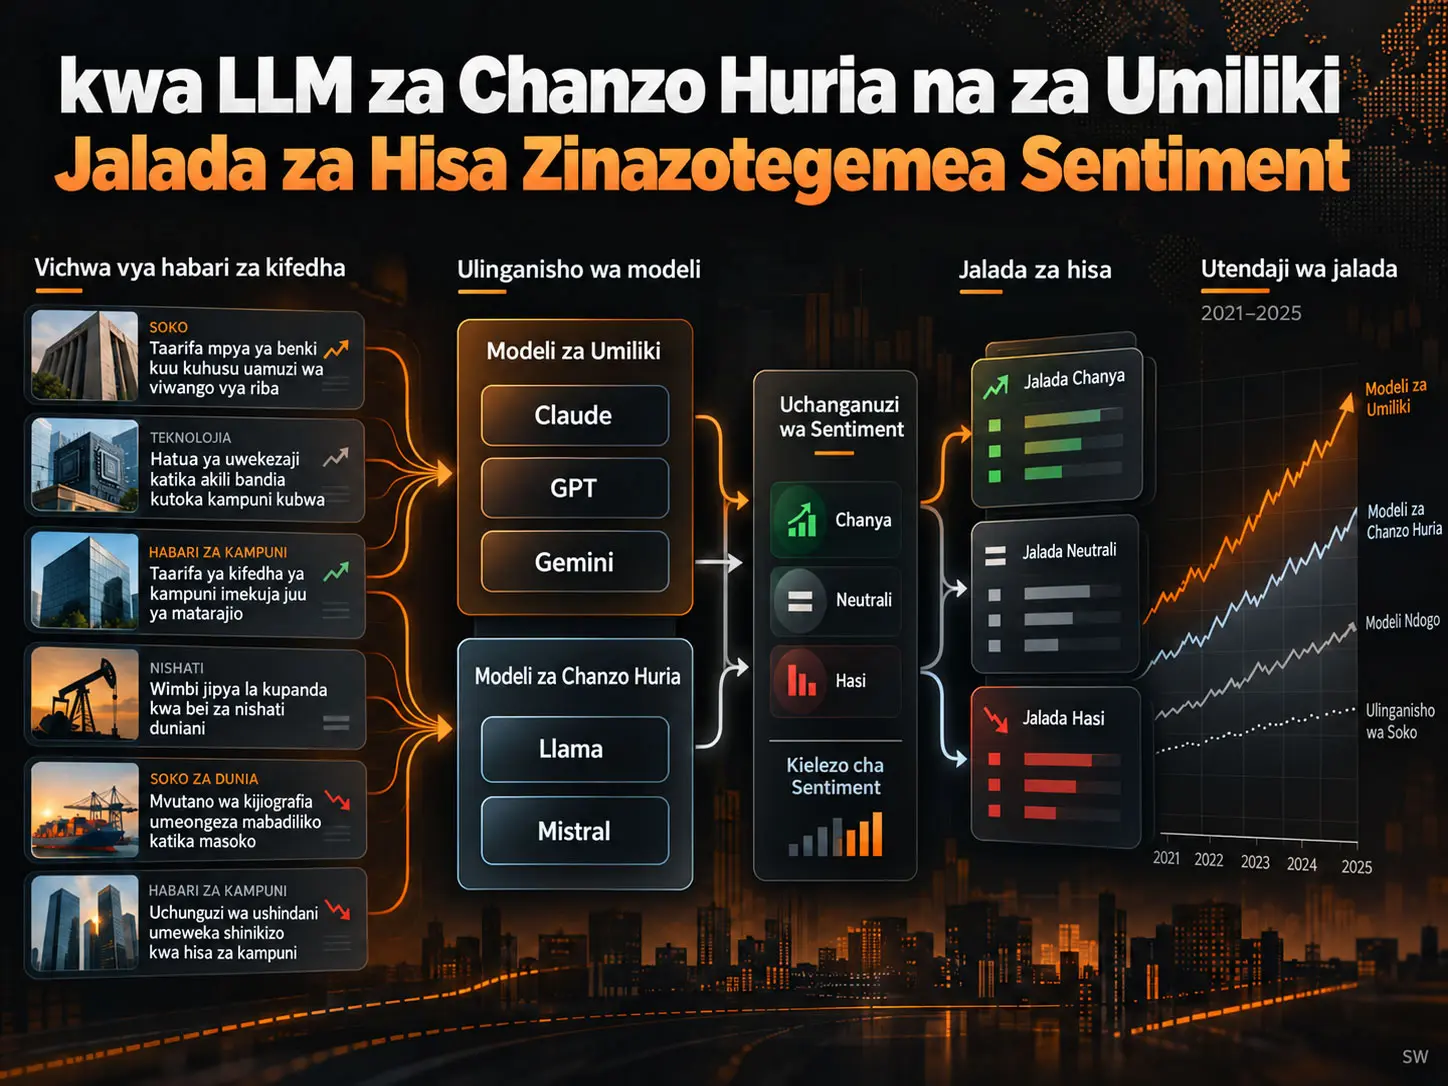
Jalada la sentiment linalotegemea LLM, ni mbinu ya jalada inayoundwa kwa kuainisha vichwa vya habari za kifedha kuwa chanya, hasi au visivyoegemea upande wowote kwa kutumia modeli kubwa za lugha, kisha kutumia alama za kila mwezi za sentiment za kampuni zinazotokana na makundi hayo katika uteuzi wa hisa. Felipe Affonso na Marcelo S. Perlin waliainisha vichwa vya habari 1.477.385 vilivyobaki baada ya usafishaji kwa kampuni za S&P 500 katika kipindi cha 2021–2025 kwa kutumia modeli saba kubwa za lugha; walilinganisha modeli nne za umiliki na modeli tatu zenye weights available zinazoweza kuendeshwa ndani ya mfumo wa mbinu ileile ya jalada ya rank-based. Katika sampuli ya chanzo, Claude 3 Haiku ilitoa utendaji wa juu zaidi uliorekebishwa kwa hatari, Llama 3.1 8B ilitoa matokeo yaliyo karibu na modeli za API za kibiashara, huku Llama 3.2 1B haikuzidi benchmark. Hata hivyo, matokeo yanatumika kwa data, kipindi, prompt, toleo la modeli na kanuni ya jalada husika; tofauti za alpha na Sharpe kati ya mikakati ya modeli hazijathibitishwa kwa vipimo rasmi vya kitakwimu vya ubora.
Jambo muhimu katika utafiti si swali la “ni LLM ipi ilitoa mapato ya juu zaidi?” pekee. Utafiti unafanya ulinganisho wa kiutendaji kati ya familia ya modeli, uwezo wa modeli, uwezekano wa kuiendesha ndani ya mfumo wa ndani na ufikiaji wa API za kibiashara katika kazi ileile ya uainishaji wa kifedha. Ingawa modeli za umiliki kwa ujumla zilitoa mapato ya juu zaidi yaliyorekebishwa kwa hatari, ukweli kwamba Llama 3.1 yenye vigezo bilioni 8 ilitoa matokeo yaliyo karibu na Gemini 2.5 Flash na juu ya GPT-4.1 Nano unaonyesha kwamba modeli inayoendeshwa ndani inaweza kuwa mbadala unaoweza kutumika katika baadhi ya kazi maalum za uainishaji wa maandishi ya kifedha.
Matokeo haya si ushauri wa uwekezaji wala ushahidi kwamba mapato hayohayo yatapatikana siku zijazo. Utafiti haujumuishi gharama za miamala, kamisheni na msuguano wa soko; alpha ni ya sababu moja tu dhidi ya benchmark ya S&P 500 yenye uzito sawa; haijarekebishwa kwa ukubwa wa kampuni, value, momentum au sababu za sekta. Aidha, kwa kuwa tarehe za mwisho za maarifa za baadhi ya modeli zinafunika sehemu ya kipindi cha data, haiwezekani kuondoa kabisa maarifa ya matukio ya zamani yaliyopatikana kupitia pre-training.
Tatizo la utafiti
Katika masoko ya fedha, maandishi yametumika kwa muda mrefu kama ishara ya uwekezaji. Mbinu za jadi zinazotegemea kamusi zinaweza kuainisha neno kuwa chanya au hasi bila kuzingatia vya kutosha muktadha unaolizunguka. Modeli kubwa za lugha, kwa upande mwingine, zinaweza kuchakata muktadha wa kichwa cha habari kwa upana zaidi na hivyo kutoa mbinu tofauti ya kutoa sentiment ya kifedha.
Hata hivyo, sehemu kubwa ya tafiti zilizotangulia imelenga familia moja ya modeli za umiliki. Hali hii inaacha maswali mawili wazi: je, LLM tofauti za kibiashara hutoa ishara ileile ya uwekezaji kwenye habari zilezile za kifedha, na modeli ndogo zinazoweza kuendeshwa ndani zinaweza kukaribia kwa kiwango gani API za kibiashara zinazolipiwa?
Affonso na Perlin wanashughulikia pengo hili kwa kulinganisha LLM saba chini ya seti ileile ya data na kanuni ileile ya jalada. Lengo si kuunda mpangilio wa ulimwengu wote kwa modeli zote zilizopo. Utafiti unalinganisha matokeo ya jalada ya ishara zinazotolewa na modeli za umiliki zilizochaguliwa na modeli zenye weights available katika kazi ileile ya maandishi ya kifedha.
Kwa nini ulimwengu wa data unategemea uanachama wa S&P 500 unaobadilika?
Seti ya data inategemea vichwa vya habari za kampuni za Marekani vilivyopatikana kutoka lango la EOD Historical Data. Utafiti unachunguza kipindi cha Januari 2021–Desemba 2025. Kila mwezi, kampuni zilizokuwa wanachama halisi wa S&P 500 katika mwezi huo pekee ndizo zilizotumika; orodha ya kampuni ya mwisho wa 2025 haikutumika kurudi nyuma katika historia.
Jambo hili ni muhimu kimetodolojia. Kuchunguza utendaji wa zamani wa kampuni zilizokuwepo mwishoni mwa kipindi pekee kunaweza kushughulikia vibaya kampuni zilizoingia kwenye faharasa baadaye au zilizotoka mapema, na hivyo kuunda selection bias na survivorship bias. Mbinu ya uanachama wa point-in-time huhakikisha kwamba ulimwengu wa jalada katika kila tarehe unategemea muundo wa faharasa uliokuwa unajulikana katika tarehe hiyo.
Kutoka vichwa vya habari milioni 1,69 hadi sampuli ya uchanganuzi ya milioni 1,48
| Hatua | 2021 | 2022 | 2023 | 2024 | 2025 | Jumla |
|---|---|---|---|---|---|---|
| Vichwa vilivyotolewa awali | 246.365 | 281.361 | 291.426 | 230.335 | 640.082 | 1.689.569 |
| Metadata artifact iliyoondolewa | 5 | 18 | 1.997 | 6.406 | 0 | 8.426 |
| Nakala inayokaribiana iliyoondolewa | 41.657 | 21.757 | 28.952 | 19.899 | 91.493 | 203.758 |
| Sampuli ya mwisho ya uchanganuzi | 204.703 | 259.586 | 260.477 | 204.030 | 548.589 | 1.477.385 |
Uwiano wa kufanana wa Levenshtein uliorekebishwa ulitumika kutambua nakala zinazokaribiana. Ikiwa uwiano wa kufanana wa vichwa viwili vya kampuni ileile na siku ileile ulikuwa zaidi ya 0,6, kimoja kati ya jozi hiyo kiliondolewa. Kizuizi cha siku ileile na kampuni ileile kilitumika kupunguza hatari ya kufuta kimakosa habari zinazohusu matukio tofauti ya kiuchumi lakini zinazofanana kiisimu.
Kwa nini ongezeko kubwa la kiasi cha habari mwaka 2025 ni muhimu?
Mwaka 2025 idadi ya habari ghafi iliongezeka hadi 640.082 na kuzidi kwa kiasi kikubwa viwango vya miaka iliyotangulia. Kulingana na chanzo, mtoa data alianza kutumia modeli kubwa ya lugha katika kipindi hiki kutoa habari kutoka vyanzo visivyo na muundo; hata hivyo, tarehe kamili ya kuanza kwa mabadiliko hayo haikuchapishwa.
Kwa sababu hiyo, waandishi walihifadhi seti nzima ya data badala ya kuigawa. Hoja yao ni kwamba, kwa kuwa Sentiment Index inayotumika hurekebishwa ndani ya kila kampuni-mwezi, kuongezeka tu kwa idadi ya habari hakubadilishi kiwango cha ishara kwa njia ya kimakanika. Hata hivyo, mabadiliko haya katika mchakato wa uzalishaji wa data ni sifa ya chanzo cha data inayopaswa kuzingatiwa wakati wa kulinganisha vipindi.
Sentiment Index hupima nini?
Sentiment Index ni kipimo cha sentiment kilichorekebishwa kinachopima usawa wa jamaa wa habari chanya na hasi zilizoainishwa kuhusu kampuni katika mwezi fulani, katika kiwango cha -1 hadi +1. +1 huwakilisha hali ya mwisho ambapo uainishaji chanya pekee umetawala, na -1 hali ambapo uainishaji hasi pekee umetawala; kipimo hutumia uwiano kati ya habari chanya na hasi badala ya kiwango kamili cha wingi wa habari.
Mlinganyo unaotumika kwa kampuni \(i\) na mwezi \(t\):
\[ SI_{i,t} = \frac{\sum POS-\sum NEG} {\sum POS+\sum NEG} \]
Hapa \(POS\) inaonyesha idadi ya habari zilizoainishwa kuwa chanya kwa kampuni-mwezi husika, na \(NEG\) inaonyesha idadi ya habari zilizoainishwa kuwa hasi. Sehemu ya juu ya fomula huonyesha mwelekeo halisi wa sentiment, huku sehemu ya chini ikirekebisha jumla ya kiasi cha habari chanya na hasi. Habari zilizoainishwa kuwa neutral haziingii moja kwa moja katika usawa chanya-hasi wa fomula hii.
Kipimo hiki si “utabiri kamili wa mapato ya hisa”. Katika hatua inayofuata kinatumika tu kama ishara ya jamaa inayowezesha kampuni kupangwa dhidi ya nyingine.
Ni LLM zipi zilizolinganishwa?
| Kundi | Model | Taarifa ya vigezo iliyotolewa na chanzo | Dirisha la muktadha | Tarehe ya mwisho ya maarifa / proxy |
|---|---|---|---|---|
| Za umiliki | GPT-4.1 Nano | Haijafichuliwa | 1M | Juni 2024 |
| Za umiliki | Claude 3 Haiku | Haijafichuliwa | 200k | Agosti 2023 |
| Za umiliki | Claude 4.5 Haiku | Haijafichuliwa | 200k | Februari 2025 |
| Za umiliki | Gemini 2.5 Flash | Haijafichuliwa | 1M | Januari 2025 |
| Kundi la “open-source” la waandishi | LLaMA 3.1 8B Instruct | bilioni 8 | 128k | Desemba 2023 |
| Kundi la “open-source” la waandishi | LLaMA 3.2 1B Instruct | bilioni 1 | 128k | Desemba 2023 |
| Kundi la “open-source” la waandishi | Mistral 7B Instruct v0.2 | bilioni 7 | 32k | Tarehe ya toleo la Desemba 2023 ilitumika kama proxy |
Chanzo kinaziita modeli za Llama na Mistral “open-source” katika kichwa na maandishi makuu; katika jedwali la vipengele vya kiufundi, kundi hili pia limefafanuliwa kama “Weights Available”. Maandishi ya Verianla yanahifadhi tofauti hii ya istilahi bila kuibadilisha.
Kwa nini modeli za gharama nafuu zaidi zilichaguliwa?
Kuchakata takribani vichwa vya habari milioni 1,5 kwa modeli nyingi kunaleta gharama kubwa za ukokotoaji na API. Kwa hiyo, watafiti walichagua modeli za kibiashara za madaraja ya Flash, Haiku na Nano ambazo ni nafuu kwa kulinganisha badala ya modeli nzito sana za reasoning; upande wa ndani walichagua modeli zenye vigezo vya 1B hadi 7–8B.
Lengo la utafiti si kulinganisha toleo kubwa zaidi la kila familia ya modeli, bali kufanya ulinganisho wa kiutendaji kati ya modeli zinazoweza kutumika kwa kiwango cha uainishaji wa habari za kifedha.
Uainishaji ulifanywaje?
Mantiki ileile ya uainishaji iliyosanifishwa ilitumika kwa vichwa vyote vya habari. Modeli ziliombwa kuainisha kila kichwa kuwa chanya, hasi au kisicho na uhakika/kisichoegemea upande wowote kwa mtazamo wa matarajio ya wawekezaji. Katika mtiririko wa kazi wa chanzo, makundi haya yanalingana na matokeo ya YES, NO na UNKNOWN.
Kwa ufanisi wa ukokotoaji, hadi vichwa 10 vya habari vilichakatwa katika ombi moja. Katika modeli za API za kibiashara temperature iliwekwa sifuri; katika modeli za ndani sampling ilizimwa na greedy decoding ikatumika. Hivyo, utofauti wa matokeo unaotokana na sampling ya nasibu kwa ingizo lilelile ulipunguzwa.
Modeli zenye uzito wazi ziliendeshwa ndani kwa kutumia maktaba ya Hugging Face transformers na kwa usahihi wa nusu wa FP16. Modeli za kibiashara ziliendeshwa kupitia API za watoa huduma. Kwa kuwa chanzo pia kinakubali kwamba tabia ya API za kibiashara inaweza kubadilika kati ya matoleo, kipindi halisi cha ufikiaji wa kila modeli kiliripotiwa tofauti katika jedwali la vipengele vya kiufundi.
Ubadilishaji kuwa jalada ulifanywaje?
Habari zilizokusanywa na kuainishwa katika mwezi \(t\) zilibadilishwa kwanza kuwa thamani ya kila mwezi ya Sentiment Index kwa kila kampuni. Jalada liliundwa katika siku ya kwanza ya kazi ya mwezi \(t+1\). Kwa njia hii, mienendo ya bei ya baadaye ndani ya mwezi huohuo haitumiki kuunda ishara.
Kampuni zilipangwa kutoka juu kwenda chini kulingana na Sentiment Index. Lengo la chini la jalada liliwekwa kuwa hisa 15. Ikiwa kampuni katika sehemu ya kukata zilikuwa na alama sawa ya sentiment, hisa zote zenye alama sawa zilijumuishwa kwenye jalada; kwa hiyo ukubwa halisi wa jalada uliweza kuzidi 15 katika baadhi ya miezi.
Ili kampuni iweze kuchaguliwa kwenye jalada katika mwezi fulani, ilihitajika kuwa na angalau vichwa 15 vya habari. Kanuni hii hupunguza vipimo vya sentiment vilivyo na mabadiliko kupita kiasi katika kampuni zenye habari chache, lakini huelekeza sampuli kwa kampuni kubwa na zinazoonekana zaidi zinazopata habari nyingi.
Hisa katika jalada zilipewa uzito sawa, zikashikiliwa kwa mwezi mmoja na kusawazishwa upya katika siku ya kwanza ya kazi ya mwezi uliofuata. Kwa kuwa mapato yalihesabiwa kutoka bei za kufunga zilizorekebishwa kwa mgawanyiko wa hisa na gawio, yana sifa ya mapato ya jumla.
Benchmarks
Sehemu mbili za kulinganisha zilitumika. Ya kwanza ni jalada la S&P 500 lenye uzito sawa, linaloundwa kila mwezi kutoka kwa wanachama hai wa S&P 500 wa mwezi huo. Ya pili ni wastani wa michoro 1.000 ya Monte Carlo ya jalada za hisa 15 zilizochaguliwa kwa nasibu kutoka kwa wanachama hao hao hai.
Ulimwengu wa benchmark haukupunguzwa kwa kampuni zenye habari za kutosha pekee. Kwa hiyo, inapaswa kuzingatiwa pia kwamba kichujio cha mwonekano wa vyombo vya habari cha jalada za LLM kinaweza kuwa na nafasi katika matokeo.
Mbinu na Matokeo ya Utafiti
Vipimo vya utendaji
Utafiti unaripoti mapato yaliyowekwa kwa kiwango cha mwaka, volatility ya mwaka, Sharpe ratio, maximum drawdown, alpha ya sababu moja na beta. Katika Sharpe ratio, kiwango cha riba kisicho na hatari kinachukuliwa kuwa sifuri.
Alpha na beta zilikadiriwa kwa OLS regression ya mapato ya kila mwezi ya kila mkakati wa LLM dhidi ya mapato ya kila mwezi ya S&P 500 EW. Beta huwakilisha unyeti dhidi ya benchmark ya soko, huku alpha ikiwakilisha sehemu ya mapato isiyoelezewa na mwelekeo wa benchmark katika uhusiano huu wa sababu moja.
Matokeo makuu ya utendaji ya 2021–2025
| Mkakati | Mapato ya mwaka (%) | Volatility (%) | Sharpe | Maximum drawdown (%) | Alpha (%) | Beta |
|---|---|---|---|---|---|---|
| Claude 3 Haiku | 14,18 | 15,11 | 0,94 | -17,14 | 7,73 | 0,90 |
| Claude 4.5 Haiku | 12,61 | 14,34 | 0,88 | -18,49 | 6,66 | 0,82 |
| Gemini 2.5 Flash | 11,25 | 14,91 | 0,75 | -16,28 | 4,73 | 0,89 |
| GPT-4.1 Nano | 10,41 | 15,87 | 0,66 | -23,20 | 3,82 | 0,89 |
| Llama 3.1 8B | 11,53 | 15,50 | 0,74 | -20,34 | 4,77 | 0,92 |
| Mistral 7B | 7,68 | 15,00 | 0,51 | -20,39 | 0,79 | 0,92 |
| Llama 3.2 1B | 4,61 | 15,44 | 0,30 | -23,59 | -2,18 | 0,91 |
| S&P 500 EW | 7,46 | 15,67 | 0,48 | -21,45 | 0,00 | 1,00 |
| Wastani wa Random 15 | 7,42 | 15,69 | 0,47 | -21,58 | -0,05 | 1,00 |
Ni LLM ipi ilitoa utendaji wa juu zaidi wa jalada?
Katika sampuli iliyochunguzwa ya 2021–2025, Claude 3 Haiku ilitoa mchanganyiko wa juu zaidi wa mapato yaliyowekwa kwa kiwango cha mwaka, Sharpe ratio na alpha ya sababu moja: mapato %14,18, Sharpe 0,94 na alpha %7,73. Hata hivyo, kwa kuwa utafiti haukulinganisha tofauti za modeli kwa vipimo rasmi vya umuhimu wa alpha au Sharpe, matokeo haya hayapaswi kufasiriwa kuwa “Claude 3 Haiku ni bora kitakwimu kuliko modeli zote”.
Claude 3 Haiku na Claude 4.5 Haiku
Claude 3 Haiku ilitoa thamani za juu zaidi za mapato na alpha, huku mrithi wake Claude 4.5 Haiku akiwa wa pili kwa mapato %12,61, Sharpe 0,88 na alpha %6,66.
Volatility ya Claude 4.5 Haiku ni %14,34 na beta yake ni 0,82, miongoni mwa thamani za chini zaidi katika sampuli. Hata hivyo, mapato yaliyorekebishwa kwa hatari ya Claude 3 Haiku ya zamani yalibaki juu zaidi. Utafiti unatumia hali hii kama mfano kwamba toleo jipya la modeli halitoi moja kwa moja ishara yenye nguvu zaidi katika kazi ileile ya kifedha.
Gemini 2.5 Flash na GPT-4.1 Nano
Gemini 2.5 Flash ilitoa mapato ya mwaka %11,25 na Sharpe 0,75. Mapato ya mwaka ya GPT-4.1 Nano ni %10,41 na Sharpe ratio yake ni 0,66. Mikakati yote miwili ina alpha chanya ya sababu moja.
Maximum drawdown ya GPT-4.1 Nano ni -%23,20, mbaya zaidi kuliko kiwango cha -%21,45 cha S&P 500 EW. Kwa hiyo, kutoa mapato ya wastani yaliyo juu ya benchmark hakumaanishi hasara ndogo katika kila hali ya soko.
Je, Llama 3.1 8B inayoendeshwa ndani iliweza kukaribia API za kibiashara?
Ndiyo. Katika kazi na kipindi kilichochunguzwa, Llama 3.1 8B ilitoa mapato ya mwaka %11,53, Sharpe 0,74 na alpha ya sababu moja %4,77; kwa thamani hizi ilifanya vizuri zaidi kuliko GPT-4.1 Nano na karibu na Gemini 2.5 Flash. Matokeo yanaunga mkono kwamba modeli inayoweza kuendeshwa ndani inaweza kuwa mbadala unaoweza kutumika katika kazi hii maalum ya uainishaji wa habari za kifedha, lakini hayathibitishi kwamba modeli zote zenye uzito wazi au kazi zote za kifedha ni sawa na API za kibiashara.
Tofauti kati ya Llama 3.1 8B na Mistral 7B inaonyesha nini?
Ingawa Llama 3.1 8B na Mistral 7B ziko katika daraja linalofanana la ukubwa wa vigezo, utendaji wa jalada zao unatofautiana kwa kiasi kikubwa. Llama 3.1 8B ilitoa mapato %11,53 na Sharpe 0,74, huku Mistral 7B ikibaki katika %7,68 na 0,51.
Waandishi wanaeleza kwamba tofauti hii inadokeza kuwa ukubwa wa modeli pekee si maelezo ya kutosha. Data ya mafunzo na uwezo wa instruction-following pia vinaweza kuwa na nafasi katika uainishaji wa maandishi ya kifedha. Hata hivyo, kwa kuwa modeli mbili tu zilichunguzwa katika kiwango cha 7–8B, matokeo haya hayawezi kufasiriwa kama sheria ya jumla ya usanifu wa modeli.
Kwa nini modeli ya 1B inapaswa kutathminiwa kando?
Llama 3.2 1B, ikiwa na mapato %4,61 na Sharpe 0,30, ilibaki chini ya S&P 500 EW na benchmark ya jalada la nasibu, huku alpha ya sababu moja ikiwa -%2,18.
Chanzo kinaeleza kwamba matokeo haya yanaendana na uwezekano kwamba modeli ya 1B ina uwezo mdogo zaidi wa kutenganisha sentiment yenye taarifa kutoka kelele. Hata hivyo, kwa kuwa kuna modeli moja tu ya 1B katika sampuli, hakijumlishi matokeo kwa kusema “modeli zenye chini ya vigezo bilioni 1 hushindwa katika uchanganuzi wa sentiment ya kifedha”. Tofauti inaweza pia kutokana na data ya mafunzo au sifa za instruction-following za modeli hiyo.
Maximum drawdown na bear market ya 2022
Maximum drawdown za Claude 3 Haiku, Claude 4.5 Haiku na Gemini 2.5 Flash ni ndogo kuliko benchmark ya S&P 500 EW. GPT-4.1 Nano, kwa upande mwingine, ilipata maximum drawdown ya kina zaidi kuliko benchmark.
Kwa kuwa thamani nyingi za beta ziko takribani katika kiwango cha 0,82–0,92, hii ina maana kwamba jalada za LLM si huru na soko, lakini baadhi ya mikakati zina unyeti wa chini zaidi kwa soko ikilinganishwa na S&P 500 EW.
Ujumbe wa kisayansi wa Kielelezo 1
Kielelezo 1 cha chanzo kinaonyesha maendeleo ya utajiri wa mkusanyiko wa mikakati yote kuanzia kiwango cha pamoja cha mwanzo wa 2021. Mistari ya modeli zenye nguvu zaidi ilianza kujitenga na benchmarks wakati wa kushuka kwa soko mwaka 2022, na tofauti ikapanuka katika kipindi cha 2024–2025.
Hata hivyo, waandishi hawafasiri sehemu hii ya mwisho kama nguvu ya ishara ya LLM pekee. Utendaji mkubwa wa kampuni kubwa za teknolojia katika 2024–2025, pamoja na ulimwengu wa jalada unaoelemea kampuni zenye ufunikaji mkubwa wa vyombo vya habari, unaweza kueleza sehemu ya tofauti iliyopimwa.
Katika kielelezo, mstari wa mkakati wa Llama 3.2 1B unabaki chini ya S&P 500 EW katika sehemu kubwa ya sampuli. Muundo huu wa kuona unaendana na mapato ya chini ya mwaka, Sharpe ya chini na alpha hasi katika Jedwali 3.
Kwa nini alpha inapaswa kufasiriwa kwa uangalifu?
Thamani za alpha zilizowekwa kwa kiwango cha mwaka za %7,73 kwa Claude 3 Haiku na %4,77 kwa Llama 3.1 8B zilihesabiwa kwa kutumia sababu moja tu ya soko ya S&P 500 EW.
Regression haidhibiti ukubwa wa kampuni, value, momentum, uzito wa sekta au sababu nyingine zinazojulikana za uwekaji bei wa mali. Kwa hiyo, sehemu ya alpha chanya inaweza kutokana na mifichuo ya kimfumo nje ya sentiment ya habari.
Hasa, ukweli kwamba kampuni zinazopata habari nyingi zaidi ni kampuni kubwa na zinazoonekana sana, pamoja na utendaji wa hisa za teknolojia katika 2024–2025, hufanya kikomo hiki cha tafsiri kuwa muhimu.
Je, utafiti unazuia kabisa matumizi ya taarifa za baadaye?
Hapana. Watafiti waliondoa tarehe za vichwa kutoka kwenye ingizo za modeli, wakachakata habari katika batch zisizo na mpangilio wa muda na hawakuzipa modeli data ya bei; hata hivyo, kwa kuwa tarehe za mwisho za maarifa za baadhi ya modeli ziko ndani ya kipindi cha sampuli cha 2021–2025, uwezekano kwamba ziliwahi kuona matukio fulani ya kampuni wakati wa pre-training hauwezi kuondolewa kabisa.
Hatua za kupunguza look-ahead bias
Hatua ya kwanza ni kuondoa tarehe za habari kwenye ingizo la modeli wakati wa uainishaji wa LLM. Hatua ya pili ni kuainisha vichwa katika batch zisizobeba taarifa ya mpangilio wa muda. Tatu, LLM hazikupewa bei za hisa.
Hatua hizi huzuia modeli kuona moja kwa moja bei ya baadaye wakati wa uainishaji. Lakini modeli inaweza kuwa iliwahi kuona tukio fulani la kampuni au habari wakati wa pre-training. Hatari hii haiwezi kuondolewa kabisa, hasa ikiwa tarehe ya mwisho ya maarifa ya modeli ni baada ya tarehe ya habari inayochunguzwa.
Ukaguzi wa post-cutoff
Waandishi walirudia uchanganuzi kwenye kipindi baada ya tarehe ya mwisho ya maarifa ya modeli ili kutathmini hatari hii. Kipindi cha post-cutoff cha modeli mbili mpya zaidi kilikuwa kifupi mno kwa ulinganisho wa kuaminika. Katika modeli nyingine, ishara ya alpha ilibaki sawa na katika sampuli kamili.
Ukaguzi huu hutoa uchanganuzi wa uthabiti unaopunguza tatizo la look-ahead; hata hivyo, hauondoi athari za entity-level ambazo majina ya kampuni yanaweza kuunda katika kumbukumbu ya modeli. Pendekezo moja la waandishi kwa utafiti wa baadaye ni kufanya majina ya kampuni kuwa anonymous ili kutenganisha tafsiri ya semantiki ya habari na miunganiko ya chapa iliyojifunzwa awali.
Kwa nini gharama za miamala ni upungufu muhimu?
Jalada husawazishwa upya kila mwezi; hata hivyo, utafiti hauondoi kamisheni za ununuzi na uuzaji, bid-ask spread, athari ya soko au msuguano mwingine wa miamala kutoka kwenye matokeo.
Kwa hiyo, Jedwali 3 linaonyesha utendaji wa jumla kabla ya gharama wa mkakati. Utafiti hauthibitishi faida halisi ya uwekezaji baada ya gharama. Kuongeza gharama za miamala kumetajwa moja kwa moja na chanzo kama eneo la utafiti wa baadaye.
Je, gharama kati ya modeli za kibiashara na za ndani zililinganishwa?
Hapana. Makala hailanishi kwa kiasi gharama za API, gharama za GPU ya ndani, matumizi ya nishati, latency au uwekezaji wa vifaa. Tofauti kati ya urahisi wa matumizi wa modeli za kibiashara na faragha ya data pamoja na udhibiti wa gharama wa modeli za ndani inajadiliwa; lakini gharama ya jumla ya umiliki haijapimwa.
Kwa hiyo, haiwezekani kutoa hitimisho la kiasi linaloungwa mkono na chanzo kwamba “Llama 3.1 8B ni nafuu zaidi” au “API ya kibiashara ni ya kiuchumi zaidi”.
Matokeo yanayoungwa mkono na utafiti
- Jalada za kila mwezi za hisa za rank-based zinaweza kuundwa kutoka vichwa vya habari za kifedha kwa kutumia uainishaji wa sentiment unaotegemea LLM.
- Katika sampuli iliyochunguzwa, modeli za umiliki kwa ujumla zilitoa matokeo ya juu zaidi yaliyorekebishwa kwa hatari.
- Claude 3 Haiku ilitoa Sharpe ratio ya juu zaidi na alpha ya sababu moja ya juu zaidi miongoni mwa modeli zilizochunguzwa.
- Kuwa kwa Claude 4.5 Haiku chini ya Claude 3 Haiku ya zamani kunaonyesha kwamba toleo jipya la modeli halitoi moja kwa moja ishara yenye nguvu zaidi katika kazi ileile.
- Llama 3.1 8B ilitoa utendaji ulio karibu na Gemini 2.5 Flash na juu kuliko GPT-4.1 Nano katika kazi iliyochunguzwa.
- Llama 3.2 1B haikuzidi benchmark na ilitoa alpha hasi ya sababu moja.
- Tofauti kati ya Llama 3.1 8B na Mistral 7B zenye ukubwa wa vigezo unaofanana inadokeza kwamba idadi ya vigezo pekee haielezi utendaji.
Matokeo ambayo utafiti hauungi mkono
- Haijathibitishwa kwamba Claude 3 Haiku ndiyo LLM bora katika vipindi vyote vya kifedha au masoko yote.
- Haijaonyeshwa kwamba tofauti za alpha au Sharpe kati ya mikakati ya modeli ni muhimu kitakwimu.
- Haijathibitishwa kwamba alpha yote iliyoripotiwa inatokana na sentiment ya habari pekee.
- Haiwezi kuhitimishwa kwamba modeli za 1B kwa ujumla hazitoshi kwa uainishaji wa kifedha; modeli moja tu ya 1B ilijaribiwa.
- Haijaonyeshwa kwamba modeli zenye uzito wazi zinaweza kuchukua nafasi ya modeli zote za API za kibiashara.
- Kwa kuwa gharama za miamala hazijazingatiwa, faida halisi ya uwekezaji ya mikakati haijathibitishwa.
- Haijaonyeshwa kwamba maarifa ya matukio ya zamani yanayotokana na pre-training yameondolewa kabisa.
- Matokeo hayatoi ushauri wa kununua au kuuza kwa mwekezaji binafsi.
Mielekeo ya utafiti wa baadaye
Chanzo kinapendekeza maeneo matatu makuu ya upanuzi. La kwanza ni kuongeza gharama za miamala na msuguano mwingine wa soko kwenye matokeo ya jalada. La pili ni kulinganisha LLM generative na modeli discriminative maalum za fedha, kwa mfano miundo ya encoder kama FinBERT.
Eneo la tatu ni taarifa ya utambulisho wa kampuni inayotokana na pre-training. Kuficha utambulisho wa majina ya kampuni kunaweza kutenganisha kwa usafi zaidi ikiwa modeli inatafsiri kweli semantiki ya habari au inanufaika na miunganiko ya kampuni na chapa iliyojifunza hapo awali.
Maelezo ya Chanzo na Mbinu
Kichwa kamili cha asili: Open-Source versus Proprietary LLMs for Sentiment-Based Equity Portfolios.
Waandishi: Felipe Affonso; Marcelo S. Perlin.
Taasisi: Escola de Administração, Departamento de Finanças, Universidade Federal do Rio Grande do Sul (UFRGS), Porto Alegre, Brazil.
Corresponding author: Felipe Affonso.
Aina ya chanzo: Preprint / utafiti ambao haujapitiwa na wataalamu wenza.
Jarida lengwa: PDF ina kauli “Preprint submitted to Economics Letters”.
Jukwaa: SSRN.
Kitambulisho cha SSRN: 7009844.
DOI: 10.2139/ssrn.7009844.
Tarehe ya uchapishaji wa SSRN: 27 Juni 2026.
Hali ya mapitio ya kitaaluma: PDF iliyopakiwa inaeleza wazi kwamba utafiti bado haujapitiwa na wataalamu wenza.
Leseni wazi: Hakuna Creative Commons au leseni sawa ya wazi ya matumizi tena iliyothibitishwa katika PDF iliyopakiwa na rekodi ya SSRN iliyothibitishwa. Kwa hiyo, simulizi la Verianla limejengwa kwa kujitegemea juu ya ukweli wa kisayansi; maandishi ya chanzo, muundo asili wa jedwali au mpangilio wa kuona wa Kielelezo 1 haujanakiliwa.
Chanzo cha data: Vichwa vya habari za kifedha vya kampuni zilizoorodheshwa Marekani kutoka lango la EOD Historical Data.
Kipindi kilichochunguzwa: Januari 2021–Desemba 2025.
Idadi ya habari ghafi: 1.689.569.
Sampuli ya mwisho ya uchanganuzi: vichwa 1.477.385.
Ulimwengu wa kampuni: Wanachama wa kihistoria wa point-in-time wa S&P 500 kwa kila mwezi.
Kichujio cha nakala zinazokaribiana: Jozi za vichwa vya kampuni ileile na tarehe ileile zenye kufanana kwa Levenshtein kulikorekebishwa zaidi ya 0,6.
Kazi ya LLM: Kuainisha vichwa vya habari kuwa chanya, hasi au visivyoegemea upande wowote/visivyo na uhakika.
Idadi ya LLM: 7.
Modeli za umiliki: GPT-4.1 Nano, Claude 3 Haiku, Claude 4.5 Haiku, Gemini 2.5 Flash.
Modeli katika kundi la open-source/weights-available la chanzo: LLaMA 3.1 8B Instruct, LLaMA 3.2 1B Instruct, Mistral 7B Instruct v0.2.
Decoding: Katika modeli za umiliki za API, temperature = 0; katika modeli za ndani, greedy decoding na do_sample=False.
Inference ya ndani: Hugging Face transformers na FP16.
Ishara kuu: Sentiment Index ya kila mwezi katika kiwango cha kampuni.
Kanuni ya jalada: Upangaji wa kushuka kulingana na alama ya sentiment ya mwezi uliopita, lengo la chini la hisa 15, uzito sawa, kusawazisha upya kila mwezi.
Kichujio cha media: Angalau habari 15 kwa kampuni-mwezi.
Benchmarks: S&P 500 Equal Weighted na jalada la Random 15, ambalo ni wastani wa michoro 1.000 ya Monte Carlo kutoka kwa wanachama hai wa S&P 500.
Aina ya mapato: Mapato ya jumla yaliyorekebishwa kwa mgawanyiko wa hisa na gawio.
Dhana ya Sharpe: Kiwango cha riba kisicho na hatari ni sifuri.
Mbinu ya alpha/beta: OLS regression ya sababu moja ya mapato ya kila mwezi ya mkakati dhidi ya mapato ya kila mwezi ya S&P 500 EW.
Kipimo rasmi cha kulinganisha modeli: Hakuna kipimo rasmi cha umuhimu kati ya modeli kilichoripotiwa kwa tofauti za alpha na Sharpe; matokeo yamewasilishwa kwa namna ya maelezo.
Ukaguzi wa look-ahead: Tarehe za habari ziliondolewa kwenye ingizo la modeli, uainishaji ulifanywa kwa batch zisizobeba taarifa ya mpangilio wa muda na modeli hazikupewa bei za hisa. Hata hivyo, maarifa ya matukio kupitia pre-training hayawezi kuondolewa kabisa.
Ukaguzi wa post-cutoff: Katika modeli zenye uchunguzi wa kutosha wa post-cutoff, ishara ya alpha ilibaki sawa na katika sampuli kamili; kwa modeli mbili mpya zaidi dirisha ni fupi mno.
Ufadhili: Coordenação de Aperfeiçoamento de Pessoal de Nível Superior – Brasil (CAPES), Finance Code 001.
Taarifa kuhusu akili bandia generative: Waandishi wanaeleza kwamba walitumia Google Gemini kuboresha usomaji wa maandishi ya mwisho, wakakagua na kuhariri matokeo yake, na wanawajibika kwa maudhui ya makala.
Mgongano wa maslahi: Hakuna taarifa tofauti ya mgongano wa maslahi iliyoripotiwa katika PDF iliyopakiwa.
CRediT / michango ya waandishi: Hakuna taarifa ya kina ya CRediT kuhusu michango ya waandishi iliyoripotiwa katika PDF iliyopakiwa.
Upatikanaji wa data: Ingawa mtoa data wa chanzo ametajwa, PDF haijaripoti sehemu tofauti na ya wazi ya upatikanaji wa data.
Vikwazo vikuu: Kutokujumuishwa kwa gharama za miamala; matumizi ya alpha ya sababu moja pekee; tarehe za mwisho za maarifa za modeli kuingiliana kwa sehemu na sampuli; kichujio cha kiwango cha chini cha habari kwa kila kampuni kuelemea kampuni zenye mwonekano mkubwa wa media; mabadiliko ya mtoa data katika mchakato wa kutoa habari mwaka 2025; kuchunguzwa kwa modeli saba pekee; kuwepo kwa modeli moja tu ya 1B; uwezekano wa matoleo ya API kubadilika kwa muda; gharama, latency na mahitaji ya vifaa kutopimwa kwa kiasi.
Kielelezo 1: Kinalinganisha maendeleo ya utajiri wa mkusanyiko wa 2021–2025 kwa mikakati ya modeli, S&P 500 EW na benchmark ya Random 15. Mikakati yenye nguvu zaidi inajitenga na benchmark baada ya 2022, huku Llama 3.2 1B ikibaki chini ya benchmark katika sehemu kubwa ya sampuli.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *