


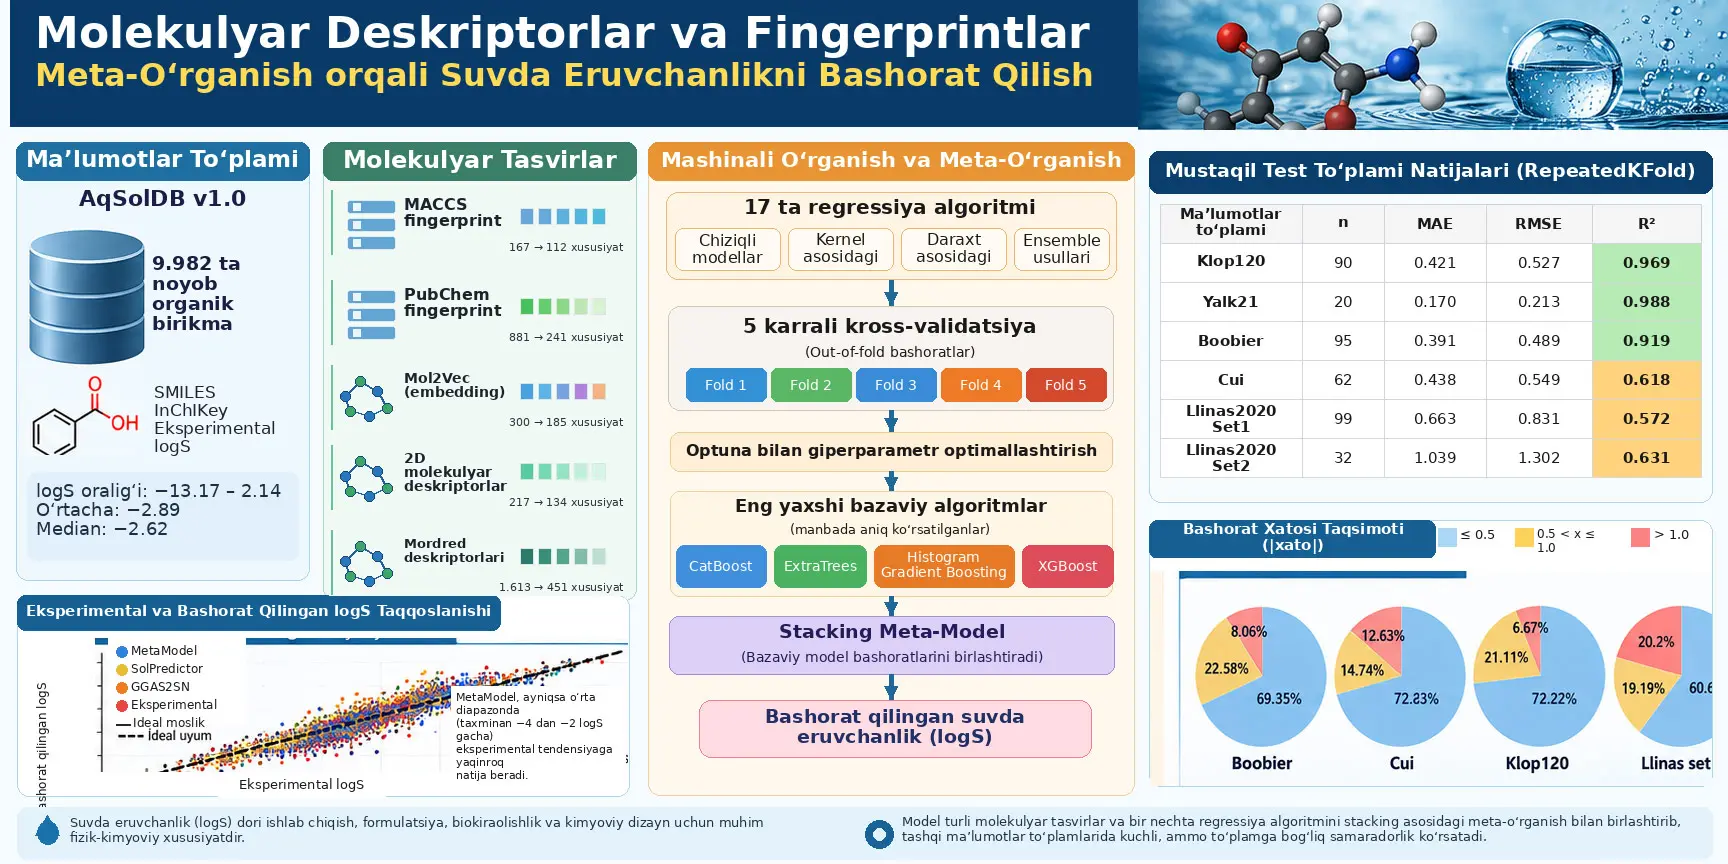
Ushbu tadqiqotdagi stacking asosidagi meta-model molekulani bir nechta sonli tasvirlar bilan kodlaydigan va turli regressiya algoritmlarining bashoratlarini yuqori darajadagi o‘rganish qatlamida birlashtirib, suvda eruvchanlik (logS) ni bashorat qiladigan mashinali o‘rganish tizimidir. Tadqiqotchilar AqSolDB v1.0 dan dastlabki ishlovdan so‘ng qolgan 9.982 ta noyob organik birikmadan foydalangan; MACCS fingerprintlari, PubChem fingerprintlari, Mol2Vec embeddinglari, ikki o‘lchamli molekulyar deskriptorlar va Mordred deskriptorlari kabi bir-birini to‘ldiruvchi molekulyar tasvirlarni baholagan. Jami 17 ta regressiya algoritmi besh karrali kross-validatsiya orqali taqqoslangan, giperparametrlar Optuna yordamida optimallashtirilgan va eng muvaffaqiyatli konfiguratsiyalar stacking arxitekturasida birlashtirilgan.
Modelning samaradorligi faqat o‘quv ma’lumotlari ichidagi kross-validatsiya bilan baholanmagan; Klop120, Yalk21, Boobier, Cui va ikkita Llinas2020 to‘plami kabi mustaqil tashqi test to‘plamlarida ham sinovdan o‘tkazilgan. Table 2 da RepeatedKFold asosidagi MetaModel; Klop120 da R²=0.969 va RMSE=0.527, Yalk21 da R²=0.988 va RMSE=0.213, Boobier da R²=0.919 va RMSE=0.489 qiymatlariga erishgan. Biroq Cui va ayniqsa Llinas ma’lumotlar to‘plamlarida samaradorlik pasayadi; masalan, Llinas2020 Set1 uchun RepeatedKFold R²=0.572, Set2 uchun R²=0.631. Bu holat model muvaffaqiyati kimyoviy taqsimotga hamda o‘quv sohasi bilan tashqi test sohasi o‘rtasidagi o‘xshashlikka bog‘liqligini ko‘rsatadi.
Manba shuningdek modelni SolPredictor va GGAS2SN deb ataladigan avvalgi usullar bilan taqqoslashni ham taqdim etadi. MetaModel Table 3 da Boobier, Klop120, Llinas set1, Lovric1 va Yalk21 ma’lumotlar to‘plamlarida umuman olganda pastroq xato va/yoki yuqoriroq R² ko‘rsatadi. Biroq u har bir ma’lumotlar to‘plamida birinchi emas: Cui va Llinas set2 da GGAS2SN ayrim asosiy xato va R² metrikalarida MetaModeldan yaxshiroq qiymatlar beradi. Shu sababli tadqiqot “MetaModel barcha kimyoviy fazolarda barcha raqiblarni yengadi” degan xulosani qo‘llab-quvvatlamaydi.
Tadqiqotning kuchli tomonlaridan biri ma’lumotlar sizib chiqishini kamaytirishga qaratilgan baholash tuzilmasidir. Dastlabki ishlov ma’lumotlar bo‘lingandan keyin har bir o‘quv foldi ichida mustaqil qo‘llangan, GroupKFold tajribasida esa Bemis–Murcko scaffoldlaridan foydalanilib, bir xil asosiy molekulyar skeletga ega birikmalarning o‘quv va validatsiya foldlariga tarqalib ketishining oldi olingan. Shunga qaramay, asosiy PDF exact random seed, Optuna trial soni va qidiruv fazosi, meta-learnerning aniq algoritmi hamda hisoblash uskunalari kabi qayta ishlab chiqish uchun foydali ayrim tafsilotlarni xabar qilmaydi.
Tadqiqotning eng muhim talqin chegarasi shundan iborat: yuqori R² va past RMSE qiymatlari model eksperimental eruvchanlik o‘lchovining o‘rnini har bir kimyoviy sinfda xatosiz egallaydi degani emas. Manbaning Figure 1 ida juda past yoki juda yuqori eruvchanlikka ega birikmalarda bashoratlar tekislanish tendensiyasini ko‘rsatishi, Llinas ma’lumotlar to‘plamlarida xatolar ortishi va model samaradorligi ma’lumotlar taqsimotiga bog‘liq ekani aniq ko‘rinadi. Model erta bosqichdagi molekulalarni saralash uchun hisoblash vositasidir; eksperimental eruvchanlik o‘lchovining universal o‘rnini bosuvchi vosita emas.
Tadqiqot muammosi nega muhim?
Suvda eruvchanlik molekulaning suvli muhitda qay darajada eriy olishini ifodalovchi asosiy fizik-kimyoviy xususiyatdir. Dori ishlab chiqishda eruvchanlik; formulatsiya qilish imkoniyatiga, biokiraolishlikka va farmakokinetik xatti-harakatga ta’sir qilishi mumkin. Manba ayni muammoning agrochemical ishlab chiqish va materiallar tadqiqotlarida ham muhim ekanini ta’kidlaydi. Eksperimental eruvchanlik o‘lchovlari qimmatli bo‘lsa-da, vaqt, resurs va laboratoriya sharoitlarini talab qiladi; bundan tashqari pH, harorat va kristall shakli kabi eksperimental omillarga sezgir bo‘lishi mumkin.
Shuning uchun tadqiqot muammosi faqat “mashinali o‘rganish modeli logS ni bashorat qila oladimi?” degan savoldan iborat emas. Asosiy savol turli xil kimyoviy axborot turlarini ifodalovchi molekulyar deskriptorlar, binary fingerprintlar va o‘rganilgan embeddinglarni bir nechta regressiya modeli bilan birlashtirish natijasida tashqi kimyoviy ma’lumotlar to‘plamlariga nisbatan bardoshliligi yuqoriroq eruvchanlikni bashorat qilish tizimini qurish mumkinmi, degan masaladir.
Suvda Eruvchanlikni Bashorat Qilishda logS Nimani Anglatadi?
Ushbu maqolada logS eksperimental suvda eruvchanlikning logarifmik maqsadli o‘zgaruvchisidir; model bashorat qilishga urinayotgan uzluksiz sonli chiqish aynan shudir. AqSolDB asosidagi o‘quv ma’lumotlarida logS qiymatlari −13.17 dan 2.14 gacha o‘zgaradi va manba past qiymatlarni juda past eruvchanlikka, yuqori qiymatlarni esa yuqoriroq eruvchanlikka mos keluvchi shkala sifatida ishlatadi. Biroq asosiy PDF ning Methods bo‘limida logarifm asosi va logS ostida ishlatiladigan xom eruvchanlik birligi alohida qayta ta’riflanmaganligi sababli Verianla bu tafsilotni manbadan tashqaridan qo‘shmaydi.
AqSolDB o‘quv ma’lumotlari
Tadqiqotda AqSolDB version 1.0 ishlatilgan. Yetishmayotgan yozuvlar olib tashlangach va dastlabki ishlovdan keyin ma’lumotlar to‘plami 9.982 ta noyob organik birikma ni o‘z ichiga oladi. Har bir birikma SMILES satri, InChIKey va eksperimental o‘lchangan logarifmik suvda eruvchanlik qiymati bilan ifodalanadi.
| Noyob birikmalar soni | 9.982 |
|---|---|
| Identifikatsiya/struktura tasvirlari | SMILES va InChIKey |
| Maqsadli o‘zgaruvchi | Eksperimental suvda eruvchanlik, logarifmik shkala |
| Minimum logS | −13.17 |
| Maksimum logS | 2.14 |
| O‘rtacha logS | −2.89 |
| Median logS | −2.62 |
Manba AqSolDB ning bir nechta adabiyot manbalaridan eksperimental kuzatuvlarni birlashtirishi ma’lumotlarda tabiiy shovqin va o‘zgaruvchanlik hosil qilishini bildiradi. Tadqiqotchilar buni faqat salbiy holat deb baholamaydilar; real erta bosqichdagi dori tadqiqotlarida turli o‘lchov manbalaridan keladigan geterogenlikka yaqinroq ssenariy yaratishini ta’kidlaydilar. Shu bilan birga, ayni xususiyat bashorat xatosiga faqat model arxitekturasi emas, balki eksperimental o‘lchovlar orasidagi farqlar ham ta’sir qilishi mumkinligini anglatadi.
O‘quv va tashqi test taqsimotlari nega bir xil emas?
Manbaning Figure 3 i o‘quv ma’lumotlari bilan turli tashqi test to‘plamlarining logS taqsimotlari bir xil emasligini ko‘rsatadi. Klop120 o‘quv taqsimotiga nisbatan yaqin bo‘lsa, Cui va Boobier torroq va ixchamroq taqsimotlarni ko‘rsatadi. Llinas1 va Llinas2 esa kengroq, tarqoqroq va past eruvchanlik hududiga siljigan taqsimotlarni namoyon qiladi. Tadqiqotchilar Llinas to‘plamlaridagi bu taqsimot siljishini modelning umumlashtirish qobiliyati nuqtayi nazaridan qiyinroq muammo deb baholaydilar.
Manbaning Figure 4 idagi t-SNE vizualizatsiyasi ham tashqi ma’lumotlar to‘plamlaridagi ko‘plab birikmalar o‘quv namunalarini qamrab olgan kimyoviy fazoning ichida yoki unga yaqin joylashganini; ayniqsa ayrim Llinas namunalari esa zich o‘quv klasterlarining atrofi yoki tashqarisida bo‘lishi mumkinligini ko‘rsatadi. Bu t-SNE grafigi modelning bashorat algoritmining o‘zi emas; ma’lumotlar to‘plamlarining kimyoviy fazodagi nisbiy joylashuvini vizuallashtirish uchun ishlatiladigan izohlovchi proyeksiyadir.
Molekulyar Deskriptor, Fingerprint va Mol2Vec Embedding O‘rtasidagi Farq Nimada?
Molekulyar deskriptorlar molekulaning o‘lcham, bog‘lanish, elektron yoki fizik-kimyoviy xususiyatlarini sonli qiymatlar bilan ifodalaydi; kimyoviy fingerprintlar muayyan strukturaviy motivlarning mavjudligini ko‘pincha 0/1 bitlari bilan kodlaydi; Mol2Vec esa molekulyar kichik tuzilmalarni Word2Vec ga o‘xshash tarzda uzluksiz vektor fazosida ifodalashni o‘rganadigan embedding usulidir. Tadqiqotning asosiy g‘oyasi shundaki, ushbu tasvirlar bir xil kimyoviy tuzilishga turli nuqtayi nazardan qarash imkonini bergani uchun bitta tasvir o‘rniga bir-birini to‘ldirishi mumkin.
MACCS fingerprint
MACCS key molekulyar tuzilishda muayyan kimyoviy xususiyatlar yoki kichik tuzilma motivlarining mavjud yoki mavjud emasligini binary bitlar bilan ifodalaydigan fingerprint yondashuvidir. Bitning 1 bo‘lishi tegishli xususiyat mavjudligini, 0 bo‘lishi esa mavjud emasligini anglatadi. Manba dastlabki ishlovdan oldin 167 ta MACCS xususiyati bo‘lganini, tozalashdan keyin 112 ta xususiyat qolganini bildiradi.
2D molekulyar deskriptorlar
Ikki o‘lchamli molekulyar deskriptorlar atomlarning uch o‘lchamli konformatsiyasidan bevosita foydalanish o‘rniga molekulaning bog‘lanish jadvaliga tayanadi. Ular o‘lcham, tarmoqlanish, bog‘lanish naqshi va elektron taqsimot bilan bog‘liq turli sonli xususiyatlarni hosil qilishi mumkin. Manbada 217 ta boshlang‘ich xususiyat dastlabki ishlovdan keyin 134 taga kamaygan.
Mordred deskriptorlari
Mordred cheminformatics tadqiqotlarida ko‘p sonli molekulyar deskriptorlarni hisoblay oladigan descriptor dasturidir. Manba umuman olganda Mordred 1.800 dan ortiq descriptorni hisoblay olishini bildiradi. Ushbu tadqiqot yaratgan xususiyatlar matritsasida tozalashdan oldingi Mordred xususiyatlari soni 1.613, dastlabki ishlovdan keyin esa 451.
Mol2Vec
Mol2Vec so‘zlar uchun ishlab chiqilgan Word2Vec mantiqiga o‘xshash tarzda molekulyar kichik tuzilmalar uchun zich vektor tasvirlarini o‘rganadigan nazoratsiz mashinali o‘rganish yondashuvidir. Molekulaning kichik tuzilmalaridan o‘rganilgan vektorlarni birlashtirish orqali butun molekula uchun sonli embedding hosil qilinadi. Tadqiqotda 300 o‘lchamli boshlang‘ich tasvirdan dastlabki ishlovdan keyin 185 ta xususiyat qolgan.
PubChem fingerprint
PubChem fingerprint halqa, atom jufti va boshqa strukturaviy motivlarning mavjudligini binary kichik tuzilma bitlari orqali ifodalaydi. Manbada tadqiqot boshidagi 881 ta PubChem xususiyati tozalashdan keyin 241 ta xususiyatgacha kamaygan.
| Tasvir | Boshlang‘ich xususiyatlar soni | Dastlabki ishlovdan keyin |
|---|---|---|
| MACCS | 167 | 112 |
| 2D descriptors | 217 | 134 |
| Mordred | 1.613 | 451 |
| Mol2Vec | 300 | 185 |
| PubChem | 881 | 241 |
Nega dastlabki ishlov ma’lumotlar bo‘lingandan keyin bajarildi?
Mashinali o‘rganishda barcha ma’lumotlar bo‘yicha xususiyatlarni tanlab, keyin o‘quv-test bo‘linishini yaratish test ma’lumotlarining statistik axboroti bilvosita o‘qitish jarayoniga sizib kirishiga olib kelishi mumkin. Manba bu xavfni kamaytirish uchun past variatsiya va yuqori korrelyatsiya filtrlarini ma’lumotlar bo‘lingandan keyin va har bir o‘quv foldi ichida mustaqil ravishda qo‘llagan. O‘quv foldida o‘rganilgan xususiyatlar kichik to‘plami keyin tegishli validatsiya/test qismiga qo‘llangan.
VarianceThreshold qiymati 0.01 sifatida ishlatilgan. Yetishmayotgan yoki cheksiz qiymatlarni o‘z ichiga olgan xususiyatlar olib tashlangan, so‘ng korrelyatsiya koeffitsiyenti 0.80 dan katta bo‘lgan ortiqcha xususiyatlar chiqarib tashlangan. Bunda maqsad shovqin va takrorlanishni kamaytirish bilan birga xususiyatlarni tanlash jarayonida baholash ma’lumotlarini oldindan ko‘rishning oldini olishdir.
Stacking Asosidagi Meta-O‘rganish Ushbu Tadqiqotda Qanday Ishlaydi?
Stacking yondashuvida bitta regressiya modelining bashorati yakuniy javob sifatida olinmaydi; turli bazaviy modellarning out-of-fold bashoratlari yangi “meta-feature”larga aylantiriladi va yuqori darajadagi meta-learner bu bashoratlarni birlashtirib yakuniy logS qiymatini hosil qiladi. Ushbu tadqiqotda besh karrali kross-validatsiya tufayli har bir o‘quv namunasi uchun meta-feature shu namunani o‘qitish vaqtida ko‘rmagan bazaviy modeldan hosil qilishga harakat qilingan; shu tariqa stacking qatlamiga o‘quv maqsadini bevosita yodlatadigan ma’lumotlar sizib chiqishi kamaytirilgan.
Out-of-fold bashorat mantiqi
O‘quv ma’lumotlari besh qismga bo‘lingan. Har bir iteratsiyada to‘rtta fold bazaviy modelni o‘qitish uchun, qolgan fold esa bashorat hosil qilish uchun ishlatiladi. Besh iteratsiya yakunida har bir o‘quv namunasi o‘zini o‘qitishda ko‘rmagan modeldan kamida bitta bashorat oladi. Bu bashoratlar yonma-yon joylashtirilib stacking meta-modelining o‘quv kirishi yaratiladi.
Keyin optimallashtirilgan bazaviy modellar barcha o‘quv ma’lumotlari asosida qayta o‘qitiladi va mustaqil tashqi test to‘plamlari uchun bashorat hosil qiladi. Ushbu tashqi bashoratlar ham xuddi shu tartibda stacking kirishiga aylantiriladi. Meta-learner bazaviy bashoratlardan yakuniy suvda eruvchanlik bashoratini hosil qiladi.
Taqqoslangan 17 regressiya algoritmi
| Usullar oilasi | Algoritmlar |
|---|---|
| Chiziqli / robust / regularized | Bayesian Ridge, Ridge, Lasso, ElasticNet, Huber, Linear Regression |
| Kernel / instance / yakka daraxt | Support Vector Regression, K-Nearest Neighbors, Decision Tree |
| Ensemble / boosting | Random Forest, Gradient Boosting, Histogram Gradient Boosting, AdaBoost, ExtraTrees, CatBoost, LightGBM, XGBoost |
Optuna bu yerda nima qiladi?
Optuna algoritmning mohiyatini o‘zgartiradigan bashorat modeli emas, balki model giperparametrlarining mos kombinatsiyalarini qidiradigan optimallashtirish frameworkidir. Manba tanlangan kuchli modellar uchun giperparametr optimallashtirishi har bir molekulyar encoding texnikasiga mustaqil qo‘llanganini bildiradi.
Biroq asosiy PDF Optuna nechta sinov o‘tkazgani, qaysi giperparametrlar qaysi diapazonlarda qidirilgani, qaysi sampler/pruner konfiguratsiyasidan foydalanilgani yoki optimallashtirishning random seed qiymatini xabar qilmaydi. Shu sababli ayni tadqiqotni bit darajasida takrorlamoqchi bo‘lgan o‘quvchi asosiy PDF dan bu tafsilotlarning barchasini ola olmaydi.
Bazaviy modellar soniga oid manba ichidagi noaniqlik
Abstract, Discussion, Methods 4.5 va Final features selection bo‘limlari CatBoost, ExtraTrees, Histogram Gradient Boosting va XGBoost nomlarini, ya’ni to‘rtta algoritmni beradi. Bunga qarshi ravishda Methods 4.6 “five top-performing machine-learning regression models”, Methods 4.8 esa “five optimized base regressors” iborasidan foydalanadi. Asosiy PDF beshinchi bazaviy algoritmni aniq nomlamaydi. Shu sababli Verianla “beshinchi model mana shu” tarzida manbadan tashqari to‘ldirish kiritmaydi.
Methods 4.8 da yana “mordered (order-sensitive) feature representations” iborasi uchraydi. Kontekst bu Mordred bilan bog‘liq yozuv muammosi bo‘lishi mumkinligini ko‘rsatsa-da, manba buni ochiq tuzatmagani sababli bu yerda qat’iy tuzatish qilinmagan.
GroupKFold Nega Qat’iyroq Umumlashtirish Testi Hisoblanadi?
Ushbu tadqiqotdagi GroupKFold bir xil Bemis–Murcko asosiy skeletiga ega molekulalarni bir fold ichida ushlab, o‘xshash scaffoldlarning ham o‘quv, ham validatsiya tomonida paydo bo‘lishiga yo‘l qo‘ymaslikka harakat qiladi; shu tariqa model juda yaqin strukturaviy qarindoshlarni yodlab yuqori natija ko‘rsatish o‘rniga ilgari ko‘rmagan asosiy chemotypelarga umumlashtirish qobiliyati yanada qat’iy sinovdan o‘tkaziladi. Buning evaziga, manba natijalarida ham ko‘ringanidek, ayrim metrikalar Random Split yoki RepeatedKFold ga qaraganda pastroq chiqishi mumkin.
Bemis–Murcko scaffold nima?
Bemis–Murcko scaffold molekulaning asosiy halqa va bog‘lanish skeletini ifodalash uchun ishlatiladigan strukturaviy xulosadir. Tadqiqotchilar RDKit yordamida har bir birikmaning scaffoldini hisoblagan, scaffold SMILES tasvirlarini hosil qilgan va bir xil asosiy tuzilishga ega molekulalarni umumiy guruh identifikatori ostida jamlagan.
GroupKFold keyin ushbu guruh belgilaridan foydalanib bir xil scaffoldning turli foldlarga bo‘linishining oldini olgan. Bu dizayn, ayniqsa kimyoviy o‘xshashlik yuqori bo‘lgan ma’lumotlar to‘plamlarida, o‘quv-validatsiya sizib chiqishini kamaytirishga qaratilgan.
Boshqa ma’lumotlarni bo‘lish strategiyalari
Random Split namunalarni tasodifiy bo‘ladi va manbada eng past o‘quv RMSE sini bergan; biroq strukturaviy jihatdan juda o‘xshash molekulalarning qarama-qarshi tomonlarga tushib qolish ehtimoli mavjud.
RepeatedKFold k-fold jarayonini turli tasodifiy bo‘linishlar bilan bir necha marta takrorlaydi. Maqsad bitta bo‘linish tasodifiga bog‘liqlikni kamaytirishdir.
ShuffleSplit ma’lumotlarni qayta-qayta aralashtirib, mustaqil o‘quv-test bo‘linishlarini yaratadi va turli namuna olish ssenariylarida samaradorlik o‘zgaruvchanligini o‘rganishga yordam beradi.
Tadqiqot Usuli va Natijalari
Besh karrali stacking o‘qitishning texnik oqimi
O‘quv ma’lumotlari taxminan teng besh foldga bo‘lingan. Har bir siklda to‘rtta fold bazaviy o‘rganuvchini o‘qitgan, qolgan fold ustida esa bashorat hosil qilingan. Besh foldning bashoratlari birlashtirilib out-of-fold meta-feature matritsasi hosil qilingan. Shu tariqa meta-modelni o‘qitadigan bashoratlarning tegishli namunani o‘qitish vaqtida ko‘rmagan bazaviy modeldan kelishi maqsad qilingan.
Meta-featurelarni hosil qilish tugagach, optimallashtirilgan bazaviy modellar butun o‘quv to‘plamida qayta o‘qitilgan va mustaqil tashqi test to‘plamlari uchun bashoratlar hosil qilgan. Bu bazaviy bashoratlarni birlashtirish orqali test meta-feature matritsasi yaratilgan, yakuniy logS bashoratlari stacking meta-modelidan olingan.
Turli split strategiyalarida o‘quv samaradorligi
| Split strategiyasi | MAE | MSE | RMSE | R² |
|---|---|---|---|---|
| Random Split | 0.727 | 0.830 | 0.911 | 0.838 |
| RepeatedKFold | 0.745 | 0.871 | 0.933 | 0.842 |
| GroupKFold | 0.796 | 0.973 | 0.985 | 0.782 |
| ShuffleSplit | 0.739 | 0.857 | 0.926 | 0.823 |
Random Split eng past RMSE ni 0.911 bilan bergan bo‘lsa, RepeatedKFold eng yuqori R² qiymatini 0.842 bilan bergan. GroupKFold da R² 0.782 gacha tushadi va RMSE 0.985 gacha ko‘tariladi. Bu farq avtomatik tarzda GroupKFold “yomon usul” degani emas; scaffold darajasidagi o‘xshashlikni alohida foldlarga o‘tkazmagani sababli baholash muammosi qiyinlashadi.
Mustaqil tashqi test to‘plamlari
| Test to‘plami | n | Random Split | RepeatedKFold | GroupKFold | ShuffleSplit |
|---|---|---|---|---|---|
| Klop120 | 90 | 0.431 / 0.540 / 0.967 | 0.421 / 0.527 / 0.969 | 0.561 / 0.701 / 0.934 | 0.432 / 0.541 / 0.967 |
| Yalk21 | 20 | 0.192 / 0.240 / 0.985 | 0.170 / 0.213 / 0.988 | 0.295 / 0.363 / 0.937 | 0.211 / 0.265 / 0.982 |
| Boobier | 95 | 0.410 / 0.513 / 0.911 | 0.391 / 0.489 / 0.919 | 0.492 / 0.616 / 0.873 | 0.417 / 0.523 / 0.908 |
| Cui | 62 | 0.417 / 0.522 / 0.654 | 0.438 / 0.549 / 0.618 | 0.586 / 0.730 / 0.519 | 0.421 / 0.528 / 0.647 |
| Llinas2020 Set1 | 99 | 0.668 / 0.837 / 0.564 | 0.663 / 0.831 / 0.572 | 0.719 / 0.899 / 0.563 | 0.686 / 0.859 / 0.541 |
| Llinas2020 Set2 | 32 | 1.106 / 1.387 / 0.581 | 1.039 / 1.302 / 0.631 | 1.145 / 1.423 / 0.588 | 1.118 / 1.401 / 0.572 |
Klop120 ma’lumotlar to‘plami nomida “120” bo‘lsa-da, manbaning Table 2 si ushbu baholashda n=90 deb xabar qiladi. Verianla jadval nomiga qarab namunalar sonini 120 ga o‘zgartirmagan.
RepeatedKFold; Klop120, Yalk21, Boobier va ikkita Llinas to‘plamida eng past yoki eng yaxshiga yaqin xatolar bilan kuchli natija beradi. Cui da esa Random Split R²=0.654 bilan RepeatedKFold ning 0.618 qiymatidan yuqoriroq va RMSE=0.522 bilan pastroq. Shu sababli bitta split strategiyasi barcha test to‘plamlarida bir xil tarzda ustun degan xulosaga kelib bo‘lmaydi.
MAE, MSE, RMSE va R² Nimani Anglatadi?
MAE o‘rtacha mutlaq bashorat xatosini, MSE xatolar kvadratlarining o‘rtachasini, RMSE MSE ning kvadrat ildizini va shu orqali xatoni yana maqsadli o‘zgaruvchining logS shkalasiga qaytaradigan kattalikni, R² esa model kuzatilgan logS o‘zgaruvchanligining qancha qismini tushuntirishini o‘lchaydi. MAE, MSE va RMSE uchun kichikroq; R² uchun esa umuman 1 ga yaqinroq qiymat yaxshiroq samaradorlikni bildiradi, biroq bitta metrika modelning butun xato tuzilmasini tushuntirib bera olmaydi.
Tenglama 1: O‘rtacha Mutlaq Xato — MAE
\(\displaystyle MAE=\frac{1}{n}\sum_{i=1}^{n}|y_i-\hat{y}_i|\)
1. Formula nimani hisoblaydi? Har bir birikma uchun haqiqiy logS bilan model bashorati o‘rtasidagi farqning mutlaq qiymatini oladi va barcha namunalar bo‘yicha o‘rtachasini hisoblaydi.
2. O‘zgaruvchilar nimalar? \(n\) umumiy namunalar soni; \(y_i\) i-chi namunaning eksperimental/kuzatilgan eruvchanlik qiymati; \(\hat{y}_i\) esa shu namuna uchun model bashoratidir.
3. Birlik nima? MAE maqsadli o‘zgaruvchi bilan bir xil shkalada ifodalanadi. Ushbu tadqiqotda maqsad logS bo‘lgani sababli MAE ham logS maqsad shkalasidadir. PDF logS ning xom birligini alohida ta’riflamagani sababli bundan tashqari fizik birlik qo‘shilmaydi.
4. Matematik roli nima? Mutlaq qiymat musbat va manfiy bashorat xatolarining bir-birini bekor qilishiga yo‘l qo‘ymaydi. Har bir xato kattaligiga chiziqli og‘irlik beradi.
5. Algoritmik ma’nosi nima? Model odatiy namunada eksperimental qiymatdan taxminan qanchaga og‘ishini to‘g‘ridan-to‘g‘ri o‘qiladigan tarzda umumlashtiradi.
6. Qaysi shartda amal qiladi? Haqiqiy va bashorat qilingan qiymatlar bir xil maqsad shkalasida bo‘lishi kerak. Turli ma’lumotlar to‘plamlarining maqsad taqsimotlari har xil bo‘lsa, faqat MAE ga qarab umumlashtirish sifatining barchasini tushuntirib bo‘lmaydi.
7. Qanday talqin qilinadi? Pastroq MAE o‘rtacha mutlaq bashorat og‘ishi kichikroq ekanini ko‘rsatadi; biroq kam sonli juda katta xatolarni MSE kabi kuchli jazolamaydi.
Tenglama 2: O‘rtacha Kvadrat Xato — MSE
\(\displaystyle MSE=\frac{1}{n}\sum_{i=1}^{n}(y_i-\hat{y}_i)^2\)
1. Formula nimani hisoblaydi? Har bir bashorat xatosining kvadratini oladi va kvadrat xatolarning o‘rtachasini hisoblaydi.
2. O‘zgaruvchilar: \(n\), \(y_i\) va \(\hat{y}_i\) MAE tenglamasidagi ma’nolarini saqlab qoladi.
3. Birlik: Maqsad shkalasining kvadratidir; shu sababli MSE ni MAE yoki RMSE kabi bevosita maqsad shkalasida o‘qish mumkin emas.
4. Matematik rol: Xato kvadratga ko‘tarilgani uchun katta og‘ishlar kichik og‘ishlarga qaraganda nomutanosib ravishda ko‘proq jazolanadi.
5. Algoritmik ma’no: Juda katta bashorat xatolari istalmagan muammolarda modelning katta og‘ishlariga sezgir sifat o‘lchovidir.
6. Shart: MSE kattaligi maqsadli o‘zgaruvchining shkalasidan ta’sirlanadi; turli shkalalardagi vazifalarni aynan bir MSE soni bilan bevosita taqqoslab bo‘lmaydi.
7. Talqin: Pastroq MSE yaxshiroq, biroq kvadratga oshirish sababli bir nechta chekka xato qiymati metrikani keskin oshirishi mumkin.
Tenglama 3: Ildiz O‘rtacha Kvadrat Xato — RMSE
\(\displaystyle RMSE=\sqrt{\frac{1}{n}\sum_{i=1}^{n}(y_i-\hat{y}_i)^2}\)
1. Formula nimani hisoblaydi? MSE ning kvadrat ildizini oladi.
2. O‘zgaruvchilar: \(n\), \(y_i\) va \(\hat{y}_i\) oldingi tenglamalardagi bilan bir xil.
3. Birlik: Kvadrat ildiz tufayli maqsadli o‘zgaruvchi shkalasiga qaytadi; ushbu tadqiqotda logS maqsad shkalasida talqin qilinadi.
4. Matematik rol: Avval katta xatolarni kvadratga ko‘tarib ta’kidlaydi, so‘ng kvadrat ildiz orqali natijani yana maqsad shkalasiga qaytaradi.
5. Algoritmik ma’no: Katta bashorat xatolariga MAE dan sezgirroq, ammo MSE dan ko‘ra bevosita o‘qish qulayroq bo‘lgan xato metrikasidir.
6. Shart: Ma’lumotlar to‘plamining taqsimoti va chekka qiymatlar RMSE ga ta’sir qilishi mumkin; shuning uchun turli external setlardagi RMSE farqlari kimyoviy taqsimot farqlari bilan birga baholanishi kerak.
7. Talqin: RMSE ning kamayishi odatda yaxshiroq bashorat samaradorligini ko‘rsatadi. Masalan, Yalk21 RepeatedKFold RMSE=0.213 bo‘lsa, Llinas2020 Set2 da 1.302; model ikkinchi ma’lumotlar to‘plamida ancha yuqori xato hosil qiladi.
Tenglama 4: Determinatsiya Koeffitsiyenti — R²
\(\displaystyle R^2=1-\frac{\sum_{i=1}^{n}(y_i-\hat{y}_i)^2}{\sum_{i=1}^{n}(y_i-\bar{y})^2}\)
1. Formula nimani hisoblaydi? Modelning kvadrat bashorat xatosini kuzatilgan qiymatlarning o‘z o‘rtachasidan umumiy kvadrat og‘ishi bilan taqqoslaydi.
2. O‘zgaruvchilar: \(y_i\) haqiqiy qiymat, \(\hat{y}_i\) bashorat, \(\bar{y}\) kuzatilgan maqsad qiymatlarining o‘rtachasi va \(n\) namunalar sonidir.
3. Birlik: Ikki kvadrat yig‘indisining nisbati bo‘lgani uchun R² o‘lchovsiz.
4. Matematik rol: Suratdagi residual sum of squares kichraygani sari nisbat kamayadi va R² 1 ga yaqinlashadi.
5. Algoritmik ma’no: Model bashoratlari kuzatilgan logS o‘zgaruvchanligini qay darajada tushuntirishining qisqacha ko‘rsatkichidir.
6. Shart: R² ma’lumotlar to‘plamining maqsad taqsimotidan ta’sirlanishi mumkin. Tor maqsad diapazoni yoki distribution shift sharoitida bir xil RMSE turlicha R² xatti-harakatini ko‘rsatishi mumkin.
7. Talqin: R²=1 mukammal moslikka to‘g‘ri keladi. R² ning nolga yaqinlashishi tushuntirish quvvati zaiflashishini, noldan pastga tushishi esa model hatto o‘rtacha qiymat bilan bashorat qilishdan ham yomonroq ishlashi mumkinligini ko‘rsatadi. Ushbu tadqiqot tashqi testlarda ma’lumotlar to‘plamiga qarab ancha turli R² qiymatlarini xabar qiladi.
MetaModel, SolPredictor va GGAS2SN taqqoslanishi
| Ma’lumotlar to‘plami | MetaModel | SolPredictor | GGAS2SN |
|---|---|---|---|
| Boobier | 0.428 / 0.597 / 0.880 | 0.821 / 1.103 / 0.591 | 0.539 / 0.696 / 0.837 |
| Cui | 0.444 / 0.567 / 0.592 | 0.722 / 0.862 / 0.057 | 0.428 / 0.519 / 0.608 |
| Klop120 | 0.424 / 0.603 / 0.959 | 0.965 / 1.208 / 0.837 | 0.499 / 0.680 / 0.948 |
| Llinas set1 | 0.619 / 0.882 / 0.517 | 1.000 / 1.250 / 0.474 | 0.719 / 0.940 / 0.451 |
| Llinas set2 | 1.027 / 1.372 / 0.590 | 1.458 / 1.762 / 0.323 | 0.990 / 1.242 / 0.633 |
| Lovric1 | 0.511 / 0.780 / 0.807 | 0.625 / 0.783 / 0.803 | 0.655 / 0.794 / 0.775 |
| Yalk21 | 0.332 / 0.387 / 0.961 | 1.075 / 1.204 / 0.618 | 0.447 / 0.588 / 0.909 |
Ushbu jadval muhim nozik jihatni ko‘rsatadi: MetaModel ko‘plab ma’lumotlar to‘plamlarida kuchli, biroq barcha ma’lumotlar to‘plamlarida eng yaxshisi emas. Cui da GGAS2SN ham pastroq MAE/RMSE, ham yuqoriroq R² beradi. Llinas set2 da ham GGAS2SN ning MAE, RMSE va R² qiymatlari MetaModeldan yaxshiroq. Shu sababli mualliflarning umumiy “robust” talqiniga qaramay, manba jadvalidagi sonli mazmun usul ustunligi ma’lumotlar to‘plamiga bog‘liqligini ko‘rsatadi.
Table 2 va Table 3 nega bir xil sonlarni bermaydi?
Table 2 bir xil stacking MetaModelni turli split strategiyalari ostida taqqoslasa, Table 3 MetaModelni SolPredictor va GGAS2SN bilan solishtiradi. Umumiy ma’lumotlar to‘plamlarida raqamlar aynan bir xil emas; masalan, Boobier uchun Table 2 da RepeatedKFold R²=0.919 bo‘lsa, Table 3 da MetaModel R²=0.880. Asosiy PDF bu jadvallar orasidagi samaradorlik farqining aniq baholash konfiguratsiyasini batafsil uyg‘unlashtirmaydi. Shu sababli Verianla ikki jadvalni xuddi bitta samaradorlik jadvali kabi birlashtirmagan.
Statistik model taqqoslashlari
Tadqiqotchilar har bir namuna bo‘yicha mutlaq bashorat xatolari ustida Wilcoxon signed-rank testlari va paired t-testlardan foydalangan. Boobier va Cui ma’lumotlar to‘plamlarida MetaModelning SolPredictorga nisbatan ustunligi P<0.001 sifatida xabar qilingan. Boobier da MetaModel bilan GGAS2SN o‘rtasidagi farq P<0.05 darajasida ahamiyatli. Cui da esa MetaModel bilan GGAS2SN o‘rtasida P>0.05 bo‘lib, statistik jihatdan ahamiyatli farq xabar qilinmagan.
Bu statistik natijalar Table 3 da Cui ustida GGAS2SN sonli jihatdan biroz yaxshiroq metrikalar berishi bilan birga o‘qilishi kerak: kichik metrik farqi statistik jihatdan ahamiyatli bo‘lmasligi mumkin. Sonli ustunlik bilan statistik jihatdan ko‘rsatilgan ustunlik bir xil tushuncha emas.
Spearman va Kendall korrelyatsiyalari
Manba keng logS dinamik diapazonida faqat R² ga tayanib qolmaslik uchun Spearman rank correlation coefficient (ρ) va Kendall's Tau (τ) ham baholanganini bildiradi. Klop120 uchun Spearman ρ=0.97 va Boobier uchun ρ=0.95 aniq yozilgan.
Biroq manba jumlasining Yalk21 va undan keyingi ρ=0.80 qismida grammatik/format buzilishi mavjud: “Yalk21 (ρ) ... (ρ = 0.80)” tuzilishi 0.80 qiymati qaysi ma’lumotlar to‘plamiga aniq tegishli ekanini ochiq qoldiradi. Asosiy matnda Kendall τ qiymatlarining sonli jadvali ham ko‘rsatilmagan. Shu sababli Verianla ρ=0.80 yoki τ uchun manbada aniq bo‘lmagan ma’lumotlar to‘plami mosligini yaratmaydi.
Predicted vs experimental logS grafiklari nimani ko‘rsatadi?
Manbaning Figure 1 i Boobier, Cui, Llinas set1 va Klop120 ma’lumotlar to‘plamlarida eksperimental logS tendensiyasi bilan MetaModel, SolPredictor va GGAS2SN bashoratlari o‘rtasidagi munosabatni taqqoslaydi. Mualliflar talqiniga ko‘ra MetaModel ayniqsa taxminan −4 dan −2 logS gacha bo‘lgan o‘rta hududda eksperimental tendensiyaga yaqin boradi.
Juda yuqori yoki juda past eruvchanlik chekkalarida esa bashorat egri chiziqlari tekislanish tendensiyasini ko‘rsatishi qayd etilgan. Bu model ekstremal eruvchanlik o‘zgarishlariga o‘rta diapazondagidek sezgir bo‘lmasligi mumkinligini anglatadi. Figure 1 ning xom binned koordinatalari jadval ko‘rinishida berilmaganligi sababli Verianla grafikni qayta chizib yangi sonli nuqtalar yaratmaydi.
Figure 2 xato taqsimoti va manba ichidagi son ziddiyati
Figure 2 mutlaq bashorat xatolarini uch oraliqqa ajratadi: ≤0.5, 0.5<x≤1.0 va >1.0. Vizualdagi yorliqlarda Boobier uchun taqsimot taxminan %69.35 / %22.58 / %8.06; Cui uchun %72.63 / %14.74 / %12.63; Klop120 uchun %72.22 / %21.11 / %6.67; Llinas set1 uchun %60.61 / %19.19 / %20.2 ko‘rinadi.
Biroq ayni shakl izohida Klop120 uchun ≤0.5 xato ulushi %77.22 deb, oldingi natijalar paragrafida esa taxminan %77 deb yozilgan. Vizual yorliq esa %72.22. Ushbu manba ichidagi nomuvofiqlikni hal qilingan ma’lumot sifatida taqdim etib bo‘lmaydi. Ishonch bilan aytish mumkin bo‘lgan jihat shuki, Klop120 da past xato guruhi ustun, Llinas set1 da esa >1.0 xato guruhi yuqoriroq.
Funksional guruh taqsimoti nimani anglatadi?
Manbaning Figure 5 i hydroxyl, ether, carbonyl, halogen va aromatic tuzilmalar o‘rtasidagi qoplanishlarni ko‘rsatib, o‘quv ma’lumotlar to‘plamining kimyoviy xilma-xilligini tushuntirishga urinadi. Aromatik tuzilmalarning ko‘p bo‘lishi gidrofob halqa tizimlari ma’lumotlar to‘plamida keng tarqalganini; hydroxyl va carbonyl kabi qutbli funksional guruhlarning aromatic tizimlar bilan bir xil molekulalarda birgalikda bo‘lishi esa ko‘plab birikmalar ham gidrofob, ham gidrofil xususiyatlarga ega ekanini ko‘rsatadi.
Mualliflar hydroxyl va carbonyl guruhlari suv bilan hydrogen bonding yoki dipole–dipole o‘zaro ta’sirlari orqali eruvchanlikni qo‘llab-quvvatlashi, halogenlar esa lipofillikni oshirib eruvchanlikni kamaytirishi mumkinligini muhokama qiladi. Bu izohlar ma’lumotlar to‘plami tarkibini kimyoviy nuqtayi nazardan talqin qiluvchi umumiy mexanistik frameworkdir; Figure 5 ning o‘zi muayyan funksional guruhning ushbu ma’lumotlar to‘plamidagi eruvchanlikka sababiy hissasi miqdorini o‘lchamaydi.
Yuqori R² Model Har Bir Kimyoviy Fazoda Ishonchli Ekanini Anglatadimi?
Yo‘q. Ushbu tadqiqotda Yalk21 va Klop120 kabi ayrim tashqi to‘plamlarda R² taxminan 0.97-0.99 gacha yetar ekan, Llinas va Cui kabi taqsimoti yoki kimyoviy sohasi qiyinroq bo‘lgan to‘plamlarda R² sezilarli pasayadi; demak, yuqori R² muayyan baholash ma’lumotlar to‘plamida kuchli moslikni ko‘rsatadi, barcha noma’lum chemotypelarda ayni aniqlik kafolatlanganini anglatmaydi. GroupKFold natijalarining pastroq bo‘lishi va Llinas to‘plamlaridagi yuqori xatolar ham strukturaviy taqsimot o‘zgarishi umumlashtirishni qiyinlashtirishini qo‘llab-quvvatlaydi.
Tadqiqotning kuchli tomonlari
Birinchi kuchli tomon molekulani bitta encoding bilan cheklash o‘rniga binary fingerprints, klassik descriptorlar va o‘rganilgan Mol2Vec embeddinglarini birgalikda baholashidir. Bu yondashuv turli tasvir turlarining bir-birini to‘ldirishiga imkon beradi.
Ikkinchi kuchli tomon 17 xil regressiya algoritmi umumiy baholash tuzilmasida taqqoslangan va kuchli modellar Optuna bilan alohida optimallashtirilganidir.
Uchinchi kuchli tomon stacking uchun out-of-fold meta-feature hosil qilishdan foydalanilganidir. Bu dizayn meta-modelning o‘z o‘quv namunalarini ko‘rgan bazaviy bashoratlardan bevosita oziqlanish xavfini kamaytirishga qaratilgan.
To‘rtinchi kuchli tomon faqat bitta random splitga tayanilmaganidir; Random Split, RepeatedKFold, GroupKFold va ShuffleSplit natijalari birgalikda ko‘rib chiqilgan.
Beshinchi kuchli tomon model AqSolDB o‘quv sohasidan tashqaridagi mustaqil test kolleksiyalarida baholangan va SolPredictor hamda GGAS2SN kabi avvalgi modellar bilan taqqoslangan.
Asosiy cheklovlar
Birinchi cheklov ma’lumotlar sifatidir. AqSolDB ko‘plab adabiyot manbalaridagi eksperimental eruvchanlik o‘lchovlarini birlashtirgani sababli turli laboratoriya sharoitlaridan kelib chiqadigan shovqin va geterogenlikni o‘z ichiga olishi mumkin.
Ikkinchi cheklov descriptor asosidagi tasvir murakkab uch o‘lchamli yoki uzoq masofali strukturaviy o‘zaro ta’sirlarni to‘liq ifodalay olmasligi mumkinligidir. Manba mualliflari kelajakdagi tadqiqotlar uchun graph neural networks, transformer asosidagi molekulyar embeddinglar va pretrained molecular encodersni tavsiya qiladilar.
Uchinchi cheklov kimyoviy domain shiftdir. Llinas ma’lumotlar to‘plamlarida taqsimot o‘quv sohasidan ko‘proq og‘adi va bashorat xatolari ortadi.
To‘rtinchi cheklov modelning ekstremal eruvchanlik hududlarida bashoratlari tekislanishi mumkinligidir; manba bu holatni juda yuqori yoki juda past logS qiymatlaridagi o‘zgarishlarga nisbatan pastroq sezgirlik sifatida muhokama qiladi.
Beshinchi cheklov asosiy PDF ayrim qayta ishlab chiqish tafsilotlarini bermasligidir. Random seed, ishlatilgan hisoblash uskunasi, Optuna sinovlari soni va to‘liq giperparametr qidiruv fazolari, stacking meta-learnerning aniq algoritmi hamda barcha final model giperparametrlari asosiy matnda yo‘q.
Oltinchi cheklov bazaviy modellar sonidagi manba ichidagi nomuvofiqlikdir: maqolaning ayrim bo‘limlari to‘rtta nomni beradi, ayrim Methods paragraflarida esa beshta bazaviy regressordan so‘z yuritiladi.
Yettinchi cheklov Figure 2 da Klop120 past xato foizining grafik yorlig‘i bilan izoh/matn o‘rtasidagi mos kelmasligidir.
Tadqiqot qo‘llab-quvvatlaydigan talqinlar
- Bir nechta molekulyar tasvir va ensemble regressiya modellarini stacking tuzilmasida birlashtirish suvda eruvchanlikni bashorat qilishda kuchli samaradorlik berishi mumkin.
- Model ayrim mustaqil tashqi ma’lumotlar to‘plamlarida yuqori R² va past bashorat xatosini ko‘rsatgan.
- RepeatedKFold ko‘plab tashqi ma’lumotlar to‘plamlarida kuchli va barqaror natijalar bergan.
- Scaffold asosidagi GroupKFold qat’iyroq strukturaviy umumlashtirish bahosini taqdim etadi.
- MetaModel SolPredictorga nisbatan Boobier va Cui da statistik jihatdan ahamiyatli darajada pastroq xato ko‘rsatgan.
- Model muvaffaqiyati tashqi ma’lumotlar to‘plamining kimyoviy taqsimotiga bog‘liq.
- Molekulyar encoding tanlovi va ma’lumotlarni bo‘lish strategiyasi samaradorlikni baholashning muhim qismlaridir.
Tadqiqot qo‘llab-quvvatlamaydigan talqinlar
- MetaModel barcha molekulalarda va barcha ma’lumotlar to‘plamlarida eng yaxshi model ekani ko‘rsatilmagan.
- Model eksperimental eruvchanlik o‘lchovining xatosiz o‘rnini bosishini isbotlamaydi.
- Yuqori R² barcha kimyoviy fazolarda bir xil umumlashtirish samaradorligini kafolatlamaydi.
- Descriptor yoki fingerprintlardagi muayyan xususiyatning eruvchanlikka sababiy ta’siri ushbu model taqqoslashidan o‘z-o‘zidan chiqarib bo‘lmaydi.
- t-SNE grafigidagi yaqinlik bevosita model aniqligi yoki kimyoviy sababiylik o‘lchovi emas.
- Table 2 dagi eng yaxshi split natijasi bilan Table 3 dagi usul taqqoslash natijasi bir xil samaradorlik tajribasi kabi birlashtirilishi mumkin emas.
- Manbada ochiqlanmagan beshinchi bazaviy model, meta-learner algoritmi yoki Optuna giperparametrlari taxmin qilib to‘ldirilishi mumkin emas.
Amaliy ma’nosi
Ushbu framework katta molekula kutubxonalaridagi nomzodlarni eksperimental sinovga kirishdan oldin hisoblash orqali saralash, erta dori kashfiyotida past eruvchanlikka ega nomzod xavfini oldindan baholash va molekulyar dizayn siklida dastlabki saralashni amalga oshirish uchun potensial vositadir. Biroq manba mualliflari ham kelajakdagi tadqiqotlarni ko‘proq eksperimental eruvchanlik ma’lumotlari, graph neural networks, transformer asosidagi modellar va pretrained molecular encoders bilan kengaytirishni tavsiya qiladilar.
Manba va Usul Haqida Izoh
Original sarlavha: Integrating molecular descriptors and fingerprints via meta-learning for aqueous solubility prediction.
Mualliflar va tartib: Waqar Ahmad, Muhannad Dehni, Rida Arshad, Myunghum Park, Hilal Tayara, Ki-Duk Song.
Hissa belgisi: Yuklangan Article in Press PDF Waqar Ahmad, Muhannad Dehni va Rida Arshadni “+ Contributing author” belgisi bilan ko‘rsatadi. Manba aniq “equal contribution” iborasidan foydalanmagani sababli teng hissa deb faraz qilinmagan.
Mas’ul mualliflar: Myunghum Park, Hilal Tayara va Ki-Duk Song.
PDF dagi muassasa 1: Department of Agricultural Convergence Technology, Jeonbuk National University, Jeonju, South Korea.
Muassasa 2: Research and Development Center, TNT Research, Sejong, South Korea.
Muassasa 3: Global Frontier College, Jeonbuk National University, Jeonju, South Korea.
Joriy rasmiy qayddagi farq: Nature ning joriy erta kirish sahifasi Ki-Duk Song uchun qo‘shimcha ravishda International Agricultural Development and Cooperation Center, Jeonbuk National University affiliatsiyasini ko‘rsatadi. Bu muassasa yuklangan Article in Press PDF ning affiliatsiyalar ro‘yxatida mavjud emas.
Jurnal: Scientific Reports.
Platforma: Nature Portfolio / nature.com.
Nashr turi: Article; accepted, peer-reviewed early-access / Article in Press versiyasi.
Preprint holati: Preprint emas. Scientific Reports tomonidan qabul qilingan va erta kirishga chiqarilgan taqrizdan o‘tgan tadqiqotdir.
DOI: 10.1038/s41598-026-65722-y.
Qabul qilib olingan sana: 26 mart 2026.
Qabul qilingan sana: 3 avgust 2026.
Joriy rasmiy nashr sanasi: 19 avgust 2026.
Final versiya holati: Nature ning joriy sahifasi mavjud versiya accepted research early-access versiyasi ekanini va keyinchalik final Version of Record bilan avtomatik almashtirilishini bildiradi.
Jild / final maqola raqami: Joriy erta kirish qaydida final bibliografik jild/maqola raqami hali aniq shaklda ko‘rsatilmagani sababli manbadan tashqari qiymat qo‘shilmagan.
Litsenziya: Creative Commons Attribution-NonCommercial-NoDerivatives 4.0 International (CC BY-NC-ND 4.0).
Litsenziyaning vizual natijasi: Manbadagi Figure 1-6 bevosita moslashtirilmagan yoki ko‘chirilmagan. Maqoladagi inline SVG Methods matnida keltirilgan faktik jarayon ketma-ketligidan mustaqil ravishda yaratilgan.
Moliyalashtirish: Basic Science Research Program through the National Research Foundation of Korea, Ministry of Education, grant 2021R1I1A3057071; shuningdek Regional Innovation System and Education (RISE) dasturi, Jeonbuk RISE Center, Ministry of Education va Jeonbuk State ko‘magi, 2026-RISE-13-JBU.
Muallif hissalari: W.A., M.D. va R.A. tajribalarni o‘tkazgan; M.P., H.T. va K.D.S. natijalarni tahlil qilgan; barcha mualliflar maqolani ko‘rib chiqqan.
Ma’lumotlardan foydalanish imkoniyati: Ishlatilgan va/yoki tahlil qilingan ma’lumotlar to‘plamlarini asosli so‘rov asosida corresponding authordan olish mumkinligi bildirilgan.
Manfaatlar to‘qnashuvi: Mualliflar competing financial interest mavjud emasligini e’lon qiladilar.
Asosiy ma’lumot manbasi: AqSolDB version 1.0; dastlabki ishlovdan so‘ng 9.982 ta noyob organik birikma.
Molekulyar tasvirlar: MACCS, 2D molecular descriptors, Mordred, Mol2Vec va PubChem.
Model oilasi: 17 ta regressiya algoritmini taqqoslash, Optuna giperparametr optimallashtirishi va stacking asosidagi meta-learning.
Aniq nomlangan final bazaviy algoritmlar: CatBoost, ExtraTrees, Histogram Gradient Boosting va XGBoost.
Manba ichidagi model soni nomuvofiqligi: Ayrim Methods paragraflari “five” top-performing/base regressors iborasidan foydalanadi, boshqa bo‘limlar esa faqat to‘rtta algoritm nomini beradi. Beshinchi algoritm asosiy PDF da aniq emas.
Manba ichidagi matn noaniqligi: Methods 4.8 da “mordered (order-sensitive)” iborasi mavjud; uning nimani anglatishi manba tomonidan alohida tuzatilmagan.
Manba ichidagi Figure 2 nomuvofiqligi: Klop120 uchun ≤0.5 xato guruhining doiraviy diagramma yorlig‘i %72.22 bo‘lsa, shakl izohida %77.22 va natijalar matnida taxminan %77 deb keltiriladi.
Rank-correlation chegarasi: Klop120 uchun ρ=0.97 va Boobier uchun ρ=0.95 aniq; qolgan ρ=0.80 iborasining qaysi ma’lumotlar to‘plamiga tegishli ekani manba jumlasidagi format buzilishi sababli aniqlashtirilmagan. Asosiy matnda Kendall τ uchun batafsil sonli jadval berilmagan.
Qayta ishlab chiqish chegarasi: Asosiy PDF exact random seed, Optuna trial soni va batafsil search space, hisoblash uskunasi hamda stacking meta-learnerning aniq algoritmini xabar qilmaydi.
Asosiy ilmiy chegara: Tadqiqot hisoblashga asoslangan QSPR/mashinali o‘rganish bashorat tadqiqotidir. Model chiqishlari eksperimental eruvchanlik o‘lchovi emas va yangi kimyoviy sohalarda samaradorlik tashqi validatsiyani talab qiladi.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan