


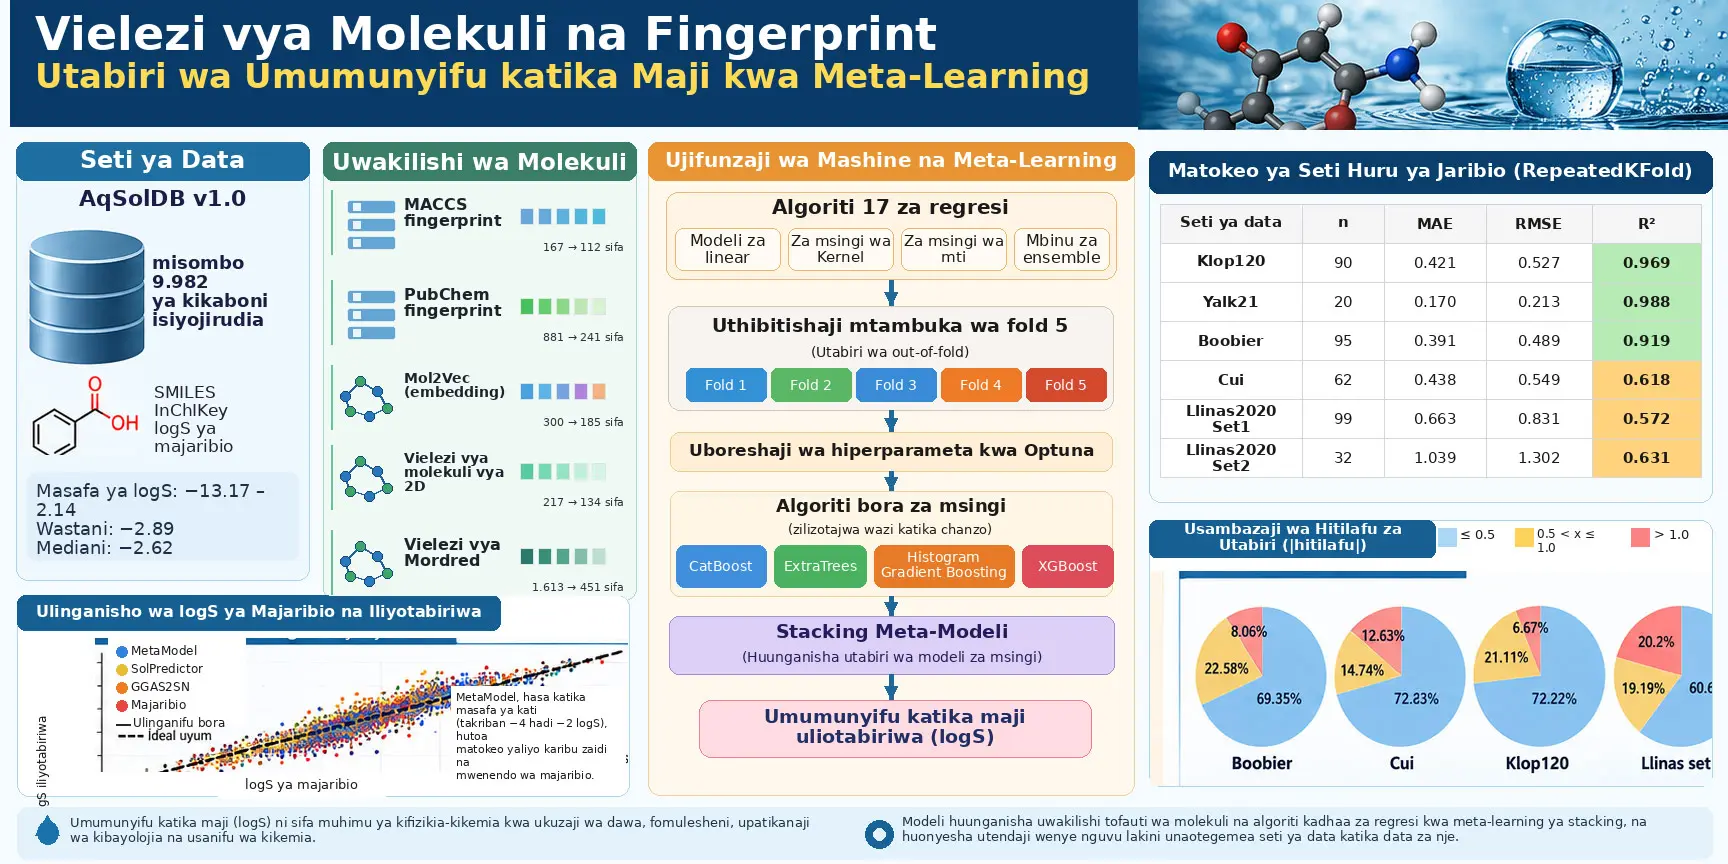
Meta-modeli inayotegemea stacking katika utafiti huu ni mfumo wa ujifunzaji wa mashine unaosimba molekuli kwa kutumia zaidi ya uwakilishi mmoja wa nambari na kuunganisha utabiri wa algoriti tofauti za regresi katika tabaka la juu la ujifunzaji ili kutabiri umumunyifu katika maji (logS). Watafiti walitumia misombo 9.982 ya kikaboni isiyojirudia iliyobaki baada ya uchakataji wa awali kutoka AqSolDB v1.0; walitathmini uwakilishi wa molekuli unaokamilishana kama vile fingerprint za MACCS, fingerprint za PubChem, embedding za Mol2Vec, vielezi vya molekuli vya pande mbili na vielezi vya Mordred. Jumla ya algoriti 17 za regresi zililinganishwa kwa uthibitishaji mtambuka wa mikunjo mitano, hiperparameta ziliboreshwa kwa Optuna, na usanidi uliofanya vizuri zaidi ukaunganishwa katika usanifu wa stacking.
Utendaji wa modeli haukutathminiwa kwa uthibitishaji mtambuka wa ndani ya mafunzo pekee; pia ulijaribiwa katika seti huru za nje za majaribio kama Klop120, Yalk21, Boobier, Cui na seti mbili za Llinas2020. Katika Table 2, MetaModel inayotegemea RepeatedKFold ilifikia R²=0.969 na RMSE=0.527 kwa Klop120, R²=0.988 na RMSE=0.213 kwa Yalk21, na R²=0.919 na RMSE=0.489 kwa Boobier. Hata hivyo, utendaji hupungua katika seti za data za Cui na hasa Llinas; kwa mfano, RepeatedKFold ina R²=0.572 kwa Llinas2020 Set1 na R²=0.631 kwa Set2. Hali hii inaonyesha kuwa mafanikio ya modeli yanategemea mgawanyo wa kikemia na ufanano kati ya eneo la mafunzo na eneo la majaribio ya nje.
Chanzo pia kinawasilisha ulinganisho wa modeli na mbinu za awali zinazoitwa SolPredictor na GGAS2SN. Katika Table 3, MetaModel kwa ujumla inaonyesha hitilafu ndogo na/au R² ya juu zaidi katika seti za data za Boobier, Klop120, Llinas set1, Lovric1 na Yalk21. Hata hivyo, si ya kwanza katika kila seti ya data: katika Cui na Llinas set2, GGAS2SN hutoa thamani bora kuliko MetaModel katika baadhi ya vipimo vikuu vya hitilafu na R². Kwa hiyo, utafiti huu hauungi mkono hitimisho kwamba “MetaModel inawashinda washindani wote katika nafasi zote za kikemia.”
Moja ya nguvu za utafiti ni mpangilio wa tathmini uliokusudiwa kupunguza uvujaji wa data. Uchakataji wa awali ulitekelezwa kwa kujitegemea ndani ya kila fold ya mafunzo baada ya data kugawanywa, na katika jaribio la GroupKFold, scaffold za Bemis–Murcko zilitumika kuzuia misombo yenye kiunzi kilekile cha msingi cha molekuli kutawanyika kati ya fold za mafunzo na uthibitishaji. Hata hivyo, PDF kuu hairipoti baadhi ya maelezo muhimu kwa uzalishaji upya, kama exact random seed, idadi ya Optuna trial na nafasi ya utafutaji, algoriti kamili ya meta-learner na vifaa vya kompyuta vilivyotumika.
Kikomo muhimu zaidi cha tafsiri ya utafiti ni hiki: thamani za juu za R² na za chini za RMSE hazimaanishi kwamba modeli inachukua nafasi ya kipimo cha majaribio cha umumunyifu bila hitilafu katika kila darasa la kemikali. Figure 1 ya chanzo inaonyesha wazi kuwa katika misombo yenye umumunyifu wa chini sana au wa juu sana, utabiri una mwelekeo wa kusawazika, hitilafu huongezeka katika seti za data za Llinas, na utendaji wa modeli hutegemea mgawanyo wa data. Modeli ni zana ya kihesabu kwa uchunguzi wa molekuli katika hatua za awali; si mbadala wa jumla wa kipimo cha majaribio cha umumunyifu.
Kwa nini tatizo la utafiti ni muhimu?
Umumunyifu katika maji ni sifa ya msingi ya kifizikia-kikemia inayoeleza kiwango ambacho molekuli inaweza kuyeyuka katika mazingira yenye maji. Katika ukuzaji wa dawa, umumunyifu unaweza kuathiri uwezekano wa kutengeneza fomulesheni, upatikanaji wa kibayolojia na tabia ya kifamakokinetiki. Chanzo pia kinabainisha kuwa tatizo hili ni muhimu katika ukuzaji wa agrochemical na utafiti wa nyenzo. Ingawa vipimo vya majaribio vya umumunyifu vina thamani, vinahitaji muda, rasilimali na mazingira ya maabara; pia vinaweza kuathiriwa na mambo ya majaribio kama pH, joto na umbo la fuwele.
Kwa hiyo, tatizo la utafiti si tu “je, modeli ya ujifunzaji wa mashine inaweza kutabiri logS?” Swali kuu ni kama inawezekana kujenga mfumo wa utabiri wa umumunyifu unaostahimili zaidi seti za data za nje za kikemia kwa kuunganisha vielezi vya molekuli, binary fingerprint na embedding zilizofunzwa, ambazo zinawakilisha aina tofauti za taarifa za kikemia, na modeli kadhaa za regresi.
logS Inamaanisha Nini Katika Utabiri wa Umumunyifu Katika Maji?
Katika makala hii, logS ni kigezo lengwa cha kilogarithimu cha umumunyifu wa majaribio katika maji; hii ndiyo thamani endelevu ya nambari ambayo modeli inajaribu kutabiri. Katika data za mafunzo zinazotegemea AqSolDB, thamani za logS hubadilika kutoka −13.17 hadi 2.14, na chanzo hutumia kipimo ambacho thamani za chini zinawakilisha umumunyifu wa chini sana na thamani za juu zinawakilisha umumunyifu wa juu zaidi. Hata hivyo, kwa kuwa sehemu ya Methods katika PDF kuu haijafafanua tena msingi wa logarithimu na kitengo ghafi cha umumunyifu kinachotumika chini ya logS, Verianla haiongezi maelezo hayo kutoka nje ya chanzo.
Data za mafunzo za AqSolDB
Utafiti ulitumia AqSolDB version 1.0. Baada ya kuondoa rekodi zilizokosekana na kufanya uchakataji wa awali, seti ya data ina misombo 9.982 ya kikaboni isiyojirudia. Kila kiwanja kinawakilishwa na mfuatano wa SMILES, InChIKey na thamani ya kilogarithimu ya umumunyifu katika maji iliyopimwa kwa majaribio.
| Idadi ya misombo isiyojirudia | 9.982 |
|---|---|
| Uwakilishi wa utambulisho/muundo | SMILES na InChIKey |
| Kigezo lengwa | Umumunyifu wa majaribio katika maji, kipimo cha kilogarithimu |
| logS ya chini kabisa | −13.17 |
| logS ya juu kabisa | 2.14 |
| Wastani wa logS | −2.89 |
| Mediani ya logS | −2.62 |
Chanzo kinaeleza kuwa kuunganisha uchunguzi wa majaribio kutoka vyanzo mbalimbali vya fasihi ndani ya AqSolDB huleta kelele asilia na utofauti katika data. Watafiti hawalichukulii jambo hili kama hasara pekee; wanahoji kuwa linaunda hali inayokaribia zaidi utofauti unaotokana na vyanzo mbalimbali vya vipimo katika utafiti halisi wa dawa wa hatua za awali. Hata hivyo, sifa hii pia ina maana kwamba hitilafu ya utabiri inaweza kuathiriwa si tu na usanifu wa modeli bali pia na tofauti za vipimo vya majaribio.
Kwa nini migawanyo ya mafunzo na majaribio ya nje si sawa?
Figure 3 ya chanzo inaonyesha kuwa migawanyo ya logS ya data za mafunzo na seti mbalimbali za majaribio ya nje si sawa. Klop120 iko karibu kiasi na mgawanyo wa mafunzo, huku Cui na Boobier zikionyesha migawanyo myembamba na iliyokusanyika zaidi. Llinas1 na Llinas2 zinaonyesha migawanyo mipana zaidi, iliyotawanyika zaidi na iliyosogea kuelekea eneo la umumunyifu wa chini. Watafiti wanachukulia mabadiliko haya ya mgawanyo katika seti za Llinas kama tatizo gumu zaidi kwa ujumlishaji wa modeli.
Uonyeshaji wa t-SNE katika Figure 4 ya chanzo pia unaonyesha kuwa misombo mingi katika seti za data za nje iko ndani au karibu na nafasi ya kikemia inayofunikwa na sampuli za mafunzo; hasa baadhi ya sampuli za Llinas zinaweza kuwa kandokando au nje ya makundi mazito ya mafunzo. Grafu hii ya t-SNE si algoriti yenyewe ya utabiri wa modeli; ni makadirio ya maelezo yanayotumiwa kuonyesha nafasi za jamaa za seti za data katika nafasi ya kikemia.
Tofauti Kati ya Kielezi cha Molekuli, Fingerprint na Mol2Vec Embedding ni Nini?
Vielezi vya molekuli huwakilisha ukubwa, muunganisho, sifa za kielektroni au za kifizikia-kikemia za molekuli kwa thamani za nambari; fingerprint za kikemia husimba uwepo wa motifu maalumu za kimuundo mara nyingi kwa biti 0/1; Mol2Vec ni mbinu ya embedding inayojifunza kuwakilisha miundo midogo ya molekuli katika nafasi endelevu ya vekta kwa namna inayofanana na Word2Vec. Wazo kuu la utafiti ni kwamba kwa kuwa uwakilishi huu hutoa mitazamo tofauti ya muundo uleule wa kikemia, unaweza kukamilishana badala ya kutegemea uwakilishi mmoja.
MACCS fingerprint
MACCS key ni mkabala wa fingerprint unaoonyesha kama sifa fulani za kikemia au motifu za muundo mdogo zipo au hazipo katika muundo wa molekuli kwa kutumia biti binary. Biti yenye thamani 1 inaonyesha kuwa sifa husika ipo, na 0 inaonyesha kuwa haipo. Chanzo kinaripoti kuwa kabla ya uchakataji wa awali kulikuwa na sifa 167 za MACCS; baada ya usafishaji zilibaki sifa 112.
Vielezi vya molekuli vya 2D
Vielezi vya molekuli vya pande mbili hutegemea jedwali la miunganisho ya molekuli badala ya kutumia moja kwa moja konformasheni ya pande tatu ya atomu. Vinaweza kutengeneza sifa mbalimbali za nambari zinazohusiana na ukubwa, matawi, mifumo ya muunganisho na mgawanyo wa elektroni. Katika chanzo, sifa 217 za awali zilipungua hadi 134 baada ya uchakataji wa awali.
Vielezi vya Mordred
Mordred ni programu ya descriptor inayoweza kukokotoa idadi kubwa ya vielezi vya molekuli katika tafiti za cheminformatics. Chanzo kinaeleza kwa ujumla kuwa Mordred inaweza kukokotoa zaidi ya descriptor 1.800. Katika matriksi ya sifa iliyotengenezwa na utafiti huu, idadi ya sifa za Mordred kabla ya usafishaji ni 1.613, na baada ya uchakataji wa awali ni 451.
Mol2Vec
Mol2Vec ni mkabala wa ujifunzaji wa mashine usiosimamiwa unaojifunza uwakilishi mnene wa vekta kwa miundo midogo ya molekuli kwa mantiki inayofanana na Word2Vec iliyotengenezwa kwa maneno. Kwa kuunganisha vekta zilizojifunzwa kutoka miundo midogo ya molekuli, embedding ya nambari hutengenezwa kwa molekuli nzima. Katika utafiti, sifa 185 zilibaki baada ya uchakataji wa awali kutoka uwakilishi wa awali wenye vipimo 300.
PubChem fingerprint
PubChem fingerprint huonyesha uwepo wa pete, jozi za atomu na motifu nyingine za kimuundo kwa kutumia biti binary za miundo midogo. Chanzo kinaripoti kuwa sifa 881 za awali za PubChem katika utafiti zilipungua hadi sifa 241 baada ya usafishaji.
| Uwakilishi | Idadi ya sifa za awali | Baada ya uchakataji wa awali |
|---|---|---|
| MACCS | 167 | 112 |
| 2D descriptors | 217 | 134 |
| Mordred | 1.613 | 451 |
| Mol2Vec | 300 | 185 |
| PubChem | 881 | 241 |
Kwa nini uchakataji wa awali ulifanywa baada ya data kugawanywa?
Katika ujifunzaji wa mashine, kuchagua sifa kwa kutumia data yote kisha kuunda mgawanyo wa mafunzo-majaribio kunaweza kufanya taarifa za kitakwimu za data za majaribio kuvuja kwa njia isiyo ya moja kwa moja katika mchakato wa mafunzo. Ili kupunguza hatari hii, chanzo kilitumia vichujio vya variance ndogo na correlation kubwa baada ya data kugawanywa na kwa kujitegemea ndani ya kila fold ya mafunzo. Seti ndogo ya sifa iliyojifunzwa katika fold ya mafunzo kisha ilitumika kwenye sehemu husika ya uthibitishaji/majaribio.
Thamani ya VarianceThreshold ilitumika kama 0.01. Sifa zenye thamani zilizokosekana au zisizo na kikomo ziliondolewa, kisha sifa za ziada zenye mgawo wa correlation zaidi ya 0.80 zikaondolewa. Lengo hapa ni kupunguza kelele na urudufu na wakati huohuo kuzuia data za tathmini kuonekana mapema wakati wa uteuzi wa sifa.
Meta-Learning Inayotegemea Stacking Inafanyaje Kazi Katika Utafiti Huu?
Katika mkabala wa stacking, utabiri wa modeli moja ya regresi hauchukuliwi kama jibu la mwisho; utabiri wa out-of-fold wa modeli tofauti za msingi hubadilishwa kuwa “meta-feature” mpya, na meta-learner ya kiwango cha juu huunganisha utabiri huo ili kutoa thamani ya mwisho ya logS. Katika utafiti huu, kwa kutumia uthibitishaji mtambuka wa mikunjo mitano, ililenga kwamba meta-feature ya kila sampuli ya mafunzo itokane na modeli ya msingi ambayo haikuiona sampuli hiyo wakati wa mafunzo; kwa njia hii uvujaji wa taarifa ambao ungeifanya tabaka la stacking kukariri moja kwa moja lengo la mafunzo ulipunguzwa.
Mantiki ya utabiri wa out-of-fold
Data za mafunzo ziligawanywa katika sehemu tano. Katika kila iteresheni, fold nne hutumika kufundisha modeli ya msingi na fold iliyobaki hutumika kutoa utabiri. Baada ya iteresheni tano, kila sampuli ya mafunzo hupokea angalau utabiri mmoja kutoka kwa modeli ambayo haikuiona katika mafunzo. Utabiri huu huwekwa sambamba ili kuunda ingizo la mafunzo la stacking meta-model.
Kisha modeli za msingi zilizoboreshwa hufundishwa upya kwa data zote za mafunzo na kutoa utabiri kwa seti huru za nje za majaribio. Utabiri huu wa nje pia hubadilishwa kuwa ingizo la stacking kwa mpangilio huohuo. Meta-learner hutumia utabiri wa msingi kutoa utabiri wa mwisho wa umumunyifu katika maji.
Algoriti 17 za regresi zilizolinganishwa
| Familia ya mbinu | Algoriti |
|---|---|
| Linear / robust / regularized | Bayesian Ridge, Ridge, Lasso, ElasticNet, Huber, Linear Regression |
| Kernel / instance / mti mmoja | Support Vector Regression, K-Nearest Neighbors, Decision Tree |
| Ensemble / boosting | Random Forest, Gradient Boosting, Histogram Gradient Boosting, AdaBoost, ExtraTrees, CatBoost, LightGBM, XGBoost |
Optuna inafanya nini hapa?
Optuna si modeli ya utabiri inayobadilisha utambulisho wa algoriti, bali ni framework ya uboreshaji inayotafuta mchanganyiko unaofaa wa hiperparameta za modeli. Chanzo kinaeleza kuwa uboreshaji wa hiperparameta kwa modeli zenye nguvu zilizochaguliwa ulitumika kwa kujitegemea kwa kila mbinu ya molekuli ya encoding.
Hata hivyo, PDF kuu hairipoti Optuna ilifanya majaribio mangapi, hiperparameta zipi zilitafutwa katika masafa gani, usanidi gani wa sampler/pruner ulitumika, au thamani ya random seed ya uboreshaji. Kwa hiyo, msomaji anayetaka kurudia utafiti huo katika kiwango cha biti hawezi kupata maelezo haya yote kutoka PDF kuu.
Kutokuwa na uhakika ndani ya chanzo kuhusu idadi ya modeli za msingi
Sehemu za Abstract, Discussion, Methods 4.5 na Final features selection zinataja majina manne: CatBoost, ExtraTrees, Histogram Gradient Boosting na XGBoost. Kinyume chake, Methods 4.6 hutumia kauli “five top-performing machine-learning regression models”, na Methods 4.8 hutumia “five optimized base regressors”. PDF kuu haitaji wazi algoriti ya tano ya msingi. Kwa hiyo, Verianla haifanyi ujazaji wa nje ya chanzo kwa kusema “modeli ya tano ni hii.”
Katika Methods 4.8 pia kuna kauli “mordered (order-sensitive) feature representations”. Ingawa muktadha unaashiria kuwa huenda ni tatizo la uandishi linalohusiana na Mordred, chanzo hakijalisahihisha wazi, kwa hiyo hakuna marekebisho ya uhakika yaliyofanywa hapa.
Kwa Nini GroupKFold Ni Jaribio Kali Zaidi la Ujumlishaji?
Katika utafiti huu, GroupKFold hujaribu kuzuia scaffold zinazofanana kuonekana katika upande wa mafunzo na wa uthibitishaji kwa kuweka molekuli zenye scaffold msingi ileile ya Bemis–Murcko ndani ya fold moja; hivyo, badala ya modeli kukariri jamaa za kimuundo zilizo karibu sana na kuonyesha utendaji wa juu, uwezo wake wa kufanya ujumlishaji kwa chemotype msingi ambazo haijawahi kuona hapo awali hujaribiwa kwa ukali zaidi. Gharama yake ni kwamba, kama inavyoonekana pia katika matokeo ya chanzo, baadhi ya metriki zinaweza kuwa za chini kuliko katika Random Split au RepeatedKFold.
Bemis–Murcko scaffold ni nini?
Bemis–Murcko scaffold ni muhtasari wa muundo unaotumiwa kuwakilisha mfumo msingi wa pete na miunganisho wa molekuli. Watafiti walikokotoa scaffold ya kila kiwanja kwa RDKit, wakatengeneza uwakilishi wa scaffold SMILES na wakakusanya molekuli zenye muundo msingi uleule chini ya kitambulisho cha kundi la pamoja.
Baadaye GroupKFold ilitumia lebo hizi za kundi kuzuia scaffold ileile kugawanywa katika fold tofauti. Muundo huu unalenga kupunguza uvujaji wa mafunzo-uthibitishaji, hasa katika seti za data zenye ufanano mkubwa wa kikemia.
Mikakati mingine ya kugawa data
Random Split hugawa sampuli kwa nasibu na katika chanzo ilitoa RMSE ya chini zaidi ya mafunzo; hata hivyo, kuna uwezekano kwamba molekuli zinazofanana sana kimuundo zitasambazwa katika pande tofauti.
RepeatedKFold hurudia mchakato wa k-fold mara nyingi kwa migawanyo tofauti ya nasibu. Lengo ni kupunguza utegemezi wa matokeo kwa bahati ya mgawanyo mmoja.
ShuffleSplit huchanganya data mara kwa mara na kuunda migawanyo huru ya mafunzo-jaribio, na husaidia kuchunguza utofauti wa utendaji katika hali tofauti za usampulishaji.
Mbinu na Matokeo ya Utafiti
Mtiririko wa kiufundi wa mafunzo ya stacking ya fold tano
Data ya mafunzo iligawanywa katika fold tano zinazokaribiana kwa ukubwa. Katika kila mzunguko, fold nne zilitumika kufundisha base learner, na utabiri ulitolewa kwenye fold iliyobaki. Utabiri wa fold zote tano uliunganishwa kuunda matriki ya out-of-fold meta-feature. Kwa njia hii, lengo lilikuwa kwamba utabiri unaotumiwa kufundisha meta-modeli utokane na modeli ya msingi ambayo haikuwa imeiona sampuli husika wakati wa mafunzo.
Baada ya uzalishaji wa meta-feature kukamilika, modeli za msingi zilizoboreshwa zilifundishwa upya kwenye seti nzima ya mafunzo na kutoa utabiri kwa seti huru za nje za jaribio. Kwa kuunganisha utabiri huu wa msingi, matriki ya meta-feature ya jaribio iliundwa, na utabiri wa mwisho wa logS ulipatikana kutoka kwa stacking meta-modeli.
Utendaji wa mafunzo katika mikakati tofauti ya split
| Mkakati wa split | MAE | MSE | RMSE | R² |
|---|---|---|---|---|
| Random Split | 0.727 | 0.830 | 0.911 | 0.838 |
| RepeatedKFold | 0.745 | 0.871 | 0.933 | 0.842 |
| GroupKFold | 0.796 | 0.973 | 0.985 | 0.782 |
| ShuffleSplit | 0.739 | 0.857 | 0.926 | 0.823 |
Random Split ilitoa RMSE ya chini zaidi, 0.911, huku RepeatedKFold ikitoa thamani ya juu zaidi ya R², 0.842. Katika GroupKFold, R² hushuka hadi 0.782 na RMSE hupanda hadi 0.985. Tofauti hii haimaanishi moja kwa moja kwamba GroupKFold ni “mbinu mbaya”; tatizo la tathmini huwa gumu zaidi kwa sababu haibebi ufanano wa kiwango cha scaffold kwenda kwenye fold tofauti.
Seti huru za nje za jaribio
| Seti ya jaribio | n | Random Split | RepeatedKFold | GroupKFold | ShuffleSplit |
|---|---|---|---|---|---|
| Klop120 | 90 | 0.431 / 0.540 / 0.967 | 0.421 / 0.527 / 0.969 | 0.561 / 0.701 / 0.934 | 0.432 / 0.541 / 0.967 |
| Yalk21 | 20 | 0.192 / 0.240 / 0.985 | 0.170 / 0.213 / 0.988 | 0.295 / 0.363 / 0.937 | 0.211 / 0.265 / 0.982 |
| Boobier | 95 | 0.410 / 0.513 / 0.911 | 0.391 / 0.489 / 0.919 | 0.492 / 0.616 / 0.873 | 0.417 / 0.523 / 0.908 |
| Cui | 62 | 0.417 / 0.522 / 0.654 | 0.438 / 0.549 / 0.618 | 0.586 / 0.730 / 0.519 | 0.421 / 0.528 / 0.647 |
| Llinas2020 Set1 | 99 | 0.668 / 0.837 / 0.564 | 0.663 / 0.831 / 0.572 | 0.719 / 0.899 / 0.563 | 0.686 / 0.859 / 0.541 |
| Llinas2020 Set2 | 32 | 1.106 / 1.387 / 0.581 | 1.039 / 1.302 / 0.631 | 1.145 / 1.423 / 0.588 | 1.118 / 1.401 / 0.572 |
Ingawa jina la seti ya data ya Klop120 lina “120”, Table 2 ya chanzo inaripoti n=90 katika tathmini hii. Verianla haikubadilisha idadi ya sampuli kuwa 120 kwa kutegemea jina la jedwali.
RepeatedKFold hutoa matokeo yenye nguvu kwa makosa ya chini zaidi au yaliyo karibu na bora zaidi katika Klop120, Yalk21, Boobier na seti zote mbili za Llinas. Hata hivyo, katika Cui, Random Split ina R²=0.654, ambayo ni ya juu kuliko 0.618 ya RepeatedKFold, na RMSE=0.522, ambayo ni ya chini. Kwa hiyo, haiwezi kuhitimishwa kwamba mkakati mmoja wa split ni bora kwa namna ileile katika seti zote za jaribio.
MAE, MSE, RMSE na R² Zinamaanisha Nini?
MAE hupima wastani wa hitilafu kamili ya utabiri, MSE wastani wa miraba ya hitilafu, RMSE mzizi wa MSE na hivyo ukubwa unaorudisha hitilafu kwenye skeli ya logS ya kigezo lengwa, huku R² ikipima ni kiasi gani modeli inaeleza utofauti unaoonekana wa logS. Kwa MAE, MSE na RMSE, thamani ndogo ni bora; kwa R², kwa ujumla thamani iliyo karibu zaidi na 1 huonyesha utendaji bora, lakini metriki moja pekee haielezi muundo mzima wa hitilafu wa modeli.
Mlinganyo 1: Wastani wa Hitilafu Kamili — MAE
\(\displaystyle MAE=\frac{1}{n}\sum_{i=1}^{n}|y_i-\hat{y}_i|\)
1. Fomula hukokotoa nini? Kwa kila kiwanja, huchukua thamani kamili ya tofauti kati ya logS halisi na utabiri wa modeli na kukokotoa wastani wake katika sampuli zote.
2. Vigezo ni vipi? \(n\) ni jumla ya idadi ya sampuli; \(y_i\) ni thamani ya umumunyifu ya majaribio/iliyoonekana ya sampuli ya i; \(\hat{y}_i\) ni utabiri wa modeli kwa sampuli hiyo hiyo.
3. Kitengo ni nini? MAE huonyeshwa katika skeli ileile ya kigezo lengwa. Kwa kuwa lengo katika utafiti huu ni logS, MAE pia iko katika skeli lengwa ya logS. Kwa sababu PDF haifafanui tena kitengo ghafi kilicho chini ya logS, hakuna kitengo kingine cha kifizikia kinachoongezwa.
4. Jukumu la kihisabati ni nini? Thamani kamili huzuia hitilafu chanya na hasi za utabiri kufutana. Hutoa uzito wa mstari kwa ukubwa wa kila hitilafu.
5. Maana ya kialgoriti ni nini? Hufupisha kwa njia inayosomeka moja kwa moja ni kwa kiasi gani modeli, katika sampuli ya kawaida, hutofautiana takriban na thamani ya majaribio.
6. Ni halali chini ya hali gani? Thamani halisi na za utabiri lazima ziwe katika skeli lengwa ileile. Ikiwa usambazaji wa lengo wa seti tofauti za data unatofautiana, ubora mzima wa ujumlishaji hauwezi kuelezwa kwa kuangalia MAE pekee.
7. Inatafsiriwaje? MAE ya chini huonyesha kuwa wastani wa upotovu kamili wa utabiri ni mdogo; hata hivyo, haiadhibu idadi ndogo ya hitilafu kubwa sana kwa nguvu kama MSE.
Mlinganyo 2: Wastani wa Hitilafu za Mraba — MSE
\(\displaystyle MSE=\frac{1}{n}\sum_{i=1}^{n}(y_i-\hat{y}_i)^2\)
1. Fomula hukokotoa nini? Huchukua mraba wa kila hitilafu ya utabiri na kukokotoa wastani wa hitilafu hizo za mraba.
2. Vigezo: \(n\), \(y_i\) na \(\hat{y}_i\) huhifadhi maana zao kutoka katika mlinganyo wa MAE.
3. Kitengo: Ni mraba wa skeli lengwa; kwa hiyo MSE haisomeki moja kwa moja katika skeli lengwa kama MAE au RMSE.
4. Jukumu la kihisabati: Kwa kuwa hitilafu inawekwa mraba, mikengeuko mikubwa hupata adhabu kubwa isiyo sawia kuliko mikengeuko midogo.
5. Maana ya kialgoriti: Ni kipimo cha ubora kinachoitikia mikengeuko mikubwa ya modeli katika matatizo ambamo hitilafu kubwa sana za utabiri hazitakiwi.
6. Hali: Ukubwa wa MSE huathiriwa na skeli ya kigezo lengwa; kazi zenye skeli tofauti hazipaswi kulinganishwa moja kwa moja kwa thamani ileile ya MSE.
7. Tafsiri: MSE ya chini ni bora, lakini kwa sababu ya kuweka mraba, thamani chache za hitilafu kali zinaweza kuongeza metriki kwa kiasi kikubwa.
Mlinganyo 3: Mzizi wa Wastani wa Hitilafu za Mraba — RMSE
\(\displaystyle RMSE=\sqrt{\frac{1}{n}\sum_{i=1}^{n}(y_i-\hat{y}_i)^2}\)
1. Fomula hukokotoa nini? Huchukua mzizi wa mraba wa MSE.
2. Vigezo: \(n\), \(y_i\) na \(\hat{y}_i\) ni vilevile kama katika milinganyo iliyotangulia.
3. Kitengo: Kwa sababu ya mzizi wa mraba, hurudi katika skeli ya kigezo lengwa; katika utafiti huu inatafsiriwa katika skeli lengwa ya logS.
4. Jukumu la kihisabati: Kwanza husisitiza hitilafu kubwa kwa kuziweka mraba, kisha hurudisha matokeo kwenye skeli lengwa kwa mzizi wa mraba.
5. Maana ya kialgoriti: Ni metriki ya hitilafu iliyo nyeti zaidi kwa hitilafu kubwa za utabiri kuliko MAE lakini inayosomeka moja kwa moja zaidi kuliko MSE.
6. Hali: Usambazaji wa seti ya data na thamani kali zinaweza kuathiri RMSE; kwa hiyo tofauti za RMSE katika seti tofauti za nje zinapaswa kutathminiwa pamoja na tofauti za usambazaji wa kikemia.
7. Tafsiri: Kupungua kwa RMSE kwa ujumla huonyesha utendaji bora wa utabiri. Kwa mfano, Yalk21 RepeatedKFold ina RMSE=0.213, ilhali katika Llinas2020 Set2 ni 1.302; modeli huzalisha hitilafu kubwa zaidi kwa wazi katika seti ya pili ya data.
Mlinganyo 4: Mgawo wa Uamuzi — R²
\(\displaystyle R^2=1-\frac{\sum_{i=1}^{n}(y_i-\hat{y}_i)^2}{\sum_{i=1}^{n}(y_i-\bar{y})^2}\)
1. Fomula hukokotoa nini? Hulinganisha hitilafu ya utabiri ya mraba ya modeli na jumla ya mikengeuko ya mraba ya thamani zilizoonekana kutoka kwenye wastani wake.
2. Vigezo: \(y_i\) ni thamani halisi, \(\hat{y}_i\) ni utabiri, \(\bar{y}\) ni wastani wa thamani lengwa zilizoonekana, na \(n\) ni idadi ya sampuli.
3. Kitengo: Kwa kuwa ni uwiano wa jumla mbili za miraba, R² haina kipimo.
4. Jukumu la kihisabati: Kadiri residual sum of squares katika sehemu ya juu inavyopungua, uwiano hupungua na R² hukaribia 1.
5. Maana ya kialgoriti: Ni muhtasari wa kiwango ambacho utabiri wa modeli unaeleza utofauti wa logS unaoonekana.
6. Hali: R² inaweza kuathiriwa na usambazaji lengwa wa seti ya data. Katika masafa finyu ya lengo au chini ya distribution shift, RMSE ileile inaweza kuonyesha tabia tofauti ya R².
7. Tafsiri: R²=1 inalingana na ulinganifu mkamilifu. R² inapokaribia sifuri inaweza kuonyesha kupungua kwa uwezo wa kueleza, na inaposhuka chini ya sifuri inaweza kuonyesha kuwa modeli inaweza kufanya vibaya hata kuliko kutabiri kwa thamani ya wastani. Utafiti huu unaripoti thamani za R² zinazotofautiana sana kulingana na seti ya data katika majaribio ya nje.
Ulinganisho wa MetaModel, SolPredictor na GGAS2SN
| Seti ya data | MetaModel | SolPredictor | GGAS2SN |
|---|---|---|---|
| Boobier | 0.428 / 0.597 / 0.880 | 0.821 / 1.103 / 0.591 | 0.539 / 0.696 / 0.837 |
| Cui | 0.444 / 0.567 / 0.592 | 0.722 / 0.862 / 0.057 | 0.428 / 0.519 / 0.608 |
| Klop120 | 0.424 / 0.603 / 0.959 | 0.965 / 1.208 / 0.837 | 0.499 / 0.680 / 0.948 |
| Llinas set1 | 0.619 / 0.882 / 0.517 | 1.000 / 1.250 / 0.474 | 0.719 / 0.940 / 0.451 |
| Llinas set2 | 1.027 / 1.372 / 0.590 | 1.458 / 1.762 / 0.323 | 0.990 / 1.242 / 0.633 |
| Lovric1 | 0.511 / 0.780 / 0.807 | 0.625 / 0.783 / 0.803 | 0.655 / 0.794 / 0.775 |
| Yalk21 | 0.332 / 0.387 / 0.961 | 1.075 / 1.204 / 0.618 | 0.447 / 0.588 / 0.909 |
Jedwali hili linaonyesha jambo muhimu lenye nuance: MetaModel ina nguvu katika seti nyingi za data, lakini si bora katika seti zote. Katika Cui, GGAS2SN inatoa MAE/RMSE ya chini na R² ya juu. Katika Llinas set2 pia, thamani za MAE, RMSE na R² za GGAS2SN ni bora kuliko za MetaModel. Kwa hiyo, licha ya tafsiri ya jumla ya waandishi kwamba modeli ni “robust”, maudhui ya nambari ya jedwali la chanzo yanaonyesha kuwa ubora wa mbinu unategemea seti ya data.
Kwa nini Table 2 na Table 3 hazitoi nambari zilezile?
Table 2 inalinganisha stacking MetaModel ileile chini ya mikakati tofauti ya split, huku Table 3 ikilinganisha MetaModel na SolPredictor na GGAS2SN. Nambari katika seti za data zinazofanana si sawa kabisa; kwa mfano, kwa Boobier, RepeatedKFold ina R²=0.919 katika Table 2, huku MetaModel ikiwa na R²=0.880 katika Table 3. PDF kuu haipatanishi kwa kina usanidi kamili wa tathmini unaosababisha tofauti ya utendaji kati ya majedwali haya. Kwa hiyo, Verianla haijaunganisha majedwali hayo mawili kana kwamba ni jedwali moja la utendaji.
Ulinganisho wa kitakwimu wa modeli
Watafiti walitumia Wilcoxon signed-rank tests na paired t-tests juu ya hitilafu kamili za utabiri kwa kila sampuli. Katika seti za data za Boobier na Cui, faida ya MetaModel dhidi ya SolPredictor iliripotiwa kuwa P<0.001. Katika Boobier, tofauti kati ya MetaModel na GGAS2SN ni ya maana katika kiwango cha P<0.05. Katika Cui, kati ya MetaModel na GGAS2SN kuna P>0.05, na hakuna tofauti yenye maana ya kitakwimu iliyoripotiwa.
Matokeo haya ya kitakwimu yanapaswa kusomwa pamoja na ukweli kwamba katika Table 3, GGAS2SN inatoa metriki zilizo bora kidogo kwa nambari katika Cui: tofauti ndogo ya metriki huenda isiwe na maana ya kitakwimu. Ubora wa nambari na ubora uliothibitishwa kitakwimu si dhana ileile.
Uwiano wa Spearman na Kendall
Chanzo kinaeleza kwamba, ili kutotegemea R² pekee katika masafa mapana ya dinamiki ya logS, pia kilitathmini Spearman rank correlation coefficient (ρ) na Kendall's Tau (τ). Kwa Klop120, Spearman ρ=0.97 na kwa Boobier ρ=0.95 zimeandikwa wazi.
Hata hivyo, katika sehemu ya sentensi ya chanzo inayohusu Yalk21 na ρ=0.80 inayofuata kuna hitilafu ya kisarufi/kimuundo: muundo wa “Yalk21 (ρ) ... (ρ = 0.80)” hauweki wazi kwa uhakika thamani ya 0.80 ni ya seti ipi ya data. Jedwali la nambari la kina la thamani za Kendall τ pia halijaonyeshwa katika maandishi makuu. Kwa hiyo, Verianla haihusishi ρ=0.80 au τ na seti ya data kwa njia ambayo haijaelezwa wazi katika chanzo.
Grafu za predicted vs experimental logS zinaonyesha nini?
Figure 1 ya chanzo inalinganisha uhusiano kati ya mwenendo wa logS ya majaribio na utabiri wa MetaModel, SolPredictor na GGAS2SN katika seti za data za Boobier, Cui, Llinas set1 na Klop120. Kulingana na tafsiri ya waandishi, MetaModel hufuata kwa karibu mwenendo wa majaribio hasa katika eneo la kati la takriban −4 hadi −2 logS.
Katika ncha za umumunyifu wa juu sana au wa chini sana, inaelezwa kwamba mikunjo ya utabiri ina mwelekeo wa kuwa tambarare. Hii inaashiria kuwa modeli huenda isiwe nyeti kwa mabadiliko makali ya umumunyifu kama ilivyo katika masafa ya kati. Kwa kuwa koordinati ghafi za binned za Figure 1 hazijatolewa kama jedwali, Verianla haichori upya grafu hiyo na kuzalisha pointi mpya za nambari.
Usambazaji wa hitilafu wa Figure 2 na mgongano wa nambari ndani ya chanzo
Figure 2 inaainisha hitilafu kamili za utabiri katika masafa matatu: ≤0.5, 0.5<x≤1.0 na >1.0. Katika lebo zilizo juu ya mchoro, usambazaji unaonekana kuwa takriban %69.35 / %22.58 / %8.06 kwa Boobier; %72.63 / %14.74 / %12.63 kwa Cui; %72.22 / %21.11 / %6.67 kwa Klop120; na %60.61 / %19.19 / %20.2 kwa Llinas set1.
Hata hivyo, maelezo ya mchoro huohuo yanaandika kiwango cha hitilafu ≤0.5 kwa Klop120 kama %77.22, na aya iliyotangulia ya matokeo pia inaeleza takriban %77. Lebo ya mchoro, kwa upande mwingine, ni %72.22. Kutokulingana huku ndani ya chanzo hakuwezi kuwasilishwa kana kwamba ni data iliyotatuliwa. Kinachoweza kusemwa kwa uhakika ni kwamba kundi la hitilafu ndogo ndilo linalotawala katika Klop120, huku katika Llinas set1 kundi la >1.0 likiwa kubwa zaidi.
Usambazaji wa vikundi tendaji unaeleza nini?
Figure 5 ya chanzo inajaribu kueleza utofauti wa kikemia wa seti ya data ya mafunzo kwa kuonyesha mwingiliano kati ya miundo ya hydroxyl, ether, carbonyl, halogen na aromatic. Kuwepo kwa idadi kubwa ya miundo ya aromatic kunaonyesha kuwa mifumo ya pete ya hydrophobic ni ya kawaida katika seti ya data; ukweli kwamba vikundi tendaji vya polar kama hydroxyl na carbonyl vinaweza kuwepo pamoja na mifumo ya aromatic katika molekuli zilezile unaonyesha kuwa viwanja vingi vina sifa za hydrophobic na hydrophilic kwa pamoja.
Waandishi wanajadili kwamba vikundi vya hydroxyl na carbonyl vinaweza kusaidia umumunyifu kupitia hydrogen bonding au mwingiliano wa dipole–dipole na maji, huku halojeni zikiongeza lipophilicity na hivyo kuweza kupunguza umumunyifu. Maelezo haya ni mfumo wa jumla wa kimekanika wa kutafsiri muundo wa seti ya data kikemia; Figure 5 yenyewe haipimi ukubwa wa mchango wa kisababishi wa kundi fulani tendaji kwa umumunyifu katika seti hii ya data.
Je, R² ya Juu Inamaanisha Modeli Inaaminika katika Kila Nafasi ya Kikemia?
Hapana. Katika utafiti huu, R² hufikia takriban 0.97-0.99 katika baadhi ya seti za nje kama Yalk21 na Klop120, lakini hupungua kwa wazi katika seti ngumu zaidi kwa upande wa usambazaji au nafasi ya kikemia kama Llinas na Cui; kwa hiyo R² ya juu huonyesha ulinganifu mkubwa katika seti fulani ya data ya tathmini, si kwamba usahihi uleule umehakikishwa katika chemotype zote zisizojulikana. Matokeo ya chini zaidi ya GroupKFold na hitilafu kubwa katika seti za Llinas pia yanaunga mkono kwamba mabadiliko ya usambazaji wa kimuundo hufanya ujumlishaji kuwa mgumu zaidi.
Nguvu za utafiti
Nguvu ya kwanza ni kwamba, badala ya kulazimisha molekuli katika encoding moja, utafiti unatathmini pamoja binary fingerprints, descriptor za kawaida na embedding za Mol2Vec zilizojifunzwa. Mbinu hii huruhusu aina tofauti za uwakilishi kukamilishana.
Nguvu ya pili ni kulinganisha algoriti 17 tofauti za regresi chini ya mpangilio mmoja wa tathmini na kuboresha zaidi modeli zenye nguvu kwa Optuna.
Nguvu ya tatu ni matumizi ya uzalishaji wa out-of-fold meta-feature kwa stacking. Muundo huu unalenga kupunguza hatari ya meta-modeli kulishwa moja kwa moja utabiri wa modeli za msingi ambazo tayari zimeona sampuli zake za mafunzo.
Nguvu ya nne ni kutotegemea random split moja pekee; matokeo ya Random Split, RepeatedKFold, GroupKFold na ShuffleSplit yanachunguzwa kwa pamoja.
Nguvu ya tano ni kwamba modeli imetathminiwa katika mikusanyo huru ya jaribio nje ya eneo la mafunzo la AqSolDB na kulinganishwa na modeli za awali kama SolPredictor na GGAS2SN.
Mapungufu ya msingi
Kizuizi cha kwanza ni ubora wa data. Kwa kuwa AqSolDB huunganisha vipimo vya majaribio vya umumunyifu kutoka katika vyanzo vingi vya fasihi, inaweza kuwa na kelele na utofauti unaotokana na hali tofauti za maabara.
Kizuizi cha pili ni kwamba uwakilishi unaotegemea descriptor huenda usiwakilishe kikamilifu mwingiliano changamano wa kimuundo wa vipimo vitatu au wa masafa marefu. Waandishi wa chanzo wanapendekeza graph neural networks, embedding za molekuli zinazotegemea transformer na pretrained molecular encoders kwa tafiti zijazo.
Kizuizi cha tatu ni chemical domain shift. Katika seti za data za Llinas, usambazaji hutofautiana zaidi na eneo la mafunzo na hitilafu za utabiri huongezeka.
Kizuizi cha nne ni kwamba utabiri wa modeli unaweza kuwa tambarare katika maeneo ya umumunyifu uliokithiri; chanzo kinajadili hali hii kama unyeti mdogo kwa mabadiliko katika thamani za logS za juu sana au za chini sana.
Kizuizi cha tano ni kwamba PDF kuu haitoi baadhi ya maelezo muhimu kwa uzalishaji upya. Random seed, vifaa vya kompyuta vilivyotumika, idadi ya majaribio ya Optuna na nafasi kamili za utafutaji wa hiperparameta, algoriti kamili ya stacking meta-learner na hiperparameta zote za modeli za mwisho hazipo katika maandishi makuu.
Kizuizi cha sita ni kutokulingana ndani ya chanzo kuhusu idadi ya modeli za msingi: baadhi ya sehemu za makala zinataja majina manne, huku baadhi ya aya za Methods zikirejelea base regressors tano.
Kizuizi cha saba ni kutokulingana kati ya lebo ya grafu na maelezo/maandishi kuhusu asilimia ya hitilafu ndogo ya Klop120 katika Figure 2.
Tafsiri zinazoungwa mkono na utafiti
- Kuunganisha uwakilishi mbalimbali wa molekuli na modeli za ensemble regression katika muundo wa stacking kunaweza kutoa utendaji wenye nguvu katika utabiri wa umumunyifu katika maji.
- Modeli imeonyesha R² ya juu na hitilafu ndogo ya utabiri katika baadhi ya seti huru za nje za data.
- RepeatedKFold imetoa matokeo yenye nguvu na thabiti katika seti nyingi za nje za data.
- GroupKFold inayotegemea scaffold hutoa tathmini kali zaidi ya ujumlishaji wa kimuundo.
- MetaModel imeonyesha hitilafu ya chini kwa kiwango chenye maana ya kitakwimu dhidi ya SolPredictor katika Boobier na Cui.
- Mafanikio ya modeli yanategemea usambazaji wa kikemia wa seti ya nje ya data.
- Uchaguzi wa molecular encoding na mkakati wa kugawa data ni sehemu muhimu za tathmini ya utendaji.
Tafsiri ambazo utafiti hauungi mkono
- Haijaonyeshwa kwamba MetaModel ndiyo modeli bora kwa molekuli zote na seti zote za data.
- Modeli haithibitishi kwamba inaweza kuchukua nafasi ya kipimo cha majaribio cha umumunyifu bila hitilafu.
- R² ya juu haihakikishi utendaji uleule wa ujumlishaji katika nafasi zote za kikemia.
- Athari ya kisababishi ya sifa fulani iliyo katika descriptor au fingerprint juu ya umumunyifu haiwezi kutolewa kutokana na ulinganisho huu wa modeli pekee.
- Ukaribu katika grafu ya t-SNE si kipimo cha moja kwa moja cha usahihi wa modeli au usababishi wa kikemia.
- Matokeo bora ya split katika Table 2 hayawezi kuunganishwa na matokeo ya ulinganisho wa mbinu katika Table 3 kana kwamba ni jaribio lilelile la utendaji.
- Modeli ya tano ya msingi, algoriti ya meta-learner au hiperparameta za Optuna ambazo hazijaelezwa katika chanzo haziwezi kujazwa kwa kukisia.
Maana ya matumizi
Framework hii ni zana inayowezekana kwa kupanga wagombea katika maktaba kubwa za molekuli kwa njia ya kihesabu kabla ya kuingia katika majaribio, kutabiri hatari ya wagombea wenye umumunyifu mdogo katika hatua za awali za ugunduzi wa dawa, na kufanya uchujaji wa awali katika mzunguko wa usanifu wa molekuli. Hata hivyo, waandishi wa chanzo pia wanapendekeza kwamba tafiti zijazo zipanuliwe kwa data zaidi ya majaribio ya umumunyifu, graph neural networks, modeli zinazotegemea transformer na pretrained molecular encoders.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: Integrating molecular descriptors and fingerprints via meta-learning for aqueous solubility prediction.
Waandishi na mpangilio: Waqar Ahmad, Muhannad Dehni, Rida Arshad, Myunghum Park, Hilal Tayara, Ki-Duk Song.
Alama ya mchango: PDF ya Article in Press iliyopakiwa inaonyesha Waqar Ahmad, Muhannad Dehni na Rida Arshad kwa alama ya “+ Contributing author”. Kwa kuwa chanzo hakitumii wazi kauli “equal contribution”, mchango sawa haujakisiwa.
Waandishi wa mawasiliano: Myunghum Park, Hilal Tayara na Ki-Duk Song.
Taasisi 1 katika PDF: Department of Agricultural Convergence Technology, Jeonbuk National University, Jeonju, South Korea.
Taasisi 2: Research and Development Center, TNT Research, Sejong, South Korea.
Taasisi 3: Global Frontier College, Jeonbuk National University, Jeonju, South Korea.
Tofauti katika rekodi rasmi ya sasa: Ukurasa wa sasa wa ufikiaji wa mapema wa Nature unaonyesha pia ushirika wa International Agricultural Development and Cooperation Center, Jeonbuk National University kwa Ki-Duk Song. Taasisi hii haipo katika orodha ya ushirika ya PDF ya Article in Press iliyopakiwa.
Jarida: Scientific Reports.
Jukwaa: Nature Portfolio / nature.com.
Aina ya uchapishaji: Article; accepted, peer-reviewed early-access / toleo la Article in Press.
Hali ya preprint: Si preprint. Ni utafiti uliopitiwa na wenzao uliokubaliwa na Scientific Reports na kufunguliwa kwa ufikiaji wa mapema.
DOI: 10.1038/s41598-026-65722-y.
Tarehe ya kupokelewa: 26 Machi 2026.
Tarehe ya kukubaliwa: 3 Agosti 2026.
Tarehe rasmi ya sasa ya uchapishaji: 19 Agosti 2026.
Hali ya toleo la mwisho: Ukurasa wa sasa wa Nature unaeleza kwamba toleo lililopo ni accepted research early-access na kwamba baadaye litabadilishwa kiotomatiki na final Version of Record.
Juzuu / nambari ya mwisho ya makala: Kwa kuwa rekodi ya sasa ya ufikiaji wa mapema bado haionyeshi kwa namna iliyothibitishwa juzuu/nambari ya makala ya mwisho ya bibliografia, hakuna thamani ya nje ya chanzo iliyoongezwa.
Leseni: Creative Commons Attribution-NonCommercial-NoDerivatives 4.0 International (CC BY-NC-ND 4.0).
Matokeo ya leseni kwa mchoro: Figure 1-6 za chanzo hazikurekebishwa moja kwa moja wala kunakiliwa. Inline SVG katika makala iliundwa kwa kujitegemea kutokana na mfuatano wa ukweli wa hatua katika maandishi ya Methods.
Ufadhili: Basic Science Research Program through the National Research Foundation of Korea, Ministry of Education, grant 2021R1I1A3057071; pamoja na msaada wa Regional Innovation System and Education (RISE) program, Jeonbuk RISE Center, Ministry of Education na Jeonbuk State, 2026-RISE-13-JBU.
Michango ya waandishi: W.A., M.D. na R.A. walifanya majaribio; M.P., H.T. na K.D.S. walichambua matokeo; waandishi wote walipitia makala.
Upatikanaji wa data: Imeelezwa kwamba seti za data zilizotumiwa na/au kuchambuliwa zinaweza kupatikana kutoka kwa corresponding author kwa ombi linalofaa.
Mgongano wa maslahi: Waandishi wanatangaza kwamba hakuna competing financial interest.
Chanzo kikuu cha data: AqSolDB version 1.0; viwanja hai vya kipekee 9.982 baada ya preprocessing.
Uwakilishi wa molekuli: MACCS, 2D molecular descriptors, Mordred, Mol2Vec na PubChem.
Familia ya modeli: Ulinganisho wa algoriti 17 za regresi, uboreshaji wa hiperparameta kwa Optuna na meta-learning inayotegemea stacking.
Algoriti za mwisho za msingi zilizotajwa wazi: CatBoost, ExtraTrees, Histogram Gradient Boosting na XGBoost.
Kutokulingana kwa idadi ya modeli ndani ya chanzo: Baadhi ya aya za Methods hutumia kauli “five” top-performing/base regressors, huku sehemu nyingine zikitaja majina ya algoriti nne pekee. Algoriti ya tano haijawekwa wazi katika PDF kuu.
Kutokuwa wazi kwa maandishi ndani ya chanzo: Katika Methods 4.8 kuna kauli “mordered (order-sensitive)”; chanzo hakijasahihisha zaidi kile kinachokusudiwa na kauli hii.
Kutokulingana ndani ya chanzo katika Figure 2: Kwa Klop120, lebo ya pie chart ya kundi la hitilafu ≤0.5 ni %72.22, huku maelezo ya mchoro yakiandika %77.22 na maandishi ya matokeo yakieleza takriban %77.
Kikomo cha rank-correlation: ρ=0.97 kwa Klop120 na ρ=0.95 kwa Boobier ziko wazi; kutokana na hitilafu ya kimuundo katika sentensi ya chanzo, haiwezi kubainishwa kwa uhakika ni seti ipi ya data inayohusishwa na kauli iliyobaki ya ρ=0.80. Maandishi makuu hayatoi jedwali la kina la nambari za Kendall τ.
Kikomo cha uzalishaji upya: PDF kuu hairipoti exact random seed, idadi ya Optuna trial na search space ya kina, vifaa vya kompyuta, wala algoriti kamili ya stacking meta-learner.
Kikomo cha msingi cha kisayansi: Utafiti huu ni utafiti wa utabiri wa kihesabu wa QSPR/ujifunzaji wa mashine. Matokeo ya modeli si vipimo vya majaribio vya umumunyifu na utendaji katika maeneo mapya ya kikemia unahitaji uthibitishaji wa nje.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *