


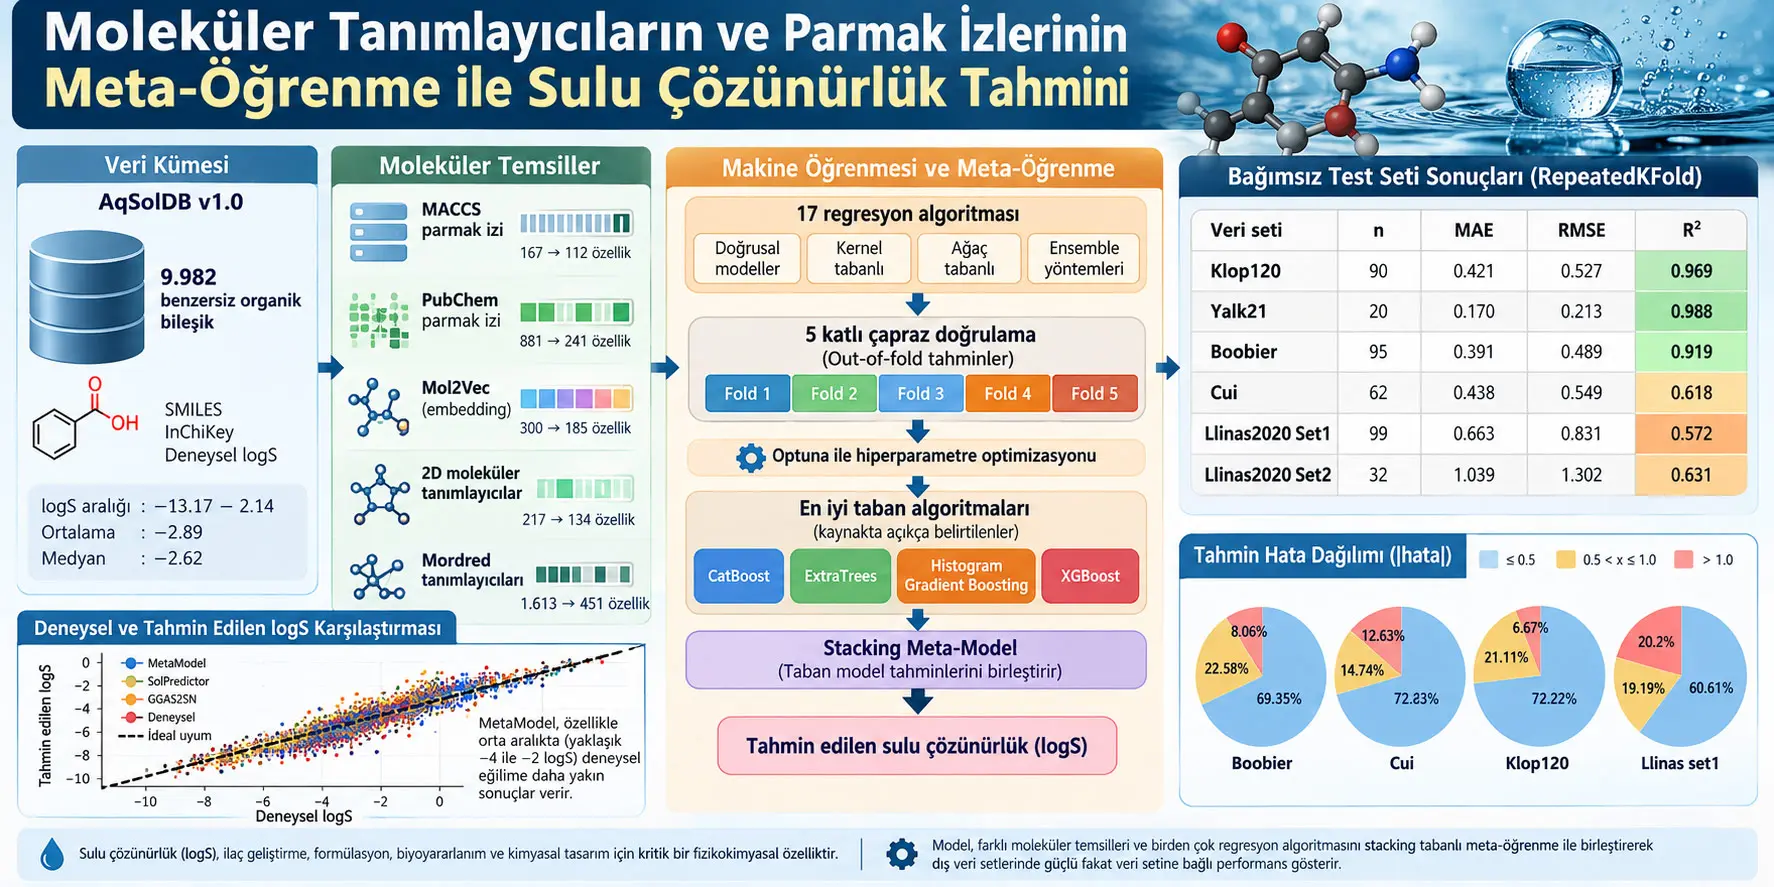
Bu çalışmadaki stacking tabanlı meta-model, bir molekülü birden fazla sayısal temsil ile kodlayan, farklı regresyon algoritmalarının tahminlerini bir üst öğrenme katmanında birleştirerek sulu çözünürlük (logS) tahmini yapan bir makine öğrenmesi sistemidir. Araştırmacılar AqSolDB v1.0'dan ön işleme sonrasında kalan 9.982 benzersiz organik bileşiği kullanmış; MACCS parmak izleri, PubChem parmak izleri, Mol2Vec embedding'leri, iki boyutlu moleküler tanımlayıcılar ve Mordred tanımlayıcıları gibi tamamlayıcı moleküler temsilleri değerlendirmiştir. Toplam 17 regresyon algoritması beş katlı çapraz doğrulama ile karşılaştırılmış, hiperparametreler Optuna ile optimize edilmiş ve en başarılı konfigürasyonlar stacking mimarisinde birleştirilmiştir.
Modelin performansı yalnız eğitim içi çapraz doğrulama ile değerlendirilmemiş; Klop120, Yalk21, Boobier, Cui ve iki Llinas2020 kümesi gibi bağımsız dış test setlerinde de sınanmıştır. Table 2'de RepeatedKFold tabanlı MetaModel; Klop120'de R²=0.969 ve RMSE=0.527, Yalk21'de R²=0.988 ve RMSE=0.213, Boobier'de R²=0.919 ve RMSE=0.489 değerlerine ulaşmıştır. Bununla birlikte Cui ve özellikle Llinas veri setlerinde performans düşmektedir; örneğin Llinas2020 Set1 için RepeatedKFold R²=0.572, Set2 için R²=0.631'dir. Bu durum model başarısının kimyasal dağılıma ve eğitim alanıyla dış test alanının benzerliğine bağlı olduğunu göstermektedir.
Kaynak, modelin SolPredictor ve GGAS2SN adlı önceki yöntemlerle karşılaştırmasını da sunmaktadır. MetaModel, Table 3'te Boobier, Klop120, Llinas set1, Lovric1 ve Yalk21 veri setlerinde genel olarak daha düşük hata ve/veya daha yüksek R² göstermektedir. Ancak her veri setinde birinci değildir: Cui ve Llinas set2'de GGAS2SN bazı ana hata ve R² metriklerinde MetaModel'den daha iyi değerler verir. Bu nedenle çalışma “MetaModel bütün kimyasal uzaylarda bütün rakipleri yener” sonucunu desteklemez.
Çalışmanın güçlü yönlerinden biri veri sızıntısını azaltmaya yönelik değerlendirme düzenidir. Ön işleme veri bölünmesinden sonra her eğitim fold'u içinde bağımsız uygulanmış, GroupKFold deneyinde ise Bemis–Murcko scaffold'ları kullanılarak aynı temel moleküler iskeleti taşıyan bileşiklerin eğitim ve doğrulama fold'larına dağılması engellenmiştir. Buna karşın ana PDF, exact random seed, Optuna trial sayısı ve arama uzayı, meta-learner'ın tam algoritması ve hesaplama donanımı gibi yeniden üretilebilirlik açısından yararlı bazı ayrıntıları raporlamamaktadır.
Çalışmanın en önemli yorum sınırı şudur: yüksek R² ve düşük RMSE değerleri, modelin deneysel çözünürlük ölçümünün yerini her kimyasal sınıfta hatasız biçimde aldığı anlamına gelmez. Kaynak Figure 1'de çok düşük veya çok yüksek çözünürlüklü bileşiklerde tahminlerin düzleşme eğilimi gösterdiği, Llinas veri kümelerinde hataların büyüdüğü ve model performansının veri dağılımına bağlı olduğu açıkça görülmektedir. Model, erken aşama molekül taraması için hesaplamalı bir araçtır; deneysel çözünürlük ölçümünün evrensel ikamesi değildir.
Araştırma problemi neden önemli?
Sulu çözünürlük, bir molekülün su içeren bir ortamda ne ölçüde çözünebildiğini ifade eden temel bir fizikokimyasal özelliktir. İlaç geliştirmede çözünürlük; formülasyon yapılabilirliğini, biyoyararlanımı ve farmakokinetik davranışı etkileyebilir. Kaynak ayrıca aynı problemin agrochemical geliştirme ve malzeme araştırmalarında da önemli olduğunu belirtmektedir. Deneysel çözünürlük ölçümleri değerli olmakla birlikte zaman, kaynak ve laboratuvar koşulları gerektirir; ayrıca pH, sıcaklık ve kristal formu gibi deneysel faktörlere duyarlı olabilir.
Bu nedenle araştırmanın problemi yalnız “bir makine öğrenmesi modeli logS tahmin edebilir mi?” değildir. Asıl soru, birbirinden farklı kimyasal bilgi türlerini temsil eden moleküler tanımlayıcıların, binary fingerprint'lerin ve öğrenilmiş embedding'lerin birden fazla regresyon modeliyle birleştirilmesi sonucunda dış kimyasal veri setlerine daha dayanıklı bir çözünürlük tahmin sistemi kurulup kurulamayacağıdır.
Sulu Çözünürlük Tahmininde logS Ne Anlama Geliyor?
Bu makalede logS, deneysel sulu çözünürlüğün logaritmik hedef değişkenidir; modelin tahmin etmeye çalıştığı sürekli sayısal çıktı budur. AqSolDB tabanlı eğitim verisinde logS değerleri −13.17 ile 2.14 arasında değişmektedir ve kaynak düşük değerleri çok düşük çözünürlüğe, yüksek değerleri daha yüksek çözünürlüğe karşılık gelen bir ölçek olarak kullanmaktadır. Ancak ana PDF Methods bölümünde logaritmanın tabanı ve logS'nin altında kullanılan ham çözünürlük birimi ayrıca yeniden tanımlanmadığı için Verianla bu ayrıntıyı kaynak dışından eklememektedir.
AqSolDB eğitim verisi
Araştırmada AqSolDB version 1.0 kullanılmıştır. Eksik kayıtların çıkarılması ve ön işlemenin ardından veri kümesi 9.982 benzersiz organik bileşik içermektedir. Her bileşik SMILES dizgesi, InChIKey ve deneysel olarak ölçülmüş logaritmik sulu çözünürlük değeriyle temsil edilmektedir.
| Benzersiz bileşik sayısı | 9.982 |
|---|---|
| Kimlik/struktur gösterimleri | SMILES ve InChIKey |
| Hedef değişken | Deneysel sulu çözünürlük, logaritmik ölçek |
| Minimum logS | −13.17 |
| Maksimum logS | 2.14 |
| Ortalama logS | −2.89 |
| Medyan logS | −2.62 |
Kaynak, AqSolDB'nin birden fazla literatür kaynağından deneysel gözlemleri birleştirmesinin veri içinde doğal gürültü ve değişkenlik oluşturduğunu belirtmektedir. Araştırmacılar bunu yalnız olumsuzluk olarak değerlendirmez; gerçek erken ilaç araştırmalarında farklı ölçüm kaynaklarından gelen heterojenliğe daha yakın bir senaryo oluşturduğunu savunurlar. Bununla birlikte aynı özellik, tahmin hatasının yalnız model mimarisinden değil deneysel ölçüm farklılıklarından da etkilenebileceği anlamına gelir.
Eğitim ve dış test dağılımları neden aynı değil?
Kaynak Figure 3, eğitim verisi ile çeşitli dış test setlerinin logS dağılımlarının aynı olmadığını göstermektedir. Klop120 eğitim dağılımına görece yakınken Cui ve Boobier daha dar ve daha kompakt dağılımlar sergiler. Llinas1 ve Llinas2 ise daha geniş, daha dağınık ve düşük çözünürlük bölgesine doğru kaymış dağılımlar gösterir. Araştırmacılar Llinas setlerindeki bu dağılım kaymasını model genellemesi açısından daha zor bir problem olarak değerlendirmektedir.
Kaynak Figure 4'teki t-SNE görselleştirmesi de dış veri setlerindeki birçok bileşiğin eğitim örneklerinin kapladığı kimyasal uzayın içinde veya yakınında bulunduğunu; özellikle bazı Llinas örneklerinin ise yoğun eğitim kümelerinin çevresinde veya dışında yer alabildiğini göstermektedir. Bu t-SNE grafiği modelin tahmin algoritmasının kendisi değildir; veri setlerinin kimyasal uzayda göreli konumlarını görselleştirmek için kullanılan açıklayıcı bir projeksiyondur.
Moleküler Tanımlayıcı, Parmak İzi ve Mol2Vec Embedding Arasındaki Fark Nedir?
Moleküler tanımlayıcılar bir molekülün boyut, bağlantı, elektronik veya fizikokimyasal özelliklerini sayısal değerlerle temsil eder; kimyasal fingerprint'ler belirli yapısal motiflerin varlığını çoğunlukla 0/1 bitleriyle kodlar; Mol2Vec ise moleküler alt yapıları Word2Vec'e benzer şekilde sürekli vektör uzayında temsil etmeyi öğrenen bir embedding yöntemidir. Çalışmanın temel fikri, bu temsillerin aynı kimyasal yapıya farklı bakışlar sağlaması nedeniyle tek bir temsil yerine birbirini tamamlayabilecek olmalarıdır.
MACCS fingerprint
MACCS key, moleküler yapıda belirli kimyasal özelliklerin veya alt yapı motiflerinin bulunup bulunmadığını binary bitlerle ifade eden bir fingerprint yaklaşımıdır. Bir bitin 1 olması ilgili özelliğin mevcut, 0 olması mevcut olmadığını temsil eder. Kaynak ön işleme öncesinde 167 MACCS özelliği bulunduğunu; temizleme sonrasında 112 özelliğin kaldığını bildirmektedir.
2D moleküler tanımlayıcılar
İki boyutlu moleküler tanımlayıcılar atomların üç boyutlu konformasyonunu doğrudan kullanmak yerine molekülün bağlantı tablosuna dayanır. Boyut, dallanma, bağlantı örüntüsü ve elektronik dağılımla ilişkili çeşitli sayısal özellikler oluşturabilir. Kaynakta 217 başlangıç özelliği ön işleme sonrasında 134'e düşmüştür.
Mordred tanımlayıcıları
Mordred, cheminformatics çalışmalarında çok sayıda moleküler tanımlayıcı hesaplayabilen bir descriptor yazılımıdır. Kaynak genel olarak Mordred'in 1.800'den fazla descriptor hesaplayabildiğini belirtmektedir. Bu çalışmanın oluşturduğu özellik matrisinde temizleme öncesi Mordred özellik sayısı 1.613, ön işleme sonrasında 451'dir.
Mol2Vec
Mol2Vec, kelimeler için geliştirilen Word2Vec mantığına benzer biçimde moleküler alt yapılar için yoğun vektör temsilleri öğrenen denetimsiz bir makine öğrenmesi yaklaşımıdır. Molekülün alt yapılarından öğrenilen vektörlerin birleştirilmesiyle bütün molekül için sayısal bir embedding oluşturulur. Çalışmada 300 boyutlu başlangıç temsilinden ön işleme sonrasında 185 özellik kalmıştır.
PubChem fingerprint
PubChem fingerprint, halka, atom çifti ve başka yapısal motiflerin varlığını binary alt yapı bitleriyle ifade eder. Kaynak çalışmada başlangıçtaki 881 PubChem özelliği temizleme sonrasında 241 özelliğe düşmüştür.
| Temsil | Başlangıç özellik sayısı | Ön işleme sonrası |
|---|---|---|
| MACCS | 167 | 112 |
| 2D descriptors | 217 | 134 |
| Mordred | 1.613 | 451 |
| Mol2Vec | 300 | 185 |
| PubChem | 881 | 241 |
Ön işleme neden veri bölündükten sonra yapıldı?
Makine öğrenmesinde bütün veri üzerinde özellik seçimi yapıp ardından eğitim-test bölümü oluşturmak, test verisinin istatistiksel bilgisinin dolaylı biçimde eğitim sürecine sızmasına neden olabilir. Kaynak bu riski azaltmak için düşük varyans ve yüksek korelasyon filtrelerini veri bölünmesinden sonra ve her eğitim fold'u içinde bağımsız olarak uygulamıştır. Eğitim fold'unda öğrenilen özellik alt kümesi daha sonra ilgili doğrulama/test bölümüne uygulanmıştır.
VarianceThreshold değeri 0.01 olarak kullanılmıştır. Eksik veya sonsuz değer içeren özellikler çıkarılmış, ardından korelasyon katsayısı 0.80'den büyük olan fazlalık özellikler elenmiştir. Buradaki amaç hem gürültüyü ve tekrarı azaltmak hem de özellik seçiminde değerlendirme verisinin önceden görülmesini engellemektir.
Stacking Tabanlı Meta-Öğrenme Bu Çalışmada Nasıl Çalışıyor?
Stacking yaklaşımında tek bir regresyon modelinin tahmini nihai cevap olarak alınmaz; farklı taban modellerinin out-of-fold tahminleri yeni “meta-feature”lar haline getirilir ve üst düzey bir meta-learner bu tahminleri birleştirerek nihai logS değerini üretir. Bu çalışmada beş katlı çapraz doğrulama sayesinde her eğitim örneği için meta-feature, o örneği eğitim sırasında görmemiş bir taban modelinden üretilmeye çalışılmıştır; böylece stacking katmanına doğrudan eğitim hedefini ezberleten bilgi sızıntısı azaltılmıştır.
Out-of-fold tahmin mantığı
Eğitim verisi beş bölüme ayrılmıştır. Her iterasyonda dört fold taban modeli eğitmek için, kalan fold ise tahmin üretmek için kullanılır. Beş iterasyon sonunda her eğitim örneği kendisini eğitimde görmemiş bir modelden en az bir tahmin alır. Bu tahminler yan yana getirilerek stacking meta-modelinin eğitim girdisi oluşturulur.
Daha sonra optimize edilmiş taban modelleri bütün eğitim verisi üzerinde yeniden eğitilir ve bağımsız dış test setleri için tahmin üretir. Bu dış tahminler de aynı düzenle stacking girişine dönüştürülür. Meta-learner, taban tahminlerinden nihai sulu çözünürlük tahminini oluşturur.
Karşılaştırılan 17 regresyon algoritması
| Yöntem ailesi | Algoritmalar |
|---|---|
| Doğrusal / robust / regularized | Bayesian Ridge, Ridge, Lasso, ElasticNet, Huber, Linear Regression |
| Kernel / instance / tek ağaç | Support Vector Regression, K-Nearest Neighbors, Decision Tree |
| Ensemble / boosting | Random Forest, Gradient Boosting, Histogram Gradient Boosting, AdaBoost, ExtraTrees, CatBoost, LightGBM, XGBoost |
Optuna burada ne yapıyor?
Optuna, algoritmanın kim olduğunu değiştiren bir tahmin modeli değil, model hiperparametrelerinin uygun kombinasyonlarını arayan bir optimizasyon çerçevesidir. Kaynak, seçilen güçlü modeller için hiperparametre optimizasyonunun her moleküler encoding tekniğine bağımsız uygulandığını belirtmektedir.
Ancak ana PDF Optuna'nın kaç deneme yaptığı, hangi hiperparametrelerin hangi aralıklarda arandığı, hangi sampler/pruner yapılandırmasının kullanıldığı veya optimizasyonun random seed değerini raporlamamaktadır. Dolayısıyla aynı araştırmayı bit düzeyinde tekrar etmek isteyen bir okuyucu ana PDF'den bu ayrıntıların tümünü elde edemez.
Taban model sayısıyla ilgili kaynak-içi belirsizlik
Özet, Discussion, Methods 4.5 ve Final features selection bölümleri CatBoost, ExtraTrees, Histogram Gradient Boosting ve XGBoost olmak üzere dört isim verir. Buna karşılık Methods 4.6 “five top-performing machine-learning regression models”, Methods 4.8 de “five optimized base regressors” ifadesini kullanır. Ana PDF beşinci taban algoritmasını açık biçimde adlandırmamaktadır. Bu nedenle Verianla “beşinci model şudur” şeklinde kaynak dışı tamamlamada bulunmaz.
Methods 4.8'de ayrıca “mordered (order-sensitive) feature representations” ifadesi geçmektedir. Bağlam bunun Mordred ile ilişkili bir yazım sorununa işaret edebileceğini düşündürse de kaynak bunu açıkça düzeltmediğinden burada kesin bir düzeltme yapılmamıştır.
GroupKFold Neden Daha Sıkı Bir Genelleme Testidir?
Bu çalışmadaki GroupKFold, aynı Bemis–Murcko temel iskeletini taşıyan molekülleri aynı fold içinde tutarak benzer scaffold'ların hem eğitim hem doğrulama tarafında bulunmasını engellemeye çalışır; böylece modelin çok yakın yapısal akrabaları ezberleyip yüksek performans göstermesi yerine daha önce görmediği temel chemotype'lara genelleme yeteneği daha sert biçimde sınanır. Bunun bedeli, kaynak sonuçlarında da görüldüğü gibi Random Split veya RepeatedKFold'a göre bazı metriklerin daha düşük çıkabilmesidir.
Bemis–Murcko scaffold nedir?
Bemis–Murcko scaffold, bir molekülün temel halka ve bağlantı iskeletini temsil etmek için kullanılan bir yapı özetidir. Araştırmacılar RDKit ile her bileşiğin scaffold'unu hesaplamış, scaffold SMILES temsillerini üretmiş ve aynı temel yapıya sahip molekülleri ortak grup kimliği altında toplamıştır.
GroupKFold daha sonra bu grup etiketlerini kullanarak aynı scaffold'un farklı fold'lara bölünmesini engellemiştir. Bu tasarım, özellikle kimyasal benzerliğin yüksek olduğu veri setlerinde eğitim-doğrulama sızıntısını azaltmayı amaçlar.
Diğer veri bölme stratejileri
Random Split, örnekleri rastgele böler ve kaynakta en düşük eğitim RMSE'sini üretmiştir; ancak yapısal olarak çok benzer moleküllerin karşı taraflara dağılma olasılığı vardır.
RepeatedKFold, farklı rastgele bölmelerle k-fold işlemini birden çok kez tekrarlar. Amaç, tek bir bölmenin şansına bağımlılığı azaltmaktır.
ShuffleSplit, veriyi tekrar tekrar karıştırıp bağımsız eğitim-test bölümleri oluşturur ve farklı örnekleme senaryolarında performans değişkenliğini incelemeye yardımcı olur.
Çalışmanın Yöntemi ve Bulguları
Beş katlı stacking eğitiminin teknik akışı
Eğitim verisi beş yaklaşık eşit fold'a ayrılmıştır. Her döngüde dört fold taban öğreniciyi eğitmiş, kalan fold üzerinde tahmin üretilmiştir. Beş fold'un tahminleri birleştirilerek out-of-fold meta-feature matrisi oluşturulmuştur. Böylece meta-modeli eğiten tahminlerin ilgili örneği eğitim sırasında görmemiş bir taban modelinden gelmesi hedeflenmiştir.
Meta-feature üretimi tamamlandıktan sonra optimize edilmiş taban modelleri bütün eğitim setinde yeniden eğitilmiş ve bağımsız dış test setleri için tahmin üretmiştir. Bu taban tahminlerinin bir araya getirilmesiyle test meta-feature matrisi oluşturulmuş, nihai logS tahminleri stacking meta-modelinden alınmıştır.
Farklı split stratejilerinde eğitim performansı
| Split stratejisi | MAE | MSE | RMSE | R² |
|---|---|---|---|---|
| Random Split | 0.727 | 0.830 | 0.911 | 0.838 |
| RepeatedKFold | 0.745 | 0.871 | 0.933 | 0.842 |
| GroupKFold | 0.796 | 0.973 | 0.985 | 0.782 |
| ShuffleSplit | 0.739 | 0.857 | 0.926 | 0.823 |
Random Split en düşük RMSE'yi 0.911 ile verirken RepeatedKFold en yüksek R² değerini 0.842 ile vermiştir. GroupKFold'da R² 0.782'ye düşmekte ve RMSE 0.985'e çıkmaktadır. Bu fark otomatik olarak GroupKFold'un “kötü yöntem” olduğu anlamına gelmez; scaffold düzeyindeki benzerliği ayrı fold'lara taşımaması nedeniyle değerlendirme problemi daha zor hale gelmektedir.
Bağımsız dış test setleri
| Test seti | n | Random Split | RepeatedKFold | GroupKFold | ShuffleSplit |
|---|---|---|---|---|---|
| Klop120 | 90 | 0.431 / 0.540 / 0.967 | 0.421 / 0.527 / 0.969 | 0.561 / 0.701 / 0.934 | 0.432 / 0.541 / 0.967 |
| Yalk21 | 20 | 0.192 / 0.240 / 0.985 | 0.170 / 0.213 / 0.988 | 0.295 / 0.363 / 0.937 | 0.211 / 0.265 / 0.982 |
| Boobier | 95 | 0.410 / 0.513 / 0.911 | 0.391 / 0.489 / 0.919 | 0.492 / 0.616 / 0.873 | 0.417 / 0.523 / 0.908 |
| Cui | 62 | 0.417 / 0.522 / 0.654 | 0.438 / 0.549 / 0.618 | 0.586 / 0.730 / 0.519 | 0.421 / 0.528 / 0.647 |
| Llinas2020 Set1 | 99 | 0.668 / 0.837 / 0.564 | 0.663 / 0.831 / 0.572 | 0.719 / 0.899 / 0.563 | 0.686 / 0.859 / 0.541 |
| Llinas2020 Set2 | 32 | 1.106 / 1.387 / 0.581 | 1.039 / 1.302 / 0.631 | 1.145 / 1.423 / 0.588 | 1.118 / 1.401 / 0.572 |
Klop120 veri setinin adı “120” içerse de kaynak Table 2, bu değerlendirmede n=90 olarak raporlamaktadır. Verianla tablo adından hareketle örnek sayısını 120'ye çevirmemiştir.
RepeatedKFold; Klop120, Yalk21, Boobier ve iki Llinas setinde en düşük veya en iyiye yakın hatalarla güçlü sonuç vermektedir. Cui'de ise Random Split R²=0.654 ile RepeatedKFold'un 0.618'inden daha yüksek ve RMSE=0.522 ile daha düşüktür. Bu nedenle tek bir split stratejisinin bütün test setlerinde aynı biçimde üstün olduğu sonucu çıkarılamaz.
MAE, MSE, RMSE ve R² Ne Anlatır?
MAE ortalama mutlak tahmin hatasını, MSE hataların karesinin ortalamasını, RMSE MSE'nin karekökünü ve böylece hatayı yeniden hedef değişkenin logS ölçeğine döndüren büyüklüğü, R² ise modelin gözlenen logS değişkenliğinin ne kadarını açıkladığını ölçer. MAE, MSE ve RMSE için daha küçük; R² için genel olarak 1'e daha yakın değer daha iyi performansı ifade eder, fakat tek bir metrik modelin bütün hata yapısını açıklamaz.
Denklem 1: Ortalama Mutlak Hata — MAE
\(\displaystyle MAE=\frac{1}{n}\sum_{i=1}^{n}|y_i-\hat{y}_i|\)
1. Formül neyi hesaplar? Her bileşik için gerçek logS ile model tahmini arasındaki farkın mutlak değerini alır ve tüm örnekler üzerinde ortalamasını hesaplar.
2. Değişkenler nelerdir? \(n\) toplam örnek sayısıdır; \(y_i\) i'inci örneğin deneysel/gözlenen çözünürlük değeridir; \(\hat{y}_i\) aynı örnek için model tahminidir.
3. Birim nedir? MAE hedef değişkenle aynı ölçekte ifade edilir. Bu çalışmada hedef logS olduğundan MAE de logS hedef ölçeğindedir. PDF logS'nin ham birimini ayrıca tanımlamadığı için daha ileri bir fiziksel birim eklenmemektedir.
4. Matematiksel rol nedir? Mutlak değer, pozitif ve negatif tahmin hatalarının birbirini götürmesini engeller. Her hata büyüklüğüne doğrusal ağırlık verir.
5. Algoritmik anlam nedir? Modelin tipik bir örnekte deneysel değerden yaklaşık ne kadar saptığını doğrudan okunabilir biçimde özetler.
6. Hangi koşulda geçerlidir? Gerçek ve tahmin değerleri aynı hedef ölçeğinde olmalıdır. Farklı veri setlerinin hedef dağılımları farklıysa yalnız MAE'ye bakarak bütün genelleme niteliği açıklanamaz.
7. Nasıl yorumlanır? Daha düşük MAE, ortalama mutlak tahmin sapmasının daha küçük olduğunu gösterir; ancak az sayıdaki çok büyük hatayı MSE kadar güçlü cezalandırmaz.
Denklem 2: Ortalama Kare Hata — MSE
\(\displaystyle MSE=\frac{1}{n}\sum_{i=1}^{n}(y_i-\hat{y}_i)^2\)
1. Formül neyi hesaplar? Her tahmin hatasının karesini alır ve kare hataların ortalamasını hesaplar.
2. Değişkenler: \(n\), \(y_i\) ve \(\hat{y}_i\) MAE denklemindeki anlamlarını korur.
3. Birim: Hedef ölçeğin karesidir; bu nedenle MSE, MAE veya RMSE kadar doğrudan hedef ölçeğinde okunmaz.
4. Matematiksel rol: Hata karesi alındığı için büyük sapmalar küçük sapmalardan orantısız biçimde daha büyük ceza alır.
5. Algoritmik anlam: Çok büyük tahmin hatalarının istenmediği problemlerde modelin büyük sapmalarına duyarlı bir kalite ölçütüdür.
6. Koşul: MSE'nin büyüklüğü hedef değişkenin ölçeğinden etkilenir; farklı ölçeklerdeki görevler doğrudan aynı MSE sayısıyla karşılaştırılmamalıdır.
7. Yorum: Daha düşük MSE daha iyidir, fakat kare alma işlemi nedeniyle birkaç uç hata değeri metriği güçlü biçimde yükseltebilir.
Denklem 3: Kök Ortalama Kare Hata — RMSE
\(\displaystyle RMSE=\sqrt{\frac{1}{n}\sum_{i=1}^{n}(y_i-\hat{y}_i)^2}\)
1. Formül neyi hesaplar? MSE'nin karekökünü alır.
2. Değişkenler: \(n\), \(y_i\) ve \(\hat{y}_i\) önceki denklemlerdekiyle aynıdır.
3. Birim: Karekök sayesinde hedef değişkenin ölçeğine geri döner; bu çalışmada logS hedef ölçeğinde yorumlanır.
4. Matematiksel rol: Önce büyük hataları kareleyerek vurgular, ardından karekök ile sonucu yeniden hedef ölçeğine taşır.
5. Algoritmik anlam: Büyük tahmin hatalarına MAE'den daha duyarlı fakat MSE'den daha doğrudan okunabilir bir hata metriğidir.
6. Koşul: Veri setinin dağılımı ve uç değerler RMSE'yi etkileyebilir; bu nedenle farklı external setlerdeki RMSE farkları kimyasal dağılım farklarıyla birlikte değerlendirilmelidir.
7. Yorum: RMSE'nin düşmesi genel olarak daha iyi tahmin performansını gösterir. Örneğin Yalk21 RepeatedKFold RMSE=0.213 iken Llinas2020 Set2'de 1.302'dir; model ikinci veri setinde belirgin biçimde daha yüksek hata üretmektedir.
Denklem 4: Belirleme Katsayısı — R²
\(\displaystyle R^2=1-\frac{\sum_{i=1}^{n}(y_i-\hat{y}_i)^2}{\sum_{i=1}^{n}(y_i-\bar{y})^2}\)
1. Formül neyi hesaplar? Modelin kare tahmin hatasını, gözlenen değerlerin kendi ortalamasından toplam kare sapmasıyla karşılaştırır.
2. Değişkenler: \(y_i\) gerçek değer, \(\hat{y}_i\) tahmin, \(\bar{y}\) gözlenen hedef değerlerin ortalaması ve \(n\) örnek sayısıdır.
3. Birim: İki kare toplamının oranı olduğundan R² boyutsuzdur.
4. Matematiksel rol: Paydaki residual sum of squares küçüldükçe oran küçülür ve R² 1'e yaklaşır.
5. Algoritmik anlam: Model tahminlerinin gözlenen logS değişkenliğini ne ölçüde açıkladığının özetidir.
6. Koşul: R² veri setinin hedef dağılımından etkilenebilir. Dar hedef aralığı veya distribution shift altında aynı RMSE farklı R² davranışı gösterebilir.
7. Yorum: R²=1 kusursuz uyuma karşılık gelir. R²'nin sıfıra yaklaşması açıklayıcı gücün zayıflamasını, sıfırın altına düşmesi ise modelin ortalama değerle tahmin yapmaktan bile daha kötü davranabildiğini gösterebilir. Bu çalışma dış testlerde veri setine bağlı olarak oldukça farklı R² değerleri raporlamaktadır.
MetaModel, SolPredictor ve GGAS2SN karşılaştırması
| Veri seti | MetaModel | SolPredictor | GGAS2SN |
|---|---|---|---|
| Boobier | 0.428 / 0.597 / 0.880 | 0.821 / 1.103 / 0.591 | 0.539 / 0.696 / 0.837 |
| Cui | 0.444 / 0.567 / 0.592 | 0.722 / 0.862 / 0.057 | 0.428 / 0.519 / 0.608 |
| Klop120 | 0.424 / 0.603 / 0.959 | 0.965 / 1.208 / 0.837 | 0.499 / 0.680 / 0.948 |
| Llinas set1 | 0.619 / 0.882 / 0.517 | 1.000 / 1.250 / 0.474 | 0.719 / 0.940 / 0.451 |
| Llinas set2 | 1.027 / 1.372 / 0.590 | 1.458 / 1.762 / 0.323 | 0.990 / 1.242 / 0.633 |
| Lovric1 | 0.511 / 0.780 / 0.807 | 0.625 / 0.783 / 0.803 | 0.655 / 0.794 / 0.775 |
| Yalk21 | 0.332 / 0.387 / 0.961 | 1.075 / 1.204 / 0.618 | 0.447 / 0.588 / 0.909 |
Bu tablo önemli bir nüansı ortaya çıkarır: MetaModel birçok veri setinde güçlüdür fakat bütün veri setlerinde en iyi değildir. Cui'de GGAS2SN hem daha düşük MAE/RMSE hem daha yüksek R² verir. Llinas set2'de de GGAS2SN'nin MAE, RMSE ve R² değerleri MetaModel'den daha iyidir. Dolayısıyla yazarların genel “robust” yorumuna rağmen kaynak tablonun sayısal içeriği yöntem üstünlüğünün veri setine bağlı olduğunu göstermektedir.
Table 2 ve Table 3 neden aynı sayıları vermiyor?
Table 2 aynı stacking MetaModel'i farklı split stratejileri altında karşılaştırırken Table 3 MetaModel'i SolPredictor ve GGAS2SN ile kıyaslar. Ortak veri setlerinde rakamlar birebir aynı değildir; örneğin Boobier için Table 2'de RepeatedKFold R²=0.919 iken Table 3'te MetaModel R²=0.880'dir. Ana PDF bu tablolar arasındaki performans farkının tam değerlendirme konfigürasyonunu ayrıntılı biçimde uzlaştırmamaktadır. Bu nedenle Verianla iki tabloyu tek performans tablosuymuş gibi birleştirmemiştir.
İstatistiksel model karşılaştırmaları
Araştırmacılar örnek başına mutlak tahmin hataları üzerinde Wilcoxon signed-rank testleri ve paired t-test'ler kullanmıştır. Boobier ve Cui veri setlerinde MetaModel'in SolPredictor'a göre avantajı P<0.001 olarak raporlanmıştır. Boobier'de MetaModel ile GGAS2SN arasındaki fark P<0.05 düzeyinde anlamlıdır. Cui'de ise MetaModel ile GGAS2SN arasında P>0.05 olup istatistiksel olarak anlamlı fark raporlanmamıştır.
Bu istatistiksel sonuçlar, Table 3'te Cui üzerinde GGAS2SN'nin sayısal olarak biraz daha iyi metrikler vermesiyle birlikte okunmalıdır: küçük metrik farkı istatistiksel olarak anlamlı olmayabilir. Sayısal üstünlük ile istatistiksel olarak gösterilmiş üstünlük aynı kavram değildir.
Spearman ve Kendall korelasyonları
Kaynak, geniş logS dinamik aralığında yalnız R²'ye bağımlı kalmamak için Spearman rank correlation coefficient (ρ) ve Kendall's Tau (τ) da değerlendirdiğini belirtmektedir. Klop120 için Spearman ρ=0.97 ve Boobier için ρ=0.95 açıkça yazılmıştır.
Bununla birlikte kaynak cümlesinin Yalk21 ve sonraki ρ=0.80 bölümünde dilbilgisel/biçimsel bozukluk vardır: “Yalk21 (ρ) ... (ρ = 0.80)” şeklindeki yapı 0.80 değerinin hangi veri setine kesin olarak ait olduğunu açık bırakmamaktadır. Ana metinde Kendall τ değerlerinin sayısal tablosu da gösterilmemektedir. Bu nedenle Verianla ρ=0.80 veya τ için kaynakta açıkça bulunmayan veri seti eşleştirmesi yapmamaktadır.
Predicted vs experimental logS grafikleri ne gösteriyor?
Kaynak Figure 1, Boobier, Cui, Llinas set1 ve Klop120 veri setlerinde deneysel logS eğilimi ile MetaModel, SolPredictor ve GGAS2SN tahminlerinin ilişkisini karşılaştırmaktadır. Yazarların yorumuna göre MetaModel özellikle yaklaşık −4 ile −2 logS arasındaki orta bölgede deneysel eğilime yakın seyretmektedir.
Çok yüksek veya çok düşük çözünürlük uçlarında ise tahmin eğrilerinin düzleşme eğilimi gösterdiği belirtilmektedir. Bu, modelin ekstrem çözünürlük değişimlerine orta aralık kadar hassas olmayabileceğini düşündürür. Figure 1'in ham binned koordinatları tablo halinde verilmediği için Verianla grafiği yeniden çizip yeni sayısal noktalar üretmemektedir.
Figure 2 hata dağılımı ve kaynak içi sayı çelişkisi
Figure 2, mutlak tahmin hatalarını üç aralıkta sınıflandırmaktadır: ≤0.5, 0.5<x≤1.0 ve >1.0. Görselin üzerindeki etiketlerde Boobier için dağılım yaklaşık %69.35 / %22.58 / %8.06; Cui için %72.63 / %14.74 / %12.63; Klop120 için %72.22 / %21.11 / %6.67; Llinas set1 için %60.61 / %19.19 / %20.2 olarak görünmektedir.
Ancak aynı şeklin açıklaması Klop120 için ≤0.5 hata oranını %77.22 olarak, önceki sonuç paragrafı da yaklaşık %77 olarak yazmaktadır. Görsel etiketi ise %72.22'dir. Bu kaynak-içi uyuşmazlık çözümlenmiş veri gibi sunulamaz. Güvenle söylenebilen nokta, Klop120'de düşük hata grubunun baskın, Llinas set1'de ise >1.0 hata grubunun daha yüksek olduğudur.
Fonksiyonel grup dağılımı neyi anlatıyor?
Kaynak Figure 5, hydroxyl, ether, carbonyl, halogen ve aromatic yapılar arasındaki örtüşmeleri göstererek eğitim veri setinin kimyasal çeşitliliğini açıklamaya çalışır. Aromatik yapıların yüksek sayıda bulunması hidrofobik halka sistemlerinin veri setinde yaygın olduğunu; hydroxyl ve carbonyl gibi polar fonksiyonel grupların aromatic sistemlerle aynı moleküllerde birlikte bulunabilmesi ise birçok bileşiğin hem hidrofobik hem hidrofilik karakterler taşıdığını gösterir.
Yazarlar hydroxyl ve carbonyl gruplarının suyla hydrogen bonding veya dipole–dipole etkileşimleri üzerinden çözünürlüğü destekleyebileceğini, halojenlerin lipofilisiteyi artırarak çözünürlüğü azaltabileceğini tartışmaktadır. Bu açıklamalar veri seti kompozisyonunu kimyasal açıdan yorumlayan genel mekanistik çerçevedir; Figure 5 tek başına belirli bir fonksiyonel grubun bu veri setindeki çözünürlüğe nedensel katkı büyüklüğünü ölçmez.
Yüksek R² Modelin Her Kimyasal Uzayda Güvenilir Olduğu Anlamına Gelir mi?
Hayır. Bu çalışmada Yalk21 ve Klop120 gibi bazı dış setlerde R² yaklaşık 0.97-0.99'a ulaşırken Llinas ve Cui gibi dağılımı veya kimyasal alanı daha zor setlerde R² belirgin biçimde düşmektedir; dolayısıyla yüksek R² belirli bir değerlendirme veri setinde güçlü uyumu gösterir, bilinmeyen bütün chemotype'larda aynı doğruluğun garanti edildiğini göstermez. GroupKFold sonuçlarının daha düşük olması ve Llinas setlerindeki yüksek hatalar da yapısal dağılım değişiminin genellemeyi zorlaştırdığını desteklemektedir.
Çalışmanın güçlü yönleri
Birinci güçlü yön, molekülü tek bir encoding'e zorlamak yerine binary fingerprints, klasik descriptor'lar ve öğrenilmiş Mol2Vec embedding'lerini birlikte değerlendirmesidir. Bu yaklaşım farklı temsil türlerinin birbirini tamamlayabilmesini sağlar.
İkinci güçlü yön, 17 farklı regresyon algoritmasının ortak değerlendirme düzeninde karşılaştırılması ve güçlü modellerin Optuna ile ayrıca optimize edilmesidir.
Üçüncü güçlü yön, stacking için out-of-fold meta-feature üretiminin kullanılmasıdır. Bu tasarım meta-modelin kendi eğitim örneklerini görmüş taban tahminlerinden doğrudan beslenmesi riskini azaltmayı amaçlar.
Dördüncü güçlü yön, yalnız tek random split'e güvenilmemesi; Random Split, RepeatedKFold, GroupKFold ve ShuffleSplit sonuçlarının birlikte incelenmesidir.
Beşinci güçlü yön, modelin AqSolDB eğitim alanı dışındaki bağımsız test koleksiyonlarında değerlendirilmesi ve SolPredictor ile GGAS2SN gibi önceki modellerle karşılaştırılmasıdır.
Temel sınırlılıklar
Birinci sınırlılık veri kalitesidir. AqSolDB birçok literatür kaynağındaki deneysel çözünürlük ölçümlerini birleştirdiği için farklı laboratuvar koşullarından kaynaklanan gürültü ve heterojenlik içerebilir.
İkinci sınırlılık descriptor tabanlı temsilin karmaşık üç boyutlu veya uzun menzilli yapısal etkileşimleri eksiksiz temsil edemeyebilmesidir. Kaynak yazarları gelecek çalışmalar için graph neural networks, transformer tabanlı moleküler embedding'ler ve pretrained molecular encoders önermektedir.
Üçüncü sınırlılık kimyasal domain shift'tir. Llinas veri setlerinde dağılım eğitim alanından daha fazla sapmakta ve tahmin hataları yükselmektedir.
Dördüncü sınırlılık modelin ekstrem çözünürlük bölgelerinde tahminlerinin düzleşebilmesidir; kaynak bu durumu çok yüksek veya çok düşük logS değerlerindeki değişimlere daha düşük hassasiyet olarak tartışmaktadır.
Beşinci sınırlılık ana PDF'nin bazı yeniden üretilebilirlik ayrıntılarını vermemesidir. Random seed, kullanılan hesaplama donanımı, Optuna deneme sayısı ve tam hiperparametre arama uzayları, stacking meta-learner'ın kesin algoritması ve bütün final model hiperparametreleri ana metinde bulunmamaktadır.
Altıncı sınırlılık taban model sayısındaki kaynak-içi uyuşmazlıktır: makalenin bazı bölümleri dört isim verirken bazı Methods paragrafları beş taban regresöründen bahseder.
Yedinci sınırlılık, Figure 2'de Klop120 düşük hata yüzdesinin grafik etiketi ile açıklama/metin arasında uyuşmamasıdır.
Çalışmanın desteklediği yorumlar
- Birden çok moleküler temsilin ve ensemble regresyon modellerinin stacking yapısında birleştirilmesi sulu çözünürlük tahmininde güçlü performans sağlayabilir.
- Model bazı bağımsız dış veri setlerinde yüksek R² ve düşük tahmin hatası göstermiştir.
- RepeatedKFold birçok dış veri setinde güçlü ve kararlı sonuçlar üretmiştir.
- Scaffold tabanlı GroupKFold daha sıkı bir yapısal genelleme değerlendirmesi sunmaktadır.
- MetaModel, SolPredictor'a karşı Boobier ve Cui'de istatistiksel olarak anlamlı derecede daha düşük hata göstermiştir.
- Model başarısı dış veri setinin kimyasal dağılımına bağlıdır.
- Moleküler encoding seçimi ve veri bölme stratejisi performans değerlendirmesinin önemli parçalarıdır.
Çalışmanın desteklemediği yorumlar
- MetaModel'in bütün moleküllerde ve bütün veri setlerinde en iyi model olduğu gösterilmemiştir.
- Model deneysel çözünürlük ölçümünün hatasız yerine geçtiğini kanıtlamamaktadır.
- Yüksek R² bütün kimyasal uzaylarda aynı genelleme performansını garanti etmez.
- Descriptor veya fingerprint'lerde bulunan belirli bir özelliğin çözünürlük üzerinde nedensel etkisi bu model karşılaştırmasından tek başına çıkarılamaz.
- t-SNE grafiğindeki yakınlık doğrudan model doğruluğu veya kimyasal nedensellik ölçümü değildir.
- Table 2'deki en iyi split sonucu ile Table 3'teki yöntem karşılaştırma sonucu aynı performans deneyi gibi birleştirilemez.
- Kaynakta açıklanmayan beşinci taban model, meta-learner algoritması veya Optuna hiperparametreleri tahmin edilerek doldurulamaz.
Uygulama anlamı
Bu framework, büyük molekül kütüphanelerindeki adayların deneysel teste girmeden önce hesaplamalı olarak sıralanması, erken ilaç keşfinde düşük çözünürlüklü aday riskinin öngörülmesi ve moleküler tasarım döngüsünde ön eleme yapılması için potansiyel bir araçtır. Ancak kaynak yazarları da gelecek araştırmaların daha fazla deneysel çözünürlük verisi, graph neural networks, transformer tabanlı modeller ve pretrained molecular encoders ile genişletilmesini önermektedir.
Kaynak ve Yöntem Notu
Özgün başlık: Integrating molecular descriptors and fingerprints via meta-learning for aqueous solubility prediction.
Yazarlar ve sıra: Waqar Ahmad, Muhannad Dehni, Rida Arshad, Myunghum Park, Hilal Tayara, Ki-Duk Song.
Katkı işareti: Yüklenen Article in Press PDF, Waqar Ahmad, Muhannad Dehni ve Rida Arshad'ı “+ Contributing author” işaretiyle gösterir. Kaynak açıkça “equal contribution” ifadesi kullanmadığından eş katkı varsayılmamıştır.
Sorumlu yazarlar: Myunghum Park, Hilal Tayara ve Ki-Duk Song.
PDF'deki kurum 1: Department of Agricultural Convergence Technology, Jeonbuk National University, Jeonju, South Korea.
Kurum 2: Research and Development Center, TNT Research, Sejong, South Korea.
Kurum 3: Global Frontier College, Jeonbuk National University, Jeonju, South Korea.
Güncel resmî kayıt farkı: Nature'ın güncel erken erişim sayfası Ki-Duk Song için ayrıca International Agricultural Development and Cooperation Center, Jeonbuk National University afiliyasyonunu göstermektedir. Bu kurum yüklenen Article in Press PDF'nin afiliyasyon listesinde bulunmamaktadır.
Dergi: Scientific Reports.
Platform: Nature Portfolio / nature.com.
Yayın türü: Article; accepted, peer-reviewed early-access / Article in Press sürümü.
Preprint durumu: Preprint değildir. Scientific Reports tarafından kabul edilmiş ve erken erişime açılmış hakemli çalışmadır.
DOI: 10.1038/s41598-026-65722-y.
Alınma tarihi: 26 Mart 2026.
Kabul tarihi: 3 Ağustos 2026.
Güncel resmî yayın tarihi: 19 Ağustos 2026.
Final sürüm durumu: Nature'ın güncel sayfası mevcut sürümün accepted research early-access sürümü olduğunu ve ileride final Version of Record ile otomatik değiştirileceğini belirtmektedir.
Cilt / final makale numarası: Güncel erken erişim kaydında final bibliyografik cilt/makale numarası henüz kesinleştirilmiş biçimde gösterilmediğinden kaynak dışı değer eklenmemiştir.
Lisans: Creative Commons Attribution-NonCommercial-NoDerivatives 4.0 International (CC BY-NC-ND 4.0).
Lisansın görsel sonucu: Kaynak Figure 1-6 doğrudan uyarlanmadı veya kopyalanmadı. Makaledeki inline SVG, Methods metnindeki olgusal işlem sırasından bağımsız olarak oluşturuldu.
Finansman: Basic Science Research Program through the National Research Foundation of Korea, Ministry of Education, grant 2021R1I1A3057071; ayrıca Regional Innovation System and Education (RISE) programı, Jeonbuk RISE Center, Ministry of Education ve Jeonbuk State desteği, 2026-RISE-13-JBU.
Yazar katkıları: W.A., M.D. ve R.A. deneyleri yürütmüştür; M.P., H.T. ve K.D.S. sonuçları analiz etmiştir; bütün yazarlar makaleyi gözden geçirmiştir.
Veri erişilebilirliği: Kullanılan ve/veya analiz edilen veri setlerinin makul talep üzerine corresponding author'dan edinilebileceği belirtilmiştir.
Çıkar çatışması: Yazarlar competing financial interest bulunmadığını beyan etmektedir.
Ana veri kaynağı: AqSolDB version 1.0; ön işleme sonrasında 9.982 benzersiz organik bileşik.
Moleküler temsiller: MACCS, 2D molecular descriptors, Mordred, Mol2Vec ve PubChem.
Model ailesi: 17 regresyon algoritmasının karşılaştırılması, Optuna hiperparametre optimizasyonu ve stacking tabanlı meta-learning.
Açıkça adlandırılmış final taban algoritmaları: CatBoost, ExtraTrees, Histogram Gradient Boosting ve XGBoost.
Kaynak-içi model sayısı tutarsızlığı: Bazı Methods paragrafları “five” top-performing/base regressors ifadesi kullanırken başka bölümler yalnız dört algoritmanın adını verir. Beşinci algoritma ana PDF'de açık değildir.
Kaynak-içi metin belirsizliği: Methods 4.8'de “mordered (order-sensitive)” ifadesi bulunur; bunun neyi kastettiği kaynak tarafından ayrıca düzeltilmemiştir.
Kaynak-içi Figure 2 tutarsızlığı: Klop120 için ≤0.5 hata grubunun pasta grafiği etiketi %72.22 iken şekil açıklamasında %77.22 ve sonuç metninde yaklaşık %77 anlatımı bulunmaktadır.
Rank-correlation sınırı: Klop120 için ρ=0.97 ve Boobier için ρ=0.95 açıktır; kalan ρ=0.80 ifadesinin hangi veri setine ait olduğu kaynak cümlesindeki biçim bozukluğu nedeniyle kesinleştirilmemiştir. Ana metinde Kendall τ için ayrıntılı sayısal tablo verilmemektedir.
Yeniden üretilebilirlik sınırı: Ana PDF exact random seed, Optuna trial sayısı ve ayrıntılı search space, hesaplama donanımı ve stacking meta-learner'ın tam algoritmasını raporlamamaktadır.
Temel bilimsel sınır: Çalışma hesaplamalı bir QSPR/makine öğrenmesi tahmin çalışmasıdır. Model çıktıları deneysel çözünürlük ölçümü değildir ve yeni kimyasal alanlarda performans dış doğrulama gerektirir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir