


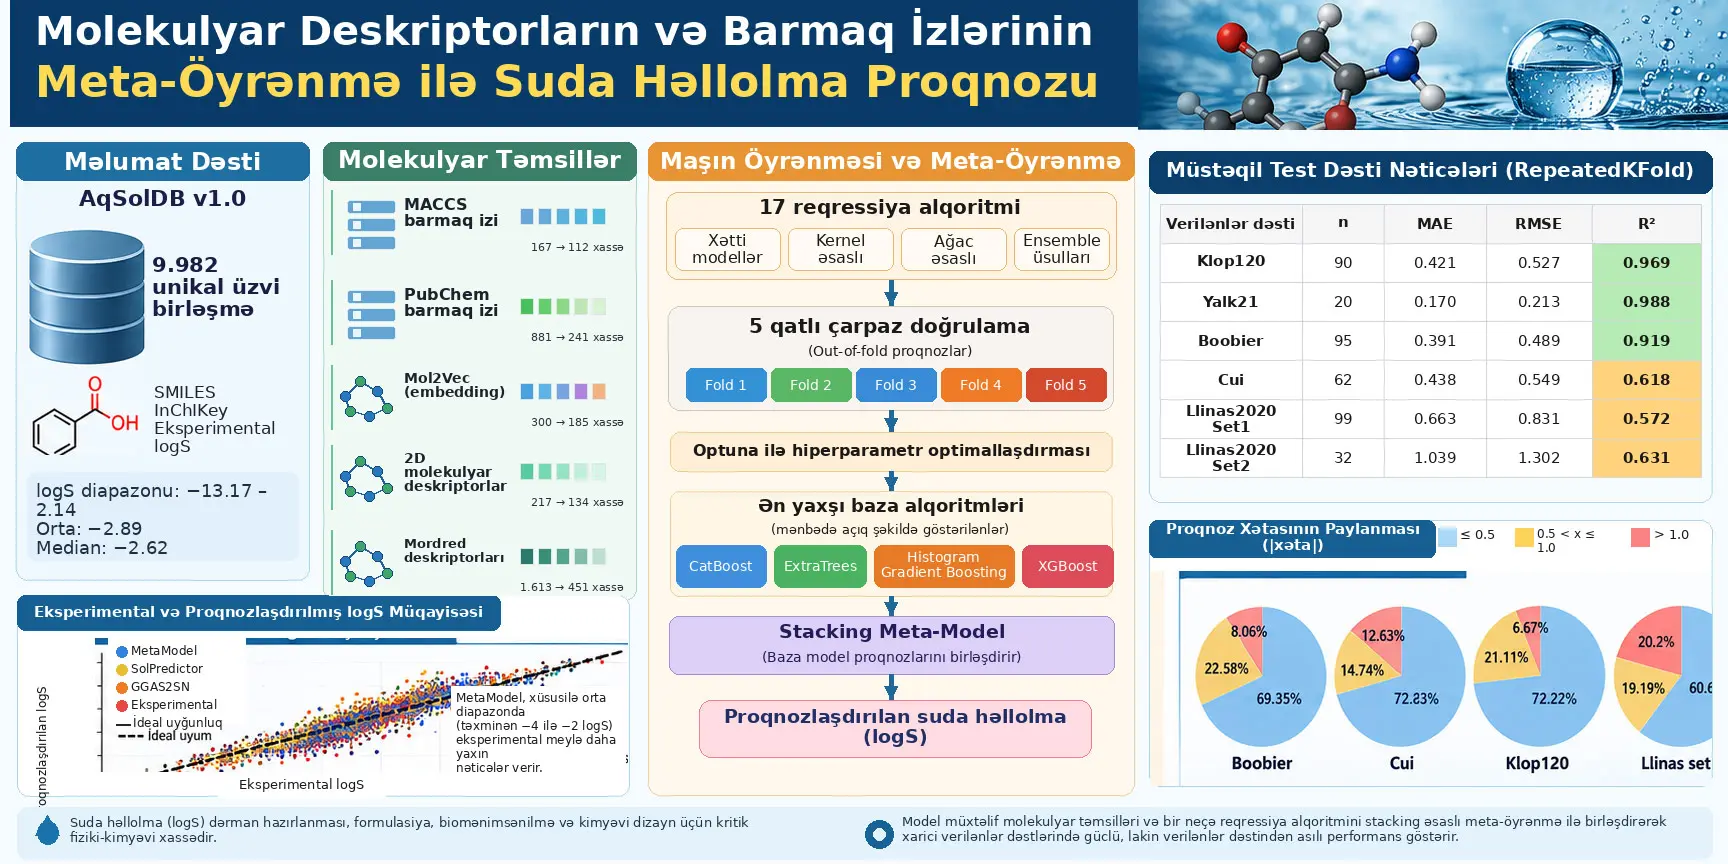
Bu tədqiqatdakı stacking əsaslı meta-model bir molekulu bir neçə ədədi təmsil ilə kodlayan və müxtəlif reqressiya alqoritmlərinin proqnozlarını yuxarı səviyyəli öyrənmə qatında birləşdirərək suda həllolma (logS) proqnozu verən maşın öyrənməsi sistemidir. Tədqiqatçılar AqSolDB v1.0-dan ilkin emaldan sonra qalan 9.982 unikal üzvi birləşmədən istifadə etmiş; MACCS barmaq izləri, PubChem barmaq izləri, Mol2Vec embedding-ləri, ikiölçülü molekulyar deskriptorlar və Mordred deskriptorları kimi tamamlayıcı molekulyar təmsilləri qiymətləndirmişlər. Ümumilikdə 17 reqressiya alqoritmi beşqat çarpaz doğrulama ilə müqayisə edilmiş, hiperparametrlər Optuna ilə optimallaşdırılmış və ən uğurlu konfiqurasiyalar stacking arxitekturasında birləşdirilmişdir.
Modelin performansı yalnız təlimdaxili çarpaz doğrulama ilə qiymətləndirilməmiş; Klop120, Yalk21, Boobier, Cui və iki Llinas2020 toplusu kimi müstəqil xarici test dəstlərində də sınaqdan keçirilmişdir. Table 2-də RepeatedKFold əsaslı MetaModel; Klop120-də R²=0.969 və RMSE=0.527, Yalk21-də R²=0.988 və RMSE=0.213, Boobier-də R²=0.919 və RMSE=0.489 göstəricilərinə çatmışdır. Bununla belə, Cui və xüsusilə Llinas verilənlər dəstlərində performans azalır; məsələn, Llinas2020 Set1 üçün RepeatedKFold R²=0.572, Set2 üçün R²=0.631-dir. Bu, modelin uğurunun kimyəvi paylanmadan və təlim sahəsi ilə xarici test sahəsinin oxşarlığından asılı olduğunu göstərir.
Mənbə həmçinin modelin SolPredictor və GGAS2SN adlı əvvəlki üsullarla müqayisəsini təqdim edir. MetaModel, Table 3-də Boobier, Klop120, Llinas set1, Lovric1 və Yalk21 verilənlər dəstlərində ümumən daha aşağı xəta və/və ya daha yüksək R² göstərir. Lakin hər verilənlər dəstində birinci deyil: Cui və Llinas set2-də GGAS2SN bəzi əsas xəta və R² metriklərində MetaModel-dən daha yaxşı qiymətlər verir. Buna görə tədqiqat “MetaModel bütün kimyəvi fəzalarda bütün rəqibləri üstələyir” nəticəsini dəstəkləmir.
Tədqiqatın güclü tərəflərindən biri verilənlər sızmasını azaltmağa yönəlmiş qiymətləndirmə quruluşudur. İlkin emal verilənlər bölündükdən sonra hər təlim fold-u daxilində müstəqil tətbiq edilmiş, GroupKFold təcrübəsində isə Bemis–Murcko scaffold-larından istifadə edilərək eyni əsas molekulyar skeleti daşıyan birləşmələrin təlim və doğrulama fold-larına səpələnməsinin qarşısı alınmışdır. Bununla belə, əsas PDF exact random seed, Optuna trial sayı və axtarış fəzası, meta-learner-in dəqiq alqoritmi və hesablama avadanlığı kimi təkrar istehsal baxımından faydalı bəzi detalları bildirmir.
Tədqiqatın ən mühüm şərh sərhədi budur: yüksək R² və aşağı RMSE qiymətləri modelin eksperimental həllolma ölçməsini hər kimyəvi sinifdə qüsursuz şəkildə əvəz etdiyi demək deyil. Mənbənin Figure 1-də çox aşağı və ya çox yüksək həllolmaya malik birləşmələrdə proqnozların yastılaşma meyli göstərdiyi, Llinas verilənlər dəstlərində xətaların artdığı və model performansının verilənlərin paylanmasından asılı olduğu aydın görünür. Model erkən mərhələli molekul skrininqi üçün hesablama vasitəsidir; eksperimental həllolma ölçməsinin universal əvəzi deyil.
Tədqiqat problemi niyə vacibdir?
Suda həllolma molekulun su olan mühitdə nə dərəcədə həll ola bildiyini ifadə edən əsas fiziki-kimyəvi xassədir. Dərman hazırlanmasında həllolma; formulasiya edilə bilməni, biomənimsənilməni və farmakokinetik davranışı təsirləndirə bilər. Mənbə eyni problemin aqrokimyəvi maddələrin hazırlanmasında və material tədqiqatlarında da əhəmiyyətli olduğunu bildirir. Eksperimental həllolma ölçmələri dəyərli olsa da, vaxt, resurs və laboratoriya şəraiti tələb edir; həmçinin pH, temperatur və kristal forması kimi eksperimental amillərə həssas ola bilər.
Buna görə tədqiqat problemi yalnız “bir maşın öyrənməsi modeli logS-ni proqnozlaşdıra bilərmi?” sualından ibarət deyil. Əsas sual müxtəlif kimyəvi informasiya növlərini təmsil edən molekulyar deskriptorların, binary fingerprint-lərin və öyrənilmiş embedding-lərin bir neçə reqressiya modeli ilə birləşdirilməsi nəticəsində xarici kimyəvi verilənlər dəstlərinə daha dayanıqlı həllolma proqnozlaşdırma sisteminin qurulub-qurula bilməyəcəyidir.
Suda Həllolmanın Proqnozlaşdırılmasında logS Nə Deməkdir?
Bu məqalədə logS eksperimental suda həllolmanın loqarifmik hədəf dəyişənidir; modelin proqnozlaşdırmağa çalışdığı fasiləsiz ədədi çıxış budur. AqSolDB əsaslı təlim verilənlərində logS qiymətləri −13.17 ilə 2.14 arasında dəyişir və mənbə aşağı qiymətləri çox aşağı həllolmaya, yüksək qiymətləri isə daha yüksək həllolmaya uyğun gələn şkala kimi istifadə edir. Lakin əsas PDF-in Methods bölməsində loqarifmin əsası və logS-nin altında istifadə olunan ilkin həllolma vahidi ayrıca yenidən tərif edilmədiyi üçün Verianla bu detalı mənbədən kənar əlavə etmir.
AqSolDB təlim verilənləri
Tədqiqatda AqSolDB version 1.0 istifadə edilmişdir. Çatışmayan qeydlər çıxarıldıqdan və ilkin emaldan sonra verilənlər dəsti 9.982 unikal üzvi birləşmə ehtiva edir. Hər bir birləşmə SMILES sətri, InChIKey və eksperimental olaraq ölçülmüş loqarifmik suda həllolma qiyməti ilə təmsil olunur.
| Unikal birləşmələrin sayı | 9.982 |
|---|---|
| Kimlik/struktur təmsilləri | SMILES və InChIKey |
| Hədəf dəyişəni | Eksperimental suda həllolma, loqarifmik şkala |
| Minimum logS | −13.17 |
| Maksimum logS | 2.14 |
| Orta logS | −2.89 |
| Median logS | −2.62 |
Mənbə AqSolDB-nin bir neçə ədəbiyyat mənbəyindən eksperimental müşahidələri birləşdirməsinin verilənlərdə təbii səs-küy və dəyişkənlik yaratdığını bildirir. Tədqiqatçılar bunu yalnız mənfi hal hesab etmirlər; real erkən dərman tədqiqatlarında müxtəlif ölçmə mənbələrindən gələn heterogenliyə daha yaxın ssenari yaratdığını müdafiə edirlər. Bununla belə, eyni xüsusiyyət proqnoz xətasının yalnız model arxitekturasından deyil, eksperimental ölçmə fərqlərindən də təsirlənə biləcəyi deməkdir.
Təlim və xarici test paylanmaları niyə eyni deyil?
Mənbənin Figure 3-ü təlim verilənləri ilə müxtəlif xarici test dəstlərinin logS paylanmalarının eyni olmadığını göstərir. Klop120 təlim paylanmasına nisbətən yaxın olduğu halda Cui və Boobier daha dar və daha kompakt paylanmalar göstərir. Llinas1 və Llinas2 isə daha geniş, daha səpələnmiş və aşağı həllolma bölgəsinə doğru sürüşmüş paylanmalar nümayiş etdirir. Tədqiqatçılar Llinas dəstlərindəki bu paylanma sürüşməsini modelin ümumiləşdirməsi baxımından daha çətin problem kimi qiymətləndirirlər.
Mənbənin Figure 4-dəki t-SNE vizuallaşdırması da xarici verilənlər dəstlərindəki bir çox birləşmənin təlim nümunələrinin əhatə etdiyi kimyəvi fəzanın daxilində və ya yaxınlığında yerləşdiyini; xüsusən bəzi Llinas nümunələrinin isə sıx təlim klasterlərinin ətrafında və ya xaricində ola bildiyini göstərir. Bu t-SNE qrafiki modelin proqnoz alqoritminin özü deyil; verilənlər dəstlərinin kimyəvi fəzadakı nisbi mövqelərini vizuallaşdırmaq üçün istifadə edilən izahedici proyeksiyadır.
Molekulyar Deskriptor, Barmaq İzi və Mol2Vec Embedding Arasındakı Fərq Nədir?
Molekulyar deskriptorlar molekulun ölçü, bağlantı, elektron və ya fiziki-kimyəvi xassələrini ədədi qiymətlərlə təmsil edir; kimyəvi fingerprint-lər müəyyən struktur motivlərinin mövcudluğunu əsasən 0/1 bitləri ilə kodlayır; Mol2Vec isə molekulyar altstrukturları Word2Vec-ə bənzər şəkildə fasiləsiz vektor fəzasında təmsil etməyi öyrənən embedding üsuludur. Tədqiqatın əsas ideyası budur ki, bu təmsillər eyni kimyəvi quruluşa müxtəlif baxışlar verdiyinə görə tək bir təmsil əvəzinə bir-birini tamamlaya bilər.
MACCS fingerprint
MACCS key molekulyar quruluşda müəyyən kimyəvi xassələrin və ya altstruktur motivlərinin olub-olmamasını binary bitlərlə ifadə edən fingerprint yanaşmasıdır. Bitin 1 olması müvafiq xassənin mövcud, 0 olması isə mövcud olmadığını göstərir. Mənbə ilkin emaldan əvvəl 167 MACCS xassəsinin olduğunu, təmizləmədən sonra 112 xassənin qaldığını bildirir.
2D molekulyar deskriptorlar
İkiölçülü molekulyar deskriptorlar atomların üçölçülü konformasiyasından birbaşa istifadə etmək əvəzinə molekulun bağlantı cədvəlinə əsaslanır. Ölçü, budaqlanma, bağlantı nümunəsi və elektron paylanması ilə əlaqəli müxtəlif ədədi xassələr yarada bilər. Mənbədə 217 başlanğıc xassəsi ilkin emaldan sonra 134-ə düşmüşdür.
Mordred deskriptorları
Mordred cheminformatics tədqiqatlarında çoxlu sayda molekulyar deskriptor hesablaya bilən descriptor proqramıdır. Mənbə ümumən Mordred-in 1.800-dən çox descriptor hesablaya bildiyini bildirir. Bu tədqiqatın yaratdığı xassə matrisində təmizləmədən əvvəl Mordred xassələrinin sayı 1.613, ilkin emaldan sonra isə 451-dir.
Mol2Vec
Mol2Vec sözlər üçün hazırlanmış Word2Vec məntiqinə bənzər şəkildə molekulyar altstrukturlar üçün sıx vektor təmsillərini öyrənən nəzarətsiz maşın öyrənməsi yanaşmasıdır. Molekulun altstrukturlarından öyrənilən vektorların birləşdirilməsi ilə bütün molekul üçün ədədi embedding yaradılır. Tədqiqatda 300 ölçülü başlanğıc təmsildən ilkin emaldan sonra 185 xassə qalmışdır.
PubChem fingerprint
PubChem fingerprint halqa, atom cütü və digər struktur motivlərinin mövcudluğunu binary altstruktur bitləri ilə ifadə edir. Mənbədə tədqiqatın başlanğıcındakı 881 PubChem xassəsinin təmizləmədən sonra 241 xassəyə düşdüyü göstərilir.
| Təmsil | Başlanğıc xassələrin sayı | İlkin emaldan sonra |
|---|---|---|
| MACCS | 167 | 112 |
| 2D descriptors | 217 | 134 |
| Mordred | 1.613 | 451 |
| Mol2Vec | 300 | 185 |
| PubChem | 881 | 241 |
İlkin emal niyə verilənlər bölündükdən sonra aparıldı?
Maşın öyrənməsində bütün verilənlər üzərində xassə seçimi edib daha sonra təlim-test bölgüsü yaratmaq test verilənlərinin statistik məlumatının dolayı şəkildə təlim prosesinə sızmasına səbəb ola bilər. Mənbə bu riski azaltmaq üçün aşağı variasiya və yüksək korrelyasiya filtrlərini verilənlər bölündükdən sonra və hər təlim fold-u daxilində müstəqil şəkildə tətbiq etmişdir. Təlim fold-unda öyrənilən xassə altçoxluğu daha sonra müvafiq doğrulama/test hissəsinə tətbiq edilmişdir.
VarianceThreshold qiyməti 0.01 olaraq istifadə edilmişdir. Çatışmayan və ya sonsuz qiymət ehtiva edən xassələr çıxarılmış, daha sonra korrelyasiya əmsalı 0.80-dən böyük olan artıq xassələr ələnmişdir. Burada məqsəd həm səs-küyü və təkrarı azaltmaq, həm də xassə seçimində qiymətləndirmə verilənlərinin əvvəlcədən görülməsinin qarşısını almaqdır.
Stacking Əsaslı Meta-Öyrənmə Bu Tədqiqatda Necə İşləyir?
Stacking yanaşmasında tək bir reqressiya modelinin proqnozu yekun cavab kimi götürülmür; müxtəlif baza modellərinin out-of-fold proqnozları yeni “meta-feature”lara çevrilir və yuxarı səviyyəli meta-learner bu proqnozları birləşdirərək yekun logS qiymətini yaradır. Bu tədqiqatda beşqat çarpaz doğrulama sayəsində hər təlim nümunəsi üçün meta-feature həmin nümunəni təlim zamanı görməmiş baza modelindən yaradılmağa çalışılmışdır; beləliklə stacking qatına təlim hədəfini birbaşa əzbərlədən məlumat sızması azaldılmışdır.
Out-of-fold proqnoz məntiqi
Təlim verilənləri beş hissəyə bölünmüşdür. Hər iterasiyada dörd fold baza modelini təlim etmək, qalan fold isə proqnoz yaratmaq üçün istifadə olunur. Beş iterasiyanın sonunda hər təlim nümunəsi özünü təlimdə görməmiş modeldən ən azı bir proqnoz alır. Bu proqnozlar yanaşı yerləşdirilərək stacking meta-modelinin təlim girişi yaradılır.
Daha sonra optimallaşdırılmış baza modelləri bütün təlim verilənləri üzərində yenidən təlim edilir və müstəqil xarici test dəstləri üçün proqnoz yaradır. Bu xarici proqnozlar da eyni qaydada stacking girişinə çevrilir. Meta-learner baza proqnozlarından yekun suda həllolma proqnozunu yaradır.
Müqayisə edilən 17 reqressiya alqoritmi
| Metod ailəsi | Alqoritmlər |
|---|---|
| Xətti / robust / regularized | Bayesian Ridge, Ridge, Lasso, ElasticNet, Huber, Linear Regression |
| Kernel / instance / tək ağac | Support Vector Regression, K-Nearest Neighbors, Decision Tree |
| Ensemble / boosting | Random Forest, Gradient Boosting, Histogram Gradient Boosting, AdaBoost, ExtraTrees, CatBoost, LightGBM, XGBoost |
Optuna burada nə edir?
Optuna alqoritmin kimliyini dəyişən proqnoz modeli deyil, model hiperparametrlərinin uyğun kombinasiyalarını axtaran optimallaşdırma çərçivəsidir. Mənbə seçilmiş güclü modellər üçün hiperparametr optimallaşdırmasının hər molekulyar encoding texnikasına müstəqil tətbiq edildiyini bildirir.
Lakin əsas PDF Optuna-nın neçə sınaq apardığını, hansı hiperparametrlərin hansı aralıqlarda axtarıldığını, hansı sampler/pruner konfiqurasiyasının istifadə edildiyini və ya optimallaşdırmanın random seed qiymətini bildirmir. Buna görə eyni tədqiqatı bit səviyyəsində təkrarlamaq istəyən oxucu əsas PDF-dən bu detalların hamısını əldə edə bilməz.
Baza modellərinin sayı ilə bağlı mənbədaxili qeyri-müəyyənlik
Xülasə, Discussion, Methods 4.5 və Final features selection bölmələri CatBoost, ExtraTrees, Histogram Gradient Boosting və XGBoost olmaqla dörd ad verir. Buna qarşılıq Methods 4.6 “five top-performing machine-learning regression models”, Methods 4.8 isə “five optimized base regressors” ifadəsini işlədir. Əsas PDF beşinci baza alqoritmini açıq şəkildə adlandırmır. Buna görə Verianla “beşinci model budur” kimi mənbədən kənar tamamlama etmir.
Methods 4.8-də həmçinin “mordered (order-sensitive) feature representations” ifadəsi keçir. Kontekst bunun Mordred ilə əlaqəli yazı problemi ola biləcəyini düşündürsə də, mənbə bunu açıq şəkildə düzəltmədiyi üçün burada qəti düzəliş edilməmişdir.
GroupKFold Niyə Daha Sərt Ümumiləşdirmə Testidir?
Bu tədqiqatdakı GroupKFold eyni Bemis–Murcko əsas skeletini daşıyan molekulları eyni fold daxilində saxlayaraq oxşar scaffold-ların həm təlim, həm də doğrulama tərəfində olmasının qarşısını almağa çalışır; beləliklə modelin çox yaxın struktur qohumlarını əzbərləyərək yüksək performans göstərməsi əvəzinə əvvəllər görmədiyi əsas chemotype-lara ümumiləşdirmə qabiliyyəti daha sərt şəkildə sınaqdan keçirilir. Bunun əvəzi olaraq, mənbə nəticələrində də görüldüyü kimi, bəzi metriklər Random Split və ya RepeatedKFold ilə müqayisədə daha aşağı çıxa bilər.
Bemis–Murcko scaffold nədir?
Bemis–Murcko scaffold molekulun əsas halqa və bağlantı skeletini təmsil etmək üçün istifadə olunan struktur xülasəsidir. Tədqiqatçılar RDKit ilə hər bir birləşmənin scaffold-unu hesablamış, scaffold SMILES təmsillərini yaratmış və eyni əsas quruluşa malik molekulları ortaq qrup kimliyi altında birləşdirmişlər.
GroupKFold daha sonra bu qrup etiketlərindən istifadə edərək eyni scaffold-un müxtəlif fold-lara bölünməsinin qarşısını almışdır. Bu dizayn xüsusilə kimyəvi oxşarlığın yüksək olduğu verilənlər dəstlərində təlim-doğrulama sızmasını azaltmağı məqsəd qoyur.
Digər verilənlər bölmə strategiyaları
Random Split nümunələri təsadüfi bölür və mənbədə ən aşağı təlim RMSE-sini vermişdir; lakin struktur baxımından çox oxşar molekulların qarşı tərəflərə düşmə ehtimalı vardır.
RepeatedKFold k-fold əməliyyatını müxtəlif təsadüfi bölgülərlə bir neçə dəfə təkrarlayır. Məqsəd tək bir bölgünün təsadüfi təsirindən asılılığı azaltmaqdır.
ShuffleSplit verilənləri təkrar-təkrar qarışdıraraq müstəqil təlim-test bölgüləri yaradır və müxtəlif seçmə ssenarilərində performans dəyişkənliyini araşdırmağa kömək edir.
Tədqiqatın Metodu və Nəticələri
Beşqat stacking təliminin texniki axını
Təlim verilənləri təxminən bərabər beş fold-a bölünmüşdür. Hər dövrdə dörd fold baza öyrənənini təlim etmiş, qalan fold üzərində proqnoz yaradılmışdır. Beş fold-un proqnozları birləşdirilərək out-of-fold meta-feature matrisi yaradılmışdır. Beləliklə meta-modeli təlim edən proqnozların müvafiq nümunəni təlim zamanı görməmiş baza modelindən gəlməsi hədəflənmişdir.
Meta-feature yaradılması tamamlandıqdan sonra optimallaşdırılmış baza modelləri bütün təlim dəstində yenidən təlim edilmiş və müstəqil xarici test dəstləri üçün proqnoz yaratmışdır. Bu baza proqnozlarının birləşdirilməsi ilə test meta-feature matrisi yaradılmış, yekun logS proqnozları stacking meta-modelindən alınmışdır.
Müxtəlif split strategiyalarında təlim performansı
| Split strategiyası | MAE | MSE | RMSE | R² |
|---|---|---|---|---|
| Random Split | 0.727 | 0.830 | 0.911 | 0.838 |
| RepeatedKFold | 0.745 | 0.871 | 0.933 | 0.842 |
| GroupKFold | 0.796 | 0.973 | 0.985 | 0.782 |
| ShuffleSplit | 0.739 | 0.857 | 0.926 | 0.823 |
Random Split ən aşağı RMSE-ni 0.911 ilə verdiyi halda RepeatedKFold ən yüksək R² qiymətini 0.842 ilə vermişdir. GroupKFold-da R² 0.782-yə düşür və RMSE 0.985-ə yüksəlir. Bu fərq avtomatik olaraq GroupKFold-un “pis üsul” olduğu demək deyil; scaffold səviyyəsindəki oxşarlığı ayrı fold-lara daşımadığı üçün qiymətləndirmə problemi daha çətin olur.
Müstəqil xarici test dəstləri
| Test dəsti | n | Random Split | RepeatedKFold | GroupKFold | ShuffleSplit |
|---|---|---|---|---|---|
| Klop120 | 90 | 0.431 / 0.540 / 0.967 | 0.421 / 0.527 / 0.969 | 0.561 / 0.701 / 0.934 | 0.432 / 0.541 / 0.967 |
| Yalk21 | 20 | 0.192 / 0.240 / 0.985 | 0.170 / 0.213 / 0.988 | 0.295 / 0.363 / 0.937 | 0.211 / 0.265 / 0.982 |
| Boobier | 95 | 0.410 / 0.513 / 0.911 | 0.391 / 0.489 / 0.919 | 0.492 / 0.616 / 0.873 | 0.417 / 0.523 / 0.908 |
| Cui | 62 | 0.417 / 0.522 / 0.654 | 0.438 / 0.549 / 0.618 | 0.586 / 0.730 / 0.519 | 0.421 / 0.528 / 0.647 |
| Llinas2020 Set1 | 99 | 0.668 / 0.837 / 0.564 | 0.663 / 0.831 / 0.572 | 0.719 / 0.899 / 0.563 | 0.686 / 0.859 / 0.541 |
| Llinas2020 Set2 | 32 | 1.106 / 1.387 / 0.581 | 1.039 / 1.302 / 0.631 | 1.145 / 1.423 / 0.588 | 1.118 / 1.401 / 0.572 |
Klop120 verilənlər dəstinin adında “120” olsa da, mənbə Table 2 bu qiymətləndirmədə n=90 kimi bildirir. Verianla cədvəl adından çıxış edərək nümunə sayını 120-yə çevirməmişdir.
RepeatedKFold; Klop120, Yalk21, Boobier və iki Llinas dəstində ən aşağı və ya ən yaxşıya yaxın xətalarla güclü nəticə verir. Cui-də isə Random Split R²=0.654 ilə RepeatedKFold-un 0.618 qiymətindən daha yüksək, RMSE=0.522 ilə isə daha aşağıdır. Buna görə tək bir split strategiyasının bütün test dəstlərində eyni şəkildə üstün olduğu nəticəsinə gəlmək olmaz.
MAE, MSE, RMSE və R² Nəyi İzah Edir?
MAE orta mütləq proqnoz xətasını, MSE xətaların kvadratlarının ortasını, RMSE MSE-nin kvadrat kökünü və bununla xətanı yenidən hədəf dəyişəninin logS şkalasına qaytaran ölçünü, R² isə modelin müşahidə olunan logS dəyişkənliyinin nə qədərini izah etdiyini ölçür. MAE, MSE və RMSE üçün daha kiçik; R² üçün isə ümumən 1-ə daha yaxın qiymət daha yaxşı performansı ifadə edir, lakin tək bir metrik modelin bütün xəta strukturunu izah etmir.
Tənlik 1: Orta Mütləq Xəta — MAE
\(\displaystyle MAE=\frac{1}{n}\sum_{i=1}^{n}|y_i-\hat{y}_i|\)
1. Formula nəyi hesablayır? Hər bir birləşmə üçün real logS ilə model proqnozu arasındakı fərqin mütləq qiymətini götürür və bütün nümunələr üzrə ortasını hesablayır.
2. Dəyişənlər hansılardır? \(n\) ümumi nümunə sayıdır; \(y_i\) i-ci nümunənin eksperimental/müşahidə olunan həllolma qiymətidir; \(\hat{y}_i\) eyni nümunə üçün model proqnozudur.
3. Vahid nədir? MAE hədəf dəyişəni ilə eyni şkalada ifadə olunur. Bu tədqiqatda hədəf logS olduğuna görə MAE də logS hədəf şkalasındadır. PDF logS-nin ilkin vahidini ayrıca tərif etmədiyi üçün daha əlavə fiziki vahid verilmir.
4. Riyazi rolu nədir? Mütləq qiymət müsbət və mənfi proqnoz xətalarının bir-birini kompensasiya etməsinin qarşısını alır. Hər xəta böyüklüyünə xətti çəki verir.
5. Alqoritmik mənası nədir? Modelin tipik nümunədə eksperimental qiymətdən təxminən nə qədər yayınmasını birbaşa oxuna bilən formada ümumiləşdirir.
6. Hansı şərtdə etibarlıdır? Real və proqnoz qiymətləri eyni hədəf şkalasında olmalıdır. Müxtəlif verilənlər dəstlərinin hədəf paylanmaları fərqlidirsə, yalnız MAE-yə baxaraq bütün ümumiləşdirmə keyfiyyətini izah etmək olmaz.
7. Necə şərh olunur? Daha aşağı MAE orta mütləq proqnoz yayınmasının daha kiçik olduğunu göstərir; lakin az sayda çox böyük xətanı MSE qədər güclü cəzalandırmır.
Tənlik 2: Orta Kvadrat Xəta — MSE
\(\displaystyle MSE=\frac{1}{n}\sum_{i=1}^{n}(y_i-\hat{y}_i)^2\)
1. Formula nəyi hesablayır? Hər bir proqnoz xətasının kvadratını götürür və kvadrat xətaların ortasını hesablayır.
2. Dəyişənlər: \(n\), \(y_i\) və \(\hat{y}_i\) MAE tənliyindəki mənalarını qoruyur.
3. Vahid: Hədəf şkalasının kvadratıdır; buna görə MSE, MAE və ya RMSE qədər birbaşa hədəf şkalasında oxunmur.
4. Riyazi rol: Xəta kvadrata yüksəldildiyi üçün böyük yayınmalar kiçik yayınmalardan qeyri-mütənasib şəkildə daha böyük cəza alır.
5. Alqoritmik məna: Çox böyük proqnoz xətalarının arzuolunmaz olduğu problemlərdə modelin böyük yayınmalarına həssas keyfiyyət ölçüsüdür.
6. Şərt: MSE-nin böyüklüyü hədəf dəyişənin şkalasından təsirlənir; müxtəlif şkalalardakı tapşırıqlar birbaşa eyni MSE rəqəmi ilə müqayisə edilməməlidir.
7. Şərh: Daha aşağı MSE daha yaxşıdır, lakin kvadratlaşdırma səbəbindən bir neçə ekstremal xəta qiyməti metriki güclü şəkildə yüksəldə bilər.
Tənlik 3: Kök Orta Kvadrat Xəta — RMSE
\(\displaystyle RMSE=\sqrt{\frac{1}{n}\sum_{i=1}^{n}(y_i-\hat{y}_i)^2}\)
1. Formula nəyi hesablayır? MSE-nin kvadrat kökünü götürür.
2. Dəyişənlər: \(n\), \(y_i\) və \(\hat{y}_i\) əvvəlki tənliklərdəki kimidir.
3. Vahid: Kvadrat kök sayəsində hədəf dəyişənin şkalasına qayıdır; bu tədqiqatda logS hədəf şkalasında şərh olunur.
4. Riyazi rol: Əvvəlcə böyük xətaları kvadrata yüksəldərək vurğulayır, sonra kvadrat köklə nəticəni yenidən hədəf şkalasına gətirir.
5. Alqoritmik məna: Böyük proqnoz xətalarına MAE-dən daha həssas, lakin MSE-dən daha birbaşa oxuna bilən xəta metrikidir.
6. Şərt: Verilənlər dəstinin paylanması və ekstremal qiymətlər RMSE-yə təsir edə bilər; buna görə müxtəlif external set-lərdə RMSE fərqləri kimyəvi paylanma fərqləri ilə birlikdə qiymətləndirilməlidir.
7. Şərh: RMSE-nin azalması ümumən daha yaxşı proqnoz performansını göstərir. Məsələn, Yalk21 RepeatedKFold RMSE=0.213 olduğu halda Llinas2020 Set2-də 1.302-dir; model ikinci verilənlər dəstində nəzərəçarpacaq dərəcədə daha yüksək xəta yaradır.
Tənlik 4: Determinasiya Əmsalı — R²
\(\displaystyle R^2=1-\frac{\sum_{i=1}^{n}(y_i-\hat{y}_i)^2}{\sum_{i=1}^{n}(y_i-\bar{y})^2}\)
1. Formula nəyi hesablayır? Modelin kvadrat proqnoz xətasını müşahidə olunan qiymətlərin öz ortalarından ümumi kvadrat yayınması ilə müqayisə edir.
2. Dəyişənlər: \(y_i\) real qiymət, \(\hat{y}_i\) proqnoz, \(\bar{y}\) müşahidə olunan hədəf qiymətlərinin ortası və \(n\) nümunə sayıdır.
3. Vahid: İki kvadrat cəminin nisbəti olduğuna görə R² ölçüsüzdür.
4. Riyazi rol: Surətdəki residual sum of squares kiçildikcə nisbət kiçilir və R² 1-ə yaxınlaşır.
5. Alqoritmik məna: Model proqnozlarının müşahidə olunan logS dəyişkənliyini nə dərəcədə izah etdiyinin xülasəsidir.
6. Şərt: R² verilənlər dəstinin hədəf paylanmasından təsirlənə bilər. Dar hədəf aralığı və ya distribution shift şəraitində eyni RMSE fərqli R² davranışı göstərə bilər.
7. Şərh: R²=1 mükəmməl uyğunluğa uyğundur. R²-nin sıfıra yaxınlaşması izahedici gücün zəifləməsini, sıfırdan aşağı düşməsi isə modelin orta qiymətlə proqnoz verməkdən belə daha pis davrana bildiyini göstərə bilər. Bu tədqiqat xarici testlərdə verilənlər dəstindən asılı olaraq xeyli fərqli R² qiymətləri bildirir.
MetaModel, SolPredictor və GGAS2SN müqayisəsi
| Verilənlər dəsti | MetaModel | SolPredictor | GGAS2SN |
|---|---|---|---|
| Boobier | 0.428 / 0.597 / 0.880 | 0.821 / 1.103 / 0.591 | 0.539 / 0.696 / 0.837 |
| Cui | 0.444 / 0.567 / 0.592 | 0.722 / 0.862 / 0.057 | 0.428 / 0.519 / 0.608 |
| Klop120 | 0.424 / 0.603 / 0.959 | 0.965 / 1.208 / 0.837 | 0.499 / 0.680 / 0.948 |
| Llinas set1 | 0.619 / 0.882 / 0.517 | 1.000 / 1.250 / 0.474 | 0.719 / 0.940 / 0.451 |
| Llinas set2 | 1.027 / 1.372 / 0.590 | 1.458 / 1.762 / 0.323 | 0.990 / 1.242 / 0.633 |
| Lovric1 | 0.511 / 0.780 / 0.807 | 0.625 / 0.783 / 0.803 | 0.655 / 0.794 / 0.775 |
| Yalk21 | 0.332 / 0.387 / 0.961 | 1.075 / 1.204 / 0.618 | 0.447 / 0.588 / 0.909 |
Bu cədvəl mühüm bir nüansı ortaya çıxarır: MetaModel bir çox verilənlər dəstində güclüdür, lakin bütün verilənlər dəstlərində ən yaxşı deyil. Cui-də GGAS2SN həm daha aşağı MAE/RMSE, həm də daha yüksək R² verir. Llinas set2-də də GGAS2SN-nin MAE, RMSE və R² qiymətləri MetaModel-dən daha yaxşıdır. Buna görə müəlliflərin ümumi “robust” şərhinə baxmayaraq, mənbə cədvəlinin ədədi məzmunu üsul üstünlüyünün verilənlər dəstindən asılı olduğunu göstərir.
Table 2 və Table 3 niyə eyni rəqəmləri vermir?
Table 2 eyni stacking MetaModel-i müxtəlif split strategiyaları altında müqayisə etdiyi halda Table 3 MetaModel-i SolPredictor və GGAS2SN ilə müqayisə edir. Ortaq verilənlər dəstlərində rəqəmlər bir-biri ilə tam eyni deyil; məsələn, Boobier üçün Table 2-də RepeatedKFold R²=0.919, Table 3-də isə MetaModel R²=0.880-dir. Əsas PDF bu cədvəllər arasındakı performans fərqinin dəqiq qiymətləndirmə konfiqurasiyasını ətraflı şəkildə uzlaşdırmır. Buna görə Verianla iki cədvəli tək performans cədvəli kimi birləşdirməmişdir.
Statistik model müqayisələri
Tədqiqatçılar nümunə üzrə mütləq proqnoz xətaları üzərində Wilcoxon signed-rank testləri və paired t-test-lər istifadə etmişlər. Boobier və Cui verilənlər dəstlərində MetaModel-in SolPredictor-a qarşı üstünlüyü P<0.001 kimi bildirilmişdir. Boobier-də MetaModel ilə GGAS2SN arasındakı fərq P<0.05 səviyyəsində əhəmiyyətlidir. Cui-də isə MetaModel ilə GGAS2SN arasında P>0.05 olub statistik baxımdan əhəmiyyətli fərq bildirilməmişdir.
Bu statistik nəticələr Table 3-də Cui üzərində GGAS2SN-nin ədədi olaraq bir qədər daha yaxşı metriklər verməsi ilə birlikdə oxunmalıdır: kiçik metrik fərqi statistik baxımdan əhəmiyyətli olmaya bilər. Ədədi üstünlük ilə statistik olaraq göstərilmiş üstünlük eyni anlayış deyil.
Spearman və Kendall korrelyasiyaları
Mənbə geniş logS dinamik diapazonunda yalnız R²-yə əsaslanmamaq üçün Spearman rank correlation coefficient (ρ) və Kendall's Tau (τ) qiymətləndirdiyini də bildirir. Klop120 üçün Spearman ρ=0.97 və Boobier üçün ρ=0.95 açıq şəkildə yazılmışdır.
Bununla belə, mənbə cümləsinin Yalk21 və sonrakı ρ=0.80 hissəsində qrammatik/formal pozuntu vardır: “Yalk21 (ρ) ... (ρ = 0.80)” quruluşu 0.80 qiymətinin hansı verilənlər dəstinə dəqiq aid olduğunu açıq saxlamır. Əsas mətndə Kendall τ qiymətlərinin ədədi cədvəli də göstərilmir. Buna görə Verianla ρ=0.80 və ya τ üçün mənbədə açıq şəkildə olmayan verilənlər dəsti uyğunlaşdırması etmir.
Predicted vs experimental logS qrafikləri nə göstərir?
Mənbənin Figure 1-i Boobier, Cui, Llinas set1 və Klop120 verilənlər dəstlərində eksperimental logS meyli ilə MetaModel, SolPredictor və GGAS2SN proqnozlarının əlaqəsini müqayisə edir. Müəlliflərin şərhinə görə MetaModel xüsusilə təxminən −4 ilə −2 logS arasındakı orta bölgədə eksperimental meylə yaxın gedir.
Çox yüksək və ya çox aşağı həllolma uclarında isə proqnoz əyrilərinin yastılaşma meyli göstərdiyi bildirilir. Bu, modelin ekstremal həllolma dəyişikliklərinə orta diapazon qədər həssas olmaya biləcəyini düşündürür. Figure 1-in xam binned koordinatları cədvəl şəklində verilmədiyi üçün Verianla qrafiki yenidən çəkib yeni ədədi nöqtələr yaratmır.
Figure 2 xəta paylanması və mənbədaxili rəqəm ziddiyyəti
Figure 2 mütləq proqnoz xətalarını üç aralıqda təsnif edir: ≤0.5, 0.5<x≤1.0 və >1.0. Vizual üzərindəki etiketlərdə Boobier üçün paylanma təxminən %69.35 / %22.58 / %8.06; Cui üçün %72.63 / %14.74 / %12.63; Klop120 üçün %72.22 / %21.11 / %6.67; Llinas set1 üçün %60.61 / %19.19 / %20.2 kimi görünür.
Lakin eyni şəklin izahı Klop120 üçün ≤0.5 xəta nisbətini %77.22 kimi, əvvəlki nəticə paraqrafı isə təxminən %77 kimi yazır. Vizual etiketi isə %72.22-dir. Bu mənbədaxili uyğunsuzluq həll edilmiş verilən kimi təqdim edilə bilməz. Etibarlı şəkildə deyilə bilən məqam Klop120-də aşağı xəta qrupunun üstün, Llinas set1-də isə >1.0 xəta qrupunun daha yüksək olmasıdır.
Funksional qrup paylanması nəyi izah edir?
Mənbənin Figure 5-i hydroxyl, ether, carbonyl, halogen və aromatic strukturlar arasındakı üst-üstə düşmələri göstərərək təlim verilənlər dəstinin kimyəvi müxtəlifliyini izah etməyə çalışır. Aromatik strukturların çox sayda olması hidrofob halqa sistemlərinin verilənlər dəstində geniş yayıldığını; hydroxyl və carbonyl kimi polar funksional qrupların aromatic sistemlərlə eyni molekullarda birlikdə ola bilməsi isə bir çox birləşmənin həm hidrofob, həm də hidrofil xarakter daşıdığını göstərir.
Müəlliflər hydroxyl və carbonyl qruplarının su ilə hydrogen bonding və ya dipole–dipole qarşılıqlı təsirləri vasitəsilə həllolmanı dəstəkləyə biləcəyini, halogenlərin isə lipofilliyi artıraraq həllolmanı azalda biləcəyini müzakirə edirlər. Bu izahlar verilənlər dəstinin tərkibini kimyəvi baxımdan şərh edən ümumi mexanistik çərçivədir; Figure 5 təkbaşına müəyyən funksional qrupun bu verilənlər dəstində həllolmaya səbəbli töhfəsinin böyüklüyünü ölçmür.
Yüksək R² Modelin Hər Kimyəvi Fəzada Etibarlı Olduğu Deməkdirmi?
Xeyr. Bu tədqiqatda Yalk21 və Klop120 kimi bəzi xarici dəstlərdə R² təxminən 0.97-0.99-a çatdığı halda Llinas və Cui kimi paylanması və ya kimyəvi sahəsi daha çətin olan dəstlərdə R² nəzərəçarpacaq dərəcədə azalır; buna görə yüksək R² müəyyən qiymətləndirmə verilənlər dəstində güclü uyğunluğu göstərir, naməlum bütün chemotype-larda eyni dəqiqliyin təmin edildiyini göstərmir. GroupKFold nəticələrinin daha aşağı olması və Llinas dəstlərindəki yüksək xətalar da struktur paylanma dəyişməsinin ümumiləşdirməni çətinləşdirdiyini dəstəkləyir.
Tədqiqatın güclü tərəfləri
Birinci güclü tərəf molekulu tək bir encoding-ə məcbur etmək əvəzinə binary fingerprints, klassik descriptor-lar və öyrənilmiş Mol2Vec embedding-lərini birlikdə qiymətləndirməsidir. Bu yanaşma müxtəlif təmsil növlərinin bir-birini tamamlaya bilməsini təmin edir.
İkinci güclü tərəf 17 müxtəlif reqressiya alqoritminin ortaq qiymətləndirmə quruluşunda müqayisə edilməsi və güclü modellərin Optuna ilə ayrıca optimallaşdırılmasıdır.
Üçüncü güclü tərəf stacking üçün out-of-fold meta-feature yaradılmasından istifadə edilməsidir. Bu dizayn meta-modelin öz təlim nümunələrini görmüş baza proqnozlarından birbaşa qidalanması riskini azaltmağı məqsəd qoyur.
Dördüncü güclü tərəf yalnız tək random split-ə güvənilməməsi; Random Split, RepeatedKFold, GroupKFold və ShuffleSplit nəticələrinin birlikdə araşdırılmasıdır.
Beşinci güclü tərəf modelin AqSolDB təlim sahəsindən kənardakı müstəqil test kolleksiyalarında qiymətləndirilməsi və SolPredictor ilə GGAS2SN kimi əvvəlki modellərlə müqayisə edilməsidir.
Əsas məhdudiyyətlər
Birinci məhdudiyyət verilənlərin keyfiyyətidir. AqSolDB bir çox ədəbiyyat mənbəsindəki eksperimental həllolma ölçmələrini birləşdirdiyi üçün müxtəlif laboratoriya şəraitindən qaynaqlanan səs-küy və heterogenlik ehtiva edə bilər.
İkinci məhdudiyyət descriptor əsaslı təmsilin mürəkkəb üçölçülü və ya uzaqməsafəli struktur qarşılıqlı təsirlərini tam təmsil edə bilməməsidir. Mənbə müəllifləri gələcək tədqiqatlar üçün graph neural networks, transformer əsaslı molekulyar embedding-lər və pretrained molecular encoders təklif edirlər.
Üçüncü məhdudiyyət kimyəvi domain shift-dir. Llinas verilənlər dəstlərində paylanma təlim sahəsindən daha çox yayınır və proqnoz xətaları yüksəlir.
Dördüncü məhdudiyyət modelin ekstremal həllolma bölgələrində proqnozlarının yastılaşa bilməsidir; mənbə bu vəziyyəti çox yüksək və ya çox aşağı logS qiymətlərində dəyişikliklərə daha aşağı həssaslıq kimi müzakirə edir.
Beşinci məhdudiyyət əsas PDF-in bəzi təkrar istehsal detallarını verməməsidir. Random seed, istifadə olunan hesablama avadanlığı, Optuna sınaqlarının sayı və tam hiperparametr axtarış fəzaları, stacking meta-learner-in dəqiq alqoritmi və bütün final model hiperparametrləri əsas mətndə yoxdur.
Altıncı məhdudiyyət baza modellərinin sayındakı mənbədaxili uyğunsuzluqdur: məqalənin bəzi bölmələri dörd ad verir, bəzi Methods paraqrafları isə beş baza reqressorundan bəhs edir.
Yeddinci məhdudiyyət Figure 2-də Klop120 aşağı xəta faizinin qrafik etiketi ilə izah/mətn arasında uyğun gəlməməsidir.
Tədqiqatın dəstəklədiyi şərhlər
- Bir neçə molekulyar təmsilin və ensemble reqressiya modellərinin stacking quruluşunda birləşdirilməsi suda həllolmanın proqnozlaşdırılmasında güclü performans təmin edə bilər.
- Model bəzi müstəqil xarici verilənlər dəstlərində yüksək R² və aşağı proqnoz xətası göstərmişdir.
- RepeatedKFold bir çox xarici verilənlər dəstində güclü və sabit nəticələr yaratmışdır.
- Scaffold əsaslı GroupKFold daha sərt struktur ümumiləşdirmə qiymətləndirilməsi təqdim edir.
- MetaModel SolPredictor-a qarşı Boobier və Cui-də statistik baxımdan əhəmiyyətli dərəcədə daha aşağı xəta göstərmişdir.
- Modelin uğuru xarici verilənlər dəstinin kimyəvi paylanmasından asılıdır.
- Molekulyar encoding seçimi və verilənlərin bölünmə strategiyası performans qiymətləndirilməsinin mühüm hissələridir.
Tədqiqatın dəstəkləmədiyi şərhlər
- MetaModel-in bütün molekullarda və bütün verilənlər dəstlərində ən yaxşı model olduğu göstərilməmişdir.
- Model eksperimental həllolma ölçməsini qüsursuz əvəz etdiyini sübut etmir.
- Yüksək R² bütün kimyəvi fəzalarda eyni ümumiləşdirmə performansını təmin etmir.
- Descriptor və ya fingerprint-lərdə olan müəyyən xassənin həllolmaya səbəbli təsiri bu model müqayisəsindən təkbaşına çıxarıla bilməz.
- t-SNE qrafikindəki yaxınlıq birbaşa model dəqiqliyi və ya kimyəvi səbəblilik ölçüsü deyil.
- Table 2-dəki ən yaxşı split nəticəsi ilə Table 3-dəki metod müqayisəsi nəticəsi eyni performans təcrübəsi kimi birləşdirilə bilməz.
- Mənbədə açıqlanmayan beşinci baza model, meta-learner alqoritmi və ya Optuna hiperparametrləri təxmin edilərək doldurula bilməz.
Tətbiqi mənası
Bu framework böyük molekul kitabxanalarındakı namizədlərin eksperimental testə girməzdən əvvəl hesablama yolu ilə sıralanması, erkən dərman kəşfində aşağı həllolmalı namizəd riskinin proqnozlaşdırılması və molekulyar dizayn dövründə ilkin seçim aparılması üçün potensial vasitədir. Lakin mənbə müəllifləri də gələcək tədqiqatların daha çox eksperimental həllolma veriləni, graph neural networks, transformer əsaslı modellər və pretrained molecular encoders ilə genişləndirilməsini təklif edirlər.
Mənbə və Metod Qeydi
Özgün başlıq: Integrating molecular descriptors and fingerprints via meta-learning for aqueous solubility prediction.
Müəlliflər və sıra: Waqar Ahmad, Muhannad Dehni, Rida Arshad, Myunghum Park, Hilal Tayara, Ki-Duk Song.
Töhfə işarəsi: Yüklənmiş Article in Press PDF Waqar Ahmad, Muhannad Dehni və Rida Arshad-ı “+ Contributing author” işarəsi ilə göstərir. Mənbə açıq şəkildə “equal contribution” ifadəsini işlətmədiyi üçün bərabər töhfə fərz edilməmişdir.
Məsul müəlliflər: Myunghum Park, Hilal Tayara və Ki-Duk Song.
PDF-dəki qurum 1: Department of Agricultural Convergence Technology, Jeonbuk National University, Jeonju, South Korea.
Qurum 2: Research and Development Center, TNT Research, Sejong, South Korea.
Qurum 3: Global Frontier College, Jeonbuk National University, Jeonju, South Korea.
Cari rəsmi qeyd fərqi: Nature-ın cari erkən giriş səhifəsi Ki-Duk Song üçün əlavə olaraq International Agricultural Development and Cooperation Center, Jeonbuk National University afiliyasiyasını göstərir. Bu qurum yüklənmiş Article in Press PDF-in afiliyasiya siyahısında yoxdur.
Jurnal: Scientific Reports.
Platforma: Nature Portfolio / nature.com.
Nəşr növü: Article; accepted, peer-reviewed early-access / Article in Press versiyası.
Preprint statusu: Preprint deyil. Scientific Reports tərəfindən qəbul edilmiş və erkən girişə açılmış resenziyalı tədqiqatdır.
DOI: 10.1038/s41598-026-65722-y.
Qəbul üçün təqdim edilmə tarixi: 26 mart 2026.
Qəbul tarixi: 3 avqust 2026.
Cari rəsmi nəşr tarixi: 19 avqust 2026.
Final versiyanın statusu: Nature-ın cari səhifəsi mövcud versiyanın accepted research early-access versiyası olduğunu və gələcəkdə final Version of Record ilə avtomatik dəyişdiriləcəyini bildirir.
Cild / final məqalə nömrəsi: Cari erkən giriş qeydində final biblioqrafik cild/məqalə nömrəsi hələ dəqiq şəkildə göstərilmədiyinə görə mənbədən kənar qiymət əlavə edilməmişdir.
Lisenziya: Creative Commons Attribution-NonCommercial-NoDerivatives 4.0 International (CC BY-NC-ND 4.0).
Lisenziyanın vizual nəticəsi: Mənbə Figure 1-6 birbaşa uyğunlaşdırılmayıb və ya kopyalanmayıb. Məqalədəki inline SVG Methods mətnindəki faktiki proses ardıcıllığından müstəqil şəkildə yaradılmışdır.
Maliyyələşdirmə: Basic Science Research Program through the National Research Foundation of Korea, Ministry of Education, grant 2021R1I1A3057071; əlavə olaraq Regional Innovation System and Education (RISE) proqramı, Jeonbuk RISE Center, Ministry of Education və Jeonbuk State dəstəyi, 2026-RISE-13-JBU.
Müəllif töhfələri: W.A., M.D. və R.A. təcrübələri aparmışdır; M.P., H.T. və K.D.S. nəticələri təhlil etmişdir; bütün müəlliflər məqaləni nəzərdən keçirmişdir.
Verilənlərin əlçatanlığı: İstifadə edilən və/və ya təhlil olunan verilənlər dəstlərinin əsaslandırılmış tələb əsasında corresponding author-dan əldə edilə biləcəyi bildirilmişdir.
Maraqlar toqquşması: Müəlliflər competing financial interest olmadığını bəyan edirlər.
Əsas verilənlər mənbəyi: AqSolDB version 1.0; ilkin emaldan sonra 9.982 unikal üzvi birləşmə.
Molekulyar təmsillər: MACCS, 2D molecular descriptors, Mordred, Mol2Vec və PubChem.
Model ailəsi: 17 reqressiya alqoritminin müqayisəsi, Optuna hiperparametr optimallaşdırması və stacking əsaslı meta-learning.
Açıq şəkildə adlandırılmış final baza alqoritmləri: CatBoost, ExtraTrees, Histogram Gradient Boosting və XGBoost.
Mənbədaxili model sayı uyğunsuzluğu: Bəzi Methods paraqrafları “five” top-performing/base regressors ifadəsini işlətdiyi halda digər bölmələr yalnız dörd alqoritmin adını verir. Beşinci alqoritm əsas PDF-də açıq deyil.
Mənbədaxili mətn qeyri-müəyyənliyi: Methods 4.8-də “mordered (order-sensitive)” ifadəsi var; bunun nəyi nəzərdə tutduğu mənbə tərəfindən ayrıca düzəldilməmişdir.
Mənbədaxili Figure 2 uyğunsuzluğu: Klop120 üçün ≤0.5 xəta qrupunun dairəvi qrafik etiketi %72.22 olduğu halda şəkil izahında %77.22 və nəticə mətnində təxminən %77 ifadəsi yer alır.
Rank-correlation sərhədi: Klop120 üçün ρ=0.97 və Boobier üçün ρ=0.95 aydındır; qalan ρ=0.80 ifadəsinin hansı verilənlər dəstinə aid olduğu mənbə cümləsindəki forma pozuntusuna görə dəqiqləşdirilməmişdir. Əsas mətndə Kendall τ üçün ətraflı ədədi cədvəl verilmir.
Təkrar istehsal sərhədi: Əsas PDF exact random seed, Optuna trial sayı və ətraflı search space, hesablama avadanlığı və stacking meta-learner-in tam alqoritmini bildirmir.
Əsas elmi sərhəd: Tədqiqat hesablama QSPR/maşın öyrənməsi proqnozlaşdırma işidir. Model çıxışları eksperimental həllolma ölçməsi deyil və yeni kimyəvi sahələrdə performans xarici doğrulama tələb edir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib