


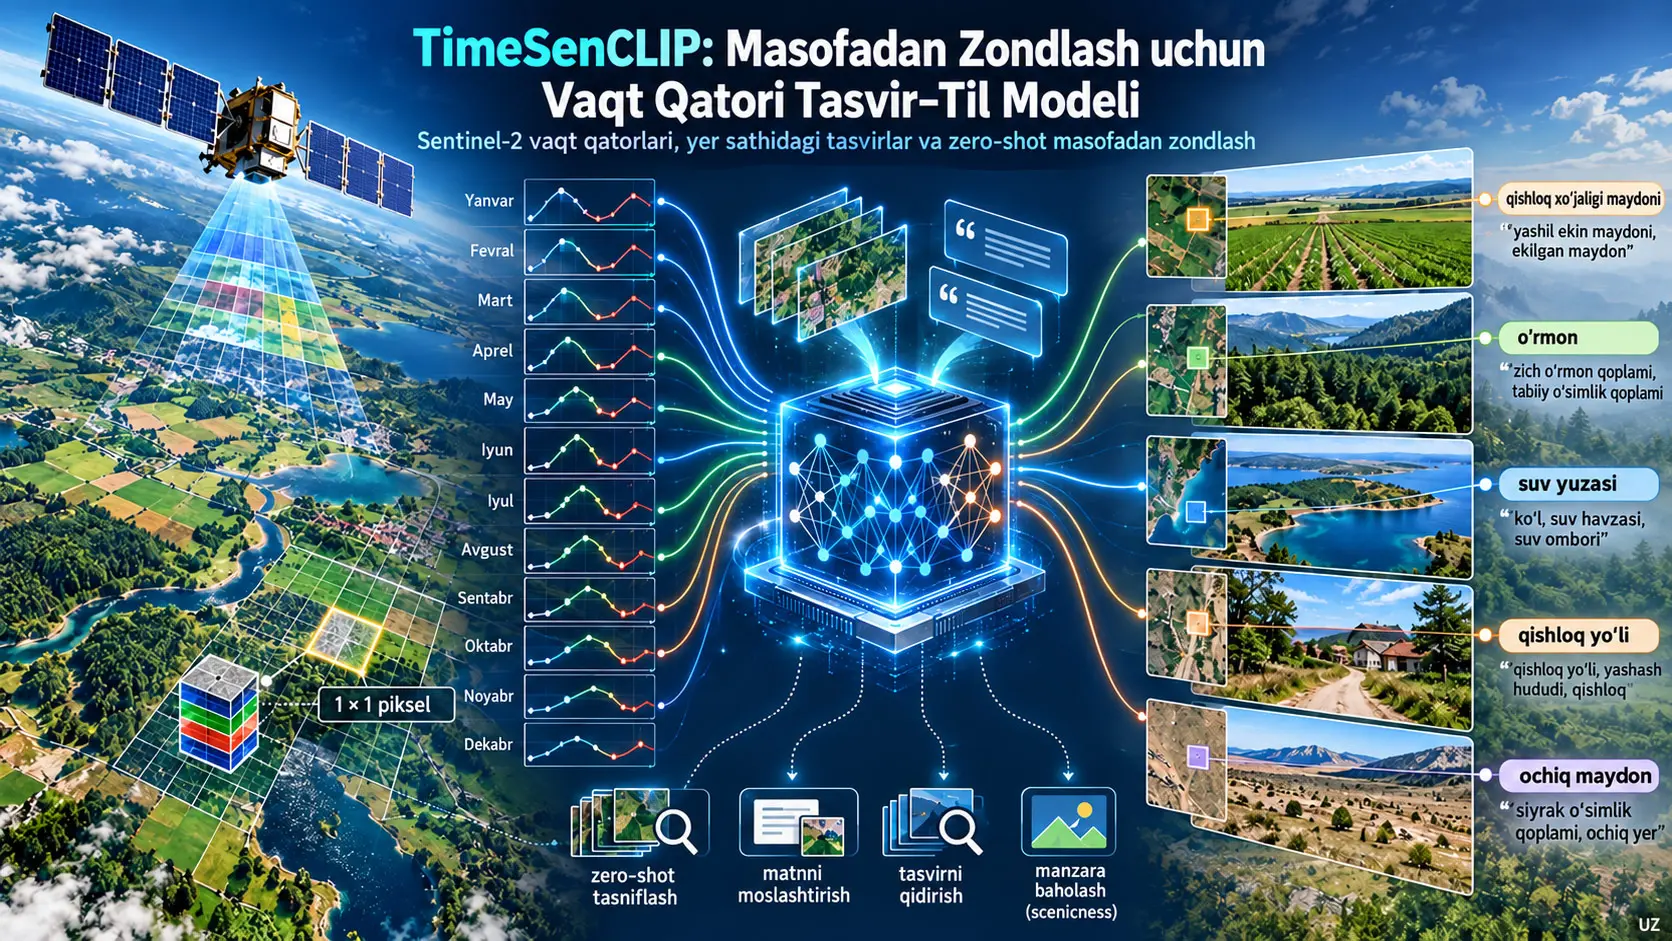
TimeSenCLIP — ko‘p spektrli Sentinel-2 sun’iy yo‘ldosh vaqt qatorlarini geografik belgilangan yer sathidagi fotosuratlarning semantik CLIP tasvirlari bilan cross-view contrastive learning yordamida moslashtiradigan yengil tasvir–til modelidir. Modelning ajralib turuvchi jihati shundaki, u sun’iy yo‘ldosh tomonida katta tasvir patch-lariga yoki o‘qitish vaqtida matn caption-lariga ehtiyoj sezmasdan, faqat bitta Sentinel-2 pikselining spektral–vaqt bo‘yicha o‘zgarishidan semantik tasvirni o‘rganishi mumkin.
TimeSenCLIP LUCAS 2018 yer sathidagi tasvirlari va Sen4Map Sentinel-2 vaqt qatorlari yordamida o‘qitilgan; yer qoplami, yerdan foydalanish, habitat, ekin turi va biogeografik hudud bo‘yicha zero-shot tasniflash, cross-modal retrieval hamda scenicness baholash vazifalarida sinovdan o‘tkazilgan. Asosiy 12-oylik, bitta-pikselli, multispektral TimeSenCLIP-P1 modeli descriptive promptlar bilan umumiy zero-shot Top-1 aniqligida %47,35 ± 0,18 natijaga erishgan. Xuddi shu modelning oylik vaqt qatori bilan umumiy cross-modal Recall@1 ko‘rsatkichi Ground-to-Satellite yo‘nalishida 0,446, Satellite-to-Ground yo‘nalishida 0,535 ni tashkil etadi.
Tadqiqotning asosiy xulosasi shuki, Sentinel-2 kabi o‘rta aniqlikdagi masofadan zondlash ma’lumotlarida vaqt va spektral dinamikalar ko‘plab vazifalar uchun keng fazoviy kontekstning muhim qismini kompensatsiya qila oladi. Biroq bu natija barcha vazifalarda “bitta piksel har doim yetarli” degani emas: habitat tasnifi va scenicness kabi fazoviy tuzilma, tekstura va landshaft geometriyasi muhim bo‘lgan muammolarda kattaroq patch-lar ustunlik berishi mumkin. Bundan tashqari, model faqat Sentinel-2 va Yevropa markazidagi LUCAS ma’lumotlari bilan baholangan; boshqa sensorlar, iqlimlar va geografik hududlarda xuddi shunday muvaffaqiyat hali ko‘rsatilmagan.
Tadqiqot muammosi
Masofadan zondlash uchun ishlab chiqilgan ko‘plab vision–language model (VLM) tabiiy tasvirlar uchun yaratilgan CLIP-ga o‘xshash arxitekturalarni sun’iy yo‘ldosh tasvirlariga moslashtiradi. Bu yondashuv uchta asosiy muammoni yuzaga keltiradi. Birinchidan, o‘qitish ko‘pincha sun’iy yo‘ldosh tasviri–matn caption juftlariga ehtiyoj sezadi; bunday tavsiflar ham qimmat, ham foydalanilgan lug‘at bilan cheklanishi mumkin. Ikkinchidan, modellar odatda yuzlab piksel kenglikdagi katta fazoviy patch-larga tayanadi. Sentinel-2 kabi o‘rta aniqlikdagi sensorlarda katta patch heterogen qishloq xo‘jaligi yoki ekotizim mozaikasidagi bir-biridan farqli hududlarni bitta kirishga aralashtirib yuborishi mumkin. Uchinchidan, klassik RGB asosidagi yondashuv mavsumiylik, fenologiya va turli to‘lqin uzunliklaridagi aks ettirish xususiyatlaridan yetarlicha foydalanmaydi.
TimeSenCLIP muammoni teskari tomondan qo‘yadi: Bitta Sentinel-2 pikselining yil davomida o‘zgaradigan ko‘p spektrli vaqt qatori katta fazoviy tasvir patch-isiz yer va ekotizim semantikasini o‘rganish uchun yetarli axborot bera oladimi?
Tadqiqot yondashuvi ayniqsa qishloq xo‘jaligi va ekologik sinflar nuqtai nazaridan mazmunlidir. Masalan, bug‘doy, makkajo‘xori yoki turli vegetatsiya tizimlari faqat bir sanadagi tasvirlari bilan bir-biriga o‘xshashi mumkin; ammo ekish, o‘sish, pishish va hosil yig‘ish davomida yuz beradigan aks ettirish o‘zgarishlari turli vaqt imzolarini hosil qiladi.
TimeSenCLIP Bitta Sentinel-2 Pikselidan Semantik Axborotni Qanday O‘rganadi?
TimeSenCLIP bir xil geografik joylashuvga tegishli Sentinel-2 spektral–vaqt ketma-ketligi va yer sathidagi fotosuratlarni umumiy embedding makonida bir-biriga yaqinlashtirish orqali o‘rganadi; yer fotosuratlarining muzlatilgan CLIP tasvir encoder-idan keladigan semantik axborot sun’iy yo‘ldosh vaqt qatoriga uzatiladi va o‘qitish tugagach faqat sun’iy yo‘ldosh encoder-i hamda CLIP text encoder yordamida yangi matn sinflari bo‘yicha zero-shot bashorat qilish mumkin.
O‘qitishda ikki ko‘rinish mavjud
Yer sathi ko‘rinishi: LUCAS nuqtalarida to‘rtta asosiy yo‘nalishda olingan geografik belgilangan fotosuratlar muzlatilgan CLIP ViT-B/32 tasvir encoder-idan o‘tkaziladi. CLIP tabiiy tasvirlar va til o‘rtasida oldindan o‘rganilgan semantik makonga ega bo‘lgani uchun bu fotosuratlar TimeSenCLIP uchun matn bilan moslashtirilgan semantik maqsad vazifasini bajaradi.
Sun’iy yo‘ldosh ko‘rinishi: Xuddi shu joylashuvning Sentinel-2 vaqt qatori alohida Transformer encoder tomonidan qayta ishlanadi. Sun’iy yo‘ldosh encoder-i noldan o‘qitiladi va yer tasviri embedding-iga yaqinlashishni o‘rganadi.
Manba ichidagi nomlash izohi: usulning umumiy xulosasida bir nechta yer tasviri “attention pooling” bilan birlashtirilishi aytiladi. Batafsil arxitektura tavsifida va Appendix A.4.3 da esa “average pooling” ishlatiladi. Manba bu ikki ifodani alohida muvofiqlashtirmagani uchun bu yerda ular jimlik bilan bitta ifodaga almashtirilmagan.
Tenglama (1): CLIP embedding-larini L2 normallashtirish
\[ \mathbf{v}_i= \frac{f_{\mathrm{img}}(I_i)} {\left\|f_{\mathrm{img}}(I_i)\right\|_2}, \qquad \mathbf{t}_i= \frac{f_{\mathrm{text}}(T_i)} {\left\|f_{\mathrm{text}}(T_i)\right\|_2}. \tag{1} \]
Formula nimani hisoblaydi? Tasvir encoder-i va text encoder ishlab chiqargan embedding vektorlarini birlik uzunlikka keltiradi.
O‘zgaruvchilar: \(I_i\), \(i\). tasvir; \(T_i\), unga mos matn; \(f_{\mathrm{img}}\) tasvir encoder-i; \(f_{\mathrm{text}}\) text encoder; \(\|\cdot\|_2\) Yevklid/L2 normasi.
Matematik roli: Normallashtirilgandan keyin embedding-lar uzunligi 1 bo‘ladi. Shunda ikki tasvir orasidagi dot product to‘g‘ridan-to‘g‘ri cosine similarity ga teng bo‘ladi:
\[ \operatorname{sim}(\mathbf{v}_i,\mathbf{t}_j) = \mathbf{v}_i\cdot\mathbf{t}_j. \]
Embedding qiymatlarida fizik o‘lchov birligi yo‘q; ular tasvir makonidagi o‘lchovsiz sonlardir.
Tenglama (2): InfoNCE yo‘qotish funksiyasi
\[ \mathcal{L}_{\mathrm{InfoNCE}} (\mathbf{x},\mathbf{x}^{+},\{\mathbf{x}_{j}^{-}\}) = -\log \frac{ \exp(\mathbf{x}\cdot\mathbf{x}^{+}/\tau) }{ \exp(\mathbf{x}\cdot\mathbf{x}^{+}/\tau) + \sum_{j=1}^{J} \exp(\mathbf{x}\cdot\mathbf{x}_{j}^{-}/\tau) }. \tag{2} \]
Nimani hisoblaydi? Anchor embedding to‘g‘ri moslik bilan qanchalik kuchli, noto‘g‘ri mosliklar bilan qanchalik zaif o‘xshashlikka ega ekanini bitta kontrastiv yo‘qotish orqali o‘lchaydi.
\(\mathbf{x}\) anchor namuna, \(\mathbf{x}^{+}\) to‘g‘ri musbat moslik, \(\mathbf{x}_{j}^{-}\) manfiy namunalar va \(\tau\) o‘rganiladigan temperature parametridir. Barcha kattaliklar embedding makonida bo‘lgani uchun fizik birlikka ega emas.
Musbat juftning cosine similarity si oshganda surat kattalashadi va yo‘qotish kamayadi. Manfiy namunaning o‘xshashligi oshganda maxraj kattalashadi va yo‘qotish ortadi. Shu tariqa model bir xil geografik nuqtaga tegishli ikki xil ko‘rinishni bir-biriga yaqinlashtirib, boshqa joylashuvlarni uzoqlashtirishni o‘rganadi.
Tenglama (3): Sentinel-2 vaqt qadamini embedding ga aylantirish
\[ \mathbf{r}_t= \operatorname{Linear} \left( \operatorname{Flatten}(\mathbf{R}_t) \right), \qquad t=1,\ldots,T. \tag{3} \]
Sun’iy yo‘ldosh kirishining to‘liq shakli:
\[ \mathbf{R}\in \mathbb{R}^{T\times C\times H\times W} \]
ko‘rinishidadir. \(T\) vaqt qadamlari soni, \(C\) spektral diapazonlar soni, \(H\times W\) fazoviy o‘lcham. Asosiy TimeSenCLIP-P1 konfiguratsiyasida \(H=W=1\), \(C=10\) va oylik ishlatishda \(T=12\).
Har bir \(\mathbf{R}_t\) vaqt kesimi avval tekislanadi, keyin o‘rganiladigan linear projection yordamida Transformer ishlata oladigan embedding o‘lchamiga aylantiriladi. Sentinel-2 diapazonlari o‘qitishdan oldin diapazon bo‘yicha min–max normallashtirish bilan \([0,1]\) oralig‘iga masshtablangan.
Tenglama (4): Vaqt tokenlari ketma-ketligini hosil qilish
\[ \mathbf{Z} = [ \mathbf{p}_{\mathrm{cls}}; \mathbf{r}_1+\mathbf{p}_1; \ldots; \mathbf{r}_T+\mathbf{p}_T ]. \tag{4} \]
\(\mathbf{p}_{\mathrm{cls}}\) — butun vaqt qatorining xulosasini tashish uchun o‘rganiladigan CLS token. \(\mathbf{p}_t\) — \(t\). vaqt qadamining ketma-ketlikdagi o‘rnini kodlaydigan o‘rganiladigan temporal position embedding.
Bu tuzilma nima uchun kerak? Bir xil aks ettirish qiymati mart oyida kuzatilishi bilan avgust oyida kuzatilishi ekologik jihatdan bir xil ma’noni anglatmasligi mumkin. Position embedding modelga “qaysi kuzatuv qaysi oy/vaqt pozitsiyasida?” axborotini saqlashga yordam beradi.
Tenglama (5): Transformer vaqt qatori encoder-i
\[ \hat{\mathbf{s}} = f_S(\mathbf{Z}). \tag{5} \]
\(f_S\) — TimeSenCLIP ning o‘qitiladigan sun’iy yo‘ldosh Transformer encoder-i. Manbada ushbu encoder 6 Transformer qatlam, 8 attention head, 256 hidden dimension va 512 latent dimension dan foydalanadi. GELU aktivatsiyalari va LayerNorm qo‘llanadi. Yakuniy CLS chiqishi ikki qatlamli yengil MLP projection head dan o‘tkaziladi.
Tenglama (6): Sun’iy yo‘ldosh va yer embedding-larini normallashtirish
\[ \mathbf{s} = \frac{\hat{\mathbf{s}}}{\|\hat{\mathbf{s}}\|_2}, \qquad \mathbf{g} = \frac{\hat{\mathbf{g}}}{\|\hat{\mathbf{g}}\|_2}. \tag{6} \]
\(\hat{\mathbf{s}}\) sun’iy yo‘ldosh encoder-ining xom chiqishi, \(\hat{\mathbf{g}}\) yer sathidagi CLIP tasviridir. Normallashtirishdan keyin \(\mathbf{s}\) va \(\mathbf{g}\) bir xil 512 o‘lchamli umumiy latent makonda taqqoslanishi mumkin.
Tenglama (7): TimeSenCLIP ning haqiqiy o‘qitish yo‘qotishi
\[ \mathcal{L}_{\mathrm{TimeSenCLIP}} ( \{\mathbf{s}_i\}, \{\mathbf{g}_i\}, \mathcal{Q} ) = \sum_i \mathcal{L}_{\mathrm{InfoNCE}} \left( \mathbf{s}_i, \mathbf{g}_i^{+}, \{\mathbf{g}_{j}^{-}\}_i \cup \mathcal{Q} \right). \tag{7} \]
\(\mathbf{g}_i^{+}\) — sun’iy yo‘ldosh namunasi bilan bir xil geografik nuqtaga tegishli yer tasviri ifodasi. \(\mathbf{g}_{j}^{-}\) — batch ichidagi boshqa joylashuvlardan kelgan manfiy namunalar. \(\mathcal{Q}\) — oldingi batch-lardan olingan yer embedding-larini saqlaydigan MoCo-tipidagi memory queue.
Queue hajmi manbada \(K=2048\). Uning maqsadi juda katta batch-lar talab qilmasdan sun’iy yo‘ldosh namunasining ko‘plab manfiy joylashuvlarga qarshi o‘rganishini ta’minlashdir.
Vaqt augmentatsiyasi nima uchun ishlatiladi?
Haqiqiy Sentinel-2 vaqt qatorlarida bulut, yetishmaydigan acquisition yoki mavsumiy ma’lumot bo‘shliqlari uchrashi mumkin. TimeSenCLIP o‘qitish vaqtida har bir batch uchun %50 ehtimol bilan uchta vaqt perturbatsiyasidan birini qo‘llaydi:
- Median Pooling: barcha vaqt qadamlarini bitta median spektral vektorga qisqartiradi.
- Random Quarter Mask: ketma-ket taxminan uch oylik qismini maskalaydi.
- Random Temporal Mask: 1–11 vaqt qadamini tasodifiy maskalaydi; kamida bitta kuzatuv saqlanadi.
Bu augmentatsiyalar faqat o‘qitish vaqtida qo‘llanadi. Inference vaqtida model oylik \(T=12\), choraklik \(T=4\) yoki butun yil medianidan foydalanadigan bitta-vaqtli \(T=1\) kirish bilan ishlashi mumkin.
Matn promptlari qanday yaratildi?
Zero-shot baholashda uchta prompt shakli taqqoslandi:
- Class-name: faqat sinf nomi.
- Generic: “a centered satellite image of {class name}” kabi umumiy shablon.
- Description: sinfning ko‘rinishi yoki ekologik xususiyatlarini tavsiflovchi tabiiy til jumlalari.
Har bir sinf uchun beshta descriptive variant GPT-4 yordamida SenCLIP yondashuviga o‘xshash tarzda yaratildi. Bu promptlar o‘qitish caption-i emas; modelning zero-shot baholash paytida CLIP text encoder ga beriladigan sinf tavsiflaridir. Descriptive promptlar uchun text embedding-lar late prompt ensembling bilan birlashtirilgan.
Vaqt Axboroti Katta Sun’iy Yo‘ldosh Patch-larining O‘rnini Bosa Oladimi?
Tadqiqot natijalariga ko‘ra, ko‘plab yer, ekin va bioregion vazifalarida uzun Sentinel-2 vaqt qatori bitta piksel kirishining kattaroq fazoviy patch-lar bilan raqobatlashishiga yoki ulardan ustun kelishiga imkon berishi mumkin; biroq habitat va scenicness kabi tekstura, geometriya va keng fazoviy tuzilmani talab qiladigan vazifalarda kattaroq patch-lar hali ham foyda beradi.
Tadqiqot Usuli va Natijalari
LUCAS va Sen4Map ma’lumotlar tuzilishi
| Element | Manbada ishlatilgan tuzilma |
|---|---|
| LUCAS yili | 2018 |
| LUCAS qamrovi | Taxminan 235.000 geografik ma’lumotli nuqta, 28 mamlakat |
| Yer tasvirlari | Shimol, sharq, janub va g‘arb yo‘nalishlaridagi yuqori aniqlikdagi fotosuratlar |
| Sentinel-2 manbasi | Sen4Map |
| Manba patch | 64 × 64 piksel |
| Spektral diapazon | 10 diapazon; 10 m va 20 m aniqlik |
| Yillik vaqt qadami | 12 oylik median kompozit |
| O‘qitish | 140.000 namuna |
| Validatsiya | 30.000 namuna |
| Test | 50.000 namuna |
| Asosiy TimeSenCLIP kirishi | Patch markazidan 1 × 1 piksel |
| Spatial ablation | 1×1, 5×5, 9×9, 16×16 va 64×64 kontekstlar |
Baholash vazifalari
| Vazifa | Sinf / ma’lumot tuzilishi | Asosiy metrika |
|---|---|---|
| Land Cover | 8 sinf | Top-1 accuracy |
| Land Use | 16 sinf | Top-1 accuracy |
| Crops | 2-jadvalda 40 sinf; matnda 38 specific crop type | Top-1 accuracy |
| EUNIS Habitat | 44 terrestrial habitat turi | Top-1 accuracy |
| Bioregion | 2-jadvalda 8 sinf | Top-1 accuracy |
| Country retrieval | 28 mamlakat yorlig‘i | Recall@1 |
| Scenicness | UK ScenicOrNot; 2411 moslashtirilgan namuna | Pearson \(R\), Kendall \(\tau\) |
Crop-class manba izohi: asosiy usul matni LUCAS Level-1 da 38 specific crop type mavjudligini aytadi, 2-jadval esa “Crops — 40 classes” qiymatini beradi. Manbadagi farq bu yerda aynan saqlangan.
O‘qitish giperparametrlari
| Ground encoder | CLIP ViT-B/32, muzlatilgan |
|---|---|
| Ground embedding | 512 o‘lcham |
| Satellite Transformer | 6 qatlam, 8 attention head |
| Hidden dimension | 256 |
| Latent dimension | 512 |
| Memory queue | 2048 manfiy embedding |
| Optimizer | AdamW |
| Boshlang‘ich learning rate | \(10^{-4}\) |
| Weight decay | \(1\times10^{-6}\) |
| AdamW \(\beta_1,\beta_2\) | 0,9; 0,999 |
| Schedule | Cosine annealing |
| Warm-up | 10 epoch |
| Umumiy o‘qitish | 200 epoch |
| Batch size | 1024 |
| Uskuna | Bitta NVIDIA TITAN X GPU |
Zero-shot tasniflashdagi asosiy natija
| Model | Kirish | T | Overall C (%) | Overall G (%) | Overall D (%) |
|---|---|---|---|---|---|
| CLIP | 64×64 RGB | 1 | 20,37 ± 0,22 | 22,14 ± 0,21 | 22,66 ± 0,20 |
| GeoRSCLIP | 64×64 RGB | 1 | 21,35 ± 0,10 | 24,74 ± 0,22 | 27,32 ± 0,15 |
| RemoteCLIP | 64×64 RGB | 1 | 20,35 ± 0,14 | 23,78 ± 0,10 | 23,31 ± 0,11 |
| SkyCLIP | 64×64 RGB | 1 | 7,91 ± 0,06 | 10,36 ± 0,10 | 16,68 ± 0,10 |
| SenCLIP | 64×64 RGB | 1 | 25,75 ± 0,10 | 25,91 ± 0,10 | 25,89 ± 0,14 |
| Llama3-MS-CLIP | Multispektral | 1 | 24,29 ± 0,12 | 25,35 ± 0,11 | 26,28 ± 0,13 |
| TimeSenCLIP-P64 | 64×64 RGB | 1 | 34,68 ± 0,16 | 36,27 ± 0,15 | 39,15 ± 0,24 |
| TimeSenCLIP-P1-RGB | 1×1 RGB | 1 | 32,33 ± 0,16 | 32,97 ± 0,14 | 32,49 ± 0,12 |
| TimeSenCLIP-P1-MS | 1×1 multispektral | 1 | 35,26 ± 0,11 | 36,47 ± 0,13 | 37,46 ± 0,15 |
| TimeSenCLIP-P1-MS | 1×1 multispektral | 12 | 42,02 ± 0,15 | 44,22 ± 0,16 | 47,35 ± 0,18 |
Oylik bitta-pikselli multispektral model vazifalar bo‘yicha nima qildi?
| Vazifa | Class-name (%) | Generic (%) | Description (%) |
|---|---|---|---|
| Land Cover | 62,40 | 61,35 | 66,49 |
| Land Use | 54,45 | 60,67 | 64,59 |
| Habitat | 24,06 | 25,01 | 30,90 |
| Crops | 29,33 | 28,42 | 40,36 |
| Bioregion | 49,87 | 45,65 | 34,42 |
Descriptive promptlar umumiy o‘rtachada eng yuqori natijani bersa-da, har bir vazifada bir xil prompt turi eng yaxshi emas. Masalan, Bioregion uchun faqat sinf nomi bilan %49,87 aniqlik, descriptive prompt bilan %34,42 aniqlik olingan. Bu “uzunroq prompt har doim yaxshiroq” degan xulosani qo‘llab-quvvatlamaydi.
Cross-modal retrieval natijalari
Retrieval baholashida Recall@1 ishlatiladi. So‘rov birinchi o‘rinda qaytargan namuna so‘rov bilan bir xil sinfga tegishli bo‘lsa, muvaffaqiyatli deb hisoblanadi.
| Model | Umumiy G2S Recall@1 | Umumiy S2G Recall@1 |
|---|---|---|
| CLIP | 0,327 | 0,161 |
| GeoRSCLIP | 0,360 | 0,209 |
| RemoteCLIP | 0,291 | 0,232 |
| SkyCLIP | 0,126 | 0,167 |
| SenCLIP | 0,362 | 0,306 |
| Llama3-MS-CLIP | 0,218 | 0,167 |
| TimeSenCLIP-P64-RGB, T=1 | 0,416 | 0,460 |
| TimeSenCLIP-P1-RGB, T=1 | 0,331 | 0,331 |
| TimeSenCLIP-P1-MS, T=1 | 0,352 | 0,365 |
| TimeSenCLIP-P1-MS, T=12 | 0,446 | 0,535 |
Oylik bitta-pikselli model ayniqsa S2G yo‘nalishida kuchli. Vazifalar bo‘yicha S2G Recall@1; Land Cover 0,660, Land Use 0,682, Habitat 0,433, Crops 0,411, Bioregion 0,634 va Country 0,392.
Scenicness baholash
Scenicness — manzaraning odamlar tomonidan idrok etiladigan vizual go‘zalligiga oid uzluksiz skor. Tadqiqot Buyuk Britaniya ScenicOrNot ma’lumotlaridan 2411 namunani eng yaqin Sen4Map joylashuvi bilan 100 m ichida moslashtirgan.
Pearson \(R\) bashorat bilan ground-truth o‘rtasidagi chiziqli korrelyatsiyani, Kendall \(\tau\) esa tartiblash mosligini o‘lchaydi. Ikkala o‘lchov ham o‘lchovsiz.
| Model | T | Kirish | Late \(R\) | Late \(\tau\) |
|---|---|---|---|---|
| CLIP — yer tasviri | 1 | Yer fotosurati | 0,660 | 0,465 |
| CLIP — satellite | 1 | 64×64 | 0,519 | 0,363 |
| SenCLIP | 1 | 64×64 | 0,421 | 0,283 |
| TimeSenCLIP-RGB | 1 | 64×64 | 0,660 | 0,450 |
| TimeSenCLIP-MS | 1 | 1×1 | 0,318 | 0,205 |
| TimeSenCLIP-MS | 4 | 1×1 | 0,451 | 0,312 |
| TimeSenCLIP-MS | 12 | 1×1 | 0,527 | 0,363 |
Appendix A.1 da barcha prompt-ensemble strategiyalarining o‘rtachasi ko‘rib chiqilganda TimeSenCLIP-P64-RGB oylik kirishda \(R=0.639\), \(\tau=0.440\); bitta-pikselli P1-MS esa \(R=0.526\), \(\tau=0.363\) natijaga erishgan. Bu natija scenicness uchun vaqt axboroti yordam berishini, biroq keng fazoviy kontekst landshaft geometriyasi va tekstura kabi xususiyatlar tufayli o‘z qiymatini saqlab qolishini ko‘rsatadi.
Klassik vaqt qatori arxitekturalari bilan taqqoslash
| Model | Overall C (%) | Overall G (%) | Overall D (%) |
|---|---|---|---|
| Supervised upper bound | 73,70 | – | – |
| CNN1D | 39,04 ± 0,19 | 41,96 ± 0,22 | 44,88 ± 0,15 |
| ConvTran | 40,06 ± 0,24 | 42,76 ± 0,24 | 45,89 ± 0,22 |
| MLP | 41,20 ± 0,24 | 43,89 ± 0,22 | 46,72 ± 0,14 |
| TempCNN | 41,94 ± 0,24 | 43,45 ± 0,22 | 45,41 ± 0,11 |
| Transformer — TimeSenCLIP | 42,02 ± 0,15 | 44,22 ± 0,16 | 47,35 ± 0,18 |
Transformer umumiy o‘rtachada eng yuqori natijani bergan; ammo har bir vazifa katagida mutlaq ustun emas. Masalan, TempCNN Habitat descriptive promptda %33,37 bilan Transformer ning %30,90 natijasidan yuqori. Shuning uchun manba “Transformer barcha quyi vazifalarda mutlaq eng yaxshi arxitekturadir” degan da’voni ilgari surmaydi.
Temporal dropout haqiqatan yordam berdimi?
| T | Temporal Drop | MS Drop | Land Cover | Land Use | Habitat | Bioregion | Crops | O‘rtacha |
|---|---|---|---|---|---|---|---|---|
| 1 | Yo‘q | Yo‘q | 28,69 | 25,86 | 9,52 | 18,68 | 3,23 | 17,20 |
| 1 | Yo‘q | Ha | 23,76 | 27,88 | 8,39 | 18,18 | 2,93 | 16,23 |
| 1 | Ha | Yo‘q | 56,32 | 57,83 | 31,29 | 25,30 | 12,61 | 36,67 |
| 1 | Ha | Ha | 53,52 | 56,15 | 28,03 | 25,00 | 7,81 | 34,10 |
| 12 | Yo‘q | Yo‘q | 61,72 | 59,76 | 23,43 | 38,71 | 31,82 | 43,09 |
| 12 | Yo‘q | Ha | 63,12 | 58,77 | 25,15 | 40,47 | 31,14 | 43,73 |
| 12 | Ha | Yo‘q | 63,63 | 60,03 | 25,54 | 40,24 | 32,23 | 44,34 |
| 12 | Ha | Ha | 62,42 | 58,17 | 26,68 | 39,42 | 31,64 | 43,67 |
Bitta-vaqt kirishda temporal dropout o‘rtacha aniqlikni %17,20 dan %36,67 gacha oshirgan. To‘liq 12 oylik kirishda hissasi kichikroq: %43,09 dan %44,34 gacha. Bu xatti-harakat manba talqini bilan mos; temporal dropout ayniqsa yetishmaydigan yoki cheklangan vaqt kuzatuvlariga nisbatan bardoshlilikni oshiradi.
Multispectral dropout esa umumiy holda xuddi shu darajada foyda bermagan. Manba buni RGB dan tashqari diapazonlar o‘simlik va ekotizimlarni ajratish uchun qimmatli spektral axborot tashishi bilan bog‘laydi.
Retrieval da temporal dropout
Appendix A.3 da bitta-vaqt \(T=1\) retrieval o‘rtachasi temporal dropout siz 0,219 bo‘lgan bo‘lsa, temporal dropout qo‘llanganda 0,369 ga oshgan. Choraklik kirishda o‘sish 0,452 → 0,457 darajasigacha kamaygan, oylik kirishda esa temporal dropout ishlatilmagan 0,516 o‘rtacha yuqoriroq qolgan. Shuning uchun regularizer ning eng katta foydasi vaqt axboroti yetishmagan rejimda.
Yer tasvirlarida to‘rtta fotosurat kerakmi?
Appendix A.4 to‘rt yo‘nalishli yer tasvirini average pooling bilan birlashtirishni faqat bitta tasodifiy yer tasviridan foydalanish bilan taqqoslagan. Umumiy zero-shot Top-1 aniqligi average pooling uchun %41,30, single image uchun %41,24. Farq juda kichik. Manba buni ayrim qo‘llanmalarda bitta vakillik yer tasviri ma’lumot yig‘ish va hisoblash talablarini kamaytirishi mumkinligiga ishora qiluvchi natija sifatida talqin qiladi.
Hisoblash samaradorligi
| Model | FLOPs / GMac | Parametr (M) | Throughput (namuna/s) | Peak Memory (MB) |
|---|---|---|---|---|
| CLIP | 4,46 | 151,28 | 565,33 | 3045,13 |
| TimeSenCLIP 1×1 | 0,105 | 8,17 | 19.530,50 | 584,60 |
| TimeSenCLIP 5×5 | 0,106 | 8,29 | 19.424,24 | 596,32 |
| TimeSenCLIP 9×9 | 0,110 | 8,58 | 19.428,41 | 624,08 |
| TimeSenCLIP 16×16 | 0,121 | 9,48 | 17.798,35 | 709,12 |
Mualliflarning hisobiga ko‘ra 1×1 TimeSenCLIP standart CLIP ga nisbatan FLOPs bo‘yicha taxminan %97–98, parametrlar sonida taxminan %94 kamayishni ta’minlaydi va throughput bo‘yicha 33 martadan ortiq tezlik beradi. Bu o‘lchovlar tadqiqotning o‘z apparat va batch-size sozlamalariga tegishli; boshqa GPU yoki deployment muhitida aynan shu raqamlar kafolatlanmaydi.
Prediction map lar nimani ko‘rsatadi?
Manba Figure 4 va 5 da oylik Sentinel-2 vaqt qatorini har bir pikselga mustaqil qo‘llash orqali LULC va crop prediction map larini yaratadi. LUCAS faqat markaziy nuqta uchun ground-truth yorlig‘i bergani sababli bu xaritalar to‘liq piksel darajasidagi segmentation ground truth bilan tasdiqlanmagan.
Xaritalarda katta hududlar semantik jihatdan izchil ko‘rinsa-da, qo‘shni piksellar orasida lokal “salt-and-pepper” sinf almashishlari mavjud. Manba buning sababini model har bir pikselni mustaqil tasniflashi va spatial smoothing post-processing ishlatilmasligi bilan izohlaydi.
Manba Figure A.4 dagi confusion matrix lar ham xatolarning muhim qismi semantik yoki strukturaviy jihatdan o‘xshash sinflar orasida to‘planganini ko‘rsatadi. Masalan, crop sinflarida bug‘doy va arpa kabi fenologik jihatdan yaqin don ekinlari, Land Cover da shrubland va woodland, habitatlarda esa o‘xshash vegetatsiya tuzilishiga ega grassland va qishloq xo‘jaligi sinflari bir-biri bilan aralashishi mumkin.
Tadqiqot bevosita qo‘llab-quvvatlaydigan natijalar
- Sentinel-2 ning ko‘p spektrli vaqt o‘zgarishlari zero-shot masofadan zondlash vazifalarida kuchli tasvir manbaidir.
- 12 oylik bitta-pikselli TimeSenCLIP-P1-MS taqqoslangan CLIP asosidagi modellardan umumiy zero-shot tasniflashda yuqoriroq natija bergan.
- Temporal depth ayniqsa ekin va bioregion kabi fenologiyaga bog‘liq sinflarda katta hissa qo‘shgan.
- Multispektral diapazonlar RGB ga nisbatan ayniqsa Land Cover va Crops vazifalarida qo‘shimcha axborot bergan.
- Fazoviy kontekst hissasi vazifaga bog‘liq; Habitat, Land Cover/Use va scenicness kabi vazifalarda kengroq patch foydali bo‘lishi mumkin.
- Temporal dropout ayniqsa yetishmaydigan yoki bitta-vaqt kuzatuvlarida bardoshlilikni sezilarli oshirgan.
- Bitta-pikselli arxitektura CLIP asosidagi katta encoder larga nisbatan ancha past hisoblash va xotira xarajati bilan ishlagan.
- Ground-to-Satellite va Satellite-to-Ground retrieval natijalari vaqt qatori embedding larini yer tasviri semantikasi bilan mazmunli tarzda moslashtirish mumkinligini ko‘rsatadi.
Tadqiqot qo‘llab-quvvatlamaydigan umumlashtirishlar va cheklovlar
- Model faqat Sentinel-2 va Yevropa Ittifoqi/LUCAS kontekstida baholangan; boshqa qit’alar, iqlimlar va sensorlarda xuddi shu ko‘rsatkich isbotlanmagan.
- Bitta piksel barcha vazifalarda katta patch o‘rnini bosmaydi.
- Habitat va scenicness kabi fazoviy tuzilma talab qiladigan muammolarda keng kontekst o‘z ahamiyatini saqlaydi.
- Prediction map lar to‘liq segmentation ground truth bilan baholanmagan; LUCAS ground truth faqat markaziy namuna nuqtasini beradi.
- CLIP ning o‘z semantik makoni internet tasvirlari va caption laridan o‘rganganligi sababli faqat vaqt davomida kuzatiladigan ayrim xususiyatlar ground-image embedding da bo‘lmasligi mumkin.
- Turli sensorlardan, ayniqsa Sentinel-1 + Sentinel-2 kabi multisensor kombinatsiyalaridan foydalanish ushbu tadqiqotda tasdiqlanmagan.
- Global miqyosdagi ground-level fotosurat manbalari bilan o‘qitish kelajakdagi tadqiqot yo‘nalishidir.
- Ekin va habitat kabi ko‘p sinfli, semantik jihatdan bir-biriga yaqin vazifalarda supervised upper bound bilan zero-shot model o‘rtasida hanuz sezilarli ko‘rsatkich farqi mavjud.
Kelajakdagi tadqiqot
Mualliflar TimeSenCLIP ni boshqa sensorlar va turli iqlim/fenologiya hududlariga kengaytirishni, Sentinel-1 va Sentinel-2 kabi bir nechta sensorlarni birgalikda ishlatishni hamda Yevropadan tashqaridagi geografiyalardan kengroq yer tasviri to‘plamlarini o‘qitish jarayoniga qo‘shishni muhim kelajak yo‘nalishlari sifatida belgilaydi.
Manba, shuningdek, CLIP yer tasviri ifodalari vaqt davomida kuzatiladigan ayrim ekologik xususiyatlarni o‘z ichiga olmasligi mumkinligini qayd etadi va bu bo‘shliqni geografik joylashuvga bog‘liq matnli tavsiflar kabi qo‘shimcha semantik manbalar bilan to‘ldirish mumkinligini taklif qiladi.
Manba va Usul Haqida Izoh
Asl sarlavha: TimeSenCLIP: A time series vision–language model for remote sensing
Mualliflar: Pallavi Jain; Diego Marcos; Dino Ienco; Roberto Interdonato; Tristan Berchoux.
Mas’ul muallif: Pallavi Jain.
Muassasalar: Mediterranean Agronomic Institute of Montpellier – CIHEAM-IAMM; Inria; INRAE; Cirad; UMR TETIS; University of Montpellier, Fransiya.
Jurnal: ISPRS Journal of Photogrammetry and Remote Sensing.
Nashriyot: Elsevier B.V., International Society for Photogrammetry and Remote Sensing (ISPRS) nomidan.
Bibliografik yozuv: Volume 236 (2026), 99–119.
DOI: 10.1016/j.isprsjprs.2026.03.043
Rasmiy havola: https://doi.org/10.1016/j.isprsjprs.2026.03.043
Topshirilgan: 14 Avgust 2025. Qayta ko‘rib chiqish: 20 Fevral 2026. Qabul: 26 Mart 2026. Jild sanasi: Iyun 2026.
Manba turi: Taqrizdan o‘tgan eksperimental mashinaviy o‘rganish / masofadan zondlash tadqiqot maqolasi.
Litsenziya: Creative Commons Attribution 4.0 (CC BY 4.0).
Ma’lumot va kod: Maqola LUCAS, Sen4Map, EUNIS/EEA va ScenicOrNot kabi mavjud ma’lumot manbalaridan foydalanadi. TimeSenCLIP kodi https://github.com/pallavijain-pj/TimeSenCLIP manzilida e’lon qilingani manba xulosasida ko‘rsatilgan.
Moliyalashtirish/qo‘llab-quvvatlash: Tadqiqot “Giving Rural Actors Novel Data and Re-Usable Tools to Lead Public Action in Rural Areas” (GRANULAR) loyihasi orqali European Union Horizon Europe Research and Innovation Programme, Grant Agreement No. 101061068 tomonidan; shuningdek ANR OBTEA loyihasi (ANR-22-CPJ1-0054-01) va University of Montpellier I-SITE Excellence Program / Investissements France 2030 doirasida qo‘llab-quvvatlangan.
Manfaatlar to‘qnashuvi: Mualliflar tadqiqotga ta’sir ko‘rsatishi mumkin bo‘lgan ma’lum raqobatdosh moliyaviy manfaat yoki shaxsiy munosabat yo‘qligini bildirgan.
AI yordamida yozish bayonoti: Mualliflar maqola tayyorlashda gap tuzilishi va grammatika yaxshilanishi uchun LLM dan foydalanganliklarini, yakuniy mazmunni o‘zlari ko‘rib chiqib tahrir qilganliklarini va uning uchun javobgarlikni o‘z zimmalariga olganliklarini bildirgan.
Muallif hissalari: Pallavi Jain: dastlabki qoralama, ko‘rib chiqish/tahrirlash, vizualizatsiya, tasdiqlash, metodologiya, tadqiqot, formal tahlil, ma’lumot kuratsiyasi va konseptuallashtirish. Diego Marcos: ko‘rib chiqish/tahrirlash, rahbarlik, resurslar, metodologiya, moliyalashtirishni jalb qilish va konseptuallashtirish. Dino Ienco: ko‘rib chiqish/tahrirlash, rahbarlik va resurslar. Roberto Interdonato: ko‘rib chiqish/tahrirlash, rahbarlik va resurslar. Tristan Berchoux: ko‘rib chiqish/tahrirlash, rahbarlik, resurslar, loyiha boshqaruvi va moliyalashtirishni jalb qilish.
Manba ichidagi hisobot izohi 1: Asosiy usul xulosasida ko‘p yo‘nalishli ground-level image embedding lar attention pooling bilan birlashtirilishi aytilgan, batafsil arxitektura tavsifi va Appendix A.4.3 esa average pooling dan foydalanadi. Manba bu ikki ifodani alohida muvofiqlashtirmaydi.
Manba ichidagi hisobot izohi 2: Dataset tavsifi Level-1 da 38 specific crop type mavjudligini aytadi, 2-jadval esa “Crops — 40 classes” deb hisobot beradi. Verianla ikki raqamni jimlik bilan birlashtirmagan.
Asosiy metodologik cheklov: TimeSenCLIP ning hisobot qilingan umumlashtirish muvaffaqiyati Sentinel-2 va Yevropa markazidagi LUCAS/Sen4Map baholash muhitiga tegishli. Boshqa sensor, qit’a, iqlim va fenologik rejimlarga cross-domain transfer ushbu tadqiqotda bevosita tasdiqlanmagan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan