


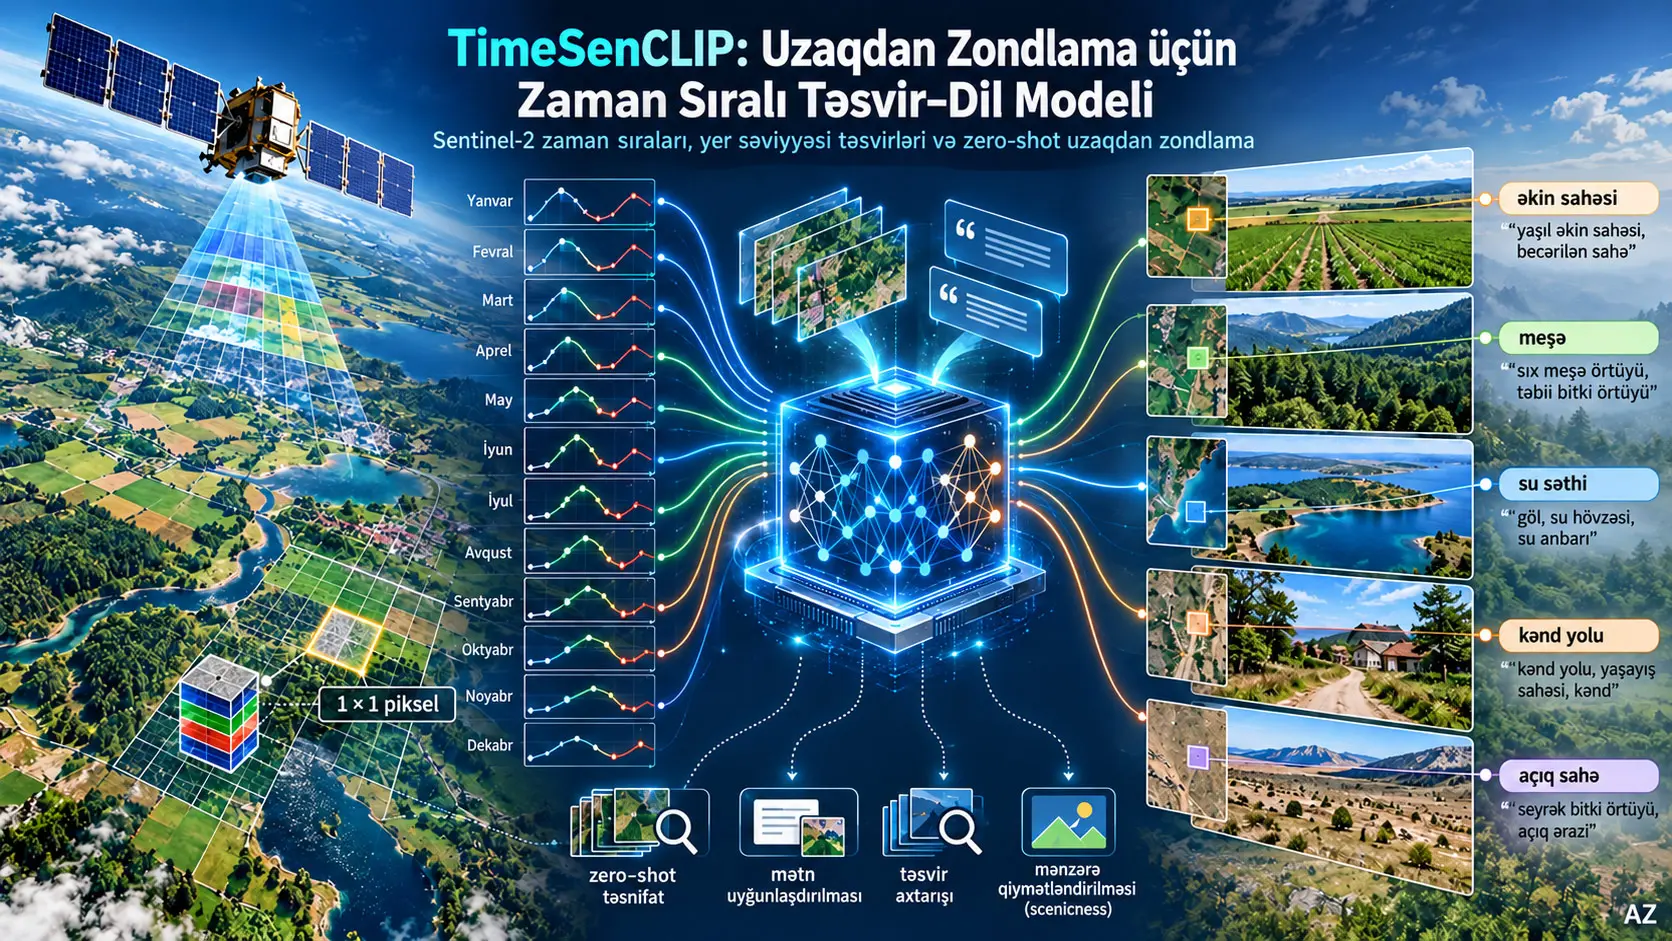
TimeSenCLIP, çoxspektrli Sentinel-2 peyk zaman sıralarını coğrafi etiketli yer səviyyəsi fotolarının semantik CLIP təsvirləri ilə çarpaz-görünüş kontrastiv öyrənmədən istifadə etməklə uyğunlaşdıran yüngül təsvir–dil modelidir. Modelin fərqləndirici xüsusiyyəti peyk tərəfində böyük təsvir patch-lərinə və ya təlim zamanı mətn caption-larına ehtiyac duymadan, yalnız bir Sentinel-2 pikselinin spektral–zaman dəyişməsindən semantik təsvir öyrənə bilməsidir.
TimeSenCLIP; LUCAS 2018 yer səviyyəsi təsvirləri və Sen4Map Sentinel-2 zaman sıraları ilə təlim edilmiş; torpaq örtüyü, torpaq istifadəsi, habitat, məhsul növü və biocoğrafi region üzrə zero-shot təsnifat, çarpaz-modal retrieval və scenicness proqnozlaşdırılması üzərində qiymətləndirilmişdir. Əsas 12-aylıq, tək-piksel, multispektral TimeSenCLIP-P1 modeli descriptive promptlarla ümumi zero-shot Top-1 dəqiqliyində %47,35 ± 0,18 nəticəsinə çatmışdır. Eyni modelin aylıq zaman sırası ilə ümumi çarpaz-modal Recall@1 göstəricisi Ground-to-Satellite istiqamətində 0,446, Satellite-to-Ground istiqamətində isə 0,535-dir.
Tədqiqatın əsas nəticəsi Sentinel-2 kimi orta ayırdetməli uzaqdan zondlama verilənlərində zaman və spektral dinamikaların bir çox tapşırıq üçün geniş məkan kontekstinin mühüm hissəsini kompensasiya edə bilməsidir. Bununla belə, bu nəticə bütün tapşırıqlarda “tək piksel həmişə kifayətdir” demək deyil: habitat təsnifatı və scenicness kimi məkan quruluşu, tekstura və ərazi həndəsəsinin mühüm olduğu problemlərdə daha böyük patch-lər üstünlük verə bilər. Bundan əlavə, model yalnız Sentinel-2 və Avropa mərkəzli LUCAS verilənləri ilə qiymətləndirilmişdir; fərqli sensorlarda, iqlimlərdə və coğrafi regionlarda eyni uğur hələ göstərilməmişdir.
Tədqiqat problemi
Uzaqdan zondlama üçün hazırlanmış bir çox vision–language model (VLM), təbii təsvirlər üçün yaradılmış CLIP-bənzər arxitekturaları peyk təsvirlərinə uyğunlaşdırır. Bu yanaşma üç əsas problem yaradır. Birincisi, təlim çox vaxt peyk təsvirsü–mətn caption cütlərinə ehtiyac duyur; belə təsvirlər həm bahadır, həm də istifadə olunan söz ehtiyatı ilə məhdudlaşdırıla bilər. İkincisi, modellər adətən yüzlərlə piksel enində böyük məkan patch-lərinə söykənir. Sentinel-2 kimi orta ayırdetməli sensorlarda böyük patch heterogen kənd təsərrüfatı və ya ekosistem mozaikasında bir-birindən fərqli sahələri bir girişdə qarışdıra bilər. Üçüncüsü, klassik RGB əsaslı yanaşma mövsümiliyi, fenologiyanı və fərqli dalğa uzunluqlarındakı əks etdirmə xüsusiyyətlərini kifayət qədər istifadə etmir.
TimeSenCLIP bu problemi əks istiqamətdən soruşur: Bir Sentinel-2 pikselinin il ərzində dəyişən çoxspektrli zaman sırası, böyük məkan təsvir patch-i olmadan torpaq və ekosistem semantikasını öyrənmək üçün kifayət qədər informasiya daşıyırmı?
Tədqiqatın yanaşması xüsusilə kənd təsərrüfatı və ekoloji siniflər baxımından mənalıdır. Məsələn, buğda, qarğıdalı və ya müxtəlif vegetasiya sistemləri yalnız bir tarixdəki təsvirləri ilə bir-birinə bənzəyə bilər; lakin əkin, böyümə, yetişmə və məhsul yığımı boyunca yaranan əks etdirmə dəyişmələri fərqli zaman imzaları yaradır.
TimeSenCLIP Tək Bir Sentinel-2 Pikselindən Semantik Məlumatı Necə Öyrənir?
TimeSenCLIP eyni coğrafi mövqeyə aid Sentinel-2 spektral–zaman ardıcıllığını və yer səviyyəsi fotolarını ortaq embedding məkanında bir-birinə yaxınlaşdıraraq öyrənir; yer fotolarının dondurulmuş CLIP təsvir encoder-indən gələn semantik informasiya peyk zaman sırasına ötürülür və təlim başa çatdıqda yalnız peyk encoder-i və CLIP text encoder istifadə edilməklə yeni mətn sinifləri üzrə zero-shot proqnoz verilə bilər.
Təlimdə iki görünüş var
Yer səviyyəsi görünüşü: LUCAS nöqtələrində dörd əsas istiqamətdə çəkilmiş coğrafi etiketli fotolar dondurulmuş CLIP ViT-B/32 təsvir encoder-indən keçirilir. CLIP təbii təsvirlərlə dil arasında əvvəldən öyrənilmiş semantik məkana malik olduğuna görə bu fotolar TimeSenCLIP üçün mətnlə uyğunlaşdırılmış semantik hədəf rolunu oynayır.
Peyk görünüşü: Eyni mövqenin Sentinel-2 zaman sırası ayrıca Transformer encoder tərəfindən işlənir. Peyk encoder-i sıfırdan təlim edilir və yer təsvirsü embedding-inə yaxınlaşmağı öyrənir.
Mənbədaxili adlandırma qeydi: metodun ümumi xülasəsində birdən çox yer təsvirsünün “attention pooling” ilə birləşdirildiyi bildirilir. Ətraflı arxitektura izahında və Appendix A.4.3-də isə “average pooling” istifadə olunur. Mənbə bu iki ifadəni ayrıca uzlaşdırmadığı üçün burada səssizcə tək bir ifadə ilə əvəz edilməmişdir.
Tənlik (1): CLIP embedding-lərinin L2 normallaşdırılması
\[ \mathbf{v}_i= \frac{f_{\mathrm{img}}(I_i)} {\left\|f_{\mathrm{img}}(I_i)\right\|_2}, \qquad \mathbf{t}_i= \frac{f_{\mathrm{text}}(T_i)} {\left\|f_{\mathrm{text}}(T_i)\right\|_2}. \tag{1} \]
Formula nəyi hesablayır? Görüntü encoder-inin və text encoder-in yaratdığı embedding vektorlarını vahid uzunluğa gətirir.
Dəyişənlər: \(I_i\), \(i\). təsvir; \(T_i\), ona uyğun mətn; \(f_{\mathrm{img}}\) təsvir encoder-i; \(f_{\mathrm{text}}\) text encoder; \(\|\cdot\|_2\) Evklid/L2 normudur.
Riyazi rol: Normallaşdırmadan sonra embedding-lərin uzunluğu 1 olur. Beləliklə iki təsvir arasındakı dot product birbaşa cosine similarity-yə uyğun gəlir:
\[ \operatorname{sim}(\mathbf{v}_i,\mathbf{t}_j) = \mathbf{v}_i\cdot\mathbf{t}_j. \]
Embedding dəyərlərinin fiziki ölçü vahidi yoxdur; onlar təsvir məkanındakı ölçüsüz ədədlərdir.
Tənlik (2): InfoNCE itkisi
\[ \mathcal{L}_{\mathrm{InfoNCE}} (\mathbf{x},\mathbf{x}^{+},\{\mathbf{x}_{j}^{-}\}) = -\log \frac{ \exp(\mathbf{x}\cdot\mathbf{x}^{+}/\tau) }{ \exp(\mathbf{x}\cdot\mathbf{x}^{+}/\tau) + \sum_{j=1}^{J} \exp(\mathbf{x}\cdot\mathbf{x}_{j}^{-}/\tau) }. \tag{2} \]
Nəyi hesablayır? Anchor embedding-in doğru uyğunlaşma ilə nə qədər güclü, yanlış uyğunlaşmalarla nə qədər zəif oxşarlıq daşıdığını vahid kontrastiv itki ilə ölçür.
\(\mathbf{x}\) anchor nümunə, \(\mathbf{x}^{+}\) düzgün müsbət uyğunlaşma, \(\mathbf{x}_{j}^{-}\) mənfi nümunələr və \(\tau\) öyrənilə bilən temperature parametridir. Bütün kəmiyyətlər embedding məkanında olduğuna görə fiziki vahidləri yoxdur.
Müsbət cütün cosine similarity-si yüksəldikdə surət böyüyür və itki azalır. Mənfi nümunənin oxşarlığı yüksəldikdə məxrəc böyüyür və itki artır. Beləliklə model eyni coğrafi nöqtəyə aid iki fərqli görünüşü bir-birinə yaxınlaşdırarkən digər mövqeləri uzaqlaşdırmağı öyrənir.
Tənlik (3): Sentinel-2 zaman addımının embedding-ə çevrilməsi
\[ \mathbf{r}_t= \operatorname{Linear} \left( \operatorname{Flatten}(\mathbf{R}_t) \right), \qquad t=1,\ldots,T. \tag{3} \]
Peyk girişinin hamısı:
\[ \mathbf{R}\in \mathbb{R}^{T\times C\times H\times W} \]
şəklindədir. \(T\) zaman addımlarının sayı, \(C\) spektral bandların sayı, \(H\times W\) məkan ölçüsüdür. Əsas TimeSenCLIP-P1 konfiqurasiyasında \(H=W=1\), \(C=10\) və aylıq istifadədə \(T=12\)-dir.
Hər \(\mathbf{R}_t\) zaman kəsiyi əvvəlcə yastılaşdırılır, sonra öyrənilə bilən linear projection ilə Transformer-in istifadə edə biləcəyi embedding ölçüsünə çevrilir. Sentinel-2 bandları təlimdən əvvəl band əsasında min–max normallaşdırması ilə \([0,1]\) intervalına miqyaslandırılmışdır.
Tənlik (4): Zaman token ardıcıllığının yaradılması
\[ \mathbf{Z} = [ \mathbf{p}_{\mathrm{cls}}; \mathbf{r}_1+\mathbf{p}_1; \ldots; \mathbf{r}_T+\mathbf{p}_T ]. \tag{4} \]
\(\mathbf{p}_{\mathrm{cls}}\), bütün zaman sırasının xülasəsini daşıması üçün öyrənilən CLS token-dir. \(\mathbf{p}_t\), \(t\). zaman addımının ardıcıllıqdakı yerini kodlayan öyrənilə bilən temporal position embedding-dir.
Bu struktur nə üçün lazımdır? Eyni əks etdirmə dəyərinin mart ayında görünməsi ilə avqust ayında görünməsi ekoloji baxımdan eyni məna daşımaya bilər. Position embedding modelin “hansı müşahidə hansı ay/zaman mövqeyindədir?” məlumatını qorumasına kömək edir.
Tənlik (5): Transformer zaman sırası encoder-i
\[ \hat{\mathbf{s}} = f_S(\mathbf{Z}). \tag{5} \]
\(f_S\), TimeSenCLIP-in təlim edilə bilən peyk Transformer encoder-idir. Mənbədə bu encoder 6 Transformer qatı, 8 attention head, 256 hidden dimension və 512 latent dimension istifadə edir. GELU aktivləşdirmələri və LayerNorm tətbiq olunur. Son CLS çıxışı ikiqatlı yüngül MLP projection head-dən keçirilir.
Tənlik (6): Peyk və yer embedding-lərinin normallaşdırılması
\[ \mathbf{s} = \frac{\hat{\mathbf{s}}}{\|\hat{\mathbf{s}}\|_2}, \qquad \mathbf{g} = \frac{\hat{\mathbf{g}}}{\|\hat{\mathbf{g}}\|_2}. \tag{6} \]
\(\hat{\mathbf{s}}\) peyk encoder-inin xam çıxışı, \(\hat{\mathbf{g}}\) yer səviyyəsi CLIP təsviridir. Normallaşdırmadan sonra \(\mathbf{s}\) və \(\mathbf{g}\) eyni 512 ölçülü ortaq latent məkanda müqayisə edilə bilər.
Tənlik (7): TimeSenCLIP-in faktiki təlim itkisi
\[ \mathcal{L}_{\mathrm{TimeSenCLIP}} ( \{\mathbf{s}_i\}, \{\mathbf{g}_i\}, \mathcal{Q} ) = \sum_i \mathcal{L}_{\mathrm{InfoNCE}} \left( \mathbf{s}_i, \mathbf{g}_i^{+}, \{\mathbf{g}_{j}^{-}\}_i \cup \mathcal{Q} \right). \tag{7} \]
\(\mathbf{g}_i^{+}\), peyk nümunəsi ilə eyni coğrafi nöqtəyə aid yer təsvirsü təsviridir. \(\mathbf{g}_{j}^{-}\), batch daxilində fərqli mövqelərdən gələn mənfi nümunələrdir. \(\mathcal{Q}\), keçmiş batch-lərdən gələn yer embedding-lərini saxlayan MoCo-tipli memory queue-dur.
Queue ölçüsü mənbədə \(K=2048\)-dir. Məqsəd çox böyük batch-lərə ehtiyac olmadan peyk nümunəsinin çox sayda mənfi mövqeyə qarşı öyrənə bilməsini təmin etməkdir.
Zaman augmentasiyası nə üçün istifadə olunur?
Real Sentinel-2 zaman sıralarında bulud, çatışmayan acquisition və ya mövsümi məlumat boşluqları ola bilər. TimeSenCLIP təlim zamanı hər batch üçün %50 ehtimalla üç zaman perturbasiyasından birini tətbiq edir:
- Median Pooling: bütün zaman addımlarını tək bir median spektral vektora endirir.
- Random Quarter Mask: ardıcıl təxminən üç aylıq bir hissəni maskalayır.
- Random Temporal Mask: 1–11 zaman addımını təsadüfi maskalayır; ən azı bir müşahidə qorunur.
Bu augmentasiyalar yalnız təlim zamanı istifadə olunur. Çıxarım zamanı model aylıq \(T=12\), rüblük \(T=4\) və ya bütün ilin medianından istifadə edən tək-zaman \(T=1\) girişlə işlədilə bilər.
Mətn promptları necə yaradıldı?
Zero-shot qiymətləndirmədə üç prompt forması müqayisə edilmişdir:
- Class-name: yalnız sinfin adı.
- Generic: “a centered satellite image of {class name}” kimi ümumi şablon.
- Description: sinfin görünüşünü və ya ekoloji xüsusiyyətlərini izah edən təbii dil cümlələri.
Hər sinif üçün beş descriptive variant GPT-4 istifadə edilərək SenCLIP yanaşmasına bənzər şəkildə yaradılmışdır. Bu promptlar təlim caption-ı deyil; modelin zero-shot qiymətləndirilməsi zamanı CLIP text encoder-a verilən sinif təsvirləridir. Descriptive promptlar üçün text embedding-lər late prompt ensembling ilə birləşdirilmişdir.
Zaman İnformasiyası Böyük Peyk Patch-lərinin Yerini Tuta Bilərmi?
Tədqiqatın nəticələrinə görə bir çox torpaq, məhsul və bioregion tapşırığında uzun Sentinel-2 zaman sırası tək piksel girişinin daha böyük məkan patch-ləri ilə rəqabət etməsinə və ya onları üstələməsinə imkan verə bilər; lakin habitat və scenicness kimi tekstura, həndəsə və geniş məkan düzəni tələb edən tapşırıqlarda daha böyük patch-lər hələ də fayda verir.
Tədqiqatın Metodu və Nəticələri
LUCAS və Sen4Map məlumat strukturu
| Element | Mənbədə istifadə olunan struktur |
|---|---|
| LUCAS ili | 2018 |
| LUCAS əhatəsi | Təxminən 235.000 coğrafi istinadlı nöqtə, 28 ölkə |
| Yer təsvirləri | Şimal, şərq, cənub və qərb istiqamətlərində yüksək ayırdetməli fotolar |
| Sentinel-2 mənbəyi | Sen4Map |
| Mənbə patch | 64 × 64 piksel |
| Spektral band | 10 band; 10 m və 20 m ayırdetmə |
| İllik zaman addımı | 12 aylıq median kompozit |
| Təlim | 140.000 nümunə |
| Doğrulama | 30.000 nümunə |
| Test | 50.000 nümunə |
| Əsas TimeSenCLIP girişi | Patch mərkəzindən 1 × 1 piksel |
| Spatial ablation | 1×1, 5×5, 9×9, 16×16 və 64×64 kontekstlər |
Qiymətləndirmə tapşırıqları
| Tapşırıq | Sinif / məlumat strukturu | Əsas metrik |
|---|---|---|
| Land Cover | 8 sinif | Top-1 accuracy |
| Land Use | 16 sinif | Top-1 accuracy |
| Crops | Cədvəl 2-də 40 sinif; mətndə 38 specific crop type | Top-1 accuracy |
| EUNIS Habitat | 44 terrestrial habitat növü | Top-1 accuracy |
| Bioregion | Cədvəl 2-də 8 sinif | Top-1 accuracy |
| Country retrieval | 28 ölkə etiketi | Recall@1 |
| Scenicness | UK ScenicOrNot; 2411 uyğunlaşdırılmış nümunə | Pearson \(R\), Kendall \(\tau\) |
Crop-class mənbə qeydi: əsas metod mətni LUCAS Level-1-in 38 specific crop type ehtiva etdiyini deyərkən Cədvəl 2 “Crops — 40 classes” dəyərini verir. Mənbədəki fərq burada olduğu kimi qorunmuşdur.
Təlim hiperparametrləri
| Ground encoder | CLIP ViT-B/32, dondurulmuş |
|---|---|
| Ground embedding | 512 ölçü |
| Satellite Transformer | 6 qat, 8 attention head |
| Hidden dimension | 256 |
| Latent dimension | 512 |
| Memory queue | 2048 mənfi embedding |
| Optimizer | AdamW |
| Başlanğıc learning rate | \(10^{-4}\) |
| Weight decay | \(1\times10^{-6}\) |
| AdamW \(\beta_1,\beta_2\) | 0,9; 0,999 |
| Schedule | Cosine annealing |
| Warm-up | 10 epoch |
| Ümumi təlim | 200 epoch |
| Batch size | 1024 |
| Avadanlıq | Tək NVIDIA TITAN X GPU |
Zero-shot təsnifatda əsas nəticə
| Model | Giriş | T | Overall C (%) | Overall G (%) | Overall D (%) |
|---|---|---|---|---|---|
| CLIP | 64×64 RGB | 1 | 20,37 ± 0,22 | 22,14 ± 0,21 | 22,66 ± 0,20 |
| GeoRSCLIP | 64×64 RGB | 1 | 21,35 ± 0,10 | 24,74 ± 0,22 | 27,32 ± 0,15 |
| RemoteCLIP | 64×64 RGB | 1 | 20,35 ± 0,14 | 23,78 ± 0,10 | 23,31 ± 0,11 |
| SkyCLIP | 64×64 RGB | 1 | 7,91 ± 0,06 | 10,36 ± 0,10 | 16,68 ± 0,10 |
| SenCLIP | 64×64 RGB | 1 | 25,75 ± 0,10 | 25,91 ± 0,10 | 25,89 ± 0,14 |
| Llama3-MS-CLIP | Multispektral | 1 | 24,29 ± 0,12 | 25,35 ± 0,11 | 26,28 ± 0,13 |
| TimeSenCLIP-P64 | 64×64 RGB | 1 | 34,68 ± 0,16 | 36,27 ± 0,15 | 39,15 ± 0,24 |
| TimeSenCLIP-P1-RGB | 1×1 RGB | 1 | 32,33 ± 0,16 | 32,97 ± 0,14 | 32,49 ± 0,12 |
| TimeSenCLIP-P1-MS | 1×1 multispektral | 1 | 35,26 ± 0,11 | 36,47 ± 0,13 | 37,46 ± 0,15 |
| TimeSenCLIP-P1-MS | 1×1 multispektral | 12 | 42,02 ± 0,15 | 44,22 ± 0,16 | 47,35 ± 0,18 |
Aylıq tək-piksel multispektral model tapşırıq üzrə nə etdi?
| Tapşırıq | Class-name (%) | Generic (%) | Description (%) |
|---|---|---|---|
| Land Cover | 62,40 | 61,35 | 66,49 |
| Land Use | 54,45 | 60,67 | 64,59 |
| Habitat | 24,06 | 25,01 | 30,90 |
| Crops | 29,33 | 28,42 | 40,36 |
| Bioregion | 49,87 | 45,65 | 34,42 |
Descriptive promptlar ümumi ortalamada ən yüksək nəticəni versə də hər tapşırıqda eyni prompt növü ən yaxşı deyil. Məsələn, Bioregion üçün yalnız sinif adı ilə %49,87 dəqiqlik, descriptive prompt ilə %34,42 dəqiqlik əldə edilmişdir. Bu, “daha uzun prompt həmişə daha yaxşıdır” nəticəsinin dəstəklənmədiyini göstərir.
Cross-modal retrieval nəticələri
Retrieval qiymətləndirməsində Recall@1 istifadə olunur. Sorğunun birinci sırada qaytardığı nümunə sorğu ilə eyni sinfə aiddirsə uğurlu hesab edilir.
| Model | Ümumi G2S Recall@1 | Ümumi S2G Recall@1 |
|---|---|---|
| CLIP | 0,327 | 0,161 |
| GeoRSCLIP | 0,360 | 0,209 |
| RemoteCLIP | 0,291 | 0,232 |
| SkyCLIP | 0,126 | 0,167 |
| SenCLIP | 0,362 | 0,306 |
| Llama3-MS-CLIP | 0,218 | 0,167 |
| TimeSenCLIP-P64-RGB, T=1 | 0,416 | 0,460 |
| TimeSenCLIP-P1-RGB, T=1 | 0,331 | 0,331 |
| TimeSenCLIP-P1-MS, T=1 | 0,352 | 0,365 |
| TimeSenCLIP-P1-MS, T=12 | 0,446 | 0,535 |
Aylıq tək-piksel model xüsusilə S2G istiqamətində güclüdür. Tapşırıq üzrə S2G Recall@1; Land Cover 0,660, Land Use 0,682, Habitat 0,433, Crops 0,411, Bioregion 0,634 və Country 0,392-dir.
Scenicness proqnozlaşdırılması
Scenicness mənzərənin insanlar tərəfindən qəbul edilən vizual gözəlliyinə dair fasiləsiz skordur. Tədqiqat Birləşmiş Krallığın ScenicOrNot verilənlərindən 2411 nümunəni ən yaxın Sen4Map mövqeyi ilə 100 m daxilində uyğunlaşdırmışdır.
Pearson \(R\) proqnoz ilə ground-truth arasındakı xətti korrelyasiyanı, Kendall \(\tau\) isə sıralama uyğunluğunu ölçür. Hər iki ölçü ölçüsüzdür.
| Model | T | Giriş | Late \(R\) | Late \(\tau\) |
|---|---|---|---|---|
| CLIP — yer təsvirsü | 1 | Yer fotosu | 0,660 | 0,465 |
| CLIP — satellite | 1 | 64×64 | 0,519 | 0,363 |
| SenCLIP | 1 | 64×64 | 0,421 | 0,283 |
| TimeSenCLIP-RGB | 1 | 64×64 | 0,660 | 0,450 |
| TimeSenCLIP-MS | 1 | 1×1 | 0,318 | 0,205 |
| TimeSenCLIP-MS | 4 | 1×1 | 0,451 | 0,312 |
| TimeSenCLIP-MS | 12 | 1×1 | 0,527 | 0,363 |
Appendix A.1-də bütün prompt-ensemble strategiyalarının ortalaması araşdırıldıqda TimeSenCLIP-P64-RGB aylıq girişdə \(R=0.639\), \(\tau=0.440\); tək-piksel P1-MS isə \(R=0.526\), \(\tau=0.363\) əldə etmişdir. Bu nəticə scenicness üçün zaman informasiyasının kömək etdiyini, lakin geniş məkan kontekstinin mənzərə həndəsəsi və tekstura kimi xüsusiyyətlərə görə dəyərini qoruduğunu göstərir.
Klassik zaman sırası arxitekturaları ilə müqayisə
| Model | Overall C (%) | Overall G (%) | Overall D (%) |
|---|---|---|---|
| Supervised upper bound | 73,70 | – | – |
| CNN1D | 39,04 ± 0,19 | 41,96 ± 0,22 | 44,88 ± 0,15 |
| ConvTran | 40,06 ± 0,24 | 42,76 ± 0,24 | 45,89 ± 0,22 |
| MLP | 41,20 ± 0,24 | 43,89 ± 0,22 | 46,72 ± 0,14 |
| TempCNN | 41,94 ± 0,24 | 43,45 ± 0,22 | 45,41 ± 0,11 |
| Transformer — TimeSenCLIP | 42,02 ± 0,15 | 44,22 ± 0,16 | 47,35 ± 0,18 |
Transformer ümumi ortalamada ən yüksək nəticəni vermişdir; lakin hər tapşırıq hüceyrəsində rəqibsiz deyil. Məsələn, TempCNN Habitat descriptive promptunda %33,37 ilə Transformer-in %30,90 nəticəsini keçir. Buna görə mənbə “Transformer bütün alt tapşırıqlarda mütləq ən yaxşı arxitekturadır” iddiasını irəli sürmür.
Temporal dropout həqiqətən işə yaradı mı?
| T | Temporal Drop | MS Drop | Land Cover | Land Use | Habitat | Bioregion | Crops | Ortalama |
|---|---|---|---|---|---|---|---|---|
| 1 | Xeyr | Xeyr | 28,69 | 25,86 | 9,52 | 18,68 | 3,23 | 17,20 |
| 1 | Xeyr | Bəli | 23,76 | 27,88 | 8,39 | 18,18 | 2,93 | 16,23 |
| 1 | Bəli | Xeyr | 56,32 | 57,83 | 31,29 | 25,30 | 12,61 | 36,67 |
| 1 | Bəli | Bəli | 53,52 | 56,15 | 28,03 | 25,00 | 7,81 | 34,10 |
| 12 | Xeyr | Xeyr | 61,72 | 59,76 | 23,43 | 38,71 | 31,82 | 43,09 |
| 12 | Xeyr | Bəli | 63,12 | 58,77 | 25,15 | 40,47 | 31,14 | 43,73 |
| 12 | Bəli | Xeyr | 63,63 | 60,03 | 25,54 | 40,24 | 32,23 | 44,34 |
| 12 | Bəli | Bəli | 62,42 | 58,17 | 26,68 | 39,42 | 31,64 | 43,67 |
Tək-zaman girişində temporal dropout orta dəqiqliyi %17,20-dən %36,67-yə qaldırmışdır. Tam 12 aylıq girişdə töhfəsi daha kiçikdir: %43,09-dan %44,34-ə. Bu davranış mənbə şərhi ilə uyğundur; temporal dropout xüsusilə çatışmayan və ya məhdud zaman müşahidələrinə qarşı dayanıqlıq qazandırır.
Multispectral dropout isə ümumilikdə eyni dərəcədə fayda verməmişdir. Mənbə bunu RGB-dən kənar bandların bitki və ekosistem ayrımı üçün dəyərli spektral informasiya daşıması ilə əlaqələndirir.
Retrieval-da temporal dropout
Appendix A.3-də tək-zaman \(T=1\) retrieval ortalaması temporal dropout olmadan 0,219 ikən temporal dropout istifadə edildikdə 0,369-a yüksəlmişdir. Rüblük girişdə artım 0,452 → 0,457 səviyyəsinə enmiş, aylıq girişdə isə temporal dropout istifadə edilməyən 0,516 orta göstərici daha yüksək qalmışdır. Buna görə regularizer-in ən böyük faydası zaman informasiyasının çatışmadığı rejimdədir.
Yer təsvirlərində dörd foto lazımdırmı?
Appendix A.4 dörd istiqamətli yer təsvirsünün average pooling ilə birləşdirilməsini yalnız bir təsadüfi yer təsvirsünün istifadəsi ilə müqayisə etmişdir. Ümumi zero-shot Top-1 dəqiqliyi average pooling üçün %41,30, single image üçün %41,24-dür. Fərq çox kiçikdir. Mənbə bunu bəzi tətbiqlərdə tək bir təmsilçi yer təsvirsünün məlumat toplama və hesablama tələblərini azalda biləcəyinə işarə edən nəticə kimi şərh edir.
Hesablama səmərəliliyi
| Model | FLOPs / GMac | Parametr (M) | Throughput (nümunə/s) | Peak Memory (MB) |
|---|---|---|---|---|
| CLIP | 4,46 | 151,28 | 565,33 | 3045,13 |
| TimeSenCLIP 1×1 | 0,105 | 8,17 | 19.530,50 | 584,60 |
| TimeSenCLIP 5×5 | 0,106 | 8,29 | 19.424,24 | 596,32 |
| TimeSenCLIP 9×9 | 0,110 | 8,58 | 19.428,41 | 624,08 |
| TimeSenCLIP 16×16 | 0,121 | 9,48 | 17.798,35 | 709,12 |
Müəlliflərin hesablamasına görə 1×1 TimeSenCLIP standart CLIP-lə müqayisədə FLOPs-da təxminən %97–98, parametr sayında təxminən %94 azalma təmin edir və throughput baxımından 33 qatdan çox sürət təqdim edir. Bu ölçmələr tədqiqatın öz avadanlıq və batch-size quruluşuna aiddir; fərqli GPU və ya deployment mühitində eyni rəqəmlərə zəmanət verilmir.
Prediction map-lər nə göstərir?
Mənbə Şəkil 4 və 5 aylıq Sentinel-2 zaman sırasının hər pikselə müstəqil tətbiqi ilə LULC və crop prediction map-ləri yaradır. LUCAS yalnız mərkəz nöqtə üçün ground-truth etiketi verdiyinə görə bu xəritələr tam piksel səviyyəsində segmentation ground truth ilə doğrulanmamışdır.
Xəritələrdə geniş sahələr semantik baxımdan ardıcıl görünsə də qonşu piksellər arasında lokal “salt-and-pepper” sinif dəyişmələri mövcuddur. Mənbə bunun səbəbini modelin hər pikseli müstəqil təsnif etməsi və spatial smoothing post-processing istifadə edilməməsi kimi izah edir.
Mənbə Şəkil A.4-dəki confusion matrix-lər də səhvlərin mühüm hissəsinin semantik və ya struktur baxımdan oxşar siniflər arasında toplandığını göstərir. Məsələn, crop siniflərində buğda və arpa kimi fenoloji baxımdan yaxın taxıllar, Land Cover-da shrubland və woodland, habitatlarda isə oxşar vegetasiya quruluşuna malik grassland və kənd təsərrüfatı sinifləri bir-birinə qarışa bilər.
Tədqiqatın birbaşa dəstəklədiyi nəticələr
- Sentinel-2-nin çoxspektrli zaman dəyişmələri zero-shot uzaqdan zondlama tapşırıqlarında güclü təsvir mənbəyidir.
- 12 aylıq tək-piksel TimeSenCLIP-P1-MS müqayisə edilən CLIP əsaslı modellərdən ümumi zero-shot təsnifatda daha yüksək nəticə vermişdir.
- Temporal depth xüsusilə məhsul və bioregion kimi fenologiyadan asılı siniflərdə güclü töhfə vermişdir.
- Multispektral bandlar RGB ilə müqayisədə xüsusilə Land Cover və Crops tapşırıqlarında əlavə informasiya vermişdir.
- Məkan kontekstinin töhfəsi tapşırıqdan asılıdır; Habitat, Land Cover/Use və scenicness kimi tapşırıqlarda daha geniş patch faydalı ola bilər.
- Temporal dropout xüsusilə çatışmayan və ya tək-zaman müşahidələrində dayanıqlığı nəzərəçarpacaq dərəcədə artırmışdır.
- Tək-piksel arxitekturası CLIP əsaslı böyük encoder-lərlə müqayisədə daha aşağı hesablama və yaddaş xərci ilə işləyib.
- Ground-to-Satellite və Satellite-to-Ground retrieval nəticələri zaman sırası embedding-lərinin yer təsvirsü semantikası ilə mənalı şəkildə uyğunlaşdırıla bildiyini göstərir.
Tədqiqatın dəstəkləmədiyi ümumiləşdirmələr və məhdudiyyətlər
- Model yalnız Sentinel-2 və Avropa İttifaqı/LUCAS kontekstində qiymətləndirilmişdir; digər qitələrdə, iqlimlərdə və sensorlarda eyni performans sübut edilməmişdir.
- Tək piksel bütün tapşırıqlarda böyük patch-in yerini tutmur.
- Habitat və scenicness kimi məkan quruluşu tələb edən problemlərdə geniş kontekst əhəmiyyətini qoruyur.
- Prediction map-lər tam segmentation ground truth ilə qiymətləndirilməmişdir; LUCAS ground truth yalnız mərkəzi nümunə nöqtəsini verir.
- CLIP-in öz semantik məkanı internet təsvirləri və caption-larından öyrənildiyinə görə yalnız zamanla müşahidə edilə bilən bəzi xüsusiyyətlər ground-image embedding-də olmaya bilər.
- Fərqli sensorların, xüsusilə Sentinel-1 + Sentinel-2 kimi multisensor kombinasiyaların istifadəsi bu tədqiqatda doğrulanmamışdır.
- Qlobal miqyaslı ground-level foto mənbələri ilə təlim gələcək tədqiqat istiqamətidir.
- Məhsul və habitat kimi çoxsinifli və semantik baxımdan bir-birinə yaxın tapşırıqlarda supervised upper bound ilə zero-shot model arasında hələ də nəzərəçarpacaq performans fərqi mövcuddur.
Gələcək tədqiqat
Müəlliflər TimeSenCLIP-in başqa sensorlara və fərqli iqlim/fenologiya regionlarına genişləndirilməsini, Sentinel-1 və Sentinel-2 kimi çoxlu sensorların birlikdə istifadəsini və Avropadan kənar coğrafiyalardan daha geniş yer təsvirsü kolleksiyalarının təlim prosesinə əlavə edilməsini mühüm gələcək istiqamətlər kimi müəyyən edirlər.
Mənbə həmçinin CLIP yer təsvirsü təsvirlərinin zamanla müşahidə edilə bilən bəzi ətraf mühit xüsusiyyətlərini ehtiva etməyə biləcəyini bildirir və bu boşluğun coğrafi mövqedən asılı mətn təsvirləri kimi əlavə semantik mənbələrlə tamamlanmasını təklif edir.
Mənbə və Metod Qeydi
Orijinal başlıq: TimeSenCLIP: A time series vision–language model for remote sensing
Müəlliflər: Pallavi Jain; Diego Marcos; Dino Ienco; Roberto Interdonato; Tristan Berchoux.
Məsul müəllif: Pallavi Jain.
Qurumlar: Mediterranean Agronomic Institute of Montpellier – CIHEAM-IAMM; Inria; INRAE; Cirad; UMR TETIS; University of Montpellier, Fransa.
Jurnal: ISPRS Journal of Photogrammetry and Remote Sensing.
Nəşriyyat: Elsevier B.V., International Society for Photogrammetry and Remote Sensing (ISPRS) adından.
Biblioqrafik qeyd: Volume 236 (2026), 99–119.
DOI: 10.1016/j.isprsjprs.2026.03.043
Rəsmi keçid: https://doi.org/10.1016/j.isprsjprs.2026.03.043
Təqdim: 14 Avqust 2025. Reviziya: 20 Fevral 2026. Qəbul: 26 Mart 2026. Cild tarixi: İyun 2026.
Mənbə növü: Resenziyalı eksperimental maşın öyrənməsi / uzaqdan zondlama tədqiqat məqaləsi.
Lisenziya: Creative Commons Attribution 4.0 (CC BY 4.0).
Məlumat və kod: Məqalə LUCAS, Sen4Map, EUNIS/EEA və ScenicOrNot kimi mövcud məlumat mənbələrindən istifadə edir. TimeSenCLIP kodunun https://github.com/pallavijain-pj/TimeSenCLIP ünvanında yayımlandığı mənbə xülasəsində bildirilmişdir.
Maliyyələşdirmə/dəstək: Tədqiqat “Giving Rural Actors Novel Data and Re-Usable Tools to Lead Public Action in Rural Areas” (GRANULAR) layihəsi vasitəsilə European Union Horizon Europe Research and Innovation Programme, Grant Agreement No. 101061068 tərəfindən; həmçinin ANR OBTEA layihəsi (ANR-22-CPJ1-0054-01) və University of Montpellier I-SITE Excellence Program / Investissements France 2030 çərçivəsində dəstəklənmişdir.
Maraqlar toqquşması: Müəlliflər tədqiqata təsir göstərə biləcək məlum rəqabət aparan maliyyə marağının və ya şəxsi münasibətin olmadığını bildirmişlər.
AI dəstəkli yazı bəyanatı: Müəlliflər məqalə hazırlanarkən cümlə strukturlaşdırılması və qrammatikanın yaxşılaşdırılması məqsədilə LLM istifadə etdiklərini, son məzmunu özlərinin nəzərdən keçirib redaktə etdiklərini və onun məsuliyyətini üzərlərinə götürdüklərini bildirmişlər.
Müəllif töhfələri: Pallavi Jain: ilkin layihə, nəzərdən keçirmə/redaktə, vizuallaşdırma, doğrulama, metodologiya, tədqiqat, formal analiz, məlumat kurasiyası və konseptuallaşdırma. Diego Marcos: nəzərdən keçirmə/redaktə, rəhbərlik, resurslar, metodologiya, maliyyələşdirmənin əldə edilməsi və konseptuallaşdırma. Dino Ienco: nəzərdən keçirmə/redaktə, rəhbərlik və resurslar. Roberto Interdonato: nəzərdən keçirmə/redaktə, rəhbərlik və resurslar. Tristan Berchoux: nəzərdən keçirmə/redaktə, rəhbərlik, resurslar, layihə idarəetməsi və maliyyələşdirmənin əldə edilməsi.
Mənbədaxili hesabat qeydi 1: Əsas metod xülasəsində çoxistiqamətli ground-level image embedding-lərinin attention pooling ilə birləşdirildiyi bildirilərkən ətraflı arxitektura izahı və Appendix A.4.3 average pooling istifadə edir. Mənbə bu iki ifadəni ayrıca uzlaşdırmır.
Mənbədaxili hesabat qeydi 2: Dataset izahı Level-1-in 38 specific crop type ehtiva etdiyini deyərkən Cədvəl 2 “Crops — 40 classes” hesabatını verir. Verianla iki rəqəmi səssizcə birləşdirməmişdir.
Əsas metodoloji məhdudiyyət: TimeSenCLIP-in hesabat verilən ümumiləşdirmə uğuru Sentinel-2 və Avropa mərkəzli LUCAS/Sen4Map qiymətləndirmə mühitinə aiddir. Başqa sensor, qitə, iqlim və fenoloji rejimlərə cross-domain ötürmə bu tədqiqatda birbaşa doğrulanmamışdır.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib