


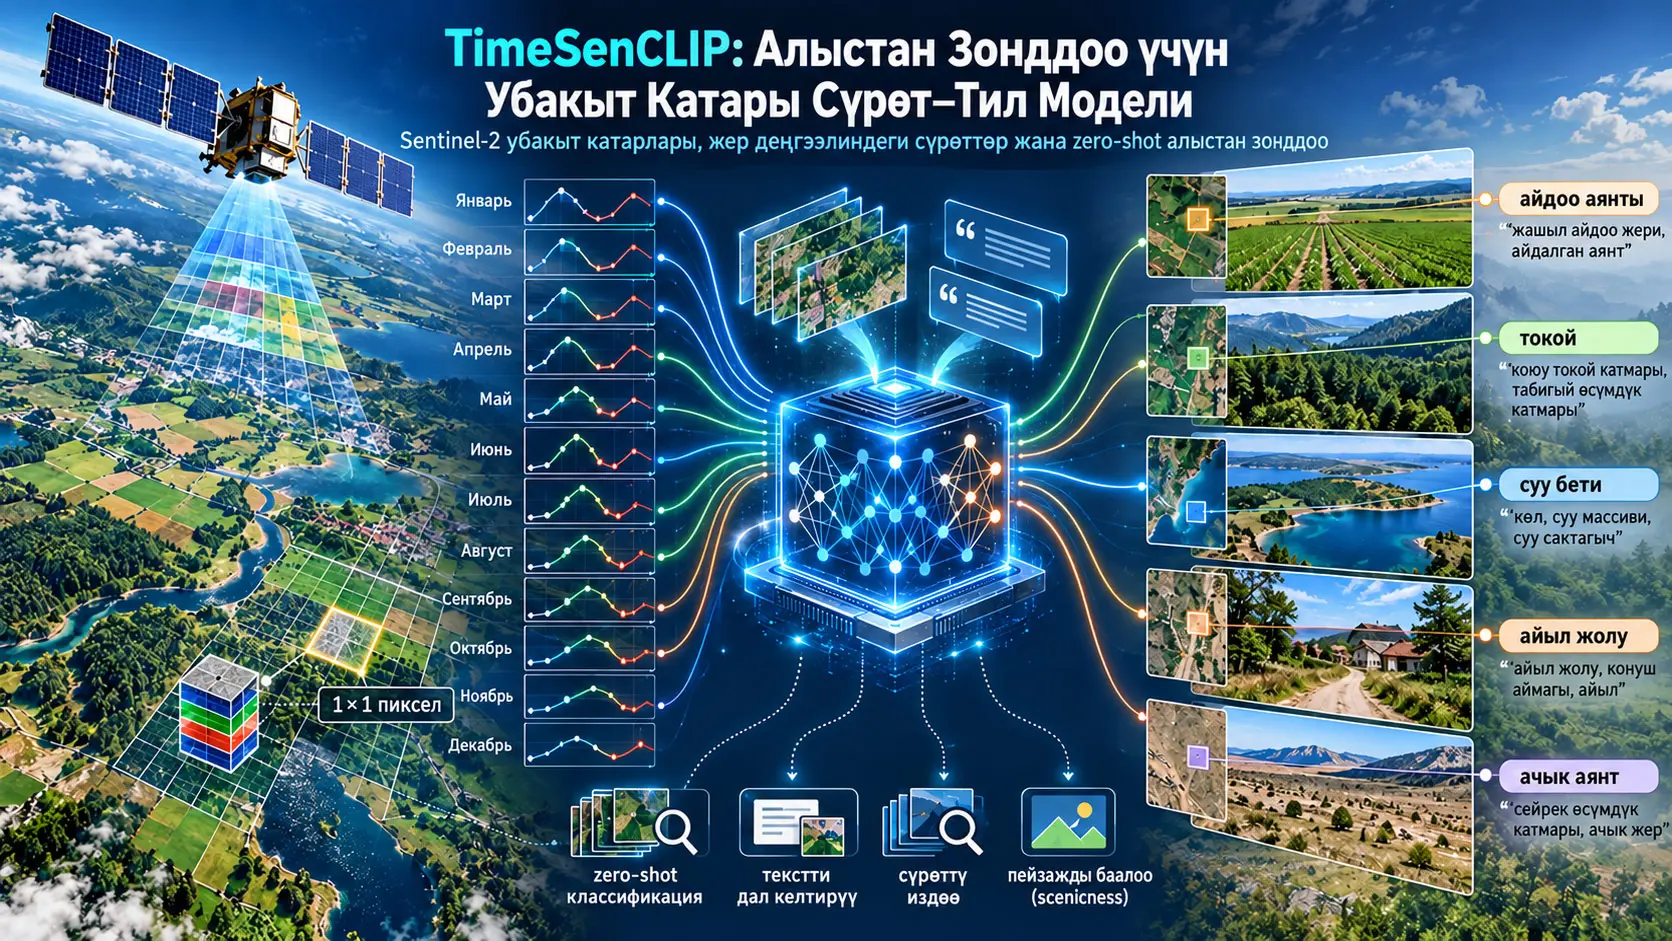
TimeSenCLIP — көп спектрдүү Sentinel-2 спутниктик убакыт катарларын географиялык белгиленген жер деңгээлиндеги сүрөттөрдүн семантикалык CLIP өкүлчүлүктөрү менен кайчылаш-көрүнүш контрастивдүү үйрөнүү аркылуу шайкеш келтирген жеңил сүрөт–тил модели. Моделдин айырмалоочу өзгөчөлүгү — спутник тарапта чоң сүрөт patch-терине же окутуу маалында тексттик caption-дарга муктаж болбостон, жалгыз бир Sentinel-2 пикселинин спектралдык–убакыттык өзгөрүшүнөн семантикалык өкүлчүлүк үйрөнө алышы.
TimeSenCLIP LUCAS 2018 жер деңгээлиндеги сүрөттөрү жана Sen4Map Sentinel-2 убакыт катарлары менен окутулуп; жер каптоосу, жер пайдалануу, habitat, өсүмдүк түрү жана биогеографиялык аймак боюнча zero-shot классификация, cross-modal retrieval жана scenicness божомолдоо тапшырмаларында бааланган. Негизги 12-айлык, бир-пикселдик, мультиспектралдык TimeSenCLIP-P1 модели descriptive promptтар менен жалпы zero-shot Top-1 тактыгында %47,35 ± 0,18 көрсөткүчүнө жеткен. Ошол эле моделдин айлык убакыт катары менен жалпы cross-modal Recall@1 көрсөткүчү Ground-to-Satellite багытында 0,446, Satellite-to-Ground багытында 0,535.
Изилдөөнүн негизги жыйынтыгы — Sentinel-2 сыяктуу орточо ажыратуу жөндөмүндөгү алыстан зонддоо маалыматтарында убакыттык жана спектралдык динамика көптөгөн тапшырмалар үчүн кең мейкиндиктик контексттин маанилүү бөлүгүн толуктай ала тургандыгы. Бирок бул жыйынтык бардык тапшырмаларда “бир пиксел ар дайым жетиштүү” дегенди билдирбейт: habitat классификациясы жана scenicness сыяктуу мейкиндиктик түзүлүш, текстура жана жердин геометриясы маанилүү болгон маселелерде чоңураак patch-тер артыкчылык бере алат. Мындан тышкары, модель Sentinel-2 жана Европага багытталган LUCAS маалыматтары менен гана бааланган; башка сенсорлордо, климаттарда жана географиялык аймактарда ушундай эле ийгилик азырынча көрсөтүлгөн эмес.
Изилдөө маселеси
Алыстан зонддоо үчүн иштелип чыккан көптөгөн vision–language model (VLM) табигый сүрөттөр үчүн түзүлгөн CLIP сыяктуу архитектураларды спутник сүрөттөрүнө ыңгайлаштырат. Бул ыкма үч негизги көйгөйдү жаратат. Биринчиден, окутуу көбүнчө спутник сүрөтү–текст caption жуптарын талап кылат; мындай түшүндүрмөлөр кымбат жана колдонулган сөз байлыгы менен чектелиши мүмкүн. Экинчиден, моделдер адатта жүздөгөн пиксел кеңдиктеги чоң мейкиндиктик patch-терге таянат. Sentinel-2 сыяктуу орточо ажыратуу жөндөмүндөгү сенсорлордо чоң patch гетерогендик айыл чарба же экосистема мозаикасындагы бири-биринен айырмаланган аймактарды бир киргизүүгө аралаштырып салышы мүмкүн. Үчүнчүдөн, классикалык RGB негизиндеги ыкма сезондуулукту, фенологияны жана ар башка толкун узундуктарындагы чагылуу өзгөчөлүктөрүн жетиштүү пайдаланбайт.
TimeSenCLIP бул маселени тескерисинен коёт: Бир Sentinel-2 пикселинин жыл ичинде өзгөргөн көп спектрдүү убакыт катары чоң мейкиндиктик сүрөт patch-и жок эле жер жана экосистема семантикасын үйрөнүү үчүн жетиштүү маалымат алып жүрөбү?
Изилдөөнүн ыкмасы өзгөчө айыл чарба жана экологиялык класстар үчүн маанилүү. Мисалы, буудай, жүгөрү же ар башка өсүмдүк системалары бир гана күндөгү сүрөттөрүндө бири-бирине окшош көрүнүшү мүмкүн; бирок себүү, өсүү, бышуу жана оруп-жыйноо мезгилдериндеги чагылуу өзгөрүүлөрү ар башка убакыттык белгилерди жаратат.
TimeSenCLIP Бир Sentinel-2 Пикселинен Семантикалык Маалыматты Кантип Үйрөнөт?
TimeSenCLIP бир географиялык жерге тиешелүү Sentinel-2 спектралдык–убакыттык катарын жана жер деңгээлиндеги сүрөттөрдү жалпы embedding мейкиндигинде жакындатуу аркылуу үйрөнөт; жер сүрөттөрүнүн тоңдурулган CLIP сүрөт encoder-инен келген семантикалык маалымат спутниктик убакыт катарына өткөрүлөт жана окутуу бүткөндөн кийин жаңы тексттик класстар боюнча zero-shot божомолдоо үчүн спутник encoder-и менен CLIP text encoder гана колдонулат.
Окутууда эки көрүнүш бар
Жер деңгээлиндеги көрүнүш: LUCAS чекиттеринде төрт негизги багытта тартылган географиялык белгиленген сүрөттөр тоңдурулган CLIP ViT-B/32 сүрөт encoder-и аркылуу өткөрүлөт. CLIP табигый сүрөттөр менен тилдин ортосунда мурда үйрөнүлгөн семантикалык мейкиндикке ээ болгондуктан, бул сүрөттөр TimeSenCLIP үчүн текст менен шайкеш семантикалык максат болуп кызмат кылат.
Спутник көрүнүшү: Ошол эле жердин Sentinel-2 убакыт катары өзүнчө Transformer encoder тарабынан иштетилет. Спутник encoder-и нөлдөн окутулат жана жер сүрөтү embedding-ине жакындаганды үйрөнөт.
Булактагы аталыш боюнча эскертүү: ыкманын жалпы кыскача баянында бир нече жер сүрөтү “attention pooling” менен бириктирилери айтылат. Толук архитектуралык түшүндүрмөдө жана Appendix A.4.3 бөлүмүндө болсо “average pooling” колдонулат. Булак бул эки түшүнүктү өзүнчө шайкеш келтирбегендиктен, бул жерде алар үн катпай бир эле түшүнүккө алмаштырылган жок.
Теңдеме (1): CLIP embedding-дерин L2 нормалдаштыруу
\[ \mathbf{v}_i= \frac{f_{\mathrm{img}}(I_i)} {\left\|f_{\mathrm{img}}(I_i)\right\|_2}, \qquad \mathbf{t}_i= \frac{f_{\mathrm{text}}(T_i)} {\left\|f_{\mathrm{text}}(T_i)\right\|_2}. \tag{1} \]
Формула эмнени эсептейт? Сүрөт encoder-и жана text encoder чыгарган embedding векторлорун бирдик узундукка келтирет.
Өзгөрмөлөр: \(I_i\), \(i\). сүрөт; \(T_i\), ага тиешелүү текст; \(f_{\mathrm{img}}\) сүрөт encoder-и; \(f_{\mathrm{text}}\) text encoder; \(\|\cdot\|_2\) Евклид/L2 нормасы.
Математикалык ролу: Нормалдаштырылгандан кийин embedding-дердин узундугу 1 болот. Ошондо эки өкүлчүлүктүн ортосундагы dot product түздөн-түз cosine similarity ге туура келет:
\[ \operatorname{sim}(\mathbf{v}_i,\mathbf{t}_j) = \mathbf{v}_i\cdot\mathbf{t}_j. \]
Embedding маанилеринин физикалык өлчөм бирдиги жок; алар өкүлчүлүк мейкиндигиндеги өлчөмсүз сандар.
Теңдеме (2): InfoNCE жоготуусу
\[ \mathcal{L}_{\mathrm{InfoNCE}} (\mathbf{x},\mathbf{x}^{+},\{\mathbf{x}_{j}^{-}\}) = -\log \frac{ \exp(\mathbf{x}\cdot\mathbf{x}^{+}/\tau) }{ \exp(\mathbf{x}\cdot\mathbf{x}^{+}/\tau) + \sum_{j=1}^{J} \exp(\mathbf{x}\cdot\mathbf{x}_{j}^{-}/\tau) }. \tag{2} \]
Эмнени эсептейт? Anchor embedding туура дал келүү менен канчалык күчтүү, туура эмес дал келүүлөр менен канчалык начар окшоштукка ээ экенин бир контрастивдүү жоготуу аркылуу өлчөйт.
\(\mathbf{x}\) anchor мисал, \(\mathbf{x}^{+}\) туура оң дал келүү, \(\mathbf{x}_{j}^{-}\) терс мисалдар жана \(\tau\) үйрөнүлүүчү temperature параметри. Бардык чоңдуктар embedding мейкиндигинде болгондуктан физикалык бирдиктери жок.
Оң жуптун cosine similarity мааниси жогорулаганда алым чоңоёт жана жоготуу азаят. Терс мисалдын окшоштугу жогорулаганда бөлүм чоңоёт жана жоготуу өсөт. Ошентип модель бир географиялык чекитке тиешелүү эки башка көрүнүштү жакындатып, башка жерлерди алыстатканды үйрөнөт.
Теңдеме (3): Sentinel-2 убакыт кадамын embedding ге айландыруу
\[ \mathbf{r}_t= \operatorname{Linear} \left( \operatorname{Flatten}(\mathbf{R}_t) \right), \qquad t=1,\ldots,T. \tag{3} \]
Спутниктик киргизүүнүн толук формасы:
\[ \mathbf{R}\in \mathbb{R}^{T\times C\times H\times W} \]
түрүндө. \(T\) убакыт кадамдарынын саны, \(C\) спектралдык тилкелердин саны, \(H\times W\) мейкиндиктик өлчөм. Негизги TimeSenCLIP-P1 конфигурациясында \(H=W=1\), \(C=10\) жана айлык колдонууда \(T=12\).
Ар бир \(\mathbf{R}_t\) убакыт кесими адегенде тегизделет, андан кийин үйрөнүлүүчү linear projection аркылуу Transformer колдоно ала турган embedding өлчөмүнө айландырылат. Sentinel-2 тилкелери окутуунун алдында тилке боюнча min–max нормалдаштыруу менен \([0,1]\) диапазонуна масштабдалган.
Теңдеме (4): Убакыттык token катарын түзүү
\[ \mathbf{Z} = [ \mathbf{p}_{\mathrm{cls}}; \mathbf{r}_1+\mathbf{p}_1; \ldots; \mathbf{r}_T+\mathbf{p}_T ]. \tag{4} \]
\(\mathbf{p}_{\mathrm{cls}}\) — бүт убакыт катарынын жыйынтыгын алып жүрүшү үчүн үйрөнүлүүчү CLS token. \(\mathbf{p}_t\) — \(t\). убакыт кадамынын катардагы ордун коддогон үйрөнүлүүчү temporal position embedding.
Бул түзүлүш эмне үчүн керек? Бирдей чагылуу мааниси март айында байкалганы менен август айында байкалганы экологиялык жактан бирдей мааниге ээ болбой калышы мүмкүн. Position embedding моделге “кайсы байкоо кайсы ай/убакыт позициясында?” деген маалыматты сактоого жардам берет.
Теңдеме (5): Transformer убакыт катары encoder-и
\[ \hat{\mathbf{s}} = f_S(\mathbf{Z}). \tag{5} \]
\(f_S\) — TimeSenCLIPтин үйрөнүлүүчү спутниктик Transformer encoder-и. Булакта бул encoder 6 Transformer катмарын, 8 attention head, 256 hidden dimension жана 512 latent dimension колдонот. GELU активдештирүүлөрү жана LayerNorm колдонулат. Акыркы CLS чыгышы эки катмарлуу жеңил MLP projection head аркылуу өткөрүлөт.
Теңдеме (6): Спутник жана жер embedding-дерин нормалдаштыруу
\[ \mathbf{s} = \frac{\hat{\mathbf{s}}}{\|\hat{\mathbf{s}}\|_2}, \qquad \mathbf{g} = \frac{\hat{\mathbf{g}}}{\|\hat{\mathbf{g}}\|_2}. \tag{6} \]
\(\hat{\mathbf{s}}\) спутник encoder-инин чийки чыгышы, \(\hat{\mathbf{g}}\) жер деңгээлиндеги CLIP өкүлчүлүгү. Нормалдаштырылгандан кийин \(\mathbf{s}\) жана \(\mathbf{g}\) бирдей 512 өлчөмдүү жалпы latent мейкиндикте салыштырылат.
Теңдеме (7): TimeSenCLIPтин чыныгы окутуу жоготуусу
\[ \mathcal{L}_{\mathrm{TimeSenCLIP}} ( \{\mathbf{s}_i\}, \{\mathbf{g}_i\}, \mathcal{Q} ) = \sum_i \mathcal{L}_{\mathrm{InfoNCE}} \left( \mathbf{s}_i, \mathbf{g}_i^{+}, \{\mathbf{g}_{j}^{-}\}_i \cup \mathcal{Q} \right). \tag{7} \]
\(\mathbf{g}_i^{+}\) — спутник мисалы менен бир географиялык чекитке тиешелүү жер сүрөтүнүн өкүлчүлүгү. \(\mathbf{g}_{j}^{-}\) — batch ичиндеги башка жерлерден келген терс мисалдар. \(\mathcal{Q}\) — мурунку batch-терден келген жер embedding-дерин сактаган MoCo-түрүндөгү memory queue.
Queue өлчөмү булакта \(K=2048\). Анын максаты өтө чоң batch-терди талап кылбастан спутник мисалынын көп сандагы терс жерлерге каршы үйрөнүшүнө шарт түзүү.
Убакыттык augmentatsiya эмне үчүн колдонулат?
Чыныгы Sentinel-2 убакыт катарларында булут, жетишпеген acquisition же сезондук маалымат боштуктары кездешиши мүмкүн. TimeSenCLIP окутуу учурунда ар бир batch үчүн %50 ыктымалдык менен үч убакыттык perturbation-нун бирин колдонот:
- Median Pooling: бардык убакыт кадамдарын бир median спектралдык векторго кыскартат.
- Random Quarter Mask: удаалаш болжол менен үч айлык бөлүктү маскалайт.
- Random Temporal Mask: 1–11 убакыт кадамын туш келди маскалайт; жок дегенде бир байкоо сакталат.
Бул augmentatsiyaлар окутуу учурунда гана колдонулат. Inference учурунда модель айлык \(T=12\), чейректик \(T=4\) же бүт жылдын median-ын колдонгон бир-убакыттык \(T=1\) киргизүү менен иштей алат.
Текст promptтары кантип түзүлгөн?
Zero-shot баалоодо үч prompt форматы салыштырылган:
- Class-name: класстын аталышы гана.
- Generic: “a centered satellite image of {class name}” сыяктуу жалпы шаблон.
- Description: класстын көрүнүшүн же экологиялык өзгөчөлүктөрүн түшүндүргөн табигый тилдеги сүйлөмдөр.
Ар бир класс үчүн беш descriptive вариант GPT-4 колдонулуп, SenCLIP ыкмасына окшош түрдө түзүлгөн. Бул promptтар окутуу caption-ы эмес; моделдин zero-shot баалоосунда CLIP text encoder-ге берилген класс түшүндүрмөлөрү. Descriptive promptтар үчүн text embedding-дер late prompt ensembling менен бириктирилген.
Убакыттык Маалымат Чоң Спутник Patch-теринин Ордун Баса Алабы?
Изилдөөнүн жыйынтыгына ылайык, көптөгөн жер, өсүмдүк жана bioregion тапшырмаларында узун Sentinel-2 убакыт катары бир-пикселдик киргизүүгө чоңураак мейкиндиктик patch-тер менен атаандашууга же алардан ашууга мүмкүндүк берет; бирок habitat жана scenicness сыяктуу текстура, геометрия жана кең мейкиндиктик түзүлүш талап кылынган тапшырмаларда чоңураак patch-тер дагы эле пайдалуу.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
LUCAS жана Sen4Map маалымат түзүлүшү
| Элемент | Булакта колдонулган түзүлүш |
|---|---|
| LUCAS жылы | 2018 |
| LUCAS камтуусу | Болжол менен 235.000 географиялык шилтемеленген чекит, 28 өлкө |
| Жер сүрөттөрү | Түндүк, чыгыш, түштүк жана батыш багыттарындагы жогорку ажыратуудагы сүрөттөр |
| Sentinel-2 булагы | Sen4Map |
| Булак patch | 64 × 64 пиксел |
| Спектралдык тилке | 10 тилке; 10 m жана 20 m ажыратуу |
| Жылдык убакыт кадамы | 12 айлык median композит |
| Окутуу | 140.000 мисал |
| Валидация | 30.000 мисал |
| Тест | 50.000 мисал |
| Негизги TimeSenCLIP киргизүүсү | Patch борборунан 1 × 1 пиксел |
| Spatial ablation | 1×1, 5×5, 9×9, 16×16 жана 64×64 контексттер |
Баалоо тапшырмалары
| Тапшырма | Класс / маалымат түзүлүшү | Негизги метрика |
|---|---|---|
| Land Cover | 8 класс | Top-1 accuracy |
| Land Use | 16 класс | Top-1 accuracy |
| Crops | 2-таблицада 40 класс; текстте 38 specific crop type | Top-1 accuracy |
| EUNIS Habitat | 44 terrestrial habitat түрү | Top-1 accuracy |
| Bioregion | 2-таблицада 8 класс | Top-1 accuracy |
| Country retrieval | 28 өлкө белгиси | Recall@1 |
| Scenicness | UK ScenicOrNot; 2411 дал келген мисал | Pearson \(R\), Kendall \(\tau\) |
Crop-class боюнча булак эскертүүсү: негизги метод текстинде LUCAS Level-1 38 specific crop type камтыйт деп айтылса, 2-таблицада “Crops — 40 classes” көрсөтүлөт. Булактагы айырма бул жерде өзгөртүүсүз сакталды.
Окутуу гиперпараметрлери
| Ground encoder | CLIP ViT-B/32, тоңдурулган |
|---|---|
| Ground embedding | 512 өлчөм |
| Satellite Transformer | 6 катмар, 8 attention head |
| Hidden dimension | 256 |
| Latent dimension | 512 |
| Memory queue | 2048 терс embedding |
| Optimizer | AdamW |
| Баштапкы learning rate | \(10^{-4}\) |
| Weight decay | \(1\times10^{-6}\) |
| AdamW \(\beta_1,\beta_2\) | 0,9; 0,999 |
| Schedule | Cosine annealing |
| Warm-up | 10 epoch |
| Жалпы окутуу | 200 epoch |
| Batch size | 1024 |
| Жабдык | Бир NVIDIA TITAN X GPU |
Zero-shot классификациядагы негизги жыйынтык
| Модель | Киргизүү | T | Overall C (%) | Overall G (%) | Overall D (%) |
|---|---|---|---|---|---|
| CLIP | 64×64 RGB | 1 | 20,37 ± 0,22 | 22,14 ± 0,21 | 22,66 ± 0,20 |
| GeoRSCLIP | 64×64 RGB | 1 | 21,35 ± 0,10 | 24,74 ± 0,22 | 27,32 ± 0,15 |
| RemoteCLIP | 64×64 RGB | 1 | 20,35 ± 0,14 | 23,78 ± 0,10 | 23,31 ± 0,11 |
| SkyCLIP | 64×64 RGB | 1 | 7,91 ± 0,06 | 10,36 ± 0,10 | 16,68 ± 0,10 |
| SenCLIP | 64×64 RGB | 1 | 25,75 ± 0,10 | 25,91 ± 0,10 | 25,89 ± 0,14 |
| Llama3-MS-CLIP | Мультиспектралдык | 1 | 24,29 ± 0,12 | 25,35 ± 0,11 | 26,28 ± 0,13 |
| TimeSenCLIP-P64 | 64×64 RGB | 1 | 34,68 ± 0,16 | 36,27 ± 0,15 | 39,15 ± 0,24 |
| TimeSenCLIP-P1-RGB | 1×1 RGB | 1 | 32,33 ± 0,16 | 32,97 ± 0,14 | 32,49 ± 0,12 |
| TimeSenCLIP-P1-MS | 1×1 мультиспектралдык | 1 | 35,26 ± 0,11 | 36,47 ± 0,13 | 37,46 ± 0,15 |
| TimeSenCLIP-P1-MS | 1×1 мультиспектралдык | 12 | 42,02 ± 0,15 | 44,22 ± 0,16 | 47,35 ± 0,18 |
Айлык бир-пикселдик мультиспектралдык модель тапшырмалар боюнча эмне кылды?
| Тапшырма | Class-name (%) | Generic (%) | Description (%) |
|---|---|---|---|
| Land Cover | 62,40 | 61,35 | 66,49 |
| Land Use | 54,45 | 60,67 | 64,59 |
| Habitat | 24,06 | 25,01 | 30,90 |
| Crops | 29,33 | 28,42 | 40,36 |
| Bioregion | 49,87 | 45,65 | 34,42 |
Descriptive promptтар жалпы орточо көрсөткүчтө эң жогорку жыйынтыкты бергени менен, ар бир тапшырмада бир эле prompt түрү мыкты эмес. Мисалы, Bioregion үчүн класстын аты гана менен %49,87 тактык, descriptive prompt менен %34,42 тактык алынган. Бул “узунураак prompt ар дайым жакшы” деген жыйынтыкты колдобойт.
Cross-modal retrieval жыйынтыктары
Retrieval баалоосунда Recall@1 колдонулат. Суроо биринчи орунда кайтарган мисал суроо менен бир класска таандык болсо, ийгиликтүү деп эсептелет.
| Модель | Жалпы G2S Recall@1 | Жалпы S2G Recall@1 |
|---|---|---|
| CLIP | 0,327 | 0,161 |
| GeoRSCLIP | 0,360 | 0,209 |
| RemoteCLIP | 0,291 | 0,232 |
| SkyCLIP | 0,126 | 0,167 |
| SenCLIP | 0,362 | 0,306 |
| Llama3-MS-CLIP | 0,218 | 0,167 |
| TimeSenCLIP-P64-RGB, T=1 | 0,416 | 0,460 |
| TimeSenCLIP-P1-RGB, T=1 | 0,331 | 0,331 |
| TimeSenCLIP-P1-MS, T=1 | 0,352 | 0,365 |
| TimeSenCLIP-P1-MS, T=12 | 0,446 | 0,535 |
Айлык бир-пикселдик модель өзгөчө S2G багытында күчтүү. Тапшырмалар боюнча S2G Recall@1: Land Cover 0,660, Land Use 0,682, Habitat 0,433, Crops 0,411, Bioregion 0,634 жана Country 0,392.
Scenicness божомолдоо
Scenicness — пейзаждын адамдар тарабынан кабыл алынган визуалдык кооздугуна тиешелүү үзгүлтүксүз баа. Изилдөө Улуу Британиянын ScenicOrNot маалыматынан 2411 мисалды эң жакын Sen4Map жери менен 100 m ичинде дал келтирген.
Pearson \(R\) божомол менен ground-truth ортосундагы сызыктуу корреляцияны, Kendall \(\tau\) болсо иреттөө шайкештигин өлчөйт. Эки өлчөм тең өлчөмсүз.
| Модель | T | Киргизүү | Late \(R\) | Late \(\tau\) |
|---|---|---|---|---|
| CLIP — жер сүрөтү | 1 | Жер сүрөтү | 0,660 | 0,465 |
| CLIP — satellite | 1 | 64×64 | 0,519 | 0,363 |
| SenCLIP | 1 | 64×64 | 0,421 | 0,283 |
| TimeSenCLIP-RGB | 1 | 64×64 | 0,660 | 0,450 |
| TimeSenCLIP-MS | 1 | 1×1 | 0,318 | 0,205 |
| TimeSenCLIP-MS | 4 | 1×1 | 0,451 | 0,312 |
| TimeSenCLIP-MS | 12 | 1×1 | 0,527 | 0,363 |
Appendix A.1 бөлүмүндө бардык prompt-ensemble стратегияларынын орточосу каралганда TimeSenCLIP-P64-RGB айлык киргизүүдө \(R=0.639\), \(\tau=0.440\); бир-пикселдик P1-MS болсо \(R=0.526\), \(\tau=0.363\) алган. Бул жыйынтык scenicness үчүн убакыттык маалымат жардам берерин, бирок кең мейкиндиктик контекст пейзаж геометриясы жана текстура сыяктуу өзгөчөлүктөрдөн улам өз баалуулугун сактай турганын көрсөтөт.
Классикалык убакыт катары архитектуралары менен салыштыруу
| Модель | Overall C (%) | Overall G (%) | Overall D (%) |
|---|---|---|---|
| Supervised upper bound | 73,70 | – | – |
| CNN1D | 39,04 ± 0,19 | 41,96 ± 0,22 | 44,88 ± 0,15 |
| ConvTran | 40,06 ± 0,24 | 42,76 ± 0,24 | 45,89 ± 0,22 |
| MLP | 41,20 ± 0,24 | 43,89 ± 0,22 | 46,72 ± 0,14 |
| TempCNN | 41,94 ± 0,24 | 43,45 ± 0,22 | 45,41 ± 0,11 |
| Transformer — TimeSenCLIP | 42,02 ± 0,15 | 44,22 ± 0,16 | 47,35 ± 0,18 |
Transformer жалпы орточо көрсөткүчтө эң жогорку жыйынтыкты берген; бирок ар бир тапшырма уячасында атаандашсыз эмес. Мисалы, TempCNN Habitat descriptive promptта %33,37 менен Transformerдин %30,90 көрсөткүчүнөн жогору. Ошондуктан булак “Transformer бардык кошумча тапшырмаларда абсолюттук эң мыкты архитектура” деген дооматты койбойт.
Temporal dropout чындап жардам бердиби?
| T | Temporal Drop | MS Drop | Land Cover | Land Use | Habitat | Bioregion | Crops | Орточо |
|---|---|---|---|---|---|---|---|---|
| 1 | Жок | Жок | 28,69 | 25,86 | 9,52 | 18,68 | 3,23 | 17,20 |
| 1 | Жок | Ооба | 23,76 | 27,88 | 8,39 | 18,18 | 2,93 | 16,23 |
| 1 | Ооба | Жок | 56,32 | 57,83 | 31,29 | 25,30 | 12,61 | 36,67 |
| 1 | Ооба | Ооба | 53,52 | 56,15 | 28,03 | 25,00 | 7,81 | 34,10 |
| 12 | Жок | Жок | 61,72 | 59,76 | 23,43 | 38,71 | 31,82 | 43,09 |
| 12 | Жок | Ооба | 63,12 | 58,77 | 25,15 | 40,47 | 31,14 | 43,73 |
| 12 | Ооба | Жок | 63,63 | 60,03 | 25,54 | 40,24 | 32,23 | 44,34 |
| 12 | Ооба | Ооба | 62,42 | 58,17 | 26,68 | 39,42 | 31,64 | 43,67 |
Бир-убакыттык киргизүүдө temporal dropout орточо тактыкты %17,20 көрсөткүчүнөн %36,67 көрсөткүчүнө көтөргөн. Толук 12 айлык киргизүүдө салымы азыраак: %43,09 көрсөткүчүнөн %44,34 көрсөткүчүнө. Бул жүрүм-турум булактын түшүндүрмөсүнө шайкеш келет; temporal dropout өзгөчө жетишпеген же чектелген убакыт байкоолоруна карата туруктуулукту күчөтөт.
Multispectral dropout болсо жалпысынан ушул даражада пайда берген эмес. Булак муну RGBден тышкаркы тилкелер өсүмдүк жана экосистемаларды айырмалоодо баалуу спектралдык маалымат берери менен байланыштырат.
Retrievalда temporal dropout
Appendix A.3 бөлүмүндө бир-убакыттык \(T=1\) retrieval орточосу temporal dropout жок кезде 0,219 болсо, temporal dropout колдонулганда 0,369 маанисине өскөн. Чейректик киргизүүдө өсүү 0,452 → 0,457 деңгээлине азайган, ал эми айлык киргизүүдө temporal dropout колдонулбаган 0,516 орточо жогору бойдон калган. Ошондуктан regularizerдин эң чоң пайдасы убакыттык маалымат жетишсиз болгон режимде.
Жер сүрөттөрүндө төрт сүрөт керекпи?
Appendix A.4 төрт багыттагы жер сүрөттөрүн average pooling менен бириктирүүнү бир эле туш келди жер сүрөтүн колдонуу менен салыштырган. Жалпы zero-shot Top-1 тактыгы average pooling үчүн %41,30, single image үчүн %41,24. Айырма өтө аз. Булак муну айрым колдонмолордо бир өкүлчүлүктүү жер сүрөтү маалымат чогултуу жана эсептөө талаптарын азайтышы мүмкүн экенин көрсөткөн жыйынтык катары чечмелейт.
Эсептөө натыйжалуулугу
| Модель | FLOPs / GMac | Параметр (M) | Throughput (мисал/s) | Peak Memory (MB) |
|---|---|---|---|---|
| CLIP | 4,46 | 151,28 | 565,33 | 3045,13 |
| TimeSenCLIP 1×1 | 0,105 | 8,17 | 19.530,50 | 584,60 |
| TimeSenCLIP 5×5 | 0,106 | 8,29 | 19.424,24 | 596,32 |
| TimeSenCLIP 9×9 | 0,110 | 8,58 | 19.428,41 | 624,08 |
| TimeSenCLIP 16×16 | 0,121 | 9,48 | 17.798,35 | 709,12 |
Авторлордун эсептөөсүнө ылайык 1×1 TimeSenCLIP стандарттык CLIPке салыштырмалуу FLOPs боюнча болжол менен %97–98, параметрлердин саны боюнча болжол менен %94 азайууну камсыздап, throughput боюнча 33 эседен ашык ылдамдык берет. Бул өлчөөлөр изилдөөнүн өз жабдыгы жана batch-size түзүмүнө тиешелүү; башка GPU же deployment чөйрөсүндө ошол эле сандар кепилденбейт.
Prediction map-тер эмнени көрсөтөт?
Булак Figure 4 жана 5 сүрөттөрүндө айлык Sentinel-2 убакыт катарын ар бир пикселге өз алдынча колдонуу менен LULC жана crop prediction map-терин түзөт. LUCAS ground-truth энбелгисин борбордук чекит үчүн гана бергендиктен, бул карталар толук пиксел деңгээлиндеги segmentation ground truth менен тастыкталган эмес.
Карталарда чоң аймактар семантикалык жактан ырааттуу көрүнгөнү менен, коңшу пикселдер арасында жергиликтүү “salt-and-pepper” класс алмашуулар бар. Булак мунун себебин модель ар бир пикселди өз алдынча классификациялап, spatial smoothing post-processing колдонулбаганы менен түшүндүрөт.
Булак Figure A.4 ичиндеги confusion matrix-тер да каталардын маанилүү бөлүгү семантикалык же түзүмдүк жактан окшош класстар арасында топтолорун көрсөтөт. Мисалы, crop класстарында буудай жана арпа сыяктуу фенологиялык жактан жакын дан өсүмдүктөрү, Land Coverда shrubland жана woodland, habitatтарда болсо өсүмдүк түзүлүшү окшош grassland жана айыл чарба класстары бири-бири менен чаташышы мүмкүн.
Изилдөө түздөн-түз колдогон жыйынтыктар
- Sentinel-2 спутнигинин көп спектрдүү убакыттык өзгөрүүлөрү zero-shot алыстан зонддоо тапшырмаларында күчтүү өкүлчүлүк булагы болуп саналат.
- 12 айлык бир-пикселдик TimeSenCLIP-P1-MS салыштырылган CLIP негизиндеги моделдерге караганда жалпы zero-shot классификацияда жогорураак жыйынтык берген.
- Temporal depth өзгөчө өсүмдүк жана bioregion сыяктуу фенологияга көз каранды класстарда чоң салым кошкон.
- Мультиспектралдык тилкелер RGBге салыштырмалуу айрыкча Land Cover жана Crops тапшырмаларында кошумча маалымат берген.
- Мейкиндиктик контексттин салымы тапшырмага жараша болот; Habitat, Land Cover/Use жана scenicness сыяктуу тапшырмаларда кеңирээк patch пайдалуу болушу мүмкүн.
- Temporal dropout өзгөчө жетишпеген же бир-убакыттык байкоолордо туруктуулукту олуттуу жогорулаткан.
- Бир-пикселдик архитектура CLIP негизиндеги чоң encoder-лерге караганда кыйла төмөн эсептөө жана эс тутум чыгымы менен иштеген.
- Ground-to-Satellite жана Satellite-to-Ground retrieval жыйынтыктары убакыт катары embedding-дерин жер сүрөтүнүн семантикасы менен маанилүү түрдө шайкеш келтирүүгө болорун көрсөтөт.
Изилдөө колдобогон жалпылоолор жана чектөөлөр
- Модель Sentinel-2 жана Европа Биримдиги/LUCAS контекстинде гана бааланган; башка континенттерде, климаттарда жана сенсорлордо ушундай эле көрсөткүч далилденген эмес.
- Бир пиксел бардык тапшырмаларда чоң patchтин ордун баспайт.
- Habitat жана scenicness сыяктуу мейкиндиктик түзүлүштү талап кылган маселелерде кең контекст маанисин сактайт.
- Prediction map-тер толук segmentation ground truth менен бааланган эмес; LUCAS ground truth борбордук үлгү чекитин гана берет.
- CLIPтин өз семантикалык мейкиндиги интернет сүрөттөрү жана caption-дардан үйрөнүлгөндүктөн, убакыт ичинде гана байкалуучу айрым өзгөчөлүктөр ground-image embedding-де болбошу мүмкүн.
- Ар башка сенсорлорду, өзгөчө Sentinel-1 + Sentinel-2 сыяктуу multisensor айкалыштарын колдонуу бул изилдөөдө тастыкталган эмес.
- Глобалдык деңгээлдеги ground-level сүрөт булактары менен окутуу — келечектеги изилдөө багыты.
- Өсүмдүк жана habitat сыяктуу көп класстуу жана семантикалык жактан бири-бирине жакын тапшырмаларда supervised upper bound менен zero-shot модель ортосунда дагы деле олуттуу көрсөткүч айырмасы бар.
Келечектеги изилдөө
Авторлор TimeSenCLIPти башка сенсорлорго жана ар кандай климат/фенология аймактарына кеңейтүүнү, Sentinel-1 жана Sentinel-2 сыяктуу бир нече сенсорду чогуу колдонууну жана Европадан тышкаркы географиялардан кеңири жер сүрөтү жыйнактарын окутуу процессине кошууну маанилүү келечек багыттары катары белгилешет.
Булак ошондой эле CLIP жер сүрөтү өкүлчүлүктөрү убакыт боюнча байкалган айрым айлана-чөйрөлүк өзгөчөлүктөрдү камтыбашы мүмкүн экенин белгилеп, бул боштукту географиялык жерге байланышкан тексттик түшүндүрмөлөр сыяктуу кошумча семантикалык булактар менен толуктоону сунуштайт.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска аталыш: TimeSenCLIP: A time series vision–language model for remote sensing
Авторлор: Pallavi Jain; Diego Marcos; Dino Ienco; Roberto Interdonato; Tristan Berchoux.
Жооптуу автор: Pallavi Jain.
Мекемелер: Mediterranean Agronomic Institute of Montpellier – CIHEAM-IAMM; Inria; INRAE; Cirad; UMR TETIS; University of Montpellier, Франция.
Журнал: ISPRS Journal of Photogrammetry and Remote Sensing.
Басма: Elsevier B.V., International Society for Photogrammetry and Remote Sensing (ISPRS) атынан.
Библиографиялык жазуу: Volume 236 (2026), 99–119.
DOI: 10.1016/j.isprsjprs.2026.03.043
Расмий шилтеме: https://doi.org/10.1016/j.isprsjprs.2026.03.043
Тапшырылган: 14 Август 2025. Ревизия: 20 Февраль 2026. Кабыл алуу: 26 Март 2026. Томдун датасы: Июнь 2026.
Булактын түрү: Рецензияланган эксперименталдык машина үйрөнүүсү / алыстан зонддоо боюнча изилдөө макаласы.
Лицензия: Creative Commons Attribution 4.0 (CC BY 4.0).
Маалымат жана код: Макала LUCAS, Sen4Map, EUNIS/EEA жана ScenicOrNot сыяктуу учурдагы маалымат булактарын колдонот. TimeSenCLIP коду https://github.com/pallavijain-pj/TimeSenCLIP дарегинде жарыялангандыгы булак кыскачасында көрсөтүлгөн.
Каржылоо/колдоо: Изилдөө “Giving Rural Actors Novel Data and Re-Usable Tools to Lead Public Action in Rural Areas” (GRANULAR) долбоору аркылуу European Union Horizon Europe Research and Innovation Programme, Grant Agreement No. 101061068 тарабынан; ошондой эле ANR OBTEA долбоору (ANR-22-CPJ1-0054-01) жана University of Montpellier I-SITE Excellence Program / Investissements France 2030 алкагында колдоого алынган.
Кызыкчылыктардын кагылышы: Авторлор изилдөөгө таасир этиши мүмкүн болгон белгилүү атаандаш финансылык кызыкчылык же жеке мамиле жок экенин билдиришкен.
AI менен колдоого алынган жазуу билдирүүсү: Авторлор макаланы даярдоодо сүйлөм түзүлүшүн жана грамматиканы жакшыртуу үчүн LLM колдонушканын, акыркы мазмунду өздөрү карап чыгып оңдогонун жана жоопкерчилигин өздөрүнө алганын билдиришкен.
Авторлордун салымы: Pallavi Jain: биринчи долбоор, карап чыгуу/редакциялоо, визуалдаштыруу, текшерүү, методология, изилдөө, формалдык анализ, маалымат курациясы жана концептуалдаштыруу. Diego Marcos: карап чыгуу/редакциялоо, жетекчилик, ресурстар, методология, каржылоо алуу жана концептуалдаштыруу. Dino Ienco: карап чыгуу/редакциялоо, жетекчилик жана ресурстар. Roberto Interdonato: карап чыгуу/редакциялоо, жетекчилик жана ресурстар. Tristan Berchoux: карап чыгуу/редакциялоо, жетекчилик, ресурстар, долбоорду башкаруу жана каржылоо алуу.
Булактагы отчеттук эскертүү 1: Негизги метод кыскачасында көп багыттуу ground-level image embedding-дери attention pooling менен бириктирилет деп айтылса, толук архитектуралык түшүндүрмө жана Appendix A.4.3 average pooling колдонот. Булак бул эки сөз айкашын өзүнчө шайкеш келтирбейт.
Булактагы отчеттук эскертүү 2: Dataset түшүндүрмөсү Level-1 ичинде 38 specific crop type бар деп айтса, 2-таблица “Crops — 40 classes” деп билдирет. Verianla эки санды үн катпай бириктирген эмес.
Негизги методологиялык чектөө: TimeSenCLIPтин билдирилген жалпылоо ийгилиги Sentinel-2 жана Европага багытталган LUCAS/Sen4Map баалоо чөйрөсүнө тиешелүү. Башка сенсор, континент, климат жана фенологиялык режимдерге cross-domain өткөрүү бул изилдөөдө түздөн-түз тастыкталган эмес.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген