


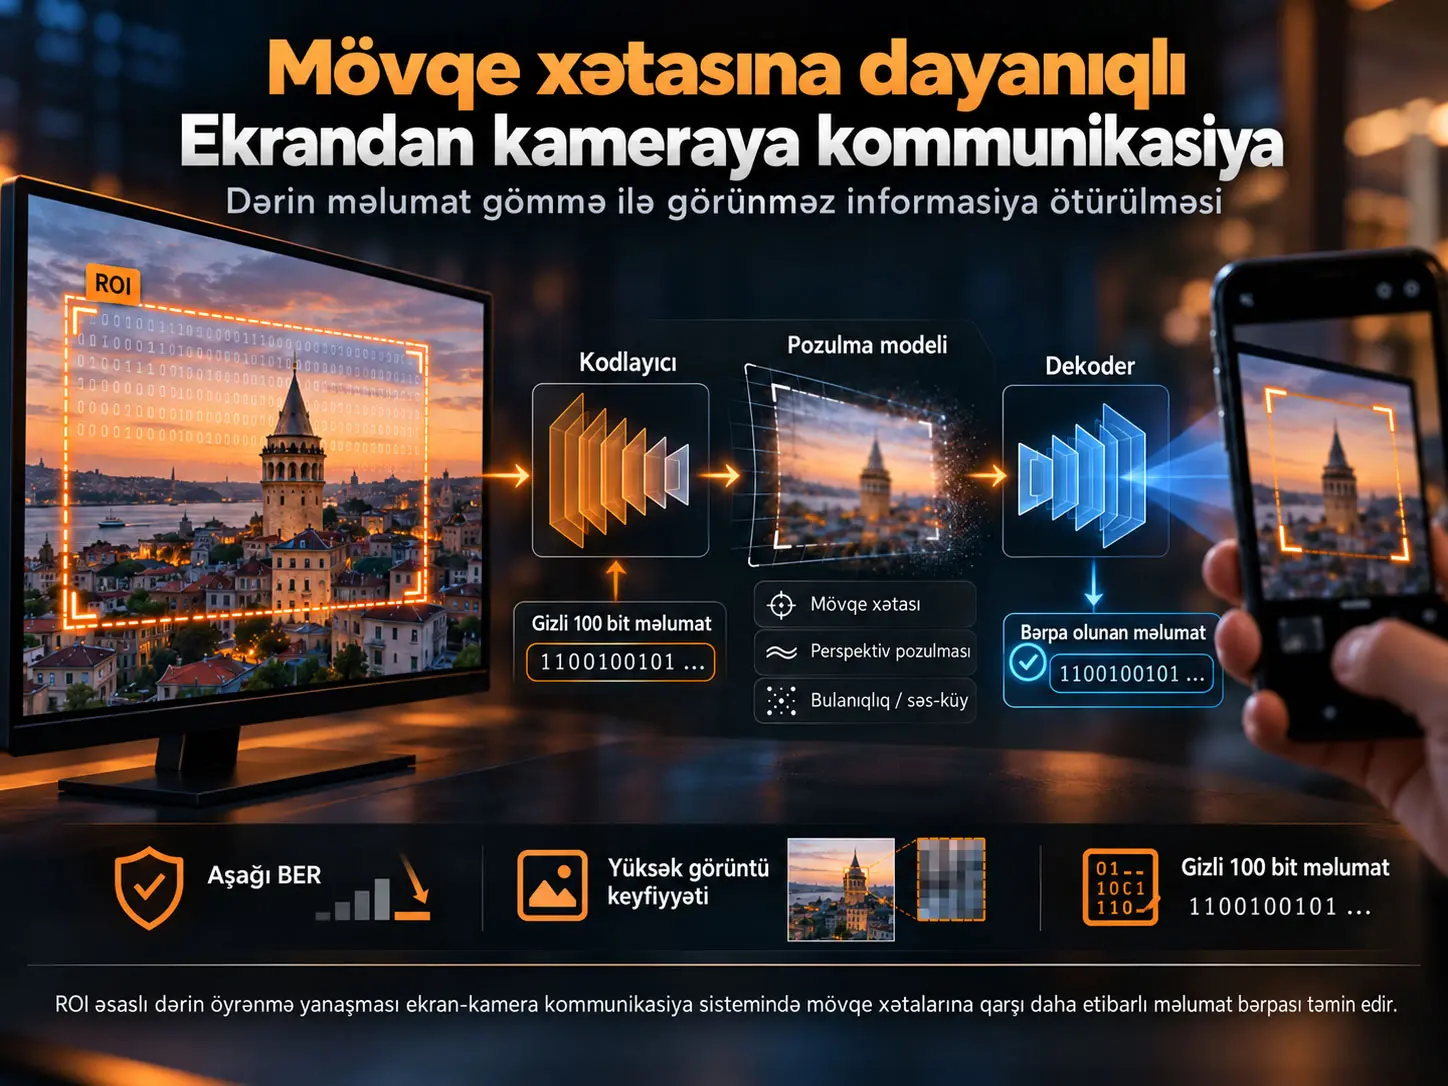
Ekrandan kameraya rabitə (Display-to-Camera Communication, D2C), elektron ekranda göstərilən vizual məzmuna rəqəmsal məlumatın yerləşdirilməsi və bu məlumatın kamera tərəfindən görüntülənərək geri çıxarılması prinsipi ilə işləyən optik rabitə yanaşmasıdır. Dae-Gyu Lee, Pankaj Singh və Sung-Yoon Jung tərəfindən hazırlanmış bu tədqiqat D2C sistemlərində obyekt aşkarlanması və təsvirin kəsilməsi mərhələlərindən qaynaqlanan mövqeləndirmə xətalarına qarşı dayanıqlılığı artırmaq üçün maraq sahəsi (Region of Interest, ROI) əsaslı, ucdan-uca dərin məlumat yerləşdirmə çərçivəsi təklif edir. Encoder təsvirlə ikili verilənləri çoxmiqyaslı xüsusiyyət xəritələrində birləşdirərkən, decoder daha yığcam konvolyusiya quruluşu vasitəsilə məlumatı geri çıxarır. Model JPEG sıxılması, rəng dəyişmələri, hərəkət bulanıqlığı, defocus, perspektiv təhrif və sensor səs-küyü kimi kanal təsirləri ilə birlikdə öyrədilmişdir.
Mənbədə 100 bitlik məlumat yükü ilə aparılmış əsas müqayisədə təklif edilən model PSNR = 31,3438 dB, SSIM = 0,9605 və BER = %0,0080 əldə etmiş; StegaStamp üçün eyni göstəricilər 28,6677 dB, 0,9170 və %0,0879 kimi bildirilmişdir. Mövqeləndirmə xətası artdıqda da təklif edilən ROI yanaşması daha aşağı BER göstərmişdir. Məsələn, mövqe pozuntusunun standart sapması σl = 5 olduqda təklif edilən modelin BER-i %0,0550, StegaStamp-in BER-i isə %0,2240 olmuşdur.
Tədqiqat həmçinin real ekran-kamera bağlantısını LG monitor və Samsung Galaxy S22+ ilə nəzarət olunan qapalı məkanda sınaqdan keçirmişdir. Təklif edilən yanaşma 20–40 cm məsafədə və 0°–45° perspektiv dəyişmələrində StegaStamp-dən daha aşağı xəta yaratmışdır. Bununla belə, bu nəticələr bir avadanlıq konfiqurasiyası və nəzarət olunan işıqlandırma şəraiti ilə məhdudlaşır; fərqli cihazlar, əllə çəkiliş, açıq mühit, dəyişən işıq və daha geniş məsafə diapazonları üçün əlavə yoxlama tələb olunur.
Ekrandan Kameraya (D2C) Rabitə Nədir?
Ekrandan kameraya rabitə ekranda görünən daşıyıcı təsvirin eyni vaxtda insan tərəfindən izlənməsini və onun daxilində yerləşdirilmiş rəqəmsal məlumatın kamera tərəfindən aşkar edilərək dekodlanmasını təmin edən optik kamera rabitəsi yanaşmasıdır; bu tədqiqatda məqsəd açıq QR kodu əvəzinə təsvirin vizual bütövlüyünü böyük ölçüdə qoruyan dərin öyrənmə əsaslı məlumat yerləşdirmə və geri çıxarma üsulundan istifadə etməkdir.
QR koddan görünməz məlumat yerləşdirməyə
QR kodlar D2C rabitəsinin ən tanınmış formalarından biridir; lakin yüksək kontrastlı qara-ağ modullar, finder pattern-lər və açıq kod həndəsəsi daşıyıcı təsvirin dizaynını məhdudlaşdırır. QR kodun mövcudluğu həmçinin müşahidəçiyə təsvir daxilində maşın tərəfindən oxuna bilən məlumat olduğunu birbaşa göstərir.
Dərin məlumat yerləşdirmə yanaşmaları fərqli məqsəd güdür. İkili məlumat daşıyıcı təsvirin daxilində insan gözü üçün mümkün qədər az nəzərə çarpan dəyişikliklərlə təmsil olunur. Kamera təsviri yenidən çəkdikdə neural decoder bu gizli nümunəni geri çıxarmağa çalışır.
Bu proses sadəcə rəqəmsal təsvir faylının başqa kompüterə köçürülməsi deyil. Ekran → optik mühit → kamera zənciri işə düşdükdə perspektiv, fokus, hərəkət, ekranın rəng xarakteristikası, sensor səs-küyü və təsvirin yanlış yerdən kəsilməsi kimi əlavə pozucu təsirlər meydana çıxır. Ədəbiyyatda rəqəmsal dünyadan fiziki dünyaya keçid problemi çox vaxt “analog hole” kontekstində nəzərdən keçirilir.
Tədqiqatın həll etməyə çalışdığı əsas boşluq
Əvvəlki dərin öyrənmə əsaslı D2C üsulları səs-küy, sıxılma, perspektiv və bulanıqlıq kimi pozuntulara dayanıqlılığı əhəmiyyətli dərəcədə yaxşılaşdırmışdır. Lakin praktik sistemdə decoder-a hansı təsvir sahəsinin veriləcəyini əvvəlcə obyekt aşkarlama və ya lokallaşdırma sistemi müəyyən etməlidir.
Real kamera kadrında ekranın küncləri bir neçə piksel yanlış müəyyən edilərsə, kəsilmiş təsvir düzgün sərhədlər daxilində qalmaya bilər. Sərhəddən kənara çıxan crop decoder-a ekranın xaricindəki fon piksellərini verir. Əks istiqamətdəki xəta isə təsvirin real daxili hissəsində məlumat daşıyan pikselləri kəsə bilər.
Buna görə tədqiqatın əsas problemi yalnız “səs-küyə davamlı gizli məlumat” deyil. Əsas sual upstream obyekt aşkarlama mərhələsi qüsursuz olmayan D2C sistemində məlumat necə etibarlı şəkildə geri çıxarıla bilər? sualıdır.
ROI Əsaslı Məlumat Yerləşdirmə Mövqeləndirmə Xətalarına Niyə Daha Dayanıqlıdır?
ROI əsaslı yanaşma ikili məlumat yükünü təsvirin həssas xarici sərhədlərinədək yaymaq əvəzinə, kənarlardan müəyyən təhlükəsizlik marjı ilə ayrılmış sabit daxili bölgədə cəmləşdirir; beləliklə, aşkarlanmış ekran sərhədi bir neçə piksel xaricə və ya daxilə sürüşdükdə decoder-ın fon piksellərinə çıxış etməsi və ya məlumat daşıyan kritik daxili pikselləri itirməsi ehtimalı azalır.
%1-lik kənar tamponu
Mənbə üsulunda ROI marjı təsvirin hündürlüyü və eninin dəqiq %1-i kimi müəyyən edilmişdir. 400 × 400 × 3 giriş təsvirində hər kənardan 4 piksel ayrılır. Nəticədə effektiv məlumat yerləşdirmə sahəsi:
392 × 392 × 3
ölçüsünə gəlir.
Bu tənzimləmənin məqsədi yalnız daha kiçik təsvir istifadə etmək deyil. Marj lokallaşdırma və perspektiv xətalarının ən çox təsir etdiyi xarici sərhədlərlə yerləşdirilmiş məlumat yükü arasında həndəsi tampon yaradır.
Overshooting və undershooting xətaları
Mənbə lokallaşdırma xətalarının iki əsas uğursuzluq forması yaratdığını izah edir. Overshooting, aşkarlanmış sərhədin real ekran sahəsinin xaricinə daşması və decoder-ın fon piksellərini görməsidir. Undershooting isə sərhədin lazım olandan artıq içəri çəkilməsi və məlumat daşıyan real təsvir piksellərinin itirilməsidir.
ROI məlumat yükünü xarici kənardan uzaqlaşdırdığı üçün hər iki xəta formasına qarşı həndəsi tolerantlıq təmin edir. Bu yanaşma mövqeləndirmə xətasını aradan qaldırmır; məqsəd decoder-ın müəyyən böyüklükdə xətalara həssaslığını azaltmaqdır.
Təklif edilən sistemin ümumi emal zənciri
| Mərhələ | Əməliyyat | Elmi vəzifəsi |
|---|---|---|
| 1 | Orijinal təsvir + L-bit məlumat | Daşıyıcı təsvirlə ötürüləcək ikili mesajın sistemə verilməsi |
| 2 | ROI-nin ayrılması | Qeyri-sabit təsvir kənarlarından %1 təhlükəsizlik marjının saxlanılması |
| 3 | Məlumatın FC qatında yenidən formalaşdırılması | İkili mesajın təsvir məkanı ilə birləşdirilə bilən tenzora çevrilməsi |
| 4 | Encoder | Təsvir və məlumat xüsusiyyətlərindən residual image yaradılması |
| 5 | Residual + orijinal təsvir | Vizual olaraq yüksək oxşarlığa malik encoded image yaradılması |
| 6 | Pozuntu modeli | Fiziki ekran-kamera kanalındakı pozuntuların təlim zamanı təqlid edilməsi |
| 7 | ROI-nin ayrılması | Decoder-ın məlumat daşıyan sabit daxili sahəyə fokuslanması |
| 8 | Decoder | Təsvir xüsusiyyətlərinin kiçildilərək L-bit mesajın geri çıxarılması |
İkili məlumat təsvir məkanına necə ötürülür?
Encoder-a daxil olan L-bit binary string əvvəlcə fully connected (FC) qatı ilə 7500 × 1 vektora proyeksiya edilir. Bu vektor daha sonra:
50 × 50 × 3
tenzoruna yenidən formalaşdırılır. Tenzor pixel replication istifadə edilərək daşıyıcı təsvirin H × W × 3 fəza ölçüsünə yüksəldilir.
ROI əməliyyatı və zero padding-dən sonra təsvirlə məlumat tenzoru channel ölçüsü üzrə birləşdirilərək:
H × W × 6
ölçülü birləşdirilmiş giriş yaradılır.
Encoder-ın expansion–preservation–contraction arxitekturası
Encoder üç funksional yol ehtiva edir. Expansion pathway, transposed convolution qatları ilə xüsusiyyət xəritələrinin fəza ölçüsünü böyüdür. Məqsəd təsvir və məlumat xüsusiyyətlərini müxtəlif miqyaslarda birləşdirməkdir.
Preservation pathway, convolution əməliyyatları ilə kritik xüsusiyyətləri qorumağa çalışır. Contraction pathway isə pooling və convolution qatları ilə böyüdülmüş xüsusiyyətləri yenidən orijinal təsvir həllinə endirir.
Erkən və gec qatlar arasındakı skip connection ilkin xüsusiyyətlərin sonrakı qatlarda yenidən istifadəsinə imkan verir. Encoder-ın son çıxışı birbaşa yekun təsvir deyil; əvvəlcə üçkanallı residual image yaradılır. Bu residual təsvir orijinal daşıyıcıya əlavə edilərək encoded image əldə olunur.
| Bölmə | Əsas quruluş | Mənbədə bildirilən funksiya |
|---|---|---|
| Expansion | 6 transposed convolution qatı | Xüsusiyyət xəritəsini genişləndirərək təsvir-məlumat birləşməsini çoxmiqyaslı hala gətirmək |
| Preservation | Convolution + max pooling | Mühüm vizual/məlumat xüsusiyyətlərini qorumaq |
| Contraction | Convolution qatları | Fəza ölçülərini yenidən 400 × 400-ə endirmək |
| Skip connection | Erkən və gec qat bağlantısı | İlkin xüsusiyyətlərin sonrakı mərhələlərdə yenidən istifadəsini təmin etmək |
| Çıxış | 400 × 400 × 3 residual image | Orijinal təsvirə əlavə ediləcək incə dəyişiklikləri yaratmaq |
Decoder niyə “thin” quruluşdan istifadə edir?
Decoder-ın vəzifəsi vizual yaratmaq deyil, encoded image daxilindəki ikili nümunəni mümkün qədər səmərəli şəkildə geri çıxarmaqdır. Buna görə arxitektura feature map ölçülərini mərhələli şəkildə kiçildən daha yığcam quruluşdan istifadə edir.
Decoder altı convolution qatından, iki average pooling əməliyyatından və bir FC qatından ibarətdir. İlk üç convolution qatında stride 1, sonrakı üçündə stride 2 istifadə olunur. Convolution qatları padding olmadan işlədilir və ReLU aktivləşdirmələri tətbiq olunur.
392 × 392 × 3 ROI girişi mərhələli şəkildə kiçildilərək son convolution çıxışında 10 × 10 × 64 xüsusiyyət xəritəsinə çatır. FC qatı sigmoid aktivləşdirmə ilə 100 çıxış yaradır. Son mərhələdə 0,5 binary threshold tətbiq edilərək orijinal 100 bitlik ardıcıllığın təxmini əldə olunur.
Fiziki kanal hansı pozuntularla modelləşdirilir?
Tədqiqat pozuntuları ekran tərəfi və kamera tərəfi olmaqla iki qrupa ayırır.
| Tərəf | Pozuntu | Mənbədə istifadə olunan diapazon |
|---|---|---|
| Ekran | JPEG sıxılması | Quality factor Q = 50–100 |
| Ekran | Kontrast | 0,5–1,5 miqyaslama |
| Ekran | Parlaqlıq | Maksimum ±0,3 sürüşdürmə |
| Ekran | Hue | Maksimum ±0,1 sürüşdürmə |
| Ekran | Saturation | 0,0–1,0 desaturation amili |
| Kamera | Motion blur | 7 × 7 linear blur; σ = 0,25–1,0 |
| Kamera | Defocus | 7 × 7 Gaussian blur; σ = 1,0–3,0 |
| Kamera | Perspective warping | Random homography; maksimum ±%10 translation scale |
| Kamera | Internal sensor noise | Additive white Gaussian noise; μ = 0, σ = 0–0,02 |
Defocus blur və motion blur təlim nümunələrinə ayrı-ayrılıqda %25 ehtimalla tətbiq edilmişdir. Qalan %50-lik hissə bulanıqlıq tətbiq edilmədən saxlanılmışdır. Bu seçim modelin yalnız blur olan təsvirlərə uyğunlaşmasının qarşısını alaraq onu müxtəlif kanal vəziyyətlərinə məruz qoymağı hədəfləyir.
İtki funksiyası hansı məqsədləri tarazlaşdırır?
Model encoder və decoder-ı ucdan-uca birgə öyrədir. Mənbədə ümumi məqsəd funksiyası:
\[ L_{\mathrm{total}} = \lambda_1 L_{\mathrm{LPIPS}} + \lambda_2 L_{2} + \lambda_3 L_{\mathrm{DATA}} + \lambda_4 L_{\mathrm{GAN}} \tag{1} \]
kimi müəyyən edilmişdir.
\(L_{\mathrm{LPIPS}}\), orijinal və encoded təsvirin perceptual xüsusiyyətləri arasındakı oxşarlığı qorumağa çalışır. \(L_2\), YUV rəng məkanındakı piksel səviyyəli fərqi cəzalandıraraq struktur/vizual sədaqəti dəstəkləyir.
\(L_{\mathrm{DATA}}\), orijinal L-bit mesaj ilə decoder-ın bərpa etdiyi çıxış arasındakı binary cross-entropy itkisidir. Məlumatın geri çıxarılma dəqiqliyinin əsas təlim komponentidir.
\(L_{\mathrm{GAN}}\), Wasserstein Generative Adversarial Network discriminator komponentidir və encoded təsvirin mənbə təsvirlərindən statistik baxımdan asanlıqla fərqləndirilə bilməməsini təşviq etməyi hədəfləyir.
Təlimdə çəki nisbəti:
λ1 : λ2 : λ3 : λ4 = 1,5 : 2 : 1,5 : 0,5
kimi istifadə edilmişdir. Bu çəkilər təsvir keyfiyyəti, məlumatın geri çıxarılması və adversarial məqsəd arasındakı optimallaşdırma tarazlığını müəyyən edir.
WGAN komponentinin mövcudluğu sistemin bütün steganalysis hücumlarına qarşı təhlükəsiz olduğunu təkbaşına sübut etmir. Tədqiqat hərtərəfli müstəqil steganalysis qiymətləndirməsi təqdim etmir.
Gaussian blur ilə kernel ölçüsü arasındakı əlaqə
Tədqiqatın ikinci tənliyi Gaussian blur standard deviation dəyəri ilə təxmini kernel ölçüsü arasındakı əlaqəni verir:
\[ k \approx 6\sigma_b+1 \tag{2} \]
Burada \(k\) blur kernel-inin kənar uzunluğunu, \(\sigma_b\) isə Gaussian blur standard deviation dəyərini ifadə edir. Mənbə \(k\)-nın tək ədəd olmalı olduğunu bildirir. Təcrübələrdə 3 × 3, 5 × 5, 7 × 7 və 9 × 9 kernel ölçüləri qiymətləndirilmişdir.
Tədqiqatın Metodu və Nəticələri
Təlim konfiqurasiyası
| Parametr | Dəyər |
|---|---|
| Təlim məlumat dəsti | MIRFLICKR |
| Təsvir ölçüsü | 400 × 400 × 3 |
| Standart məlumat yükü | 100 bit |
| Ümumi təlim addımı | 160.000 |
| Başlanğıc decoder-only təlimi | İlk 2000 addım; əsas məlumat geriçıxarma dəqiqliyi >%95 hədəfi |
| Batch size | 2 |
| Learning rate | 10−4 |
| Total-loss optimizer | Adam |
| WGAN critic optimizer | RMSProp |
| Loss çəkiləri | 1,5 : 2 : 1,5 : 0,5 |
| Təlim avadanlığı | NVIDIA GeForce RTX 3060 |
Test məlumat dəsti və fiziki təcrübə
Ümumi təsvir keyfiyyəti və məlumatın geri çıxarılmasının qiymətləndirilməsi üçün MS COCO-dan təsadüfi seçilmiş 10.000 təsvir istifadə edilmişdir. Rəqəmsal qiymətləndirməyə əlavə olaraq, təsvirlər real monitorda göstərilmiş və smartfon kamerası ilə yenidən çəkilmişdir.
| Komponent | Mənbədə bildirilən xüsusiyyət |
|---|---|
| Ekran | LG monitor |
| Ekran həlli | 2560 × 1080 piksel |
| Ekranın yenilənmə tezliyi | 60 Hz |
| Kamera | Samsung Galaxy S22+ |
| Kamera həlli | 1920 × 1080 piksel |
| Kamera kadr tezliyi | 30 fps |
| Zoom | 0,6 |
| İşıqlandırma | Standart qapalı məkan tavan işıqlandırması |
| Məsafə sınağı | 20–40 cm |
| Bucaq sınağı | 30 cm sabit məsafədə 0°–45° perspektiv dəyişmələri |
BER, PSNR və SSIM Bu Tədqiqatda Nəyi Ölçür?
BER bərpa edilmiş ikili mesajdakı bit xətalarının nisbətini və beləliklə rabitənin etibarlılığını ölçür; aşağı BER daha yaxşı məlumat geriçıxarma deməkdir. PSNR orijinal və encoded təsvir arasındakı piksel səviyyəli pozuntunun böyüklüyünü dB ilə qiymətləndirir və yüksək dəyər üstün hesab olunur. SSIM isə təsvirlərin struktur oxşarlığını qiymətləndirir və 1-ə yaxın dəyərlər daha yüksək struktur oxşarlığını göstərir.
Əsas StegaStamp müqayisəsi
| Üsul | PSNR (dB) | SSIM | BER |
|---|---|---|---|
| StegaStamp | 28,6677 | 0,9170 | %0,0879 |
| Təklif edilən model | 31,3438 | 0,9605 | %0,0080 |
Təklif edilən üsul hər üç metrikdə StegaStamp-dən daha yaxşı nəticə vermişdir. Mənbə BER-də azalmanı %90,90 kimi bildirir. Təsvir keyfiyyətindəki artım PSNR-də 2,6761 dB və SSIM-də 0,0435 fərq kimi verilmişdir.
Gaussian noise altında performans
Gaussian noise təcrübələrində SNR azaldıqca BER yüksəlmişdir. Bu gözlənilən meyl siqnaldakı səs-küy miqdarının artması ilə decoder-ın yerləşdirilmiş bit nümunəsini ayırmasının çətinləşməsi ilə əlaqələndirilmişdir.
SNR = 25 dB nöqtəsində StegaStamp təxminən %0,22 BER göstərdiyi halda təklif edilən model təxminən %0,11 BER əldə etmişdir. Mənbə bu fərqi %48,97 etibarlılıq yaxşılaşması kimi ifadə edir.
SNR 30 dB-dən yuxarı qalxdıqda təklif edilən modelin BER-i StegaStamp-lə müqayisədə mənbədə %85–91 daha aşağı göstərilir. SNR 20 dB-dən aşağı olan yüksək səs-küy rejimində hər iki model nəzərəçarpacaq dərəcədə pisləşir.
Gaussian blur altında performans
| Üsul | 3 × 3, σ=0,3 | 5 × 5, σ=0,6 | 7 × 7, σ=1,0 | 9 × 9, σ=1,2 |
|---|---|---|---|---|
| StegaStamp | %0,0868 | %0,0693 | %0,0664 | %0,0665 |
| Təklif edilən model | %0,0079 | %0,0076 | %0,0095 | %0,0103 |
Təklif edilən model 3 × 3 və 5 × 5 blur şəraitində çox aşağı BER-i qorumuş, 7 × 7 və 9 × 9-da xəta nisbəti yüksəlməyə başlamışdır. Mənbə 9 × 9 maksimum sınaq bulanıqlığında belə təklif edilən modelin BER-inin StegaStamp-dən %84,51 daha aşağı olduğunu bildirir.
Hər iki modelin bəzi orta intensivlikli blur şəraitində pozuntusuz vəziyyətlə müqayisədə daha yaxşı məlumat geriçıxarma göstərməsi diqqətəlayiqdir. Müəlliflər bunu blur-un təlim distortion pipeline-ında olması və şəbəkələrin bu pozuntuya xüsusi hazırlanması ilə izah edirlər.
Obyekt aşkarlama mövqeləndirmə xətasının empirik ölçülməsi
Mövqeləndirmə xətası simulyasiyasının realistik miqyasını müəyyən etmək üçün BiSeNet obyekt aşkarlama modeli 10.000 təsvir üzərində qiymətləndirilmişdir. Mövqeləndirmə xətası 10 piksel və ya daha az olduqda aşkarlama uğurlu hesab edilmiş və uğur nisbəti %81,28 kimi bildirilmişdir.
Uğurlu aşkarlamalarda x və y oxlarındakı xəta ortalamaları müvafiq olaraq 0,687 və 0,178 piksel; standart sapmalar isə 2,719 və 2,665 piksel olmuşdur.
Bu müşahidələrə əsasən təsvirin dörd sərhəd küncü x və y oxlarında müstəqil normal paylanmış mövqeləndirmə xətaları ilə perturbe edilmişdir.
Mövqeləndirmə xətasına dayanıqlılıq
| Üsul | μl=0, σl=0 | μl=0, σl=3 | μl=0, σl=5 |
|---|---|---|---|
| StegaStamp | %0,0879 | %0,1293 | %0,2240 |
| Təklif edilən model | %0,0080 | %0,0109 | %0,0550 |
Təklif edilən sistemin BER-i σl = 0-dan 5-ə yüksəldikcə artır; buna görə ROI mövqeləndirmə xətasını tam aradan qaldırmır. Buna baxmayaraq, artım StegaStamp-lə müqayisədə xeyli məhduddur.
Mənbə σl = 3 üçün StegaStamp-lə müqayisədə %91,57 BER azalması, σl = 5 üçün isə %75,45 yaxşılaşma bildirir. Bundan əlavə, σl = 5 şəraitindəki %0,0550 BER, StegaStamp-in mövqeləndirmə xətası olmayan %0,0879 dəyərindən də aşağıdır.
Real kamera məsafəsinin təsiri
Real ekran-kamera təcrübəsində məsafə 20 cm-dən 40 cm-ə artırılmışdır. Təsvirin kamera sensorundakı fəza izi kiçildiyi üçün nümunələmə həlli azalır və BER yüksəlir.
Mənbə təklif edilən sistem üçün 20 cm-də BER = 0,0003, 30 cm-də BER = 0,0009 və 40 cm-də BER = 0,0053 dəyərlərini bildirir. 20 cm-də xəta azalması StegaStamp-lə müqayisədə %89,29, 40 cm-də üstünlük isə %65,13 kimi verilir.
Bu bölmədə mənbə BER dəyərlərini faiz işarəsi olmadan verdiyi üçün Verianla mətni onları avtomatik olaraq faizə çevirməmişdir.
Perspektiv bucağının təsiri
Kamera–ekran məsafəsi 30 cm-də sabit saxlanılmış və kamera bucağı 0°-dən 45°-yə qədər dəyişdirilmişdir. Bucaq böyüdükcə perspective warping və piksel uyğunlaşdırma xətaları artdığı üçün hər iki sistemin BER-i yüksəlmişdir.
Təklif edilən model 0°-də BER = 0,0009 və 45° sağ rotasiyada maksimum BER = 0,0035 göstərmişdir. StegaStamp üçün 0° dəyəri 0,0052, 45° sol rotasiyadakı dəyər isə 0,0193 kimi bildirilmişdir.
Müəlliflər bu fərqi ROI-nin kənar nonlinearity və localization jitter təsirlərinə qarşı tampon yaratması və çoxmiqyaslı encoder/yığcam decoder arxitekturasının məlumat xüsusiyyətlərini qoruması ilə əlaqələndirirlər.
Məlumat yükü artdıqda nə baş verir?
| Metrik | 50 bit | 100 bit | 200 bit |
|---|---|---|---|
| PSNR (dB) | 31,3525 | 31,3438 | 29,4619 |
| SSIM | 0,9609 | 0,9605 | 0,9458 |
| BER | %0,0072 | %0,0080 | %0,1106 |
50 bitdən 100 bitə keçiddə təsvir keyfiyyəti və BER yalnız kiçik dəyişikliklər göstərir. Əvəzində 200 bitlik məlumat yükü həm təsvir sədaqətini, həm də məlumat geriçıxarma uğurunu nəzərəçarpacaq dərəcədə azaldır.
Mənbə 200 bitdəki %0,1106 BER-in 100 bitlik %0,0080 dəyərindən təxminən 13,8 dəfə yüksək olduğunu bildirir. Daha yüksək məlumat sıxlığı daşıyıcı təsvir üzərində daha güclü dəyişikliklər tələb etdiyi üçün görünməzliklə məlumatın ayrılması arasındakı tarazlıq pisləşir.
Buna görə tədqiqat özünün araşdırdığı arxitektura və şəraitdə performans–tutum tarazlığı üçün 100 biti seçmişdir. Bu nəticə “100 bit bütün D2C sistemləri üçün universal optimumdur” mənasına gəlmir.
Hesablama mürəkkəbliyi
| Ölçü | StegaStamp | Təklif edilən model |
|---|---|---|
| FLOPs | 55,19 M | 2,52 M |
| Öyrədilə bilən parametr | 54,27 M | 2,24 M |
| Orta decoding müddəti | 7,1 ms | 4,1 ms |
Mənbə FLOPs sayında təxminən 22 dəfə, öyrədilə bilən parametr sayında isə təxminən 24 dəfə azalma bildirir. Əsas səbəb decoder arxitekturasının sadələşdirilmiş olmasıdır. Daha aşağı hesablama yükü mobil D2C tətbiqləri üçün mühüm üstünlük potensialı yaradır; lakin tədqiqat müxtəlif mobil prosessorlarda enerji sərfiyyatı və ya ucdan-uca tətbiq gecikməsi ölçümü təqdim etmir.
ROI ablation tədqiqatı nə göstərdi?
Ablation təcrübəsində ROI modulu çıxarıldıqda decoder-ın son convolution çıxış ölçüsü dəyişdiyi üçün müqayisə edilə bilən arxitektura yaratmaq məqsədilə ilk convolution kernel ölçüsü 7-yə dəyişdirilmişdir.
| Vəziyyət | PSNR (dB) | SSIM | BER |
|---|---|---|---|
| ROI olmadan — mənbənin izahedici mətninə görə | 30,2658 | 0,9472 | %0,0611 |
| ROI ilə — mənbənin izahedici mətninə görə | 31,3438 | 0,9605 | %0,0080 |
Mənbənin izahına görə ROI olmadıqda BER %0,0611 ikən ROI əlavə edildikdə %0,0080-a düşür; bu, təxminən 7,6 dəfə yaxşılaşma kimi bildirilmişdir. PSNR və SSIM də ROI ilə bir qədər yüksəlir.
Ablation nəticəsi ROI-nin sadəcə arxitektura dizayn detalı olmadığını, mənbədə bildirilən məlumat geriçıxarma uğurunun mühüm hissəsinə töhfə verdiyini dəstəkləyir.
Tədqiqatın dəstəklədiyi nəticələr
Tədqiqat araşdırılan məlumat dəstləri və təcrübə şəraitində ROI əsaslı, mövqeləndirmə xətasına tolerant dərin məlumat yerləşdirmə yanaşmasının StegaStamp-lə müqayisədə daha yüksək təsvir keyfiyyəti və daha aşağı BER təmin edə bildiyini dəstəkləyir.
Simulyasiya edilmiş Gaussian noise, Gaussian blur və mövqeləndirmə xətası təcrübələri təklif edilən arxitekturanın bu pozucu təsirlər altında daha dayanıqlı olduğunu göstərir. Nəzarət olunan real ekran-kamera təcrübələri də 20–40 cm məsafə və 0°–45° perspektiv diapazonunda üstünlüyün fiziki görüntüləmə kanalına daşına bildiyini göstərir.
Ablation tədqiqatı ROI modulunun məlumat geriçıxarma uğuruna mühüm töhfə verdiyini; hesablama mürəkkəbliyi müqayisəsi isə yığcam decoder arxitekturasının daha aşağı FLOPs, daha az parametr və daha qısa decoding müddəti təmin etdiyini göstərir.
Tədqiqatın dəstəkləmədiyi ümumiləşdirmələr
Tədqiqat təklif edilən sistemin bütün ekranlarda, bütün kameralarda, bütün işıq şəraitində və ya açıq hava mühitində eyni performansı verəcəyini sübut etmir. Real təcrübə müəyyən LG monitor, Samsung Galaxy S22+ kamera, nəzarət olunan tavan işıqlandırması və sabit montaj şəraitində aparılmışdır.
Tədqiqat bütün məlumat yüklərində yüksək performansa zəmanət vermir. 200 bit təcrübəsi tutum artdıqca təsvir sədaqətinin və BER performansının nəzərəçarpacaq dərəcədə pisləşə bildiyini göstərir.
Tədqiqat WGAN loss istifadə etdiyi üçün bütün steganalysis üsullarına qarşı kriptoqrafik və ya steqanoqrafik təhlükəsizliyi sübut etmir. Dedicated hücum qiymətləndirməsi bu məqalənin təcrübə əhatəsinə daxil deyil.
Tədqiqat upstream obyekt aşkarlanmasını lazımsız etmir. BiSeNet ilə ekran/təsvir lokallaşdırılması yenə də sistem zəncirinin bir hissəsidir; təklif edilən ROI üsulu bu mərhələdəki qüsurlara tolerantlığı artırmağı hədəfləyir.
Məhdudiyyətlər və gələcək tədqiqatlar
Mənbə nəticə bölməsində tutumla rabitə uğuru arasındakı kompromisin daha ətraflı araşdırılmasını gələcək tədqiqat kimi göstərir. Xüsusilə dəyişən məlumat yükünün model arxitekturası və təsvir keyfiyyətinə təsirinin daha geniş diapazonlarda qiymətləndirilməsi tələb olunur.
Müəlliflər hər loss komponentinin töhfəsinin ayrıca araşdırılmasını da təklif edirlər. Mövcud tədqiqat ROI üçün ablation təqdim etsə də, LPIPS, L2, DATA və GAN loss komponentlərinin hamısı üçün ayrıca hərtərəfli ablation təqdim etmir.
Fiziki yoxlamanın fərqli ekranlar, kameralar və işıqlandırma şəraiti ilə genişləndirilməsi də açıq gələcək tədqiqat məqsədidir. Bu məqam mövcud real-dünya nəticəsinin cihazdan asılı olmayan ümumi performans sübutu olmadığını göstərir.
Nəhayət, müəlliflər dəyişən məlumat yüklərinə və müxtəlif təsvir həllərinə uyğunlaşa bilən adaptiv alqoritmlərin hazırlanmasını təklif edirlər. Belə genişləndirmə D2C yanaşmasının daha müxtəlif ubiquitous computing ssenarilərində istifadəsini hədəfləyir.
Mənbə və Metod Qeydi
Orijinal başlıq: Robust Display-to-Camera Communication via Location Error-Tolerant Deep Data Embedding.
Müəlliflər: Dae-Gyu Lee; Pankaj Singh; Sung-Yoon Jung.
Müxbir müəlliflər: Pankaj Singh; Sung-Yoon Jung.
Qurum: Department of Electronic Engineering, Yeungnam University, Gyeongsan, Gyeongsangbuk, Republic of Korea.
Jurnal: Applied Sciences.
Nəşriyyat: MDPI, Basel, Switzerland.
Nəşr məlumatı: Applied Sciences 2026, 16, 8767.
DOI: 10.3390/app16178767.
Məqalənin tarixçəsi: Alınma 29 May 2026; reviziya 22 İyun 2026; qəbul 24 İyun 2026; nəşr 3 Sentyabr 2026.
Mənbə növü: Resenziyalı, açıq girişli orijinal mühəndislik tədqiqat məqaləsi; ucdan-uca dərin öyrənmə əsaslı model inkişafı, simulyasiya edilmiş kanal pozuntuları və nəzarət olunan fiziki ekran-kamera yoxlaması.
Lisenziya: Creative Commons Attribution 4.0 International (CC BY 4.0). Müəllif hüquqları müəlliflərə məxsusdur.
Əsas üsul: ROI əsaslı, mövqeləndirmə xətasına tolerant encoder–decoder D2C məlumat yerləşdirmə arxitekturası.
Encoder: Expansion, preservation və contraction yolları; transposed convolution, convolution, pooling və skip connection; residual-image öyrənməsi.
Decoder: Altı convolution qatı, iki average-pooling əməliyyatı və sigmoid çıxışlı FC qatı; 0,5 binary threshold.
Təlim məlumat dəsti: MIRFLICKR.
Test məlumat dəsti: MS COCO-dan təsadüfi seçilmiş 10.000 təsvir.
Təsvir ölçüsü: 400 × 400 × 3 piksel.
ROI: Təsvirin hündürlüyü və eninin hər kənarında %1 marj; 400 × 400 təsvir üçün 392 × 392 məlumat yerləşdirmə sahəsi.
Standart payload: 100 bit.
Təlim: 160.000 addım; ilk 2000 addım decoder loss yönümlü; batch size 2; learning rate 10−4.
Optimizer: Total loss üçün Adam; WGAN critic üçün RMSProp.
Loss: LPIPS + YUV L2 + binary-cross-entropy DATA + WGAN discriminator loss.
Performans metrikləri: PSNR, SSIM və BER.
Real fiziki avadanlıq: LG 2560 × 1080 / 60 Hz monitor və Samsung Galaxy S22+ 1920 × 1080 / 30 fps kamera.
Müqayisə üsulu: StegaStamp.
Maliyyələşdirmə: Gyeongbuk ANCHOR system through the Gyeongbuk ANCHOR CENTER; Ministry of Education və Gyeongsangbuk-do, Republic of Korea; layihə 2026-ANCHOR-15-115.
İnstitusional Etika Şurası: Tətbiq edilmir.
Məlumatlandırılmış razılıq: Tətbiq edilmir.
Məlumat əlçatanlığı: Mənbə məqalə nəticələrin əsasını təşkil edən məlumatların öz istinad siyahısındakı [41] nömrəli mənbədə mövcud olduğunu bildirir.
Maraqlar toqquşması: Müəlliflər maraqlar toqquşmasının olmadığını bildirmişdir.
Süni intellekt istifadəsi bəyanatı: Müəlliflər ChatGPT 5.5-dən məqalənin dilini, oxunaqlılığını və məzmun təşkilini yaxşılaşdırmaq üçün istifadə etdiklərini; çıxışı nəzərdən keçirib redaktə etdiklərini və yayımlanmış məzmunun məsuliyyətini öz üzərlərinə götürdüklərini bildirmişdir.
Müəllif töhfələri: Sung-Yoon Jung konseptuallaşdırma, supervision, layihə idarəetməsi və maliyyələşdirmənin əldə edilməsində; Dae-Gyu Lee metodologiya, proqram təminatı, formal analiz, tədqiqat, məlumat kurasiyası və ilkin layihədə; Pankaj Singh metodologiya, doğrulama, formal analiz, nəzərdən keçirmə/redaktə və vizuallaşdırmada töhfə vermişdir. Mənbədəki ətraflı CRediT bəyanatında bəzi vəzifələr bir neçə müəllif arasında bölüşdürülür.
Mənbədaxili hesabat qeydi: Cədvəl 8-in hər iki sətri “Proposed (w/o ROI)” kimi etiketlənmişdir; lakin dərhal əvvəlki mətn ikinci nəticə dəstini ROI əlavə olunmuş təklif edilən modelə aid edir. Bundan əlavə, bəzi simulyasiya cədvəllərində BER faizlə, real məsafə/bucaq təcrübələrinin izahında isə faiz işarəsi olmadan onluq formada bildirilmişdir. Bu Verianla məzmununda həmin məqamlar təxmin yolu ilə səssizcə standartlaşdırılmamışdır.
Əsas metodoloji məhdudiyyət: Fiziki yoxlama real ekran və kamera istifadə etsə də, nəzarət olunan qapalı məkan, müəyyən avadanlıq, məhdud məsafə və bucaq diapazonunda aparılmışdır. Nəticələr fərqli avadanlıq, işıqlandırma, mobil hərəkət və açıq hava şəraitinə avtomatik ümumiləşdirilə bilməz.
Vizual materialın yenidən istifadəsi qeydi: Mənbə CC BY 4.0 lisenziyalıdır. Bununla belə, Verianla üçün mənbə fiqurlarını ekran görüntüsü kimi daşımaq əvəzinə üsul əlaqələrinin və ədədi nəticələrin orijinal texniki sxem və cədvəllərlə yenidən qurulmasına üstünlük verilmişdir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib