


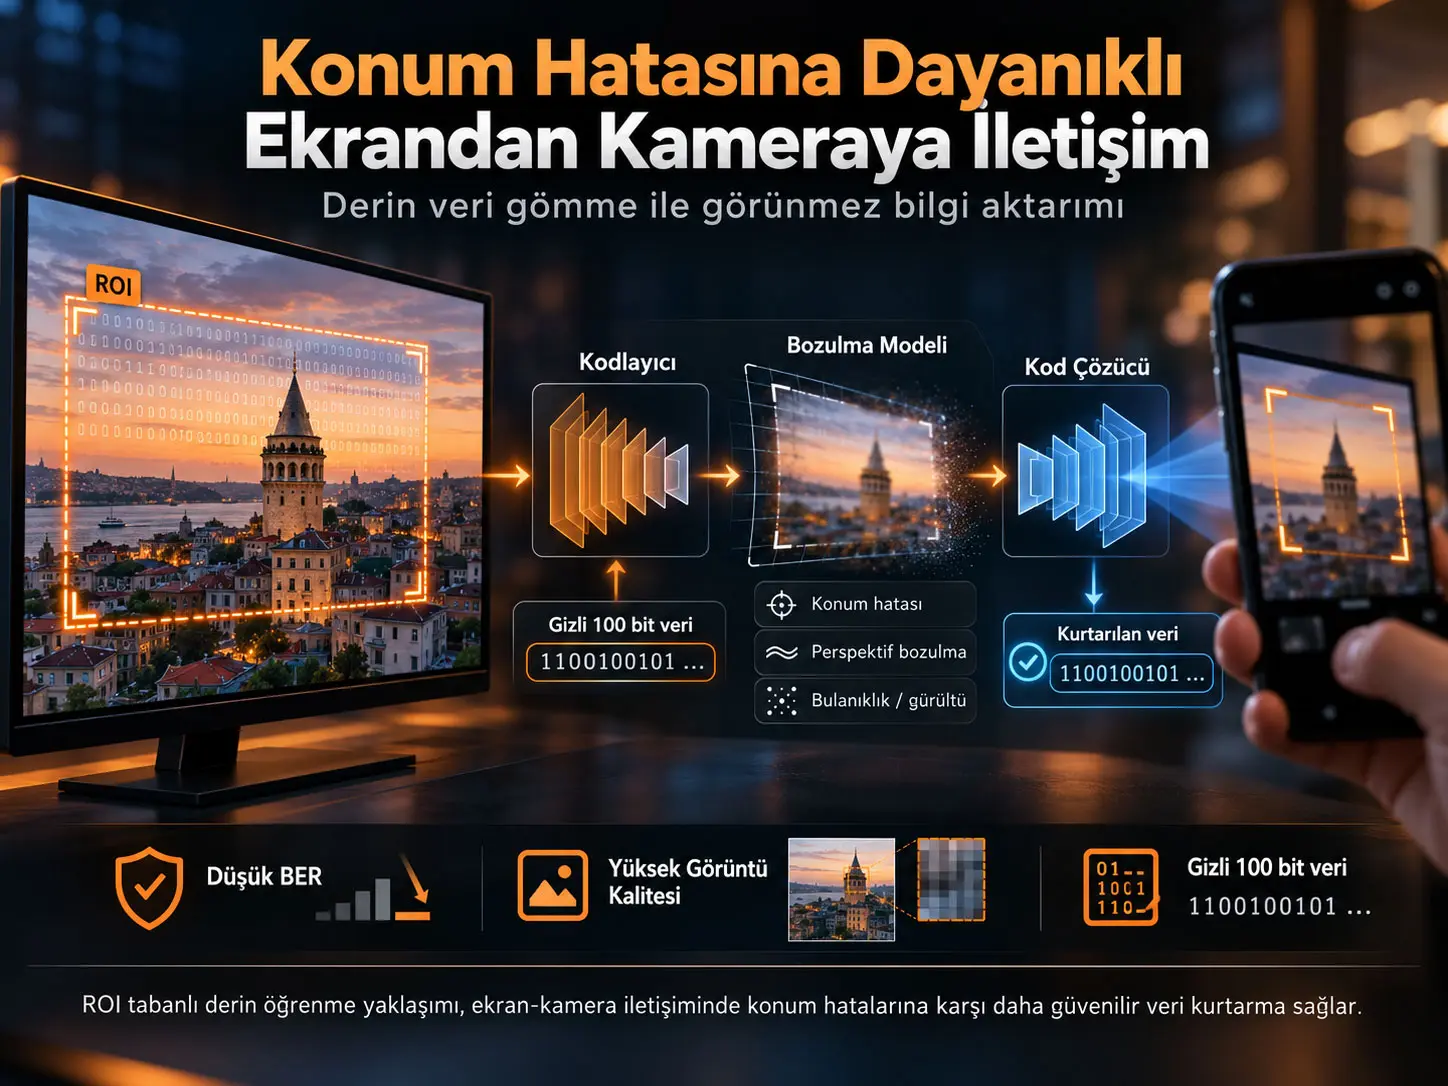
Ekrandan kameraya iletişim (Display-to-Camera Communication, D2C), bir elektronik ekranda gösterilen görsel içeriğe dijital bilginin gömülmesi ve bu bilginin kamera tarafından görüntülenerek geri çıkarılmasıyla çalışan bir optik haberleşme yaklaşımıdır. Dae-Gyu Lee, Pankaj Singh ve Sung-Yoon Jung tarafından geliştirilen bu çalışma, D2C sistemlerinde nesne algılama ve görüntü kırpma aşamalarından kaynaklanan konumlama hatalarına karşı dayanıklılığı artırmak için ilgi bölgesi (Region of Interest, ROI) tabanlı uçtan uca bir derin veri gömme çerçevesi önermektedir. Encoder, görüntü ile ikili veriyi çok ölçekli özellik haritalarında birleştirirken decoder daha ince bir konvolüsyonel yapı üzerinden veriyi geri kazanır. Model, JPEG sıkıştırması, renk değişimleri, hareket bulanıklığı, defocus, perspektif bozulması ve sensör gürültüsü gibi kanal etkileriyle birlikte eğitilmiştir.
Kaynakta 100 bitlik veri yüküyle gerçekleştirilen temel karşılaştırmada önerilen model PSNR = 31,3438 dB, SSIM = 0,9605 ve BER = %0,0080 elde etmiş; StegaStamp için aynı değerler 28,6677 dB, 0,9170 ve %0,0879 olarak raporlanmıştır. Konum hatası arttığında da önerilen ROI yaklaşımı daha düşük BER göstermiştir. Örneğin konum bozulmasının standart sapması σl = 5 olduğunda önerilen modelin BER'i %0,0550, StegaStamp'in BER'i %0,2240'tır.
Çalışma ayrıca gerçek ekran-kamera bağlantısını bir LG monitör ve Samsung Galaxy S22+ ile kontrollü iç mekânda test etmiştir. Önerilen yaklaşım 20–40 cm mesafe ve 0°–45° perspektif değişimlerinde StegaStamp'ten daha düşük hata üretmiştir. Bununla birlikte bu sonuçlar tek donanım konfigürasyonu ve kontrollü aydınlatma koşullarıyla sınırlıdır; farklı cihazlar, serbest elde çekim, dış ortam, değişken ışık ve çok daha geniş mesafe aralıkları için ayrıca doğrulama gereklidir.
Ekrandan Kameraya (D2C) İletişim Nedir?
Ekrandan kameraya iletişim, ekranda görünen bir taşıyıcı görüntünün aynı anda insan tarafından görüntülenmesini ve içine gömülmüş dijital verinin kamera tarafından algılanarak çözülmesini sağlayan optik kamera haberleşmesi yaklaşımıdır; bu çalışmada amaç, açık bir QR kodu yerine görüntünün görsel bütünlüğünü büyük ölçüde koruyan derin öğrenme tabanlı veri gömme ve geri çıkarma kullanmaktır.
QR koddan görünmez veri gömmeye
QR kodlar D2C iletişimin en bilinen biçimlerinden biridir; ancak yüksek kontrastlı siyah-beyaz modüller, finder pattern'ler ve açık kod geometrisi taşıyıcı görselin tasarımını sınırlar. Bir QR kodun varlığı ayrıca gözlemciye görüntüde makine tarafından okunabilir bilgi bulunduğunu doğrudan gösterir.
Derin veri gömme yaklaşımları farklı bir hedef izler. İkili bilgi, taşıyıcı görüntünün içinde insan gözü açısından mümkün olduğunca az fark edilir değişikliklerle temsil edilir. Kamera görüntüyü yeniden çektiğinde neural decoder bu gizli örüntüyü geri çıkarmaya çalışır.
Bu işlem yalnız sayısal görüntü dosyasının başka bir bilgisayara kopyalanması değildir. Ekran → optik ortam → kamera zinciri devreye girdiğinde perspektif, odak, hareket, ekran renk karakteristiği, sensör gürültüsü ve görüntünün yanlış yerden kırpılması gibi ek bozucu etkiler ortaya çıkar. Literatürde bu dijitalden fiziksel dünyaya geçiş problemi sıklıkla “analog hole” bağlamında değerlendirilir.
Çalışmanın çözmeye çalıştığı temel boşluk
Önceki derin öğrenme tabanlı D2C yöntemleri gürültü, sıkıştırma, perspektif ve bulanıklık gibi bozulmalara dayanıklılığı önemli ölçüde geliştirmiştir. Ancak pratik bir sistemde decoder'a hangi görüntü alanının verileceğini önce bir nesne algılama veya lokalizasyon sistemi belirlemek zorundadır.
Gerçek kamera karesindeki ekranın köşeleri birkaç piksel yanlış bulunursa kırpılmış görüntü doğru sınırlar içinde kalmayabilir. Sınır dışına taşan crop, decoder'a ekranın dışındaki arka plan piksellerini verir. Ters yöndeki hata ise görüntünün gerçek iç kısmından veri taşıyan pikselleri kesebilir.
Çalışmanın temel araştırma problemi bu nedenle yalnız “gürültüye dayanıklı gizli veri” değildir. Esas soru, upstream nesne algılama aşaması kusursuz olmayan bir D2C sisteminde veri nasıl güvenilir biçimde geri kazanılabilir? sorusudur.
ROI Tabanlı Veri Gömme Konum Hatalarına Neden Daha Dayanıklıdır?
ROI tabanlı yaklaşım, ikili veri yükünü görüntünün hassas dış sınırlarına kadar yaymak yerine kenarlardan belirli bir güvenlik marjıyla ayrılmış kararlı iç bölgeye yoğunlaştırır; böylece algılanan ekran sınırı birkaç piksel dışarı veya içeri kaydığında decoder'ın arka plan piksellerine erişme veya veri taşıyan kritik iç pikselleri kaybetme olasılığı azaltılır.
%1'lik kenar tamponu
Kaynak yöntemde ROI marjı görüntünün yüksekliği ve genişliğinin tam %1'i olarak belirlenmiştir. 400 × 400 × 3 giriş görüntüsünde her kenardan 4 piksel ayrılır. Bunun sonucunda etkin veri gömme alanı:
392 × 392 × 3
boyutuna gelir.
Bu düzenlemenin amacı yalnız daha küçük bir görüntü kullanmak değildir. Marj, lokalizasyon ve perspektif hatalarının en fazla etkilediği dış sınırlar ile gömülü veri yükü arasında geometrik bir tampon oluşturmaktır.
Overshooting ve undershooting hataları
Kaynak, lokalizasyon hatalarının iki temel başarısızlık biçimi oluşturduğunu açıklamaktadır. Overshooting, algılanan sınırın gerçek ekran alanının dışına taşması ve decoder'ın arka plan piksellerini görmesidir. Undershooting ise sınırın gereğinden fazla içeri taşınması ve veri taşıyan gerçek görüntü piksellerinin kaybedilmesidir.
ROI, veri yükünü dış kenardan uzaklaştırdığı için her iki hata biçimine karşı geometrik tolerans sağlar. Bu yaklaşım konum hatasını ortadan kaldırmaz; decoder'ın belirli büyüklükteki hatalara daha az duyarlı olmasını amaçlar.
Önerilen sistemin genel işlem zinciri
| Aşama | İşlem | Bilimsel görevi |
|---|---|---|
| 1 | Özgün görüntü + L-bit veri | Taşıyıcı görsel ile iletilecek ikili mesajın sisteme verilmesi |
| 2 | ROI isolation | Kararsız görüntü kenarlarından %1 güvenlik marjı bırakılması |
| 3 | Verinin FC katmanında yeniden biçimlendirilmesi | İkili mesajın görüntü uzayıyla birleştirilebilecek tensöre dönüştürülmesi |
| 4 | Encoder | Görüntü ve veri özelliklerinden residual image üretilmesi |
| 5 | Residual + özgün görüntü | Görsel olarak yüksek benzerlikte encoded image oluşturulması |
| 6 | Distortion model | Fiziksel ekran-kamera kanalındaki bozulmaların eğitim sırasında taklit edilmesi |
| 7 | ROI isolation | Decoder'ın veri taşıyan kararlı iç bölgeye odaklanması |
| 8 | Decoder | Görüntü özelliklerinin küçültülerek L-bit mesajın geri çıkarılması |
İkili veri görüntü uzayına nasıl aktarılıyor?
Encoder'a giren L-bit binary string önce fully connected (FC) katmanıyla 7500 × 1 vektöre projekte edilir. Bu vektör daha sonra:
50 × 50 × 3
tensörüne yeniden şekillendirilir. Tensör pixel replication kullanılarak taşıyıcı görüntünün H × W × 3 uzamsal boyutuna yükseltilir.
ROI işlemi ve zero padding sonrasında görüntü ile veri tensörü channel boyutunda birleştirilerek:
H × W × 6
boyutlu birleşik girdi oluşturulur.
Encoder'ın expansion–preservation–contraction mimarisi
Encoder üç işlevsel yol içerir. Expansion pathway, transposed convolution katmanlarıyla özellik haritalarının uzamsal boyutunu büyütür. Amaç görüntü ve veri özelliklerini farklı ölçeklerde birleştirmektir.
Preservation pathway, convolution işlemleriyle kritik özellikleri korumaya çalışır. Contraction pathway ise pooling ve convolution katmanlarıyla büyütülen özellikleri yeniden özgün görüntü çözünürlüğüne indirir.
Erken ve geç katmanlar arasındaki skip connection, ilk özelliklerin daha sonraki katmanlarda tekrar kullanılmasına olanak verir. Encoder'ın son çıktısı doğrudan nihai görüntü değildir; önce üç kanallı bir residual image üretilir. Bu residual görüntü özgün taşıyıcıya eklenerek encoded image elde edilir.
| Bölüm | Temel yapı | Kaynakta bildirilen işlev |
|---|---|---|
| Expansion | 6 transposed convolution katmanı | Özellik haritasını genişleterek görüntü-veri birleşimini çok ölçekli hale getirmek |
| Preservation | Convolution + max pooling | Önemli görsel/veri özelliklerini korumak |
| Contraction | Convolution katmanları | Uzamsal boyutları yeniden 400 × 400'e indirmek |
| Skip connection | Erken ve geç katman bağlantısı | İlk özelliklerin daha sonraki aşamalarda yeniden kullanılmasını sağlamak |
| Çıkış | 400 × 400 × 3 residual image | Özgün görüntüye eklenecek ince değişiklikleri üretmek |
Decoder neden “thin” yapı kullanıyor?
Decoder'ın görevi görsel üretmek değil, encoded image içindeki ikili örüntüyü mümkün olduğunca verimli biçimde geri çıkarmaktır. Bu nedenle mimari, feature map boyutlarını aşamalı biçimde küçülten daha yalın bir yapı kullanır.
Decoder altı convolution katmanı, iki average pooling işlemi ve bir FC katmanından oluşur. İlk üç convolution katmanında stride 1, sonraki üçünde stride 2 kullanılır. Convolution katmanları padding olmadan çalıştırılır ve ReLU aktivasyonları uygulanır.
392 × 392 × 3 ROI girdisi aşamalı olarak küçültülerek son convolution çıkışında 10 × 10 × 64 özellik haritasına ulaşır. FC katmanı sigmoid aktivasyonuyla 100 çıkış üretir. Son aşamada 0,5 binary threshold uygulanarak özgün 100 bitlik dizinin tahmini elde edilir.
Fiziksel kanal hangi bozulmalarla modelleniyor?
Çalışma bozulmaları ekran tarafı ve kamera tarafı olmak üzere iki gruba ayırmaktadır.
| Taraf | Bozulma | Kaynakta kullanılan aralık |
|---|---|---|
| Ekran | JPEG sıkıştırması | Quality factor Q = 50–100 |
| Ekran | Kontrast | 0,5–1,5 ölçekleme |
| Ekran | Parlaklık | En fazla ±0,3 kaydırma |
| Ekran | Hue | En fazla ±0,1 kaydırma |
| Ekran | Saturation | 0,0–1,0 desaturation faktörü |
| Kamera | Motion blur | 7 × 7 linear blur; σ = 0,25–1,0 |
| Kamera | Defocus | 7 × 7 Gaussian blur; σ = 1,0–3,0 |
| Kamera | Perspective warping | Random homography; maksimum ±%10 translation scale |
| Kamera | Internal sensor noise | Additive white Gaussian noise; μ = 0, σ = 0–0,02 |
Defocus blur ve motion blur eğitim örneklerine ayrı ayrı %25 olasılıkla uygulanmıştır. Kalan %50'lik bölüm bulanıklık uygulanmadan bırakılmıştır. Bu seçim, modelin yalnız blur bulunan görüntülere uyum sağlamasını önleyerek farklı kanal durumlarına maruz kalmasını amaçlamaktadır.
Kayıp fonksiyonu hangi hedefleri dengeliyor?
Model encoder ve decoder'ı uçtan uca ortak biçimde eğitir. Kaynakta toplam amaç fonksiyonu:
\[ L_{\mathrm{total}} = \lambda_1 L_{\mathrm{LPIPS}} + \lambda_2 L_{2} + \lambda_3 L_{\mathrm{DATA}} + \lambda_4 L_{\mathrm{GAN}} \tag{1} \]
olarak tanımlanmıştır.
\(L_{\mathrm{LPIPS}}\), özgün ve encoded görüntünün perceptual özellikleri arasındaki benzerliği korumaya çalışır. \(L_2\), YUV renk uzayındaki piksel düzeyli farkı cezalandırarak yapısal/görsel sadakati destekler.
\(L_{\mathrm{DATA}}\), özgün L-bit mesaj ile decoder'ın geri oluşturduğu çıktı arasındaki binary cross-entropy kaybıdır. Veri kurtarma doğruluğunun ana eğitim bileşenidir.
\(L_{\mathrm{GAN}}\), Wasserstein Generative Adversarial Network discriminator bileşenidir ve encoded görüntünün kaynak görüntülerden istatistiksel olarak kolay ayrılabilir olmamasını teşvik etmeyi amaçlar.
Eğitimde ağırlık oranı:
λ1 : λ2 : λ3 : λ4 = 1,5 : 2 : 1,5 : 0,5
olarak kullanılmıştır. Bu ağırlıklar görüntü kalitesi, veri kurtarma ve adversarial hedef arasındaki optimizasyon dengesini belirler.
WGAN bileşeninin bulunması tek başına sistemin bütün steganalysis saldırılarına karşı güvenli olduğunu kanıtlamaz. Çalışma, kapsamlı bağımsız steganalysis değerlendirmesi raporlamamaktadır.
Gaussian blur ile kernel büyüklüğü ilişkisi
Çalışmanın ikinci denklemi Gaussian blur standard deviation değeri ile yaklaşık kernel büyüklüğü arasındaki ilişkiyi verir:
\[ k \approx 6\sigma_b+1 \tag{2} \]
Burada \(k\) blur kernel'inin kenar uzunluğunu, \(\sigma_b\) ise Gaussian blur standard deviation değerini ifade eder. Kaynak \(k\)'nin tek sayı olması gerektiğini belirtmektedir. Deneylerde 3 × 3, 5 × 5, 7 × 7 ve 9 × 9 kernel boyutları değerlendirilmiştir.
Çalışmanın Yöntemi ve Bulguları
Eğitim yapılandırması
| Parametre | Değer |
|---|---|
| Eğitim veri seti | MIRFLICKR |
| Görüntü boyutu | 400 × 400 × 3 |
| Varsayılan veri yükü | 100 bit |
| Toplam eğitim adımı | 160.000 |
| Başlangıç decoder-only eğitimi | İlk 2000 adım; temel veri kurtarma doğruluğu >%95 hedefi |
| Batch size | 2 |
| Learning rate | 10−4 |
| Total-loss optimizer | Adam |
| WGAN critic optimizer | RMSProp |
| Loss ağırlıkları | 1,5 : 2 : 1,5 : 0,5 |
| Eğitim donanımı | NVIDIA GeForce RTX 3060 |
Test veri seti ve fiziksel deney
Genel görüntü kalitesi ve veri kurtarma değerlendirmesi için MS COCO'dan rastgele seçilen 10.000 görüntü kullanılmıştır. Dijital değerlendirmeye ek olarak görüntüler gerçek bir monitörde gösterilmiş ve akıllı telefon kamerasıyla tekrar çekilmiştir.
| Bileşen | Kaynakta bildirilen özellik |
|---|---|
| Ekran | LG monitor |
| Ekran çözünürlüğü | 2560 × 1080 piksel |
| Ekran yenileme hızı | 60 Hz |
| Kamera | Samsung Galaxy S22+ |
| Kamera çözünürlüğü | 1920 × 1080 piksel |
| Kamera kare hızı | 30 fps |
| Zoom | 0,6 |
| Aydınlatma | Standart iç mekân tavan aydınlatması |
| Mesafe testi | 20–40 cm |
| Açı testi | 30 cm sabit mesafede 0°–45° perspektif değişimleri |
BER, PSNR ve SSIM Bu Çalışmada Neyi Ölçer?
BER geri kazanılan ikili mesajdaki bit hatalarının oranını ve dolayısıyla haberleşme güvenilirliğini ölçer; düşük BER daha iyi veri kurtarma anlamına gelir. PSNR özgün ve encoded görüntü arasındaki piksel düzeyli bozulmanın büyüklüğünü dB cinsinden değerlendirir ve yüksek değer tercih edilir. SSIM ise görüntülerin yapısal benzerliğini değerlendirir ve 1'e yaklaşan değerler daha yüksek yapısal benzerliği gösterir.
Temel StegaStamp karşılaştırması
| Yöntem | PSNR (dB) | SSIM | BER |
|---|---|---|---|
| StegaStamp | 28,6677 | 0,9170 | %0,0879 |
| Önerilen model | 31,3438 | 0,9605 | %0,0080 |
Önerilen yöntem üç metrikte de StegaStamp'ten daha iyi sonuç vermiştir. Kaynak BER'deki azalmayı %90,90 olarak raporlamaktadır. Görüntü kalitesindeki artış PSNR'de 2,6761 dB ve SSIM'de 0,0435 fark olarak verilmektedir.
Gaussian noise altında performans
Gaussian noise deneylerinde SNR azaldıkça BER yükselmiştir. Bu beklenen eğilim, sinyal içindeki gürültü miktarının artmasıyla decoder'ın gömülü bit örüntüsünü ayırmasının zorlaşmasıyla ilişkilendirilmiştir.
SNR = 25 dB noktasında StegaStamp yaklaşık %0,22 BER gösterirken önerilen model yaklaşık %0,11 BER elde etmiştir. Kaynak bu farkı %48,97 güvenilirlik iyileşmesi olarak ifade etmektedir.
SNR 30 dB'nin üzerine çıktığında önerilen modelin BER'i StegaStamp'e göre kaynakta %85–91 daha düşük olarak raporlanmaktadır. SNR 20 dB'nin altındaki yüksek gürültü rejiminde iki model de belirgin biçimde kötüleşmektedir.
Gaussian blur altında performans
| Yöntem | 3 × 3, σ=0,3 | 5 × 5, σ=0,6 | 7 × 7, σ=1,0 | 9 × 9, σ=1,2 |
|---|---|---|---|---|
| StegaStamp | %0,0868 | %0,0693 | %0,0664 | %0,0665 |
| Önerilen model | %0,0079 | %0,0076 | %0,0095 | %0,0103 |
Önerilen model 3 × 3 ve 5 × 5 blur koşullarında çok düşük BER korumuş, 7 × 7 ve 9 × 9'da hata oranı yükselmeye başlamıştır. Kaynak, 9 × 9 maksimum test bulanıklığında dahi önerilen modelin BER'inin StegaStamp'ten %84,51 daha düşük olduğunu bildirmektedir.
Her iki modelin bazı orta şiddette blur koşullarında bozulmasız duruma göre daha iyi veri geri kazanımı göstermesi dikkat çekicidir. Yazarlar bunu blur'un eğitim distortion pipeline'ında bulunması ve ağların bu bozulmaya özellikle hazırlanmasıyla açıklamaktadır.
Nesne algılama konum hatasının ampirik ölçümü
Konum hatası simülasyonunun gerçekçi ölçeğini belirlemek amacıyla BiSeNet nesne algılama modeli 10.000 görüntü üzerinde değerlendirilmiştir. Konum hatası 10 piksel veya daha az olduğunda algılama başarılı kabul edilmiş ve başarı oranı %81,28 olarak bildirilmiştir.
Başarılı algılamalarda x ve y eksenlerindeki hata ortalamaları sırasıyla 0,687 ve 0,178 piksel; standart sapmalar 2,719 ve 2,665 piksel olarak bulunmuştur.
Bu gözlemlerden hareketle görüntünün dört sınır köşesi x ve y eksenlerinde bağımsız normal dağılımlı konum hatalarıyla pertürbe edilmiştir.
Konum hatasına dayanıklılık
| Yöntem | μl=0, σl=0 | μl=0, σl=3 | μl=0, σl=5 |
|---|---|---|---|
| StegaStamp | %0,0879 | %0,1293 | %0,2240 |
| Önerilen model | %0,0080 | %0,0109 | %0,0550 |
Önerilen sistemin BER'i σl = 0'dan 5'e giderken yükselmektedir; dolayısıyla ROI konum hatasını tamamen ortadan kaldırmaz. Buna rağmen artış StegaStamp'e göre belirgin biçimde daha sınırlıdır.
Kaynak σl = 3 için StegaStamp'e kıyasla %91,57 BER azalması, σl = 5 için ise %75,45 iyileşme raporlamaktadır. Ayrıca σl = 5 koşulundaki %0,0550 BER, StegaStamp'in konum hatasız %0,0879 değerinden de düşüktür.
Gerçek kamera mesafesinin etkisi
Gerçek ekran-kamera deneyinde mesafe 20 cm'den 40 cm'ye çıkarılmıştır. Görüntünün kamera sensöründeki uzamsal ayak izi küçüldüğü için örnekleme çözünürlüğü azalmakta ve BER yükselmektedir.
Kaynak önerilen sistem için 20 cm'de BER = 0,0003, 30 cm'de BER = 0,0009 ve 40 cm'de BER = 0,0053 değerlerini raporlamaktadır. 20 cm'deki hata azalması StegaStamp'e göre %89,29, 40 cm'deki avantaj ise %65,13 olarak verilmektedir.
Bu bölümde kaynak BER değerlerini yüzde işareti olmadan verdiği için Verianla metni bunları otomatik olarak yüzdeye çevirmemiştir.
Perspektif açısının etkisi
Kamera–ekran mesafesi 30 cm'de sabitlenmiş ve kamera açısı 0°'den 45°'ye kadar değiştirilmiştir. Açı büyüdükçe perspektif warping ve piksel eşleme hataları arttığından her iki sistemin BER'i de yükselmiştir.
Önerilen model 0°'de BER = 0,0009 ve 45° sağ rotasyonda maksimum BER = 0,0035 göstermiştir. StegaStamp için 0° değeri 0,0052, 45° sol rotasyondaki değer ise 0,0193 olarak raporlanmıştır.
Yazarlar bu farkı ROI'nin kenar nonlinearity ve localization jitter etkilerine karşı tampon oluşturması ve çok ölçekli encoder/ince decoder mimarisinin veri özelliklerini korumasıyla ilişkilendirmektedir.
Veri yükü arttığında ne oluyor?
| Metrik | 50 bit | 100 bit | 200 bit |
|---|---|---|---|
| PSNR (dB) | 31,3525 | 31,3438 | 29,4619 |
| SSIM | 0,9609 | 0,9605 | 0,9458 |
| BER | %0,0072 | %0,0080 | %0,1106 |
50 bitten 100 bite geçildiğinde görüntü kalitesi ve BER yalnız küçük değişiklikler göstermektedir. Buna karşılık 200 bitlik veri yükü hem görüntü sadakatini hem veri kurtarma başarısını belirgin biçimde düşürmektedir.
Kaynak 200 bitteki %0,1106 BER'in 100 bitlik %0,0080 değerine göre yaklaşık 13,8 kat yüksek olduğunu belirtmektedir. Daha yüksek veri yoğunluğu taşıyıcı görüntü üzerinde daha güçlü değişiklikler gerektirdiği için görünmezlik ile veri ayrıştırma arasındaki denge kötüleşmektedir.
Bu nedenle çalışma kendi incelenen mimari ve koşullarında 100 biti performans–kapasite dengesi için seçmiştir. Bu sonuç “100 bit bütün D2C sistemleri için evrensel optimumdur” anlamına gelmez.
Hesaplama karmaşıklığı
| Ölçüt | StegaStamp | Önerilen model |
|---|---|---|
| FLOPs | 55,19 M | 2,52 M |
| Eğitilebilir parametre | 54,27 M | 2,24 M |
| Ortalama decoding süresi | 7,1 ms | 4,1 ms |
Kaynak FLOPs sayısında yaklaşık 22 kat, eğitilebilir parametre sayısında yaklaşık 24 kat azalma bildirmektedir. Temel neden decoder mimarisinin sadeleştirilmiş olmasıdır. Daha düşük hesaplama yükü mobil D2C uygulamaları için önemli bir avantaj potansiyeli sunar; ancak çalışma farklı mobil işlemcilerde enerji tüketimi veya uçtan uca uygulama gecikmesi ölçümü sunmamaktadır.
ROI ablasyon çalışması ne gösterdi?
Ablation deneyinde ROI modülü çıkarıldığında decoder'ın son convolution çıkış boyutunun değişmesi nedeniyle karşılaştırılabilir mimari oluşturmak amacıyla ilk convolution kernel boyutu 7 olarak değiştirilmiştir.
| Durum | PSNR (dB) | SSIM | BER |
|---|---|---|---|
| ROI olmadan — kaynak açıklama metnine göre | 30,2658 | 0,9472 | %0,0611 |
| ROI ile — kaynak açıklama metnine göre | 31,3438 | 0,9605 | %0,0080 |
Kaynak anlatımına göre ROI bulunmadığında BER %0,0611 iken ROI eklendiğinde %0,0080'a düşmektedir; bu yaklaşık 7,6 kat iyileşme olarak raporlanmıştır. PSNR ve SSIM de ROI ile hafifçe yükselmektedir.
Ablation sonucu ROI'nin yalnız mimari bir tasarım ayrıntısı olmadığını, kaynakta raporlanan veri kurtarma başarısının önemli bir bölümüne katkıda bulunduğunu desteklemektedir.
Çalışmanın desteklediği sonuçlar
Çalışma, incelenen veri kümeleri ve deney koşullarında ROI tabanlı konum-hatası toleranslı derin gömme yaklaşımının StegaStamp'e göre daha yüksek görüntü kalitesi ve daha düşük BER sağlayabildiğini desteklemektedir.
Simüle Gaussian noise, Gaussian blur ve konum hatası deneyleri önerilen mimarinin bu bozucu etkiler altında daha dayanıklı olduğunu göstermektedir. Kontrollü gerçek ekran-kamera deneyleri de 20–40 cm mesafe ve 0°–45° perspektif aralığında avantajın fiziksel görüntüleme kanalına taşınabildiğini göstermektedir.
Ablation çalışması, ROI modülünün veri kurtarma başarısına önemli katkı yaptığını; hesaplama karmaşıklığı karşılaştırması ise ince decoder mimarisinin daha düşük FLOPs, daha az parametre ve daha kısa decoding süresi sağladığını göstermektedir.
Çalışmanın desteklemediği genellemeler
Çalışma önerilen sistemin bütün ekranlarda, bütün kameralarda, bütün ışık koşullarında veya açık hava ortamında aynı performansı vereceğini kanıtlamamaktadır. Gerçek deney belirli LG monitör, Samsung Galaxy S22+ kamera, kontrollü tavan aydınlatması ve sabit montaj koşullarında yapılmıştır.
Çalışma bütün veri yüklerinde yüksek performans garanti etmemektedir. 200 bit deneyi, kapasite arttıkça görüntü sadakati ve BER performansının belirgin biçimde bozulabildiğini göstermektedir.
Çalışma WGAN loss kullandığı için bütün steganalysis yöntemlerine karşı kriptografik veya steganografik güvenlik kanıtlamaz. Dedicated saldırı değerlendirmesi bu makalenin deney kapsamı değildir.
Çalışma upstream nesne algılamayı gereksiz hale getirmemektedir. BiSeNet ile ekran/görüntü lokalizasyonu yine sistem zincirinin bir parçasıdır; önerilen ROI yöntemi bu aşamadaki kusurlara toleransı artırmayı amaçlar.
Sınırlılıklar ve gelecek çalışmalar
Kaynak sonuç bölümünde kapasite ile haberleşme başarısı arasındaki ödünleşimin daha ayrıntılı incelenmesini gelecek çalışma olarak belirtmektedir. Özellikle değişken veri yükünün model mimarisi ve görüntü kalitesi üzerindeki etkisinin daha geniş aralıklarda değerlendirilmesi gerekmektedir.
Yazarlar her loss bileşeninin katkısının ayrı ayrı incelenmesini de önermektedir. Mevcut çalışma ROI için ablasyon sunmasına rağmen LPIPS, L2, DATA ve GAN loss bileşenlerinin tamamı için bağımsız kapsamlı ablasyon raporlamamaktadır.
Fiziksel doğrulamanın farklı ekranlar, kameralar ve aydınlatma koşullarıyla genişletilmesi de açık bir gelecek çalışma hedefidir. Bu nokta mevcut gerçek-dünya sonucunun cihazdan bağımsız genel performans kanıtı olmadığını gösterir.
Son olarak yazarlar değişken veri yükleri ve farklı görüntü çözünürlüklerine uyum sağlayabilen adaptif algoritmalar geliştirmeyi önermektedir. Böyle bir genişleme, D2C yaklaşımının daha farklı ubiquitous computing senaryolarında kullanılmasını hedeflemektedir.
Kaynak ve Yöntem Notu
Özgün başlık: Robust Display-to-Camera Communication via Location Error-Tolerant Deep Data Embedding.
Yazarlar: Dae-Gyu Lee; Pankaj Singh; Sung-Yoon Jung.
Corresponding authors: Pankaj Singh; Sung-Yoon Jung.
Kurum: Department of Electronic Engineering, Yeungnam University, Gyeongsan, Gyeongsangbuk, Republic of Korea.
Dergi: Applied Sciences.
Yayınevi: MDPI, Basel, Switzerland.
Yayın bilgisi: Applied Sciences 2026, 16, 8767.
DOI: 10.3390/app16178767.
Makale geçmişi: Alınma 29 Mayıs 2026; revizyon 22 Haziran 2026; kabul 24 Haziran 2026; yayın 3 Eylül 2026.
Kaynak türü: Hakemli, açık erişimli özgün mühendislik araştırma makalesi; uçtan uca derin öğrenme tabanlı model geliştirme, simüle kanal bozulmaları ve kontrollü fiziksel ekran-kamera doğrulaması.
Lisans: Creative Commons Attribution 4.0 International (CC BY 4.0). Telif hakkı yazarlara aittir.
Ana yöntem: ROI tabanlı konum-hatasına toleranslı encoder–decoder D2C veri gömme mimarisi.
Encoder: Expansion, preservation ve contraction yolları; transposed convolution, convolution, pooling ve skip connection; residual-image öğrenmesi.
Decoder: Altı convolution katmanı, iki average-pooling işlemi ve sigmoid çıkışlı FC katmanı; 0,5 binary threshold.
Eğitim veri seti: MIRFLICKR.
Test veri seti: MS COCO'dan rastgele seçilmiş 10.000 görüntü.
Görüntü boyutu: 400 × 400 × 3 piksel.
ROI: Görüntü yüksekliği ve genişliğinin her kenarında %1 marj; 400 × 400 görüntü için 392 × 392 veri gömme bölgesi.
Varsayılan payload: 100 bit.
Eğitim: 160.000 adım; ilk 2000 adım decoder loss odaklı; batch size 2; learning rate 10−4.
Optimizer: Total loss için Adam; WGAN critic için RMSProp.
Loss: LPIPS + YUV L2 + binary-cross-entropy DATA + WGAN discriminator loss.
Performans metrikleri: PSNR, SSIM ve BER.
Gerçek fiziksel donanım: LG 2560 × 1080 / 60 Hz monitör ve Samsung Galaxy S22+ 1920 × 1080 / 30 fps kamera.
Karşılaştırma yöntemi: StegaStamp.
Finansman: Gyeongbuk ANCHOR system through the Gyeongbuk ANCHOR CENTER; Ministry of Education ve Gyeongsangbuk-do, Republic of Korea; proje 2026-ANCHOR-15-115.
Institutional Review Board: Uygulanamaz.
Informed Consent: Uygulanamaz.
Veri erişilebilirliği: Kaynak makale, sonuçların altında yatan verilerin kendi referans listesinde [41] numaralı kaynakta mevcut olduğunu bildirmektedir.
Çıkar çatışması: Yazarlar çıkar çatışması bulunmadığını bildirmiştir.
Yapay zekâ kullanım beyanı: Yazarlar ChatGPT 5.5'i makalenin dilini, okunabilirliğini ve içerik organizasyonunu iyileştirmek için kullandıklarını; çıktıyı gözden geçirip düzenlediklerini ve yayımlanan içeriğin sorumluluğunu üstlendiklerini bildirmiştir.
Yazar katkıları: Sung-Yoon Jung kavramsallaştırma, supervision, proje yönetimi ve finansman ediniminde; Dae-Gyu Lee metodoloji, yazılım, formal analiz, araştırma, veri kürasyonu ve özgün taslakta; Pankaj Singh metodoloji, doğrulama, formal analiz, inceleme/düzenleme ve görselleştirmede katkı sağlamıştır. Kaynaktaki ayrıntılı CRediT beyanında bazı görevler birden fazla yazar arasında paylaşılmaktadır.
Kaynak içi raporlama notu: Tablo 8'in iki satırı da “Proposed (w/o ROI)” şeklinde etiketlenmiştir; ancak hemen önceki metin ikinci sonuç setini ROI'nin eklendiği önerilen modele atfetmektedir. Ayrıca bazı simülasyon tablolarında BER yüzde olarak, gerçek mesafe/açı deneylerinin açıklamasında ise yüzde işareti olmadan ondalık biçimde raporlanmıştır. Bu Verianla içeriğinde söz konusu noktalar tahmin yoluyla sessizce standartlaştırılmamıştır.
Temel yöntemsel sınır: Fiziksel doğrulama gerçek ekran ve kamera kullanmasına rağmen kontrollü iç mekân, belirli donanım, sınırlı mesafe ve açı aralığıyla yapılmıştır. Sonuçlar farklı donanım, aydınlatma, mobil hareket ve dış ortam koşullarına otomatik olarak genellenemez.
Görsel yeniden kullanım notu: Kaynak CC BY 4.0 lisanslıdır. Bununla birlikte Verianla için kaynak figürlerini ekran görüntüsü olarak taşımak yerine yöntem ilişkilerini ve sayısal sonuçları özgün teknik şema ve tablolarla yeniden kurmak tercih edilmiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir