


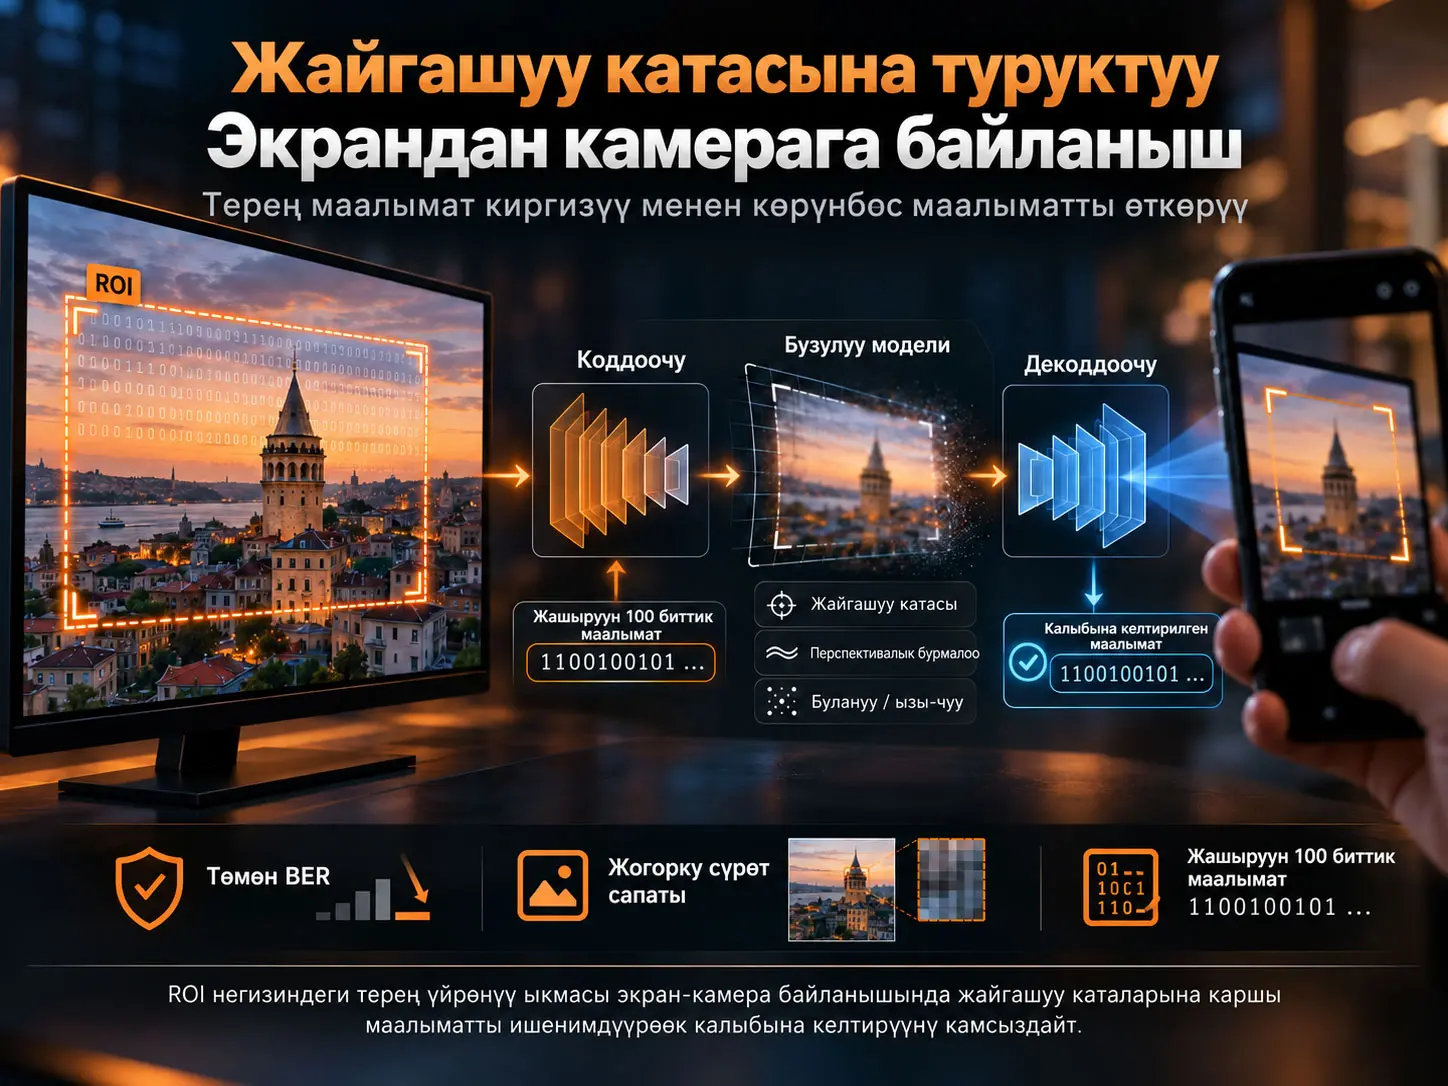
Экрандан камерага байланыш (Display-to-Camera Communication, D2C) — электрондук экранда көрсөтүлгөн визуалдык мазмунга санариптик маалыматты жайгаштырып, андан соң камера аркылуу сүрөткө тартып ошол маалыматты кайра чыгарып алууга негизделген оптикалык байланыш ыкмасы. Dae-Gyu Lee, Pankaj Singh жана Sung-Yoon Jung тарабынан иштелип чыккан бул изилдөө D2C системаларында объектти аныктоо жана сүрөттү кесүү баскычтарынан келип чыккан жайгашуу каталарына туруктуулукту жогорулатуу үчүн кызыгуу аймагына (Region of Interest, ROI) негизделген учтан-учка терең маалымат жайгаштыруу алкагын сунуштайт. Encoder сүрөт менен экилик маалыматты көп масштабдуу өзгөчөлүк карталарында бириктирсе, decoder маалыматты кыйла ичке конволюциялык түзүлүш аркылуу кайра чыгарат. Модель JPEG кысуу, түстүн өзгөрүшү, кыймыл бүдөмүктүгү, defocus, перспектива бузулушу жана сенсордук ызы-чуу сыяктуу канал таасирлери менен кошо үйрөтүлгөн.
Булакта 100 bit маалымат жүгү менен жүргүзүлгөн негизги салыштырууда сунушталган модель PSNR = 31,3438 dB, SSIM = 0,9605 жана BER = %0,0080 көрсөткөн; StegaStamp үчүн ошол эле маанилер 28,6677 dB, 0,9170 жана %0,0879 деп берилген. Жайгашуу катасы көбөйгөндө да сунушталган ROI ыкмасы төмөнүрөөк BER көрсөткөн. Мисалы, жайгашуу бузулуусунун стандарттык четтөөсү σl = 5 болгондо сунушталган моделдин BER-и %0,0550, ал эми StegaStamp-и %0,2240 болгон.
Изилдөө ошондой эле чыныгы экран-камера байланышын LG монитор жана Samsung Galaxy S22+ менен көзөмөлдөнгөн жабык жайда сынаган. Сунушталган ыкма 20–40 cm аралыкта жана 0°–45° перспектива өзгөрүүлөрүндө StegaStamp-ке караганда азыраак ката берген. Бирок бул жыйынтыктар бир жабдык конфигурациясы жана көзөмөлдөнгөн жарыктандыруу шарттары менен чектелет; башка түзмөктөр, кол менен тартуу, сырттагы шарттар, өзгөрмө жарык жана кыйла кең аралык диапазондору үчүн кошумча текшерүү талап кылынат.
Экрандан Камерага (D2C) Байланыш Деген Эмне?
Экрандан камерага байланыш — экранда көрүнгөн алып жүрүүчү сүрөттү адам бир убакта көрө алышын жана анын ичине жайгаштырылган санариптик маалыматты камера аныктап, чечмелеп чыгышын камсыз кылган оптикалык камера байланышы; бул изилдөөдө максат ачык QR коддун ордуна сүрөттүн визуалдык бүтүндүгүн негизинен сактаган терең үйрөнүүгө негизделген маалымат жайгаштыруу жана кайра чыгаруу ыкмасын колдонуу.
QR коддон көрүнбөгөн маалымат жайгаштырууга
QR коддор D2C байланыштын эң белгилүү түрлөрүнүн бири; бирок жогорку контрасттагы кара-ак модулдар, finder pattern-дер жана ачык код геометриясы алып жүрүүчү сүрөттүн дизайнын чектейт. QR коддун болушу сүрөттө машина окуй ала турган маалымат бар экенин да байкоочуга түз көрсөтөт.
Терең маалымат жайгаштыруу ыкмалары башка максатты көздөйт. Экилик маалымат алып жүрүүчү сүрөттүн ичинде адамдын көзүнө мүмкүн болушунча аз байкала турган өзгөрүүлөр аркылуу берилет. Камера сүрөттү кайра тартканда neural decoder бул жашыруун үлгүнү кайра чыгарууга аракет кылат.
Бул процесс санариптик сүрөт файлын жөн гана башка компьютерге көчүрүү эмес. Экран → оптикалык чөйрө → камера чынжыры ишке киргенде перспектива, фокус, кыймыл, экрандын түс мүнөздөмөсү, сенсордук ызы-чуу жана сүрөттү туура эмес жерден кесүү сыяктуу кошумча бузулуучу таасирлер пайда болот. Адабиятта санариптик дүйнөдөн физикалык дүйнөгө өтүү көйгөйү көп учурда “analog hole” түшүнүгүндө каралат.
Изилдөө чечүүгө аракет кылган негизги боштук
Мурунку терең үйрөнүүгө негизделген D2C ыкмалары ызы-чуу, кысуу, перспектива жана бүдөмүктүк сыяктуу бузулууларга туруктуулукту кыйла жакшырткан. Бирок практикалык системада decoder-га сүрөттүн кайсы бөлүгү берилерин адегенде объектти аныктоо же жайгаштырууну аныктоо системасы белгилеши керек.
Чыныгы камера кадрындагы экрандын бурчтары бир нече пикселге туура эмес табылса, кесилген сүрөт туура чек аралардын ичинде калбай калышы мүмкүн. Чек арадан сыртка чыккан crop decoder-га экрандын сыртындагы фон пикселдерин берет. Тескери багыттагы ката болсо сүрөттүн чыныгы ички бөлүгүндөгү маалымат алып жүргөн пикселдерди кесип салышы мүмкүн.
Ошондуктан изилдөөнүн негизги көйгөйү жөн гана “ызы-чууга туруктуу жашыруун маалымат” эмес. Негизги суроо — upstream объектти аныктоо баскычы идеалдуу эмес D2C системасында маалыматты кантип ишенимдүү кайра чыгарууга болот? — деген суроо.
ROI Негизиндеги Маалымат Жайгаштыруу Жайгашуу Каталарына Эмне Үчүн Туруктуураак?
ROI негизиндеги ыкма экилик маалымат жүгүн сүрөттүн сезгич тышкы чек араларына чейин жайылтуунун ордуна, четтерден белгилүү коопсуздук маржасы менен бөлүнгөн туруктуу ички аймакка топтойт; ошентип аныкталган экран чек арасы бир нече пикселге сыртка же ичке жылганда decoder-дын фон пикселдерине жетип калышы же маалымат алып жүргөн маанилүү ички пикселдерди жоготуп алуу ыктымалдыгы азаят.
%1 четки буфер
Булактагы ыкмада ROI маржасы сүрөттүн бийиктиги менен туурасынын так %1 и деп белгиленген. 400 × 400 × 3 кириш сүрөтүндө ар бир четтен 4 пиксел бөлүнөт. Натыйжада натыйжалуу маалымат жайгаштыруу аймагы:
392 × 392 × 3
өлчөмүнө келет.
Бул түзүлүштүн максаты жөн гана кичирээк сүрөт колдонуу эмес. Маржа жайгашуу жана перспектива каталары эң көп таасир эткен тышкы чек аралар менен жайгаштырылган маалымат жүгүнүн ортосунда геометриялык буфер түзөт.
Overshooting жана undershooting каталары
Булак жайгашуу каталары эки негизги бузулуу түрүн жаратарын түшүндүрөт. Overshooting — аныкталган чек аранын чыныгы экран аймагынан сыртка чыгып кетиши жана decoder-дын фон пикселдерин көрүшү. Undershooting болсо чек аранын керектүүдөн ашык ичкери жылышы жана маалымат алып жүргөн чыныгы сүрөт пикселдеринин жоголушу.
ROI маалымат жүгүн тышкы четтен алыстатканы үчүн эки ката түрүнө тең геометриялык толеранттуулук берет. Бул ыкма жайгашуу катасын жок кылбайт; максаты decoder-дын белгилүү чоңдуктагы каталарга сезгичтигин азайтуу.
Сунушталган системанын жалпы иштетүү чынжыры
| Баскыч | Иш-аракет | Илимий милдети |
|---|---|---|
| 1 | Баштапкы сүрөт + L-bit маалымат | Алып жүрүүчү сүрөт менен берилүүчү экилик билдирүүнү системага киргизүү |
| 2 | ROI бөлүп алуу | Туруксуз сүрөт четтеринен %1 коопсуздук маржасын калтыруу |
| 3 | Маалыматты FC катмарында кайра калыптандыруу | Экилик билдирүүнү сүрөт мейкиндиги менен бириктирүүгө боло турган тензорго айлантуу |
| 4 | Encoder | Сүрөт жана маалымат өзгөчөлүктөрүнөн residual image түзүү |
| 5 | Residual + баштапкы сүрөт | Визуалдык жактан жогорку окшоштуктагы encoded image түзүү |
| 6 | Бузулуу модели | Физикалык экран-камера каналындагы бузулууларды үйрөтүү маалында окшоштуруп моделдөө |
| 7 | ROI бөлүп алуу | Decoder-дын маалымат алып жүргөн туруктуу ички аймакка көңүл бурушу |
| 8 | Decoder | Сүрөт өзгөчөлүктөрүн кичирейтип L-bit билдирүүнү кайра чыгаруу |
Экилик маалымат сүрөт мейкиндигине кантип өткөрүлөт?
Encoder-га кирген L-bit binary string адегенде fully connected (FC) катмары аркылуу 7500 × 1 векторго проекцияланат. Андан кийин бул вектор:
50 × 50 × 3
тензорго кайра калыптандырылат. Тензор pixel replication колдонулуп алып жүрүүчү сүрөттүн H × W × 3 мейкиндик өлчөмүнө чейин чоңойтулат.
ROI иштетүүсү жана zero padding ден кийин сүрөт менен маалымат тензору channel өлчөмү боюнча бириктирилип:
H × W × 6
өлчөмдүү бириккен кириш түзүлөт.
Encoder-дын expansion–preservation–contraction архитектурасы
Encoder үч функционалдык жолду камтыйт. Expansion pathway transposed convolution катмарлары аркылуу өзгөчөлүк карталарынын мейкиндик өлчөмүн чоңойтот. Максат — сүрөт жана маалымат өзгөчөлүктөрүн ар башка масштабдарда бириктирүү.
Preservation pathway convolution операциялары менен маанилүү өзгөчөлүктөрдү сактоого аракет кылат. Contraction pathway болсо pooling жана convolution катмарлары менен чоңойтулган өзгөчөлүктөрдү кайра баштапкы сүрөт чечилишине чейин азайтат.
Алгачкы жана кийинки катмарлардын ортосундагы skip connection баштапкы өзгөчөлүктөрдү кийинки катмарларда кайра колдонууга мүмкүндүк берет. Encoder-дын акыркы чыгышы түздөн-түз акыркы сүрөт эмес; адегенде үч каналдуу residual image түзүлөт. Бул residual сүрөт баштапкы алып жүрүүчүгө кошулуп encoded image алынат.
| Бөлүм | Негизги түзүлүш | Булакта көрсөтүлгөн функция |
|---|---|---|
| Expansion | 6 transposed convolution катмары | Өзгөчөлүк картасын кеңейтип, сүрөт-маалымат бирикмесин көп масштабдуу кылуу |
| Preservation | Convolution + max pooling | Маанилүү визуалдык/маалымат өзгөчөлүктөрүн сактоо |
| Contraction | Convolution катмарлары | Мейкиндик өлчөмдөрүн кайра 400 × 400 ге азайтуу |
| Skip connection | Алгачкы жана кийинки катмар байланышы | Баштапкы өзгөчөлүктөрдү кийинки баскычтарда кайра колдонууга мүмкүндүк берүү |
| Чыгыш | 400 × 400 × 3 residual image | Баштапкы сүрөткө кошула турган майда өзгөрүүлөрдү түзүү |
Decoder эмне үчүн “thin” түзүлүштү колдонот?
Decoder-дын милдети визуал түзүү эмес, encoded image ичиндеги экилик үлгүнү мүмкүн болушунча натыйжалуу кайра чыгаруу. Ошондуктан архитектура feature map өлчөмдөрүн баскыч-баскыч кичирейткен жөнөкөйлөтүлгөн түзүлүштү колдонот.
Decoder алты convolution катмарынан, эки average pooling операциясынан жана бир FC катмарынан турат. Алгачкы үч convolution катмарында stride 1, кийинки үчөөндө stride 2 колдонулат. Convolution катмарлары padding жок иштетилет жана ReLU активациялары колдонулат.
392 × 392 × 3 ROI кириши баскыч-баскыч кичирейтилип, акыркы convolution чыгышында 10 × 10 × 64 өзгөчөлүк картасына жетет. FC катмары sigmoid активациясы менен 100 чыгыш берет. Акыркы баскычта 0,5 binary threshold колдонулуп, баштапкы 100 bit тизмектин божомолу алынат.
Физикалык канал кайсы бузулуулар менен моделденет?
Изилдөө бузулууларды экран тарабы жана камера тарабы болуп эки топко бөлөт.
| Тарап | Бузулуу | Булакта колдонулган диапазон |
|---|---|---|
| Экран | JPEG кысуу | Quality factor Q = 50–100 |
| Экран | Контраст | 0,5–1,5 масштабдоо |
| Экран | Жарыктык | Эң көп ±0,3 жылдыруу |
| Экран | Hue | Эң көп ±0,1 жылдыруу |
| Экран | Saturation | 0,0–1,0 desaturation фактору |
| Камера | Motion blur | 7 × 7 linear blur; σ = 0,25–1,0 |
| Камера | Defocus | 7 × 7 Gaussian blur; σ = 1,0–3,0 |
| Камера | Perspective warping | Random homography; максимум ±%10 translation scale |
| Камера | Internal sensor noise | Additive white Gaussian noise; μ = 0, σ = 0–0,02 |
Defocus blur жана motion blur үйрөтүү үлгүлөрүнө өз-өзүнчө %25 ыктымалдык менен колдонулган. Калган %50 бөлүккө бүдөмүктүк колдонулган эмес. Бул тандоо моделдин blur бар сүрөттөргө гана ыңгайлашып калуусун алдын алып, аны ар кандай канал абалдарына дуушар кылууну көздөйт.
Жоготуу функциясы кайсы максаттарды тең салмактайт?
Модель encoder менен decoder-ды учтан-учка биргелешип үйрөтөт. Булакта жалпы максат функциясы:
\[ L_{\mathrm{total}} = \lambda_1 L_{\mathrm{LPIPS}} + \lambda_2 L_{2} + \lambda_3 L_{\mathrm{DATA}} + \lambda_4 L_{\mathrm{GAN}} \tag{1} \]
деп аныкталган.
\(L_{\mathrm{LPIPS}}\) баштапкы жана encoded сүрөттүн perceptual өзгөчөлүктөрүнүн окшоштугун сактоого аракет кылат. \(L_2\) YUV түс мейкиндигиндеги пиксел деңгээлиндеги айырманы жазалап, түзүмдүк/визуалдык тактыкты колдойт.
\(L_{\mathrm{DATA}}\) баштапкы L-bit билдирүү менен decoder кайра түзгөн чыгыштын ортосундагы binary cross-entropy жоготуусу. Бул маалыматты кайра калыбына келтирүү тактыгынын негизги үйрөтүү компоненти.
\(L_{\mathrm{GAN}}\) Wasserstein Generative Adversarial Network discriminator компоненти болуп, encoded сүрөттү булак сүрөттөрдөн статистикалык жактан оңой айырмалоого болбой тургандай кылууну көздөйт.
Үйрөтүүдө салмактардын катышы:
λ1 : λ2 : λ3 : λ4 = 1,5 : 2 : 1,5 : 0,5
түрүндө колдонулган. Бул салмактар сүрөт сапаты, маалыматты кайра калыбына келтирүү жана adversarial максаттын ортосундагы оптималдаштыруу тең салмагын аныктайт.
WGAN компонентинин болушу системанын бардык steganalysis чабуулдарына каршы коопсуз экенин өзү эле далилдебейт. Изилдөө кеңири көз карандысыз steganalysis баалоосун бербейт.
Gaussian blur менен kernel өлчөмүнүн байланышы
Изилдөөнүн экинчи теңдемеси Gaussian blur standard deviation мааниси менен болжолдуу kernel өлчөмүнүн ортосундагы байланышты берет:
\[ k \approx 6\sigma_b+1 \tag{2} \]
Бул жерде \(k\) blur kernel-инин кыр узундугун, ал эми \(\sigma_b\) Gaussian blur standard deviation маанисин билдирет. Булак \(k\) так сан болушу керектигин белгилейт. Эксперименттерде 3 × 3, 5 × 5, 7 × 7 жана 9 × 9 kernel өлчөмдөрү бааланган.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Үйрөтүү конфигурациясы
| Параметр | Маани |
|---|---|
| Үйрөтүү маалымат топтому | MIRFLICKR |
| Сүрөт өлчөмү | 400 × 400 × 3 |
| Демейки маалымат жүгү | 100 bit |
| Жалпы үйрөтүү кадамы | 160.000 |
| Баштапкы decoder-only үйрөтүү | Алгачкы 2000 кадам; негизги маалыматты калыбына келтирүү тактыгы >%95 максаты |
| Batch size | 2 |
| Learning rate | 10−4 |
| Total-loss optimizer | Adam |
| WGAN critic optimizer | RMSProp |
| Loss салмактары | 1,5 : 2 : 1,5 : 0,5 |
| Үйрөтүү жабдыгы | NVIDIA GeForce RTX 3060 |
Тест маалымат топтому жана физикалык эксперимент
Жалпы сүрөт сапатын жана маалыматты калыбына келтирүүнү баалоо үчүн MS COCO дан туш келди тандалган 10.000 сүрөт колдонулган. Санариптик баалоодон тышкары сүрөттөр чыныгы монитордо көрсөтүлүп, смартфон камерасы менен кайра тартылган.
| Компонент | Булакта көрсөтүлгөн өзгөчөлүк |
|---|---|
| Экран | LG monitor |
| Экран чечилиши | 2560 × 1080 пиксел |
| Экран жаңыртуу жыштыгы | 60 Hz |
| Камера | Samsung Galaxy S22+ |
| Камера чечилиши | 1920 × 1080 пиксел |
| Камеранын кадр ылдамдыгы | 30 fps |
| Zoom | 0,6 |
| Жарыктандыруу | Стандарттуу жабык жайдагы шып жарыктандыруусу |
| Аралык сыноосу | 20–40 cm |
| Бурч сыноосу | 30 cm туруктуу аралыкта 0°–45° перспектива өзгөрүүлөрү |
BER, PSNR жана SSIM Бул Изилдөөдө Эмнени Өлчөйт?
BER калыбына келтирилген экилик билдирүүдөгү bit каталарынын үлүшүн жана ошону менен байланыштын ишенимдүүлүгүн өлчөйт; төмөн BER маалыматты жакшыраак калыбына келтирүүнү билдирет. PSNR баштапкы жана encoded сүрөттүн ортосундагы пиксел деңгээлиндеги бузулуунун чоңдугун dB менен баалайт жана жогорку маани артыкчылыктуу. SSIM болсо сүрөттөрдүн түзүмдүк окшоштугун баалайт жана 1 ге жакын маанилер жогорку түзүмдүк окшоштукту көрсөтөт.
Негизги StegaStamp салыштыруусу
| Ыкма | PSNR (dB) | SSIM | BER |
|---|---|---|---|
| StegaStamp | 28,6677 | 0,9170 | %0,0879 |
| Сунушталган модель | 31,3438 | 0,9605 | %0,0080 |
Сунушталган ыкма үч метрикада тең StegaStamp-ке караганда жакшы жыйынтык берген. Булак BERдин азайышын %90,90 деп билдирет. Сүрөт сапатындагы өсүш PSNRде 2,6761 dB жана SSIMде 0,0435 айырма катары берилген.
Gaussian noise шартындагы натыйжалуулук
Gaussian noise эксперименттеринде SNR азайган сайын BER жогорулаган. Бул күтүлгөн тенденция сигналдагы ызы-чуунун көлөмү көбөйгөн сайын decoder-га жайгаштырылган bit үлгүсүн ажыратуу кыйындашы менен байланышкан.
SNR = 25 dB чекитинде StegaStamp болжол менен %0,22 BER көрсөткөндө, сунушталган модель болжол менен %0,11 BER алган. Булак бул айырманы %48,97 ишенимдүүлүк жакшыртуусу деп мүнөздөйт.
SNR 30 dB ден жогорулаганда сунушталган моделдин BER-и булакта StegaStamp-ке салыштырмалуу %85–91 төмөн деп берилген. SNR 20 dB ден төмөн болгон жогорку ызы-чуу режиминде эки модель тең байкаларлык начарлайт.
Gaussian blur шартындагы натыйжалуулук
| Ыкма | 3 × 3, σ=0,3 | 5 × 5, σ=0,6 | 7 × 7, σ=1,0 | 9 × 9, σ=1,2 |
|---|---|---|---|---|
| StegaStamp | %0,0868 | %0,0693 | %0,0664 | %0,0665 |
| Сунушталган модель | %0,0079 | %0,0076 | %0,0095 | %0,0103 |
Сунушталган модель 3 × 3 жана 5 × 5 blur шарттарында өтө төмөн BERди сактаган, 7 × 7 жана 9 × 9 да ката деңгээли өсө баштаган. Булак 9 × 9 максималдуу сыноо бүдөмүктүгүндө да сунушталган моделдин BER-и StegaStamp-ке караганда %84,51 төмөн экенин билдирет.
Эки моделдин тең айрым орточо күчтөгү blur шарттарында бузулбаган абалга караганда маалыматты жакшыраак калыбына келтириши көңүл бурууга арзыйт. Авторлор муну blur үйрөтүү distortion pipeline ичинде болушу жана тармактар бул бузулууга атайын даярдалганы менен түшүндүрүшөт.
Объектти аныктоодогу жайгашуу катасынын эмпирикалык өлчөөсү
Жайгашуу катасынын симуляциясынын реалдуу масштабын аныктоо үчүн BiSeNet объектти аныктоо модели 10.000 сүрөттө бааланган. Жайгашуу катасы 10 пиксел же андан аз болгондо аныктоо ийгиликтүү деп эсептелип, ийгилик көрсөткүчү %81,28 деп билдирилген.
Ийгиликтүү аныктоолордо x жана y окторундагы ката орточолору тиешелүүлүгүнө жараша 0,687 жана 0,178 пиксел; стандарттык четтөөлөр 2,719 жана 2,665 пиксел болгон.
Бул байкоолорго таянып сүрөттүн төрт чек бурчу x жана y окторунда көз карандысыз нормалдуу бөлүштүрүлгөн жайгашуу каталары менен perturbe кылынган.
Жайгашуу катасына туруктуулук
| Ыкма | μl=0, σl=0 | μl=0, σl=3 | μl=0, σl=5 |
|---|---|---|---|
| StegaStamp | %0,0879 | %0,1293 | %0,2240 |
| Сунушталган модель | %0,0080 | %0,0109 | %0,0550 |
Сунушталган системанын BER-и σl = 0 дон 5 ке өскөн сайын жогорулайт; демек ROI жайгашуу катасын толук жойбойт. Ошентсе да өсүш StegaStamp-ке салыштырмалуу кыйла чектелүү.
Булак σl = 3 үчүн StegaStamp-ке салыштырмалуу %91,57 BER азайышын, σl = 5 үчүн болсо %75,45 жакшыртууну билдирет. Мындан тышкары, σl = 5 шартындагы %0,0550 BER StegaStamp-тин жайгашуу катасы жок %0,0879 маанисинен да төмөн.
Чыныгы камера аралыгынын таасири
Чыныгы экран-камера экспериментинде аралык 20 cm ден 40 cm ге чейин көбөйтүлгөн. Сүрөттүн камера сенсорундагы мейкиндик изи кичирейгендиктен үлгүлөө чечилиши төмөндөп, BER жогорулайт.
Булак сунушталган система үчүн 20 cm де BER = 0,0003, 30 cm де BER = 0,0009 жана 40 cm де BER = 0,0053 маанилерин билдирет. 20 cm деги ката азайышы StegaStamp-ке салыштырмалуу %89,29, ал эми 40 cm деги артыкчылык %65,13 деп берилген.
Бул бөлүмдө булак BER маанилерин пайыз белгисиз бергендиктен Verianla тексти аларды автоматтык түрдө пайызга айландырган эмес.
Перспектива бурчунун таасири
Камера–экран аралыгы 30 cm де туруктуу кармалып, камера бурчу 0° ден 45° ге чейин өзгөртүлгөн. Бурч чоңойгон сайын perspective warping жана пиксел дал келтирүү каталары көбөйгөндүктөн эки системанын BER-и тең жогорулаган.
Сунушталган модель 0° де BER = 0,0009 жана 45° оң ротацияда максималдуу BER = 0,0035 көрсөткөн. StegaStamp үчүн 0° мааниси 0,0052, ал эми 45° сол ротациядагы маани 0,0193 деп берилген.
Авторлор бул айырманы ROIнин четки nonlinearity жана localization jitter таасирлерине каршы буфер түзүшү жана көп масштабдуу encoder/ичке decoder архитектурасынын маалымат өзгөчөлүктөрүн сакташы менен байланыштырышат.
Маалымат жүгү көбөйгөндө эмне болот?
| Метрика | 50 bit | 100 bit | 200 bit |
|---|---|---|---|
| PSNR (dB) | 31,3525 | 31,3438 | 29,4619 |
| SSIM | 0,9609 | 0,9605 | 0,9458 |
| BER | %0,0072 | %0,0080 | %0,1106 |
50 bitтен 100 bitке өткөндө сүрөт сапаты жана BER болгону майда өзгөрүүлөрдү көрсөтөт. Ал эми 200 bit маалымат жүгү сүрөттүн тактыгын да, маалыматты калыбына келтирүү ийгилигин да байкаларлык төмөндөтөт.
Булак 200 bitтеги %0,1106 BER 100 bitтеги %0,0080 мааниден болжол менен 13,8 эсе жогору экенин белгилейт. Жогорку маалымат тыгыздыгы алып жүрүүчү сүрөттө күчтүүрөөк өзгөрүүлөрдү талап кылгандыктан көрүнбөстүк менен маалыматты ажыратуунун ортосундагы тең салмак начарлайт.
Ошондуктан изилдөө каралган архитектура жана шарттарында натыйжалуулук–сыйымдуулук тең салмагы үчүн 100 bitти тандаган. Бул жыйынтык “100 bit бардык D2C системалары үчүн универсалдуу оптимум” дегенди билдирбейт.
Эсептөө татаалдыгы
| Өлчөм | StegaStamp | Сунушталган модель |
|---|---|---|
| FLOPs | 55,19 M | 2,52 M |
| Үйрөтүлүүчү параметр | 54,27 M | 2,24 M |
| Орточо decoding убактысы | 7,1 ms | 4,1 ms |
Булак FLOPs санында болжол менен 22 эсе, үйрөтүлүүчү параметрлердин санында болжол менен 24 эсе азайуу болгонун билдирет. Негизги себеп — decoder архитектурасынын жөнөкөйлөштүрүлгөнү. Төмөн эсептөө жүгү мобилдик D2C колдонмолору үчүн маанилүү артыкчылык мүмкүнчүлүгүн берет; бирок изилдөө ар башка мобилдик процессорлордо энергия керектөөсүн же учтан-учка колдонмо кечигүүсүн өлчөбөйт.
ROI ablation изилдөөсү эмнени көрсөттү?
Ablation экспериментинде ROI модулу алып салынганда decoder-дын акыркы convolution чыгыш өлчөмү өзгөргөндүктөн салыштырууга боло турган архитектура түзүү үчүн биринчи convolution kernel өлчөмү 7 ге өзгөртүлгөн.
| Абал | PSNR (dB) | SSIM | BER |
|---|---|---|---|
| ROI жок — булактын түшүндүрмө тексти боюнча | 30,2658 | 0,9472 | %0,0611 |
| ROI менен — булактын түшүндүрмө тексти боюнча | 31,3438 | 0,9605 | %0,0080 |
Булактын баяны боюнча ROI жок болгондо BER %0,0611 болсо, ROI кошулганда %0,0080 га түшөт; бул болжол менен 7,6 эсе жакшыртуу деп берилген. PSNR жана SSIM да ROI менен бир аз жогорулайт.
Ablation жыйынтыгы ROI жөн гана архитектуралык дизайн деталдарынын бири эмес экенин, булакта билдирилген маалыматты калыбына келтирүү ийгилигинин маанилүү бөлүгүнө салым кошорун колдойт.
Изилдөө колдогон жыйынтыктар
Изилдөө каралган маалымат топтомдору жана эксперимент шарттарында ROI негизиндеги, жайгашуу катасына толеранттуу терең маалымат жайгаштыруу ыкмасы StegaStamp-ке караганда жогорку сүрөт сапатын жана төмөн BERди камсыз кыла аларын колдойт.
Симуляцияланган Gaussian noise, Gaussian blur жана жайгашуу катасы эксперименттери сунушталган архитектура бул бузулуучу таасирлерге туруктуураак экенин көрсөтөт. Көзөмөлдөнгөн чыныгы экран-камера эксперименттери да 20–40 cm аралык жана 0°–45° перспектива диапазонунда артыкчылык физикалык сүрөттөө каналына өтө аларын көрсөтөт.
Ablation изилдөөсү ROI модулу маалыматты калыбына келтирүү ийгилигине олуттуу салым кошорун; эсептөө татаалдыгын салыштыруу болсо ичке decoder архитектурасы төмөн FLOPs, аз параметр жана кыска decoding убактысын камсыз кыларын көрсөтөт.
Изилдөө колдобогон жалпылоолор
Изилдөө сунушталган системанын бардык экрандарда, бардык камераларда, бардык жарык шарттарында же сыртта бирдей натыйжа берерин далилдебейт. Чыныгы эксперимент белгилүү LG монитор, Samsung Galaxy S22+ камера, көзөмөлдөнгөн шып жарыктандыруусу жана туруктуу орнотуу шарттарында жүргүзүлгөн.
Изилдөө бардык маалымат жүктөрүндө жогорку натыйжалуулукту кепилдебейт. 200 bit эксперименти сыйымдуулук көбөйгөн сайын сүрөт тактыгы жана BER көрсөткүчү байкаларлык начарлай аларын көрсөтөт.
Изилдөө WGAN loss колдонгону үчүн бардык steganalysis ыкмаларына каршы криптографиялык же стеганографиялык коопсуздукту далилдебейт. Dedicated чабуул баалоосу бул макаланын эксперименттик чегине кирбейт.
Изилдөө upstream объектти аныктоону керексиз кылбайт. BiSeNet менен экран/сүрөт жайгашуусун аныктоо дагы эле система чынжырынын бир бөлүгү; сунушталган ROI ыкмасы ушул баскычтагы кемчиликтерге туруктуулукту жогорулатууну көздөйт.
Чектөөлөр жана келечектеги изилдөөлөр
Булак жыйынтык бөлүмүндө сыйымдуулук менен байланыш ийгилигинин ортосундагы компромиссти кеңири изилдөөнү келечектеги иш катары көрсөтөт. Өзгөчө өзгөрмө маалымат жүгүнүн модель архитектурасына жана сүрөт сапатына таасирин кенен диапазондордо баалоо керек.
Авторлор ар бир loss компонентинин салымын өзүнчө изилдөөнү да сунушташат. Азыркы изилдөө ROI үчүн ablation бергени менен LPIPS, L2, DATA жана GAN loss компоненттеринин баарына өз алдынча кеңири ablation бербейт.
Физикалык текшерүүнү ар башка экрандар, камералар жана жарыктандыруу шарттары менен кеңейтүү да ачык келечектеги изилдөө максаты. Бул жагдай азыркы реалдуу дүйнөдөгү жыйынтык түзмөктөн көз карандысыз жалпы натыйжалуулуктун далили эмес экенин көрсөтөт.
Акырында, авторлор өзгөрмө маалымат жүктөрүнө жана ар башка сүрөт чечилиштерине ыңгайлаша ала турган адаптивдүү алгоритмдерди иштеп чыгууну сунушташат. Мындай кеңейтүү D2C ыкмасын ар түрдүү ubiquitous computing сценарийлеринде колдонууга багытталат.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска аталышы: Robust Display-to-Camera Communication via Location Error-Tolerant Deep Data Embedding.
Авторлор: Dae-Gyu Lee; Pankaj Singh; Sung-Yoon Jung.
Жооптуу авторлор: Pankaj Singh; Sung-Yoon Jung.
Мекеме: Department of Electronic Engineering, Yeungnam University, Gyeongsan, Gyeongsangbuk, Republic of Korea.
Журнал: Applied Sciences.
Басмакана: MDPI, Basel, Switzerland.
Басылма маалыматы: Applied Sciences 2026, 16, 8767.
DOI: 10.3390/app16178767.
Макаланын тарыхы: Алынган 29 май 2026; кайра кароо 22 июнь 2026; кабыл алынган 24 июнь 2026; жарыяланган 3 сентябрь 2026.
Булактын түрү: Рецензияланган, ачык жеткиликтүү оригиналдуу инженердик изилдөө макаласы; учтан-учка терең үйрөнүүгө негизделген модель иштеп чыгуу, симуляцияланган канал бузулуулары жана көзөмөлдөнгөн физикалык экран-камера текшерүүсү.
Лицензия: Creative Commons Attribution 4.0 International (CC BY 4.0). Автордук укук авторлорго таандык.
Негизги ыкма: ROI негизиндеги, жайгашуу катасына толеранттуу encoder–decoder D2C маалымат жайгаштыруу архитектурасы.
Encoder: Expansion, preservation жана contraction жолдору; transposed convolution, convolution, pooling жана skip connection; residual-image үйрөнүүсү.
Decoder: Алты convolution катмары, эки average-pooling операциясы жана sigmoid чыгыштуу FC катмары; 0,5 binary threshold.
Үйрөтүү маалымат топтому: MIRFLICKR.
Тест маалымат топтому: MS COCO дан туш келди тандалган 10.000 сүрөт.
Сүрөт өлчөмү: 400 × 400 × 3 пиксел.
ROI: Сүрөттүн бийиктиги менен туурасынын ар бир четинде %1 маржа; 400 × 400 сүрөт үчүн 392 × 392 маалымат жайгаштыруу аймагы.
Демейки payload: 100 bit.
Үйрөтүү: 160.000 кадам; алгачкы 2000 кадам decoder loss багытында; batch size 2; learning rate 10−4.
Optimizer: Total loss үчүн Adam; WGAN critic үчүн RMSProp.
Loss: LPIPS + YUV L2 + binary-cross-entropy DATA + WGAN discriminator loss.
Натыйжалуулук метрикалары: PSNR, SSIM жана BER.
Чыныгы физикалык жабдык: LG 2560 × 1080 / 60 Hz монитор жана Samsung Galaxy S22+ 1920 × 1080 / 30 fps камера.
Салыштыруу ыкмасы: StegaStamp.
Каржылоо: Gyeongbuk ANCHOR system through the Gyeongbuk ANCHOR CENTER; Ministry of Education жана Gyeongsangbuk-do, Republic of Korea; долбоор 2026-ANCHOR-15-115.
Институционалдык этикалык кеңеш: Колдонулбайт.
Маалымдалган макулдук: Колдонулбайт.
Маалыматтардын жеткиликтүүлүгү: Булак макала жыйынтыктардын негизиндеги маалыматтар өзүнүн адабияттар тизмесиндеги [41] номерлүү булакта бар экенин билдирет.
Кызыкчылыктардын кагылышы: Авторлор кызыкчылыктардын кагылышы жок экенин билдиришкен.
Жасалма интеллектти колдонуу жөнүндө билдирүү: Авторлор ChatGPT 5.5 моделин макаланын тилин, окулушун жана мазмун уюштуруусун жакшыртуу үчүн колдонушканын; чыгышты карап чыгып түзөтүшкөнүн жана жарыяланган мазмун үчүн жоопкерчиликти өздөрүнө алышканын билдиришкен.
Авторлордун салымдары: Sung-Yoon Jung концептуалдаштыруу, supervision, долбоор башкаруу жана каржылоону алуу иштерине; Dae-Gyu Lee методология, программалык камсыздоо, formal анализ, изилдөө, маалымат курациясы жана баштапкы долбоорго; Pankaj Singh методология, текшерүү, formal анализ, кароо/түзөтүү жана визуалдаштырууга салым кошкон. Булактагы кеңири CRediT билдирүүсүндө айрым милдеттер бир нече автордун ортосунда бөлүштүрүлгөн.
Булак ичиндеги отчеттук эскертүү: 8-таблицанын эки сабы тең “Proposed (w/o ROI)” деп белгиленген; бирок дароо алдындагы текст экинчи жыйынтык топтомун ROI кошулган сунушталган моделге таандык кылат. Мындан тышкары, айрым симуляция таблицаларында BER пайыз менен, ал эми чыныгы аралык/бурч эксперименттеринин түшүндүрмөсүндө пайыз белгисиз ондук түрүндө берилген. Бул Verianla мазмунунда бул пункттар болжол аркылуу унчукпай стандартташтырылган эмес.
Негизги методологиялык чектөө: Физикалык текшерүү чыныгы экран жана камераны колдонгону менен көзөмөлдөнгөн жабык жайда, белгилүү жабдыкта, чектелген аралык жана бурч диапазонунда жүргүзүлгөн. Жыйынтыктарды башка жабдык, жарыктандыруу, мобилдик кыймыл жана сырткы шарттарга автоматтык жалпылоого болбойт.
Визуалдык материалды кайра колдонуу эскертүүсү: Булак CC BY 4.0 лицензиясына ээ. Ошентсе да Verianla үчүн булак фигураларын экран сүрөтү катары көчүрүүнүн ордуна ыкма байланыштары менен сандык жыйынтыктарды оригиналдуу техникалык схема жана таблицалар аркылуу кайра куруу артык көрүлгөн.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген