


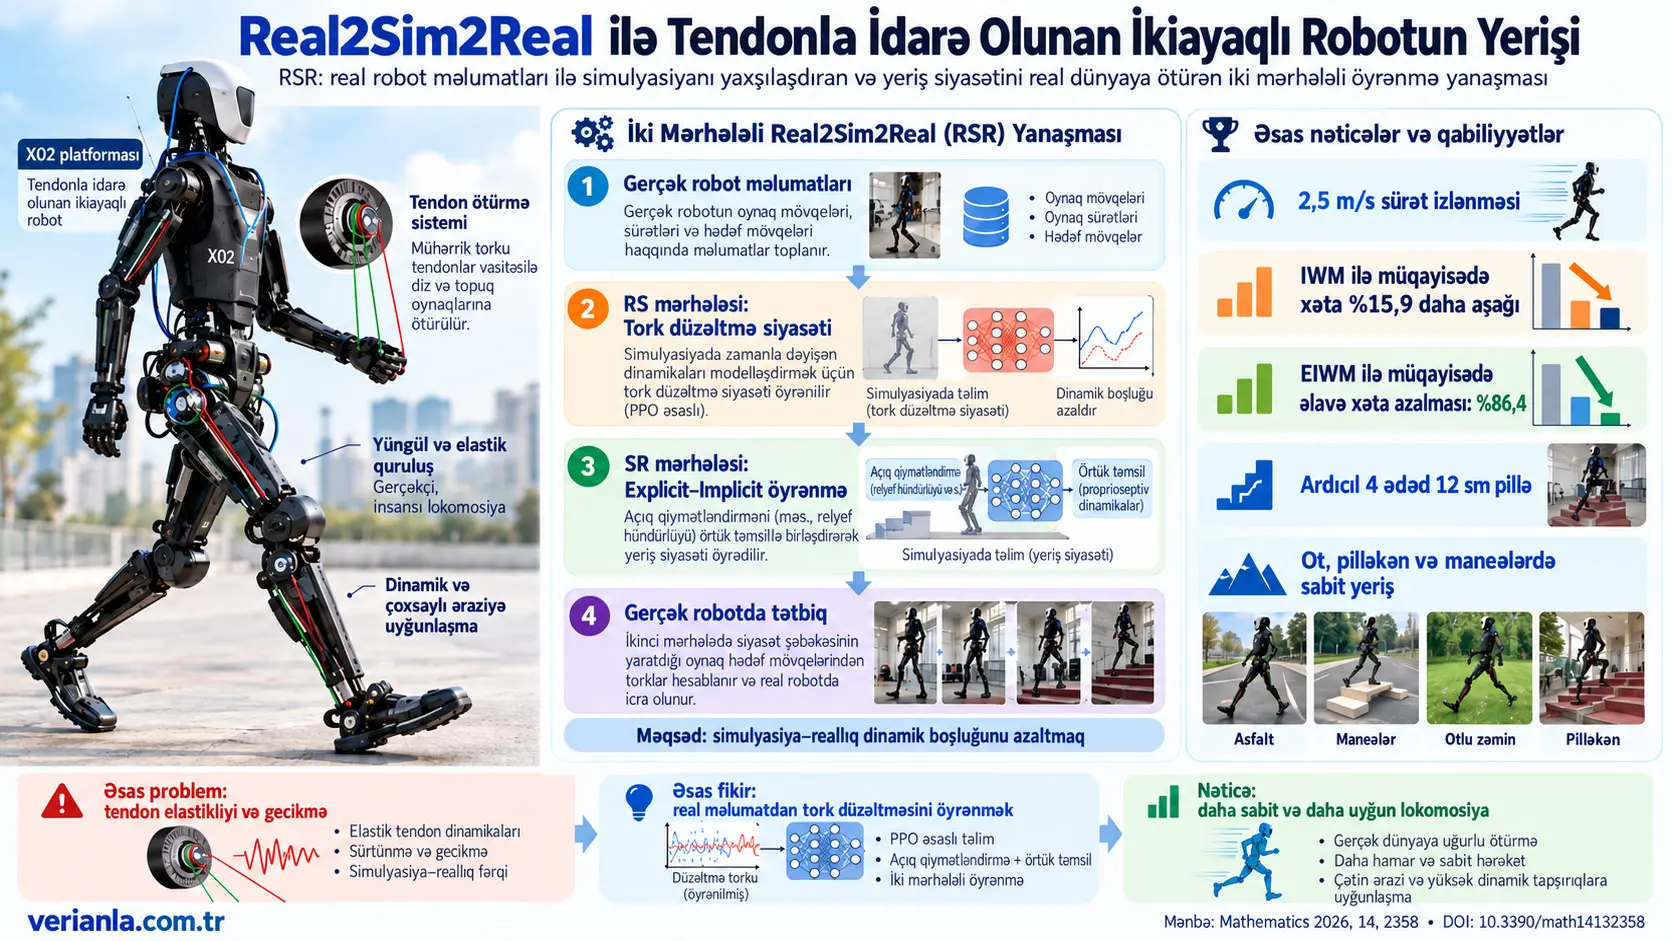
RSR (Real2Sim2Real), real tendonla idarə olunan robotun ölçülmüş oynaq hərəkətlərindən istifadə edərək simulyasiyadakı dinamik davranışı real robota yaxınlaşdıran və daha sonra bu düzəldilmiş simulyasiya üzərində lokomosiya siyasətini öyrədən iki mərhələli möhkəmləndirici öyrənmə çərçivəsidir. Tədqiqatın məqsədi tendon elastikliyi, sürtünmə, boşluq, çoxoynaqlı əlaqələnmə və ötürmə gecikməsi səbəbindən ideal birbaşa ötürücülü simulyasiya modeli ilə fiziki tendon robotu arasında yaranan sim-to-real dinamik boşluğu azaltmaqdır.
Birinci mərhələdə real robotdan oynaq hədəf mövqeyi, real oynaq mövqeyi və oynaq sürəti məlumatları toplanır. Bu məlumatlar simulyasiyaya ötürülür və möhkəmləndirici öyrənmə ilə fırlanma momentinin düzəldilməsi siyasəti öyrədilir. Tədqiqatçılar tendonun bütün fiziki parametrlərini bir-bir müəyyən etmək əvəzinə, modelləşdirilməsi çətin olan zamanla dəyişən davranışları ideal simulyasiya modelindən sapma kimi qəbul edir və bu sapmanı \(c_t\) adlı öyrənilmiş fırlanma momenti çarpanı ilə düzəldirlər.
İkinci mərhələdə yerimə siyasəti öyrədilir. Metod yalnız örtük latent təsvirə güvənmir. Robot gövdəsinin xətti sürətini və ayaqların altındakı yerli relyef hündürlüyünü açıq şəkildə qiymətləndirir; eyni zamanda keçmiş proprioseptiv müşahidələrdən birbaşa fiziki qarşılığı olmayan tapşırıqla əlaqəli örtük xüsusiyyətlər öyrənir. Beləliklə, açıq fiziki vəziyyət məlumatı ilə modelləşdirilməsi çətin olan təmas və dinamik xüsusiyyətlər eyni siyasətdə birləşdirilir.
Simulyasiyada IWM, EIWM və RSR müqayisə edilmişdir. IWM-in orta mükafatı 23,33, EIWM-in 35,67 və RSR-in 35,83 olaraq bildirilmişdir. Orta relyef çətinlik səviyyələri müvafiq olaraq 3,68, 4,58 və 4,56; xətti sürət izləmə mükafatları isə 0,82, 0,95 və 0,97-dir. Bu nəticələr explicit–implicit təsvirin yalnız örtük təsvirə nisbətən təlim performansını artırdığını, RS fırlanma momenti düzəltməsinin isə simulyasiyadakı siyasət performansını nəzərəçarpacaq dərəcədə pisləşdirmədiyini göstərir.
Fiziki robot təcrübələri təxminən 1,70 m hündürlüyündə, 32 kg ağırlığında X02 tendonla idarə olunan ikiayaqlı robot üzərində aparılmışdır. Yalnız aşağı gövdədəki 10 sərbəstlik dərəcəsi idarə edilmiş, siyasət RK3588 üzərində 100 Hz tezliyində işlədilmişdir. 2,5 m/s irəli sürət əmrində RSR-in orta real sürəti 2,41 m/s olduğu halda EIWM 1,84 m/s-ə çatmışdır. Mənbə explicit–implicit öyrənmənin yalnız örtük IWM yanaşmasına nisbətən sürət izləmə xətasını %15,9 azaltdığını; RSR-in fırlanma momenti düzəltmə mərhələsinin əlavə olunması ilə EIWM-ə nisbətən xətanın əlavə olaraq %86,4 azaldığını bildirir.
Robot həmçinin ardıcıl dörd 12 cm pilləli pilləkən, 20 cm ayrıq maneələr, iki pilləli 10 cm pilləkən, asfalt və yumşaq maili ot örtüyü üzərində sınaqdan keçirilmişdir. Tədqiqatda bu ssenarilərdə sabit hərəkət bildirilib. Xüsusilə yumşaq ot örtüyü simulyasiya təlim mühitində olmayan təmas şərtidir.
Bu nəticələrin mühüm məhdudiyyəti təcrübələrin yalnız bir X02 platforması və tədqiqatda müəyyən edilmiş təlim/təcrübə şərtləri üçün aparılmasıdır. Tədqiqat bütün tendonla idarə olunan robotlarda eyni performansın təmin edildiyini göstərmir. Mövcud yanaşma xarici mühiti birbaşa kamera ilə qavramır; tədqiqatçılar daha mürəkkəb relyef üçün vizual məlumatı gələcək tədqiqatlarda sistemə əlavə etməyi planlaşdırırlar.
1. Tendonla idarə olunan robot nə deməkdir?
Tendonla idarə olunan robotda motorun birbaşa hərəkət etdiriləcək oynağın üzərində yerləşməsi məcburi deyil. Motor gövdənin daha proksimal nöqtəsinə yerləşdirilə və motor qüvvəsi kabel və ya tendonabənzər elastik ötürücü elementlə dizə, topuğa və ya başqa bir oynağa ötürülə bilər.
Bu yanaşma bioloji əzələ–tendon düzülüşünə bənzər prinsipdən istifadə edir. Ağır motorların distal oynaqlardan uzaqlaşdırılması ayaqların ətalətini və kütləsini azalda bilər. Bunun müqabilində idarəetmə problemi daha mürəkkəbləşir; çünki motorun hərəkəti ilə oynağın real cavabı arasına tendonun fiziki davranışı daxil olur.
2. Tendon niyə simulyasiya ilə real robot arasında boşluq yaradır?
Mənbə beş əsas fiziki problem üzərində dayanır. Tendonun oxboyu elastikliyi səbəbindən oynaq cavabı motor əmrini gecikmiş və ya rəqsi şəkildə izləyə bilər. Tendonla kasnaq arasındakı sürtünmə və tendon liflərinin daxili sönümlənməsi enerji itkisinə və qeyri-xətti davranışa səbəb ola bilər. Uzunmüddətli istifadə tendonun uzanmasına və ya boşluğuna səbəb olaraq backlash yarada bilər. Distal tendon yollarına görə bir oynağın hərəkəti başqa oynağın tendon gərginliyinə təsir edə bilər. Nəhayət, tendonun elastikliyi və kütlə paylanması qüvvə ötürmə zolaq enini məhdudlaşdıraraq yüksək tezlikli idarəetmə siqnallarını zəiflədə bilər.
MuJoCo və ya Isaac Gym kimi geniş istifadə olunan simulyasiyalarda hər oynağa ideal motor yerləşdirmək hesablama baxımından daha asandır. Lakin bu ideal model tendonun real, zamanla dəyişən davranışını təbii şəkildə yaratmır. Tədqiqatın “proprioseptiv dinamik boşluq” adlandırdığı fərqin əsasında bu vəziyyət dayanır.
3. Propriosepsiya nədir?
Robototexnika kontekstində proprioseptiv müşahidə, robotun öz gövdə və oynaqlarından ölçdüyü daxili vəziyyət məlumatıdır. Bu tədqiqatda oynaq mövqeyi, oynaq sürəti, gövdə orientasiyası və bucaq sürəti kimi məlumatlar proprioseptiv informasiya kimi istifadə olunur.
Kamera və ya xarici mühit xəritəsi proprioseptiv informasiya deyil. Tədqiqatın xüsusilə mühüm tərəfi real robot siyasətinin xaricdən verilən ayrıcalıqlı relyef xəritəsinə birbaşa ehtiyac duymadan keçmiş proprioseptiv müşahidələrdən istifadə etməsidir.
Real2Sim2Real bu tədqiqatda nə deməkdir?
Real2Sim2Real əvvəlcə real robotdan toplanan hərəkət məlumatları ilə simulyasiyanın robot dinamikasına yaxınlaşdırılması, sonra isə bu düzəldilmiş simulyasiyada lokomosiya siyasətinin öyrədilib yenidən fiziki robota ötürülməsidir; yəni məlumat axını yalnız Sim→Real deyil, Real→Sim→Real şəklindədir.
4. RSR-in iki mərhələsi
| Mərhələ | Mənbəyi | Öyrənilən struktur | Əsas məqsəd |
|---|---|---|---|
| Stage I — Real2Sim / RS | Real robotun oynaq hədəf mövqeyi, real mövqeyi və sürəti | Fırlanma momentinin düzəldilməsi siyasəti | İdeal simulyasiya ilə tendon robotunun zamanla dəyişən gövdə dinamikası arasındakı fərqi azaltmaq |
| Stage II — Sim2Real / SR | RS siyasəti ilə düzəldilmiş simulyasiya, keçmiş müşahidələr və privileged training state | Explicit–implicit lokomosiya siyasəti | Sürət izləmə, sabit yerimə və mürəkkəb relyefə uyğunlaşma |
| Real tətbiq | Real sensorlardan əldə edilə bilən müşahidələr | Stage II siyasət çıxışı + PD idarəetmə | Fiziki robot lokomosiyası |
5. Asimmetrik actor–critic arxitekturası nədir?
Möhkəmləndirici öyrənmədə actor, mövcud məlumata əsasən hansı hərəkətin tətbiq ediləcəyini müəyyən edən siyasətdir. Critic isə vəziyyətin və ya hərəkətin gözlənilən uzunmüddətli dəyərini qiymətləndirərək actor-un təliminə kömək edir.
“Asimmetrik” ifadəsi actor ilə critic-in eyni məlumata malik olmaması deməkdir. Təlim zamanı critic real dünyada birbaşa ölçülməsi çətin olan əlavə məlumatlara çıxış əldə edə bilər. Bunlara privileged information, yəni ayrıcalıqlı təlim məlumatı deyilir. Actor isə real robota ötürülə bilən sensor məlumatları ilə işləyəcək şəkildə öyrədilir.
Bu fərq mühümdür. Təlim zamanı relyef xəritəsinin həqiqi dəyəri məlum olaraq encoder-a düzgün hədəf öyrədilə bilər; lakin fiziki robot yeriyərkən bu həqiqi dəyər birbaşa siyasət girişinə verilmir.
6. Stage I müşahidəsi — Tənlik (1)
RS mərhələsindəki ani müşahidə mənbədə:
\[ o_t^{rs}= \begin{bmatrix} q_t^{rs} & \dot{q}_t^{rs} \end{bmatrix}^{T} \tag{1} \]
kimi müəyyən edilmişdir. \(q_t^{rs}\) oynaq mövqelərini, \(\dot{q}_t^{rs}\) oynaq sürətlərini göstərir. Mövqenin vahidi radian, bucaq sürətinin vahidi rad/s-dir.
Encoder-a yalnız bir zaman anı verilmir. Dörd zaman addımından ibarət keçmiş oynaq mövqeyi və sürət ardıcıllığı \(o_{H1}^{rs}\) istifadə olunur. Aşağı gövdə 10 sərbəstlik dərəcəsinə malik olduğuna görə bir zaman addımında 10 mövqe + 10 sürət vardır; dörd addımlıq keçmiş mənbədə 80 ölçülü vektor kimi müəyyən edilmişdir.
7. Stage I critic vəziyyəti — Tənlik (2)
\[ s_t^{rs}= \begin{bmatrix} o_t^{rs} & d_t^{rs} & m_t^{rs} \end{bmatrix}^{T} \tag{2} \]
Burada \(d_t^{rs}\) oynaq sönümlənməsini, \(m_t^{rs}\) motorun fırlanma ətalətini göstərir. Bunlar critic üçün istifadə olunan ayrıcalıqlı dinamik məlumatlardır.
Actor-un bunları real robot üzərində birbaşa ölçməsi tələb olunmur. Critic-in daha dolğun məlumatdan istifadə etməsi dəyər funksiyasının təlim zamanı daha az qeyri-müəyyənliklə öyrənilməsinə kömək etməyi hədəfləyir.
8. PPO itki funksiyası — Tənlik (3)
Siyasət Proximal Policy Optimization, yəni PPO ilə yenilənmişdir:
\[ \mathcal{L}_{\pi}= \min\left( \frac{\pi_{\theta}(a_t|s_t)} {\pi_{\theta_b}(a_t|s_t)} A^{\pi_{\theta_b}}(s_t,a_t), \operatorname{clip} \left( \frac{\pi_{\theta}(a_t|s_t)} {\pi_{\theta_b}(a_t|s_t)}, 1-\epsilon, 1+\epsilon \right) A^{\pi_{\theta_b}}(s_t,a_t) \right) \tag{3} \]
\(\pi_{\theta}\) yenilənən yeni siyasət, \(\pi_{\theta_b}\) isə əvvəlki iterasiyadakı davranış siyasətidir. İki siyasətin eyni hərəkətə verdiyi ehtimalların nisbəti yeni siyasətin köhnə siyasətdən nə qədər uzaqlaşdığını ifadə edir. \(A^{\pi_{\theta_b}}(s_t,a_t)\) advantage funksiyasıdır və müəyyən bir hərəkətin köhnə siyasətə görə gözləniləndən nə dərəcədə yaxşı və ya pis olduğunu qiymətləndirir.
\(\epsilon\) clipping sərhədidir. Tədqiqatda clipping range 0,2-dir. Nisbət \(1-\epsilon\) ilə \(1+\epsilon\) arasına sıxılaraq siyasətin bir yeniləmədə həddindən artıq dəyişməsinin qarşısı alınmağa çalışılır.
9. Critic dəyər itkisi — Tənlik (4)
\[ \mathcal{L}_{v}= \left( V_{\phi}(s_t)-\hat{R}_t \right)^2 \tag{4} \]
\(V_{\phi}(s_t)\), critic-in vəziyyət üçün qiymətləndirdiyi dəyərdir. \(\hat{R}_t\) müşahidə edilən və ya hesablanan hədəf qaytarımdır. İki dəyər arasındakı fərqin kvadratı azaldıqca critic-in gözlənilən qaytarımı daha dəqiq qiymətləndirməsi məqsədi güdülür.
10. Real robot məlumatı necə yaradıldı?
Real məlumatların toplanması zamanı robotun gövdə hündürlüyü sabit saxlanılmış və ayaq trayektoriyası sinus funksiyası ilə həyəcanlandırılmışdır. İstənilən ayaq mövqeləri tərs kinematikadan istifadə edilərək oynaq hədəflərinə çevrilmişdir.
Sinus amplitudası 5–20 cm, tezliyi 1–25 Hz arasında sistemli şəkildə dəyişdirilmişdir. Beləliklə, tendon sisteminin yalnız bir yavaş hərəkət şərtində deyil, müxtəlif zaman və tezlik miqyaslarında həyəcanlandırılması hədəflənmişdir.
Mövqe idarəetməsində aşağı sərtlikli PD nəzarətçi istifadə edilmişdir. Topuq üçün \(k_p=30\) və \(k_d=1\); digər oynaqlar üçün \(k_p=100\) və \(k_d=2\) qiymətləri verilmişdir.
Qeydə alınan əsas məlumatlar hədəf oynaq mövqeləri, real oynaq mövqeləri və oynaq sürətləridir. RS təlimində bu məlumatdan təsadüfi 1 saniyəlik ardıcıllıqlar götürülmüş, ardıcıllığın ilk zaman addımı simulyasiya robotunun başlanğıc vəziyyəti kimi istifadə olunmuşdur.
11. Stage I domain randomization
| Parametr | Vahid | Paylanma |
|---|---|---|
| Oynaq mövqeyi səs-küyü | rad | \(U(-0.05,0.05)\) |
| Oynaq sürəti səs-küyü | rad/s | \(U(-2,2)\) |
\(U(a,b)\), göstərilən aşağı və yuxarı sərhədlər arasında uniform paylanmanı ifadə edir. Oynaq sürətinə xüsusilə güclü ±2 rad/s səs-küy verilməsinin səbəbi real robotda sürətin çox vaxt mövqe siqnalının ədədi törəməsi ilə alınması və törəmə əməliyyatının sensor səs-küyünü böyüdə bilməsidir.
12. Fırlanma momenti düzəltmə idarəetməsi — Tənlik (5)
\[ \tau = c_t\cdot \left[ k_p \left( q_{tar}^{rs}-q^{rs} \right) - k_d\dot{q}^{rs} \right] \tag{5} \]
\(\tau\) oynağa tətbiq olunan fırlanma momentini, \(q_{tar}^{rs}\) hədəf oynaq mövqeyini, \(q^{rs}\) mövcud oynaq mövqeyini və \(\dot q^{rs}\) oynaq sürətini göstərir. \(k_p\) mövqe xətasına, \(k_d\) sürətə bağlı PD qazancıdır.
Tənlikdəki kritik yenilik \(c_t\)-dir. Bu qiymət RL siyasəti tərəfindən yaradılan fırlanma momenti düzəltmə əmsalıdır. Yəni şəbəkə sıfırdan fırlanma momenti yaratmaq əvəzinə mövcud PD fırlanma momentini zamanla dəyişən əmsalla miqyaslayır.
\(c_t\) mənbədə [0,8, 1,2] intervalına clamp edilmişdir. Beləliklə, siyasət PD fırlanma momentini ən çox təxminən %20 azalda və ya artıra bilər. Bu sərhəd təlim paylanmasından kənara çıxıldıqda həddindən artıq düzəltmələrin fiziki baxımdan təhlükəli və ya qeyri-sabit olmasının qarşısını alan qoruyucu məhdudiyyətdir.
13. RS mükafatı — Tənlik (6)
\[ r= \exp \left( -100 \left\| q_{real}-q_{sim} \right\|^2 \right) - 0.01 \left\| c_t-c_{t-1} \right\|^2 \tag{6} \]
Birinci termin simulyasiya oynaq mövqelərinin real robot oynaq mövqelərinə yaxınlaşmasını mükafatlandırır. \(q_{real}\) real robotdan qeydə alınan mövqe, \(q_{sim}\) simulyasiyadakı mövqedir. Xəta artdıqca eksponensial termin sürətlə kiçilir.
İkinci termin ardıcıl fırlanma momenti düzəltmə əmsallarının sürətli dəyişməsini cəzalandırır. Beləliklə, yalnız real hərəkəti izləmək deyil, bunu ani və nizamsız düzəlişlər əvəzinə daha hamar fırlanma momenti modulyasiyası ilə etmək hədəflənir.
14. Stage I təlim hiperparametrləri
| Parametr | Qiymət |
|---|---|
| Paralel mühitlərin sayı | 4096 |
| Öyrənmə sürəti | 5 × 10⁻⁴ |
| Discount factor | 0,99 |
| GAE coefficient | 0,95 |
| Batch sayı | 5 |
| Gradient clipping | 1 |
| PPO clipping range | 0,2 |
| Entropy coefficient | 0,002 |
| Policy hidden layers | [256, 128] |
| Critic hidden layers | [256, 128] |
| Encoder | [256, 128] |
| H1 | 4 zaman addımı |
Explicit–implicit öyrənmə niyə birlikdə istifadə olunur?
Explicit hissə gövdənin xətti sürəti və ayaq altındakı yerli relyef hündürlüyü kimi fiziki mənası aydın dəyişənləri birbaşa qiymətləndirərkən, implicit hissə təmas qeyri-müəyyənliyi və ya modelləşdirilməmiş dinamika kimi bir fiziki dəyişənə endirilməsi çətin, lakin idarəetmə üçün faydalı keçmiş nümunələri latent təsvirdə saxlayır; tədqiqat bu iki məlumat növünün birlikdə istifadəsinin yalnız implicit IWM yanaşmasından daha sürətli və daha uğurlu təlim təmin etdiyini göstərir.
15. İkinci mərhələdə robot müşahidəsi — Tənlik (7)
\[ o_t= \begin{bmatrix} cmd & q_t & \dot q_t & \Phi & \omega \end{bmatrix}^{T} \tag{7} \]
\(cmd\), istənilən hərəkət əmrlərini və gait phase məlumatını ehtiva edir. \(q_t\) oynaq mövqeyi, \(\dot q_t\) oynaq sürəti, \(\Phi\) gövdə duruşu/orientasiyası və \(\omega\) gövdənin bucaq sürətidir.
Oynaq mövqeyi və sürəti encoder-lardan; duruş və bucaq sürəti IMU-dan əldə edilə bilər. Əmr isə yuxarı səviyyəli idarəetmə modulundan gəlir.
16. Critic privileged state — Tənlik (8)
\[ s_t= \begin{bmatrix} o_t & v_t & h_t^{feet} & \mu_t \end{bmatrix}^{T} \tag{8} \]
\(v_t\) səs-küysüz real gövdə xətti sürəti, \(h_t^{feet}\) ayaqların altındakı relyef hündürlüyü xəritəsi, \(\mu_t\) isə səth sürtünmə əmsalıdır.
Bunların hamısı təlim zamanı critic-ə verilə bilər. Lakin real robot siyasətinin tətbiq zamanı bu privileged state-i birbaşa qəbul etməsi lazım deyil.
17. Açıq və örtük təsvir
Encoder keçmiş müşahidələrdən iki fərqli çıxış yaradır. \(e_t\) açıq, fiziki qarşılığı olan qiymətləndirmələri; \(z_t\) isə birbaşa müəyyən fiziki kəmiyyətə bərabər olmayan latent təsviri göstərir.
Açıq komponentin iki əsas çıxışı qiymətləndirilmiş gövdə xətti sürəti \(\tilde v_t\) və qiymətləndirilmiş yerli relyef hündürlüyü \(\tilde h_t^{feet}\)-dir.
Örtük \(z_t\) isə modelləşdirilməmiş dinamikanı, təmas qeyri-müəyyənliyini və keçmiş müşahidə nümunələrində olan tapşırıqla əlaqəli digər məlumatları sıxlaşdırmağı hədəfləyir.
18. Açıq qiymətləndirmə itkisi — Tənlik (9)
\[ \mathcal{L}_{ed} = \left\| v_t-\tilde v_t \right\|_2 + \left\| h_t^{feet}-\tilde h_t^{feet} \right\|_2 \tag{9} \]
Birinci termin real və qiymətləndirilmiş gövdə xətti sürəti arasındakı fərqi, ikinci termin real və qiymətləndirilmiş ayaqaltı relyef xəritəsi arasındakı fərqi ölçür.
Bu auxiliary loss encoder-i yalnız latent xüsusiyyətlər öyrənməklə kifayətlənməyib iki fiziki dəyişəni də açıq şəkildə təmsil etməyə məcbur edir.
19. Ümumi Stage II itkisi — Tənlik (10)
\[ \mathcal{L}_{sr} = \mathcal{L}_{ed} + \mathcal{L}_{\pi} + \mathcal{L}_{v} \tag{10} \]
Ümumi təlim məqsədi explicit estimation loss, PPO policy loss və critic value loss komponentlərinin birlikdə optimallaşdırılmasıdır. Actor, critic və encoder beləliklə end-to-end şəkildə birlikdə öyrədilir.
20. Lokomosiya PD idarəetməsi — Tənlik (11)
\[ \tau = c_t \cdot \left[ k_p \left( a_t+q_d-q \right) - k_d\dot q \right] \tag{11} \]
\(a_t\), siyasətin yaratdığı 10 ölçülü oynaq-mövqeyi residual hərəkətidir. \(q_d\) standart oynaq mövqeyi, \(q\) real mövqedir.
Siyasət 100 Hz-də yeni hərəkət yaradarkən PD nəzarətçi 500 Hz-də işləyir. Beləliklə, yüksək səviyyəli öyrənilmiş siyasət daha aşağı tezlikdə hədəf dəyişikliyi yaradır, aşağı səviyyəli PD dövrəsi isə fırlanma momentini daha tez-tez yeniləyir.
Stage I-in \(c_t\) fırlanma momenti düzəltmə əmsalı ikinci mərhələdə də PD fırlanma momentini vurur. Stage II təlimi zamanı Stage I fırlanma momenti düzəltmə şəbəkəsinin parametrləri sabit saxlanılır; gradient ilə yenidən dəyişdirilmir.
21. Mükafat funksiyasının quruluşu
| Komponent | Mənbə formulu | Çəki | Vəzifəsi |
|---|---|---|---|
| Xətti sürət izləmə | \(\exp(-4\|v_{xy}^{cmd}-v_{xy}\|^2)\) | 1 | İstənilən üfüqi sürəti izlətmək |
| Bucaq sürəti izləmə | \(\exp[-4(\omega_z^{cmd}-\omega_z)^2]\) | 1 | Şaquli ox üzrə fırlanma əmrini izlətmək |
| Bucaq sürəti cəzası | \(\|\omega_{xy}\|^2\) | −0,1 | Pitch/roll hərəkətini məhdudlaşdırmaq |
| Gövdə duruşu cəzası | \(\|g_{xy}\|^2\) | −2 | Gövdə əyilməsini azaltmaq |
| COM hündürlüyü cəzası | \((h-h_{des})^2\) | −1 | İstənilən gövdə hündürlüyünü qorumaq |
| Oynaq gücü cəzası | \(\|\tau\dot q\|^2\) | −1 × 10⁻³ | Yüksək güc istifadəsini məhdudlaşdırmaq |
| Oynaq təcili cəzası | \(\|\ddot q\|^2\) | −2,5 × 10⁻⁷ | Ani oynaq hərəkətlərini azaltmaq |
| Hərəkət dəyişikliyi cəzası | \(\|a_t-a_{t-1}\|^2\) | −0,01 | İdarəetmə siqnalını hamarlamaq |
| Stance-phase cəzası | \(r_{fc}\) | −1 | Swing zamanı arzuolunmaz təması azaltmaq |
| Swing-phase cəzası | \(r_{fv}\) | −1 | Stance ayağında sürüşməni azaltmaq |
| Gövdə toqquşması cəzası | \(n_{collision}\) | −1 | Arzuolunmaz gövdə/mühit təmasını azaltmaq |
22. Swing ayağının təmas cəzası — Tənlik (12)
\[ r_{fc} = \sum_i I_i(t) \left[ 1- \exp \left( -\frac{ \|f_{foot,i}\|^2 }{50} \right) \right] \tag{12} \]
\(I_i(t)=1\) olduqda müvafiq ayaq swing fazasındadır. Swing zamanı ayağın yerə böyük təmas qüvvəsi tətbiq etməsi arzuolunmazdır. Qüvvə artdıqca bu cəza yüksəlir və siyasətin ayağı kifayət qədər qaldırması təşviq olunur.
23. Stance ayağının sürüşmə cəzası — Tənlik (13)
\[ r_{fv} = \sum_i [1-I_i(t)] \left[ 1- \exp \left( -4 \|v_{xy}^{foot,i}\|^2 \right) \right] \tag{13} \]
Stance fazasında \(I_i(t)=0\) olduğuna görə müvafiq ayaq bu terminə töhfə verir. Ayaq dayaq verərkən üfüqi sürətinin böyük olması sürüşməyə işarə edə bildiyindən cəza artır.
24. Episode və əmr sərhədləri
Bir simulyasiya episode-u ən çox 24 saniyədir. Gövdənin roll və ya pitch bucağının mütləq qiyməti 0,785 rad qiymətini aşarsa və ya gövdə kütlə mərkəzinin hündürlüyü 0,3 m-dən aşağı düşərsə episode erkən dayandırılır.
Hərəkət əmrləri hər 2–6 saniyədən bir yenidən nümunələnir. İrəli/geri xətti sürət əmri \(v_x^{cmd}\) −0,5 ilə 2,8 m/s; yanal sürət \(v_y^{cmd}\) −1 ilə 1 m/s; şaquli ox üzrə bucaq sürəti əmri \(\omega_z^{cmd}\) isə −1 ilə 1 rad/s arasındadır.
Təlim yalnız irəli yeriməni deyil; yerində dayanma, irəli/geri yerimə, yanal hərəkət, yerində dönmə və çoxistiqamətli yerimə davranışlarını əhatə edir.
25. İkinci mərhələ domain randomization
| Parametr | Vahid | Aralıq |
|---|---|---|
| Oynaq mövqeyi səs-küyü | rad | \(U(-0.05,0.05)\) |
| Oynaq sürəti səs-küyü | rad/s | \(U(-2,2)\) |
| Euler bucağı səs-küyü | rad | \(U(-0.05,0.05)\) |
| Bucaq sürəti səs-küyü | rad/s | \(U(-0.5,0.5)\) |
| Kütlə mərkəzi ofseti | cm | \(U(-0.075,0.075)\) |
| Daşınan yük kütləsi | kg | \(U(-5,5)\) |
| Sürtünmə əmsalı | Ölçüsüz | \(U(0.3,2)\) |
| \(k_p,k_d\) qazanc çarpanı | Ölçüsüz | \(U(0.85,1.15)\) |
Mənbə cədvəldəki kütlə mərkəzi ofsetinin vahidi “cm” kimi verilmiş və qiymətlər ±0,075-dir. Bu qiymət mənbədə yazıldığı formada qorunmuşdur; səssizcə metrə və ya başqa miqyasa çevrilməmişdir.
26. Stage II hiperparametrləri
| Parametr | Qiymət |
|---|---|
| Paralel mühit | 4096 |
| Öyrənmə sürəti | Adaptive |
| Discount factor | 0,99 |
| GAE coefficient | 0,95 |
| Batch sayı | 5 |
| Gradient clipping | 1 |
| PPO clipping range | 0,2 |
| Entropy coefficient | 0,01 |
| Policy hidden layers | [512, 256, 128] |
| Critic hidden layers | [512, 256, 128] |
| Encoder | [512, 256, 128] |
| H1, H2 | 4, 60 |
H2=60 keçmiş zaman addımının istifadəsi yerimə zamanı dinamikanın zamandan asılı inkişafını tutmağı hədəfləyir. İkinci mərhələdə entropy coefficient 0,01-ə yüksəldilmişdir; tədqiqatçılar bunu daha mürəkkəb lokomosiya tapşırığında kəşfi artırmaq məqsədilə istifadə edirlər.
27. Terrain curriculum necə işləyir?
Təlim mühitində relyefin çətinliyi robotun uğuruna əsasən dinamik şəkildə dəyişdirilir. Robot mövcud relyefin yarısından çoxunu keçə bilirsə daha çətin səviyyəyə qaldırılır. Məsafə meyarını qarşılamırsa orta xətti sürət mükafatı da qiymətləndirilir; performans aşağıdırsa daha asan relyefə endirilir.
Maksimum səviyyəyə çatan robotlar daim eyni ən çətin relyefdə saxlanmaq əvəzinə yuxarı sərhədi aşmayacaq şəkildə yenidən təsadüfi relyef səviyyələrinə təyin edilə bilər. Məqsəd müəyyən bir relyef formasına həddindən artıq uyğunlaşmanı azaltmaqdır.
Tədqiqatın Metodu və Nəticələri
28. Fiziki robot platforması
Təcrübələr Shanghai DroidUp Co., Ltd. tərəfindən hazırlanmış X02 tendonla idarə olunan ikiayaqlı robot üzərində aparılmışdır. Robot təxminən 1,70 m hündürlüyündə və təxminən 32 kg ağırlığındadır.
Tədqiqatda yalnız aşağı gövdənin 10 sərbəstlik dərəcəsi idarə edilmişdir. Lokomosiya policy şəbəkəsi RK3588 üzərində 100 Hz tezliyində işlədilmişdir.
29. Müqayisə edilən metodlar
| Metod | Əsas xüsusiyyət | RS fırlanma momenti düzəltməsi | Explicit qiymətləndirmə | Implicit təsvir |
|---|---|---|---|---|
| RMA | Teacher–student Rapid Motor Adaptation | Xeyr | RSR ilə eyni struktur deyil | Adaptasiya təsvirindən istifadə edir |
| IWM | Yalnız implicit world representation | Xeyr | Xeyr | Bəli |
| EIWM | Explicit–implicit world representation | Xeyr | Bəli | Bəli |
| RSR | EIWM + Real2Sim fırlanma momenti düzəltmə siyasəti | Bəli | Bəli | Bəli |
RMA iki mərhələli teacher–student quruluşuna malik olduğuna görə mənbə simulyasiya ablasyonunda birbaşa EIWM/IWM/RSR müqayisəsinə daxil edilməmiş, real robot müqayisələrində isə istifadə edilmişdir.
30. Simulyasiyadakı əsas ablasyon nəticəsi
| Metod | Orta mükafat | Orta relyef səviyyəsi | Orta xətti sürət mükafatı |
|---|---|---|---|
| IWM | 23,33 | 3,68 | 0,82 |
| EIWM | 35,67 | 4,58 | 0,95 |
| RSR | 35,83 | 4,56 | 0,97 |
EIWM və RSR təxminən 200 episode ərzində yüksək mükafat bölgəsinə çatdığı halda IWM-in yaxınsaması daha yavaşdır. Mənbə bunu açıq sürət və relyef qiymətləndirmələrinin siyasətin zəruri fiziki məlumatı yalnız latent fəzadan kəşf etmə yükünü azaltması ilə əlaqələndirir.
31. Mənbə Cədvəl 7-dəki hesabat təfərrüatı
| Metod | “Average Reward” sütunu | Final mükafatın %80-inə çatma episode-u |
|---|---|---|
| EIWM | 0,9532 | 192 |
| IWM | 0,8268 | 1770 |
| RSR | 0,9768 | 192 |
Burada diqqət edilməli məqam budur ki, eyni bölmədə mətn və Cədvəl 8 “average reward” üçün 35,67, 23,33 və 35,83 qiymətlərindən istifadə edir. Cədvəl 7-dəki 0–1 miqyasındakı “Average Reward” qiymətlərinin normallaşdırılmış başqa ölçü olub-olmadığı mənbədə açıq şəkildə izah edilmir. Buna görə iki sütun eyni metrik kimi birləşdirilməmişdir.
32. Təlimin hesablama xərci
Mənbə orta real vaxt öyrənmə müddətini EIWM üçün 0,2790 s, RSR üçün 0,2760 s və IWM üçün 0,2738 s olaraq bildirmişdir. Tədqiqatçılar fərqlərin kiçik olduğunu və explicit–implicit encoder ilə RS fırlanma momenti düzəltməsinin bu ölçüdə böyük əlavə hesablama yükü yaratmadığını şərh edirlər.
33. Fırlanma momenti düzəltmə siyasətinin real robota oxşarlığı artırması
RS fırlanma momenti düzəltməsinin təsirini birbaşa yoxlamaq üçün RS təlim məlumatında olmayan iki fərqli sürətdə oynaq hədəf trayektoriyası real robota və iki simulyasiya mühitinə tətbiq edilmişdir. Simulyasiyalardan biri orijinal model, digəri RS fırlanma momenti düzəltməli modeldir.
Real oynaq trayektoriyaları ilə simulyasiya trayektoriyaları müqayisə edilmiş və RMSE hesablanmışdır.
Standart RMSE məntiqi öyrədici şəkildə:
\[ RMSE= \sqrt{ \frac{1}{N} \sum_{t=1}^{N} \left( q_t^{real}-q_t^{sim} \right)^2 } \]
şəklindədir. Bu tənlik mənbədə nömrələnmiş ayrıca tənlik deyil; RMSE metrikasının nəyi ölçdüyünü izah edən standart riyazi göstərimdir. RMSE-nin vahidi oynaq mövqeyi ilə eyni olduğuna görə burada radiandır. Qiymət azaldıqca simulyasiya trayektoriyası real robot trayektoriyasına daha yaxın olur.
| Model | Oynaq | Aşağı sürət RMSE (rad) | Yüksək sürət RMSE (rad) |
|---|---|---|---|
| Orijinal simulyasiya | Bud-çanaq | 0,0356 | 0,1590 |
| Orijinal simulyasiya | Diz | 0,0483 | 0,1985 |
| Orijinal simulyasiya | Topuq | 0,0627 | 0,2412 |
| RS fırlanma momenti düzəltməli simulyasiya | Bud-çanaq | 0,0148 | 0,0375 |
| RS fırlanma momenti düzəltməli simulyasiya | Diz | 0,0219 | 0,0586 |
| RS fırlanma momenti düzəltməli simulyasiya | Topuq | 0,0294 | 0,0743 |
Fərq xüsusilə yüksək sürət şəraitində böyükdür. Bu nəticə tendon sistemindəki zamanla dəyişən davranışların yüksək sürətli hərəkətdə ideal modeldən daha çox sapma yarada bilməsi və öyrənilmiş fırlanma momenti düzəltməsinin bu fərqi azalda bilməsi şərhini dəstəkləyir.
34. Real dünyada sürət izləmə
Robot 0,6, 1,5, 2,0 və 2,5 m/s irəli sürət əmrlərində ayrı-ayrılıqda yeridilmişdir. Hər sürət şərti 20 saniyə davam etmiş və hər metod/sürət cütü üçün beş müstəqil sınaq aparılmışdır.
| Metod | 0,6 m/s əmri | 1,5 m/s əmri | 2,0 m/s əmri | 2,5 m/s əmri |
|---|---|---|---|---|
| RMA | 10,5 m | 26,8 m | 34,5 m | 32,1 m |
| IWM | 11,1 m | 27,9 m | 36,2 m | 34,3 m |
| EIWM | 11,5 m | 28,6 m | 37,5 m | 36,8 m |
| RSR | 11,8 m | 29,1 m | 38,4 m | 48,2 m |
Ən böyük fərq 2,5 m/s əmrində görülmüşdür. Mənbə beş müstəqil sınağın orta sürətini RSR üçün 2,41 m/s, dispersiyasını 0,00416; EIWM üçün orta sürəti 1,84 m/s, dispersiyasını 0,0102 olaraq bildirmişdir.
Mənbə həmçinin 2,5 m/s şəraitində explicit–implicit EIWM-in yalnız implicit IWM-ə nisbətən sürət izləmə xətasını %15,9 azaltdığını və RS fırlanma momenti düzəltməsi əlavə edilmiş RSR-in EIWM-ə nisbətən xətanı əlavə olaraq %86,4 azaltdığını bildirir.
Bu faizlər “robotun ümumi performansı %86,4 artdı” kimi şərh edilməməlidir. Mənbədəki ifadə xüsusi olaraq 2,5 m/s irəli sürət əmrindəki sürət izləmə xətası ilə bağlıdır.
35. İdarəetmə siqnalının hamarlığı — Tənlik (14)
Tədqiqat yalnız robotun nə qədər sürətli yeridiyinə deyil, oynaq əmrlərinin nə qədər hamar olduğuna da baxmışdır. FFT əsaslı hamarlıq metrikası:
\[ S_m= \frac{2}{n f_s} \sum_{i=1}^{n} M_i f_i \tag{14} \]
şəklindədir.
\(M_i\), \(i\)-ci tezlik komponentinin böyüklüyünü; \(f_i\), həmin komponentin tezliyini; \(n\), ümumi tezlik komponentlərinin sayını; \(f_s\), nümunələmə tezliyini göstərir.
Yüksək tezlik komponentləri \(f_i\) ilə çəkiləndiyinə görə yüksək tezlikli rəqslər metrikanı daha çox artırır. Buna görə daha kiçik \(S_m\) daha az yüksək tezlik məzmunu və daha hamar idarəetmə siqnalı deməkdir.
| Metod | Bud-çanaq | Diz | Topuq |
|---|---|---|---|
| RMA | 0,307 | 0,340 | 0,389 |
| IWM | 0,228 | 0,286 | 0,351 |
| EIWM | 0,210 | 0,224 | 0,338 |
| RSR | 0,156 | 0,182 | 0,311 |
Hər üç oynaqda ən aşağı \(S_m\) qiyməti RSR-dədir. Mənbə bunu fırlanma momenti düzəltmə siyasətinin model xətasından yaranan lazımsız yüksək tezlikli siyasət düzəlişlərini azaltması ilə əlaqələndirir.
36. Hərəkətlərin standart sapmaları
| Metod | Bud-çanaq (rad) | Diz (rad) | Topuq (rad) |
|---|---|---|---|
| RMA | 0,7447 | 0,7546 | 4,2153 |
| IWM | 0,7125 | 0,7956 | 3,1262 |
| EIWM | 0,4996 | 0,5974 | 1,7028 |
| RSR | 0,4863 | 0,5857 | 1,6957 |
Standart sapmanın azalması təkbaşına daha yaxşı hərəkət demək deyil; robot tapşırığı da yerinə yetirməlidir. Bu tədqiqatda aşağı rəqs qiymətlərinin sürət izləmə və pilləkən sabitliyi ilə birlikdə qiymətləndirilməsi vacibdir.
37. Pilləkən hündürlüyü necə “qavranılır”?
Real robotda ayaqaltı relyef hündürlüyü ayrıcalıqlı sensor ölçümü kimi birbaşa mövcud deyil. Encoder keçmiş proprioseptiv müşahidə ardıcıllığından yerli relyef hündürlüyünü explicit şəkildə qiymətləndirir.
Ardıcıl dörd 12 cm pilləli pilləkən təcrübəsində qiymətləndirilən relyef hündürlüyü artdıqda diz fleksiyasının da artaraq ayağın pillənin üzərindən keçirilməsinə kömək etdiyi bildirilmişdir. Düz səthdə qiymətləndirilən hündürlük dəyişikliyi kiçik olduqda diz daha kiçik tənzimləmələr edir.
38. Pilləkəndə gövdə pitch sabitliyi
| Metod | Orta (rad) | Standart sapma (rad) | Maksimum mütləq qiymət (rad) |
|---|---|---|---|
| RMA | −0,0434 | 0,0431 | 0,1471 |
| IWM | −0,0334 | 0,0446 | 0,1191 |
| EIWM | −0,0321 | 0,0395 | 0,1367 |
| RSR | −0,0262 | 0,0255 | 0,1065 |
RSR-in orta pitch bucağı sıfıra ən yaxın, standart sapması və maksimum mütləq sapması dörd metod arasında ən aşağı qiymətlərdir. Mənbə EIWM ilə müqayisədə orta mütləq pitch qiymətinin %18,4, standart sapmanın %35,4 və maksimum mütləq pitch qiymətinin %22,1 daha aşağı olduğunu bildirir.
PDF-dəki Şəkil 15-in vizual lejandında dördüncü sıra “TS” kimi görünsə də, bölmə mətni və Cədvəl 13 bu metodu RMA adlandırır. Verianla bu vizual etiket fərqini yeni beşinci metod varmış kimi şərh etmir.
39. Örtük təsvir fəzası nə göstərir?
Düz səth və pilləkən müşahidələri latent fəzada iki aydın klasterə ayrılmışdır. Keçid mərhələsində isə qismən üst-üstə düşmə vardır.
Mənbə bunu robot pilləkənlə hələ kifayət qədər fiziki qarşılıqlı təsirə girmədikdə proprioseptiv vəziyyətin düz səthdəki vəziyyətə bənzəməsi ilə izah edir. Bu nəticə latent təsvirin relyeflə əlaqəli vəziyyət fərqlərini daşıdığını göstərir.
Bununla belə, klaster ayrılması robotun xarici mühiti kamera kimi birbaşa sensorla semantik olaraq tanıdığı demək deyil. Təsvir keçmiş proprioseptiv müşahidələrdən törəyir.
40. Çoxsaylı real mühit təcrübələri
| Ssenari | Mənbədə verilən şərt | Bildirilən müşahidə |
|---|---|---|
| Asfalt üzərində yüksək sürətli lokomosiya | 2,5 m/s | Sabit hərəkət və sürət izləmə |
| Ayrıq maneələr | 20 cm | Maneələrin aşılması |
| İki pilləli pilləkən | Hər pillə 10 cm | Davamlı qalxma |
| Yumşaq maili ot örtüyü | Simulyasiya təlimində olmayan təmas mühiti | Sürüşmə və ya gait kəsilməsi olmadan sabit yerimə hesabatı |
| Ardıcıl dörd pilləkən pilləsi | Hər pillə 12 cm | Ardıcıl qalxma |
Bu ssenarilər metodun real dünyadakı əhatəsini göstərir. Lakin mənbə bu bölmə üçün yüzlərlə təkrarlı sahə benchmark-ı, hər relyef üçün uğur faizi və ya xəta ehtimalı bildirmir. Buna görə “hər cür relyefdə zəmanətli işləyir” nəticəsi çıxarıla bilməz.
41. Tədqiqatın dəstəklədiyi nəticələr
| Dəstəklənən nəticə | Sübut növü |
|---|---|
| Explicit–implicit təsvir yalnız implicit IWM-ə nisbətən simulyasiya təlimində daha yüksək mükafat və relyef səviyyəsi təmin etmişdir. | Simulyasiya ablasyonu |
| RS fırlanma momenti düzəltməsi real robot oynaq dinamikasına daha yaxın simulyasiya reaksiyası yaratmışdır. | Real robot–simulyasiya RMSE müqayisəsi |
| RSR 2,5 m/s sürət əmrində müqayisə edilən metodlar arasında ən yüksək izləmə performansını göstərmişdir. | Beş müstəqil real robot sınağı |
| RSR oynaq əmrlərində ən aşağı \(S_m\) qiymətlərini göstərmişdir. | FFT əsaslı idarəetmə siqnalı analizi |
| RSR dörd 12 cm pilləli pilləkəndə müqayisə edilən metodlar arasında daha aşağı pitch dalğalanması göstərmişdir. | Real robot pilləkən təcrübəsi |
| Robot simulyasiyada olmayan yumşaq ot örtüyündə sabit yeriyə bilmişdir. | Real mühit keyfiyyət təcrübəsi |
42. Tədqiqatın birbaşa dəstəkləmədiyi nəticələr
| Dəstəklənməyən ümumiləşdirmə | Niyə çıxarıla bilməz? |
|---|---|
| RSR bütün tendonla idarə olunan robotlarda eyni nəticəni verir. | Birbaşa eksperimental doğrulama X02 platforması ilə məhduddur. |
| RSR bütün relyeflərdə %100 uğur təmin edir. | Mənbə bütün relyef sinifləri üçün əhatəli uğur göstəricisi bildirmir. |
| Robot səthi kamera kimi birbaşa görür. | Mövcud siyasət keçmiş proprioseptiv müşahidələrdən relyef məlumatını qiymətləndirir; vizual məlumat gələcək tədqiqat kimi göstərilmişdir. |
| Latent fəzadakı iki klaster relyef təsnifatının qüsursuz olduğunu sübut edir. | Keçid bölgəsində klasterlər qismən üst-üstə düşür və analiz idarə olunan təcrübə kontekstindədir. |
| RS fırlanma momenti düzəltməsi real tendon fizikasını tam təsvir edən analitik modeldir. | Metod fiziki parametrləri bir-bir müəyyən etmək əvəzinə dinamik sapmanı öyrənilmiş fırlanma momenti düzəltməsi ilə örtük şəkildə təmsil edir. |
| %86,4 qiyməti robotun ümumi uğurunun %86,4 artdığını göstərir. | Qiymət yalnız 2,5 m/s şəraitindəki sürət izləmə xətasının EIWM-ə nisbətən azalmasıdır. |
43. Tədqiqatın əsas elmi töhfəsi
Bu tədqiqatın əsas töhfəsi tendon sistemini daha təfərrüatlı analitik yay–sönüm–sürtünmə modeli ilə yenidən qurmağa çalışmaq deyil. Tədqiqatçılar real robotun müşahidə olunan dinamik cavabından istifadə edərək ideal simulyasiya fırlanma momentini kiçik intervalda düzəldən ayrıca RL siyasəti öyrənirlər.
Bu yanaşma daha sonra lokomosiya siyasəti ilə birləşdirilir. Beləliklə, iki fərqli problem ayrı, lakin əlaqəli şəkildə həll olunur: birinci şəbəkə “simulyasiyadakı robot fiziki robot kimi necə cavab verməlidir?”, ikinci şəbəkə isə “bu daha realistik dinamika altında robot necə yeriməlidir?” sualına fokuslanır.
Explicit–implicit struktur isə ikinci problemdə natamam müşahidəolunmaya qarşı iki fərqli məlumat formasını birləşdirir. Açıq qiymətləndirmələr fiziki mənası müəyyən olan sürət və relyef həndəsəsini təmin edir; örtük latent xüsusiyyətlər isə bütün mühüm amillərin bir-bir adlandırılmasının çətin olduğu halları təmsil edir.
44. Məhdudiyyətlər və gələcək tədqiqat
Tədqiqatın mövcud siyasət strukturu əsasən proprioseptiv keçmişə söykənir. Tədqiqatçılar daha mürəkkəb relyef üzərində robust lokomosiya üçün gələcəkdə vizual məlumatın əlavə edilməsini planlaşdırırlar.
Həmçinin adversarial motion priors istifadə edərək daha bioloji görünüşlü gait yaratmaq və RS mərhələsində fırlanma momenti düzəltmə təlimində bioloji ilhamlı yerimə trayektoriyalarından istifadə etmək gələcək tədqiqat hədəfləri arasındadır.
Mənbə birbaşa vahid “Limitations” alt başlığı altında təfərrüatlı xəta büdcəsi təqdim etmir. Buna görə Verianla mənbədə olmayan ayrıca eksperimental məhdudiyyət siyahısı yaratmamışdır. Metodoloji əhatə sərhədi; bir fiziki platforma, müəyyən tapşırıq və relyeflər, mövcud proprioseptiv qavrayış strukturu və bildirilən təcrübə sayları əsasında qorunmuşdur.
Mənbə və Metod Qeydi
Özgün başlıq: RSR: Tendon-Driven Bipedal Robot Locomotion Learning Method Based on Real2Sim2Real
Müəlliflər: Suozhong Fan, Jian Liu, Jie Xue, Jun Tang, Qingdu Li və Jianwei Zhang.
Məsul müəllif: Jun Tang.
Bərabər töhfə: Mənbə məqalədə bərabər töhfə bəyanatı yoxdur.
Qurumlar: School of Optical-Electrical and Computer Engineering, University of Shanghai for Science and Technology; Institute of Machine Intelligence, University of Shanghai for Science and Technology; Shanghai DroidUp Co., Ltd.; Department of Informatics, University of Hamburg.
Jurnal: Mathematics.
Nəşriyyat: MDPI.
Biblioqrafik qeyd: Mathematics 2026, 14(13), 2358.
DOI: 10.3390/math14132358.
Təqdim tarixi: 14 May 2026.
Reviziya tarixi: 22 İyun 2026.
Qəbul tarixi: 23 İyun 2026.
Nəşr tarixi: 2 İyul 2026.
Rəsmi keçid: https://doi.org/10.3390/math14132358
Mənbə növü: Resenziyalı elmi jurnalda dərc edilmiş özgün tədqiqat məqaləsi. Tədqiqat möhkəmləndirici öyrənmə, simulyasiya ablasyonu və fiziki ikiayaqlı robot təcrübələrini birlikdə ehtiva edir.
Preprint statusu: Təqdim edilmiş sənəd dərc olunmuş jurnal versiyasıdır. PDF daxilində ayrıca preprint nömrəsi göstərilmir.
Lisenziya: Creative Commons Attribution (CC BY).
Robot platforması: Shanghai DroidUp Co., Ltd. tərəfindən hazırlanmış X02 tendonla idarə olunan bipedal robot; təxminən 1,70 m, təxminən 32 kg; bu tədqiqatda aşağı gövdədəki 10 DOF idarə edilmişdir.
Əsas metod: İki mərhələli Real2Sim2Real. Birinci mərhələdə real robot məlumatı ilə torque refinement policy, ikinci mərhələdə explicit xətti sürət + ayaqaltı relyef hündürlüyü qiymətləndirməsi ilə implicit latent representation istifadə edən lokomosiya policy-si öyrədilmişdir.
Möhkəmləndirici öyrənmə alqoritmi: PPO.
Siyasətin işləmə tezliyi: 100 Hz.
PD idarəetmə tezliyi: 500 Hz.
Real robot hesablama platforması: RK3588.
Real sürət sınaqları: 0,6; 1,5; 2,0 və 2,5 m/s əmrləri, hər şərt üçün 20 saniyə və metod/sürət cütü üçün beş müstəqil sınaq.
Maliyyələşdirmə: Shanghai Special Fund for Promoting Industrial High-Quality Development–Pioneering Industry Innovation and Development Project, RZ-RGZN-01-25-0673; National Key Research and Development Program of China “Regional Integrated Application Demonstration of Intelligent Technology for Active Health Services”, 2023YFC3605800; 2025 Shanghai Key Technologies Research and Development Program–“New Energy” Project, 25DZ3001401.
Məlumat əlçatanlığı: Müəlliflər tədqiqatın özgün töhfələrinin məqalə materialında olduğunu, əlavə sualların məsul müəllifə yönəldilə biləcəyini bildiriblər.
Maraqların toqquşması / qurum əlaqəsi: Jian Liu, Jie Xue, Jun Tang və Qingdu Li-nin Shanghai DroidUp Co., Ltd. əməkdaşları olduğu bildirilmişdir. Digər müəlliflər tədqiqatın potensial maraqlar toqquşması kimi şərh edilə biləcək kommersiya və ya maliyyə əlaqəsi olmadan aparıldığını bəyan etmişlər.
Müəllif töhfələri: Konseptuallaşdırma Suozhong Fan və Jian Liu; metodologiya Suozhong Fan; proqram təminatı Suozhong Fan; doğrulama Suozhong Fan və Jian Liu; formal analiz Jun Tang və Qingdu Li; tədqiqat Suozhong Fan; resurslar Suozhong Fan; məlumat kurasiyası Suozhong Fan və Jianwei Zhang; ilkin qaralama Suozhong Fan və Jie Xue; nəzərdən keçirmə və redaktə Suozhong Fan; vizuallaşdırma Jie Xue; nəzarət Jun Tang və Qingdu Li; layihə idarəetməsi Jun Tang; maliyyələşdirmə Jun Tang və Jianwei Zhang tərəfindən həyata keçirilmişdir.
Mənbədaxili Cədvəl 7 qeydi: Nəticə mətni və Cədvəl 8 simulyasiya average reward qiymətlərini IWM=23,33, EIWM=35,67 və RSR=35,83 olaraq bildirərkən, Cədvəl 7-də “Average Reward” sütununda müvafiq olaraq 0,8268, 0,9532 və 0,9768 göstərilir. Mənbə bu iki miqyas arasındakı çevrilməni izah etmədiyinə görə qiymətlər birləşdirilməmişdir.
Mənbədaxili Şəkil 15 qeydi: PDF-in vizual lejandında RSR, EIWM və IWM yanında “TS” etiketi göründüyü halda, ətraf mətn və Cədvəl 13 dördüncü müqayisə metodunu RMA adlandırır. Verianla mənbədə olmayan izahla bu etiketi düzəltməmiş; kəmiyyət qiymətləndirməsində Cədvəl 13-də açıq verilən RMA sətrini qorumuşdur.
Formula qeydi: Mənbədə nömrələnmiş Tənlik (1)–(14) qorunaraq öyrədici şəkildə izah edilmişdir. RMSE-nin standart riyazi göstərimi yalnız metrikanın mənasını öyrətmək üçün əlavə edilmiş və mənbədə yeni nömrələnmiş tənlik kimi təqdim edilməmişdir.
Əsas şərh sərhədi: Tədqiqat real fiziki robot doğrulamasını ehtiva edir; buna görə yalnız simulyasiya tədqiqatı deyil. Bununla belə, doğrulama X02 robotu və tədqiqatda bildirilən tapşırıq/mühitlərlə məhduddur. Nəticələr bütün tendonla idarə olunan ikiayaqlı robot arxitekturaları üçün universal performans zəmanəti yaratmır.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib