


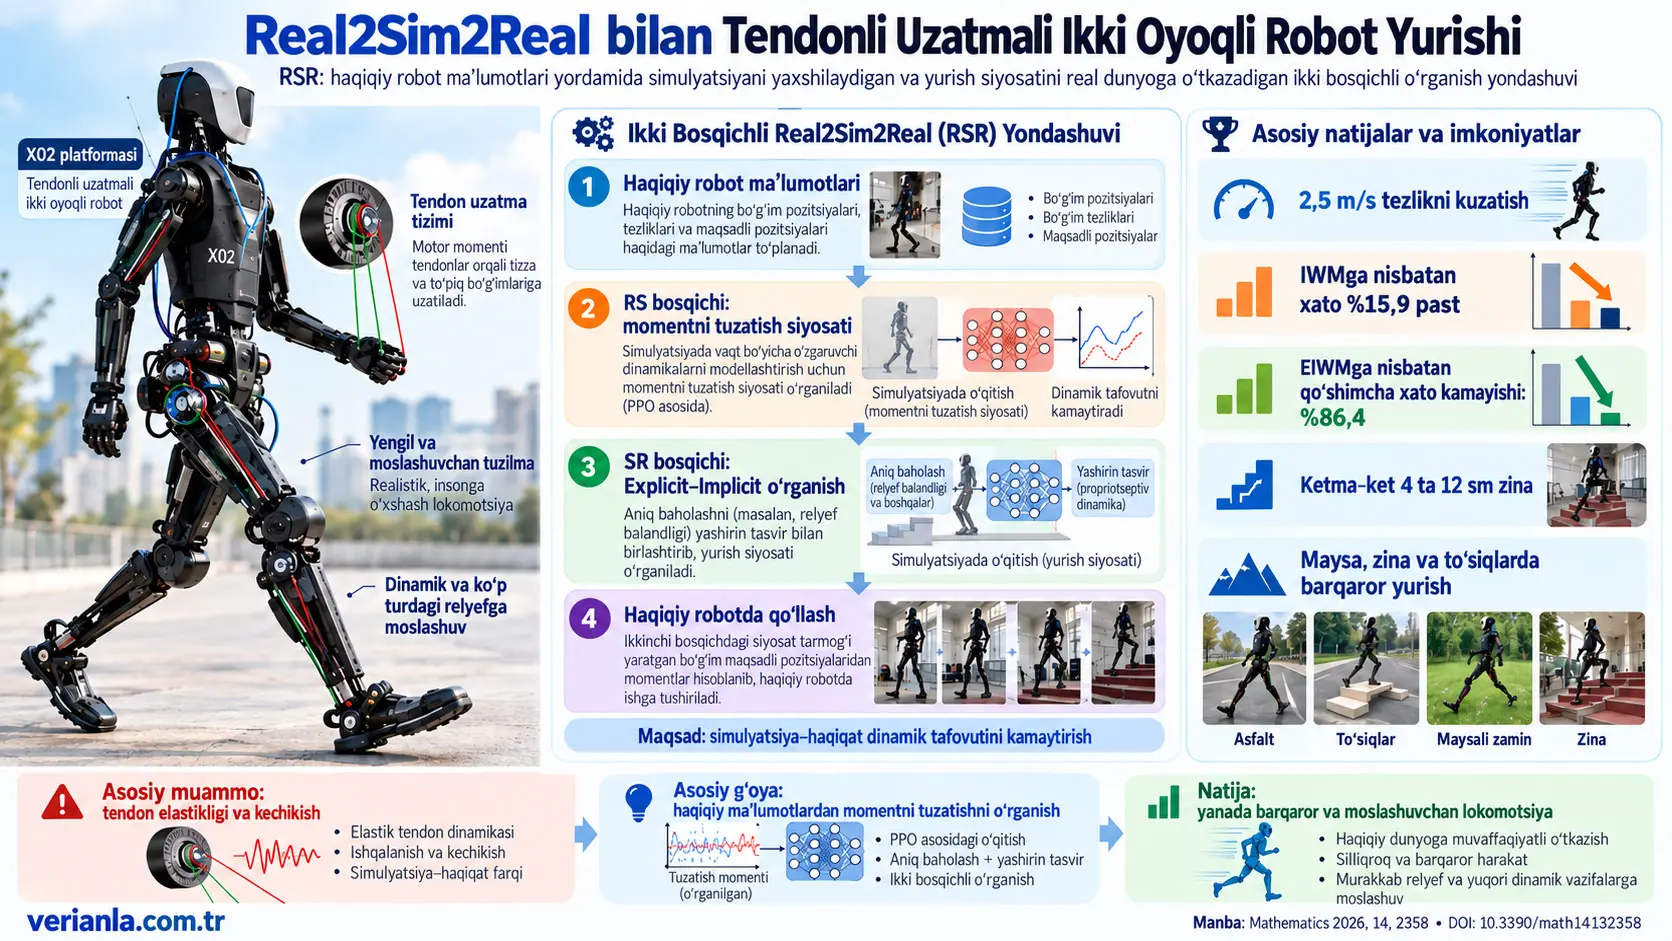
RSR (Real2Sim2Real) — haqiqiy tendonli uzatmali robotning o‘lchangan bo‘g‘im harakatlaridan foydalanib, simulyatsiyadagi dinamik xatti-harakatni haqiqiy robotga yaqinlashtiradigan va keyin shu tuzatilgan simulyatsiyada lokomotsiya siyosatini o‘qitadigan ikki bosqichli mustahkamlovchi o‘rganish doirasidir. Tadqiqotning maqsadi tendon elastikligi, ishqalanish, bo‘shliq, ko‘p bo‘g‘imli bog‘lanish va uzatish kechikishi tufayli ideal to‘g‘ridan-to‘g‘ri yuritmali simulyatsiya modeli bilan jismoniy tendonli robot o‘rtasida yuzaga keladigan sim-to-real dinamik tafovutni kamaytirishdir.
Birinchi bosqichda haqiqiy robotdan bo‘g‘imning maqsad holati, haqiqiy bo‘g‘im holati va bo‘g‘im tezligi ma’lumotlari yig‘iladi. Bu ma’lumotlar simulyatsiyaga uzatiladi va mustahkamlovchi o‘rganish yordamida aylantiruvchi momentni tuzatish siyosati o‘qitiladi. Tadqiqotchilar tendonning barcha jismoniy parametrlarini birma-bir belgilash o‘rniga, modellashtirish qiyin bo‘lgan vaqt bo‘yicha o‘zgaruvchan xatti-harakatlarni ideal simulyatsiya modelidan og‘ish sifatida ko‘radi va bu og‘ishni \(c_t\) nomli o‘rganilgan aylantiruvchi moment ko‘paytirgichi bilan tuzatadi.
Ikkinchi bosqichda yurish siyosati o‘qitiladi. Usul faqat yashirin latent tasvirga tayanmaydi. Robot tanasining chiziqli tezligini va oyoqlar ostidagi mahalliy relyef balandligini ochiq tarzda baholaydi; shu bilan birga, oldingi propriotseptiv kuzatuvlardan bevosita jismoniy muqobili bo‘lmagan vazifaga aloqador yashirin xususiyatlarni o‘rganadi. Shunday qilib, ochiq jismoniy holat ma’lumoti bilan modellashtirish qiyin bo‘lgan kontakt va dinamik xususiyatlar bitta siyosatda birlashtiriladi.
Simulyatsiyada IWM, EIWM va RSR taqqoslangan. IWMning o‘rtacha mukofoti 23,33, EIWMniki 35,67 va RSRniki 35,83 deb xabar qilingan. O‘rtacha relyef qiyinlik darajalari mos ravishda 3,68, 4,58 va 4,56; chiziqli tezlikni kuzatish mukofotlari esa 0,82, 0,95 va 0,97. Bu natijalar explicit–implicit tasvir faqat yashirin tasvirga nisbatan o‘qitish samaradorligini oshirishini, RS aylantiruvchi moment tuzatishi esa simulyatsiyadagi siyosat samaradorligini sezilarli darajada yomonlashtirmasligini ko‘rsatadi.
Jismoniy robot tajribalari taxminan 1,70 m bo‘yli, 32 kg og‘irlikdagi X02 tendonli uzatmali ikki oyoqli robotda o‘tkazilgan. Faqat pastki tanadagi 10 erkinlik darajasi boshqarilgan, siyosat RK3588 qurilmasida 100 Hz tezlikda ishlatilgan. 2,5 m/s oldinga tezlik buyrug‘ida RSRning o‘rtacha haqiqiy tezligi 2,41 m/s bo‘lgan, EIWM esa 1,84 m/s ga yetgan. Manba explicit–implicit o‘rganish faqat yashirin IWM yondashuviga nisbatan tezlikni kuzatish xatosini %15,9 kamaytirganini; RSRning aylantiruvchi momentni tuzatish bosqichi qo‘shilishi bilan EIWMga nisbatan xato yana %86,4 kamayganini bildiradi.
Robot, shuningdek, ketma-ket to‘rtta 12 cm li zina, 20 cm ajratilgan to‘siqlar, ikki pog‘onali 10 cm zina, asfalt va yumshoq qiya maysada sinovdan o‘tkazilgan. Tadqiqotda ushbu ssenariylarda barqaror harakat qayd etilgan. Ayniqsa yumshoq maysa simulyatsiya o‘qitish muhitida bo‘lmagan kontakt sharoitidir.
Bu natijalarning muhim cheklovi shundaki, tajribalar faqat bitta X02 platformasi va tadqiqotda belgilangan o‘qitish/tajriba sharoitlarida o‘tkazilgan. Tadqiqot barcha tendonli uzatmali robotlarda ayni samaradorlik kafolatlanishini ko‘rsatmaydi. Mavjud yondashuv tashqi muhitni kamera orqali to‘g‘ridan-to‘g‘ri idrok etmaydi; tadqiqotchilar murakkabroq relyef uchun vizual ma’lumotni kelajakdagi ishlarda tizimga qo‘shishni rejalashtirgan.
1. Tendonli uzatmali robot nimani anglatadi?
Tendonli uzatmali robotda motor bevosita harakatlantiriladigan bo‘g‘imning ustida joylashishi shart emas. Motor tananing proksimalroq nuqtasiga o‘rnatilishi va motor kuchi kabel yoki tendonga o‘xshash elastik uzatish elementi orqali tizza, to‘piq yoki boshqa bo‘g‘imga uzatilishi mumkin.
Bu yondashuv biologik mushak–tendon tuzilishiga o‘xshash tamoyildan foydalanadi. Og‘ir motorlarni distal bo‘g‘imlardan uzoqlashtirish oyoqlarning inertsiya va massasini kamaytirishi mumkin. Buning evaziga boshqaruv muammosi murakkablashadi, chunki motor harakati bilan bo‘g‘imning haqiqiy javobi orasiga tendonning jismoniy xatti-harakati kiradi.
2. Tendon nega simulyatsiya bilan haqiqiy robot o‘rtasida tafovut hosil qiladi?
Manba beshta asosiy jismoniy muammoga e’tibor qaratadi. Tendonning o‘q bo‘ylab elastikligi tufayli bo‘g‘im javobi motor buyrug‘ini kechikib yoki tebranma tarzda kuzatishi mumkin. Tendon bilan shkiv orasidagi ishqalanish va tendon tolalarining ichki so‘nishi energiya yo‘qotilishi va nochiziqli xatti-harakatga olib kelishi mumkin. Uzoq muddatli foydalanish tendonning cho‘zilishi yoki bo‘shashishiga sabab bo‘lib, backlash yuzaga keltirishi mumkin. Distal tendon yo‘llari sababli bir bo‘g‘im harakati boshqa bo‘g‘im tendonidagi taranglikka ta’sir qilishi mumkin. Nihoyat, tendonning elastikligi va massa taqsimoti kuch uzatish o‘tkazish polosasi kengligini cheklab, yuqori chastotali boshqaruv signallarini susaytirishi mumkin.
MuJoCo yoki Isaac Gym kabi keng qo‘llanadigan simulyatsiyalarda har bir bo‘g‘imga ideal motor joylashtirish hisoblash nuqtai nazaridan osonroq. Biroq bu ideal model tendonning vaqt bo‘yicha o‘zgaradigan haqiqiy xatti-harakatini tabiiy ravishda hosil qilmaydi. Tadqiqot “propriotseptiv dinamik tafovut” deb ataydigan farqning asosi shudir.
3. Propriotsepsiya nima?
Robototexnika kontekstida propriotseptiv kuzatuv — robot o‘z tanasi va bo‘g‘imlaridan o‘lchaydigan ichki holat ma’lumotidir. Bu tadqiqotda bo‘g‘im holati, bo‘g‘im tezligi, tana orientatsiyasi va burchak tezligi kabi ma’lumotlar propriotseptiv axborot sifatida ishlatiladi.
Kamera yoki tashqi muhit xaritasi propriotseptiv axborot emas. Tadqiqotning ayniqsa muhim jihati shundaki, haqiqiy robot siyosati tashqaridan berilgan imtiyozli relyef xaritasiga bevosita ehtiyoj sezmasdan oldingi propriotseptiv kuzatuvlardan foydalanadi.
Real2Sim2Real bu tadqiqotda nimani anglatadi?
Real2Sim2Real — avval haqiqiy robotdan yig‘ilgan harakat ma’lumotlari bilan simulyatsiyani robot dinamikasiga yaqinlashtirish, so‘ng shu tuzatilgan simulyatsiyada lokomotsiya siyosatini o‘qitib, uni yana jismoniy robotga ko‘chirishdir; ya’ni ma’lumot oqimi faqat Sim→Real emas, balki Real→Sim→Real ko‘rinishidadir.
4. RSRning ikki bosqichi
| Bosqich | Manbasi | O‘rganiladigan tuzilma | Asosiy maqsad |
|---|---|---|---|
| Stage I — Real2Sim / RS | Haqiqiy robotning bo‘g‘im maqsad holati, haqiqiy holati va tezligi | Aylantiruvchi momentni tuzatish siyosati | Ideal simulyatsiya bilan tendonli robotning vaqt bo‘yicha o‘zgaradigan tana dinamikasi o‘rtasidagi farqni kamaytirish |
| Stage II — Sim2Real / SR | RS siyosati bilan tuzatilgan simulyatsiya, oldingi kuzatuvlar va privileged training state | Explicit–implicit lokomotsiya siyosati | Tezlikni kuzatish, barqaror yurish va murakkab relyefga moslashish |
| Haqiqiy joriy etish | Haqiqiy sensorlardan olinadigan kuzatuvlar | Stage II siyosat chiqishi + PD boshqaruv | Jismoniy robot lokomotsiyasi |
5. Asimmetrik actor–critic arxitekturasi nima?
Mustahkamlovchi o‘rganishda actor mavjud ma’lumotga ko‘ra qaysi harakat bajarilishini belgilaydigan siyosatdir. Critic esa holat yoki harakatning kutiladigan uzoq muddatli qiymatini baholab, actorni o‘qitishga yordam beradi.
“Asimmetrik” atamasi actor va critic bir xil ma’lumotga ega emasligini anglatadi. O‘qitish vaqtida critic haqiqiy dunyoda bevosita o‘lchash qiyin bo‘lgan qo‘shimcha ma’lumotlarga ega bo‘lishi mumkin. Bular privileged information, ya’ni imtiyozli o‘qitish ma’lumoti deb ataladi. Actor esa haqiqiy robotga ko‘chirilishi mumkin bo‘lgan sensor ma’lumotlari bilan ishlashga o‘rgatiladi.
Bu farq muhim. O‘qitish vaqtida relyef xaritasining haqiqiy qiymati ma’lum bo‘lib, encoderga to‘g‘ri maqsad o‘rgatilishi mumkin; ammo jismoniy robot yurganda bu haqiqiy qiymat siyosat kirishiga to‘g‘ridan-to‘g‘ri berilmaydi.
6. Stage I kuzatuvi — Tenglama (1)
RS bosqichidagi oniy kuzatuv manbada:
\[ o_t^{rs}= \begin{bmatrix} q_t^{rs} & \dot{q}_t^{rs} \end{bmatrix}^{T} \tag{1} \]
deb ta’riflangan. \(q_t^{rs}\) bo‘g‘im holatlarini, \(\dot{q}_t^{rs}\) bo‘g‘im tezliklarini bildiradi. Holat birligi radian, burchak tezligi birligi rad/s.
Encoderga faqat bitta vaqt onining ma’lumoti berilmaydi. To‘rtta vaqt qadamidan iborat oldingi bo‘g‘im holati va tezligi ketma-ketligi \(o_{H1}^{rs}\) ishlatiladi. Pastki tana 10 erkinlik darajasiga ega bo‘lgani uchun bitta vaqt qadamida 10 holat + 10 tezlik mavjud; to‘rt qadamli tarix manbada 80 o‘lchamli vektor sifatida ta’riflangan.
7. Stage I critic holati — Tenglama (2)
\[ s_t^{rs}= \begin{bmatrix} o_t^{rs} & d_t^{rs} & m_t^{rs} \end{bmatrix}^{T} \tag{2} \]
Bu yerda \(d_t^{rs}\) bo‘g‘im so‘nishini, \(m_t^{rs}\) motorning aylanish inertsiyasini bildiradi. Bular critic uchun ishlatiladigan imtiyozli dinamik ma’lumotlardir.
Actor ularni haqiqiy robotda bevosita o‘lchashi shart emas. Criticning to‘liqroq ma’lumotdan foydalanishi qiymat funksiyasini o‘qitish vaqtida kamroq noaniqlik bilan o‘rganishga yordam berishni ko‘zlaydi.
8. PPO yo‘qotish funksiyasi — Tenglama (3)
Siyosat Proximal Policy Optimization, ya’ni PPO orqali yangilangan:
\[ \mathcal{L}_{\pi}= \min\left( \frac{\pi_{\theta}(a_t|s_t)} {\pi_{\theta_b}(a_t|s_t)} A^{\pi_{\theta_b}}(s_t,a_t), \operatorname{clip} \left( \frac{\pi_{\theta}(a_t|s_t)} {\pi_{\theta_b}(a_t|s_t)}, 1-\epsilon, 1+\epsilon \right) A^{\pi_{\theta_b}}(s_t,a_t) \right) \tag{3} \]
\(\pi_{\theta}\) yangilanayotgan yangi siyosat, \(\pi_{\theta_b}\) esa oldingi iteratsiyadagi xatti-harakat siyosatidir. Ikki siyosatning bir xil harakatga bergan ehtimollari nisbati yangi siyosat eski siyosatdan qanchalik uzoqlashganini ifodalaydi. \(A^{\pi_{\theta_b}}(s_t,a_t)\) advantage funksiyasi bo‘lib, muayyan harakat eski siyosat bo‘yicha kutilganidan qay darajada yaxshi yoki yomon ekanini baholaydi.
\(\epsilon\) clipping chegarasidir. Tadqiqotda clipping range 0,2. Nisbat \(1-\epsilon\) bilan \(1+\epsilon\) oralig‘iga siqilib, siyosatning bitta yangilanishda haddan tashqari o‘zgarishining oldini olishga harakat qilinadi.
9. Critic qiymat yo‘qotishi — Tenglama (4)
\[ \mathcal{L}_{v}= \left( V_{\phi}(s_t)-\hat{R}_t \right)^2 \tag{4} \]
\(V_{\phi}(s_t)\) criticning holat uchun baholagan qiymatidir. \(\hat{R}_t\) kuzatilgan yoki hisoblangan maqsad qaytimidir. Ikki qiymat orasidagi farq kvadrati kamaytirilgan sari criticning kutiladigan qaytimni aniqroq baholashi ko‘zlanadi.
10. Haqiqiy robot ma’lumoti qanday yaratildi?
Haqiqiy ma’lumot yig‘ish vaqtida robot tanasining balandligi o‘zgarmas saqlangan va oyoq trayektoriyasi sinus funksiyasi bilan qo‘zg‘atilgan. Kerakli oyoq holatlari teskari kinematika yordamida bo‘g‘im maqsadlariga aylantirilgan.
Sinus amplitudasi 5–20 cm, chastotasi 1–25 Hz oralig‘ida tizimli ravishda o‘zgartirilgan. Shu tariqa tendon tizimini faqat bitta sekin harakat sharoitida emas, turli vaqt va chastota masshtablarida qo‘zg‘atish maqsad qilingan.
Holatni boshqarishda past qattiqlikli PD boshqaruvchi ishlatilgan. To‘piq uchun \(k_p=30\) va \(k_d=1\); boshqa bo‘g‘imlar uchun \(k_p=100\) va \(k_d=2\) qiymatlari berilgan.
Qayd etilgan asosiy ma’lumotlar maqsad bo‘g‘im holatlari, haqiqiy bo‘g‘im holatlari va bo‘g‘im tezliklaridir. RS o‘qitishida bu ma’lumotdan tasodifiy 1 soniyalik ketma-ketliklar olingan, ketma-ketlikning birinchi vaqt qadami simulyatsiya robotining boshlang‘ich holati sifatida ishlatilgan.
11. Stage I domain randomization
| Parametr | Birlik | Taqsimot |
|---|---|---|
| Bo‘g‘im holati shovqini | rad | \(U(-0.05,0.05)\) |
| Bo‘g‘im tezligi shovqini | rad/s | \(U(-2,2)\) |
\(U(a,b)\) ko‘rsatilgan pastki va yuqori chegaralar orasidagi uniform taqsimotni anglatadi. Bo‘g‘im tezligiga ayniqsa kuchli ±2 rad/s shovqin berilishining sababi shundaki, haqiqiy robotda tezlik ko‘pincha holat signalining sonli hosilasi orqali olinadi va hosila amali sensor shovqinini kuchaytirishi mumkin.
12. Aylantiruvchi momentni tuzatish boshqaruvi — Tenglama (5)
\[ \tau = c_t\cdot \left[ k_p \left( q_{tar}^{rs}-q^{rs} \right) - k_d\dot{q}^{rs} \right] \tag{5} \]
\(\tau\) bo‘g‘imga qo‘llanadigan aylantiruvchi momentni, \(q_{tar}^{rs}\) maqsad bo‘g‘im holatini, \(q^{rs}\) joriy bo‘g‘im holatini va \(\dot q^{rs}\) bo‘g‘im tezligini bildiradi. \(k_p\) holat xatosiga, \(k_d\) tezlikka bog‘liq PD koeffitsiyentidir.
Tenglamadagi muhim yangilik \(c_t\) dir. Bu qiymat RL siyosati tomonidan hosil qilinadigan aylantiruvchi momentni tuzatish koeffitsiyentidir. Ya’ni tarmoq aylantiruvchi momentni noldan yaratish o‘rniga mavjud PD momentini vaqt bo‘yicha o‘zgaradigan koeffitsiyent bilan masshtablaydi.
\(c_t\) manbada [0,8, 1,2] oralig‘iga clamp qilingan. Shu tariqa siyosat PD momentini ko‘pi bilan taxminan %20 kamaytirishi yoki oshirishi mumkin. Bu chegara o‘qitish taqsimotidan tashqariga chiqilganda haddan tashqari tuzatishlar jismonan xavfli yoki beqaror bo‘lib qolishining oldini oluvchi himoya cheklovidir.
13. RS mukofoti — Tenglama (6)
\[ r= \exp \left( -100 \left\| q_{real}-q_{sim} \right\|^2 \right) - 0.01 \left\| c_t-c_{t-1} \right\|^2 \tag{6} \]
Birinchi had simulyatsiyadagi bo‘g‘im holatlarining haqiqiy robot bo‘g‘im holatlariga yaqinlashishini mukofotlaydi. \(q_{real}\) haqiqiy robotdan qayd etilgan holat, \(q_{sim}\) simulyatsiyadagi holatdir. Xato kattalashgani sari eksponensial had tez kamayadi.
Ikkinchi had ketma-ket aylantiruvchi momentni tuzatish koeffitsiyentlarining tez o‘zgarishini jazolaydi. Shu tariqa maqsad nafaqat haqiqiy harakatni kuzatish, balki buni keskin va tartibsiz tuzatishlar o‘rniga silliqroq moment modulyatsiyasi bilan bajarishdir.
14. Stage I o‘qitish giperparametrlari
| Parametr | Qiymat |
|---|---|
| Parallel muhitlar soni | 4096 |
| O‘rganish tezligi | 5 × 10⁻⁴ |
| Discount factor | 0,99 |
| GAE coefficient | 0,95 |
| Batch soni | 5 |
| Gradient clipping | 1 |
| PPO clipping range | 0,2 |
| Entropy coefficient | 0,002 |
| Policy hidden layers | [256, 128] |
| Critic hidden layers | [256, 128] |
| Encoder | [256, 128] |
| H1 | 4 vaqt qadami |
Explicit–implicit o‘rganish nega birgalikda qo‘llanadi?
Explicit qism tana chiziqli tezligi va oyoq ostidagi mahalliy relyef balandligi kabi jismoniy ma’nosi aniq o‘zgaruvchilarni bevosita baholaydi, implicit qism esa kontakt noaniqligi yoki modellashtirilmagan dinamika kabi bitta jismoniy o‘zgaruvchiga keltirish qiyin, ammo boshqaruv uchun foydali bo‘lgan oldingi naqshlarni latent tasvirda saqlaydi; tadqiqot bu ikki axborot turini birga ishlatish faqat implicit IWM yondashuviga qaraganda tezroq va muvaffaqiyatliroq o‘qitishni ta’minlashini ko‘rsatadi.
15. Ikkinchi bosqichdagi robot kuzatuvi — Tenglama (7)
\[ o_t= \begin{bmatrix} cmd & q_t & \dot q_t & \Phi & \omega \end{bmatrix}^{T} \tag{7} \]
\(cmd\) kerakli harakat buyruqlari va gait phase ma’lumotini o‘z ichiga oladi. \(q_t\) bo‘g‘im holati, \(\dot q_t\) bo‘g‘im tezligi, \(\Phi\) tana holati/orientatsiyasi va \(\omega\) tana burchak tezligidir.
Bo‘g‘im holati va tezligi encoderlardan; holat va burchak tezligi IMUdan olinishi mumkin. Buyruq esa yuqori darajadagi boshqaruv modulidan keladi.
16. Critic privileged state — Tenglama (8)
\[ s_t= \begin{bmatrix} o_t & v_t & h_t^{feet} & \mu_t \end{bmatrix}^{T} \tag{8} \]
\(v_t\) shovqinsiz haqiqiy tana chiziqli tezligi, \(h_t^{feet}\) oyoqlar ostidagi relyef balandligi xaritasi, \(\mu_t\) esa sirt ishqalanish koeffitsiyentidir.
Bularning barchasi o‘qitish paytida criticga berilishi mumkin. Ammo haqiqiy robot siyosati joriy etish vaqtida bu privileged stateni bevosita olishi shart emas.
17. Ochiq va yashirin tasvir
Encoder oldingi kuzatuvlardan ikki xil chiqish hosil qiladi. \(e_t\) ochiq, jismoniy muqobili bo‘lgan baholarni; \(z_t\) esa bevosita muayyan jismoniy kattalikka teng bo‘lmagan latent tasvirni bildiradi.
Ochiq komponentning ikki asosiy chiqishi baholangan tana chiziqli tezligi \(\tilde v_t\) va baholangan mahalliy relyef balandligi \(\tilde h_t^{feet}\) dir.
Yashirin \(z_t\) esa modellashtirilmagan dinamika, kontakt noaniqligi va oldingi kuzatuv naqshlaridagi vazifaga aloqador boshqa ma’lumotlarni siqilgan holda ifodalashni maqsad qiladi.
18. Ochiq baholash yo‘qotishi — Tenglama (9)
\[ \mathcal{L}_{ed} = \left\| v_t-\tilde v_t \right\|_2 + \left\| h_t^{feet}-\tilde h_t^{feet} \right\|_2 \tag{9} \]
Birinchi had haqiqiy va baholangan tana chiziqli tezligi orasidagi farqni, ikkinchi had haqiqiy va baholangan oyoqosti relyef xaritasi orasidagi farqni o‘lchaydi.
Bu auxiliary loss encoderni faqat latent xususiyatlarni o‘rganish bilan cheklanmasdan, ikki jismoniy o‘zgaruvchini ham ochiq tarzda ifodalashga majbur qiladi.
19. Umumiy Stage II yo‘qotishi — Tenglama (10)
\[ \mathcal{L}_{sr} = \mathcal{L}_{ed} + \mathcal{L}_{\pi} + \mathcal{L}_{v} \tag{10} \]
Umumiy o‘qitish maqsadi explicit estimation loss, PPO policy loss va critic value loss komponentlarini birgalikda optimallashtirishdir. Actor, critic va encoder shu tariqa end-to-end tarzda birga o‘qitiladi.
20. Lokomotsiya PD boshqaruvi — Tenglama (11)
\[ \tau = c_t \cdot \left[ k_p \left( a_t+q_d-q \right) - k_d\dot q \right] \tag{11} \]
\(a_t\) siyosat tomonidan hosil qilinadigan 10 o‘lchamli bo‘g‘im-holati residual harakatidir. \(q_d\) standart bo‘g‘im holati, \(q\) haqiqiy holatdir.
Siyosat 100 Hz da yangi harakat hosil qilarkan, PD boshqaruvchi 500 Hz da ishlaydi. Shu tariqa yuqori darajadagi o‘rganilgan siyosat nisbatan past chastotada maqsad o‘zgarishini yaratadi, past darajadagi PD konturi esa momentni tez-tez yangilaydi.
Stage I dagi \(c_t\) aylantiruvchi momentni tuzatish koeffitsiyenti ikkinchi bosqichda ham PD momentini ko‘paytiradi. Stage II o‘qitilishi davomida Stage I moment tuzatish tarmog‘i parametrlari muzlatiladi; gradient orqali qayta o‘zgartirilmaydi.
21. Mukofot funksiyasining tuzilishi
| Komponent | Manba formulasi | Og‘irlik | Vazifasi |
|---|---|---|---|
| Chiziqli tezlikni kuzatish | \(\exp(-4\|v_{xy}^{cmd}-v_{xy}\|^2)\) | 1 | Kerakli gorizontal tezlikni kuzatish |
| Burchak tezligini kuzatish | \(\exp[-4(\omega_z^{cmd}-\omega_z)^2]\) | 1 | Vertikal o‘q bo‘yicha aylanish buyrug‘ini kuzatish |
| Burchak tezligi jazosi | \(\|\omega_{xy}\|^2\) | −0,1 | Pitch/roll harakatini cheklash |
| Tana holati jazosi | \(\|g_{xy}\|^2\) | −2 | Tana og‘ishini kamaytirish |
| COM balandligi jazosi | \((h-h_{des})^2\) | −1 | Kerakli tana balandligini saqlash |
| Bo‘g‘im quvvati jazosi | \(\|\tau\dot q\|^2\) | −1 × 10⁻³ | Yuqori quvvat sarfini cheklash |
| Bo‘g‘im tezlanishi jazosi | \(\|\ddot q\|^2\) | −2,5 × 10⁻⁷ | Keskin bo‘g‘im harakatlarini kamaytirish |
| Harakat o‘zgarishi jazosi | \(\|a_t-a_{t-1}\|^2\) | −0,01 | Boshqaruv signalini silliqlash |
| Stance-phase jazosi | \(r_{fc}\) | −1 | Swing paytida istalmagan kontaktni kamaytirish |
| Swing-phase jazosi | \(r_{fv}\) | −1 | Stance oyog‘idagi sirpanishni kamaytirish |
| Tana to‘qnashuvi jazosi | \(n_{collision}\) | −1 | Istalmagan tana/muhit kontaktini kamaytirish |
22. Swing oyog‘ining kontakt jazosi — Tenglama (12)
\[ r_{fc} = \sum_i I_i(t) \left[ 1- \exp \left( -\frac{ \|f_{foot,i}\|^2 }{50} \right) \right] \tag{12} \]
\(I_i(t)=1\) bo‘lsa, tegishli oyoq swing fazasidadir. Swing paytida oyoqning yerga katta kontakt kuchi qo‘llashi istalmaydi. Kuch oshgani sari bu jazo ortadi va siyosat oyoqni yetarli darajada ko‘tarishga undaladi.
23. Stance oyog‘ining sirpanish jazosi — Tenglama (13)
\[ r_{fv} = \sum_i [1-I_i(t)] \left[ 1- \exp \left( -4 \|v_{xy}^{foot,i}\|^2 \right) \right] \tag{13} \]
Stance fazasida \(I_i(t)=0\) bo‘lgani uchun tegishli oyoq ushbu hadga hissa qo‘shadi. Oyoq tayanch bo‘lib turganda uning gorizontal tezligi katta bo‘lishi sirpanishni ko‘rsatishi mumkinligi sabab jazo ortadi.
24. Episode va buyruq chegaralari
Bitta simulyatsiya episode’i ko‘pi bilan 24 soniya. Tananing roll yoki pitch burchagi mutlaq qiymati 0,785 rad dan oshsa yoki tana massa markazi balandligi 0,3 m dan pastga tushsa, episode muddatidan oldin tugatiladi.
Harakat buyruqlari har 2–6 soniyada qayta namunalab olinadi. Oldinga/orqaga chiziqli tezlik buyrug‘i \(v_x^{cmd}\) −0,5 dan 2,8 m/s gacha; yon tezlik \(v_y^{cmd}\) −1 dan 1 m/s gacha; vertikal o‘q burchak tezligi buyrug‘i \(\omega_z^{cmd}\) esa −1 dan 1 rad/s gacha.
O‘qitish faqat oldinga yurishni emas, balki joyida turish, oldinga/orqaga yurish, yonlama harakat, joyida burilish va ko‘p yo‘nalishli yurish xatti-harakatlarini ham qamrab oladi.
25. Ikkinchi bosqich domain randomization
| Parametr | Birlik | Oraliq |
|---|---|---|
| Bo‘g‘im holati shovqini | rad | \(U(-0.05,0.05)\) |
| Bo‘g‘im tezligi shovqini | rad/s | \(U(-2,2)\) |
| Euler burchagi shovqini | rad | \(U(-0.05,0.05)\) |
| Burchak tezligi shovqini | rad/s | \(U(-0.5,0.5)\) |
| Massa markazi ofseti | cm | \(U(-0.075,0.075)\) |
| Ko‘tariladigan yuk massasi | kg | \(U(-5,5)\) |
| Ishqalanish koeffitsiyenti | O‘lchamsiz | \(U(0.3,2)\) |
| \(k_p,k_d\) koeffitsiyent ko‘paytirgichi | O‘lchamsiz | \(U(0.85,1.15)\) |
Manba jadvalidagi massa markazi ofsetining birligi “cm” deb berilgan va qiymatlar ±0,075. Bu qiymat manbada yozilgan shaklda saqlangan; yashirin tarzda metrga yoki boshqa masshtabga o‘tkazilmagan.
26. Stage II giperparametrlari
| Parametr | Qiymat |
|---|---|
| Parallel muhit | 4096 |
| O‘rganish tezligi | Adaptive |
| Discount factor | 0,99 |
| GAE coefficient | 0,95 |
| Batch soni | 5 |
| Gradient clipping | 1 |
| PPO clipping range | 0,2 |
| Entropy coefficient | 0,01 |
| Policy hidden layers | [512, 256, 128] |
| Critic hidden layers | [512, 256, 128] |
| Encoder | [512, 256, 128] |
| H1, H2 | 4, 60 |
H2=60 oldingi vaqt qadamidan foydalanish yurish paytida dinamikaning vaqtga bog‘liq rivojlanishini ushlashni ko‘zlaydi. Ikkinchi bosqichda entropy coefficient 0,01 ga oshirilgan; tadqiqotchilar bundan murakkabroq lokomotsiya vazifasida qidiruvni kuchaytirish uchun foydalanadi.
27. Terrain curriculum qanday ishlaydi?
O‘qitish muhitidagi relyef qiyinligi robotning muvaffaqiyatiga qarab dinamik ravishda o‘zgartiriladi. Robot joriy relyefning yarmidan ko‘prog‘ini bosib o‘tsa, qiyinroq darajaga ko‘tariladi. Masofa mezoniga javob bermasa, o‘rtacha chiziqli tezlik mukofoti ham baholanadi; samaradorlik past bo‘lsa, osonroq relyefga tushiriladi.
Maksimal darajaga yetgan robotlar doim bir xil eng qiyin relyefda qoldirilish o‘rniga, yuqori chegaradan oshmaydigan tarzda yana tasodifiy relyef darajalariga tayinlanishi mumkin. Maqsad muayyan relyef shakliga haddan tashqari moslashishni kamaytirishdir.
Tadqiqot Usuli va Natijalari
28. Jismoniy robot platformasi
Tajribalar Shanghai DroidUp Co., Ltd. tomonidan ishlab chiqilgan X02 tendonli uzatmali ikki oyoqli robotda o‘tkazilgan. Robot taxminan 1,70 m bo‘yli va taxminan 32 kg og‘irlikda.
Tadqiqotda faqat pastki tananing 10 erkinlik darajasi boshqarilgan. Lokomotsiya policy tarmog‘i RK3588 da 100 Hz tezlikda ishlatilgan.
29. Taqqoslangan usullar
| Usul | Asosiy xususiyat | RS moment tuzatishi | Explicit baholash | Implicit tasvir |
|---|---|---|---|---|
| RMA | Teacher–student Rapid Motor Adaptation | Yo‘q | RSR bilan ayni tuzilma emas | Moslashuv tasviridan foydalanadi |
| IWM | Faqat implicit world representation | Yo‘q | Yo‘q | Ha |
| EIWM | Explicit–implicit world representation | Yo‘q | Ha | Ha |
| RSR | EIWM + Real2Sim aylantiruvchi momentni tuzatish siyosati | Ha | Ha | Ha |
RMA ikki bosqichli teacher–student tuzilmasiga ega bo‘lgani uchun manbadagi simulyatsiya ablatsiyasida bevosita EIWM/IWM/RSR taqqosiga kiritilmagan, ammo haqiqiy robot taqqoslarida ishlatilgan.
30. Simulyatsiyadagi asosiy ablatsiya natijasi
| Usul | O‘rtacha mukofot | O‘rtacha relyef darajasi | O‘rtacha chiziqli tezlik mukofoti |
|---|---|---|---|
| IWM | 23,33 | 3,68 | 0,82 |
| EIWM | 35,67 | 4,58 | 0,95 |
| RSR | 35,83 | 4,56 | 0,97 |
EIWM va RSR taxminan 200 episode ichida yuqori mukofot hududiga yetgan, IWMning yaqinlashuvi esa sekinroq. Manba buni ochiq tezlik va relyef baholari siyosatning zarur jismoniy ma’lumotni faqat latent fazodan kashf etish yukini kamaytirishi bilan bog‘laydi.
31. Manba 7-jadvalidagi hisobot tafsiloti
| Usul | “Average Reward” ustuni | Final mukofotning %80 iga yetish episode’i |
|---|---|---|
| EIWM | 0,9532 | 192 |
| IWM | 0,8268 | 1770 |
| RSR | 0,9768 | 192 |
Bu yerda e’tibor berish kerak bo‘lgan jihat shuki, shu bo‘limdagi matn va 8-jadval “average reward” uchun 35,67, 23,33 va 35,83 qiymatlarini ishlatadi. 7-jadvaldagi 0–1 masshtabidagi “Average Reward” qiymatlari normalashtirilgan boshqa o‘lchovmi yoki yo‘qmi, manbada aniq izohlanmagan. Shu sababli ikki ustun bir xil metrik sifatida birlashtirilmagan.
32. O‘qitishning hisoblash xarajati
Manba o‘rtacha real vaqt o‘rganish davomiyligini EIWM uchun 0,2790 s, RSR uchun 0,2760 s va IWM uchun 0,2738 s deb bildirgan. Tadqiqotchilar farqlar kichikligini va explicit–implicit encoder bilan RS moment tuzatishi bu o‘lchovda katta qo‘shimcha hisoblash yukini keltirib chiqarmaganini ta’kidlaydi.
33. Aylantiruvchi momentni tuzatish siyosatining haqiqiy robotga o‘xshashlikni oshirishi
RS moment tuzatishining ta’sirini bevosita tekshirish uchun RS o‘qitish ma’lumotida bo‘lmagan ikki xil tezlikdagi bo‘g‘im maqsad trayektoriyasi haqiqiy robotga va ikkita simulyatsiya muhitiga qo‘llangan. Simulyatsiyalardan biri original model, ikkinchisi RS moment tuzatishli model.
Haqiqiy bo‘g‘im trayektoriyalari bilan simulyatsiya trayektoriyalari taqqoslangan va RMSE hisoblangan.
Standart RMSE mantiqi tushuntirish uchun:
\[ RMSE= \sqrt{ \frac{1}{N} \sum_{t=1}^{N} \left( q_t^{real}-q_t^{sim} \right)^2 } \]
ko‘rinishidadir. Bu tenglama manbada alohida raqamlangan tenglama emas; RMSE metrikasi nimani o‘lchashini tushuntiruvchi standart matematik ifodadir. RMSE birligi bo‘g‘im holati bilan bir xil bo‘lgani uchun bu yerda radian. Qiymat kamaygan sari simulyatsiya trayektoriyasi haqiqiy robot trayektoriyasiga yaqinlashadi.
| Model | Bo‘g‘im | Past tezlik RMSE (rad) | Yuqori tezlik RMSE (rad) |
|---|---|---|---|
| Original simulyatsiya | Son | 0,0356 | 0,1590 |
| Original simulyatsiya | Tizza | 0,0483 | 0,1985 |
| Original simulyatsiya | To‘piq | 0,0627 | 0,2412 |
| RS moment tuzatishli simulyatsiya | Son | 0,0148 | 0,0375 |
| RS moment tuzatishli simulyatsiya | Tizza | 0,0219 | 0,0586 |
| RS moment tuzatishli simulyatsiya | To‘piq | 0,0294 | 0,0743 |
Farq ayniqsa yuqori tezlik sharoitida katta. Bu natija tendon tizimidagi vaqt bo‘yicha o‘zgaruvchan xatti-harakatlar yuqori tezlikli harakatda ideal modeldan ko‘proq og‘ish hosil qilishi va o‘rganilgan moment tuzatishi bu farqni kamaytirishi mumkinligi haqidagi talqinni qo‘llab-quvvatlaydi.
34. Haqiqiy dunyoda tezlikni kuzatish
Robot 0,6, 1,5, 2,0 va 2,5 m/s oldinga tezlik buyruqlarida alohida yurgizilgan. Har bir tezlik sharoiti 20 soniya davom etgan va har bir usul/tezlik jufti uchun beshta mustaqil sinov o‘tkazilgan.
| Usul | 0,6 m/s buyrug‘i | 1,5 m/s buyrug‘i | 2,0 m/s buyrug‘i | 2,5 m/s buyrug‘i |
|---|---|---|---|---|
| RMA | 10,5 m | 26,8 m | 34,5 m | 32,1 m |
| IWM | 11,1 m | 27,9 m | 36,2 m | 34,3 m |
| EIWM | 11,5 m | 28,6 m | 37,5 m | 36,8 m |
| RSR | 11,8 m | 29,1 m | 38,4 m | 48,2 m |
Eng katta farq 2,5 m/s buyrug‘ida kuzatilgan. Manba beshta mustaqil sinovning o‘rtacha tezligini RSR uchun 2,41 m/s, dispersiyasini 0,00416; EIWM uchun o‘rtacha tezlikni 1,84 m/s, dispersiyasini 0,0102 deb bildirgan.
Manba, shuningdek, 2,5 m/s sharoitida explicit–implicit EIWM faqat implicit IWMga nisbatan tezlikni kuzatish xatosini %15,9 kamaytirgani va RS moment tuzatishi qo‘shilgan RSR EIWMga nisbatan xatoni yana %86,4 kamaytirganini bildiradi.
Bu foizlar “robotning umumiy samaradorligi %86,4 oshdi” deb talqin qilinmasligi kerak. Manbadagi ifoda aynan 2,5 m/s oldinga tezlik buyrug‘idagi tezlikni kuzatish xatosiga taalluqlidir.
35. Boshqaruv signalining silliqligi — Tenglama (14)
Tadqiqot faqat robot qanchalik tez yurganiga emas, bo‘g‘im buyruqlari qanchalik silliq ekaniga ham qaragan. FFT asosidagi silliqlik metrikasi:
\[ S_m= \frac{2}{n f_s} \sum_{i=1}^{n} M_i f_i \tag{14} \]
ko‘rinishidadir.
\(M_i\) \(i\)-chastota komponentining kattaligini; \(f_i\) shu komponentning chastotasini; \(n\) jami chastota komponentlari sonini; \(f_s\) namunalash chastotasini bildiradi.
Yuqori chastotali komponentlar \(f_i\) bilan og‘irliklanganligi sababli yuqori chastotadagi tebranishlar metrikani ko‘proq oshiradi. Shu sababli kichikroq \(S_m\) kamroq yuqori chastotali tarkib va silliqroq boshqaruv signalini anglatadi.
| Usul | Son | Tizza | To‘piq |
|---|---|---|---|
| RMA | 0,307 | 0,340 | 0,389 |
| IWM | 0,228 | 0,286 | 0,351 |
| EIWM | 0,210 | 0,224 | 0,338 |
| RSR | 0,156 | 0,182 | 0,311 |
Uchala bo‘g‘imda ham eng past \(S_m\) qiymati RSRda. Manba buni aylantiruvchi momentni tuzatish siyosati model xatosidan kelib chiqadigan keraksiz yuqori chastotali siyosat tuzatishlarini kamaytirishi bilan bog‘laydi.
36. Harakatlarning standart og‘ishlari
| Usul | Son (rad) | Tizza (rad) | To‘piq (rad) |
|---|---|---|---|
| RMA | 0,7447 | 0,7546 | 4,2153 |
| IWM | 0,7125 | 0,7956 | 3,1262 |
| EIWM | 0,4996 | 0,5974 | 1,7028 |
| RSR | 0,4863 | 0,5857 | 1,6957 |
Standart og‘ishning kamayishi o‘z-o‘zidan yaxshiroq harakat degani emas; robot vazifani ham bajarishi kerak. Bu tadqiqotda past tebranish qiymatlarini tezlikni kuzatish va zinadagi barqarorlik bilan birga baholash muhim.
37. Zina balandligi qanday “idrok etiladi”?
Haqiqiy robotda oyoq osti relyef balandligi imtiyozli sensor o‘lchovi sifatida bevosita mavjud emas. Encoder oldingi propriotseptiv kuzatuv ketma-ketligidan mahalliy relyef balandligini explicit tarzda baholaydi.
Ketma-ket to‘rtta 12 cm li zina tajribasida baholangan relyef balandligi oshganda tizza fleksiyasi ham ortib, oyoqning pog‘ona ustidan o‘tishiga yordam bergani xabar qilingan. Tekis sirtlarda baholangan balandlik o‘zgarishi kichik bo‘lsa, tizza ham kichikroq tuzatishlar qiladi.
38. Zinada tana pitch barqarorligi
| Usul | O‘rtacha (rad) | Standart og‘ish (rad) | Maksimal mutlaq qiymat (rad) |
|---|---|---|---|
| RMA | −0,0434 | 0,0431 | 0,1471 |
| IWM | −0,0334 | 0,0446 | 0,1191 |
| EIWM | −0,0321 | 0,0395 | 0,1367 |
| RSR | −0,0262 | 0,0255 | 0,1065 |
RSRning o‘rtacha pitch burchagi nolga eng yaqin, standart og‘ishi va maksimal mutlaq og‘ishi to‘rtta usul orasidagi eng past qiymatlardir. Manba EIWMga nisbatan o‘rtacha mutlaq pitch qiymati %18,4, standart og‘ish %35,4 va maksimal mutlaq pitch qiymati %22,1 past bo‘lganini bildiradi.
PDFdagi 15-rasm vizual legendasida to‘rtinchi qator “TS” ko‘rinishida bo‘lsa-da, bo‘lim matni va 13-jadval bu usulni RMA deb ataydi. Verianla bu vizual yorliq farqini go‘yo yangi beshinchi usul mavjuddek talqin qilmaydi.
39. Yashirin tasvir fazosi nimani ko‘rsatadi?
Tekis sirt va zina kuzatuvlari latent fazoda ikki aniq klasterga ajralgan. O‘tish bosqichida esa qisman ustma-ust tushish bor.
Manba buni robot zina bilan hali yetarli jismoniy o‘zaro ta’sirga kirishmaganida propriotseptiv holat tekis sirt holatiga o‘xshash bo‘lishi bilan izohlaydi. Bu natija latent tasvir relyefga bog‘liq holat farqlarini olib yurishini ko‘rsatadi.
Biroq klasterlarning ajralishi robot tashqi muhitni kamera kabi to‘g‘ridan-to‘g‘ri sensor bilan semantik jihatdan taniydi degani emas. Tasvir oldingi propriotseptiv kuzatuvlardan hosil qilinadi.
40. Ko‘p turdagi haqiqiy muhit tajribalari
| Ssenariy | Manbada berilgan sharoit | Qayd etilgan kuzatuv |
|---|---|---|
| Asfaltda yuqori tezlikli lokomotsiya | 2,5 m/s | Barqaror harakat va tezlikni kuzatish |
| Ajratilgan to‘siqlar | 20 cm | To‘siqlardan oshib o‘tish |
| Ikki pog‘onali zina | Har bir pog‘ona 10 cm | Uzluksiz ko‘tarilish |
| Yumshoq qiya maysa | Simulyatsiya o‘qitishida bo‘lmagan kontakt muhiti | Sirpanishsiz yoki gait uzilishisiz barqaror yurish qaydi |
| Ketma-ket to‘rtta zina pog‘onasi | Har bir pog‘ona 12 cm | Ketma-ket ko‘tarilish |
Bu ssenariylar usulning haqiqiy dunyodagi qamrovini ko‘rsatadi. Biroq manba ushbu bo‘lim uchun yuzlab takrorlangan dala benchmarkini, har bir relyef uchun muvaffaqiyat foizini yoki xato ehtimolini bermaydi. Shu sababli “har qanday relyefda kafolatli ishlaydi” degan xulosa chiqarib bo‘lmaydi.
41. Tadqiqot qo‘llab-quvvatlaydigan xulosalar
| Qo‘llab-quvvatlanadigan xulosa | Dalil turi |
|---|---|
| Explicit–implicit tasvir faqat implicit IWMga nisbatan simulyatsiya o‘qitishida yuqoriroq mukofot va relyef darajasini ta’minlagan. | Simulyatsiya ablatsiyasi |
| RS aylantiruvchi moment tuzatishi haqiqiy robot bo‘g‘im dinamikasiga yaqinroq simulyatsiya javobini yaratgan. | Haqiqiy robot–simulyatsiya RMSE taqqosi |
| RSR 2,5 m/s tezlik buyrug‘ida taqqoslangan usullar orasida eng yuqori kuzatish samaradorligini ko‘rsatgan. | Beshta mustaqil haqiqiy robot sinovi |
| RSR bo‘g‘im buyruqlarida eng past \(S_m\) qiymatlarini ko‘rsatgan. | FFT asosidagi boshqaruv signali tahlili |
| RSR to‘rtta 12 cm li zinada taqqoslangan usullar orasida pastroq pitch tebranishini ko‘rsatgan. | Haqiqiy robot zina tajribasi |
| Robot simulyatsiyada bo‘lmagan yumshoq maysada barqaror yura olgan. | Haqiqiy muhitdagi sifat tajribasi |
42. Tadqiqot bevosita qo‘llab-quvvatlamaydigan xulosalar
| Qo‘llab-quvvatlanmaydigan umumlashtirish | Nega chiqarib bo‘lmaydi? |
|---|---|
| RSR barcha tendonli uzatmali robotlarda bir xil natija beradi. | Bevosita tajribaviy tekshiruv X02 platformasi bilan cheklangan. |
| RSR barcha relyeflarda %100 muvaffaqiyat beradi. | Manba barcha relyef sinflari uchun keng qamrovli muvaffaqiyat ko‘rsatkichini bermaydi. |
| Robot yerni kamera kabi to‘g‘ridan-to‘g‘ri ko‘radi. | Mavjud siyosat oldingi propriotseptiv kuzatuvlardan relyef ma’lumotini baholaydi; vizual axborot kelajakdagi ish sifatida ko‘rsatilgan. |
| Latent fazodagi ikki klaster relyef tasnifi mukammal ekanini isbotlaydi. | O‘tish hududida klasterlar qisman ustma-ust tushadi va tahlil boshqariladigan tajriba kontekstidadir. |
| RS moment tuzatishi haqiqiy tendon fizikasini to‘liq tavsiflaydigan analitik modeldir. | Usul jismoniy parametrlarni birma-bir belgilash o‘rniga dinamik og‘ishni o‘rganilgan moment tuzatishi bilan yashirin tarzda ifodalaydi. |
| %86,4 qiymat robotning umumiy muvaffaqiyati %86,4 oshganini ko‘rsatadi. | Qiymat faqat 2,5 m/s sharoitidagi tezlikni kuzatish xatosining EIWMga nisbatan kamayishidir. |
43. Tadqiqotning asosiy ilmiy hissasi
Ushbu tadqiqotning asosiy hissasi tendon tizimini yanada batafsil analitik prujina–so‘nish–ishqalanish modeli bilan qayta qurishga urinish emas. Tadqiqotchilar haqiqiy robotning kuzatilgan dinamik javobidan foydalanib, ideal simulyatsiya momentini kichik oraliqda tuzatadigan alohida RL siyosatini o‘rganadi.
Bu yondashuv keyin lokomotsiya siyosati bilan birlashtiriladi. Shu tariqa ikki xil muammo alohida, ammo bog‘liq tarzda hal qilinadi: birinchi tarmoq “simulyatsiyadagi robot jismoniy robot kabi qanday javob berishi kerak?”, ikkinchi tarmoq esa “shu realistikroq dinamika ostida robot qanday yurishi kerak?” savoliga e’tibor qaratadi.
Explicit–implicit tuzilma esa ikkinchi muammoda to‘liq kuzatilmaslikka qarshi ikki xil axborot shaklini birlashtiradi. Ochiq baholar jismoniy ma’nosi ma’lum tezlik va relyef geometriyasini beradi; yashirin latent xususiyatlar esa barcha muhim omillarni birma-bir nomlash qiyin bo‘lgan holatlarni ifodalaydi.
44. Cheklovlar va kelajakdagi ish
Tadqiqotning hozirgi siyosat tuzilmasi asosan propriotseptiv tarixga tayanadi. Tadqiqotchilar murakkabroq relyefda robust lokomotsiya uchun kelajakda vizual ma’lumot qo‘shishni rejalashtirgan.
Shuningdek, adversarial motion priors yordamida biologikroq ko‘rinadigan gait hosil qilish va RS bosqichidagi moment tuzatish o‘qitishida biologik ilhomlangan yurish trayektoriyalaridan foydalanish kelajakdagi ish maqsadlari qatoriga kiradi.
Manba bevosita bitta “Limitations” sarlavhasi ostida batafsil xato byudjetini bermaydi. Shu sababli Verianla manbada yo‘q alohida tajribaviy cheklovlar ro‘yxatini yaratmagan. Uslubiy qamrov chegarasi; bitta jismoniy platforma, belgilangan vazifalar va relyeflar, mavjud propriotseptiv idrok tuzilmasi va xabar qilingan tajriba sonlari asosida saqlangan.
Manba va Usul Haqida Izoh
Asl sarlavha: RSR: Tendon-Driven Bipedal Robot Locomotion Learning Method Based on Real2Sim2Real
Mualliflar: Suozhong Fan, Jian Liu, Jie Xue, Jun Tang, Qingdu Li va Jianwei Zhang.
Mas’ul muallif: Jun Tang.
Teng hissa: Manba maqolada teng hissa bayonoti mavjud emas.
Muassasalar: School of Optical-Electrical and Computer Engineering, University of Shanghai for Science and Technology; Institute of Machine Intelligence, University of Shanghai for Science and Technology; Shanghai DroidUp Co., Ltd.; Department of Informatics, University of Hamburg.
Jurnal: Mathematics.
Nashriyot: MDPI.
Bibliografik qayd: Mathematics 2026, 14(13), 2358.
DOI: 10.3390/math14132358.
Topshirilgan sana: 14 May 2026.
Tahrir sanasi: 22 Iyun 2026.
Qabul sanasi: 23 Iyun 2026.
Nashr sanasi: 2 Iyul 2026.
Rasmiy havola: https://doi.org/10.3390/math14132358
Manba turi: Taqrizdan o‘tgan ilmiy jurnalda chop etilgan original tadqiqot maqolasi. Tadqiqot mustahkamlovchi o‘rganish, simulyatsiya ablatsiyasi va jismoniy ikki oyoqli robot tajribalarini birga qamrab oladi.
Preprint holati: Taqdim etilgan hujjat chop etilgan jurnal versiyasidir. PDF ichida alohida preprint raqami ko‘rsatilmagan.
Litsenziya: Creative Commons Attribution (CC BY).
Robot platformasi: Shanghai DroidUp Co., Ltd. tomonidan ishlab chiqilgan X02 tendonli uzatmali bipedal robot; taxminan 1,70 m, taxminan 32 kg; bu tadqiqotda pastki tanadagi 10 DOF boshqarilgan.
Asosiy usul: Ikki bosqichli Real2Sim2Real. Birinchi bosqichda haqiqiy robot ma’lumotlari bilan torque refinement policy, ikkinchi bosqichda explicit chiziqli tezlik + oyoqosti relyef balandligini baholash bilan implicit latent representation ishlatadigan lokomotsiya policy si o‘qitilgan.
Mustahkamlovchi o‘rganish algoritmi: PPO.
Siyosat ishlash chastotasi: 100 Hz.
PD boshqaruv chastotasi: 500 Hz.
Haqiqiy robot hisoblash platformasi: RK3588.
Haqiqiy tezlik sinovlari: 0,6; 1,5; 2,0 va 2,5 m/s buyruqlari, har bir sharoit uchun 20 soniya va har bir usul/tezlik jufti uchun beshta mustaqil sinov.
Moliyalashtirish: Shanghai Special Fund for Promoting Industrial High-Quality Development–Pioneering Industry Innovation and Development Project, RZ-RGZN-01-25-0673; National Key Research and Development Program of China “Regional Integrated Application Demonstration of Intelligent Technology for Active Health Services”, 2023YFC3605800; 2025 Shanghai Key Technologies Research and Development Program–“New Energy” Project, 25DZ3001401.
Ma’lumotlardan foydalanish: Mualliflar tadqiqotning original hissalari maqola materialida mavjudligini, qo‘shimcha savollar mas’ul muallifga yo‘naltirilishi mumkinligini bildirgan.
Manfaatlar to‘qnashuvi / muassasa aloqasi: Jian Liu, Jie Xue, Jun Tang va Qingdu Li Shanghai DroidUp Co., Ltd. xodimlari ekani xabar qilingan. Boshqa mualliflar tadqiqot potensial manfaatlar to‘qnashuvi sifatida talqin qilinishi mumkin bo‘lgan tijoriy yoki moliyaviy aloqalarsiz o‘tkazilganini bildirgan.
Muallif hissalari: Konseptuallashtirish Suozhong Fan va Jian Liu; metodologiya Suozhong Fan; dasturiy ta’minot Suozhong Fan; tekshirish Suozhong Fan va Jian Liu; formal tahlil Jun Tang va Qingdu Li; tadqiqot Suozhong Fan; resurslar Suozhong Fan; ma’lumot kuratsiyasi Suozhong Fan va Jianwei Zhang; dastlabki qoralama Suozhong Fan va Jie Xue; ko‘rib chiqish va tahrirlash Suozhong Fan; vizuallashtirish Jie Xue; nazorat Jun Tang va Qingdu Li; loyiha boshqaruvi Jun Tang; moliyalashtirish Jun Tang va Jianwei Zhang tomonidan bajarilgan.
Manba ichidagi 7-jadval izohi: Natijalar matni va 8-jadval simulyatsiya average reward qiymatlarini IWM=23,33, EIWM=35,67 va RSR=35,83 deb bergan bo‘lsa, 7-jadvaldagi “Average Reward” ustunida mos ravishda 0,8268, 0,9532 va 0,9768 keltirilgan. Manba bu ikki masshtab orasidagi o‘tishni tushuntirmagani sabab qiymatlar birlashtirilmagan.
Manba ichidagi 15-rasm izohi: PDFning vizual legendasida RSR, EIWM va IWM yonida “TS” yorlig‘i ko‘rinadi, biroq atrofdagi matn va 13-jadval to‘rtinchi taqqoslash usulini RMA deb ataydi. Verianla manbada bo‘lmagan izoh bilan bu yorliqni tuzatmagan; miqdoriy baholashda 13-jadvalda aniq berilgan RMA qatorini saqlagan.
Formula izohi: Manbada raqamlangan Tenglama (1)–(14) saqlanib, tushuntiruvchi tarzda bayon qilingan. RMSEning standart matematik ifodasi faqat metrika ma’nosini tushuntirish uchun qo‘shilgan va manbada yangi raqamlangan tenglama sifatida ko‘rsatilmagan.
Asosiy talqin chegarasi: Tadqiqot haqiqiy jismoniy robot tekshiruvini o‘z ichiga oladi; shu sababli faqat simulyatsiya tadqiqoti emas. Biroq tekshiruv X02 roboti va tadqiqotda berilgan vazifa/muhitlar bilan cheklangan. Natijalar barcha tendonli uzatmali ikki oyoqli robot arxitekturalari uchun universal samaradorlik kafolati bermaydi.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan