


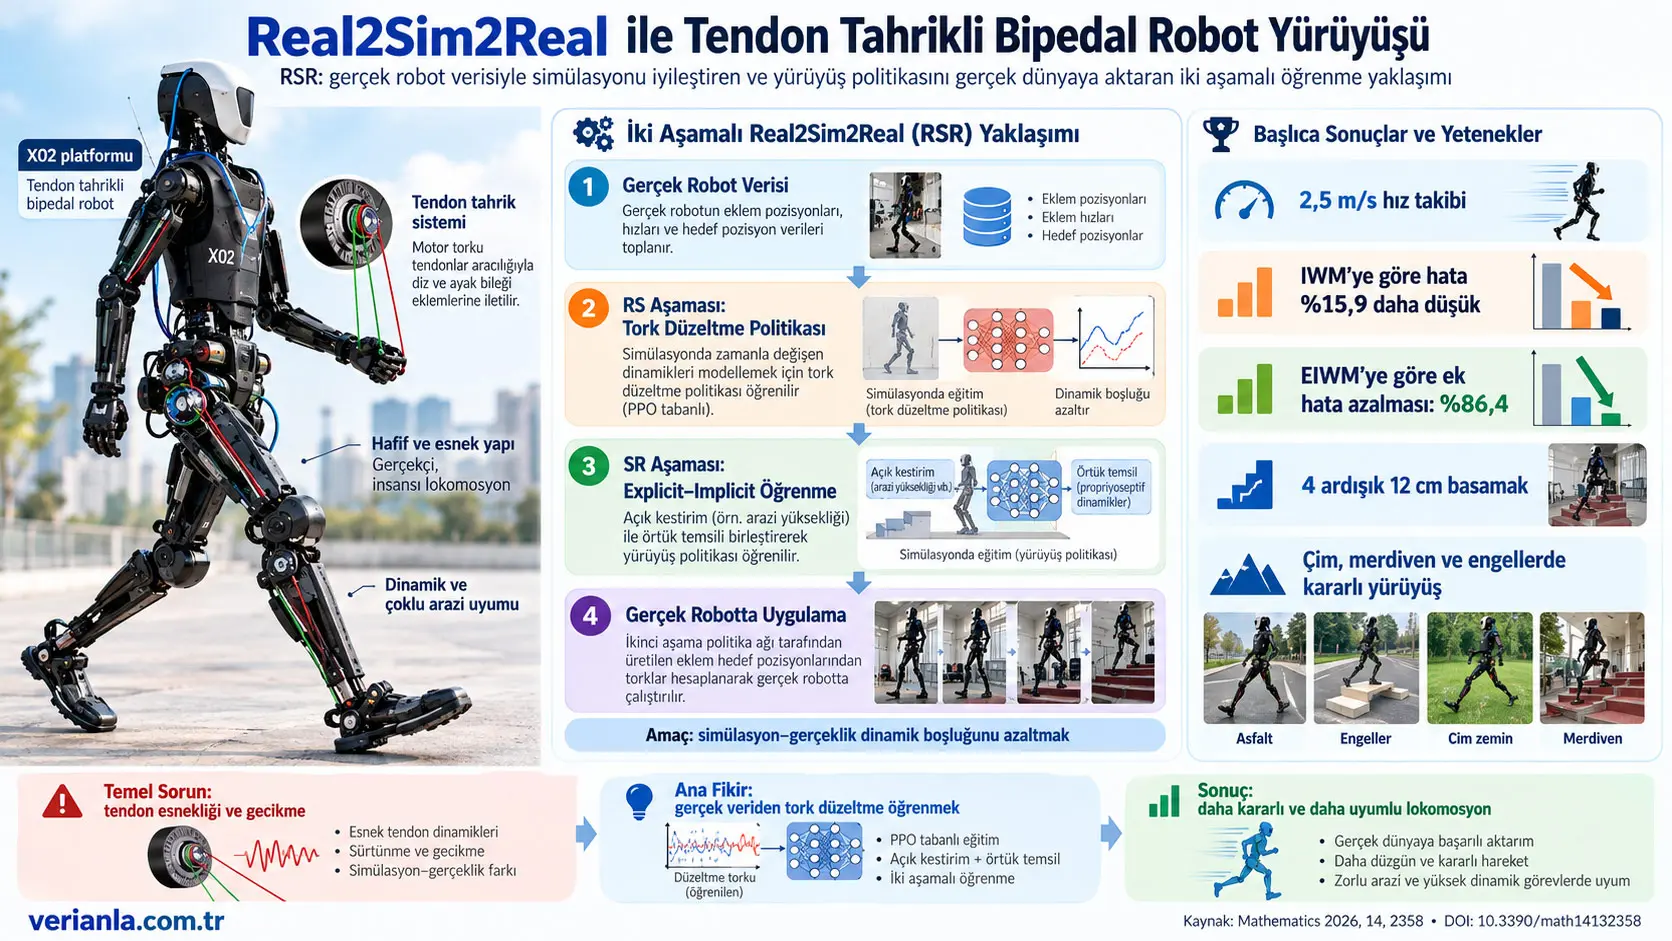
RSR (Real2Sim2Real), gerçek tendon tahrikli robotun ölçülmüş eklem hareketlerinden yararlanarak simülasyondaki dinamik davranışı gerçek robota yaklaştıran ve daha sonra bu düzeltilmiş simülasyon üzerinde lokomosyon politikası eğiten iki aşamalı bir pekiştirmeli öğrenme çerçevesidir. Çalışmanın hedefi, tendon esnekliği, sürtünme, gevşeklik, çoklu eklem bağlantısı ve iletim gecikmesi nedeniyle ideal doğrudan-tahrikli simülasyon modeli ile fiziksel tendon robotu arasında oluşan sim-to-real dinamik boşluğunu azaltmaktır.
İlk aşamada, gerçek robottan eklem hedef konumu, gerçek eklem konumu ve eklem hızı verileri toplanır. Bu veriler simülasyona aktarılır ve pekiştirmeli öğrenmeyle bir tork düzeltme politikası eğitilir. Araştırmacılar tendonun bütün fiziksel parametrelerini tek tek tanımlamak yerine, modellenmesi zor zamanla değişen davranışları ideal simülasyon modelinden sapma olarak ele alır ve bu sapmayı \(c_t\) adlı öğrenilmiş tork çarpanıyla düzeltir.
İkinci aşamada yürüyüş politikası eğitilir. Yöntem yalnız örtük bir latent temsile güvenmez. Robot gövdesinin doğrusal hızını ve ayakların altındaki yerel zemin yüksekliğini açık biçimde tahmin eder; aynı zamanda geçmiş proprioseptif gözlemlerden doğrudan fiziksel bir karşılığı bulunmayan görevle ilişkili örtük özellikler öğrenir. Böylece açık fiziksel durum bilgisi ile modellenmesi zor temas ve dinamik özellikleri aynı politika içerisinde birleştirilir.
Simülasyonda IWM, EIWM ve RSR karşılaştırılmıştır. IWM'nin ortalama ödülü 23,33, EIWM'nin 35,67 ve RSR'nin 35,83 olarak raporlanmıştır. Ortalama zemin güçlük seviyeleri sırasıyla 3,68, 4,58 ve 4,56; doğrusal hız izleme ödülleri ise 0,82, 0,95 ve 0,97'dir. Bu sonuçlar explicit–implicit temsilin yalnız örtük temsile göre eğitim performansını artırdığını, RS tork düzeltmesinin ise simülasyondaki politika performansını belirgin biçimde bozmadığını göstermektedir.
Fiziksel robot deneyleri yaklaşık 1,70 m boyunda, 32 kg ağırlığında X02 tendon tahrikli çift ayaklı robot üzerinde gerçekleştirilmiştir. Yalnız alt gövdedeki 10 serbestlik derecesi kontrol edilmiş, politika RK3588 üzerinde 100 Hz hızında çalıştırılmıştır. 2,5 m/s ileri hız komutunda RSR'nin ortalama gerçek hızı 2,41 m/s iken EIWM 1,84 m/s'ye ulaşmıştır. Kaynak, explicit–implicit öğrenmenin yalnız örtük IWM yaklaşımına göre hız izleme hatasını %15,9 azalttığını; RSR'nin tork düzeltme aşamasının eklenmesiyle EIWM'ye göre hatanın ayrıca %86,4 azaldığını bildirmektedir.
Robot ayrıca dört ardışık 12 cm basamaklı merdiven, 20 cm ayrık engeller, iki basamaklı 10 cm merdiven, asfalt ve yumuşak eğimli çim üzerinde denenmiştir. Çalışmada bu senaryolarda kararlı hareket raporlanmıştır. Özellikle yumuşak çim, simülasyon eğitim ortamında bulunmayan bir temas koşuludur.
Bu sonuçların önemli sınırı, deneylerin tek bir X02 platformu ve çalışmada tanımlanan eğitim/deney koşulları için yapılmış olmasıdır. Çalışma bütün tendon tahrikli robotlarda aynı performansın garanti edildiğini göstermez. Mevcut yaklaşım dış ortamı doğrudan kamera ile algılamamaktadır; araştırmacılar daha karmaşık arazi için görsel bilgiyi gelecek çalışmalarda sisteme eklemeyi planlamaktadır.
1. Tendon tahrikli robot ne demektir?
Tendon tahrikli bir robotta motorun doğrudan hareket ettirilecek eklemin üzerinde bulunması zorunlu değildir. Motor gövdenin daha proksimal bir noktasına yerleştirilebilir ve motor kuvveti kablo veya tendon benzeri esnek bir iletim elemanıyla diz, ayak bileği veya başka bir ekleme taşınabilir.
Bu yaklaşım biyolojik kas–tendon düzenine benzer bir prensip kullanır. Ağır motorların distal eklemlerden uzaklaştırılması bacakların eylemsizliğini ve kütlesini azaltabilir. Bunun karşılığında kontrol problemi daha karmaşık hale gelir; çünkü motorun hareketi ile eklemin gerçek cevabı arasına tendonun fiziksel davranışı girer.
2. Tendon neden simülasyon ile gerçek robot arasında boşluk oluşturuyor?
Kaynak beş temel fiziksel problem üzerinde durmaktadır. Tendonun eksenel esnekliği nedeniyle eklem cevabı motor komutunu gecikmeli veya salınımlı izleyebilir. Tendon ile kasnak arasındaki sürtünme ve tendon liflerinin iç sönümü enerji kaybına ve doğrusal olmayan davranışa neden olabilir. Uzun süreli kullanım tendon uzaması veya gevşeklik oluşturarak backlash meydana getirebilir. Distal tendon yolları nedeniyle bir eklemin hareketi başka bir eklemin tendon gerilimini etkileyebilir. Son olarak tendonun esnekliği ve kütle dağılımı kuvvet iletim bant genişliğini sınırlandırarak yüksek frekanslı kontrol sinyallerini zayıflatabilir.
MuJoCo veya Isaac Gym gibi yaygın simülasyonlarda her ekleme ideal motor yerleştirmek hesaplama bakımından daha kolaydır. Fakat bu ideal model tendonun gerçek zamanla değişen davranışını doğal olarak üretmez. Çalışmanın “proprioseptif dinamik boşluk” dediği farkın temelinde bu durum vardır.
3. Propriosepsiyon nedir?
Robotik bağlamda proprioseptif gözlem, robotun kendi gövde ve eklemlerinden ölçtüğü içsel durum bilgisidir. Bu çalışmada eklem konumu, eklem hızı, gövde yönelimi ve açısal hız gibi bilgiler proprioseptif bilgi olarak kullanılır.
Kamera veya dış ortam haritası proprioseptif bilgi değildir. Araştırmanın özellikle önemli tarafı, gerçek robot politikasının dışarıdan verilen ayrıcalıklı zemin haritasına doğrudan ihtiyaç duymadan geçmiş proprioseptif gözlemlerden yararlanmasıdır.
Real2Sim2Real bu çalışmada ne anlama geliyor?
Real2Sim2Real, önce gerçek robottan toplanan hareket verileriyle simülasyonun robot dinamiklerine yaklaştırılması, ardından bu düzeltilmiş simülasyonda lokomosyon politikasının eğitilip yeniden fiziksel robota aktarılmasıdır; yani veri akışı yalnız Sim→Real değil, Real→Sim→Real şeklindedir.
4. RSR'nin iki aşaması
| Aşama | Kaynağı | Öğrenilen yapı | Ana amaç |
|---|---|---|---|
| Stage I — Real2Sim / RS | Gerçek robotun eklem hedef konumu, gerçek konumu ve hızı | Tork düzeltme politikası | İdeal simülasyon ile tendon robotunun zamanla değişen gövde dinamikleri arasındaki farkı azaltmak |
| Stage II — Sim2Real / SR | RS politikasıyla düzeltilmiş simülasyon, geçmiş gözlemler ve privileged training state | Explicit–implicit lokomosyon politikası | Hız takibi, kararlı yürüyüş ve karmaşık araziye uyum |
| Gerçek dağıtım | Gerçek sensörlerden alınabilen gözlemler | Stage II politika çıktısı + PD kontrol | Fiziksel robot lokomosyonu |
5. Asimetrik actor–critic mimarisi nedir?
Pekiştirmeli öğrenmede actor, mevcut bilgiye göre hangi eylemin uygulanacağını belirleyen politikadır. Critic ise durumun veya eylemin beklenen uzun vadeli değerini tahmin ederek actor'ın eğitimine yardımcı olur.
“Asimetrik” ifadesi actor ile critic'in aynı bilgiye sahip olmaması anlamına gelir. Eğitim sırasında critic gerçek dünyada doğrudan ölçülmesi zor olan ek bilgilere erişebilir. Bunlara privileged information, yani ayrıcalıklı eğitim bilgisi denir. Actor ise gerçek robota aktarılabilecek sensör bilgileriyle çalışacak biçimde eğitilir.
Bu ayrım önemlidir. Eğitim sırasında zemin haritasının gerçek değeri bilinerek encoder'a doğru hedef öğretilebilir; fakat fiziksel robot yürürken bu gerçek değer doğrudan politika girişine verilmez.
6. Stage I gözlemi — Denklem (1)
RS aşamasındaki anlık gözlem kaynakta:
\[ o_t^{rs}= \begin{bmatrix} q_t^{rs} & \dot{q}_t^{rs} \end{bmatrix}^{T} \tag{1} \]
olarak tanımlanmıştır. \(q_t^{rs}\) eklem konumlarını, \(\dot{q}_t^{rs}\) eklem hızlarını gösterir. Konumun birimi radyan, açısal hızın birimi rad/s'dir.
Encoder'a yalnız tek zaman anı verilmez. Dört zaman adımından oluşan geçmiş eklem konumu ve hız dizisi \(o_{H1}^{rs}\) kullanılır. Alt gövde 10 serbestlik derecesine sahip olduğu için bir zaman adımında 10 konum + 10 hız bulunur; dört adımlık geçmiş kaynakta 80 boyutlu vektör olarak tanımlanmıştır.
7. Stage I critic durumu — Denklem (2)
\[ s_t^{rs}= \begin{bmatrix} o_t^{rs} & d_t^{rs} & m_t^{rs} \end{bmatrix}^{T} \tag{2} \]
Burada \(d_t^{rs}\) eklem sönümünü, \(m_t^{rs}\) motor dönme ataletini gösterir. Bunlar critic için kullanılan ayrıcalıklı dinamik bilgileridir.
Actor'ın bunları gerçek robot üzerinde doğrudan ölçmesi şart değildir. Critic'in daha eksiksiz bilgi kullanması, değer fonksiyonunun eğitim sırasında daha düşük belirsizlikle öğrenilmesine yardımcı olmayı amaçlar.
8. PPO kayıp fonksiyonu — Denklem (3)
Politika Proximal Policy Optimization, yani PPO ile güncellenmiştir:
\[ \mathcal{L}_{\pi}= \min\left( \frac{\pi_{\theta}(a_t|s_t)} {\pi_{\theta_b}(a_t|s_t)} A^{\pi_{\theta_b}}(s_t,a_t), \operatorname{clip} \left( \frac{\pi_{\theta}(a_t|s_t)} {\pi_{\theta_b}(a_t|s_t)}, 1-\epsilon, 1+\epsilon \right) A^{\pi_{\theta_b}}(s_t,a_t) \right) \tag{3} \]
\(\pi_{\theta}\) güncellenmekte olan yeni politika, \(\pi_{\theta_b}\) önceki iterasyondaki davranış politikasıdır. İki politikanın aynı eyleme verdiği olasılıkların oranı, yeni politikanın eski politikadan ne kadar uzaklaştığını temsil eder. \(A^{\pi_{\theta_b}}(s_t,a_t)\) advantage fonksiyonudur ve belirli eylemin eski politikaya göre beklenenden ne ölçüde iyi veya kötü olduğunu değerlendirir.
\(\epsilon\) clipping sınırıdır. Çalışmada clipping range 0,2'dir. Oran \(1-\epsilon\) ile \(1+\epsilon\) arasına sıkıştırılarak politikanın tek bir güncellemede aşırı değişmesi engellenmeye çalışılır.
9. Critic değer kaybı — Denklem (4)
\[ \mathcal{L}_{v}= \left( V_{\phi}(s_t)-\hat{R}_t \right)^2 \tag{4} \]
\(V_{\phi}(s_t)\), critic'in durum için tahmin ettiği değerdir. \(\hat{R}_t\) gözlenen veya hesaplanan hedef geri dönüştür. İki değer arasındaki farkın karesi küçültüldükçe critic'in beklenen getiriyi daha doğru tahmin etmesi amaçlanır.
10. Gerçek robot verisi nasıl oluşturuldu?
Gerçek veri toplama sırasında robotun gövde yüksekliği sabit tutulmuş ve ayak yörüngesi sinüs fonksiyonuyla uyarılmıştır. İstenen ayak konumları ters kinematik kullanılarak eklem hedeflerine dönüştürülmüştür.
Sinüs genliği 5–20 cm, frekansı 1–25 Hz arasında sistematik olarak değiştirilmiştir. Böylece tendon sisteminin yalnız tek bir yavaş hareket koşulunda değil, farklı zaman ve frekans ölçeklerinde uyarılması amaçlanmıştır.
Konum kontrolünde düşük sertlikli PD denetleyici kullanılmıştır. Ayak bileği için \(k_p=30\) ve \(k_d=1\); diğer eklemler için \(k_p=100\) ve \(k_d=2\) değerleri verilmiştir.
Kaydedilen temel veriler hedef eklem konumları, gerçek eklem konumları ve eklem hızlarıdır. RS eğitiminde bu veriden rastgele 1 saniyelik diziler alınmış, dizinin ilk zaman adımı simülasyon robotunun başlangıç durumu olarak kullanılmıştır.
11. Stage I domain randomization
| Parametre | Birim | Dağılım |
|---|---|---|
| Eklem konumu gürültüsü | rad | \(U(-0.05,0.05)\) |
| Eklem hızı gürültüsü | rad/s | \(U(-2,2)\) |
\(U(a,b)\), belirtilen alt ve üst sınırlar arasında uniform dağılımı ifade eder. Eklem hızına özellikle güçlü ±2 rad/s gürültü verilmesinin nedeni, gerçek robotta hızın çoğu zaman konum sinyalinin sayısal türeviyle elde edilmesi ve türev işleminin sensör gürültüsünü büyütebilmesidir.
12. Tork düzeltme kontrolü — Denklem (5)
\[ \tau = c_t\cdot \left[ k_p \left( q_{tar}^{rs}-q^{rs} \right) - k_d\dot{q}^{rs} \right] \tag{5} \]
\(\tau\) ekleme uygulanan torku, \(q_{tar}^{rs}\) hedef eklem konumunu, \(q^{rs}\) mevcut eklem konumunu ve \(\dot q^{rs}\) eklem hızını gösterir. \(k_p\) konum hatasına, \(k_d\) hıza bağlı PD kazancıdır.
Denklemdeki kritik yenilik \(c_t\)'dir. Bu değer RL politikası tarafından üretilen tork düzeltme katsayısıdır. Yani ağ sıfırdan tork üretmek yerine mevcut PD torkunu zamanla değişen bir katsayıyla ölçekler.
\(c_t\) kaynakta [0,8, 1,2] aralığına clamp edilmiştir. Böylece politika PD torkunu en fazla yaklaşık %20 azaltabilir veya artırabilir. Bu sınır, eğitim dağılımı dışına çıkıldığında aşırı düzeltmelerin fiziksel olarak tehlikeli veya kararsız hale gelmesini önleyen koruyucu bir kısıttır.
13. RS ödülü — Denklem (6)
\[ r= \exp \left( -100 \left\| q_{real}-q_{sim} \right\|^2 \right) - 0.01 \left\| c_t-c_{t-1} \right\|^2 \tag{6} \]
Birinci terim simülasyon eklem konumlarının gerçek robot eklem konumlarına yaklaşmasını ödüllendirir. \(q_{real}\) gerçek robottan kaydedilen konum, \(q_{sim}\) simülasyondaki konumdur. Hata büyüdükçe üstel terim hızla küçülür.
İkinci terim ardışık tork düzeltme katsayılarının hızlı değişmesini cezalandırır. Böylece yalnız gerçek hareketi takip etmek değil, bunu ani ve düzensiz düzeltmeler yerine daha yumuşak bir tork modülasyonuyla yapmak hedeflenir.
14. Stage I eğitim hiperparametreleri
| Parametre | Değer |
|---|---|
| Paralel ortam sayısı | 4096 |
| Öğrenme oranı | 5 × 10⁻⁴ |
| Discount factor | 0,99 |
| GAE coefficient | 0,95 |
| Batch sayısı | 5 |
| Gradient clipping | 1 |
| PPO clipping range | 0,2 |
| Entropy coefficient | 0,002 |
| Policy hidden layers | [256, 128] |
| Critic hidden layers | [256, 128] |
| Encoder | [256, 128] |
| H1 | 4 zaman adımı |
Explicit–implicit öğrenme neden birlikte kullanılıyor?
Explicit bölüm gövde doğrusal hızı ve ayak altındaki yerel zemin yüksekliği gibi fiziksel anlamı açık değişkenleri doğrudan tahmin ederken, implicit bölüm temas belirsizliği veya modellenmemiş dinamikler gibi tek bir fiziksel değişkene indirgenmesi zor fakat kontrol için yararlı geçmiş örüntülerini latent temsilde tutar; çalışma bu iki bilgi tipinin birlikte kullanılmasının yalnız implicit IWM yaklaşımından daha hızlı ve daha başarılı eğitim sağladığını göstermektedir.
15. İkinci aşamadaki robot gözlemi — Denklem (7)
\[ o_t= \begin{bmatrix} cmd & q_t & \dot q_t & \Phi & \omega \end{bmatrix}^{T} \tag{7} \]
\(cmd\), istenen hareket komutlarını ve gait phase bilgisini içerir. \(q_t\) eklem konumu, \(\dot q_t\) eklem hızı, \(\Phi\) gövde duruşu/yönelimi ve \(\omega\) gövde açısal hızıdır.
Eklem konumu ve hızı encoderlardan; duruş ve açısal hız IMU'dan elde edilebilir. Komut ise üst seviye kontrol modülünden gelir.
16. Critic privileged state — Denklem (8)
\[ s_t= \begin{bmatrix} o_t & v_t & h_t^{feet} & \mu_t \end{bmatrix}^{T} \tag{8} \]
\(v_t\) gürültüsüz gerçek gövde doğrusal hızı, \(h_t^{feet}\) ayakların altındaki zemin yükseklik haritası, \(\mu_t\) ise zemin sürtünme katsayısıdır.
Bunların tamamı critic'e eğitim sırasında verilebilir. Fakat gerçek robot politikasının dağıtım sırasında bu privileged state'i doğrudan alması gerekmez.
17. Açık ve örtük temsil
Encoder geçmiş gözlemlerden iki farklı çıktı üretir. \(e_t\) açık, fiziksel karşılığı olan tahminleri; \(z_t\) ise doğrudan belirli bir fiziksel büyüklüğe eşit olmayan latent temsili gösterir.
Açık bileşenin iki ana çıktısı, tahmini gövde doğrusal hızı \(\tilde v_t\) ve tahmini yerel zemin yüksekliği \(\tilde h_t^{feet}\)'tir.
Örtük \(z_t\) ise modellenmemiş dinamikler, temas belirsizliği ve geçmiş gözlem örüntülerinde bulunan görevle ilişkili başka bilgileri sıkıştırmayı amaçlar.
18. Açık kestirim kaybı — Denklem (9)
\[ \mathcal{L}_{ed} = \left\| v_t-\tilde v_t \right\|_2 + \left\| h_t^{feet}-\tilde h_t^{feet} \right\|_2 \tag{9} \]
İlk terim gerçek ve tahmini gövde doğrusal hızı arasındaki farkı, ikinci terim gerçek ve tahmini ayak-altı zemin haritası arasındaki farkı ölçer.
Bu auxiliary loss, encoder'ın latent özellik öğrenmekle yetinmeyip iki fiziksel değişkeni de açık biçimde temsil etmesini zorlar.
19. Toplam Stage II kaybı — Denklem (10)
\[ \mathcal{L}_{sr} = \mathcal{L}_{ed} + \mathcal{L}_{\pi} + \mathcal{L}_{v} \tag{10} \]
Toplam eğitim amacı explicit estimation loss, PPO policy loss ve critic value loss bileşenlerinin birlikte optimizasyonudur. Actor, critic ve encoder böylece end-to-end biçimde birlikte eğitilir.
20. Lokomosyon PD kontrolü — Denklem (11)
\[ \tau = c_t \cdot \left[ k_p \left( a_t+q_d-q \right) - k_d\dot q \right] \tag{11} \]
\(a_t\), politika tarafından üretilen 10 boyutlu eklem-konumu residual eylemidir. \(q_d\) varsayılan eklem konumu, \(q\) gerçek konumdur.
Politika 100 Hz'de yeni eylem üretirken PD denetleyici 500 Hz'de çalışır. Böylece yüksek seviyeli öğrenilmiş politika daha yavaş frekansta hedef değişikliği oluştururken düşük seviye PD döngüsü daha sık tork güncellemesi yapar.
Stage I'in \(c_t\) tork düzeltme katsayısı ikinci aşamada da PD torkunu çarpar. Stage II eğitimi sırasında Stage I tork düzeltme ağının parametreleri sabitlenir; gradient ile yeniden değiştirilmez.
21. Ödül fonksiyonunun yapısı
| Bileşen | Kaynak formülü | Ağırlık | Görevi |
|---|---|---|---|
| Doğrusal hız takibi | \(\exp(-4\|v_{xy}^{cmd}-v_{xy}\|^2)\) | 1 | İstenen yatay hızı izletmek |
| Açısal hız takibi | \(\exp[-4(\omega_z^{cmd}-\omega_z)^2]\) | 1 | Dikey eksen dönüş komutunu izletmek |
| Açısal hız cezası | \(\|\omega_{xy}\|^2\) | −0,1 | Pitch/roll hareketini sınırlamak |
| Gövde duruş cezası | \(\|g_{xy}\|^2\) | −2 | Gövde eğimini azaltmak |
| COM yükseklik cezası | \((h-h_{des})^2\) | −1 | İstenen gövde yüksekliğini korumak |
| Eklem güç cezası | \(\|\tau\dot q\|^2\) | −1 × 10⁻³ | Yüksek güç kullanımını sınırlamak |
| Eklem ivmesi cezası | \(\|\ddot q\|^2\) | −2,5 × 10⁻⁷ | Ani eklem hareketlerini azaltmak |
| Eylem değişim cezası | \(\|a_t-a_{t-1}\|^2\) | −0,01 | Kontrol sinyalini yumuşatmak |
| Stance-phase cezası | \(r_{fc}\) | −1 | Swing sırasında istenmeyen teması azaltmak |
| Swing-phase cezası | \(r_{fv}\) | −1 | Stance ayağındaki kaymayı azaltmak |
| Gövde çarpışma cezası | \(n_{collision}\) | −1 | İstenmeyen gövde/çevre temasını azaltmak |
22. Swing ayağının temas cezası — Denklem (12)
\[ r_{fc} = \sum_i I_i(t) \left[ 1- \exp \left( -\frac{ \|f_{foot,i}\|^2 }{50} \right) \right] \tag{12} \]
\(I_i(t)=1\) ise ilgili bacak swing fazındadır. Swing sırasında ayağın yere büyük temas kuvveti uygulaması istenmez. Kuvvet büyüdükçe bu ceza yükselir ve politikanın ayağı yeterince kaldırması teşvik edilir.
23. Stance ayağının kayma cezası — Denklem (13)
\[ r_{fv} = \sum_i [1-I_i(t)] \left[ 1- \exp \left( -4 \|v_{xy}^{foot,i}\|^2 \right) \right] \tag{13} \]
Stance fazında \(I_i(t)=0\) olduğu için ilgili ayak bu terime katkı verir. Ayak destek verirken yatay hızının büyük olması kaymaya işaret edebileceğinden ceza yükselir.
24. Episode ve komut sınırları
Bir simülasyon episode'u en fazla 24 saniyedir. Gövdenin roll veya pitch açısının mutlak değeri 0,785 rad değerini aşarsa veya gövde kütle merkezi yüksekliği 0,3 m'nin altına düşerse episode erken sonlandırılır.
Hareket komutları her 2–6 saniyede bir yeniden örneklenir. İleri/geri doğrusal hız komutu \(v_x^{cmd}\) −0,5 ile 2,8 m/s; yanal hız \(v_y^{cmd}\) −1 ile 1 m/s; dikey eksen açısal hız komutu \(\omega_z^{cmd}\) ise −1 ile 1 rad/s arasındadır.
Eğitim yalnız ileri yürümeyi değil; yerinde durma, ileri/geri yürüme, yanal hareket, yerinde dönme ve çok yönlü yürüme davranışlarını kapsar.
25. İkinci aşama domain randomization
| Parametre | Birim | Aralık |
|---|---|---|
| Eklem konumu gürültüsü | rad | \(U(-0.05,0.05)\) |
| Eklem hızı gürültüsü | rad/s | \(U(-2,2)\) |
| Euler açısı gürültüsü | rad | \(U(-0.05,0.05)\) |
| Açısal hız gürültüsü | rad/s | \(U(-0.5,0.5)\) |
| Kütle merkezi ofseti | cm | \(U(-0.075,0.075)\) |
| Taşınan yük kütlesi | kg | \(U(-5,5)\) |
| Sürtünme katsayısı | Boyutsuz | \(U(0.3,2)\) |
| \(k_p,k_d\) kazanç çarpanı | Boyutsuz | \(U(0.85,1.15)\) |
Kaynak tablodaki kütle merkezi ofsetinin birimi “cm” olarak verilmiştir ve değerler ±0,075'tir. Bu değer, kaynakta yazıldığı biçimde korunmuştur; sessizce metreye veya başka bir ölçeğe dönüştürülmemiştir.
26. Stage II hiperparametreleri
| Parametre | Değer |
|---|---|
| Paralel ortam | 4096 |
| Öğrenme oranı | Adaptive |
| Discount factor | 0,99 |
| GAE coefficient | 0,95 |
| Batch sayısı | 5 |
| Gradient clipping | 1 |
| PPO clipping range | 0,2 |
| Entropy coefficient | 0,01 |
| Policy hidden layers | [512, 256, 128] |
| Critic hidden layers | [512, 256, 128] |
| Encoder | [512, 256, 128] |
| H1, H2 | 4, 60 |
H2=60 geçmiş zaman adımının kullanılması, yürüyüş sırasında dinamiğin zamana bağlı gelişimini yakalamayı amaçlar. İkinci aşamada entropy coefficient 0,01'e yükseltilmiştir; araştırmacılar bunu daha karmaşık lokomosyon görevinde keşfi artırmak amacıyla kullanmaktadır.
27. Terrain curriculum nasıl çalışıyor?
Eğitim ortamındaki arazi güçlüğü robotun başarısına göre dinamik olarak değiştirilir. Robot mevcut arazinin yarısından fazlasını geçebilirse daha zor bir seviyeye çıkarılır. Mesafe ölçütünü karşılamıyorsa ortalama doğrusal hız ödülü de değerlendirilir; performans düşükse daha kolay araziye indirilir.
Maksimum seviyeye ulaşan robotlar sürekli aynı en zor arazide tutulmak yerine üst sınırı aşmayacak şekilde yeniden rastgele arazi seviyelerine atanabilir. Amaç belirli bir arazi biçimine aşırı uyumu azaltmaktır.
Çalışmanın Yöntemi ve Bulguları
28. Fiziksel robot platformu
Deneyler Shanghai DroidUp Co., Ltd. tarafından geliştirilen X02 tendon tahrikli çift ayaklı robot üzerinde yapılmıştır. Robot yaklaşık 1,70 m boyunda ve yaklaşık 32 kg ağırlığındadır.
Çalışmada yalnız alt gövdenin 10 serbestlik derecesi kontrol edilmiştir. Lokomosyon policy ağı RK3588 üzerinde 100 Hz hızında çalıştırılmıştır.
29. Karşılaştırılan yöntemler
| Yöntem | Temel özellik | RS tork düzeltmesi | Explicit kestirim | Implicit temsil |
|---|---|---|---|---|
| RMA | Teacher–student Rapid Motor Adaptation | Hayır | RSR ile aynı yapı değil | Adaptasyon temsili kullanır |
| IWM | Yalnız implicit world representation | Hayır | Hayır | Evet |
| EIWM | Explicit–implicit world representation | Hayır | Evet | Evet |
| RSR | EIWM + Real2Sim tork düzeltme politikası | Evet | Evet | Evet |
RMA iki aşamalı teacher–student yapıya sahip olduğundan kaynak simülasyon ablasyonunda doğrudan EIWM/IWM/RSR karşılaştırmasına alınmamış, gerçek robot karşılaştırmalarında ise kullanılmıştır.
30. Simülasyondaki temel ablasyon sonucu
| Yöntem | Ortalama ödül | Ortalama arazi seviyesi | Ortalama doğrusal hız ödülü |
|---|---|---|---|
| IWM | 23,33 | 3,68 | 0,82 |
| EIWM | 35,67 | 4,58 | 0,95 |
| RSR | 35,83 | 4,56 | 0,97 |
EIWM ve RSR yaklaşık 200 episode içinde yüksek ödül bölgesine ulaşırken IWM'nin yakınsaması daha yavaştır. Kaynak bunu açık hız ve arazi tahminlerinin politikanın gerekli fiziksel bilgiyi yalnız latent uzaydan keşfetme yükünü azaltmasıyla ilişkilendirmektedir.
31. Kaynak Tablo 7'deki raporlama ayrıntısı
| Yöntem | “Average Reward” sütunu | Final ödülün %80'ine ulaşma episode'u |
|---|---|---|
| EIWM | 0,9532 | 192 |
| IWM | 0,8268 | 1770 |
| RSR | 0,9768 | 192 |
Burada dikkat edilmesi gereken nokta, aynı bölümde metin ve Tablo 8'in “average reward” için 35,67, 23,33 ve 35,83 değerlerini kullanmasıdır. Tablo 7'deki 0–1 ölçeğindeki “Average Reward” değerlerinin normalize edilmiş başka bir ölçüm olup olmadığı kaynakta açık biçimde açıklanmamaktadır. Bu nedenle iki sütun aynı metrikmiş gibi birleştirilmemiştir.
32. Eğitim hesaplama maliyeti
Kaynak, ortalama gerçek zamanlı öğrenme süresini EIWM için 0,2790 s, RSR için 0,2760 s ve IWM için 0,2738 s olarak bildirmiştir. Araştırmacılar farkların küçük olduğunu ve explicit–implicit encoder ile RS tork düzeltmesinin bu ölçümde büyük bir ek hesaplama yükü oluşturmadığını yorumlamaktadır.
33. Tork düzeltme politikasının gerçek robota benzerliği artırması
RS tork düzeltmesinin etkisini doğrudan test etmek için RS eğitim verisinde bulunmayan iki farklı hızdaki eklem hedef yörüngesi gerçek robota ve iki simülasyon ortamına uygulanmıştır. Simülasyonlardan biri orijinal model, diğeri RS tork düzeltmeli modeldir.
Gerçek eklem trajektorileriyle simülasyon trajektorileri karşılaştırılmış ve RMSE hesaplanmıştır.
Standart RMSE mantığı öğretici olarak:
\[ RMSE= \sqrt{ \frac{1}{N} \sum_{t=1}^{N} \left( q_t^{real}-q_t^{sim} \right)^2 } \]
şeklindedir. Bu denklem kaynakta numaralandırılmış ayrı bir denklem değildir; RMSE metriğinin neyi ölçtüğünü açıklayan standart matematiksel gösterimdir. RMSE'nin birimi eklem konumuyla aynı olduğundan burada radyandır. Değer küçüldükçe simülasyon trajektorisi gerçek robot trajektorisine daha yakındır.
| Model | Eklem | Düşük hız RMSE (rad) | Yüksek hız RMSE (rad) |
|---|---|---|---|
| Orijinal simülasyon | Kalça | 0,0356 | 0,1590 |
| Orijinal simülasyon | Diz | 0,0483 | 0,1985 |
| Orijinal simülasyon | Ayak bileği | 0,0627 | 0,2412 |
| RS tork düzeltmeli simülasyon | Kalça | 0,0148 | 0,0375 |
| RS tork düzeltmeli simülasyon | Diz | 0,0219 | 0,0586 |
| RS tork düzeltmeli simülasyon | Ayak bileği | 0,0294 | 0,0743 |
Fark özellikle yüksek hız koşulunda büyüktür. Bu sonuç, tendon sistemindeki zamanla değişen davranışların yüksek hızlı harekette ideal modele daha fazla sapma oluşturabildiği ve öğrenilmiş tork düzeltmesinin bu farkı azaltabildiği yorumunu desteklemektedir.
34. Gerçek dünyadaki hız takibi
Robot 0,6, 1,5, 2,0 ve 2,5 m/s ileri hız komutlarında ayrı ayrı yürütülmüştür. Her hız koşulu 20 saniye sürmüş ve her yöntem/hız çifti için beş bağımsız deneme yapılmıştır.
| Yöntem | 0,6 m/s komutu | 1,5 m/s komutu | 2,0 m/s komutu | 2,5 m/s komutu |
|---|---|---|---|---|
| RMA | 10,5 m | 26,8 m | 34,5 m | 32,1 m |
| IWM | 11,1 m | 27,9 m | 36,2 m | 34,3 m |
| EIWM | 11,5 m | 28,6 m | 37,5 m | 36,8 m |
| RSR | 11,8 m | 29,1 m | 38,4 m | 48,2 m |
En büyük fark 2,5 m/s komutunda görülmüştür. Kaynak beş bağımsız denemenin ortalama hızını RSR için 2,41 m/s, varyansını 0,00416; EIWM için ortalama hızı 1,84 m/s, varyansını 0,0102 olarak bildirmiştir.
Kaynak ayrıca 2,5 m/s koşulunda explicit–implicit EIWM'nin yalnız implicit IWM'ye göre hız izleme hatasını %15,9 azalttığını ve RS tork düzeltmesi eklenen RSR'nin EIWM'ye göre hatayı ayrıca %86,4 azalttığını raporlamaktadır.
Bu yüzdeler “robotun genel performansı %86,4 arttı” şeklinde yorumlanmamalıdır. Kaynaktaki ifade özel olarak 2,5 m/s ileri hız komutundaki hız izleme hatası ile ilgilidir.
35. Kontrol sinyali düzgünlüğü — Denklem (14)
Çalışma yalnız robotun ne kadar hızlı yürüdüğüne değil, eklem komutlarının ne kadar yumuşak olduğuna da bakmıştır. FFT tabanlı düzgünlük metriği:
\[ S_m= \frac{2}{n f_s} \sum_{i=1}^{n} M_i f_i \tag{14} \]
şeklindedir.
\(M_i\), \(i\). frekans bileşeninin büyüklüğünü; \(f_i\), o bileşenin frekansını; \(n\), toplam frekans bileşeni sayısını; \(f_s\), örnekleme frekansını gösterir.
Yüksek frekans bileşenleri \(f_i\) ile ağırlıklandırıldığı için yüksek frekanstaki salınımlar metriği daha fazla büyütür. Bu nedenle daha küçük \(S_m\), daha düşük yüksek-frekans içeriği ve daha yumuşak kontrol sinyali anlamına gelir.
| Yöntem | Kalça | Diz | Ayak bileği |
|---|---|---|---|
| RMA | 0,307 | 0,340 | 0,389 |
| IWM | 0,228 | 0,286 | 0,351 |
| EIWM | 0,210 | 0,224 | 0,338 |
| RSR | 0,156 | 0,182 | 0,311 |
Üç eklemde de en düşük \(S_m\) değeri RSR'dedir. Kaynak bunu tork düzeltme politikasının model hatasından doğan gereksiz yüksek frekanslı politika düzeltmelerini azaltmasıyla ilişkilendirmektedir.
36. Eylem standart sapmaları
| Yöntem | Kalça (rad) | Diz (rad) | Ayak bileği (rad) |
|---|---|---|---|
| RMA | 0,7447 | 0,7546 | 4,2153 |
| IWM | 0,7125 | 0,7956 | 3,1262 |
| EIWM | 0,4996 | 0,5974 | 1,7028 |
| RSR | 0,4863 | 0,5857 | 1,6957 |
Standart sapmanın küçülmesi tek başına daha iyi hareket anlamına gelmez; robotun görevi de yerine getirmesi gerekir. Bu çalışmada düşük salınım değerlerinin hız takibi ve merdiven kararlılığıyla birlikte değerlendirilmesi önemlidir.
37. Merdiven yüksekliği nasıl “algılanıyor”?
Gerçek robotta ayak altı zemin yüksekliği ayrıcalıklı sensör ölçümü olarak doğrudan bulunmamaktadır. Encoder geçmiş proprioseptif gözlem dizisinden yerel zemin yüksekliğini explicit olarak tahmin etmektedir.
Dört ardışık 12 cm basamaklı merdiven deneyinde tahmini zemin yüksekliği arttığında diz fleksiyonunun da artarak ayağın basamağın üzerinden geçirilmesine yardımcı olduğu raporlanmıştır. Düz zeminde tahmini yükseklik değişimi küçük olduğunda diz daha küçük düzenlemeler yapmaktadır.
38. Merdivende gövde pitch kararlılığı
| Yöntem | Ortalama (rad) | Standart sapma (rad) | Maksimum mutlak değer (rad) |
|---|---|---|---|
| RMA | −0,0434 | 0,0431 | 0,1471 |
| IWM | −0,0334 | 0,0446 | 0,1191 |
| EIWM | −0,0321 | 0,0395 | 0,1367 |
| RSR | −0,0262 | 0,0255 | 0,1065 |
RSR'nin ortalama pitch açısı sıfıra en yakın, standart sapması ve maksimum mutlak sapması dört yöntem arasındaki en düşük değerlerdir. Kaynak EIWM'ye kıyasla ortalama mutlak pitch değerinin %18,4, standart sapmanın %35,4 ve maksimum mutlak pitch değerinin %22,1 daha düşük olduğunu bildirmektedir.
PDF'deki Şekil 15'in görsel lejandında dördüncü seri “TS” biçiminde görünürken bölüm metni ve Tablo 13 bu yöntemi RMA olarak adlandırmaktadır. Verianla, bu görsel etiket farkını yeni bir beşinci yöntem varmış gibi yorumlamamaktadır.
39. Örtük temsil uzayı ne gösteriyor?
Düz zemin ve merdiven gözlemleri latent uzayda iki belirgin kümeye ayrılmıştır. Geçiş aşamasında ise kısmi örtüşme vardır.
Kaynak bunu robot merdivenle henüz yeterli fiziksel etkileşim kurmadığında proprioseptif durumun düz zemindeki duruma benzemesiyle açıklar. Bu sonuç latent temsilin araziyle ilişkili durum farklarını taşıdığını göstermektedir.
Bununla birlikte küme ayrımı, robotun dış ortamı kamera benzeri doğrudan bir sensörle semantik olarak tanıdığı anlamına gelmez. Temsil geçmiş proprioseptif gözlemlerden türetilmektedir.
40. Çoklu gerçek ortam deneyleri
| Senaryo | Kaynakta verilen koşul | Raporlanan gözlem |
|---|---|---|
| Asfalt üzerinde yüksek hızlı lokomosyon | 2,5 m/s | Kararlı hareket ve hız takibi |
| Ayrık engeller | 20 cm | Engellerin aşılması |
| İki basamaklı merdiven | Her basamak 10 cm | Sürekli çıkış |
| Yumuşak eğimli çim | Simülasyon eğitiminde bulunmayan temas ortamı | Kaymadan veya gait kesintisi olmadan kararlı yürüyüş raporu |
| Dört ardışık merdiven basamağı | Her basamak 12 cm | Ardışık çıkış |
Bu senaryolar yöntemin gerçek dünyadaki kapsamını göstermektedir. Ancak kaynak bu bölüm için yüzlerce tekrarlı bir saha benchmark'ı, her arazi için başarı yüzdesi veya hata olasılığı raporlamamaktadır. Bu nedenle “her türlü arazide garantili çalışır” sonucu çıkarılamaz.
41. Çalışmanın desteklediği sonuçlar
| Desteklenen çıkarım | Kanıt türü |
|---|---|
| Explicit–implicit temsil, yalnız implicit IWM'ye göre simülasyon eğitiminde daha yüksek ödül ve arazi seviyesi sağlamıştır. | Simülasyon ablasyonu |
| RS tork düzeltmesi gerçek robot eklem dinamiklerine daha yakın simülasyon tepkisi üretmiştir. | Gerçek robot–simülasyon RMSE karşılaştırması |
| RSR 2,5 m/s hız komutunda karşılaştırılan yöntemler arasında en yüksek takip performansını göstermiştir. | Beş bağımsız gerçek robot denemesi |
| RSR eklem komutlarında en düşük \(S_m\) değerlerini göstermiştir. | FFT tabanlı kontrol sinyali analizi |
| RSR dört 12 cm basamaklı merdivende karşılaştırılan yöntemler arasında daha düşük pitch dalgalanması göstermiştir. | Gerçek robot merdiven deneyi |
| Robot simülasyonda bulunmayan yumuşak çimde kararlı yürüyebilmiştir. | Gerçek ortam nitel deney |
42. Çalışmanın doğrudan desteklemediği sonuçlar
| Desteklenmeyen genelleme | Neden çıkarılamaz? |
|---|---|
| RSR bütün tendon tahrikli robotlarda aynı sonucu verir. | Doğrudan deneysel doğrulama X02 platformuyla sınırlıdır. |
| RSR bütün arazilerde %100 başarı sağlar. | Kaynak bütün arazi sınıfları için kapsamlı başarı oranı raporlamamaktadır. |
| Robot zemini kamera gibi doğrudan görmektedir. | Mevcut politika geçmiş proprioseptif gözlemlerden arazi bilgisi kestirir; görsel bilgi gelecek çalışma olarak belirtilmiştir. |
| Latent uzaydaki iki küme arazi sınıflandırmasının kusursuz olduğunu kanıtlar. | Geçiş bölgesinde kümeler kısmen örtüşmektedir ve analiz kontrollü deney bağlamındadır. |
| RS tork düzeltmesi gerçek tendon fiziğini tam olarak tanımlayan analitik modeldir. | Yöntem fiziksel parametreleri tek tek tanımlamak yerine dinamik sapmayı öğrenilmiş tork düzeltmesiyle örtük olarak temsil eder. |
| %86,4 değeri robotun genel başarısının %86,4 arttığını gösterir. | Değer yalnız 2,5 m/s koşulundaki hız izleme hatasının EIWM'ye göre azalmasıdır. |
43. Çalışmanın temel bilimsel katkısı
Bu araştırmanın temel katkısı tendon sistemini daha ayrıntılı bir analitik yay–sönüm–sürtünme modeliyle yeniden kurmaya çalışmak değildir. Araştırmacılar gerçek robotun gözlenen dinamik cevabını kullanarak ideal simülasyon torkunu küçük bir aralıkta düzelten ayrı bir RL politikası öğrenmektedir.
Bu yaklaşım daha sonra lokomosyon politikasıyla birleştirilir. Böylece iki farklı problem ayrı ama bağlantılı şekilde çözülür: birinci ağ “simülasyondaki robot fiziksel robot gibi nasıl cevap vermeli?”, ikinci ağ ise “bu daha gerçekçi dinamikler altında robot nasıl yürümeli?” sorusuna odaklanır.
Explicit–implicit yapı ise ikinci sorunda eksik gözlemlenebilirliğe karşı iki farklı bilgi biçimini birleştirir. Açık kestirimler fiziksel anlamı belirli hız ve arazi geometrisini sağlar; örtük latent özellikler ise tüm önemli faktörlerin tek tek isimlendirilmesinin zor olduğu durumları temsil eder.
44. Sınırlılıklar ve gelecek çalışma
Çalışmanın mevcut politika yapısı esas olarak proprioseptif geçmişe dayanır. Araştırmacılar daha karmaşık arazi üzerinde robust lokomosyon için gelecekte görsel bilginin eklenmesini planlamaktadır.
Ayrıca adversarial motion priors kullanarak daha biyolojik görünümlü gait üretmek ve RS aşamasındaki tork düzeltme eğitiminde biyolojik esinli yürüyüş trajektorileri kullanmak gelecek çalışma hedefleri arasındadır.
Kaynak doğrudan tek bir “Limitations” alt başlığı altında ayrıntılı hata bütçesi sunmamaktadır. Bu nedenle Verianla, kaynakta bulunmayan ayrı bir deneysel sınırlılık listesi üretmemiştir. Yöntemsel kapsam sınırı; tek fiziksel platform, belirli görev ve araziler, mevcut proprioseptif algı yapısı ve raporlanan deney sayıları üzerinden korunmuştur.
Kaynak ve Yöntem Notu
Özgün başlık: RSR: Tendon-Driven Bipedal Robot Locomotion Learning Method Based on Real2Sim2Real
Yazarlar: Suozhong Fan, Jian Liu, Jie Xue, Jun Tang, Qingdu Li ve Jianwei Zhang.
Sorumlu yazar: Jun Tang.
Eşit katkı: Kaynak makalede eşit katkı bildirimi bulunmamaktadır.
Kurumlar: School of Optical-Electrical and Computer Engineering, University of Shanghai for Science and Technology; Institute of Machine Intelligence, University of Shanghai for Science and Technology; Shanghai DroidUp Co., Ltd.; Department of Informatics, University of Hamburg.
Dergi: Mathematics.
Yayınevi: MDPI.
Bibliyografik kayıt: Mathematics 2026, 14(13), 2358.
DOI: 10.3390/math14132358.
Gönderim tarihi: 14 Mayıs 2026.
Revizyon tarihi: 22 Haziran 2026.
Kabul tarihi: 23 Haziran 2026.
Yayın tarihi: 2 Temmuz 2026.
Resmî bağlantı: https://doi.org/10.3390/math14132358
Kaynak türü: Hakemli bilimsel dergide yayımlanmış özgün araştırma makalesi. Çalışma pekiştirmeli öğrenme, simülasyon ablasyonu ve fiziksel çift ayaklı robot deneylerini birlikte içermektedir.
Preprint durumu: Sağlanan belge yayımlanmış dergi sürümüdür. PDF içinde ayrıca bir preprint numarası belirtilmemektedir.
Lisans: Creative Commons Attribution (CC BY).
Robot platformu: Shanghai DroidUp Co., Ltd. tarafından geliştirilen X02 tendon tahrikli bipedal robot; yaklaşık 1,70 m, yaklaşık 32 kg; bu çalışmada alt gövdedeki 10 DOF kontrol edilmiştir.
Temel yöntem: İki aşamalı Real2Sim2Real. Birinci aşamada gerçek robot verisiyle tork refinement policy, ikinci aşamada explicit doğrusal hız + ayak-altı arazi yüksekliği kestirimi ile implicit latent representation kullanan lokomosyon policy'si eğitilmiştir.
Pekiştirmeli öğrenme algoritması: PPO.
Politika çalışma frekansı: 100 Hz.
PD kontrol frekansı: 500 Hz.
Gerçek robot hesaplama platformu: RK3588.
Gerçek hız denemeleri: 0,6; 1,5; 2,0 ve 2,5 m/s komutları, koşul başına 20 saniye ve yöntem/hız çifti başına beş bağımsız deneme.
Finansman: Shanghai Special Fund for Promoting Industrial High-Quality Development–Pioneering Industry Innovation and Development Project, RZ-RGZN-01-25-0673; National Key Research and Development Program of China “Regional Integrated Application Demonstration of Intelligent Technology for Active Health Services”, 2023YFC3605800; 2025 Shanghai Key Technologies Research and Development Program–“New Energy” Project, 25DZ3001401.
Veri erişilebilirliği: Yazarlar çalışmanın özgün katkılarının makale materyali içinde bulunduğunu, ek soruların sorumlu yazara yöneltilebileceğini belirtmiştir.
Çıkar çatışması / kurum ilişkisi: Jian Liu, Jie Xue, Jun Tang ve Qingdu Li'nin Shanghai DroidUp Co., Ltd. çalışanı olduğu bildirilmiştir. Diğer yazarlar araştırmanın potansiyel çıkar çatışması olarak yorumlanabilecek ticari veya finansal ilişki olmadan yürütüldüğünü beyan etmiştir.
Yazar katkıları: Kavramsallaştırma Suozhong Fan ve Jian Liu; yöntem Suozhong Fan; yazılım Suozhong Fan; doğrulama Suozhong Fan ve Jian Liu; biçimsel analiz Jun Tang ve Qingdu Li; araştırma Suozhong Fan; kaynaklar Suozhong Fan; veri kürasyonu Suozhong Fan ve Jianwei Zhang; ilk taslak Suozhong Fan ve Jie Xue; inceleme ve düzenleme Suozhong Fan; görselleştirme Jie Xue; denetim Jun Tang ve Qingdu Li; proje yönetimi Jun Tang; finansman Jun Tang ve Jianwei Zhang tarafından gerçekleştirilmiştir.
Kaynak içi Tablo 7 notu: Sonuç metni ve Tablo 8 simülasyon average reward değerlerini IWM=23,33, EIWM=35,67 ve RSR=35,83 olarak raporlarken, Tablo 7'de “Average Reward” sütununda sırasıyla 0,8268, 0,9532 ve 0,9768 bulunmaktadır. Kaynak bu iki ölçek arasındaki dönüşümü açıklamadığı için değerler birleştirilmemiştir.
Kaynak içi Şekil 15 notu: PDF'nin görsel lejandında RSR, EIWM ve IWM yanında “TS” etiketi görünürken, çevre metin ve Tablo 13 dördüncü karşılaştırma yöntemini RMA olarak adlandırmaktadır. Verianla, kaynakta bulunmayan açıklamayla bu etiketi düzeltmemiş; nicel değerlendirmede Tablo 13'te açıkça verilen RMA satırını korumuştur.
Formül notu: Kaynakta numaralandırılmış Denklem (1)–(14) korunarak öğretici biçimde açıklanmıştır. RMSE'nin standart matematiksel gösterimi yalnız metriğin anlamını öğretmek için eklenmiş ve kaynakta yeni bir numaralı denklemmiş gibi sunulmamıştır.
Temel yorum sınırı: Çalışma gerçek fiziksel robot doğrulaması içermektedir; dolayısıyla yalnız simülasyon çalışması değildir. Buna karşılık doğrulama X02 robotu ve çalışmada raporlanan görev/ortamlarla sınırlıdır. Sonuçlar bütün tendon tahrikli çift ayaklı robot mimarileri için evrensel performans garantisi oluşturmaz.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir