


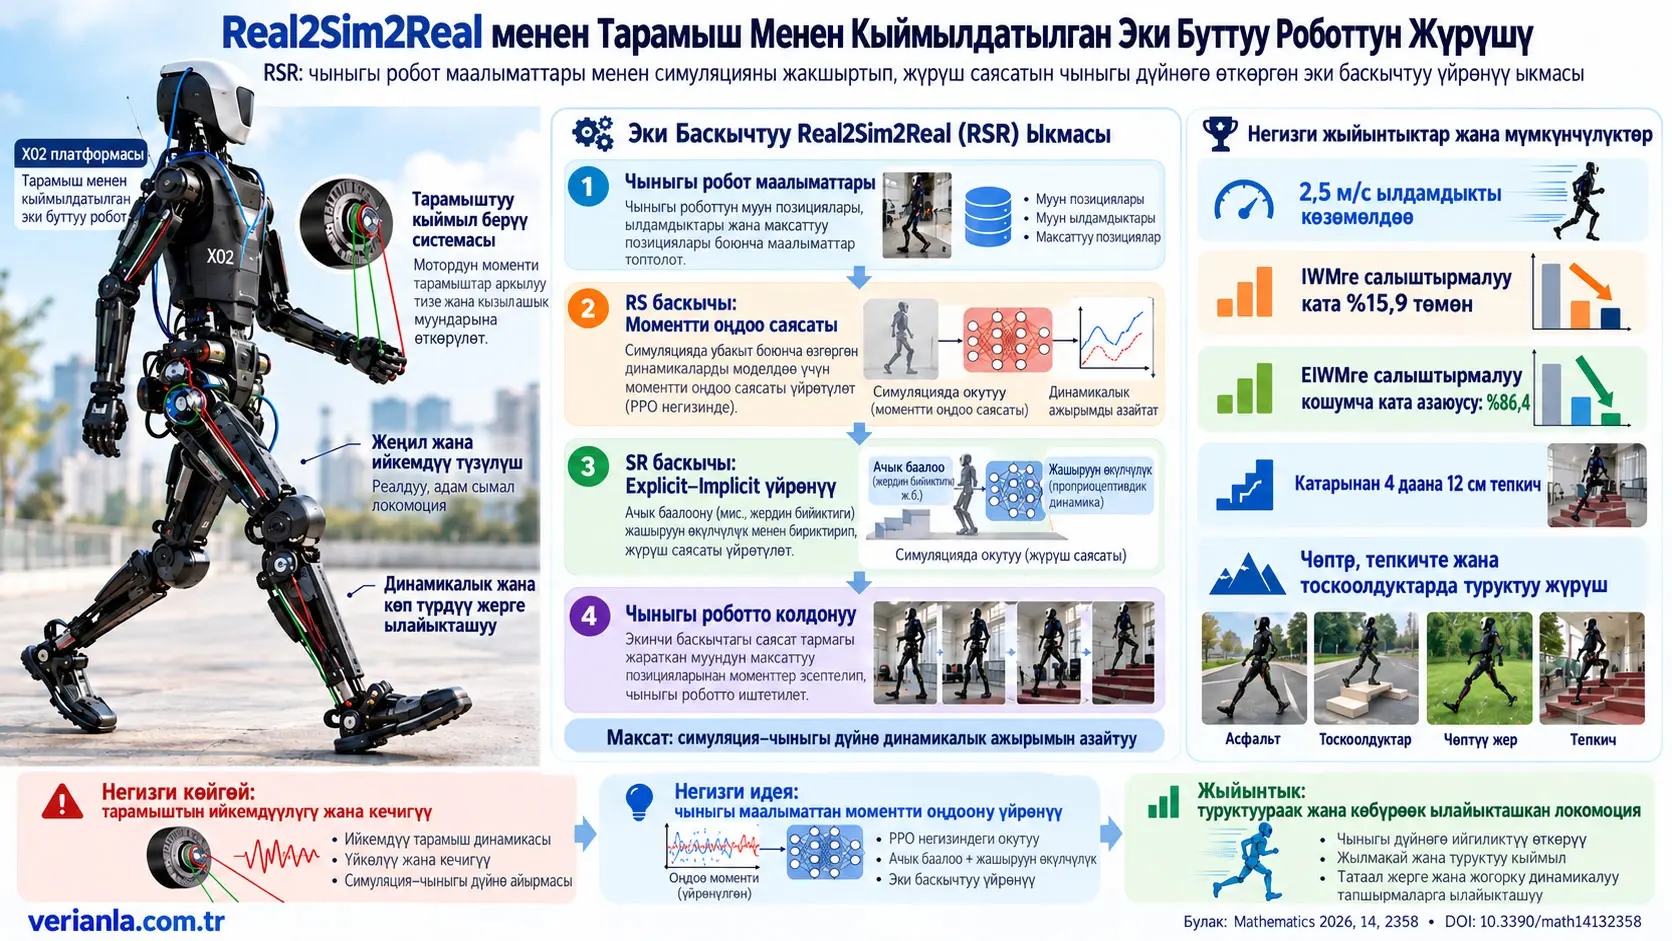
RSR (Real2Sim2Real) — чыныгы тарамыш менен кыймылдатылган роботтун өлчөнгөн муун кыймылдарын колдонуп, симуляциядагы динамикалык жүрүм-турумду чыныгы роботко жакындаткан жана андан кийин ушул оңдолгон симуляцияда локомоция саясатын үйрөткөн эки баскычтуу бекемдөөчү үйрөнүү алкагы. Изилдөөнүн максаты — тарамыштын ийкемдүүлүгү, сүрүлүү, боштук, көп муундуу байланыш жана өткөрүү кечигүүсү себеп болгон идеалдуу түз кыймылдаткычтуу симуляция модели менен физикалык тарамыш роботунун ортосундагы sim-to-real динамикалык ажырымды азайтуу.
Биринчи баскычта чыныгы роботтон муундун максаттуу абалы, чыныгы муун абалы жана муун ылдамдыгы боюнча маалыматтар чогултулат. Бул маалыматтар симуляцияга өткөрүлүп, бекемдөөчү үйрөнүү аркылуу айланма моментти оңдоо саясаты үйрөтүлөт. Изилдөөчүлөр тарамыштын бардык физикалык параметрлерин бирден аныктоонун ордуна, моделдөө кыйын болгон убакытка жараша өзгөрүүчү жүрүм-турумду идеалдуу симуляция моделинен четтөө катары карап, бул четтөөнү \(c_t\) деп аталган үйрөнүлгөн айланма момент көбөйткүчү менен оңдошот.
Экинчи баскычта басуу саясаты үйрөтүлөт. Ыкма бир гана жашыруун latent өкүлчүлүккө таянбайт. Роботтун тулку боюнун сызыктуу ылдамдыгын жана буттардын астындагы жергиликтүү рельеф бийиктигин ачык түрдө баалайт; ошол эле учурда мурунку проприоцептивдик байкоолордон түз физикалык эквиваленти жок, тапшырмага байланышкан жашыруун өзгөчөлүктөрдү үйрөнөт. Ошентип, ачык физикалык абал маалыматы менен моделдөө кыйын болгон контакт жана динамикалык өзгөчөлүктөр бир саясаттын ичинде бириктирилет.
Симуляцияда IWM, EIWM жана RSR салыштырылган. IWMдин орточо сыйлыгы 23,33, EIWMдики 35,67 жана RSRдики 35,83 деп билдирилген. Орточо рельеф кыйындык деңгээлдери тиешелүүлүгүнө жараша 3,68, 4,58 жана 4,56; сызыктуу ылдамдыкты көзөмөлдөө сыйлыктары болсо 0,82, 0,95 жана 0,97. Бул жыйынтыктар explicit–implicit өкүлчүлүк бир гана жашыруун өкүлчүлүккө салыштырмалуу окутуу көрсөткүчүн жакшыртарын, ал эми RS айланма моментин оңдоо симуляциядагы саясаттын көрсөткүчүн олуттуу начарлатпай турганын көрсөтөт.
Физикалык робот сыноолору болжол менен 1,70 m бою, 32 kg салмагы бар X02 тарамыш менен кыймылдатылган эки буттуу роботто өткөрүлгөн. Төмөнкү тулкудагы 10 эркиндик даражасы гана башкарылып, саясат RK3588 үстүндө 100 Hz жыштыкта иштетилген. 2,5 m/s алдыга ылдамдык буйругунда RSRдин орточо чыныгы ылдамдыгы 2,41 m/s болсо, EIWM 1,84 m/s ге жеткен. Булак explicit–implicit үйрөнүү бир гана жашыруун IWM ыкмасына салыштырмалуу ылдамдыкты көзөмөлдөө катасын %15,9 азайтканын; RSRдин айланма моментти оңдоо баскычы кошулганда EIWMге салыштырмалуу ката дагы %86,4 азайганын билдирет.
Робот ошондой эле төрт удаалаш 12 cm баскычы бар тепкичте, 20 cm бөлүнгөн тоскоолдордо, эки баскычтуу 10 cm тепкичте, асфальтта жана жумшак жантайыңкы чөптө сыналган. Изилдөөдө бул сценарийлерде туруктуу кыймыл билдирилген. Өзгөчө жумшак чөп симуляциялык окутуу чөйрөсүндө болбогон контакт шарты.
Бул жыйынтыктардын маанилүү чектөөсү — эксперименттер бир гана X02 платформасында жана изилдөөдө аныкталган окутуу/сыноо шарттарында жүргүзүлгөн. Изилдөө бардык тарамыш менен кыймылдатылган роботтордо ошол эле көрсөткүч кепилденерин көрсөтпөйт. Учурдагы ыкма тышкы чөйрөнү камера менен түз кабыл албайт; изилдөөчүлөр татаалыраак рельеф үчүн визуалдык маалыматты келечектеги иштерде системага кошууну пландашат.
1. Тарамыш менен кыймылдатылган робот деген эмне?
Тарамыш менен кыймылдатылган роботто мотор түз кыймылдатылуучу муундун үстүндө жайгашууга милдеттүү эмес. Мотор тулкунун проксималдуураак чекитине орнотулуп, мотор күчү кабель же тарамыш сымал ийкемдүү өткөргүч элемент аркылуу тизеге, томукка же башка муунга жеткирилиши мүмкүн.
Бул ыкма биологиялык булчуң–тарамыш түзүлүшүнө окшош принципти колдонот. Оор моторлорду дисталдык муундардан алыстатуу буттардын инерциясын жана массасын азайтышы мүмкүн. Анын ордуна башкаруу маселеси татаалдашат, анткени мотордун кыймылы менен муундун чыныгы жообунун ортосуна тарамыштын физикалык жүрүм-туруму кирет.
2. Тарамыш эмне үчүн симуляция менен чыныгы роботтун ортосунда ажырым түзөт?
Булак беш негизги физикалык көйгөйгө токтолот. Тарамыштын октук ийкемдүүлүгүнөн улам муундун жообу мотор буйругун кечигип же термелип ээрчиши мүмкүн. Тарамыш менен шкивдин ортосундагы сүрүлүү жана тарамыш булаларынын ички демпфирлөөсү энергия жоготуусуна жана сызыктуу эмес жүрүм-турумга алып келиши мүмкүн. Узак мөөнөттүү колдонуу тарамыштын созулушуна же бошошуна себеп болуп, backlash жаратышы мүмкүн. Дисталдык тарамыш жолдорунан улам бир муундун кыймылы башка муундун тарамыш чыңалуусуна таасир этиши мүмкүн. Акырында, тарамыштын ийкемдүүлүгү жана массанын бөлүштүрүлүшү күч өткөрүүнүн тилке кеңдигин чектеп, жогорку жыштыктагы башкаруу сигналдарын алсыратышы мүмкүн.
MuJoCo же Isaac Gym сыяктуу кеңири колдонулган симуляцияларда ар бир муунга идеалдуу мотор коюу эсептөө жагынан жеңилирээк. Бирок бул идеалдуу модель тарамыштын убакыт боюнча өзгөргөн чыныгы жүрүм-турумун табигый түрдө жаратпайт. Изилдөө “проприоцептивдик динамикалык ажырым” деп атаган айырманын негизи ушул.
3. Проприоцепция деген эмне?
Робототехника контекстинде проприоцептивдик байкоо — робот өзүнүн тулкусунан жана муундарынан өлчөгөн ички абал маалыматы. Бул изилдөөдө муун абалы, муун ылдамдыгы, тулку ориентациясы жана бурчтук ылдамдык сыяктуу маалыматтар проприоцептивдик маалымат катары колдонулат.
Камера же тышкы чөйрө картасы проприоцептивдик маалымат эмес. Изилдөөнүн өзгөчө маанилүү жагы — чыныгы робот саясаты сырттан берилген артыкчылыктуу рельеф картасына түз муктаж болбой, мурунку проприоцептивдик байкоолорду колдонот.
Real2Sim2Real бул изилдөөдө эмнени билдирет?
Real2Sim2Real — адегенде чыныгы роботтон чогултулган кыймыл маалыматтары менен симуляцияны робот динамикасына жакындатуу, андан кийин ушул оңдолгон симуляцияда локомоция саясатын үйрөтүп, кайра физикалык роботко өткөрүү; башкача айтканда маалымат агымы Sim→Real гана эмес, Real→Sim→Real түрүндө.
4. RSRдин эки баскычы
| Баскыч | Булак | Үйрөнүлгөн түзүм | Негизги максат |
|---|---|---|---|
| Stage I — Real2Sim / RS | Чыныгы роботтун муун максаттуу абалы, чыныгы абалы жана ылдамдыгы | Айланма моментти оңдоо саясаты | Идеалдуу симуляция менен тарамыш роботунун убакыт боюнча өзгөргөн тулку динамикасынын айырмасын азайтуу |
| Stage II — Sim2Real / SR | RS саясаты менен оңдолгон симуляция, мурунку байкоолор жана privileged training state | Explicit–implicit локомоция саясаты | Ылдамдыкты көзөмөлдөө, туруктуу басуу жана татаал рельефке ыңгайлашуу |
| Чыныгы жайылтуу | Чыныгы сенсорлордон алынуучу байкоолор | Stage II саясат чыгышы + PD башкаруу | Физикалык робот локомоциясы |
5. Асимметриялык actor–critic архитектурасы деген эмне?
Бекемдөөчү үйрөнүүдө actor жеткиликтүү маалыматка жараша кайсы аракет аткарыларын аныктаган саясат. Critic болсо абалдын же аракеттин күтүлгөн узак мөөнөттүү маанисин баалап, actorду окутууга жардам берет.
“Асимметриялык” деген actor менен critic бирдей маалыматка ээ эмес экенин билдирет. Окутуу учурунда critic чыныгы дүйнөдө түз өлчөө кыйын болгон кошумча маалыматка жетиши мүмкүн. Бул privileged information, башкача айтканда артыкчылыктуу окутуу маалыматы деп аталат. Actor болсо чыныгы роботко өткөрүүгө боло турган сенсор маалыматы менен иштей тургандай үйрөтүлөт.
Бул айырма маанилүү. Окутуу учурунда рельеф картасынын чыныгы мааниси белгилүү болуп, encoderге туура максат үйрөтүлүшү мүмкүн; бирок физикалык робот басып жатканда бул чыныгы маани саясаттын киришине түз берилбейт.
6. Stage I байкоосу — Теңдеме (1)
RS баскычындагы учурдагы байкоо булакта:
\[ o_t^{rs}= \begin{bmatrix} q_t^{rs} & \dot{q}_t^{rs} \end{bmatrix}^{T} \tag{1} \]
деп аныкталган. \(q_t^{rs}\) муун абалдарын, \(\dot{q}_t^{rs}\) муун ылдамдыктарын көрсөтөт. Абалдын бирдиги радиан, бурчтук ылдамдыктын бирдиги rad/s.
Encoderге бир гана убакыт учуру берилбейт. Төрт убакыт кадамынан турган мурунку муун абалы жана ылдамдык тизмеги \(o_{H1}^{rs}\) колдонулат. Төмөнкү тулку 10 эркиндик даражасына ээ болгондуктан, бир убакыт кадамында 10 абал + 10 ылдамдык бар; төрт кадамдык тарых булакта 80 өлчөмдүү вектор катары аныкталган.
7. Stage I critic абалы — Теңдеме (2)
\[ s_t^{rs}= \begin{bmatrix} o_t^{rs} & d_t^{rs} & m_t^{rs} \end{bmatrix}^{T} \tag{2} \]
Бул жерде \(d_t^{rs}\) муун демпфирлөөсүн, \(m_t^{rs}\) мотордун айлануу инерциясын көрсөтөт. Булар critic үчүн колдонулган артыкчылыктуу динамикалык маалыматтар.
Actor буларды чыныгы роботто түз өлчөөгө милдеттүү эмес. Criticтин толугураак маалыматты колдонушу маанилүүлүк функциясын окутуу учурунда азыраак белгисиздик менен үйрөнүүгө жардам берүүнү көздөйт.
8. PPO жоготуу функциясы — Теңдеме (3)
Саясат Proximal Policy Optimization, башкача айтканда PPO менен жаңыртылган:
\[ \mathcal{L}_{\pi}= \min\left( \frac{\pi_{\theta}(a_t|s_t)} {\pi_{\theta_b}(a_t|s_t)} A^{\pi_{\theta_b}}(s_t,a_t), \operatorname{clip} \left( \frac{\pi_{\theta}(a_t|s_t)} {\pi_{\theta_b}(a_t|s_t)}, 1-\epsilon, 1+\epsilon \right) A^{\pi_{\theta_b}}(s_t,a_t) \right) \tag{3} \]
\(\pi_{\theta}\) жаңыртылып жаткан жаңы саясат, \(\pi_{\theta_b}\) мурунку итерациядагы жүрүм-турум саясаты. Эки саясаттын бир эле аракетке берген ыктымалдыктарынын катышы жаңы саясат эски саясаттан канчалык алыстаганын көрсөтөт. \(A^{\pi_{\theta_b}}(s_t,a_t)\) advantage функциясы болуп, белгилүү аракет эски саясатка салыштырмалуу күтүлгөндөн канчалык жакшы же жаман экенин баалайт.
\(\epsilon\) clipping чеги. Изилдөөдө clipping range 0,2. Катыш \(1-\epsilon\) менен \(1+\epsilon\) аралыгына кысылып, саясат бир жаңыртууда өтө катуу өзгөрүп кетпеши көздөлөт.
9. Critic мааниси боюнча жоготуу — Теңдеме (4)
\[ \mathcal{L}_{v}= \left( V_{\phi}(s_t)-\hat{R}_t \right)^2 \tag{4} \]
\(V_{\phi}(s_t)\) criticтин абал үчүн баалаган мааниси. \(\hat{R}_t\) байкалган же эсептелген максаттуу кайтарым. Эки маанинин айырмасынын квадраты кичирейген сайын critic күтүлгөн кайтарымды такыраак баалоого үйрөнөт.
10. Чыныгы робот маалыматы кантип түзүлдү?
Чыныгы маалымат чогултууда роботтун тулку бийиктиги туруктуу кармалып, бут траекториясы синус функциясы менен козголгон. Каалаган бут абалдары тескери кинематика аркылуу муун максаттарына айландырылган.
Синус амплитудасы 5–20 cm, жыштыгы 1–25 Hz аралыгында системалуу өзгөртүлгөн. Ошентип тарамыш системасын бир гана жай кыймыл шартында эмес, ар кандай убакыт жана жыштык масштабдарында козгоо максатталган.
Абал башкарууда төмөн катуулуктагы PD контроллер колдонулган. Томук үчүн \(k_p=30\) жана \(k_d=1\); башка муундар үчүн \(k_p=100\) жана \(k_d=2\) маанилери берилген.
Жазылган негизги маалыматтар — максаттуу муун абалдары, чыныгы муун абалдары жана муун ылдамдыктары. RS окутуусунда бул маалыматтан туш келди 1 секунддук тизмектер алынган, тизмектин биринчи убакыт кадамы симуляция роботунун баштапкы абалы катары колдонулган.
11. Stage I domain randomization
| Параметр | Бирдик | Бөлүштүрүү |
|---|---|---|
| Муун абалынын ызы-чуусу | rad | \(U(-0.05,0.05)\) |
| Муун ылдамдыгынын ызы-чуусу | rad/s | \(U(-2,2)\) |
\(U(a,b)\) көрсөтүлгөн төмөнкү жана жогорку чектердин ортосундагы uniform бөлүштүрүүнү билдирет. Муун ылдамдыгына өзгөчө күчтүү ±2 rad/s ызы-чуу берилгенинин себеби — чыныгы роботто ылдамдык көп учурда абал сигналынын сандык туундусу аркылуу алынат жана туунду алуу сенсор ызы-чуусун чоңойтушу мүмкүн.
12. Айланма моментти оңдоо башкаруусу — Теңдеме (5)
\[ \tau = c_t\cdot \left[ k_p \left( q_{tar}^{rs}-q^{rs} \right) - k_d\dot{q}^{rs} \right] \tag{5} \]
\(\tau\) муунга берилген айланма моментти, \(q_{tar}^{rs}\) максаттуу муун абалын, \(q^{rs}\) учурдагы муун абалын жана \(\dot q^{rs}\) муун ылдамдыгын көрсөтөт. \(k_p\) абал катасына, \(k_d\) ылдамдыкка байланышкан PD коэффициенти.
Теңдемедеги негизги жаңылык — \(c_t\). Бул RL саясаты чыгарган айланма моментти оңдоо коэффициенти. Башкача айтканда, тармак моментти нөлдөн жаратпастан, учурдагы PD моментин убакытка жараша өзгөргөн коэффициент менен масштабдайт.
\(c_t\) булакта [0,8, 1,2] аралыгына clamp кылынган. Ошентип саясат PD моментин эң көп болжол менен %20 азайтып же көбөйтө алат. Бул чек окутуу бөлүштүрүүсүнөн сыртка чыкканда ашыкча оңдоолор физикалык жактан кооптуу же туруксуз болуп калбашы үчүн коргоочу чектөө болуп саналат.
13. RS сыйлыгы — Теңдеме (6)
\[ r= \exp \left( -100 \left\| q_{real}-q_{sim} \right\|^2 \right) - 0.01 \left\| c_t-c_{t-1} \right\|^2 \tag{6} \]
Биринчи мүчө симуляциядагы муун абалдарынын чыныгы робот муун абалдарына жакындашын сыйлайт. \(q_{real}\) чыныгы роботтон жазылган абал, \(q_{sim}\) симуляциядагы абал. Ката чоңойгон сайын экспоненциалдык мүчө тез кичирейет.
Экинчи мүчө удаалаш айланма моментти оңдоо коэффициенттеринин тез өзгөрүшүн жазалайт. Ошентип максат чыныгы кыймылды жөн гана ээрчүү эмес, аны кескин жана тартипсиз оңдоолордун ордуна жылмакайыраак момент модуляциясы менен аткаруу.
14. Stage I окутуу гиперпараметрлери
| Параметр | Маани |
|---|---|
| Параллелдүү чөйрөлөрдүн саны | 4096 |
| Үйрөнүү ылдамдыгы | 5 × 10⁻⁴ |
| Discount factor | 0,99 |
| GAE coefficient | 0,95 |
| Batch саны | 5 |
| Gradient clipping | 1 |
| PPO clipping range | 0,2 |
| Entropy coefficient | 0,002 |
| Policy hidden layers | [256, 128] |
| Critic hidden layers | [256, 128] |
| Encoder | [256, 128] |
| H1 | 4 убакыт кадамы |
Explicit–implicit үйрөнүү эмне үчүн чогуу колдонулат?
Explicit бөлүк тулкунун сызыктуу ылдамдыгы жана бут алдындагы жергиликтүү рельеф бийиктиги сыяктуу физикалык мааниси так өзгөрмөлөрдү түз баалайт, implicit бөлүк болсо контакт белгисиздиги же моделденбеген динамика сыяктуу бир физикалык өзгөрмөгө түшүрүү кыйын, бирок башкаруу үчүн пайдалуу мурунку үлгүлөрдү latent өкүлчүлүктө сактайт; изилдөө бул эки маалымат түрүн чогуу колдонуу бир гана implicit IWM ыкмасына караганда тезирээк жана ийгиликтүүрөөк окутуу берерин көрсөтөт.
15. Экинчи баскычтагы робот байкоосу — Теңдеме (7)
\[ o_t= \begin{bmatrix} cmd & q_t & \dot q_t & \Phi & \omega \end{bmatrix}^{T} \tag{7} \]
\(cmd\) каалаган кыймыл буйруктарын жана gait phase маалыматын камтыйт. \(q_t\) муун абалы, \(\dot q_t\) муун ылдамдыгы, \(\Phi\) тулку абалы/ориентациясы жана \(\omega\) тулкунун бурчтук ылдамдыгы.
Муун абалы жана ылдамдыгы encoderлерден; абал жана бурчтук ылдамдык IMUдан алынышы мүмкүн. Буйрук болсо жогорку деңгээлдеги башкаруу модулунан келет.
16. Critic privileged state — Теңдеме (8)
\[ s_t= \begin{bmatrix} o_t & v_t & h_t^{feet} & \mu_t \end{bmatrix}^{T} \tag{8} \]
\(v_t\) ызы-чуусуз чыныгы тулку сызыктуу ылдамдыгы, \(h_t^{feet}\) буттардын астындагы рельеф бийиктик картасы, \(\mu_t\) болсо жердин сүрүлүү коэффициенти.
Булардын баары окутуу учурунда criticке берилиши мүмкүн. Бирок чыныгы робот саясаты жайылтуу учурунда бул privileged stateти түз алууга тийиш эмес.
17. Ачык жана жашыруун өкүлчүлүк
Encoder мурунку байкоолордон эки башка чыгыш түзөт. \(e_t\) ачык, физикалык эквиваленти бар баалоолорду; \(z_t\) болсо белгилүү бир физикалык чоңдукка түз барабар эмес latent өкүлчүлүктү көрсөтөт.
Ачык компоненттин эки негизги чыгышы — бааланган тулку сызыктуу ылдамдыгы \(\tilde v_t\) жана бааланган жергиликтүү рельеф бийиктиги \(\tilde h_t^{feet}\).
Жашыруун \(z_t\) моделденбеген динамиканы, контакт белгисиздигин жана мурунку байкоо үлгүлөрүндөгү тапшырмага байланышкан башка маалыматтарды кысылган түрдө чагылдырууну көздөйт.
18. Ачык баалоо жоготуусу — Теңдеме (9)
\[ \mathcal{L}_{ed} = \left\| v_t-\tilde v_t \right\|_2 + \left\| h_t^{feet}-\tilde h_t^{feet} \right\|_2 \tag{9} \]
Биринчи мүчө чыныгы жана бааланган тулку сызыктуу ылдамдыгынын айырмасын, экинчи мүчө чыныгы жана бааланган бут алдындагы рельеф картасынын айырмасын өлчөйт.
Бул auxiliary loss encoderди latent өзгөчөлүктөрдү гана үйрөнбөстөн, эки физикалык өзгөрмөнү да ачык түрдө чагылдырууга мажбурлайт.
19. Жалпы Stage II жоготуусу — Теңдеме (10)
\[ \mathcal{L}_{sr} = \mathcal{L}_{ed} + \mathcal{L}_{\pi} + \mathcal{L}_{v} \tag{10} \]
Жалпы окутуу максаты — explicit estimation loss, PPO policy loss жана critic value loss компоненттерин бирге оптималдаштыруу. Actor, critic жана encoder ушундайча end-to-end түрүндө чогуу үйрөтүлөт.
20. Локомоция PD башкаруусу — Теңдеме (11)
\[ \tau = c_t \cdot \left[ k_p \left( a_t+q_d-q \right) - k_d\dot q \right] \tag{11} \]
\(a_t\) саясат чыгарган 10 өлчөмдүү муун-абал residual аракети. \(q_d\) демейки муун абалы, \(q\) чыныгы абал.
Саясат 100 Hz жыштыкта жаңы аракет чыгарса, PD контроллер 500 Hz жыштыкта иштейт. Ошентип жогорку деңгээлдеги үйрөнүлгөн саясат төмөнүрөөк жыштыкта максат өзгөрүүсүн берет, ал эми төмөнкү деңгээлдеги PD цикл моментти бат-бат жаңыртат.
Stage Iдеги \(c_t\) айланма моментти оңдоо коэффициенти экинчи баскычта да PD моментин көбөйтөт. Stage II окутуусунда Stage I айланма моментти оңдоо тармагынын параметрлери тоңдурулат; gradient аркылуу кайра өзгөртүлбөйт.
21. Сыйлык функциясынын түзүлүшү
| Компонент | Булак формуласы | Салмак | Милдети |
|---|---|---|---|
| Сызыктуу ылдамдыкты көзөмөлдөө | \(\exp(-4\|v_{xy}^{cmd}-v_{xy}\|^2)\) | 1 | Каалаган горизонталдык ылдамдыкты көзөмөлдөө |
| Бурчтук ылдамдыкты көзөмөлдөө | \(\exp[-4(\omega_z^{cmd}-\omega_z)^2]\) | 1 | Тик огундагы айлануу буйругун көзөмөлдөө |
| Бурчтук ылдамдык жазасы | \(\|\omega_{xy}\|^2\) | −0,1 | Pitch/roll кыймылын чектөө |
| Тулку абалы жазасы | \(\|g_{xy}\|^2\) | −2 | Тулкунун кыйшаюусун азайтуу |
| COM бийиктиги жазасы | \((h-h_{des})^2\) | −1 | Каалаган тулку бийиктигин сактоо |
| Муун кубаттуулугу жазасы | \(\|\tau\dot q\|^2\) | −1 × 10⁻³ | Жогорку кубат колдонууну чектөө |
| Муун ылдамдануусу жазасы | \(\|\ddot q\|^2\) | −2,5 × 10⁻⁷ | Кескин муун кыймылдарын азайтуу |
| Аракет өзгөрүүсү жазасы | \(\|a_t-a_{t-1}\|^2\) | −0,01 | Башкаруу сигналын жылмакай кылуу |
| Stance-phase жазасы | \(r_{fc}\) | −1 | Swing учурунда кааланбаган контактты азайтуу |
| Swing-phase жазасы | \(r_{fv}\) | −1 | Stance бутундагы тайгаланууну азайтуу |
| Тулку кагылышуу жазасы | \(n_{collision}\) | −1 | Кааланбаган тулку/чөйрө контакттарын азайтуу |
22. Swing бутунун контакт жазасы — Теңдеме (12)
\[ r_{fc} = \sum_i I_i(t) \left[ 1- \exp \left( -\frac{ \|f_{foot,i}\|^2 }{50} \right) \right] \tag{12} \]
\(I_i(t)=1\) болсо, тиешелүү бут swing фазасында. Swing учурунда буттун жерге чоң контакт күчүн берүү кааланбайт. Күч чоңойгон сайын бул жаза өсүп, саясат бутту жетиштүү көтөрүүгө түрткү алат.
23. Stance бутунун тайгалануу жазасы — Теңдеме (13)
\[ r_{fv} = \sum_i [1-I_i(t)] \left[ 1- \exp \left( -4 \|v_{xy}^{foot,i}\|^2 \right) \right] \tag{13} \]
Stance фазасында \(I_i(t)=0\) болгондуктан, тиешелүү бут бул мүчөгө салым кошот. Бут таяныч болуп турганда анын горизонталдык ылдамдыгы чоң болсо, бул тайгаланууну көрсөтүшү мүмкүн болгондуктан жаза өсөт.
24. Episode жана буйрук чектери
Бир симуляция episode эң көп 24 секунд. Тулкунун roll же pitch бурчунун абсолюттук мааниси 0,785 radдан ашса же тулкунун масса борборунун бийиктиги 0,3 mден төмөн түшсө, episode эрте токтотулат.
Кыймыл буйруктары ар 2–6 секунд сайын кайра үлгүлөнөт. Алдыга/артка сызыктуу ылдамдык буйругу \(v_x^{cmd}\) −0,5 менен 2,8 m/s; каптал ылдамдык \(v_y^{cmd}\) −1 менен 1 m/s; тик огундагы бурчтук ылдамдык буйругу \(\omega_z^{cmd}\) болсо −1 менен 1 rad/s аралыгында.
Окутуу алдыга басууну гана эмес; ордунда туруу, алдыга/артка басуу, каптал кыймыл, ордунда бурулуу жана көп багыттуу басуу жүрүм-турумдарын камтыйт.
25. Экинчи баскыч domain randomization
| Параметр | Бирдик | Аралык |
|---|---|---|
| Муун абалынын ызы-чуусу | rad | \(U(-0.05,0.05)\) |
| Муун ылдамдыгынын ызы-чуусу | rad/s | \(U(-2,2)\) |
| Euler бурчу ызы-чуусу | rad | \(U(-0.05,0.05)\) |
| Бурчтук ылдамдык ызы-чуусу | rad/s | \(U(-0.5,0.5)\) |
| Масса борборунун офсети | cm | \(U(-0.075,0.075)\) |
| Ташылган жүктүн массасы | kg | \(U(-5,5)\) |
| Сүрүлүү коэффициенти | Өлчөмсүз | \(U(0.3,2)\) |
| \(k_p,k_d\) коэффициент көбөйткүчү | Өлчөмсүз | \(U(0.85,1.15)\) |
Булактагы таблицада масса борборунун офсет бирдиги “cm” деп берилген жана маанилер ±0,075. Бул маани булакта жазылгандай сакталган; унчукпай метрге же башка масштабга өзгөртүлгөн эмес.
26. Stage II гиперпараметрлери
| Параметр | Маани |
|---|---|
| Параллелдүү чөйрө | 4096 |
| Үйрөнүү ылдамдыгы | Adaptive |
| Discount factor | 0,99 |
| GAE coefficient | 0,95 |
| Batch саны | 5 |
| Gradient clipping | 1 |
| PPO clipping range | 0,2 |
| Entropy coefficient | 0,01 |
| Policy hidden layers | [512, 256, 128] |
| Critic hidden layers | [512, 256, 128] |
| Encoder | [512, 256, 128] |
| H1, H2 | 4, 60 |
H2=60 мурунку убакыт кадамын колдонуу басуу учурунда динамиканын убакытка жараша өнүгүшүн кармоону көздөйт. Экинчи баскычта entropy coefficient 0,01ге жогорулатылган; изилдөөчүлөр муну татаалыраак локомоция тапшырмасында изилдөөнү көбөйтүү үчүн колдонушат.
27. Terrain curriculum кантип иштейт?
Окутуу чөйрөсүндөгү рельеф кыйынчылыгы роботтун ийгилигине жараша динамикалык түрдө өзгөртүлөт. Робот учурдагы рельефтин жарымынан көбүн өтө алса, кыйыныраак деңгээлге көтөрүлөт. Аралык критерийин аткарбаса, орточо сызыктуу ылдамдык сыйлыгы да бааланат; көрсөткүч төмөн болсо, жеңилирээк рельефке түшүрүлөт.
Максималдуу деңгээлге жеткен роботтор дайыма бир эле эң кыйын рельефте кармалбастан, жогорку чектен ашпай тургандай кайра туш келди рельеф деңгээлдерине дайындалышы мүмкүн. Максат — белгилүү бир рельеф формасына ашыкча ыңгайлашууну азайтуу.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
28. Физикалык робот платформасы
Эксперименттер Shanghai DroidUp Co., Ltd. тарабынан иштелип чыккан X02 тарамыш менен кыймылдатылган эки буттуу роботто жүргүзүлгөн. Робот болжол менен 1,70 m бою жана болжол менен 32 kg салмагы бар.
Изилдөөдө төмөнкү тулкунун 10 эркиндик даражасы гана башкарылган. Локомоция policy тармагы RK3588 үстүндө 100 Hz жыштыкта иштетилген.
29. Салыштырылган ыкмалар
| Ыкма | Негизги өзгөчөлүк | RS момент оңдоосу | Explicit баалоо | Implicit өкүлчүлүк |
|---|---|---|---|---|
| RMA | Teacher–student Rapid Motor Adaptation | Жок | RSR менен бирдей түзүм эмес | Адаптация өкүлчүлүгүн колдонот |
| IWM | Жалаң implicit world representation | Жок | Жок | Ооба |
| EIWM | Explicit–implicit world representation | Жок | Ооба | Ооба |
| RSR | EIWM + Real2Sim айланма моментти оңдоо саясаты | Ооба | Ооба | Ооба |
RMA эки баскычтуу teacher–student түзүмүнө ээ болгондуктан, булактагы симуляциялык абляцияда түз EIWM/IWM/RSR салыштыруусуна киргизилген эмес, бирок чыныгы робот салыштырууларында колдонулган.
30. Симуляциядагы негизги абляция жыйынтыгы
| Ыкма | Орточо сыйлык | Орточо рельеф деңгээли | Орточо сызыктуу ылдамдык сыйлыгы |
|---|---|---|---|
| IWM | 23,33 | 3,68 | 0,82 |
| EIWM | 35,67 | 4,58 | 0,95 |
| RSR | 35,83 | 4,56 | 0,97 |
EIWM жана RSR болжол менен 200 episode ичинде жогорку сыйлык аймагына жетсе, IWMдин жакындашуусу жайыраак. Булак муну ачык ылдамдык жана рельеф баалоолору саясаттын керектүү физикалык маалыматты бир гана latent мейкиндиктен табуу жүгүн азайтышы менен байланыштырат.
31. Булактагы 7-таблицадагы отчеттук детал
| Ыкма | “Average Reward” тилкеси | Final сыйлыктын %80ине жеткен episode |
|---|---|---|
| EIWM | 0,9532 | 192 |
| IWM | 0,8268 | 1770 |
| RSR | 0,9768 | 192 |
Бул жерде көңүл буруучу нерсе — ошол эле бөлүмдө текст жана 8-таблица “average reward” үчүн 35,67, 23,33 жана 35,83 маанилерин колдонот. 7-таблицадагы 0–1 масштабындагы “Average Reward” маанилери нормалдаштырылган башка өлчөмбү же жокпу, булакта ачык түшүндүрүлгөн эмес. Ошондуктан эки тилке бир метрика катары бириктирилген эмес.
32. Окутуунун эсептөө чыгымы
Булак орточо реалдуу убакыттагы үйрөнүү убактысын EIWM үчүн 0,2790 s, RSR үчүн 0,2760 s жана IWM үчүн 0,2738 s деп билдирген. Изилдөөчүлөр айырмалар кичине экенин жана explicit–implicit encoder менен RS айланма момент оңдоосу бул өлчөмдө чоң кошумча эсептөө жүгүн жаратпаганын түшүндүрүшөт.
33. Айланма моментти оңдоо саясаты чыныгы роботко окшоштукту жогорулатат
RS айланма момент оңдоосунун таасирин түз текшерүү үчүн RS окутуу маалыматында болбогон эки башка ылдамдыктагы муун максат траекториясы чыныгы роботко жана эки симуляция чөйрөсүнө берилген. Симуляциялардын бири баштапкы модель, экинчиси RS момент оңдоосу бар модель.
Чыныгы муун траекториялары менен симуляция траекториялары салыштырылып, RMSE эсептелген.
Стандарттык RMSE логикасы түшүндүрүү үчүн:
\[ RMSE= \sqrt{ \frac{1}{N} \sum_{t=1}^{N} \left( q_t^{real}-q_t^{sim} \right)^2 } \]
түрүндө. Бул теңдеме булакта өзүнчө номерленген теңдеме эмес; RMSE метрикасы эмнени өлчөй турганын түшүндүргөн стандарттык математикалык көрсөтмө. RMSEнин бирдиги муун абалы менен бирдей болгондуктан, бул жерде радиан. Маани азайган сайын симуляция траекториясы чыныгы робот траекториясына жакындайт.
| Модель | Муун | Төмөн ылдамдык RMSE (rad) | Жогорку ылдамдык RMSE (rad) |
|---|---|---|---|
| Баштапкы симуляция | Жамбаш | 0,0356 | 0,1590 |
| Баштапкы симуляция | Тизе | 0,0483 | 0,1985 |
| Баштапкы симуляция | Томук | 0,0627 | 0,2412 |
| RS момент оңдоосу бар симуляция | Жамбаш | 0,0148 | 0,0375 |
| RS момент оңдоосу бар симуляция | Тизе | 0,0219 | 0,0586 |
| RS момент оңдоосу бар симуляция | Томук | 0,0294 | 0,0743 |
Айырма өзгөчө жогорку ылдамдык шартында чоң. Бул жыйынтык тарамыш системасындагы убакытка жараша өзгөргөн жүрүм-турум жогорку ылдамдыктагы кыймылда идеалдуу моделден көбүрөөк четтөө жаратышы мүмкүн экенин жана үйрөнүлгөн момент оңдоосу бул айырманы азайта аларын колдойт.
34. Чыныгы дүйнөдө ылдамдыкты көзөмөлдөө
Робот 0,6, 1,5, 2,0 жана 2,5 m/s алдыга ылдамдык буйруктарында өз-өзүнчө бастырылган. Ар бир ылдамдык шарты 20 секунд болгон жана ар бир ыкма/ылдамдык жуп үчүн беш көз карандысыз сыноо өткөрүлгөн.
| Ыкма | 0,6 m/s буйругу | 1,5 m/s буйругу | 2,0 m/s буйругу | 2,5 m/s буйругу |
|---|---|---|---|---|
| RMA | 10,5 m | 26,8 m | 34,5 m | 32,1 m |
| IWM | 11,1 m | 27,9 m | 36,2 m | 34,3 m |
| EIWM | 11,5 m | 28,6 m | 37,5 m | 36,8 m |
| RSR | 11,8 m | 29,1 m | 38,4 m | 48,2 m |
Эң чоң айырма 2,5 m/s буйругунда байкалган. Булак беш көз карандысыз сыноонун орточо ылдамдыгын RSR үчүн 2,41 m/s, дисперсиясын 0,00416; EIWM үчүн орточо ылдамдыкты 1,84 m/s, дисперсиясын 0,0102 деп билдирген.
Булак ошондой эле 2,5 m/s шартында explicit–implicit EIWM бир гана implicit IWMге салыштырмалуу ылдамдыкты көзөмөлдөө катасын %15,9 азайтканын жана RS момент оңдоосу кошулган RSR EIWMге салыштырмалуу катаны дагы %86,4 азайтканын билдирет.
Бул пайыздар “роботтун жалпы көрсөткүчү %86,4 өстү” деп түшүндүрүлбөшү керек. Булактагы билдирүү так 2,5 m/s алдыга ылдамдык буйругундагы ылдамдыкты көзөмөлдөө катасына тиешелүү.
35. Башкаруу сигналынын жылмакайлыгы — Теңдеме (14)
Изилдөө роботтун канчалык тез басканына гана эмес, муун буйруктарынын канчалык жылмакай экенине да караган. FFT негизиндеги жылмакайлык метрикасы:
\[ S_m= \frac{2}{n f_s} \sum_{i=1}^{n} M_i f_i \tag{14} \]
түрүндө.
\(M_i\) \(i\)-жыштык компонентинин чоңдугун; \(f_i\) ошол компоненттин жыштыгын; \(n\) жалпы жыштык компоненттеринин санын; \(f_s\) үлгүлөө жыштыгын көрсөтөт.
Жогорку жыштык компоненттери \(f_i\) менен салмакталгандыктан, жогорку жыштыктагы термелүүлөр метриканы көбүрөөк чоңойтот. Ошондуктан кичирээк \(S_m\) жогорку жыштыктагы мазмундун аздыгын жана жылмакайыраак башкаруу сигналын билдирет.
| Ыкма | Жамбаш | Тизе | Томук |
|---|---|---|---|
| RMA | 0,307 | 0,340 | 0,389 |
| IWM | 0,228 | 0,286 | 0,351 |
| EIWM | 0,210 | 0,224 | 0,338 |
| RSR | 0,156 | 0,182 | 0,311 |
Үч муунда тең эң төмөн \(S_m\) мааниси RSRде. Булак муну айланма моментти оңдоо саясаты модель катасынан чыккан керексиз жогорку жыштыктагы саясат оңдоолорун азайтышы менен байланыштырат.
36. Аракеттердин стандарттык четтөөлөрү
| Ыкма | Жамбаш (rad) | Тизе (rad) | Томук (rad) |
|---|---|---|---|
| RMA | 0,7447 | 0,7546 | 4,2153 |
| IWM | 0,7125 | 0,7956 | 3,1262 |
| EIWM | 0,4996 | 0,5974 | 1,7028 |
| RSR | 0,4863 | 0,5857 | 1,6957 |
Стандарттык четтөөнүн азайышы өзүнчө эле жакшыраак кыймыл дегенди билдирбейт; робот тапшырманы да аткарышы керек. Бул изилдөөдө төмөн термелүү маанилерин ылдамдыкты көзөмөлдөө жана тепкичтеги туруктуулук менен бирге баалоо маанилүү.
37. Тепкич бийиктиги кантип “сезилет”?
Чыныгы роботто бут алдындагы рельеф бийиктиги артыкчылыктуу сенсор өлчөөсү катары түз жеткиликтүү эмес. Encoder мурунку проприоцептивдик байкоо тизмегинен жергиликтүү рельеф бийиктигин explicit түрдө баалайт.
Төрт удаалаш 12 cm баскычы бар тепкич тажрыйбасында бааланган рельеф бийиктиги көбөйгөндө тизенин бүгүлүүсү да көбөйүп, буттун баскычтын үстүнөн өтүшүнө жардам бергени билдирилген. Тегиз жерде бааланган бийиктик өзгөрүүсү аз болсо, тизе да кичине оңдоолорду жасайт.
38. Тепкичтеги тулку pitch туруктуулугу
| Ыкма | Орточо (rad) | Стандарттык четтөө (rad) | Максималдуу абсолюттук маани (rad) |
|---|---|---|---|
| RMA | −0,0434 | 0,0431 | 0,1471 |
| IWM | −0,0334 | 0,0446 | 0,1191 |
| EIWM | −0,0321 | 0,0395 | 0,1367 |
| RSR | −0,0262 | 0,0255 | 0,1065 |
RSRдин орточо pitch бурчу нөлгө эң жакын, стандарттык четтөөсү жана максималдуу абсолюттук четтөөсү төрт ыкманын ичинен эң төмөн. Булак EIWMге салыштырмалуу орточо абсолюттук pitch мааниси %18,4, стандарттык четтөө %35,4 жана максималдуу абсолюттук pitch мааниси %22,1 төмөн экенин билдирет.
PDFдеги 15-сүрөттүн визуалдык легендасында төртүнчү катар “TS” деп көрүнгөнү менен, бөлүм тексти жана 13-таблица бул ыкманы RMA деп атайт. Verianla бул визуалдык энбелги айырмасын жаңы бешинчи ыкма бардай чечмелебейт.
39. Жашыруун өкүлчүлүк мейкиндиги эмнени көрсөтөт?
Тегиз жер жана тепкич байкоолору latent мейкиндикте эки айкын кластерге бөлүнгөн. Өтүү баскычында болсо жарым-жартылай кабатташуу бар.
Булак муну робот тепкич менен али жетиштүү физикалык өз ара аракеттене элек кезде проприоцептивдик абал тегиз жердеги абалга окшош болушу менен түшүндүрөт. Бул жыйынтык latent өкүлчүлүк рельефке байланышкан абал айырмаларын алып жүрөрүн көрсөтөт.
Ошентсе да кластерлердин бөлүнүшү робот тышкы чөйрөнү камера сыяктуу түз сенсор менен семантикалык тааныйт дегенди билдирбейт. Өкүлчүлүк мурунку проприоцептивдик байкоолордон алынат.
40. Ар түрдүү чыныгы чөйрө эксперименттери
| Сценарий | Булакта берилген шарт | Билдирилген байкоо |
|---|---|---|
| Асфальтта жогорку ылдамдыктагы локомоция | 2,5 m/s | Туруктуу кыймыл жана ылдамдыкты көзөмөлдөө |
| Бөлүнгөн тоскоолдор | 20 cm | Тоскоолдордон өтүү |
| Эки баскычтуу тепкич | Ар бир баскыч 10 cm | Үзгүлтүксүз көтөрүлүү |
| Жумшак жантайыңкы чөп | Симуляциялык окутууда болбогон контакт чөйрөсү | Тайгаланбастан же gait үзүлбөстөн туруктуу басуу билдирилген |
| Төрт удаалаш тепкич баскычы | Ар бир баскыч 12 cm | Удаалаш көтөрүлүү |
Бул сценарийлер ыкманын чыныгы дүйнөдөгү камтуусун көрсөтөт. Бирок булак бул бөлүм үчүн жүздөгөн кайталоолуу талаа benchmarkын, ар бир рельеф үчүн ийгилик пайызын же ката ыктымалдыгын бербейт. Ошондуктан “бардык рельефте кепилденген иштейт” деген жыйынтык чыгарууга болбойт.
41. Изилдөө колдогон жыйынтыктар
| Колдоого алынган жыйынтык | Далил түрү |
|---|---|
| Explicit–implicit өкүлчүлүк бир гана implicit IWMге салыштырмалуу симуляциялык окутууда жогорку сыйлык жана рельеф деңгээлин берген. | Симуляциялык абляция |
| RS айланма момент оңдоосу чыныгы робот муун динамикасына жакыныраак симуляция жообун жараткан. | Чыныгы робот–симуляция RMSE салыштыруусу |
| RSR 2,5 m/s ылдамдык буйругунда салыштырылган ыкмалардын ичинен эң жогорку көзөмөлдөө көрсөткүчүн көрсөткөн. | Беш көз карандысыз чыныгы робот сыноосу |
| RSR муун буйруктарында эң төмөн \(S_m\) маанилерин көрсөткөн. | FFT негизиндеги башкаруу сигналын талдоо |
| RSR төрт 12 cm баскычтуу тепкичте салыштырылган ыкмалардын ичинен төмөнүрөөк pitch термелүүсүн көрсөткөн. | Чыныгы робот тепкич тажрыйбасы |
| Робот симуляцияда болбогон жумшак чөптө туруктуу баса алган. | Чыныгы чөйрөдөгү сапаттык эксперимент |
42. Изилдөө түз колдобогон жыйынтыктар
| Колдоого алынбаган жалпылоо | Эмне үчүн чыгарууга болбойт? |
|---|---|
| RSR бардык тарамыш менен кыймылдатылган роботтордо бирдей жыйынтык берет. | Түз эксперименттик текшерүү X02 платформасы менен чектелген. |
| RSR бардык рельефте %100 ийгилик берет. | Булак бардык рельеф класстары үчүн кеңири ийгилик көрсөткүчүн бербейт. |
| Робот жерди камера сыяктуу түз көрөт. | Учурдагы саясат мурунку проприоцептивдик байкоолордон рельеф маалыматын баалайт; визуалдык маалымат келечектеги иш катары көрсөтүлгөн. |
| Latent мейкиндиктеги эки кластер рельеф классификациясы кемчиликсиз экенин далилдейт. | Өтүү аймагында кластерлер жарым-жартылай кабатташат жана талдоо башкарылуучу эксперимент контекстинде. |
| RS айланма момент оңдоосу чыныгы тарамыш физикасын толук сүрөттөгөн аналитикалык модель. | Ыкма физикалык параметрлерди бирден аныктоонун ордуна динамикалык четтөөнү үйрөнүлгөн момент оңдоосу менен жашыруун түрдө чагылдырат. |
| %86,4 мааниси роботтун жалпы ийгилиги %86,4 өскөнүн көрсөтөт. | Маани бир гана 2,5 m/s шартындагы ылдамдыкты көзөмөлдөө катасынын EIWMге салыштырмалуу азайышы. |
43. Изилдөөнүн негизги илимий салымы
Бул изилдөөнүн негизги салымы тарамыш системасын дагы деталдаштырылган аналитикалык пружина–демпфирлөө–сүрүлүү модели менен кайра курууга аракет кылуу эмес. Изилдөөчүлөр чыныгы роботтун байкалган динамикалык жообун колдонуп, идеалдуу симуляция моментин кичине диапазондо оңдогон өзүнчө RL саясатын үйрөнүшөт.
Бул ыкма андан кийин локомоция саясаты менен бириктирилет. Ошентип эки башка маселе өзүнчө, бирок байланышкан түрдө чечилет: биринчи тармак “симуляциядагы робот физикалык робот сыяктуу кантип жооп бериши керек?”, экинчи тармак болсо “ушул реалдуураак динамикада робот кантип басышы керек?” деген суроого көңүл бурат.
Explicit–implicit түзүм экинчи маселеде толук байкалбоого каршы эки башка маалымат формасын бириктирет. Ачык баалоолор физикалык мааниси белгилүү ылдамдык жана рельеф геометриясын берет; жашыруун latent өзгөчөлүктөр болсо бардык маанилүү факторлорду бирден атоо кыйын болгон учурларды чагылдырат.
44. Чектөөлөр жана келечектеги иш
Изилдөөнүн учурдагы саясат түзүмү негизинен проприоцептивдик тарыхка таянат. Изилдөөчүлөр татаалыраак рельефте robust локомоция үчүн келечекте визуалдык маалыматты кошууну пландашат.
Мындан тышкары adversarial motion priors колдонуп биологияга окшошураак gait жаратуу жана RS баскычындагы момент оңдоо окутуусунда биологиядан шыктанган басуу траекторияларын колдонуу келечектеги иштердин максаттарынын арасында.
Булак түз эле бир “Limitations” бөлүмчөсүнүн астында кеңири ката бюджетин бербейт. Ошондуктан Verianla булакта жок өзүнчө эксперименттик чектөөлөр тизмесин түзгөн эмес. Ыкмалык камтуу чеги; бир физикалык платформа, белгилүү тапшырмалар жана рельефтер, учурдагы проприоцептивдик кабылдоо түзүмү жана билдирилген эксперимент саны боюнча сакталган.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска аталыш: RSR: Tendon-Driven Bipedal Robot Locomotion Learning Method Based on Real2Sim2Real
Авторлор: Suozhong Fan, Jian Liu, Jie Xue, Jun Tang, Qingdu Li жана Jianwei Zhang.
Жооптуу автор: Jun Tang.
Тең салым: Булак макалада тең салым жөнүндө билдирүү жок.
Мекемелер: School of Optical-Electrical and Computer Engineering, University of Shanghai for Science and Technology; Institute of Machine Intelligence, University of Shanghai for Science and Technology; Shanghai DroidUp Co., Ltd.; Department of Informatics, University of Hamburg.
Журнал: Mathematics.
Басма: MDPI.
Библиографиялык жазуу: Mathematics 2026, 14(13), 2358.
DOI: 10.3390/math14132358.
Тапшыруу датасы: 14 Май 2026.
Ревизия датасы: 22 Июнь 2026.
Кабыл алуу датасы: 23 Июнь 2026.
Жарыяланган датасы: 2 Июль 2026.
Расмий шилтеме: https://doi.org/10.3390/math14132358
Булак түрү: Рецензияланган илимий журналда жарыяланган оригиналдуу изилдөө макаласы. Изилдөө бекемдөөчү үйрөнүүнү, симуляциялык абляцияны жана физикалык эки буттуу робот эксперименттерин бириктирет.
Preprint абалы: Берилген документ жарыяланган журнал версиясы. PDF ичинде өзүнчө preprint номери көрсөтүлгөн эмес.
Лицензия: Creative Commons Attribution (CC BY).
Робот платформасы: Shanghai DroidUp Co., Ltd. тарабынан иштелип чыккан X02 тарамыш менен кыймылдатылган bipedal робот; болжол менен 1,70 m, болжол менен 32 kg; бул изилдөөдө төмөнкү тулкудагы 10 DOF башкарылган.
Негизги ыкма: Эки баскычтуу Real2Sim2Real. Биринчи баскычта чыныгы робот маалыматы менен torque refinement policy, экинчи баскычта explicit сызыктуу ылдамдык + бут алдындагы рельеф бийиктигин баалоо менен implicit latent representation колдонгон локомоция policyси үйрөтүлгөн.
Бекемдөөчү үйрөнүү алгоритми: PPO.
Саясат иштөө жыштыгы: 100 Hz.
PD башкаруу жыштыгы: 500 Hz.
Чыныгы робот эсептөө платформасы: RK3588.
Чыныгы ылдамдык сыноолору: 0,6; 1,5; 2,0 жана 2,5 m/s буйруктары, ар бир шарт үчүн 20 секунд жана ар бир ыкма/ылдамдык жуп үчүн беш көз карандысыз сыноо.
Каржылоо: Shanghai Special Fund for Promoting Industrial High-Quality Development–Pioneering Industry Innovation and Development Project, RZ-RGZN-01-25-0673; National Key Research and Development Program of China “Regional Integrated Application Demonstration of Intelligent Technology for Active Health Services”, 2023YFC3605800; 2025 Shanghai Key Technologies Research and Development Program–“New Energy” Project, 25DZ3001401.
Маалыматтын жеткиликтүүлүгү: Авторлор изилдөөнүн оригиналдуу салымдары макала материалында бар экенин, кошумча суроолор жооптуу авторго жөнөтүлүшү мүмкүн экенин билдиришкен.
Кызыкчылыктардын кагылышы / мекеме байланышы: Jian Liu, Jie Xue, Jun Tang жана Qingdu Li Shanghai DroidUp Co., Ltd. кызматкерлери экени билдирилген. Башка авторлор изилдөө потенциалдуу кызыкчылыктардын кагылышы катары каралышы мүмкүн болгон коммерциялык же финансылык мамилелерсиз жүргүзүлгөнүн билдиришкен.
Автордук салымдар: Концептуалдаштыруу Suozhong Fan жана Jian Liu; методология Suozhong Fan; программалык камсыздоо Suozhong Fan; текшерүү Suozhong Fan жана Jian Liu; формалдык талдоо Jun Tang жана Qingdu Li; изилдөө Suozhong Fan; ресурстар Suozhong Fan; маалыматтарды курациялоо Suozhong Fan жана Jianwei Zhang; алгачкы долбоор Suozhong Fan жана Jie Xue; карап чыгуу жана редакциялоо Suozhong Fan; визуалдаштыруу Jie Xue; көзөмөл Jun Tang жана Qingdu Li; долбоорду башкаруу Jun Tang; каржылоо Jun Tang жана Jianwei Zhang тарабынан аткарылган.
Булактагы 7-таблица эскертүүсү: Жыйынтык тексти жана 8-таблица симуляция average reward маанилерин IWM=23,33, EIWM=35,67 жана RSR=35,83 деп билдирсе, 7-таблицадагы “Average Reward” тилкесинде тиешелүүлүгүнө жараша 0,8268, 0,9532 жана 0,9768 берилген. Булак бул эки масштабдын ортосундагы өзгөртүүнү түшүндүрбөгөндүктөн, маанилер бириктирилген эмес.
Булактагы 15-сүрөт эскертүүсү: PDFтин визуалдык легендасында RSR, EIWM жана IWM жанында “TS” энбелгиси көрүнөт, бирок жанындагы текст жана 13-таблица төртүнчү салыштыруу ыкмасын RMA деп атайт. Verianla булакта жок түшүндүрмө менен бул энбелгини оңдогон эмес; сандык баалоодо 13-таблицада так берилген RMA сабын сактаган.
Формула эскертүүсү: Булакта номерленген Теңдеме (1)–(14) сакталып, түшүндүрмөлүү түрдө берилген. RMSEнин стандарттык математикалык көрсөтмөсү метриканын маанисин түшүндүрүү үчүн гана кошулуп, булакта жаңы номерленген теңдеме катары көрсөтүлгөн эмес.
Негизги чечмелөө чеги: Изилдөө чыныгы физикалык робот текшерүүсүн камтыйт; демек, бул бир гана симуляциялык изилдөө эмес. Бирок текшерүү X02 роботу жана изилдөөдө билдирилген тапшырма/чөйрөлөр менен чектелген. Жыйынтыктар бардык тарамыш менен кыймылдатылган эки буттуу робот архитектуралары үчүн универсалдуу көрсөткүч кепилдигин бербейт.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген