


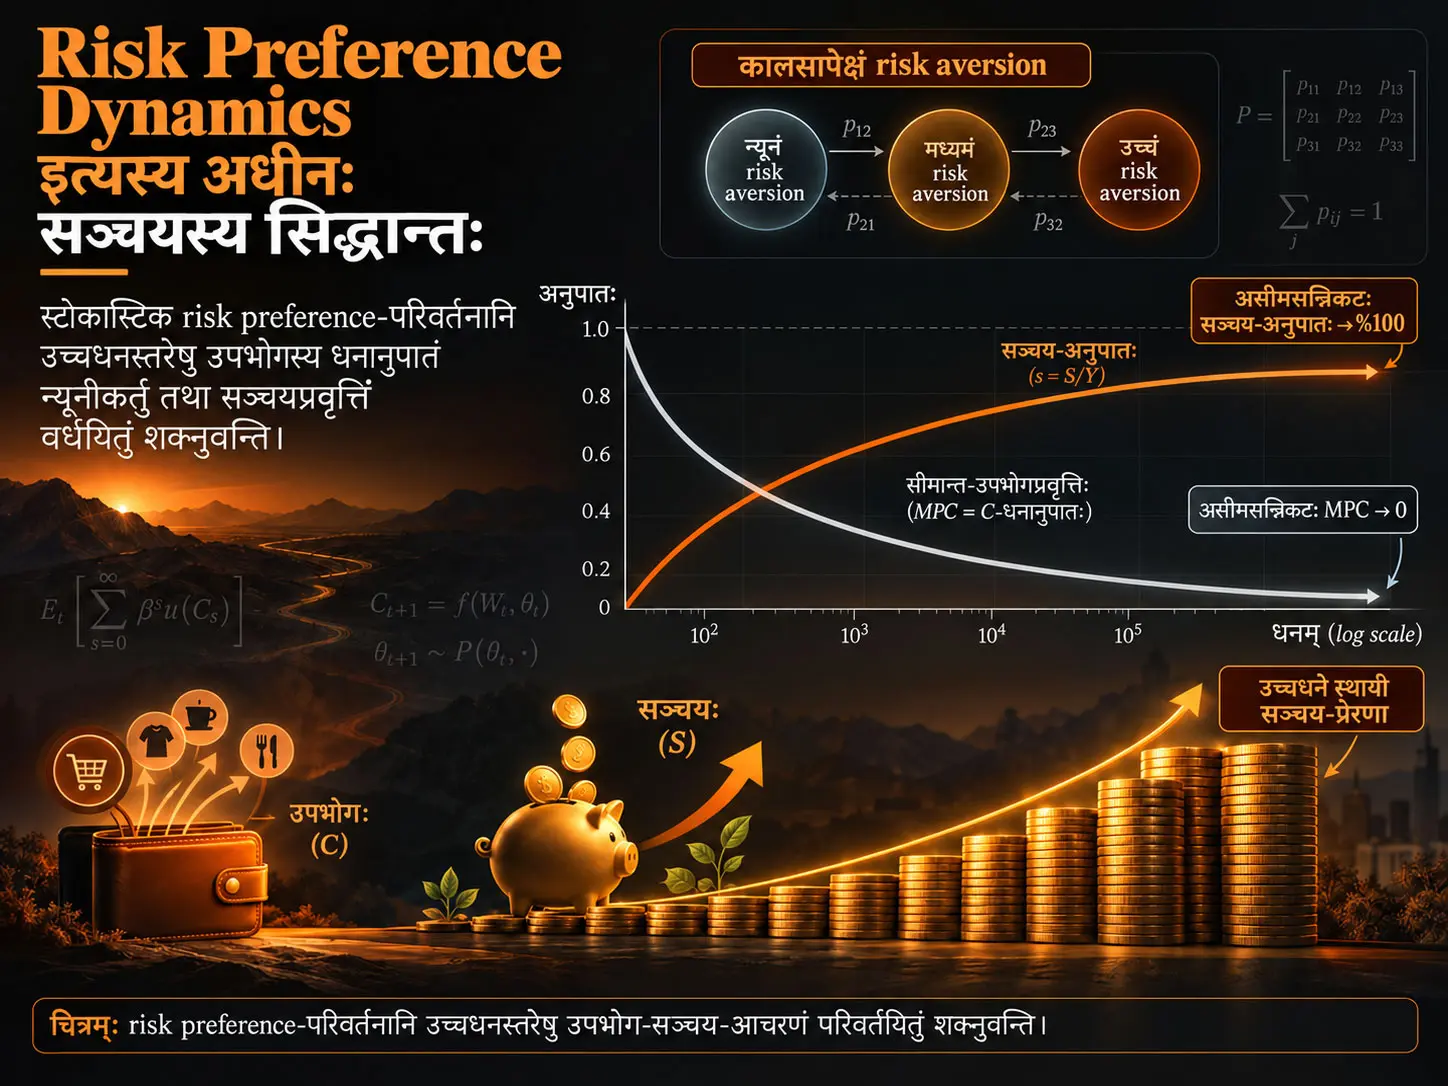
risk preference dynamics नाम प्राथमिकतासंरचना अस्ति, यत्र आर्थिकनिर्णयकर्तुः risk aversion इत्यस्य स्तरः काले स्थिरः न तिष्ठति, अपि तु विभिन्नावस्थासु परिवर्तितुं शक्नोति। Qingyin Ma, Xinxi Song, Alexis Akira Toda इत्येतैः विकसितम् अध्ययनम् एतान् परिवर्तनीयान् risk preference-भावान् dynamic optimal saving model इत्यस्मिन् निवेश्य विशेषतः उच्चसम्पत्तिस्तरेषु उपभोगस्य सञ्चयस्य च व्यवहारं परीक्षते। मुख्यं परिणामम् इदम् अस्ति: यदि कस्यचित् व्यक्तेः आगामीकाले अद्यतनावस्थातः न्यूनतर-risk aversion अवस्थां प्रति गमनस्य सम्भावना धनात्मिका अस्ति, तर्हि सम्पत्तेः किञ्चित् अंशं भविष्यत्कालं प्रति वहनस्य मूल्यं उच्चसम्पत्तिस्तरेष्वपि न नश्येत्। model द्वारा निर्दिष्टेषु शर्तेषु एषः mechanism सम्पत्तिः अनन्तं प्रति गच्छति सति asymptotic MPC इत्येतत् शून्यं प्रति नयति, तथा च सम्पत्तेः return धनात्मकः सति asymptotic saving rate इत्येतत् %100 प्रति नयति।
अस्य अध्ययनस्य नूतनता एषा यत् उच्चसञ्चयं केवलं आयस्य अनिश्चितता, investment return risk अथवा discount factor इत्यादिभिः पारम्परिकैः resource-risk कारणैः न व्याख्याय, risk preference स्वयं काले परिवर्तते इत्येतं स्वतन्त्रं dynamic mechanism इव गृह्णाति। पारम्परिके precautionary saving तर्के सम्पत्तेः वृद्ध्या भविष्यति संसाधनाभावात् संरक्षणस्य आवश्यकता दुर्बला भवितुम् अर्हति। अत्र तु भविष्यति न्यूनतर-risk aversion युक्तः “भावी आत्मा” विद्यमानां सम्पत्तिं उपभोगे परिवर्तयितुं अधिकम् इच्छुकः भवेत्; अतः अद्यतनसम्पत्तेः भविष्यत्कालं प्रति वहनं निरन्तरं मूल्यं धारयितुं शक्नोति।
तथापि अध्ययनस्य परिणामः एवं न पठनीयः यत् प्रत्यक्षतः दृश्यन्ते सर्वे धनिकगृहसमूहाः स्वस्य आयस्य %100 सञ्चयं करिष्यन्ति। परिणामः सम्पत्तेः \(w\to\infty\) सीमायां सैद्धान्तिकं व्यवहारं वर्णयति। अध्ययनस्य quantitative विभागः calculation-उदाहरणैः state-dependent impulse-response functions इत्येतैश्च mechanism दर्शयति; सः गृहस्तरस्य प्रत्यक्षं structural estimation अथवा causal field experiment न करोति।
अध्ययनसमस्या: उच्चसम्पत्तौ सञ्चयः किमर्थं न न्यूनो भवति?
अध्ययनस्य प्रारम्भबिन्दुः एषः यत् धनिकगृहसमूहाः स्वस्य आयस्य अधिकम् अंशं सञ्चयितुं तथा न्यूनतरं MPC दर्शयितुं प्रवृत्ताः भवन्ति। standard incomplete-market models इत्येषु risk aversion coefficient, discount factor, सम्पत्तेः return च स्थिराणि क्रियन्ते चेत्, अत्युच्चसम्पत्तिस्तरे precautionary saving-प्रेरणा दुर्बला भवितुम् अर्हति। तदा उपभोगः आयात् शीघ्रतरं वर्धेत् तथा asymptotic saving rate ऋणात्मकः भवेत्। लेखकाः यत् सैद्धान्तिकं प्रश्नं समाधातुम् इच्छन्ति सः एषः—दृश्यते यः स्थायी उच्चसञ्चयव्यवहारः, सः सामान्यतरेषु न्यूनबन्धनयुक्तेषु शर्तेषु कथं व्याख्येयः?
पूर्वतन-models capital return risk अथवा stochastic discount factor प्रणालीमध्ये निवेश्य एतत् अन्तरं न्यूनं कर्तुं प्रयतितवन्तः। किन्तु शून्यं प्रति गच्छन्तं asymptotic MPC प्राप्तुं return, discount, preferences इत्येषु संयुक्तरूपेण कतिपयाः विशिष्टाः शर्ताः आवश्यकाः भवितुम् अर्हन्ति। एतत् अध्ययनम् अन्यं प्रश्नं पृच्छति: यदि risk aversion coefficient स्वयं काले परिवर्तते तर्हि किं भवति?
risk preference dynamics धनिकगृहसमूहानां उच्चसञ्चयं कथं व्याख्यातुं शक्नोति?
model मध्ये आगामीकाले न्यूनतर-risk aversion अवस्थां प्रति गमनस्य सम्भावना धनात्मिका अस्ति चेत्, भावी निर्णयकर्ता विद्यमानां सम्पत्तिं उपभोगे परिवर्तयितुं वर्तमाननिर्णयकर्तुः अपेक्षया अधिकम् इच्छुकः भवेत्; अतः वर्तमाननिर्णयकर्ता उच्चसम्पत्तिस्तरेष्वपि सम्पत्तिं भविष्यत्कालं प्रति वहति, तथा कतिपयेषु शर्तेषु उपभोगस्य सम्पत्तेः प्रति अनुपातः asymptotic रूपेण शून्यं प्रति गच्छति।
पारम्परिकात् precautionary saving इत्यस्मात् भेदः
पारम्परिकः precautionary saving mechanism प्रायः भविष्यति आयस्य न्यूनता, प्रतिकूलः investment return, अथवा अन्यः resource shock भविष्यति इति सम्भावनायाम् आधृतः अस्ति। एतेषां risk-कारणानां कारणात् वर्तमानोपभोगः न्यूनः क्रियते तथा सम्पत्तिः buffer इव धार्यते। किन्तु सम्पत्तिः अतिवृद्धा भवति चेत् संसाधनाभावस्य भयस्य सापेक्षं महत्त्वं न्यूनं भवितुम् अर्हति।
risk preference dynamics तु भिन्नम् अस्ति। अत्र निर्णायकं केवलं भविष्यति कियत् संसाधनं भविष्यति इति न, अपि तु तदेव संसाधनं भविष्यति कियत् मूल्यवान् इति मन्यते इति। भविष्यति न्यूनतर-risk aversion अवस्थां प्रति गमनं शक्यम् अस्ति चेत्, सम्पत्तिः तस्यां भाव्यावस्थायां अधिकम् उपभोगमूल्यं धारयितुं शक्नोति। अतः अद्यतनसम्पत्तेः भविष्यत्कालं प्रति वहनं केवलं “दुष्कालाय धनं स्थापयितुम्” इति व्यवहारः न; एषः विभिन्न-risk preference अवस्थासु कालान्तरं उपभोगस्य पुनर्वितरणसमस्या अस्ति।
asymptotic MPC शून्यं प्रति गच्छति इत्यस्य अर्थः कः?
अस्मिन् अध्ययने शून्य-asymptotic MPC इत्यस्य अर्थः—सम्पत्तिः \(w\) अतीव वर्धते सति optimal consumption function इत्यस्य सम्पत्तेः प्रति अनुपातः \(c^*(w,z)/w\to0\) भवति; अतः एषः परिणामः दृश्यः एककालिकः MPC-estimate न, अपि तु optimal policy इत्यस्य infinite-wealth limit मध्ये गणितीयः व्यवहारः अस्ति।
optimal saving समस्यायाः मूलरचना
निर्णयकर्ता उपभोगस्य सम्पत्तेश्च मार्गं तथा चिनोति यथा अपेक्षितं lifetime utility अधिकतमं भवेत्। स्रोतसि मूलसमस्या एवं दत्ता:
\[ \max_{\{c_t,w_t\}_{t\geq0}} E_0\left[ \sum_{t=0}^{\infty} \left(\prod_{i=0}^{t}\beta_i\right) u(c_t,Z_t) \right] \]
तथा budget constraint:
\[ w_{t+1}=R_{t+1}(w_t-c_t)+Y_{t+1}, \qquad 0\leq c_t\leq w_t. \]
अत्र \(w_t\) सम्पत्तिं, \(c_t\) उपभोगं, \(R_t\) सम्पत्तेः gross return, \(Y_t\) nonfinancial income, \(\beta_t\) discount factor, तथा \(Z_t\) आर्थिक-प्राथमिकतास्थितीन् वहन्तं Markov state variable दर्शयति।
model discount factor, return, nonfinancial income च समान-state transitions तथा innovations इत्येषां अधीनानि भवितुं अनुमन्यते:
\[ \beta_t=\beta(Z_{t-1},Z_t,\varepsilon_t),\qquad R_t=R(Z_{t-1},Z_t,\varepsilon_t),\qquad Y_t=Y(Z_{t-1},Z_t,\varepsilon_t). \]
एषा रचना महत्त्वपूर्णा; यतः अध्ययनं केवलं risk preference परिवर्तते इति अतीव संकीर्णं model न निर्माति। return, income, discount, preference-states च एकस्य सामान्यस्य stochastic environment इत्यस्य अङ्गानि भवितुम् अर्हन्ति।
utility function विषये शर्ताः
प्रत्येकस्य \(z\) अवस्थायाः कृते utility function उपभोगस्य विषये द्विवारं differentiable, increasing, concave च इति स्वीक्रियते:
\[ u'(c,z)>0,\qquad u''(c,z)<0,\qquad u'(c,z)\rightarrow\infty \quad \text{iken}\quad c\rightarrow0. \]
अन्तिमः गुणः Inada-type boundary behavior अस्ति, यः उपभोगे शून्यं प्रति गच्छति सति marginal utility अत्यधिकं करोति। अध्ययनं lifetime utility प्रत्येकावस्थायां साधारण-real number इव अनिवार्यतया सुस्पष्टं भवेत् इति न अपेक्षते; अतः Brock इत्यस्य overtaking criterion प्रयुज्यते।
प्रथम-क्रम optimality तथा time iteration
optimal consumption policy \(c(w,z)\) वर्तमानोपभोगस्य marginal utility इत्येतत् भविष्यत्कालं प्रति वहितस्य एकस्य सम्पत्तिएककस्य अपेक्षितेन discounted marginal value इत्यनेन सह तुलयति। borrowing constraint अपि गृहीत्वा प्रथम-क्रमशर्तः स्रोतसि एवं लिखितः:
\[ u'(c(w,z),z)= \max\left\{ E_z\!\left[ \hat{\beta}\hat{R}\, u'(c(\hat{w},\hat{Z}),\hat{Z}) \right], u'(w,z) \right\}, \]
\[ \hat{w}=\hat{R}\,[w-c(w,z)]+\hat{Y}. \]
लेखकाः एतं शर्तं time-iteration operator \(T\) द्वारा विश्लेष्य optimal consumption function इत्येतत् तस्य operator इत्यस्य स्थिरबिन्दुरूपेण वर्णयन्ति।
spectral condition तथा optimal policy इत्यस्य अस्तित्वम्
अवस्थयोः मध्ये एककालिक-गमनसम्भावना \(P(z,\hat z)\) इति कृत्वा अध्ययनं निम्नं matrix निर्दिशति:
\[ K_{z\hat z}(\theta)= P(z,\hat z) \int \beta(z,\hat z,\hat\varepsilon) R(z,\hat z,\hat\varepsilon)^{\theta} \,\pi(d\hat\varepsilon). \]
\(r(A)\) matrix इत्यस्य spectral radius, अर्थात् तस्य eigenvalues इत्येषां absolute values मध्ये महत्तमं मूल्यं दर्शयति। मुख्येषु assumptions मध्ये एकम्:
\[ r(K(1))<1. \]
लेखकानां व्याख्यानुसारं \(\ln r(K(1))\) discounted average gross asset return इत्यस्य asymptotic growth rate इत्यनेन सम्बद्धम् अस्ति। \(r(K(1))<1\) शर्तः model मध्ये सम्पत्तेः अनियन्त्रितवृद्धिं निरोद्धुं प्रयुज्यते तथा पारम्परिकात् स्थिर-parameter \(\beta R<1\) शर्तात् सामान्यतरः अस्ति।
Theorem 2.1 अन्तर्गतं time-iteration operator \(T\) उचित-policy-space मध्ये एकमेव स्थिरबिन्दुं \(c^*\) धारयति, तथा कस्यापि उचितस्य initial policy इत्यस्मात् iterations तं बिन्दुं प्रति अभिसरन्ति। एवं पश्चात्तन-asymptotic परिणामानां आधारः optimal consumption function लभ्यते।
उपभोगः, सञ्चयः, सम्पत्तेः threshold
अध्ययनं दर्शयति यत् optimal consumption तथा investment/saving मात्रा \(i^*(w,z)=w-c^*(w,z)\) सम्पत्त्या सह वर्धेते। nonfinancial income process वर्धते सति optimal consumption अपि pointwise वर्धते।
अतिरिक्ततः प्रत्येकावस्थायाः कृते सम्पत्तेः एकः threshold अस्ति। सम्पत्तिः तस्मात् threshold अतः अधः अथवा तस्मै समा अस्ति चेत् borrowing constraint binding भवति तथा निर्णयकर्ता सर्वां विद्यमानां सम्पत्तिं उपभुङ्क्ते। threshold अतः उपरि धनात्मकः सञ्चयः भवति। एषः परिणामः उच्चसम्पत्तिव्यवहारस्य परीक्षायां saving regime प्रति कदा प्रवेशः भवति इति गणिततः विभजति।
द्विकालिकं सहज-उदाहरणम्
मुख्यः mechanism प्रथमं द्वयोः risk aversion अवस्थयोः सरल-model द्वारा दर्श्यते। प्रारम्भावस्था उच्च-risk aversion \(\gamma_H\), आगामीकालस्य अवस्था न्यूनतर-risk aversion \(\gamma_L\) अस्तु, तथा \(\gamma_L<\gamma_H\) अस्तु। प्रथमकालस्य first-order condition:
\[ c^{-\gamma_H} = \beta R^{1-\gamma_L} (w-c)^{-\gamma_L}. \]
अतः प्रथमकालस्य optimal consumption कृते:
\[ 0\leq \frac{c^*(w,\gamma_H)}{w} \leq \left(\beta R^{1-\gamma_L}\right)^{-1/\gamma_H} w^{\gamma_L/\gamma_H-1} \]
सीमा लभ्यते। \(\gamma_L/\gamma_H-1<0\) इति कारणात्:
\[ \lim_{w\rightarrow\infty} \frac{c^*(w,\gamma_H)}{w}=0. \]
एतत् लघूदाहरणं सम्पूर्णलेखस्य मुख्यं बोधं दर्शयति: आगामीकाले न्यूनतर-risk aversion अवस्थां प्रति गमनं सम्पत्तेः वृद्ध्या अपि न नश्यन्तं भावी-उपभोगमूल्यं जनयितुं शक्नोति।
अवस्थाधीनं CRRA preference
सामान्य-model मध्ये relative risk aversion coefficient स्थिरः न क्रियते। utility:
\[ u(c,z)= \begin{cases} \dfrac{c^{1-\gamma(z)}}{1-\gamma(z)}, & \gamma(z)>0,\ \gamma(z)\neq1,\\[6pt] \log c, & \gamma(z)=1. \end{cases} \]
एवं भवति। अतः \(\gamma(z)\) वर्तमानावस्थानुसारं परिवर्तमानः relative risk aversion coefficient अस्ति।
state process \(Z_t=(\bar Z_t,\tilde Z_t)\) इति विभज्यते। \(\bar Z_t\) risk aversion state वहति, \(\tilde Z_t\) अन्यान् state variables वहति। risk aversion levels:
\[ 0<\gamma_1<\gamma_2<\cdots<\gamma_N \]
इति क्रमबद्धाः भवन्ति। अतः न्यूनतरः index न्यूनतर-risk aversion दर्शयति।
risk preference transitions किमर्थं निर्णायकाः?
वर्तमान-risk aversion अवस्था \(\gamma_i\) अस्ति सति न्यूनतरां \(\gamma_\ell\) अवस्थां प्रति गमनस्य सम्भावना धनात्मिका भवति चेत्, optimal saving policy मध्ये महत्त्वपूर्णा सीमा निर्मीयते। Theorem 3.1 इत्यस्य मूलावस्थायां, एतादृशः downward risk-aversion transition शक्यः भवति तथा भविष्यत्कालस्य discounted return अशून्यं मूल्यं धारयितुं शक्नोति चेत्:
\[ \lim_{w\rightarrow\infty} \frac{c^*(w,z_{ij})}{w}=0 \]
इति परिणामः लभ्यते।
अत्र “downward” इत्यस्य अर्थः आर्थिकस्थितेः अवनतिः न, किन्तु \(\gamma\) इत्यस्य न्यूनता, अर्थात् व्यक्तिः भविष्यति न्यूनतर-risk aversion अवस्थां प्रति गच्छति।
एषः mechanism पारम्परिकात् precautionary saving इत्यस्मात् किमर्थं भिन्नः?
पारम्परिकः precautionary saving भविष्यति संसाधनक्षय-risk विरुद्धं सम्पत्तिं धारयति; अस्मिन् अध्ययने तु नूतनः mechanism भावी-preference-state परिवर्तनात् तदेव सम्पत्तिधनं भविष्यति भिन्नम् उपभोगमूल्यं धारयितुं शक्नोति इति आधारे स्थितः। अतः सम्पत्तिः अतीव उच्चा भवति चेदपि mechanism अनिवार्यतया न नश्यति।
यदि downward transition नास्ति तर्हि किं भवति?
अध्ययनस्य महत्त्वपूर्णेषु अङ्गेषु एकम् एतत् यत् केवलं zero-MPC परिणामं न दर्शयति, अपि तु downward risk-aversion transition अभावे विभिन्नान् asymptotic regimes अपि वर्णयति।
यदि भविष्यति risk aversion निश्चितरूपेण वर्धते तर्हि model किं पूर्वानुमानं करोति?
यदि कस्याश्चित् अवस्थायाः आगामीकाले केवलं उच्चतर-risk aversion अवस्थाः प्रति गमनं शक्यम् अस्ति तथा return इत्यस्य धनात्मकः lower bound अस्ति, तर्हि model दर्शयति यत् asymptotic MPC एकं प्रति गन्तुं शक्नोति तथा optimal consumption function सम्पत्तेः विषये concavity-गुणं त्यक्तुं शक्नोति।
Theorem 3.3 मध्ये वर्तमानावस्थातः समानं वा न्यूनतरं risk aversion state प्रति गमनम् अभावि कठोर-upward-transition regime मध्ये:
\[ \lim_{w\rightarrow\infty} \frac{c^*(w,z_{ij})}{w}=1. \]
अत्र भावी आत्मा अधिक-risk-averse भविष्यति इति अपेक्षया वर्तमाननिर्णयकर्तुः अतिरिक्तसम्पत्तेः भविष्यत्कालं प्रति वहनस्य marginal value उच्चसम्पत्तौ न्यूनं भवति। परिणामः zero-MPC regime इत्यस्य पूर्णविपरीतः अस्ति।
अध्ययनं पुनः दर्शयति यत् एतेषु शर्तेषु optimal consumption function सम्पत्तेः विषये concave भवितुं न शक्नोति। एतत् सूचयति यत् पारम्परिके HARA/CRRA saving literature मध्ये प्रचलिता consumption-function concavity इत्यस्य धारणा परिवर्तनीय-risk preferences अन्तर्गतं भङ्गं प्राप्नुयात्।
यदि risk aversion पूर्णतः स्थिरम् अस्ति
वर्तमान-risk aversion state absorbing अस्ति, अर्थात् \(\bar p_{ii}=1\), तर्हि risk preference dynamics इत्यस्य नूतनः mechanism निष्क्रियः भवति। Theorem 3.4 अन्तर्गतं सम्बन्धितः spectral radius condition \(r(G_i)<1\) अस्ति चेत् asymptotic MPC शून्यात् अधिकं मूल्यं प्रति अभिसरति:
\[ \lim_{w\rightarrow\infty} \frac{c^*(w,z_{ij})}{w} = x_i^*(\tilde z_j)^{-1/\gamma_i} >0. \]
अस्मिन् regime मध्ये दीर्घकालिकोपभोगव्यवहारः पुनः discount, return, वर्तमान-risk aversion level इत्येषां परस्परसम्बन्धे निर्भरः भवति।
अपूर्णा किन्तु upward persistence
यत्र \(0<\bar p_{ii}<1\), downward risk-aversion transitions न सन्ति, तथा return च income च धनात्मकौ lower bounds धारयतः, तस्मिन् मध्य-regime मध्ये अपि अध्ययनं धनात्मकम् asymptotic MPC प्राप्नोति। Theorem 3.5 एतत् परिणामं सिद्धयितुं risk attitudes अनुसारं optimal consumption इत्यस्य parametric monotonicity उपयुज्य अधिकं जटिलं proof निर्माति।
asymptotic saving rate
अध्ययनं saving rate इत्येतत् net worth परिवर्तनस्य total income प्रति अनुपातः इति निर्दिशति, capital losses विना। Equation (17) प्रति गच्छन्ती अभिव्यक्तिः:
\[ s_{t+1} = 1- \frac{ (R_{t+1}-1)^-(1-c_t/w_t)+c_t/w_t }{ (R_{t+1}-1)^+(1-c_t/w_t)+Y_{t+1}/w_t }, \]
अत्र:
\[ x^+=\max\{x,0\}, \qquad x^-=-\min\{x,0\}. \]
सम्पत्तौ अनन्तं प्रति गच्छति सति asymptotic MPC \(\bar c\) इति मान्यताम्:
\[ \bar{s} = 1- \frac{ (\hat R-1)^-(1-\bar c)+\bar c }{ (\hat R-1)^+(1-\bar c) }. \]
एषा equation अध्ययनस्य केन्द्रसम्बन्धं प्रत्यक्षं दर्शयति। यदि gross return \(R>1\) तथा \(\bar c=0\) अस्ति:
\[ \bar s=1. \]
अर्थात् model इत्यस्य asymptotic saving rate %100 अस्ति। एतत् वास्तविकस्य गृहसमूहस्य अल्पकालिकं वा मध्यमकालिकं observed saving rate नास्ति इति विशेषतः वक्तव्यम्; एषः सम्पत्तौ अनन्तं प्रति गच्छति सति model-limit अस्ति।
अध्ययनस्य विधिः परिणामाश्च
सैद्धान्तिक-समाधानरणनीतिः
अध्ययनं प्रथमं सामान्यायां dynamic saving समस्यायां optimal policy इत्यस्य अस्तित्वं, एकत्वं, गणनीयतां च स्थापयति। तदर्थम् उचित-consumption policies युक्तं function space निर्दिश्यते, marginal utility difference आधारितं metric प्रयुज्यते, तथा time-iteration operator एकमेव स्थिरबिन्दुं प्रति अभिसरति इति दर्श्यते। ततः state-dependent CRRA preference उपयुज्य उच्चसम्पत्तौ consumption ratio प्रति risk-aversion transitions इत्येषां प्रभावः विश्लेषणात्मकतया परीक्ष्यते।
| risk preference regime | मुख्यशर्तः | asymptotic MPC | वैज्ञानिकव्याख्या |
|---|---|---|---|
| न्यूनतर-risk aversion अवस्थां प्रति गमनं शक्यम् | downward transition सम्भावना धनात्मिका, तथा भावी discounted return धनात्मकः भवितुं शक्नोति | \(0\) | सम्पत्तेः भविष्यत्कालं प्रति वहनप्रेरणा उच्चसम्पत्तावपि तिष्ठति। |
| generalized spectral boundary regime | \(G_i\) irreducible अस्ति तथा \(r(G_i)\geq1\) | \(0\) | downward transition विना अपि विशेषे spectral regime मध्ये zero MPC उत्पद्यते। |
| आगामीकाले निश्चितरूपेण उच्चतर-risk aversion | समानं वा न्यूनतरं risk aversion state प्रति transition नास्ति; \(R\) धनात्मकं lower bound धारयति | \(1\) | उच्चसम्पत्तौ अतिरिक्तसम्पत्तेः भविष्यत्कालं प्रति वहनस्य marginal value नश्यति। |
| risk aversion state पूर्णतः स्थिरम् | \(\bar p_{ii}=1\), \(r(G_i)<1\) | \((0,1]\) | risk preference परिवर्तन-mechanism निष्क्रियः; return, discount, वर्तमान-preference निर्णायकानि भवन्ति। |
| downward transition विना अपूर्णा persistence | \(0<\bar p_{ii}<1\), \(r(G_i)<1\), \(R\) तथा \(Y\) धनात्मकौ lower bounds धारयतः | \((0,1]\) | धनात्मकः आन्तरिकः asymptotic MPC regime उत्पद्यते। |
quantitative model कथं निर्मीयते?
सैद्धान्तिकपरिणामानां आर्थिकबोधं दर्शयितुं अध्ययनं वार्षिक-frequency मध्ये quantitative model निर्माति। एतेषु प्रयोगेषु discount factor तथा gross asset return स्थिरौ क्रियेते, risk aversion coefficient तु discretized AR(1) process अनुसरति:
\[ \gamma_{t+1} = \mu_\gamma(1-\rho_\gamma) + \rho_\gamma\gamma_t + \sigma_\gamma \sqrt{1-\rho_\gamma^2}\, \varepsilon^\gamma_{t+1}, \qquad \varepsilon^\gamma_t\overset{iid}{\sim}N(0,1). \]
model Carroll इत्यस्य endogenous grid method द्वारा समाधीयते। मुख्य quantitative parameters एते:
| Parameter | मूल्यम् | भूमिका |
|---|---|---|
| \(\beta\) | 0,95 | वार्षिक discount factor |
| \(R\) | 1,02 | gross wealth return |
| \(\rho_\gamma\) | 0,6 | मूल-risk aversion process इत्यस्य persistence |
| \(\mu_\gamma\) | 4 | risk aversion process इत्यस्य मध्यमस्तरः |
| \(\sigma_\gamma\) | 1 | risk aversion shock इत्यस्य परिमाणम् |
| \(\gamma_{\min},\gamma_{\mathrm{med}},\gamma_{\max}\) | 1, 4, 7 | उपयुक्ता risk aversion range |
त्र्यवस्थीयः risk aversion process
asymptotic saving तुलनायां \(\gamma_t\in\{1,4,7\}\) इति त्र्यवस्थीयः Markov chain प्रयुज्यते:
\[ \bar P= \begin{bmatrix} 0.6416 & 0.3538 & 0.0001\\ 0.0303 & 0.9392 & 0.0305\\ 0.0001 & 0.3538 & 0.6461 \end{bmatrix}. \]
मध्यावस्थायां \(\gamma=4\) स्थितेः स्थायित्वसम्भावना %93,92 अस्ति। तथापि आगामीकाले न्यूनतर-risk aversion अवस्था \(\gamma=1\) प्रति गमनस्य केवलं %3,03 सम्भावना अपि model इत्यस्य asymptotic behavior परिवर्तयितुं पर्याप्ता अस्ति।
स्थिरस्य stochastic च risk aversion इत्योः तुलना
स्रोतस्य Figure 1 तथा Figure 2, उभयोः models मध्ये वर्तमान-risk aversion coefficient \(\gamma=4\) सति fixed-CRRA model तथा stochastic risk-aversion model इत्येतौ तुलयतः। वर्तमान-preference समानम् अस्ति, तथापि भविष्यति risk preference परिवर्तितुं शक्नोति इति कारणात् stochastic model मध्ये उपभोगः स्पष्टतया न्यूनः भवति।
| Model | asymptotic consumption/MPC behavior | asymptotic saving rate |
|---|---|---|
| Fixed CRRA, \(\gamma=4\) | \(1-(\beta R^{1-\gamma})^{1/\gamma}=0.0273\) | −%40,31 |
| Stochastic risk aversion | \(0\) | %100 |
अस्यां तुलनायां %100 मूल्यं model इत्यस्य high-wealth limit अस्ति। तथैव fixed CRRA model इत्यस्मिन् −%40,31 सर्वेषां finite-wealth गृहसमूहानां observed rate न, अपि तु सम्बन्धित-calibration इत्यस्य theoretical asymptotic result अस्ति।
impulse-response विश्लेषणम्
अध्ययनं nonlinear model dynamics परीक्षितुं Koop, Pesaran, Potter इत्येषां पद्धतिम् अनुसरन्तः state-dependent impulse-response functions प्रयुङ्क्ते। उद्देश्यं यत् risk aversion प्रति आगतः shock कालक्रमेण उपभोगे, saving rate मध्ये, consumption volatility मध्ये च कथं प्रसारं करोति इति ज्ञातुम्।
अस्मिन् विभागे श्रम-आयः:
\[ \log Y_t=\eta_t+\nu_t, \qquad \nu_t\sim N(0,\sigma_\nu^2), \]
\[ \eta_{t+1} = \rho_\eta\eta_t+\varepsilon^\eta_t, \qquad \varepsilon^\eta_t\sim N(0,\sigma_\eta^2) \]
इति model क्रियते। प्रयुक्ताः income parameters \(\rho_\eta=0.9735\), \(\sigma_\eta=0.1272\), \(\sigma_\nu=0.2102\) च; स्रोतः एतान् Lander इत्यस्य PSID 1970–2012 estimates आधृतान् इति वदति।
numerical accuracy कृते risk aversion process 121-state Markov chain मध्ये, permanent income component 5 अवस्थासु च discretize क्रियते; temporary income shock विषये expectations 7-point Gauss–Hermite quadrature द्वारा गणिताः भवन्ति।
सम्पत्तिस्तरः shock इत्यस्य प्रभावं कथं परिवर्तयति?
प्रारम्भ-risk aversion \(\gamma_{t-1}=4\) तथा shock persistence \(\rho_\gamma=0.7\) सति एकक-धनात्मक-risk-aversion shock कृते स्रोतः निम्नान् प्रथमकालिकान् responses निर्दिशति:
| प्रारम्भसम्पत्तिः \(w_{t-1}\) | उपभोग-response | saving-rate response | अनुमानितः प्रभावकालः |
|---|---|---|---|
| 5 | −%4,67 | +%5,81 | उपभोगे प्रायः 2–6 वर्षाणि; सञ्चये प्रायः 4–8 वर्षपरासस्य निम्नभागः |
| 10 | −%7,89 | +%10,15 | मध्यमपरिमाणः स्थायी च response |
| 50 | −%20,23 | +%28,05 | उपभोगे प्रायः 2–6 वर्षाणि; सञ्चये प्रायः 4–8 वर्षपरासे अधिकस्थायी response |
सम्पत्तेः वृद्ध्या consumption response तथा saving adjustment अत्यधिकं बलवत्तरौ भवतः—एषः महत्त्वपूर्णः nonlinear परिणामः। अध्ययनस्य व्याख्या एषा यत् न्यूनसम्पत्तियुक्तगृहसमूहानां सञ्चयपरिवर्तनक्षमता सीमिता, उच्चसम्पत्तियुक्तगृहसमूहाः तु intertemporal resource allocation अधिकपरिमाणेन परिवर्तयितुं शक्नुवन्ति।
प्रारम्भ-risk aversion स्तरः अपि परिणामं परिवर्तयति
प्रारम्भसम्पत्तिः \(w_{t-1}=10\) स्थिरा क्रियते चेत्, तस्यैव एकक-shock इत्यस्य प्रभावः वर्तमान-risk aversion level अनुसारं तीव्रतया भिन्नः भवति।
| प्रारम्भ \(\gamma_{t-1}\) | उपभोग-response | saving-rate response |
|---|---|---|
| 6 — उच्च-risk aversion | −%4,84 | +%5,53 |
| 1 — न्यून-risk aversion | −%19,26 | +%32,21 |
प्रारम्भ-risk aversion न्यूनम् अस्ति चेत्, समानपरिमाणः धनात्मकः shock वर्तमान-preference-state अपेक्षया बहु बृहत्तरं परिवर्तनं जनयति। अतः model उपभोगस्य अधिकतीव्रां न्यूनतां तथा सञ्चयस्य अधिकं वर्धनं जनयति।
shock persistence
\(\rho_\gamma\) वर्धते सति risk-aversion shock अधिककालं स्थास्यति इति अपेक्षा। स्रोतसि \(\rho_\gamma=0.3\), \(0.5\), \(0.7\) च तुल्यन्ते। उच्चतर-persistence उपभोगस्य न्यूनतां बलवत्तरां दीर्घतरां च करोति, सञ्चयवृद्धिं च अधिकस्थायिनीं करोति। consumption volatility इत्यस्य न्यूनता अपि अधिकस्पष्टा भवति।
अस्य आर्थिकः अर्थः यत् अस्थायिनी इव दृश्यते या risk-preference परिवर्तनम्, सा अधिकस्थायिनी भवति चेत् निर्णयकर्ता तां प्रायः स्थायिनी preference regime इव मन्यते। एवं वर्तमान consumption-saving plan अधिकबलपूर्वकं पुनः optimize क्रियते।
अध्ययने समर्थिताः असमर्थिताश्च व्याख्याः
| अध्ययनं समर्थयति | अध्ययनं प्रत्यक्षतः न समर्थयति |
|---|---|
| stochastic risk preferences optimal saving policy इत्यस्य high-wealth limit मूलतः परिवर्तयितुं शक्नुवन्ति। | सर्वे वास्तविकाः धनिकगृहसमूहाः समान-mechanism कारणात् उच्चसञ्चयं कुर्वन्ति इति निष्कर्षः। |
| न्यूनतर-risk aversion अवस्थां प्रति गमनसम्भावना कतिपयेषु सामान्यशर्तेषु zero asymptotic MPC जनयति। | प्रत्येकस्मिन् finite-wealth स्तरः MPC शून्यम् अस्ति इति। |
| धनात्मक-return सह zero asymptotic MPC model-limit मध्ये %100 saving rate इत्यनेन तुल्यः। | वास्तविकगृहसमूहाः दृश्यस्य आयस्य वास्तवतः %100 सञ्चयं कुर्वन्ति इति प्रतिपादनम्। |
| risk preference shocks quantitative model मध्ये उपभोगे सञ्चये च स्थायिनः state-dependent responses जनयितुं शक्नुवन्ति। | वास्तविकदत्तांशे risk preference shocks इत्येषां causal magnitude एतैः सङ्ख्याभिः एव समानम् इति प्रतिपादनम्। |
| mechanism सम्पत्तिवितरणं ज्ञातुं नूतनं channel ददाति। | अध्ययनं सम्पूर्णां wealth inequality अथवा general-equilibrium distribution प्रत्यक्षतः model करोति इति। |
मुख्यसीमाः
अध्ययनं गणिततः सुदृढं सैद्धान्तिकं mechanism तथा तस्य quantitative उदाहरणानि ददाति; किन्तु धनिकगृहसमूहानां risk preference transition matrix इत्येतत् प्रत्यक्षं microdata आधारेण estimate न करोति। quantitative प्रयोगेषु प्रयुक्तः risk aversion process calibrated अस्ति, तथा income process इत्यस्य कतिपयाः parameters पूर्वतन-PSID आधारित-अध्ययनात् गृह्यन्ते। अतः numerical विभागः mechanism तथा magnitude इत्यस्य प्रदर्शनम् अस्ति; स्वतन्त्रः empirical causality test न।
लेखकाः अपि स्पष्टं वदन्ति यत् wealth inequality प्रत्यक्षं model न कृतम्। परिणामाः wealth distribution कृते सम्भाव्यतया महत्त्वपूर्णं channel दर्शयन्ति, तथापि general equilibrium, intergenerational transfer, entrepreneurship, tax system, heterogeneous investment opportunities, अथवा सम्पूर्णं wealth distribution एकत्र समाधातुं inequality model—एतानि अस्य अध्ययनस्य विषयाः न सन्ति।
अध्ययनं 26 जून 2026 दिनाङ्कस्य preprint अपि अस्ति। गणितीयाः परिणामाः विस्तृतैः proofs द्वारा समर्थिताः सन्ति, तथापि स्रोतसंस्करणं peer-reviewed अन्तिमं journal article न। परिणामव्याख्यायाम् एषः status रक्षणीयः।
स्रोतः तथा विधेः टिप्पणी
मूल-अध्ययनम्: A Theory of Saving under Risk Preference Dynamics.
लेखकाः: Qingyin Ma; Xinxi Song; Alexis Akira Toda.
दिनाङ्कः: 26 जून 2026.
स्रोतप्रकारः: सैद्धान्तिकं quantitative च dynamic macroeconomics/saving अध्ययनम्; preprint research paper.
peer-review status: उपारोपिते PDF मध्ये स्पष्टतया “This preprint research paper has not been peer reviewed” इति वाक्यम् अस्ति।
Platform: SSRN.
SSRN record number: 7001311.
DOI: 10.2139/ssrn.7001311. DOI-विवरणं वर्तमान-SSRN bibliographic record इत्यस्मात् सत्यापितम्; उपारोपितस्य PDF इत्यस्य मुख्यपृष्ठे DOI न लिखितम्।
PDF मध्ये संस्थाः: Qingyin Ma तथा Xinxi Song — ISEM, Capital University of Economics and Business; Alexis Akira Toda — Department of Economics, Emory University.
bibliographic record भेदः: वर्तमान-SSRN record Alexis Akira Toda इत्येनं University of California, San Diego, Department of Economics इत्यनेन सह दर्शयति। अतः Verianla-पाठे स्रोत-PDF इत्यस्य affiliation तथा वर्तमान-platform record परस्परं न मिश्रितौ।
सम्पर्कलेखकः: वर्तमान-SSRN record मध्ये Qingyin Ma “Contact Author” इति दर्श्यते।
वित्तपोषणम्: Qingyin Ma acknowledgements विभागे National Natural Science Foundation of China — NSFC No. 72573111 इत्यस्य समर्थनं निर्दिशति।
data availability: PDF मध्ये पृथक् “Data Availability” statement नास्ति। अध्ययनस्य मुख्ययोगदानं सैद्धान्तिकम्। quantitative विभागः model calibration तथा simulations इत्येषु आधृतः; income process parameters इत्येषां कश्चित् भागः Lander (2024) इत्यस्य PSID 1970–2012 estimates इत्यस्मात् गृहीतः।
conflict of interest: उपारोपिते PDF मध्ये पृथक् conflict-of-interest statement न दृष्टम्; अतः “conflict of interest नास्ति” इति निष्कर्षः न निर्मितः।
License: उपारोपिते PDF मध्ये Creative Commons अथवा तुल्यं open-reuse license न निर्दिष्टम्। अतः Verianla-प्रस्तुतौ स्रोत-figures अक्षरशः प्रतिलिप्य न, अपि तु वैज्ञानिकसम्बन्धाः पाठेन मौलिक-सारणीभिश्च पुनः व्यक्ताः।
मुख्यविधिः: state-dependent preference shocks युक्ता infinite-horizon optimal saving problem; Markov state processes; time-iteration operator; fixed-point तथा spectral-radius analysis; state-dependent CRRA preferences; asymptotic MPC analysis; endogenous grid method; Tauchen discretization; state-dependent generalized impulse-response functions.
वैज्ञानिकव्याख्यायाः सीमा: अध्ययनस्य zero MPC तथा %100 saving परिणामाः \(w\rightarrow\infty\) asymptotic limits सन्ति। एते finite wealth युक्तानां वास्तविकगृहसमूहानां observed behavior इव प्रत्यक्षं न व्याख्येयाः। quantitative analysis mechanism दर्शयति, किन्तु वास्तविकजगति risk preference shocks इत्येषां causal effect प्रत्यक्षं estimate कुर्वत् microeconometric study न।
दृश्य-पुनर्निर्माणम्: स्रोतस्य Table 1 इत्यस्य asymptotic-regime तर्कः तथा स्रोतसि स्पष्टतया प्रतिवेदितानि quantitative values मौलिक-Verianla सारणीषु परिवर्तयितुं शक्यन्ते। Figure 1–3 इत्येषां continuous curves इत्यस्य raw data points PDF मध्ये न दत्तानि; अतः पूर्णं numerical redrawing केवलं मूल-computation code अथवा data उपलब्धे सति source-faithful प्रकारेण कर्तुं शक्यते।
Leave a comment
Your email address will not be published. Required fields are marked *