


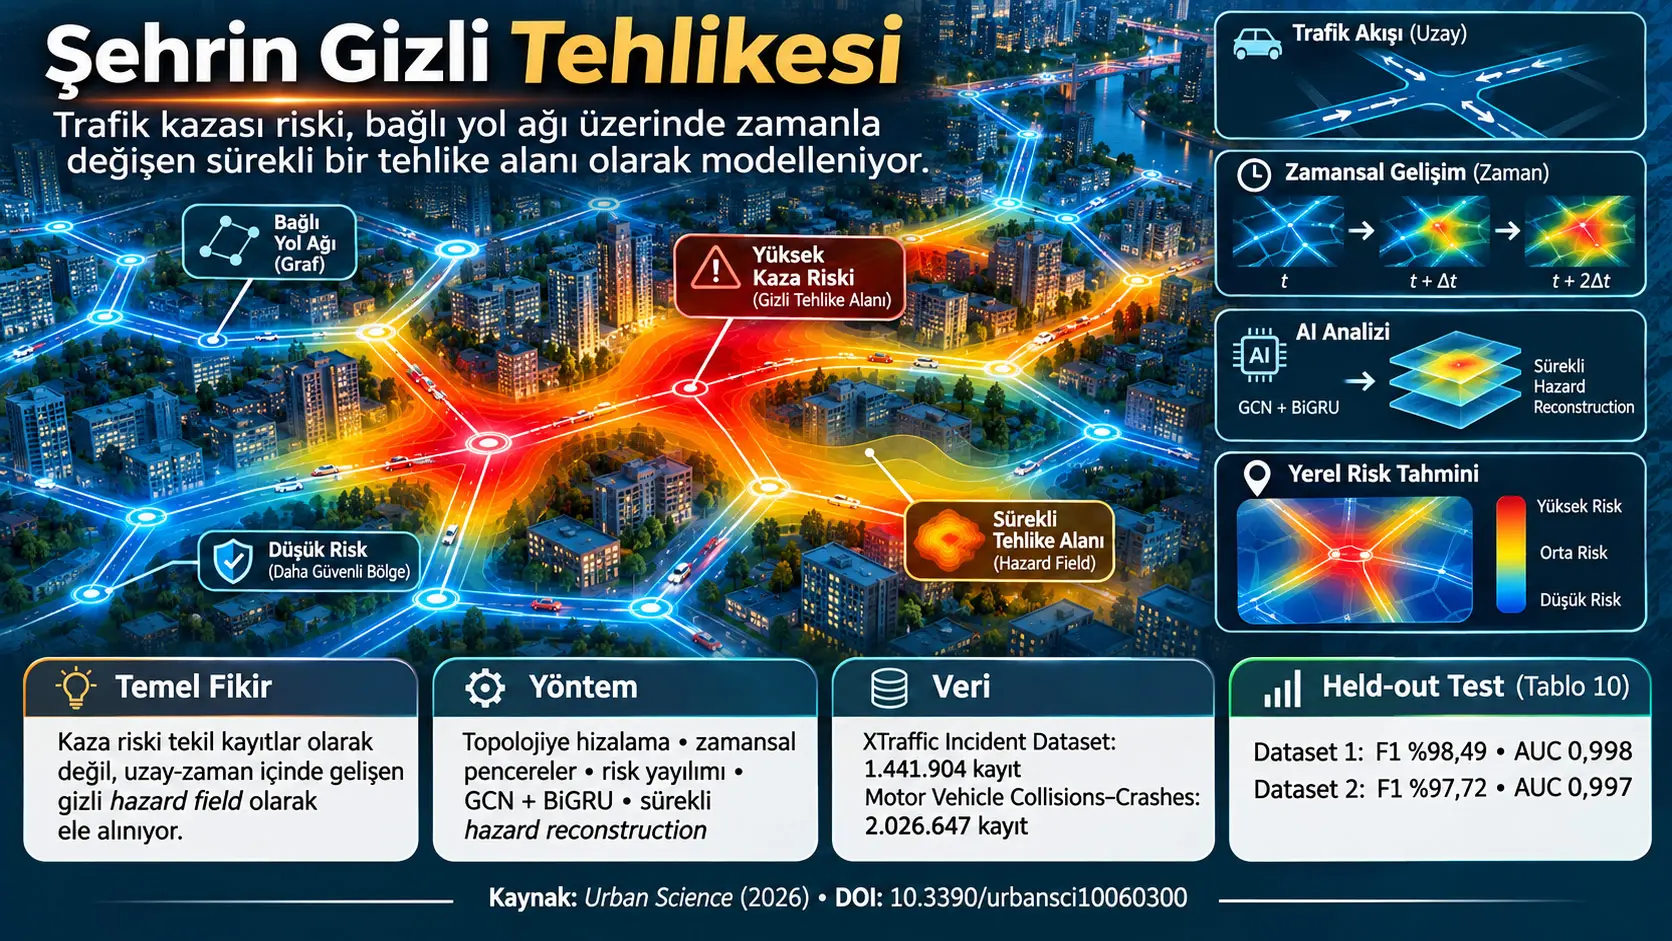
Sürekli Tehlike Alanı Zekâ Çerçevesi (Continuous Hazard Field Intelligence Framework, CHFI), trafik kazası riskini yalnız tek tek kayıtların “kaza var/yok” veya “şiddet sınıfı” şeklinde doğrudan sınıflandırılması olarak değil, bağlantılı yol altyapısı üzerinde uzay ve zaman boyunca oluşan, yayılan ve yoğunlaşan gizli bir tehlike alanı olarak öğrenmeye çalışan bir derin öğrenme çerçevesidir. Çalışma, 2022–2024 dönemine ait 1.441.904 kayıtlı XTraffic Incident Dataset ile 2.026.647 kayıtlı Motor Vehicle Collisions–Crashes Dataset üzerinde; topoloji-kısıtlı mekânsal hizalama, zamansal tehlike pencereleri, risk-yayılım özellik yükseltmesi, tehlikeye duyarlı normalizasyon, sürekli tehlike yüzeyi başlatma, graph-based spatial encoding, GRU/BiGRU tabanlı temporal modeling ve sürekli hazard reconstruction adımlarını birlikte değerlendirmektedir.
Modelin temel fikri şudur: Bir trafik kazası çoğu zaman tamamen bağımsız ve aniden oluşan tek bir nokta olayı olarak ele alınmamalıdır. Kaynağın kurduğu modelde trafik akışı kararsızlığı, hız değişkenliği, sıkışıklık, yol ağı bağlantısı, kavşak etkileri, çevresel koşullar ve yakın yol kesimlerinden gelen risk etkileri önce gizli bir tehlike alanına dönüştürülür. Model daha sonra bu alanın yalnız mevcut büyüklüğünü değil, önceki zamana göre artıp artmadığını ve komşu yol parçalarındaki tehlikenin yerel noktayı güçlendirip güçlendirmediğini de kullanarak yerelleştirilmiş kaza ortaya çıkma olasılığı üretir.
Kaynak özetinde ve sonuç bölümünde final CHFI için Dataset 1'de %99,12 accuracy, %98,94 precision, %98,76 recall, %98,85 F1 ve 0,998 AUC; Dataset 2'de %98,63 accuracy, %98,41 precision, %98,16 recall, %98,28 F1 ve 0,997 AUC raporlanmaktadır. Ancak bu değerler kaynak Tablo 9'un “Training Stage” E10 satırıyla aynıdır. Ayrı “Test-stage” Tablo 10'da bağımsız test değerleri Dataset 1 için %98,84 accuracy, %98,62 precision, %98,37 recall, %98,49 F1 ve 0,998 AUC; Dataset 2 için %98,07 accuracy, %97,86 precision, %97,59 recall, %97,72 F1 ve 0,997 AUC olarak verilmektedir. Verianla bu kaynak-içi raporlama farkını tek bir sayı halinde birleştirmemektedir.
Daha sıkı doğrulama deneylerinde performans düşmekle birlikte yüksek kalmaktadır. Kaynak Tablo 14'e göre Dataset 1 F1 değeri stratified random split için %98,85, temporal hold-out için %97,39, geographic hold-out için %96,93 ve blocked spatio-temporal validation için %96,21'dir. Dataset 2'de aynı değerler sırasıyla %98,28, %96,82, %96,35 ve %95,60 olarak raporlanmaktadır. Bununla birlikte random-split satırlarının yine kaynakta özet/Training Stage değerleriyle aynı olması nedeniyle bu tablo da Tablo 10'daki bağımsız test sonuçlarıyla birlikte ve dikkatle okunmalıdır.
Çalışma güçlü kontrollü sonuçlar göstermektedir; fakat gerçek zamanlı trafik akışı üzerinde canlı konuşlandırma yapılmamıştır. Kaynak, gerçek zamanlı streaming, daha fazla şehir ve ulaşım ağı, daha ayrıntılı signal timing ve lane-level dynamics, multimodal hareketlilik, ayrıntılı hava koşulları, belirsizlik modelleme ve trafik kontrol sistemleriyle entegrasyonu gelecekteki araştırma alanları olarak bırakmaktadır. Bu nedenle CHFI'nin sonuçları “gerçek kentte kazaları kesin olarak önleyen hazır sistem” şeklinde yorumlanmamalıdır.
Çalışma hangi problemi çözmeye çalışıyor?
Geleneksel trafik kazası tahmin modellerinin önemli bir bölümü her trafik kaydını veya her kaza noktasını ayrı bir örnek olarak değerlendirir. Böyle bir yaklaşımda modelin görevi çoğunlukla verilen bir gözlemi belirli bir sınıfa atamaktır. Ancak gerçek yol ağında bir yol kesiminin güvenlik durumu komşu yol kesimlerinden, kavşaklardan, trafik kuyruğundan, hız kararsızlığından ve daha önceki zaman dilimlerinden etkilenebilir.
CHFI'nin temel araştırma problemi, bu bağımlılıkları doğrudan “tekil olay sınıflandırması” içinde kaybetmek yerine görünmeyen tehlikeyi bağlantılı ulaşım ağı üzerinde sürekli değişen bir alan olarak temsil etmektir.
Sürekli Tehlike Alanı Nedir?
Sürekli tehlike alanı, çalışmada bir yol kesimi veya kavşaktaki gizli trafik tehlikesini yalnız kaza noktasının varlığıyla değil, yerel trafik durumu, komşu ağ birimleri ve geçmiş zamandaki tehlike durumunun birlikte belirlediği sürekli bir latent yoğunluk olarak temsil eden matematiksel ara yapıdır; bu alan nihai kaza etiketi değildir, son tahmini üretmek için kullanılan yorumlanabilir gizli-risk temsilidir.
Bu ayrım çok önemlidir. Kaynakta \(\hat{H}(u_i,t)\) ile temsil edilen tehlike alanı doğrudan “kaza olacak” etiketi değildir. Model önce gizli tehlike yapısını yeniden kurar; ardından bu yapıdan yerelleştirilmiş kaza ortaya çıkma olasılığı elde edilir.
Model neden yol ağını bir graph olarak gösteriyor?
Ulaşım sistemi \(G=(V,E)\) biçiminde bir graph olarak tanımlanmaktadır. \(V\), yol parçaları, kavşaklar veya başka mekânsal ulaşım birimlerinden oluşan düğümleri; \(E\) ise bunların bağlantılarını temsil eder.
Bu gösterimin amacı yalnız matematiksel şıklık değildir. Bir kesimdeki sıkışıklık veya kuyruk bir sonraki kesime yayılabilir; birleşme noktası, kavşak veya komşu koridor mevcut riski artırabilir. Flat tabular veri bu fiziksel bağlantıları doğal olarak taşımazken graph yapısı komşuluk ilişkisini doğrudan modele verir.
Kullanılan iki veri seti
| Özellik | Dataset 1 | Dataset 2 |
|---|---|---|
| Ad | XTraffic Incident Dataset (2022–2024) | Motor Vehicle Collisions–Crashes Dataset |
| Kayıt sayısı | 1.441.904 | 2.026.647 |
| Ana gözlem türü | Kaza dışında hazard, disabled vehicle, roadway disruption ve benzeri operasyonel olayları da içeren incident kayıtları | Gerçekleşmiş motorlu araç çarpışmaları ve sonuçları |
| Temporal kapsam | 2022: 478.581; 2023: 476.768; 2024: 486.555 kayıt | Kaynakta tek bir üç yıllık dönem şeklinde verilmemektedir. |
| Önemli değişken örnekleri | incident_id, duration, Abs PM, Fwy, AREA, DESCRIPTION, LOCATION, dt, Latitude, Longitude, Freeway direction, Type | CRASH DATE, CRASH TIME, BOROUGH, ZIP CODE, LATITUDE, LONGITUDE, yaralanma/ölüm sayıları, contributing factor ve vehicle type alanları |
| Deneysel rol | Incident-emergence ve precursor düzeyindeki operasyonel tehlike örüntülerini incelemek | Gerçekleşmiş crash outcome ve severity yapısını incelemek |
Dataset 1 yalnız kaza kayıtlarından oluşmadığı için CHFI'nin “kaza ortaya çıkmadan önceki operasyonel bozulmayı” öğrenme amacına daha yakın precursor sinyaller içerir. Dataset 2 ise yaralanma, ölüm, yaya, bisikletli, sürücü ve araç bilgileri nedeniyle gerçekleşmiş kazanın sonucunu çok daha doğrudan temsil eder.
Dataset 2'deki dört severity sınıfı
Kaynak Dataset 2 için hedefi dört sınıfa ayırmaktadır:
- No Injury: \(I_i=0\) ve \(F_i=0\)
- Minor Injury: \(I_i=1\) ve \(F_i=0\)
- Multi-Injury: \(I_i>1\) ve \(F_i=0\)
- Fatal/Severe: \(F_i\geq1\)
Burada \(I_i\), kayıttaki toplam yaralı sayısını; \(F_i\), toplam ölüm sayısını ifade eder.
Modelde “Target Leakage” Neden Kritik Bir Sorundur?
Target leakage, tahmin edilmesi gereken sonucu doğrudan veya dolaylı biçimde zaten açıklayan değişkenlerin model girdisine verilmesiyle model performansının yapay biçimde yükselmesidir; çalışma bu riski azaltmak için label oluşturmakta kullanılan yaralanma, ölüm, olay tipi, açıklama ve post-outcome değişkenlerini tahmin girdilerinden ayırmaktadır.
Denklem (1): Nihai girdi özelliklerinin seçilmesi
\[ F_{\mathrm{input}}^{(m)} = F_{\mathrm{all}}^{(m)} \setminus \left( F_{\mathrm{target}}^{(m)} \cup F_{\mathrm{proxy}}^{(m)} \right), \qquad m\in\{1,2\} \]
Formül neyi hesaplıyor? Modelin gerçekten kullanmasına izin verilen girdi özelliklerini belirliyor.
\(F_{\mathrm{all}}\): Veri setindeki belgelenmiş bütün değişkenlerdir.
\(F_{\mathrm{target}}\): Hedef etiketi doğrudan oluşturan değişkenlerdir.
\(F_{\mathrm{proxy}}\): Hedefi doğrudan oluşturmamakla birlikte hedefi olaydan sonra neredeyse açık biçimde ele veren proxy değişkenlerdir.
\(\setminus\): Küme farkı operatörüdür. Yani bütün değişkenler arasından target ve proxy değişkenleri çıkarılır.
Denklem (2): Dataset 1 label oluşturma
\[ y_i^{(1)} = g_1(\mathrm{Type}_i,\mathrm{DESCRIPTION}_i) \]
\(g_1\), olay kategorisi ve olay açıklamasını nihai incident-risk sınıfına dönüştüren mapping function'dır. Collision-related, injury-related, unknown-injury ve hazard-related kayıtlar daha yüksek riskli sınıflara; non-accident operational kayıtlar daha düşük risk veya non-emergence sınıflarına eşlenmektedir.
Ancak Type ve DESCRIPTION hedefi doğrudan veya çok güçlü biçimde ima edebildiği için label oluşturulduktan sonra model girdisinden çıkarılır.
Denklem (3)–(4): Dataset 2 severity label
\[ y_i^{(2)}=g_2(I_i,F_i) \]
Kaynakta mapping şu parçalı yapıyla tanımlanır:
\[ y_i^{(2)}= \begin{cases} \text{No Injury}, & I_i=0,\;F_i=0\\ \text{Minor Injury}, & I_i=1,\;F_i=0\\ \text{Multi-Injury}, & I_i>1,\;F_i=0\\ \text{Fatal/Severe}, & F_i\geq1 \end{cases} \]
Label oluşturulduktan sonra injury ve fatality count alanlarının tamamı girdiden çıkarılır. Aksi durumda model “kaza şiddetini tahmin ediyor” görünürken aslında tahmin edilmesi gereken sonucu doğrudan okuyor olabilir.
Denklem (5): Ön işlem parametrelerinin yalnız eğitim verisinden öğrenilmesi
\[ \phi_{\mathrm{prep}}=\operatorname{Fit}(D_{\mathrm{train}}), \qquad \widetilde{D}_{\mathrm{test}} = \operatorname{Transform} \left(D_{\mathrm{test}};\phi_{\mathrm{prep}}\right) \]
Bu denklem leakage prevention'ın ikinci önemli katmanıdır. Normalizasyon, encoding, hazard-field initialization ve diğer preprocessing parametreleri önce yalnız eğitim bölümünden öğrenilir. Test verisi bu parametrelerin belirlenmesine katılmaz; yalnız önceden öğrenilmiş dönüşüm test verisine uygulanır.
Temporal Hazard Window Embedding ne yapıyor?
Model her zaman damgasını ayrı bir örnek gibi kullanmak yerine ardışık trafik gözlemlerini kısmen örtüşen temporal pencerelere böler. Pencere uzunluğu \(W\), stride ise \(\Delta\) ile temsil edilir.
Örneğin kaynak deneylerinin ilerleyen konfigürasyonlarında \(W=6,8,10\) ve \(\Delta=2,3\) gibi ayarlar denenmiştir. \(W\) büyüdüğünde model daha uzun yakın geçmişi görebilir; \(\Delta\) pencerenin zaman dizisi üzerinde ne kadar ilerlediğini belirler. Bu matematiksel yorum, kaynak deneyi dışında yeni bir başarı iddiası değildir.
Denklem (6)–(10): Risk-diffusion feature lifting
Yol ağı:
\[ G=(V,E) \]
Her düğümün \(t\) zamanındaki yerel özellik vektörü:
\[ x_i^{(t)}\in\mathbb{R}^{d} \]
Komşu etkisiyle zenginleştirilmiş özellik:
\[ \widetilde{x}_i^{(t)} = \alpha x_i^{(t)} + (1-\alpha) \sum_{j\in N(i)} \omega_{ij}x_j^{(t)} \]
Komşu ağırlıkları:
\[ \sum_{j\in N(i)}\omega_{ij}=1 \]
Matris biçimi:
\[ \widetilde{X}^{(t)} = \alpha X^{(t)} + (1-\alpha)WX^{(t)} \]
Ne anlama geliyor? Bir yol kesiminin model girdisi yalnız kendi trafik durumundan oluşmaz. \(\alpha\) kadar yerel bilgi, \(1-\alpha\) kadar komşu yol birimlerinden gelen ağırlıklı bilgi kullanılır.
\(\alpha=1\) olursa denklem yalnız yerel gözleme düşer; \(\alpha=0\) olursa yerel bileşen kaybolur ve yalnız komşu ağırlıklı durum kalır. Bunlar denklemin matematiksel sınır durumlarıdır; çalışmanın deneysel sonucu değildir.
Denklem (11): Benzer kararsızlık gösteren komşuların ağırlığı
\[ \omega_{ij} = \frac{ a_{ij} \exp\left( -\frac{\|x_i^{(t)}-x_j^{(t)}\|_2^2}{\sigma^2} \right) }{ \sum_{k\in N(i)} a_{ik} \exp\left( -\frac{\|x_i^{(t)}-x_k^{(t)}\|_2^2}{\sigma^2} \right) } \]
\(a_{ij}\), graph adjacency bilgisini; \(\sigma\), diffusion sensitivity değerini kontrol eder. Üstel fonksiyon nedeniyle özellik durumu birbirine daha benzer komşuların ağırlığı daha yüksek olabilir. Paydadaki toplam ağırlıkları normalize ederek komşu katkıların birlikte kontrollü bir dağılım oluşturmasını sağlar.
Hazard-sensitive normalization neden sıradan global scaling değildir?
Kaynağın iddiasına göre tehlikeli durum bazen normalde çok stabil olan belirli bir yol kesimindeki küçük fakat alışılmadık sapma olabilir. Bütün şehir verisini tek global ortalama ve varyans yapısıyla ölçeklemek böyle lokal sapmaları bastırabilir. CHFI bu nedenle her road segment'i kendi tarihsel ve yapısal bağlamına göre yorumlamaya çalışan hazard-sensitive normalizasyon kullanmaktadır.
Kaynak bu işlemin exact kapalı-form normalizasyon denklemini ve bütün sayısal parametrelerini ayrıca vermemektedir. Bu nedenle burada yeni normalizasyon formülü uydurulmamıştır.
Ayrık Kaza Noktaları Sürekli Bir Tehlike Yüzeyine Nasıl Dönüştürülüyor?
Çalışma her kaza veya yüksek risk olayının etkisini yol ağı üzerindeki yakın spatial birimlere ve komşu zaman aralıklarına Gaussian-benzeri spatial ve temporal kernel'lar ile yaymakta, bütün olay katkılarını üst üste toplamakta, sonucu geçerli yol ağı birimlerine projekte etmekte ve normalize ederek öğrenmeye hazır sürekli başlangıç tehlike alanı oluşturmaktadır.
Algorithm 1 ve Algorithm 2'nin temel matematiği
Sparse event set:
\[ S=\{(s_k,t_k,y_k)\}_{k=1}^{M} \]
\(s_k\) olayın konumunu, \(t_k\) zamanını ve \(y_k\) tehlike/severity büyüklüğünü temsil eder.
Spatial kernel:
\[ K_s(u,s_k) = \exp\left( -\frac{d_G(u,s_k)^2}{2\sigma_s^2} \right) \]
Temporal kernel:
\[ K_t(t,t_k) = \exp\left( -\frac{(t-t_k)^2}{2\sigma_t^2} \right) \]
Olayın bir konum-zaman noktasına katkısı:
\[ y_kK_s(u,s_k)K_t(t,t_k) \]
Bütün olayların üst üste eklenmesiyle ham alan:
\[ H_0(u,t) = \sum_{k=1}^{M} y_kK_s(u,s_k)K_t(t,t_k) \]
Ardından graph projection:
\[ H_0^G(u,t)=\Pi_G(H_0(u,t)) \]
ve normalizasyon:
\[ \widehat{H}_0(u,t)=\mathcal{N}(H_0^G(u,t)) \]
\(d_G\): Basit düz çizgi Euclidean distance yerine ulaşım graph'ı üzerindeki topology-aware mesafeyi temsil eder.
\(\sigma_s\): Spatial bandwidth'tir. Matematiksel olarak büyüdükçe bir olayın mekânsal kernel etkisi daha geniş alana yayılabilir; küçüldükçe daha lokal kalır.
\(\sigma_t\): Temporal bandwidth'tir. Büyüdükçe olayın zaman üzerindeki etkisi daha geniş pencereye yayılabilir.
Önemli reproducibility notu: Kaynak Algoritma 1 ve 2'de \(\sigma_s\) ve \(\sigma_t\)'yi gerekli parametre olarak tanımlar, ancak incelenen deneysel konfigürasyon tablolarında bunların spesifik sayısal değerlerini raporlamaz. Verianla bu eksikliği kafadan tamamlamamaktadır.
Denklem (12)–(18): Sürekli mekânsal hazard field
Bir yol birimindeki latent tehlike:
\[ H_i(t)\in\mathbb{R}_{\geq0} \]
Yerel contextual feature vector:
\[ x_i(t)\in\mathbb{R}^{d} \]
Yerel hazard generation:
\[ \phi_i(t)=f(x_i(t)) \]
Komşu ağırlıkları:
\[ \omega_{ij}\geq0, \qquad \sum_{j\in N(i)}\omega_{ij}=1 \]
Topology-coupled hazard:
\[ H_i(t) = \alpha\phi_i(t) + (1-\alpha) \sum_{j\in N(i)} \omega_{ij}\phi_j(t) \]
Kaynak bunu bütün ağ için matris biçiminde:
\[ H(t) = \alpha\Phi(t) + (1-\alpha)W\Phi(t) \]
olarak ifade eder.
Buradaki önemli fark, \(x_i\)'nin ham özellik; \(\phi_i=f(x_i)\)'nin bu özelliklerden çıkarılmış latent hazard contribution; \(H_i\)'nin ise yerel ve komşu contribution'ların birleştiği hazard state olmasıdır.
Denklem (19)–(29): Unified governing formulation
Kaynak önce graph'ı tekrar tanımlar:
\[ G=(V,E) \]
Yerel hazard contribution:
\[ \phi_i(t)=f(x_i(t)) \]
Komşu hazard aggregation:
\[ S_i(t) = \sum_{j\in N(i)} \omega_{ij}\phi_j(t) \]
ve:
\[ \sum_{j\in N(i)}\omega_{ij}=1 \]
Instantaneous coupled hazard:
\[ \widetilde{H}_i(t) = \alpha\phi_i(t) + (1-\alpha)S_i(t) \]
Temporal memory eklenince:
\[ H_i(t) = \beta H_i(t-1) + (1-\beta)\widetilde{H}_i(t) \]
\(\beta\), geçmiş hazard state'in ne kadar korunacağını kontrol eden temporal persistence coefficient'tır.
\(\beta=0\) ise önceki durum hesaba katılmaz ve yeni hazard yalnız mevcut coupled state'e eşit olur. \(\beta=1\) sınırında ise denklem önceki state'i tamamen taşır ve yeni instantaneous contribution etkisiz kalır. Bunlar denklemin matematiksel sınırlarıdır.
Accident emergence probability:
\[ P_i(t) = \sigma\left( \gamma_1H_i(t) + \gamma_2\Delta H_i(t) + \gamma_3H_{N(i)}(t) + b \right) \]
Burada:
- \(H_i(t)\): mevcut gizli tehlike düzeyi,
- \(\Delta H_i(t)=H_i(t)-H_i(t-1)\): tehlikenin son zaman adımında artış veya azalışı,
- \(H_{N(i)}(t)\): komşu yol birimlerinin tehlike bağlamı,
- \(\gamma_1,\gamma_2,\gamma_3\): öğrenilebilir katsayılar,
- \(b\): bias,
- \(\sigma(\cdot)\): sigmoid activation'dır.
Sigmoid fonksiyonun görevi lineer birleşimi olasılık benzeri sınırlı bir çıktıya dönüştürmektir. Model böylece “tehlike yüksek mi?” sorusunun yanında “tehlike hızla artıyor mu?” ve “yakın ağ birimleri de tehlikeli mi?” sorularını birlikte kullanır.
Matris biçimindeki kaynak zinciri:
\[ \Phi(t)=f(X(t)) \]
\[ \widetilde{H}(t) = \alpha\Phi(t) + (1-\alpha)W\Phi(t) \]
\[ H(t) = \beta H(t-1) + (1-\beta)\widetilde{H}(t) \]
\[ P(t) = \sigma\left( \gamma_1H(t) + \gamma_2\Delta H(t) + \gamma_3WH(t) + b \right) \]
Zamansal tehlike neden yalnız mevcut değer değildir?
Kaynağın model hipotezi, bir kaza öncesindeki tehlikenin congestion buildup, unstable speed transition, repeated interaction pressure, intersection conflict veya corridor-level propagation gibi süreçlerle zaman içinde birikmesidir.
Bu nedenle \(\Delta H(t)\) önemli bir işarettir. İki yol biriminde mevcut \(H(t)\) aynı olsa bile birinde tehlike hızla yükseliyor, diğerinde sabit kalıyor olabilir. Model bu iki durumu aynı kabul etmemeyi amaçlar.
Denklem (30)–(42): Derin öğrenme architecture matematiği
Girdi tensörü:
\[ X(t)\in\mathbb{R}^{N\times d} \]
\(N\), spatial unit sayısı; \(d\), her birim için hazard-aware feature dimension'dır.
Graph:
\[ G=(V,E) \]
Spatial hazard encoding:
\[ Z_s(t) = \rho\left( WX(t)\Theta_s^{(1)} + X(t)\Theta_s^{(2)} + b_s \right) \]
Bu denklem iki bilgi yolunu birleştirir: \(WX(t)\Theta_s^{(1)}\) komşu graph etkisini; \(X(t)\Theta_s^{(2)}\) yerel özelliği taşır. \(\rho\), nonlinear activation function'dır. Çıktı \(Z_s(t)\in\mathbb{R}^{N\times h}\) latent spatial hazard embedding'dir.
Temporal evolution:
\[ Z_t(t) = \Psi\left( Z_s(t),Z_t(t-1) \right) \]
\(\Psi\), kaynağın genel temporal operator gösterimidir; kaynak bu yapının GRU, LSTM, Transformer-style attention veya başka sequential mekanizma olarak kurulabileceğini söyler. Deneysel E1–E10 dizisinde GRU ve daha sonra BiGRU kullanılmıştır.
Kaynağın öğretici sadeleştirilmiş memory gösterimi:
\[ Z_t(t) = \beta Z_t(t-1) + (1-\beta)Z_s(t) \]
Hazard reconstruction:
\[ \widehat{H}(t) = \rho\left( Z_t(t)\Theta_h+b_h \right) \]
Buradaki \(\widehat{H}(t)\in\mathbb{R}^{N\times1}\), modelin bütün road segment/intersection birimleri üzerindeki gizli tehlike dağılım tahminidir.
Hazard escalation:
\[ \Delta\widehat{H}(t) = \widehat{H}(t) - \widehat{H}(t-1) \]
Neighborhood hazard:
\[ \widehat{H}_{N}(t) = W\widehat{H}(t) \]
Localized emergence probability:
\[ \widehat{P}(t) = \sigma\left( \gamma_1\widehat{H}(t) + \gamma_2\Delta\widehat{H}(t) + \gamma_3\widehat{H}_{N}(t) + b_p \right) \]
Kaynak daha sonra forward propagation zincirini dört fonksiyonla özetler:
\[ Z_s(t)=F_s(X(t),W) \]
\[ Z_t(t)=F_t(Z_s(t),Z_t(t-1)) \]
\[ \widehat{H}(t)=F_h(Z_t(t)) \]
\[ \widehat{P}(t) = F_p\left( \widehat{H}(t), \Delta\widehat{H}(t), W\widehat{H}(t) \right) \]
Composite loss
Algorithm 3'te eğitim hedefi şu genel biçimde verilir:
\[ L(t) = \lambda_1 L_{\mathrm{pred}} \left( \widehat{P}(t),Y(t) \right) + \lambda_2 L_{\mathrm{haz}} \left( \widehat{H}(t) \right) \]
\(L_{\mathrm{pred}}\), accident-emergence prediction error'ını; \(L_{\mathrm{haz}}\), hazard-field consistency bileşenini temsil eder. \(\lambda_1\) ve \(\lambda_2\) iki hedef arasındaki ağırlığı kontrol eder.
Kaynak sınırı: Çalışma Algorithm 3'te bu composite objective'i tanımlar; ancak incelenen metinde \(L_{\mathrm{haz}}\)'ın tam kapalı formunu ve \(\lambda_1,\lambda_2\)'nin kullanılan sayısal değerlerini ayrıca raporlamamaktadır. Bu nedenle Verianla bunları tahmin ederek doldurmamaktadır.
E1–E10 deney tasarımı
| Deney | Ana değişiklik | Spatial | Temporal | Hazard reconstruction | W, Δ | h | α, β | Eğitim |
|---|---|---|---|---|---|---|---|---|
| E1 | Baseline | Yok | Yok | Yok | 1,1 | 64 | — | Adam, 10−3, batch 64, 60 epoch |
| E2 | Spatial encoding | GCN | Yok | Yok | 1,1 | 64 | 0,70; 0 | Adam, 10−3, batch 64, 70 epoch |
| E3 | Temporal hazard | Yok | GRU | Yok | 6,2 | 96 | 1,00; 0,60 | Adam, 8×10⁻⁴, batch 64, 80 epoch |
| E4 | Spatial + temporal | GCN | GRU | Yok | 6,2 | 128 | 0,70; 0,60 | Adam, 8×10⁻⁴, batch 64, 90 epoch |
| E5 | Reconstruction | GCN | GRU | Linear + ReLU | 6,2 | 128 | 0,70; 0,65 | Adam, 5×10⁻⁴, batch 64, 100 epoch |
| E6 | Risk diffusion | GCN + lifted diffusion | GRU | Hazard field | 8,2 | 128 | 0,65; 0,70 | Adam, 5×10⁻⁴, batch 64, 100 epoch |
| E7 | Escalation cue | GCN + diffusion | GRU | Hazard field | 8,2 | 160 | 0,65; 0,75 | Adam, 3×10⁻⁴, batch 64, 110 epoch |
| E8 | Neighborhood context | GCN + diffusion | GRU | Hazard field | 8,2 | 160 | 0,60; 0,75 | Adam, 3×10⁻⁴, batch 64, 110 epoch |
| E9 | Uzun temporal memory | GCN + diffusion | BiGRU | Hazard field | 10,3 | 192 | 0,60; 0,80 | Adam, 2×10⁻⁴, batch 32, 120 epoch |
| E10 | Final CHFI | GCN + topology-aware diffusion | BiGRU + memory | Continuous reconstruction | 10,3 | 256 | 0,60; 0,80 | Adam, 2×10⁻⁴, batch 32, 120 epoch, early stopping |
W: temporal window length; Δ: stride; h: latent hazard embedding dimension; α: local/neighbor balance; β: temporal persistence.
Deney donanımı ve yazılımı
Bütün deneyler MATLAB R2023a üzerinde, Windows 11 Home 64-bit işletim sistemi kullanılarak yürütülmüştür. Donanım ASUS TUF Gaming F15 FX506LH; Intel Core i5-10300H 2,50 GHz CPU; 32 GB RAM; NVIDIA GeForce GTX 1650, 4 GB dedicated display memory ve 16 GB shared memory olarak raporlanmıştır.
Eğitim, doğrulama ve test ayrımı
Her veri seti bağımsız olarak:
\[ D^{(m)} = D_{\mathrm{train}}^{(m)} \cup D_{\mathrm{test}}^{(m)} \]
ve:
\[ D_{\mathrm{train}}^{(m)} \cap D_{\mathrm{test}}^{(m)} = \varnothing \]
şeklinde ayrılmıştır.
70/30 oranı:
\[ |D_{\mathrm{train}}^{(m)}| = 0.70|D^{(m)}|, \qquad |D_{\mathrm{test}}^{(m)}| = 0.30|D^{(m)}| \]
Eğitim bölümü kendi içinde:
\[ D_{\mathrm{train}}^{(m)} = D_{\mathrm{fit}}^{(m)} \cup D_{\mathrm{val}}^{(m)} \]
ve:
\[ D_{\mathrm{fit}}^{(m)} \cap D_{\mathrm{val}}^{(m)} = \varnothing \]
olarak ayrılmıştır. \(D_{\mathrm{fit}}\) parameter learning için; \(D_{\mathrm{val}}\) validation-loss monitoring, early stopping ve checkpoint selection için kullanılmıştır. Held-out \(D_{\mathrm{test}}\) eğitim, hyperparameter monitoring veya model selection için kullanılmamalıdır.
Eksik reproducibility ayrıntısı: Kaynak iç validation subset'in yüzde oranını ve early-stopping patience \(P\)'nin sayısal değerini bu bölümde vermemektedir.
Precision, Recall ve F1 ne ölçüyor?
Her sınıf \(c\) için precision:
\[ \mathrm{Precision}_c = \frac{TP_c} {TP_c+FP_c+\epsilon} \]
TP, doğru pozitif; FP, yanlış pozitif sonuçtur. Precision yüksekse modelin “bu sınıftır” dediği örneklerin büyük bölümü gerçekten o sınıftadır.
Recall:
\[ \mathrm{Recall}_c = \frac{TP_c} {TP_c+FN_c+\epsilon} \]
FN, modelin kaçırdığı gerçek pozitif örnektir. Recall yüksekse gerçek sınıf örneklerinin daha büyük bölümü yakalanmaktadır.
F1:
\[ F1_c = \frac{ 2\mathrm{Precision}_c\mathrm{Recall}_c }{ \mathrm{Precision}_c+\mathrm{Recall}_c+\epsilon } \]
F1 precision ve recall arasında harmonic mean kullanır. İkisinden biri ciddi biçimde düşükse F1 de düşer.
Macro-F1:
\[ \mathrm{MacroF1} = \frac{1}{C} \sum_{c=1}^{C} F1_c \]
Her sınıf eşit ağırlık aldığı için çoğunluk sınıfının büyük örnek sayısıyla bütün metriği domine etmesi azaltılır. Kaynak bu nedenle Macro-F1'i class imbalance bulunan trafik güvenliği problemlerinde temel metrik olarak seçmektedir.
Validation loss ile checkpoint seçimi
\[ L_{\mathrm{val}}^{(m,e)} = \frac{1} {|D_{\mathrm{val}}^{(m)}|} \sum_{(x_i,y_i)\in D_{\mathrm{val}}^{(m)}} L(y_i,\widehat{y}_i^{(e)}) \]
Seçilen epoch:
\[ e^{*(m)} = \operatorname*{arg\,min}_{e\in\{1,\ldots,E\}} L_{\mathrm{val}}^{(m,e)} \]
Nihai parameter checkpoint:
\[ \theta^{*(m)} = \theta^{(e^{*(m)})} \]
Early stopping:
\[ L_{\mathrm{val}}^{(m,e)} \geq \min_{k<e} L_{\mathrm{val}}^{(m,k)} \quad \text{P ardışık epoch boyunca} \]
Yani validation loss belirlenen patience süresi boyunca iyileşmezse eğitim durdurulabilir. Kaynak \(P\)'nin sayısal değerini raporlamamaktadır.
Final evaluation set:
\[ D_{\mathrm{eval}}^{(m)} = D_{\mathrm{test}}^{(m)} \]
Test setinin class distribution'ı yapay biçimde dengelenmemiş; class imbalance etkisi macro precision, recall, F1, AUC, confusion matrix ve precision–recall behavior ile değerlendirilmiştir.
Çalışmanın Yöntemi ve Bulguları
Kaynakta öne çıkarılan E10 sonuçları
| Veri seti | Accuracy | Precision | Recall | F1 | AUC | Kaynak statüsü |
|---|---|---|---|---|---|---|
| Dataset 1 | %99,12 | %98,94 | %98,76 | %98,85 | 0,998 | Abstract / sonuç / Tablo 9 Training Stage |
| Dataset 2 | %98,63 | %98,41 | %98,16 | %98,28 | 0,997 | Abstract / sonuç / Tablo 9 Training Stage |
Bağımsız Test-stage Tablo 10 sonuçları
| Veri seti | Test Accuracy | Test Precision | Test Recall | Test F1 | Test AUC | Test Loss |
|---|---|---|---|---|---|---|
| Dataset 1 | %98,84 | %98,62 | %98,37 | %98,49 | 0,998 | 0,089 |
| Dataset 2 | %98,07 | %97,86 | %97,59 | %97,72 | 0,997 | 0,101 |
Yorum sınırı: Kaynakta bu iki performans katmanı arasında açık bir raporlama uyumsuzluğu vardır. Verianla held-out test sonucu olarak Tablo 10'un etiketini korur; ancak yazarların abstract/conclusion değerlerini de yok saymaz. İki set birbirinin yerine geçirilmemelidir.
Test aşamasında E1'den E10'a ilerleme
| Konfigürasyon | Dataset 1 Test F1 | Dataset 1 AUC | Dataset 2 Test F1 | Dataset 2 AUC |
|---|---|---|---|---|
| E1 | %90,06 | 0,938 | %89,14 | 0,931 |
| E2 | %91,73 | 0,951 | %90,85 | 0,944 |
| E3 | %92,44 | 0,958 | %91,62 | 0,952 |
| E4 | %94,00 | 0,970 | %93,17 | 0,965 |
| E5 | %94,92 | 0,977 | %94,11 | 0,973 |
| E6 | %95,67 | 0,983 | %94,80 | 0,980 |
| E7 | %96,57 | 0,988 | %95,62 | 0,986 |
| E8 | %97,18 | 0,992 | %96,28 | 0,990 |
| E9 | %97,84 | 0,996 | %96,98 | 0,994 |
| E10 | %98,49 | 0,998 | %97,72 | 0,997 |
Bu test tablosuna göre E1'den E10'a mutlak F1 artışı Dataset 1 için 8,43 yüzde puanı, Dataset 2 için 8,58 yüzde puanıdır. Kaynak tartışma metni de bu iki test-stage farkını bu şekilde hesaplamaktadır.
Buna karşılık abstract ve Table 11 kaynakta Training Stage değerlerini kullanarak +7,91 ve +8,26 yüzde puanı artış bildirir. Bu iki hesap farklı tablolara dayanır.
Ablasyon ne gösteriyor?
Ablation mantığının amacı final performansın tek bir “sihirli” modülden mi yoksa birikimli bileşenlerden mi geldiğini incelemektir.
| Model aşaması | F1 D1 | F1 D2 | Ana eklenen bilgi |
|---|---|---|---|
| Baseline MLP | %90,94 | %90,02 | Spatial/temporal hazard reasoning yok |
| Spatial-only | %92,64 | %91,70 | Road-network topology |
| Temporal-only | %93,29 | %92,40 | Temporal buildup |
| Spatial + Temporal | %94,69 | %93,85 | Coupled spatio-temporal model |
| + Hazard Reconstruction | %95,54 | %94,79 | Explicit hidden-danger field |
| + Risk Diffusion | %96,21 | %95,42 | Komşu yol risk transferi |
| + Escalation Cue | %97,02 | %96,23 | Recent hazard intensification |
| + Neighborhood Context | %97,60 | %96,87 | Corridor-level reinforcement |
| + BiGRU | %98,17 | %97,50 | Daha uzun temporal memory |
| Full CHFI | %98,85 | %98,28 | Tam hazard-to-emergence mapping |
Yine önemli not: Bu Tablo 11 değerleri Tablo 9 Training Stage ile aynı performans dizisini izlemektedir. Test-stage Tablo 10'da karşılık gelen F1 değerleri biraz daha düşüktür.
Hangi modül ne sağladı?
Spatial encoder: Flat record yaklaşımına road network connectivity ekler.
Temporal module: Aynı noktadaki tehlikenin geçmişten bugüne nasıl geliştiğini öğrenir. Kaynakta temporal-only modelin spatial-only modelden biraz daha yüksek F1 üretmesi, zaman içindeki buildup bilgisinin tek başına güçlü predictive signal olduğunu göstermektedir.
Spatial + temporal: Modelin yalnız “nerede?” veya “ne zaman?” değil, “bağlantılı ağ üzerinde zamanla nerede gelişiyor?” sorusuna yaklaşmasını sağlar.
Hazard reconstruction: Modeli doğrudan classification embedding'den önce explicit latent tehlike alanı kurmaya zorlar.
Risk diffusion: Bir yol kesimini çevresinden tamamen bağımsız kabul etmeyi bırakır.
Escalation cue: Absolute hazard seviyesinden ayrı olarak hazard'ın yükselme hızını temsil eder.
Neighborhood context: Lokal tehlikenin izole mi yoksa daha geniş corridor-level risk yapısının parçası mı olduğunu anlamaya yardım eder.
BiGRU ve memory: Daha uzun hazard evolution pattern'lerini modellemeye yönelik son temporal güçlendirmedir.
Sıkı doğrulama neden gerekli?
Spatio-temporal veride rastgele train/test ayrımı özellikle yakın zamanlar veya komşu yol bölgeleri iki grupta da kalırsa gerçek dünyadaki genellenebilirliği olduğundan iyi gösterebilir. Kaynak bu nedenle random split'e ek olarak temporal, geographic ve blocked spatio-temporal hold-out uygular.
| Dataset | Validation | Accuracy | Precision | Recall | F1 |
|---|---|---|---|---|---|
| Dataset 1 | Stratified random | %99,12 | %98,94 | %98,76 | %98,85 |
| Dataset 1 | Temporal hold-out | %97,84 | %97,51 | %97,28 | %97,39 |
| Dataset 1 | Geographic hold-out | %97,36 | %97,04 | %96,82 | %96,93 |
| Dataset 1 | Blocked spatio-temporal | %96,71 | %96,38 | %96,05 | %96,21 |
| Dataset 2 | Stratified random | %98,63 | %98,41 | %98,16 | %98,28 |
| Dataset 2 | Temporal hold-out | %97,29 | %96,94 | %96,71 | %96,82 |
| Dataset 2 | Geographic hold-out | %96,88 | %96,52 | %96,19 | %96,35 |
| Dataset 2 | Blocked spatio-temporal | %96,14 | %95,78 | %95,43 | %95,60 |
Blocked spatio-temporal validation hem zaman hem mekân benzerliğini birlikte sınırlandırdığı için en sıkı test olarak tanımlanmaktadır ve her iki veri setinde de en düşük F1 burada görülmektedir. Performans düşüşü, random record split değerlerinin daha kolay bir değerlendirme koşulu olduğunu göstermektedir.
Ancak random split satırlarının Tablo 9 Training Stage değerleriyle birebir aynı oluşu kaynak içindeki sonuç-etiketleme tutarsızlığının burada da devam ettiğini göstermektedir. Bu nedenle yukarıdaki tablo kaynağın bildirdiği şekliyle aktarılmıştır; Tablo 10 sonuçlarının yerine geçirilmemelidir.
Hesaplama maliyeti
| Exp. | Parametre | Train / epoch | Inference | Peak memory | FLOPs |
|---|---|---|---|---|---|
| E1 | 0,18 M | 9,4 s | 2,1 ms | 186 MB | 12,6 M |
| E2 | 0,31 M | 13,8 s | 3,4 ms | 224 MB | 21,7 M |
| E3 | 0,42 M | 15,9 s | 4,2 ms | 241 MB | 28,1 M |
| E4 | 0,64 M | 20,3 s | 5,6 ms | 292 MB | 39,8 M |
| E5 | 0,78 M | 23,1 s | 6,2 ms | 317 MB | 46,5 M |
| E6 | 0,83 M | 25,4 s | 6,8 ms | 336 MB | 51,2 M |
| E7 | 0,89 M | 27,9 s | 7,2 ms | 348 MB | 55,6 M |
| E8 | 0,94 M | 29,2 s | 7,8 ms | 361 MB | 58,9 M |
| E9 | 1,08 M | 33,7 s | 8,9 ms | 388 MB | 66,4 M |
| E10 | 1,26 M | 36,8 s | 9,6 ms | 412 MB | 73,8 M |
E10, E1'e kıyasla yaklaşık yedi kat daha fazla model parameter'ına ve daha yüksek computation/memory maliyetine sahiptir. Kaynak buna rağmen 9,6 ms inference değerini “practical inference cost” olarak tanımlamaktadır. Bu değer çalışmanın raporladığı donanım ve implementation koşullarına aittir; farklı donanım veya gerçek zamanlı üretim sistemi için aynı latency garanti edilmez.
Kaynak figürler tehlike alanının görsel olarak neye dönüştüğünü gösteriyor?
Kaynak preprocessing öncesinde hazard bilgisini dar, izole ve parçalı high-intensity adalar olarak göstermektedir. Preprocessing sonrasında aynı kavramsal yapı daha geniş, düzgün ve komşu yol alanlarına süreklilikle yayılan hazard surface'e dönüşmektedir.
Bu görsellerdeki yüzeyler çalışmanın preprocessing mekanizmasını anlatmaktadır. Verianla aynı contour koordinatlarını veya renk yoğunluklarını yeni deneysel veriymiş gibi yeniden üretmemiştir; çünkü kaynakta bunları yeniden çizmek için tam underlying numerical grid verilmemektedir.
Kaynakta raporlanan bazı görsel diagnostic sonuçları
E1 baseline'da Dataset 1 test AUC değeri 0,938'dir ve rare class'larda daha zayıf generalization görülmektedir. Dataset 2 baseline'da özellikle Multi-Injury ve Fatal/Severe gibi daha seyrek sınıfların ayrımı daha zordur.
Kaynak E10 için Dataset 1 confusion matrix'inde normalized diagonal oranlarını Low %99,5, Moderate %94,9, Elevated %93,4 ve Critical %94,3 olarak raporlamaktadır. Kaynak ayrıca calibration curve'ün ideal calibration çizgisini büyük bölümde yakından izlediğini belirtmektedir. Bu değerler kaynak Figure 24'ün diagnostic yorumudur ve bütün diğer veri setlerinde aynı calibration davranışını garanti etmez.
İlgili çalışmalarla karşılaştırma nasıl okunmalı?
Kaynak Tablo 15; Park ve Hong'un MLP yaklaşımı, Macedo ve arkadaşlarının GEE modeli, Gou ve arkadaşlarının XTraffic benchmark'ları, Huang ve arkadaşlarının TRAVEL yaklaşımı, Wang ve arkadaşlarının RoadInTCP modeli, Yumak ve arkadaşlarının XGBoost/RF/MLP çalışması, Li ve Chen'in CNN–LSTM–GNN modeli ve Alnowaiser'in GNN–LSTM–MLP yaklaşımı gibi farklı çalışmaları konumlandırmaktadır.
Ancak bu çalışmalar farklı veri setleri, farklı target tanımları, farklı sample distributions ve farklı değerlendirme protokolleri kullanmaktadır. Örneğin bir çalışmada raporlanan %99,97 accuracy ile CHFI'nin %98–99 aralığındaki değerlerini yalnız sayıya bakarak “hangisi daha iyi?” şeklinde sıralamak metodolojik olarak doğru değildir.
Kaynağın asıl novelty iddiası yalnız en yüksek accuracy değildir. CHFI'nin farkı, discrete accident classification'dan önce topology-aware, temporally evolving ve interpretable bir hidden hazard field oluşturmasıdır.
Kaynak dış-baseline karşılaştırmasında ne eksik?
Metin, RF, XGBoost, MLP, LSTM/GRU ve graph-based modellerin güçlü dış benchmark aileleri olduğunu belirtmekte ve bunların değerlendirme tasarımındaki önemini tartışmaktadır. Bununla birlikte makalede bulunan ana sayısal sonuç tabloları E1–E10 iç mimari konfigürasyonlarını vermektedir. Tablo 15 ise diğer yayımlanmış çalışmaların kendi sonuçlarını aktarır.
Bu nedenle ayrı bir same-dataset, same-split RF/XGBoost/LSTM/GCN sayısal benchmark tablosu kaynakta görünmediği için Verianla böyle bir tablo üretmemektedir.
Çalışmanın desteklediği sonuçlar
- Flat MLP baseline'dan topology-aware ve temporal architecture'a ilerlemek her iki veri setinde performansı artırmıştır.
- Temporal-only yapı spatial-only yapıdan biraz daha yüksek F1 göstermiştir.
- Spatial ve temporal modelin birlikte kullanılması tek başlarına kullanımlarından daha iyi sonuç vermiştir.
- Explicit hazard reconstruction eklenmesi performansı daha ileri taşımıştır.
- Risk-diffusion, hazard escalation ve neighborhood context eklenmesi aşamalı iyileşme sağlamıştır.
- BiGRU ve daha uzun temporal window son aşamalarda ek iyileşme sağlamıştır.
- Random split'ten temporal, geographic ve blocked spatio-temporal validation'a geçildiğinde performans düşmüş fakat kaynakta yüksek kalmıştır.
- Model yaklaşık 1,26 milyon parameter ve kaynak donanımında 9,6 ms inference cost ile raporlanmıştır.
- Continuous hazard representation modelin kaza tahmininden önce yorumlanabilir bir latent safety structure üretmesini amaçlamaktadır.
Çalışmanın desteklemediği genellemeler
- CHFI'nin gerçek zamanlı şehir trafik sisteminde canlı olarak doğrulandığı gösterilmemiştir.
- Modelin kazaları fiilen önlediği veya kaza sayısını belirli bir yüzde azalttığı gösterilmemiştir.
- Model çıktısı doğrudan otonom trafik sinyal kontrol komutu değildir.
- İki veri setindeki yüksek accuracy bütün şehirler ve ülkelerde aynı performansın elde edileceğini göstermez.
- Random split performansı geographic veya temporal generalization ile aynı şey değildir.
- Hazard field gerçek fiziksel olarak doğrudan ölçülmüş bir alan değildir; model tarafından reconstructed latent representation'dır.
- Bir hazard hotspot'un bulunması tek başına nedensel kaza mekanizmasını kanıtlamaz.
- Tablo 15'teki farklı çalışmaların metrikleri doğrudan aynı test setinde yarışmış sonuçlar değildir.
- Kaynakta sayısal değeri verilmemiş \(\sigma_s\), \(\sigma_t\), \(\lambda_1\), \(\lambda_2\) ve patience \(P\) değerleri bilinmemektedir.
- Özet ve sonuçtaki performans sayılarının bağımsız held-out test değerleriyle tamamen tutarlı olduğu söylenemez; kaynak Tablo 9 ve Tablo 10 farklı değerler raporlamaktadır.
Çalışmanın önemli sınırlılıkları ve gelecek araştırmaları
Kaynak özel bir “Limitations” başlığı altında uzun bir sınırlılık listesi vermemekle birlikte sonuç bölümünde gelecekte doğrulanması gereken alanları açıkça belirtmektedir.
Gerçek zaman: Model gelecekte real-time streaming environment'a genişletilmelidir. Mevcut çalışma bunu canlı trafik akışı üzerinde doğrulamamıştır.
Daha zengin context: Signal timing, lane-level dynamics, multimodal mobility interaction ve daha ayrıntılı weather progression modelde gelecekte ele alınabilir.
Cross-city generalization: Daha fazla şehir, ulaşım ağı ve external benchmark dataset üzerinde değerlendirme gerekmektedir.
Uncertainty: Uncertainty-aware accident emergence modeling gelecekteki araştırma başlığıdır; mevcut sonuçlar tam uncertainty quantification çerçevesi sunmamaktadır.
Traffic-control integration: Trafik kontrol ve intervention sistemleriyle entegrasyon gelecekteki uygulama alanıdır.
Reproducibility: Kaynak çok sayıda mimari hyperparameter vermektedir; ancak kernel bandwidth'leri, composite loss ağırlıkları ve early-stopping patience gibi bazı değerler sayısal olarak eksiktir.
Reporting consistency: Training Stage, Test Stage, abstract/conclusion ve robustness tablolarındaki final performance değerleri aynı değildir. Bu durum sonuçların hangi evaluation layer'a ait olduğunun dikkatle takip edilmesini gerektirir.
Pratik olarak model nasıl çalıştırılmak isteniyor?
- Yeni trafik, incident, yol, zaman ve contextual veri alınır.
- Gözlemler ulaşım graph'ındaki doğru road segment/intersection birimine hizalanır.
- Veriler overlapping temporal windows içine alınır.
- Risk-diffusion ile komşu ağ etkileri feature space'e taşınır.
- Hazard-sensitive normalization uygulanır.
- Sparse olaylardan initial continuous hazard surface oluşturulur.
- GCN spatial hazard ilişkilerini öğrenir.
- GRU/BiGRU hazard'ın zaman içindeki buildup ve persistence yapısını öğrenir.
- Model continuous latent hazard field \(\widehat{H}(t)\) üretir.
- \(\Delta\widehat{H}(t)\) ile hazard escalation hesaplanır.
- \(W\widehat{H}(t)\) ile neighborhood context çıkarılır.
- Prediction head bu bilgileri localized accident-emergence probability'ye dönüştürür.
- Çıktılar hazard map, risk zone, hotspot ve safety inspection/early-warning karar desteği için yorumlanabilir.
Bilimsel anlamı
Çalışmanın asıl kavramsal katkısı, kazayı tek başına tahmin edilen bir sonuç olmaktan çıkarıp gözlenemeyen ama model tarafından reconstruct edilen bir “öncül tehlike durumu”nun sonucu olarak ele almaktır.
Bu bakış açısında model yalnız “hangi kayıt kazadır?” sorusuna değil, “hangi bağlı yol kesimlerinde tehlike birikiyor, nereden yayılıyor, zaman içinde güçleniyor mu ve hangi lokal birim kritik hale yaklaşıyor?” sorularına cevap vermeyi hedefler.
Ancak bu tehlike alanı doğrudan fiziksel bir sensörle ölçülmüş “gerçek tehlike maddesi” değildir. Öğrenilmiş latent mathematical representation'dır. Bu ayrım, model çıktısının yorumlanması açısından kritiktir.
Kaynak ve Yöntem Notu
Özgün başlık: Learning the City’s Hidden Danger: A Continuous Hazard Field Intelligence Framework for Traffic Accident Emergence and Urban Safety Prediction
Yazarlar: Nawal Louzi; Mahmoud AlJamal; Mohammad Q. Al-Jamal.
Corresponding authors: Nawal Louzi ve Mahmoud AlJamal.
Eş katkı / eş birinci yazarlık: Kaynakta eş katkı işareti raporlanmamaktadır.
Kurum 1: Civil Engineering Department, Al-Ahliyya University, Amman 19111, Jordan.
Kurum 2: Department of Cybersecurity, Science and Information Technology, Irbid National University, Irbid 21110, Jordan.
Kurum 3: Department of Renewable Energy, Technical Faculty, Jadara University, P.O. Box 733, Irbid 21110, Jordan.
Dergi: Urban Science.
Yayınevi: MDPI, Basel, Switzerland.
Cilt / sayı / makale: Volume 10, Issue 6, Article 300.
DOI: 10.3390/urbansci10060300.
Gönderim: 5 Nisan 2026.
Revizyon: 10 Mayıs 2026.
Kabul: 22 Mayıs 2026.
Yayın: 27 Mayıs 2026.
Kaynak türü: Article; gerçek dünya trafik güvenliği veri setleri üzerinde topology-aware spatio-temporal deep learning ve continuous hazard-field modellemesi geliştiren hesaplamalı araştırma.
Hakemlik durumu: Urban Science hakemli dergisinde yayımlanmış Version of Record.
Preprint: Kaynakta ayrı preprint bilgisi bulunmamaktadır; hedefli kontrolde de aynı başlık için ayrı preprint tespit edilmemiştir.
Lisans: Creative Commons Attribution (CC BY).
Ana model: Continuous Hazard Field Intelligence Framework — CHFI.
Dataset 1: XTraffic Incident Dataset (2022–2024), 1.441.904 kayıt.
Dataset 2: Motor Vehicle Collisions–Crashes Dataset, 2.026.647 kayıt, 29 belgelenmiş feature.
Ana veri bölümü: %70 training / %30 held-out testing. Training bölümü içinde ayrı validation subset kullanılmıştır; exact validation oranı kaynakta raporlanmamaktadır.
Optimizer: Adam.
Final E10 learning rate: 2×10⁻⁴.
Final batch size: 32.
Maximum epoch: 120.
Final temporal window / stride: W=10, Δ=3.
Final latent dimension: h=256.
Final local–neighbor balance: α=0,60.
Final temporal persistence: β=0,80.
Final temporal model: BiGRU + temporal memory update.
Spatial model: GCN + topology-aware diffusion.
Hazard reconstruction: Continuous hazard reconstruction layer.
Evaluation metrics: Accuracy, macro-precision, macro-recall, Macro-F1, AUC, loss; ayrıca confusion matrix, ROC ve precision–recall diagnostic değerlendirmeleri.
Ek robust validation: Stratified random split, temporal hold-out, geographic hold-out ve blocked spatio-temporal validation.
Uygulama ortamı: MATLAB R2023a; Windows 11 Home 64-bit.
Donanım: ASUS TUF Gaming F15 FX506LH; Intel Core i5-10300H 2,50 GHz; 32 GB RAM; NVIDIA GeForce GTX 1650, 4 GB dedicated display memory ve 16 GB shared memory.
Final model complexity: Kaynak Tablo 12'ye göre yaklaşık 1,26 milyon parameter, 36,8 s training time/epoch, 9,6 ms inference, 412 MB peak memory ve 73,8 M FLOPs.
Finansman: Araştırmanın Al-Ahliyya University, Amman, Jordan tarafından desteklendiği ve finanse edildiği bildirilmiştir.
Institutional Review Board: Uygulanabilir değil.
Informed Consent: Uygulanabilir değil.
Veri erişilebilirliği: Yazarlar kullanılan veri setlerinin kamuya açık çevrimiçi kaynaklardan elde edildiğini; derived processing scripts, feature-engineering procedures ve implementation details'in reasonable request üzerine corresponding author tarafından sağlanabileceğini belirtmektedir.
Veri erişimiyle ilgili kaynak notu: XTraffic Dataset kaynakça [21]'de Kaggle kaydı olarak gösterilir. Motor Vehicle Collisions–Crashes ise kaynakça [22]'de TUSH32 Kaggle kaydı olarak listelenmektedir. Data Availability bölümünün sonunda verilen 10.1016/j.aap.2024.107564 DOI'si kaynakça [11]'deki Cui ve arkadaşlarının makalesine karşılık geldiği için Dataset 2 deposu gibi yorumlanmamıştır.
Yazar katkıları: Conceptualization — N.L., M.A., M.Q.A.-J.; methodology — N.L., M.A.; software — M.A.; validation — N.L., M.A., M.Q.A.-J.; formal analysis — N.L., M.A.; investigation — N.L., M.A.; resources — N.L., M.Q.A.-J.; data curation — M.A.; writing—original draft — N.L., M.A.; writing—review and editing — N.L., M.A., M.Q.A.-J.; visualization — M.A.; supervision — N.L., M.Q.A.-J.; project administration — N.L.; funding acquisition — N.L.
Çıkar çatışması: Yazarlar çıkar çatışması olmadığını beyan etmektedir.
Önemli raporlama tutarsızlığı: Abstract, sonuç, Tablo 9 ve bazı sonraki özet tablolar final CHFI için Dataset 1'de %99,12 accuracy / %98,85 F1 ve Dataset 2'de %98,63 accuracy / %98,28 F1 verirken, açıkça “Test-stage” olarak etiketlenen Tablo 10 E10 değerleri Dataset 1'de %98,84 accuracy / %98,49 F1 ve Dataset 2'de %98,07 accuracy / %97,72 F1 olarak raporlanmaktadır. Verianla bu farkı sessizce düzeltmemiştir.
Ablasyon raporlama notu: Tablo 11'deki F1 dizisi Tablo 9 Training Stage sonuçlarıyla eşleşmektedir; test-stage değerleri için Tablo 10 ayrı değerlendirilmelidir.
External baseline notu: Kaynak güçlü benchmark aileleri olarak RF, XGBoost, MLP, LSTM/GRU ve graph-based modelleri tartışır; ancak makaledeki ayrıntılı sayısal E1–E10 tabloları esas olarak CHFI'nin iç konfigürasyonlarıdır. Tablo 15'in diğer araştırmalara ait sonuçları aynı veri seti üzerinde doğrudan head-to-head kıyas değildir.
Eksik reproducibility parametreleri: Spatial bandwidth \(\sigma_s\), temporal bandwidth \(\sigma_t\), composite loss ağırlıkları \(\lambda_1,\lambda_2\), exact internal validation fraction ve early-stopping patience \(P\) için sayısal değerler kaynakta açık olarak raporlanmamaktadır.
Temel yorum sınırı: Çalışma iki büyük mevcut veri seti üzerinde kontrollü computational evaluation yapmaktadır. Gerçek zamanlı canlı kent konuşlandırması, gerçek trafik müdahalesi, kaza sayısında prospektif azalma veya farklı şehirlerde geniş ölçekli saha doğrulaması yapılmamıştır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir