


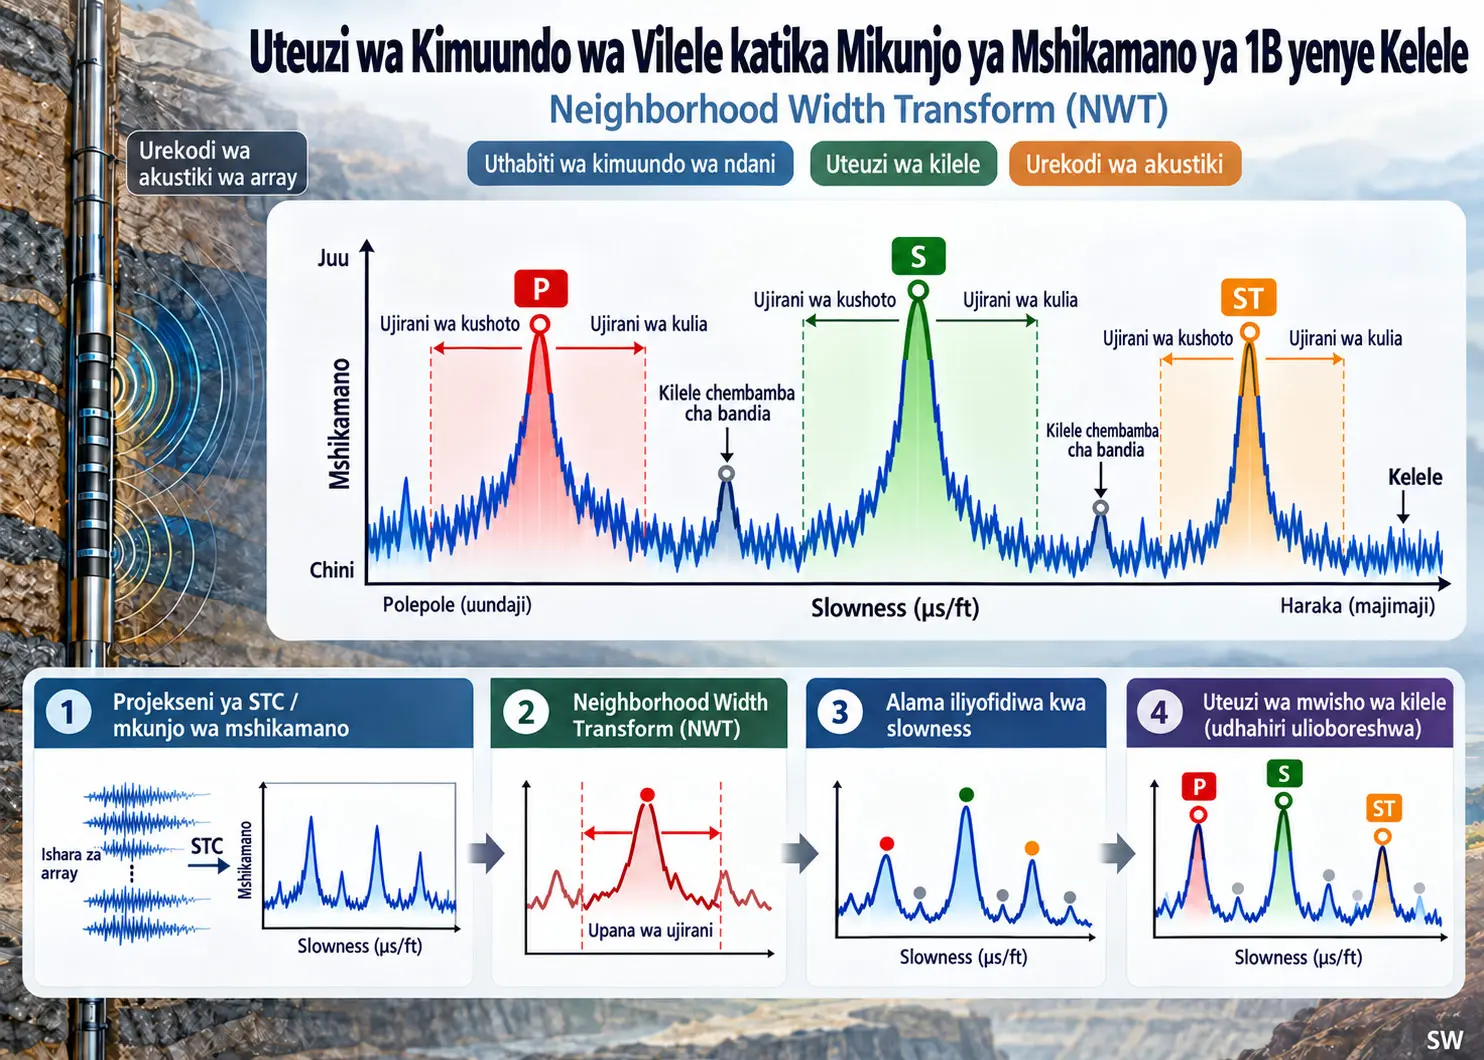
Ubadilishaji wa Upana wa Ujirani (Neighborhood Width Transform, NWT) ni mfumo wa kihisabati wa uteuzi wa vilele unaochagua vilele halisi vya kifizikia katika mikunjo ya mshikamano ya 1B yenye kelele si kwa ukubwa wa amplitudo pekee, bali kwa uthabiti wa kimuundo wa mazingira yake, bila kuhitaji data za mafunzo. Utafiti uliunda NWT ili kutoa kiotomatiki thamani za slowness za mawimbi ya mgandamizo (P), ukataji (S) na Stoneley (ST) katika mikunjo ya mshikamano ya 1B inayopatikana kutoka data za array acoustic logging kwa njia ya Slowness Time Coherence (STC).
Wazo kuu la mbinu ni kwamba kilele halisi kinapaswa kubaki kikitawala katika ujirani mpana upande wa kushoto na wa kulia hadi thamani iliyo juu yake ipatikane. Miiba myembamba ya kelele au maksimumu bandia kwenye bega la kilele kikubwa mara nyingi huonekana kuwa mipana katika upande mmoja tu. Kwa hiyo NWT haitumii jumla au maksimumu ya upana wa ujirani wa kushoto na kulia, bali minimumu yake. Katika hatua ya kwanza, kipimo hiki cha kimuundo huunganishwa na amplitudo ya mshikamano na fidia ya slowness ili kuunda alama ya Slowness-Compensated Neighborhood-Width Transform (SCNWT); katika hatua ya pili, NWT hutumika tena kwenye mkunjo huohuo wa alama ili kupata jibu la mwisho la prominence.
Utafiti ulitathmini mbinu katika kipindi endelevu cha 172,4 m cha array acoustic logging kutoka kisima cha eneo la uwanjani nchini China. Kila moja ya sehemu nne ngumu zilizochaguliwa kwa jaribio la kina ina pointi 251 za sampuli, azimio la slowness la 1 µs/ft na modi tatu za mawimbi lengwa. Mbinu iliyopendekezwa ilipata vilele vyote 12 vya ground-truth katika sehemu nne za data katika nafasi sahihi kabisa; iliripoti mafanikio ya %100 kwa SR5, SR10 na SR15, na kosa sifuri kwa MAE, RMSE na MRE. Hata hivyo, matokeo haya hayamaanishi kuwa mbinu ni kamilifu katika hali zote za kijiolojia: muundo wa sasa hudhani modi tatu kamili za mawimbi hai na umeundwa kwa mikunjo ya mshikamano ya mwelekeo mmoja pekee.
Neighborhood Width Transform (NWT) Ni Nini?
Neighborhood Width Transform (NWT) ni mbinu isiyosimamiwa ya uteuzi wa vilele inayopima umuhimu wa kimuundo wa kilele mgombea kwa kuangalia si urefu wake tu, bali pia upana wa eneo la ndani linalotawaliwa upande wa kushoto na wa kulia hadi sampuli yenye thamani kubwa zaidi ipatikane; kwa njia hii miiba myembamba ya kelele na maksimumu bandia kwenye mabega ya vilele hukandamizwa, huku vilele vya kifizikia vinavyobaki thabiti katika pande zote mbili vikipewa kipaumbele.
Kwa nini array acoustic logging na slowness ni muhimu?
Array acoustic logging ni mbinu inayotumiwa kutathmini sifa za miundo ya kijiolojia kutoka vipimo vya akustiki vya njia nyingi ndani ya kisima. Kasi za mawimbi ya akustiki hutofautiana kati ya mazingira tofauti ya kijiolojia. Slowness ni kinyume cha kasi na katika chanzo inachukuliwa kuwa kiasi muhimu kwa utenganishaji wa tabaka, kutambua maeneo ya gesi, kukokotoa porosity na kutathmini shinikizo la formation.
Mbinu ya STC huzalisha ramani ya mshikamano ya vipimo viwili kwenye mihimili ya muda wa kuwasili \(\tau\) na slowness \(s\) kutoka rekodi za akustiki za njia nyingi. Modi za mawimbi ya kifizikia zinahusishwa na maksimumu za ndani kwenye ramani hii.
Mlinganyo (1): Ramani ya STC ya vipimo viwili inabadilikaje kuwa mkunjo wa 1B?
\[ \rho(s)=\max_{\tau\in\mathcal{T}}\rho^{*}(\tau,s) \tag{1} \]
\(\rho^{*}(\tau,s)\) ni thamani ya mshikamano ya STC ya vipimo viwili iliyokokotolewa kwa muda wa kuwasili \(\tau\) na slowness \(s\). \(\mathcal{T}\) ni seti ya nyakati za kuwasili zilizogawanywa. Mlinganyo huchagua mshikamano wa juu zaidi kwenye mhimili wa muda kwa kila thamani ya \(s\), na hivyo kutayarisha ramani ya 2B ya STC kuwa mkunjo wa mwelekeo mmoja \(\rho(s)\).
\(\rho(s)\) huwakilisha thamani ya mshikamano isiyo na kipimo, huku \(s\) ikiwakilisha kiratibu cha slowness kinachotumiwa katika chanzo kwa kitengo cha µs/ft. Katika hali bora, mawimbi ya P, S na ST huunda maksimumu tatu za ndani zilizo wazi na kutenganishwa, na mpangilio wa kifizikia ni:
\[ s_P<s_S<s_{ST} \]
kama ilivyoonyeshwa.
Kwa nini uteuzi wa vilele unakuwa mgumu katika data halisi ya kisima?
- Kelele isiyo tulivu: Kiwango cha msingi cha kelele kinapoongezeka, hasa mshikamano wa wimbi la S unaweza kubaki dhaifu ikilinganishwa na mawimbi ya P na ST.
- Lobu za pembeni bandia: Miundo ya windowing na kuingiliana katika ukokotoaji wa STC inaweza kuzalisha pseudo-peak nyembamba lakini zenye amplitudo kubwa.
- Ubadilikaji wa manifold: Kutofanana kwa kijiolojia, mabadiliko ya kipenyo cha kisima na anisotropy ya miamba vinaweza kupanua, kusawazisha au kugawanya vilele halisi vya kifizikia katika sehemu kadhaa.
Kwa hiyo mantiki ya “chagua pointi tatu za juu zaidi” pekee si ya kuaminika. Wimbi halisi la S lenye amplitudo ndogo linaweza kupitwa, au kilele chembamba sana cha kelele kinaweza kudhaniwa kuwa wimbi la kifizikia.
Mlinganyo (2): Jirani ya juu zaidi upande wa kushoto iko wapi?
\[ l_i=\max\{\,l\mid l<i,\ f_l>f_i\,\} \tag{2} \]
\(f_i=\rho(s_i)\) ni thamani ya mshikamano katika sampuli ya \(i\)-th ya slowness. \(l_i\) hufafanua mpaka halali wa karibu zaidi ulio upande wa kushoto wa mgombea wa \(i\)-th na wenye mshikamano mkubwa kuliko \(f_i\). Kihisabati, kwa kuwa faharasa ya maksimumu huchaguliwa, pointi ya juu iliyo karibu zaidi upande wa kushoto wa mgombea hupatikana.
Mlinganyo (3): Upana wa ujirani wa kushoto
\[ W_L(i)=s_i-s_{l_i+1}. \tag{3} \]
\(W_L(i)\) hupima urefu wa kipindi cha slowness ambacho pointi mgombea hubaki ikitawala upande wa kushoto. Kitengo chake ni sawa na cha \(s\); katika mifano ya utafiti ni µs/ft.
Mlinganyo (4): Jirani ya juu zaidi upande wa kulia iko wapi?
\[ r_i=\min\{\,r\mid r>i,\ f_r>f_i\,\} \tag{4} \]
\(r_i\) hufafanua pointi ya karibu zaidi upande wa kulia wa mgombea yenye thamani ya mshikamano kubwa kuliko \(f_i\). Sababu ya kutumia faharasa ya maksimumu upande wa kushoto na minimumu upande wa kulia ni kupata jirani ya juu iliyo karibu zaidi na mgombea katika pande zote mbili.
Mlinganyo (5): Upana wa ujirani wa kulia
\[ W_R(i)=s_{r_i-1}-s_i. \tag{5} \]
\(W_R(i)\) ni kipindi cha utawala wa kimuundo wa mgombea upande wa kulia na pia kina kitengo cha µs/ft.
Kwa nini minimumu inatumika badala ya jumla au maksimumu?
Chanzo kinalinganisha namna tatu za kuunganisha:
\[ W_{\mathrm{sum}}(i)=W_L(i)+W_R(i) \]
\[ W_{\mathrm{max}}(i)=\max\{W_L(i),W_R(i)\} \]
\[ W_{\mathrm{min}}(i)=\min\{W_L(i),W_R(i)\}. \]
Sampuli kwenye mteremko unaopanda au kushuka wa kilele kikubwa cha kifizikia inaweza kuwa na ujirani mpana sana upande mmoja na karibu upana sifuri upande mwingine. Jumla au maksimumu inaweza kuupa thawabu kubwa kupita kiasi upana huu wa upande mmoja. Minimum pooling hulazimisha pande zote mbili kuwa na nguvu.
Mlinganyo (6): Neighborhood Width ghafi
\[ W(i)=\min\{W_L(i),W_R(i)\}. \tag{6} \]
Mlinganyo huu ndio kiini cha NWT. Ikiwa maksimumu halisi ya ndani inatawala umbali wenye maana katika pande zote mbili kabla ya kufikia thamani iliyo juu zaidi, \(W(i)\) huongezeka. Ikiwa pointi ya bega au mwiba mwembamba wa kelele ni mpana upande mmoja tu, upande mdogo huchaguliwa na operesheni ya minimum na \(W(i)\) hupungua.
Kwa nini vilele bandia katika eneo la slowness ya juu vinaadhibiwa tofauti?
Katika matumizi ya vitendo, ili wimbi la Stoneley lisikatwe, kikomo cha juu cha kipindi cha slowness kinaweza kupanuliwa hadi thamani kubwa kama 400 µs/ft. Matokeo yake, sehemu ndefu, tambarare kiasi na isiyo halali kifizikia inaweza kuunda mwishoni mwa mfululizo. Vinundu vidogo vya nasibu katika maeneo haya vinaweza kupata \(W(i)\) kubwa kwa njia bandia kwa sababu hakuna thamani iliyo juu zaidi karibu navyo.
Chanzo kwa hiyo huongeza fidia ya slowness inayotegemea nafasi badala ya kutumia kizingiti thabiti cha amplitudo.
Mlinganyo (7): Slowness-Compensated Neighborhood-Width Transform
\[ S(i) = f(i)\cdot \frac{W(i)}{s_i}\cdot \frac{s_N+s_1}{s_N-s_1}. \tag{7} \]
Mlinganyo unaunganisha taarifa tatu:
- \(f(i)\): nguvu ya mshikamano/amplitudo ya mgombea;
- \(W(i)\): uthabiti wa kimuundo wa pande mbili wa mgombea;
- \(1/s_i\): fidia inayopunguza vilele bandia vya hatua za baadaye katika eneo la slowness ya juu;
- \((s_N+s_1)/(s_N-s_1)\): kipengele cha normalization kinachotumiwa kwa kipindi kizima cha slowness.
Kwa kuwa \(W(i)\) na \(s_i\) vina kitengo sawa cha slowness, \(W(i)/s_i\) haina kipimo. Kipengele cha mwisho cha normalization pia hakina kipimo. Kwa kuwa mshikamano \(f(i)\) pia hauna kipimo, \(S(i)\) ni alama ya pamoja ya umuhimu isiyo na kipimo.
Kwa sababu ya neno \(1/s_i\), kadiri \(s_i\) inavyoongezeka, ikiwa kiasi vingine vinabaki sawa, alama huwa na mwelekeo wa kupungua. Utaratibu huu unakusudia kuzuia matukio ya kelele katika mkia wa slowness ya juu kutawala kwa sababu tu yana ujirani mpana.
Mlinganyo (8): Kikomo cha normalization kwa nusu ya kwanza ya mfululizo
\[ \begin{aligned} \frac{S(i)}{f(i)} &= \frac{s_N+s_1}{s_N-s_1} \frac{W(i)}{s_i}\\ &\leq \frac{s_N+s_1}{s_N-s_1} \frac{W_L(i)}{s_i}\\ &\leq \frac{s_N+s_1}{s_N-s_1} \frac{s_i-s_1}{s_i}\\ &= \frac{s_N+s_1}{s_N-s_1} \left(1-\frac{s_1}{s_i}\right)\\ &\leq \frac{s_N+s_1}{s_N-s_1} \left(1-\frac{2s_1}{s_N+s_1}\right) =1, \qquad i\leq \frac{N}{2}. \end{aligned} \tag{8} \]
Kwa mlolongo huu, chanzo kinaonyesha kuwa katika nusu ya kwanza ya mfululizo, kizidishi cha kimuundo kilichonormalishwa kwa slowness hakizidi 1. Kwa sababu ya minimum pooling, \(W(i)\leq W_L(i)\), na upana wa kushoto unaweza kuenea zaidi hadi mpaka wa mwanzo.
Mlinganyo (9): Kikomo cha normalization kwa nusu ya pili ya mfululizo
\[ \begin{aligned} \frac{S(i)}{f(i)} &= \frac{s_N+s_1}{s_N-s_1} \frac{W(i)}{s_i}\\ &\leq \frac{s_N+s_1}{s_N-s_1} \frac{W_R(i)}{s_i}\\ &\leq \frac{s_N+s_1}{s_N-s_1} \frac{s_N-s_i}{s_i}\\ &= \frac{s_N+s_1}{s_N-s_1} \left(\frac{s_N}{s_i}-1\right)\\ &\leq \frac{s_N+s_1}{s_N-s_1} \left( \frac{2s_N}{s_N+s_1}-1 \right) =1, \qquad i>\frac{N}{2}. \end{aligned} \tag{9} \]
Katika nusu ya pili, wazo hilo hilo hutumika kupitia upana wa ujirani wa kulia. Mlinganyo (8) na (9) kwa pamoja hutolewa na chanzo kama msingi wa kihisabati wa kutumia alama ya SCNWT kwa unyeti uliosawazishwa katika manifold nzima.
Kwa nini hatua ya pili inahitajika?
Mkunjo wa \(S(i)\) katika hatua ya kwanza unatathmini pamoja amplitudo, ujirani wa kimuundo na nafasi ya slowness. Hata hivyo chanzo hutumia kichujio kingine cha kimuundo: \(S(i)\) sasa hushughulikiwa kama ishara mpya na NWT huendeshwa tena. Kwa hiyo haitoshi alama ya kwanza kuwa kubwa; mgombea lazima pia awe mwenye kutawala kimuundo ndani ya mkunjo wa alama ya kwanza.
Mlinganyo (10): Mpaka wa kushoto katika hatua ya pili
\[ \mathcal{L}_i = \max \{ \mathcal{L}\mid \mathcal{L}<i,\, S_{\mathcal{L}}>S_i \}. \tag{10} \]
\(\mathcal{L}_i\) hufafanua mpaka wa kushoto ulio karibu zaidi katika mkunjo wa combined-significance wenye thamani kubwa kuliko \(S_i\). Wakati Mlinganyo (2) wa hatua ya kwanza unafanya kazi kwenye mshikamano \(f\), Mlinganyo (10) sasa unafanya kazi kwenye mkunjo uliobadilishwa wa \(S\).
Mlinganyo (11): Upana wa kushoto wa hatua ya pili
\[ \mathcal{W}_{L}(i) = s_i-s_{\mathcal{L}_i+1}. \tag{11} \]
Thamani hii ni umbali wa utawala wa kimuundo upande wa kushoto katika hatua ya pili.
Mlinganyo (12): Mpaka wa kulia wa hatua ya pili
\[ \mathcal{R}_i = \min \{ \mathcal{R}\mid \mathcal{R}>i,\, S_{\mathcal{R}}>S_i \}. \tag{12} \]
\(\mathcal{R}_i\) hufanya operesheni hiyo hiyo kwa upande wa kulia.
Mlinganyo (13): Upana wa kulia wa hatua ya pili
\[ \mathcal{W}_{R}(i) = s_{\mathcal{R}_i-1}-s_i. \tag{13} \]
Kiasi hiki pia ni upana wa ujirani wa kulia wa hatua ya pili katika µs/ft.
Mlinganyo (14): Refined neighborhood width
\[ \mathcal{W}(i) = \min \{ \mathcal{W}_{L}(i), \mathcal{W}_{R}(i) \}. \tag{14} \]
Mantiki ileile ya minimum-pooling ya hatua ya kwanza hudumishwa. Lengo ni kuzuia miundo midogo ya sekondari iliyo wazi katika upande mmoja tu kupata prominence.
Mlinganyo (15): Jibu la mwisho la prominence
\[ \mathcal{P}(i) = S(i)\cdot \frac{\mathcal{W}(i)} {(s_N-s_1)/2}. \tag{15} \]
\(\mathcal{P}(i)\) ni alama ya mwisho ya uteuzi wa kilele. \(\mathcal{W}(i)\) kwenye numerator iko katika kitengo cha slowness; \((s_N-s_1)/2\) kwenye denominator pia ina kitengo hicho hicho, kwa hiyo uwiano hauna kipimo. Kwa kuwa \(S(i)\) tayari haina kipimo, \(\mathcal{P}(i)\) pia hubaki bila kipimo.
Katika hatua ya pili, adhabu ya slowness ya \(1/s_i\) haitumiki tena. Chanzo kinatoa sababu mbili: adhabu ya high-slowness tayari ilitumika katika hatua ya kwanza ya SCNWT; pia, kurudia adhabu hiyo kunaweza kukandamiza kupita kiasi kilele cha Stoneley, ambacho kwa asili kiko katika eneo la slowness ya juu zaidi.
Hatimaye, wagombea wenye \(\mathcal{P}(i)>0\) hupangwa kwa thamani ya prominence inayopungua, wagombea watatu wenye nguvu zaidi huchukuliwa, na viratibu vya slowness hupangwa kutoka ndogo hadi kubwa na kupewa mawimbi ya P, S na ST.
Mbinu na Matokeo ya Utafiti
Algorithm 1: Mantiki ya hatua kwa hatua ya mchakato wa SCNWT
- Kwa kila \(s_i\), mshikamano \(f_i=\rho(s_i)\) huchukuliwa.
- Upande wa kushoto, hurudiwa nyuma hadi thamani ya kwanza inayozidi \(f_i\) ipatikane.
- \(W_L(i)\) hukokotolewa.
- Upande wa kulia, husogezwa mbele hadi thamani ya kwanza inayozidi \(f_i\) ipatikane.
- \(W_R(i)\) hukokotolewa.
- Kwa \(W(i)=\min(W_L,W_R)\), upana wa kimuundo wa pande mbili hupatikana.
- Mlinganyo (7) hutumika kukokotoa slowness-compensated combined-significance \(S(i)\).
- Mchakato hurudiwa kwa pointi zote \(N\) katika mfululizo.
Algorithm 2: NWT refinement na uteuzi wa mwisho wa mawimbi
- Mkunjo wa \(S(i)\) kutoka Algorithm 1 hutumiwa kama ishara mpya ya kuingiza.
- Katika kila pointi, mipaka ya majirani ya juu upande wa kushoto na kulia hutafutwa kwa mara ya pili.
- \(\mathcal{W}_L(i)\) na \(\mathcal{W}_R(i)\) hukokotolewa.
- \(\mathcal{W}(i)\) hupatikana kwa minimum pooling.
- Mlinganyo (15) hutumika kukokotoa jibu la prominence \(\mathcal{P}(i)\).
- Wagombea wenye \(\mathcal{P}(i)>0\) hupangwa kwa alama inayopungua.
- Viratibu vya slowness vya wagombea watatu wenye nguvu zaidi huchukuliwa.
- Viratibu hupewa P, S na ST kwa mpangilio wa slowness unaoongezeka.
Data ya uwanjani na sehemu nne ngumu za majaribio
| Kipindi endelevu cha logging | 172.4 m |
|---|---|
| Chanzo | Kisima cha uwanjani nchini China |
| Sehemu ya jaribio la kina | 4 |
| Idadi ya sampuli katika kila sehemu | N = 251 |
| Azimio la sampuli | 1 µs/ft |
| Idadi ya vilele lengwa | K = 3 |
| Mawimbi lengwa | P, S na ST |
| Ground truth | Nafasi za vilele zilizothibitishwa kwa mikono na wataalamu wa binadamu |
- Dataset 1: Mshikamano wa wimbi la S ni mdogo kiasi.
- Dataset 2: Kuna vilele bandia vilivyoshikamana karibu na wimbi la ST na nafasi kati ya modi za mawimbi ni kubwa kiasi.
- Dataset 3: Kuna vilele bandia vilivyoshikamana karibu na wimbi la S na kilele bandia dhahiri upande wa kulia wa wimbi la ST.
- Dataset 4: Kuna kilele bandia dhahiri kati ya mawimbi ya S na ST.
Mbinu saba zilizolinganishwa
| Mbinu | Muundo mkuu uliotumiwa katika chanzo |
|---|---|
| CWT Ridge Analysis | Mexican-hat wavelet, ridge tracking; K ridge zenye nguvu zaidi kulingana na urefu wa ridge na mgawo wa maksimumu. |
| Gaussian Mixture Fitting | Kazi K za Gauss zinalinganishwa kwa Levenberg–Marquardt nonlinear least squares; vituo ni nafasi za vilele. |
| AMPD | Matrix ya local-maximum ya mizani mingi; mizani ya jumla ya chini zaidi ya safu; K vilele vya juu zaidi. |
| SG Derivative Crossing | Savitzky–Golay ya daraja la 3, frame length 11; kuvuka sifuri kuelekea chini katika derivative ya kwanza na K amplitudo za juu zaidi. |
| NMS | K vilele vya juu zaidi kwa sharti la minimum spacing la %10 ya N. |
| Random Forest | Miti 80 ya maamuzi yenye takwimu za ndani kama maksimumu, minimumu, wastani, standard deviation na curvature. |
| 1D U-Net | Encoder-decoder yenye skip connection; mafunzo kwenye ramani za uwezekano za peak-blob za sintetiki. |
Baseline zinazotegemea kujifunza kama Random Forest na 1D U-Net hazikufundishwa upya kwenye sehemu nne halisi za majaribio. Chanzo kilitengeneza seti ya sintetiki ya pre-training kutoka mchanganyiko wa Gaussian wenye vilele vingi kwa nasibu; kikaweka vigezo vilivyojifunzwa bila kubadilika na kuvitumia kwa namna hiyo hiyo katika sehemu zote halisi za majaribio.
Ulinganishaji wa moja kwa moja wa nafasi za vilele
| Mbinu | Dataset 1 | Dataset 2 | Dataset 3 | Dataset 4 | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| sP | sS | sST | sP | sS | sST | sP | sS | sST | sP | sS | sST | |
| CWT | 40.0000 | 62.0000 | 207.0000 | 66.0000 | 217.0000 | 222.0000 | 47.0000 | 106.0000 | 188.0000 | 51.0000 | 63.0000 | 224.0000 |
| GaussFit | 60.2457 | 115.7970 | 201.0158 | 140.2564 | 199.5528 | 213.5319 | 48.8805 | 91.3863 | 113.8091 | 107.9682 | 208.4278 | 222.1249 |
| AMPD | 47.0000 | 48.0000 | 49.0000 | 236.0000 | 253.0000 | 254.0000 | 40.0000 | 41.0000 | 42.0000 | 44.0000 | 45.0000 | 46.0000 |
| SG | 59.0000 | 119.0000 | 201.0000 | 141.0000 | 201.0000 | 215.0000 | 50.0000 | 93.0000 | 112.0000 | 57.0000 | 111.0000 | 220.0000 |
| NMS | 59.0000 | 65.0000 | 199.0000 | 141.0000 | 200.0000 | 216.0000 | 50.0000 | 90.0000 | 94.0000 | 107.0000 | 214.0000 | 221.0000 |
| RF | 55.0000 | 65.0000 | 195.0000 | 67.0000 | 137.0000 | 197.0000 | 47.0000 | 52.0000 | 90.0000 | 43.0000 | 97.0000 | 224.0000 |
| U-Net | 58.4314 | 187.8431 | 201.5686 | 139.8039 | 199.6078 | 214.3137 | 51.5686 | 90.7843 | 114.3137 | 56.4706 | 109.4118 | 218.2353 |
| NWT Iliyopendekezwa | 59.0000 | 119.0000 | 199.0000 | 70.0000 | 141.0000 | 216.0000 | 50.0000 | 94.0000 | 191.0000 | 58.0000 | 107.0000 | 221.0000 |
| Ground Truth | 59 | 119 | 199 | 70 | 141 | 216 | 50 | 94 | 191 | 58 | 107 | 221 |
Mbinu iliyopendekezwa ilitoa kiratibu sawa cha slowness na ground truth katika kila moja ya nafasi tatu lengwa katika seti nne za data. Kwa hiyo metriksi zote za makosa hapa chini ni sifuri kwa sehemu hizi nne zilizochaguliwa.
Metriksi za mafanikio na makosa zilikokotolewaje?
Success Rate (SR) ni asilimia ya ugunduzi ambao kosa kamili la nafasi ya kilele hubaki ndani ya kikomo fulani. Utafiti hutumia mipaka mitatu: ≤5 µs/ft kwa SR5, ≤10 µs/ft kwa SR10 na ≤15 µs/ft kwa SR15.
\[ MAE= \frac{1}{K} \sum_{i=1}^{K} \left| p_i^{*}-\hat p_i \right| \]
MAE ni wastani wa tofauti kamili kati ya nafasi za vilele zilizotabiriwa na halisi. Kitengo chake ni µs/ft.
\[ RMSE= \sqrt{ \frac{1}{K} \sum_{i=1}^{K} \left( p_i^{*}-\hat p_i \right)^2 } \]
RMSE huadhibu makosa makubwa ya localization kwa nguvu zaidi kuliko MAE kutokana na neno la mraba. Kitengo chake pia ni µs/ft.
\[ MRE= \frac{1}{K} \sum_{i=1}^{K} \frac{ \left|p_i^{*}-\hat p_i\right| }{ p_i^{*} }. \]
MRE hugawanya kosa kwa thamani halisi ya slowness na huripotiwa kwa asilimia katika jedwali la matokeo la chanzo.
Matokeo ya kiasi katika seti nne za data
| Mbinu | SR5 (%) | SR10 (%) | SR15 (%) | MAE (µs/ft) | RMSE (µs/ft) | MRE (%) | MAE* (µs/ft) | RMSE* (µs/ft) | MRE* (%) |
|---|---|---|---|---|---|---|---|---|---|
| CWT | 33.33 | 50.00 | 66.67 | 20.1667 | 31.1689 | 18.45 | 5.7500 | 6.4807 | 5.78 |
| GaussFit | 58.33 | 58.33 | 58.33 | 30.9322 | 47.5557 | 31.31 | 1.9701 | 2.1151 | 1.78 |
| AMPD | 0.00 | 0.00 | 25.00 | 84.3333 | 103.6838 | 67.10 | 12.0000 | 12.1106 | 21.49 |
| SG | 66.67 | 75.00 | 75.00 | 18.3333 | 35.2444 | 16.15 | 1.1111 | 1.6330 | 0.94 |
| NMS | 50.00 | 50.00 | 50.00 | 36.7500 | 53.7843 | 35.68 | 0.6667 | 1.6330 | 0.71 |
| RF | 58.33 | 58.33 | 58.33 | 21.8333 | 36.1040 | 17.52 | 4.4286 | 5.0000 | 4.66 |
| U-Net | 66.67 | 66.67 | 66.67 | 24.1879 | 39.7555 | 21.25 | 2.0392 | 2.1899 | 1.97 |
| NWT Iliyopendekezwa | 100 | 100 | 100 | 0 | 0 | 0 | 0 | 0 | 0 |
Hata thamani ya SR5 ya NWT kuwa %100 haimaanishi tu kwamba ilipata mawimbi matatu “karibu sahihi”; katika sehemu nne zilizojaribiwa, malengo yote yalibaki ndani ya kikomo cha 5 µs/ft. Ukiangalia Jedwali 1 tofauti inaonekana kuwa kubwa zaidi: katika sehemu hizi nne zilizochaguliwa vilele vyote 12 vilipatikana hasa katika kiratibu cha ground-truth.
Hata hivyo, idadi ya sampuli na muundo wa majaribio ni muhimu. Ulinganishaji wa kina wa kiasi wa Jedwali 1–2 unategemea sehemu nne zilizochaguliwa ambazo ni ngumu hasa. Kwa hiyo matokeo ya kosa sifuri hayawezi kujumlishwa kama “kosa sifuri katika visima vyote”.
Tabia iliyoonekana katika kipindi endelevu cha kisima
Kielelezo 6 cha chanzo kinalinganisha kwa kuona wasifu wa ufuatiliaji wa P, S na ST wa baseline saba na mbinu iliyopendekezwa katika kipindi endelevu cha logging. Katika tathmini ya waandishi wa chanzo, mbinu iliyopendekezwa hufuata njia za mawimbi kwa uthabiti zaidi chini ya kelele na vilele vilivyo karibu, huku baadhi ya baseline zikionyesha kuruka kwa vilele na pointi bandia zilizochaguliwa. Kwa sababu viratibu ghafi vya ufuatiliaji kwa kina havikutolewa kama jedwali, katika toleo hili la Verianla hakuna grafu mpya iliyoundwa kwa kusoma data ya nambari kutoka Kielelezo 6.
Kasi ya ukokotoaji
Chanzo kinaripoti kuwa algoritimu nyepesi ya uchanganuzi iliyopendekezwa hufanya kazi kwa takriban 0,7 ms kwa kila ishara kwenye AMD Ryzen AI 9 H 465 with Radeon 880M, 2.00 GHz. NWT haihitaji mafunzo ya modeli wala training set yenye lebo.
Muda huu unahusu tu vifaa na muktadha wa matumizi uliotajwa katika chanzo. Muda huo huo hauhakikishwi kwa prosesa nyingine, mazingira ya programu au urefu tofauti wa ishara.
Hitimisho zinazoungwa mkono na utafiti
- NWT ililinganisha kwa usahihi nafasi za vilele vya P, S na ST na ground truth katika sehemu nne ngumu za uwanja zilizojaribiwa.
- Minimum-pooling ilichaguliwa na chanzo ili kukandamiza mabega ya vilele yanayoonekana mapana upande mmoja tu na pseudo-peak nyembamba.
- Slowness compensation inalenga kupunguza kelele inayoweza kuzalisha neighborhood width kubwa kwa njia bandia katika mkia uliopanuliwa wa high-slowness.
- Hatua ya pili ya NWT huleta tena mbele wagombea wanaotawala kimuundo katika mkunjo wa combined-significance.
- Katika ulinganishaji uliojaribiwa, mbinu iliyopendekezwa ilitoa kiwango cha mafanikio cha juu zaidi na kosa la localization la chini zaidi kuliko baseline zote saba.
- Mbinu haihitaji data za mafunzo na chanzo kinaripoti muda wa takriban 0,7 ms/ishara kwenye vifaa vilivyotumika.
Ujumlishaji na mipaka ambayo utafiti hauungi mkono
- Algoritimu ya sasa hudhani kuwepo kwa modi tatu kamili za mawimbi hai \(s_P,s_S,s_{ST}\).
- Katika formation laini sana, wimbi la S linaweza kufyonzwa kabisa na kubaki kuwasili mbili tu zinazoweza kuonekana; muundo wa sasa wa fixed-K=3 haujarekebishwa moja kwa moja kwa hali hii.
- Mbinu imeundwa kwa mikunjo ya mshikamano ya mwelekeo mmoja; 2B na 3B peak-picking hazijathibitishwa katika utafiti huu.
- Mafanikio ya %100 na kosa sifuri yaliyopatikana katika sehemu nne ngumu hayahakikishi matokeo hayo hayo katika mazingira yote ya kijiolojia.
- Baseline za learning-based zilitumia synthetic Gaussian-mixture pre-training; utaratibu wa data za mafunzo katika ulinganishaji huu si supervised training ya kiwango kikubwa kwenye lebo halisi za uwanjani.
- Chanzo kinapendekeza kupanua mbinu kwenda mass spectrometry, radar na uchanganuzi wa biomedical waveform kama eneo la kazi ya baadaye; mafanikio katika matumizi haya hayajaonyeshwa kwa majaribio katika makala ya sasa.
Maelezo ya Chanzo na Mbinu
Kichwa asili: Neighborhood Width Transform: A Structural Stability Framework for Peak Selection in Noisy 1D Coherence Curves
Waandishi: Sicheng Li; Zhaohui Ye.
Mwandishi anayewajibika: Zhaohui Ye.
Taasisi: Department of Automation, Tsinghua University, Beijing 100084, China.
Jarida: Mathematics.
Mchapishaji: MDPI.
Rekodi ya bibliografia: Mathematics 2026, 14(12), 2156.
DOI: 10.3390/math14122156
Iliwasilishwa: 20 Mei 2026. Ilirekebishwa: 4 Juni 2026. Ilikubaliwa: 9 Juni 2026. Ilichapishwa: 16 Juni 2026.
Academic Editor: Davide Valenti.
Aina ya chanzo: Makala ya utafiti iliyopitiwa na wataalamu; utafiti wa uchakataji wa ishara za kihisabati, array acoustic logging na ukuzaji wa mbinu ya peak-selection.
Leseni: Creative Commons Attribution (CC BY).
Ufadhili: Waandishi wameripoti kuwa utafiti haukupokea ufadhili wa nje.
Upatikanaji wa data: Makala inaeleza kuwa data zilizotumiwa zinapatikana wazi kwenye Zenodo na DOI ya data ni 10.5281/zenodo.20288178.
Mgongano wa maslahi: Waandishi wameripoti kutokuwepo kwa mgongano wa maslahi.
Taarifa ya matumizi ya akili bandia: Katika sehemu ya acknowledgments, waandishi wameripoti kuwa walitumia ChatGPT image-2 wakati wa kuchora muhtasari wa picha na Kielelezo 3 cha usanifu wa jumla; wao wenyewe walikagua na kuhariri matokeo na wakakubali kuwajibika kwa maudhui ya uchapishaji.
Michango ya waandishi: Uundaji wa dhana na metodolojia Sicheng Li na Zhaohui Ye; programu, uchanganuzi rasmi, utafiti, uratibu wa data, rasimu ya kwanza, mapitio/uhariri na uonyeshaji Sicheng Li; uthibitishaji Sicheng Li na Zhaohui Ye; rasilimali, usimamizi, usimamizi wa mradi na upatikanaji wa ufadhili ulifanywa na Zhaohui Ye.
Kikomo kikuu cha kimetodolojia: Usanifu uliochapishwa wa NWT unategemea dhana ya modi tatu hai za P/S/ST na mkunjo wa STC projection wa mwelekeo mmoja. Matokeo ya localization kamilifu katika sehemu nne ngumu za data zilizojaribiwa hayapaswi kujumlishwa kiotomatiki kwa hali tofauti za kijiolojia, vifaa au modi za mawimbi.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *