


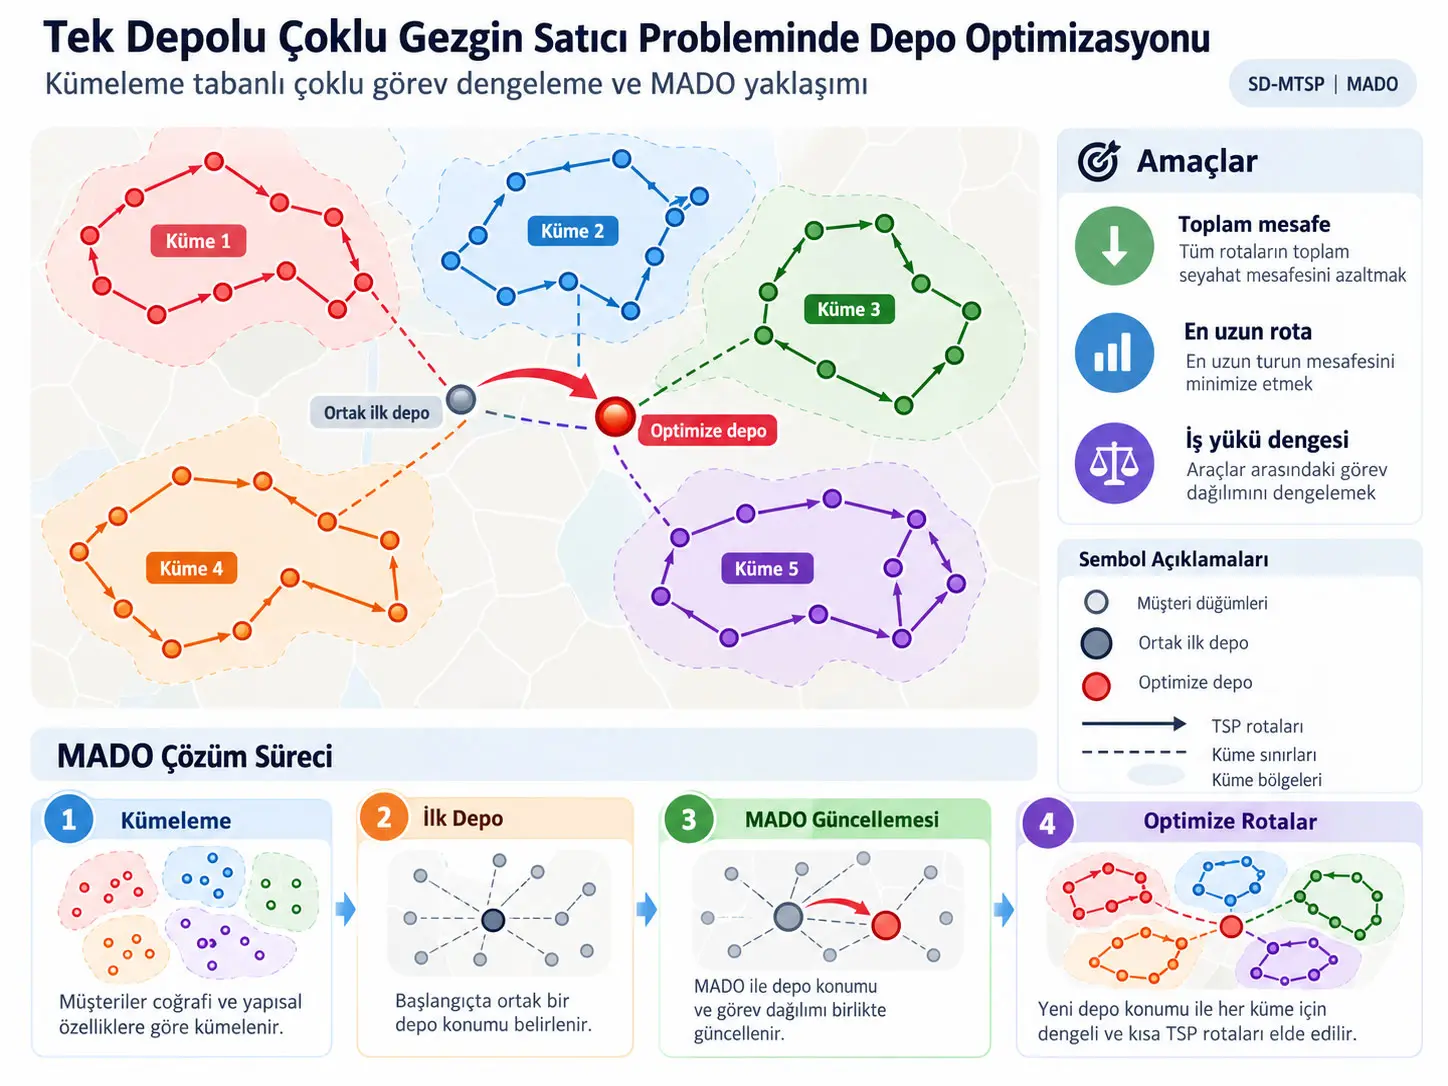
Çok Ağırlıklı Uyarlamalı Depo Optimizasyonu (Multi-Weight Adaptive Depot Optimization, MADO), tek depolu çoklu gezgin satıcı probleminde müşteri düğümlerini kümelere ayıran, her kümeyi bir gezgin satıcıya atayan ve ortak depo konumunu rota verimliliği ile iş yükü dengesini birlikte dikkate alacak şekilde iteratif olarak değiştiren bir optimizasyon yaklaşımıdır. Çalışma, TSPLIB benchmark veri kümeleri üzerinde sekiz farklı kümeleme algoritmasını, OR-Tools tabanlı TSP çözümünü, depo konumu optimizasyonunu ve Total-Sum Distance, Min-Max Distance, Workload Balance, Cluster Separability, Robustness ve Running Time olmak üzere altı performans göstergesini birleştirmektedir.
Yöntemin temel fikri büyük bir SD-MTSP'yi doğrudan tek parça çözmek yerine müşteri düğümlerini kümelere ayırarak daha küçük TSP alt problemlerine bölmektir. Daha sonra ortak depo konumu, kümelerin büyüklüğü ve uzamsal/rota yükünü temsil eden ağırlıklar yardımıyla güncellenir. Her aday depo için küme içi TSP rotaları yeniden çözülür ve yeni konum rota uzunluğu ile denge ölçütlerine göre değerlendirilir.
İlk beş veri seti karşılaştırmasında att48, eil76, gr229, pr299 ve dsj1000 kullanılmıştır. Total-Sum Distance açısından att48'de BIRCH, gr229'da Fuzzy C-Means; eil76, pr299 ve dsj1000'de Bisecting K-Means en düşük değerleri vermiştir. Bu sonuç tek bir kümeleme algoritmasının her veri dağılımında üstün olmadığını göstermektedir.
pr299 vaka çalışmasında başlangıç deposuyla Total-Sum Distance 55.145,51 iken optimize edilmiş depoda 54.533,97'ye; Min-Max Distance 21.130,08'den 20.624,04'e düşmüştür. Kaynak aynı karşılaştırmada Workload Balance değerinin 0,98'den 0,99'a ve Robustness değerinin 0,88'den 0,90'a çıktığını; Cluster Separability'nin 0,24'ten 0,21'e düştüğünü ve çalışma süresinin 7,71 saniyeden 7,87 saniyeye yükseldiğini bildirmektedir.
Daha sonraki altı veri setli ablasyon çalışmasında Full MADO, att48, eil76, gr229, rat575, dsj1000 ve pcb1173 üzerinde Geometric, Midpoint, S-shaped, Node-only MADO ve Route-only MADO yaklaşımlarıyla karşılaştırılmıştır. Kaynak, Full MADO'nun altı örneğin tamamında en düşük veya eşit en düşük Total-Sum Distance; beşinde en düşük veya eşit en düşük Min-Max Distance elde ettiğini bildirmektedir. dsj1000 ve pcb1173'te en iyi statik başlangıç stratejisine göre Total-Sum Distance düşüşü sırasıyla yaklaşık %2,3 ve %1,6 olarak raporlanmıştır.
Bununla birlikte çalışma gerçek dağıtım filosu, gerçek trafik, araç kapasitesi, zaman penceresi veya dinamik sipariş akışı üzerinde saha doğrulaması değildir. Sonuçlar TSPLIB tabanlı hesaplamalı benchmark koşullarında elde edilmiştir. Kaynak ayrıca yöntem tanımının farklı bölümlerinde ağırlık hesabı, küme üyeliklerinin iterasyon sırasında sabit olup olmadığı ve Workload Balance metriğinin yüksek/düşük değerinin yorumlanması konusunda birbiriyle tam uyuşmayan ifadeler içermektedir. Bu nedenle bu noktalar kesinleştirilmiş gibi sunulmamalıdır.
1. Gezgin Satıcı Problemi nedir?
Traveling Salesman Problem (TSP), bir satıcının veya aracın belirli şehirlerin her birini bir kez ziyaret edip başlangıç noktasına dönmesini ve toplam yol maliyetini mümkün olduğunca azaltmasını amaçlayan klasik kombinatoryal optimizasyon problemidir.
Bir rota:
\[ v_1 \rightarrow v_2 \rightarrow \cdots \rightarrow v_n \rightarrow v_1 \]
biçiminde kapalı bir tur oluşturur.
TSP'nin önemli özelliği, çözüm uzayının şehir sayısıyla çok hızlı büyümesidir. \(n\) şehir için olası sıralamaların sayısı faktöriyel büyüme gösterir. Bu nedenle düğüm sayısı yüzler veya binler seviyesine çıktığında bütün rotaları tek tek denemek pratik değildir.
2. MTSP nedir?
Multiple Traveling Salesman Problem (MTSP), TSP'nin birden fazla gezgin satıcı veya operasyon birimi bulunan genişletilmiş biçimidir. Tek bir kişinin bütün noktaları ziyaret etmesi yerine görevler birden fazla satıcı arasında paylaşılır.
Burada yalnız toplam mesafenin kısa olması yeterli olmayabilir. Örneğin dört araçtan üçü kısa rotalarda çalışırken dördüncü araç bütün uzak noktaları taşımak zorunda kalırsa toplam yol kabul edilebilir olsa bile görev dağılımı operasyonel açıdan dengesiz olabilir.
3. SD-MTSP nedir?
Single-Depot Multiple Traveling Salesman Problem (SD-MTSP), bütün gezgin satıcıların aynı ortak depodan başladığı, kendilerine atanan müşteri düğümlerini ziyaret ettiği ve yine aynı depoya döndüğü MTSP türüdür.
Dolayısıyla iki karar birbirine bağlıdır:
- Hangi müşterinin hangi satıcıya atanacağı,
- ortak deponun nerede bulunacağı.
Depo konumu değiştiğinde her satıcının rotasının başlangıç ve bitiş bağlantıları da değişir. Böylece toplam mesafe ve en uzun rota birlikte değişebilir.
4. Depo neden yalnız geometrik merkeze konulmuyor?
Müşteri noktalarının geometrik merkezini almak basit ve hızlıdır; ancak geometrik merkez müşteri kümelerinin kaç düğüm içerdiğini, kümelerin ne kadar yayıldığını veya gerçek TSP rotalarının ne kadar uzun olduğunu doğrudan hesaba katmaz.
Örneğin iki kümenin merkezleri depoya eşit uzaklıkta olsa bile bir kümede 20, diğerinde 100 müşteri bulunabilir. Benzer şekilde aynı sayıda müşteri bulunan iki kümeden biri dar bir alanda, diğeri geniş bir coğrafyada dağılmış olabilir.
MADO'nun temel motivasyonu bu farklılıkları depo güncellemesine ağırlık olarak katmaktır.
5. Kümeleme neden kullanılıyor?
Kümeleme, büyük SD-MTSP problemini daha küçük alt problemlere bölmek için kullanılmaktadır. Her küme bir gezgin satıcıya atanır ve küme içindeki rota ayrı bir TSP olarak çözülür.
Kaynak, statik ve eşit büyüklüklü bir bölme için \(n=k\,m\) varsayımı altında tam ölçekli problemin teorik faktöriyel yapısını:
\[ O(n!) \]
yerine yaklaşık:
\[ O(k\cdot m!) \]
biçiminde düşünmektedir.
Burada:
- \(n\): toplam düğüm sayısı,
- \(k\): küme veya satıcı sayısı,
- \(m=n/k\): küme başına ortalama düğüm sayısıdır.
Bu ifade, büyük problemi küçük TSP'lere ayırmanın teorik motivasyonunu açıklar. Ancak çalışmanın gerçek TSP alt problemleri OR-Tools ile çözülmektedir; dolayısıyla \(O(m!)\) ifadesi kullanılan OR-Tools heuristiğinin gerçek çalışma zamanı karmaşıklığı olarak yorumlanmamalıdır.
6. Çalışmada karşılaştırılan kümeleme algoritmaları
| Algoritma | Temel fikir | Bu çalışmadaki rolü |
|---|---|---|
| Agglomerative | Küçük kümeleri hiyerarşik biçimde birleştirir. | Müşteri düğümlerini satıcılara bölmek. |
| BIRCH | Büyük veri kümelerini özetleyen hiyerarşik küme yapıları kullanır. | Özellikle ölçeklenebilir kümeleme alternatifi. |
| Bisecting K-Means | Kümeleri ardışık olarak ikiye bölerek hedef küme sayısına ulaşır. | Orta ve büyük veri setlerinde güçlü rota sonuçları vermiştir. |
| Fuzzy C-Means | Bir noktanın birden fazla kümeye üyelik derecesi taşımasına izin verir. | Alternatif yumuşak kümeleme yöntemi. |
| Gaussian Mixture | Veriyi Gauss dağılımlarının karışımı olarak modeller. | Olasılıksal kümeleme karşılaştırması. |
| K-Means | Düğümleri en yakın küme merkezlerine göre iteratif olarak böler. | pr299 vaka çalışmasında kullanılan yöntem. |
| MiniBatch K-Means | K-Means güncellemelerini küçük veri alt kümeleriyle yapar. | Daha düşük hesaplama maliyetli K-Means alternatifi. |
| Spectral Clustering | Benzerlik grafiğinin spektral yapısını kullanır. | Geometrik olarak farklı küme yapıları için karşılaştırma. |
MADO Depo Konumunu Nasıl Güncelliyor?
MADO, ortak depodan her kümenin merkezine yönelen vektörleri kümenin görev büyüklüğü ve uzamsal/rota yükünü temsil eden ağırlıklarla birleştirerek bir depo hareket yönü üretir; ancak kaynakta bu ikinci ağırlığın erken yöntem bölümünde konveks çevre, daha sonraki Route-Feedback MADO akışında ise güncel TSP rota uzunluğu olarak tanımlandığı için iki tarifin aynı matematiksel algoritma olduğu varsayılmamalıdır.
7. İlk depo nasıl seçiliyor?
Kaynakta ilk olarak bütün müşteri düğümlerinin geometrik centroid'i hesaplanır. Bu nokta teorik depo olarak adlandırılır.
Ancak gerçek depo konumunun problemdeki uygun örnek düğümlerinden biri olması istendiğinden teorik centroid'e en yakın örnek noktası seçilir ve ilk gerçek depo konumu olarak kullanılır.
8. Denklem (1): Erken MADO ağırlıklı yön vektörü
Kaynak yöntem bölümündeki Denklem (1):
\[ V= \frac{N(C_1)}{N}\frac{L_1}{L}V_1+ \frac{N(C_2)}{N}\frac{L_2}{L}V_2+ \cdots+ \frac{N(C_n)}{N}\frac{L_n}{L}V_n \tag{1} \]
Burada:
- \(V\): deponun toplam durum/konum değiştirme vektörü,
- \(N\): toplam müşteri düğümü sayısı,
- \(N(C_i)\): \(i\). kümedeki müşteri düğümü sayısı,
- \(L_i\): bu erken tanımda \(i\). kümenin konveks çevresi,
- \(L\): bütün kümelerin konveks çevrelerinin toplamı,
- \(V_i\): mevcut depodan \(i\). kümenin merkezine yönelen vektördür.
\(N(C_i)/N\) ve \(L_i/L\) boyutsuz oranlardır. Bu iki oran çarpıldığında ortaya yine boyutsuz bir ağırlık çıkar. Bu ağırlık \(V_i\) konum vektörüyle çarpıldığı için sonuç \(V\), konum koordinatlarıyla aynı boyuta sahip olur.
Düğüm oranı büyük olduğunda çok sayıda göreve sahip kümenin depo üzerindeki etkisi artar. Konveks çevre oranı büyük olduğunda uzamsal olarak daha geniş yayılmış kümenin etkisi artar.
Kaynak özellikle gerçek TSP rota uzunluğunu bu erken formülde kullanmamasının gerekçesini, rota uzunluğunun depo konumuna zaten bağlı olması ve bunun güncelleme sırasında döngüsel bağımlılığı artırabilmesi olarak açıklamaktadır.
9. Denklem (2): Yeni depo
\[ Updated\_depot = Last\_depot + V \tag{2} \]
Bu denklem ağırlıklı yön vektörünün mevcut depo koordinatına eklenmesini ifade eder. \(V\) sıfıra yaklaştıkça önerilen depo hareketi küçülür.
10. Denklem (3): Erken durdurma tanımı
\[ Updated\_depot == Last\_depot \tag{3} \]
Kaynağın erken dört-adımlı tarifinde yeni depo, önceki depoyla aynı örnek düğümüne projekte edilirse algoritma sonlandırılmaktadır.
Fakat daha sonraki Algorithm 1 bundan daha geniş bir durdurma mantığı kullanır: depo değişmiyorsa, adım büyüklüğü çok küçülmüşse, bir döngü veya tekrarlanan durum saptanmışsa ya da maksimum iterasyon sayısına ulaşılmışsa algoritma durur.
11. Kaynağın sonraki Route-Feedback MADO tanımı
Makalenin daha sonraki sekiz aşamalı akışı ve Algorithm 1, güncelleme mekanizmasını farklı biçimde anlatır. Burada kümeler bir kez oluşturulur ve depo optimizasyonu boyunca sabit tutulur. Her iterasyonda ağırlıklar:
- küme düğüm sayısı \(n_i\),
- mevcut depoda hesaplanan TSP rota uzunluğu \(L_i^{(t)}\)
kullanılarak oluşturulur.
Kaynak aynı bölümde aday depo güncellemesini:
\[ p^{(t+1)} = p^{(t)} + s_t \frac{D^{(t)}}{\|D^{(t)}\|_2+\varepsilon} \]
biçiminde verir.
Burada:
- \(p^{(t)}\): \(t\). iterasyondaki depo koordinatı,
- \(D^{(t)}\): sentezlenmiş depo güncelleme yönü,
- \(\|D^{(t)}\|_2\): yön vektörünün Öklid normu,
- \(s_t\): adaptif etkin adım büyüklüğü,
- \(\varepsilon\): sıfıra bölme veya çok küçük norm problemi için kullanılan tolerans terimidir.
Vektörün normuna bölünmesi yön bilgisini büyük ölçüde normalize eder; gerçek hareket büyüklüğünü \(s_t\) belirler.
Ancak kaynak \(T_{max}\), \(\varepsilon\) ve başlangıç adımı \(\eta_0\) için sayısal değer vermemektedir. Aday kabulünde “önceden tanımlanmış lexicographic objective” kullanıldığı söylenmekte, fakat bu lexicographic kabul kuralının tam matematiksel öncelik sırası ayrı bir denklem halinde raporlanmamaktadır.
12. İki yöntem tarifinin farkı neden önemli?
Konveks çevre yalnız kümenin geometrik yayılımına bağlıdır ve depo hareket ettikçe doğrudan değişmez. TSP rota uzunluğu ise mevcut depo konumuna bağlıdır ve her depo değişiminden sonra yeniden hesaplanabilir.
Dolayısıyla:
Düğüm sayısı + konveks çevre
ile:
Düğüm sayısı + güncel TSP rota uzunluğu
aynı optimizasyon kuralı değildir.
Kaynak Table 6 ablasyonunda “Node-only”, “Route-only” ve “Full MADO” ifadelerini kullandığı ve tartışmada route-length teriminin gerçek routing burden bilgisini sağladığını açıkladığı için bu sonraki deneyler route-feedback tarifine aittir. Buna rağmen yayımlanan erken Denklem (1) korunmalı ve yok sayılmamalıdır.
13. Kümeler yeniden oluşturuluyor mu?
Kaynak burada da iki farklı anlatım içerir. Erken dört-adımlı bölüm, yeni teorik depo belirlendikten sonra “cluster the dataset again” ifadesini kullanır. Buna karşılık daha sonraki Şekil 2 açıklaması ve Algorithm 1, clustering'in bir kez gerçekleştirildiğini ve küme üyeliklerinin depo optimizasyonu boyunca sabit kaldığını açıkça söyler.
Bu nedenle Verianla, kaynağın bu iki anlatımından birini sessizce silerek algoritmayı yeniden tanımlamamaktadır. Yeniden üretilebilir bir uygulamada hangi varyantın esas alınacağının ayrıca netleştirilmesi gerekir.
14. Döngü önleme ve durdurma
Depo adayı sürekli uygun müşteri düğümlerine projekte edildiğinde algoritma iki veya daha fazla düğüm arasında gidip gelebilir. Kaynak bunu önlemek amacıyla:
- ziyaret edilmiş depo durumlarının hash ile kaydedilmesi,
- tekrarlanan durum algılama,
- iki-durumlu kalıcı döngü algılama,
- projection stall algılama,
- aday iyileşme sağlamazsa adım küçültme/rejection damping,
- minimum displacement,
- maksimum iterasyon sınırı
gibi güvenlik mekanizmaları tanımlar.
Yazarlar bu mekanizmaların algoritmanın pratikte sonlu sayıda iterasyonda durmasını sağladığını belirtmektedir. Ancak kaynak açıkça küresel optimuma yakınsama garantisi vermemektedir.
15. Böl-ve-yönet karmaşıklığı
Kaynağın tam MADO çerçevesi için verdiği genel karmaşıklık ifadesi:
\[ O\left( nkI_c+ T\left(n+k\,f(m)\right) \right) \]
şeklindedir.
Burada:
- \(n\): toplam düğüm sayısı,
- \(k\): küme sayısı,
- \(I_c\): kümeleme yönteminin iç iterasyon sayısı,
- \(T\): MADO depo güncelleme iterasyonu sayısı,
- \(m=n/k\): küme başına ortalama düğüm sayısı,
- \(f(m)\): \(m\) düğümlü tek bir TSP alt problemini çözme maliyetidir.
Kaynak, \(T\)'nin pratikte küçük bir sabit kaldığını varsayarak depo optimizasyonunun yüksek dereceli ek yük yaratmadığını savunmaktadır. Bununla birlikte \(f(m)\)'nin kullanılan OR-Tools ayarlarına ve çözüm stratejisine bağlı olduğu unutulmamalıdır.
Workload Balance Değeri Nasıl Yorumlanmalıdır?
Kaynağın yayımlanmış hali bu konuda kendi içinde tutarlı değildir: yöntem metni Denklem (7) için daha küçük değeri daha dengeli kabul ederken sonuç bölümü ve tablolar daha yüksek Workload Balance değerini daha iyi denge olarak yorumlamaktadır; bu nedenle belirli bir değerin yönünü kaynağı düzeltiyormuş gibi kesinleştirmek yerine formülü, tablo sonuçlarını ve bu raporlama uyuşmazlığını birlikte görmek gerekir.
16. Denklem (4): Tek kümenin kapalı TSP rota uzunluğu
\[ D_k= \sum_{i=1}^{n-1} d(v_i,v_{i+1}) + d(v_n,v_1) \tag{4} \]
\(D_k\), \(k\). kümeye atanmış satıcının kapalı tur uzunluğudur. \(d(v_i,v_{i+1})\) ardışık iki düğüm arasındaki mesafedir. Son terim son düğümden başlangıç düğümüne dönüşü ekleyerek rotayı kapatır.
17. Denklem (5): Min-Max Distance
\[ D_{\mathrm{Min\_Max}} = \max_{k\in\{1,\ldots,M\}} (D_k) \tag{5} \]
Bu metrik bütün satıcı rotaları içindeki en uzun rotayı seçer. Amaç bu maksimum değeri mümkün olduğunca azaltmaktır.
Örneğin üç rota 100, 105 ve 250 birim ise Min-Max Distance 250'dir. Toplam yol makul olsa bile bir satıcıya 250 birimlik aşırı yük binmiş olabilir. Bu yüzden Min-Max metriği en ağır çalışan birimi kontrol etmek açısından önemlidir.
18. Denklem (6): Total-Sum Distance
\[ D_{\mathrm{Sum}} = \sum_{k=1}^{M}D_k \tag{6} \]
Total-Sum, bütün satıcıların kat ettiği rota uzunluklarını toplar. Daha küçük değer toplam operasyon mesafesinin daha düşük olduğunu gösterir.
Min-Max ve Total-Sum aynı amaç değildir. Bir çözüm toplam mesafeyi biraz artırırken en uzun rotayı ciddi biçimde azaltabilir. MADO'nun çok amaçlı denge problemi bu gerilimden doğmaktadır.
19. Denklem (7) ve (8): Workload Balance
Kaynakta:
\[ balance= \frac{ \frac{1}{M} \sum_{k=1}^{M}(D_k-\bar{D})^2 }{ \max\left((D_k-\bar{D})^2\right) } \tag{7} \]
ve:
\[ \bar{D} = \frac{1}{M} \sum_{k=1}^{M}D_k \tag{8} \]
verilmiştir.
\(\bar D\), bütün rota uzunluklarının ortalamasıdır. Pay, rota uzunluklarının ortalamadan karesel sapmalarının ortalamasıdır. Payda ise karesel sapmaların en büyüğüdür.
Hem pay hem payda mesafenin karesi birimindedir; oran bu nedenle boyutsuzdur.
Ancak bu normalizasyon önemli bir matematiksel sonuç doğurur: bütün sapmalar aynı katsayıyla küçültülür veya büyütülürse pay ve payda aynı katsayının karesiyle değişir ve oran aynı kalabilir. Bu nedenle Denklem (7), rota farklarının mutlak büyüklüğünü tek başına ölçen klasik varyans veya standart sapma değildir.
Tam eşit rotalarda bütün \(D_k-\bar D\) değerleri sıfır olduğundan yayımlanan formül teorik olarak \(0/0\) durumuna gelir. Kaynak bu sınır durumu için ayrı tanım vermemektedir.
Yöntem açıklaması “küçük değer = daha dengeli” derken, Figure 3 açıklaması “yüksek değer = daha dengeli” demekte ve Table 5'te 0,98 → 0,99 değişimi iyileşme olarak yorumlanmaktadır. Bu nedenle sonuç tablolarındaki Workload Balance değerleri kaynak yazarlarının sonuç bölümündeki yorum yönüyle aktarılmış, fakat formülle metin arasındaki çelişki açık tutulmuştur.
20. Denklem (9) ve (10): Silhouette / Cluster Separability
Kaynak genel silhouette skorunu:
\[ S_{\mathrm{global}} = \frac{1}{M} \sum_{k=1}^{M}S(k) \tag{9} \]
ve tek nokta için silhouette değerini:
\[ S(k) = \frac{b(k)-a(k)} {\max\{a(k),b(k)\}} \tag{10} \]
biçiminde verir.
\(a(k)\), noktanın kendi kümesindeki diğer noktalara ortalama uzaklığıdır. Küme içi noktalar birbirine yakınsa \(a(k)\) küçülür.
\(b(k)\), noktanın diğer kümelerin her birine olan ortalama uzaklıkları arasındaki en küçük değerdir. Diğer kümeler iyi ayrılmışsa \(b(k)\) daha büyük olabilir.
Silhouette değeri −1 ile +1 arasındadır:
- +1'e yaklaşmak: daha kompakt ve daha iyi ayrılmış küme,
- 0 civarı: kümelerin sınırında veya örtüşmeye yakın yapı,
- negatif değer: noktanın başka kümeye daha yakın olabileceğini düşündüren yapı.
Kaynakta dsj1000 veri setinin belirgin kümelenmiş mekânsal yapısı nedeniyle en yüksek separability değerlerini gösterdiği belirtilmektedir.
21. Denklem (11) ve (12): Robustness
Kaynak stabilite ölçütünü:
\[ CV = 1- \frac{ \sqrt{ \frac{1}{T} \sum_{t=1}^{T} \left( D_{\mathrm{Min\_Sum}}^{t} - \overline{D}_{\mathrm{Min\_Sum}} \right)^2 } }{ \overline{D}_{\mathrm{Min\_Sum}} } \tag{11} \]
ve ortalama değeri:
\[ \overline{D}_{\mathrm{Min\_Sum}} = \frac{1}{T} \sum_{t=1}^{T} D_{\mathrm{Min\_Sum}}^{t} \tag{12} \]
olarak tanımlar.
Kesrin içindeki yapı standart sapmanın ortalamaya oranına benzer. Kaynak bunun başına \(1-\) eklediği için değişkenlik küçüldükçe skor 1'e yaklaşır. Dolayısıyla burada “CV” adı kullanılmış olsa da yayımlanan ölçüt klasik coefficient of variation'ın kendisi değil, 1 eksi normalize edilmiş değişkenlik biçimindeki bir stabilite skorudur.
Kaynak sonuç bölümünde bütün veri setlerindeki ortalama Robustness değerinin yaklaşık 0,81 olduğunu bildirmektedir.
Ancak tekrarlı deney sayısı \(T\)'nin kesin sayısal değeri ve kullanılan random seed kaynak yöntem bölümünde açık olarak raporlanmamıştır.
22. Denklem (13): Çalışma süresi
\[ T_{\mathrm{abs}} = t_{\mathrm{end}} - t_{\mathrm{start}} \tag{13} \]
Bu metrik algoritmanın başlangıcından nihai çözüm çıktısına kadar geçen duvar saati süresidir. Birimi saniyedir.
Kaynak, düğüm sayısı arttıkça çalıştırma süresinin genel olarak yükseldiğini ve deney grafiğinde yaklaşık doğrusal bir eğilim gözlendiğini belirtmektedir. Bu gözlem, teorik karmaşıklığın matematiksel ispatı değildir; raporlanan benchmark koşullarındaki ampirik çalışma zamanı eğilimidir.
Çalışmanın Yöntemi ve Bulguları
23. Veri setleri
İlk ana karşılaştırmada beş TSPLIB benchmark örneği kullanılmıştır:
| Veri seti | Düğüm sayısı | Kaynak sınıflandırması | Küme / satıcı sayısı |
|---|---|---|---|
| att48 | 48 | Küçük | 3 |
| eil76 | 76 | Küçük | 3 |
| gr229 | 229 | Orta | 3 |
| pr299 | 299 | Orta | 3 |
| dsj1000 | 1000 | Büyük | 5 |
pr299 özellikle görsel vaka çalışması için seçilmiştir. Yazarlar bunun orta ölçekli olması, mekânsal yapısının depo konumu etkisini görselleştirmeye uygun olması ve toplam mesafe ile iş yükü dengesi arasındaki ödünleşmeyi göstermesi nedeniyle seçildiğini belirtmektedir.
24. Yazılım altyapısı
Deneyler Python 3.10 ile uygulanmıştır.
Kümeleme algoritmaları:
scikit-learn v1.3.0
ile; TSP alt problemleri:
OR-Tools v9.10
ile çözülmüştür.
Kaynağın sonuç bölümünde 2-opt yerel optimizasyon algoritmasından da söz edilmektedir. Ancak 2-opt'un yöntem zincirindeki tam çağrılma noktası, iterasyon limiti veya arama parametreleri ayrıca raporlanmamıştır.
Kaynak kullanılan CPU/GPU modeli, işletim sistemi, RAM miktarı ve random seed bilgisini raporlamamaktadır. Bu durum çalışma süresi sonuçlarının başka sistemlerde birebir yeniden üretilmesini sınırlar.
25. Sekiz aşamalı ana çözüm akışı
- Girdi: TSPLIB düğüm koordinatları, mesafe bilgisi ve satıcı/küme sayısı \(k\) yüklenir.
- Kümeleme: Düğümler seçilen algoritmayla \(k\) kümeye ayrılır.
- İlk depo: Bütün düğümlerin geometrik centroid'i bulunur ve en yakın uygun düğüme projekte edilir.
- İlk TSP çözümü: Her kümenin başlangıç ve bitiş noktası ortak depo olacak biçimde rota çözülür.
- MADO güncellemesi: Dinamik ağırlıklarla depo güncelleme yönü oluşturulur ve aday depo hesaplanır.
- Yeniden değerlendirme: Aday depo için bütün küme rotaları yeniden çözülür; Total-Sum, Min-Max ve rota dağılımı değerlendirilir.
- Performans değerlendirmesi: Altı metrik hesaplanır.
- Çıktı: Best-so-far depo, rotalar ve performans ölçütleri döndürülür.
26. İlk beş veri setindeki Total-Sum sonuçları
| Veri seti | En düşük değeri veren kümeleme yöntemi | Total-Sum Distance |
|---|---|---|
| att48 | BIRCH | 41.226,85 |
| eil76 | Bisecting K-Means | 578,87 |
| gr229 | Fuzzy C-Means | 1.848,42 |
| pr299 | Bisecting K-Means | 50.757,05 |
| dsj1000 | Bisecting K-Means | 20.512.000,79 |
Bisecting K-Means özellikle eil76, pr299 ve dsj1000'de Total-Sum bakımından en düşük sonucu vermiştir. Buna rağmen att48 ve gr229'da farklı algoritmaların daha iyi olması, kümeleme yönteminin veri dağılımına bağımlı olduğunu gösterir.
27. İlk beş veri setindeki Min-Max sonuçları
| Veri seti | En düşük değeri veren kümeleme yöntemi | Min-Max Distance |
|---|---|---|
| att48 | Gaussian Mixture | 13.251,51 |
| eil76 | BIRCH | 203,95 |
| gr229 | Agglomerative | 802,58 |
| pr299 | Agglomerative | 19.416,89 |
| dsj1000 | Bisecting K-Means | 7.549.732,68 |
Bu tablo ile Total-Sum tablosunun kazananları aynı değildir. Bu durum toplam operasyon mesafesini azaltmak ile tek bir satıcıya düşen en uzun rotayı azaltmanın farklı hedefler olduğunu doğrudan göstermektedir.
28. Workload Balance, separability ve robustness grafiklerinin ana mesajı
Kaynak Figure 3'te Workload Balance değerlerinin çoğunun yüksek seviyede olduğu ve bütün algoritma/veri seti kombinasyonlarında ortalamanın yaklaşık 0,95 olduğu belirtilmektedir. Daha önce açıklanan formül-yön çelişkisi nedeniyle bu grafiğin yorumu sonuç bölümünde kullanılan “yüksek değer daha iyi” yönüyle aktarılmaktadır.
Figure 4'te Cluster Separability veri setine güçlü biçimde bağlıdır. dsj1000, belirgin kümelenmiş mekânsal yapısı nedeniyle en yüksek silhouette değerlerini göstermektedir.
Figure 5 için kaynak ortalama Robustness değerini yaklaşık 0,81 olarak bildirmektedir. Ancak bazı algoritmaların belirli veri setlerindeki skorları belirgin biçimde düşmektedir; dolayısıyla ortalama değer tek tek bütün algoritmaların aynı stabiliteyi gösterdiği anlamına gelmez.
29. Radar grafik ve heatmap nasıl yorumlanmalı?
Kaynak altı metriği birlikte göstermek için radar grafikler ve ortalama sıralamalardan oluşan bir heatmap kullanmıştır.
Radar grafik açıklamasında “K-Means en büyük poligon alanına sahiptir” ifadesinden hemen sonra Agglomerative için de “en büyük poligon alanına sahiptir” denmektedir. Aynı bölüm Spectral için hem olumlu hem de “worst comprehensive performance” yönünde birbirine uymayan ifadeler içerir.
Bu nedenle Verianla, radar grafiğinden tek bir evrensel “en iyi algoritma” sonucu çıkarmamaktadır.
Kaynağın heatmap tartışmasının daha temkinli sonucu korunabilir: hiçbir kümeleme algoritması bütün veri setleri ve bütün ölçütlerde mutlak üstün değildir. Algoritma seçimi veri dağılımına ve hangi metriğin önceliklendirildiğine bağlıdır.
30. pr299 vaka çalışması
pr299, K-Means ile üç kümeye ayrılmıştır. Kaynak Şekil 9–14 dizisi:
- orijinal düğüm dağılımını,
- başlangıç deposunun seçimini,
- üç kümenin oluşumunu,
- ilk TSP rotalarını,
- MADO ile depo konumunun taşınmasını,
- yeni depodan çözülen son rotaları
göstermektedir.
Kaynak bu grafiklerin bütün koordinat ve rota düğüm sıralarını metin/tablo halinde vermediği için Verianla içinde sahte bir pr299 rota haritası yeniden çizilmemiştir.
| Metrik | Başlangıç deposu | Optimize depo | Kaynak yorum yönü |
|---|---|---|---|
| Total-Sum Distance | 55.145,51 | 54.533,97 | Azalma = daha iyi |
| Min-Max Distance | 21.130,08 | 20.624,04 | Azalma = daha iyi |
| Workload Balance | 0,98 | 0,99 | Sonuç bölümünde artış iyileşme olarak yorumlanmış |
| Cluster Separability | 0,24 | 0,21 | Azalmış |
| Robustness | 0,88 | 0,90 | Artmış |
| Running Time | 7,71 s | 7,87 s | Hafif artmış |
Bu vaka çalışması önemli bir çok-amaçlı ödünleşme göstermektedir: rota uzunluğu ve kaynakta kullanılan denge/stabilite göstergeleri iyileşirken cluster separability biraz düşmüş ve çalışma süresi biraz artmıştır.
31. Table 3 ile pr299 vaka sayıları neden birebir aynı değil?
Table 3'te K-Means/pr299 için Total-Sum Distance 53.848,32 olarak verilirken Table 5 vaka çalışmasının optimize depo sonucu 54.533,97'dir. Kaynak bu iki değerin neden farklı olduğunu açık biçimde açıklamamaktadır. K-Means başlangıç koşullarının veya deney prosedürünün farklı tekrarları olası bir açıklama olabilir, ancak kaynak bunu doğrulamadığı için Verianla böyle bir nedeni gerçekmiş gibi atfetmemektedir.
32. Full MADO ablasyonunun amacı
Ablasyon çalışması iki ağırlık bileşeninin görevini ayırmayı amaçlamaktadır:
- Node-only MADO: yalnız küme büyüklüğü,
- Route-only MADO: yalnız rota yükü,
- Full MADO: düğüm sayısı ve rota yükü birlikte.
Yazarların yorumuna göre rota uzunluğu terimi gerçek routing burden bilgisini, düğüm sayısı terimi ise görev ölçeğini ve düzenleyici/dengeleyici etkiyi sağlamaktadır.
33. Table 6'daki tam ablasyon sonuçları
| Veri seti | Strateji | Total-Sum | Min-Max | Workload Balance | Separability | Robustness | Süre (s) |
|---|---|---|---|---|---|---|---|
| att48 | Geometric | 13.881 | 4.962 | 0,877 | 0,402 | 0,823 | 1,253 |
| att48 | Midpoint | 14.745 | 4.962 | 0,877 | 0,402 | 0,823 | 1,253 |
| att48 | S-shaped | 14.037 | 4.263 | 0,750 | 0,402 | 0,823 | 1,187 |
| att48 | Node-only MADO | 13.881 | 4.962 | 0,877 | 0,402 | 0,823 | 1,253 |
| att48 | Route-only MADO | 13.881 | 4.962 | 0,877 | 0,402 | 0,823 | 1,253 |
| att48 | Full MADO | 13.881 | 3.991 | 0,958 | 0,418 | 0,889 | 2,817 |
| eil76 | Geometric | 649 | 217 | 0,809 | 0,313 | 0,803 | 1,806 |
| eil76 | Midpoint | 648 | 216 | 0,805 | 0,314 | 0,816 | 1,752 |
| eil76 | S-shaped | 656 | 217 | 0,809 | 0,313 | 0,803 | 1,704 |
| eil76 | Node-only MADO | 649 | 217 | 0,809 | 0,313 | 0,803 | 1,806 |
| eil76 | Route-only MADO | 649 | 223 | 0,826 | 0,303 | 0,819 | 1,928 |
| eil76 | Full MADO | 648 | 210 | 0,849 | 0,324 | 0,828 | 3,851 |
| gr229 | Geometric | 169.948 | 47.044 | 0,869 | 0,402 | 0,804 | 4,206 |
| gr229 | Midpoint | 191.629 | 57.467 | 0,893 | 0,403 | 0,818 | 4,557 |
| gr229 | S-shaped | 166.952 | 46.178 | 0,878 | 0,412 | 0,858 | 4,353 |
| gr229 | Node-only MADO | 165.944 | 46.145 | 0,888 | 0,423 | 0,318 | 7,812 |
| gr229 | Route-only MADO | 167.868 | 46.271 | 0,861 | 0,403 | 0,824 | 7,506 |
| gr229 | Full MADO | 164.464 | 45.068 | 0,912 | 0,423 | 0,885 | 9,208 |
| rat575 | Geometric | 7.341 | 1.866 | 0,866 | 0,325 | 0,867 | 6,507 |
| rat575 | Midpoint | 7.341 | 1.866 | 0,866 | 0,325 | 0,867 | 6,507 |
| rat575 | S-shaped | 7.516 | 1.944 | 0,821 | 0,315 | 0,887 | 6,203 |
| rat575 | Node-only MADO | 7.268 | 1.865 | 0,827 | 0,334 | 0,888 | 12,014 |
| rat575 | Route-only MADO | 7.268 | 1.866 | 0,827 | 0,334 | 0,888 | 12,014 |
| rat575 | Full MADO | 7.341 | 1.865 | 0,835 | 0,334 | 0,888 | 13,208 |
| dsj1000 | Geometric | 22.716.706 | 8.940.540 | 0,839 | 0,419 | 0,893 | 15,012 |
| dsj1000 | Midpoint | 22.947.417 | 9.224.216 | 0,895 | 0,356 | 0,885 | 16,507 |
| dsj1000 | S-shaped | 22.554.069 | 8.552.881 | 0,811 | 0,404 | 0,858 | 22,038 |
| dsj1000 | Node-only MADO | 22.403.027 | 8.511.387 | 0,811 | 0,404 | 0,858 | 22,038 |
| dsj1000 | Route-only MADO | 22.352.892 | 8.344.442 | 0,803 | 0,419 | 0,886 | 21,506 |
| dsj1000 | Full MADO | 22.204.192 | 8.271.912 | 0,899 | 0,456 | 0,898 | 28,513 |
| pcb1173 | Geometric | 63.590 | 16.358 | 0,825 | 0,342 | 0,887 | 20,012 |
| pcb1173 | Midpoint | 63.642 | 16.393 | 0,827 | 0,326 | 0,889 | 20,508 |
| pcb1173 | S-shaped | 65.591 | 16.962 | 0,825 | 0,342 | 0,887 | 20,012 |
| pcb1173 | Node-only MADO | 63.506 | 16.358 | 0,825 | 0,342 | 0,887 | 20,012 |
| pcb1173 | Route-only MADO | 63.575 | 16.298 | 0,814 | 0,326 | 0,862 | 19,806 |
| pcb1173 | Full MADO | 62.579 | 16.197 | 0,828 | 0,375 | 0,885 | 32,507 |
Bu tablonun önemli sonucu Full MADO'nun her ölçütte ve her veri setinde tek başına mutlak üstün olmadığıdır. Örneğin rat575'te Node-only MADO daha düşük Total-Sum Distance üretirken Full MADO aynı veya daha iyi Min-Max performansını ve farklı bir denge kombinasyonunu sağlar. Benzer biçimde bazı statik yöntemler çalışma süresinde daha hızlıdır.
Dolayısıyla MADO'nun katkısı yalnız “her sütunda en küçük sayı” değildir; rota toplamı, en uzun rota ve kaynakta kullanılan denge göstergesi arasında daha uygun bir uzlaşma aramaktır.
34. Table 3/4 ile Table 6 mesafe ölçekleri neden doğrudan karşılaştırılmamalıdır?
Kaynağın Table 3 ve Table 4 değerleri ile Table 6 değerleri aynı isimli veri setlerinde dahi bazı durumlarda çok farklı sayısal ölçeklere sahiptir. Örneğin gr229 Total-Sum değerleri Table 3'te yaklaşık 1.800–2.300 aralığındayken Table 6'da yaklaşık 164.000–192.000 düzeyindedir.
Kaynak bu fark için mesafe dönüşümü, farklı TSPLIB edge-weight uygulaması veya başka bir preprocessing açıklaması vermemektedir. Bu nedenle Verianla bu tabloları tek ortak sayısal ölçek üzerinde birleştirmemektedir.
35. Ablasyonun bilimsel mesajı
Yazarlar Node-only ile Full MADO'yu karşılaştırdığında rota uzunluğu teriminin yalnız düğüm sayısından görülemeyen gerçek routing-cost bilgisini sağladığını savunmaktadır.
Route-only ile Full MADO karşılaştırmasında ise düğüm sayısı teriminin ölçek telafisi ve düzenleyici etki sağladığı öne sürülmektedir.
gr229 örneğinde Route-only Workload Balance 0,861 iken Full MADO 0,912'ye ulaşmıştır. Kaynak bunu tek bir uzamsal olarak geniş kümenin depoyu aşırı çekmesini düğüm sayısı teriminin sınırlamasıyla ilişkilendirmektedir.
36. Çalışmanın desteklediği sonuçlar
- MADO, test edilen TSPLIB benchmark örneklerinde ortak depo konumunu değiştirerek rota sonuçlarını etkileyebilmektedir.
- pr299 vaka çalışmasında optimize depo daha düşük Total-Sum ve Min-Max Distance üretmiştir.
- Kümeleme algoritması seçimi sonuçları önemli ölçüde değiştirmektedir; tek bir kümeleme yöntemi bütün veri setlerinde üstün değildir.
- Bisecting K-Means ilk beş veri setinin birkaçında Total-Sum açısından güçlü sonuç vermiştir.
- Full MADO, Table 6'daki altı benchmark'ın tamamında minimum veya eşit minimum Total-Sum sonucu elde etmiştir.
- Full MADO özellikle dsj1000 ve pcb1173'te statik başlangıç yöntemlerine göre daha düşük Total-Sum ve Min-Max değerleri sağlamıştır.
- Node-count ve route-length bileşenlerinin ablasyon sonuçları birbirini tamamlayan roller taşıdığı yönündeki yazar yorumunu desteklemektedir.
- Kümeleme temelli böl-ve-yönet yaklaşımı büyük SD-MTSP'nin daha küçük TSP alt problemlerine ayrılmasını sağlar.
37. Çalışmanın doğrudan desteklemediği sonuçlar
- MADO'nun bütün SD-MTSP örneklerinde küresel optimum bulduğu gösterilmemiştir.
- Gerçek zamanlı trafik altında saha doğrulaması yapılmamıştır.
- Dinamik olarak eklenen veya silinen müşteri noktaları deneysel olarak değerlendirilmemiştir.
- Farklı kapasitelerde araçlardan oluşan heterojen filo doğrudan test edilmemiştir.
- Zaman pencereleri ve araç kapasitesi ana benchmark modelinin kısıtları arasında değildir.
- Gerçek lojistik şirketine ait maliyet, yakıt, sürücü çalışma süresi veya teslimat SLA verileri değerlendirilmemiştir.
- Grafiklerdeki yüksek Robustness değeri gerçek saha belirsizliklerine karşı kanıtlanmış dayanıklılık anlamına gelmez.
- Empirik çalışma süresi grafiğinin yaklaşık doğrusal görünmesi algoritmanın bütün koşullarda doğrusal zaman karmaşıklığına sahip olduğunu kanıtlamaz.
- Table 6 sonuçları Table 3/4'ün sayısal ölçeğiyle açıklama olmadan doğrudan birleştirilemez.
38. Kaynağın kendi gelecek çalışma önerileri
Yazarlar yöntemin daha karmaşık dinamik ortamlarda geliştirilmesi gerektiğini belirtmektedir. Önerilen yönler:
- gerçek zamanlı trafik değişikliklerine cevap verebilmek için reinforcement learning veya online optimization eklemek,
- müşteri/görev noktalarının dinamik olarak eklenmesi veya çıkarılmasını ele almak,
- heterojen gezgin/araç tiplerini desteklemek,
- araç kapasitesi gibi gerçek operasyon kısıtlarını eklemek,
- kümeleme ile rota planlama arasındaki ortak optimizasyon mekanizmasını geliştirmek
şeklindedir.
Bu gelecek çalışma önerileri aynı zamanda mevcut makalenin saha uygulanabilirliğine koyduğu sınırı gösterir. Yöntem doğrudan “mühendislikte tamamen doğrulanmış lojistik sistem” seviyesinde değildir; yazarlar da teorik uygulanabilirlikten engineering reliability düzeyine geçiş için ek geliştirme gerektiğini belirtmektedir.
Kaynak ve Yöntem Notu
Özgün başlık: A Clustering-Based Multi-Task Balancing Method for Depot Optimization in Single-Depot Multiple Traveling Salesman Problems
Yazarlar: Chunlong Fu, Jiaxin Zou, Guofang Liu, Pingli Zheng, Kaiwen Xiao, Yang Deng, Hongxia He ve Qi Jiang.
Sorumlu yazar: Chunlong Fu.
Eşit katkı: Kaynakta eşit katkı bildirimi bulunmamaktadır.
Kurum: Department of Computer Science, Sichuan University Jinjiang College, Meishan 620860, China.
Dergi: Mathematics.
Yayınevi: MDPI.
Bibliyografik kayıt: Mathematics 2026, 14(15), 2811.
DOI: 10.3390/math14152811.
Gönderim tarihi: 5 Haziran 2026.
Revizyon tarihi: 18 Temmuz 2026.
Kabul tarihi: 28 Temmuz 2026.
Yayın tarihi: 5 Ağustos 2026.
Resmî bağlantı: DOI 10.3390/math14152811 üzerinden MDPI yayın kaydı.
Kaynak türü: Hakemli bilimsel dergide yayımlanmış özgün araştırma makalesi; kombinatoryal optimizasyon, kümeleme ve rota planlama tabanlı hesaplamalı çalışma.
Preprint durumu: Sağlanan kaynak yayımlanmış dergi sürümüdür. PDF içinde ayrıca bir preprint kimliği bildirilmemektedir.
Lisans: Creative Commons Attribution (CC BY).
Anahtar kelimeler: SD-MTSP; clustering algorithm; task balancing; depot location optimization.
MSC: 05B05; 90B50.
Yazılım: Python 3.10, scikit-learn v1.3.0 ve OR-Tools v9.10.
Benchmark kaynağı: TSPLIB.
İlk ana veri setleri: att48, eil76, gr229, pr299 ve dsj1000.
Ablasyon veri setleri: att48, eil76, gr229, rat575, dsj1000 ve pcb1173.
Değerlendirme metrikleri: Total-Sum Distance, Min-Max Distance, Workload Balance, Cluster Separability, Robustness ve Running Time.
Finansman: Opening Foundation of the State Key Laboratory of Cognitive Intelligence, Anhui iFLYTEK Co., Ltd., Grant No. COGOS-2024HE03; ayrıca Sichuan University Jinjiang College 2024 Young Teacher Research Fund Project, Grant No. QNJJ-2024-B08.
Veri erişilebilirliği: Yazarlar çalışma verilerinin TSPLIB tabanlı olarak açık erişilebilir olduğunu ve Data Availability bölümünde bir GitCode erişim bağlantısı sağladıklarını belirtmiştir.
Çıkar çatışması: Yazarlar çıkar çatışması bildirmemiştir.
Yapay zekâ kullanım bildirimi: Yazarlar makalenin hazırlanması sırasında ChatGPT-5.4'ü dilbilgisi iyileştirmesi ve dil düzenleme amacıyla kullandıklarını; son içeriği kendilerinin gözden geçirip düzenlediklerini ve yayın içeriğinin sorumluluğunu üstlendiklerini bildirmiştir.
Yazar katkıları: Kavramsallaştırma Qi Jiang; yöntem Jiaxin Zou, Chunlong Fu, Pingli Zheng ve Kaiwen Xiao; yazılım Guofang Liu ve Hongxia He; doğrulama Jiaxin Zou, Chunlong Fu ve Hongxia He; biçimsel analiz Guofang Liu ve Yang Deng; araştırma Chunlong Fu; kaynaklar Pingli Zheng ve Qi Jiang; veri kürasyonu Jiaxin Zou, Pingli Zheng ve Kaiwen Xiao; ilk taslak Jiaxin Zou; inceleme ve düzenleme Chunlong Fu; görselleştirme Yang Deng; denetim Chunlong Fu ve Guofang Liu tarafından gerçekleştirilmiştir.
Önemli yöntemsel tutarsızlık 1 — ağırlık tanımı: Erken Denklem (1) düğüm oranı ile konveks çevre oranını kullanır. Daha sonraki Route-Feedback MADO akışı, Algorithm 1 ve Table 6 tartışması düğüm sayısı ile güncel TSP rota uzunluğunu kullanır. Kaynak bu iki tarifi açık bir revizyon ilişkisiyle birbirine bağlamamaktadır.
Önemli yöntemsel tutarsızlık 2 — kümeleme: Erken dört-adımlı açıklama güncellenmiş depo sonrasında yeniden kümelemeden söz ederken, Şekil 2 ve Algorithm 1 küme üyeliklerinin bir kez oluşturulup depo optimizasyonu boyunca sabit tutulduğunu söyler.
Önemli metrik tutarsızlığı — Workload Balance: Denklem (7) öncesindeki açıklama küçük değerlerin daha iyi dengeyi gösterdiğini söyler. Sonuç bölümü, Şekil 3 ve Table 5–6 ise daha yüksek değeri daha iyi olarak yorumlamaktadır. Verianla bu çelişkiyi sessizce düzeltmemiştir.
Veri seti kapsam notu: Section 5.1 beş benchmark örneği tanımlar; Table 6 ise pr299 yerine rat575 ve pcb1173'ü içeren altı örnekli ayrı karşılaştırma kullanır.
Mesafe ölçeği notu: Table 3/4 ve Table 6'da aynı TSPLIB adlarını taşıyan bazı veri setlerinin mesafe büyüklükleri farklı ölçeklerdedir. Kaynak bunun için açık bir dönüşüm veya preprocessing açıklaması vermemektedir; tablolar doğrudan tek ölçekli veri kümesi gibi birleştirilmemiştir.
pr299 sayı notu: Table 3'te K-Means/pr299 Total-Sum Distance 53.848,32 iken vaka çalışmasının Table 5 optimize depo sonucu 54.533,97'dir. Kaynak farkın nedenini açıkça açıklamamaktadır.
2-opt notu: Sonuç bölümünde 2-opt yerel optimizasyonun OR-Tools çözümüne dahil edildiği belirtilmektedir; ancak yöntem bölümünde 2-opt'un ayrıntılı konfigürasyonu verilmemiştir.
Yeniden üretilebilirlik notu: Algorithm 1, \(T_{max}\), \(\varepsilon\) ve başlangıç adımı \(\eta_0\) parametrelerini girdi olarak tanımlar; kaynak bu parametrelerin kullanılan sayısal değerlerini bildirmemektedir. Repeated-experiment sayısı, random seed ve hesaplama donanımı da açık biçimde raporlanmamıştır.
Yakınsama sınırı: Yazarlar global optimum garantisi vermemektedir. State hashing, cycle detection, projection-stall kontrolü ve adım küçültme mekanizmaları iterasyonun pratikte sonlandırılmasını amaçlar.
Gerçek dünya sınırı: Çalışma TSPLIB benchmark doğrulamasıdır. Gerçek lojistik filosu, canlı trafik, araç kapasitesi, zaman penceresi, dinamik müşteri girişi ve heterojen araçlar üzerinde operasyonel saha doğrulaması yapılmamıştır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir