


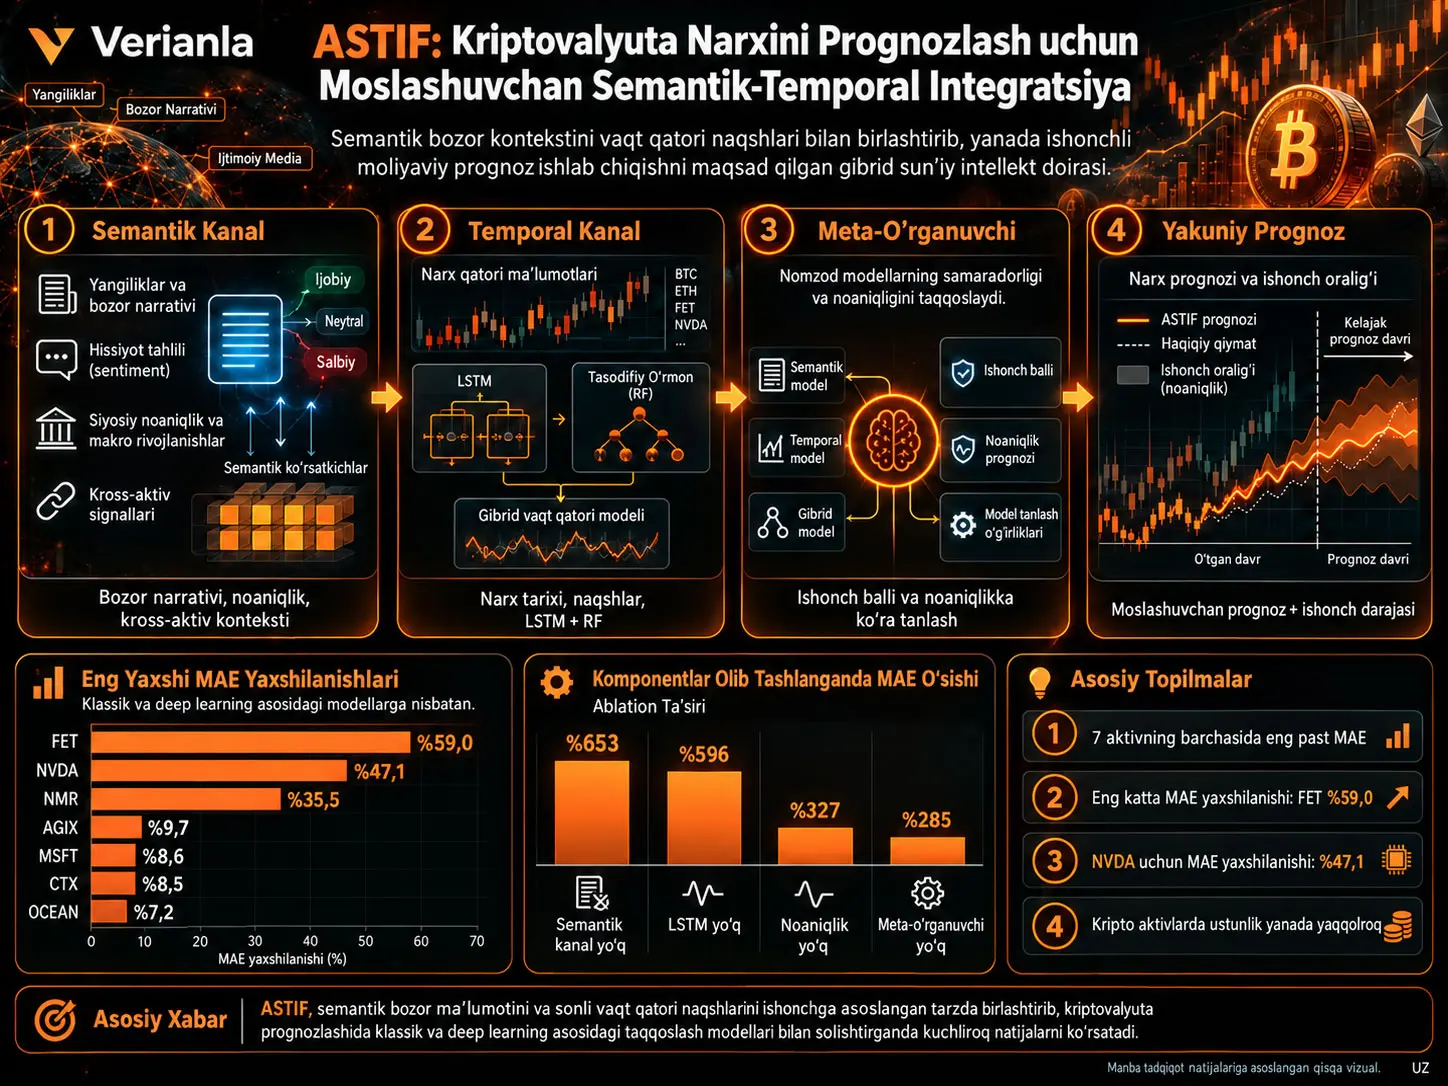
ASTIF — Adaptive Semantic-Temporal Integration Framework — semantik bozor kontekstini va sonli vaqt qatori naqshlarini alohida prognoz kanallarida qayta ishlaydigan, soʻng prognoz ishonchi va noaniqligiga qarab ushbu kanallar oʻrtasida moslashuvchan tanlov qiladigan ierarxik moliyaviy prognozlash arxitekturasidir. Tadqiqot faqat oʻtgan narx harakatlari kriptovalyuta bozoridagi siyosiy noaniqlik, bozor narrativlari, sentiment koʻrsatkichlari va cross-asset munosabatlarini yetarlicha ifodalamasligi mumkinligi muammosidan kelib chiqadi. ASTIF bu muammoni uchta komponent bilan hal qiladi: MirrorPrompt asosidagi Small Language Model semantik prognozlovchi, LSTM–Random Forest gibrid temporal prognozlovchi va ushbu ikki ekspertning ishonchliligini baholaydigan confidence-calibrated meta-learner.
Tajribalar Yanvar 2020–Dekabr 2024 davridagi kunlik ma’lumotlarda oʻtkazilgan. Beshta AI bilan bogʻliq kripto aktiv — FET, AGIX, NMR, OCEAN va CTX — hamda NVIDIA va Microsoft aksiyalari baholangan. Tizim kirishlari faqat maqsad aktiv narxidan iborat emas; Bitcoin, Ethereum, turli token sektorlar, aksiyalar indekslari, tematik ETF’lar, neft, oltin, cross-asset correlation, momentum, SMA/EMA, volatillik, RSI, Bollinger Bands, Global Economic Policy Uncertainty va turli media/sentiment koʻrsatkichlarini qamrab olgan 29 dan ortiq xususiyat ishlatilgan.
Manbaning asosiy taqqoslashiga koʻra ASTIF yetti aktivning barchasida eng past MAE ni bergan. Eng yaxshi baseline modelga nisbatan MAE kamayishi FET uchun %59,0, NVDA uchun %47,1, NMR uchun %35,5, AGIX uchun %9,7, MSFT uchun %8,6, CTX uchun %8,5 va OCEAN uchun %7,2 ni tashkil qiladi. Biroq bu ustunlik barcha xato oʻlchovlarida bir xil emas: Jadval 1 da ASTIF barcha aktivlarda eng past RMSE ni bermaydi. Shu sababli natijani “ASTIF barcha metrikalarda barcha modellarni yengdi” deb talqin qilmaslik kerak.
Ablatsiya tajribalari semantik va temporal kanallarning birgalikda ishlashi muhimligini koʻrsatadi. Manbaning ablatsiya hisobida SLM semantic channel olib tashlanganda oʻrtacha MAE oshishi %653, LSTM komponenti olib tashlanganda %596, uncertainty quantification olib tashlanganda %327 va adaptive meta-learner olib tashlanganda %285 deb xabar qilingan. Shu bilan birga, ushbu ablatsiya boʻlimidagi NMR va FET baseline qiymatlari asosiy performance jadvalidagi ASTIF qiymatlaridan farq qiladi; manba ikki tajriba kontekstini aniq tarzda muvofiqlashtirmaydi.
Tadqiqot real-time kriptovalyuta trading tizimi yoki investitsiya strategiyasi testi emas. Transaction cost, spread, slippage, portfolio return, Sharpe ratio, maximum drawdown yoki real pul P&L baholashi amalga oshirilmagan. Bundan tashqari ishlatilgan ma’lumot tarixiy kunlik ma’lumot boʻlib, manba real-time data feed va breaking-news ma’lumotlari tizimga kiritilmaganini ochiq ravishda cheklov sifatida koʻrsatadi.
ASTIF Nima va Statik Moliyaviy Prognozlash Modellaridan Qanday Farq Qiladi?
ASTIF semantik bozor ma’lumotini qayta ishlaydigan Small Language Model kanali bilan tarixiy sonli naqshlarni qayta ishlaydigan LSTM–Random Forest kanalini bitta prognoz tizimida birlashtiradigan va qaysi kanal ayni paytda ishonchliroq ekanini confidence-calibrated meta-learning orqali hal qiladigan moslashuvchan ensemble arxitekturasidir. Statik ensemble lardan asosiy farqi ikki ekspertga oldindan belgilangan oʻzgarmas vazn berish oʻrniga prognoz ishonchi, noaniqlik, model kelishmovchiligi va bozor kontekstini har bir qaror bosqichida meta-feature sifatida baholashidir.
Tadqiqot hal qilishga urinayotgan muammo
Kriptovalyuta bozorlarida narx shakllanish jarayoni statsionar emas. Bozor xulqi, volatillik darajasi, makroiqtisodiy sharoitlar, regulyator rivojlanishlar, cross-asset munosabatlari va investor xatti-harakatlari vaqt davomida oʻzgarishi mumkin. Shu sababli muayyan davrda muvaffaqiyatli boʻlgan prognozlash usulining boshqa bozor rejimida ayni darajada muvaffaqiyatli boʻlishi kafolatlanmaydi.
Manbaga koʻra mavjud usullarda uchta asosiy boʻshliq ajralib turadi. Birinchidan, koʻplab statistik, deep learning va Transformer modellari prognoz strategiyasini bozor rejimiga qarab oʻzgartirmaydigan statik arxitekturalardan foydalanadi. Ikkinchidan, semantic market information koʻp gibrid tizimlarda faqat bitta sentiment score kabi sonli xususiyat sifatida narx kirishlariga qoʻshiladi. Uchinchidan, semantik va temporal prognozlovchilarning real-time ishonchliligini taqqoslab, qaysi biriga ishonishni aniqlaydigan cross-modal adaptation mexanizmlari cheklangan.
Uchta tadqiqot savoli
| Tadqiqot savoli | Koʻrib chiqilgan mavzu |
|---|---|
| RQ1 | ASTIF an’anaviy machine learning, deep learning va Transformer baseline lariga qarshi prognoz aniqligi va barqarorligi boʻyicha qanday natija koʻrsatadi? |
| RQ2 | Confidence-based meta-learner va uncertainty quantification kabi moslashuvchan komponentlar umumiy natijaga qanchalik hissa qoʻshadi? |
| RQ3 | Ikki kanalli semantic encoding, numeric-only yoki semantic-only yondashuvlardan yaxshiroq natija beradimi? |
ASTIF ning uchta asosiy komponenti
| Komponent | Asosiy vazifa | Chiqish |
|---|---|---|
| MirrorPrompt SLM | Narx ketma-ketligini numeric channel da, bozor kontekstini semantic channel da qayta ishlaydi. | SLM prognozi, confidence va uncertainty. |
| LSTM–Random Forest Temporal Learner | Vaqtga bogʻliq munosabatlar va xususiyatlar oʻzaro ta’sirlarini oʻrganadi. | ML prognozi, model kelishmovchiligiga asoslangan uncertainty va confidence. |
| Confidence-Calibrated Meta-Learner | Har ikki ekspertni confidence, uncertainty va bozor kontekstiga koʻra baholaydi. | SLM yoki ML kanalini tanlash va yakuniy prognoz. |
Moliyaviy prognozlash muammosi qanday formulalanadi?
Tadqiqot kunlik koʻp-aktivli vaqt qatorini rejim oʻzgarishlari va heteroskedastik shovqin sharoitida koʻrib chiqadi. \(X_t\), \(t\) vaqtidagi cross-asset signallari, sentiment koʻrsatkichlari va texnik xususiyatlarni; \(p_t\) esa normallashtirilgan maqsad yopilish narxini bildiradi.
\[ \hat{f}=\arg\min_f \mathbb{E}_{(X_t,p_t)\sim P_t} \left[ \ell\left(p_{t+1},f(X_{1:t},p_{1:t})\right) \right] \]
Bu yerda maqsad, taqsimot vaqt davomida oʻzgarishi mumkin boʻlgan \(P_t\) sharoitida keyingi kun narxini prognozlashdagi kutilgan yoʻqotishni kamaytirishdir. \(\ell\) mutlaq yoki kvadratik xato yoʻqotishini ifodalaydi. Formula tizim faqat oʻzgarmas ma’lumot taqsimotida emas, balki oʻzgaruvchan bozor sharoitlarida prognoz qilishni maqsad qilganini matematik tarzda ifodalaydi.
Ma’lumotlar olami
| Guruh | Aktiv / xususiyat misollari |
|---|---|
| AI bilan bogʻliq kripto maqsadlar | FET, AGIX, NMR, OCEAN, CTX |
| Texnologiya aksiyalari maqsadlari | NVDA, MSFT |
| Asosiy kripto bozori | BTC, ETH |
| Token sektorlari | DeFi, NFT, Energy, Gold, Healthcare, Asset Management, Lending & Borrowing |
| Aksiya/indeks konteksti | S&P, NASDAQ AI & Robotics, NASDAQ Internet, Dow Jones Basic Materials, Dow Jones Oil & Gas |
| Xomashyo | Xom neft, oltin |
| Tematik ETF’lar | Clean Energy, Robotics & AI, ROBO, Fintech Global ETF’lari |
| Semantic/policy oʻzgaruvchilari | Panic Index, Media Hype Index, Media Coverage Index, Fake News Index, Infodemic Index, GEPU |
Kriptovalyuta narxlari CoinMarketCap dan, neft ma’lumotlari Energy Information Administration dan va turli equity/index/ETF ma’lumotlari Thomson Reuters manbalaridan olingani koʻrsatilgan.
Xususiyatlar muhandisligi
Barcha oʻzgaruvchilar Min-Max usuli bilan \([0,1]\) oraligʻiga masshtablanadi:
\[ x_i'= \frac{x_i-\min(X)} {\max(X)-\min(X)} \]
Bu oʻzgartirish turli masshtabdagi moliyaviy oʻzgaruvchilarni umumiy sonli oraliqqa olib keladi. Biroq manba \(\min(X)\) va \(\max(X)\) qiymatlari faqat training set dan hisoblanganmi yoki yoʻqmi, buni aniq jumla bilan koʻrsatmaydi. Tadqiqot xronologik boʻlish va leakage dan qochish maqsadini bildirsa-da, scaler fitting tafsiloti reproducibility nuqtai nazaridan aniqroq hisobot qilinishi mumkin edi.
Texnik xususiyatlar orasida turli kechikishlar uchun momentum:
\[ M_{t,k}= \frac{p_t-p_{t-k}}{p_{t-k}}, \qquad k\in\{1,2,3,5,7\} \]
SMA, EMA, rolling volatility, RSI, Bollinger Bands va rolling cross-asset correlation mavjud. Cross-asset korrelyatsiya:
\[ \rho_{i,j}(t) = \operatorname{corr} \left( p_{i,t-w:t}, p_{j,t-w:t} \right) \]
koʻrinishida ifodalanadi.
MirrorPrompt Nima va Ikki Kanal Nimani Ajratadi?
MirrorPrompt bir xil bozor holatini ikki alohida ifoda orqali Small Language Model ga taqdim etadigan semantic predictor tuzilmasidir: numeric channel soʻnggi narx ketma-ketligini yuqori aniqlikdagi sonli tasvir sifatida saqlaydi, semantic channel esa momentum, volatillik, cross-asset koʻrsatkichlari va sentiment/policy oʻzgaruvchilaridan tabiiy til kontekstini yaratadi; shunday qilib miqdoriy naqsh va kontekstual talqin bitta xom feature vector ga qisqartirilmasdan qayta ishlanadi.
Numeric channel
Numeric channel oʻtgan narx ketma-ketligini:
\[ n_t = [p_{t-w+1},p_{t-w+2},...,p_t] \]
koʻrinishida va olti oʻnlik raqam aniqligida taqdim etadi. Amaliyot boʻlimida MirrorPrompt uchun \(w=8\) oʻtgan narx ishlatilgani koʻrsatilgan.
Semantic channel
Semantic channel kontekstni:
\[ S(c_t) = f_{\mathrm{template}} (\Delta p_t,\sigma_t,I_t,S_t) \]
koʻrinishida yaratadi. Bu yerda \(\Delta p_t\) narx oʻzgarishini, \(\sigma_t\) volatillikni, \(I_t\) cross-asset koʻrsatkichlarini va \(S_t\) sentiment/policy xususiyatlarini ifodalaydi.
Muhim farq bor: tizim breaking-news matnlarini yoki jonli yangilik oqimini bevosita oʻqimaydi. Manbadagi semantic channel strukturalashtirilgan bozor va sentiment koʻrsatkichlarini template-driven tabiiy til izohlariga aylantiradi.
Uchta ustma-ust oyna va confidence-weighted prognoz
MirrorPrompt \(K=3\) ustma-ust oyna hosil qiladi. Har bir oyna return prognozi \(\hat r_k\) va confidence \(c_k\) beradi. Small Language Model deterministic sampling bilan, ya’ni temperature \(\tau=0\) ishlatilgan holda ishga tushiriladi.
\[ \hat r_{\mathrm{SLM}} = \frac{\sum_{k=1}^{K} c_k\hat r_k} {\sum_{k=1}^{K}c_k} \]
\[ c_{\mathrm{SLM}} = \frac{1}{K} \sum_{k=1}^{K}c_k \]
\[ u_{\mathrm{SLM}} = 1-\min(c_{\mathrm{SLM}},1) \]
Shunday qilib, yuqori confidence bergan oynaning return prognozi ensemble natijasida yuqoriroq vazn oladi; uncertainty esa confidence ning toʻldiruvchisi sifatida meta-learner ga uzatiladi.
SLM amaliyot tafsilotlari
Tajribalarda Small Language Model sifatida Gemma-3-1b-it LM Studio API orqali ishlatilgan. Response timeout 30 soniya, standart max_tokens=150, reasoning modellar uchun 600 va temperature qiymati 0 deb koʻrsatilgan.
LSTM–Random Forest temporal predictor
Temporal kanal ikki xil model oilasini birlashtiradi. LSTM oʻtgan ketma-ketlikdagi uzoq va qisqa bogʻliqliklarni qayta ishlasa, Random Forest xususiyatlar orasidagi chiziqsiz oʻzaro ta’sirlarni aniqlashga harakat qiladi.
LSTM uchta qatlamdan iborat:
64 → 32 → 16 birlik
va sequence length \(L=10\), dropout 0,2, batch normalization, Adam optimizer va learning rate 0,001 dan foydalanadi.
LSTM ning asosiy hujayra amallari manbada quyidagi zanjir bilan berilgan:
\[ f_t=\sigma(W_f[h_{t-1},x_t]+b_f) \]
\[ i_t=\sigma(W_i[h_{t-1},x_t]+b_i) \]
\[ \tilde C_t= \tanh(W_C[h_{t-1},x_t]+b_C) \]
\[ C_t=f_t\odot C_{t-1}+i_t\odot\tilde C_t \]
\[ o_t=\sigma(W_o[h_{t-1},x_t]+b_o), \qquad h_t=o_t\odot\tanh(C_t) \]
Random Forest kanali 100 tree ishlatadi. Manba maximum depth qiymatini 20 deb beradi va minimum-sample cheklovlari bilan overfitting ni cheklashni maqsad qiladi.
Yakuniy temporal prediction amaliyot boʻlimida:
\[ \hat y^{ML} = 0.7\hat y^{LSTM} + 0.3\hat y^{RF} \]
koʻrinishidagi qat’iy LSTM–RF aralashmasidir.
Temporal kanalning noaniqligi
Ikki model orasidagi nisbiy kelishmovchilik:
\[ u_{ML,t} = \frac{ |\hat y_{t+1}^{LSTM}-\hat y_{t+1}^{RF}| }{ \max( \hat y_{t+1}^{LSTM}, \hat y_{t+1}^{RF} ) } \]
bilan hisoblanadi. Soʻng:
\[ c_{ML,t}=1-u_{ML,t} \]
tarzida confidence olinadi. Ushbu yondashuv ikki temporal model bir xil natijaga yaqinlashganda yuqori, bir-biridan uzoqlashganda esa pastroq ishonch hosil qilish mantiqiga asoslanadi.
Meta-learner nimaga qaraydi?
Meta-learner 12 oʻlchamli \(z_t\) feature vector ustida ishlaydigan Random Forest classifier dir. Manbada berilgan asosiy meta-feature lar quyidagilar: ikki kanalning confidence qiymatlari, uncertainty qiymatlari, prognozlar orasidagi nisbiy farq, confidence va uncertainty farqlari, volatillik, trend kuchi, soʻnggi davr model accuracy qiymatlari va narx momentumi.
Meta-classifier 20 estimator va maximum depth 5 dan foydalanadi. Manba shuningdek minimum-sample cheklovlari va temporal validation haqida soʻz yuritadi.
Meta-selection
Meta-selector:
\[ \delta(z_t)\in\{\mathrm{SLM},\mathrm{ML}\} \]
tarzida aniqlanadi va qaysi prognoz kanali ishlatilishini tanlaydi.
Ikki kanalning nisbiy disagreement qiymati:
\[ d_t= \frac{ |\hat y_{t+1}^{SLM}-\hat y_{t+1}^{ML}| }{ \max( \hat y_{t+1}^{SLM}, \hat y_{t+1}^{ML} ) } \]
bilan oʻlchanadi.
Confidence calibration
Manba meta-classifier ning xom probability qiymatini oʻrtacha kanal confidence qiymatiga qarab qayta masshtablaydi:
\[ p_{\mathrm{cal}}= \begin{cases} 0.4+0.2(p_{\mathrm{raw}}-0.5), & \bar c<0.6\\ 0.3+0.4p_{\mathrm{raw}}, & 0.6\leq \bar c<0.8\\ 0.2+0.6p_{\mathrm{raw}}, & \bar c\geq0.8 \end{cases} \]
Bu yerda:
\[ \bar c= \frac{c_{SLM}+c_{ML}}{2} \]
boʻlib, kalibrlangan confidence qiymati koʻpi bilan 0,85 bilan cheklanadi. Ushbu chegara meta-learner ning ayniqsa volatil sharoitlarda haddan tashqari ishonchli xulq koʻrsatishining oldini olishga qaratilgan manba-ta’riflangan xavfsizlik mexanizmidir.
Sanity check
Yakuniy prognoz \([0,1]\) normallashtirilgan domain ichida qolishi kerak. Bundan tashqari single-step nisbiy oʻzgarish:
\[ \frac{|\hat y_i-p_t|}{p_t}\leq\tau_{\max} \]
shartiga boʻysunadi va manbada:
\[ \tau_{\max}=0.5 \]
deb berilgan. Prognoz ushbu chegaralarni buzsa tizim muqobil modelga oʻtishi yoki ehtiyotkorroq prediction capping ni qoʻllashi mumkin.
Tadqiqot Usuli va Natijalari
Oʻqitish va baholash tartibi
| Element | Manbada berilgan qiymat |
|---|---|
| Ma’lumot davri | Yanvar 2020 – Dekabr 2024 |
| Chastota | Kunlik |
| Global ma’lumot boʻlinishi | %80 training, %20 test |
| Ichki validation | Training boʻlimining soʻnggi %10 qismi |
| Meta-learner anti-overfitting holdout | Manbaning alohida usul bayonida %30 temporal holdout |
| SLM | Gemma-3-1b-it |
| MirrorPrompt narx oynasi | w = 8 |
| MirrorPrompt ensemble | K = 3 oyna |
| SLM temperature | 0 |
| LSTM tuzilmasi | 64 → 32 → 16 |
| LSTM sequence length | L = 10 |
| Dropout | 0,2 |
| Optimizer | Adam |
| Learning rate | 0,001 |
| Batch size | 32 |
| Early stopping | Cross-validation uchun 15, final training uchun 25 epoch patience |
| Temporal Random Forest | 100 tree, max depth 20 |
| Meta Random Forest | 20 estimator, max depth 5 |
| ML aralashmasi | 0,7 LSTM + 0,3 RF |
| Maximum calibrated confidence | 0,85 |
| Single-step relative change chegarasi | 0,5 |
%30 meta-learning temporal holdout bilan training boʻlimining soʻnggi %10 qismiga ajratilgan internal validation aynan qanday ichma-ich qoʻllangani manbada yetarlicha tushuntirilmagan. Shu sababli ularni bitta nisbat sifatida birlashtirish kerak emas.
LSTM training yoʻqotishi
\[ L_{LSTM} = \frac{1}{N} \sum_{i=1}^{N} (y_i-\hat y_{LSTM,i})^2 \]
Ushbu Mean Squared Error yoʻqotishi LSTM prognoz qilingan va haqiqiy normallashtirilgan narx orasidagi kvadratik farqni kamaytirishini ta’minlaydi.
Meta-learner training maqsadi
Meta-learner ning ground-truth yorligʻi validation ma’lumotida qaysi ekspert pastroq xato berganiga qarab yaratiladi. Meta-classifier uchun manbada cross-entropy koʻrinishida:
\[ L_{meta} = -\frac{1}{T} \sum_{t=1}^{T} \left[ y_t^{SLM}\log P(SLM|z_t) + y_t^{ML}\log P(ML|z_t) \right] \]
ishlatiladi.
\(y_t^{SLM}=1\), tegishli bosqichda SLM pastroq xato hosil qilganda; \(y_t^{ML}=1-y_t^{SLM}\) esa temporal model muvaffaqiyatliroq boʻlganda ishlatiladi.
Baholash metrikalari
MAE:
\[ MAE= \frac{1}{n} \sum_{i=1}^{n} |y_i-\hat y_i| \]
RMSE:
\[ RMSE= \sqrt{ \frac{1}{n} \sum_{i=1}^{n} (y_i-\hat y_i)^2 } \]
va coefficient of determination:
\[ R^2= 1- \frac{ \sum_{i=1}^{n}(y_i-\hat y_i)^2 }{ \sum_{i=1}^{n}(y_i-\bar y)^2 } \]
ishlatiladi. Manba, shuningdek, confidence calibration uchun reliability diagram va bin-based calibration error baholashini amalga oshirganini bildiradi.
Taqqoslangan baseline modellar
| Model oilasi | Modellar |
|---|---|
| An’anaviy machine learning | DTC, RFC, AdaBoost, SVM |
| Deep learning | LSTM, CNN-LSTM |
| Transformer | Standard Transformer, Informer, TFT |
| Taklif etilgan tizim | ASTIF |
Yetti aktivdagi MAE va RMSE natijalari
| Aktiv | ASTIF MAE | ASTIF RMSE | Eng yaxshi baseline MAE | MAE yaxshilanishi |
|---|---|---|---|---|
| CTX | 0,0226 | 0,0576 | 0,0247 — LSTM | %8,5 |
| FET | 0,0133 | 0,0521 | 0,0324 — Informer | %59,0 |
| NMR | 0,0158 | 0,0305 | 0,0245 — Informer | %35,5 |
| OCEAN | 0,0168 | 0,0421 | 0,0181 — Informer | %7,2 |
| AGIX | 0,0213 | 0,0558 | 0,0236 — Informer | %9,7 |
| MSFT | 0,0222 | 0,0440 | 0,0243 — LSTM | %8,6 |
| NVDA | 0,0073 | 0,0130 | 0,0138 — Informer | %47,1 |
ASTIF ning yetti aktivning barchasida eng past MAE ni berishi tadqiqotning eng aniq taqqoslama natijasidir. Eng katta nisbiy yutuq FET da, ikkinchi eng katta yutuq NVDA da, eng kichik yutuq esa OCEAN da xabar qilingan.
ASTIF Ning Ustunligi Barcha Xato Oʻlchovlarida Amal Qiladimi?
Yoʻq. Manba ASTIF ni umumiy holda barcha baseline lardan ustun deb talqin qilsa-da, Jadval 1 ning batafsil qiymatlari ASTIF yetti aktivning barchasida eng past MAE ni berganini, ammo eng past RMSE ni faqat NMR, MSFT va NVDA da berganini koʻrsatadi; CTX da LSTM, FET da Informer/TFT, OCEAN va AGIX da Informer pastroq RMSE qiymatiga ega. Shu sababli eng mustahkam natija MAE ustunligidir; “barcha oʻlchovlarda mutlaq ustunlik” manba jadvali tomonidan qoʻllab-quvvatlanmaydi.
RMSE boʻyicha aktiv darajasidagi farq
| Aktiv | Eng past RMSE modeli | Eng past RMSE | ASTIF RMSE |
|---|---|---|---|
| CTX | LSTM | 0,0422 | 0,0576 |
| FET | Informer / TFT | 0,0447 | 0,0521 |
| NMR | ASTIF | 0,0305 | 0,0305 |
| OCEAN | Informer | 0,0256 | 0,0421 |
| AGIX | Informer | 0,0378 | 0,0558 |
| MSFT | ASTIF | 0,0440 | 0,0440 |
| NVDA | ASTIF | 0,0130 | 0,0130 |
Bu farq MAE va RMSE turli xato xususiyatlariga sezgir ekanini ham koʻrsatadi. RMSE katta xatolarni kvadratga oshirgani sababli oz sonli katta prognoz ogʻishlariga MAE ga qaraganda koʻproq vazn beradi.
Manba shakllari koʻrsatgan natijalar
Manba Shakl 3 ASTIF ning yetti aktivdagi MAE qiymatlarini eng yaxshi baseline bilan yonma-yon koʻrsatadi va ayniqsa FET hamda NVDA dagi farqlar yaqqol. Shakl 4; oʻrtacha MAE, R², xato taqsimoti va ayrim aktivlardagi model taqqoslashini toʻrt panelda koʻrsatadi. Shakl 5 esa NMR, CTX, MSFT va NVDA uchun actual va predicted price trajectory chiziqlarini taqqoslaydi.
Bu chiziqlarning vizual ravishda yaqin boʻlishi oʻz-oʻzidan trading profitability dalili emas. Xuddi shuningdek, past normallashtirilgan narx xatosi direction accuracy yoki risk-adjusted daromad bilan teng ma’noli emas; manba bunday trading backtest oʻtkazmagan.
Ablatsiya: qaysi komponent qanchalik muhim?
| Konfiguratsiya | Olib tashlangan komponent | NMR MAE | NMR RMSE | FET MAE | FET RMSE |
|---|---|---|---|---|---|
| ASTIF Baseline | Yoʻq | 0,0109 | 0,0180 | 0,0146 | 0,0298 |
| Pure Machine Learning | SLM Channel | 0,0703 | 0,0881 | 0,1252 | 0,2459 |
| Non-Sequential ML | LSTM Modeling | 0,0618 | 0,0791 | 0,1201 | 0,2308 |
| Deterministic Framework | Uncertainty | 0,0420 | 0,0649 | 0,0682 | 0,1726 |
| Static Ensemble | Meta-Learner | 0,0367 | 0,0462 | 0,0629 | 0,1240 |
Manbaning oʻz oʻrtacha oshish hisobida semantic SLM kanali olib tashlanganda MAE %653, LSTM olib tashlanganda %596, uncertainty mexanizmi olib tashlanganda %327 va meta-learner olib tashlanganda %285 oshadi.
Biroq ushbu ablatsiya jadvalidagi ASTIF baseline qiymatlari asosiy performance Jadval 1 dagi NMR va FET ASTIF qiymatlari bilan bir xil emas. Manba bu farqni aniq izohlamagani uchun jadvallar turli tajriba kontekstlari sifatida koʻrib chiqilishi kerak.
Dual-channel encoding haqiqatan hissa qoʻshadimi?
Manba vakil sifatidagi volatil kripto aktivda toʻliq dual-channel tuzilma uchun MAE 0,0133 ni xabar qiladi. Numeric-only tuzilma uchun MAE 0,0325, semantic-only tuzilma uchun 0,0378. Manbaning hisobiga koʻra dual-channel yondashuv mos ravishda taxminan %59,0 va %64,7 yaxshilanish beradi.
Ikkinchi baholash aktivida dual-channel ustunligi kichikroq ekani koʻrsatiladi: numeric-only yondashuvga nisbatan %3,4 va semantic-only yondashuvga nisbatan %14,9.
Cross-asset context
Cross-asset expanded feature konfiguratsiyasi koʻrib chiqilgan ikki kripto aktivda MAE 0,0278 va 0,0292 qiymatlarini bergan; asosiy semantic configuration ga nisbatan %15,5 va %9,6 yaxshilanish xabar qilingan. Volatility–momentum xususiyatlari ham hissa qoʻshgani, sentiment va market indicator xususiyatlari esa cheklanganroq, ammo oʻlchab boʻladigan yutuq bergani bildirilgan.
Temporal window sezgirligi
Manba sensitivity analysis da oyna oʻlchami 8 ni eng yaxshi accuracy–efficiency muvozanati sifatida xabar qiladi. Window size 12 ishlatilganda FET MAE si %47,3 va NMR MAE si %42,0 oshgan. Mualliflar buni overfitting xulqi sifatida talqin qiladi.
Shuningdek, ikki-model ensemble bitta-model tuzilmaga nisbatan FET va NMR da mos ravishda %5,3 va %4,3 MAE yaxshilanishi bergani koʻrsatilgan; murakkabroq ensemble tuzilmalari albatta yaxshiroq boʻlmasligi haqida xulosa chiqarilgan.
Confidence taqsimoti nimani anglatadi?
Manba Shakl 6 semantic va temporal kanallarning confidence taqsimotlarini koʻrsatadi. Semantic confidence taqsimoti umumiy holda yuqoriroq confidence hududiga siljigan boʻlsa, temporal confidence pastroq qiymatlarda jamlanadi. Mualliflar ikki kanal bir-biriga yaqinlashgan holatlarda meta-learner confidence i oshishini; kanallar ajralganda uncertainty ortishini talqin qiladi.
Bu natija confidence qiymatlari haqiqiy bozor riskining barchasini oʻlchaydi degani emas. Ular modelning oʻz prognoz tuzilmasi va calibration mexanizmi ichidagi noaniqlik koʻrsatkichlaridir.
Tadqiqot qoʻllab-quvvatlaydigan xulosalar
- ASTIF koʻrib chiqilgan yetti aktivning barchasida Jadval 1 ning MAE oʻlchoviga koʻra taqqoslangan baseline lardan pastroq xato bergan.
- MAE ustunligi aktivga qarab %7,2 dan %59,0 gacha oʻzgaradi.
- Semantic SLM, temporal LSTM, uncertainty quantification va meta-learning komponentlarini olib tashlash ablatsiya sharoitlarida natijani yomonlashtirgan.
- Dual-channel encoding manba tajribalarida single-channel tuzilmalardan yaxshiroq natija bergan.
- Cross-asset xususiyatlar va oʻrtacha kattalikdagi temporal context ayrim tajribalarda aniqlikni yaxshilagan.
- Confidence-aware model selection manba tajribalarida semantic va temporal ekspertlarni bitta statik vazn bilan birlashtirishga muqobil mexanizm bergan.
Tadqiqot qoʻllab-quvvatlamaydigan xulosalar
Tadqiqot ASTIF barcha moliyaviy bozorlarda yoki barcha kripto aktivlarda eng yaxshi model ekanini koʻrsatmaydi. Test olami beshta AI bilan bogʻliq token va ikkita texnologiya aksiyasi bilan cheklangan.
Tadqiqot real pul bilan savdo strategiyasi, transaction cost, spread, slippage, order-book impact, Sharpe ratio, Sortino ratio, maximum drawdown yoki portfolio P&L testini amalga oshirmagan. Shu sababli past MAE bevosita foydali trading strategiyasi degani deb boʻlmaydi.
Tadqiqot multi-step forecasting tizimi emas; asosiy vazifa next-step prediction. Multi-step forecasting manbada kelajak tadqiqot mavzusi sifatida koʻrsatilgan.
Tizim real-time yangilik oqimidan foydalanmaydi. Manba historical data ishlatilishini va breaking news / real-time feed integratsiyasi yoʻqligini ochiq bildiradi.
Manba natijalarni p-qiymatlar, confidence interval yoki koʻp random-seed performance taqsimotlari bilan qoʻllab-quvvatlamaydi. Shu sababli baseline farqlarining inferential statistical significance darajasi haqida manbadan tashqari hukm berib boʻlmaydi.
Cheklovlar
| Cheklov | Natijalar talqiniga ta’siri |
|---|---|
| Prompt engineering domain ekspertligini talab qiladi | Semantic channel natijasi prompt dizayniga sezgir boʻlishi mumkin. |
| Hisoblash yuki | Resource-constrained muhitlarda real-time foydalanish qiyinlashishi mumkin. |
| Cheklangan aktiv olami | Yangi tokenlar va muqobil asset class larga umumlashtirish bevosita koʻrsatilmagan. |
| Historical data | Live market feed va breaking-news sharoitlarida xatti-harakat sinovdan oʻtkazilmagan. |
| Next-step forecast | Uzoq multi-step horizon natijasi noma’lum. |
| Asosiy jadvallar orasida baseline farqi | NMR va FET uchun asosiy benchmark bilan ablation baseline qiymatlarini bevosita birlashtirish kerak emas. |
| Validation nisbatlari izohi | %30 meta holdout bilan global split ichidagi %10 internal validation munosabatini qayta ishlab chiqish qoʻshimcha izoh talab qiladi. |
| Inferential significance hisoboti yoʻq | Model farqlarining p-qiymat yoki ishonch oraligʻi darajasidagi ahamiyati manba tomonidan koʻrsatilmagan. |
Kelajak tadqiqot yoʻnalishlari
Manba kelajakda real-time data integratsiyasi, reinforcement learning bilan automated prompt optimization, multi-step forecasting, kengroq asset class baholash va edge computing optimization ni taklif qiladi.
Manba va Usul Haqida Izoh
Asl sarlavha: ASTIF: Adaptive Semantic-Temporal Integration for Cryptocurrency Price Forecasting
Mualliflar: Hafiz Saif Ur Rehman, Ling Liu, Kaleem Ullah Qasim
Corresponding author: Ling Liu
Tashkilotlar: Southwestern University of Finance and Economics, Chengdu, Sichuan, China; Southwest Jiaotong University, Chengdu, Sichuan, China.
Manba turi: arXiv preprint.
arXiv: 2512.18661v1
arXiv kategoriyasi: cs.AI
Birinchi versiya sanasi: 21 Dekabr 2025.
Taqriz holati: Tasdiqlangan taqrizli jurnal nashri topilmagani sababli preprint sifatida koʻrib chiqilgan.
Jurnal ma’lumoti: ArXiv tomonidan qayta ishlangan manuscript matnida “journal: Nuclear Physics B” maydoni koʻrinadi; biroq ushbu sarlavha bilan tasdiqlanadigan Nuclear Physics B nashr yozuvi yoki mustaqil jurnal DOI si topilmagani sababli bu ifoda nashr holati sifatida ishlatilmagan.
DOI: Tasdiqlangan mustaqil jurnal DOI si mavjud emas. arXiv yozuvi 2512.18661 orqali aniqlanadi.
Ma’lumot davri: Yanvar 2020 – Dekabr 2024.
Maqsad aktivlar: FET, AGIX, NMR, OCEAN, CTX, MSFT, NVDA.
Asosiy model: MirrorPrompt SLM + LSTM–Random Forest temporal learner + confidence-calibrated Random Forest meta-learner.
SLM: Gemma-3-1b-it, LM Studio API.
Asosiy baholash metrikalari: MAE, RMSE, R² va calibration error.
Ma’lumot mavjudligi: Taqdim etilgan PDF da alohida Data Availability Statement yoki tasdiqlanadigan public dataset repository havolasi mavjud emas.
Kod mavjudligi: Taqdim etilgan PDF da tasdiqlanadigan GitHub yoki kod repository havolasi mavjud emas.
Moliyalashtirish: Taqdim etilgan PDF da alohida funding statement aniqlanmagan.
Manfaatlar toʻqnashuvi: Taqdim etilgan PDF da alohida conflict-of-interest statement aniqlanmagan.
Muallif hissalari: Alohida CRediT/muallif hissalari bayonoti aniqlanmagan.
Litsenziya: Taqdim etilgan PDF va tasdiqlanadigan birlamchi bibliografik yozuvda ochiq qayta foydalanish litsenziyasi ishonchli tarzda aniqlanmagani sababli litsenziya mavjud deb faraz qilinmagan. Manba figuralari aynan koʻchirilmasligi; sonli ma’lumotlar va ilmiy munosabatlar Verianla uchun mustaqil tarzda qayta chizilishi kerak.
Manba ichidagi talqin izohi: Jadval 1 ASTIF barcha maqsadlarda eng past MAE ni berganini koʻrsatsa-da, barcha maqsadlarda eng past RMSE ni bermaganini koʻrsatadi. Shu sababli manba bayonidagi umumiy “outperforms all baselines” ifodasi eng xavfsiz tarzda MAE va manbada taqdim etilgan umumiy baholash kontekstida talqin qilinishi kerak.
Manba ichidagi reproducibility izohi: Jadval 1 va Table 3 dagi NMR/FET ASTIF baseline qiymatlari farq qiladi. Shuningdek, meta-learner uchun berilgan %30 temporal holdout bilan global %80/%20 split ichidagi soʻnggi %10 internal validation oʻrtasidagi qoʻllash munosabati manbada toʻliq tushuntirilmagan.
Asosiy usul chegarasi: Ushbu tadqiqot tarixiy kunlik ma’lumotda next-step forecast natijasini oʻlchaydi. Real-time yangilik oqimi, live trading, transaction cost va real pul portfolio performance tadqiqotning tajriba doirasidan tashqarida qoladi.
Mualliflik huquqi/bayon usuli: Verianla matni manba tadqiqotning gaplarini yoki figura dizaynlarini qayta yaratmaydi. Usul, matematika, tajriba parametrlari, jadval qiymatlari va natija chegaralari manba tadqiqotdan olinib, mustaqil oʻquvchi Oʻzbekcha tuzilma ichida qayta tartiblangan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan